Le marché promis à mille milliards de dollars de la programmation par IA
Qui projette un marché de mille milliards de dollars pour la programmation par IA, ce que compte chaque projection, et ce que chacune suppose sur l'énergie, les jetons et la réutilisation.
David Charlot, Open Interface Engineering
Ceci est une traduction de la version anglaise. En cas de divergence, la version anglaise fait foi. Original anglais.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Le marché promis à mille milliards de dollars de la programmation par IA. Open Interface Engineering. Web: https://research.openie.dev/papers/ai-coding-market/. PDF: https://research.openie.dev/pdfs/ai-coding-market.pdf.
Version 1.1, 11 octobre 2026. Données et code : research.openie.dev/data/. PDF LaTeX : /pdfs/latex/ai-coding-market.pdf (source).
Résumé
Les prévisions disent que la programmation par IA vaudra des milliers de milliards de dollars par an. Cet essai énumère qui l’affirme, étiquette chaque chiffre selon ce qu’il est, et nomme les hypothèses que les prévisions partagent.
En termes simples
- Les grands chiffres sur la programmation par IA sont surtout des conjectures sur l’avenir, non des comptages d’argent déjà gagné.
- Presque tous supposent que chaque nouveau morceau de code a besoin d’un grand modèle d’IA, facturé au mot, pour toujours.
- Si le code qui fonctionne peut être sauvegardé et réutilisé, le coût d’un travail répété tombe vers le coût de l’électricité pour l’exécuter, et ces prévisions seraient trop élevées.
1. Les projections et les mesures sont des objets différents
Chaque nombre ci-dessous porte l’une de cinq étiquettes.
| Étiquette | Signification |
|---|---|
| Projection | Une prévision ou une estimation de valeur fondée sur des hypothèses énoncées |
| Déclaré par l’entreprise | Un chiffre qu’une entreprise déclare sur elle-même, comme un revenu annualisé (le dernier mois multiplié par douze) ou une valorisation de levée de fonds |
| Estimation d’enquête | Un chiffre de taille de marché issu d’une enquête auprès d’acheteurs |
| Déposé | Un chiffre figurant dans un document réglementaire |
| Mesuré | Un comptage ou une lecture d’énergie provenant d’une exécution dont les artefacts sont conservés. Les lectures d’énergie portent l’une de trois étiquettes : est_j pour une estimation analytique, reported_j pour un compteur du système d’exploitation ou sur puce, measured_j pour un wattmètre externe |
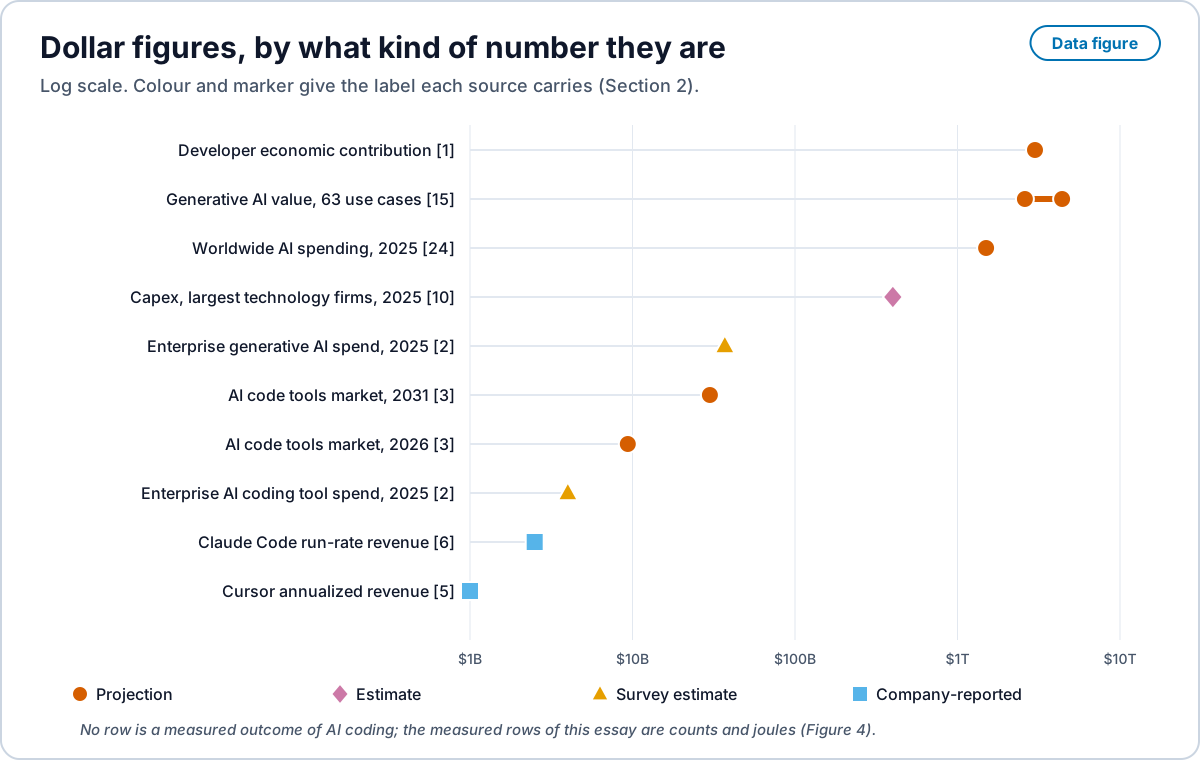
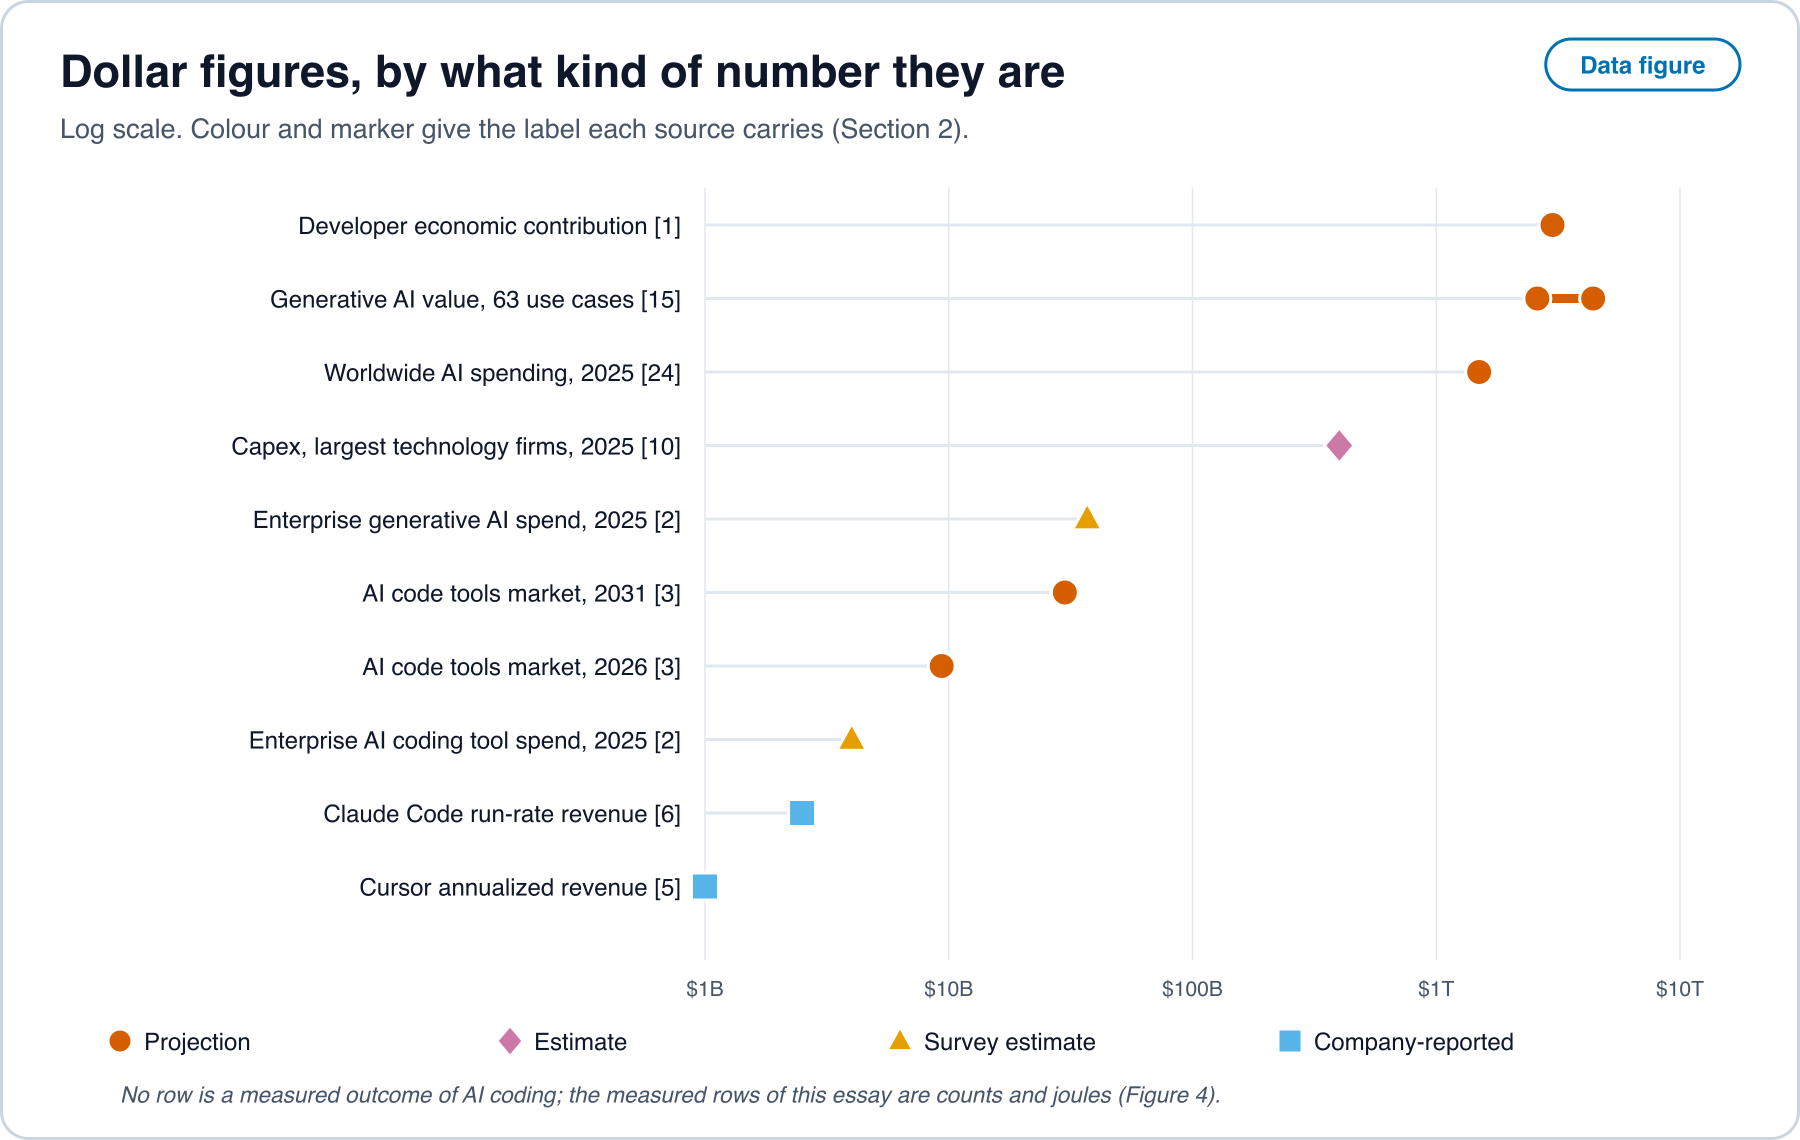
Seule la dernière ligne constitue une preuve sur le coût d’un résultat correct. Les autres sont des preuves de ce qu’attend le marché.
2. Qui projette quoi
2.1 La valeur des développeurs : les mille milliards
| Affirmation | Nombre | Étiquette | Source |
|---|---|---|---|
| Développeurs de logiciels dans le monde | environ 30 millions (de 27 à 47 millions selon les estimations) | Donnée d’entrée de projection | Appenzeller et Li [1] |
| Valeur par développeur et par an | 100 000 dollars (hypothèse) | Donnée d’entrée de projection | [1] |
| Contribution économique annuelle | environ 3 000 milliards de dollars | Projection | [1] |
| Développeurs sur GitHub | plus de 180 millions ; 518,7 millions de pull requests fusionnées dans l’année | Déclaré par l’entreprise | GitHub Octoverse 2025 [17] |
| Valeur de l’IA générative sur 63 cas d’usage | de 2 600 à 4 400 milliards de dollars par an ; productivité de l’ingénierie logicielle de 20 % à 45 % des dépenses annuelles actuelles de la fonction | Projection | McKinsey [15] |
| Effet de l’IA générative sur le PIB mondial | 7 % sur une période de dix ans | Projection | Goldman Sachs [16] |
| Gain de productivité d’un assistant simple | environ 20 % | Estimation tirée d’entretiens | [1] |
| Gain de productivité d’un déploiement de premier ordre | « au moins le double » | Estimation « fondée sur des preuves anecdotiques » | [1] |
Le nombre de développeurs est fragile : 30 millions est une estimation de professionnels, et GitHub seul compte six fois plus de comptes qui développent sur sa plateforme [17]. La valeur par développeur et le multiple de productivité sont fragiles eux aussi (section 2.7). L’estimation de McKinsey de 2023 est le millier de milliards d’origine de ce marché, et c’est une estimation de valeur portant sur toutes les fonctions [15]. Le même essai de capital-risque affirme que l’écosystème de la programmation par IA peut « soutenir des dizaines d’entreprises à un milliard de dollars et même un géant à mille milliards de dollars » [1]. Cette phrase, ce sont les mille milliards. C’est une estimation de valeur. Ce n’est pas une prévision de revenus.
2.2 Revenus des outils et dépenses des entreprises
| Affirmation | Nombre | Étiquette | Source |
|---|---|---|---|
| Dépenses des entreprises en outils de programmation par IA, 2025 | 4,0 milliards de dollars, 55 % des dépenses d’IA des départements | Estimation d’enquête | Menlo Ventures [2] |
| Dépenses des entreprises en IA générative, 2025 | 37 milliards de dollars | Estimation d’enquête | [2] |
| Marché des outils de code par IA, 2026 | 9,35 milliards de dollars, jusqu’à 29,96 milliards en 2031 | Projection | Mordor Intelligence [3] |
Les revenus que le marché déclare aujourd’hui se comptent en milliards. Les mille milliards sont la valeur que le marché espère capter.
2.3 Revenus et valorisations des entreprises
| Affirmation de l’entreprise | Nombre | Date | Étiquette | Source |
|---|---|---|---|---|
| Revenu annualisé de Cursor | plus de 1 milliard de dollars | 13 novembre 2025 | Déclaré par l’entreprise | Cursor [5] |
| Nouvelle tarification de Cursor Pro | des limites de requêtes à « 20 dollars d’usage de modèles de pointe par mois au tarif de l’API », avec remboursements pour le changement | juin à juillet 2025 | Déclaré par l’entreprise | Cursor [18] |
| Série D de Cursor | 2,3 milliards de dollars pour une valorisation post-money de 29,3 milliards | 13 novembre 2025 | Déclaré par l’entreprise | [5] |
| Revenu annualisé d’Anthropic | 14 milliards de dollars | 12 février 2026 | Déclaré par l’entreprise | Anthropic [6] |
| Revenu annualisé de Claude Code | plus de 2,5 milliards de dollars | 12 février 2026 | Déclaré par l’entreprise | [6] |
| Série G d’Anthropic | 30 milliards de dollars pour une valorisation post-money de 380 milliards | 12 février 2026 | Déclaré par l’entreprise | [6] |
Anthropic indique que le tour finance des « extensions d’infrastructure » [6]. Revenus, valorisation et calcul forment un seul pari.
La Figure 1 place sur un seul axe les montants en dollars des Sections 2.1 à 2.3 et 2.6, marqués par l’étiquette que porte chaque source.
2.4 Inférence, tokens et économie unitaire
| Affirmation | Nombre | Étiquette | Source |
|---|---|---|---|
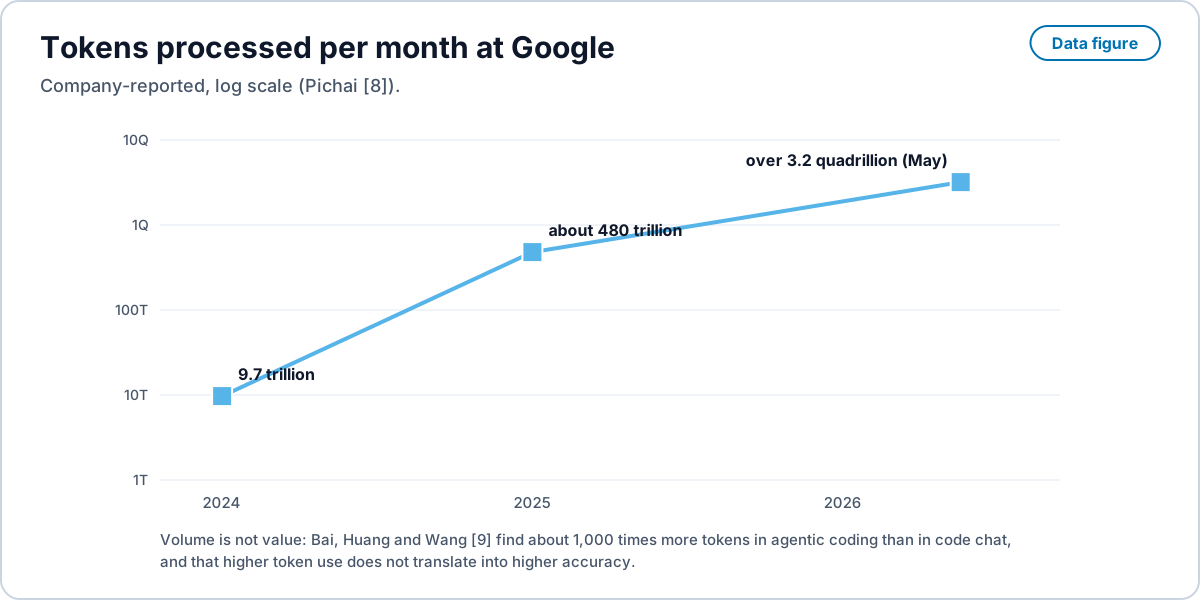
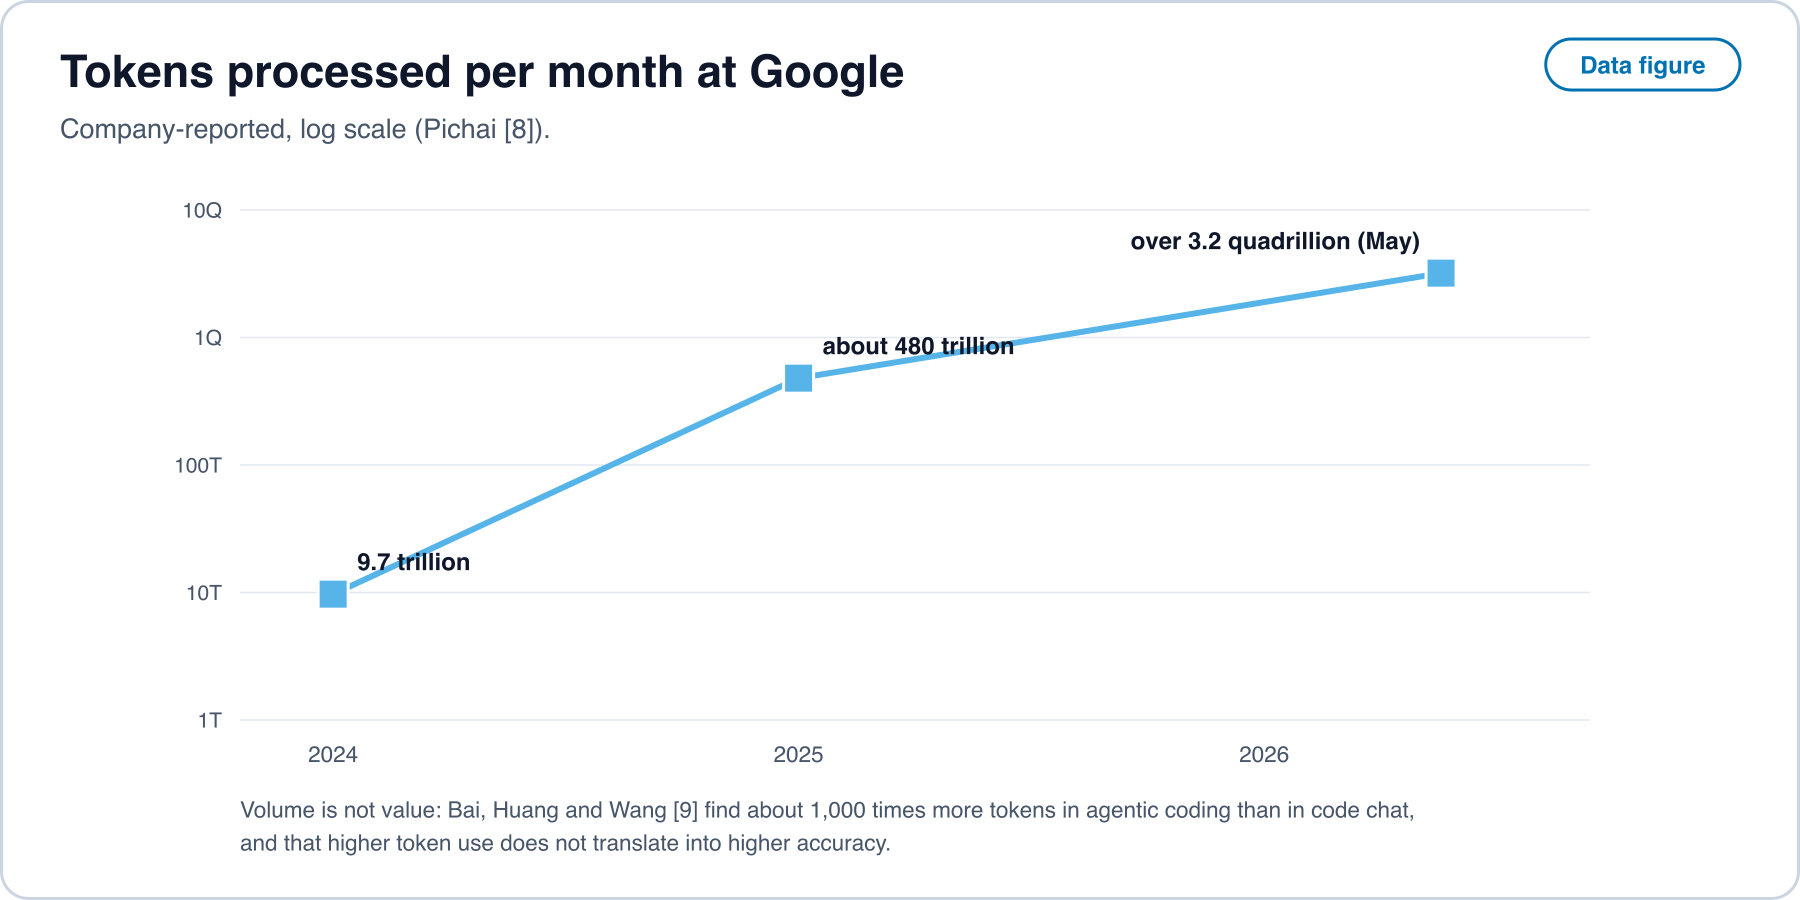
| Tokens traités par Google par mois | 9 700 milliards (2024), environ 480 000 milliards (2025), plus de 3,2 millions de milliards (mai 2026) | Déclaré par l’entreprise | Pichai [8] |
| Outils internes d’IA pour développeurs de Google | 500 milliards de tokens par jour en mars 2026, plus de 3 000 milliards par jour en mai | Déclaré par l’entreprise | [8] |
| Coût d’une requête de programmation agentique aux prix catalogue | 2,50 dollars : un contexte de 100 000 tokens et 10 000 tokens de sortie à 15 et 75 dollars par million de tokens | Illustration | Appenzeller et Li [1] |
| La même chose à 3 requêtes par heure, 7 heures par jour, 200 jours | environ 10 000 dollars par an et par développeur | Illustration | [1] |
| Tokens en programmation agentique face au raisonnement sur le code et au chat de code | environ 1 000 fois plus ; les exécutions d’une même tâche diffèrent jusqu’à 30 fois ; un usage plus élevé de tokens « ne se traduit pas par une précision plus élevée » | Mesuré (huit modèles, SWE-bench Verified) | Bai, Huang et Wang [9] |
| Pertes nettes de l’investissement de Microsoft dans OpenAI, trimestre clos le 30 septembre 2025 | 4,1 milliards de dollars avant impôts, sa part selon la méthode de mise en équivalence, dans les autres charges ; une réduction de 3,1 milliards du résultat net (0,41 dollar par action diluée) | Déposé et déclaré par l’entreprise | Microsoft Form 10-Q [7] ; Microsoft FY26 Q1 performance [19] |
Deux phrases des sources énoncent l’économie sans détour. Pichai : « many companies are already blowing through their annual token budgets, and it’s only May » [8]. Appenzeller et Li : « For decades, software development cost was almost purely people’s cost, but now LLMs add a substantial opex component » [1].
La Figure 2 trace la série de tokens.
2.5 Prix par token
| Affirmation | Nombre | Étiquette | Source |
|---|---|---|---|
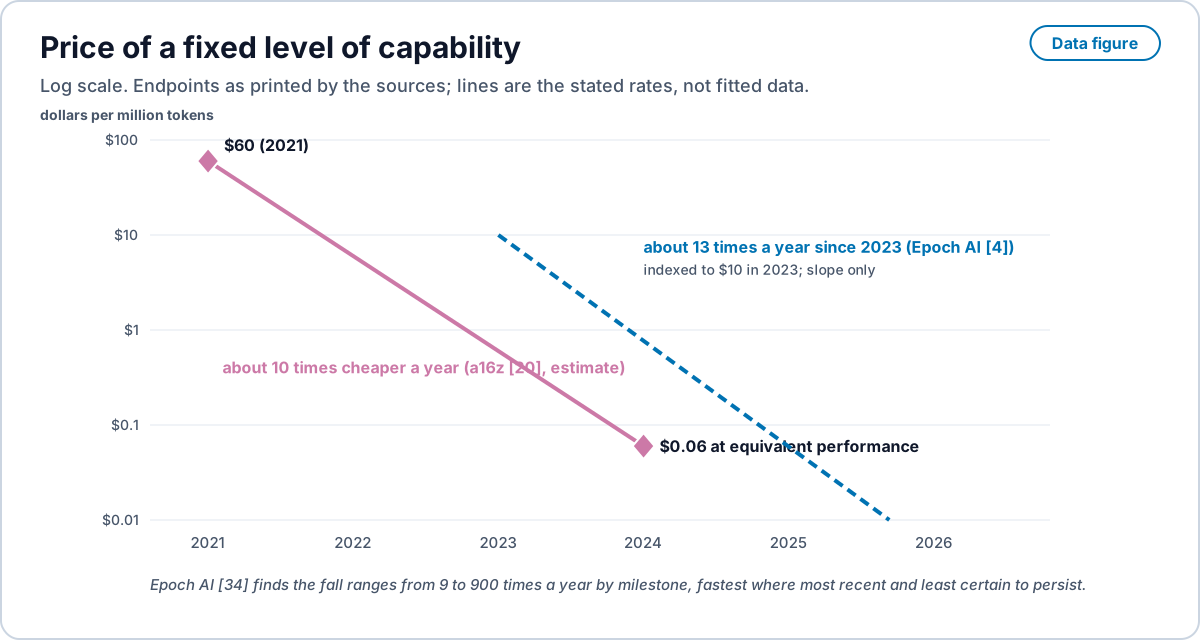
| Coût d’un niveau fixe de performance de l’IA | baisse d’environ 47 % par trimestre, environ 13 fois par an, depuis 2023 | Série de prix mesurée (cinq benchmarks) | Epoch AI [4] |
| Prix pour atteindre un score fixe de benchmark | baisse de 9 à 900 fois par an, selon le jalon ; les baisses les plus rapides sont les plus récentes et les moins sûres de persister | Série de prix mesurée (ajustements log-linéaires) | Epoch AI [34] |
| Coût d’inférence à performance équivalente | baisse d’environ 10 fois par an : de 60 dollars par million de tokens en 2021 à 0,06 dollar | Estimation | Appenzeller, a16z [20] |
| Baisse du prix de l’API DeepSeek, 29 septembre 2025 | coût pour les développeurs « lowered by more than 50% » | Déclaré par l’entreprise | DeepSeek [21] |
Les 13 fois par an de [4] sont un point dans un large intervalle [34]. La baisse est portée par la concurrence et les poids ouverts, comme le montre la baisse de DeepSeek [21]. Elle n’exige aucune comptabilité énergétique. C’est le premier des deux déclins de la section 5. La réutilisation en ajoute un autre, différent : les appels par tâche.
La Figure 3 trace les deux séries de prix.
2.6 Énergie et capital
| Affirmation | Nombre | Étiquette | Source |
|---|---|---|---|
| Électricité des centres de données, 2024 | environ 415 TWh, environ 1,5 % de l’électricité mondiale | Estimation | IEA, Energy and AI [11] |
| Électricité des centres de données, 2030 | environ 945 TWh, scénario de base | Projection | [11] |
| Électricité des centres de données, 2025 à 2030 | de 485 TWh à 950 TWh, environ 3 % de la demande mondiale | Estimation et projection | IEA, Key Questions on Energy and AI [10] |
| Investissements des plus grandes entreprises technologiques | plus de 400 milliards de dollars en 2025, avec une hausse attendue de 75 % supplémentaires en 2026 | Déclaré et projeté | [10] |
| Investissements d’Alphabet | 31 milliards de dollars en 2022 ; environ 180 à 190 milliards attendus en 2026 | Déclaré par l’entreprise et guidance | Pichai [8] |
| Énergie par tâche | baisse d’au moins un ordre de grandeur par an ; les tâches de raisonnement et agentiques utilisent « hundreds or thousands of times more energy per query than simple text generation » | Estimation | [10] |
| Une invite de texte médiane à un assistant en production | 0,24 Wh | Mesuré par l’opérateur | Elsworth et al. [12] |
| Stargate | 500 milliards de dollars sur quatre ans pour l’infrastructure d’IA d’un laboratoire, 100 milliards déployés d’un coup | Annoncé par l’entreprise | OpenAI [22] |
| Dépenses mondiales en IA, 2025 | environ 1 500 milliards de dollars | Projection | Gartner [24] |
| Revenus que les investissements doivent récupérer | « AI’s $600B Question » | Analyse | Sequoia Capital [23] |
La rente à servir est une rente de matériel. Des investissements et des engagements de cette taille se remboursent par un usage tarifé au-dessus de son énergie. Sur les tâches qui peuvent être closes par réutilisation, cette base est plus petite.
2.7 Preuves de productivité
| Étude | n | Conception | Effet | Source |
|---|---|---|---|---|
| Essai a16z | entretiens | Estimation | environ 20 % pour un assistant simple ; « at least double » pour le meilleur de sa classe | [1] |
| GitHub Copilot, tâche de serveur HTTP | développeurs recrutés | Expérience contrôlée | 55,8 % plus rapide sur une tâche jouet | Peng et al. [27] |
| Essai d’entreprise Google | 96 ingénieurs | Essai contrôlé randomisé | environ 21 % de temps en moins sur la tâche | Paradis et al. [28] |
| METR, début 2025 | 16 développeurs expérimentés de code ouvert, 246 tâches | Essai contrôlé randomisé | 19 % plus lents avec l’IA | Becker et al. [25] |
| METR, mise à jour 2026 | nouvelle cohorte | Essai contrôlé randomisé | les auteurs qualifient les nouvelles données de « an unreliable signal » | METR [26] |
Les effets mesurés vont d’un ralentissement de 19 % à une accélération de 56 % sur une tâche jouet. Les deux facteurs de l’estimation de valeur, le nombre de développeurs et le multiple de productivité, sont fragiles. Cela affaiblit les mille milliards. Cela signifie aussi que toute valeur libérée par une programmation moins chère n’est pas un nombre connu.
3. Ce que supposent les projections
Lues ensemble, les projections reposent sur quatre hypothèses. Chacune est un énoncé sur une direction de l’espace de conception, non sur la valeur du logiciel.
- Une seule direction : la génération. Chaque changement est écrit par un modèle. L’estimation de valeur met à l’échelle la productivité par le modèle, et l’illustration de coût met un prix sur chaque requête [1].
- Haute énergie et haut calcul. Le volume de tokens, l’électricité des centres de données et les investissements sont projetés pour croître ensemble [8, 10, 11]. L’énergie par requête baisse, et les tokens par tâche montent plus vite [9, 10].
- Rente par token. Les revenus sont facturés par token ou par siège dont le coût est en tokens. Le coût annuel en tokens d’un développeur est projeté à l’échelle d’un salaire [1].
- L’IA dans la boucle pour toujours. La tâche 10 000 coûte ce que coûte la tâche 1, parce que rien de ce que le modèle a appris sur la tâche 1 ne s’exécute sans le modèle sur la tâche 10 000.
L’essai qui énonce les mille milliards énonce aussi sa limite : « while substitution pricing works in early markets, eventually the cost of a good converges to its marginal cost, and so does pricing » [1]. Cet essai est d’accord, et demande quel est le coût marginal d’une tâche de programmation correcte.
4. Ce que coûte une tâche correcte
Définissons, pour une tâche de programmation, le résultat de son contrôle d’acceptation (les tests passent, une preuve se vérifie, ou une sortie correspond à une référence), l’énergie utilisée pour atteindre , en joules, le prix de l’énergie, en dollars par joule, et le coût d’exécution du contrôle, en dollars. Un acheteur paie pour , non pour des tokens.
L’énergie borne le coût marginal. Le coût marginal d’une exécution est au moins , car l’électricité doit être achetée. Sous concurrence, le prix tend vers le coût marginal [1, 14].
Une grande part du code est réutilisée. Gurevich a prouvé que tout algorithme séquentiel est capturé par une machine à états abstraits séquentielle : un ensemble d’états et une règle de transition [35]. Lopes et ses collègues ont mesuré qu’environ 70 % du code sur GitHub consiste en clones de fichiers créés auparavant [36]. Là où une solution qui passe existe déjà, une tâche peut être close en la récupérant et en la contrôlant plutôt qu’en la générant à nouveau.
Proposition E0 (prix d’une tâche couverte). On dit qu’une tâche est couverte lorsqu’une solution stockée passe son contrôle. Soit l’énergie pour récupérer, appliquer et contrôler cette solution. Sous concurrence entre vendeurs dont les résultats passent le même contrôle, le prix d’une tâche couverte tend vers
La génération n’est nécessaire que sur les tâches non couvertes. Pour un flux de tâches de fraction couverte et de coût moyen de génération sur les tâches non couvertes, le prix attendu par tâche est . La fraction n’est pas encore mesurée (Proposition E4).
5. Où les projections sont fragiles
Tarification par token. Une tâche close par réutilisation n’a besoin d’aucun token, si bien qu’une ligne de revenus tarifée au token n’y gagne rien. Le revenu total en tokens sur un flux de tâches croît avec .
Le modèle dans chaque boucle. Si une solution trouvée une fois est stockée et contrôlée, les tâches ultérieures de même forme n’ont pas besoin du modèle, si bien que les appels de modèle par tâche baissent à mesure que croît. Qu’ils le fassent sur le travail réel est mesuré par la Proposition E3.
Énergie par tâche. Une invite de texte médiane à un assistant en production est mesurée par son opérateur à 0,24 Wh, soit 864 J [12], et l’IEA place les requêtes de raisonnement et agentiques à des centaines ou des milliers de fois l’énergie d’une requête simple [10]. Aucune mesure publique ne compare génération et récupération sur les mêmes tâches, si bien qu’aucun rapport n’est énoncé ici.
Deux déclins se multiplient. Écrivons le coût par tâche comme , avec appels de modèle par tâche et dollars par appel. Le prix par appel à performance fixe baisse d’un facteur de 9 à 900 par an, selon la tâche [4, 34]. La réutilisation baisse . Une projection qui extrapole le volume de tokens ne modélise que .
Regroupement. Un bien dont le coût marginal est proche de zéro, et qui complète un outil que les gens ont déjà, tend à être regroupé dans cet outil, et son prix séparé disparaît [13, 14]. Nalebuff a montré qu’un regroupement peut dissuader l’entrée [32], et Adams et Yellen qu’il peut discriminer sur le prix [33] ; Spolsky a décrit la stratégie consistant à commoditiser un complément [31]. Les changements de tarification sont visibles : GitHub a fait passer les plans individuels de Copilot à une facturation à l’usage à partir du 1er juin 2026 [30], et Cursor a fait passer Pro des limites de requêtes à une tarification API répercutée en 2025 [18].
Ce qui survit. L’estimation de valeur de la section 2.1 peut tenir. Ce qui est fragile, c’est l’hypothèse que la valeur est collectée comme une charge sur la génération, car cette charge ne s’applique qu’à la fraction .
6. Demande
Des tâches moins chères peuvent augmenter la demande totale. L’essai de capital-risque s’y attend : « we believe Jevon’s Paradox in this case holds » [1]. Deux effets doivent être séparés. La demande pour une tâche s’arrête une fois que . L’usage total peut encore croître, car un travail moins cher ouvre de nouvelles tâches. La seule élasticité publiée est faible. Entre les tâches de l’échantillon d’API d’Anthropic, chaque hausse de 1 % du coût est associée à une baisse de 0,29 % de la fréquence d’usage, une élasticité de [29]. C’est une relation transversale entre tâches, non un changement de prix dans le temps. Avec , une baisse de prix sur un ensemble fixe de tâches diminue les revenus, car les revenus changent selon .
7. Propositions et protocoles
Proposition E1 (les courbes de coût se croisent). Pour un flux de tâches dans un dépôt, le coût cumulé par tâche résolue d’une méthode qui stocke et réutilise des solutions contrôlées tombe en dessous de celui d’une méthode qui génère chaque changement, après un nombre fini de tâches. Protocole : exécuter les deux sur le même flux d’issues sous un wattmètre externe. Rapporter measured_j et les dollars par tâche résolue selon l’indice de la tâche, ainsi que l’indice de croisement.
Proposition E2 (le prix suit le plancher). Là où une capacité de programmation peut être close par récupération et règles, son prix catalogue tombe vers . Protocole : suivre dans le temps les prix catalogue d’une telle classe de capacité face à son énergie d’exécution mesurée.
Proposition E3 (la part des tokens dans le coût). Dans un dépôt où la réutilisation croît, la part du coût de la tâche payée en tokens baisse. Protocole : journaliser tokens, joules et dollars par tâche close et par tour, et rapporter la part des tokens dans le coût par tour.
Proposition E4 (couverture). La fraction couverte du volume réel de tâches de programmation est mesurable. Protocole : tirer un échantillon aléatoire de pull requests fusionnées de dépôts publics (GitHub rapporte 518,7 millions fusionnées en une année [17]), tester chacune pour une solution récupérée qui passe les tests du dépôt, et rapporter avec un intervalle de Wilson à 95 %.
Références
[1] G. Appenzeller and Y. Li, “The Trillion Dollar AI Software Development Stack,” 9 October 2025. https://a16z.com/the-trillion-dollar-ai-software-development-stack/
[2] Menlo Ventures, “2025: The State of Generative AI in the Enterprise,” December 2025. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
[3] Mordor Intelligence, “AI Code Tools Market Size, Share and 2031 Growth Trends Report,” fetched 11 October 2026. https://www.mordorintelligence.com/industry-reports/artificial-intelligence-code-tools-market
[4] B. Emberson and D. Roodman, “The plunging price of thought,” Epoch AI, 22 September 2026. https://epoch.ai/publications/the-plunging-price-of-thought
[5] Cursor, “Past, Present, and Future” (Series D announcement), 13 November 2025. https://cursor.com/blog/series-d
[6] Anthropic, “Anthropic raises $30 billion in Series G funding at $380 billion post-money valuation,” 12 February 2026. https://www.anthropic.com/news/anthropic-raises-30-billion-series-g-funding-380-billion-post-money-valuation
[7] Microsoft Corporation, Form 10-Q for the quarter ended 30 September 2025, Note 3 and Item 2. https://www.sec.gov/Archives/edgar/data/789019/000119312525256321/msft-20250930.htm
[8] S. Pichai, “I/O 2026: Welcome to the agentic Gemini era,” 19 May 2026. https://blog.google/innovation-and-ai/sundar-pichai-io-2026/
[9] L. Bai, Z. Huang and X. Wang, “How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks,” 2026. arXiv:2604.22750. https://arxiv.org/abs/2604.22750
[10] International Energy Agency, Key Questions on Energy and AI, executive summary, 2026. https://www.iea.org/reports/key-questions-on-energy-and-ai/executive-summary
[11] International Energy Agency, Energy and AI, executive summary, April 2025. https://www.iea.org/reports/energy-and-ai/executive-summary
[12] C. Elsworth et al., “Measuring the environmental impact of delivering AI at Google Scale,” 2025. arXiv:2508.15734. https://arxiv.org/abs/2508.15734
[13] Y. Bakos and E. Brynjolfsson, “Bundling Information Goods: Pricing, Profits, and Efficiency,” Management Science 45(12), 1999. doi:10.1287/mnsc.45.12.1613
[14] C. Shapiro and H. R. Varian, Information Rules: A Strategic Guide to the Network Economy, Harvard Business School Press, 1998.
[15] McKinsey & Company, “The economic potential of generative AI: The next productivity frontier,” June 2023. https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/the-economic-potential-of-generative-ai-the-next-productivity-frontier
[16] Goldman Sachs, “Generative AI could raise global GDP by 7%,” April 2023. https://www.goldmansachs.com/intelligence/pages/generative-ai-could-raise-global-gdp-by-7-percent.html
[17] GitHub, “Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1,” 2025. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
[18] Cursor, “Clarifying our pricing,” June 2025 pricing post. https://cursor.com/blog/june-2025-pricing
[19] Microsoft Investor Relations, FY26 Q1 Performance. https://www.microsoft.com/en-us/investor/earnings/fy-2026-q1/performance
[20] G. Appenzeller, “Welcome to LLMflation: LLM inference cost is going down fast,” a16z, November 2024. https://a16z.com/llmflation-llm-inference-cost/
[21] DeepSeek, DeepSeek-V3.2-Exp release and API price reduction, 29 September 2025 (in Chinese). https://api-docs.deepseek.com/zh-cn/news/news250929
[22] OpenAI, “Announcing The Stargate Project,” 21 January 2025. https://openai.com/index/announcing-the-stargate-project/
[23] D. Cahn, “AI’s $600B Question,” Sequoia Capital, 2024. https://www.sequoiacap.com/article/ais-600b-question/
[24] Gartner, “Gartner Says Worldwide AI Spending Will Total $1.5 Trillion in 2025,” 17 September 2025. https://www.gartner.com/en/newsroom/press-releases/2025-09-17-gartner-says-worldwide-ai-spending-will-total-1-point-5-trillion-in-2025
[25] J. Becker, N. Rush, E. Barnes and D. Rein, “Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity,” METR, 2025. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
[26] METR, uplift study update, 24 February 2026. https://metr.org/blog/2026-02-24-uplift-update/
[27] S. Peng, E. Kalliamvakou, P. Cihon and M. Demirer, “The Impact of AI on Developer Productivity: Evidence from GitHub Copilot,” 2023. arXiv:2302.06590. https://arxiv.org/abs/2302.06590
[28] E. Paradis, K. Grey, Q. Madison et al., “How much does AI impact development speed? An enterprise-based randomized controlled trial,” 2024. arXiv:2410.12944. https://arxiv.org/abs/2410.12944
[29] Anthropic, “Anthropic Economic Index report: Uneven geographic and enterprise AI adoption,” September 2025. https://www.anthropic.com/research/anthropic-economic-index-september-2025-report
[30] GitHub Japan blog, “GitHub Copilotの個人向けプラン: ProとPro+へのフレックス枠追加と新しいMaxプランのご紹介,” 15 May 2026 (in Japanese). https://github.blog/jp/2026-05-15-github-copilot-individual-plans-introducing-flex-allotments-in-pro-and-pro-and-a-new-max-plan/
[31] J. Spolsky, “Strategy Letter V,” Joel on Software, 12 June 2002. https://www.joelonsoftware.com/2002/06/12/strategy-letter-v/
[32] B. Nalebuff, “Bundling as an Entry Barrier,” Quarterly Journal of Economics 119(1), 2004. doi:10.1162/003355304772839551
[33] W. J. Adams and J. L. Yellen, “Commodity Bundling and the Burden of Monopoly,” Quarterly Journal of Economics 90(3), 1976. doi:10.2307/1886045
[34] Epoch AI, “LLM inference prices have fallen rapidly but unequally across tasks,” data insight. https://epoch.ai/data-insights/llm-inference-price-trends
[35] Y. Gurevich, “Sequential abstract-state machines capture sequential algorithms,” ACM Transactions on Computational Logic 1(1), 2000, pp. 77 to 111. doi:10.1145/343369.343384
[36] C. V. Lopes, P. Maj, P. Martins, V. Saini, D. Yang, J. Zitny, H. Sajnani and J. Vitek, “DéjàVu: a map of code duplicates on GitHub,” Proceedings of the ACM on Programming Languages 1(OOPSLA), 2017, article 84. doi:10.1145/3133908