Le prix de l'interface non examinée
Ce que coûtent les défaillances d'interface, à partir des seuls chiffres énoncés par une source primaire, chacun étiqueté comme coût comptabilisé, estimation de modèle ou estimation d'enquête.
David Charlot, Open Interface Engineering
Ceci est une traduction de la version anglaise. En cas de divergence, la version anglaise fait foi. Original anglais.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Le prix de l'interface non examinée. Open Interface Engineering. Web: https://research.openie.dev/papers/interface-economics/. PDF: https://research.openie.dev/pdfs/interface-economics.pdf.
Version 1.0, 11 octobre 2026. PDF LaTeX : /pdfs/latex/interface-economics.pdf (source).
Résumé
Cet essai rassemble les coûts publiés des défaillances qui surviennent aux transferts entre les parties d’un système, et étiquette chaque chiffre selon la manière dont il a été produit. Il ne les additionne pas en un total.
En termes simples
- Certaines défaillances aux transferts ont un prix exact, comme une sonde martienne perdue qui a coûté des centaines de millions de dollars.
- Les plus grands chiffres nationaux sont des estimations tirées d’enquêtes et de modèles, et aucun d’eux ne compte les seules défaillances aux transferts.
- Écrire et vérifier ce que suppose chaque partie coûte peu, mais celui qui le fait paie pendant que tout le monde en profite, si bien que cela reste souvent non fait.
0. Définitions et périmètre
Une interface est un transfert par lequel la sortie d’une partie devient l’entrée d’une autre : de ceux qui énoncent ce qu’un système doit faire (les théoriciens) à ceux qui le construisent (les constructeurs) puis à ceux qui l’exploitent (les utilisateurs), ou entre deux niveaux d’une pile logicielle et matérielle. Une hypothèse d’interface est une condition portant sur les valeurs qui franchissent un transfert, dont le côté récepteur dépend pour sa propre correction, comme une unité, une plage, un type, une version ou une enveloppe de fonctionnement. Une hypothèse est non examinée lorsqu’on s’y fie sans qu’elle soit ni écrite ni vérifiée. Une longue littérature d’ingénierie, de Garlan, Allen et Ockerbloom sur l’inadéquation architecturale à Leveson sur les accidents comme défaillances d’interaction, situe de nombreuses défaillances de systèmes dans de telles hypothèses [19, 20]. Cet essai demande ce que coûtent ces défaillances, et ne répond qu’avec des chiffres qu’énonce une source primaire. Chaque chiffre est étiqueté selon son type. Un coût comptabilisé est ce qu’une agence ou une entreprise déclare avoir réellement dépensé ou perdu. Une estimation de modèle est un chiffre produit par une méthode énoncée à partir d’enquêtes, d’entretiens ou de données secondaires. Une projection est un énoncé sur l’avenir. Les trois types ne s’additionnent pas.
Les coûts comptabilisés des défaillances d’interface isolées sont élevés et précis : le projet Mars Surveyor 1998, qui comprenait Mars Climate Orbiter, a coûté 327,6 millions de dollars [1], et l’ESA a approuvé 214 millions d’ECU pour reconstituer la mission Cluster perdue lors du premier vol d’Ariane 5 [4]. Les estimations de modèle sont plus élevées et plus larges : le NIST a évalué le coût annuel d’une infrastructure de test logiciel inadéquate aux États-Unis à 59,5 milliards de dollars [6], et le coût d’une interopérabilité inadéquate dans le secteur américain des grandes installations (capital facilities) à 15,8 milliards de dollars par an [7]. Le CISQ a estimé le coût de la mauvaise qualité logicielle aux États-Unis à au moins 2 410 milliards de dollars en 2022, et la dette technique accumulée à environ 1 520 milliards de dollars [8]. Aucun de ces chiffres ne mesure la seule défaillance d’interface. Chacun la contient.
1. Types de nombres
Les affirmations économiques sur les défaillances logicielles circulent sous trois formes qui se ressemblent et ne sont pas équivalentes. Un budget de projet est un enregistrement comptable. Une estimation nationale de coût est la sortie d’un modèle dont les entrées sont des enquêtes, des études de cas et des hypothèses d’échelle. Une prévision n’est ni l’un ni l’autre. Cet essai suit une règle : chaque chiffre porte son type, sa source et ce qu’il compte réellement.
Des chiffres pour le coût de la « défaillance d’interface » comme total annuel unique circulent sans méthode énoncée. Aucune des estimations primaires de la Section 3 n’isole les interfaces, et cet essai ne les ramène donc à aucun total unique.
2. Défaillances isolées, comptabilisées
Mars Climate Orbiter. L’interface était une unité : des données d’impulsion des propulseurs en livres-force secondes lues comme des newtons-secondes [2]. La fiche descriptive du projet de la NASA indique un coût de 327,6 millions de dollars pour le projet Mars Surveyor 1998, orbiteur et Mars Polar Lander réunis : 193,1 millions de dollars pour le développement des engins, 91,7 millions de dollars pour le lancement et 42,8 millions de dollars pour les opérations [1]. Les comptes rendus de l’époque présentaient l’orbiteur seul comme un engin de 125 millions de dollars [3]. Type : coût comptabilisé du projet, avec un chiffre rapporté pour le seul engin.
Ariane 501 et Cluster. L’interface était une enveloppe : un logiciel réutilisé d’Ariane 4 supposait une plage de vitesse horizontale que le nouveau lanceur a dépassée [5]. Les quatre satellites Cluster ont été perdus. Le récit de l’ESA sur la reconstitution consigne les options que son Comité du programme scientifique a chiffrées en 1996, dont 351 millions d’unités de compte pour reconstruire les quatre satellites selon la conception d’origine, et l’ESA a approuvé en 1997 une mission de reconstitution, Cluster II, pour 214 millions d’ECU [4, 17]. Type : coût comptabilisé de la reconstitution choisie par l’ESA, qui est une borne inférieure de la perte, et non la valeur des satellites ni celle de la science retardée.
Ces deux cas fixent la forme du problème. Dans chacun, chaque organisme a fait son propre travail, et le coût est tombé à l’interface. Dans chacun, la vérification qui aurait détecté l’inadéquation coûtait peu au regard de la perte. Aucun des deux cas ne peut être extrapolé à un chiffre national, car des accidents isolés ne constituent pas un échantillon.
3. Estimations nationales, modélisées
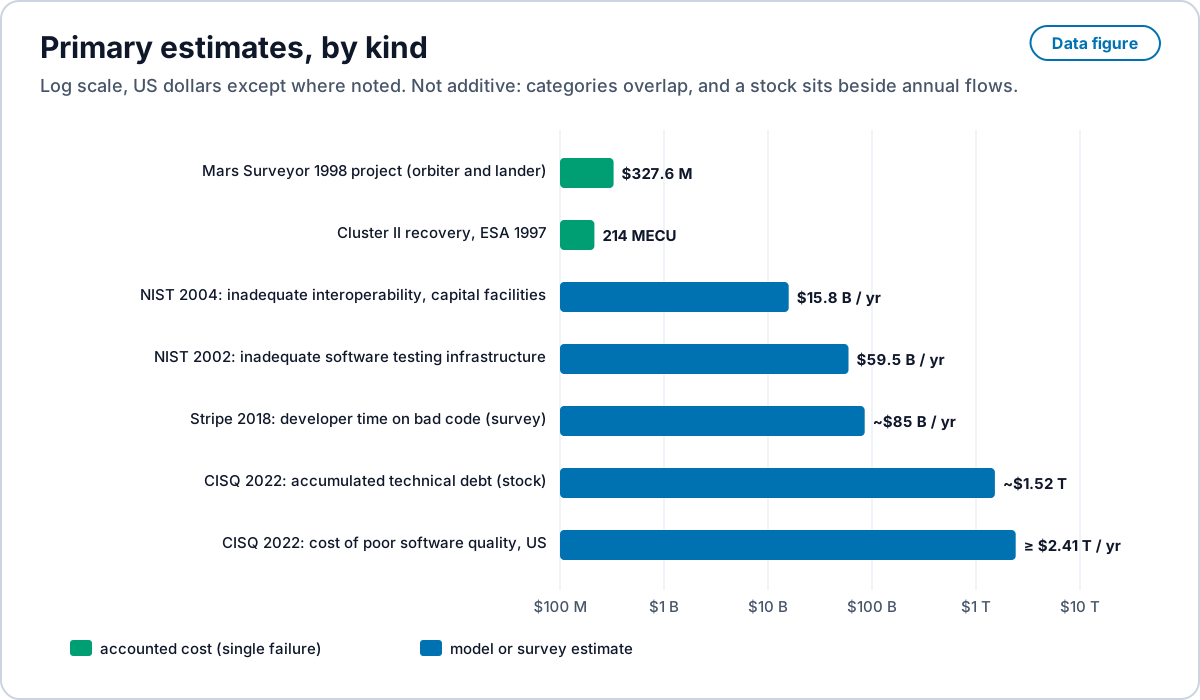
Test logiciel, NIST 2002. RTI International, pour le NIST, a estimé qu’une infrastructure inadéquate de test logiciel coûtait à l’économie américaine de 22,2 à 59,5 milliards de dollars par an, le chiffre haut étant le coût total et le chiffre bas la part que des améliorations réalisables pourraient supprimer [6]. La méthode combinait des enquêtes auprès de développeurs et d’utilisateurs de deux secteurs, la construction de matériel de transport et les services financiers, avec une extrapolation à l’économie nationale. Type : estimation de modèle.
Interopérabilité, NIST 2004. Gallaher et ses collègues, pour le NIST, ont estimé le coût d’une interopérabilité inadéquate dans le secteur américain des grandes installations à 15,8 milliards de dollars par an, à partir d’entretiens et d’enquêtes auprès de propriétaires, d’exploitants, d’architectes, d’ingénieurs et d’entrepreneurs [7]. L’interopérabilité désigne ici la capacité d’échanger et d’utiliser des données de conception et d’exploitation entre systèmes logiciels, ce qui est une interface au sens défini dans le Résumé. Le rapport précise que son chiffre omet les coûts qu’il n’a pas pu quantifier. Type : estimation de modèle, un seul secteur, présentée comme prudente.
Mauvaise qualité logicielle, CISQ 2022. Le Consortium for Information and Software Quality a estimé que le coût de la mauvaise qualité logicielle aux États-Unis avait atteint au moins 2 410 milliards de dollars en 2022, et que la dette technique accumulée avait atteint environ 1 520 milliards de dollars [8]. Le rapport construit le total à partir de catégories, les défaillances opérationnelles, les projets infructueux, les problèmes des systèmes hérités et les pertes dues à la cybercriminalité attribuées aux vulnérabilités logicielles, et tire une grande partie de ses données de sources secondaires ; sa composante cybercriminalité attribue aux États-Unis une part d’une prévision mondiale [8]. Type : estimation de modèle fondée en partie sur d’autres estimations. C’est le chiffre documenté le plus élevé dans ce domaine, et c’est un chiffre pour la qualité logicielle dans son ensemble, non pour les interfaces.
Temps des développeurs, Stripe 2018. Une enquête de Stripe menée avec Harris Poll a indiqué que les développeurs consacrent environ 17,3 heures par semaine à des travaux de maintenance comme le débogage et la refactorisation, et environ quatre heures par semaine au « mauvais code », que le rapport évalue à près de 85 milliards de dollars par an dans le monde [9]. Type : estimation fondée sur une enquête.
Ce que ces chiffres ont en commun est une structure, non un total. Chacun compte le coût d’une hypothèse sur laquelle on s’est appuyé sans la vérifier : un chemin non testé, un format de données qui ne se transmet pas, une vulnérabilité à une frontière, un système hérité dont personne ne sait plus réénoncer les contrats. Une inadéquation qui n’est pas vérifiée là où elle naît passe comme une entrée bien formée à chaque niveau au-dessus d’elle, si bien que son coût apparaît loin de sa cause, comme dans la solution de navigation de Mars Climate Orbiter, qui était cohérente en interne et fausse [2]. C’est aussi pourquoi les estimations nationales doivent être modélisées plutôt que comptées.
4. La dette technique est un compte d’interfaces
Cunningham a introduit la dette technique en 1992 comme le coût de livrer du code dont la structure ne correspond pas encore à ce que l’équipe a appris, avec des intérêts payés à chaque modification ultérieure jusqu’au remboursement de la dette [10]. Sculley et ses collègues ont montré que, dans les systèmes d’apprentissage automatique, l’essentiel de cette dette se trouve hors du modèle, dans le code de liaison, la configuration, les dépendances de données et les consommateurs non déclarés [11]. Dans les termes définis plus haut, une grande partie de la dette technique est un solde d’hypothèses d’interface non examinées porté au bilan, et ses intérêts sont le coût qu’une inadéquation non vérifiée impose à chaque niveau au-dessus d’elle, à chaque exécution.
L’estimation du CISQ d’environ 1 520 milliards de dollars de dette technique accumulée aux États-Unis est un stock, mesuré en coût de correction [8]. Les chiffres annuels de la Section 3 sont des flux. La conséquence économique est une hypothèse, testée dans la Section 7 : une vérification payée une fois à une frontière peut coûter moins, sur une charge de travail, qu’une défaillance payée de nouveau à chaque niveau qu’elle atteint.
5. Les normes sont la façon dont les marchés ferment les interfaces
Les économistes étudient le problème de l’interface depuis des décennies sous un autre nom : la compatibilité. Katz et Shapiro ont montré que, lorsque la valeur d’un produit augmente avec le nombre d’utilisateurs avec lesquels il peut fonctionner, les incitations des entreprises à être compatibles dépendent de leur taille et de leur position, et le marché peut fournir trop peu de compatibilité [12]. Farrell et Saloner ont montré qu’un marché peut rester bloqué sur une ancienne norme, ou passer trop vite à une nouvelle, parce que le choix de chaque utilisateur dépend de ce que choisissent les autres [13]. L’histoire du clavier QWERTY par David a rendu concrète la dépendance au chemin emprunté [14]. Baldwin et Clark ont montré que les règles de conception, des interfaces visibles fixées à l’avance, sont ce qui permet aux industries modulaires de se former [15]. La revue de Swann pour le gouvernement britannique a résumé les données selon lesquelles les normes contribuent à la productivité et au commerce [16].
Le fil commun est qu’une interface est un bien public aux coûts privés. Écrire une hypothèse et la vérifier profite à chaque partie qui franchit la frontière, mais c’est payé par celui qui l’écrit. Chaque partie a une raison de considérer le transfert comme le travail de quelqu’un d’autre. Les organismes de normalisation, les régulateurs et les propriétaires de plateformes sont les institutions qui ont historiquement payé ce coût. Les représentations vérifiées par machine, comme les types qui portent des unités de mesure ou les spécifications formelles vérifiées par un vérificateur de modèles [21, 22], font baisser le coût privé de la fermeture d’une interface vers le coût de l’exécution de sa vérification.
6. Le code généré franchit les mêmes interfaces
Le code produit par un générateur automatique franchit les mêmes frontières que le code écrit à la main : entre une spécification et une implémentation, entre une bibliothèque et ses utilisateurs, entre le logiciel et le contrat d’instructions qui se trouve en dessous. Chaque franchissement porte des hypothèses qu’un générateur ne vérifie pas, sauf s’il est conçu pour le faire. Les chiffres de la Section 3 concernent donc aussi la génération automatique de code. Si une grande part du coût de la mauvaise qualité logicielle est le coût d’hypothèses non vérifiées aux frontières, alors la valeur de la fermeture des interfaces peut dépasser la valeur d’une écriture plus rapide du code. C’est une hypothèse sur l’endroit où se trouve la valeur, non une mesure. Les protocoles de la Section 7 sont le moyen de la mesurer.
7. Propositions et protocoles
Proposition E1 (la part de l’interface). Dans une population de défaillances logicielles aux coûts comptabilisés, la part du coût dont la cause est une hypothèse d’interface violée, au sens défini dans le Résumé, dépasse la part dont la cause se situe entièrement à l’intérieur d’un seul organisme.
Protocole. Prendre un corpus public d’incidents comportant des champs de coût, comme des rapports d’accidents d’agences ou des dépôts réglementaires. Deux codeurs classent chaque cause comme relevant de l’interface ou interne, à l’aide des définitions du Résumé, sans connaître les coûts. Rapporter la part de l’interface pondérée par les coûts avec un intervalle bootstrap, ainsi que l’accord entre les codeurs.
Proposition E2 (les vérifications sont rentables). Pour une charge de travail fixée, le coût de l’ajout d’une vérification explicite à une interface est inférieur au coût attendu des défaillances qu’elle refuse, sommé sur chaque niveau que la défaillance atteindrait sinon. Formellement, pour une interface franchie fois, soit le coût d’une vérification en dollars, la probabilité qu’un franchissement viole l’hypothèse, et le coût en dollars qu’une violation non détectée impose au niveau des niveaux qu’elle atteint. La vérification est rentable lorsque , c’est-à-dire lorsque . Les deux cas comptabilisés de la Section 2 ont un de l’ordre de dollars, si bien que la condition est satisfaite par toute vérification coûtant moins de dollars par franchissement.
Protocole. Sur un système dont les niveaux ont des coûts d’exploitation connus, injecter une violation de chaque hypothèse d’interface consignée sur un ensemble fixe de graines, en enregistrant le coût de chaque vérification et le coût de chaque violation non détectée là où elle aboutit. Rapporter les deux en joules et en dollars à un prix énoncé.
Proposition E3 (fermer une interface abaisse son coût privé). Lorsque l’hypothèse d’interface fait partie d’une représentation partagée et est vérifiée par construction, le coût de sa fermeture pour une seule partie baisse vers le coût de l’exécution de la vérification.
Protocole. Choisir un transfert réel entre organisations, comme une spécification transmise à un implémenteur. Le faire passer dans un bras sous forme de documentation en prose et dans l’autre sous forme de représentation vérifiée par machine. Enregistrer les heures de travail de chaque côté du transfert et les défaillances situées à l’interface dans chaque bras, avec des intervalles de Wilson à 95 %.
8. Conclusion
Le coût des interfaces non examinées est réel, élevé et mal mesuré. Les défaillances isolées peuvent être chiffrées exactement, et elles montrent que la perte tombe à une frontière que chaque organisme croyait appartenir à quelqu’un d’autre. Les estimations nationales sont des modèles, et les plus élevées décrivent la qualité logicielle dans son ensemble. Aucune source primaire n’énonce le coût de la défaillance d’interface à elle seule, et cet essai n’en fournit pas. Ce que les données étayent, c’est une structure : des coûts qui naissent aux frontières, se propagent vers le haut et s’accumulent comme une dette, dans des marchés qui fournissent trop peu le bien public qu’est une interface vérifiée. Les propositions de la Section 7 énoncent comment cette structure peut être testée.
Références
[1] NASA Jet Propulsion Laboratory, “Mars Climate Orbiter Fact Sheet,” Mars Surveyor 1998 project. Archived copy: https://web.archive.org/web/20121003073752/http://mars.jpl.nasa.gov/msp98/orbiter/fact.html
[2] Mars Climate Orbiter Mishap Investigation Board, Phase I Report. NASA, 10 November 1999. https://llis.nasa.gov/llis_lib/pdf/1009464main1_0641-mr.pdf
[3] A. Pollack, “Two Teams, Two Measures Equaled One Lost Spacecraft,” The New York Times, 1 October 1999. https://archive.nytimes.com/www.nytimes.com/library/national/science/100199sci-nasa-mars.html
[4] European Space Agency, “Cluster will fly again!,” press release N° 12 1997, 26 March 1997. https://www.esa.int/Newsroom/Press_Releases/Cluster_will_fly_again
[5] J. L. Lions (chair), Ariane 5 Flight 501 Failure: Report by the Inquiry Board. European Space Agency, 19 July 1996. https://esamultimedia.esa.int/docs/esa-x-1819eng.pdf
[6] RTI International for the National Institute of Standards and Technology, The Economic Impacts of Inadequate Infrastructure for Software Testing, Planning Report 02-3, May 2002. https://www.nist.gov/system/files/documents/director/planning/report02-3.pdf
[7] M. P. Gallaher, A. C. O’Connor, J. L. Dettbarn and L. T. Gilday, Cost Analysis of Inadequate Interoperability in the U.S. Capital Facilities Industry, NIST GCR 04-867, 2004. doi:10.6028/NIST.GCR.04-867
[8] H. Krasner, The Cost of Poor Software Quality in the US: A 2022 Report. Consortium for Information and Software Quality, 2022. https://www.it-cisq.org/the-cost-of-poor-quality-software-in-the-us-a-2022-report/
[9] Stripe, The Developer Coefficient, with Harris Poll, September 2018. https://stripe.com/files/reports/the-developer-coefficient.pdf
[10] W. Cunningham, “The WyCash portfolio management system,” OOPSLA 1992 Addendum, ACM SIGPLAN OOPS Messenger 4(2), 1993, pp. 29 to 30. doi:10.1145/157710.157715
[11] D. Sculley, G. Holt, D. Golovin, E. Davydov, T. Phillips, D. Ebner, V. Chaudhary, M. Young, J.-F. Crespo and D. Dennison, “Hidden Technical Debt in Machine Learning Systems,” Advances in Neural Information Processing Systems 28, 2015. https://papers.nips.cc/paper_files/paper/2015/hash/86df7dcfd896fcaf2674f757a2463eba-Abstract.html
[12] M. L. Katz and C. Shapiro, “Network Externalities, Competition, and Compatibility,” American Economic Review 75(3), June 1985, pp. 424 to 440. RePEc:aea:aecrev:v:75:y:1985:i:3:p:424-40. https://www.jstor.org/stable/1814809
[13] J. Farrell and G. Saloner, “Standardization, Compatibility, and Innovation,” RAND Journal of Economics 16(1), 1985, pp. 70 to 83. doi:10.2307/2555589
[14] P. A. David, “Clio and the Economics of QWERTY,” American Economic Review 75(2), Papers and Proceedings, May 1985, pp. 332 to 337. RePEc:aea:aecrev:v:75:y:1985:i:2:p:332-37. https://www.jstor.org/stable/1805621
[15] C. Y. Baldwin and K. B. Clark, Design Rules, Volume 1: The Power of Modularity. MIT Press, 2000. doi:10.7551/mitpress/2366.001.0001
[16] G. M. P. Swann, The Economics of Standardization: An Update. Report for the UK Department for Business, Innovation and Skills, 2010. https://www.gov.uk/government/publications/economics-of-standardisation-update-to-report
[17] European Space Agency, “The Resurrection of the Cluster Scientific Mission,” ESA Bulletin 91, 1997. https://www.esa.int/esapub/bulletin/bullet91/b91cred.htm
[19] D. Garlan, R. Allen and J. Ockerbloom, “Architectural mismatch: why reuse is so hard,” IEEE Software 12(6), 1995, pp. 17 to 26. doi:10.1109/52.469757
[20] N. G. Leveson, Engineering a Safer World: Systems Thinking Applied to Safety. MIT Press, 2012. doi:10.7551/mitpress/8179.001.0001
[21] A. Kennedy, “Types for Units-of-Measure: Theory and Practice,” in Central European Functional Programming School, Lecture Notes in Computer Science 6299, Springer, 2010, pp. 268 to 305. doi:10.1007/978-3-642-17685-2_8
[22] C. Newcombe, T. Rath, F. Zhang, B. Munteanu, M. Brooker and M. Deardeuff, “How Amazon Web Services uses formal methods,” Communications of the ACM 58(4), 2015, pp. 66 to 73. doi:10.1145/2699417