Aufgabensättigung versus aggregierter Rebound in der KI-Nachfrage
Der veröffentlichte Preisverfall digitaler Inferenz belegt weder kostenlose Energie noch kostenlose Aktuation noch unbegrenzten Wert, nachdem eine Aufgabe erledigt ist.
David Charlot, Open Interface Engineering
Dies ist eine Übersetzung der englischen Fassung. Bei Abweichungen gilt die englische Fassung. Englisches Original.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Aufgabensättigung versus aggregierter Rebound in der KI-Nachfrage. Open Interface Engineering. Web: https://research.openie.dev/papers/satiation/. PDF: https://research.openie.dev/pdfs/satiation.pdf.
Version 1.1, 11. Oktober 2026. Daten und Code: research.openie.dev/data/. LaTeX-PDF: /pdfs/latex/satiation.pdf (Quelltext).
Zusammenfassung
Sobald eine Aufgabe erledigt ist, fügt weiterer maschineller Aufwand für diese Aufgabe nichts hinzu. Dieses Papier definiert diesen Halt präzise und trennt ihn von der gesonderten Frage, ob die Gesamtnachfrage nach maschineller Arbeit weiter wächst.
In einfachen Worten
- Jede Arbeit hat eine Ziellinie. Danach ist weitere Computerarbeit an dieser Arbeit Verschwendung.
- Billigere Computerarbeit kann trotzdem dazu führen, dass Menschen viel mehr Arbeiten beginnen, sodass die Gesamtnutzung weiter steigen kann.
- Die Geldpreise für KI fallen schnell, aber der Strom, den sie verbraucht, ist nie kostenlos.
Viele Planungsmodelle behandeln die Nachfrage nach maschineller Intelligenz, als hätte sie keine Ziellinie. Die Konsumtheorie enthält bereits das Gegenstück. Sättigung, und der verwandte Bliss-Punkt, ist der Bereich, in dem weitere Einheiten eines Gutes den Nutzen nicht erhöhen und ihn senken können (Andersen, 2001). Dieses Papier definiert ein operationales Gegenstück für Arbeit und Pflege: Eine Schleife erreicht den Aufgabenabschluss, wenn ein ausdrücklich formuliertes Vollständigkeitsprädikat gilt, weitere Aufrufe keine Klausel dieses Prädikats von falsch auf wahr umschalten und Aufrufe, die das Prädikat rückgängig machen, Schaden sind, kein Wert. Verweildauer, Tokenanzahl und Lizenzplatzanzahl sind andere Variablen. Sie können nach der Vollständigkeit steigen.
Zwei Behauptungen müssen getrennt bleiben. Sättigung auf Aufgabenebene gilt per Definition: Sobald das Vollständigkeitsprädikat einer Aufgabe wahr ist, kauft weitere Synthese für diese Aufgabe nichts. Aggregierte Sättigung ist eine Behauptung über die Gesamtnachfrage, und sie folgt nicht daraus. Billigere Synthese kann neue Aufgaben eröffnen (Acemoglu und Restrepo, 2019) und die Gesamtnutzung erhöhen, so wie billigere Kohle den gesamten Kohleverbrauch erhöhte (Jevons, 1865). Jede Routineaufgabe kann gesättigt sein, während die Gesamtnachfrage nach Routineaufgaben unbegrenzt wächst. Dieser Rebound ist das zentrale Identifikationsproblem des Papiers. Abschnitt 5.1 formuliert zwei prüfbare Hypothesen und die Daten, die sie identifizieren würden.
Eine zweite Tatsache betrifft den Preis, nicht die Physik. Epoch AI berichtet starke Rückgänge des Preises einer festen Inferenzleistung (Epoch AI, 2025; Emberson und Roodman, 2026). Dieses Papier nennt die daraus entstehende Lage an der Grenze kostenlos, für digitale Routineaufgaben, deren Ergebnis Information ist und deren Vollständigkeitstest endlich ist. Die Formulierung bedeutet nicht, dass Joule kostenlos sind, dass eine Anlage sich ohne Zertifikat bewegen darf oder dass Pflegearbeit wegautomatisiert wurde. Die Landauer-Schranke ist eine untere Schranke für das Löschen, keine Beschreibung heutiger Beschleuniger (Landauer, 1961; Horowitz, 2014).
Das Papier berichtet weder eine randomisierte Studie noch eine Fehlerrate eines Fertig-Detektors noch eine Aufteilung zwischen der Energie, die vor der Vollständigkeit, und der Energie, die danach aufgewendet wird. Diese Messungen sind in Abschnitt 3.3 spezifiziert und fehlen.
Notation
| Begriff | Definition in diesem Papier |
|---|---|
| Sättigung | In der zitierten Theorie ein Absinken des Grenznutzens auf null oder darunter. In der operationalen Klausel dieses Papiers schalten nach der Vollständigkeit weitere Aufrufe keine Klausel von C von falsch auf wahr um; Aufrufe, die C rückgängig machen, sind Schaden, kein Wert (Abschnitt 3.1). |
| Bliss-Punkt | Ein Güterbündel, bei dem zusätzliche Menge des Gutes den Nutzen senkt. Ein Lehrbuchobjekt. Hier nicht geschätzt. |
| Aufgabenabschluss | Das Ereignis, dass das Vollständigkeitsprädikat wahr wird. Orthogonal zur Modellgröße. |
| Arbeitsvollständigkeit | Ein ausdrücklich formulierter Arbeitshalt: Ticket geschlossen, Patch gemergt, Bericht eingereicht, Hauptbuch abgestimmt oder ein gleichwertiger schriftlicher Test. |
| Pflegevollständigkeit | Ein ausdrücklich formulierter Pflegehalt: Untersuchung abgeschlossen, Medikation abgeglichen, übernehmende Stelle benachrichtigt, Person in einem sicheren Zustand oder ein gleichwertiger schriftlicher Test. |
| An der Grenze kostenlos | Der Grenzpreis eines digitalen Syntheseschritts strebt gegen einen gebündelten oder vernachlässigbaren Geldpreis. Joule und Commits bleiben teuer. |
| Künstliche allgemeine Intelligenz (AGI) | Ein breites Fähigkeitsziel. Keine Preisbeobachtung und kein Ergebnis dieses Papiers. |
| Direkter Rebound | Zusätzliche Nutzung einer Leistung, wenn ihr effektiver Preis fällt, bei derselben Leistung (Gillingham, Rapson und Wagner). |
| Modelliert / simuliert / auf der Platine gemessen | Formel, Programmausführung oder Messgerät. Die neuen Zahlen dieses Papiers gehören zu keiner der drei Klassen; sein empirischer Gehalt ist das Zitieren veröffentlichter Reihen und Dokumente. |
Umfang. Abschnitt 2 gibt einen Überblick über Sättigungstheorie, Aufgabenautomatisierung, Aufmerksamkeitsmärkte, Evidenz zu Technologiezyklen und Inferenzpreise. Abschnitt 3 formuliert Prädikate und sagt, welche nicht geschätzt wurden. Abschnitt 4 listet Behauptungen auf, die auf Zitaten beruhen, und trennt sie von Gestaltungsregeln. Abschnitt 5 antwortet auf Rebound, Pflegekosten und militärische Nachfrage. Abschnitt 6 listet Gefährdungen der Validität auf.
1. Einleitung
Eine Nachfragekurve mit konstant positiver Steigung in „Intelligenz“ empfiehlt mehr Lizenzplätze, mehr Token und mehr Agenten, nachdem eine Arbeit erledigt ist. Diese Empfehlung ist eine Modellierungsentscheidung. Sie ist kein Satz über Arbeit. Die Standardkonsumtheorie erlaubt, dass der Grenznutzen sinkt und null kreuzt. Hat eine Routineaufgabe ein Vollständigkeitsprädikat, lautet die relevante Frage, ob mehr Modellausgabe dieses Prädikat verändert. Wenn nicht, ist zusätzliche Ausgabe ein Kostenfaktor ohne Zuwachs an dem Ziel, das aufgeschrieben wurde.
Die jüngste Preisevidenz weist von einer Knappheit der Synthese weg. Die Reihen von Epoch zeigen, dass der Geldpreis einer gegebenen Benchmarkleistung schnell fällt. Offene Gewichte und typisierte Entscheidungsverfahren, darunter System One, sind weitere Wege, auf denen ein bisher knapper Generierungsschritt billig wird. Teams, die eine abgeschlossene Routineaufgabe so bepreisen, als wäre Synthese noch knapp, verwenden eine veraltete Nebenbedingung.
Die Nebenbedingungen, die nicht aus einer Preisreihe folgen, sind physikalisch und institutionell. Rechnen dissipiert Energie. Horowitz (2014) dokumentiert, dass Datenbewegung und Speicher die praktische CMOS-Energie dominieren, auf Skalen weit oberhalb der idealen Löschschranke von Landauer. Ein Aktor ist kein Token. Eine Unterschrift, eine klinische Übergabe und eine Zahlung werden nicht dadurch rückgängig gemacht, dass man einen weiteren Absatz sampelt. Baumol (1967) zeigte, wie Sektoren mit schwachem Produktivitätswachstum einen wachsenden Anteil der Ausgaben aufnehmen können. Acemoglu und Restrepo (2019) modellieren Automatisierung als Verdrängung von Aufgaben plus die mögliche Schaffung neuer Aufgaben. Keines dieser Ergebnisse sagt, dass ein Sprachmodell die Kostenkrankheit beendet. Sie sagen aber, dass „mehr Fähigkeit“ keine hinreichende Beschreibung von Wert ist.
Die positive Behauptung dieses Papiers ist definitorisch und bibliografisch. Sättigung ist ein kohärentes Objekt. Veröffentlichte Preise für Inferenz sind stark gefallen. Engagement-Metriken sind keine Vollständigkeitsmetriken. Ein Halt für „nicht ausgeben“ und ein Halt für „nicht bewegen“ sind verschiedene Prädikate. Die negative Behauptung ist ebenso wichtig. Dieses Papier identifiziert kein strukturelles Nachfragesystem, schätzt keinen Rebound und berichtet keine gemessene Energie.
2. Verwandte Arbeiten
2.1 Sättigung und Bliss-Punkte
Andersen (2001) behandelt Sättigung innerhalb eines evolutorischen Modells des Strukturwandels, nicht als verbale Präferenz. Das tragfähige Element für dieses Papier ist das ökonomische: Die Grenzbewertung eines Gutes kann null erreichen. Lehrbuch-Bliss-Punkte machen die Geometrie explizit. Für ein Bündel x* steigt der Nutzen in einer Koordinate jenseits von x* nicht, und eine glatte Darstellung kann dort einen negativen Grenznutzen haben. Ein quadratisches Beispiel, U(x) = -a (x - x*)^2 für a > 0, hat ein Maximum bei x* und jenseits davon eine negative Ableitung. Diese Funktion ist ein Modell, mit dem die Definition gelehrt wird. Sie wird in dieser Studie nicht an Agentenprotokolle angepasst. Kein Koeffizient a wird berichtet.
Die operationale Übersetzung erfordert ein Prädikat, das das Modell nicht kennt, solange es niemand formuliert. Sei C(z) = 1, wenn der schriftliche Vollständigkeitstest für die Episode z gilt, sonst 0. Sättigung in dieser Episode bedeutet, dass es einen Zeitpunkt t* gibt, zu dem C bei t* gleich 1 ist und für alle späteren Aufrufe keine Klausel von C von falsch auf wahr umschaltet. Aufrufe, die C rückgängig machen, sind Schaden, kein Wert. Abschnitt 3.1 formuliert dieselbe Regel. Das interne Ereignis ökonomisch fertig tritt ein, wenn C zu 1 wird; dieses Papier nennt dieses Ereignis Aufgabenabschluss. Das ist eine Definition. Zu einer empirischen Behauptung wird sie erst mit einer gelabelten Menge von Episoden und einem Detektor, dessen Fehler gezählt werden. Abschnitt 4 enthält diese Zählung nicht.
Keynes zog 1930 dieselbe Linie. Er teilte Bedürfnisse in absolute Bedürfnisse, die man empfindet, was immer andere haben, und relative Bedürfnisse, die man empfindet, weil ihre Befriedigung uns über andere erhebt. Er argumentierte, dass die absoluten Bedürfnisse erfüllt werden könnten. Das Vollständigkeitsprädikat ist das absolute Bedürfnis einer Aufgabe, aufgeschrieben. Relative und offene Wünsche haben kein solches Prädikat, und Abschnitt 5.2 hält sie aus der Behauptung heraus.
2.2 Aufgaben, Verdrängung und Kostenkrankheit
Baumol (1967) analysiert unausgewogenes Wachstum. Steigt die Produktivität eines Sektors und die eines anderen nicht, steigen die relativen Kosten des stagnierenden Sektors, und er kann die Ausgaben dominieren, selbst wenn seine Menge langsam wächst. Gesundheitswesen, Bildung und Live-Aufführungen sind die üblichen Beispiele. Spätere gesundheitsökonomische Arbeiten bestreiten Größenordnungen und Mechanismen. Dieses Papier verwendet Baumol für eine negative Anweisung: Aus einem Fall des Tokenpreises nicht schließen, dass Pflege zu einem Softwaregut geworden ist. Pflege bleibt im gewöhnlichen institutionellen Sinn von Zeit, Vertrauen und Haftung abhängig. Ein Dokumentationsmodell kann die erfasste Aktivität erhöhen, was eine für Baumol relevante Mehrdeutigkeit ist: Die gemessene Leistung kann sich bewegen, während das Pflegeprädikat sich nicht bewegt.
Die mit David Autor verbundene Arbeitsmarktliteratur zerlegt Berufe in Aufgaben, die Maschinen ausführen können oder nicht. Die festgehaltene Aussage ist Acemoglu und Restrepo (2019), „Automation and New Tasks: How Technology Displaces and Reinstates Labor“, Journal of Economic Perspectives 33(2), https://www.aeaweb.org/articles?id=10.1257/jep.33.2.3. Sie argumentieren, dass Verdrängung den Aufgabenanteil der Arbeit verringert und dass neue Aufgaben ihn wiederherstellen können. Ein vollständigkeitsorientierter Halt steht dem Abschließen einer Aufgabe näher als dem Schaffen einer neuen Engagement-Aufgabe. Eine Agentenschleife ohne Halt kann Aktivitätsmaße ohne Produktivitätsgewinn erhöhen. Diese Möglichkeit ist mit ihrer Warnung vor schwacher Automatisierung vereinbar.
2.3 Aufmerksamkeit und Engagement
Wus Buch „The Attention Merchants“ (Verlagsseite: https://www.penguinrandomhouse.com/books/234876/the-attention-merchants-by-tim-wu/) beschreibt Unternehmen, die Aufmerksamkeit ernten und weiterverkaufen. Der Überblick des Center for Humane Technology über die Aufmerksamkeitsökonomie (https://www.humanetech.com/youth/the-attention-economy) ist eine Zusammenfassung desselben Musters aus Sicht einer Interessenvertretung, keine Studie. Der hier verwendete Schluss ist begrenzt. Ist das Ziel eines Produkts die Verweildauer bei der Aufgabe, kann eine Sitzung, die nach C = 1 weiterläuft, erfolgreich aussehen. Ist das Ziel C, ist dieselbe Sitzung Verschwendung oder Schaden. Die beiden Ziele sind in einem Tokenprotokoll beobachtungsmäßig nicht äquivalent. Kein Experiment in diesem Papier schätzt die Wohlfahrtslücke.
2.4 Historische Zyklen
Technologiemärkte zeigen oft eine spekulative Phase, eine Nutzungsphase und eine spätere Phase der Massenware. Die Evidenz ist ungleichmäßig.
Quinn (2019), „Technological revolutions and speculative finance: evidence from the British Bicycle Mania“, Cambridge Journal of Economics 43(2), 271-294, https://doi.org/10.1093/cje/bey029, untersucht Aktienkurse von Fahrradunternehmen von 1895 bis 1900. Die Kurse stiegen um über 200 Prozent und fielen dann um mehr als 75 Prozent. Das Ergebnis des Papiers betrifft spekulative Finanzierung und Fundamentaldaten, nicht ein gemessenes Prädikat „genug Fahrrad“ für Haushalte. Es als Bild der Finanzierung in der Wettlaufphase zu verwenden, ist gestützt. Es als Beweis einer Sättigung im Verkehr zu verwenden, ist es nicht.
Autos, Linienflugverkehr und Fernsehen haben Märkte mit Massenwarencharakter im alltäglichen Sinn: Gebrauchtfahrzeuge, ertragsgesteuerte Sitzplätze und Panels, die als Vorleistungen für Inhalte verkauft werden. Die Zeilen dienen der historischen Orientierung. Sie sind keine Regressionen. Das Ertragsmanagement der Fluggesellschaften nach der Deregulierung ist eine Preisinstitution für einen Sitzplatz, was Evidenz für einen Massenwarenmarkt für Sitzplätze ist, nicht Evidenz dafür, dass die Reisenachfrage der Passagiere global gesättigt ist.
Das Mobile-Faktenblatt des Pew Research Center (https://www.pewresearch.org/internet/fact-sheet/mobile/) ist die Sättigungsquelle für Telefone. Das Projektarchiv verzeichnet einen Smartphone-Besitz in den USA von nahezu 91 Prozent in den Lesungen der Faktenblätter von 2024 und 2025. Wer die Zahl zitiert, sollte das aktuelle Blatt öffnen, weil Faktenblätter überarbeitet werden. Hoher Besitz ist Evidenz für Diffusion. Er ist für sich genommen keine Evidenz dafür, dass der Grenzwert einer weiteren Telefonkamera null ist.
Die Zeile der digitalen Routineaufgabe ist diejenige, die dieses Papier mit einer Preisreihe statt mit einer Analogie verteidigt. Siehe Abschnitt 4.2.
2.5 Inferenzpreise und offene Gewichte
Epoch AI (2025), „LLM inference price trends“, https://epoch.ai/data-insights/llm-inference-price-trends, berichtet Preisrückgänge bei fester Leistung in der Größenordnung des 9- bis 900-Fachen pro Jahr über die Benchmarks in dieser Notiz. Emberson und Roodman für Epoch AI (2026), „The plunging price of thought“, https://epoch.ai/publications/the-plunging-price-of-thought, berichten einen Rückgang der Kosten einer gegebenen Leistung um etwa 47 Prozent pro Quartal seit etwa 2023, zusammengefasst als etwa das 13-Fache pro Jahr, schneller nahe der Frontier. Das sind die Zusammenfassungen der Autoren zu ihren Daten. Dieses Papier schätzt den Index nicht neu. Die ökonomische Lesart ist eng: Der Geldpreis der Synthese für eine feste gemessene Leistung ist schnell gefallen. Ein fallender Angebotspreis verschiebt die nachgefragte Menge, wenn die Nachfrage elastisch ist. Er schafft kein neues Vollständigkeitsprädikat, und er setzt den Energiepreis nicht auf null.
Werkzeuge der Klasse System One sind als Mechanismus für eine weitere Preissenkung bei Entscheidungsproblemen mit bekannter Optionsmenge relevant. Ein System-One-Modell liefert in einem Vorwärtsdurchlauf eine typisierte Antwort und eine Wahrscheinlichkeit für jede zulässige Option, ohne freien Text. TypeSafe AI benannte die Kategorie mit seinem gehosteten Modell Jev (15. September 2026). Offene Modelle folgten, darunter Laya von Convai Innovations. Ein System-One-Modell schlägt vor. Es ist keine Vollständigkeitsprüfung.
Eine Planungsfaustregel, nach der Frontier-Kompetenz in etwa sechs Monaten billigere Geräte erreicht, ist in keiner hier zitierten Quelle eine gemessene Konstante. Destillation, Quantisierung und Inferenz per Tabellennachschlag (Ma et al., 2024; Wei et al., 2024) sind veröffentlichte Mechanismen, durch die eine gegebene Kompetenz auf billigere Hardware wandern kann. Die Geschwindigkeit ist je Modellpaar eine empirische Frage.
2.6 Physikalische Kosten
Landauer (1961) beschränkt das Löschen. Bennett (1973) zeigt, dass reversibles Rechnen diese Schranke theoretisch umgehen kann. Horowitz (2014) ist die praktische Aussage für CMOS: Energie pro Operation und Energie der Datenbewegung bestimmen die Entwurfsnebenbedingung, viele Größenordnungen oberhalb von kT ln 2 für irreversible CMOS-Logik. Bei K beträgt die Schranke J pro gelöschtem Bit, mit J/K.
Goldman Sachs veröffentlichte eine Research-Notiz mit dem Titel „Gen AI: Too Much Spend, Too Little Benefit?“ (https://www.goldmansachs.com/insights/top-of-mind/gen-ai-too-much-spend-too-little-benefit). Dass eine bedeutende Sell-Side-Notiz existiert, die Infrastrukturausgaben im Verhältnis zum Nutzen infrage stellt, ist eine Dokumententatsache. Dollarbeträge aus der Notiz werden hier nicht zitiert, weil Sell-Side-Schätzungen keine wissenschaftliche Energiebilanz sind.
3. Definitionen und Methoden
3.1 Prädikate
Eine Episode sei eine Folge von Modell- oder Werkzeugaufrufen z_1, ..., z_T zusammen mit einem dem Menschen zugewandten Zustand. Ein Vollständigkeitsprädikat C bildet das Präfix der Episode auf {0, 1} ab. Beispiele, die sich ohne Modellbewertung aufschreiben lassen:
- Arbeit: Die Tests bestehen und die Änderung ist gemergt; oder die Abweichung im Hauptbuch ist null; oder die Pflichtfelder eines Berichts sind ausgefüllt und der Bericht ist eingereicht.
- Pflege: Die Medikationsliste stimmt mit der Quelle überein, die übernehmende Klinikerin oder der übernehmende Kliniker hat die Notiz, und die Punkte der Sicherheitscheckliste, die die Einrichtung als kritisch markiert hat, sind wahr.
C ist keine Wahrscheinlichkeit. Ein Detektor, der eine Bewertung ausgibt, braucht noch eine Schwelle und eine Fehlertabelle, bevor er ein Prädikat im Sinn des fehlenden Experiments aus Abschnitt 4 ist.
Das interne Ereignis ökonomisch fertig zum Zeitpunkt t* bedeutet für den gewählten Test C = 0 auf dem Präfix vor t* und C = 1 bei t*. Dieses Papier nennt die Katalogschicht Aufgabenabschluss. Sättigung in Bezug auf Modellaufrufe bedeutet, dass für alle t > t* zusätzliche Aufrufe keine Klausel von C von falsch auf wahr umschalten. Aufrufe, die C rückgängig machen, sind Schaden, kein Wert. Die Definition sagt nicht, dass Menschen t* immer kennen. Sie sagt, dass die Sättigungsbehauptung, solange kein C aufgeschrieben ist, noch keine Aussage über dieses Produkt ist.
An der Grenze kostenlos ist eine Aussage über den Geldpreis. Sei p_t(q) der Preis der Syntheseleistung q zum Datum t. Die archivierte Preisevidenz lautet, dass p_t für feste Benchmarkleistung mit den Raten gefallen ist, die Epoch berichtet. An der Grenze kostenlos heißt, dass p_t niedrig genug ist, dass eine Lizenzplatz-Lizenz die Kosten dieser Routineaufgabe nur schwach erklärt. Es heißt nicht, dass das Integral der Leistung über die Zeit null ist.
Eine Halteregel kann daher zwei Arten von Gründen haben, ökonomische (das Prädikat gilt, oder ein Budget- oder Richtlinienlimit ist erreicht) und physikalische (ein Sicherheits- oder Energielimit ist erreicht). Die beiden Arten sind verschiedene Prädikate und sollten als verschiedene Gründe erfasst werden.
3.2 Was in dieser Studie getan wurde
Diese Studie ist eine strukturierte Lektüre. Quellen sind das Zitationsgerüst, das im Projekt vom 29. bis 30. September 2026 geprüft wurde, und die Notizen zur Sättigung. Abschnitt 3.3 nennt die Messungen, die die operationale Definition empirisch machen würden.
Die Gestaltungsregeln in Abschnitt 4.10 sind Empfehlungen unter der Bedingung der Definitionen. Sie sind keine geschätzten Behandlungseffekte. Man kann eine Regel ablehnen, ohne die Preisreihe von Epoch abzulehnen, und die Preisreihe annehmen, ohne eine Produktempfehlung anzunehmen.
3.3 Spezifizierte, nicht durchgeführte Messungen
Das Prädikat ist endogen. Witt (2001) argumentiert, dass Wünsche gelernt werden, sodass das Vollständigkeitsprädikat mit fallendem Preis nachrücken kann. Eine Studie der Sättigung über eine Preisänderung hinweg muss deshalb vor der Änderung in ihrer Präregistrierung einfrieren und jede Änderung des Prädikats als gesonderte Behandlung berichten.
H1 lässt sich jetzt aus öffentlichen Daten ablesen. Chen und Kollegen (2024) messen die Token, die nach der ersten korrekten Antwort ausgegeben werden; Cuadron und Kollegen (2025) bewerten das Überdenken in Agententrajektorien; Bai, Huang und Wang (2026) finden, dass der Tokenverbrauch für dieselbe Aufgabe beim agentischen Programmieren über Läufe hinweg um bis zum 30-Fachen schwankt. Wendet man das dieses Papiers nachträglich auf diese Trajektorien an, erhält man eine explorative Schätzung von H1, als explorativ gekennzeichnet. Sie ist die nächste Messung.
Token und Joule. H1 und H2 sind in Token formuliert; die These ist in Joule formuliert. Masanet und Kollegen (2020) fanden, dass die Rechenleistung von Rechenzentren von 2010 bis 2018 etwa auf das Sechsfache wuchs, während die Energie weit weniger stieg; eine Token-Elastizität ist also keine Energie-Elastizität. Jede Hypothese ist in beiden Einheiten zu berichten, mit Nennung der Einheit, die die Daten identifizieren.
- Aufgeteilte Bilanz. Für jede Episode die analytische oder später auf der Platine gemessene Energie der Aufrufe mit
t <= t*und der Aufrufe mitt > t*summieren. Direkter Rebound bei dieser Routineaufgabe ist nur sichtbar, wenn das Integral nach dem Fertigsein geschätzt wird. Das Repository enthält diese Aufteilung nicht. - Detektorfehler. Auf einem gelabelten Korpus falsches Fertig (Prädikat als wahr erklärt, während eine Klausel falsch ist) und falsches Weiter (
Cwahr, und das System ruft weiter auf). Hier werden keine Raten veröffentlicht. - Pflegeübergabe. Zeit bis zum sicheren Zustand und eine Übergabe-Checkliste, der Sitzungsdauer gegenübergestellt. Nicht gemessen.
- Segmenttabelle. Welche Produkte ein kurzes
Chaben und welche offene Forschung oder gegnerische Wettläufe sind. Nicht geschätzt. Der militärische Fall wird in Abschnitt 5 aus der Sättigungsbehauptung ausgeschlossen, statt in sie hineingezwungen zu werden. - Gemessene Energie. Ein externes Leistungsmessgerät an einer formulierten Arbeitslast. Nicht durchgeführt.
Solange diese nicht existieren, sind Sätze über „Overkill-Joule“ Hypothesen. Sätze über die Preise von Epoch sind Zitate.
3.4 Veranschaulichende Episoden, keine Daten
Support-Desk. Vollständigkeit: Das Anliegen der Kundin oder des Kunden ist gelöst, die Antwort ist gesendet und der Ticketstatus ist Done. Weitere Entwürfe verändern C nicht. Ein Tokenzähler kann trotzdem weiterzählen. Die Episode ist ein konstruiertes Beispiel, das die Variablen zeigt. Sie ist keine Stichprobe aus einem Helpdesk.
Pflegeübergabe. Vollständigkeit: kritische Felder ausgefüllt, Medikationsliste abgeglichen, übernehmende Stelle bestätigt, Person in einem sicheren Zustand. Die Sitzungsdauer ist eine andere Variable. Die Episode ist konstruiert. Kein Krankenhausdatensatz wurde analysiert.
Routineaufgabe beim Programmieren. Vollständigkeit: Das Artefakt stimmt mit einem schriftlichen Orakel überein (Tests oder eine bitgenaue Prüfung). Ein Artefakt, das bereits besteht, neu zu erzeugen, erhöht C nicht.
3.6 Treuekriterien und Halteregeln
Shannon (1959) definiert eine Rate-Distortion-Funktion: die kleinste Beschreibungsrate, die die erwartete Verzerrung auf oder unter einer gewählten Treue hält. Gegenstand ist Kommunikation unter einer Nebenbedingung, die die Nutzerin oder der Nutzer festlegt. Es ist keine Nachfragekurve für Intelligenz. Die Ähnlichkeit mit diesem Papier ist nur strukturell. Ein Vollständigkeitsprädikat C ist eine harte Treue: Entweder gelten die formulierten Klauseln oder nicht. Ein Verlust eines Sprachmodells steht einer mittleren Verzerrung auf einer Trainingsverteilung näher. Fallender Verlust und fallender Preis bei festem Benchmark lassen sich als Bewegung entlang einer Raten-Ressourcen-Kurve der Art lesen, die Kaplan et al. (2020) und Hoffmann et al. (2022) für das Training schätzen. Diese Bewegung wählt kein C für eine bestimmte Routineaufgabe. Benchmarkverzerrung mit der Vollständigkeit einer Routineaufgabe zu verwechseln, ist der Kategorienfehler hinter Plänen mit unbegrenzten Lizenzplätzen für abgeschlossene Arbeit.
Cover und Thomas (2006) ist der Lehrbuchweg in die Rate-Distortion-Theorie, wenn man die formale Entwicklung möchte. Das Papier nutzt die Existenz des Treuebegriffs, um zwei Zahlen auseinanderzuhalten: eine Bewertung, die sich immer um einen Bruchteil verbessern lässt, und ein Prädikat, das bereits wahr ist.
3.7 Rebound-Taxonomie, ohne neue Schätzung
Der Rebound-Kanon ist der Rahmen für H2. Khazzoom (1980) zeigte, dass vorgeschriebene Effizienz die Nutzung der Leistung erhöhen kann, Brookes (1990) argumentierte dasselbe auf Ebene der Volkswirtschaft, und Saunders (1992) leitete die Bedingungen im neoklassischen Wachstum her. Sorrell und Dimitropoulos (2008) gaben die mikroökonomischen Definitionen und ihre Grenzen an. Brockway, Sorrell, Semieniuk, Heun und Court (2021) prüften die Evidenz und fanden, dass gesamtwirtschaftlicher Rebound mehr als die Hälfte der erwarteten Energieeinsparungen aufzehren kann. Aufgabensättigung widerspricht diesem Befund nicht. Sie ist ein Halt je Aufgabe, und der aggregierte Rebound von H2 ist der Ort, an dem die Evidenz des Kanons gilt. Beleuchtung ist der historische Fall, an dem sie zu prüfen ist: Fouquet und Pearson (2006) verfolgen sieben Jahrhunderte des Preises und der Nutzung von Licht im Vereinigten Königreich, und Tsao und Kollegen (2010) finden, dass die Nutzung von Licht mit der Effizienz stieg, eine sättigbare Leistung mit großem Rebound.
Die Rebound-Übersicht von Gillingham, Rapson und Wagner trennt Kanäle, die ein einzelnes Schlagwort zusammenfallen lässt. Direkter Rebound ist zusätzliche Nutzung derselben Leistung, wenn ihre effektiven Kosten fallen. Indirekter Rebound ist das Ausgeben eingesparter Ressourcen für andere Leistungen. Gesamtwirtschaftlicher Rebound läuft über Preise und Wachstum. Das Politikfeld der Übersicht ist Energieeffizienz, nicht Token. Die Taxonomie überträgt sich dennoch als Warnung zur Identifikation. Ein gemessener Fall von p_t (Behauptung S-2) identifiziert für sich genommen keinen der drei Kanäle. Direkter Rebound bei einer Routineaufgabe, deren C bereits wahr ist, setzt voraus, dass Käufer weiterhin für Aufrufe zahlen, die C nicht verändern. Indirekte und gesamtwirtschaftliche Kanäle können groß sein, wenn neue Aufgaben entstehen (Acemoglu und Restrepo, 2019). Ein Papier, das eine Elastizität berichtete und sie „den Rebound“ nennte, wäre unterbestimmt. Dieses Papier berichtet keine Elastizität.
Das Muster ist alt. Jevons argumentierte 1865, dass effizientere Dampfmaschinen den gesamten Kohleverbrauch Großbritanniens erhöhen statt senken würden. Alcott verfolgt dieses Argument und die anschließende Debatte (Ecological Economics 54(1), 2005). Nordhaus maß den Preis der Berechnung über mehr als ein Jahrhundert und fand, dass er um viele Größenordnungen fiel, während die gesamte Berechnung stieg (Journal of Economic History 67(1), 2007). Agentenlasten zeigen bereits die Nutzungsseite. Das Engineering-Team von Anthropic berichtete für sein eigenes System, dass Agenten etwa das 4-Fache der Token einer Chat-Interaktion verwenden und Multiagentensysteme etwa das 15-Fache (13. Juni 2025). Diese Zahl ist vom Betreiber berichtet, nicht geprüft. Sie ist damit vereinbar, dass der Appetit je Aufgabe steigt, wenn Aufgaben ihre Gestalt ändern, und genau das muss die aufgeteilte Bilanz aus Abschnitt 3.3 von Verschwendung nach dem Abschluss trennen.
3.8 Knappe Joule und der ökonomische Halt (Fachliteratur 2025 bis 2026)
Die Preisreihen von Epoch (S-2) zeigen, dass Synthese in Geld billiger wird. Neuere Energiepublikationen zeigen, dass Joule knapp bleiben und im Aggregat oft wachsen.
Chung, Wu, Ma und Chowdhury (arXiv:2601.22076, 2026) diagnostizieren die Inferenzenergie über 1,858 Konfigurationen: Der Aufgabentyp allein kann die LLM-Energie pro Antwort um etwa 25× verschieben; Videogenerierung kann die Energie für Bilder um zwei Größenordnungen übertreffen. Der Joule-Artikel „Energy use of AI inference, efficiency pathways, and test-time scaling“ (cell.com/joule/fulltext/S2542-4351(26)00114-5, online am 22. Apr. 2026) schätzt optimierte Anfragen im Frontier-Maßstab im Medianbereich unter einer Wattstunde und berichtet zugleich, dass lange Reasoning- und agentische Anfragen die Energie um mehr als eine Größenordnung erhöhen können; Effizienzgewinne von 8 bis 20× sind absehbar, keine kostenlosen Joule. Luccioni, Strubell und Crawford (FAccT 2025) (doi:10.1145/3715275.3732007) warnen, dass Effizienz ohne Halt die Gesamtausgaben verstärken kann (Jevons). Der Energieüberblick von Epoch AI (epoch.ai/publications/ai-energy, aktualisiert im Juli 2026) trennt moderate Kosten pro Anfrage von der sich rasch verdoppelnden aggregierten Leistung der Rechenzentren.
Lesart für dieses Papier. An der Grenze kostenlos ist eine Aussage über den Geldpreis. Knappe Joule sind eine physikalische Aussage. Der operationale Halt ist der Aufgabenabschluss: Wenn C(z) = 1 gilt, erhöht weitere Synthese das schriftliche Ziel nicht, und ein Halt aus Budget- oder Richtliniengründen ist ein Erfolg. Schätzungen sind keine gemessene Energie.
3.9 Protokoll für eine Studie zum Fertig-Detektor (nicht ausgeführt)
Das folgende Protokoll ist eine Methode für eine künftige Messung. Kein Schritt wurde ausgeführt. Es ist so geschrieben, dass das fehlende Ergebnis ein Ausstiegskriterium hat statt eines Schlagworts.
Population. Episoden aus einer einzigen Produktoberfläche, keine Mischung aus offener Forschung und Ticketabschluss. Jede Episode hat ein schriftliches C mit endlich vielen Klauseln, jede Klausel beobachtbar für eine Person, die das Modell nicht bedient hat. Die Zielgröße ist eine Entwurfsentscheidung; dieses Papier gibt nicht vor, dass eine Poweranalyse durchgeführt wurde. Eine erste brauchbare Tabelle braucht genug positive und negative Fälle, dass eine Rate keine Einzelanekdote ist. Das Archiv enthält diese Tabelle nicht.
Label. Zwei Annotierende markieren jede Klausel als wahr oder falsch zu dem Zeitpunkt, an dem das System zum ersten Mal fertig meldet, und noch einmal am Ende der Sitzung. Abweichungen werden entschieden und gezählt. Die Entscheidung des Detektors wird getrennt vom Label erfasst.
Primäre Raten.
- Falsches Fertig: Das System meldet
C = 1, während eine kritische Klausel falsch ist. - Falsches Weiter: Alle kritischen Klauseln sind wahr, und das System setzt weitere Modell- oder Werkzeugaufrufe ab.
- Sitzungsdauer und Aufrufanzahl sind Kovariaten, keine Endpunkte.
Sekundäre Aufteilung, nur wenn eine Energiebilanz existiert. Die Energie, analytisch oder auf der Platine gemessen, für Aufrufe vor dem entschiedenen t* und danach summieren. Die Messklasse im selben Satz wie die Zahl nennen. Eine analytische OpCounter-Summe ersetzt kein Messgerät und ist nicht mit den Tabellen von Horowitz vergleichbar.
Ausschluss. Episoden ohne schriftliches C werden nicht als „ungesättigt“ gelabelt. Sie liegen außerhalb des Umfangs. Gegnerische Episoden liegen außerhalb des Umfangs für den Sättigungsendpunkt und können dennoch auf physikalische Ablehnung bewertet werden, wenn ein Zertifikat vorliegt.
Scheitern des Protokolls. Können sich die Annotierenden nicht auf Klauseln einigen, war das Prädikat nicht aufgeschrieben. Hat das System kein Ereignis, mit dem es fertig meldet, ist falsches Weiter nicht identifiziert. Statt der beiden Raten eine Modell-Bestenliste zu veröffentlichen, würde dieses Protokoll nicht ausführen.
3.10 Ein numerisches Beispiel für einen Bliss-Punkt (Modell, keine Anpassung)
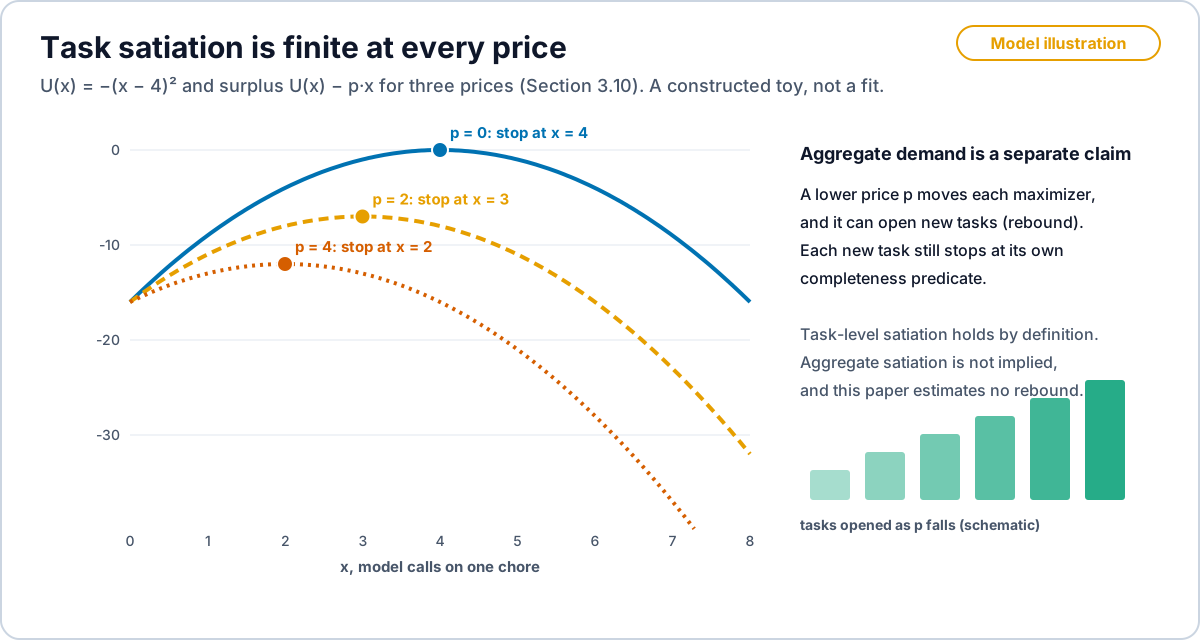
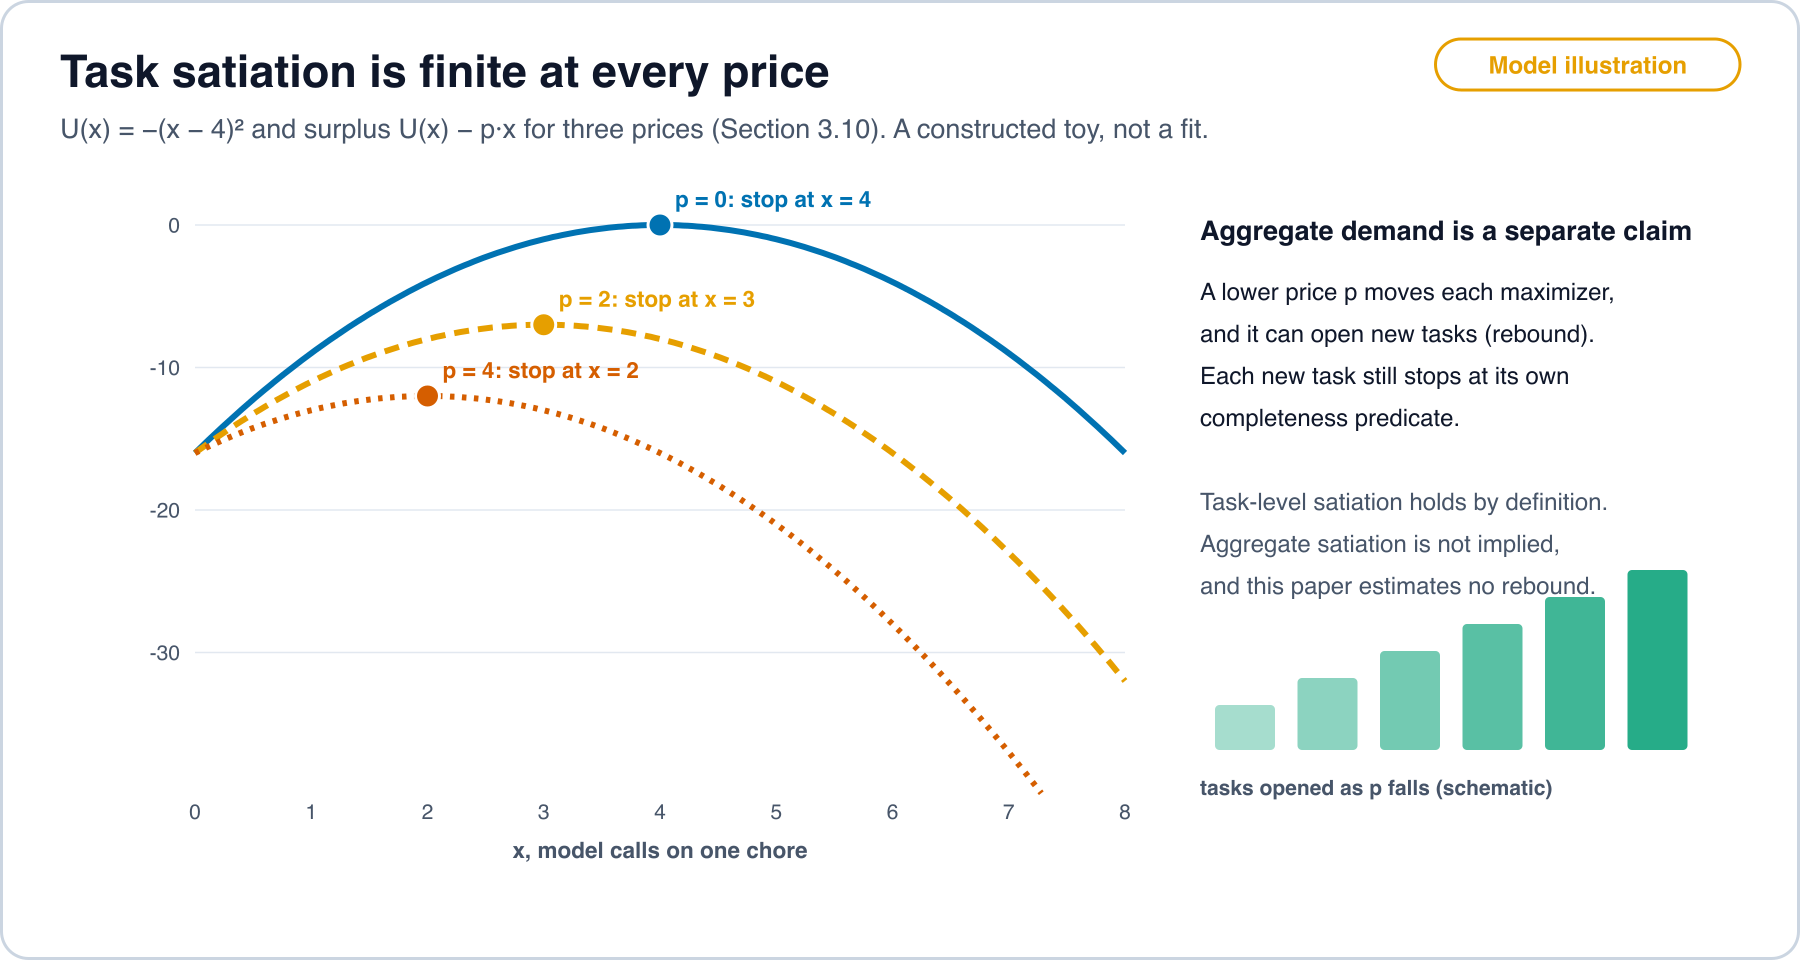
Eine Koordinate x sei die Anzahl der Modellaufrufe für eine einzelne Routineaufgabe, und es sei
U(x) = -(x - 4)^2für eine Routineaufgabe, deren konstruiertes Maximum bei vier Aufrufen liegt. Dann gilt U(0) = -16, U(4) = 0, U(8) = -16. Der Grenznutzen ist dU/dx = -2(x - 4), positiv vor 4, null bei 4 und negativ danach. Das Beispiel verwendet ganze Zahlen, damit der Vorzeichenwechsel ohne Anpassung sichtbar ist. Kein Datensatz wurde zur Wahl von 4 verwendet. Ersetzt man 4 durch eine andere ganze Zahl, verschiebt sich der Gipfel, die Definition ändert sich nicht. Eine Produktmetrik gleich x stuft x = 8 über x = 4 ein. Eine Produktmetrik gleich U tut das Umgekehrte. Behauptung S-3 ist diese Nichtidentität, hier in einer vollständig spezifizierten Spielzeugfunktion und in Abschnitt 3.4 in konstruierten Episoden. Keines von beiden ist eine Wohlfahrtsschätzung für ein Unternehmen.
Ein Tokenpreis lässt sich anfügen, ohne Einheiten zu verwechseln. Angenommen, ein Aufruf kostet p in Geld und der Käufer zahlt p * x, während der Wert U folgt. Der Näherungswert für die Käuferrente U(x) - p x hat für jedes p >= 0 weiterhin einen endlichen Maximierer. Ein Fall von p verschiebt den Maximierer, das ist die Rebound-Logik an diesem Spielzeug, und der Maximierer bleibt endlich. Das Spielzeug sagt nicht, wo der Maximierer für einen realen Käufer liegt. Es blockiert den Schluss, dass ein niedrigeres p das Maximum beseitigt.
Abbildung 1 zeichnet das Spielzeugmodell und die gesonderte Aussage zum Aggregat.
3.11 Begründungscodes als Partition, nicht als Wohlfahrtsfunktion
R sei die Menge der Ablehnungscodes in einer Spur. Man partitioniere R in R_econ = {policy, budget_exceeded} und R_phys = {lut_veto, energy_veto, cbf_veto}, passend zur Taxonomie des Schemas. Andere Codes müssen, falls sie später hinzukommen, schriftlich zugeordnet werden, bevor sie gezählt werden. Ein Intervall der Spur trägt nur dann zur ökonomischen Ablehnung nach dem Fertigsein bei, wenn C bereits 1 ist und der Code in R_econ liegt. Es trägt zur physikalischen Ablehnung bei, wenn der Code in R_phys liegt, unabhängig davon, ob C gleich 1 ist. Eine unsichere Aktion nach dem Fertigsein gehört zu beiden Geschichten und sollte in beiden Spalten gezählt werden, nicht gemittelt. Die irreversible Ablehnung der MCP-Demo ist ein physikalisches Beispiel: Energie- und Barrierecodes, 0 Aufrufe des Ausführenden. Sie ist kein Beispiel für R_econ. Eine künftige Episode mit policy nach einem gemergten Patch wäre das ökonomische Beispiel. Das Repository enthält diese Episode nicht. Die Partition legt fest, wie sie bewertet würde.
4. Evidenz
4.1 Behauptung S-1. Sättigung ist ein definiertes ökonomisches Objekt
Andersen (2001), https://doi.org/10.1007/PL00003852, und die Lehrbuchkonstruktion des Bliss-Punkts in Abschnitt 2.1 stützen S-1. Die Behauptung ist theoretisch. Sie ist keine gemessene Nutzenfunktion für irgendeine Nutzerpopulation in dieser Studie.
4.2 Behauptung S-2. Veröffentlichte Inferenzpreise fielen bei fester Leistung stark
Gestützt durch Epoch AI (2025) und Emberson und Roodman (2026), mit den Größenordnungen, die diese Notizen angeben (Abschnitt 2.5). Die Behauptung betrifft Preisindizes, die diese Autoren veröffentlichen. Sie behauptet nicht, dass die Rechnung jeder Organisation um das 13-Fache gefallen ist, und sie ist keine Behauptung über Watt.
4.3 Behauptung S-3. Engagement-Variablen sind nicht das Vollständigkeitsprädikat
Gestützt durch die Definitionen in Abschnitt 3.1 und durch die Beschreibung von Zielen der Verweildauer in der Aufmerksamkeitsliteratur (Wu; Überblick des Center for Humane Technology). Keine kausale Schätzung eines Wohlfahrtsverlusts wird beansprucht. Die logische Behauptung ist die Nichtidentität der Variablen: Die Tokenanzahl kann steigen, während C konstant bleibt. Die konstruierten Episoden in Abschnitt 3.4 veranschaulichen die Nichtidentität, sie sind keine Datensätze.
4.4 Behauptung S-4. Die Kurse der Fahrradmanie lösten sich von einer einfachen Fundamentalgeschichte
Gestützt durch Quinn (2019): Anstiege von über 200 Prozent und anschließende Rückgänge von über 75 Prozent bei Fahrradaktien von 1895 bis 1900, in den Tests dieses Papiers weder vollständig durch Fundamentaldaten noch durch eine einfache Risikoverschiebung erklärt. Die Behauptung endet dort. Sie quantifiziert keine Sättigung der Haushalte mit Fahrrädern.
4.5 Behauptung S-5. Der Smartphone-Besitz in den USA ist im zitierten Faktenblatt hoch
Die Lesung des Mobile-Faktenblatts von Pew im Projektarchiv ergibt einen Besitz von nahezu 91 Prozent für die Zeilen 2024 und 2025. Die in diesem Papier verwendete Behauptung ist eine Diffusion in dieser Größenordnung, unter der Bedingung, dass das aktuelle Blatt mit dem Archiv übereinstimmt. Sie ist eine Sättigungstatsache über Besitz, keine Schätzung eines Bliss-Punkts.
4.6 Behauptung S-6. Pflege wird im Rahmen von Baumol nicht als reines Softwaregut bepreist
Baumol (1967) liefert den Rahmen. Acemoglu und Restrepo (2019) liefern die Sprache der Aufgaben. Die Behauptung lautet, dass diese Rahmen kein Ende der Anforderungen der Pflege an Arbeit, Vertrauen oder Haftung implizieren, wenn Tokenpreise fallen. Die Behauptung ist keine Prognose der Gesundheitsausgaben.
4.7 Behauptung S-7. Eine Sell-Side-Notiz stellt Ausgaben dem Nutzen gegenüber infrage
Die in Abschnitt 2.6 genannte Seite von Goldman Sachs existiert und rahmt die Frage in ihrem Titel.
4.9 Behauptung S-9. Physikalisches Gesetz wird von Epoch nicht auf null bepreist
Landauer (1961) und Horowitz (2014) stützen eine dauerhafte Lücke zwischen einer idealen Löschschranke und der CMOS-Praxis. S-9 sagt nur, dass ein Zitat von Epoch ein Zitat von Landauer nicht aufhebt.
4.10 Gestaltungsregeln, als Gestaltung gekennzeichnet
Diese Regeln folgen, wenn man die Definitionen annimmt und ein Produkt will, das C optimiert statt Token. Sie sind keine Effekte.
Caufschreiben, bevor Modellkapazität hinzugefügt wird.- Einen Preisaufschlag für Synthese als vorübergehend behandeln, wenn Reihen nach Art von Epoch und offene Gewichte auf diese Routineaufgabe zutreffen.
- Modellierte oder simulierte Energie nicht als gemessene Energie beschreiben.
- Einen Detektor für
Cmit einer Fehlertabelle einer ungelabelten Vergrößerung des Modells vorziehen, sobald die Routineaufgabe das Produkt ist. - Vor jeder irreversiblen Aktion eine gesonderte physikalische Sicherheitsprüfung verlangen.
- Energie vor und nach dem Fertigsein getrennt berichten, wenn die Aufteilung existiert. Sie existiert noch nicht.
- Das Sättigungsprädikat nicht auf gegnerische oder militärische Wettläufe anwenden (Abschnitt 5.3).
- Ist das Ziel des Produkts Aufmerksamkeit, dies offen sagen. Die Vollständigkeitsbehauptungen gelten dann nicht.
K.-o.-Tests für eine Roadmap, ebenfalls Gestaltung: ein Plan, der unbegrenzten Appetit für eine Routineaufgabe mit kurzem C annimmt; ein Preis, der dauerhafte Knappheit der Synthese und keinen physikalischen oder haftungsbedingten Keil voraussetzt; eine Sicherheitsgeschichte, die nur eine Konfidenzzeichenkette verwendet; eine Behauptung „kostenlos“, die Joule streicht; eine Agentenschleife ohne C.
4.11 Was ein Ergebnis wäre und keines ist
Eine Tabelle der Raten von falschem Fertig und falschem Weiter. Eine Zeitreihe der Aufrufe nach t*. Eine Messgerätablesung der Energie für eine formulierte Arbeitslast. Eine strukturelle Rebound-Schätzung. Ein AGI-Preisaufschlag, geschätzt für eine gesättigte Routineaufgabe. Nichts davon erscheint unter den gestützten Behauptungen von Abschnitt 4.
4.12 Nichtidentität, formuliert als Vergleich von Zielen
x sei die Aufrufanzahl, s die Sitzungsdauer, J_pre und J_post die Energie vor und nach dem entschiedenen Fertigsein und C das Prädikat. Die folgenden Implikationen sind definitorisch.
| Beobachtung | Impliziert nicht |
|---|---|
x gestiegen | C gestiegen |
s gestiegen | Wohlfahrt gestiegen |
p gefallen (S-2) | J_post = 0 |
C = 1 | die Fehlerrate des Detektors ist bekannt |
| Besitz von Telefonen ist hoch (S-5) | der Grenzwert eines weiteren Modellaufrufs ist null |
| Kurse der Fahrradaktien boomten und brachen ein (S-4) | Haushalte erreichten einen Bliss-Punkt im Verkehr |
Die rechte Spalte ist die Liste der Schlüsse, die dieses Papier verweigert. Jede Beobachtung links ist entweder ein Zitat in Abschnitt 4 oder eine Variable in Abschnitt 3. Die Tabelle ist die Diskussion, verdichtet zu einer Prüfung. Ein Satz, der eine Behauptung der rechten Spalte aufstellt, hat die Evidenz verlassen.
5. Diskussion
5.1 Rebound: das zentrale Identifikationsproblem
Drei Ergebnisse begrenzen das natürliche Experiment. Gundlach und Kollegen (2025) finden, dass Preise bei fester Benchmarkleistung schnell fallen, Frontier-Preise dagegen nicht, und Du (2026) findet einen Strukturbruch und einen Reasoning-Aufschlag in der Preisentwicklung, sodass Preissenkungen gebündelt mit Modellwechseln eintreffen. Der Economic Index von Anthropic (September 2025) berichtet, dass über Aufgaben hinweg jeder Anstieg der Kosten um 1% mit einem Rückgang der Nutzungshäufigkeit um 0.29% einhergeht, eine unelastische Querschnittszahl, keine Preisänderung über die Zeit. Ein Design auf Anbieterebene kann keinen Rebound auf Marktebene identifizieren; das Design braucht Preise und Mengen auf Marktebene.
Gillingham, Rapson und Wagner geben einen Überblick über Rebound aus Politik zur Energieeffizienz. Der Mechanismus ist die verbleibende Nachfrageelastizität. Fällt der Geldpreis der Synthese, steigt die Nutzung dort, wo Käufer eine weitere Einheit noch schätzen. An einem Bliss-Punkt für eine abgeschlossene Routineaufgabe ist die direkte Ableitung des Werts nach mehr Synthese für diese Routineaufgabe nicht positiv, sodass direkter Rebound bei dieser Routineaufgabe nicht impliziert ist. Indirekter Rebound, neue Aufgaben und Verschiebungen der Aufmerksamkeit können bleiben. Der Rand neuer Aufgaben von Acemoglu und Restrepo ist ein Ort, an dem Menge wieder auftauchen kann. Behauptung S-2 impliziert deshalb keine globale Obergrenze für Rechenleistung. Sie impliziert eine Obergrenze nur relativ zu einem formulierten C. Globalen Rebound zu bestreiten, würde die Aufteilung aus Abschnitt 3.3 und ein Nachfragesystem erfordern. Dieses Papier bestreitet globalen Rebound nicht. Es weigert sich, „Jevons“ als Grund zu behandeln, C nicht aufzuschreiben.
Zwei Hypothesen machen die Frage prüfbar.
- H1. Ausgaben nach dem Abschluss. Der Anteil der Agentenrechenleistung, der nach
C(z) = 1ausgegeben wird, Joule oder Aufrufe mitt > t*im Verhältnis zu allen Joule oder Aufrufen der Episode, liegt messbar über null. H1 ist die direkte Verschwendung, die der Vollständigkeitshalt beseitigt. Sie lässt sich aus Agentenprotokollen mit einem gelabeltent*je Episode schätzen (Abschnitt 3.3, Punkt 1). - H2. Jevons bei Aufgaben. H2 ist die Elastizität des direkten Rebounds von Khazzoom (1980), formuliert für Aufgaben. Wenn der Preis der Synthese fällt, übersteigt die Elastizität der Anzahl ausgeführter Aufgaben den Rückgang der Ausgaben je Aufgabe. Dann steigen die Gesamtausgaben, obwohl jede Aufgabe gesättigt ist. H2 ist aggregierter Rebound.
Identifikation. H1 braucht keine Preisvariation: einen gelabelten Korpus, die Fehlerraten des Detektors aus Abschnitt 3.3 Punkt 2 und die aufgeteilte Bilanz. H2 braucht exogene Preisänderungen. Preissenkungen von Anbietern bei fester Modellqualität, an einem bekannten Datum angekündigt, sind natürliche Experimente. Das Design ist ein Panel von Konten mit gezahltem Preis, eröffneten Aufgaben, Aufrufen je Aufgabe und einem Vollständigkeitslabel je Episode, vor und nach jeder Senkung. Der Vergleich von Konten auf einem neu bepreisten Modell mit Konten auf Modellen, deren Preis sich nicht bewegte, ergibt eine Differenz-von-Differenzen-Schätzung der Elastizität der Aufgabenanzahl und der Reaktion der Ausgaben je Aufgabe, jeweils getrennt. Die Ausgaben je Aufgabe können fallen, während die Aufgabenanzahl steigt. Beide Zahlen werden gebraucht. Der Vollständigkeitshalt ist eine Behauptung über die erste. Jevons ist eine Behauptung über die zweite. Keine wurde hier geschätzt.
5.2 Status- und kreative Güter
Manche Güter werden geschätzt, weil sie nicht fertig sind: Status, offene Kunst, Forschung, deren C keine endliche Checkliste ist. Die Definition in Abschnitt 3.1 zwingt diesen Gütern keinen Bliss-Punkt auf. Sie erzwingt eine Segmentierung. Eine endliche Routineaufgabe und eine offene Praxis können vom selben Unternehmen verkauft werden und sollten keine Nachfrageannahme teilen. Eine endliche Routineaufgabe so zu bepreisen, als wäre sie ein offener Wettlauf um Fähigkeit, ist ein Kategorienfehler, kein Befund über AGI.
5.3 Gegnerische Nachfrage
Ist der Gewinn der anderen Partei der Verlust dieser Partei, ist „genug“ nicht durch eine lokale Checkliste definiert. Wettrüsten und manche Sicherheitswettbewerbe gehören zu dieser Klasse. Physikalische Commit-Beschränkungen können dennoch gelten: Eine unsichere Aktion kann abgelehnt werden, während die strategische Nachfrage offen bleibt. Der Umfang ist Teil der Behauptung, keine Fußnote, die sie aufhebt.
5.4 Unvollständiges Wissen über das Fertigsein
Menschen schätzen den Abschluss falsch ein. Detektoren werden falsches Fertig und falsches Weiter liefern. Das ist ein Argument dafür, Detektorfehler zu messen, die Abschnitt 3.3 als fehlend aufführt. Es ist kein Argument dafür, dass die Sitzungsdauer C in einem Bereich ersetzt, in dem eine versäumte Übergabe eine haftende Partei hat. Wo kein Prädikat aufgeschrieben werden kann, schweigt die operationale Behauptung dieses Papiers.
5.5 Baumol ist nicht gelöst
Ein Modell, das eine Notiz schneller entwirft, kann den Durchsatz an Notizen erhöhen und Untersuchung, Urteil und Verantwortung bei einer Person lassen. Ausgabenanteile können sich weiterhin so bewegen, wie Baumol es beschrieb, wenn das menschliche Residuum nicht schneller wird. Das Gegenteil zu sagen, wäre eine Prognose, die diese Bibliografie nicht enthält. Die zulässige Aussage ist S-6.
5.6 Kostenlose Synthese ist keine kostenlose Aktuierung
Ein fallender Geldpreis für Inferenz sagt nichts über die Energie, die nötig ist, um ein physikalisches System zu bewegen. Eine Masse aus der Ruhe um eine Geschwindigkeitsänderung zu bewegen, erfordert mindestens Joule an Arbeit, was immer der Preis der Anweisung ist, die sie befohlen hat. Die Preise von Epoch liegen auf einer anderen Achse als diese Arbeit. Sie zu „kostenloser KI“ zusammenzuziehen, streicht die Messklasse.
5.7 Konfidenz ist kein Zertifikat
Eine hohe Modellbewertung kann Vorschläge ordnen. Sie ist kein Vollständigkeitsprädikat: Eine Bewertung braucht eine Schwelle und eine Fehlertabelle (Raten falsch und richtig Positiver gegenüber einer gelabelten Menge), bevor sie über C entscheidet.
5.8 Sell-Side-Skepsis ist keine Messung
S-7 verhindert, dass eine Literaturübersicht einen bedeutenden öffentlichen Zweifel an Ausgaben und Nutzen übergeht. Sie erlaubt nicht, dass eine Research-Notiz ein Messgerät oder eine Nachfrageschätzung ersetzt. Werden die Zahlen der Notiz später zitiert, muss das primäre PDF die Quelle sein, und die Kennzeichnung ist Sell-Side-Schätzung.
5.9 Was eine strukturelle Nachfrageschätzung erfordern würde
S-2 ist eine Tatsache über den Angebotspreis aus sekundär veröffentlichten Reihen. Eine Nachfrageschätzung ist eine andere Regression. Mindestens braucht sie eine Menge (Aufrufe, abgeschlossene Aufgaben oder beides), einen Preis und eine Möglichkeit, eine Bewegung entlang einer Nachfragekurve von einer Verschiebung der Kurve zu trennen. Der Benchmarkpreis von Epoch ist keine Rechnung auf Unternehmensebene, und die Rechnung eines Unternehmens ist nicht C. Sie zu verknüpfen, erfordert ein Panel, das diese Studie nicht hat: Konten, die gezahlten Preis, getätigte Aufrufe und ein entschiedenes Vollständigkeitslabel für dieselbe Episode erfassen. Ohne dieses Panel ist die Steigung der Nachfrage nach t* nicht identifiziert. Die Spielzeugrente in Abschnitt 3.10 zeigt nur, dass ein quadratischer Bliss-Punkt ein endliches Optimum behält, wenn p fällt. Sie ist nicht die fehlende Regression.
Die Segmentierung gehört in dasselbe Design. Jedes Produkt vor dem Poolen als endliches C oder offen codieren. Einen Ticket-Desk mit einem offenen Forschungswerkzeug zu poolen, mittelt zwei Nachfrageregime und kann den Anschein unbegrenzten Appetits erzeugen. Der militärische Ausschluss in Abschnitt 5.3 ist dieselbe Regel, angewandt auf einen Bereich, in dem das Ziel des Gegners einen lokalen Bliss-Punkt verhindert. Eine Tabelle mit diesen Codes wäre, selbst noch ohne Preise, aussagekräftiger als eine einzelne Zahl für den gesamten adressierbaren Markt. Die Tabelle wurde nicht erstellt.
5.10 Warum kein Vielfaches von kT ln 2 angegeben wird
Landauers Ergebnis ist eine Ungleichung für ein idealisiertes Löschen bei der Temperatur T. Horowitz (2014) berichtet Energien für bestimmte CMOS-Operationen und für Speicherverkehr, in Pikojoule, unter den Annahmen jenes Tutorials. Die Division der einen durch die andere ergibt erst dann eine Zahl, wenn jemand die Operation, den Aktivitätsfaktor, die Temperatur und das Bauelement wählt. Keine dieser Wahlen wird in diesem Papier gemessen. Ein Vielfaches oberhalb der Landauer-Schranke anzugeben, würde vorgeben, dass diese Wahlen getroffen worden seien. Die wissenschaftliche Aussage ist die Richtung der Ungleichung: Praktische irreversible CMOS-Logik liegt in der Darstellung von Horowitz weit oberhalb der Schranke, und ein Preisindex bewegt ein Bauelement nicht auf die Schranke.
6. Grenzen und Gefährdungen der Validität
Konstruktvalidität. Operationale Sättigung hängt von C ab. Ein feindseliges oder vages C macht das Prädikat beliebig. Die Verteidigung des Papiers besteht darin, zu verlangen, dass C in beobachtbaren Klauseln aufgeschrieben wird. Viele reale Produkte haben diese Niederschrift noch nicht. Für diese Produkte gilt die Theorie empirisch noch nicht.
Interne Validität der Preisbehauptung. S-2 erbt die Identifikation, die Epoch verwendet hat (Qualitätsbereinigung, Wahl des Benchmarks, Listenpreise gegenüber tatsächlichen Rechnungen). Dieses Papier hat die Mikrodaten nicht geprüft. Eine Überarbeitung der Reihen von Epoch würde die Größenordnungen von S-2 ändern und die Richtung möglicherweise nicht. S-2 sollte mit den Primärseiten abgeglichen werden, bevor es als Kennzahl für die Geschäftsleitung verwendet wird.
Externe Validität. Arbeit und Pflege, wie definiert, schließen militärische Rivalität aus und schließen möglicherweise Forschung aus. Telefonbesitz überträgt sich nicht auf Agentenprodukte. Kurse von Fahrradaktien übertragen sich nicht auf Softwaremargen. Die konstruierten Episoden sind keine Stichprobe.
Messvalidität. Keine aufgeteilten Joule, keine Konfusionsmatrix des Detektors und kein Energiemessgerät an irgendeinem Gerät. Hardwarespezifikationen von Herstellern sind keine Energiemessungen.
Ausgelassene Variable. Neue Aufgaben können Ausgaben aufnehmen, die durch billige Synthese frei werden. Abschnitt 5.1 sagt das. Eine Roadmap, die Sättigung je Routineaufgabe als Prognose der aggregierten Nachfrage nach Rechenleistung behandelt, ist durch dieses Papier nicht gedeckt.
Publikationsverzerrung und Dokumenttyp. Wu ist ein Buch. Die Seite zu Humane Technology ist Interessenvertretung. Goldman Sachs ist Sell-Side. Quinn, Epoch, Baumol, Acemoglu und Restrepo, Landauer und Horowitz sind die tragenden Zitate, und sie stützen verschiedene Sätze. Die Struktur des Papiers ist ein Versuch, zu verhindern, dass diese Sätze zu einer Stimmung gemittelt werden.
Falsifikatoren. S-1 scheitert, wenn die zitierte Theorie keinen Bereich mit einem Grenznutzen von null enthält. Sie enthält ihn. S-2 scheitert, wenn die primären Seiten von Epoch keine Rückgänge dieser Art berichten. Ein künftiger gelabelter Korpus, in dem zusätzliche Aufrufe nach einem korrekten C einen unabhängig spezifizierten Wert systematisch erhöhen, würde die Sättigung für diesen Korpus falsifizieren. Ein solcher Korpus würde die Definition nicht falsifizieren. Er würde ihren Geltungsbereich begrenzen.
Hardwarespezifikationen von Herstellern nennen Kapazitäten, keine Schaltaktivität, keine statische Leistung und keine Energie einer Arbeitslast. Ein Energiebericht muss die Hardware, den Takt, die Arbeitslast, das Messgerät und die Dauer nennen.
7. Schluss
Sättigung ist in der zitierten Theorie ein Standardobjekt, und sie hat eine enge operationale Form: ein schriftliches Vollständigkeitsprädikat, das zusätzliche Synthese nicht voranbringt. Die veröffentlichten Reihen von Epoch dokumentieren einen starken Fall des Geldpreises der Inferenz bei fester Leistung. Dieser Fall stützt die Beschreibung digitaler Routineaufgaben als an der Grenze kostenlos und stützt weder kostenlose Joule noch kostenlose Anlagenbewegung noch das Ende der Kostenstruktur der Pflege. Kurse von Fahrradaktien, die Diffusion von Smartphones und Aufmerksamkeitsmärkte sind in den spezifischen Hinsichten schwächer und stärker, die Abschnitt 4 nennt. Die fehlenden wissenschaftlichen Objekte sind ein gelabelter Fertig-Detektor, eine Aufteilung der Energie vor und nach dem Fertigsein und eine Nachfrageschätzung, die Rebound sehen kann. Solange sie nicht existieren, ist der empirische Gehalt des Papiers der zitierte Bestand, und sein formaler Gehalt ist das Prädikat.
Literatur
Cover, T. M., and Thomas, J. A. Elements of Information Theory, 2nd ed. Wiley, 2006. https://doi.org/10.1002/047174882X
Hoffmann, J., et al. Training compute-optimal large language models. arXiv:2203.15556.
Kaplan, J., et al. Scaling laws for neural language models. arXiv:2001.08361.
Shannon, C. E. Coding theorems for a discrete source with a fidelity criterion. IRE National Convention Record, 1959.
Acemoglu, D., and Restrepo, P. Automation and new tasks: how technology displaces and reinstates labor. Journal of Economic Perspectives 33(2), 2019. https://www.aeaweb.org/articles?id=10.1257/jep.33.2.3
Ames, A. D., et al. Control barrier functions: theory and applications. ECC 2019. https://doi.org/10.23919/ECC.2019.8796030
Andersen, E. S. Satiation in an evolutionary model of structural economic dynamics. Journal of Evolutionary Economics, 2001. https://doi.org/10.1007/PL00003852
Baumol, W. J. Macroeconomics of unbalanced growth: the anatomy of urban crisis. American Economic Review 57, 415-426, 1967.
Bennett, C. H. Logical reversibility of computation. IBM Journal of Research and Development, 1973. https://doi.org/10.1147/rd.176.0525
Center for Humane Technology. The attention economy. https://www.humanetech.com/youth/the-attention-economy
Emberson, L., and Roodman, D. / Epoch AI. The plunging price of thought. 22 September 2026. https://epoch.ai/publications/the-plunging-price-of-thought
Epoch AI. LLM inference price trends. 12 March 2025. https://epoch.ai/data-insights/llm-inference-price-trends
Gillingham, K., Rapson, D., and Wagner, G. The rebound effect and energy efficiency policy. Review of Environmental Economics and Policy 10(1), 68-88, 2016. https://doi.org/10.1093/reep/rev017 Working text: https://gwagner.com/wp-content/uploads/Gillingham-Rapson-Wagner-2015-Rebound-Effect.pdf
Alcott, B. Jevons’ paradox. Ecological Economics 54(1), 9-21, 2005. https://doi.org/10.1016/j.ecolecon.2005.03.020
Anthropic. How we built our multi-agent research system. 13 June 2025. https://www.anthropic.com/engineering/multi-agent-research-system
Jevons, W. S. The Coal Question. London: Macmillan, 1865.
Keynes, J. M. Economic possibilities for our grandchildren. 1930. Reprinted in Essays in Persuasion, 1931.
Nordhaus, W. D. Two centuries of productivity growth in computing. Journal of Economic History 67(1), 128-159, 2007. https://doi.org/10.1017/S0022050707000058
Goldman Sachs. Gen AI: too much spend, too little benefit? https://www.goldmansachs.com/insights/top-of-mind/gen-ai-too-much-spend-too-little-benefit
Horowitz, M. Computing’s energy problem (and what we can do about it). ISSCC 2014. https://doi.org/10.1109/ISSCC.2014.6757323
Landauer, R. Irreversibility and heat generation in the computing process. IBM Journal of Research and Development, 1961. https://doi.org/10.1147/rd.53.0183
Laya. System One models and typed decision engines (comparison table, checked 2 October 2026). https://laya-ai.com/system-one-models
Convai Innovations. Laya model card. https://huggingface.co/convaiinnovations/laya
TypeSafe AI. Introducing System One Models and Jev. 15 September 2026. https://typesafe.ai/blog/introducing-system-one-models-and-jev
Ma, S., et al. The era of 1-bit LLMs. arXiv:2402.17764.
Pew Research Center. Mobile fact sheet. https://www.pewresearch.org/internet/fact-sheet/mobile/
Quinn, W. Technological revolutions and speculative finance: evidence from the British Bicycle Mania. Cambridge Journal of Economics 43(2), 271-294, 2019. https://doi.org/10.1093/cje/bey029
Wei, J., et al. T-MAC. arXiv:2407.00088.
Wu, T. The Attention Merchants. Knopf. https://www.penguinrandomhouse.com/books/234876/the-attention-merchants-by-tim-wu/
Chung, J.-W., Wu, R., Ma, J. J., and Chowdhury, M. Where Do the Joules Go? Diagnosing Inference Energy Consumption. arXiv:2601.22076. https://arxiv.org/abs/2601.22076
Energy use of AI inference, efficiency pathways, and test-time scaling. Joule, 2026. https://www.cell.com/joule/fulltext/S2542-4351(26)00114-5
Luccioni, A. S., Strubell, E., and Crawford, K. From efficiency gains to rebound effects: the problem of Jevons’ Paradox in AI’s polarized environmental debate. FAccT 2025. https://doi.org/10.1145/3715275.3732007
Ostrovsky, N. / Epoch AI. What you need to know about AI energy use. Updated 14 July 2026. https://epoch.ai/publications/ai-energy
Anthropic. Anthropic Economic Index report: uneven geographic and enterprise AI adoption. September 2025. https://www.anthropic.com/research/anthropic-economic-index-september-2025-report
Bai, L., Huang, Z., Wang, X., et al. How do AI agents spend your money? Analyzing and predicting token consumption in agentic coding. arXiv:2604.22750, 2026. https://arxiv.org/abs/2604.22750
Brockway, P. E., Sorrell, S., Semieniuk, G., Heun, M. K., and Court, V. Energy efficiency and economy-wide rebound effects: a review of the evidence and its implications. Renewable and Sustainable Energy Reviews 141, 110781, 2021. https://doi.org/10.1016/j.rser.2021.110781
Brookes, L. The greenhouse effect: the fallacies in the energy efficiency solution. Energy Policy 18(2), 199-201, 1990. https://doi.org/10.1016/0301-4215(90)90145-T
Chen, X., Xu, J., Liang, T., et al. Do NOT think that much for 2+3=? On the overthinking of o1-like LLMs. arXiv:2412.21187, 2024. https://arxiv.org/abs/2412.21187
Cuadron, A., Li, D., Ma, W., et al. The danger of overthinking: examining the reasoning-action dilemma in agentic tasks. arXiv:2502.08235, 2025. https://arxiv.org/abs/2502.08235
Du, M. Tiered super-Moore’s law: price evolution, production frontiers, and market competition in large language models. arXiv:2603.28576, 2026. https://arxiv.org/abs/2603.28576
Fouquet, R., and Pearson, P. J. G. Seven centuries of energy services: the price and use of light in the United Kingdom (1300-2000). The Energy Journal 27(1), 2006. https://doi.org/10.5547/ISSN0195-6574-EJ-Vol27-No1-8
Gundlach, H., Lynch, J., Mertens, M., et al. The price of progress: price performance and the future of AI. arXiv:2511.23455, 2025. https://arxiv.org/abs/2511.23455
Khazzoom, J. D. Economic implications of mandated efficiency in standards for household appliances. The Energy Journal 1(4), 1980. https://doi.org/10.5547/ISSN0195-6574-EJ-Vol1-No4-2
Masanet, E., Shehabi, A., Lei, N., Smith, S., and Koomey, J. Recalibrating global data center energy-use estimates. Science 367(6481), 984-986, 2020. https://doi.org/10.1126/science.aba3758
Saunders, H. D. The Khazzoom-Brookes postulate and neoclassical growth. The Energy Journal 13(4), 1992. https://doi.org/10.5547/ISSN0195-6574-EJ-Vol13-No4-7
Sorrell, S., and Dimitropoulos, J. The rebound effect: microeconomic definitions, limitations and extensions. Ecological Economics 65(3), 636-649, 2008. https://doi.org/10.1016/j.ecolecon.2007.08.013
Tsao, J. Y., Saunders, H. D., Creighton, J. R., Coltrin, M. E., and Simmons, J. A. Solid-state lighting: an energy-economics perspective. Journal of Physics D: Applied Physics 43(35), 354001, 2010. https://doi.org/10.1088/0022-3727/43/35/354001
Witt, U. Learning to consume: a theory of wants and the growth of demand. Journal of Evolutionary Economics 11(1), 23-36, 2001. https://doi.org/10.1007/PL00003851
Anhang A. Entscheidungsregeln und Nichtergebnisse
| Id | Aussage | Klasse |
|---|---|---|
| R1 | Das Vollständigkeitsprädikat aufschreiben, bevor Kapazität hinzugefügt wird. | Gestaltung |
| R2 | Erwarten, dass Preisaufschläge für Synthese dort erodieren, wo Evidenz nach Art von Epoch gilt. | Gestaltung, unter der Bedingung von S-2 |
| R3 | Keine kostenlose Energie und keine kostenlose Aktuierung behaupten. | Beschränkung aus S-9 |
| R4 | Ökonomische Haltegründe von physikalischen Haltegründen trennen. | Gestaltung |
| R5 | Fehlerraten des Detektors veröffentlichen, bevor ein Halt als genau behandelt wird. | Noch kein Ergebnis |
| R6 | Energie vor und nach dem Fertigsein aufteilen. | Noch kein Ergebnis |
| R7 | Gegnerische Wettläufe außerhalb der Sättigungsbehauptung halten. | Umfang |
| R8 | Die Primärquellen von Pew und Epoch erneut lesen, bevor eine feinere Größenordnung zitiert wird. | Methode |
Anhang C. Karte der Behauptungen
Jetzt gestützt: S-1 bis S-9, mit den Sätzen zum Umfang in Abschnitt 4.
Nicht gestützt: ein Ende der Baumolschen Kostenkrankheit; kostenlose Anlagenbewegung; Sättigung militärischer Nachfrage; ein numerischer globaler Rebound von null; Betrieb eines Sprachmodells im Landauer-Maßstab; Platinen-Watt; ein AGI-Preis als Tatsache über gesättigte Routineaufgaben; eine universelle Verzögerung der Destillation; Führerschaft bei der Siliziumleistung.
Offene Messungen: Abschnitt 3.3.