Die Lücke zwischen Möglichem und Eingesetztem: ein Taktmodell der Computerintelligenz und die Erzwingungsfunktion von Automatisierungswerkzeugen
Methoden, die die Kosten von Computerintelligenz senken, sind Jahre öffentlich, bevor die meisten Produkte sie nutzen. Dieser Artikel misst die Lücke anhand datierter Quellen, modelliert, wie Berichts- und Finanzierungskalender einen Teil davon festlegen, prüft, welcher Anteil der Infrastrukturausgaben ein geschlossener Kreislauf ist, modelliert die Kosten einer Aufgabe und nennt die Daten, die das Modell widerlegen würden.
David Charlot, Open Interface Engineering
Dies ist eine Übersetzung der englischen Fassung. Bei Abweichungen gilt die englische Fassung. Englisches Original.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Die Lücke zwischen Möglichem und Eingesetztem: ein Taktmodell der Computerintelligenz und die Erzwingungsfunktion von Automatisierungswerkzeugen. Open Interface Engineering. Web: https://research.openie.dev/papers/latency/. PDF: https://research.openie.dev/pdfs/latency.pdf.
18. Oktober 2026. Die Quellen sind datiert und in der Literatur nach Beweisklasse sortiert. Die Propositionen sind von Hand abgeleitet und wurden nicht von einem Beweisassistenten geprüft, und keine der Zahlen in Abschnitt 7 ist eine Messgröße. Als Modellausgabe gekennzeichnete Größen sind aus zitierten Zahlen berechnet und keine Beobachtungen.
Zusammenfassung
Neue Methoden, Computerintelligenz kostengünstiger zu betreiben, werden offen veröffentlicht und erreichen die meisten Produkte erst nach einer Verzögerung. Dieser Artikel definiert diese Verzögerung als messbare Größe, zerlegt sie in einen technischen, einen kalendarischen und einen anreizbedingten Teil und modelliert, wie ein Werkzeug, das die Kosten der Automatisierung senkt, verändert, wofür ein Anbieter gewinnbringend Geld verlangen kann. Anschließend ordnet er die Verzögerung in den gegenwärtigen Ausbau der Infrastruktur ein. Er legt dar, was öffentliche Pflichtmeldungen über Geldflüsse zwischen Laboren, Clouds und Chipherstellern belegen, formuliert einen Test, der einen geschlossenen Kreislauf von externer Nachfrage unterscheidet, baut ein Kostenmodell in Dollar und Joule pro Aufgabe, vergleicht offene Softwaremethoden und alternative Hardware mit dem etablierten Stack und kartiert, wo Fähigkeit, Rechenleistung und Strom angesiedelt sind. Die Propositionen sind von Hand abgeleitet, und jede Vorhersage nennt die Daten, die sie widerlegen würden.
In einfachen Worten
- Offene Methoden, die Computerintelligenz billiger machen, erreichen dieselben Ergebnisse auf älteren und billigeren Maschinen, und die Wartezeit zwischen einer veröffentlichten Methode und einem ausgelieferten Produkt ist bei manchen Methoden kürzer als bei anderen.
- Der größte Teil dessen, was eine Aufgabe kostet, ist der Preis der Maschinen und nicht der Strom, und die von Nutzern gezahlten Preise sind weit schneller gefallen als die Hardwarekosten. Das Geld hinter den Maschinen umfasst Kreisläufe zwischen einigen Laboren, Clouds und Chipherstellern, die Pflichtmeldungen belegen, und es umfasst auch Geld aus anderen Geschäften und von Kunden außerhalb dieser Kreisläufe. Abschnitt 10 gibt einen Test an, der beides mit Daten trennt.
- Ein Teil der Wartezeit kommt von Kalendern, weil Unternehmen in Quartals- und Jahresschritten entscheiden. Wenn ein Werkzeug die Arbeit billig genug macht, lohnt sich das Warten für den Anbieter nicht mehr, und was dann noch berechnet werden kann, sind die Kosten des Wechsels und nicht die Kosten des Rechnens.
Notation
| Begriff | Bedeutung in diesem Artikel |
|---|---|
| Aufgabe | Eine Einheit nützlicher Arbeit mit einer angegebenen Qualitätsschwelle , zum Beispiel eine korrekte Antwort oder eine geprüfte Schätzung. |
| Joule pro Aufgabe, | Gemessene Energie in Joule, um eine Aufgabe mit einer Qualität von mindestens zu erledigen. Hier die Rechnungseinheit für Computerintelligenz. |
| Kosten pro Aufgabe, | Geldkosten einer Aufgabe: , wobei der Preis eines Joule ist und die Hardware- und Betriebskosten, die nicht mit sinken. |
| Fähigkeitsgrenze, | Die niedrigsten Kosten pro Aufgabe, die mit irgendeiner bis zum Zeitpunkt öffentlich dokumentierten Methode erreichbar sind. |
| Einsatzgrenze, | Die niedrigsten Kosten pro Aufgabe, die bis zum Zeitpunkt in einem allgemein verfügbaren Produkt angeboten werden. |
| Latenz, | Bei einem Kostenniveau die Zeit zwischen dem Erreichen von durch die Fähigkeitsgrenze und dem Erreichen von durch die Einsatzgrenze. Definiert in Abschnitt 0. |
| Berichtsperiode, | Der Abstand der Entscheidungstermine in einem Unternehmen, das Ergebnisse berichtet, etwa ein Quartal. |
| Wechselreibung, | Die Kosten pro Aufgabe, die ein Käufer trägt, um zu einem anderen Anbieter zu wechseln: Integration, Datenübertragung, Umschulung, Vertragsbedingungen, Standardeinstellungen. |
| Übernahmekosten, | Einmalige Kosten, um ein Angebot um eine neue Methode herum neu aufzubauen. |
| Beschleunigerzeit pro Aufgabe, | Genutzte Beschleunigerstunden, die eine Aufgabe bei einer Qualität von mindestens belegt. Abschnitt 12. |
| Kapitalbelasteter Preis eines Joule, | Strompreis plus Kapital pro genutzter Stunde, geteilt durch die Leistung der Anlage. Abschnitt 12. |
| Schranke des Kreislaufanteils, | Obere Schranke für den Anteil am Umsatz eines Lieferanten, den sein eigenes bereitgestelltes Kapital hätte finanzieren können. Abschnitt 10. |
| Tolerierter Rückgang, | Der größte Rückgang der berichteten Ergebnisse in einer Periode, den ein Unternehmen hinnimmt, in denselben Einheiten wie . |
0. Definitionen und Geltungsbereich
Sei die niedrigsten Kosten pro Aufgabe, die zum Zeitpunkt mit irgendeiner öffentlich dokumentierten Methode bei Qualität erreichbar sind. Sie ist nicht steigend, weil Dokumentation nicht zurückgezogen wird. Sei die niedrigsten Kosten pro Aufgabe, die zum Zeitpunkt in einem allgemein verfügbaren Produkt angeboten werden. Sie ist aus demselben Grund nicht steigend, solange ein Anbieter kein Angebot zurückzieht, und es gilt konstruktionsbedingt . Für ein Kostenniveau schreibe und .
Definition 1 (Latenz). . Die Frage des Artikels ist, wie groß ist, was es festlegt und was es verschiebt.
Definition 2 (technischer, kalendarischer und anreizbedingter Teil). Für ein Unternehmen wird die Latenz zerlegt als . Dabei ist die technische Reifeverzögerung: die Zeit, die Ingenieure brauchen, um die Methode zu portieren, zu testen und zu härten. Der Term ist die Kalenderwartezeit: die Zeit zwischen der Reife und dem nächsten Termin, an dem das Unternehmen Freigabeentscheidungen trifft. Der Term ist die Anreizverzögerung: die Zeit, in der eine Freigabe einen positiven langfristigen Wert hat, aber eine Berichts- oder Finanzierungsregel sie blockiert. Die künstliche Latenz ist . Das Wort wird in einem engen Sinn verwendet: Es ist der Teil, der nicht durch Ingenieurszeit erklärt wird, und es ist keine Aussage über irgendjemandes Motiv.
Geltungsbereich. Der Artikel behandelt Methoden, die die Kosten von Computerintelligenz verändern: Modellarchitekturen, Zahlenformate, Kernels, Compiler, statistische Inferenzverfahren und Energiemessung. Er behandelt auch die Infrastruktur, auf der sie laufen: die Flüsse von Kapital- und Rechenzusagen zwischen Laboren, Clouds und Chipherstellern, die Kosten einer Beschleunigerstunde, offene Methoden und alternative Hardware, die die Beschleunigerzeit pro Aufgabe verändern, und wo Fähigkeit, Rechenleistung und Strom angesiedelt sind. Er prognostiziert kein Unternehmen, keinen Preis und keinen Anteil. Energie pro Aufgabe in Joule ist die Metrik, wo eine Joule-Angabe existiert. Wo eine Quelle nur Dollar oder Sekunden berichtet, wird die Dollar- oder Sekundenangabe verwendet und als solche gekennzeichnet.
1. Arten von Belegen
Jede Quelle in diesem Artikel ist einer von drei Klassen zugeordnet, und die Klasse ist in der Literatur angegeben.
- In der Quelle durch Beweis begründet. Die Quelle enthält ein Theorem oder eine analytische Herleitung mit ihrem Beweis. Ein Beweis in einem Artikel ist der Beweis des Autors, kein maschinell geprüfter, und der Artikel nennt ihn nicht mehr als das. Gerichtsakten und statistische Veröffentlichungen werden als nachgewiesen eingeordnet, weil sie datierte Tatsachen berichten und keine Herleitungen.
- Nachgewiesen. Die Quelle berichtet eine Messung, Erhebung, ein Experiment oder eine datierte Veröffentlichung mit angegebener Methode. Das Ergebnis gilt für diesen Rahmen und lässt sich möglicherweise nicht übertragen.
- Meinung. Die Quelle ist eine Prognose, eine Herstelleraussage ohne Daten, ein Erfahrungsbericht aus der Praxis oder eine Übersicht, die andere Arbeiten zusammenfasst. Übersichten werden hier eingeordnet, weil der Artikel ihnen nicht entnehmen kann, was gemessen wurde.
Zahlen werden so zitiert, wie die Quelle sie angibt, mit dem eigenen Rahmen und den Vorbehalten der Quelle. Wo eine Größe aus zitierten Zahlen abgeleitet ist, nennt der Text sie Modellausgabe und zeigt die Rechnung oder nennt das Skript, das sie berechnet. Ankündigungen von Plänen, Zielen und beabsichtigten Investitionen werden als Meinung eingeordnet, weil sie eine Absicht und kein Ergebnis angeben, und Meldungen an die Aufsichtsbehörde werden als nachgewiesen eingeordnet. Jede Quelle wurde im Volltext abgerufen, und jede zitierte Zahl wurde in diesem Text aufgefunden. Quellen auf Deutsch, Französisch, Spanisch, Portugiesisch, Italienisch, Koreanisch, Japanisch und Chinesisch wurden in der Originalsprache gelesen, und ihre Zahlen werden unverändert auf Englisch wiedergegeben.
2. Was 2024 bis 2026 möglich wurde
Die folgende Liste ist nach dem Hebel geordnet, an dem jede Methode bei den Kosten pro Aufgabe ansetzt. Jede Zeile nennt das Datum der frühesten öffentlichen Veröffentlichung, die Aussage, wie die Autoren sie berichten, und die Klasse.
Tabelle 1. Methoden, die verändern, was eine Aufgabe kostet.
| Hebel | Methode und Aussage | Veröffentlicht | Klasse |
|---|---|---|---|
| Architektur | Selektive Zustandsraummodelle und Attention-Varianten sind über strukturierte semiseparable Matrizen dual, und die resultierende Schicht wird als 2 bis 8 Mal schneller als der frühere Scan berichtet [38]. | 31. Mai 2024 | in der Quelle durch Beweis begründet |
| Architektur | Hybride Modelle aus Zustandsraum und Attention wurden 2024 und 2025 von mehreren Gruppen mit offenen Gewichten veröffentlicht [39]. | 2024 bis 2025 | nachgewiesen |
| Zahlenformat | Ternäre Gewichte erreichen in den Experimenten der Autoren ab etwa 3 Milliarden Parametern die Perplexität und die Endaufgabenwerte von 16-Bit, bei geringerer Latenz, weniger Speicher und weniger Energie [40]. | 27. Feb. 2024 | nachgewiesen |
| Zahlenformat | Stabiles 4-Bit-Vortraining eines hybriden Modells mit 12 Milliarden Parametern auf 10 Billionen Token, vergleichbar mit 8-Bit-Ergebnissen, berichtet vom Hardwarehersteller [41]. | Sep. 2025 | nachgewiesen |
| Kernels | Ein Attention-Kernel erreicht auf einer Beschleunigergeneration bis zu 75% des 16-Bit-Spitzendurchsatzes, gegenüber 35% bei seinem Vorgänger [42]. | Jul. 2024 | nachgewiesen |
| Sparsität | Hardwaregerechte, nativ trainierbare sparse Attention mit berichteten Beschleunigungen bei 64 Tausend Token Kontext [43]. | Feb. 2025 | nachgewiesen |
| Dekodierung | Spekulatives Dekodieren lässt die Ausgabeverteilung unverändert und wurde bei einem großen Übersetzungsmodell als 2 bis 3 Mal schneller gemessen [23]. | 30. Nov. 2022 | in der Quelle durch Beweis begründet |
| Skalierung | Wenn der Inferenzbedarf über die gesamte Lebensdauer mitgezählt wird, ist das kostenoptimale Modell kleiner und auf mehr Token trainiert, als die reine Trainingsregel ergibt [44, 45]. | Jan. 2024 | nachgewiesen |
| Trainingskosten | Ein Modell im Maßstab der Spitzenklasse mit berichteten 2.788 Millionen Beschleunigerstunden für das vollständige Training, mit latenter Attention und 8-Bit-Training [46]. | 26. Dez. 2024 | nachgewiesen |
| Konforme Inferenz | Verteilungsfreie Überdeckung bei endlichen Stichproben für jeden Prädiktor, mit in einem Buch gesammelten Beweisen [47]; eine im Oktober 2024 erstmals veröffentlichte und 2025 erschienene Übersicht behandelt strukturierte, unstrukturierte und dynamische Daten [48]. | 18. Nov. 2024 | in der Quelle durch Beweis begründet |
| Inferenz mit Vorhersagen | Gültige Intervalle aus einer kleinen gelabelten Menge und vielen maschinellen Vorhersagen, für jeden Prädiktor [49]. | 2023 | in der Quelle durch Beweis begründet |
| Sequenzielle Inferenz | E-Prozesse und Konfidenzfolgen, die gültig bleiben, wenn ein Test zu einem beliebigen Zeitpunkt abgebrochen wird [50]. | Nov. 2023 | in der Quelle durch Beweis begründet |
| Kausale Schätzung | Entzerrtes maschinelles Lernen liefert gültige Inferenz über einen Zielparameter mit flexiblen Störmodellen, erweitert auf identifizierbare Effekte jenseits der Hintertür-Adjustierung [51, 52]. | 2018; 2021 | in der Quelle durch Beweis begründet |
| Compiler | Compilerdurchläufe für automatische Differentiation höherer Ordnung berichten bis zum 1.3-Fachen bei Operatoren zweiter Ordnung, vorläufig [53]; ein Methodenartikel von 2026 stellt fest, dass kompiliertes JAX die Effizienz von Stan auf moderner Hardware weit übertrifft, ohne Benchmarkzahlen in seiner Zusammenfassung [54]. | 2025 | nachgewiesen |
| Probabilistische Programmierung | Ein Compiler, der die probabilistische Semantik bewahrt, berichtet auf Standardbenchmarks im geometrischen Mittel das 6.4-Fache gegenüber Stan und das 53-Fache gegenüber Turing [55]. | 2025 bis 2026 | nachgewiesen |
| Energiemessung | Ein offener Benchmark misst die Inferenzenergie über 40 Architekturen und berichtet Pareto-Konfigurationen für Zeit und Energie mit Einsparungen von über 40% in einigen Fällen [56]; ein Anbieter berichtet 0.24 Wattstunden für einen medianen Text-Prompt im Produktivbetrieb [57]. | 2025 | nachgewiesen |
Zwei Raten bilden den Hintergrund. Die Rechenleistung, die nötig ist, um einen festen Wert eines Sprachmodells zu erreichen, hat sich etwa alle 8 Monate halbiert, mit einem 95%-Intervall von etwa 5 bis 14 Monaten [58]. Der Preis, ein festes Benchmarkniveau zu erreichen, fiel über sechs Benchmarks hinweg um das 9- bis 900-Fache pro Jahr, im Median etwa um das 50-Fache, wobei die schnellsten Raten auf weniger als einem Jahr an Daten beruhen [59]. Beide sind Änderungsraten der Fähigkeitsgrenze oder eines Preises, und keine misst den Abstand zum Einsatz.
Für die Tabelle gelten zwei Einschränkungen. Mehrere Zeilen sind Beschleunigungen gegenüber einer von den Autoren gewählten Basislinie, sodass sich die Zahlen über Zeilen hinweg weder addieren noch vergleichen lassen. Und “möglich” bedeutet in diesen Zeilen von den Autoren in einem angegebenen Rahmen nachgewiesen, nicht in einem Produkt verfügbar.
3. Wie die Lücke in Daten aussieht
Langfristige Diffusion. Über 15 Technologien und 166 Länder von 1820 bis 2003 betrug der durchschnittliche Abstand zwischen Erfindung und Übernahme in einem Land etwa 45 Jahre, und die Abstände schrumpften im Lauf des Zeitraums [60]. Dieselbe Geschichte enthält eine Warnung, was Übernahme bedeutet. Elektromotoren steigerten die Produktivität von Fabriken erst, nachdem die Werke um einen Motor pro Maschine herum neu gestaltet wurden, eine Veränderung, die Jahrzehnte dauerte [61]. Ein späteres Modell führt den Rückgang und Anstieg der gemessenen Produktivität auf ungemessene komplementäre Investitionen in Prozesse und Fähigkeiten zurück [62]. In beiden Darstellungen ist die Verzögerung überwiegend der Aufwand, sich um das Werkzeug herum neu zu organisieren, was in der obigen Notation ist.
Von der offenen Veröffentlichung zur Verbraucherhardware. Bei Modellen, die auf eine einzelne Verbrauchergrafikkarte passen, lag der durchschnittliche Rückstand hinter dem insgesamt besten Modell 2025 über vier Maße hinweg bei 6 bis 12 Monaten, mit dem größten Rückstand, 12.4 Monaten, bei einem Präferenzwert [63]. Eine breitere Analyse von Modellen mit offenen Gewichten jeder Größe fand etwa ein Jahr, mit einer Spanne von 5 bis 22 Monaten je nach Benchmark, und eine spätere indexbasierte Analyse setzte den Durchschnitt bei nahe 3 Monaten an [64]. Diese Zahlen messen den Abstand zwischen zwei öffentlichen Grenzen. Sie sind untere Schranken für einen Rückstand bis zu Produkten, denn ein offenes Modell auf einer Karte ist noch kein Produkt, für dessen Betreuung jemand bezahlt wird.
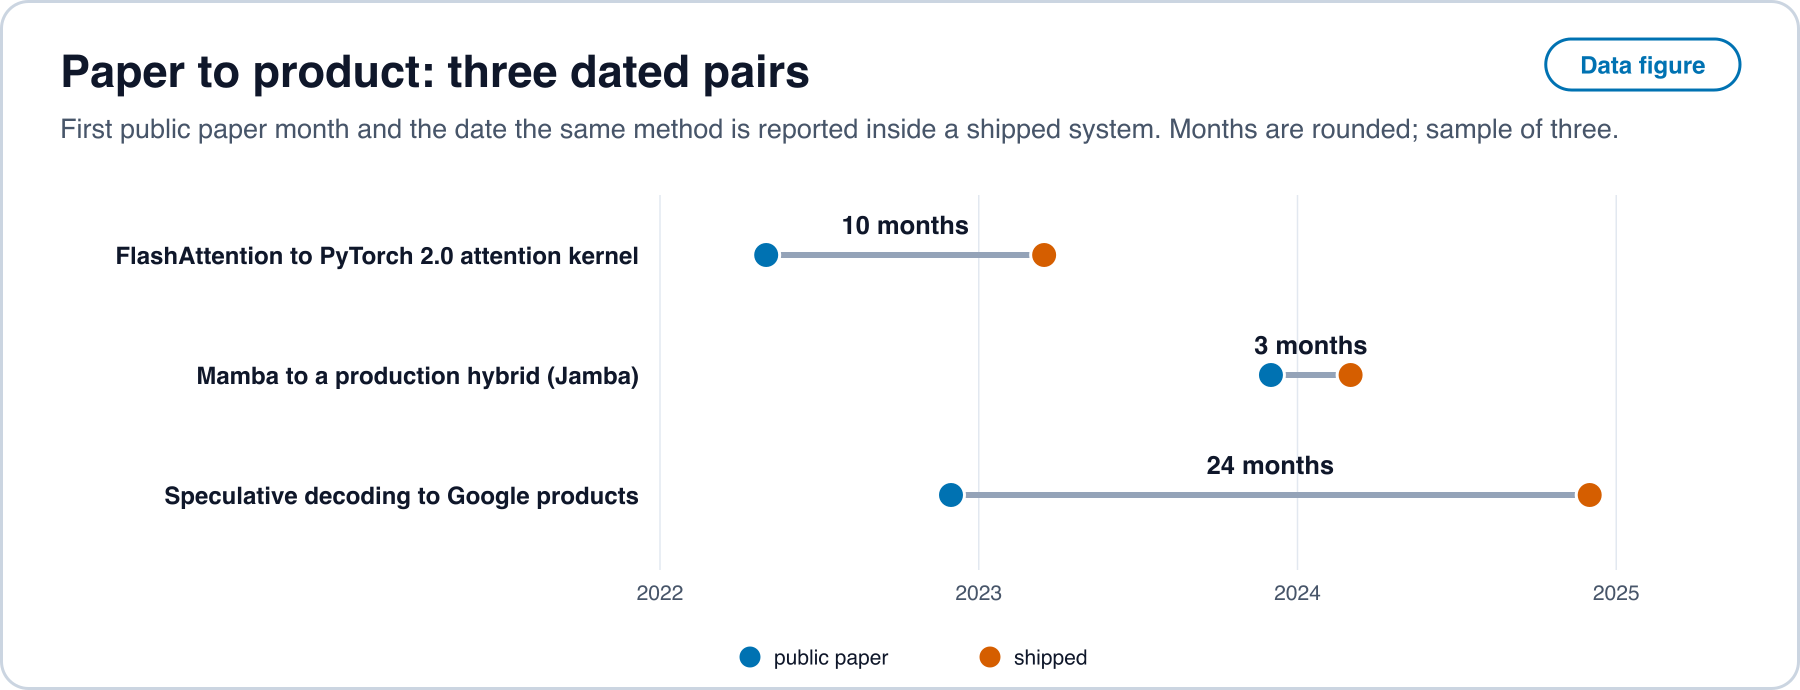
Vom Artikel zum Produkt. Spekulatives Dekodieren wurde im November 2022 veröffentlicht. Der Arbeitgeber seiner Autoren berichtete bis Dezember 2024, es in Produkten einzusetzen [24]. Ein Praxisbericht aus demselben Monat sagt, dass der Produktiveinsatz zusätzliche Arbeit an Batching, Qualität und Zuverlässigkeit erforderte und vor allem bei begrenzten Batchgrößen hilft [65]. Zwei weitere Paare stehen in Abschnitt 13. Einige datierte Paare sind keine Verteilung, und das Protokoll in Abschnitt 16 legt fest, wie viele gesammelt werden. Ein längerfristiges Maß für den Abstand zwischen Artikel und Patent findet, dass die auf der Titelseite eines Patents zitierten Artikel im Durchschnitt 14.4 Jahre älter sind als das Patent und 16.6 Jahre, wenn Zitate im Text mitgezählt werden [66], und verknüpfte Patente und Artikel liegen typischerweise zwei bis vier Zitationsschritte auseinander [67]. Diese Zahlen gelten für die Wissenschaft allgemein und betreffen nicht speziell das maschinelle Lernen.
Praxis der 4-Bit-Modelle. Praxisberichte datieren den Zeitpunkt, ab dem lokale 4-Bit-Inferenz auf Verbrauchermaschinen praktikabel wurde, auf 2023 [68]. Die Berichte sind erzählend, daher ist dies ein Beleg der Klasse Meinung für ein Datum und keine Messung.
Übernahme in Unternehmen. Die Ergänzungserhebung 2026 des United States Census Bureau ergab, dass von November 2025 bis Januar 2026 18% der Unternehmen KI in einer Geschäftsfunktion nutzten, 22% dies innerhalb von sechs Monaten erwarteten und 57% der Nutzer sie in drei oder weniger Funktionen einsetzten [34]. In der Europäischen Union nutzten 2025 20.0% der Unternehmen mit 10 oder mehr Beschäftigten mindestens eine KI-Technologie, 6.5 Punkte mehr als 2024, mit 55.0% der großen, 30.4% der mittleren und 17.0% der kleinen Unternehmen [33]. Die OECD berichtet für 2024 eine Übernahme von 13.9% sowie 39% der großen gegenüber 12% der kleinen Unternehmen [35]. Chinesische Einstellungsdaten zeigen Ende 2025 Einstellungen für generative KI bei 21% der börsennotierten Unternehmen gegenüber 0.2% der nicht börsennotierten [69]. Fragewortlaut und Stichprobenrahmen unterscheiden sich je nach Quelle, und die Census-Frage wurde im November 2025 überarbeitet, daher sind die Raten über die Zeilen hinweg nicht vergleichbar.
Amtliche Statistiken in den Originalsprachen. Das Statistische Bundesamt berichtet, dass 2024 20% der Unternehmen mit 10 oder mehr Beschäftigten KI nutzten, gegenüber 12% 2023 und 11% 2021, mit 48% der großen, 28% der mittleren und 17% der kleinen Unternehmen, und nennt fehlendes Wissen und rechtliche Unsicherheit als häufigste Gründe für die Nichtnutzung [70]. Seine Tabelle für 2025 nennt 26% insgesamt und 57% für Unternehmen mit mehr als 250 Beschäftigten, bei einer geänderten Unternehmensdefinition [31]. Insee berichtet für 2024, dass 10% der Unternehmen in Frankreich KI nutzten, vier Punkte mehr als 2023, 33% der Unternehmen mit 250 oder mehr Beschäftigten, und 42% in Information und Kommunikation gegenüber 5% oder weniger in Verkehr, Beherbergung und Gastronomie sowie Bau [37]. Das spanische Instituto Nacional de Estadística berichtet, dass im ersten Quartal 2025 21.1% der Unternehmen mit 10 oder mehr Beschäftigten KI nutzten, 8.7 Punkte mehr als ein Jahr zuvor [32]. Das brasilianische Cetic.br berichtet, dass 2024 13% der Unternehmen KI nutzten, derselbe Anteil wie 2023, konzentriert auf große Unternehmen und auf Information und Kommunikation [36]. Koreanische Ministeriumsstatistiken, wie in der koreanischen Presse berichtet, nennen für 2024 32.9% der Unternehmen, die KI-Technologie oder KI-Dienste nutzen, gegenüber 30.3% 2023, und 66.9% für Unternehmen mit 250 oder mehr Beschäftigten [30]. Das japanische Weißbuch befragte Beschäftigte in vier Ländern und fand irgendeine geschäftliche Nutzung generativer KI bei 55.2% in Japan, 90.6% in den Vereinigten Staaten, 90.3% in Deutschland und 95.8% in China. Unter japanischen Unternehmen hatten 2024 49.7% eine Richtlinie zur aktiven oder eingeschränkten Nutzung, gegenüber 42.7% ein Jahr zuvor, und die häufigste japanische Sorge, mit 30.1%, war, nicht zu wissen, wie man sie wirksam einsetzt, gegenüber 9.7% in den Vereinigten Staaten und 10.4% in China [71]. Das chinesische CNNIC zählt im Juni 2025 515 Millionen Nutzer generativer KI, 266 Millionen mehr als im Dezember 2024, eine Durchdringung von 36.5% [72]. Dies sind Messungen der Nutzung, nicht der Freigabe. Innerhalb jedes Landes steigt die Rate mit der Unternehmensgröße, was damit vereinbar ist, dass feste Übernahmekosten bei einem großen Budget weniger ins Gewicht fallen, auch wenn die Erhebungen das nicht von anderen Ursachen trennen können.
Nutzung auf der Ebene von Menschen und Aufgaben. Fast 40% der Erwachsenen in den Vereinigten Staaten im Alter von 18 bis 64 Jahren nutzten Ende 2024 generative KI, und etwa 23% der Beschäftigten hatten sie in der Vorwoche bei der Arbeit genutzt [73]. Eine Feldstudie mit 5,179 Kundendienstmitarbeitern fand im Durchschnitt 14% mehr Lösungen pro Stunde und 34% mehr bei unerfahrenen und gering qualifizierten Beschäftigten [74]. Eine randomisierte Studie mit 16 erfahrenen Entwicklern und 246 Aufgaben fand, dass Aufgaben, bei denen KI erlaubt war, in diesem Rahmen 19% länger dauerten [75]. Diese Ergebnisse unterscheiden sich, weil sich Aufgaben, Menschen und Werkzeuge unterscheiden. Sie zeigen, dass der Einsatz kein einzelnes Ereignis ist, weshalb über Angebote und nicht über Nutzung definiert ist.
Was die Forschung selbst bremst. Der Forschungsaufwand ist gestiegen, während die Forschungsproduktivität in den meisten Sektoren gesunken ist, und das Fortführen der Verdopplung der Chipdichte erforderte mehr als das 18-Fache der Forscher der frühen 1970er Jahre [76]. Das betrifft , nicht , und wird angemerkt, damit der Artikel die Fähigkeitsgrenze nicht als kostenlos liest.
4. Kalender: Berichts- und Finanzierungsperioden
Entscheidungstermine in börsennotierten Unternehmen folgen dem Berichtskalender. In einer Befragung von 401 Finanzvorständen würden 78% wirtschaftlichen Wert aufgeben, um die berichteten Ergebnisse zu glätten, und 55% würden den Start eines Projekts mit sehr positivem Kapitalwert vermeiden, wenn es bedeutete, den Konsens des Quartals zu verfehlen [77]. Vergleichbare börsennotierte Unternehmen investieren weniger und reagieren schwächer auf Investitionsgelegenheiten als private Unternehmen [78]. All dies ist für frühere Technologien und Zeiträume nachgewiesen, und nichts davon ist eine Messung von KI-Freigaben.
Aufmerksamkeit folgt demselben Kalender. Die Zahl der Ergebnis-Telefonkonferenzen großer Unternehmen in den Vereinigten Staaten, in denen “AI” genannt wurde, erreichte im dritten Quartal 2025 306, gegenüber einem Zehnjahresdurchschnitt von 86 [79]. Die Sprache von Ergebnis-Telefonkonferenzen wurde bereits als Messinstrument für andere Themen verwendet, validiert gegen manuelles Lesen [80], und dasselbe Instrument lässt sich auf Freigabethemen richten.
Finanzierung folgt einem längeren Kalender. Ein Risikokapitalfonds hat eine begrenzte Laufzeit, typischerweise zehn Jahre, und Gesellschaften legen alle drei bis fünf Jahre neue Fonds auf [81]. Gesellschaftsverträge legen begrenzte Laufzeiten fest, meist zehn Jahre [82]. Die beiden Kalender unterscheiden sich in der Länge, etwa ein Quartal und drei bis fünf Jahre, und beide quantisieren, wann eine Zusage gemacht werden kann. Proposition 1 unten nutzt nur diese Struktur.
5. Kontrolle und Reaktion etablierter Anbieter
Zwei ältere Ergebnisse rahmen den Anreiz zum Einsatz. Arrows Analyse findet den Anreiz zu erfinden unter einem Monopol, also bei Marktzutrittsschranken, kleiner als unter Wettbewerb, und zählt ein vorübergehendes Monopol, das den Zutritt nicht versperrt, als nahezu wettbewerblich [83]. Eine spätere Übersicht der Literatur zu Wettbewerb und Innovation stellt fest, dass Präemptionsanreize eine Kraft sind, die in einfachen statischen Modellen fehlt [84]. Etablierte Anbieter übersehen auch Veränderungen, die bekannte Komponenten neu anordnen, weil ihre Routinen filtern, was sie wahrnehmen [85]. Keines davon ist eine Aussage über irgendein heutiges Unternehmen.
Kontrolle über den Vertrieb ist in öffentlichen Gerichtsakten dokumentiert. Im September 2025 untersagte ein Bezirksgericht der Vereinigten Staaten exklusive Vertriebsverträge für mehrere Such- und Assistenzprodukte, erlaubte nicht exklusive Zahlungen für Standardeinstellungen mit Laufzeiten, die in der Regel auf ein Jahr begrenzt sind, und ordnete Abhilfen zur Datenweitergabe und Syndizierung an [86]. Der Artikel nutzt die Akte nur als Beleg dafür, dass Standardeinstellungen und Vertriebsbedingungen bepreist und reguliert sind, was der Parameter in Abschnitt 6 darstellt.
6. Das Modell
Rahmen. Eine Käuferpopulation mit der Nachfrage pro Periode für eine Aufgabe zum Preis . Ein etablierter Anbieter bedient sie zu Kosten mit einer bestehenden Methode. Eine öffentliche Methode wird für jeden zu Kosten verfügbar, nicht steigend in der Zeit. Ein Käufer kann bei einer Reibung pro Aufgabe zu einem Anbieter wechseln, der die öffentliche Methode nutzt, sodass die Preisobergrenze des etablierten Anbieters ist. Der etablierte Anbieter kann zu einmaligen Kosten ein auf der öffentlichen Methode aufgebautes Angebot freigeben. Entscheidungen werden nur zu den Terminen getroffen.
Annahmen.
- A1. Lineare Nachfrage , mit .
- A2. Die öffentlichen Kosten sinken: ist nicht steigend und stetig mit , und .
- A3. Die Obergrenze bindet den Preis des etablierten Anbieters, das heißt für die Kosten , denen er gegenübersteht. Das gilt für die Zahlen in Abschnitt 7.
- A4. Der etablierte Anbieter maximiert den mit der Rate diskontierten Gewinn unter einer Berichtsregel: Ein Anteil von wird in der Freigabeperiode als Aufwand verbucht, und die berichteten Ergebnisse der Freigabeperiode dürfen das Niveau vor der Freigabe um nicht mehr als unterschreiten.
- A5. Nach der Freigabe sind die Kosten des etablierten Anbieters , die Kosten der öffentlichen Methode.
- A6. Laufende Gewinne aus der Freigabe werden nach dem Freigabedatum als konstant behandelt (Näherung im stationären Zustand).
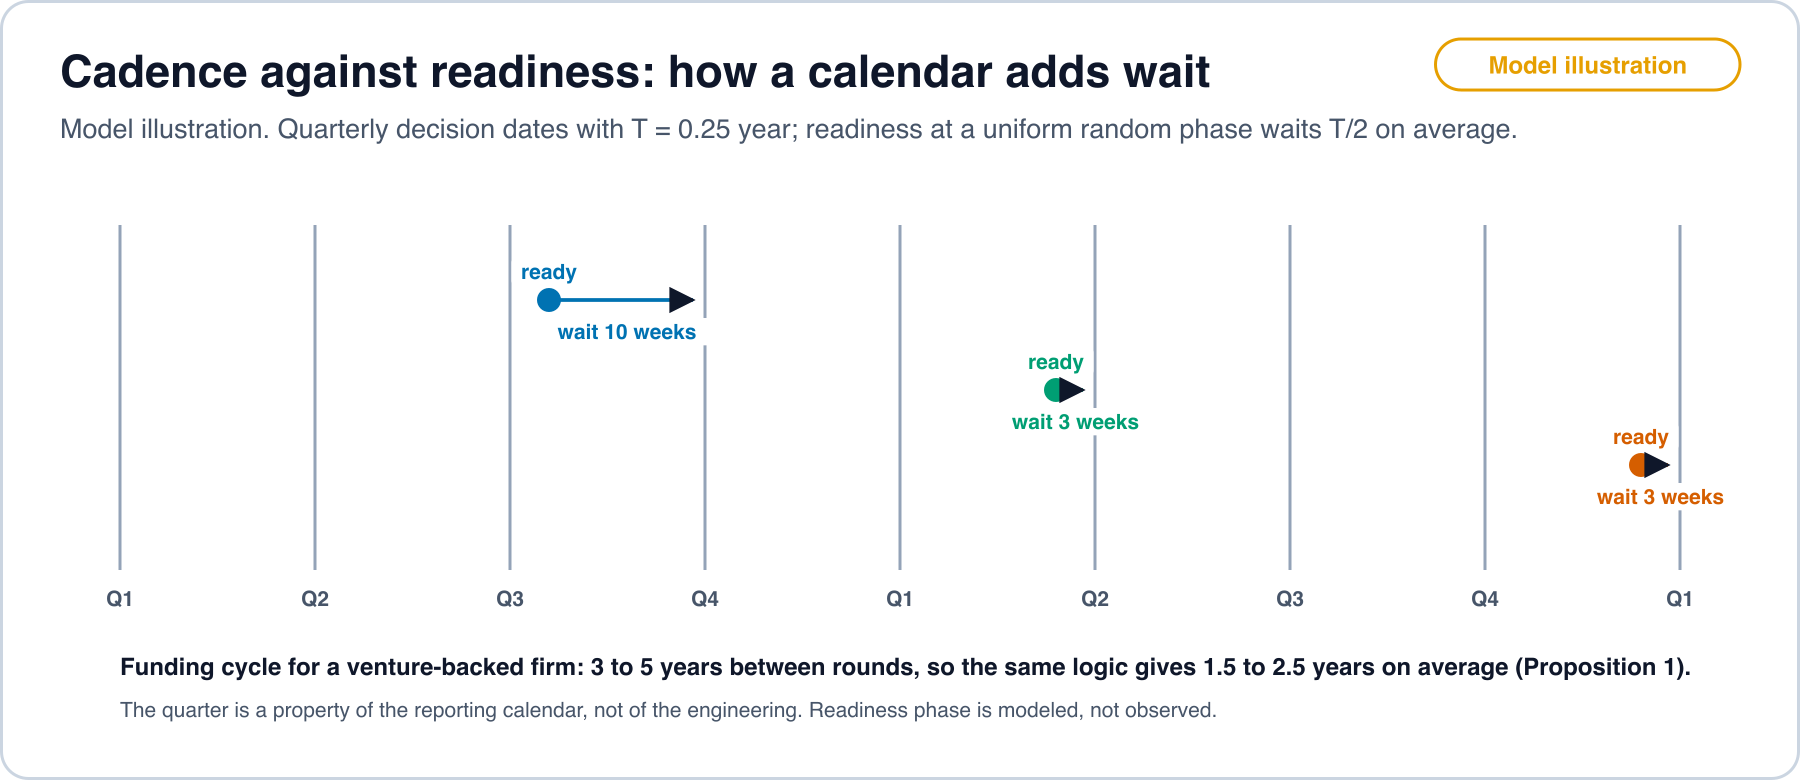
Proposition 1 (Kalenderquantisierung). Wird eine Methode zum Zeitpunkt reif und gibt das Unternehmen sie am ersten Entscheidungstermin zu oder nach frei, an dem sich die Freigabe lohnt, so beträgt die Wartezeit . Ist gleichverteilt auf , dann gilt und .
Herleitung. Schreibe mit gleichverteilt auf . Für ist der nächste Termin und die Wartezeit , die auf gleichverteilt ist. Eine auf einem Intervall der Länge gleichverteilte Variable hat den Mittelwert und die Varianz . Der Fall hat die Wahrscheinlichkeit null.
Folgerung. Ein Unternehmen, das nach einem Quartalskalender entscheidet, fügt der Reifeverzögerung im Mittel etwa 6 Wochen hinzu, und eines, das nach einem Finanzierungszyklus von 3 bis 5 Jahren entscheidet, 1.5 bis 2.5 Jahre, ohne technische Ursache. Die Annahme, dass die Reife innerhalb einer Periode gleichverteilt ist, ist der schwache Teil, und Vorhersage 1 prüft die Umkehrung.
Proposition 2 (Freigabeschwelle und erzwungene Freigabe). Definiere den laufenden Gewinn für die externen Kosten . Auf ist in streng fallend. Ohne Kalender- oder Berichtsbeschränkungen ist die Freigabe genau dann optimal, wenn , das heißt wenn , wobei die eindeutige Lösung von ist, sofern sie existiert. Ist , bringt das Festhalten keinen Gewinn, und die Freigabe wird dem Festhalten vorgezogen. Eine Berichtsregel kann sie verzögern, aber das Festhalten nicht gewinnbringend machen.
Herleitung. Unter A3 setzt der etablierte Anbieter, der bei Kosten festhält, den Preis an der Obergrenze an, sodass sein Gewinn ist. Nach der Freigabe sind seine Kosten und sein Gewinn . Die Differenz ist . Ableiten ergibt auf dem angegebenen Bereich, also ist streng fallend. Mit A6 ist der Wert der Freigabe , der genau dann nicht negativ ist, wenn . Festhalten ergibt den Gewinn , der bei , also bei , null ist und darunter negativ. Eine Freigabe an diesem Punkt ergibt nach A1 den Gewinn .
Proposition 3 (Berichtstor, Verzögerung und ein Bereich ohne Freigabe). Unter A4 ist die Änderung der berichteten Ergebnisse in der Freigabeperiode . Die Freigabe ist zulässig, wenn dies mindestens ist, das heißt wenn . Definiere und . Dann gilt , das Freigabedatum verschiebt sich von zu oder zum Punkt der erzwungenen Freigabe , je nachdem, was früher liegt, und für beträgt die Verzögerung , wenn . Ist , wobei die Kostenuntergrenze ist, findet unter den NPV- und Torbedingungen nie eine Freigabe statt, und nur die erzwungene Freigabe bei greift, falls .
Herleitung. Die berichteten Ergebnisse in der Freigabeperiode gewinnen an operativem Gewinn und verlieren den als Aufwand verbuchten Teil der Übernahmekosten. Die Forderung, dass der Saldo mindestens beträgt, ergibt die angegebene Ungleichung. Da streng fallend ist (Proposition 2), entspricht der größere von zwei geforderten Gewinnen der kleineren Kostenschwelle, also gilt . Mit ist die Zeit bis zum Erreichen von gleich , und die Differenz zweier solcher Zeiten ist die angegebene Verzögerung. Der erreichbare Gewinn ist höchstens , weil nach A2 gilt.
Proposition 4 (Erzwingungsfunktion). Angenommen, ein Automatisierungswerkzeug senkt die Übernahmekosten von auf . (a) Die NPV-Schwelle steigt, sodass die Freigabe früher optimal ist. (b) Ist , bindet das Berichtstor nicht, , und . (c) Die Gesamtlatenz des Unternehmens sinkt auf , wobei die technische Reifeverzögerung mit dem Werkzeug ist.
Herleitung. (a) und ist streng fallend, also senkt ein kleineres den geforderten Gewinn und erhöht . (b) Die Torbedingung ist für jedes erfüllt, wenn die rechte Seite nicht positiv ist, also bei . Dann gilt . (c) Folgt aus Definition 2 und Proposition 3.
Lesart. Ein Werkzeug wirkt auf zwei getrennte Weisen als Erzwingungsfunktion. Es senkt und beseitigt so die Torverzögerung, sobald unter fällt. Und es senkt für jeden Anbieter, was die Freigabe bei erzwingt, wo Festhalten nichts einbringt. Das Erste ist eine Eigenschaft des übernehmenden Unternehmens, das Zweite eine Eigenschaft des Marktes.
Proposition 5 (die Marktlatenz wird vom am wenigsten eingeschränkten Unternehmen bestimmt). Ist über die Unternehmen, die an die Käuferpopulation verkaufen können, dann gilt .
Herleitung. , und hängt nicht von ab. Subtrahieren ergibt das Ergebnis.
Folgerung. Ein Kalender oder Tor, das ein Unternehmen verzögert, verzögert den Markt nicht, wenn ein anderes Unternehmen dieselben Käufer ohne diese Verzögerung erreichen kann. Die in einem Markt beobachtete Latenz ist dann die Latenz des schnellsten Unternehmens, das Zugang hat. Wo der Zugang beschränkt ist, weil Käufer andere Anbieter nicht erreichen können, wird das Minimum über eine kleinere Menge gebildet. Im Modell ist das die Rolle von .
Proposition 6 (was noch berechnet werden kann). Nach der Freigabe, bei bindender Obergrenze, ist der Preis , der Gewinn und die Marge pro Aufgabe , unabhängig von . Der Preis ändert sich eins zu eins mit den Kosten, während das Verhältnis von Preis zu Kosten steigt, wenn die Kosten fallen. Der Grenzwert der Reibung ist , der für positiv ist und mit fallendem zunimmt.
Herleitung. Unter A3 verlangt der etablierte Anbieter die Obergrenze . Bei Kosten ist die Marge und die Menge , was ergibt. Das Verhältnis folgt aus . Ableiten von nach ergibt , und .
Lesart. Wenn die Kosten des Rechnens fallen, schrumpft der Teil des Preises, der das Rechnen widerspiegelt, und die verbleibende Marge hängt davon ab, wie kostspielig es für einen Käufer ist zu gehen. Ausgaben, die erhöhen, werden wertvoller. Im Modell ist das eine Aussage über Anreize und kein Urteil über irgendein Unternehmen. Maßnahmen, die senken, etwa Begrenzungen bei Standardbedingungen oder portable Datenformate, senken die Marge um denselben Betrag, und das Modell sagt nicht, ob das wünschenswert ist.
7. Eine numerische Illustration, keine Anpassung
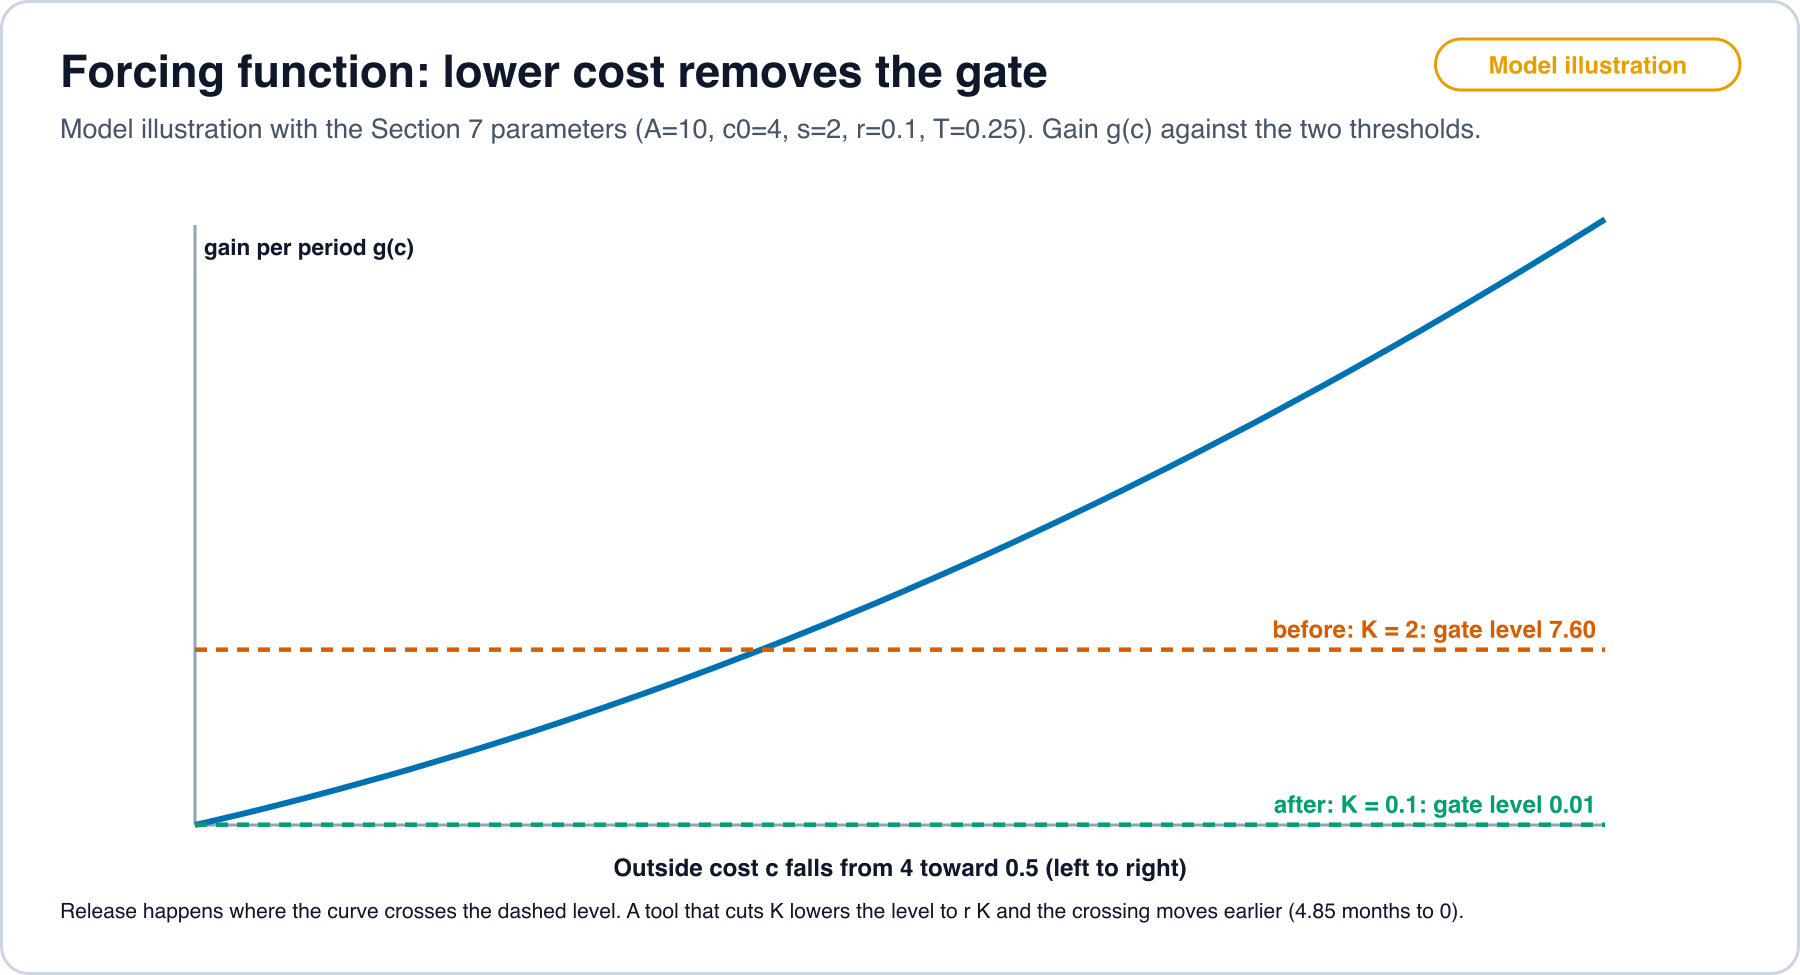
Das Skript model_check.py im Arbeitsordner reproduziert diese Zahlen mit der Standardbibliothek. Parameter: , , , pro Jahr, Jahr, , , und externe Kosten, die sich alle 8 Monate halbieren, sodass . Die 8-Monats-Rate greift [58] auf und ist eine Wahl zur Illustration, keine Schätzung der Kosten.
Tabelle 2. Freigabedatum mit und ohne ein Werkzeug, das die Übernahmekosten senkt.
| Fall | NPV-Schwelle | Torschwelle | Freigabe bei | Torverzögerung | |
|---|---|---|---|---|---|
| Vor dem Werkzeug | 2.0 | , Tag 4 | Monat 5.00 | 4.85 Monate | |
| Werkzeug senkt die Übernahmekosten | 0.1 | Tag 0.2 | 0 |
In der ersten Zeile verlangt das Tor einen Gewinn von , weit über der NPV-Anforderung , sodass der Anteil der Anreizverzögerung 4.85 Monate beträgt. Das ist länger als der Kalenderterm aus Proposition 1 für ein Unternehmen mit Quartalsberichten, der im Mittel 1.5 Monate beträgt. In der zweiten Zeile gilt , sodass das Tor nicht bindet und nur die NPV-Bedingung bleibt, wie in Proposition 4(b).
model_check.py und Tabelle 2. Open full sizeTabelle 3. Nach der Freigabe, mit .
| Preis | Gewinn | |||
|---|---|---|---|---|
| 4.0 | 6.00 | 1.50 | 8.00 | 2.00 |
| 3.0 | 5.00 | 1.67 | 10.00 | 3.00 |
| 2.0 | 4.00 | 2.00 | 12.00 | 4.00 |
| 1.0 | 3.00 | 3.00 | 14.00 | 5.00 |
| 0.5 | 2.50 | 5.00 | 15.00 | 5.50 |
Der Gewinn steigt mit fallenden Kosten, weil die lineare Nachfrage die Menge wachsen lässt. Bei gesättigter Nachfrage würde die Gewinnspalte abflachen, und die Aussage, dass die Marge bei bleibt, würde sich nicht ändern. Eine Simulation von Proposition 1 mit und gleichverteilter Reife ergibt eine mittlere Wartezeit von 0.1250 gegenüber und eine Varianz von 0.00521 gegenüber (200,000 Ziehungen, Seed 7).
8. Vorhersagen und was sie widerlegen würde
Jede Vorhersage nennt die Daten, den Test und das Ergebnis, das gegen das Modell sprechen würde. Die Vorhersagen sind formuliert, bevor irgendwelche Daten erhoben wurden.
Vorhersage 1 (Kalenderhäufung). Die Termine, an denen Unternehmen mit Quartalsberichten zuvor offene Methoden allgemein verfügbar machen, sind innerhalb des Quartals nicht gleichverteilt. Test: Für eine Stichprobe von mindestens 200 Freigaben börsennotierter Unternehmen wird die Phase jedes Termins innerhalb des Geschäftsquartals des Unternehmens berechnet, und Rayleigh- und Kuiper-Tests gegen Gleichverteilung werden angewendet. Widerlegt, wenn die Nullhypothese gleichverteilter Phase bei 200 oder mehr unabhängigen Einträgen auf dem 5%-Niveau nicht verworfen wird.
Vorhersage 2 (börsennotiert gegen nicht börsennotiert). Für dieselbe Methode und vergleichbare Schwierigkeit ist die mediane Verzögerung von der offenen Veröffentlichung bis zu einem allgemein verfügbaren Produkt bei börsennotierten Unternehmen länger als bei Unternehmen, die außerhalb eines Berichtskalenders finanziert werden. Test: nach Methode gebildete Paare, mit dem Unternehmenstyp als Behandlung und Hazard-Ratios für die Zeit bis zur Freigabe. Widerlegt, wenn das 95%-Intervall der Hazard-Ratio (börsennotiert zu nicht börsennotiert) vollständig über 0.8 liegt.
Vorhersage 3 (Werkzeuge senken das Tor). Nachdem ein Automatisierungswerkzeug, das die Portierungskosten senkt, für ein Hardware- oder Softwareziel verfügbar wird, sinkt die Zeit von der offenen Veröffentlichung bis zur allgemeinen Verfügbarkeit auf diesem Ziel. Test: Differenz-von-Differenzen mit Zielen, die vom Werkzeug bedient werden und nicht bedient werden, mit der Freigabeverzögerung in Tagen als Ergebnisgröße. Widerlegt, wenn das 95%-Intervall der geschätzten Veränderung vollständig über Tagen liegt. Die Marge von 30 Tagen ist eine vor der Datenerhebung getroffene Protokollentscheidung.
Vorhersage 4 (der Preis läuft den Kosten davon). Wo Joule- und Hardwarekosten pro Aufgabe gemessen werden, steigt das Verhältnis von Listenpreis zu Kosten pro Aufgabe, wenn die gemessenen Kosten fallen. Test: Panel von Diensten mit einer angegebenen Aufgabe, unter Nutzung offener Energiemessungen und Listenpreise. Widerlegt, wenn das Verhältnis bei mehr als der Hälfte der Aufgaben über einen Zeitraum, in dem die Kosten um den Faktor 2 oder mehr fielen, gleich bleibt oder fällt.
Vorhersage 5 (Ausgaben verlagern sich auf Reibung). In einem Markt, in dem die Kosten pro Aufgabe fallen, steigt der Anteil des Anbieterumsatzes, der für Vertrieb, Standardeinstellungen und Bündelung ausgegeben wird. Test: offengelegte Vertriebszahlungen und Bündelungsbedingungen in Pflichtmeldungen und Gerichtsakten im Verhältnis zum Umsatz. Widerlegt, wenn der Anteil gleich bleibt oder fällt, während die Kosten pro Aufgabe um den Faktor 2 oder mehr fallen.
Vorhersage 6 (die Marktlatenz folgt dem schnellsten Unternehmen). In Märkten, in denen Käufer bei geringer Reibung mehr als einen Anbieter erreichen können, liegt die Marktlatenz nahe an der minimalen Unternehmenslatenz, und in Märkten mit hoher gemessener Reibung näher am Median. Test: Regression der Marktlatenz auf die gemessene Wechselreibung. Widerlegt, wenn das 95%-Intervall der Steigung bezüglich der Reibung vollständig bei oder unter null liegt.
Vorhersagen zur Finanzierung und zu den Kosten des Ausbaus. Die Vorhersagen in den Abschnitten 10 und 12 betreffen die Geldflüsse und die Kosten einer Beschleunigerstunde. Sie sind in diesen Abschnitten formuliert und werden an Pflichtmeldungen und Preislisten geprüft, die nach diesem Artikel datiert sind.
Was das Modell selbst widerlegen würde. Ein Befund, dass die Freigabetermine börsennotierter Unternehmen innerhalb des Quartals gleichverteilt sind (Vorhersage 1), dass börsennotierte und nicht börsennotierte Unternehmen im selben Tempo freigeben (Vorhersage 2) und dass das Aufkommen von Portierungswerkzeugen die Verzögerung nicht verändert (Vorhersage 3), ließe Kalendern und Berichtstoren keine Rolle, und die künstliche Latenz aus Definition 2 wäre in der Messung null. Das Modell würde sich dann auf die technische Verzögerung reduzieren.
9. Der Geldkreislauf: was die Pflichtmeldungen belegen
Eine verbreitete Beschreibung des gegenwärtigen Ausbaus ist eine Kreislaufwirtschaft: Labore kaufen Rechenleistung von Clouds, Clouds und Neoclouds kaufen Chips und Speicher, und Chiphersteller und Clouds investieren in die Labore. Dieser Abschnitt legt dar, was datierte Dokumente zu dieser Beschreibung sagen. Er fällt kein Urteil. Jeder Eintrag ist als belegt gekennzeichnet, wenn eine Pflichtmeldung, eine datierte Veröffentlichung oder eine amtliche Statistik den Betrag und die Gegenparteien nennt, als gefolgert, wenn er sich unter einer angegebenen Annahme rechnerisch aus belegten Zahlen ergibt, und als nicht gefunden, wenn die gelesenen Quellen dazu nichts sagen.
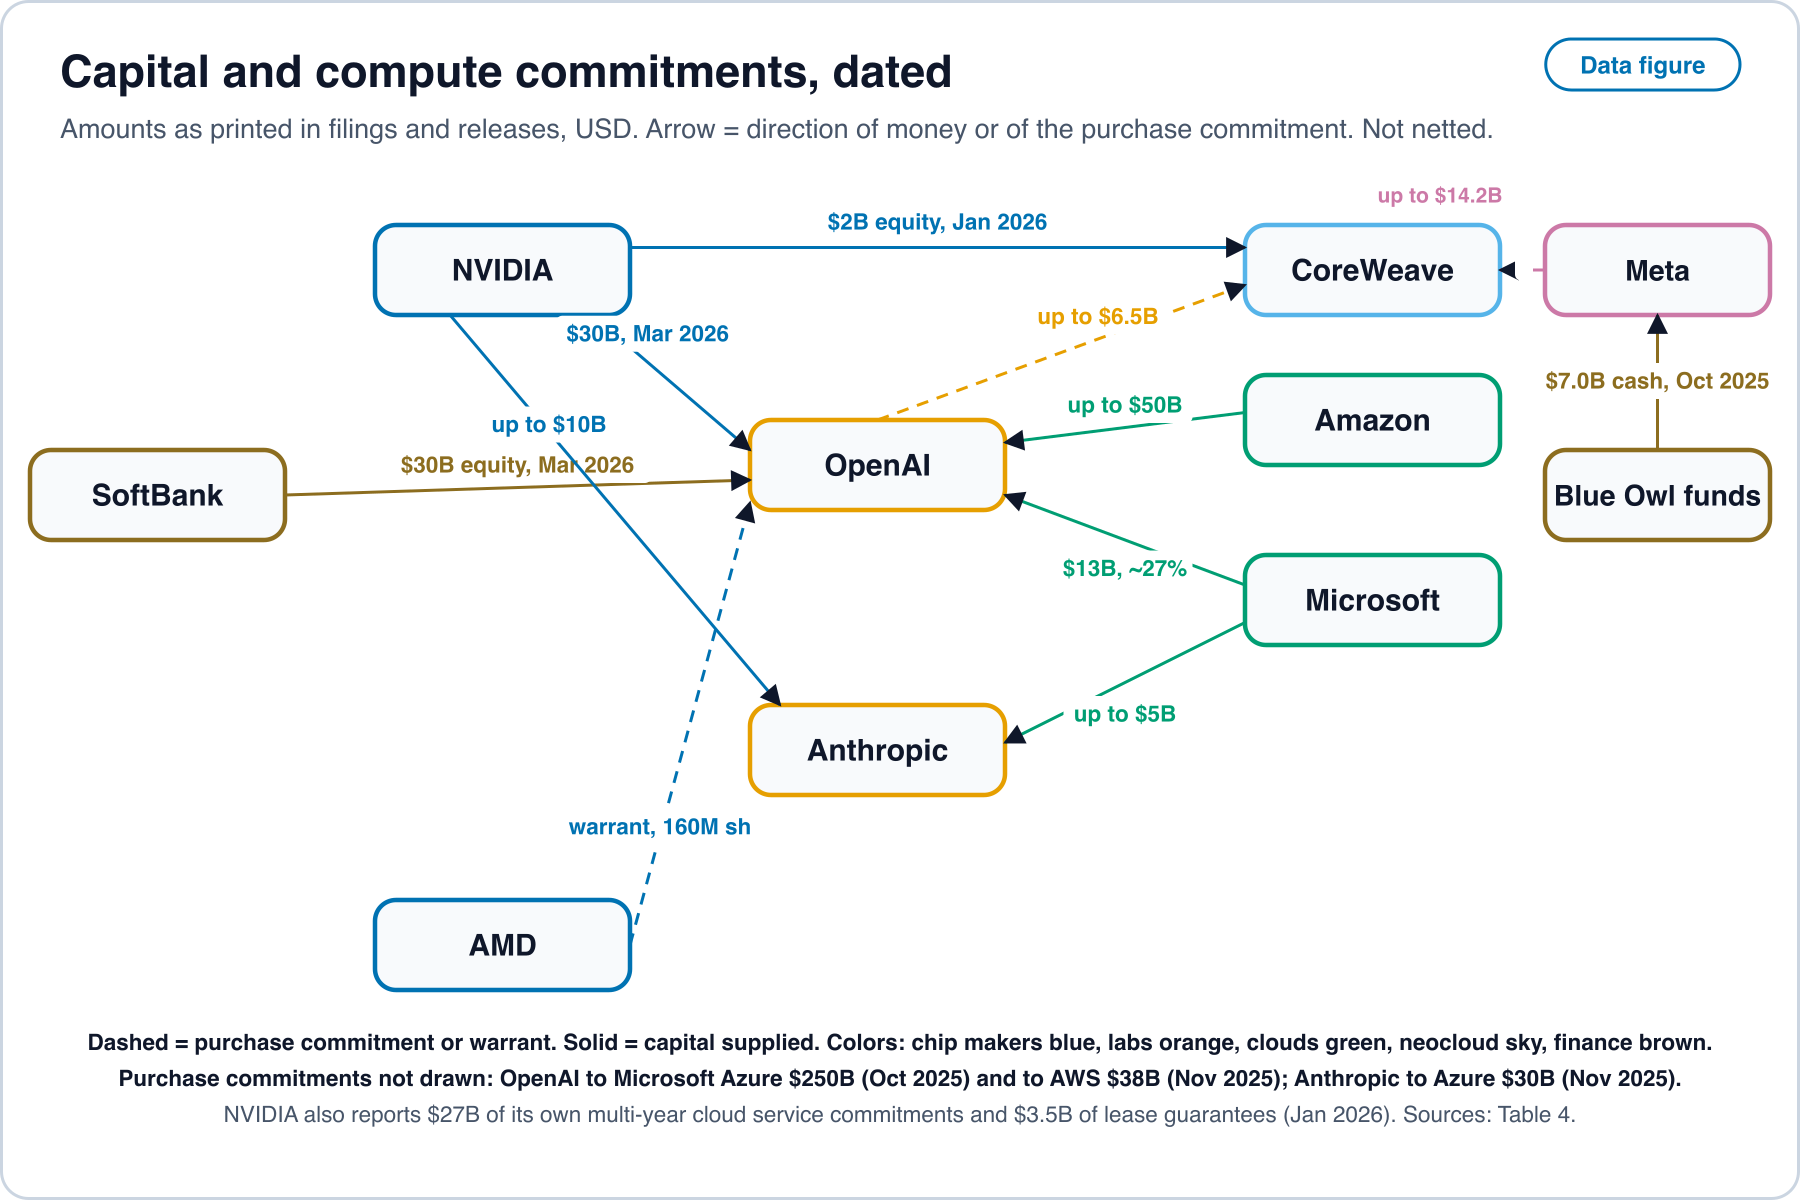
scripts/figures/latency_figures.py mit latency_data/flows.csv; die Quellen sind in Tabelle 4 aufgeführt. Open full sizeKapital, das Kunden bereitgestellt wird. In der Finanzierungsrunde von 122 Milliarden Dollar, die OpenAI im März 2026 abschloss, wird NVIDIA mit 30 Milliarden Dollar genannt, Amazon mit bis zu 50 Milliarden und SoftBank mit 30 Milliarden [9]. Eine frühere Absichtserklärung hatte besagt, NVIDIA beabsichtige, schrittweise bis zu 100 Milliarden Dollar zu investieren, sobald jeweils ein Gigawatt in Betrieb geht, was eine Absichtserklärung und keine abgeschlossene Transaktion ist [87]. Microsoft berichtet etwa 27% an der OpenAI public benefit corporation und 13 Milliarden Dollar an gesamten Finanzierungszusagen, bilanziert nach der Equity-Methode [7]. Für Anthropic sagten NVIDIA und Microsoft Investitionen von bis zu 10 und 5 Milliarden Dollar zu [10]. NVIDIA kaufte nach dem Ende des Geschäftsjahres 2025 von CoreWeave Aktien der Klasse A dieses Unternehmens für 2 Milliarden Dollar [4]. AMD gab OpenAI einen Optionsschein auf bis zu 160 Millionen Aktien zu 0.01 Dollar je Aktie aus, der in Tranchen unverfallbar wird, die an Käufe von AMD-Instinct-GPU-Produkten gebunden sind [88].
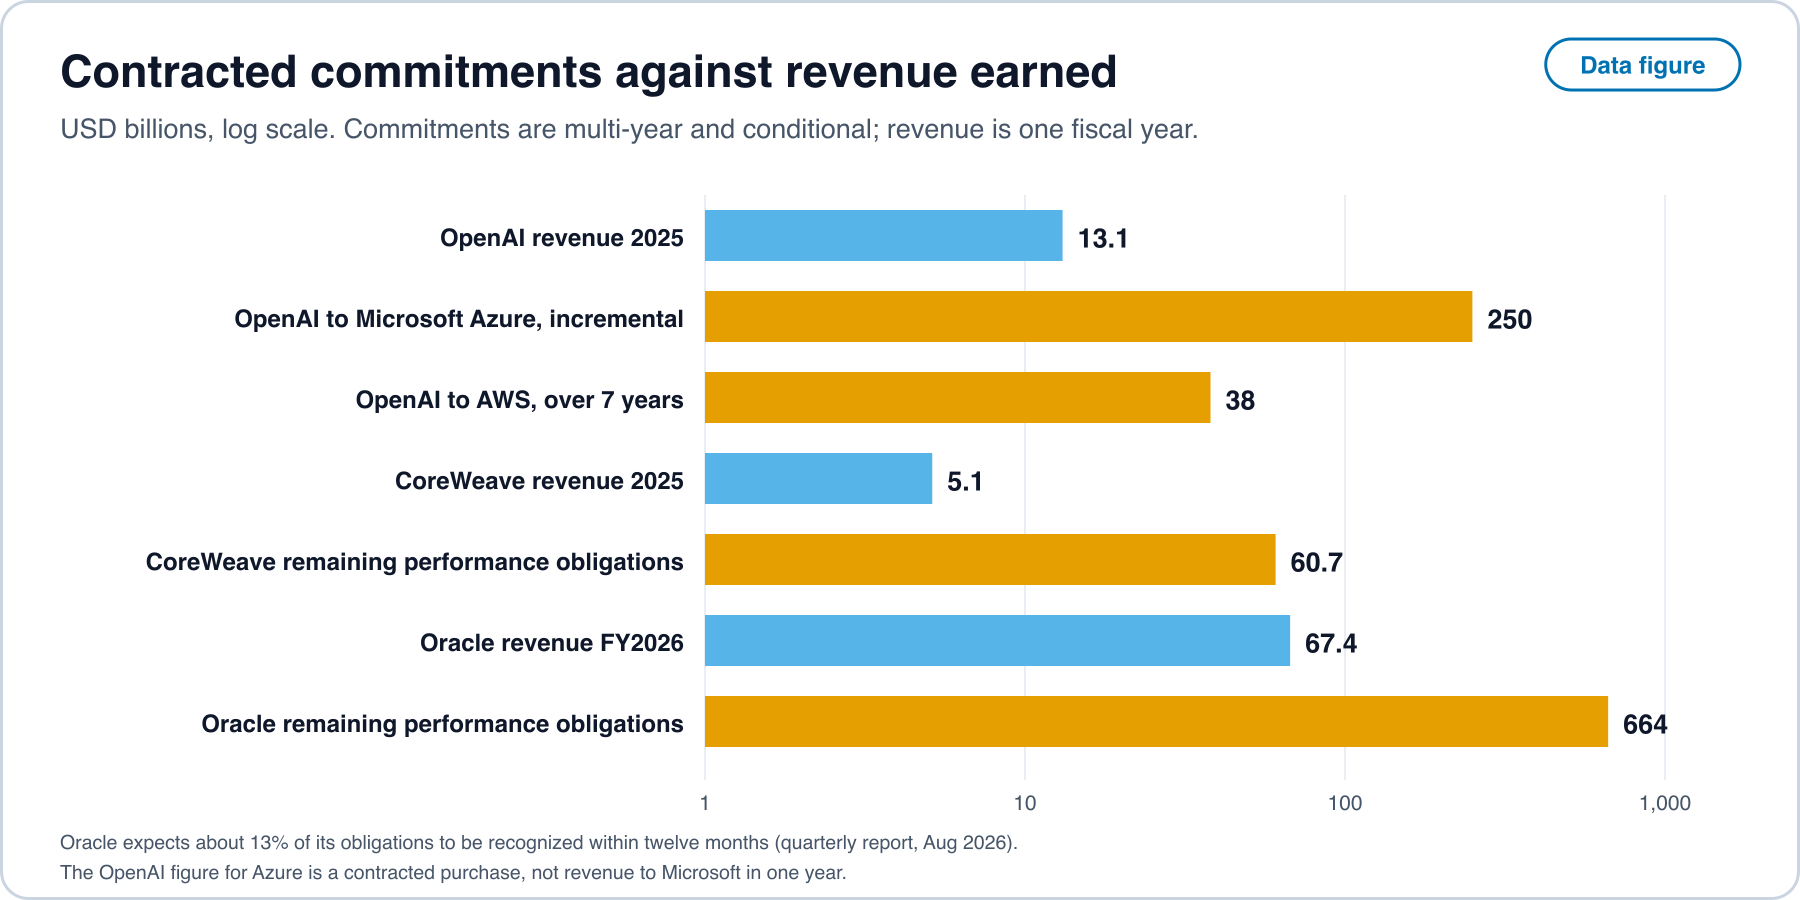
Von Kunden zugesagte Käufe. OpenAI verpflichtete sich vertraglich, zusätzliche Azure-Dienste für 250 Milliarden Dollar zu kaufen [7, 89], schloss mit AWS eine Vereinbarung über 38 Milliarden Dollar, die die Ankündigung als über sieben Jahre wachsend beschreibt [8], und eine über bis zu 6.5 Milliarden Dollar mit CoreWeave, während Meta mit CoreWeave ein Bestellformular über bis zu 14.2 Milliarden hat [4]. Anthropic verpflichtete sich, Azure-Rechenleistung für 30 Milliarden Dollar zu kaufen und bis zu einem weiteren Gigawatt unter Vertrag zu nehmen [10]. NVIDIA selbst berichtet 27 Milliarden Dollar an mehrjährigen Zusagen für Clouddienste und 3.5 Milliarden Dollar an Garantien für Grundstücke, Strom und Gebäudehüllen gegenüber Partnern in frühem Stadium [3].
Tabelle 4. Was belegt ist, was gefolgert ist und was die Quellen nicht sagen.
| Eintrag | Belegt | Gefolgert, mit der Annahme | In den gelesenen Quellen nicht gefunden |
|---|---|---|---|
| Eigenkapital von Lieferanten an Kunden | Die obigen Beträge und Daten [9, 10, 4] | Keine gezogen | Ob irgendein Eigenkapital an Käufe gebunden ist, außer beim Optionsschein von AMD, dessen Unverfallbarkeit in der Pflichtmeldung an GPU-Käufe gebunden ist [88] |
| Käufe von Laboren bei Clouds | Azure 250 und AWS 38 Milliarden Dollar für OpenAI; Azure 30 Milliarden für Anthropic [7, 8, 10] | Der AWS-Betrag entspricht im Mittel etwa 5.4 Milliarden Dollar pro Jahr, wenn er gleichmäßig über sieben Jahre verteilt wird | Laufzeit und Hochlauf der Azure-Zusage; die an den Amazon-Betrag von 50 Milliarden Dollar geknüpften Bedingungen |
| Kundenkonzentration | Direkte Kunden von NVIDIA mit 22% und 14% des Umsatzes, mit Systembauern und Distributoren unter den direkten Kunden [3]; CoreWeave mit Microsoft bei 67% des Umsatzes 2025 [4] | Eine untere Schranke für den Herfindahl-Index aus den offengelegten Anteilen: mindestens 0.068 für NVIDIA und 0.449 für CoreWeave | Wer hinter den direkten Kunden von NVIDIA steht |
| Vorauszahlungen von Kunden | Die abgegrenzten Erlöse von Oracle aus Kundenvorauszahlungen mit einer wesentlichen Finanzierungskomponente stiegen im Quartal um 11.4 Milliarden Dollar, innerhalb eines operativen Cashflows von 23.1 Milliarden [5] | Etwa die Hälfte des operativen Cashflows dieses Quartals stammte aus Vorauszahlungen | Welche Kunden vorausgezahlt haben |
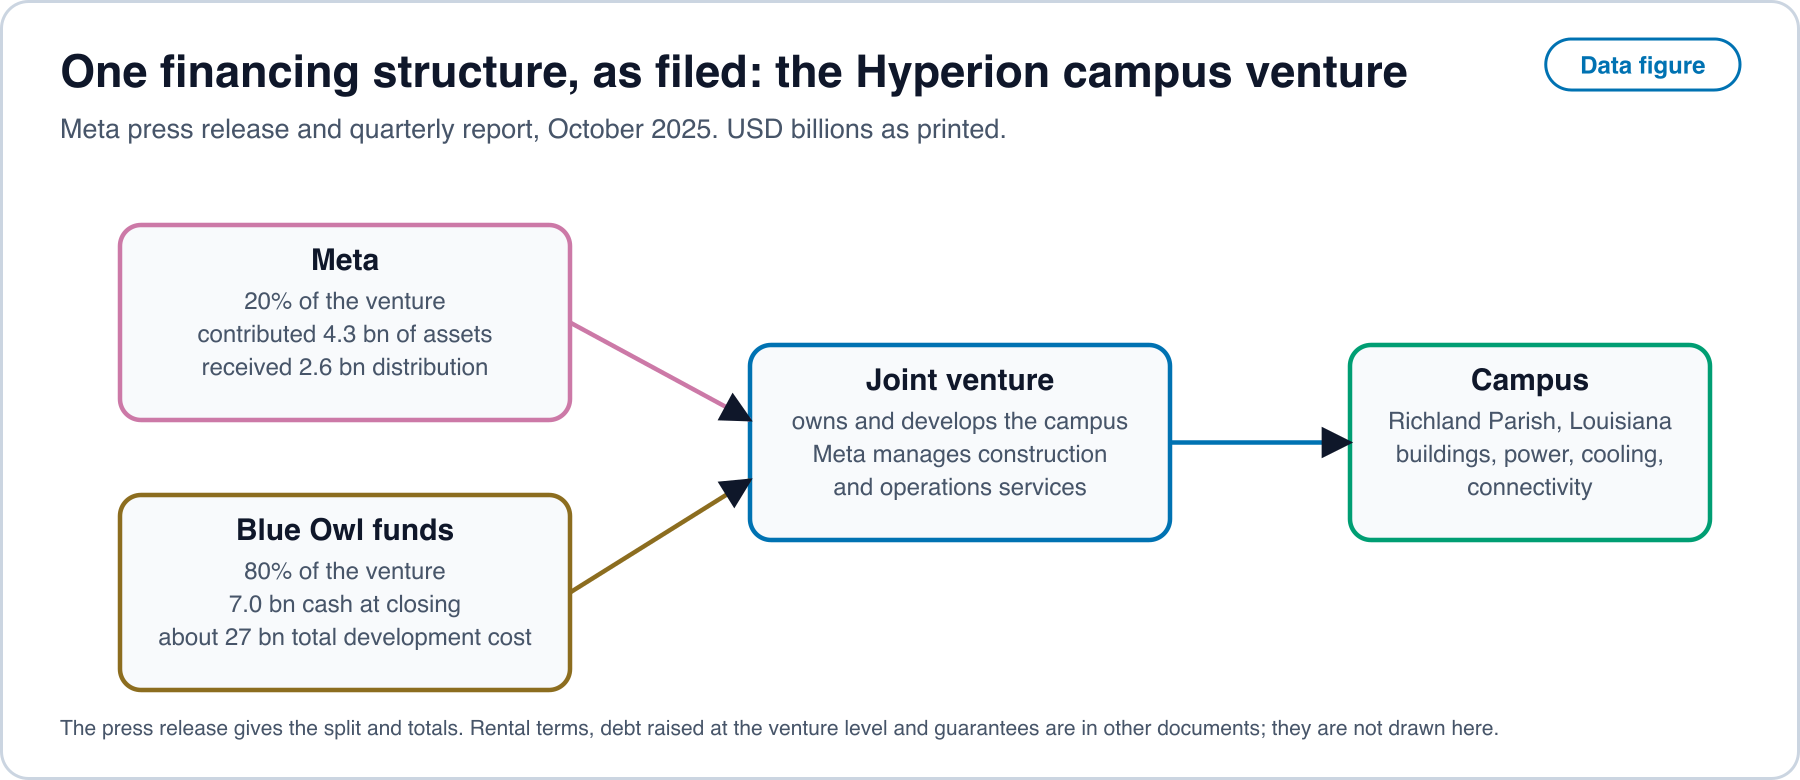
| Finanzierung auf Ebene eines Gemeinschaftsunternehmens | Fonds von Blue Owl halten 80% und Meta 20% eines Gemeinschaftsunternehmens für den Hyperion-Campus; die Fonds brachten 7.0 Milliarden Dollar in bar gegenüber etwa 27 Milliarden Dollar Entwicklungskosten ein [2, 1] | Das Bargeld entspricht etwa einem Viertel der Entwicklungskosten | Mietbedingungen, vom Gemeinschaftsunternehmen aufgenommene Schulden und Garantien |
| Abschreibungsdauern | Angegebene Nutzungsdauern für Server in Abbildung 12 [4, 14, 15, 16, 17] | Eine Verlängerung der Nutzungsdauer von 5 auf 6 Jahre senkt die lineare jährliche Abschreibung auf dieselben Vermögenswerte um ein Sechstel | Die Nutzungsdauer, die GPUs im Betrieb erreichen |
| Bareinsatz für Investitionen gegenüber operativem Cashflow | Die Jahresreihe in Abbildung 8 [11] | Das Verhältnis der beiden | Finanzierungsleasing und außerbilanzielles Leasing |
Der Begriff Kunde folgt in dieser Tabelle dem Sprachgebrauch der jeweiligen Pflichtmeldung. Geld ist fungibel, daher kann eine Pflichtmeldung zeigen, dass Kapital an einen Kunden ging und dass der Kunde den Lieferanten bezahlte, aber nicht, dass das eine das andere finanzierte. Abschnitt 10 formuliert einen Test, der innerhalb dieser Grenze funktioniert.
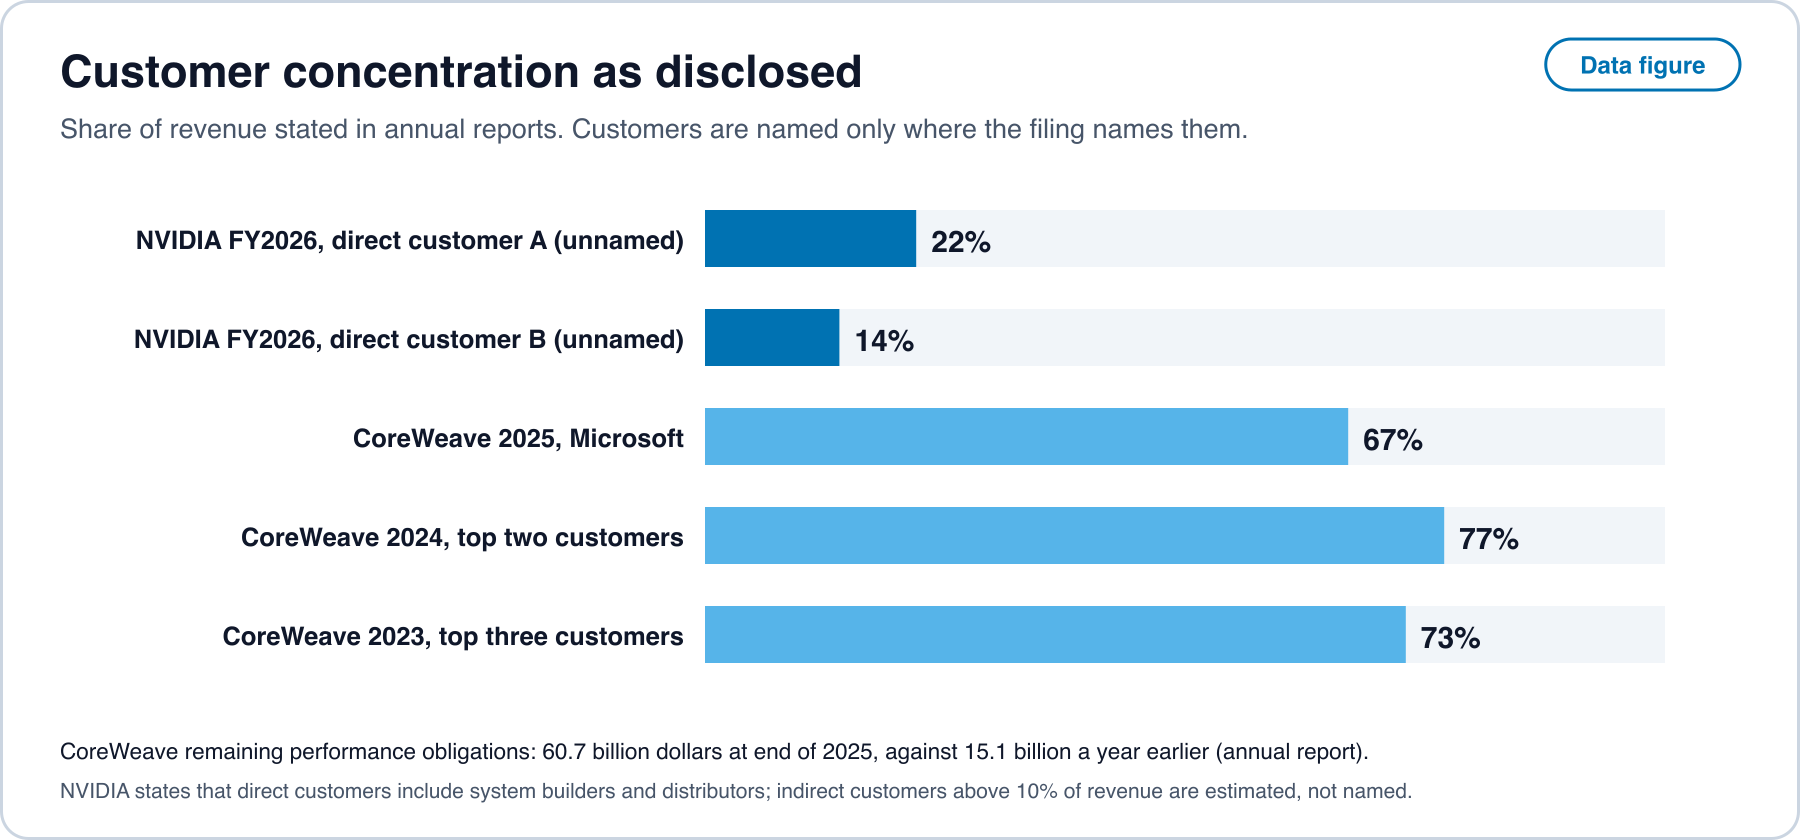
Konzentration und Auftragsbestand. Die offengelegten Kundenanteile sind an den fremdfinanzierten Knoten hoch und beim größten Chiphersteller niedriger. CoreWeave berichtet seine drei größten Kunden mit 73% des Umsatzes 2023, seine zwei größten mit 77% im Jahr 2024 und Microsoft allein mit 67% im Jahr 2025 [4]. Seine verbleibenden Leistungsverpflichtungen von 60.7 Milliarden Dollar entsprechen dem 11.8-Fachen seines Umsatzes 2025 von 5.131 Milliarden. Oracle berichtet Verpflichtungen von 664 Milliarden Dollar zum 31. August 2026 und erwartet, dass etwa 13% davon in den nächsten zwölf Monaten erfasst werden [5, 6], gegenüber einem Umsatz im Geschäftsjahr 2026 von 67.4 Milliarden [11]. OpenAI berichtete für 2025 einen Umsatz von 13.1 Milliarden Dollar und nannte im März 2026 eine Rate von 2 Milliarden Dollar pro Monat [9]. Vertraglich vereinbarte Käufe laufen über mehrere Jahre und hängen von Bedingungen ab, die diese Zahlen nicht zeigen, daher sind sie kein Umsatz eines Jahres und nicht mit den obigen Zahlen addierbar.
Labore kaufen auch anderswo. Anthropic kündigte einen Plan an, bis zu eine Million TPUs zu nutzen, im Wert von zig Milliarden Dollar und mit deutlich über einem Gigawatt Kapazität im Jahr 2026 [90]. OpenAI kündigte einen Plan an, 10 Gigawatt an Beschleunigern eigener Bauart einzusetzen [91], und hält den oben genannten Optionsschein von AMD. Ein Labor, das bei mehreren Lieferanten kauft und eigene Bauteile entwirft, ist nicht der einzige Kunde eines von ihnen, was für die Schranke im nächsten Abschnitt wichtig ist.
10. Ein Test auf geschlossenen Kreislauf und seine Vorhersagen
Die Frage, die die Dokumente allein nicht beantworten können, ist, wie viel vom Umsatz eines Lieferanten mit Geld bezahlt wird, das der Lieferant selbst bereitgestellt hat. Der folgende Test macht daraus Größen, die sich aus einer Pflichtmeldung beschränken lassen.
Für ein Fenster (ein Geschäftsjahr) sei das vom Lieferanten dem Kunden bereitgestellte Kapital (Eigenkapital, Kredite, Garantien, Optionsscheine zum Ausgabewert), der Umsatz, den von erhält, der Gesamtumsatz von und das Kapital, das aus allen Quellen aufnimmt.
Definition 3 (Rundlaufquote). , bereitgestelltes Kapital pro Dollar Umsatz, der von derselben Gegenpartei erhalten wird.
Definition 4 (Schranke des Kreislaufanteils). . Ein Kunde kann nicht mit mehr eigenem Kapital von bezahlt haben, als bereitgestellt hat, und nicht mit mehr, als er bezahlt hat, also ist eine obere Schranke für den Anteil von , der mit dem eigenen Kapital von finanziert worden sein könnte. Das Gegenstück auf Kundenseite ist , der Anteil des von aufgenommenen Kapitals, der von seinen eigenen Lieferanten stammt. Beide sind aus offengelegten Zahlen berechnete Schranken. Sie sind keine Schätzungen dessen, was geschehen ist, weil Geld fungibel ist.
Proposition 7 (wann sich ein vom Lieferanten finanzierter Kauf lohnt). Der Lieferant verkaufe zum Preis mit Stückkosten und Bruttomarge . Er stelle Kapital bereit, das einen Anteil der Verkäufe auslöst, die sonst nicht stattfänden, und er gewinne aus seiner Beteiligung den Wert zurück. Der zusätzliche Gewinn ist . Wird das gesamte bei ausgegeben, sodass , dann gilt genau dann, wenn , wobei .
Herleitung. Setze ein und löse . (Von Hand, nicht maschinell geprüft.)
Folgerung. Da , lohnt sich Lieferantenfinanzierung allein über ausgelöste Verkäufe nur, wenn . Bei der von NVIDIA für das Geschäftsjahr 2026 berichteten Bruttomarge von 71.1% [3] muss von der Beteiligung erwartet werden, dass sie mindestens 28.9% des Kapitals zurückbringt. Die Modellausgabe für den Gewinnschwellen-Anteil ausgelöster Verkäufe bei einer Rückgewinnung von 0, 25%, 50%, 75% und 100% beträgt 1.41, 1.05, 0.70, 0.35 und 0, sodass ohne Rückgewinnung kein Anteil ausgelöster Verkäufe ausreicht.
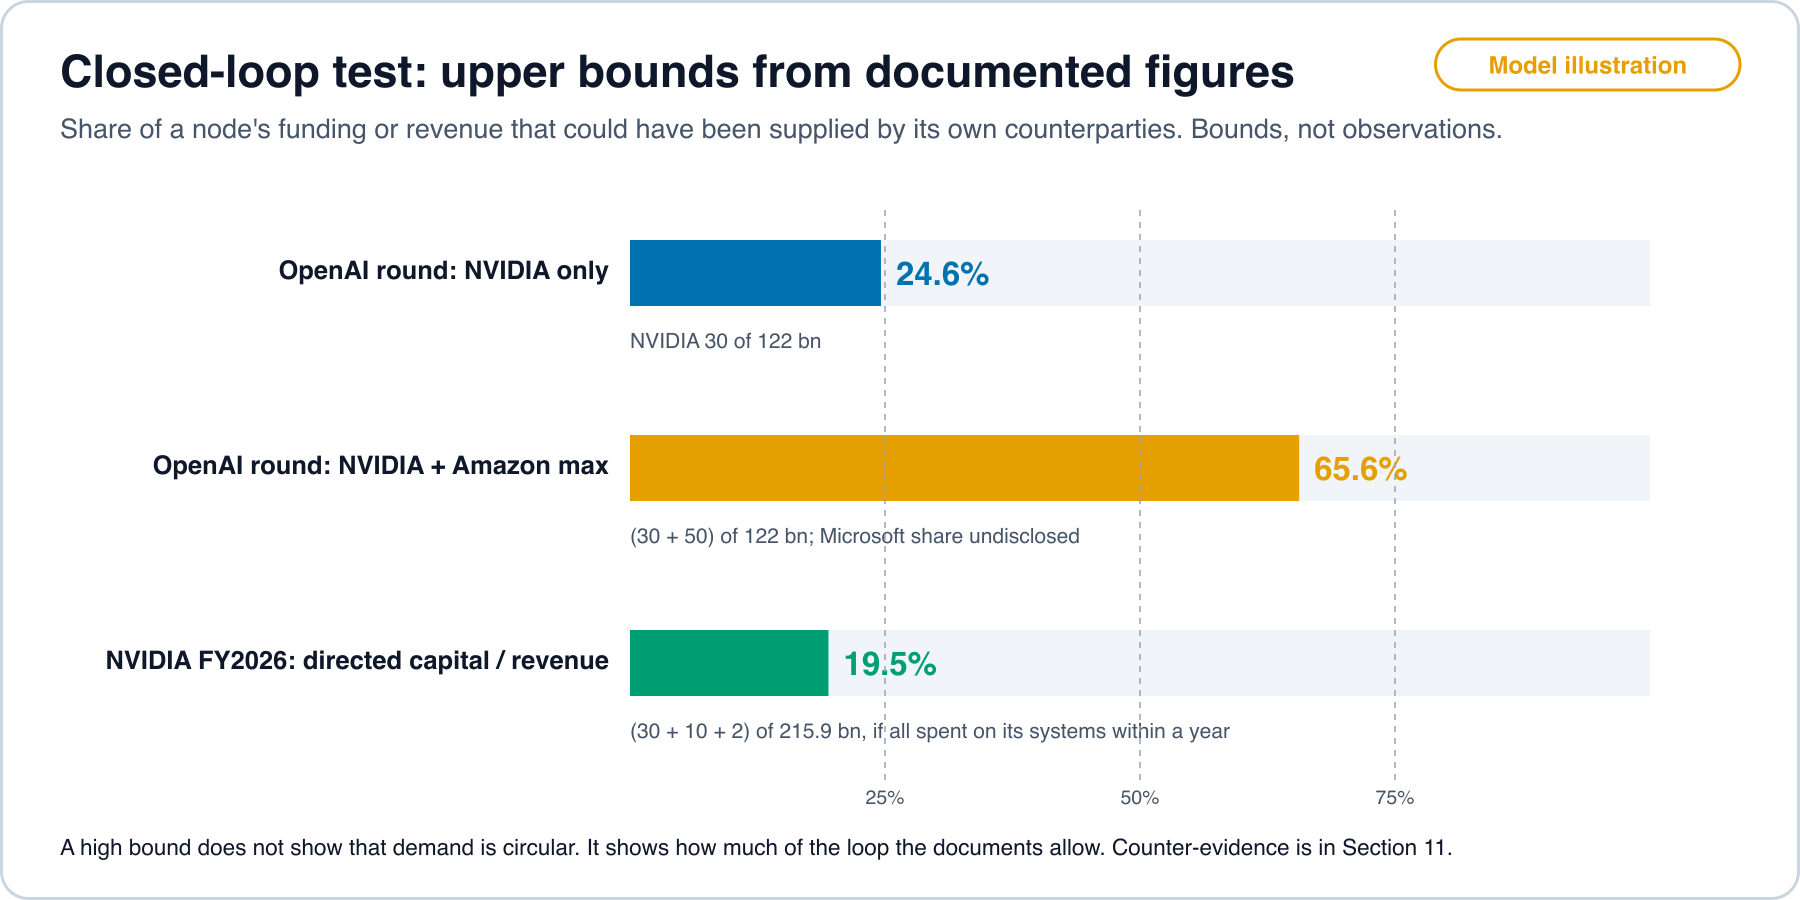
latency_data/model_outputs.json, berechnet von model_airace.py aus [9, 10, 4, 3]. Open full sizeSchranken aus den Dokumenten. Der Anteil von NVIDIA an der OpenAI-Runde beträgt höchstens 24.6%, und mit Amazon zu seinem angegebenen Höchstbetrag erreichen die beiden höchstens 65.6%, wobei der Anteil von Microsoft nicht offengelegt ist (Modellausgabe). Das Kapital, das NVIDIA von November 2025 bis März 2026 Kunden bereitzustellen ankündigte oder laut Berichten bereitstellte, beträgt 42 Milliarden Dollar (30 für OpenAI, bis zu 10 für Anthropic und 2 für CoreWeave), das sind 19.5% seines Umsatzes im Geschäftsjahr 2026 von 215.9 Milliarden und 41% seines operativen Cashflows von 102.7 Milliarden [3, 11]. Die erste Zahl ist ein Größenvergleich, da sich die Beträge und das Umsatzjahr unterscheiden. Als Schranke gelesen bedeutet sie: Käme jeder dieser Dollar innerhalb eines Jahres als Umsatz zu NVIDIA zurück, wäre höchstens etwa ein Fünftel des Umsatzes dieses Jahres mit dem eigenen Kapital von NVIDIA finanziert.
Vorhersagen. Jede nennt Daten, einen Test und ein Ergebnis, das gegen die Aussage sprechen würde. Diese Vorhersagen wurden geschrieben, nachdem die obigen Pflichtmeldungen gelesen worden waren, und sie werden an Pflichtmeldungen geprüft, die nach diesem Artikel datiert sind.
Vorhersage 7 (der Kreislaufanteil bleibt beschränkt). Für jeden Chip- oder Cloudlieferanten mit offengelegtem gerichtetem Kapital bleibt , berechnet aus jedem Geschäftsbericht, unter 0.25, während der Umsatz mit Kunden, die kein gerichtetes Kapital erhielten, mindestens so schnell wächst wie der Umsatz mit denen, die es erhielten. Test: jährliche Pflichtmeldungen, mit Kunden benannt, wo die Pflichtmeldungen sie benennen. Widerlegt, wenn in einem Geschäftsjahr 0.5 übersteigt oder wenn sich das Umsatzwachstum auf Kunden konzentriert, die gerichtetes Kapital erhielten. Werte zwischen 0.25 und 0.5 sind nicht schlüssig.
Vorhersage 8 (der Umsatz mit Endnutzern wächst schneller als die Zusagen). Für ein Labor fällt das Verhältnis der vertraglich vereinbarten Käufe zum Umsatz der letzten zwölf Monate über vier aufeinanderfolgende Quartale, während der Umsatz steigt. Test: Angaben der Labore und Offenlegungen zum Auftragsbestand der Clouds. Widerlegt, wenn das Verhältnis vier aufeinanderfolgende Quartale lang steigt.
Vorhersage 9 (Belastung zeigt sich zuerst dort, wo Konzentration und Fremdfinanzierung am höchsten sind). Wenn ein Labor eine Rechenzusage nach unten korrigiert, ist der Umfang der Prognosekorrekturen an den Lieferantenknoten nach ihrem offengelegten Anteil des größten Kunden geordnet. Test: Prognosekorrekturen nach jedem solchen Ereignis, geordnet nach dem offengelegten Anteil des größten Kunden. Widerlegt, wenn die Reihenfolge nicht mit der Konzentration zusammenhängt.
Vorhersage 10 (Substitution senkt die zugesagte Kapazität pro Dollar Umsatz). Wo offene Methoden und billigere Hardware die Beschleunigerzeit pro Aufgabe senken (Abschnitt 12), sinken die zugesagten Gigawatt pro Dollar Laborumsatz. Test: angekündigte Kapazität und Laborumsatz nach Quartal. Widerlegt, wenn die zugesagten Gigawatt pro Dollar Umsatz vier aufeinanderfolgende Quartale lang steigen, während die gemessene Beschleunigerzeit pro Aufgabe auf offenen Benchmarks ebenfalls fällt.
11. Die stärksten Gegenbelege
Die Lesart, der Ausbau sei überwiegend ein geschlossener Kreislauf, trifft auf vier Gruppen von Dokumenten, die in die andere Richtung weisen, und auf eine Gruppe, die auf Fragilität hinweist.
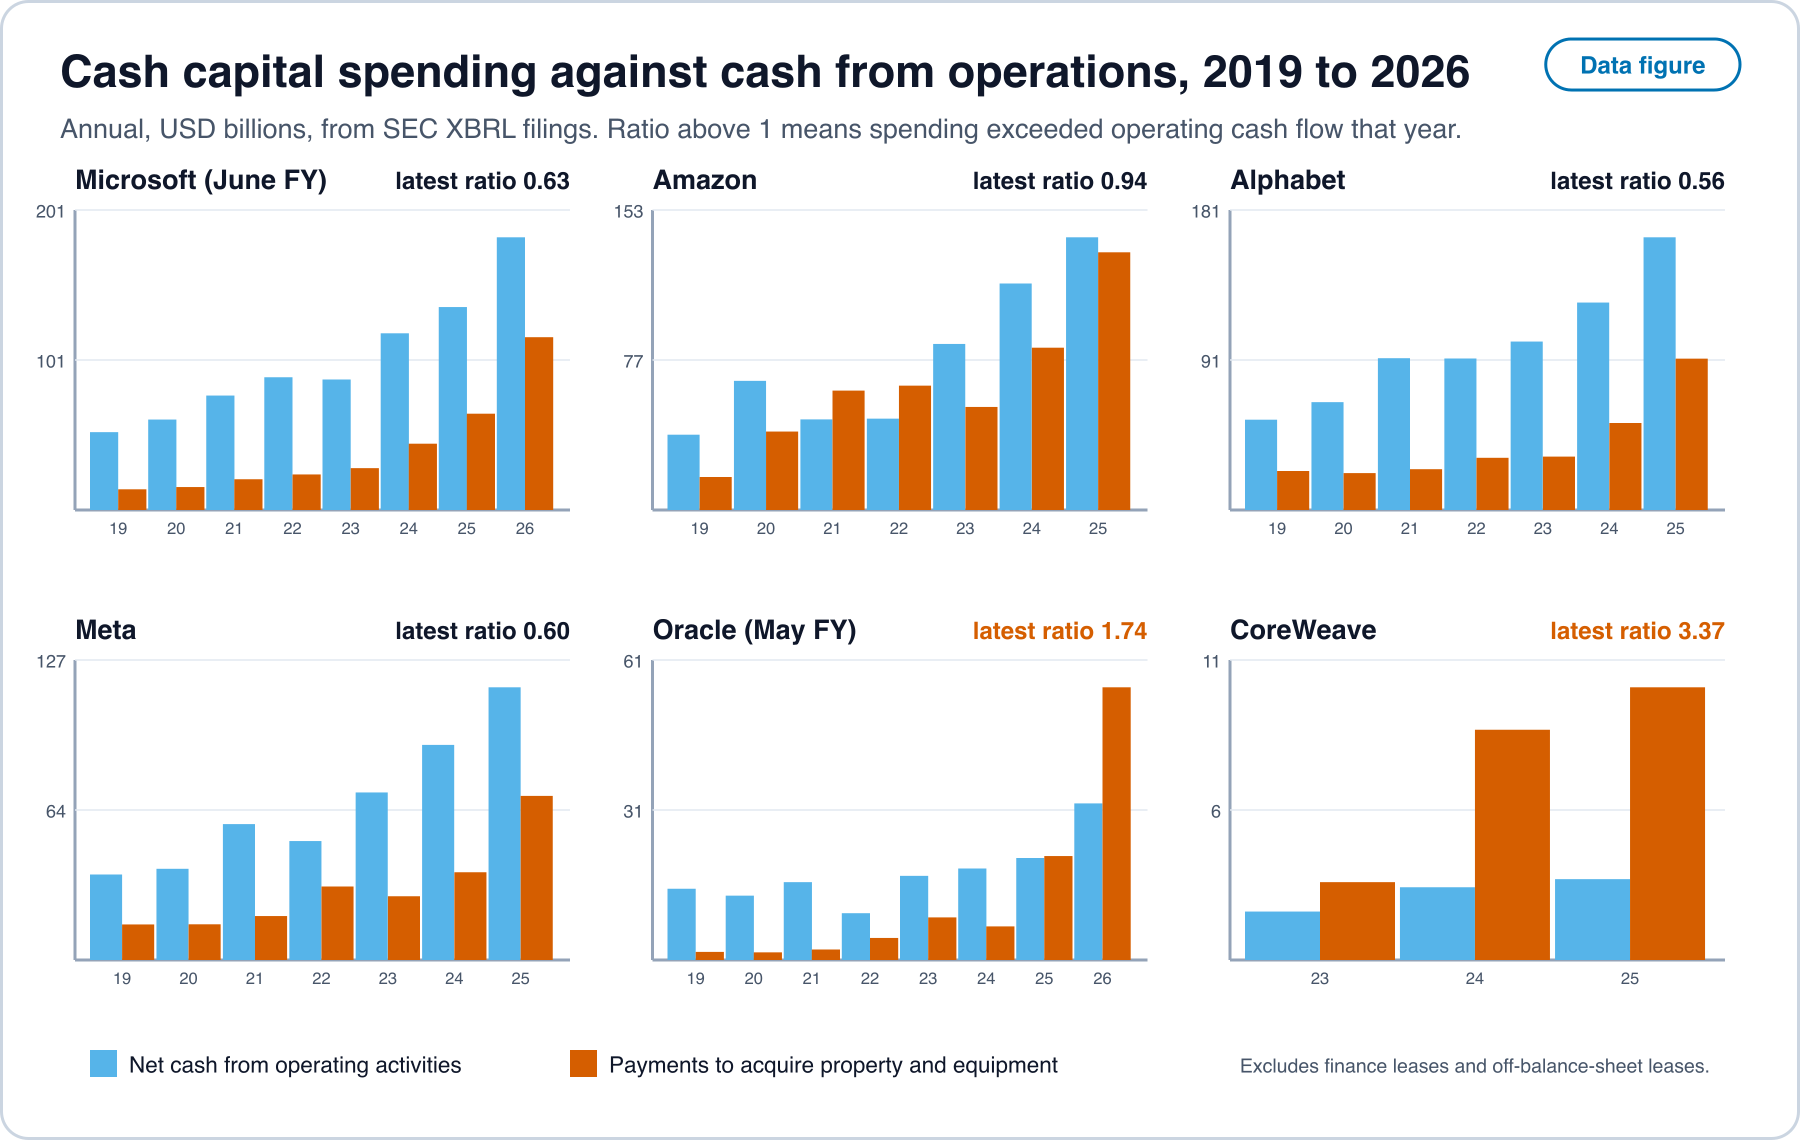
Die meisten Ausgaben werden bei den größten Käufern aus dem laufenden Geschäft finanziert. In ihren jüngsten Geschäftsjahren betrugen die bar gezahlten Investitionsausgaben das 0.63-Fache des operativen Cashflows bei Microsoft, das 0.94-Fache bei Amazon, das 0.56-Fache bei Alphabet und das 0.60-Fache bei Meta [11]. Die Ausgaben sind groß, und sie werden aus Bargeld bezahlt, das dieselben Unternehmen mit anderen Geschäften verdienen.
latency_data/capex_ocf.csv [11]. Open full sizeDer größte Chiplieferant könnte sein gerichtetes Kapital aus eigenen Mitteln finanzieren. Die obigen 42 Milliarden Dollar sind 41% des operativen Cashflows eines Jahres bei NVIDIA [3, 11], und seine zwei größten direkten Kunden machen 22% und 14% des Umsatzes aus, darunter Systembauer und Distributoren [3].
Der Umsatz mit Endnutzern ist in den gelesenen Angaben real und wächst. OpenAI berichtete für 2025 einen Umsatz von 13.1 Milliarden Dollar und im März 2026 eine Rate von 2 Milliarden Dollar pro Monat, was aufs Jahr gerechnet 24 Milliarden ergibt (Rechnung) [9].
Labore diversifizieren. Der Plan von Anthropic für bis zu eine Million TPUs neben seinen Zusagen an Azure und NVIDIA sowie die Pläne von OpenAI für eigene Beschleuniger und der Optionsschein von AMD bedeuten, dass die hier genannten Labore in ihren angekündigten Plänen mehr als eine Chipquelle haben [90, 10, 91, 88].
Was die Gegenbelege nicht beseitigen. Die bar gezahlten Investitionsausgaben betrugen bei Oracle im Geschäftsjahr 2026 das 1.74-Fache des operativen Cashflows und bei CoreWeave im Jahr 2025 das 3.37-Fache [11]. Das am 31. August 2026 endende Quartal von Oracle zeigt einen operativen Cashflow von 23.1 Milliarden Dollar, davon 11.4 Milliarden aus Kundenvorauszahlungen, und einen freien Cashflow von minus 5 Milliarden [5, 6]. Die Verpflichtungen von CoreWeave betragen das 11.8-Fache seines Umsatzes, und sein Kundenstamm ist konzentriert [4]. Das sind die Knoten, an denen eine Finanzierungslücke eines Labors zuerst ankäme, was Vorhersage 9 prüft.
Gesamtlesart, soweit die Dokumente reichen. Kreisläufe von zig Milliarden Dollar zwischen benannten Lieferanten und Kunden sind belegt. Die Dokumente beschränken den Anteil des Umsatzes des größten Chiplieferanten, den sein eigenes Kapital hätte finanzieren können, auf unter ein Fünftel und zeigen, dass die meisten Ausgaben der Hyperscaler aus dem operativen Cashflow bezahlt werden. Die konzentrierten und fremdfinanzierten Knoten, eine Cloud mit Vorauszahlungen und eine Neocloud mit einem einzigen dominierenden Kunden, sind die Stellen, an denen die Kreislaufannahme am meisten ins Gewicht fiele. Die Bedingungen privater Vereinbarungen sind nicht öffentlich, daher liefern die Dokumente Schranken und keine Messung.
12. Was eine Aufgabe kostet: das Infrastrukturkostenmodell
Abschnitt 0 definiert die Kosten pro Aufgabe als . Dieser Abschnitt füllt und aus den Kosten einer Beschleunigerstunde aus und verknüpft das Ergebnis mit , und .
Beschleunigerstunde. Sei das Kapital pro Beschleuniger, einschließlich des Anteils an Anlage, Stromversorgung und Kühlung, mit linearer Nutzungsdauer von Jahren und Auslastung . Das Kapital pro genutzter Stunde ist . Sei die Anlagenleistung pro Beschleuniger in Kilowatt und der Strompreis pro Kilowattstunde. Eine Aufgabe, die genutzte Stunden belegt, kostet
Proposition 8 (der kapitalbelastete Preis eines Joule). Bei fester Hardware gilt mit pro Kilowattstunden-Äquivalent, sodass Joule pro Aufgabe die richtige Rechnungseinheit bleibt, und der Preis, der Joule in Dollar umrechnet, wird von dominiert, sobald . Herleitung. Eliminiere zwischen den beiden Ausdrücken. (Von Hand.)
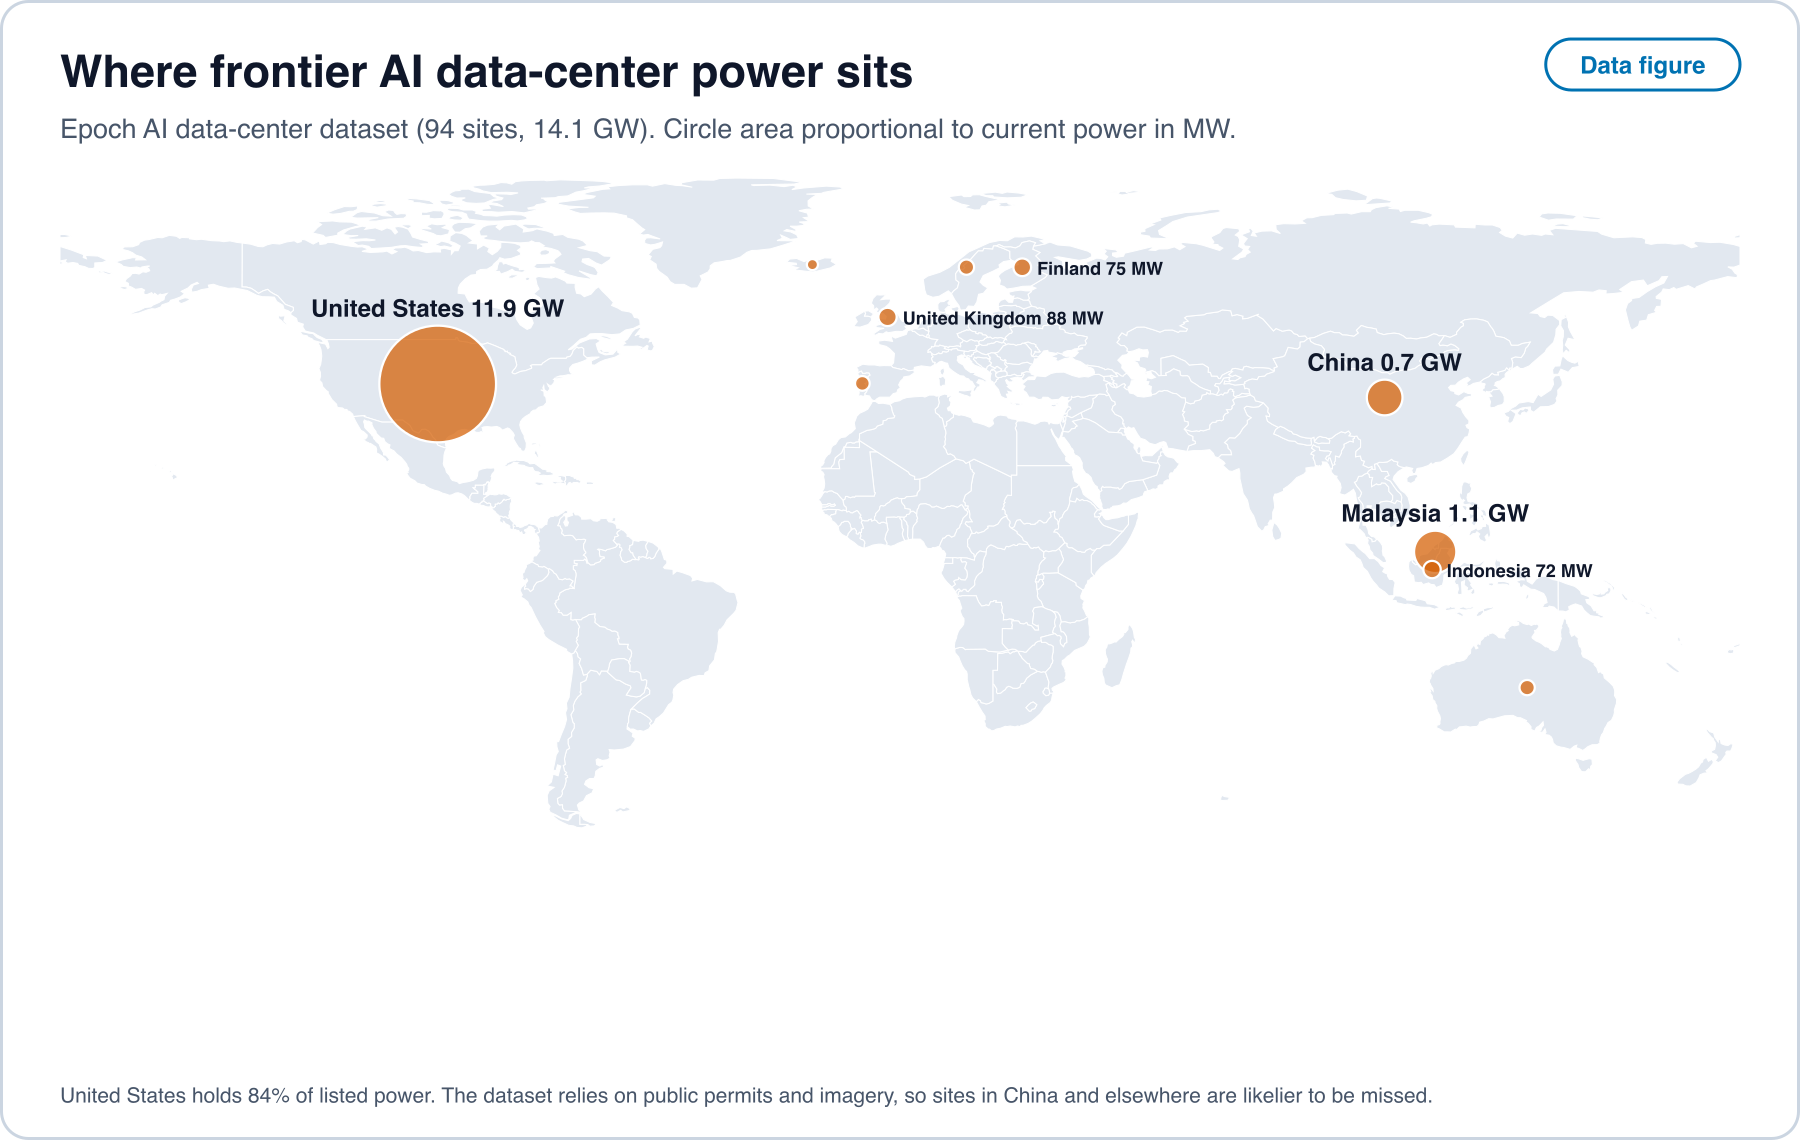
Eingaben. Der Rechenzentrumsdatensatz von Epoch AI ergibt für 74 Standorte mit beiden Angaben ein medianes Kapital von etwa 33,300 Dollar und 880 Watt Anlagenleistung pro H100-Äquivalent, wobei das Kapital pro H100-Äquivalent von etwa 19,600 bis etwa 200,800 Dollar reicht [12]. Dies sind Schätzungen auf Grundlage öffentlicher Genehmigungen und Bildaufnahmen, und das ausgewiesene Kapital eines Standorts umfasst Rechentechnik, Bau und Ausbau.
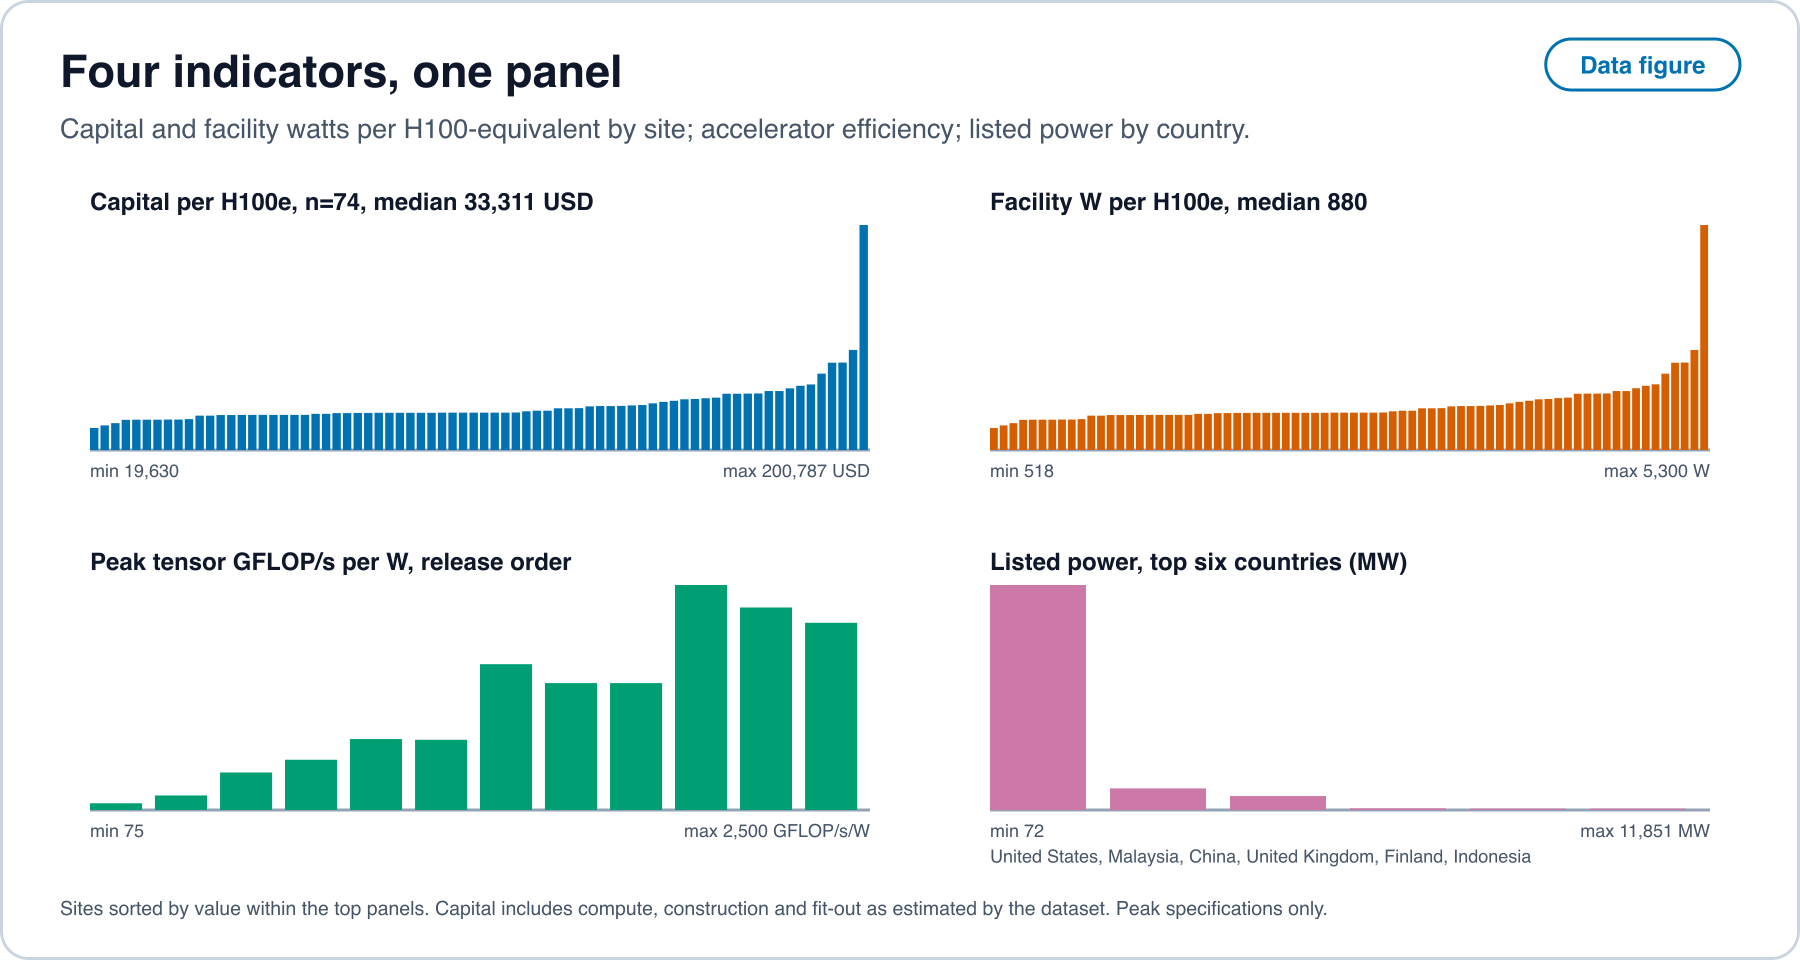
latency_data/frontier_dc_cost_per_h100e.csv, hardware_flops_per_watt.csv, frontier_dc_by_country.csv [12, 13]. Open full sizeModellausgabe. Bei Nutzungsdauern von 4 bis 6 Jahren, einer Auslastung von 40% bis 80% und Strom zu 0.04 bis 0.12 Dollar pro Kilowattstunde kostet eine genutzte Beschleunigerstunde zwischen etwa 0.83 und 2.5 Dollar, und die Energie macht zwischen 1.5% und 11.8% davon aus. Der kapitalbelastete Preis beträgt etwa 0.9 bis 2.7 Dollar pro Kilowattstunden-Äquivalent, gegenüber Strom zu 0.04 bis 0.12, sodass vom Kapital dominiert wird, mit etwa dem 8- bis 70-Fachen des Stromterms.
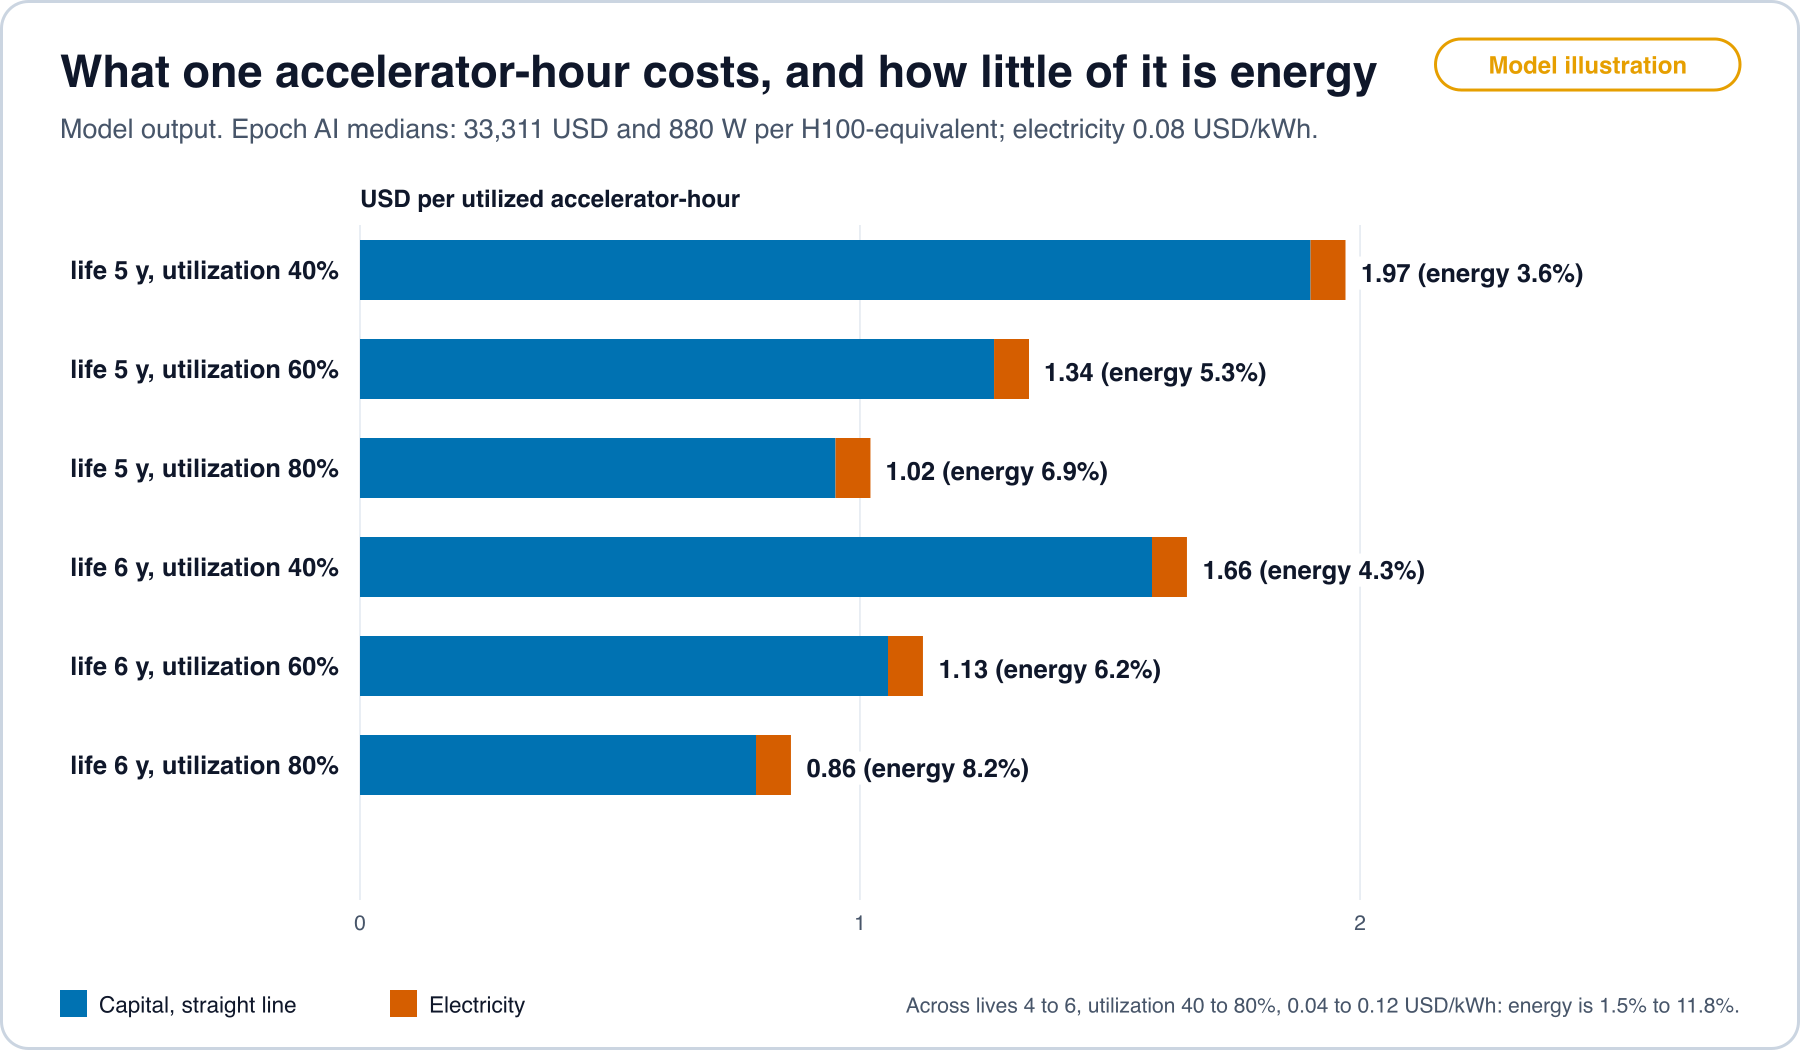
latency_data/model_outputs.json, berechnet von model_airace.py aus [12]. Open full sizeDrei Folgerungen ergeben sich. Billigerer Strom kann die Kosten einer Aufgabe höchstens um den Energieanteil senken, der in diesem Raster höchstens etwa ein Achtel beträgt. Die Auslastung zählt ebenso viel wie die Energie: Eine Halbierung von verdoppelt . Und die angegebene Nutzungsdauer ist eine Bilanzierungsentscheidung, die proportional zu verschiebt.
Nutzungsdauern und Effizienz. Die Spitzen-Tensoroperationen pro Watt stiegen nach den eigenen Spezifikationen der Hersteller über zwölf führende Beschleuniger von 2016 bis 2024 um etwa das 1.42-Fache pro Jahr, was etwa einer Verdopplung alle zwei Jahre entspricht [13]. Ein leistungsbegrenzter Standort, der ein Bauteil durch ein drei Jahre neueres ersetzt, erhielte aus derselben Leistung etwa das -Fache der Spitzenoperationen. Spitzenspezifikationen sind keine gelieferte Energie pro Aufgabe, denn Auslastung, Speicherverkehr und Software bestimmen den gelieferten Wert. Die angegebenen Servernutzungsdauern in Abbildung 12 reichen bei mehreren großen Unternehmen von 5 bis 6 Jahren, und bei anderen ist die angegebene Spanne breiter. Nutzungsdauern dieser Länge und eine Effizienzverdopplung alle zwei Jahre sind miteinander vereinbar, wenn ältere Bauteile weiterhin zu Preisen verdienen, die von neueren gesetzt werden, was eine Aussage über Preise und nicht über Physik ist.
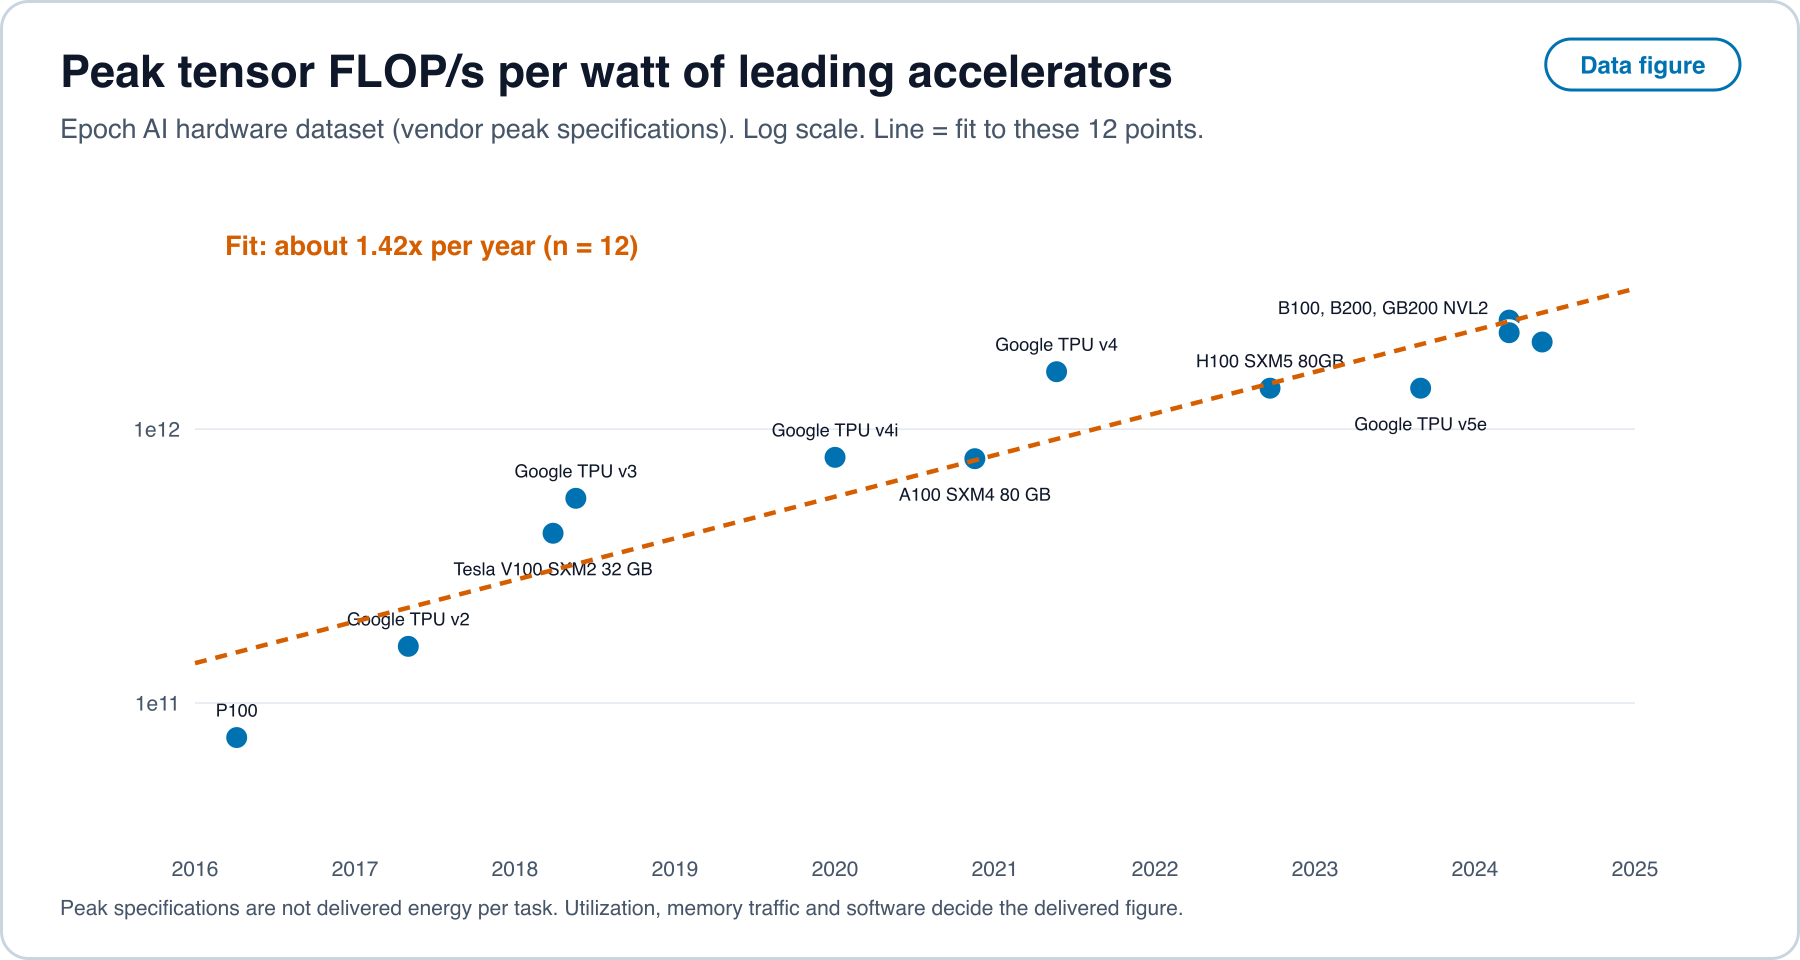
latency_data/hardware_flops_per_watt.csv und hardware_fit.json [13]. Open full size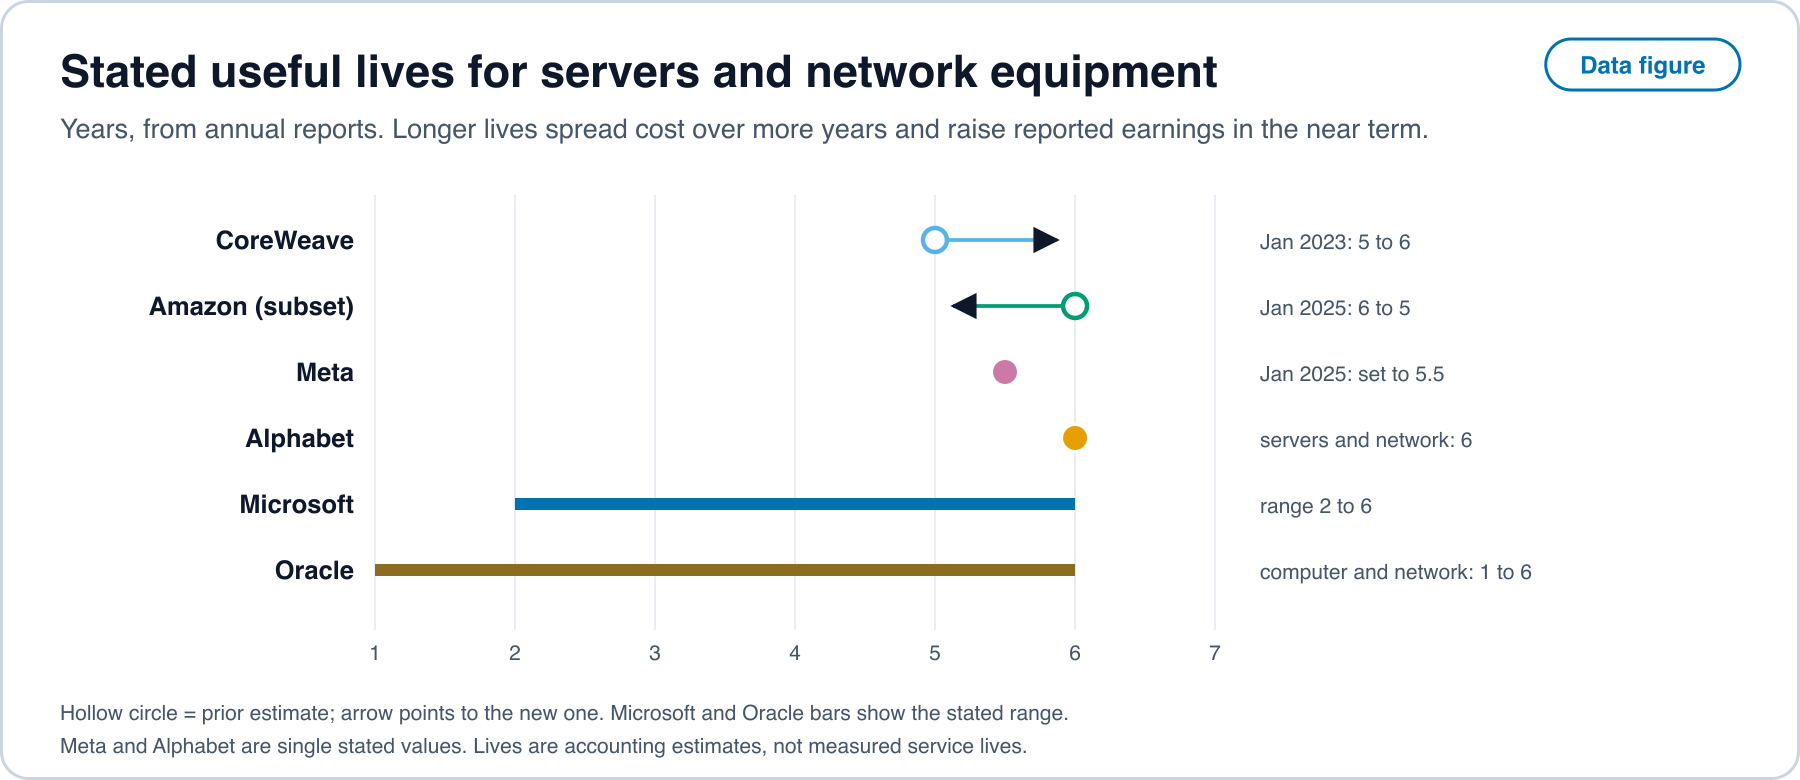
Der Preis ist nicht die Kosten. Für ein System auf dem Niveau von GPT-3.5 fiel der Inferenzpreis zwischen November 2022 und Oktober 2024 um mehr als das 280-Fache, während die Hardwarekosten um 30% pro Jahr fielen und die Energieeffizienz der Hardware um 40% pro Jahr stieg [18]. Über die 1.9 Jahre dieses Fensters ergeben diese Raten etwa das 2.0-Fache für die Hardwarekosten und das 1.9-Fache für die Energieeffizienz (Modellausgabe). Teilt man 280 durch 2.0, bleibt ein Faktor von etwa 141, den die Hardwarekosten nicht erklären. Dieser Rest mischt kleinere Modelle, algorithmische Effizienz, Auslastung und Margen, und die Quellen schlüsseln ihn nicht auf. Epoch AI schätzt gesondert, dass sich die für eine feste Leistung eines Sprachmodells nötige Rechenleistung etwa alle 8 Monate halbiert [58] und dass der Preis für ein festes Benchmarkniveau um das 9- bis 900-Fache pro Jahr fiel, mit einem Median nahe 50, wobei die schnellsten Raten auf weniger als einem Jahr an Daten beruhen [59].
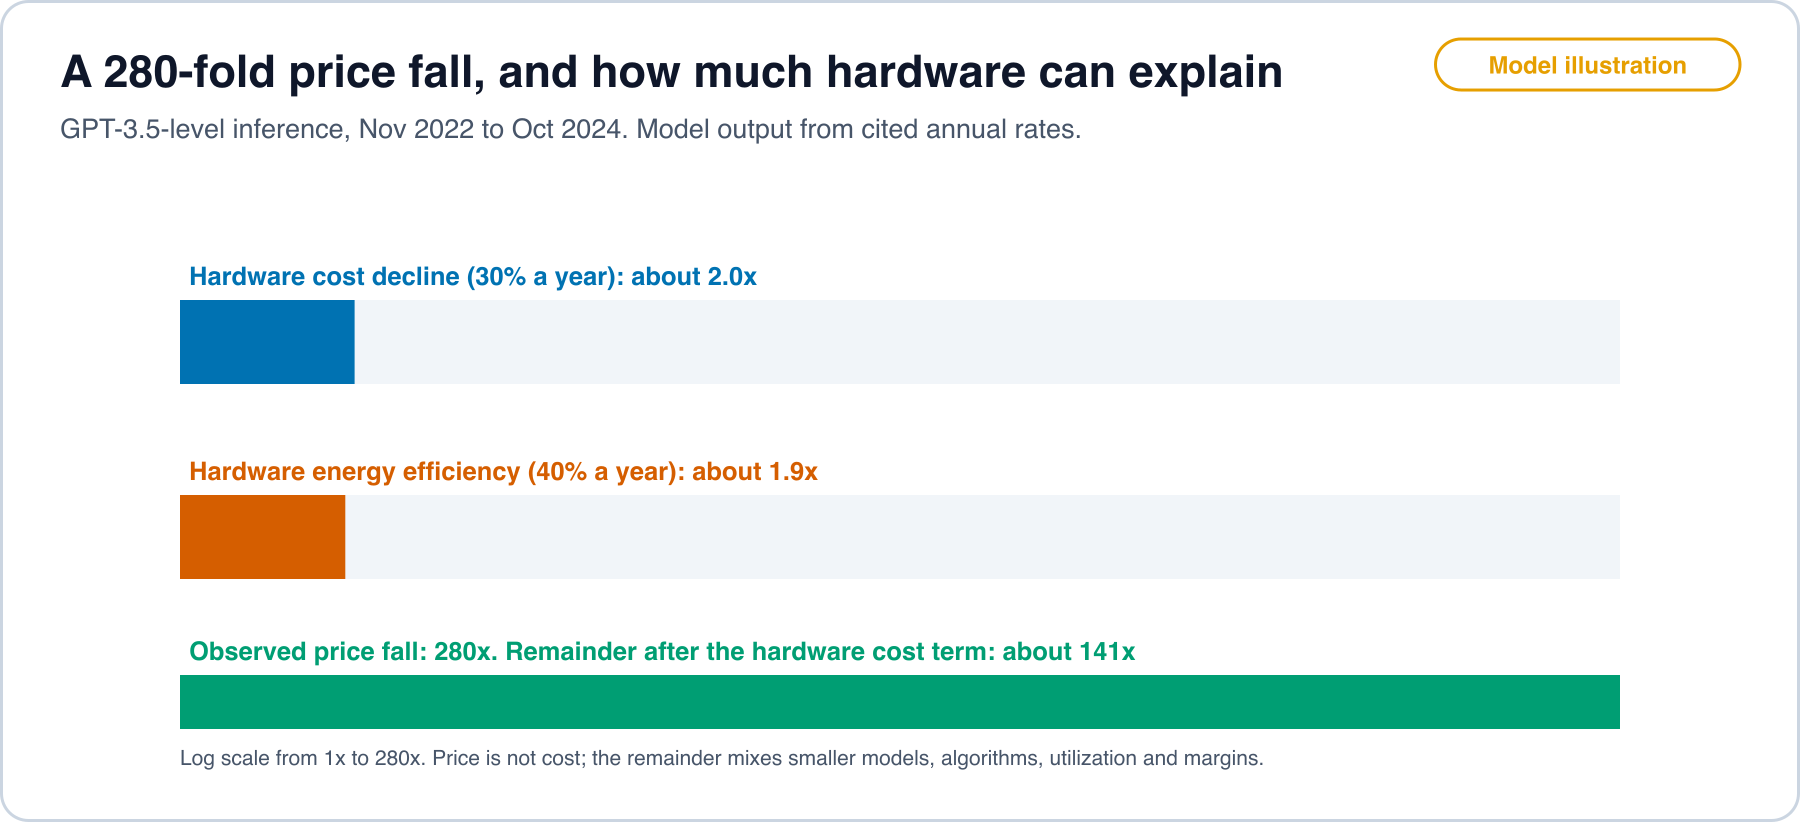
latency_data/model_outputs.json. Open full sizeVerknüpfung mit den Grenzen. Sei die niedrigste Beschleunigerzeit pro Aufgabe bei Qualität unter den dokumentierten Methoden und die Zeit in allgemein verfügbaren Produkten. Dann gilt für die Fähigkeitsgrenze, und die Einsatzgrenze folgt dem angebotenen Preis, der mindestens die Kosten plus die Marge aus Abschnitt 6 beträgt. Die Hardwarekosten gehen auf dieselbe Weise in und ein, weil Lieferanten und Käufer auf demselben Markt einkaufen, sodass sie beide Grenzen gemeinsam verschieben und nahezu unverändert lassen. Die Latenz wird durch den Softwareterm bewegt: Eine Methode, die die Beschleunigerzeit pro Aufgabe um einen Faktor senkt, senkt um diesen Faktor, sobald sie veröffentlicht ist, und erst, wenn ein Produkt sie übernimmt. Während der Wartezeit beträgt das Verhältnis der eingesetzten Kosten zu den Kosten an der Fähigkeitsgrenze .
Verknüpfung mit dem Taktmodell. Kapital wird in mehrjährigen Schritten zugesagt und über Nutzungsdauern von mehreren Jahren abgeschrieben, sodass die Entscheidungstermine für Hardware weit auseinanderliegen, und die Übernahmekosten aus Abschnitt 6 umfassen den Wert des installierten Kapitals, das eine neue Methode entwerten oder einsparen würde. Eine Methode, die auf Hardware läuft, die ein Unternehmen bereits besitzt, hat Übernahmekosten, die überwiegend Ingenieursarbeit sind. Eine Methode, die neue Hardware braucht, bringt den Kapitalzyklus mit sich. Deshalb sind offene Softwaremethoden auf vorhandenen Bauteilen am wenigsten durch Tore beschränkt, und deshalb vergleicht Vorhersage 3 Ziele mit und ohne Portierungswerkzeuge.
Wo die Kosten der Fähigkeit nicht mehr folgen. Bei fester Qualität fallen die Kosten pro Aufgabe mit , mit der Hardware und mit dem Preis. An der Fähigkeitsgrenze werden die Kosten pro Aufgabe vom Training und Betrieb der größten Modelle bestimmt und fallen nicht auf dieselbe Weise, weshalb eine Aufgabe in Spitzenqualität und eine Aufgabe fester Qualität unterschiedliche Kostenkurven haben. Die obigen Daten messen nur den ersten Fall.
Vorhersage 11 (ältere Bauteile verdienen weiter). Sind die angegebenen Servernutzungsdauern wirtschaftlich realistisch, fallen die Mietpreise pro Beschleunigerstunde für mehrere Jahre alte Bauteile langsamer, als es die Spitzenoperationen pro Watt nahelegen würden. Test: datierte offene Preislisten nach Bauteil und Alter, gegenüber der Effizienzanpassung in Abbildung 11. Widerlegt, wenn der Preis eines älteren Bauteils pro Einheit Spitzenoperationen mindestens so schnell fällt wie die Effizienzanpassung.
Vorhersage 12 (der Energieanteil bleibt klein). In einer Stichprobe gemessener Einsätze bleibt der Energieanteil an den Kosten pro Aufgabe bei Strompreisen unter 0.12 Dollar pro Kilowattstunde unter 15%. Test: offene Energiemessung der Inferenz [56], kombiniert mit ausgewiesenen Preisen für Beschleunigerstunden. Widerlegt, wenn der gemessene Anteil in der Mehrheit der Einsätze 15% übersteigt.
13. Offene Methoden und vorhandene Hardware auf Augenhöhe
Eine zweite Beschreibung der Gegenwart lautet, dass offene algorithmische Arbeit vorhandene und ältere Infrastruktur auf Augenhöhe mit der neuesten arbeiten lässt. Die datierte Überlieferung stützt eine engere Aussage, die hier nach dem Hebel, an dem jede Methode ansetzt, und nach dem Abstand bis zu einer ausgelieferten Nutzung dargelegt wird.
Tabelle 6. Offene Methoden, ihre datierten Artikel und was eine spätere Nutzung zeigt.
| Hebel | Offene Methode und was die Autoren berichten | Veröffentlicht | Spätere Nutzung | Abstand |
|---|---|---|---|---|
| Quantisierung | Modelle mit 175 Milliarden Parametern, in etwa vier GPU-Stunden auf 3 oder 4 Bit pro Gewicht quantisiert, bei vernachlässigbarem Genauigkeitsverlust [92] | Okt. 2022 | Lokale 4-Bit-Inferenz 2023 als auf Verbrauchermaschinen praktikabel berichtet [68] | Nicht berechnet: Die spätere Nutzung ist eine andere 4-Bit-Implementierung, und ihr Datum ist ein Beleg der Klasse Meinung |
| Ternäre Gewichte auf der CPU | Ein Modell mit 2 Milliarden Parametern bei 0.4 GB Speicher ohne Embeddings und 29 ms pro Token auf einer CPU, gegenüber 1.4 bis 4.8 GB und 41 bis 124 ms bei sechs offenen Modellen voller Genauigkeit ähnlicher Größe [26] | Apr. 2025 | Modellgewichte mit dem Artikel veröffentlicht | 0 Monate |
| Attention-Kernels | Exakte Attention, beschleunigt durch Berücksichtigung der Lese- und Schreibvorgänge zwischen Speicherebenen [19] | Mai 2022 | Beschleunigte Attention-Kernels in der Veröffentlichung von PyTorch 2.0 [20] | Etwa 10 Monate |
| Speicher beim Bereitstellen | Seitenweise organisierter Key-Value-Speicher in einem offenen Bereitstellungssystem, mit höherem Durchsatz als frühere Systeme bei gleicher Latenz [93] | Sep. 2023 | Quellcode mit dem Artikel veröffentlicht | 0 Monate |
| Zustandsraum- und Hybridmodelle | Ein Modell ohne Attention mit berichtetem 5-fachem Inferenzdurchsatz gegenüber Transformern [21]; ein Hybrid, der auf eine einzelne 80-GB-GPU passt, mit offenen Gewichten [22] | Dez. 2023 | Der Hybrid, März 2024; weitere Hybride 2024 und 2025 [39] | Etwa 3 bis 4 Monate |
| Spekulatives Dekodieren | Ausgabeverteilung unverändert bei 2- bis 3-mal schnellerem Dekodieren [23] | Nov. 2022 | Bis Dez. 2024 in Google-Produkten berichtet [24] | Etwa 24 Monate |
| Trainingskosten | 2.788 Millionen H800-GPU-Stunden für das vollständige Training, selbst berichtet [46]; Schlussfolgern durch bestärkendes Lernen mit destillierten kleineren Modellen [94] | Dez. 2024 bis Jan. 2025 | Kleinere destillierte Modelle mit dem zweiten Bericht veröffentlicht | Nicht anwendbar |
| Bereitstellen ohne NVIDIA | Prefill-Effizienz von 4.45 Token pro Sekunde pro TFLOPS auf Ascend-NPUs, über veröffentlichten Ergebnissen für SGLang auf H100 und DeepSeek auf H800, Leistungsaufnahme nicht berichtet [95] | Jun. 2025 | Einsatz durch die Autoren | Nicht anwendbar |
Die Abstände werden vom Veröffentlichungsmonat bis zum Datum der späteren Nutzung berechnet und beruhen auf einem Paar pro Zeile. Sie sind eine Stichprobe aus wenigen Fällen, keine Verteilung, und das Protokoll in Abschnitt 16 legt fest, wie viele gesammelt werden.
Offene Modelle gegenüber der geschlossenen Spitze, nach Trainingsrechenleistung. Nimmt man das erste nennenswerte Modell auf jeder Stufe der Trainingsrechenleistung, mit beliebigem Zugangstyp gegenüber offenen Gewichten, so betrug der Rückstand offener Gewichte 1 Monat bei FLOP, 30 Monate bei , 24 Monate bei und 15 Monate bei , und bei ist noch kein Modell mit offenen Gewichten verzeichnet [25]. Jede Stufe wird zuerst von einem Modell überschritten, sodass die Rückstände auf einem Paar pro Stufe beruhen. Die Richtung ist, dass der Rückstand mit steigender Stufe schrumpft, und der Vorbehalt ist, dass Trainingsrechenleistung keine Fähigkeit ist.
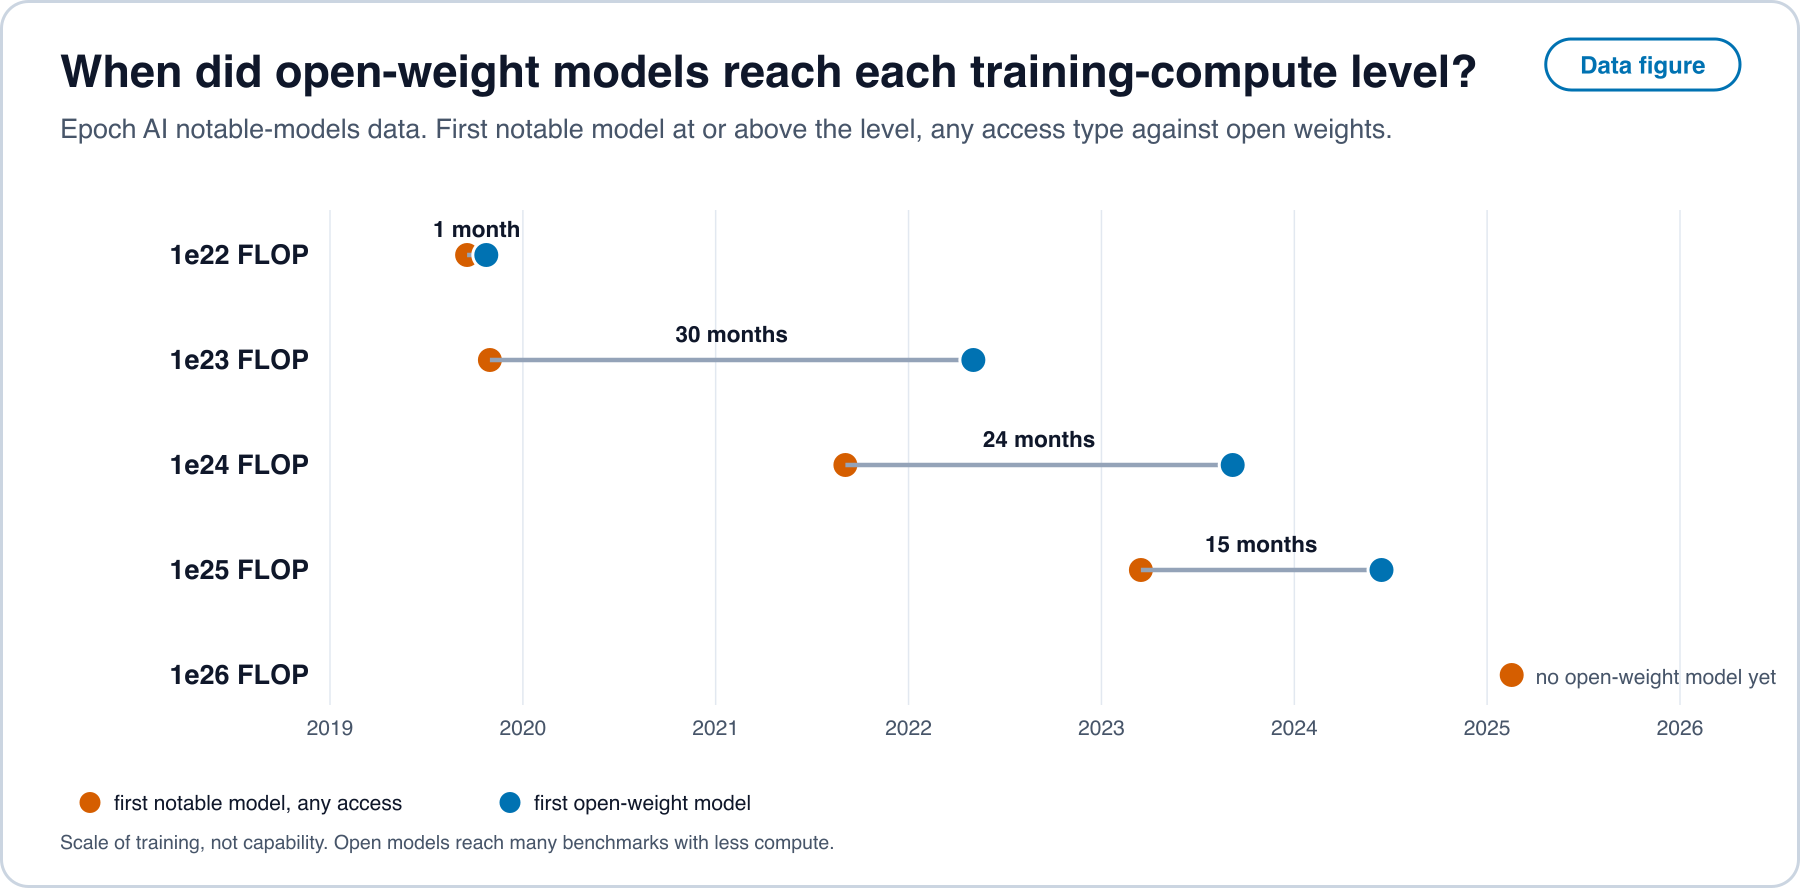
latency_data/compute_threshold_firsts.csv, aus dem Datensatz nennenswerter Modelle von Epoch AI [25]. Open full sizeAuf Verbraucherhardware holen offene Modelle, die auf eine einzelne Verbraucher-GPU passen, die Spitze je nach Maß im Durchschnitt nach 6 bis 12 Monaten ein [63]. Modelle mit offenen Gewichten jeder Größe liegen auf Benchmarks etwa ein Jahr hinter der geschlossenen Spitze, mit einer Spanne von 5 bis 22 Monaten [64].
Was Augenhöhe hier bedeutet. Sie bedeutet denselben Benchmarkwert. Sie bedeutet nicht denselben Durchsatz: Eine Verbraucherkarte bedient einen Datenstrom, und ein Rechenzentrum bedient viele, wobei Batching und Kernels eine Rolle spielen. Die Gewinne aus Quantisierung und Kernels gelten für beide. Die für eine feste Leistung nötige Rechenleistung halbiert sich etwa alle 8 Monate [58], was -fach pro Jahr ist, etwa doppelt so viel wie das 1.42-Fache pro Jahr der Hardwareeffizienz in Abbildung 11. Wo das gilt, läuft der algorithmische Fortschritt bei fester Qualität dem Hardwarefortschritt davon, und früher gekaufte Bauteile erzeugen mehr Aufgaben einer gegebenen Qualität als zuvor. Ob diese zusätzlichen Aufgaben zu niedrigeren Preisen verkauft oder in größerer Zahl nachgefragt werden, ist eine Frage der Nachfrage, die keine der Quellen hier klärt.
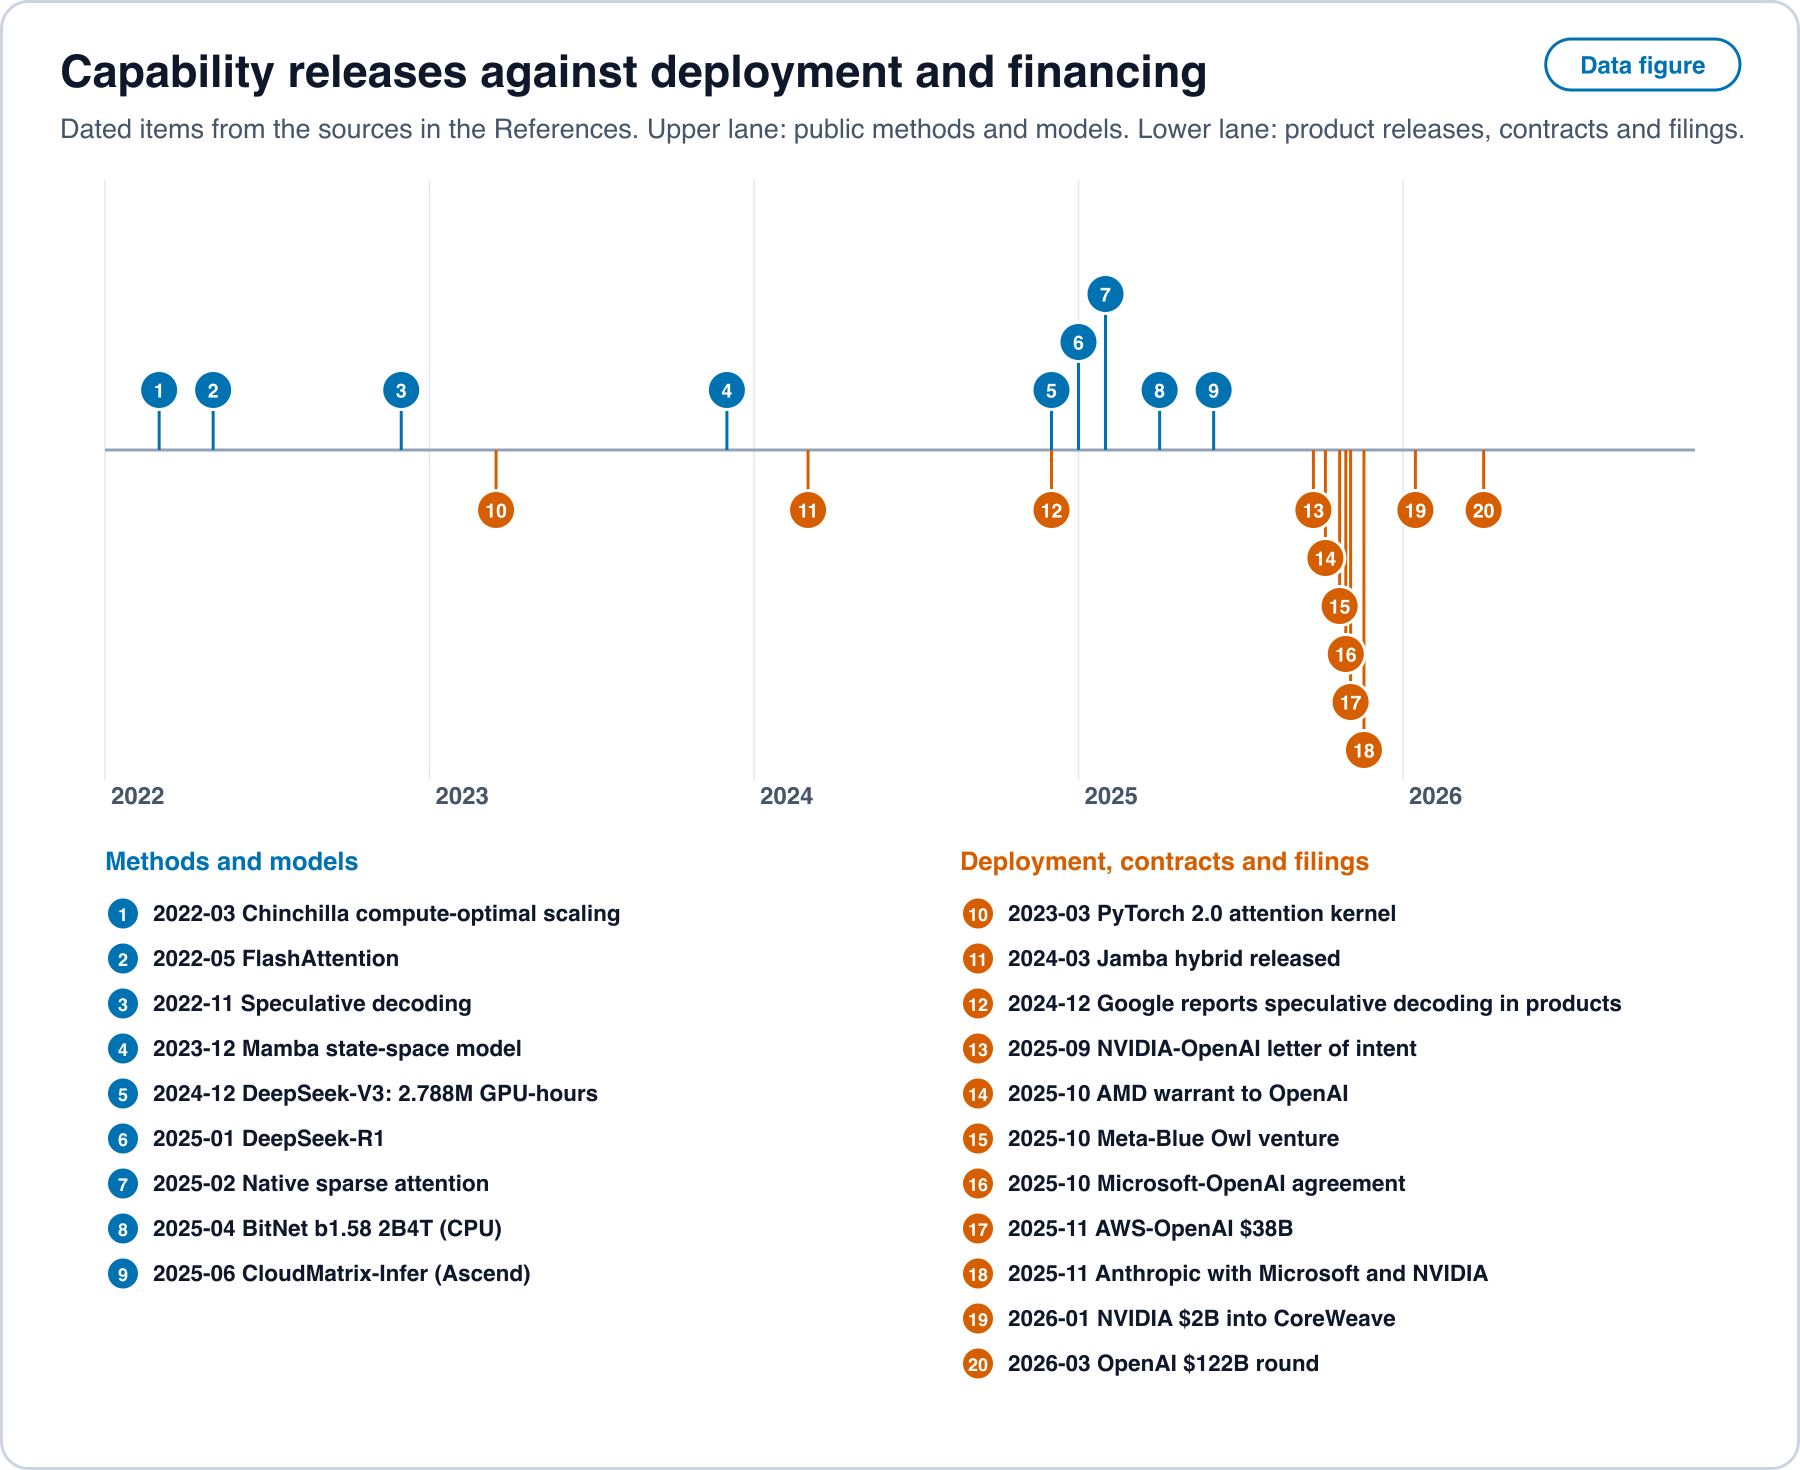
14. Andere Wege, die Maschine zu bauen
Eine dritte Beschreibung lautet, dass Gruppen, die Hardware mit orthogonalen Verfahren herstellen, einen Teil der Kosten herkömmlicher Infrastruktur als höher erweisen, als die Aufgabe erfordert. Die gelesenen Quellen enthalten datierte Demonstrationen analoger, photonischer, neuromorpher, FPGA-basierter, reiner CPU- und flexibler Elektronikdesigns. Sie unterscheiden sich in Aufgabe, Maßstab und Messung, daher berichtet dieser Abschnitt jede innerhalb ihres eigenen Artikels und zieht nur Verhältnisse heran, die ein Artikel selbst berichtet.
Tabelle 7. Alternative Designs, was gemessen wurde, und der Vorbehalt.
| Ansatz | Demonstration | Gemessen oder berichtet | Vorbehalt |
|---|---|---|---|
| Analog im Speicher | 35 Millionen Phasenwechselspeicher-Bauelemente über 34 Kacheln bei einer Sprach-Schlüsselwortaufgabe [96] | Bis zu 12.4 TOPS pro Watt dauerhaft auf dem Chip, Genauigkeit gleichwertig mit Software | Kleines Netz, keine passende Basislinie im gelesenen Text, daher wird kein Verhältnis gezogen |
| Photonisch | Ein photonischer KI-Prozessor bei einer Genauigkeit, die die Autoren für ResNet und BERT als praxistauglich darstellen [97] | Genauigkeit bei diesen Netzen | Keine Joule pro Aufgabe im gelesenen Text |
| Neuromorph | Ein MatMul-freies Modell mit 370 Millionen Parametern auf Loihi 2 [28] | Bis zum 3-fachen Durchsatz bei 2-mal weniger Energie als Transformer auf einer Edge-GPU | Vorläufig, kleines Modell |
| FPGA | FlightLLM auf einer Alveo-U280-Karte mit LLaMA2-7B, kompilierter Sparsität und Quantisierung [27] | Das 6.0- und 4.2-Fache der Energieeffizienz und das 1.8- und 1.4-Fache der Kosteneffizienz einer V100S und einer A100 | Vergleich und GPU-Konfiguration der Autoren |
| Ternäre Gewichte auf der CPU | BitNet b1.58 2B auf einer CPU [26] | 0.4 GB Speicher gegenüber 1.4 bis 4.8 GB und 29 ms gegenüber 41 bis 124 ms pro Token | Die Energie von 0.028 J pro Token ist mit einem arithmetischen Modell geschätzt, 6.6- bis 23-mal niedriger als bei den Basislinien, und wurde nicht an einem Leistungsmessgerät abgelesen |
| Alternativer Beschleuniger-Stack | Bereitstellen auf Ascend-NPUs [95] | 4.45 Token pro Sekunde pro TFLOPS im Prefill, über veröffentlichten Ergebnissen für H100 und H800 | Leistungsaufnahme nicht berichtet, daher wird kein Joule-Verhältnis gezogen |
| Flexibles Verfahren ohne Silizium | Ein 32-Bit-Arm-Mikroprozessor auf einem flexiblen Substrat [98] | Dass sich ein Universalprozessor mit einem Verfahren ohne Silizium herstellen lässt | Kein Ergebnis für maschinelles Lernen und keine Joule pro Aufgabe |
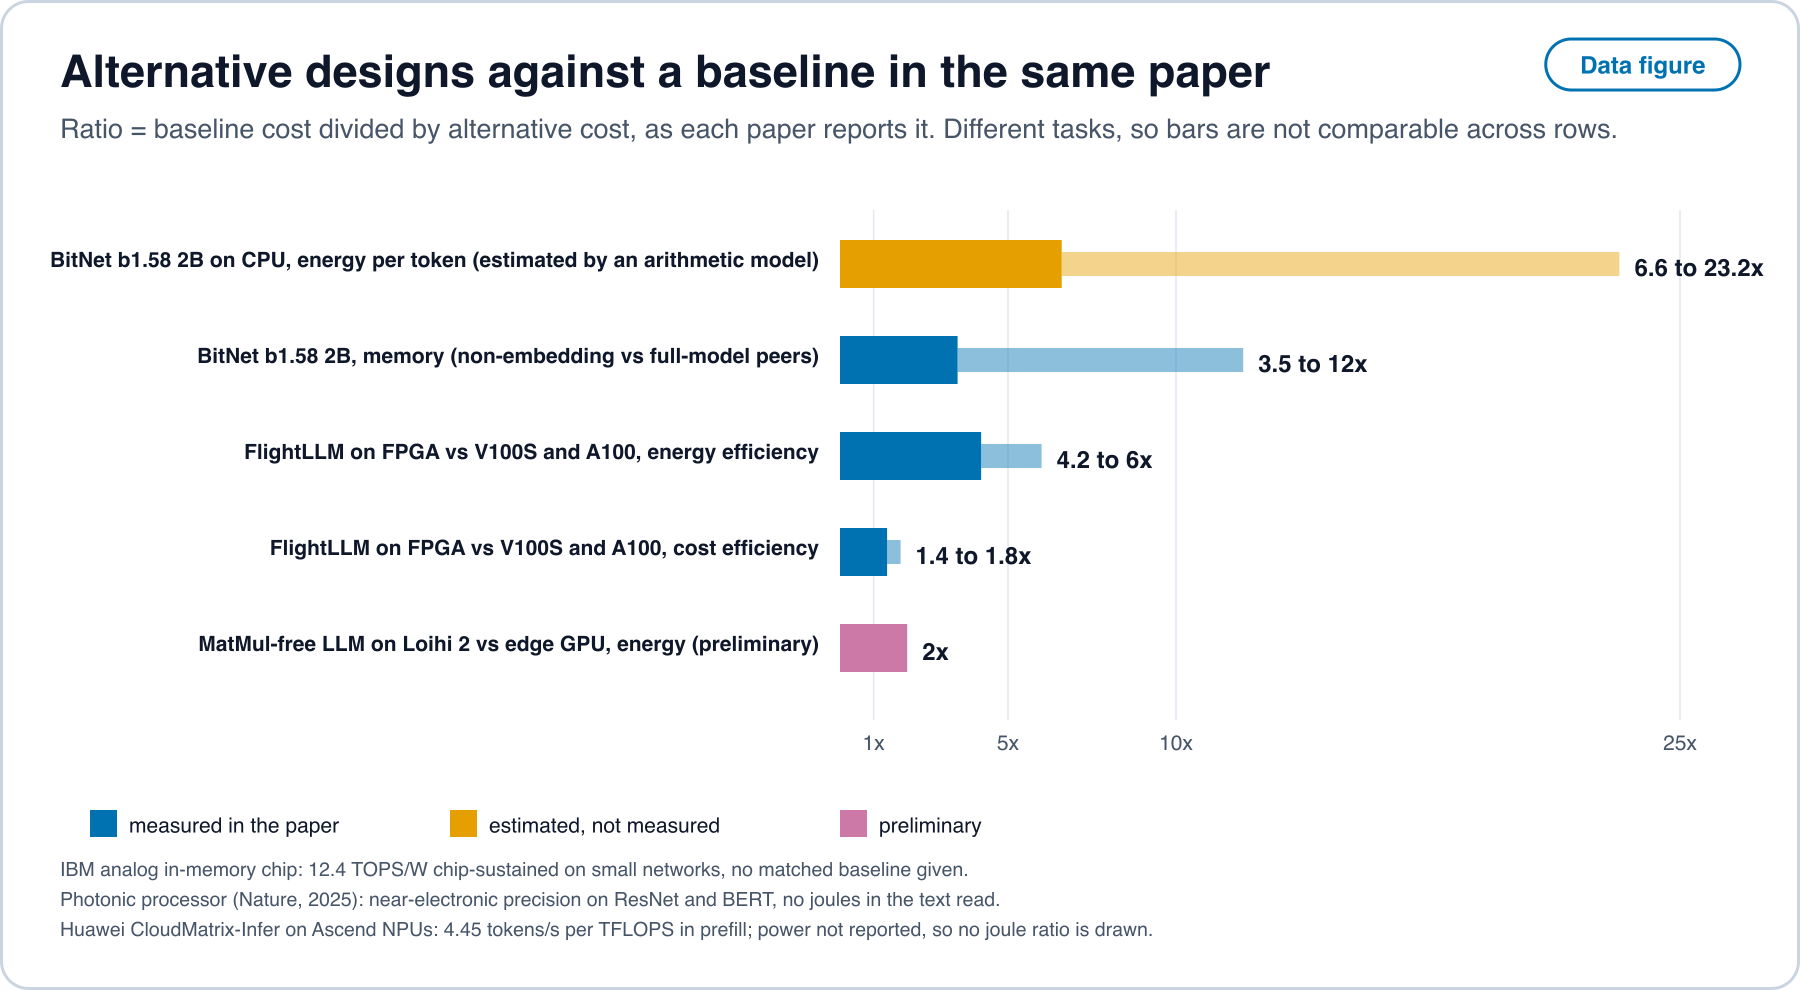
Was das stützt. Für bestimmte Aufgabenklassen, nämlich kleine Modelle, Einsatz am Netzrand, Dekodieren auf der CPU und sparse oder quantisierte Inferenz auf programmierbarer Logik, berichten die Autoren 2- bis 23-mal weniger Energie oder Speicher als eine herkömmliche Basislinie. Dies sind Verhältnisse innerhalb eines Artikels bei kleinen oder mittelgroßen Modellen. Die gelesenen Quellen enthalten keine Messung eines alternativen Designs, das ein Modell im Maßstab der Spitzenklasse bereitstellt, und keine zu Designs im Wafermaßstab oder auf ausgereiften Fertigungsknoten, daher zieht dieser Artikel für sie keine Schlussfolgerung.
Warum ein Energieverhältnis kein Kostenverhältnis ist. Nach Proposition 8 macht die Energie bei Rechenzentrumspreisen zwischen etwa 1.5% und 11.8% einer Beschleunigerstunde aus. Eine Alternative, die die Energie pro Aufgabe um den Faktor 10 senkt, senkt die Kosten pro Aufgabe höchstens um den Energieanteil, sofern sie nicht auch das Kapital pro Aufgabe senkt. Das Speicherergebnis des ternären Modells weist auf diesen zweiten Weg: Ein Modell, das 0.4 GB statt 1.4 bis 4.8 GB braucht, kann auf einem kleineren und billigeren Gerät laufen, und der Kapitaleffekt ist in den Quellen hier nicht gemessen. Wo der Strom nicht der dominierende Term ist, ist der nützliche Vergleich Dollar pro Aufgabe einschließlich Kapital, und keiner der gelesenen Artikel zu alternativer Hardware berichtet ihn, außer FlightLLM, dessen Verhältnisse der Kosteneffizienz die kleineren Zahlen in der Tabelle sind.
15. Wo Fähigkeit, Rechenleistung und Strom angesiedelt sind
Die Geografie des Ausbaus wird hier aus nationalen Statistiken, Ministerien und Behörden gelesen, in der Originalsprache, wo die Quelle nicht auf Englisch ist. Die Einheiten unterscheiden sich zwischen Ländern, daher werden die Zahlen nebeneinandergestellt und nicht in eine Rangfolge gebracht.
Rechenleistung und Strom. Im Rechenzentrumsdatensatz von Epoch AI summieren sich die ausgewiesenen Spitzenstandorte auf 14.1 GW, wovon die Vereinigten Staaten 84% halten, gefolgt von Malaysia mit 1.1 GW und China mit 0.7 GW [12]. Der Datensatz stützt sich auf öffentliche Genehmigungen und Bildaufnahmen, daher werden Standorte an Orten mit weniger öffentlicher Offenlegung eher übersehen. Chinas eigene Statistiken berichten eine andere Größe: 10.85 Millionen genutzte Standard-Racks und eine intelligente Rechenkapazität von 788 EFLOPS Ende Juni 2025 [99] sowie 1.59 Millionen PFLOPS (FP16) Ende 2025 [100]. Die beiden chinesischen Zahlen stammen aus verschiedenen Veröffentlichungen und beruhen möglicherweise auf unterschiedlichen Definitionen, und keine ist mit einer Angabe ausgewiesener Leistung vergleichbar. Beim Strom verbrauchten Rechenzentren 2024 etwa 415 TWh, 1.5% des Weltverbrauchs, davon 45% in den Vereinigten Staaten, 25% in China und 15% in Europa, und die Internationale Energieagentur projiziert als modelliertes Szenario eine Verdopplung auf etwa 945 TWh bis 2030 [101, 102].
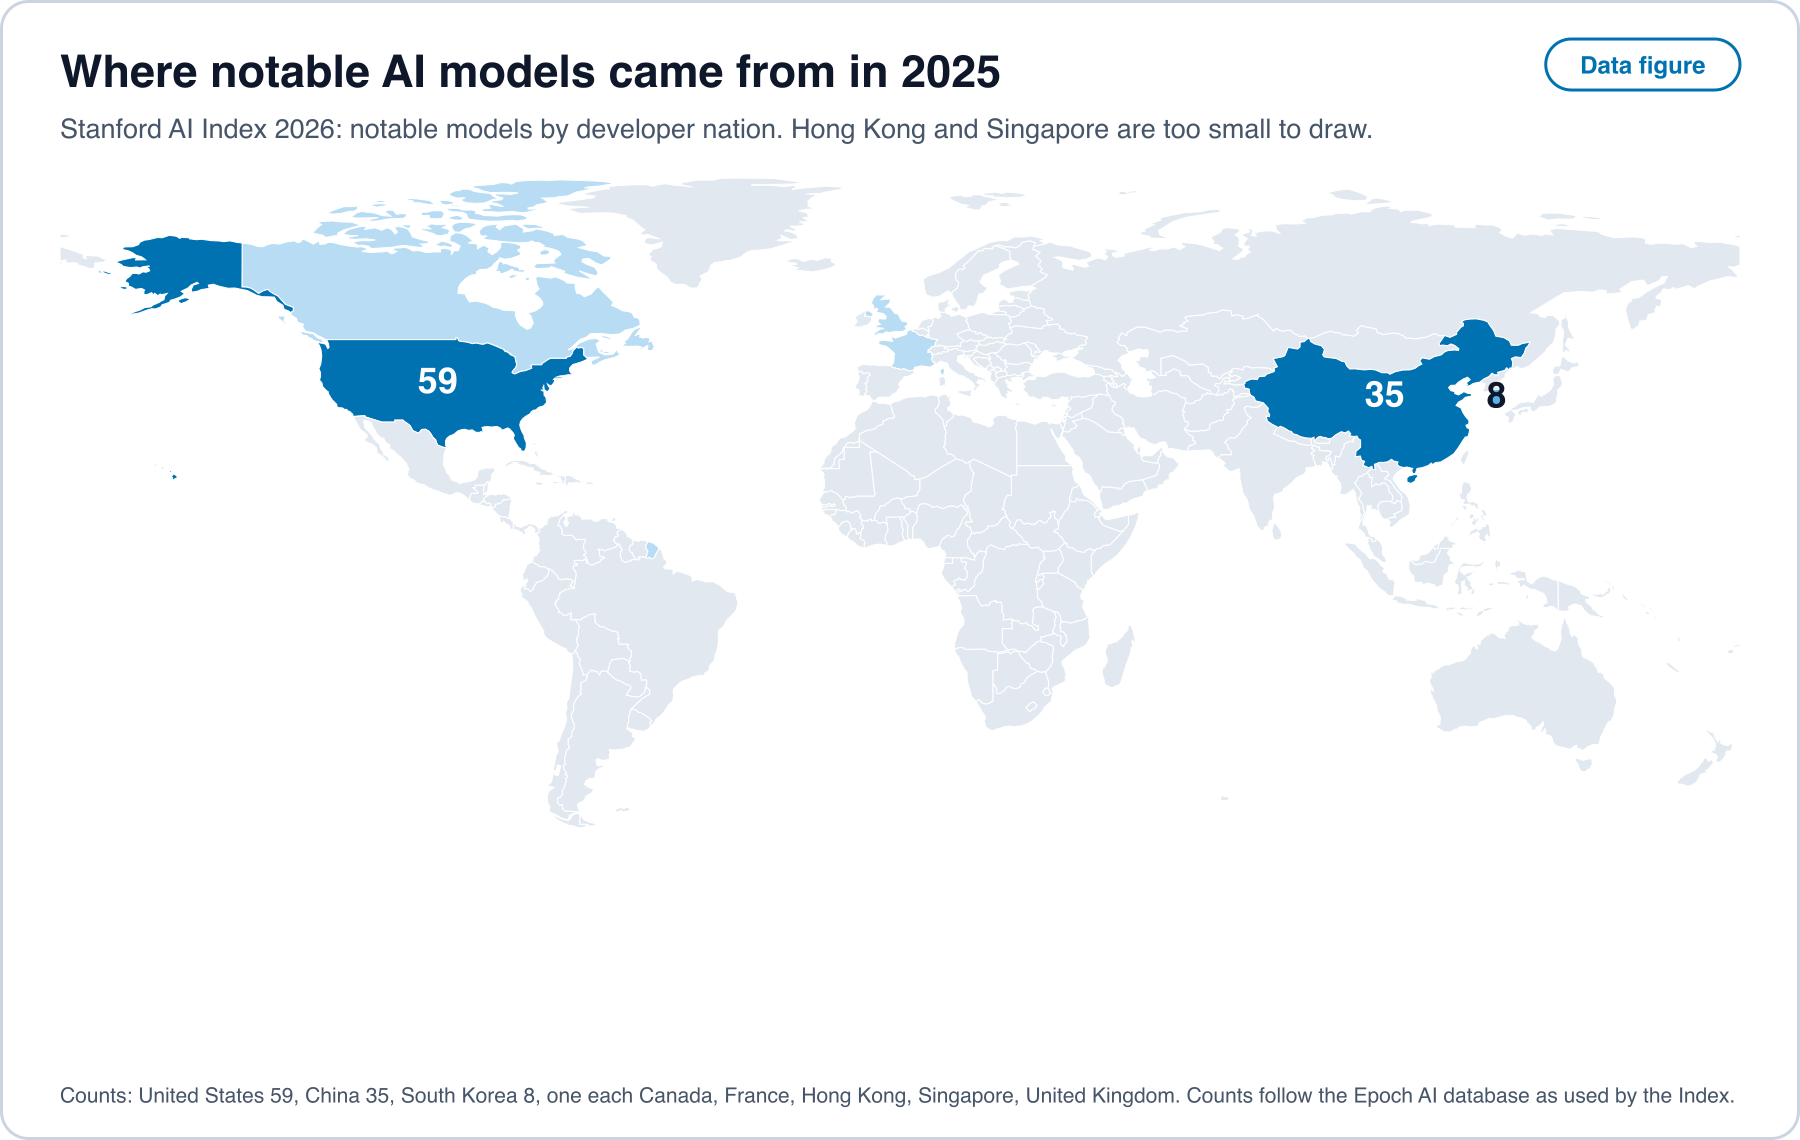
latency_data/frontier_dc_by_country.csv [12]. Open full sizeWoher die Modelle kommen. Von den nennenswerten Modellen des Jahres 2025 nach nationaler Zugehörigkeit des Entwicklers entfallen 59 auf die Vereinigten Staaten, 35 auf China und 8 auf Südkorea, mit einzelnen Modellen aus Kanada, Frankreich, Hongkong, Singapur und dem Vereinigten Königreich [29].
Chips. Bei den Beschleunigern im Hardwaredatensatz von Epoch ist TSMC für etwa vier von fünf der Einträge mit verzeichneter Fertigungsstätte als Auftragsfertiger verzeichnet, gefolgt von Samsung, SMIC und Intel, und bei mehr als einem Drittel aller Einträge ist die Fertigungsstätte nicht verzeichnet (latency_data/hardware_foundry_counts.json) [13]. Die gelesenen Quellen lieferten keine verwertbaren Zahlen zur Packaging-Kapazität oder zur Fertigungskapazität nach Ländern, daher zeichnet dieser Artikel keine Karte davon.
Nationale Programme. Programme geben ihre Größe in unterschiedlichen Einheiten an, und Tabelle 8 nennt jede wie angegeben.
Tabelle 8. Nationale Programme wie angegeben, mit der Sprache der Quelle.
| Ort | Angabe | Sprache | Klasse |
|---|---|---|---|
| China | Intelligente Rechenkapazität von 788 EFLOPS Ende Juni 2025 und 1.59 Millionen PFLOPS (FP16) Ende 2025 [99, 100] | Chinesisch | nachgewiesen |
| Südkorea | Regierungserklärung vom Oktober 2025 über die Sicherung von 260,000 NVIDIA-GPUs [103] | Koreanisch | Meinung |
| Japan | Mindestens 10 Billionen Yen öffentliche Förderung über die sieben Jahre bis zum Geschäftsjahr 2030, mit dem Ziel von mehr als 50 Billionen Yen privater Investitionen über zehn Jahre [104]; eine Marktstudie, nach der die Cloudinvestitionen in japanische Rechenzentren jedes Jahr voraussichtlich Hunderte Milliarden Yen oder mehr betragen [105] | Japanisch | Meinung |
| Europäische Union | 200 Milliarden Euro, die für KI mobilisiert werden sollen, mit einem Fonds von 20 Milliarden Euro für KI-Gigafabriken [106, 107] | Englisch und Italienisch | Meinung |
| Indien | 38,231 GPUs, die über das IndiaAI-Rechenportal eingebunden wurden, wie im März 2026 dem Parlament berichtet [108] | Englisch | nachgewiesen |
| Brasilien | R$ 23.03 Milliarden geplante Investitionen für 2024 bis 2028 [109] | Portugiesisch | Meinung |
| Vereinigte Arabische Emirate | Ein Rechencluster von 1 GW innerhalb eines geplanten Campus von 5 GW in Abu Dhabi [110] | Englisch | Meinung |
| Saudi-Arabien | Projizierte Kapazität von bis zu 500 MW über fünf Jahre [111] | Englisch | Meinung |
| Afrika | Eine KI-Fabrik im Aufbau in Südafrika, mit Plänen für Nigeria, Kenia, Ägypten und Marokko; keine Kapazitätsangabe [112] | Englisch | Meinung |
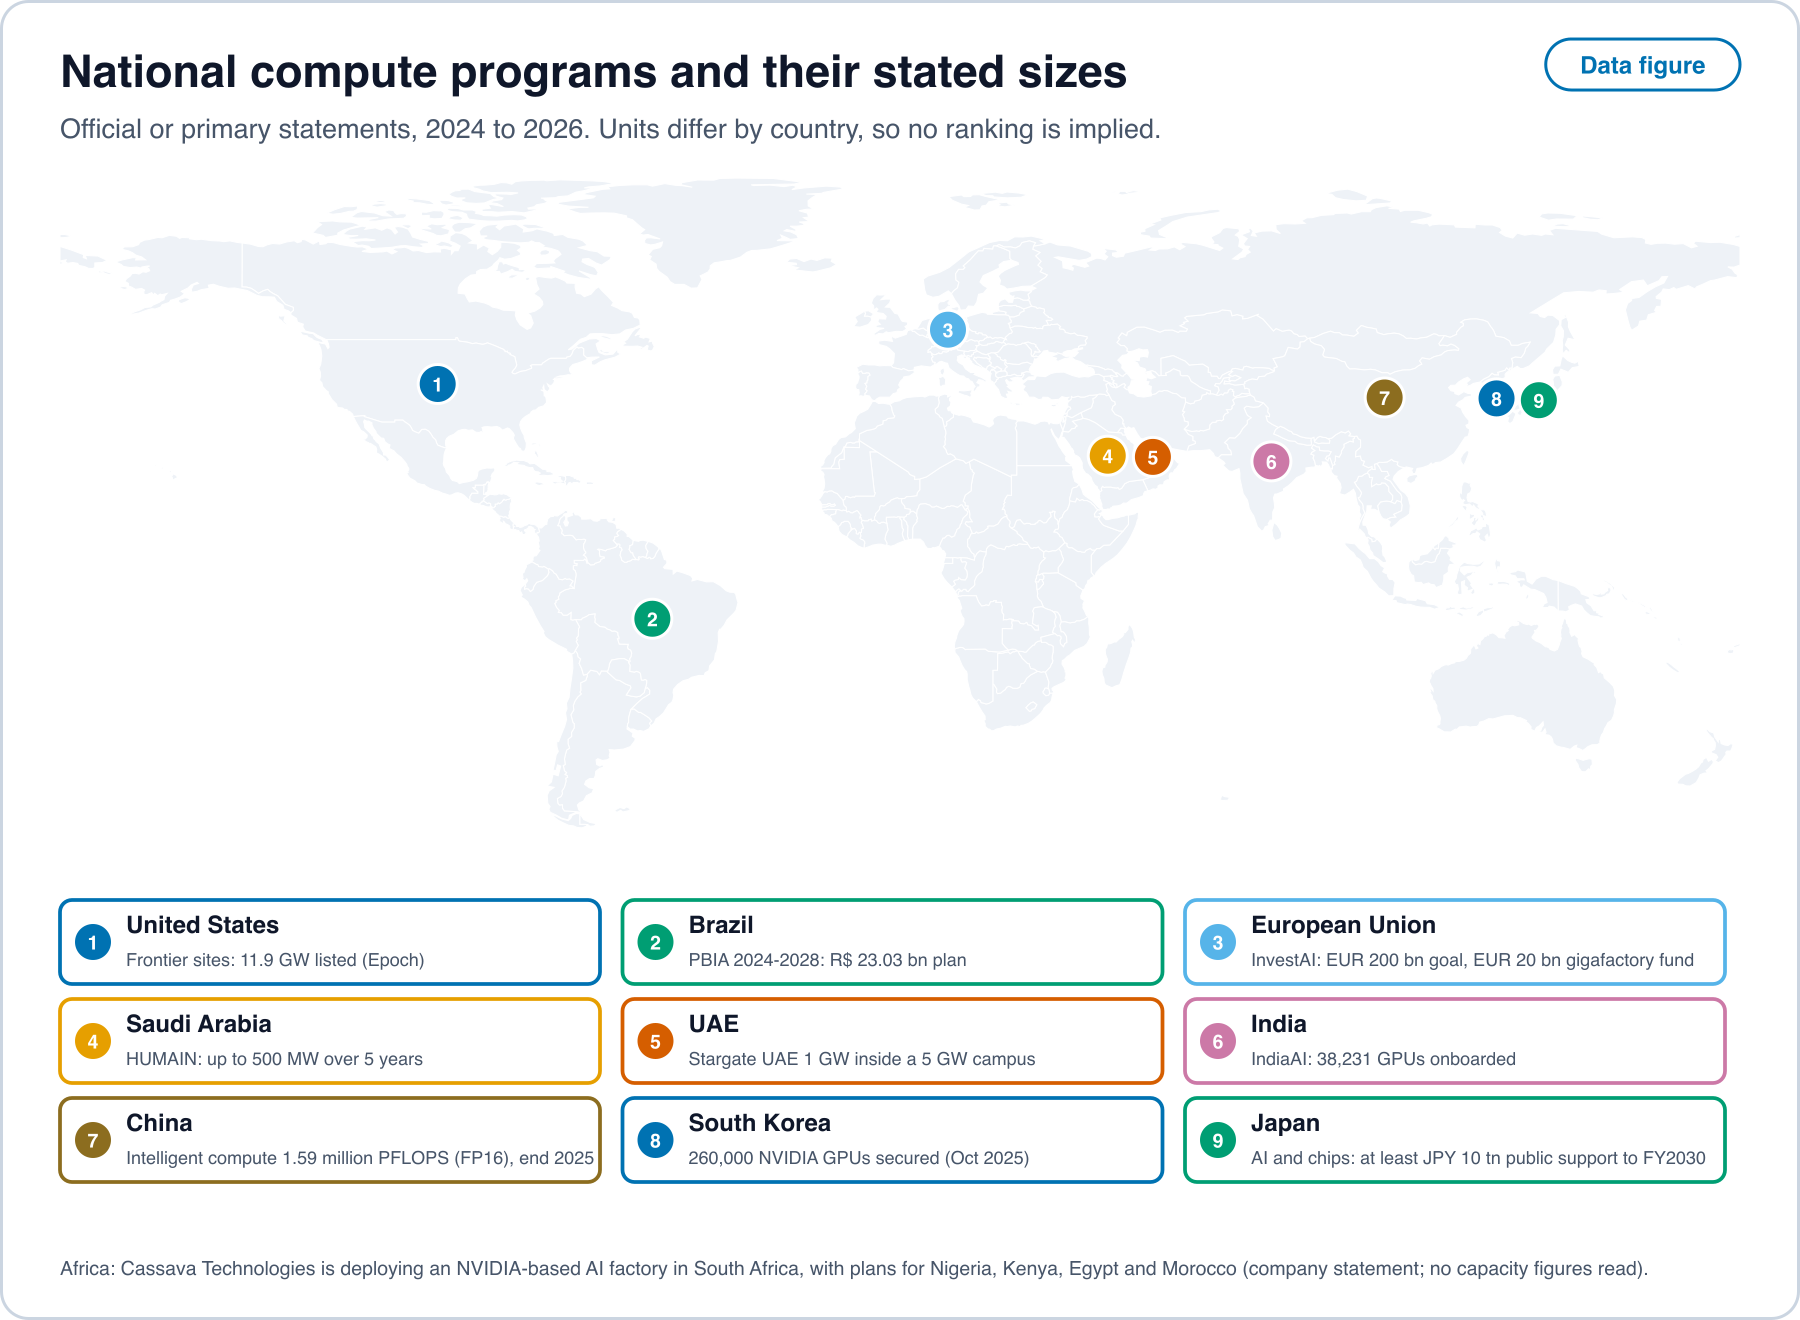
Angaben der Klasse Meinung sind Pläne und Ziele, und die Klasse nachgewiesen enthält berichtete Kapazitäten oder Statistiken. Die beiden Arten sollten nicht addiert werden.
Nutzung. Amtliche Erhebungen über Unternehmen, die KI nutzen, ergeben 32.9% in Südkorea im Jahr 2024, 26% in Deutschland im Jahr 2025, 21.1% in Spanien Anfang 2025, 20.0% in der Europäischen Union im Jahr 2025, 18% in den Vereinigten Staaten im Winter 2025 bis 2026, 13.9% für den OECD-Raum im Jahr 2024, 13% in Brasilien im Jahr 2024 und 10% in Frankreich im Jahr 2024, mit unterschiedlichen Jahren und Definitionen [30, 31, 32, 33, 34, 35, 36, 37]. Japan und China werden über Personen und nicht über Unternehmen gemessen [71, 72].
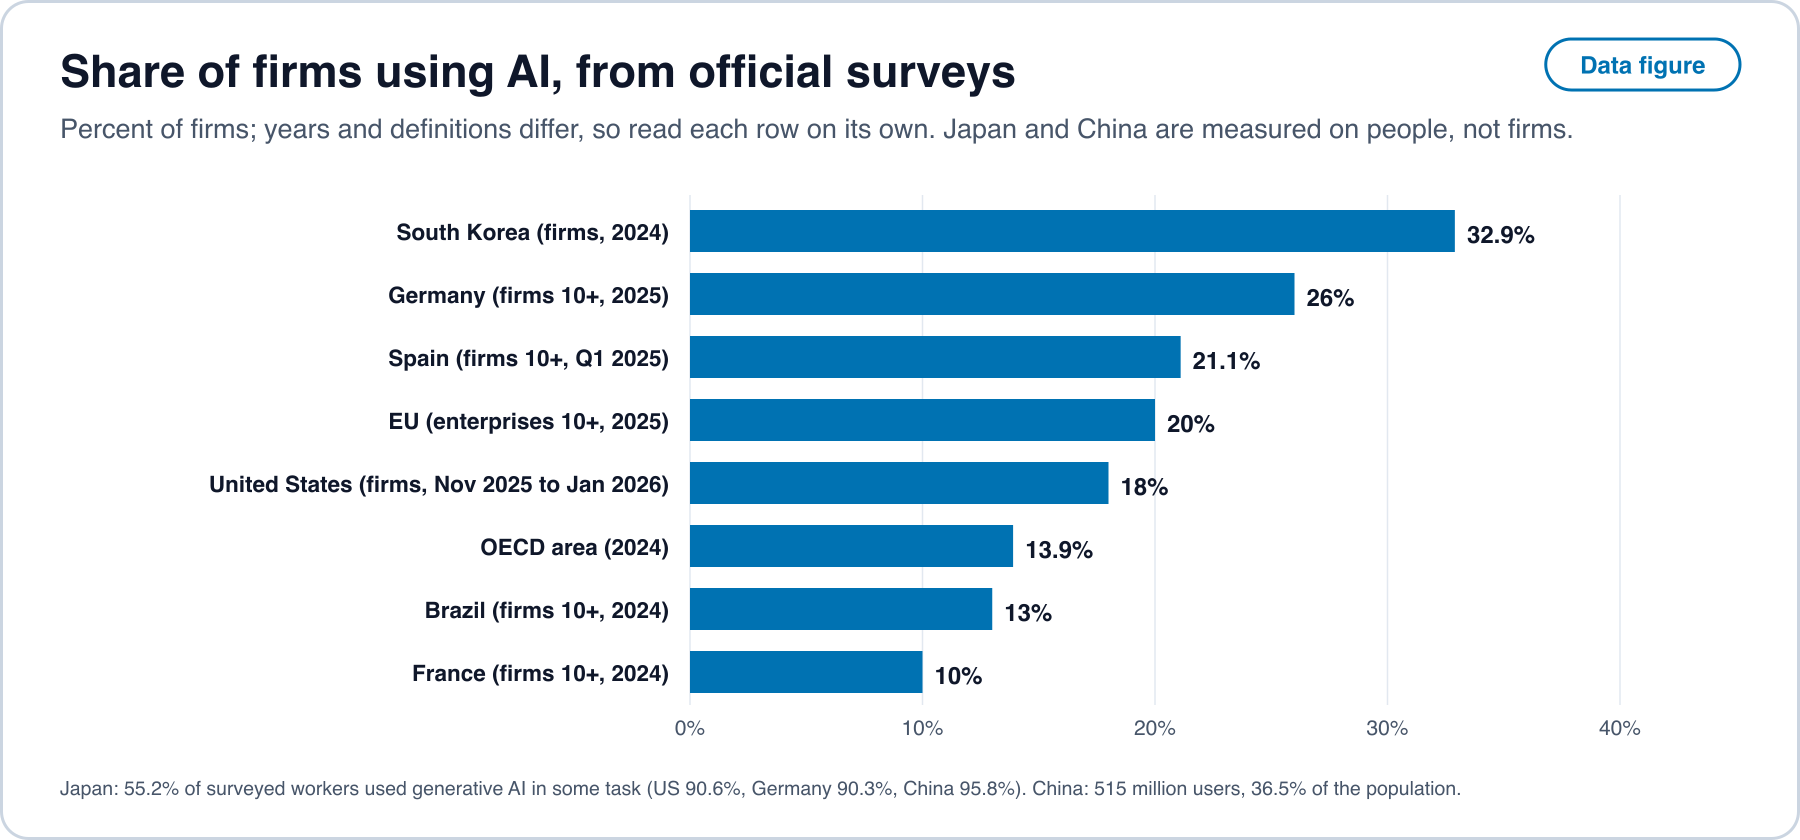
Was die Geografie zeigt. Die ausgewiesene Rechenleistung ist mit großem Abstand auf ein Land konzentriert, während veröffentlichte Modelle und amtliche Kapazitätsangaben ein zweites Land mit einem großen Anteil an Modellen und einer großen angegebenen Kapazität zeigen, das Datensätze ausgewiesener Leistung schlecht erfassen können. Programme anderswo nennen Pläne im Maßstab von Gigawatt oder Hunderten Milliarden, und die gemessene Nutzung von KI durch Unternehmen liegt in den gelesenen Erhebungen zwischen 10% und 33%. Die Lücke zwischen Plänen und gemessener Nutzung ist die Lücke, die dieser Artikel untersucht, nun im nationalen Maßstab.
16. Versuchsprotokoll (nicht durchgeführt)
Zweck. und seine drei Teile für eine Liste von Methoden messen, nur anhand öffentlicher Daten.
Einheit. Eine Methode, etwa ein Zahlenformat, ein Kernel, ein Inferenzverfahren oder ein Compilerdurchlauf, mit einer datierten öffentlichen Beschreibung.
Für jede Methode zu erhebende Daten. Die früheste öffentliche Veröffentlichung (Preprint oder Repository), die früheste offene Implementierung, die früheste Veröffentlichung in einer weit verbreiteten offenen Bibliothek und die früheste allgemein verfügbare Veröffentlichung in mindestens einem kommerziellen Produkt, mit dem Unternehmenstyp (börsennotiert, privat, öffentlicher Sektor, akademisch). Jedes Datum wird mit seinem Quellenlink und einer Archivkopie festgehalten.
Stichprobe. Alle Methoden einer vorab registrierten Liste, die aus einer festen Menge von Publikationsorten und Repositories über 2022 bis 2026 gezogen wird, einschließlich nicht englischsprachiger Publikationsorte und Repositories, wobei die Auswahlregel festgeschrieben wird, bevor irgendein Freigabedatum nachgeschlagen wird.
Analyse. pro Methode berechnen. mit den Phasentests aus Vorhersage 1 und durch Vergleich der mittleren Verzögerung mit schätzen. Den Torteil als Differenz zwischen börsennotierten und nicht börsennotierten Unternehmen schätzen (Vorhersage 2). Mediane mit Bootstrap-Intervallen berichten und berichten, welcher Anteil der Methoden nie ein Produkt erreicht.
Energie. Wo eine Methode Joule pro Aufgabe berichtet, die Messbedingungen festhalten, und wo nicht, sie auf einem offenen Energiemessaufbau wie dem in Tabelle 1 zitierten ausführen und die gemessenen Joule berichten.
Finanzierung und Kosten. Aus Pflichtmeldungen die Schranke aus Definition 4 für jeden Lieferanten und jedes Geschäftsjahr berechnen, den kapitalbelasteten Preis eines Joule aus ausgewiesenen Preisen für Beschleunigerstunden und gemessener Leistung und das Verhältnis der vertraglich vereinbarten Käufe zum zurückliegenden Umsatz für jedes Labor, und jedes mit der Pflichtmeldung und der Seite festhalten, aus der es stammt. Das Abbildungsskript scripts/figures/latency_figures.py und die Datendateien unter scripts/figures/latency_data/ reproduzieren jede Abbildung in den Abschnitten 9 bis 15 aus den zitierten Quellen.
Ergebnisse. Eine Tabelle der Daten, ein Analyseskript und ein Protokoll der Ausschlüsse. Die Skripte und Daten sollen mit der Studie zu denselben Bedingungen wie diese Website veröffentlicht werden.
17. Fazit
Öffentliche Methoden, die die Kosten von Computerintelligenz senken, erreichen Produkte nach einer Verzögerung mit einem technischen, einem kalendarischen und einem anreizbedingten Teil. Der erste ist Ingenieurszeit. Der zweite ist die Struktur der Entscheidungstermine, die bei einem Quartalskalender im Mittel etwa sechs Wochen hinzufügt (Proposition 1). Der dritte tritt auf, wenn eine Berichtsregel eine Freigabe blockiert, die sich langfristig lohnt (Proposition 3). Ein Werkzeug, das die Kosten der Übernahme einer Methode senkt, beseitigt den dritten, sobald die Kosten unter eine angegebene Schranke fallen, und ein Werkzeug, das die Kosten der Arbeit selbst senkt, erzwingt die Freigabe, wenn das Festhalten nichts einbringt (Proposition 4). Hat der Markt mehrere Anbieter, die bei geringer Reibung erreichbar sind, bestimmt der schnellste die Latenz (Proposition 5). Wenn die Kosten des Rechnens fallen, hängt die verbleibende Marge von der Wechselreibung ab (Proposition 6). Die Belege zur Infrastruktur fügen Folgendes hinzu. Pflichtmeldungen belegen Kreisläufe von zig Milliarden Dollar zwischen benannten Lieferanten und Kunden, und sie beschränken den Anteil des Umsatzes des größten Chiplieferanten, den sein eigenes Kapital hätte finanzieren können, auf unter ein Fünftel, während die meisten Ausgaben der Hyperscaler aus dem operativen Cashflow bezahlt werden. Bei Rechenzentrumspreisen ist die Energie ein kleiner Teil einer Beschleunigerstunde und das Kapital der große Teil, sodass die Kosten pro Aufgabe der Beschleunigerzeit pro Aufgabe, der Auslastung und der angegebenen Nutzungsdauer der Maschine folgen. Offene Methoden und alternative Designs senken in den eigenen Messungen der Autoren die Beschleunigerzeit, den Speicher oder die Energie pro Aufgabe, für kleine und mittelgroße Modelle, und keine gelesene Quelle misst sie im Maßstab der Spitzenklasse. Fähigkeit, Rechenleistung und Strom sind ungleich verteilt, und nationale Pläne werden in Größenordnungen angegeben, die weit über der gemessenen Nutzung liegen. Die Propositionen sind ein Modell, und die Vorhersagen nennen die Pflichtmeldungen, Preislisten und Messungen, die jede von ihnen widerlegen würden.
Literatur
Each entry ends with its evidence class (Section 1).
- Meta, joint venture with funds managed by Blue Owl Capital to develop the Hyperion data center. 2025-10-21. https://investor.atmeta.com/investor-news/press-release-details/2025/Meta-Announces-Joint-Venture-with-Funds-Managed-by-Blue-Owl-Capital-to-Develop-Hyperion-Data-Center/default.aspx (opinion)
- Meta Platforms, Quarterly Report on Form 10-Q, period ended 30 September 2025. 2025-10-30. https://www.sec.gov/Archives/edgar/data/1326801/000162828025047240/meta-20250930.htm (demonstrated)
- NVIDIA, Annual Report on Form 10-K, fiscal year ended 25 January 2026. 2026-02-25. https://www.sec.gov/Archives/edgar/data/1045810/000104581026000021/nvda-20260125.htm (demonstrated)
- CoreWeave, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-03-02. https://www.sec.gov/Archives/edgar/data/1769628/000176962826000104/crwv-20251231.htm (demonstrated)
- Oracle, Quarterly Report on Form 10-Q, period ended 31 August 2026. 2026-09-11. https://www.sec.gov/Archives/edgar/data/1341439/000119312626389274/orcl-20260831.htm (demonstrated)
- Oracle, Q1 FY27 results (Exhibit 99.1 to Form 8-K). 2026-09-10. https://www.sec.gov/Archives/edgar/data/1341439/000119312626387905/orcl-20260910.htm (demonstrated)
- Microsoft, Quarterly Report on Form 10-Q, period ended 30 September 2025, Note 17. 2025-10-29. https://www.sec.gov/Archives/edgar/data/789019/000119312525256321/msft-20250930.htm (demonstrated)
- OpenAI and Amazon Web Services, partnership announcement. 2025-11-03. https://openai.com/index/aws-and-openai-partnership/ (opinion)
- CNBC, OpenAI closes record-breaking 122 billion dollar funding round. 2026-03-31. https://www.cnbc.com/2026/03/31/openai-funding-round-ipo.html (opinion)
- Microsoft, NVIDIA and Anthropic, strategic partnerships announcement. 2025-11-18. https://blogs.microsoft.com/blog/2025/11/18/microsoft-nvidia-and-anthropic-announce-strategic-partnerships/ (opinion)
- U.S. Securities and Exchange Commission, XBRL company concept API (annual capital expenditure and operating cash flow, seven filers). 2026-10. https://data.sec.gov/api/xbrl/companyconcept/ (demonstrated)
- Epoch AI, Frontier Data Centers dataset (CC BY). 2026-10. https://epoch.ai/data/data-centers (demonstrated)
- Epoch AI, Machine Learning Hardware dataset (CC BY). 2026-10. https://epoch.ai/data/machine-learning-hardware (demonstrated)
- Amazon, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-06. https://www.sec.gov/Archives/edgar/data/1018724/000101872426000004/amzn-20251231.htm (demonstrated)
- Meta Platforms, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-01-29. https://www.sec.gov/Archives/edgar/data/1326801/000162828026003942/meta-20251231.htm (demonstrated)
- Alphabet, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-05. https://www.sec.gov/Archives/edgar/data/1652044/000165204426000018/goog-20251231.htm (demonstrated)
- Microsoft, Annual Report on Form 10-K, fiscal year ended 30 June 2026. 2026-07-29. https://www.sec.gov/Archives/edgar/data/789019/000119312626323660/msft-20260630.htm (demonstrated)
- Stanford HAI, AI Index Report 2025. 2025-04. https://hai.stanford.edu/assets/files/hai_ai_index_report_2025.pdf (demonstrated)
- Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. 2022-05-27. https://arxiv.org/abs/2205.14135 (demonstrated)
- PyTorch, PyTorch 2.0 release announcement. 2023-03-15. https://pytorch.org/blog/pytorch-2-0-release/ (opinion)
- Gu and Dao, Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023-12-01. https://arxiv.org/abs/2312.00752 (demonstrated)
- Lieber et al., Jamba: A Hybrid Transformer-Mamba Language Model. 2024-03-28. https://arxiv.org/abs/2403.19887 (demonstrated)
- Leviathan, Kalman, Matias, Fast Inference from Transformers via Speculative Decoding. 2022-11-30 (ICML 2023). https://arxiv.org/abs/2211.17192 (established by proof in the source)
- Google Research, Looking back at speculative decoding. 2024-12-06. https://research.google/blog/looking-back-at-speculative-decoding/ (opinion)
- Epoch AI, Notable AI Models dataset (CC BY). 2026-10. https://epoch.ai/data/notable-ai-models (demonstrated)
- Ma et al., BitNet b1.58 2B4T Technical Report. 2025-04-16. https://arxiv.org/abs/2504.12285 (demonstrated)
- Zeng et al., FlightLLM: Efficient Large Language Model Inference with a Complete Mapping Flow on FPGAs. 2024-01-08. https://arxiv.org/abs/2401.03868 (demonstrated)
- Abreu et al., Neuromorphic Principles for Efficient Large Language Models on Intel Loihi 2. 2025-03. https://arxiv.org/abs/2503.18002 (demonstrated)
- Stanford HAI, AI Index Report 2026, research and development chapter. 2026-04. https://hai.stanford.edu/ai-index/2026-ai-index-report (demonstrated)
- (Korean) Electronic Times, reporting the 2025 Enterprise Informatization Statistics of the Ministry of Science and ICT and NIA. 2026-01-20. https://www.etnews.com/20260120000071 (demonstrated)
- (German) Statistisches Bundesamt, Unternehmen mit Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen (table, 2025). 2025. https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-unternehmen-kuenstliche-intelligenz.html (demonstrated)
- (Spanish) Instituto Nacional de Estadística, Encuesta sobre el uso de TIC y del comercio electrónico en las empresas, nota de prensa. 2025-10-22. https://ine.es/dyngs/Prensa/ETICCE20241T2025.pdf (demonstrated)
- Eurostat, 20% of EU enterprises use AI technologies. 2025-12-11. https://ec.europa.eu/eurostat/documents/7870049/23260410/KS-01-26-009-EN-N.pdf (demonstrated)
- Bonney et al., The Microstructure of AI Diffusion (Census CES-WP-26-25). 2026-04. https://www.census.gov/library/working-papers/2026/adrm/CES-WP-26-25.html (demonstrated)
- OECD, Emerging divides in the transition to artificial intelligence. 2025-06. https://www.oecd.org/content/dam/oecd/en/publications/reports/2025/06/emerging-divides-in-the-transition-to-artificial-intelligence_eeb5e120/7376c776-en.pdf (demonstrated)
- (Portuguese) Cetic.br/NIC.br, Pesquisa TIC Empresas 2024, resumo executivo. 2025-05. https://www.nic.br/media/docs/publicacoes/2/20250512121759/tic_empresas_2024_resumo_executivo.pdf (demonstrated)
- (French) Insee, Les technologies de l’information et de la communication dans les entreprises en 2024, Insee Première n° 2061. 2025-07. https://www.insee.fr/fr/statistiques/fichier/8604126/ip2061.pdf (demonstrated)
- Dao and Gu, Transformers are SSMs (Mamba-2, state space duality). 2024-05-31. https://arxiv.org/abs/2405.21060 (established by proof in the source)
- Lieber et al. (Jamba); NVIDIA (Nemotron-H); TII (Falcon-H1); IBM (Granite 4.0). 2024 to 2025. https://arxiv.org/abs/2504.03624 (demonstrated)
- Ma et al., The Era of 1-bit LLMs (BitNet b1.58). 2024-02-27. https://arxiv.org/abs/2402.17764 (demonstrated)
- NVIDIA, Pretraining Large Language Models with NVFP4. 2025-09. https://arxiv.org/abs/2509.25149 (demonstrated)
- Shah et al., FlashAttention-3. 2024-07. https://arxiv.org/abs/2407.08608 (demonstrated)
- Yuan et al., Native Sparse Attention. 2025-02 (ACL 2025). https://arxiv.org/abs/2502.11089 (demonstrated)
- Hoffmann et al., Training Compute-Optimal Large Language Models. 2022-03-29. https://arxiv.org/abs/2203.15556 (demonstrated)
- Sardana et al., Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling. 2024-01 (ICML 2024). https://arxiv.org/abs/2401.00448 (demonstrated)
- DeepSeek-AI, DeepSeek-V3 Technical Report. 2024-12-26. https://arxiv.org/abs/2412.19437 (demonstrated)
- Angelopoulos, Barber, Bates, Theoretical Foundations of Conformal Prediction. 2024-11-18 (v5 2026-03-06). https://arxiv.org/abs/2411.11824 (established by proof in the source)
- Zhou, Chen, Gui and Cheng, Conformal Prediction: A Data Perspective. 2024-10 (arXiv 2410.06494; ACM Computing Surveys 2025). https://arxiv.org/abs/2410.06494 (opinion)
- Angelopoulos et al., Prediction-powered inference. 2023 (Science). https://www.science.org/doi/10.1126/science.adi6000 (established by proof in the source)
- Ramdas, Grunwald, Vovk, Shafer, Game-Theoretic Statistics and Safe Anytime-Valid Inference. 2023-11 (Statistical Science 38(4)). https://doi.org/10.1214/23-sts894 (established by proof in the source)
- Chernozhukov et al., Double/debiased machine learning. 2018 (Econometrics Journal). https://doi.org/10.1111/ectj.12097 (established by proof in the source)
- Jung, Tian, Bareinboim, Estimating Identifiable Causal Effects through Double Machine Learning. 2021 (AAAI). https://doi.org/10.1609/aaai.v35i13.17438 (established by proof in the source)
- Sathia et al., Compiler Optimizations for Higher-Order Automatic Differentiation. 2025 (PPoPP workshop). https://ece.is/assets/pdf/diffprog-ppopp25-paper90.pdf (demonstrated)
- Ward et al., JAX a la Stan. 2026-10-11. https://bob-carpenter.github.io/dj-paper/template-computo-python.pdf (opinion)
- Qian et al., Impulse: probabilistic programming via compiler augmentation. 2026 (abstract). https://ece.is/assets/pdf/impulse-pldi-src-abstract.pdf (demonstrated)
- Chung et al., The ML.ENERGY Benchmark. 2025 (NeurIPS Datasets and Benchmarks). https://ml.energy/leaderboard/ (demonstrated)
- Google, Measuring the environmental impact of delivering AI at Google Scale. 2025-08. https://arxiv.org/abs/2508.15734 (demonstrated)
- Ho et al. (Epoch AI), Algorithmic progress in language models. 2024-03 (NeurIPS 2024). https://arxiv.org/abs/2403.05812 (demonstrated)
- Epoch AI, LLM inference prices have fallen rapidly but unequally across tasks. 2025. https://epoch.ai/data-insights/llm-inference-price-trends (demonstrated)
- Comin and Hobijn, An Exploration of Technology Diffusion. 2010 (AER 100(5)). https://doi.org/10.1257/aer.100.5.2031 (demonstrated)
- P. A. David, The Dynamo and the Computer. 1990 (AER 80(2)). https://ideas.repec.org/a/aea/aecrev/v80y1990i2p355-61.html (demonstrated)
- Brynjolfsson, Rock, Syverson, The Productivity J-Curve. 2021 (AEJ Macro). https://doi.org/10.1257/mac.20180386 (demonstrated)
- Somala and Emberson (Epoch AI), Frontier AI performance becomes accessible on consumer hardware within a year. 2025-08-15. https://epoch.ai/data-insights/consumer-gpu-model-gap (demonstrated)
- Epoch AI, Open vs. closed AI: how behind are open models?. 2025. https://epoch.ai/publications/open-models-report (demonstrated)
- Gupta and Kiely, Production-ready speculative decoding with TensorRT-LLM. 2024-12-19. https://www.baseten.co/blog/how-we-built-production-ready-speculative-decoding-with-tensorrt-llm/ (opinion)
- Marx and Fuegi, Reliance on Science: Worldwide Front-Page Patent Citations to Scientific Articles. 2020 (NBER 27987; JEMS 2022). https://www.nber.org/system/files/working_papers/w27987/w27987.pdf (demonstrated)
- Ahmadpoor and Jones, The dual frontier. 2017 (Science). https://doi.org/10.1126/science.aam9527 (demonstrated)
- Willison, Stanford Alpaca, and the acceleration of on-device large language model development. 2023-03-13. https://simonwillison.net/2023/Mar/13/alpaca/ (opinion)
- Li et al., Now Hiring: Firm-Level Adoption of Generative AI in China (World Bank). 2025/2026. https://thedocs.worldbank.org/en/doc/cbdef4ef57efdbb3c29aa4c07edf860b-0050062026/original/Now-hiring-Firm-Level-Li-etal.pdf (demonstrated)
- (German) Statistisches Bundesamt, Pressemitteilung Nr. 444: Jedes fünfte Unternehmen nutzt künstliche Intelligenz. 2024-11-25. https://www.destatis.de/DE/Presse/Pressemitteilungen/2024/11/PD24_444_52911.html (demonstrated)
- Japan Ministry of Internal Affairs and Communications, 令和7年版情報通信白書 (Information and Communications White Paper 2025), data tables, in Japanese. 2025. https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/html/nd112220.html (demonstrated)
- (Chinese) China Internet Network Information Center, 生成式人工智能应用发展报告(2025). 2025-10. https://pdf.dfcfw.com/pdf/H301_AP202510241768289458_1.pdf (demonstrated)
- Bick, Blandin, Deming, The Rapid Adoption of Generative AI. 2024-09 (rev. 2025-02). https://www.nber.org/papers/w32966 (demonstrated)
- Brynjolfsson, Li, Raymond, Generative AI at Work (NBER Working Paper 31161; later published in QJE 2025). 2023 working paper, revised. https://www.nber.org/papers/w31161 (demonstrated)
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. 2025-07-10. https://arxiv.org/abs/2507.09089 (demonstrated)
- Bloom, Jones, Van Reenen, Webb, Are Ideas Getting Harder to Find?. 2020 (AER 110(4)). https://doi.org/10.1257/aer.20180338 (demonstrated)
- Graham, Harvey, Rajgopal, The Economic Implications of Corporate Financial Reporting. 2005 (JAE 40); NBER 2004-10. https://www.nber.org/papers/w10550 (demonstrated)
- Asker, Farre-Mensa, Ljungqvist, Corporate Investment and Stock Market Listing: A Puzzle?. 2015 (RFS 28(2)). https://doi.org/10.1093/rfs/hhu077 (demonstrated)
- FactSet, Highest number of S&P 500 earnings calls citing AI over the past 10 years. 2025-12. https://insight.factset.com/highest-number-of-sp-500-earnings-calls-citing-ai-over-the-past-10-years-1 (demonstrated)
- Hassan, Hollander, van Lent, Tahoun, Firm-Level Political Risk. 2019 (QJE 134(4)). https://doi.org/10.1093/qje/qjz021 (demonstrated)
- Metrick and Yasuda, Venture Capital and Other Private Equity: A Survey (NBER Working Paper 16652). 2010-10. https://www.nber.org/system/files/working_papers/w16652/w16652.pdf (opinion)
- Gompers and Lerner, What Drives Venture Capital Fundraising? (Brookings Papers: Microeconomics). 1998. https://www.brookings.edu/wp-content/uploads/1998/01/1998_bpeamicro_gompers.pdf (demonstrated)
- Arrow, Economic Welfare and the Allocation of Resources for Invention (NBER chapter). 1962. https://www.nber.org/system/files/chapters/c2144/c2144.pdf (established by proof in the source)
- Shapiro, Competition and Innovation: Did Arrow Hit the Bull’s Eye? (NBER conference draft). 2010. https://conference.nber.org/confer/2010/RDIA10/Shapiro.pdf (opinion)
- Henderson and Clark, Architectural Innovation. 1990 (ASQ 35(1)). https://doi.org/10.2307/2393549 (demonstrated)
- US District Court for D.C., United States v. Google LLC, remedies memorandum. 2025-09-02. https://www.courthousenews.com/wp-content/uploads/2025/09/judge-amit-mehta-google-search-monopoly-remedy-ruling.pdf (demonstrated)
- NVIDIA and OpenAI, letter of intent announcement. 2025-09-22. https://nvidianews.nvidia.com/news/openai-and-nvidia-announce-strategic-partnership-to-deploy-10gw-of-nvidia-systems (opinion)
- Advanced Micro Devices, Form 8-K, Item 1.01 (warrant issued to OpenAI). 2025-10-06. https://www.sec.gov/Archives/edgar/data/2488/000119312525230895/d28189d8k.htm (demonstrated)
- Microsoft, The next chapter of the Microsoft-OpenAI partnership. 2025-10-28. https://blogs.microsoft.com/blog/2025/10/28/the-next-chapter-of-the-microsoft-openai-partnership/ (opinion)
- Anthropic, Expanding our use of Google Cloud TPUs and services. 2025-10-23. https://www.anthropic.com/news/expanding-our-use-of-google-cloud-tpus-and-services (opinion)
- OpenAI and Broadcom, strategic collaboration announcement. 2025-10-13. https://openai.com/index/openai-and-broadcom-announce-strategic-collaboration/ (opinion)
- Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. 2022-10-31. https://arxiv.org/abs/2210.17323 (demonstrated)
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention (vLLM). 2023-09-12. https://arxiv.org/abs/2309.06180 (demonstrated)
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025-01-22. https://arxiv.org/abs/2501.12948 (demonstrated)
- Zuo et al., Serving Large Language Models on Huawei CloudMatrix384. 2025-06. https://arxiv.org/abs/2506.12708 (demonstrated)
- Le Gallo et al., An analog-AI chip for energy-efficient speech recognition and transcription, Nature. 2023-08-23. https://www.nature.com/articles/s41586-023-06337-5 (demonstrated)
- Ahmed et al., Universal photonic artificial intelligence acceleration, Nature. 2025-04-09. https://www.nature.com/articles/s41586-025-08854-x (demonstrated)
- Biggs et al., A natively flexible 32-bit Arm microprocessor, Nature. 2021-07-21. https://www.nature.com/articles/s41586-021-03625-w (demonstrated)
- (Chinese) 国务院, 截至今年6月底我国智能算力规模达788百亿亿次/秒 (人民日报). 2025-09-02. https://www.gov.cn/yaowen/liebiao/202509/content_7038732.htm (demonstrated)
- (Chinese) 全国数据资源统计调查工作组, 全国数据资源调查报告(2025年). 2026. https://www.nda.gov.cn/sjj/swdt/xwfb/0429/ff808081-9b5e8626-019d-d86b2f54-1154.pdf (demonstrated)
- International Energy Agency, Energy and AI, executive summary. 2025-04. https://www.iea.org/reports/energy-and-ai/executive-summary (demonstrated)
- International Energy Agency, Energy and AI, energy demand from AI. 2025-04. https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai (demonstrated)
- (Korean) 뉴시스, 정부, 엔비디아 GPU 26만장 확보. 2025-10-31. https://www.newsis.com/view/NISX20251031_0003385059 (opinion)
- (Japanese) 経済産業省, AI・半導体産業基盤強化フレーム. 2024-11. https://www.meti.go.jp/policy/mono_info_service/ai_semiconductor_frame/ai_semiconductor_frame.html (opinion)
- (Japanese) 総務省 有識者会合 資料5, 国内データセンター市場におけるAI需要・地方分散・再エネ電源 (富士キメラ総研). 2024-05-30. https://www.meti.go.jp/policy/mono_info_service/joho/conference/digital_infrastructure/0007/005_fujichimera.pdf (opinion)
- European Commission, EU launches InvestAI initiative to mobilise 200 billion euro (English). 2025-02-11. https://digital-strategy.ec.europa.eu/en/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- (Italian) Commissione europea, UE lancia InvestAI per mobilitare 200 miliardi di EUR. 2025-02-11. https://digital-strategy.ec.europa.eu/it/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- Press Information Bureau (India), reply in the Lok Sabha on the IndiaAI Mission. 2026-03-25. https://www.pib.gov.in/PressReleasePage.aspx?PRID=2245063 (demonstrated)
- (Portuguese) Ministério da Ciência, Tecnologia e Inovação, Plano Brasileiro de Inteligência Artificial 2024-2028. 2025. https://www.gov.br/mcti/pt-br/acompanhe-o-mcti/transformacaodigital/plano-brasileiro-de-inteligencia-artificial (opinion)
- SoftBank Group, Global Tech Alliance Launches Stargate UAE. 2025-05-22. https://group.softbank/en/news/press/20250522 (opinion)
- NVIDIA, HUMAIN and NVIDIA Announce Strategic Partnership to Build AI Factories in Saudi Arabia. 2025-05-13. https://nvidianews.nvidia.com/news/humain-and-nvidia-announce-strategic-partnership-to-build-ai-factories-of-the-future-in-saudi-arabia (opinion)
- Cassava Technologies, Cassava scales African AI infrastructure with NVIDIA-powered AI factories. 2025. https://www.cassavatechnologies.com/cassava-scales-african-ai-infrastructure-with-nvidia-powered-ai-factories-to-accelerate-sovereign-data-capabilities/ (opinion)