L'écart entre le possible et le déployé : un modèle de cadence de l'intelligence informatique et la fonction de forçage des outils d'automatisation
Les méthodes qui réduisent le coût de l'intelligence informatique sont publiées des années avant que la plupart des produits ne les utilisent. Cet article mesure cet écart à partir de sources datées, modélise la part que fixent les calendriers de publication des résultats et de financement, teste quelle part des dépenses d'infrastructure forme une boucle fermée, modélise le coût d'une tâche et énonce les données qui réfuteraient le modèle.
David Charlot, Open Interface Engineering
Ceci est une traduction de la version anglaise. En cas de divergence, la version anglaise fait foi. Original anglais.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. L'écart entre le possible et le déployé : un modèle de cadence de l'intelligence informatique et la fonction de forçage des outils d'automatisation. Open Interface Engineering. Web: https://research.openie.dev/papers/latency/. PDF: https://research.openie.dev/pdfs/latency.pdf.
18 octobre 2026. Les sources sont datées et classées par classe de preuve dans les Références. Les propositions sont dérivées à la main et n’ont pas été vérifiées par un assistant de preuve, et aucun des nombres de la Section 7 n’est une donnée. Les quantités marquées comme sortie du modèle sont calculées à partir de chiffres cités et ne sont pas des observations.
Résumé
Les nouvelles méthodes pour faire fonctionner l’intelligence informatique à moindre coût sont publiées ouvertement, puis atteignent la plupart des produits avec un retard. Cet article définit ce retard comme une quantité mesurable, le décompose en parties technique, calendaire et incitative, et modélise comment un outil qui abaisse le coût de l’automatisation change ce qu’un vendeur peut facturer avec profit. Il place ensuite ce retard dans le déploiement actuel des infrastructures. Il expose ce que les documents publics déposés établissent sur les flux d’argent entre laboratoires, nuages et fabricants de puces, énonce un test qui distingue une boucle fermée d’une demande extérieure, construit un modèle de coût en dollars et en joules par tâche, compare les méthodes logicielles ouvertes et le matériel alternatif avec la pile en place, et cartographie où se trouvent la capacité, le calcul et l’énergie. Les propositions sont dérivées à la main, et chaque prédiction nomme les données qui la réfuteraient.
En termes simples
- Les méthodes ouvertes qui rendent l’intelligence informatique moins chère obtiennent les mêmes résultats sur des machines plus anciennes et moins chères, et l’attente entre une méthode publiée et un produit livré est plus courte pour certaines méthodes que pour d’autres.
- L’essentiel du coût d’une tâche est le prix des machines et non l’électricité, et les prix payés par les utilisateurs ont baissé bien plus vite que les coûts du matériel. L’argent derrière les machines comprend des boucles entre quelques laboratoires, nuages et fabricants de puces que les documents déposés établissent, et il comprend aussi des liquidités venant d’autres activités et de clients extérieurs à ces boucles. La Section 10 donne un test qui sépare les deux à l’aide de données.
- Une partie de l’attente vient des calendriers, parce que les entreprises décident par pas trimestriels et annuels. Quand un outil rend le travail assez bon marché, attendre cesse de rapporter au vendeur, et ce qu’il reste à facturer est le coût du changement de fournisseur et non le coût du calcul.
Notation
| Terme | Sens dans cet article |
|---|---|
| Tâche | Une unité de travail utile avec un seuil de qualité déclaré , par exemple une réponse correcte ou une estimation vérifiée. |
| Joules par tâche, | Énergie mesurée en joules pour accomplir une tâche avec une qualité au moins égale à . L’unité de compte de l’intelligence informatique ici. |
| Coût par tâche, | Coût monétaire d’une tâche : , où est le prix d’un joule et le coût du matériel et de l’exploitation qui ne baisse pas avec . |
| Frontière des capacités, | Le plus bas coût par tâche atteignable par toute méthode documentée publiquement au temps . |
| Frontière déployée, | Le plus bas coût par tâche proposé dans un produit généralement disponible au temps . |
| Latence, | À un niveau de coût , le temps entre le moment où la frontière des capacités atteint et celui où la frontière déployée atteint . Définie à la Section 0. |
| Période de publication, | L’espacement des dates de décision dans une entreprise qui publie ses résultats, environ un trimestre. |
| Friction de changement, | Le coût par tâche que supporte un acheteur pour passer à un autre vendeur : intégration, transfert de données, reformation, clauses contractuelles, réglages par défaut. |
| Coût d’adoption, | Coût ponctuel pour reconstruire une offre autour d’une nouvelle méthode. |
| Temps d’accélérateur par tâche, | Heures d’accélérateur utilisées qu’occupe une tâche avec une qualité au moins égale à . Section 12. |
| Prix d’un joule chargé en capital, | Prix de l’électricité plus le capital par heure utilisée divisé par la puissance de l’installation. Section 12. |
| Borne de la part en boucle fermée, | Borne supérieure de la part du chiffre d’affaires d’un fournisseur que son propre capital fourni aurait pu financer. Section 10. |
| Manque à gagner toléré, | La plus forte baisse des résultats publiés sur une période qu’une entreprise acceptera, dans les mêmes unités que . |
0. Définitions et périmètre
Soit le plus bas coût par tâche atteignable au temps par toute méthode documentée publiquement à la qualité . Il est non croissant, parce que la documentation n’est pas retirée. Soit le plus bas coût par tâche proposé dans un produit généralement disponible au temps . Il est non croissant pour la même raison quand un vendeur ne retire pas une offre, et par construction. Pour un niveau de coût , on écrit et .
Définition 1 (latence). . La question de l’article est de savoir quelle est la taille de , ce qui la fixe et ce qui la fait varier.
Définition 2 (parties technique, calendaire et incitative). Pour une entreprise , la latence se décompose en . Ici est le délai de maturité technique : le temps dont les ingénieurs ont besoin pour porter, tester et durcir la méthode. Le terme est l’attente calendaire : le temps entre la maturité et la prochaine date à laquelle l’entreprise prend des décisions de lancement. Le terme est le délai incitatif : le temps pendant lequel le lancement a une valeur positive à long terme mais qu’une règle de publication des résultats ou de financement le bloque. La latence artificielle est . Le mot est employé dans un sens étroit : c’est la partie que le temps d’ingénierie n’explique pas, et ce n’est pas une affirmation sur le motif de qui que ce soit.
Périmètre. L’article couvre les méthodes qui changent le coût de l’intelligence informatique : architectures de modèles, formats numériques, noyaux, compilateurs, procédures d’inférence statistique et mesure de l’énergie. Il couvre aussi l’infrastructure qui les fait fonctionner : les flux de capital et d’engagements de calcul entre laboratoires, nuages et fabricants de puces, le coût d’une heure d’accélérateur, les méthodes ouvertes et le matériel alternatif qui changent le temps d’accélérateur par tâche, et l’emplacement de la capacité, du calcul et de l’énergie. Il ne prévoit aucune entreprise, aucun prix ni aucune part de marché. L’énergie par tâche en joules est la métrique là où un chiffre en joules existe. Là où une source ne rapporte que des dollars ou des secondes, le chiffre en dollars ou en secondes est utilisé et signalé comme tel.
1. Types de preuves
Chaque source de cet article est classée dans l’une de trois classes, et la classe est indiquée dans les Références.
- Établi par une preuve dans la source. La source contient un théorème ou une dérivation analytique avec sa preuve. Une preuve dans un article est la preuve de l’auteur, non une preuve vérifiée par machine, et l’article ne la présente pas comme davantage. Les dossiers judiciaires et les publications statistiques sont classés comme démontrés, parce qu’ils rapportent des faits datés et non des dérivations.
- Démontré. La source rapporte une mesure, une enquête, une expérience ou une publication datée avec une méthode déclarée. Le résultat vaut pour ce cadre et peut ne pas se transposer ailleurs.
- Opinion. La source est une prévision, une déclaration de fournisseur sans données, un récit de praticien ou une revue qui résume d’autres travaux. Les revues sont classées ici parce que l’article ne peut pas savoir à partir d’elles ce qui a été mesuré.
Les chiffres sont cités tels que la source les énonce, avec le cadre et les réserves de la source. Là où une quantité est dérivée de chiffres cités, le texte l’appelle sortie du modèle et montre le calcul ou nomme le script qui la calcule. Les annonces de plans, d’objectifs et d’investissements prévus sont classées comme opinion, parce qu’elles énoncent une intention et non un résultat, et les documents déposés auprès du régulateur sont classés comme démontrés. Chaque source a été récupérée en texte intégral et chaque chiffre cité a été localisé dans ce texte. Les sources en allemand, français, espagnol, portugais, italien, coréen, japonais et chinois ont été lues dans la langue d’origine, et leurs chiffres sont reformulés en anglais sans changement.
2. Ce qui est devenu possible, de 2024 à 2026
La liste ci-dessous est organisée selon le levier que chaque méthode actionne sur le coût par tâche. Chaque ligne donne la date de la première publication en ligne, l’affirmation telle que les auteurs la rapportent, et la classe.
Tableau 1. Méthodes qui changent le coût d’une tâche.
| Levier | Méthode et affirmation | Publié | Classe |
|---|---|---|---|
| Architecture | Les modèles à espace d’états sélectifs et des variantes de l’attention sont duaux par le biais de matrices semi-séparables structurées, et la couche qui en résulte est rapportée 2 à 8 fois plus rapide que le balayage antérieur [38]. | 31 mai 2024 | établi par une preuve dans la source |
| Architecture | Des modèles hybrides à espace d’états et attention ont été publiés avec des poids ouverts par plusieurs groupes en 2024 et 2025 [39]. | 2024 à 2025 | démontré |
| Format numérique | Des poids ternaires égalent la perplexité et les scores de tâches finales en 16 bits à partir d’environ 3 milliards de paramètres, avec une latence, une mémoire et une énergie moindres, dans les expériences des auteurs [40]. | 27 févr. 2024 | démontré |
| Format numérique | Préentraînement stable en 4 bits d’un modèle hybride de 12 milliards de paramètres sur 10 000 milliards de tokens, comparable aux résultats en 8 bits, rapporté par le fabricant du matériel [41]. | sept. 2025 | démontré |
| Noyaux | Un noyau d’attention atteint jusqu’à 75 % du débit maximal en 16 bits sur une génération d’accélérateurs, contre 35 % pour son prédécesseur [42]. | juil. 2024 | démontré |
| Parcimonie | Attention parcimonieuse alignée sur le matériel et entraînable nativement, avec des accélérations rapportées à 64 mille tokens de contexte [43]. | févr. 2025 | démontré |
| Décodage | Le décodage spéculatif laisse la distribution de sortie inchangée et a été mesuré 2 à 3 fois plus rapide sur un grand modèle de traduction [23]. | 30 nov. 2022 | établi par une preuve dans la source |
| Mise à l’échelle | Quand la demande d’inférence sur toute la durée de vie est comptée, le modèle optimal en coût est plus petit et entraîné sur plus de tokens que ne le donne la règle fondée sur le seul entraînement [44, 45]. | janv. 2024 | démontré |
| Coût d’entraînement | Un modèle à l’échelle de la frontière rapporté à 2,788 millions d’heures d’accélérateur pour l’entraînement complet, avec une attention latente et un entraînement en 8 bits [46]. | 26 déc. 2024 | démontré |
| Inférence conforme | Couverture sur échantillon fini et sans hypothèse de distribution pour tout prédicteur, avec des preuves rassemblées dans un livre [47] ; une revue publiée en ligne en octobre 2024 et parue en 2025 couvre les données structurées, non structurées et dynamiques [48]. | 18 nov. 2024 | établi par une preuve dans la source |
| Inférence avec prédictions | Intervalles valides à partir d’un petit ensemble étiqueté et de nombreuses prédictions de machine, pour tout prédicteur [49]. | 2023 | établi par une preuve dans la source |
| Inférence séquentielle | E-processus et suites de confiance qui restent valides quand un test est arrêté à tout moment [50]. | nov. 2023 | établi par une preuve dans la source |
| Estimation causale | L’apprentissage automatique débiaisé donne une inférence valide sur un paramètre cible avec des modèles de nuisance flexibles, étendue aux effets identifiables au-delà de l’ajustement par la porte dérobée [51, 52]. | 2018 ; 2021 | établi par une preuve dans la source |
| Compilateurs | Des passes de compilateur pour la différentiation automatique d’ordre supérieur rapportent jusqu’à 1,3 fois sur des opérateurs du second ordre, à titre préliminaire [53] ; un article méthodologique de 2026 affirme que JAX compilé dépasse de loin l’efficacité de Stan sur le matériel moderne, sans chiffres de banc d’essai dans son résumé [54]. | 2025 | démontré |
| Programmation probabiliste | Un compilateur qui conserve la sémantique probabiliste rapporte en moyenne géométrique 6,4 fois mieux que Stan et 53 fois mieux que Turing sur des bancs d’essai standard [55]. | 2025 à 2026 | démontré |
| Mesure de l’énergie | Un banc d’essai ouvert mesure l’énergie d’inférence sur 40 architectures et rapporte des configurations Pareto en temps et en énergie avec des économies supérieures à 40 % dans certains cas [56] ; un fournisseur rapporte 0,24 wattheure pour une requête textuelle médiane en production [57]. | 2025 | démontré |
Deux taux donnent le contexte. Le calcul nécessaire pour atteindre un score fixe de modèle de langage a été divisé par deux environ tous les 8 mois, avec un intervalle à 95 % d’environ 5 à 14 mois [58]. Le prix pour atteindre un niveau fixe de banc d’essai a baissé de 9 à 900 fois par an sur six bancs d’essai, avec une médiane d’environ 50, les taux les plus rapides reposant sur moins d’un an de données [59]. Ce sont tous deux des taux de variation de la frontière des capacités ou d’un prix, et aucun ne mesure l’écart jusqu’au déploiement.
Deux limites s’appliquent au tableau. Plusieurs lignes sont des accélérations par rapport à une référence choisie par les auteurs, si bien que les nombres ne s’additionnent pas et ne se comparent pas d’une ligne à l’autre. Et « possible » dans ces lignes signifie démontré par les auteurs dans un cadre déclaré, non disponible dans un produit.
3. À quoi ressemble l’écart dans les données
Diffusion de long terme. Sur 15 technologies et 166 pays de 1820 à 2003, le décalage moyen entre l’invention et l’adoption dans un pays était d’environ 45 ans, et les décalages se sont réduits sur la période [60]. La même histoire comporte un avertissement sur ce que signifie l’adoption. Les moteurs électriques n’ont relevé la productivité des usines qu’après que les usines ont été repensées autour d’un moteur par machine, un changement qui a pris des décennies [61]. Un modèle ultérieur attribue le creux puis la hausse de la productivité mesurée à un investissement complémentaire non mesuré dans les processus et les compétences [62]. Dans les deux récits, le retard est surtout le coût de la réorganisation autour de l’outil, qui dans la notation ci-dessus est .
De la publication ouverte au matériel grand public. Pour les modèles qui tiennent sur une seule carte graphique grand public, le décalage moyen derrière le meilleur modèle toutes catégories était de 6 à 12 mois sur quatre mesures en 2025, le plus grand décalage, 12,4 mois, portant sur un score de préférence [63]. Une analyse plus large des modèles à poids ouverts de toute taille a trouvé environ un an, avec une fourchette de 5 à 22 mois selon le banc d’essai, et une analyse ultérieure fondée sur un indice a placé la moyenne près de 3 mois [64]. Ces chiffres mesurent la distance entre deux frontières publiques. Ce sont des bornes inférieures d’un décalage jusqu’aux produits, parce qu’un modèle ouvert sur une carte n’est pas encore un produit que quelqu’un est payé pour prendre en charge.
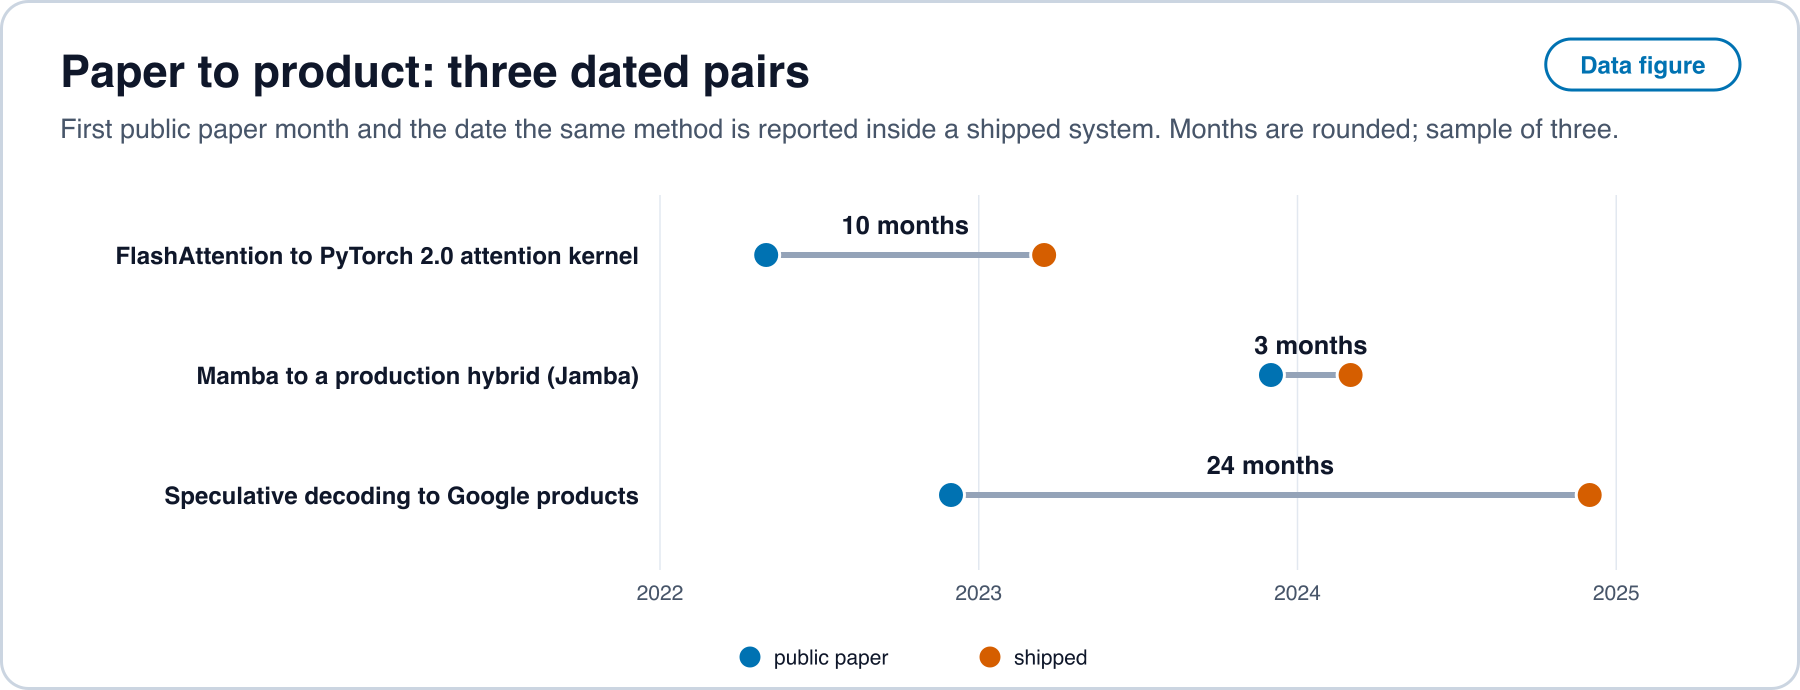
De l’article au produit. Le décodage spéculatif a été publié en ligne en novembre 2022. L’employeur de ses auteurs a indiqué l’appliquer dans des produits en décembre 2024 [24]. Un récit de praticien du même mois dit que l’usage en production a demandé un travail supplémentaire sur le traitement par lots, la qualité et la fiabilité, et qu’il aide surtout pour des tailles de lot limitées [65]. Deux autres paires figurent à la Section 13. Quelques paires datées ne forment pas une distribution, et le protocole de la Section 16 précise comment en recueillir beaucoup. Une mesure de plus long terme de la distance entre article et brevet trouve que les citations d’articles dans les brevets sont en moyenne 14,4 ans plus anciennes que le brevet en première page, et 16,6 ans quand les citations dans le texte sont comptées [66], et que les brevets et articles liés sont typiquement séparés de deux à quatre étapes de citation [67]. Ces chiffres concernent la science en général et ne portent pas sur l’apprentissage automatique en particulier.
Pratique des modèles en 4 bits. Des récits de praticiens datent de 2023 le moment où l’inférence locale en 4 bits est devenue praticable sur des machines grand public [68]. Les récits sont narratifs, c’est donc une preuve de classe opinion pour une date et non une mesure.
Adoption par les entreprises. Le supplément 2026 du Bureau du recensement des États-Unis a trouvé 18 % des entreprises utilisant l’IA dans une fonction de l’entreprise de novembre 2025 à janvier 2026, 22 % s’attendant à le faire dans les six mois, et 57 % des utilisateurs dans trois fonctions ou moins [34]. Dans l’Union européenne, 20,0 % des entreprises de 10 salariés ou plus utilisaient au moins une technologie d’IA en 2025, soit 6,5 points de plus qu’en 2024, avec 55,0 % des grandes, 30,4 % des moyennes et 17,0 % des petites entreprises [33]. L’OCDE rapporte une adoption de 13,9 % en 2024 et 39 % des grandes entreprises contre 12 % des petites [35]. Les données d’embauche chinoises montrent une embauche liée à l’IA générative dans 21 % des entreprises cotées contre 0,2 % des non cotées à la fin de 2025 [69]. La formulation des enquêtes et les bases de sondage diffèrent selon la source, et la question du recensement a été révisée en novembre 2025, si bien que les taux ne sont pas comparables d’une ligne à l’autre.
Statistiques officielles dans les langues d’origine. Le Statistisches Bundesamt allemand rapporte que 20 % des entreprises de 10 salariés ou plus utilisaient l’IA en 2024, contre 12 % en 2023 et 11 % en 2021, avec 48 % des grandes, 28 % des moyennes et 17 % des petites entreprises, et cite le manque de connaissances et l’insécurité juridique comme les raisons les plus fréquentes de ne pas l’utiliser [70]. Son tableau de 2025 donne 26 % au total et 57 % pour les entreprises de plus de 250 salariés, selon une définition modifiée de l’entreprise [31]. L’Insee rapporte que 10 % des entreprises en France utilisaient l’IA en 2024, quatre points de plus qu’en 2023, 33 % des entreprises de 250 salariés ou plus, et 42 % dans l’information et la communication contre 5 % ou moins dans les transports, l’hébergement et la restauration, et la construction [37]. L’Instituto Nacional de Estadística espagnol rapporte que 21,1 % des entreprises de 10 salariés ou plus utilisaient l’IA au premier trimestre 2025, 8,7 points de plus qu’un an plus tôt [32]. Le Cetic.br brésilien rapporte que 13 % des entreprises utilisaient l’IA en 2024, la même part qu’en 2023, concentrée dans les grandes entreprises et dans l’information et la communication [36]. Les statistiques du ministère coréen, telles que rapportées par la presse coréenne, donnent 32,9 % des entreprises utilisant des technologies ou services d’IA en 2024 contre 30,3 % en 2023, et 66,9 % pour les entreprises de 250 travailleurs ou plus [30]. Le livre blanc japonais a interrogé des travailleurs dans quatre pays et trouvé un usage professionnel quelconque de l’IA générative de 55,2 % au Japon, 90,6 % aux États-Unis, 90,3 % en Allemagne et 95,8 % en Chine. Parmi les entreprises japonaises, 49,7 % avaient une politique d’usage actif ou limité en 2024 contre 42,7 % un an plus tôt, et la préoccupation japonaise la plus fréquente, à 30,1 %, était de ne pas savoir comment l’utiliser efficacement, contre 9,7 % aux États-Unis et 10,4 % en Chine [71]. Le CNNIC chinois compte 515 millions d’utilisateurs d’IA générative en juin 2025, 266 millions de plus qu’en décembre 2024, soit une pénétration de 36,5 % [72]. Ce sont des mesures d’usage, non de lancement. Dans chaque pays, le taux augmente avec la taille de l’entreprise, ce qui est cohérent avec un coût d’adoption fixe qui pèse moins sur un gros budget, bien que les enquêtes ne puissent pas le distinguer d’autres causes.
L’usage au niveau des personnes et des tâches. Près de 40 % des adultes des États-Unis âgés de 18 à 64 ans utilisaient l’IA générative fin 2024, et environ 23 % des travailleurs l’avaient utilisée au travail la semaine précédente [73]. Une étude de terrain portant sur 5 179 agents du service client a trouvé 14 % de résolutions de plus par heure en moyenne et 34 % de plus pour les travailleurs novices et peu qualifiés [74]. Un essai randomisé avec 16 développeurs expérimentés et 246 tâches a trouvé que les tâches où l’IA était autorisée prenaient 19 % de temps en plus dans ce cadre [75]. Ces résultats diffèrent parce que les tâches, les personnes et les outils diffèrent. Ils montrent que le déploiement n’est pas un événement unique, et c’est pourquoi est défini à partir des offres et non de l’usage.
Ce qui ralentit la recherche elle-même. L’effort de recherche a augmenté tandis que la productivité de la recherche a baissé dans la plupart des secteurs, et maintenir le doublement de la densité des puces a demandé plus de 18 fois les chercheurs du début des années 1970 [76]. Cela porte sur , non sur , et c’est noté pour que l’article ne présente pas la frontière des capacités comme gratuite.
4. Calendriers : périodes de publication des résultats et de financement
Les dates de décision des entreprises cotées suivent le calendrier de publication des résultats. Dans une enquête auprès de 401 dirigeants financiers, 78 % renonceraient à de la valeur économique pour lisser les résultats publiés, et 55 % éviteraient de lancer un projet à valeur actuelle nette très positive si cela signifiait manquer le consensus du trimestre [77]. Les entreprises cotées comparables investissent moins, et réagissent moins aux opportunités d’investissement, que les entreprises non cotées [78]. Tout cela est démontré pour des technologies et des périodes antérieures, et rien de cela n’est une mesure des lancements d’IA.
L’attention suit le même calendrier. Le nombre de conférences sur les résultats de grandes entreprises des États-Unis citant « AI » a atteint 306 au troisième trimestre 2025, contre une moyenne sur dix ans de 86 [79]. Le langage des conférences sur les résultats a été utilisé comme instrument de mesure pour d’autres sujets, validé par une lecture manuelle [80], et le même instrument peut être pointé sur des sujets de lancement.
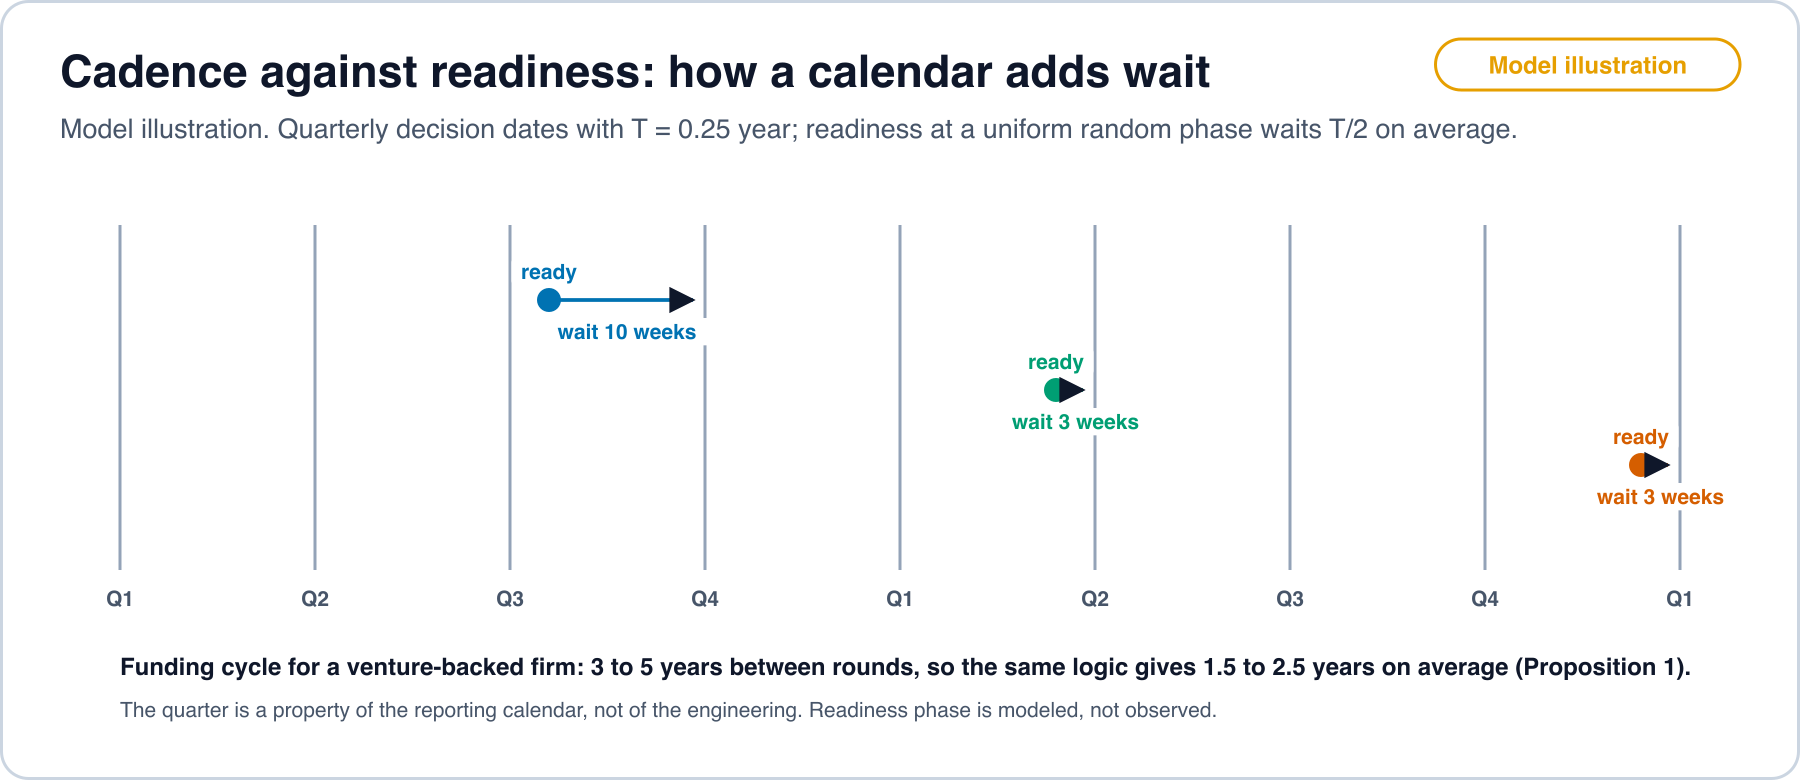
Le financement suit un calendrier plus long. Un fonds de capital-risque a une durée de vie finie, typiquement dix ans, et les sociétés lèvent de nouveaux fonds tous les trois à cinq ans [81]. Les contrats de société en commandite précisent des durées de vie finies, généralement dix ans [82]. Les deux calendriers diffèrent en longueur, environ un trimestre et trois à cinq ans, et tous deux quantifient le moment où un engagement peut être pris. La Proposition 1 ci-dessous n’utilise que cette structure.
5. Contrôle et réponse des acteurs en place
Deux résultats plus anciens encadrent l’incitation à déployer. L’analyse d’Arrow trouve l’incitation à inventer plus faible sous monopole, c’est-à-dire avec des barrières à l’entrée, que sous concurrence, et compte un monopole temporaire qui n’interdit pas l’entrée comme presque concurrentiel [83]. Une revue ultérieure de la littérature sur la concurrence et l’innovation note que les incitations à la préemption sont une force absente des modèles statiques simples [84]. Les acteurs en place manquent aussi les changements qui réarrangent des composants connus, parce que leurs routines filtrent ce qu’ils remarquent [85]. Aucun de ces résultats n’est une affirmation sur une entreprise actuelle.
Le contrôle de la distribution est établi dans des dossiers judiciaires publics. En septembre 2025, un tribunal de district des États-Unis a interdit les contrats de distribution exclusive pour plusieurs produits de recherche et d’assistant, a autorisé les paiements non exclusifs pour la position par défaut avec des durées généralement limitées à un an, et a ordonné des mesures de partage de données et de syndication [86]. L’article utilise ce dossier uniquement comme preuve que les positions par défaut et les conditions de distribution ont un prix et sont réglementées, ce que représente le paramètre de la Section 6.
6. Le modèle
Cadre. Une population d’acheteurs avec une demande par période pour une tâche au prix . Un acteur en place la sert au coût avec une méthode existante. Une méthode publique devient accessible à tous au coût , non croissant dans le temps. Un acheteur peut passer à un vendeur utilisant la méthode publique avec une friction par tâche, si bien que le plafond de prix de l’acteur en place est . L’acteur en place peut lancer une offre construite sur la méthode publique pour un coût ponctuel . Les décisions ne sont prises qu’aux dates .
Hypothèses.
- A1. Demande linéaire , avec .
- A2. Le coût public décroît : est non croissant et continu avec , et .
- A3. Le plafond contraint le prix de l’acteur en place, c’est-à-dire pour le coût auquel il fait face. Cela vaut pour les nombres de la Section 7.
- A4. L’acteur en place maximise le profit actualisé au taux sous une règle de publication des résultats : une part de est passée en charges dans la période de lancement, et les résultats publiés de la période de lancement ne doivent pas être inférieurs au niveau d’avant le lancement de plus de .
- A5. Après le lancement, le coût de l’acteur en place est , le coût de la méthode publique.
- A6. Les gains de flux du lancement sont traités comme constants après la date de lancement (approximation en régime permanent).
Proposition 1 (quantification calendaire). Si une méthode devient prête au temps et que l’entreprise lance à la première date de décision égale ou postérieure à où le lancement en vaut la peine, l’attente est . Si est uniforme sur , alors et .
Dérivation. On écrit avec uniforme sur . Pour , la date suivante est et l’attente est , qui est uniforme sur . Une variable uniforme sur un intervalle de longueur a pour moyenne et pour variance . Le cas a une probabilité nulle.
Conséquence. Une entreprise qui décide selon un calendrier trimestriel ajoute en moyenne environ 6 semaines, et une qui décide selon un cycle de financement de 3 à 5 ans ajoute 1,5 à 2,5 ans, au délai de maturité , sans cause d’ingénierie. L’hypothèse selon laquelle la maturité est uniforme au sein d’une période est le point faible, et la Prédiction 1 teste la réciproque.
Proposition 2 (seuil de lancement et lancement forcé). On définit le gain de flux pour le coût extérieur . Sur , est strictement décroissant en . Sans contraintes calendaires ni de publication des résultats, le lancement est optimal exactement quand , c’est-à-dire quand , où est l’unique solution de si elle existe. Si , attendre ne rapporte aucun profit, et le lancement est préféré à l’attente. Une règle de publication des résultats peut le retarder mais ne peut pas rendre l’attente profitable.
Dérivation. Sous A3, l’acteur en place qui attend au coût fixe son prix au plafond, si bien que son profit est . Après le lancement, son coût est et son profit est . La différence est . En dérivant, sur l’intervalle indiqué, donc est strictement décroissant. Avec A6, la valeur du lancement est , qui est positive ou nulle exactement quand . Attendre donne le profit , qui est nul en , c’est-à-dire en , et négatif en dessous. Le lancement en ce point donne le profit par A1.
Proposition 3 (porte de publication des résultats, retard et région de non-lancement). Sous A4, la variation des résultats publiés de la période de lancement est . Le lancement est permis si elle est au moins égale à , c’est-à-dire si . On définit et . Alors , la date de lancement passe de à ou au point de lancement forcé , selon celui qui vient en premier, et pour le retard est quand . Si , où est le plancher de coût, le lancement n’a jamais lieu selon les conditions de VAN et de porte, et seul le lancement forcé en s’applique si .
Dérivation. Les résultats publiés de la période de lancement gagnent de bénéfice d’exploitation et perdent la part passée en charges du coût d’adoption. Exiger que le solde soit au moins égal à donne l’inégalité indiquée. Comme est strictement décroissant (Proposition 2), le plus grand de deux gains requis correspond au plus petit seuil de coût, donc . Avec , le temps pour atteindre est , et la différence de deux tels temps est le retard indiqué. Le gain atteignable est au plus parce que par A2.
Proposition 4 (fonction de forçage). Supposons qu’un outil d’automatisation abaisse le coût d’adoption de à . (a) Le seuil de VAN monte, donc le lancement est optimal plus tôt. (b) Si , la porte de publication des résultats ne contraint pas, , et . (c) La latence totale de l’entreprise tombe à , où est le délai de maturité technique avec l’outil.
Dérivation. (a) et est strictement décroissant, donc abaisser abaisse le gain requis et relève . (b) La condition de porte est satisfaite par tout quand le membre de droite est négatif ou nul, c’est-à-dire . Alors . (c) Découle de la Définition 2 et de la Proposition 3.
Lecture. Un outil agit comme fonction de forçage de deux manières distinctes. Il abaisse et supprime ainsi le retard de porte dès que passe sous . Et il abaisse pour chaque vendeur, ce qui force le lancement en , où attendre ne rapporte rien. La première est une propriété de l’entreprise qui adopte et la seconde une propriété du marché.
Proposition 5 (la latence du marché est fixée par l’entreprise la moins contrainte). Si sur les entreprises qui peuvent vendre à la population d’acheteurs, alors .
Dérivation. , et ne dépend pas de . La soustraction donne le résultat.
Conséquence. Un calendrier ou une porte qui retarde une entreprise ne retarde pas le marché quand une autre entreprise peut atteindre les mêmes acheteurs sans ce retard. La latence observée sur un marché est alors la latence de l’entreprise la plus rapide qui y a accès. Là où l’accès est restreint, parce que les acheteurs ne peuvent pas atteindre d’autres vendeurs, le minimum est pris sur un ensemble plus petit. Dans le modèle, c’est le rôle de .
Proposition 6 (ce qu’il reste à facturer). Après le lancement, avec le plafond contraignant, le prix est , le profit est , et la marge par tâche est , indépendante de . Le prix varie un pour un avec le coût, tandis que le rapport prix sur coût augmente quand le coût baisse. La valeur marginale de la friction est , qui est positive pour et augmente quand baisse.
Dérivation. Sous A3, l’acteur en place facture le plafond . Avec le coût , la marge est et le volume est , ce qui donne . Le rapport découle de . Dériver par rapport à donne , et .
Lecture. À mesure que le coût du calcul baisse, la part du prix qui reflète le calcul se réduit, et la marge restante dépend de ce qu’il en coûte à un acheteur de partir. Les dépenses qui relèvent prennent plus de valeur. Dans le modèle, c’est une affirmation sur les incitations et non un jugement sur une entreprise. Les politiques qui abaissent , comme des limites aux conditions par défaut ou des formats de données portables, abaissent la marge du même montant, et le modèle ne dit pas si c’est souhaitable.
7. Une illustration numérique, non un ajustement
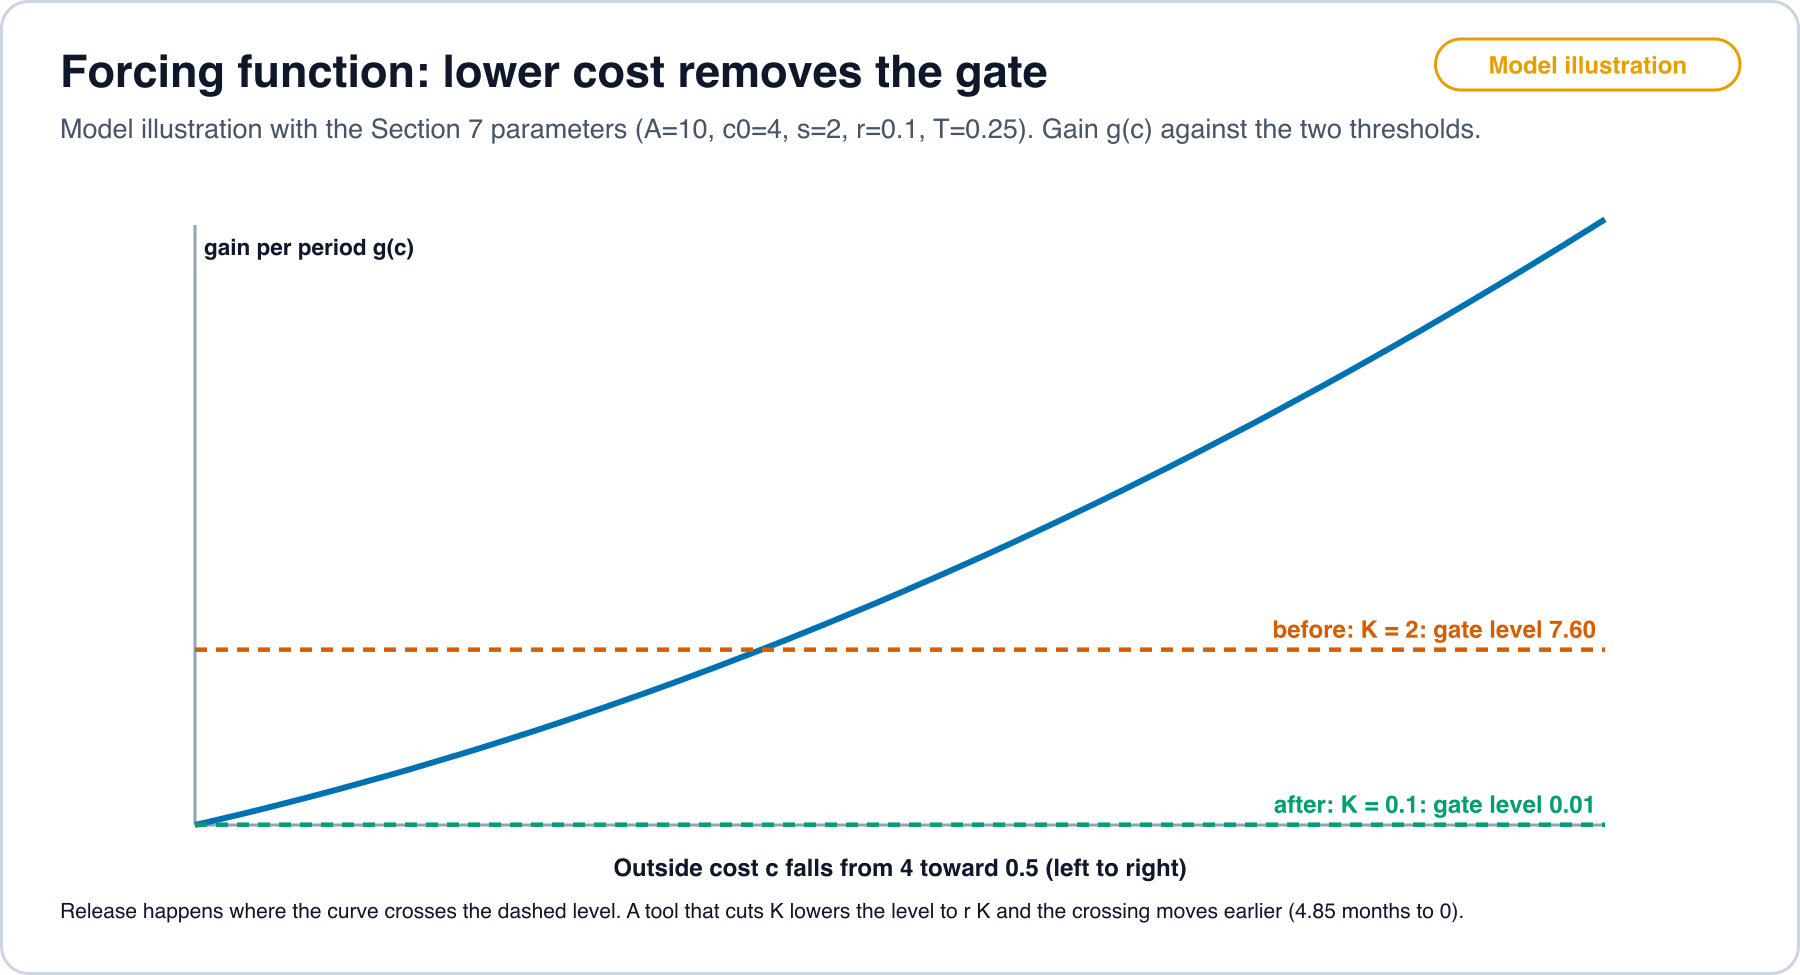
Le script model_check.py du dossier de travail reproduit ces nombres avec la bibliothèque standard. Paramètres : , , , par an, an, , , et un coût extérieur divisé par deux tous les 8 mois, donc . Le taux de 8 mois fait écho à [58] et est un choix d’illustration, non une estimation du coût.
Tableau 2. Date de lancement avec et sans un outil qui abaisse le coût d’adoption.
| Cas | Seuil de VAN | Seuil de porte | Lancement à | Retard de porte | |
|---|---|---|---|---|---|
| Avant l’outil | 2,0 | , jour 4 | mois 5,00 | 4,85 mois | |
| L’outil abaisse le coût d’adoption | 0,1 | jour 0,2 | 0 |
Dans la première ligne, la porte exige un gain de , bien au-dessus de l’exigence de VAN , si bien que la partie de retard incitatif est de 4,85 mois. C’est plus long que le terme calendaire de la Proposition 1 pour une entreprise trimestrielle, qui est de 1,5 mois en moyenne. Dans la seconde ligne, , donc la porte ne contraint pas et seule la condition de VAN demeure, comme dans la Proposition 4(b).
model_check.py et Tableau 2. Open full sizeTableau 3. Après le lancement, avec .
| Prix | Profit | |||
|---|---|---|---|---|
| 4,0 | 6,00 | 1,50 | 8,00 | 2,00 |
| 3,0 | 5,00 | 1,67 | 10,00 | 3,00 |
| 2,0 | 4,00 | 2,00 | 12,00 | 4,00 |
| 1,0 | 3,00 | 3,00 | 14,00 | 5,00 |
| 0,5 | 2,50 | 5,00 | 15,00 | 5,50 |
Le profit augmente quand le coût baisse parce que la demande linéaire permet au volume de croître. Avec une demande saturée, la colonne du profit s’aplatirait, et l’affirmation selon laquelle la marge reste à ne changerait pas. Une simulation de la Proposition 1 avec et une maturité uniforme donne une attente moyenne de 0,1250 contre et une variance de 0,00521 contre (200 000 tirages, graine 7).
8. Prédictions et ce qui les réfuterait
Chaque prédiction nomme les données, le test et le résultat qui compterait contre le modèle. Les prédictions sont énoncées avant que la moindre donnée ait été recueillie.
Prédiction 1 (regroupement calendaire). Les dates auxquelles les entreprises à publication trimestrielle rendent généralement disponibles des méthodes déjà ouvertes ne sont pas uniformes au sein du trimestre. Test : pour un échantillon d’au moins 200 lancements d’entreprises cotées, calculer la phase de chaque date au sein du trimestre fiscal de l’entreprise et appliquer les tests de Rayleigh et de Kuiper contre l’uniformité. Réfutée si l’hypothèse nulle d’une phase uniforme n’est pas rejetée au seuil de 5 % avec 200 éléments indépendants ou plus.
Prédiction 2 (cotées contre non cotées). Pour la même méthode et une difficulté comparable, le délai médian entre la publication ouverte et un produit généralement disponible est plus long pour les entreprises cotées que pour les entreprises financées hors d’un calendrier de publication des résultats. Test : paires appariées par méthode, avec le type d’entreprise comme traitement et des rapports de risques pour le temps jusqu’au lancement. Réfutée si l’intervalle à 95 % du rapport de risques (cotées sur non cotées) se situe entièrement au-dessus de 0,8.
Prédiction 3 (les outils abaissent la porte). Après qu’un outil d’automatisation qui abaisse le coût de portage devient disponible pour une cible matérielle ou logicielle, le temps entre la publication ouverte et la disponibilité générale sur cette cible diminue. Test : différence de différences avec des cibles servies et non servies par l’outil, avec le retard de lancement en jours comme résultat. Réfutée si l’intervalle à 95 % de la variation estimée se situe entièrement au-dessus de jours. La marge de 30 jours est un choix de protocole fait avant la collecte des données.
Prédiction 4 (le prix dépasse le coût). Là où les coûts en joules et en matériel par tâche sont mesurés, le rapport du prix catalogue au coût par tâche augmente quand le coût mesuré baisse. Test : panel de services avec une tâche déclarée, utilisant des mesures d’énergie ouvertes et des prix catalogue. Réfutée si le rapport est stable ou baisse dans plus de la moitié des tâches sur une période où le coût a baissé d’un facteur 2 ou plus.
Prédiction 5 (les dépenses se déplacent vers la friction). Sur un marché où le coût par tâche baisse, la part du chiffre d’affaires des vendeurs consacrée à la distribution, aux positions par défaut et au groupage augmente. Test : paiements de distribution et conditions de groupage publiés dans les documents déposés et les dossiers judiciaires, rapportés au chiffre d’affaires. Réfutée si la part est stable ou baisse tandis que le coût par tâche baisse d’un facteur 2 ou plus.
Prédiction 6 (la latence du marché suit l’entreprise la plus rapide). Sur les marchés où les acheteurs peuvent atteindre plus d’un vendeur avec une faible friction, la latence du marché est proche de la latence minimale des entreprises, et sur les marchés à forte friction mesurée elle est plus proche de la médiane. Test : régresser la latence du marché sur la friction de changement mesurée. Réfutée si l’intervalle à 95 % de la pente sur la friction se situe entièrement à zéro ou en dessous.
Prédictions sur le financement et le coût du déploiement des infrastructures. Les prédictions des Sections 10 et 12 portent sur les flux d’argent et sur le coût d’une heure d’accélérateur. Elles sont énoncées dans ces sections et sont testées sur des documents déposés et des offres datés d’après cet article.
Ce qui réfuterait le modèle lui-même. Le constat que les dates de lancement sont uniformes au sein du trimestre pour les entreprises cotées (Prédiction 1), que les entreprises cotées et non cotées lancent au même rythme (Prédiction 2) et que l’arrivée d’outils de portage ne change pas le retard (Prédiction 3) ne laisserait aucun rôle aux calendriers ni aux portes de publication des résultats, et la latence artificielle de la Définition 2 serait nulle dans la mesure. Le modèle se réduirait alors au délai d’ingénierie .
9. La boucle de l’argent : ce que les documents déposés établissent
Une description courante du déploiement actuel est celle d’une économie circulaire : les laboratoires achètent du calcul aux nuages, les nuages et les néonuages achètent des puces et de la mémoire, et les fabricants de puces et les nuages investissent dans les laboratoires. Cette section expose ce que disent des documents datés sur cette description. Elle ne rend aucun verdict. Chaque élément est marqué établi quand un document déposé, une publication datée ou une statistique officielle indique le montant et les contreparties, inféré quand il découle par calcul de chiffres établis sous une hypothèse déclarée, et non trouvé quand les sources lues ne le disent pas.
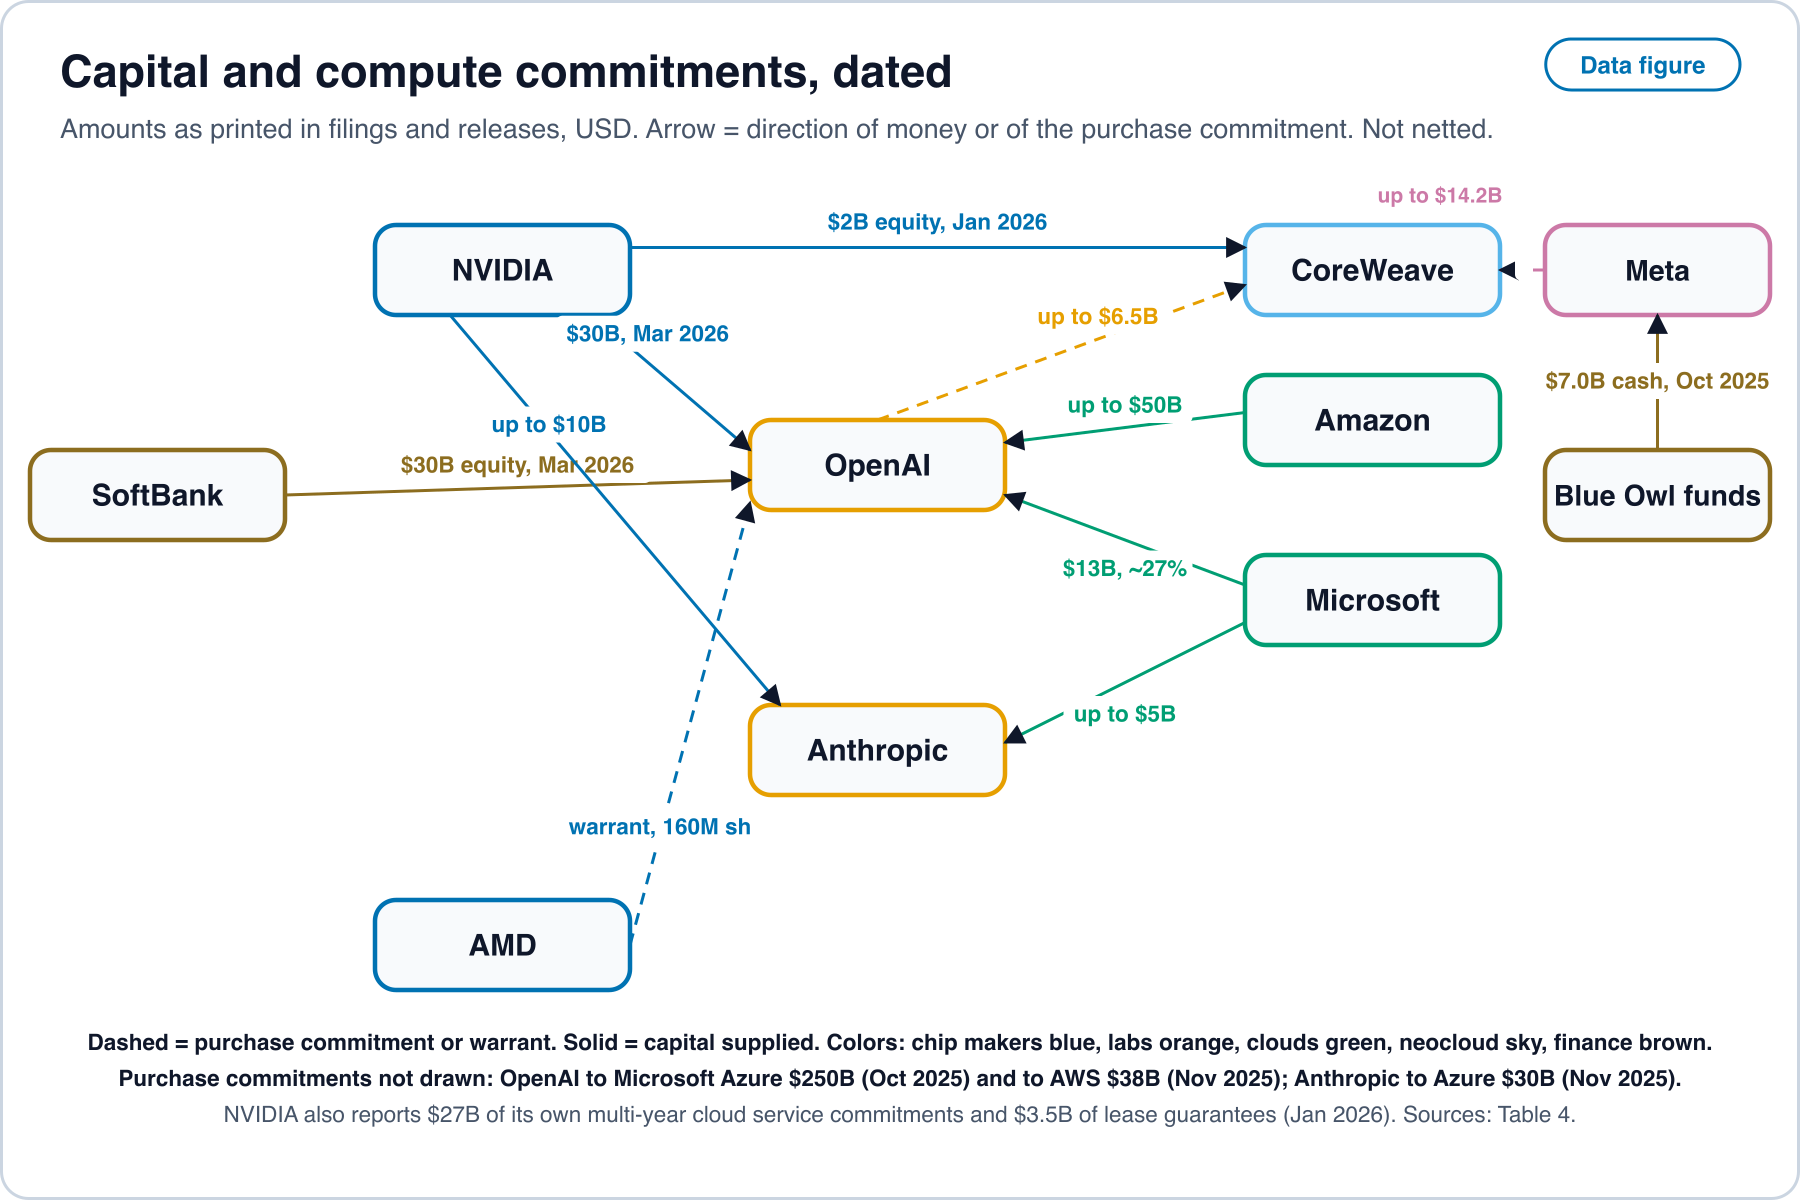
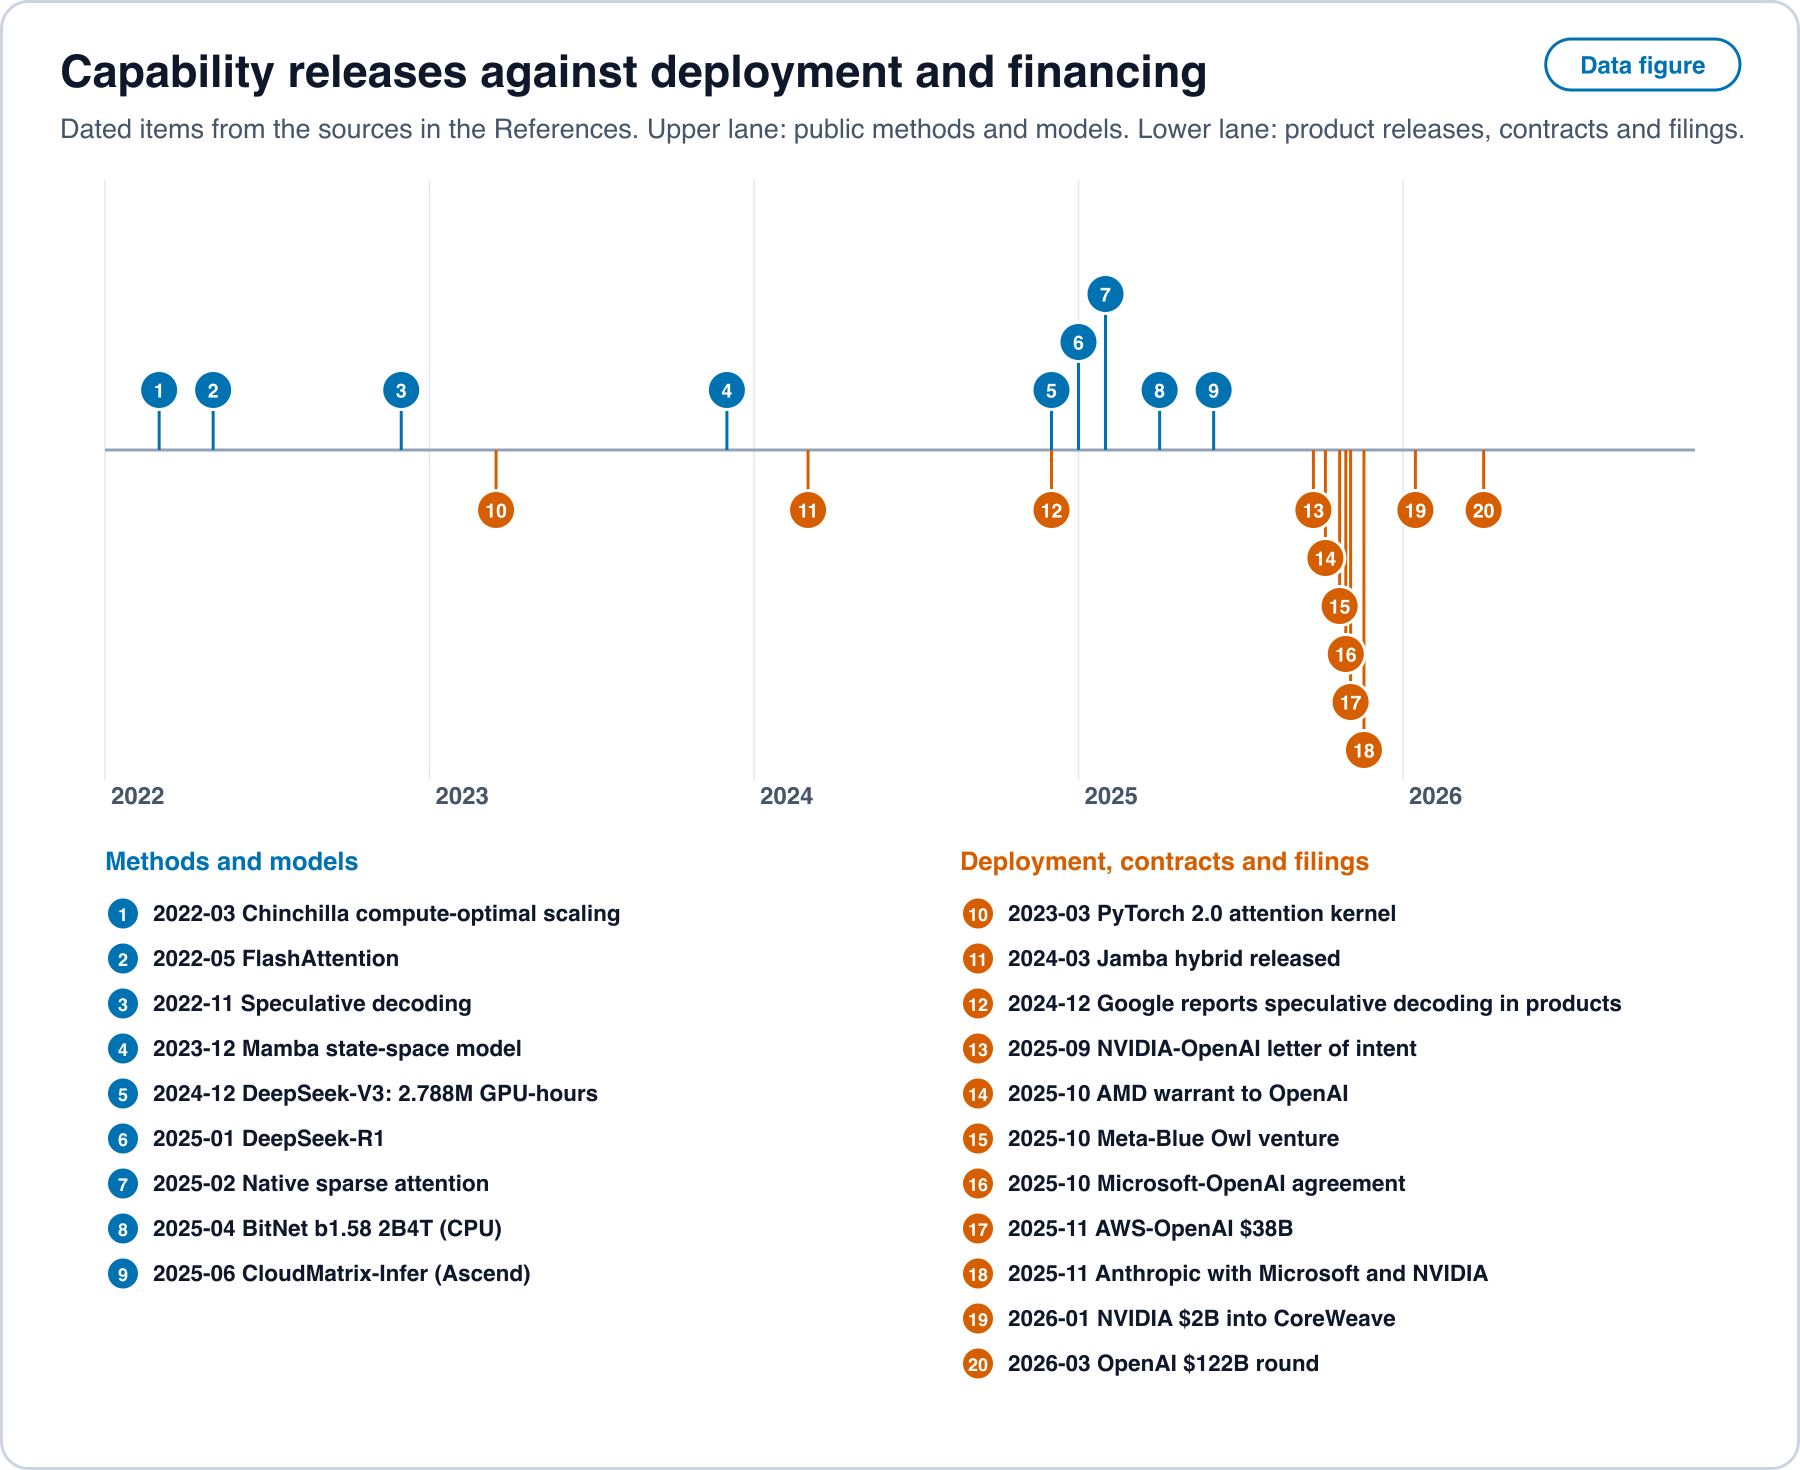
scripts/figures/latency_figures.py avec latency_data/flows.csv ; les sources sont énumérées dans le Tableau 4. Open full sizeCapital fourni aux clients. Dans le tour de table de 122 milliards de dollars qu’OpenAI a bouclé en mars 2026, NVIDIA est rapportée à 30 milliards de dollars, Amazon à jusqu’à 50 milliards et SoftBank à 30 milliards [9]. Une lettre d’intention antérieure indiquait que NVIDIA avait l’intention d’investir jusqu’à 100 milliards de dollars progressivement, à mesure que chaque gigawatt serait déployé, ce qui est une déclaration d’intention et non une transaction conclue [87]. Microsoft déclare environ 27 % de la public benefit corporation d’OpenAI et 13 milliards de dollars d’engagements de financement totaux comptabilisés selon la méthode de la mise en équivalence [7]. Pour Anthropic, NVIDIA et Microsoft se sont engagées à investir jusqu’à 10 et 5 milliards de dollars [10]. NVIDIA a acheté pour 2 milliards de dollars d’actions de classe A de CoreWeave après la fin de l’exercice 2025 de cette société [4]. AMD a émis au profit d’OpenAI un bon de souscription portant sur jusqu’à 160 millions d’actions à 0,01 dollar par action, acquis par tranches liées aux achats de produits GPU AMD Instinct [88].
Achats engagés par les clients. OpenAI s’est engagée par contrat à acheter 250 milliards de dollars supplémentaires de services Azure [7, 89], un accord de 38 milliards de dollars avec AWS que l’annonce décrit comme croissant sur sept ans [8], et jusqu’à 6,5 milliards de dollars auprès de CoreWeave, tandis que Meta a un bon de commande auprès de CoreWeave de jusqu’à 14,2 milliards [4]. Anthropic s’est engagée à acheter 30 milliards de dollars de calcul Azure et à contracter jusqu’à un gigawatt de plus [10]. NVIDIA elle-même déclare 27 milliards de dollars d’engagements pluriannuels de services cloud et 3,5 milliards de dollars de garanties portant sur des terrains, de l’électricité et des bâtiments nus au profit de partenaires en phase de démarrage [3].
Tableau 4. Ce qui est établi, ce qui est inféré, et ce que les sources ne disent pas.
| Élément | Établi | Inféré, avec l’hypothèse | Non trouvé dans les sources lues |
|---|---|---|---|
| Capitaux propres des fournisseurs dans les clients | Les montants et dates ci-dessus [9, 10, 4] | Aucune inférence | Si des capitaux propres sont conditionnés à des achats, sauf le bon de souscription d’AMD, dont l’acquisition est liée à des achats de GPU dans le document déposé [88] |
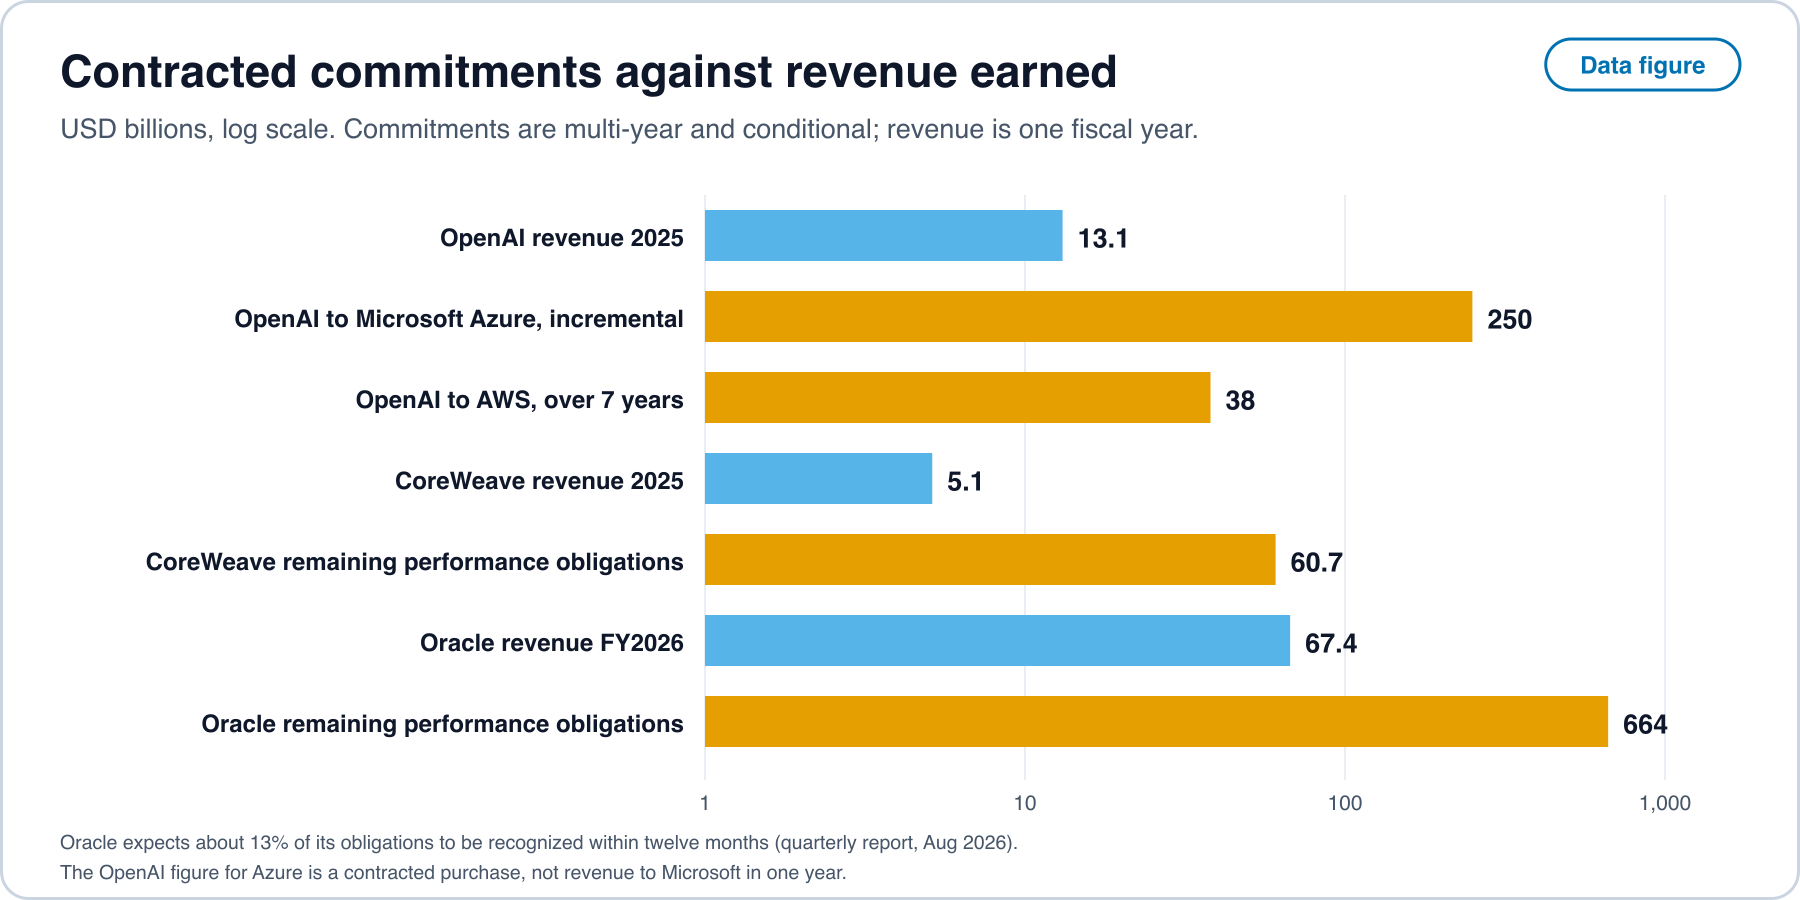
| Achats des laboratoires aux nuages | Azure 250 et AWS 38 milliards de dollars pour OpenAI ; Azure 30 milliards pour Anthropic [7, 8, 10] | le chiffre d’AWS représente en moyenne environ 5,4 milliards de dollars par an s’il est réparti uniformément sur sept ans | La durée et la montée en charge de l’engagement Azure ; les conditions attachées au chiffre de 50 milliards de dollars d’Amazon |
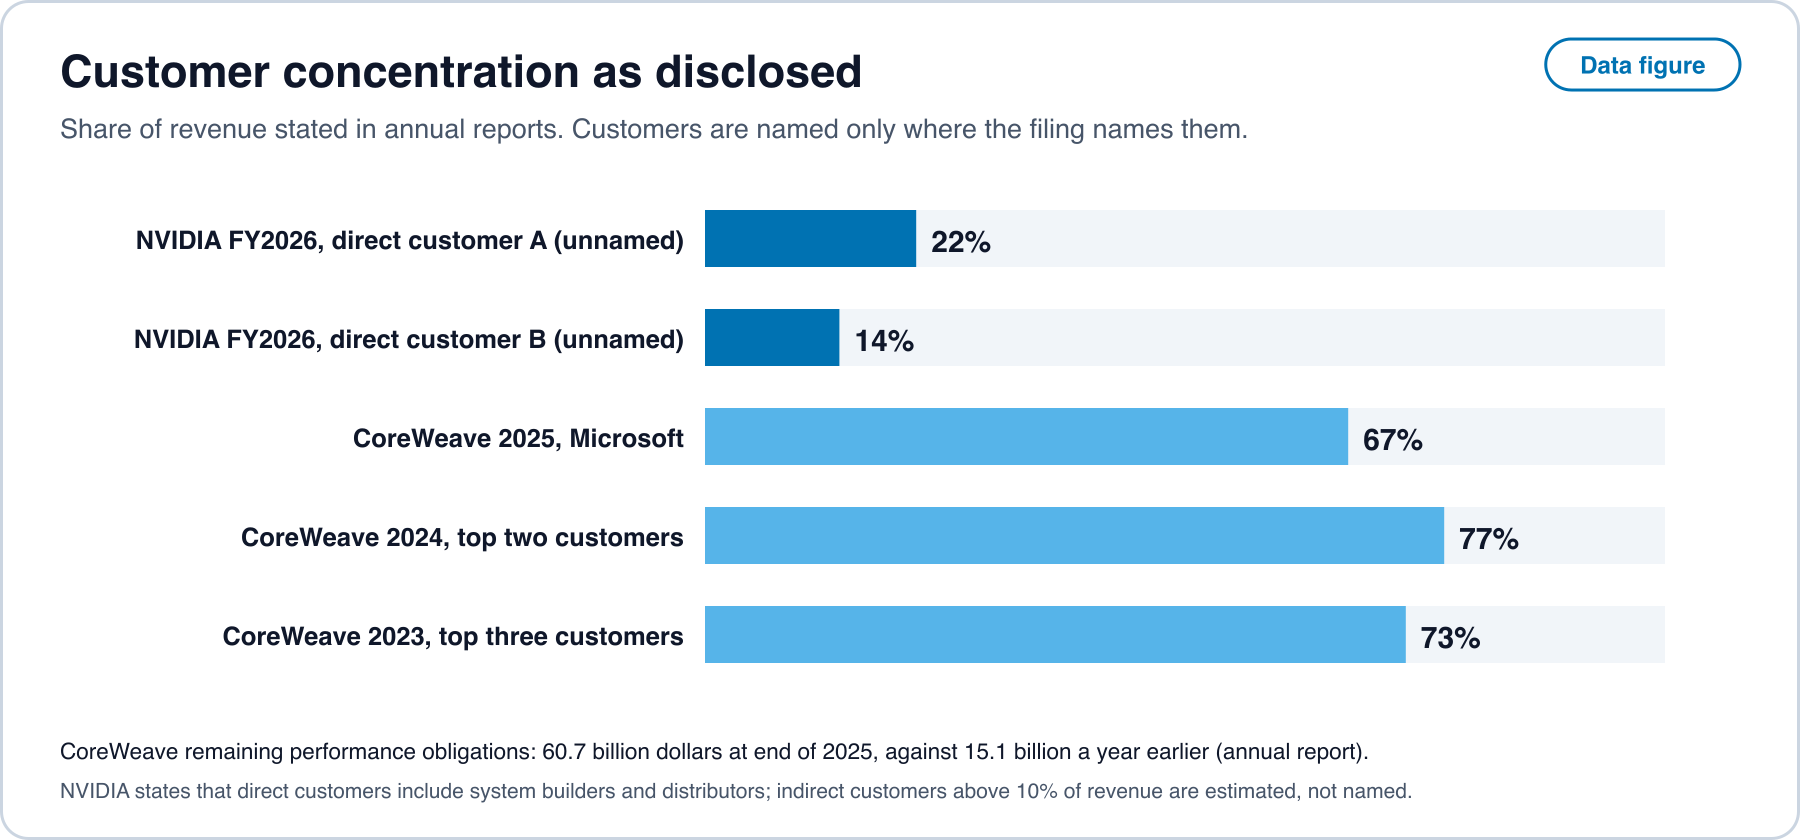
| Concentration des clients | Clients directs de NVIDIA à 22 % et 14 % du chiffre d’affaires, avec des intégrateurs de systèmes et des distributeurs parmi les clients directs [3] ; CoreWeave avec Microsoft à 67 % du chiffre d’affaires 2025 [4] | Une borne inférieure de l’indice de Herfindahl à partir des parts publiées : au moins 0,068 pour NVIDIA et 0,449 pour CoreWeave | Qui se tient derrière les clients directs de NVIDIA |
| Paiements anticipés des clients | Les produits constatés d’avance d’Oracle issus de paiements anticipés de clients comportant une composante de financement significative ont augmenté de 11,4 milliards de dollars dans le trimestre, au sein d’un flux de trésorerie d’exploitation de 23,1 milliards [5] | Environ la moitié du flux de trésorerie d’exploitation de ce trimestre provenait de paiements anticipés | Quels clients ont payé d’avance |
| Financement au niveau d’une coentreprise | Des fonds Blue Owl détiennent 80 % et Meta 20 % d’une coentreprise pour le campus Hyperion ; les fonds ont apporté 7,0 milliards de dollars en liquidités pour un coût de développement d’environ 27 milliards de dollars [2, 1] | Les liquidités représentent environ un quart du coût de développement | Conditions du bail, dette levée par la coentreprise et garanties |
| Durées d’amortissement | Durées déclarées pour les serveurs dans la Figure 12 [4, 14, 15, 16, 17] | Faire passer une durée de 5 à 6 ans abaisse d’un sixième la charge annuelle linéaire sur les mêmes actifs | La durée de service que les GPU atteignent en usage |
| Dépenses d’investissement en liquidités contre trésorerie d’exploitation | La série annuelle de la Figure 8 [11] | Le rapport des deux | Contrats de location-financement et locations hors bilan |
Le terme client dans ce tableau suit l’usage propre à chaque document déposé. L’argent est fongible, si bien qu’un document déposé peut montrer que du capital est allé à un client et que le client a payé le fournisseur, et ne peut pas montrer que l’un a financé l’autre. La Section 10 énonce un test qui fonctionne dans cette limite.
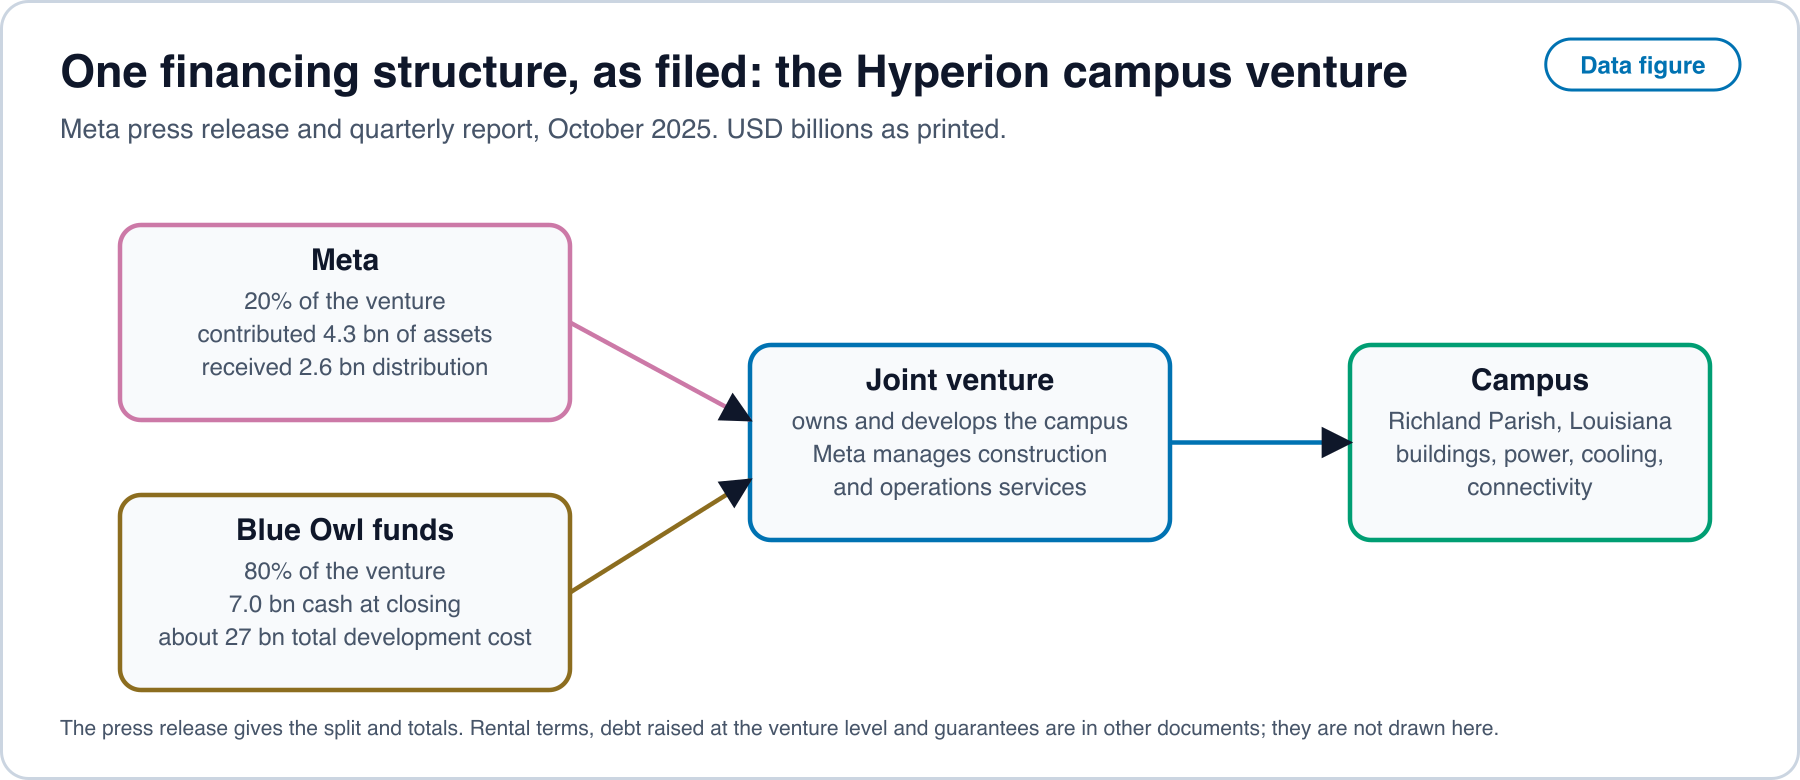
Concentration et carnet de commandes. Les parts de clients publiées sont élevées aux nœuds endettés et plus faibles chez le plus grand fabricant de puces. CoreWeave déclare ses trois premiers clients à 73 % du chiffre d’affaires 2023, ses deux premiers à 77 % en 2024 et Microsoft seule à 67 % en 2025 [4]. Ses obligations de prestation restant à remplir, de 60,7 milliards de dollars, représentent 11,8 fois son chiffre d’affaires 2025 de 5,131 milliards. Oracle déclare des obligations de 664 milliards de dollars au 31 août 2026 et s’attend à ce qu’environ 13 % d’entre elles soient comptabilisées au cours des douze mois suivants [5, 6], contre un chiffre d’affaires de l’exercice 2026 de 67,4 milliards [11]. OpenAI a déclaré un chiffre d’affaires de 13,1 milliards de dollars pour 2025 et a indiqué un rythme de 2 milliards de dollars par mois en mars 2026 [9]. Les achats contractés sont pluriannuels et soumis à des conditions que ces chiffres ne montrent pas ; ils ne sont donc pas du chiffre d’affaires d’une seule année et ne s’additionnent pas aux chiffres ci-dessus.
Les laboratoires achètent aussi ailleurs. Anthropic a annoncé un projet d’utiliser jusqu’à un million de TPU, d’une valeur de plusieurs dizaines de milliards de dollars et bien plus d’un gigawatt de capacité en 2026 [90]. OpenAI a annoncé un projet de déployer 10 gigawatts d’accélérateurs de sa propre conception [91] et détient le bon de souscription d’AMD mentionné ci-dessus. Un laboratoire qui achète à plusieurs fournisseurs et conçoit ses propres composants n’est le client unique d’aucun d’entre eux, ce qui compte pour la borne de la section suivante.
10. Un test de boucle fermée et ses prédictions
La question à laquelle les documents ne peuvent pas répondre seuls est de savoir quelle part du chiffre d’affaires d’un fournisseur est payée avec de l’argent que le fournisseur a lui-même fourni. Le test ci-dessous la transforme en quantités qu’un document déposé peut borner.
Pour une fenêtre (un exercice), soit le capital fourni par le fournisseur au client (capitaux propres, prêts, garanties, bons de souscription évalués à l’émission), soit le chiffre d’affaires que reçoit de , soit le chiffre d’affaires total de , et soit le capital que lève auprès de toutes les sources.
Définition 3 (ratio d’aller-retour). , le capital fourni par dollar de chiffre d’affaires reçu de la même contrepartie.
Définition 4 (borne de la part en boucle fermée). . Un client ne peut pas avoir payé avec plus du propre capital de que ce que a fourni, ni plus que ce qu’il a payé, donc est une borne supérieure de la part de qui aurait pu être financée par le propre capital de . La contrepartie côté client est , la part du capital levé par qui provenait de ses propres fournisseurs. Toutes deux sont des bornes calculées à partir de chiffres publiés. Ce ne sont pas des estimations de ce qui s’est passé, parce que l’argent est fongible.
Proposition 7 (quand un achat financé par le fournisseur est rentable). Soit un fournisseur qui vend au prix avec un coût unitaire et une marge brute . Supposons qu’il fournisse un capital qui induit une part des ventes qui n’auraient pas eu lieu autrement, et qu’il récupère une valeur de sa participation. Le profit supplémentaire est . Si la totalité de est dépensée auprès de , de sorte que , alors si et seulement si , où .
Dérivation. Substituer et résoudre . (À la main, non vérifié par machine.)
Conséquence. Comme , le financement par le fournisseur n’est rentable par les seules ventes induites que si . Avec la marge brute de 71,1 % déclarée par NVIDIA pour l’exercice 2026 [3], la participation doit être censée récupérer au moins 28,9 % du capital. La sortie du modèle pour la part induite d’équilibre à des taux de récupération de 0, 25 %, 50 %, 75 % et 100 % est 1,41, 1,05, 0,70, 0,35 et 0 ; sans récupération, aucune part de ventes induites ne suffit.
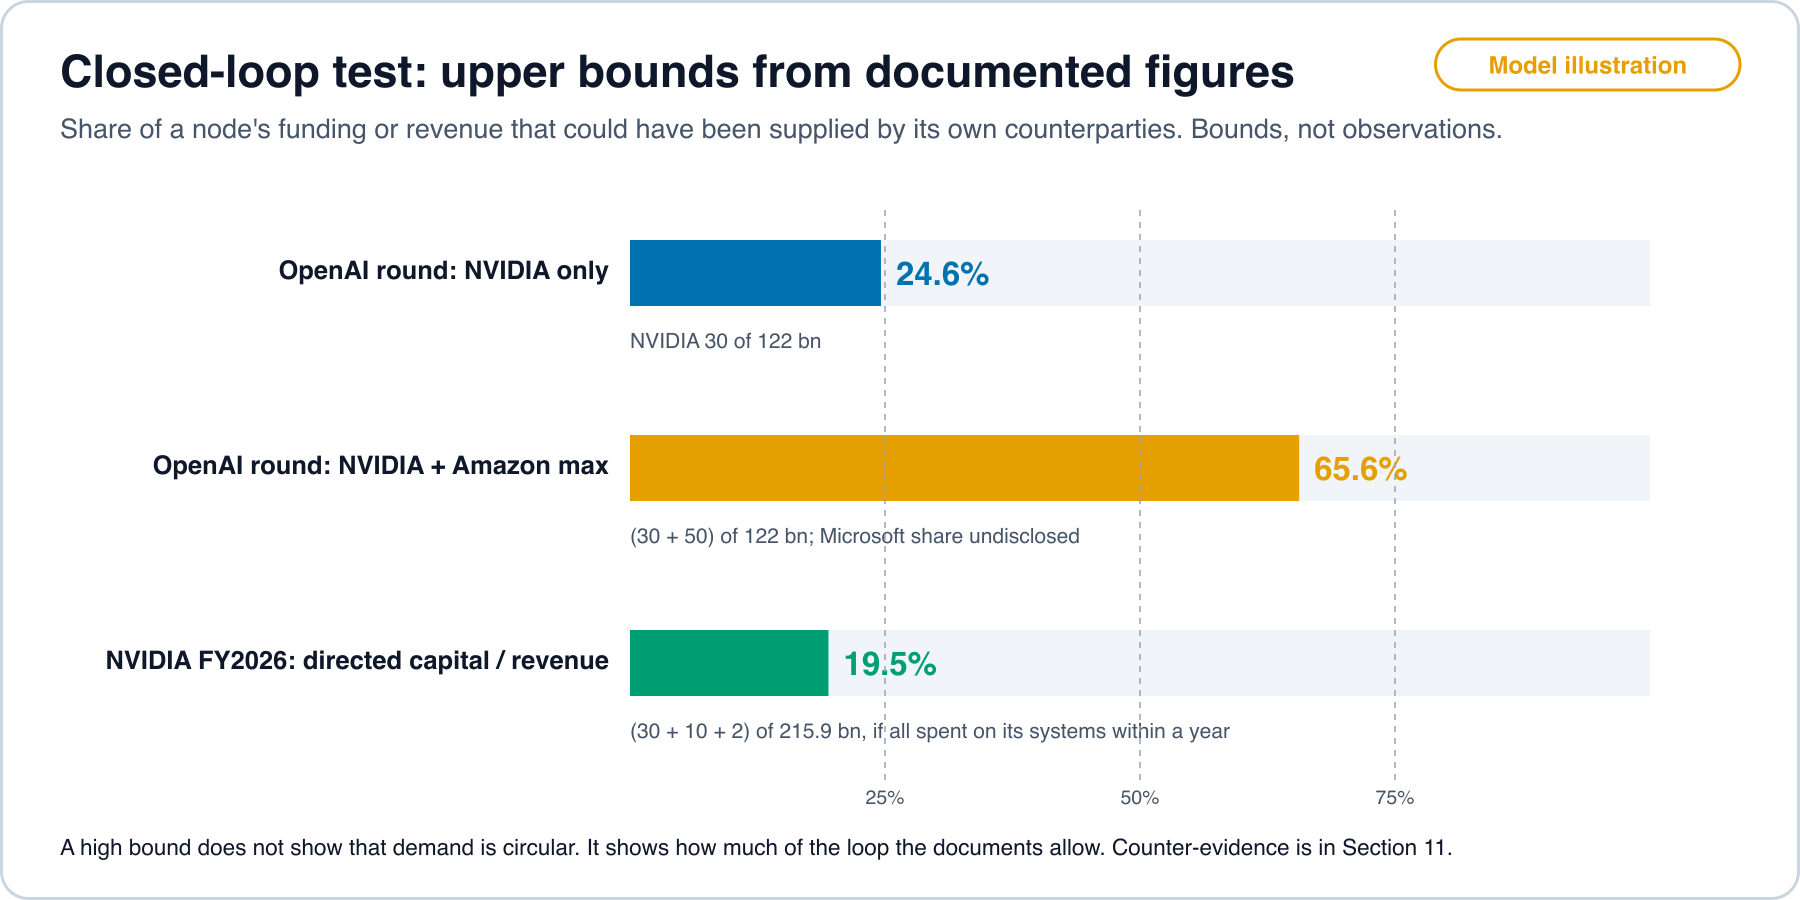
latency_data/model_outputs.json, calculé par model_airace.py à partir de [9, 10, 4, 3]. Open full sizeBornes tirées des documents. La part de NVIDIA dans le tour de table d’OpenAI est d’au plus 24,6 %, et avec Amazon à son maximum déclaré les deux atteignent au plus 65,6 %, la part de Microsoft n’étant pas publiée (sortie du modèle). Le capital que NVIDIA a annoncé fournir, ou qu’elle aurait fourni selon les comptes rendus, à des clients de novembre 2025 à mars 2026 est de 42 milliards de dollars (30 pour OpenAI, jusqu’à 10 pour Anthropic et 2 pour CoreWeave), soit 19,5 % de son chiffre d’affaires de l’exercice 2026 de 215,9 milliards et 41 % de son flux de trésorerie d’exploitation de 102,7 milliards [3, 11]. Le premier chiffre est une comparaison d’ordre de grandeur, puisque les montants et l’année du chiffre d’affaires diffèrent. Lu comme une borne, il signifie que si chacun de ces dollars revenait en chiffre d’affaires de NVIDIA dans l’année, au plus environ un cinquième du chiffre d’affaires de cette année serait financé par le propre capital de NVIDIA.
Prédictions. Chacune nomme des données, un test et un résultat qui compterait contre l’affirmation. Ces prédictions ont été écrites après la lecture des documents déposés ci-dessus, et elles sont testées sur des documents déposés datés d’après cet article.
Prédiction 7 (la part de la boucle reste bornée). Pour chaque fournisseur de puces ou de cloud ayant un capital dirigé publié, calculé à partir de chaque rapport annuel reste inférieur à 0,25 tandis que le chiffre d’affaires provenant de clients qui n’ont reçu aucun capital dirigé croît au moins aussi vite que celui provenant de ceux qui en ont reçu. Test : documents annuels déposés, avec les clients nommés là où les documents les nomment. Réfutée si dépasse 0,5 sur un exercice, ou si la croissance du chiffre d’affaires est concentrée sur les clients qui ont reçu du capital dirigé. Les valeurs entre 0,25 et 0,5 ne sont pas concluantes.
Prédiction 8 (le chiffre d’affaires des utilisateurs finaux croît plus vite que les engagements). Pour un laboratoire, le rapport des achats contractés au chiffre d’affaires des douze derniers mois baisse sur quatre trimestres consécutifs tandis que le chiffre d’affaires augmente. Test : déclarations des laboratoires et publications sur les carnets de commandes des nuages. Réfutée si le rapport augmente pendant quatre trimestres consécutifs.
Prédiction 9 (les tensions apparaissent d’abord là où la concentration et l’endettement sont les plus élevés). Quand un laboratoire révise à la baisse un engagement de calcul, l’ampleur des révisions des prévisions aux nœuds fournisseurs est ordonnée selon leur part publiée du premier client. Test : révisions des prévisions après tout événement de ce type, ordonnées selon la part publiée du premier client. Réfutée si l’ordre est sans rapport avec la concentration.
Prédiction 10 (la substitution réduit la capacité engagée par dollar de chiffre d’affaires). Là où les méthodes ouvertes et un matériel moins cher réduisent le temps d’accélérateur par tâche (Section 12), les gigawatts engagés par dollar de chiffre d’affaires des laboratoires baissent. Test : capacité annoncée et chiffre d’affaires des laboratoires par trimestre. Réfutée si les gigawatts engagés par dollar de chiffre d’affaires augmentent pendant quatre trimestres consécutifs tandis que le temps d’accélérateur mesuré par tâche baisse aussi sur des bancs d’essai ouverts.
11. Les contre-preuves les plus fortes
La lecture selon laquelle le déploiement est surtout une boucle fermée se heurte à quatre ensembles de documents qui pointent dans l’autre sens, et à un ensemble qui pointe vers la fragilité.
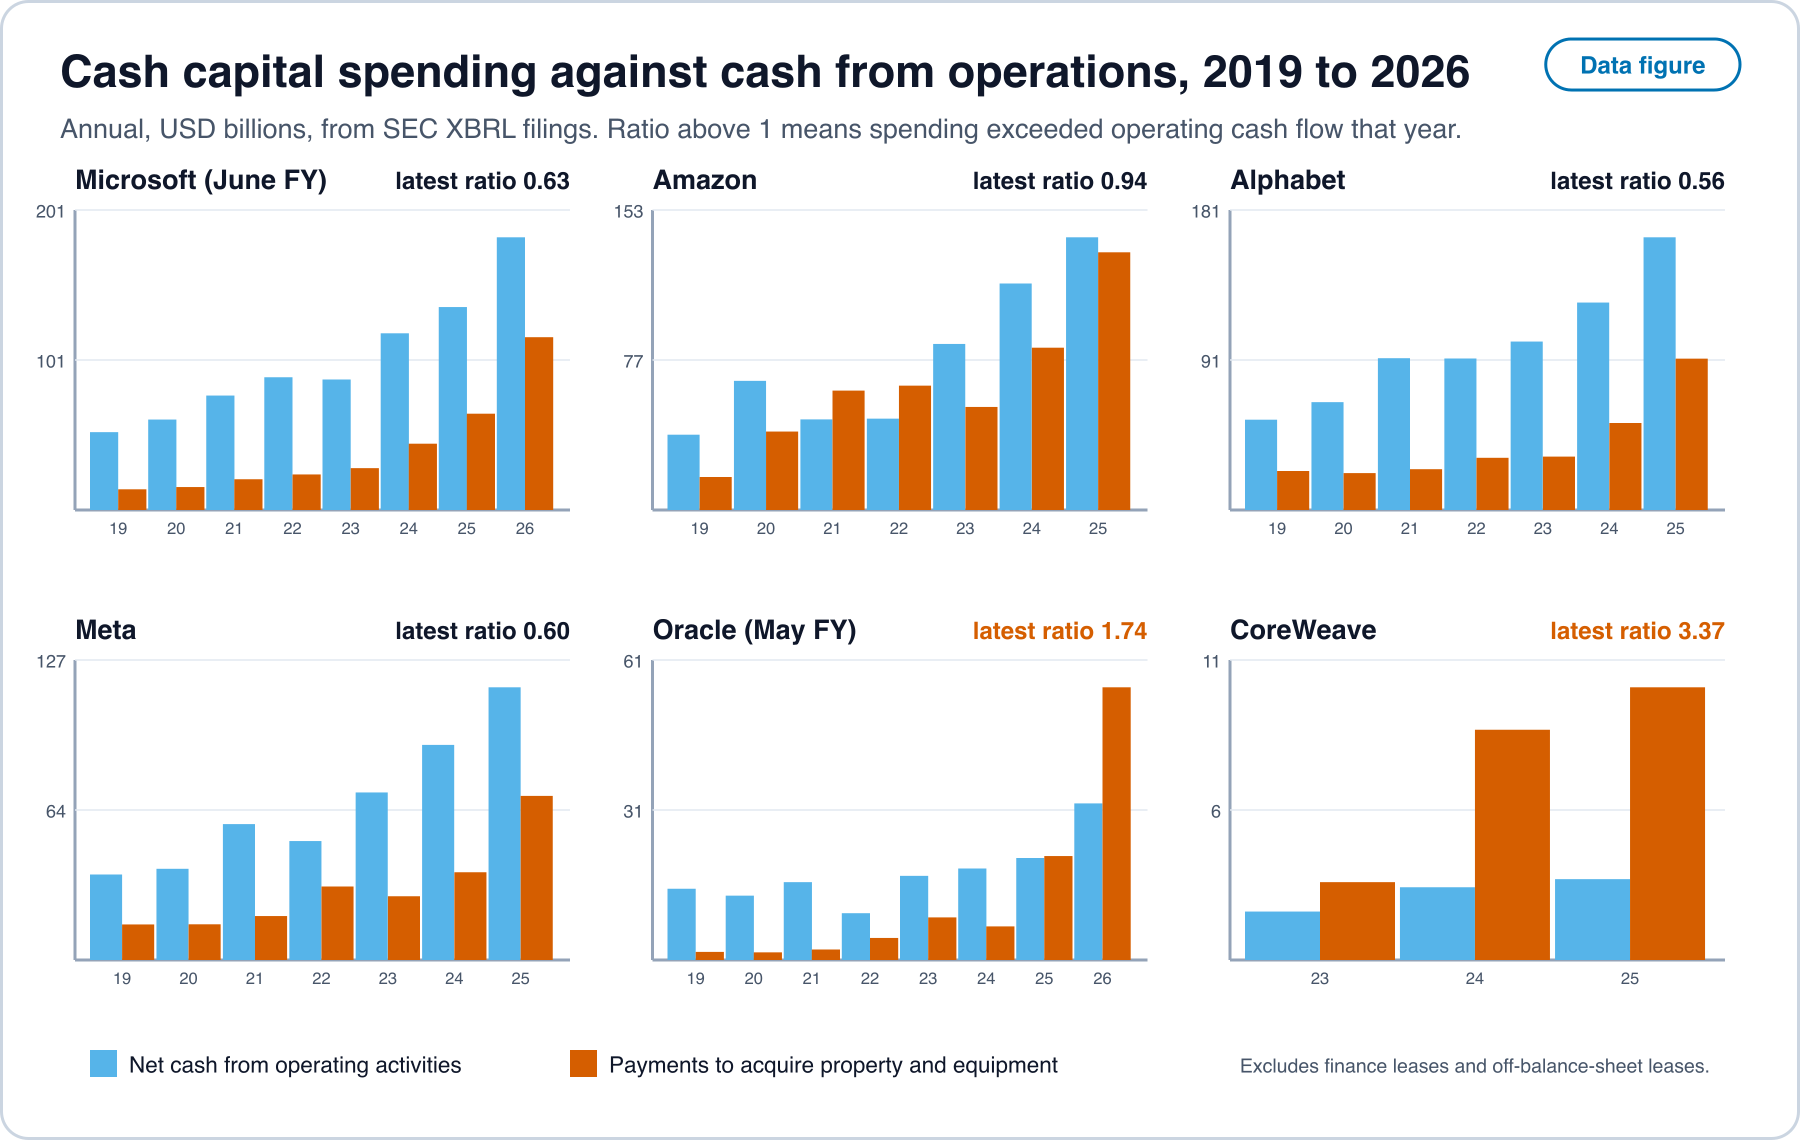
La plupart des dépenses sont financées par l’exploitation chez les plus gros acheteurs. Lors de leurs derniers exercices, les dépenses d’investissement en liquidités représentaient 0,63 du flux de trésorerie d’exploitation chez Microsoft, 0,94 chez Amazon, 0,56 chez Alphabet et 0,60 chez Meta [11]. Les dépenses sont importantes, et elles sont payées sur des liquidités que ces mêmes entreprises gagnent dans d’autres activités.
latency_data/capex_ocf.csv [11]. Open full sizeLe plus grand fournisseur de puces pourrait financer son capital dirigé sur sa propre trésorerie. Les 42 milliards de dollars ci-dessus représentent 41 % d’une année de flux de trésorerie d’exploitation de NVIDIA [3, 11], et ses deux plus grands clients directs représentent 22 % et 14 % du chiffre d’affaires, avec des intégrateurs de systèmes et des distributeurs parmi eux [3].
Le chiffre d’affaires provenant des utilisateurs finaux est réel et croissant dans les états financiers lus. OpenAI a déclaré 13,1 milliards de dollars de chiffre d’affaires pour 2025 et un rythme de 2 milliards de dollars par mois en mars 2026, soit 24 milliards en rythme annuel (calcul) [9].
Les laboratoires se diversifient. Le projet d’Anthropic portant sur jusqu’à un million de TPU, à côté de ses engagements Azure et NVIDIA, et les projets d’OpenAI pour ses propres accélérateurs ainsi que le bon de souscription d’AMD, signifient que les laboratoires nommés ici ont plus d’une source de puces dans leurs projets annoncés [90, 10, 91, 88].
Ce que les contre-preuves n’éliminent pas. Les dépenses d’investissement en liquidités représentaient 1,74 fois le flux de trésorerie d’exploitation chez Oracle lors de l’exercice 2026 et 3,37 fois chez CoreWeave en 2025 [11]. Le trimestre d’Oracle clos le 31 août 2026 montre un flux de trésorerie d’exploitation de 23,1 milliards de dollars, dont 11,4 milliards issus de paiements anticipés de clients, et un flux de trésorerie disponible négatif de 5 milliards [5, 6]. Les obligations de CoreWeave représentent 11,8 fois son chiffre d’affaires, et sa clientèle est concentrée [4]. Ce sont les nœuds où un manque de financement d’un laboratoire arriverait en premier, ce que teste la Prédiction 9.
Lecture nette, dans la limite des documents. Des boucles de plusieurs dizaines de milliards de dollars sont établies entre des fournisseurs et des clients nommés. Les documents bornent à moins d’un cinquième la part du chiffre d’affaires du plus grand fournisseur de puces que son propre capital aurait pu financer, et montrent que la plupart des dépenses des hyperscalers sont payées sur la trésorerie d’exploitation. Les nœuds concentrés et endettés, un nuage avec des paiements anticipés et un néonuage avec un seul client dominant, sont ceux où l’hypothèse de boucle compterait le plus. Les conditions des accords privés ne sont pas publiques, si bien que les documents donnent des bornes et non une mesure.
12. Ce que coûte une tâche : le modèle de coût des infrastructures
La Section 0 définit le coût par tâche comme . Cette section renseigne et à partir du coût d’une heure d’accélérateur et relie le résultat à , et .
Heure d’accélérateur. Soit le capital par accélérateur, y compris la part de l’installation, de l’alimentation électrique et du refroidissement, avec une durée de vie linéaire de ans et une utilisation . Le capital par heure utilisée est . Soit la puissance de l’installation par accélérateur en kilowatts et le prix de l’électricité par kilowattheure. Une tâche qui occupe heures utilisées coûte
Proposition 8 (le prix d’un joule chargé en capital). À matériel fixé, avec par équivalent kilowattheure, si bien que les joules par tâche restent la bonne unité de compte, et le prix qui convertit les joules en dollars est dominé par dès que . Dérivation. Éliminer entre les deux expressions. (À la main.)
Données d’entrée. Le jeu de données d’Epoch AI sur les centres de données donne, pour 74 sites disposant des deux chiffres, un capital médian d’environ 33 300 dollars et 880 watts de puissance d’installation par équivalent H100, le capital par équivalent H100 allant d’environ 19 600 à environ 200 800 dollars [12]. Ce sont des estimations construites à partir de permis publics et d’images, et le capital indiqué pour un site comprend le calcul, la construction et l’aménagement.
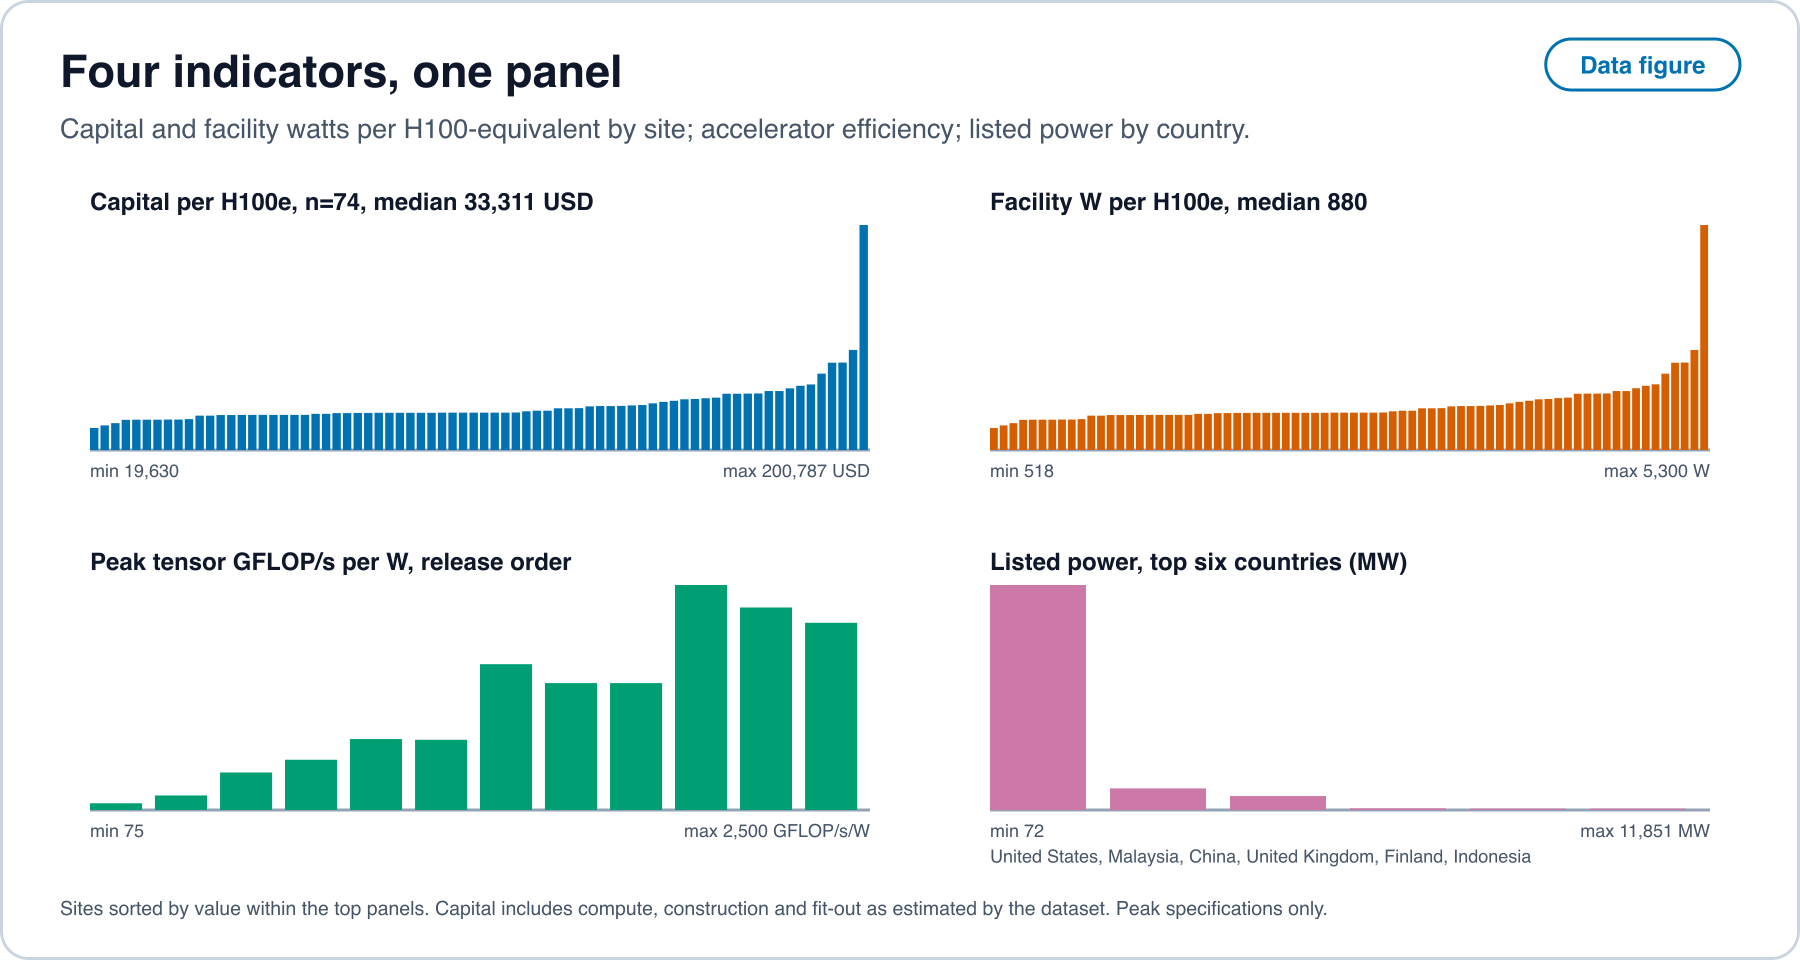
latency_data/frontier_dc_cost_per_h100e.csv, hardware_flops_per_watt.csv, frontier_dc_by_country.csv [12, 13]. Open full sizeSortie du modèle. Avec des durées de vie de 4 à 6 ans, une utilisation de 40 % à 80 % et une électricité à 0,04 à 0,12 dollar par kilowattheure, une heure d’accélérateur utilisée coûte entre environ 0,83 et 2,5 dollars, et l’énergie en représente entre 1,5 % et 11,8 %. Le prix chargé en capital est d’environ 0,9 à 2,7 dollars par équivalent kilowattheure, contre une électricité à 0,04 à 0,12, si bien que est dominé par le capital, à environ 8 à 70 fois le terme d’électricité.
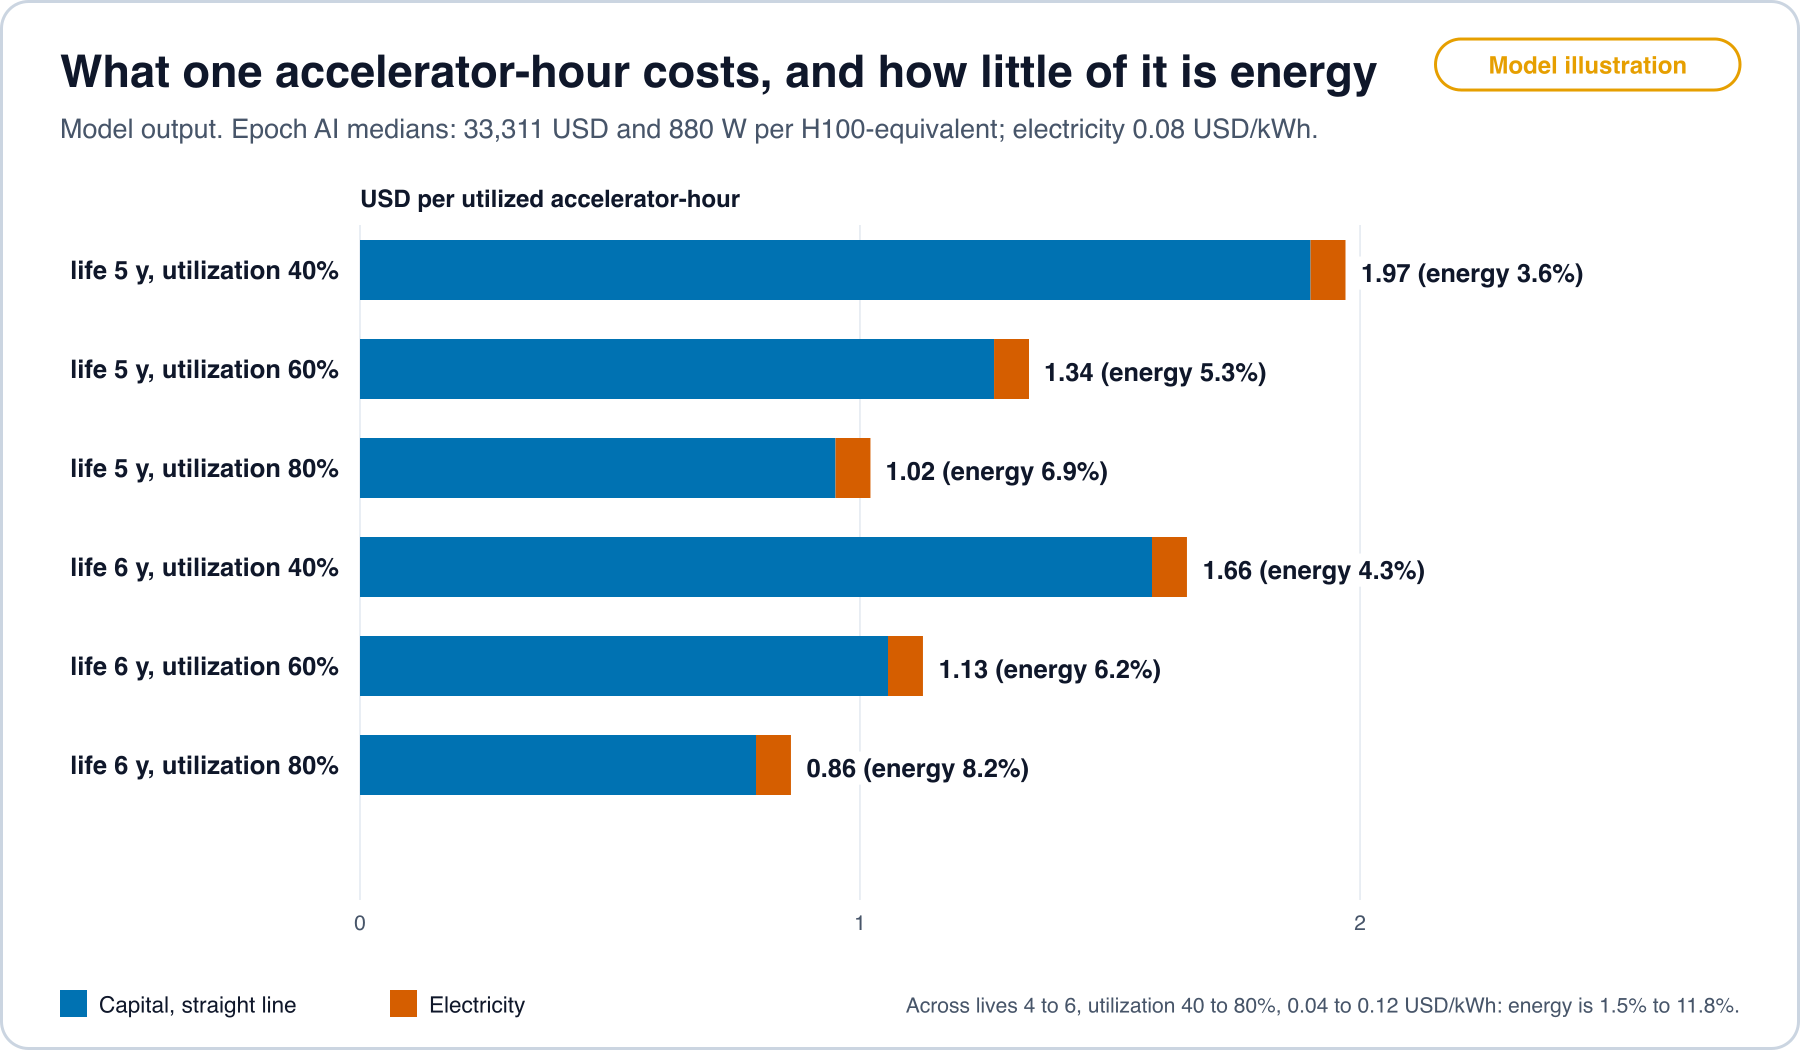
latency_data/model_outputs.json, calculé par model_airace.py à partir de [12]. Open full sizeTrois conséquences en découlent. Une électricité moins chère peut abaisser le coût d’une tâche au plus de la part de l’énergie, qui est au plus d’environ un huitième dans cette grille. L’utilisation compte autant que l’énergie : diviser par deux double . Et la durée de vie déclarée est un choix comptable qui fait varier proportionnellement à .
Durées de vie et efficacité. Les opérations tensorielles maximales par watt ont augmenté d’environ 1,42 fois par an sur douze accélérateurs de pointe de 2016 à 2024 selon les spécifications des fabricants eux-mêmes, soit un doublement environ tous les deux ans [13]. Un site limité en puissance qui remplacerait un composant par un autre plus récent de trois ans obtiendrait environ fois les opérations maximales avec la même puissance. Les spécifications maximales ne sont pas l’énergie délivrée par tâche, parce que l’utilisation, le trafic mémoire et le logiciel décident du chiffre délivré. Les durées de vie déclarées des serveurs dans la Figure 12 vont de 5 à 6 ans dans plusieurs grandes entreprises, et la fourchette déclarée est plus large dans d’autres. Des durées de vie de cette longueur et un doublement de l’efficacité en deux ans sont cohérents quand les composants plus anciens continuent de rapporter à des prix fixés par les plus récents, ce qui est une affirmation sur les prix et non sur la physique.
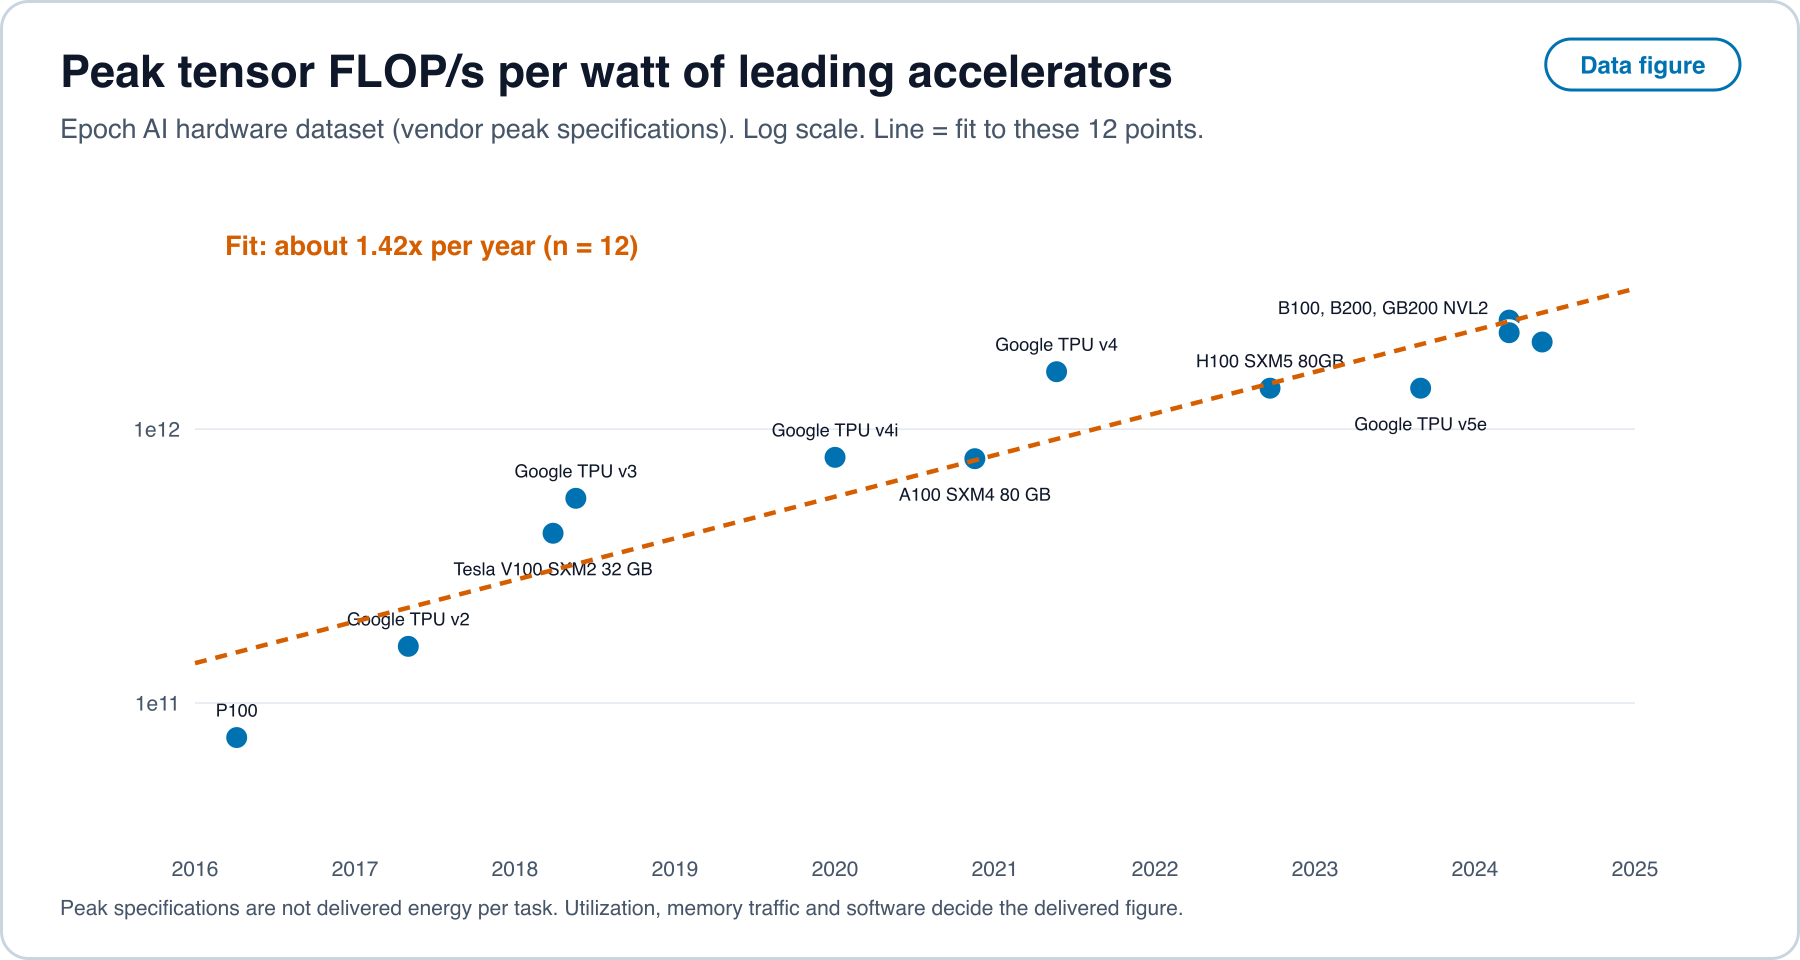
latency_data/hardware_flops_per_watt.csv et hardware_fit.json [13]. Open full size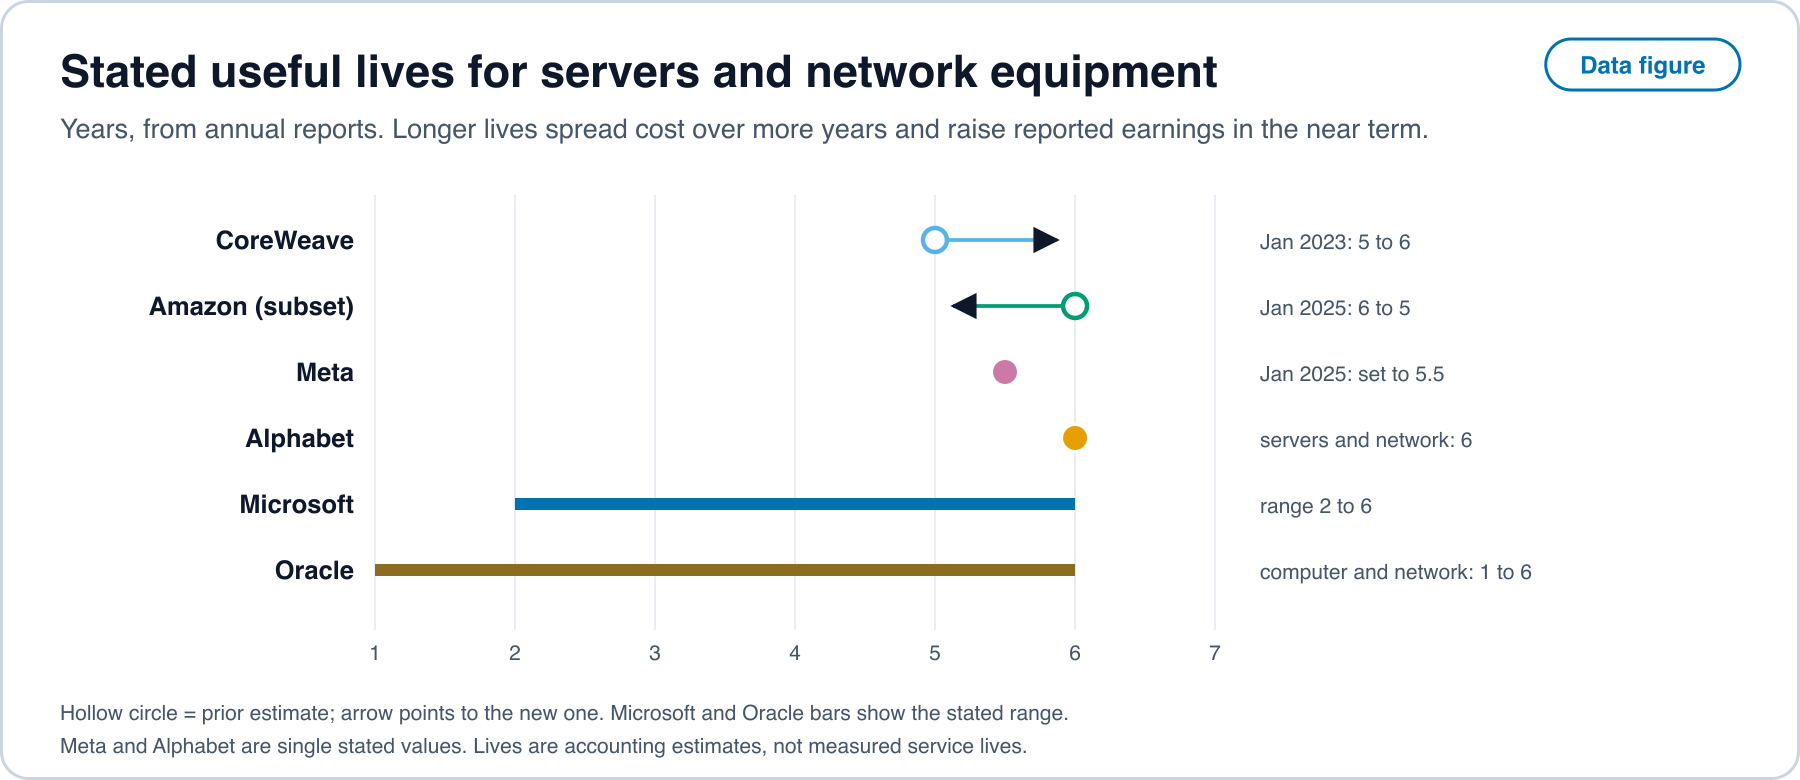
Le prix n’est pas le coût. Pour un système du niveau de GPT-3.5, le prix de l’inférence a baissé de plus de 280 fois entre novembre 2022 et octobre 2024, tandis que les coûts du matériel baissaient de 30 % par an et que l’efficacité énergétique du matériel s’améliorait de 40 % par an [18]. Sur les 1,9 année de cette fenêtre, ces taux donnent environ 2,0 fois pour le coût du matériel et 1,9 fois pour l’efficacité énergétique (sortie du modèle). Diviser 280 par 2,0 laisse un facteur d’environ 141 que le coût du matériel n’explique pas. Ce reste mêle des modèles plus petits, l’efficacité algorithmique, l’utilisation et les marges, et les sources ne le répartissent pas. Epoch AI estime par ailleurs que le calcul nécessaire pour une performance fixe de modèle de langage est divisé par deux environ tous les 8 mois [58], et que le prix pour un niveau fixe de banc d’essai a baissé de 9 à 900 fois par an avec une médiane proche de 50, les taux les plus rapides reposant sur moins d’un an de données [59].
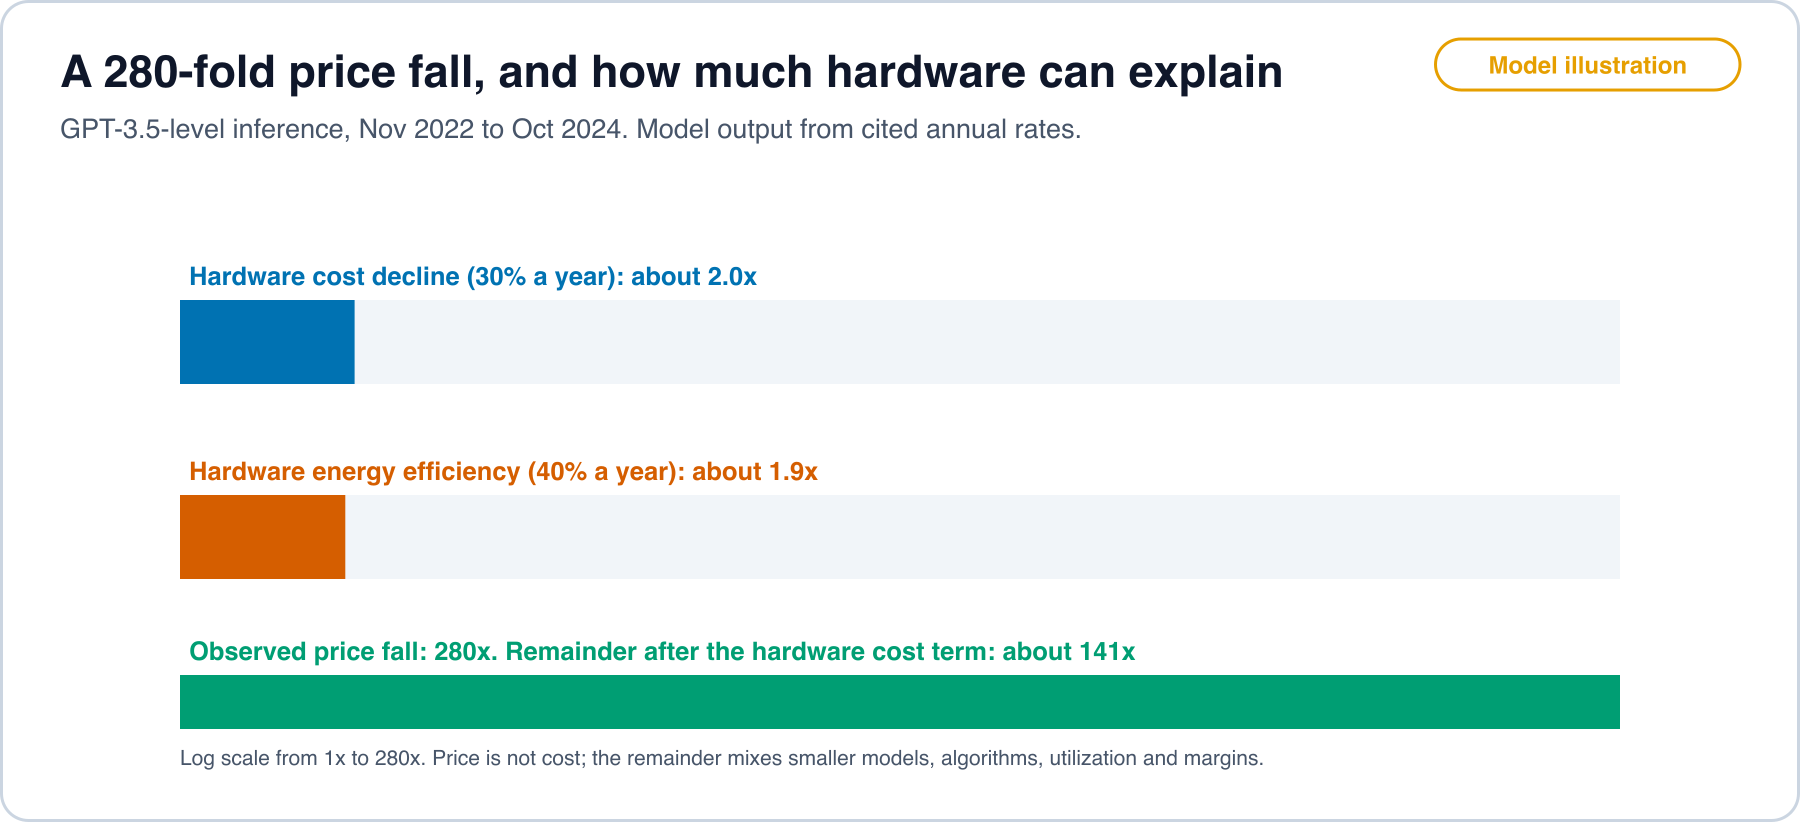
latency_data/model_outputs.json. Open full sizeLien avec les frontières. Soit le plus bas temps d’accélérateur par tâche à la qualité parmi les méthodes documentées et le temps dans les produits généralement disponibles. Alors pour la frontière des capacités, et la frontière déployée suit le prix proposé, qui est au moins égal au coût plus la marge de la Section 6. Le coût du matériel entre dans et de la même manière, parce que fournisseurs et acheteurs achètent sur le même marché ; il déplace donc les deux frontières ensemble et laisse presque inchangée. La latence est déplacée par le terme logiciel : une méthode qui réduit le temps d’accélérateur par tâche d’un facteur abaisse de ce facteur dès sa publication, et seulement quand un produit l’adopte. Pendant l’attente, le rapport du coût déployé au coût des capacités est .
Lien avec le modèle de cadence. Le capital est engagé par pas pluriannuels et imputé sur des durées de vie de plusieurs années, si bien que les dates de décision pour le matériel sont très espacées, et le coût d’adoption de la Section 6 inclut la valeur du capital installé qu’une nouvelle méthode immobiliserait inutilement ou économiserait. Une méthode qui fonctionne sur le matériel qu’une entreprise possède déjà a un coût d’adoption qui est surtout de l’ingénierie. Une méthode qui nécessite un nouveau matériel emporte avec elle le cycle du capital. C’est pourquoi les méthodes logicielles ouvertes sur des composants existants sont les moins soumises aux portes, et pourquoi la Prédiction 3 compare des cibles avec et sans outils de portage.
Là où le coût cesse de suivre la capacité. À qualité fixe , le coût par tâche baisse avec , avec le matériel et avec le prix. À la frontière des capacités, le coût par tâche est fixé par l’entraînement et le service des plus grands modèles et ne baisse pas de la même manière, ce qui explique qu’une tâche de qualité frontière et une tâche de qualité fixe aient des courbes de coût différentes. Les données ci-dessus ne mesurent que la seconde.
Prédiction 11 (les composants plus anciens continuent de rapporter). Si les durées de vie déclarées des serveurs sont économiquement réalistes, les prix de location par heure d’accélérateur pour des composants vieux de plusieurs années baissent plus lentement que ne l’impliqueraient les opérations maximales par watt. Test : offres de prix ouvertes et datées par composant et par âge, rapportées à l’ajustement d’efficacité de la Figure 11. Réfutée si le prix d’un composant plus ancien par unité d’opérations maximales baisse au moins aussi vite que l’ajustement d’efficacité.
Prédiction 12 (la part de l’énergie reste faible). Dans un échantillon de déploiements mesurés, la part de l’énergie dans le coût par tâche reste inférieure à 15 % pour des prix de l’électricité inférieurs à 0,12 dollar par kilowattheure. Test : mesure ouverte de l’énergie d’inférence [56] combinée aux prix répertoriés de l’heure d’accélérateur. Réfutée si la part mesurée dépasse 15 % dans une majorité de déploiements.
13. Méthodes ouvertes et matériel existant à parité
Une deuxième description du présent veut que le travail algorithmique ouvert permette à l’infrastructure existante et plus ancienne d’atteindre la parité avec la plus récente. Les données datées étayent une affirmation plus étroite, exposée ici selon le levier que chaque méthode actionne et selon le décalage jusqu’à un usage livré.
Tableau 6. Méthodes ouvertes, leurs articles datés et ce que montre un usage ultérieur.
| Levier | Méthode ouverte et ce que rapportent les auteurs | Publié | Usage ultérieur | Décalage |
|---|---|---|---|---|
| Quantification | Des modèles de 175 milliards de paramètres quantifiés en environ quatre heures de GPU à 3 ou 4 bits par poids avec une perte de précision négligeable [92] | oct. 2022 | Inférence locale en 4 bits rapportée comme praticable sur des machines grand public en 2023 [68] | Non calculé : l’usage ultérieur est une autre implémentation en 4 bits, et sa date est une preuve de classe opinion |
| Poids ternaires sur CPU | Un modèle de 2 milliards de paramètres avec 0,4 Go de mémoire hors plongements et 29 ms par token sur un CPU, contre 1,4 à 4,8 Go et 41 à 124 ms pour six modèles ouverts en pleine précision de taille similaire [26] | avr. 2025 | Poids du modèle publiés avec l’article | 0 mois |
| Noyaux d’attention | Attention exacte rendue plus rapide en tenant compte des lectures et écritures entre niveaux de mémoire [19] | mai 2022 | Noyaux d’attention accélérés dans la version PyTorch 2.0 [20] | Environ 10 mois |
| Mémoire de service | Mémoire clé-valeur paginée dans un système de service ouvert, avec un débit supérieur aux systèmes antérieurs à latence égale [93] | sept. 2023 | Code source publié avec l’article | 0 mois |
| Modèles à espace d’états et hybrides | Un modèle sans attention rapportant 5 fois le débit d’inférence des Transformers [21] ; un hybride qui tient sur un GPU de 80 Go, avec des poids ouverts [22] | déc. 2023 | L’hybride, mars 2024 ; d’autres hybrides en 2024 et 2025 [39] | Environ 3 à 4 mois |
| Décodage spéculatif | Distribution de sortie inchangée avec un décodage 2 à 3 fois plus rapide [23] | nov. 2022 | Rapporté dans des produits Google en déc. 2024 [24] | Environ 24 mois |
| Coût d’entraînement | 2,788 millions d’heures GPU H800 pour l’entraînement complet, autodéclarées [46] ; raisonnement par apprentissage par renforcement avec des modèles plus petits distillés [94] | déc. 2024 à janv. 2025 | Modèles distillés plus petits publiés avec le second rapport | Sans objet |
| Service hors NVIDIA | Efficacité de préremplissage de 4,45 tokens par seconde par TFLOPS sur des NPU Ascend, au-dessus des résultats publiés pour SGLang sur H100 et DeepSeek sur H800, puissance non rapportée [95] | juin 2025 | Déploiement des auteurs | Sans objet |
Les décalages sont calculés du mois de publication en ligne à la date de l’usage ultérieur, et reposent sur une paire par ligne. Ils forment un échantillon de quelques cas, non une distribution, et le protocole de la Section 16 précise comment en recueillir beaucoup.
Modèles ouverts contre la frontière fermée, par calcul d’entraînement. En prenant le premier modèle notable à chaque niveau de calcul d’entraînement, tous types d’accès confondus contre poids ouverts, le décalage des poids ouverts était de 1 mois à FLOP, 30 mois à , 24 mois à et 15 mois à , et aucun modèle à poids ouverts n’est encore recensé à [25]. Chaque niveau est franchi en premier par un seul modèle, si bien que les décalages reposent sur une paire par niveau. La tendance est que le décalage se réduit à mesure que le niveau monte, et la réserve est que le calcul d’entraînement n’est pas la capacité.
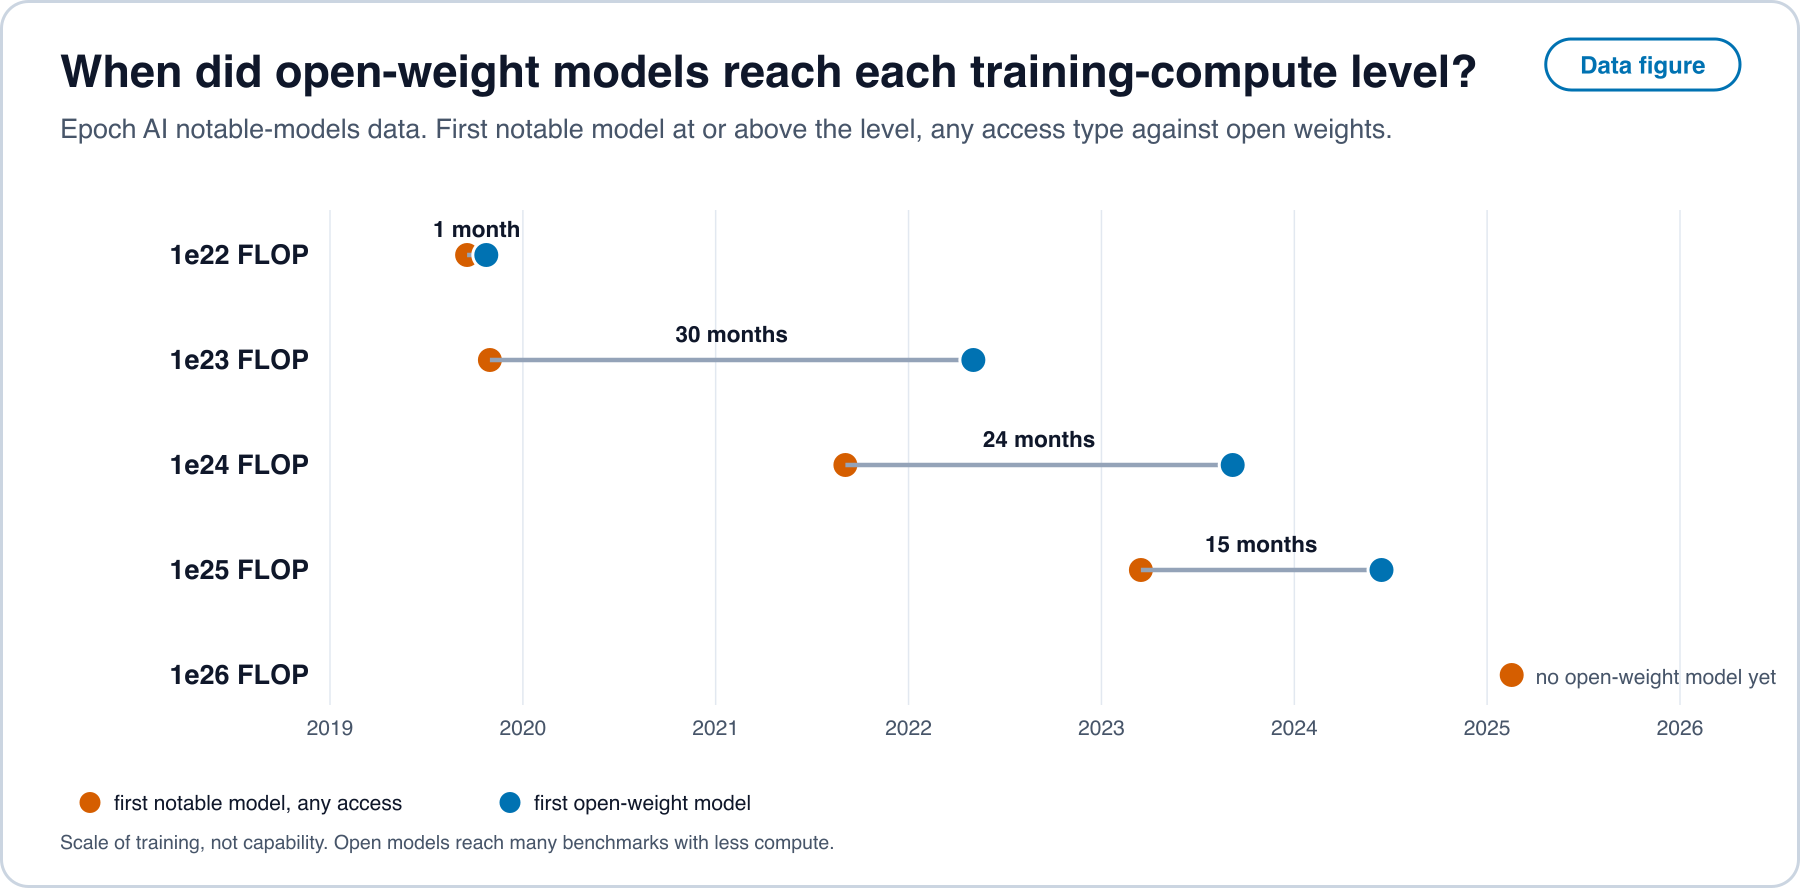
latency_data/compute_threshold_firsts.csv, d’après le jeu de données des modèles notables d’Epoch AI [25]. Open full sizeSur le matériel grand public, les modèles ouverts qui tiennent sur un seul GPU grand public rejoignent la frontière après en moyenne 6 à 12 mois, selon la mesure [63]. Les modèles à poids ouverts de toute taille ont environ un an de retard sur la frontière fermée dans les bancs d’essai, avec une fourchette de 5 à 22 mois [64].
Ce que parité signifie ici. Cela signifie le même score de banc d’essai. Cela ne signifie pas le même débit : une carte grand public exécute un flux, et un centre de données en sert beaucoup, où le traitement par lots et les noyaux comptent. Les gains de la quantification et des noyaux s’appliquent aux deux. Le calcul nécessaire pour une performance fixe est divisé par deux environ tous les 8 mois [58], soit fois par an, environ le double des 1,42 fois par an de l’efficacité du matériel de la Figure 11. Là où cela vaut, le progrès algorithmique dépasse le progrès matériel à qualité fixe, et les composants achetés plus tôt produisent plus de tâches d’une qualité donnée qu’auparavant. Que ces tâches supplémentaires soient vendues à des prix plus bas ou demandées en plus grand nombre est une question de demande qu’aucune des sources ici ne tranche.
14. D’autres manières de construire la machine
Une troisième description veut que des groupes fabriquant du matériel par des procédés orthogonaux montrent qu’une partie du coût de l’infrastructure conventionnelle est plus élevée que ce que la tâche exige. Les sources lues contiennent des démonstrations datées de conceptions analogiques, photoniques, neuromorphiques, FPGA, uniquement CPU et en électronique flexible. Elles diffèrent par la tâche, l’échelle et la mesure ; cette section rapporte donc chacune dans le cadre de son propre article et ne tire que des rapports qu’un article rapporte lui-même.
Tableau 7. Conceptions alternatives, ce qui a été mesuré et la réserve.
| Approche | Démonstration | Mesuré ou rapporté | Réserve |
|---|---|---|---|
| Analogique en mémoire | 35 millions de dispositifs de mémoire à changement de phase répartis sur 34 tuiles pour une tâche de mots-clés vocaux [96] | Jusqu’à 12,4 TOPS par watt soutenus par la puce, précision équivalente au logiciel | Petit réseau, pas de référence appariée dans le texte lu, donc aucun rapport n’est tiré |
| Photonique | Un processeur d’IA photonique à une précision que les auteurs présentent comme pratique pour ResNet et BERT [97] | Précision sur ces réseaux | Pas de joules par tâche dans le texte lu |
| Neuromorphique | Un modèle sans MatMul de 370 millions de paramètres sur Loihi 2 [28] | Jusqu’à 3 fois le débit avec 2 fois moins d’énergie que des transformers sur un GPU embarqué | Préliminaire, petit modèle |
| FPGA | FlightLLM sur une carte Alveo U280 exécutant LLaMA2-7B avec parcimonie et quantification compilées [27] | 6,0 et 4,2 fois l’efficacité énergétique et 1,8 et 1,4 fois l’efficacité en coût d’un V100S et d’un A100 | Comparaison et configuration GPU des auteurs |
| Poids ternaires sur CPU | BitNet b1.58 2B sur un CPU [26] | 0,4 Go de mémoire contre 1,4 à 4,8 Go, et 29 ms contre 41 à 124 ms par token | L’énergie de 0,028 J par token est estimée par un modèle arithmétique, 6,6 à 23 fois plus faible que les références, et n’a pas été lue sur un wattmètre |
| Pile d’accélérateurs alternative | Service sur des NPU Ascend [95] | 4,45 tokens par seconde par TFLOPS en préremplissage, au-dessus des résultats publiés sur H100 et H800 | Puissance non rapportée, donc aucun rapport en joules n’est tiré |
| Procédé flexible, hors silicium | Un microprocesseur Arm 32 bits sur un substrat flexible [98] | Qu’un processeur généraliste peut être fabriqué par un procédé hors silicium | Aucun résultat d’apprentissage automatique et pas de joules par tâche |
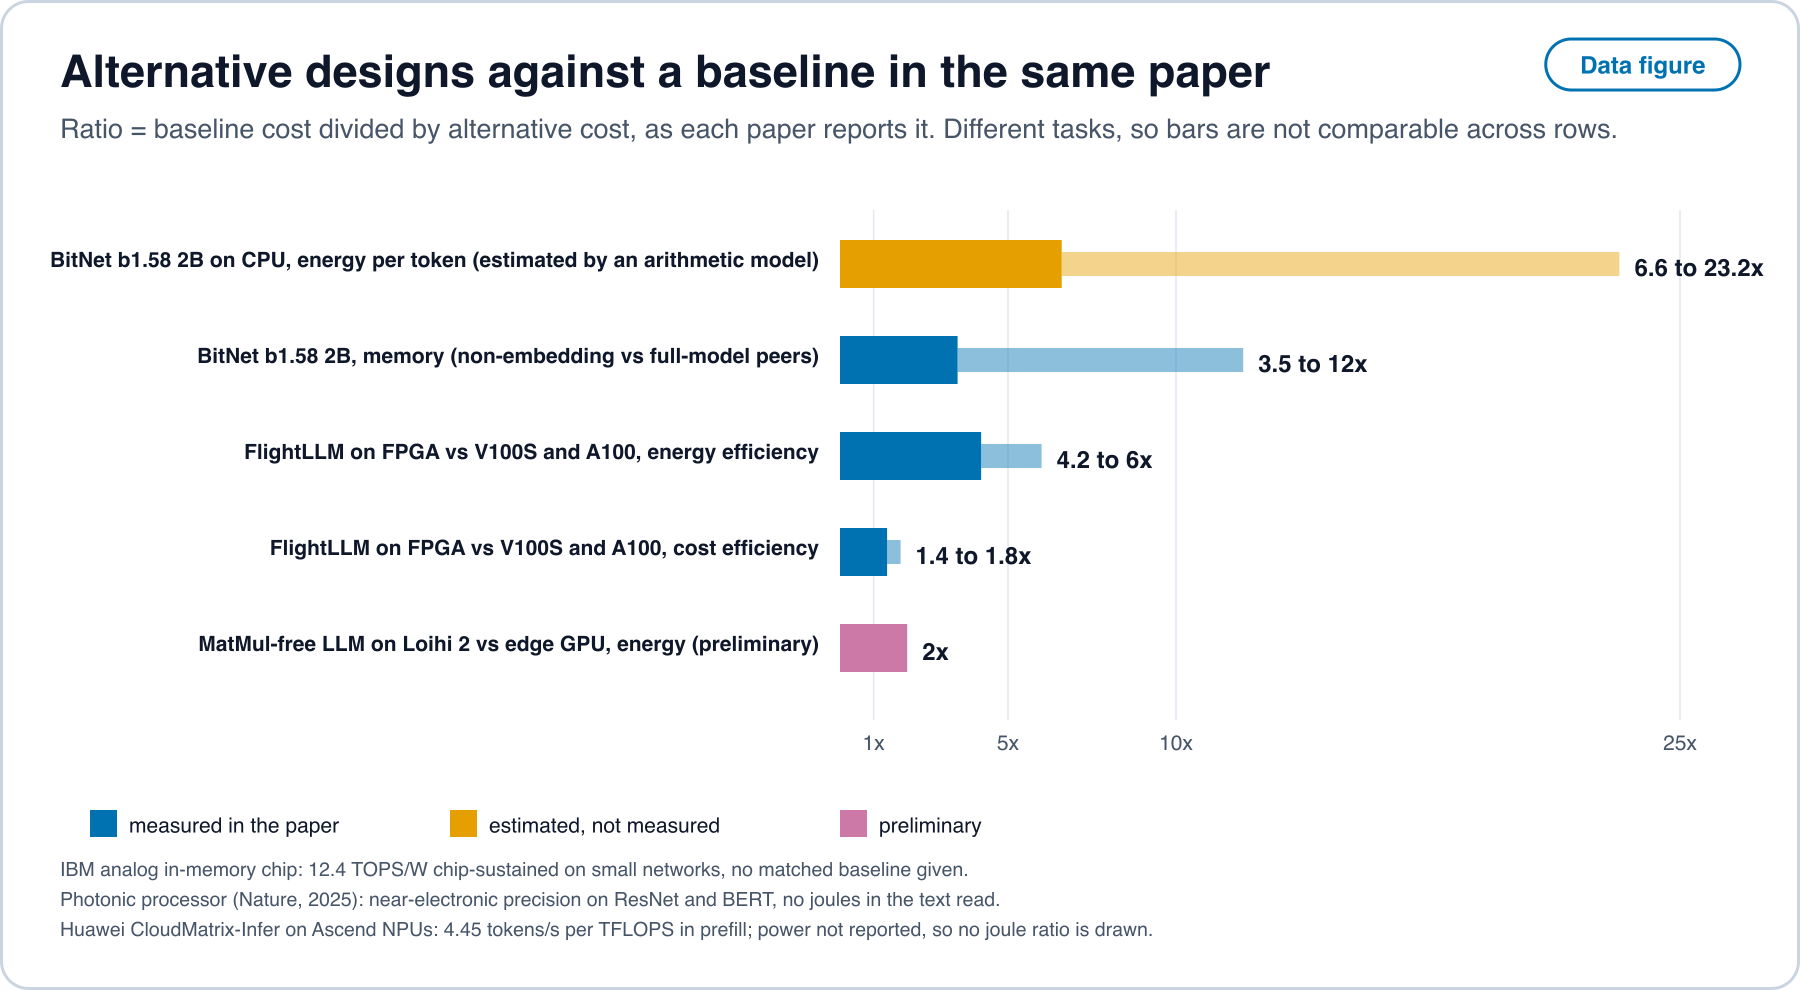
Ce que cela étaye. Pour des classes de tâches particulières, à savoir les petits modèles, le déploiement embarqué, le décodage sur CPU et l’inférence parcimonieuse ou quantifiée sur logique programmable, les auteurs rapportent une énergie ou une mémoire 2 à 23 fois plus faible qu’une référence conventionnelle. Ce sont des rapports internes à chaque article sur des modèles petits ou moyens. Les sources lues ne contiennent aucune mesure d’une conception alternative servant un modèle à l’échelle de la frontière, ni aucune sur des conceptions à l’échelle de la plaquette ou en nœuds matures ; cet article ne tire donc aucune conclusion à leur sujet.
Pourquoi un rapport d’énergie n’est pas un rapport de coût. Selon la Proposition 8, aux prix des centres de données, l’énergie représente entre environ 1,5 % et 11,8 % d’une heure d’accélérateur. Une alternative qui abaisse l’énergie par tâche d’un facteur 10 abaisse le coût par tâche au plus de la part de l’énergie, sauf si elle abaisse aussi le capital par tâche. Le résultat de mémoire du modèle ternaire pointe vers cette seconde voie : un modèle qui nécessite 0,4 Go au lieu de 1,4 à 4,8 Go peut fonctionner sur un appareil plus petit et moins cher, et l’effet sur le capital n’a pas été mesuré dans les sources ici. Là où l’électricité n’est pas le terme dominant, la comparaison utile est le coût en dollars par tâche capital compris, et aucun des articles lus sur le matériel alternatif ne le rapporte, sauf FlightLLM, dont les rapports d’efficacité en coût sont les plus petits nombres du tableau.
15. Où se trouvent la capacité, le calcul et l’énergie
La géographie du déploiement est lue ici à partir de statistiques nationales, de ministères et d’agences, dans la langue d’origine lorsque la source n’est pas en anglais. Les unités diffèrent d’un pays à l’autre ; les chiffres sont donc placés côte à côte et ne sont pas classés.
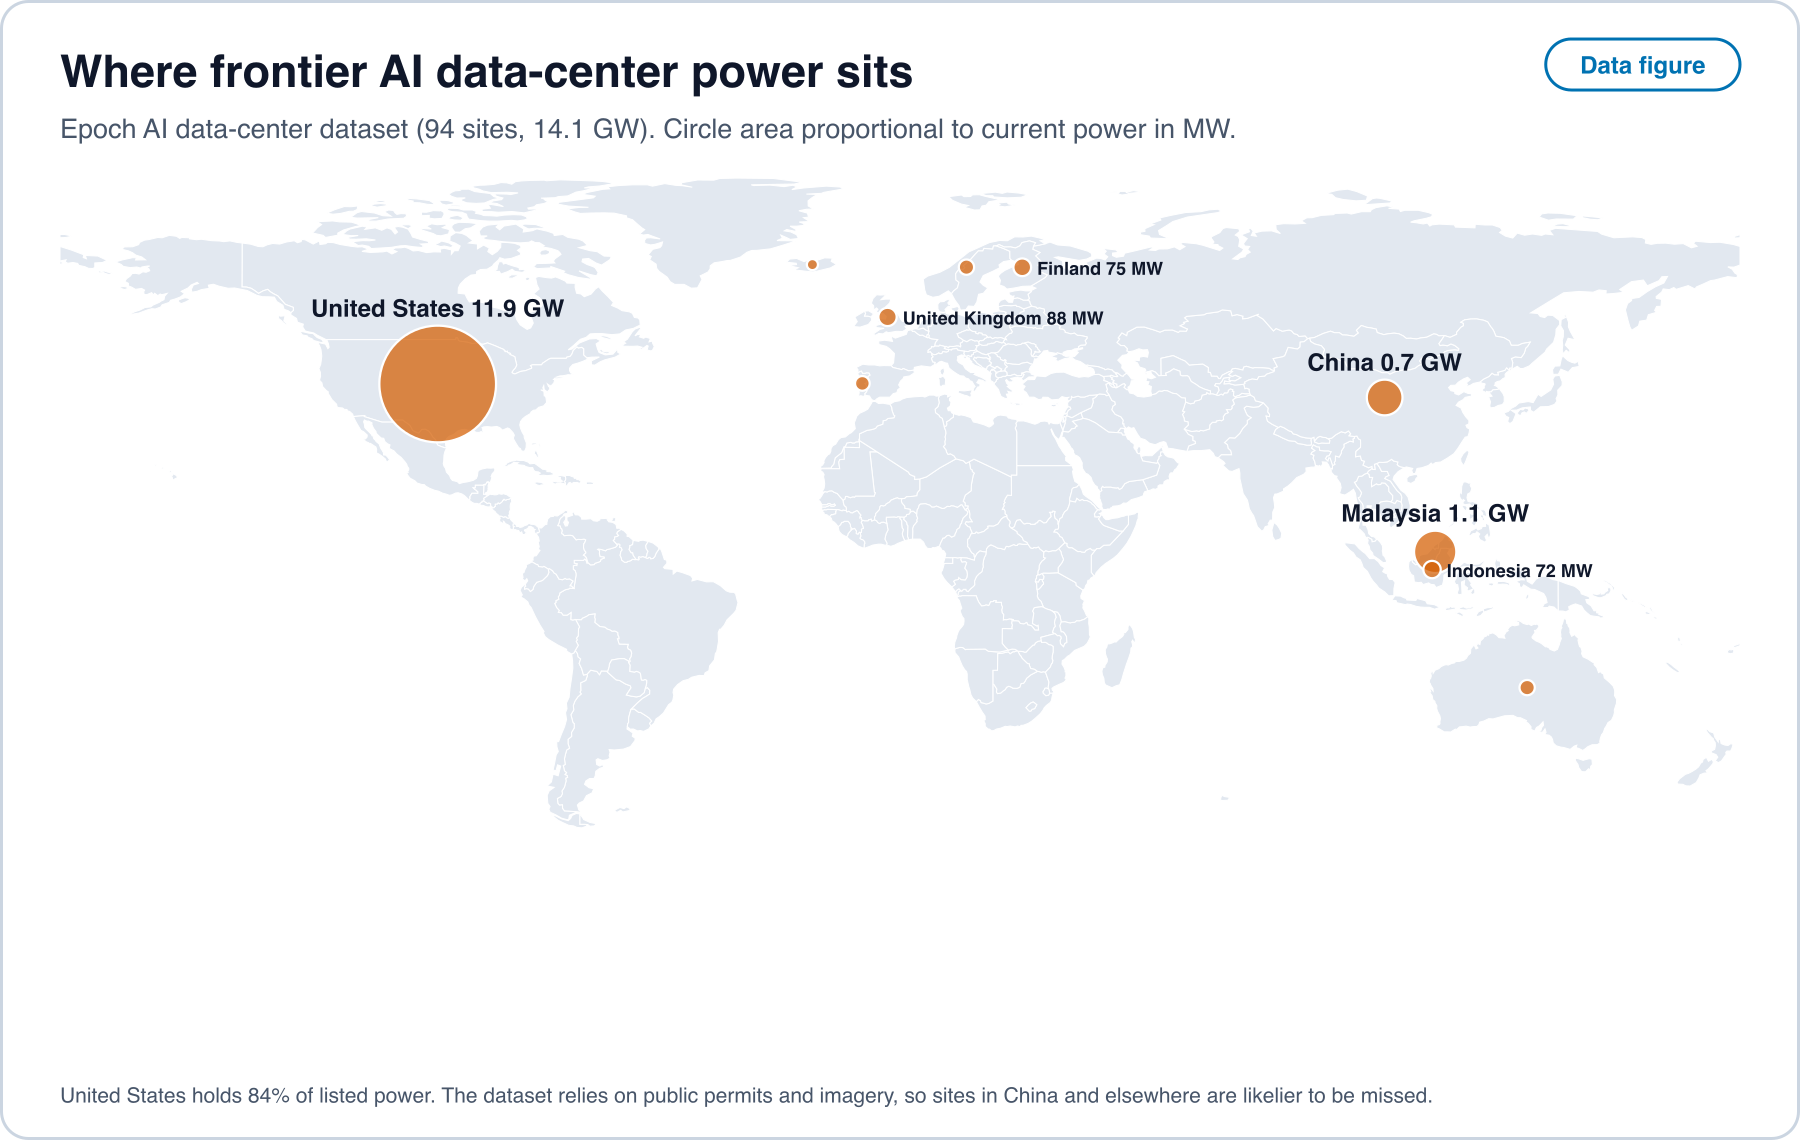
Calcul et énergie. Dans le jeu de données d’Epoch AI sur les centres de données, les sites frontières répertoriés totalisent 14,1 GW, dont les États-Unis détiennent 84 %, suivis de la Malaisie avec 1,1 GW et de la Chine avec 0,7 GW [12]. Le jeu de données repose sur des permis publics et des images ; les sites situés dans des pays où la divulgation publique est moindre ont donc plus de chances d’être manqués. Les statistiques chinoises elles-mêmes rapportent une quantité différente : 10,85 millions de baies standard en service et une capacité de calcul intelligent de 788 EFLOPS à la fin juin 2025 [99], et 1,59 million de PFLOPS (FP16) à la fin de 2025 [100]. Les deux chiffres chinois proviennent de publications différentes et peuvent reposer sur des définitions différentes, et aucun n’est comparable à un chiffre de puissance répertoriée. Pour l’électricité, les centres de données ont consommé environ 415 TWh en 2024, soit 1,5 % du total mondial, dont 45 % aux États-Unis, 25 % en Chine et 15 % en Europe, et l’Agence internationale de l’énergie projette un doublement à environ 945 TWh d’ici 2030 selon un scénario modélisé [101, 102].
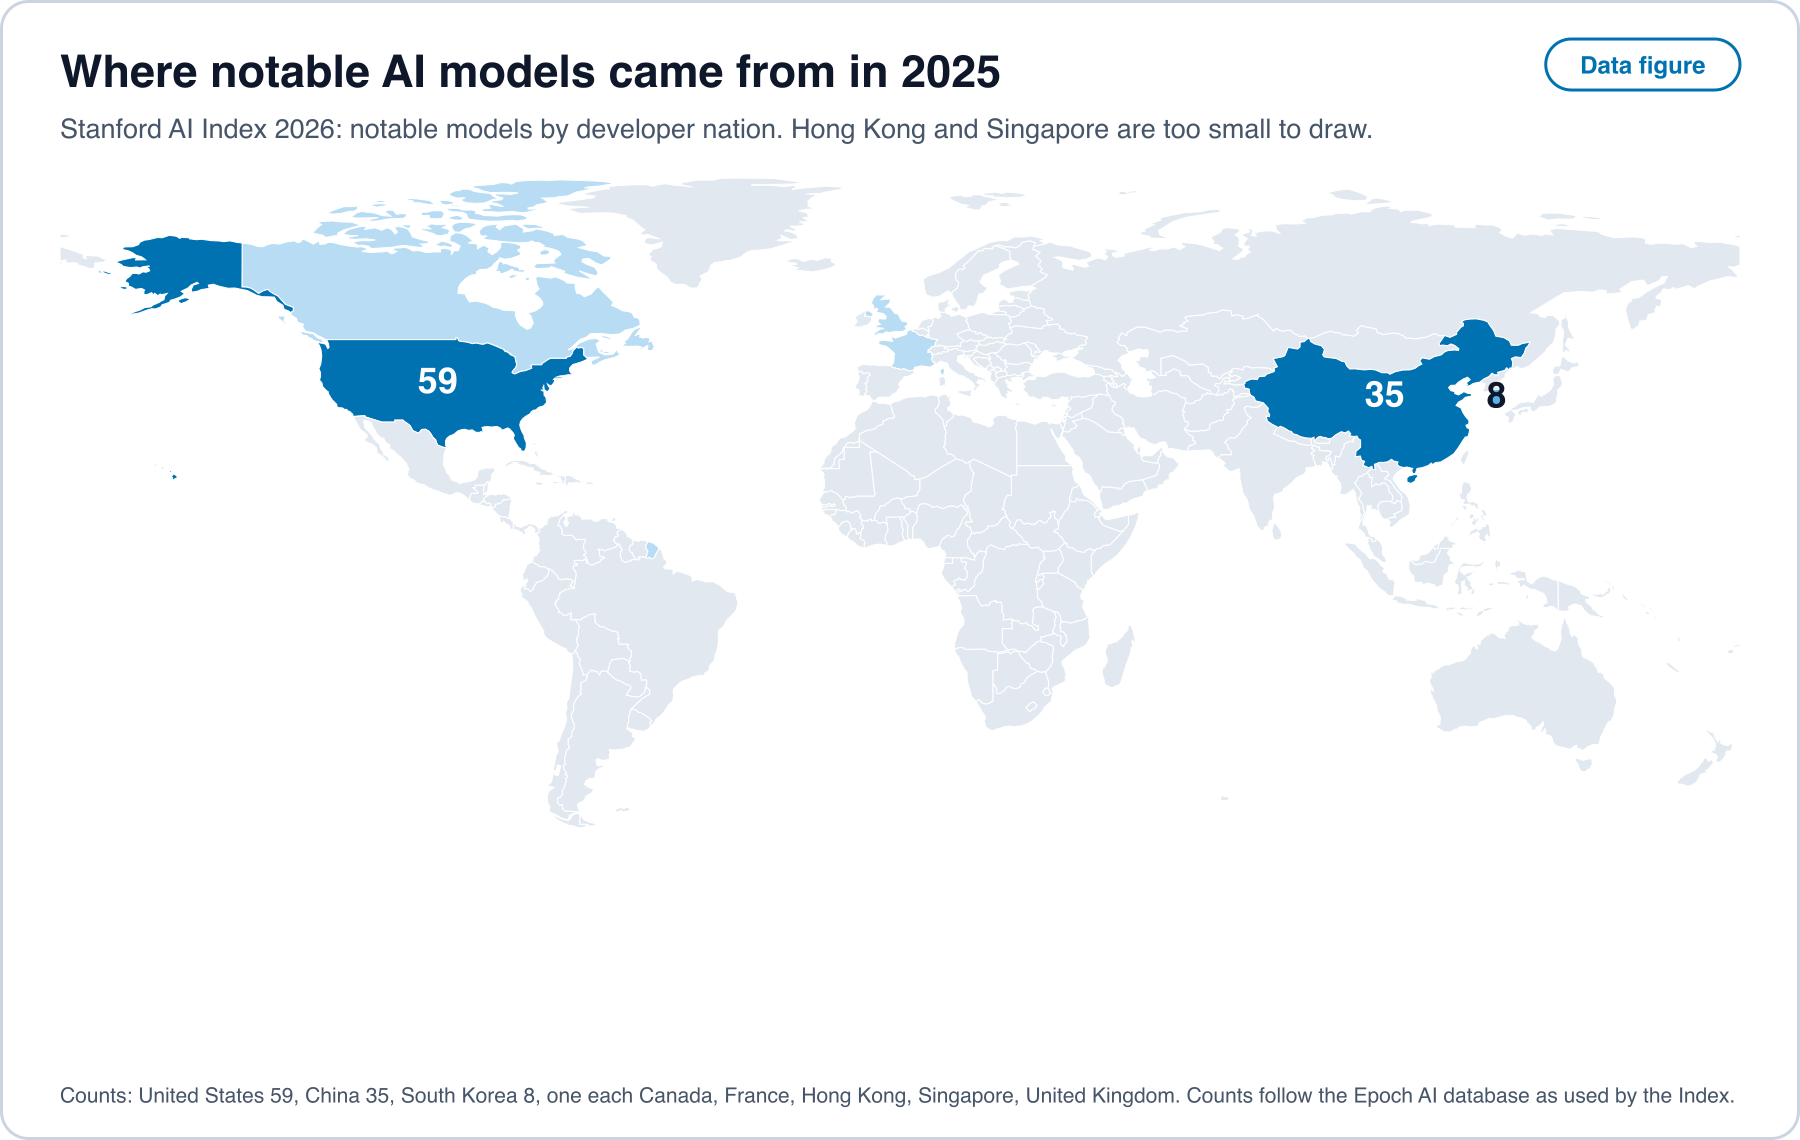
latency_data/frontier_dc_by_country.csv [12]. Open full sizeD’où viennent les modèles. Parmi les modèles notables de 2025 selon l’affiliation nationale du développeur, les États-Unis en comptent 59, la Chine 35 et la Corée du Sud 8, avec des modèles uniques du Canada, de la France, de Hong Kong, de Singapour et du Royaume-Uni [29].
Puces. Pour les accélérateurs du jeu de données matériel d’Epoch, TSMC est la fonderie enregistrée pour environ quatre entrées sur cinq parmi celles dont la fonderie est enregistrée, suivie de Samsung, SMIC et Intel, et la fonderie n’est pas enregistrée pour plus d’un tiers de l’ensemble des entrées (latency_data/hardware_foundry_counts.json) [13]. Les sources lues n’ont donné aucun chiffre exploitable sur la capacité d’encapsulation ni sur la capacité de fabrication par pays ; cet article n’en dresse donc aucune carte.
Programmes nationaux. Les programmes indiquent leur taille dans des unités différentes, et le Tableau 8 donne chacun tel qu’il est énoncé.
Tableau 8. Programmes nationaux tels qu’énoncés, avec la langue de la source.
| Lieu | Énoncé | Langue | Classe |
|---|---|---|---|
| Chine | Capacité de calcul intelligent de 788 EFLOPS à la fin juin 2025 et de 1,59 million de PFLOPS (FP16) à la fin de 2025 [99, 100] | chinois | démontré |
| Corée du Sud | Déclaration gouvernementale portant sur l’obtention de 260 000 GPU NVIDIA, en octobre 2025 [103] | coréen | opinion |
| Japon | Au moins 10 000 milliards de yens de soutien public sur les sept années allant jusqu’à l’exercice 2030, visant plus de 50 000 milliards de yens d’investissement privé sur dix ans [104] ; une étude de marché indiquant que l’investissement cloud dans les centres de données japonais devrait atteindre des centaines de milliards de yens ou plus chaque année [105] | japonais | opinion |
| Union européenne | 200 milliards d’euros à mobiliser pour l’IA, avec un fonds de 20 milliards d’euros pour des gigafactories d’IA [106, 107] | anglais et italien | opinion |
| Inde | 38 231 GPU intégrés au portail de calcul IndiaAI, tel que rapporté au parlement en mars 2026 [108] | anglais | démontré |
| Brésil | 23,03 milliards de R$ d’investissement prévu pour 2024 à 2028 [109] | portugais | opinion |
| Émirats arabes unis | Une grappe de calcul de 1 GW au sein d’un campus prévu de 5 GW à Abou Dhabi [110] | anglais | opinion |
| Arabie saoudite | Capacité projetée allant jusqu’à 500 MW sur cinq ans [111] | anglais | opinion |
| Afrique | Une usine d’IA en cours de déploiement en Afrique du Sud, avec des projets pour le Nigeria, le Kenya, l’Égypte et le Maroc ; aucun chiffre de capacité indiqué [112] | anglais | opinion |
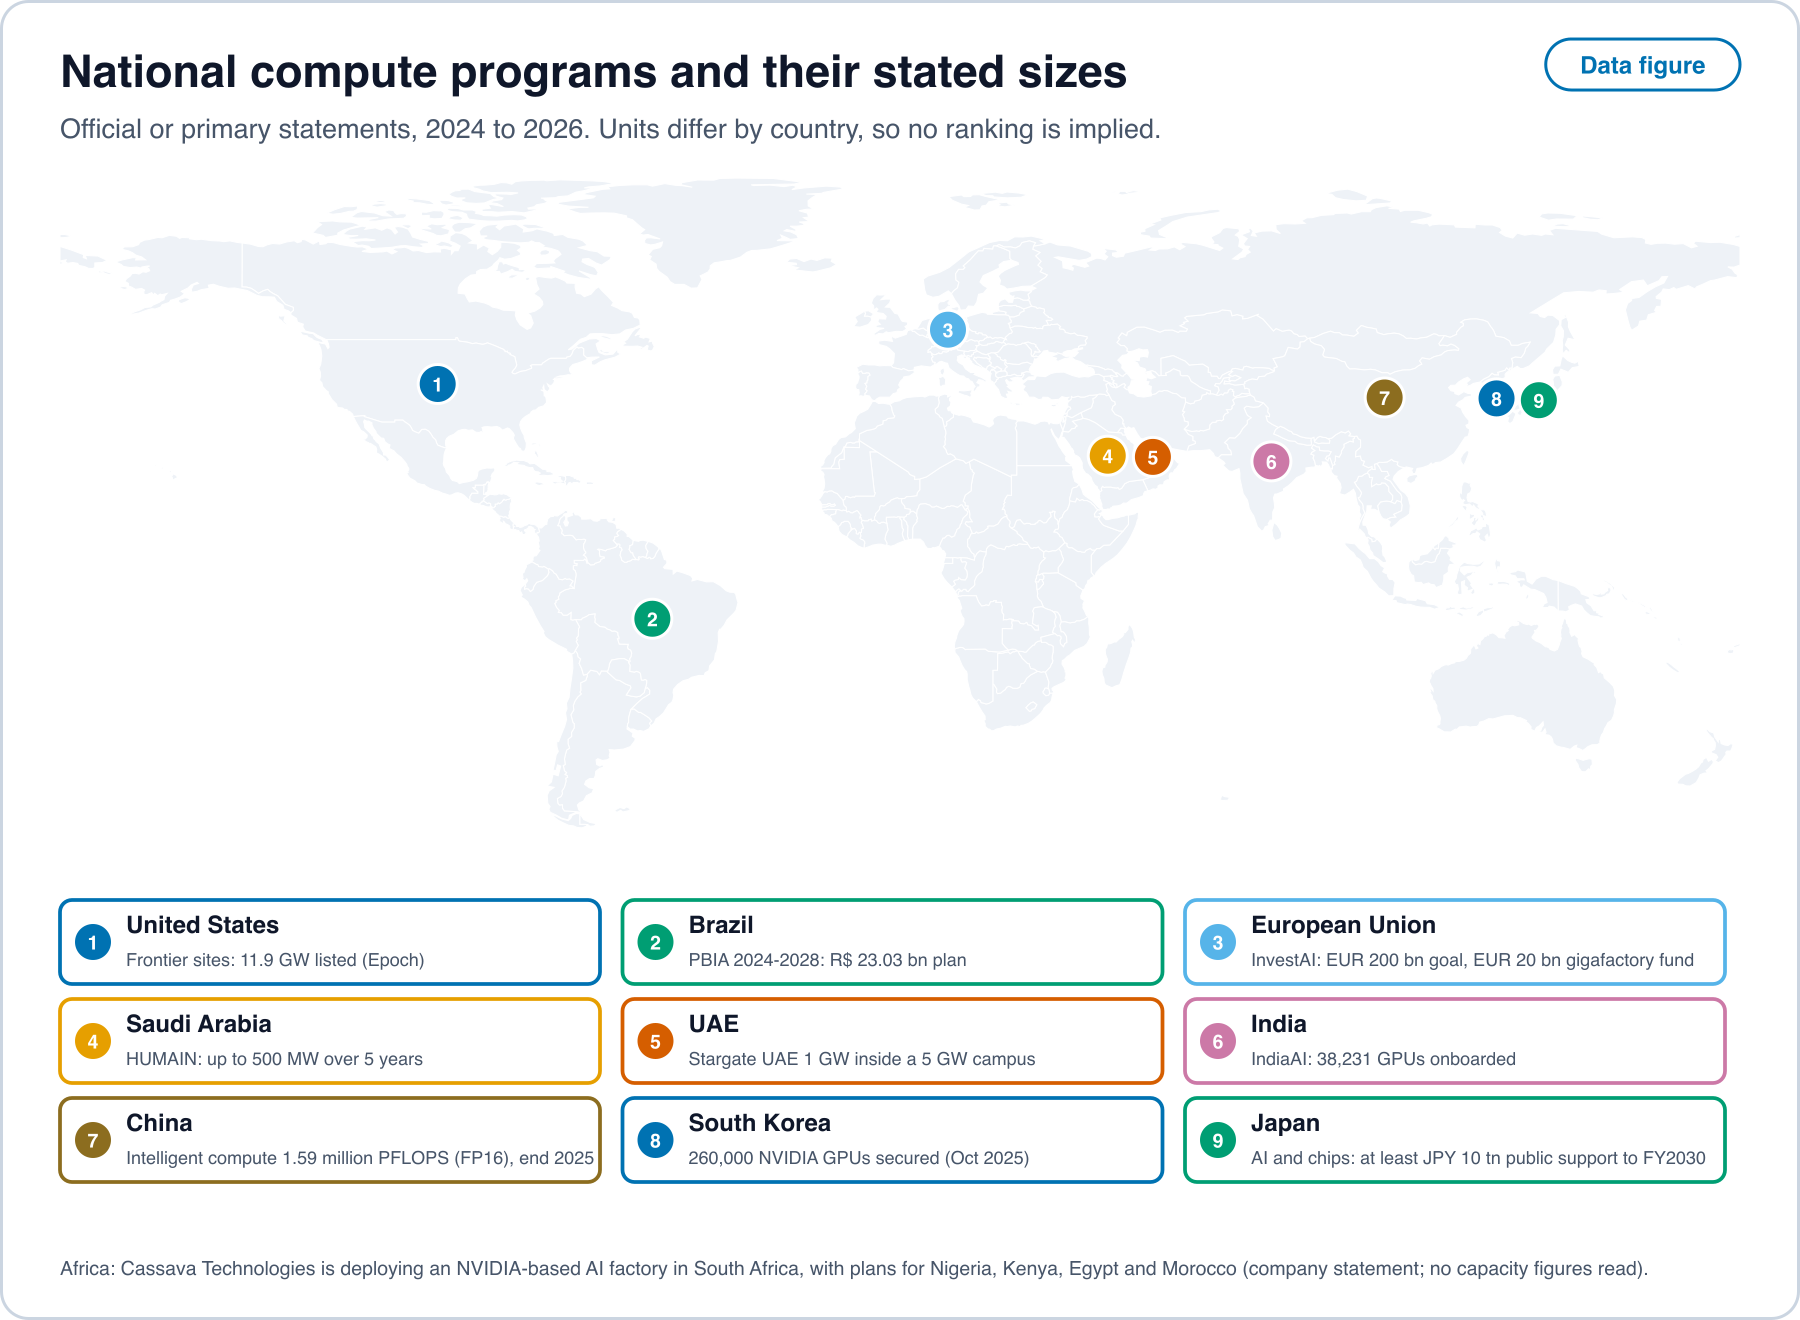
Les énoncés de la classe opinion sont des plans et des objectifs, et la classe démontré contient des capacités ou des statistiques rapportées. Les deux types ne doivent pas être additionnés.
Usage. Les enquêtes officielles sur les entreprises utilisant l’IA donnent 32,9 % en Corée du Sud en 2024, 26 % en Allemagne en 2025, 21,1 % en Espagne début 2025, 20,0 % dans l’Union européenne en 2025, 18 % aux États-Unis pendant l’hiver 2025 à 2026, 13,9 % pour la zone OCDE en 2024, 13 % au Brésil en 2024 et 10 % en France en 2024, avec des années et des définitions qui diffèrent [30, 31, 32, 33, 34, 35, 36, 37]. Le Japon et la Chine sont mesurés sur les personnes et non sur les entreprises [71, 72].
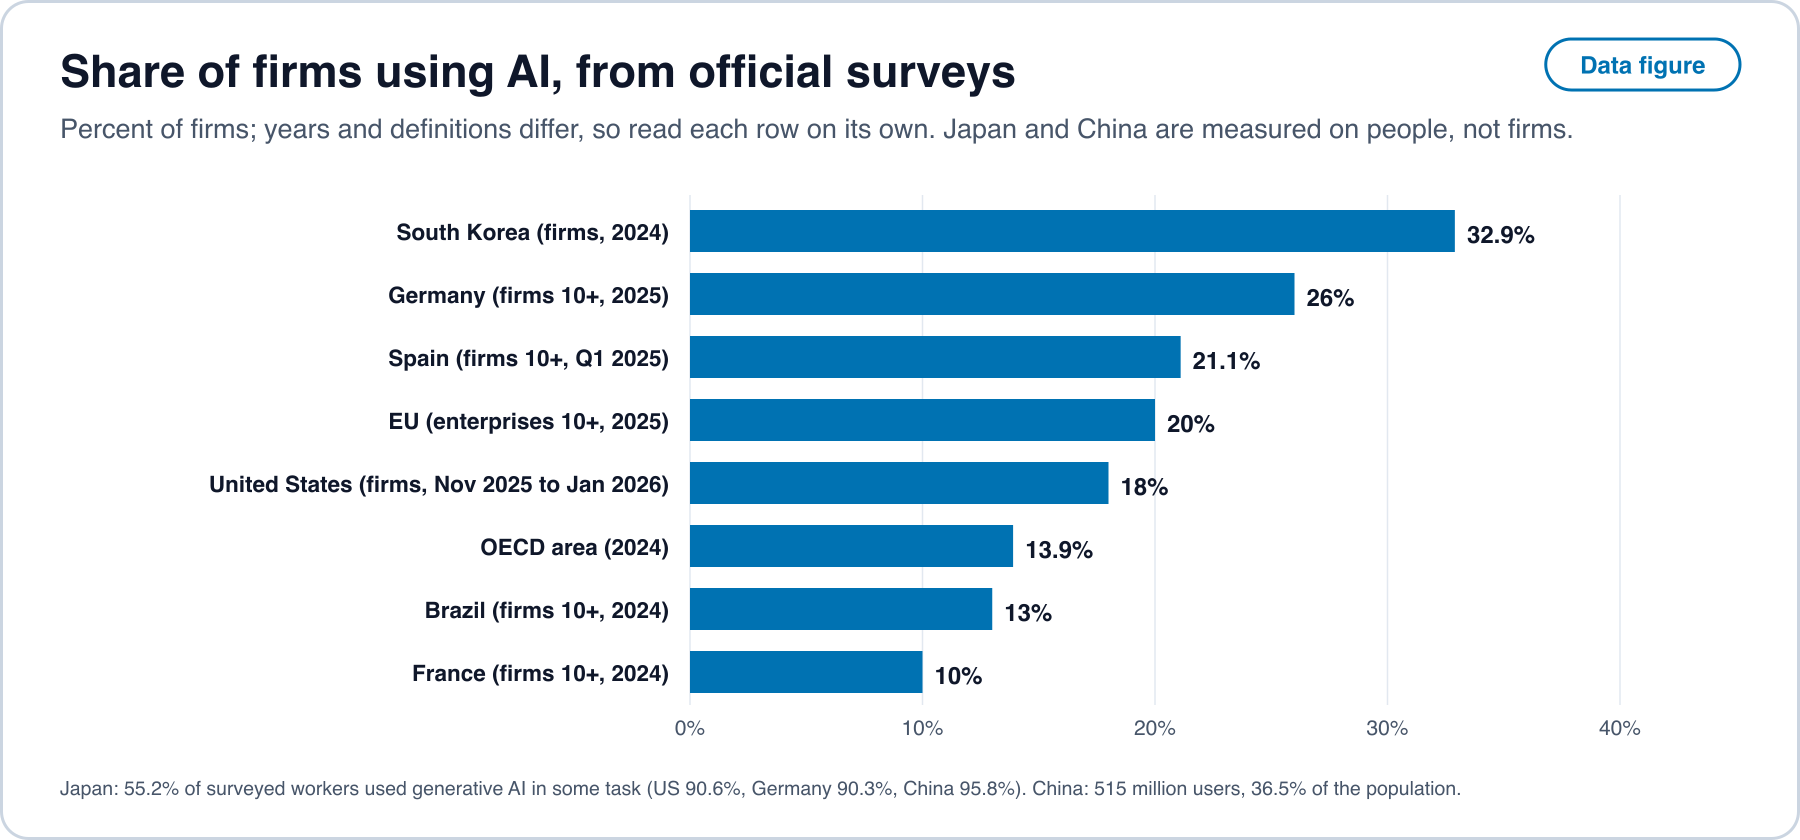
Ce que montre la géographie. La puissance de calcul répertoriée est concentrée dans un seul pays avec une large marge, tandis que les modèles publiés et les déclarations officielles de capacité montrent un second pays avec une grande part des modèles et une grande capacité déclarée que les jeux de données de puissance répertoriée sont mal placés pour voir. Ailleurs, des programmes énoncent des plans à l’échelle du gigawatt ou de la centaine de milliards, et l’usage mesuré de l’IA par les entreprises se situe entre 10 % et 33 % dans les enquêtes lues. L’écart entre les plans et l’usage mesuré est l’écart que cet article étudie, désormais à l’échelle nationale.
16. Protocole expérimental (non exécuté)
Objet. Mesurer et ses trois parties pour une liste de méthodes, en n’utilisant que des dates publiques.
Unité. Une méthode, comme un format numérique, un noyau, une procédure d’inférence ou une passe de compilateur, avec une description publique datée.
Dates à recueillir pour chaque méthode. La première publication en ligne publique (prépublication ou dépôt), la première implémentation ouverte, la première publication dans une bibliothèque ouverte largement utilisée, et la première publication en disponibilité générale dans au moins un produit commercial, avec le type d’entreprise (cotée, privée, secteur public, académique). Chaque date est enregistrée avec le lien vers sa source et une copie archivée.
Échantillonnage. Toutes les méthodes d’une liste préenregistrée tirée d’un ensemble fixe de lieux de publication et de dépôts sur la période 2022 à 2026, y compris des lieux de publication et des dépôts non anglophones, avec la règle de sélection écrite avant toute recherche de date de lancement.
Analyse. Calculer par méthode. Estimer par les tests de phase de la Prédiction 1 et en comparant le retard moyen avec . Estimer la partie liée à la porte comme la différence entre entreprises cotées et non cotées (Prédiction 2). Rapporter des médianes avec des intervalles par bootstrap, et rapporter quelle part des méthodes n’atteint jamais un produit.
Énergie. Là où une méthode rapporte des joules par tâche, enregistrer les conditions de mesure, et là où elle ne le fait pas, l’exécuter sur un banc de mesure d’énergie ouvert comme celui cité dans le Tableau 1 et rapporter les joules mesurés.
Financement et coût. Calculer la borne de la Définition 4 pour chaque fournisseur et chaque exercice à partir des documents déposés, le prix d’un joule chargé en capital à partir des prix répertoriés de l’heure d’accélérateur et de la puissance mesurée, et le rapport des achats contractés au chiffre d’affaires glissant pour chaque laboratoire, et enregistrer chacun avec le document déposé et la page dont il provient. Le script de figures scripts/figures/latency_figures.py et les fichiers de données sous scripts/figures/latency_data/ reproduisent chaque figure des Sections 9 à 15 à partir des sources citées.
Livrables. Un tableau de dates, un script d’analyse et un journal des exclusions. Les scripts et les données seront publiés avec l’étude dans les mêmes conditions que ce site.
17. Conclusion
Les méthodes publiques qui abaissent le coût de l’intelligence informatique atteignent les produits après un retard comportant une partie technique, une partie calendaire et une partie incitative. La première est le temps d’ingénierie. La deuxième est la structure des dates de décision, qui sur un calendrier trimestriel ajoute environ six semaines en moyenne (Proposition 1). La troisième apparaît quand une règle de publication des résultats bloque un lancement qui vaut la peine à long terme (Proposition 3). Un outil qui abaisse le coût d’adoption d’une méthode supprime la troisième dès que le coût passe sous une borne déclarée, et un outil qui abaisse le coût du travail lui-même force le lancement quand attendre ne rapporte rien (Proposition 4). Quand le marché compte plusieurs vendeurs accessibles avec une faible friction, le plus rapide fixe la latence (Proposition 5). À mesure que le coût du calcul baisse, la marge qui demeure dépend de la friction de changement (Proposition 6). Les éléments sur les infrastructures ajoutent ce qui suit. Les documents déposés établissent des boucles de plusieurs dizaines de milliards de dollars entre des fournisseurs et des clients nommés, et ils bornent à moins d’un cinquième la part du chiffre d’affaires du plus grand fournisseur de puces que son propre capital aurait pu financer, tandis que la plupart des dépenses des hyperscalers sont payées sur le flux de trésorerie d’exploitation. Aux prix des centres de données, l’énergie est une petite partie d’une heure d’accélérateur et le capital en est la grande partie ; le coût par tâche suit donc le temps d’accélérateur par tâche, l’utilisation et la durée de vie déclarée de la machine. Les méthodes ouvertes et les conceptions alternatives réduisent le temps d’accélérateur, la mémoire ou l’énergie par tâche dans les mesures des auteurs eux-mêmes, pour des modèles petits et moyens, et aucune source lue ne les mesure à l’échelle de la frontière. La capacité, le calcul et l’énergie sont répartis inégalement, et les plans nationaux sont énoncés à des échelles bien supérieures à l’usage mesuré. Les propositions sont un modèle, et les prédictions nomment les documents déposés, les offres et les mesures qui réfuteraient chacune.
Références
Each entry ends with its evidence class (Section 1).
- Meta, joint venture with funds managed by Blue Owl Capital to develop the Hyperion data center. 2025-10-21. https://investor.atmeta.com/investor-news/press-release-details/2025/Meta-Announces-Joint-Venture-with-Funds-Managed-by-Blue-Owl-Capital-to-Develop-Hyperion-Data-Center/default.aspx (opinion)
- Meta Platforms, Quarterly Report on Form 10-Q, period ended 30 September 2025. 2025-10-30. https://www.sec.gov/Archives/edgar/data/1326801/000162828025047240/meta-20250930.htm (demonstrated)
- NVIDIA, Annual Report on Form 10-K, fiscal year ended 25 January 2026. 2026-02-25. https://www.sec.gov/Archives/edgar/data/1045810/000104581026000021/nvda-20260125.htm (demonstrated)
- CoreWeave, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-03-02. https://www.sec.gov/Archives/edgar/data/1769628/000176962826000104/crwv-20251231.htm (demonstrated)
- Oracle, Quarterly Report on Form 10-Q, period ended 31 August 2026. 2026-09-11. https://www.sec.gov/Archives/edgar/data/1341439/000119312626389274/orcl-20260831.htm (demonstrated)
- Oracle, Q1 FY27 results (Exhibit 99.1 to Form 8-K). 2026-09-10. https://www.sec.gov/Archives/edgar/data/1341439/000119312626387905/orcl-20260910.htm (demonstrated)
- Microsoft, Quarterly Report on Form 10-Q, period ended 30 September 2025, Note 17. 2025-10-29. https://www.sec.gov/Archives/edgar/data/789019/000119312525256321/msft-20250930.htm (demonstrated)
- OpenAI and Amazon Web Services, partnership announcement. 2025-11-03. https://openai.com/index/aws-and-openai-partnership/ (opinion)
- CNBC, OpenAI closes record-breaking 122 billion dollar funding round. 2026-03-31. https://www.cnbc.com/2026/03/31/openai-funding-round-ipo.html (opinion)
- Microsoft, NVIDIA and Anthropic, strategic partnerships announcement. 2025-11-18. https://blogs.microsoft.com/blog/2025/11/18/microsoft-nvidia-and-anthropic-announce-strategic-partnerships/ (opinion)
- U.S. Securities and Exchange Commission, XBRL company concept API (annual capital expenditure and operating cash flow, seven filers). 2026-10. https://data.sec.gov/api/xbrl/companyconcept/ (demonstrated)
- Epoch AI, Frontier Data Centers dataset (CC BY). 2026-10. https://epoch.ai/data/data-centers (demonstrated)
- Epoch AI, Machine Learning Hardware dataset (CC BY). 2026-10. https://epoch.ai/data/machine-learning-hardware (demonstrated)
- Amazon, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-06. https://www.sec.gov/Archives/edgar/data/1018724/000101872426000004/amzn-20251231.htm (demonstrated)
- Meta Platforms, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-01-29. https://www.sec.gov/Archives/edgar/data/1326801/000162828026003942/meta-20251231.htm (demonstrated)
- Alphabet, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-05. https://www.sec.gov/Archives/edgar/data/1652044/000165204426000018/goog-20251231.htm (demonstrated)
- Microsoft, Annual Report on Form 10-K, fiscal year ended 30 June 2026. 2026-07-29. https://www.sec.gov/Archives/edgar/data/789019/000119312626323660/msft-20260630.htm (demonstrated)
- Stanford HAI, AI Index Report 2025. 2025-04. https://hai.stanford.edu/assets/files/hai_ai_index_report_2025.pdf (demonstrated)
- Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. 2022-05-27. https://arxiv.org/abs/2205.14135 (demonstrated)
- PyTorch, PyTorch 2.0 release announcement. 2023-03-15. https://pytorch.org/blog/pytorch-2-0-release/ (opinion)
- Gu and Dao, Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023-12-01. https://arxiv.org/abs/2312.00752 (demonstrated)
- Lieber et al., Jamba: A Hybrid Transformer-Mamba Language Model. 2024-03-28. https://arxiv.org/abs/2403.19887 (demonstrated)
- Leviathan, Kalman, Matias, Fast Inference from Transformers via Speculative Decoding. 2022-11-30 (ICML 2023). https://arxiv.org/abs/2211.17192 (established by proof in the source)
- Google Research, Looking back at speculative decoding. 2024-12-06. https://research.google/blog/looking-back-at-speculative-decoding/ (opinion)
- Epoch AI, Notable AI Models dataset (CC BY). 2026-10. https://epoch.ai/data/notable-ai-models (demonstrated)
- Ma et al., BitNet b1.58 2B4T Technical Report. 2025-04-16. https://arxiv.org/abs/2504.12285 (demonstrated)
- Zeng et al., FlightLLM: Efficient Large Language Model Inference with a Complete Mapping Flow on FPGAs. 2024-01-08. https://arxiv.org/abs/2401.03868 (demonstrated)
- Abreu et al., Neuromorphic Principles for Efficient Large Language Models on Intel Loihi 2. 2025-03. https://arxiv.org/abs/2503.18002 (demonstrated)
- Stanford HAI, AI Index Report 2026, research and development chapter. 2026-04. https://hai.stanford.edu/ai-index/2026-ai-index-report (demonstrated)
- (Korean) Electronic Times, reporting the 2025 Enterprise Informatization Statistics of the Ministry of Science and ICT and NIA. 2026-01-20. https://www.etnews.com/20260120000071 (demonstrated)
- (German) Statistisches Bundesamt, Unternehmen mit Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen (table, 2025). 2025. https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-unternehmen-kuenstliche-intelligenz.html (demonstrated)
- (Spanish) Instituto Nacional de Estadística, Encuesta sobre el uso de TIC y del comercio electrónico en las empresas, nota de prensa. 2025-10-22. https://ine.es/dyngs/Prensa/ETICCE20241T2025.pdf (demonstrated)
- Eurostat, 20% of EU enterprises use AI technologies. 2025-12-11. https://ec.europa.eu/eurostat/documents/7870049/23260410/KS-01-26-009-EN-N.pdf (demonstrated)
- Bonney et al., The Microstructure of AI Diffusion (Census CES-WP-26-25). 2026-04. https://www.census.gov/library/working-papers/2026/adrm/CES-WP-26-25.html (demonstrated)
- OECD, Emerging divides in the transition to artificial intelligence. 2025-06. https://www.oecd.org/content/dam/oecd/en/publications/reports/2025/06/emerging-divides-in-the-transition-to-artificial-intelligence_eeb5e120/7376c776-en.pdf (demonstrated)
- (Portuguese) Cetic.br/NIC.br, Pesquisa TIC Empresas 2024, resumo executivo. 2025-05. https://www.nic.br/media/docs/publicacoes/2/20250512121759/tic_empresas_2024_resumo_executivo.pdf (demonstrated)
- (French) Insee, Les technologies de l’information et de la communication dans les entreprises en 2024, Insee Première n° 2061. 2025-07. https://www.insee.fr/fr/statistiques/fichier/8604126/ip2061.pdf (demonstrated)
- Dao and Gu, Transformers are SSMs (Mamba-2, state space duality). 2024-05-31. https://arxiv.org/abs/2405.21060 (established by proof in the source)
- Lieber et al. (Jamba); NVIDIA (Nemotron-H); TII (Falcon-H1); IBM (Granite 4.0). 2024 to 2025. https://arxiv.org/abs/2504.03624 (demonstrated)
- Ma et al., The Era of 1-bit LLMs (BitNet b1.58). 2024-02-27. https://arxiv.org/abs/2402.17764 (demonstrated)
- NVIDIA, Pretraining Large Language Models with NVFP4. 2025-09. https://arxiv.org/abs/2509.25149 (demonstrated)
- Shah et al., FlashAttention-3. 2024-07. https://arxiv.org/abs/2407.08608 (demonstrated)
- Yuan et al., Native Sparse Attention. 2025-02 (ACL 2025). https://arxiv.org/abs/2502.11089 (demonstrated)
- Hoffmann et al., Training Compute-Optimal Large Language Models. 2022-03-29. https://arxiv.org/abs/2203.15556 (demonstrated)
- Sardana et al., Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling. 2024-01 (ICML 2024). https://arxiv.org/abs/2401.00448 (demonstrated)
- DeepSeek-AI, DeepSeek-V3 Technical Report. 2024-12-26. https://arxiv.org/abs/2412.19437 (demonstrated)
- Angelopoulos, Barber, Bates, Theoretical Foundations of Conformal Prediction. 2024-11-18 (v5 2026-03-06). https://arxiv.org/abs/2411.11824 (established by proof in the source)
- Zhou, Chen, Gui and Cheng, Conformal Prediction: A Data Perspective. 2024-10 (arXiv 2410.06494; ACM Computing Surveys 2025). https://arxiv.org/abs/2410.06494 (opinion)
- Angelopoulos et al., Prediction-powered inference. 2023 (Science). https://www.science.org/doi/10.1126/science.adi6000 (established by proof in the source)
- Ramdas, Grunwald, Vovk, Shafer, Game-Theoretic Statistics and Safe Anytime-Valid Inference. 2023-11 (Statistical Science 38(4)). https://doi.org/10.1214/23-sts894 (established by proof in the source)
- Chernozhukov et al., Double/debiased machine learning. 2018 (Econometrics Journal). https://doi.org/10.1111/ectj.12097 (established by proof in the source)
- Jung, Tian, Bareinboim, Estimating Identifiable Causal Effects through Double Machine Learning. 2021 (AAAI). https://doi.org/10.1609/aaai.v35i13.17438 (established by proof in the source)
- Sathia et al., Compiler Optimizations for Higher-Order Automatic Differentiation. 2025 (PPoPP workshop). https://ece.is/assets/pdf/diffprog-ppopp25-paper90.pdf (demonstrated)
- Ward et al., JAX a la Stan. 2026-10-11. https://bob-carpenter.github.io/dj-paper/template-computo-python.pdf (opinion)
- Qian et al., Impulse: probabilistic programming via compiler augmentation. 2026 (abstract). https://ece.is/assets/pdf/impulse-pldi-src-abstract.pdf (demonstrated)
- Chung et al., The ML.ENERGY Benchmark. 2025 (NeurIPS Datasets and Benchmarks). https://ml.energy/leaderboard/ (demonstrated)
- Google, Measuring the environmental impact of delivering AI at Google Scale. 2025-08. https://arxiv.org/abs/2508.15734 (demonstrated)
- Ho et al. (Epoch AI), Algorithmic progress in language models. 2024-03 (NeurIPS 2024). https://arxiv.org/abs/2403.05812 (demonstrated)
- Epoch AI, LLM inference prices have fallen rapidly but unequally across tasks. 2025. https://epoch.ai/data-insights/llm-inference-price-trends (demonstrated)
- Comin and Hobijn, An Exploration of Technology Diffusion. 2010 (AER 100(5)). https://doi.org/10.1257/aer.100.5.2031 (demonstrated)
- P. A. David, The Dynamo and the Computer. 1990 (AER 80(2)). https://ideas.repec.org/a/aea/aecrev/v80y1990i2p355-61.html (demonstrated)
- Brynjolfsson, Rock, Syverson, The Productivity J-Curve. 2021 (AEJ Macro). https://doi.org/10.1257/mac.20180386 (demonstrated)
- Somala and Emberson (Epoch AI), Frontier AI performance becomes accessible on consumer hardware within a year. 2025-08-15. https://epoch.ai/data-insights/consumer-gpu-model-gap (demonstrated)
- Epoch AI, Open vs. closed AI: how behind are open models?. 2025. https://epoch.ai/publications/open-models-report (demonstrated)
- Gupta and Kiely, Production-ready speculative decoding with TensorRT-LLM. 2024-12-19. https://www.baseten.co/blog/how-we-built-production-ready-speculative-decoding-with-tensorrt-llm/ (opinion)
- Marx and Fuegi, Reliance on Science: Worldwide Front-Page Patent Citations to Scientific Articles. 2020 (NBER 27987; JEMS 2022). https://www.nber.org/system/files/working_papers/w27987/w27987.pdf (demonstrated)
- Ahmadpoor and Jones, The dual frontier. 2017 (Science). https://doi.org/10.1126/science.aam9527 (demonstrated)
- Willison, Stanford Alpaca, and the acceleration of on-device large language model development. 2023-03-13. https://simonwillison.net/2023/Mar/13/alpaca/ (opinion)
- Li et al., Now Hiring: Firm-Level Adoption of Generative AI in China (World Bank). 2025/2026. https://thedocs.worldbank.org/en/doc/cbdef4ef57efdbb3c29aa4c07edf860b-0050062026/original/Now-hiring-Firm-Level-Li-etal.pdf (demonstrated)
- (German) Statistisches Bundesamt, Pressemitteilung Nr. 444: Jedes fünfte Unternehmen nutzt künstliche Intelligenz. 2024-11-25. https://www.destatis.de/DE/Presse/Pressemitteilungen/2024/11/PD24_444_52911.html (demonstrated)
- Japan Ministry of Internal Affairs and Communications, 令和7年版情報通信白書 (Information and Communications White Paper 2025), data tables, in Japanese. 2025. https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/html/nd112220.html (demonstrated)
- (Chinese) China Internet Network Information Center, 生成式人工智能应用发展报告(2025). 2025-10. https://pdf.dfcfw.com/pdf/H301_AP202510241768289458_1.pdf (demonstrated)
- Bick, Blandin, Deming, The Rapid Adoption of Generative AI. 2024-09 (rev. 2025-02). https://www.nber.org/papers/w32966 (demonstrated)
- Brynjolfsson, Li, Raymond, Generative AI at Work (NBER Working Paper 31161; later published in QJE 2025). 2023 working paper, revised. https://www.nber.org/papers/w31161 (demonstrated)
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. 2025-07-10. https://arxiv.org/abs/2507.09089 (demonstrated)
- Bloom, Jones, Van Reenen, Webb, Are Ideas Getting Harder to Find?. 2020 (AER 110(4)). https://doi.org/10.1257/aer.20180338 (demonstrated)
- Graham, Harvey, Rajgopal, The Economic Implications of Corporate Financial Reporting. 2005 (JAE 40); NBER 2004-10. https://www.nber.org/papers/w10550 (demonstrated)
- Asker, Farre-Mensa, Ljungqvist, Corporate Investment and Stock Market Listing: A Puzzle?. 2015 (RFS 28(2)). https://doi.org/10.1093/rfs/hhu077 (demonstrated)
- FactSet, Highest number of S&P 500 earnings calls citing AI over the past 10 years. 2025-12. https://insight.factset.com/highest-number-of-sp-500-earnings-calls-citing-ai-over-the-past-10-years-1 (demonstrated)
- Hassan, Hollander, van Lent, Tahoun, Firm-Level Political Risk. 2019 (QJE 134(4)). https://doi.org/10.1093/qje/qjz021 (demonstrated)
- Metrick and Yasuda, Venture Capital and Other Private Equity: A Survey (NBER Working Paper 16652). 2010-10. https://www.nber.org/system/files/working_papers/w16652/w16652.pdf (opinion)
- Gompers and Lerner, What Drives Venture Capital Fundraising? (Brookings Papers: Microeconomics). 1998. https://www.brookings.edu/wp-content/uploads/1998/01/1998_bpeamicro_gompers.pdf (demonstrated)
- Arrow, Economic Welfare and the Allocation of Resources for Invention (NBER chapter). 1962. https://www.nber.org/system/files/chapters/c2144/c2144.pdf (established by proof in the source)
- Shapiro, Competition and Innovation: Did Arrow Hit the Bull’s Eye? (NBER conference draft). 2010. https://conference.nber.org/confer/2010/RDIA10/Shapiro.pdf (opinion)
- Henderson and Clark, Architectural Innovation. 1990 (ASQ 35(1)). https://doi.org/10.2307/2393549 (demonstrated)
- US District Court for D.C., United States v. Google LLC, remedies memorandum. 2025-09-02. https://www.courthousenews.com/wp-content/uploads/2025/09/judge-amit-mehta-google-search-monopoly-remedy-ruling.pdf (demonstrated)
- NVIDIA and OpenAI, letter of intent announcement. 2025-09-22. https://nvidianews.nvidia.com/news/openai-and-nvidia-announce-strategic-partnership-to-deploy-10gw-of-nvidia-systems (opinion)
- Advanced Micro Devices, Form 8-K, Item 1.01 (warrant issued to OpenAI). 2025-10-06. https://www.sec.gov/Archives/edgar/data/2488/000119312525230895/d28189d8k.htm (demonstrated)
- Microsoft, The next chapter of the Microsoft-OpenAI partnership. 2025-10-28. https://blogs.microsoft.com/blog/2025/10/28/the-next-chapter-of-the-microsoft-openai-partnership/ (opinion)
- Anthropic, Expanding our use of Google Cloud TPUs and services. 2025-10-23. https://www.anthropic.com/news/expanding-our-use-of-google-cloud-tpus-and-services (opinion)
- OpenAI and Broadcom, strategic collaboration announcement. 2025-10-13. https://openai.com/index/openai-and-broadcom-announce-strategic-collaboration/ (opinion)
- Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. 2022-10-31. https://arxiv.org/abs/2210.17323 (demonstrated)
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention (vLLM). 2023-09-12. https://arxiv.org/abs/2309.06180 (demonstrated)
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025-01-22. https://arxiv.org/abs/2501.12948 (demonstrated)
- Zuo et al., Serving Large Language Models on Huawei CloudMatrix384. 2025-06. https://arxiv.org/abs/2506.12708 (demonstrated)
- Le Gallo et al., An analog-AI chip for energy-efficient speech recognition and transcription, Nature. 2023-08-23. https://www.nature.com/articles/s41586-023-06337-5 (demonstrated)
- Ahmed et al., Universal photonic artificial intelligence acceleration, Nature. 2025-04-09. https://www.nature.com/articles/s41586-025-08854-x (demonstrated)
- Biggs et al., A natively flexible 32-bit Arm microprocessor, Nature. 2021-07-21. https://www.nature.com/articles/s41586-021-03625-w (demonstrated)
- (Chinese) 国务院, 截至今年6月底我国智能算力规模达788百亿亿次/秒 (人民日报). 2025-09-02. https://www.gov.cn/yaowen/liebiao/202509/content_7038732.htm (demonstrated)
- (Chinese) 全国数据资源统计调查工作组, 全国数据资源调查报告(2025年). 2026. https://www.nda.gov.cn/sjj/swdt/xwfb/0429/ff808081-9b5e8626-019d-d86b2f54-1154.pdf (demonstrated)
- International Energy Agency, Energy and AI, executive summary. 2025-04. https://www.iea.org/reports/energy-and-ai/executive-summary (demonstrated)
- International Energy Agency, Energy and AI, energy demand from AI. 2025-04. https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai (demonstrated)
- (Korean) 뉴시스, 정부, 엔비디아 GPU 26만장 확보. 2025-10-31. https://www.newsis.com/view/NISX20251031_0003385059 (opinion)
- (Japanese) 経済産業省, AI・半導体産業基盤強化フレーム. 2024-11. https://www.meti.go.jp/policy/mono_info_service/ai_semiconductor_frame/ai_semiconductor_frame.html (opinion)
- (Japanese) 総務省 有識者会合 資料5, 国内データセンター市場におけるAI需要・地方分散・再エネ電源 (富士キメラ総研). 2024-05-30. https://www.meti.go.jp/policy/mono_info_service/joho/conference/digital_infrastructure/0007/005_fujichimera.pdf (opinion)
- European Commission, EU launches InvestAI initiative to mobilise 200 billion euro (English). 2025-02-11. https://digital-strategy.ec.europa.eu/en/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- (Italian) Commissione europea, UE lancia InvestAI per mobilitare 200 miliardi di EUR. 2025-02-11. https://digital-strategy.ec.europa.eu/it/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- Press Information Bureau (India), reply in the Lok Sabha on the IndiaAI Mission. 2026-03-25. https://www.pib.gov.in/PressReleasePage.aspx?PRID=2245063 (demonstrated)
- (Portuguese) Ministério da Ciência, Tecnologia e Inovação, Plano Brasileiro de Inteligência Artificial 2024-2028. 2025. https://www.gov.br/mcti/pt-br/acompanhe-o-mcti/transformacaodigital/plano-brasileiro-de-inteligencia-artificial (opinion)
- SoftBank Group, Global Tech Alliance Launches Stargate UAE. 2025-05-22. https://group.softbank/en/news/press/20250522 (opinion)
- NVIDIA, HUMAIN and NVIDIA Announce Strategic Partnership to Build AI Factories in Saudi Arabia. 2025-05-13. https://nvidianews.nvidia.com/news/humain-and-nvidia-announce-strategic-partnership-to-build-ai-factories-of-the-future-in-saudi-arabia (opinion)
- Cassava Technologies, Cassava scales African AI infrastructure with NVIDIA-powered AI factories. 2025. https://www.cassavatechnologies.com/cassava-scales-african-ai-infrastructure-with-nvidia-powered-ai-factories-to-accelerate-sovereign-data-capabilities/ (opinion)