La brecha entre lo posible y lo desplegado: un modelo de cadencia de la inteligencia computacional y la función de forzamiento de las herramientas de automatización
Los métodos que reducen el costo de la inteligencia computacional se publican años antes de que la mayoría de los productos los usen. Este artículo mide esa brecha con fuentes fechadas, modela cómo los calendarios de reporte y financiamiento fijan una parte de ella, somete a prueba qué parte del gasto en infraestructura es un circuito cerrado, modela el costo de una tarea y enuncia qué datos refutarían el modelo.
David Charlot, Open Interface Engineering
Esta es una traducción de la versión en inglés. Si hay diferencias, prevalece la versión en inglés. Original en inglés.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. La brecha entre lo posible y lo desplegado: un modelo de cadencia de la inteligencia computacional y la función de forzamiento de las herramientas de automatización. Open Interface Engineering. Web: https://research.openie.dev/papers/latency/. PDF: https://research.openie.dev/pdfs/latency.pdf.
18 de octubre de 2026. Las fuentes están fechadas y clasificadas por clase de evidencia en las Referencias. Las proposiciones se derivaron a mano y no se comprobaron con un asistente de demostración, y ninguno de los números de la Sección 7 es un dato. Las cantidades marcadas como salida del modelo se calculan a partir de cifras citadas y no son observaciones.
Resumen
Los nuevos métodos para ejecutar inteligencia computacional a menor costo se publican abiertamente y llegan a la mayoría de los productos después de una demora. Este artículo define esa demora como una cantidad medible, la divide en partes técnica, de calendario y de incentivos, y modela cómo una herramienta que reduce el costo de la automatización cambia aquello por lo que un vendedor puede cobrar con beneficio. Después sitúa la demora dentro de la expansión actual de la infraestructura. Expone lo que los registros públicos documentan sobre el dinero que circula entre laboratorios, nubes y fabricantes de chips, enuncia una prueba que separa un circuito cerrado de la demanda externa, construye un modelo de costos en dólares y julios por tarea, compara los métodos de software abiertos y el hardware alternativo con la pila establecida, y traza un mapa de dónde se encuentran la capacidad, el cómputo y la energía. Las proposiciones se derivaron a mano, y cada predicción nombra los datos que la refutarían.
En palabras sencillas
- Los métodos abiertos que abaratan la inteligencia computacional alcanzan los mismos resultados en máquinas más antiguas y más baratas, y la espera entre un método publicado y un producto lanzado es más corta para algunos métodos que para otros.
- La mayor parte de lo que cuesta una tarea es el precio de las máquinas y no la electricidad, y los precios que pagan los usuarios han caído mucho más rápido que los costos del hardware. El dinero detrás de las máquinas incluye circuitos entre unos pocos laboratorios, nubes y fabricantes de chips que los registros documentan, e incluye también efectivo de otros negocios y de clientes ajenos a esos circuitos. La Sección 10 ofrece una prueba que separa ambos con datos.
- Parte de la espera proviene de los calendarios, porque las empresas deciden en pasos trimestrales y anuales. Cuando una herramienta abarata el trabajo lo suficiente, esperar deja de compensar al vendedor, y lo que queda por cobrar es el costo de cambiar de proveedor y no el costo del cómputo.
Notación
| Término | Significado en este artículo |
|---|---|
| Tarea | Una unidad de trabajo útil con un umbral de calidad declarado , por ejemplo una respuesta correcta o una estimación comprobada. |
| Julios por tarea, | Energía medida en julios para completar una tarea con calidad de al menos . Aquí es la unidad de cuenta de la inteligencia computacional. |
| Costo por tarea, | Costo monetario de una tarea: , donde es el precio de un julio y es el costo de hardware y operación que no baja con . |
| Frontera de capacidad, | El costo por tarea más bajo alcanzable por cualquier método documentado públicamente hasta el tiempo . |
| Frontera desplegada, | El costo por tarea más bajo ofrecido en un producto de disponibilidad general hasta el tiempo . |
| Latencia, | Para un nivel de costo , el tiempo entre el momento en que la frontera de capacidad alcanza y el momento en que la frontera desplegada alcanza . Se define en la Sección 0. |
| Periodo de reporte, | La separación entre las fechas de decisión de una empresa que reporta resultados, alrededor de un trimestre. |
| Fricción de cambio, | El costo por tarea que asume un comprador para pasarse a otro vendedor: integración, transferencia de datos, recapacitación, condiciones contractuales, configuraciones por defecto. |
| Costo de adopción, | Costo único de reconstruir una oferta en torno a un método nuevo. |
| Tiempo de acelerador por tarea, | Horas de acelerador utilizadas que ocupa una tarea con calidad de al menos . Sección 12. |
| Precio del julio con carga de capital, | Precio de la electricidad más el capital por hora utilizada dividido entre la potencia de la instalación. Sección 12. |
| Cota de la proporción de circuito cerrado, | Cota superior de la proporción de los ingresos de un proveedor que su propio capital aportado podría haber financiado. Sección 10. |
| Déficit tolerado, | La mayor caída de los resultados reportados en un periodo que una empresa aceptará, en las mismas unidades que . |
0. Definiciones y alcance
Sea el costo por tarea más bajo alcanzable en el tiempo por cualquier método documentado públicamente con calidad . Es no creciente, porque la documentación no se retira. Sea el costo por tarea más bajo ofrecido en un producto de disponibilidad general en el tiempo . Es no creciente por la misma razón cuando un vendedor no retira una oferta, y por construcción. Para un nivel de costo , se escribe y .
Definición 1 (latencia). . La pregunta del artículo es qué tan grande es , qué la fija y qué la mueve.
Definición 2 (partes técnica, de calendario y de incentivos). Para una empresa la latencia se descompone como . Aquí es la demora de preparación técnica: el tiempo que necesitan los ingenieros para portar, probar y robustecer el método. El término es la espera de calendario: el tiempo entre la preparación y la siguiente fecha en que la empresa toma decisiones de lanzamiento. El término es la demora por incentivos: el tiempo durante el cual el lanzamiento tiene valor positivo a largo plazo pero una regla de reporte o de financiamiento lo bloquea. La latencia artificial es . La palabra se usa en un sentido estrecho: es la parte que el tiempo de ingeniería no explica, y no es una afirmación sobre el motivo de nadie.
Alcance. El artículo cubre los métodos que cambian el costo de la inteligencia computacional: arquitecturas de modelos, formatos numéricos, kernels, compiladores, procedimientos de inferencia estadística y medición de energía. Cubre también la infraestructura que los ejecuta: los flujos de capital y de compromisos de cómputo entre laboratorios, nubes y fabricantes de chips, el costo de una hora de acelerador, los métodos abiertos y el hardware alternativo que cambian el tiempo de acelerador por tarea, y dónde se ubican la capacidad, el cómputo y la energía. No pronostica ninguna empresa, precio ni cuota. La energía por tarea en julios es la métrica donde existe una cifra en julios. Donde una fuente reporta solo dólares o segundos, se usa la cifra en dólares o segundos y se rotula como tal.
1. Clases de evidencia
Cada fuente de este artículo se clasifica en una de tres clases, y la clase figura en las Referencias.
- Establecido por demostración en la fuente. La fuente contiene un teorema o una derivación analítica con su demostración. Una demostración dentro de un artículo es la demostración del autor, no una comprobada por máquina, y el artículo no la llama más que eso. Los expedientes judiciales y las publicaciones estadísticas se clasifican como demostrados, porque reportan hechos fechados y no derivaciones.
- Demostrado. La fuente reporta una medición, encuesta, experimento o lanzamiento fechado con un método declarado. El resultado vale para ese contexto y puede no trasladarse a otros.
- Opinión. La fuente es un pronóstico, una declaración de un proveedor sin datos, un relato de un profesional o una revisión que resume otros trabajos. Las revisiones se clasifican aquí porque el artículo no puede saber por ellas qué se midió.
Las cifras se citan tal como las declara la fuente, con el contexto y las salvedades de la propia fuente. Donde una cantidad se deriva de cifras citadas, el texto la llama salida del modelo y muestra la aritmética o nombra el script que la calcula. Los anuncios de planes, metas e inversiones previstas se clasifican como opinión, porque declaran una intención y no un resultado, y los registros ante el regulador se clasifican como demostrados. Cada fuente se obtuvo en texto completo y cada cifra citada se localizó en ese texto. Las fuentes en alemán, francés, español, portugués, italiano, coreano, japonés y chino se leyeron en el idioma original, y sus cifras se reproducen en inglés sin cambios.
2. Lo que se hizo posible, de 2024 a 2026
La lista siguiente se organiza según la palanca que cada método acciona sobre el costo por tarea. Cada fila da la fecha de la primera publicación pública, la afirmación tal como la reportan los autores y la clase.
Tabla 1. Métodos que cambian lo que cuesta una tarea.
| Palanca | Método y afirmación | Publicado | Clase |
|---|---|---|---|
| Arquitectura | Los modelos de espacio de estados selectivos y las variantes de atención son duales a través de matrices semiseparables estructuradas, y la capa resultante se reporta de 2 a 8 veces más rápida que el barrido anterior [38]. | 31 de mayo de 2024 | establecido por demostración en la fuente |
| Arquitectura | Varios grupos publicaron modelos híbridos de espacio de estados y atención con pesos abiertos a lo largo de 2024 y 2025 [39]. | 2024 a 2025 | demostrado |
| Formato numérico | Los pesos ternarios igualan la perplejidad y las puntuaciones en tareas finales de 16 bits a partir de unos 3.000 millones de parámetros, con menor latencia, memoria y energía, en los experimentos de los autores [40]. | 27 de febrero de 2024 | demostrado |
| Formato numérico | Preentrenamiento estable en 4 bits de un modelo híbrido de 12.000 millones de parámetros con 10 billones de tokens, comparable a los resultados en 8 bits, reportado por el fabricante del hardware [41]. | sep. de 2025 | demostrado |
| Kernels | Un kernel de atención alcanza hasta el 75% del rendimiento máximo en 16 bits en una generación de aceleradores, frente al 35% de su predecesor [42]. | jul. de 2024 | demostrado |
| Dispersión | Atención dispersa alineada con el hardware y entrenable de forma nativa, con aceleraciones reportadas a 64.000 tokens de contexto [43]. | feb. de 2025 | demostrado |
| Decodificación | La decodificación especulativa deja la distribución de salida sin cambios y se midió de 2 a 3 veces más rápida en un modelo de traducción grande [23]. | 30 de noviembre de 2022 | establecido por demostración en la fuente |
| Escalado | Cuando se cuenta la demanda de inferencia de toda la vida útil, el modelo óptimo en costo es más pequeño y se entrena con más tokens de lo que da la regla que solo considera el entrenamiento [44, 45]. | ene. de 2024 | demostrado |
| Costo de entrenamiento | Un modelo de escala de frontera reportado con 2,788 millones de horas de acelerador para el entrenamiento completo, con atención latente y entrenamiento en 8 bits [46]. | 26 de diciembre de 2024 | demostrado |
| Inferencia conforme | Cobertura de muestra finita y libre de distribución para cualquier predictor, con demostraciones reunidas en un libro [47]; una revisión publicada por primera vez en octubre de 2024 y editada en 2025 cubre datos estructurados, no estructurados y dinámicos [48]. | 18 de noviembre de 2024 | establecido por demostración en la fuente |
| Inferencia con predicciones | Intervalos válidos a partir de un pequeño conjunto etiquetado y muchas predicciones de máquina, para cualquier predictor [49]. | 2023 | establecido por demostración en la fuente |
| Inferencia secuencial | Procesos E y secuencias de confianza que siguen siendo válidos cuando una prueba se detiene en cualquier momento [50]. | nov. de 2023 | establecido por demostración en la fuente |
| Estimación causal | El aprendizaje automático sin sesgo da inferencia válida sobre un parámetro objetivo con modelos de perturbación flexibles, extendido a efectos identificables más allá del ajuste por puerta trasera [51, 52]. | 2018; 2021 | establecido por demostración en la fuente |
| Compiladores | Pases de compilador para diferenciación automática de orden superior reportan hasta 1,3 veces en operadores de segundo orden, de forma preliminar [53]; un artículo metodológico de 2026 afirma que JAX compilado supera con creces la eficiencia de Stan en hardware moderno, sin cifras de referencia en su resumen [54]. | 2025 | demostrado |
| Programación probabilística | Un compilador que conserva la semántica probabilística reporta una media geométrica de 6,4 veces sobre Stan y 53 veces sobre Turing en pruebas de referencia estándar [55]. | 2025 a 2026 | demostrado |
| Medición de energía | Una prueba de referencia abierta mide la energía de inferencia en 40 arquitecturas y reporta configuraciones de Pareto de tiempo y energía con ahorros superiores al 40% en algunos casos [56]; un proveedor reporta 0,24 vatios hora para una consulta de texto mediana en producción [57]. | 2025 | demostrado |
Dos tasas dan el contexto. El cómputo necesario para alcanzar una puntuación fija de un modelo de lenguaje se ha reducido a la mitad aproximadamente cada 8 meses, con un intervalo del 95% de unos 5 a 14 meses [58]. El precio de alcanzar un nivel fijo en una prueba de referencia cayó entre 9 y 900 veces al año en seis pruebas, con una mediana de unas 50, y las tasas más rápidas se apoyan en menos de un año de datos [59]. Ambas son tasas de cambio de la frontera de capacidad o de un precio, y ninguna mide la brecha hasta el despliegue.
Dos límites se aplican a la tabla. Varias filas son aceleraciones frente a una línea base elegida por los autores, de modo que los números no se suman ni se comparan entre filas. Y “posible” en estas filas significa demostrado por los autores en un contexto declarado, no disponible en un producto.
3. Cómo se ve la brecha en los datos
Difusión a largo plazo. En 15 tecnologías y 166 países de 1820 a 2003, el rezago medio entre la invención y la adopción en un país fue de unos 45 años, y los rezagos se acortaron a lo largo del periodo [60]. La misma historia encierra una advertencia sobre lo que significa adoptar. Los motores eléctricos elevaron la productividad de las fábricas solo después de que las plantas se rediseñaran en torno a un motor por máquina, un cambio que llevó décadas [61]. Un modelo posterior atribuye la caída y el repunte de la productividad medida a una inversión complementaria no medida en procesos y habilidades [62]. En ambos relatos la demora es sobre todo el costo de reorganizarse en torno a la herramienta, que en la notación anterior es .
De la publicación abierta al hardware de consumo. Para los modelos que caben en una tarjeta gráfica de consumo, el rezago medio frente al mejor modelo en general fue de 6 a 12 meses en cuatro medidas en 2025, con el mayor rezago, 12,4 meses, en una puntuación de preferencia [63]. Un análisis más amplio de modelos de pesos abiertos de cualquier tamaño encontró alrededor de un año, con un rango de 5 a 22 meses según la prueba de referencia, y un análisis posterior basado en un índice situó la media cerca de 3 meses [64]. Estas cifras miden la distancia entre dos fronteras públicas. Son cotas inferiores de un rezago hasta los productos, porque un modelo abierto en una tarjeta todavía no es un producto al que alguien se le pague por dar soporte.
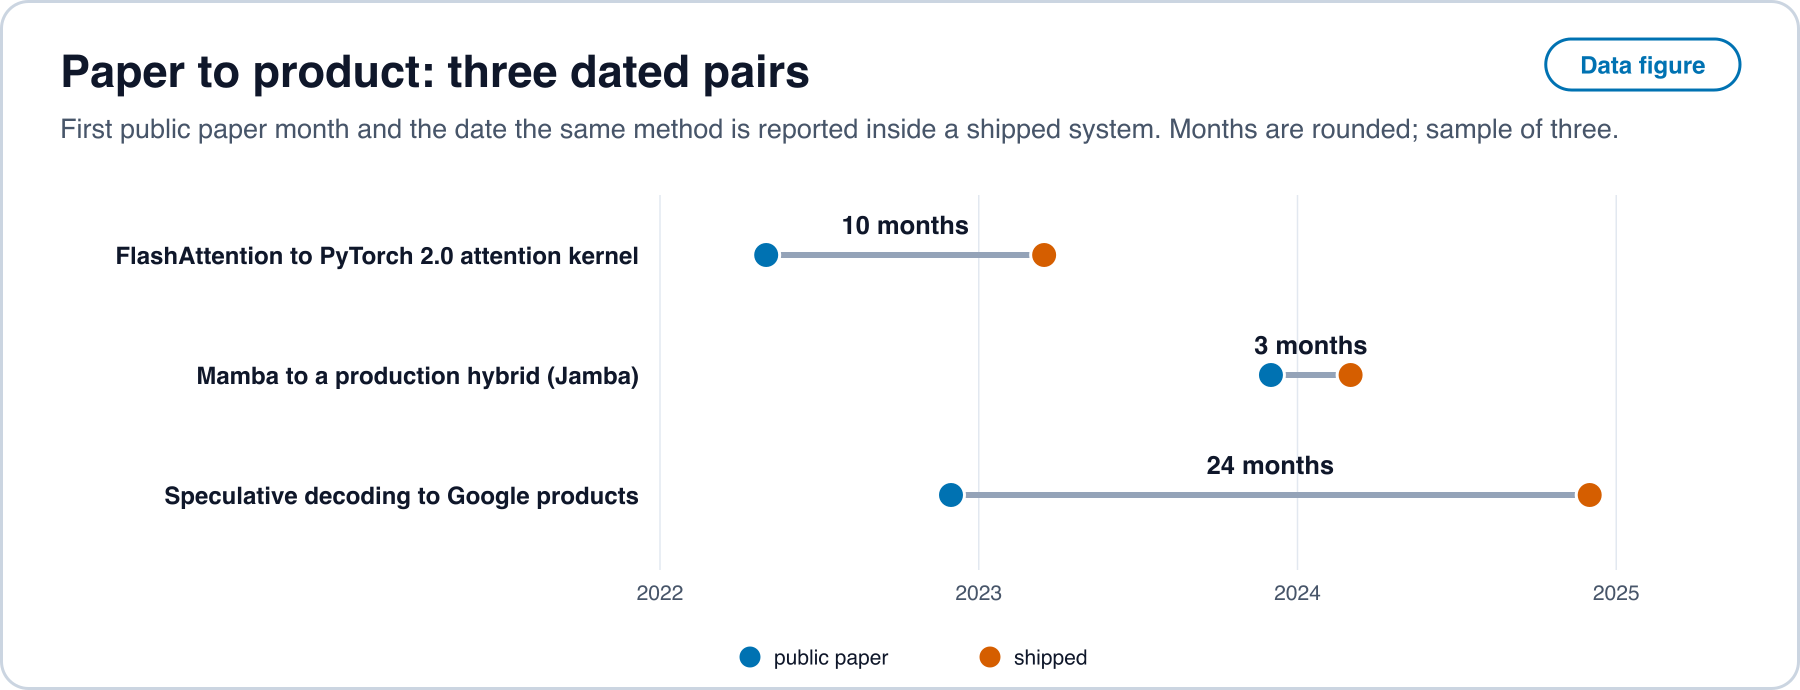
Del artículo al producto. La decodificación especulativa se publicó en noviembre de 2022. El empleador de sus autores informó que la aplicaba en productos para diciembre de 2024 [24]. Un relato de un profesional del mismo mes dice que el uso en producción requirió trabajo adicional en el procesamiento por lotes, la calidad y la fiabilidad, y que ayuda sobre todo con tamaños de lote limitados [65]. Otros dos pares figuran en la Sección 13. Unos pocos pares fechados no son una distribución, y el protocolo de la Sección 16 especifica cómo reunir muchos. Una medida de más largo plazo de la distancia entre artículos y patentes encuentra que las citas de patentes a artículos son en promedio 14,4 años más antiguas que la patente en la portada y 16,6 años cuando se cuentan las citas en el texto [66], y que las patentes y los artículos vinculados suelen estar a entre dos y cuatro pasos de citación [67]. Esas cifras son para la ciencia en general y no se refieren al aprendizaje automático en particular.
La práctica de los modelos de 4 bits. Los relatos de profesionales fechan en 2023 el momento en que la inferencia local en 4 bits se volvió viable en máquinas de consumo [68]. Los relatos son narrativos, así que es evidencia de clase opinión para una fecha y no una medición.
Adopción en las empresas. El suplemento de 2026 de la Oficina del Censo de los Estados Unidos encontró que el 18% de las empresas usaba IA en una función de negocio entre noviembre de 2025 y enero de 2026, que el 22% esperaba hacerlo en seis meses y que el 57% de los usuarios la empleaba en tres funciones o menos [34]. En la Unión Europea, el 20,0% de las empresas con 10 o más empleados usó al menos una tecnología de IA en 2025, 6,5 puntos más que en 2024, con el 55,0% de las grandes, el 30,4% de las medianas y el 17,0% de las pequeñas [33]. La OCDE reporta una adopción del 13,9% en 2024 y del 39% de las grandes empresas frente al 12% de las pequeñas [35]. Los datos de contratación chinos muestran contratación relacionada con la IA generativa en el 21% de las empresas cotizadas frente al 0,2% de las no cotizadas a finales de 2025 [69]. La redacción de las encuestas y los marcos muestrales difieren según la fuente, y la pregunta del Censo se revisó en noviembre de 2025, de modo que las tasas no son comparables entre filas.
Estadísticas oficiales en los idiomas originales. El Statistisches Bundesamt de Alemania reporta que el 20% de las empresas con 10 o más empleados usó IA en 2024, frente al 12% en 2023 y el 11% en 2021, con el 48% de las grandes, el 28% de las medianas y el 17% de las pequeñas, y señala la falta de conocimientos y la inseguridad jurídica como las razones más comunes para no usarla [70]. Su tabla de 2025 da un 26% en total y un 57% para las empresas con más de 250 empleados, con una definición de empresa modificada [31]. Insee reporta que el 10% de las empresas en Francia usaba IA en 2024, cuatro puntos más que en 2023, el 33% de las empresas con 250 o más empleados, y el 42% en información y comunicación frente al 5% o menos en transporte, alojamiento y alimentación, y construcción [37]. El Instituto Nacional de Estadística de España reporta que el 21,1% de las empresas con 10 o más empleados usaba IA en el primer trimestre de 2025, 8,7 puntos más que un año antes [32]. Cetic.br de Brasil reporta que el 13% de las empresas usaba IA en 2024, la misma proporción que en 2023, concentrada en las grandes empresas y en información y comunicación [36]. Las estadísticas del ministerio coreano, según la prensa coreana, dan un 32,9% de empresas que usaban tecnología o servicios de IA en 2024 frente al 30,3% en 2023, y un 66,9% para las empresas con 250 o más trabajadores [30]. El libro blanco de Japón encuestó a trabajadores de cuatro países y encontró algún uso empresarial de la IA generativa en el 55,2% en Japón, el 90,6% en los Estados Unidos, el 90,3% en Alemania y el 95,8% en China. Entre las empresas japonesas, el 49,7% tenía una política de uso activo o limitado en 2024 frente al 42,7% un año antes, y la preocupación japonesa más común, con el 30,1%, era no saber usarla de manera eficaz, frente al 9,7% en los Estados Unidos y el 10,4% en China [71]. El CNNIC de China cuenta 515 millones de usuarios de IA generativa en junio de 2025, 266 millones más que en diciembre de 2024, una penetración del 36,5% [72]. Son mediciones de uso, no de lanzamiento. Dentro de cada país la tasa aumenta con el tamaño de la empresa, lo que es coherente con un costo de adopción fijo que pesa menos en un presupuesto grande, aunque las encuestas no pueden separarlo de otras causas.
Uso a nivel de personas y tareas. Casi el 40% de los adultos de los Estados Unidos de 18 a 64 años usó IA generativa a finales de 2024, y alrededor del 23% de los trabajadores la había usado en el trabajo la semana anterior [73]. Un estudio de campo con 5.179 agentes de atención al cliente encontró en promedio un 14% más de resoluciones por hora y un 34% más para los trabajadores novatos y de baja cualificación [74]. Un ensayo aleatorizado con 16 desarrolladores experimentados y 246 tareas encontró que las tareas en las que se permitía la IA tardaron un 19% más en ese contexto [75]. Estos resultados difieren porque las tareas, las personas y las herramientas difieren. Muestran que el despliegue no es un evento único, y por eso se define a partir de ofertas y no del uso.
Lo que frena a la propia investigación. El esfuerzo de investigación ha aumentado mientras la productividad de la investigación ha caído en la mayoría de los sectores, y mantener la duplicación de la densidad de los chips requirió más de 18 veces los investigadores de principios de la década de 1970 [76]. Esto afecta a , no a , y se señala para que el artículo no trate la frontera de capacidad como gratuita.
4. Calendarios: periodos de reporte y de financiamiento
Las fechas de decisión en las empresas cotizadas siguen el calendario de reporte. En una encuesta a 401 ejecutivos financieros, el 78% renunciaría a valor económico para suavizar los resultados reportados, y el 55% evitaría iniciar un proyecto con valor actual neto muy positivo si eso significara no alcanzar el consenso del trimestre [77]. Las empresas públicas comparables invierten menos, y responden menos a las oportunidades de inversión, que las empresas privadas [78]. Todo esto está demostrado para tecnologías y periodos anteriores, y nada de ello es una medición de lanzamientos de IA.
La atención sigue el mismo calendario. El número de llamadas de resultados de grandes empresas de los Estados Unidos que mencionaron “AI” llegó a 306 en el tercer trimestre de 2025, frente a una media de diez años de 86 [79]. El lenguaje de las llamadas de resultados se ha usado como instrumento de medición para otros temas, validado frente a la lectura manual [80], y el mismo instrumento puede apuntarse a temas de lanzamiento.
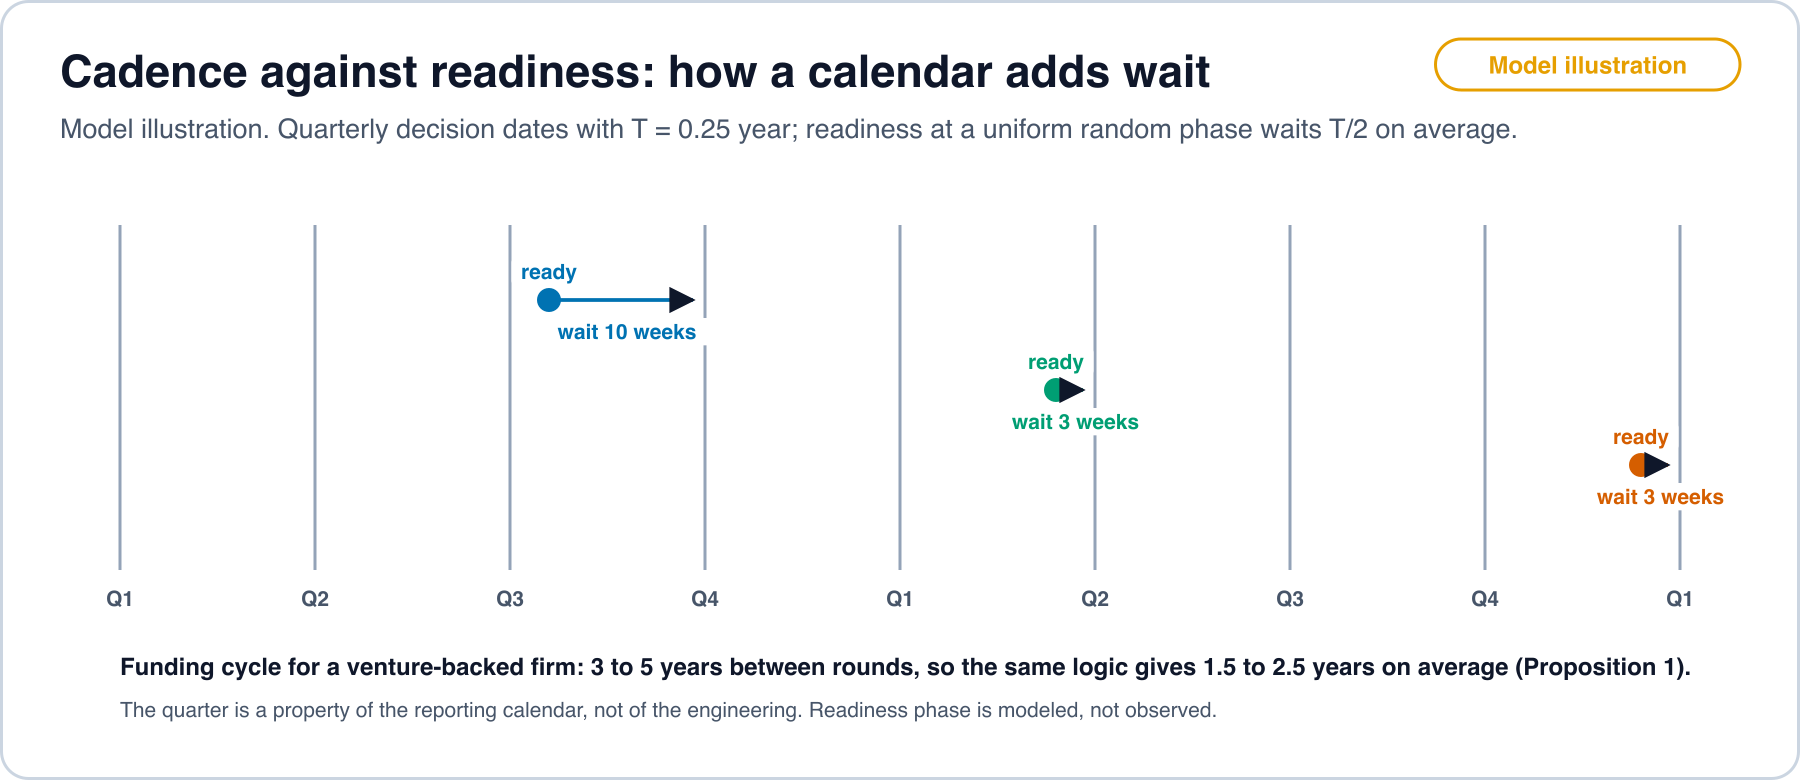
El financiamiento sigue un calendario más largo. Un fondo de capital de riesgo tiene una vida finita, por lo general de diez años, y las firmas levantan nuevos fondos cada tres a cinco años [81]. Los acuerdos de sociedad especifican vidas finitas, normalmente de diez años [82]. Los dos calendarios difieren en duración, alrededor de un trimestre y de tres a cinco años, y ambos cuantizan cuándo puede asumirse un compromiso. La Proposición 1 de más abajo usa solo esa estructura.
5. Control y respuesta de los incumbentes
Dos resultados más antiguos enmarcan el incentivo para desplegar. El análisis de Arrow encuentra que el incentivo para inventar es menor bajo monopolio, entendido como barreras de entrada, que bajo competencia, y considera casi competitivo un monopolio temporal que no impide la entrada [83]. Una revisión posterior de la literatura sobre competencia e innovación señala que los incentivos de apropiación preventiva son una fuerza ausente en los modelos estáticos simples [84]. Los incumbentes también pasan por alto cambios que reordenan componentes conocidos, porque sus rutinas filtran lo que perciben [85]. Ninguno de ellos es una afirmación sobre alguna empresa actual.
El control sobre la distribución está documentado en expedientes judiciales públicos. En septiembre de 2025 un tribunal de distrito de los Estados Unidos prohibió los contratos de distribución exclusiva para varios productos de búsqueda y de asistente, permitió pagos no exclusivos por configuración por defecto con plazos limitados en general a un año, y ordenó remedios de intercambio de datos y de sindicación [86]. El artículo usa el expediente solo como evidencia de que las configuraciones por defecto y las condiciones de distribución tienen precio y están reguladas, que es lo que representa el parámetro en la Sección 6.
6. El modelo
Contexto. Una población de compradores con demanda por periodo para una tarea a precio . Un incumbente la atiende a costo con un método existente. Un método público queda disponible para cualquiera a costo , no creciente en el tiempo. Un comprador puede pasarse a un vendedor que usa el método público con una fricción por tarea, de modo que el techo de precio del incumbente es . El incumbente puede lanzar una oferta basada en el método público con un costo único . Las decisiones se toman solo en las fechas .
Supuestos.
- A1. Demanda lineal , con .
- A2. El costo público disminuye: es no creciente y continuo con , y .
- A3. El techo limita el precio del incumbente, es decir para el costo al que se enfrenta. Esto se cumple para los números de la Sección 7.
- A4. El incumbente maximiza el beneficio descontado a la tasa sujeto a una regla de reporte: una proporción de se registra como gasto en el periodo de lanzamiento, y los resultados reportados del periodo de lanzamiento no deben quedar por debajo del nivel previo al lanzamiento en más de .
- A5. Después del lanzamiento el costo del incumbente es , el costo del método público.
- A6. Las ganancias de flujo del lanzamiento se tratan como constantes después de la fecha de lanzamiento (aproximación de estado estacionario).
Proposición 1 (cuantización por calendario). Si un método queda listo en el tiempo y la empresa lanza en la primera fecha de decisión igual o posterior a en la que el lanzamiento conviene, la espera es . Si es uniforme en , entonces y .
Derivación. Se escribe con uniforme en . Para la fecha siguiente es y la espera es , que es uniforme en . Una variable uniforme en un intervalo de longitud tiene media y varianza . El caso tiene probabilidad cero.
Consecuencia. Una empresa que decide con un calendario trimestral añade en promedio unas 6 semanas, y una que decide con un ciclo de financiamiento de 3 a 5 años añade de 1,5 a 2,5 años, a la demora de preparación , sin ninguna causa de ingeniería. El supuesto de que la preparación es uniforme dentro de un periodo es la parte débil, y la Predicción 1 pone a prueba lo contrario.
Proposición 2 (umbral de lanzamiento y lanzamiento forzado). Se define la ganancia de flujo para el costo externo . En , es estrictamente decreciente en . Sin restricciones de calendario ni de reporte, el lanzamiento es óptimo exactamente cuando , es decir cuando , donde es la solución única de si existe. Si , retener no produce beneficio, y se prefiere lanzar a retener. Una regla de reporte puede demorarlo pero no puede hacer rentable la retención.
Derivación. Bajo A3 el incumbente que retiene a costo fija el precio en el techo, de modo que su beneficio es . Después del lanzamiento su costo es y su beneficio es . La diferencia es . Derivando, en el rango indicado, así que es estrictamente decreciente. Con A6 el valor del lanzamiento es , que es no negativo exactamente cuando . Retener da un beneficio , que es cero en , es decir en , y negativo por debajo. Lanzar en ese punto da un beneficio por A1.
Proposición 3 (compuerta de reporte, demora y una región sin lanzamiento). Bajo A4 el cambio en los resultados reportados del periodo de lanzamiento es . El lanzamiento se permite si esto es al menos , es decir si . Se define y . Entonces , la fecha de lanzamiento se desplaza de a o al punto de lanzamiento forzado , lo que ocurra antes, y para la demora es cuando . Si , donde es el piso de costo, el lanzamiento nunca ocurre por las condiciones de VAN y de compuerta, y solo se aplica el lanzamiento forzado en si .
Derivación. Los resultados reportados en el periodo de lanzamiento ganan de beneficio operativo y pierden la parte registrada como gasto del costo de adopción. Exigir que el neto sea al menos da la desigualdad indicada. Como es estrictamente decreciente (Proposición 2), la mayor de dos ganancias exigidas corresponde al menor umbral de costo, de modo que . Con el tiempo para alcanzar es , y la diferencia de dos de esos tiempos es la demora indicada. La ganancia alcanzable es como mucho porque por A2.
Proposición 4 (función de forzamiento). Supóngase que una herramienta de automatización reduce el costo de adopción de a . (a) El umbral de VAN sube, de modo que el lanzamiento es óptimo antes. (b) Si , la compuerta de reporte no limita, , y . (c) La latencia total de la empresa baja a , donde es la demora de preparación técnica con la herramienta.
Derivación. (a) y es estrictamente decreciente, así que reducir reduce la ganancia exigida y eleva . (b) La condición de compuerta se cumple para todo cuando el lado derecho es no positivo, es decir . Entonces . (c) Se sigue de la Definición 2 y la Proposición 3.
Lectura. Una herramienta actúa como función de forzamiento de dos maneras distintas. Reduce y así elimina la demora de compuerta cuando pasa por debajo de . Y reduce para todos los vendedores, lo que fuerza el lanzamiento en , donde retener no produce nada. La primera es una propiedad de la empresa que adopta y la segunda una propiedad del mercado.
Proposición 5 (la latencia del mercado la fija la empresa menos restringida). Si sobre las empresas que pueden vender a la población de compradores, entonces .
Derivación. , y no depende de . Restando se obtiene el resultado.
Consecuencia. Un calendario o una compuerta que demora a una empresa no demora al mercado cuando otra empresa puede llegar a los mismos compradores sin esa demora. La latencia observada en un mercado es entonces la latencia de la empresa más rápida que tiene acceso. Donde el acceso está restringido, porque los compradores no pueden llegar a otros vendedores, el mínimo se toma sobre un conjunto más pequeño. En el modelo ese es el papel de .
Proposición 6 (lo que queda por cobrar). Después del lanzamiento, con el techo limitando, el precio es , el beneficio es y el margen por tarea es , independiente de . El precio cambia uno a uno con el costo, mientras que la razón entre precio y costo sube a medida que el costo baja. El valor marginal de la fricción es , que es positivo para y aumenta a medida que baja.
Derivación. Bajo A3 el incumbente cobra el techo . Con costo , el margen es y el volumen es , lo que da . La razón se sigue de . Derivando respecto de se obtiene , y .
Lectura. A medida que cae el costo del cómputo, la parte del precio que refleja el cómputo se reduce, y el margen restante depende de lo costoso que le resulte a un comprador irse. El gasto que eleva pasa a valer más. En el modelo esta es una afirmación sobre incentivos y no un juicio sobre ninguna empresa. Las políticas que reducen , como los límites a las condiciones por defecto o los formatos de datos portables, reducen el margen en la misma cantidad, y el modelo no dice si eso es deseable.
7. Una ilustración numérica, no un ajuste
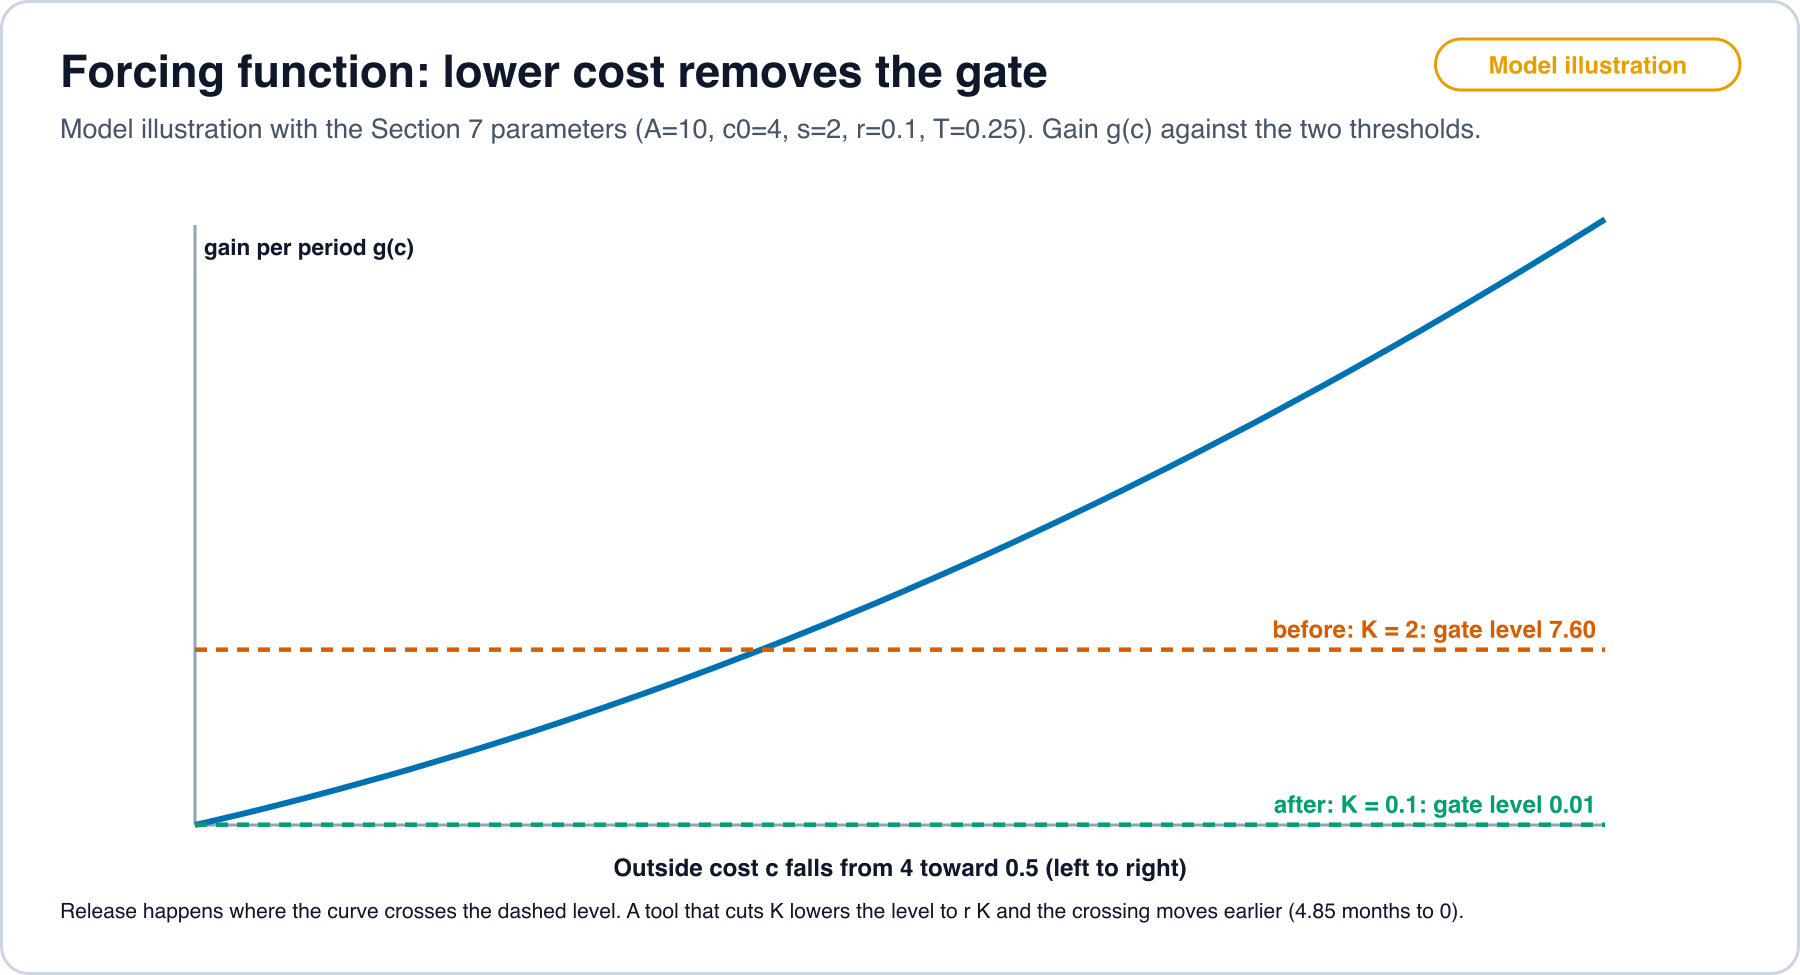
El script model_check.py de la carpeta de trabajo reproduce estos números con la biblioteca estándar. Parámetros: , , , por año, año, , , y un costo externo que se reduce a la mitad cada 8 meses, de modo que . La tasa de 8 meses remite a [58] y es una elección para la ilustración, no una estimación del costo.
Tabla 2. Fecha de lanzamiento con y sin una herramienta que reduce el costo de adopción.
| Caso | Umbral de VAN | Umbral de compuerta | Lanzamiento en | Demora de compuerta | |
|---|---|---|---|---|---|
| Antes de la herramienta | 2,0 | , día 4 | mes 5,00 | 4,85 meses | |
| La herramienta reduce el costo de adopción | 0,1 | día 0,2 | 0 |
En la primera fila la compuerta exige una ganancia de , muy por encima del requisito de VAN , de modo que la parte de demora por incentivos es de 4,85 meses. Eso es más largo que el término de calendario de la Proposición 1 para una empresa trimestral, que es de 1,5 meses en promedio. En la segunda fila , así que la compuerta no limita y solo queda la condición de VAN, como en la Proposición 4(b).
model_check.py y Tabla 2. Open full sizeTabla 3. Después del lanzamiento, con .
| Precio | Beneficio | |||
|---|---|---|---|---|
| 4,0 | 6,00 | 1,50 | 8,00 | 2,00 |
| 3,0 | 5,00 | 1,67 | 10,00 | 3,00 |
| 2,0 | 4,00 | 2,00 | 12,00 | 4,00 |
| 1,0 | 3,00 | 3,00 | 14,00 | 5,00 |
| 0,5 | 2,50 | 5,00 | 15,00 | 5,50 |
El beneficio sube a medida que baja el costo porque la demanda lineal permite que el volumen se expanda. Con una demanda saciada la columna de beneficio se aplanaría, y la afirmación de que el margen se mantiene en no cambiaría. Una simulación de la Proposición 1 con y preparación uniforme da una espera media de 0,1250 frente a y una varianza de 0,00521 frente a (200.000 extracciones, semilla 7).
8. Predicciones y lo que las refutaría
Cada predicción nombra los datos, la prueba y el resultado que contaría en contra del modelo. Las predicciones se enuncian antes de reunir cualquiera de los datos.
Predicción 1 (agrupamiento por calendario). Las fechas en que las empresas con reporte trimestral ponen en disponibilidad general métodos que antes eran abiertos no son uniformes dentro del trimestre. Prueba: para una muestra de al menos 200 lanzamientos de empresas cotizadas, calcular la fase de cada fecha dentro del trimestre fiscal de la empresa y aplicar las pruebas de Rayleigh y de Kuiper contra la uniformidad. Se refuta si la hipótesis nula de fase uniforme no se rechaza al 5% con 200 o más elementos independientes.
Predicción 2 (cotizadas frente a no cotizadas). Para el mismo método y una dificultad comparable, la demora mediana desde la publicación abierta hasta un producto de disponibilidad general es más larga para las empresas cotizadas que para las empresas financiadas fuera de un calendario de reporte. Prueba: pares emparejados por método, con el tipo de empresa como tratamiento y razones de riesgo para el tiempo hasta el lanzamiento. Se refuta si el intervalo del 95% de la razón de riesgo (cotizadas sobre no cotizadas) queda por completo por encima de 0,8.
Predicción 3 (las herramientas bajan la compuerta). Después de que una herramienta de automatización que reduce el costo de portar queda disponible para un objetivo de hardware o de software, el tiempo desde la publicación abierta hasta la disponibilidad general en ese objetivo disminuye. Prueba: diferencias en diferencias con objetivos atendidos y no atendidos por la herramienta, con la demora de lanzamiento en días como resultado. Se refuta si el intervalo del 95% del cambio estimado queda por completo por encima de días. El margen de 30 días es una elección del protocolo hecha antes de reunir los datos.
Predicción 4 (el precio supera al costo). Donde se miden los costos en julios y de hardware por tarea, la razón entre el precio de lista y el costo por tarea sube a medida que baja el costo medido. Prueba: panel de servicios con una tarea declarada, usando mediciones abiertas de energía y precios de lista. Se refuta si la razón es plana o baja en más de la mitad de las tareas durante un periodo en el que el costo cayó en un factor de 2 o más.
Predicción 5 (el gasto se desplaza hacia la fricción). En un mercado donde el costo por tarea baja, la proporción de los ingresos del vendedor gastada en distribución, configuraciones por defecto y empaquetamiento sube. Prueba: pagos de distribución y condiciones de empaquetamiento divulgados en registros y expedientes judiciales frente a los ingresos. Se refuta si la proporción es plana o baja mientras el costo por tarea cae en un factor de 2 o más.
Predicción 6 (la latencia del mercado sigue a la empresa más rápida). En los mercados donde los compradores pueden llegar a más de un vendedor con poca fricción, la latencia del mercado se acerca a la latencia mínima de las empresas, y en los mercados con alta fricción medida se acerca más a la mediana. Prueba: regresión de la latencia del mercado sobre la fricción de cambio medida. Se refuta si el intervalo del 95% de la pendiente respecto de la fricción queda por completo en cero o por debajo.
Predicciones sobre el financiamiento y el costo de la expansión. Las predicciones de las Secciones 10 y 12 tratan de los flujos de dinero y del costo de una hora de acelerador. Se enuncian en esas secciones, y se ponen a prueba con registros y listados fechados después de este artículo.
Lo que refutaría el modelo en sí. Un hallazgo de que las fechas de lanzamiento son uniformes dentro del trimestre para las empresas cotizadas (Predicción 1), de que las empresas cotizadas y no cotizadas lanzan al mismo ritmo (Predicción 2) y de que la llegada de herramientas para portar no cambia la demora (Predicción 3) no dejaría ningún papel a los calendarios ni a las compuertas de reporte, y la latencia artificial de la Definición 2 sería cero en la medición. El modelo se reduciría entonces a la demora de ingeniería .
9. El circuito del dinero: lo que documentan los registros
Una descripción frecuente de la expansión actual es una economía circular: los laboratorios compran cómputo a las nubes, las nubes y las neonubes compran chips y memoria, y los fabricantes de chips y las nubes invierten en los laboratorios. Esta sección expone lo que dicen los documentos fechados sobre esa descripción. No da ningún veredicto. Cada elemento se marca como documentado cuando un registro, un comunicado fechado o una estadística oficial declara el importe y las contrapartes, inferido cuando se sigue por aritmética de cifras documentadas bajo un supuesto declarado, y no encontrado cuando las fuentes leídas no lo dicen.
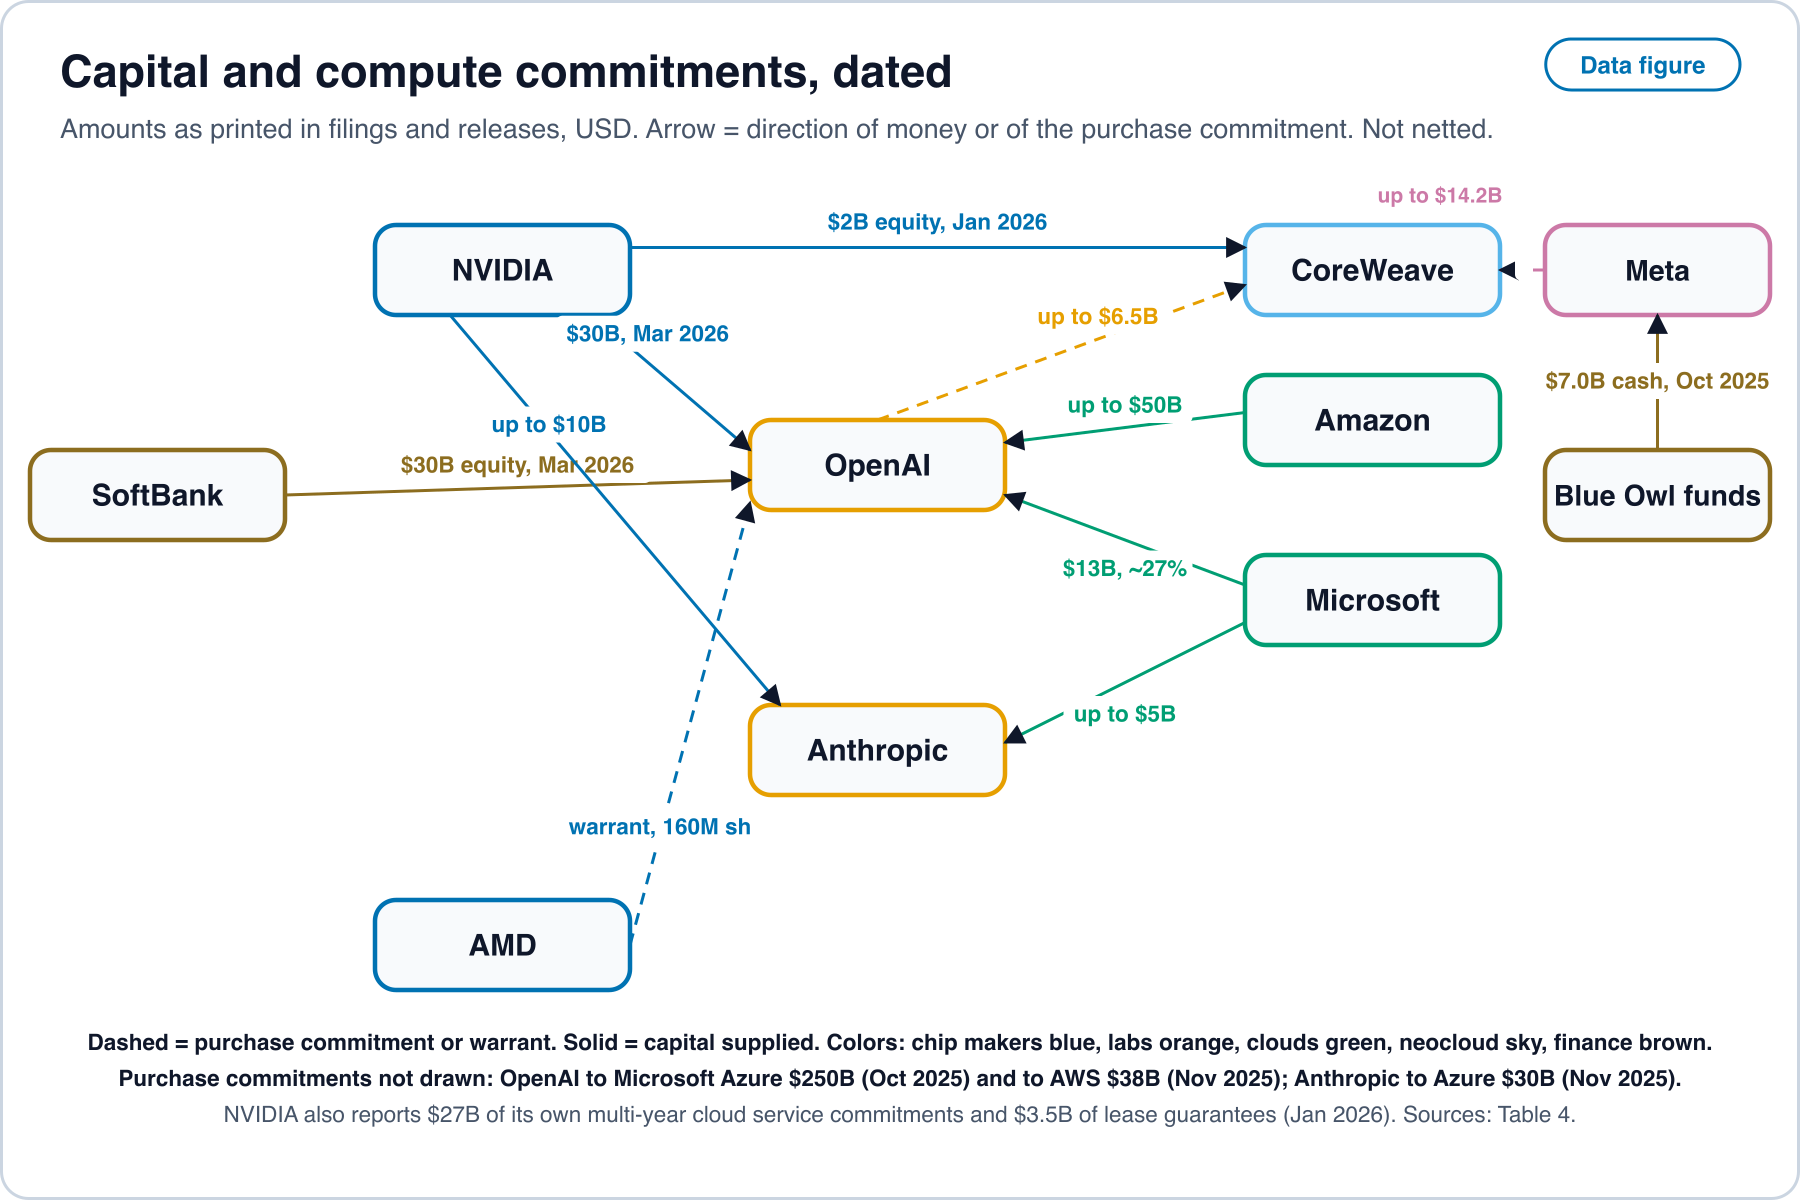
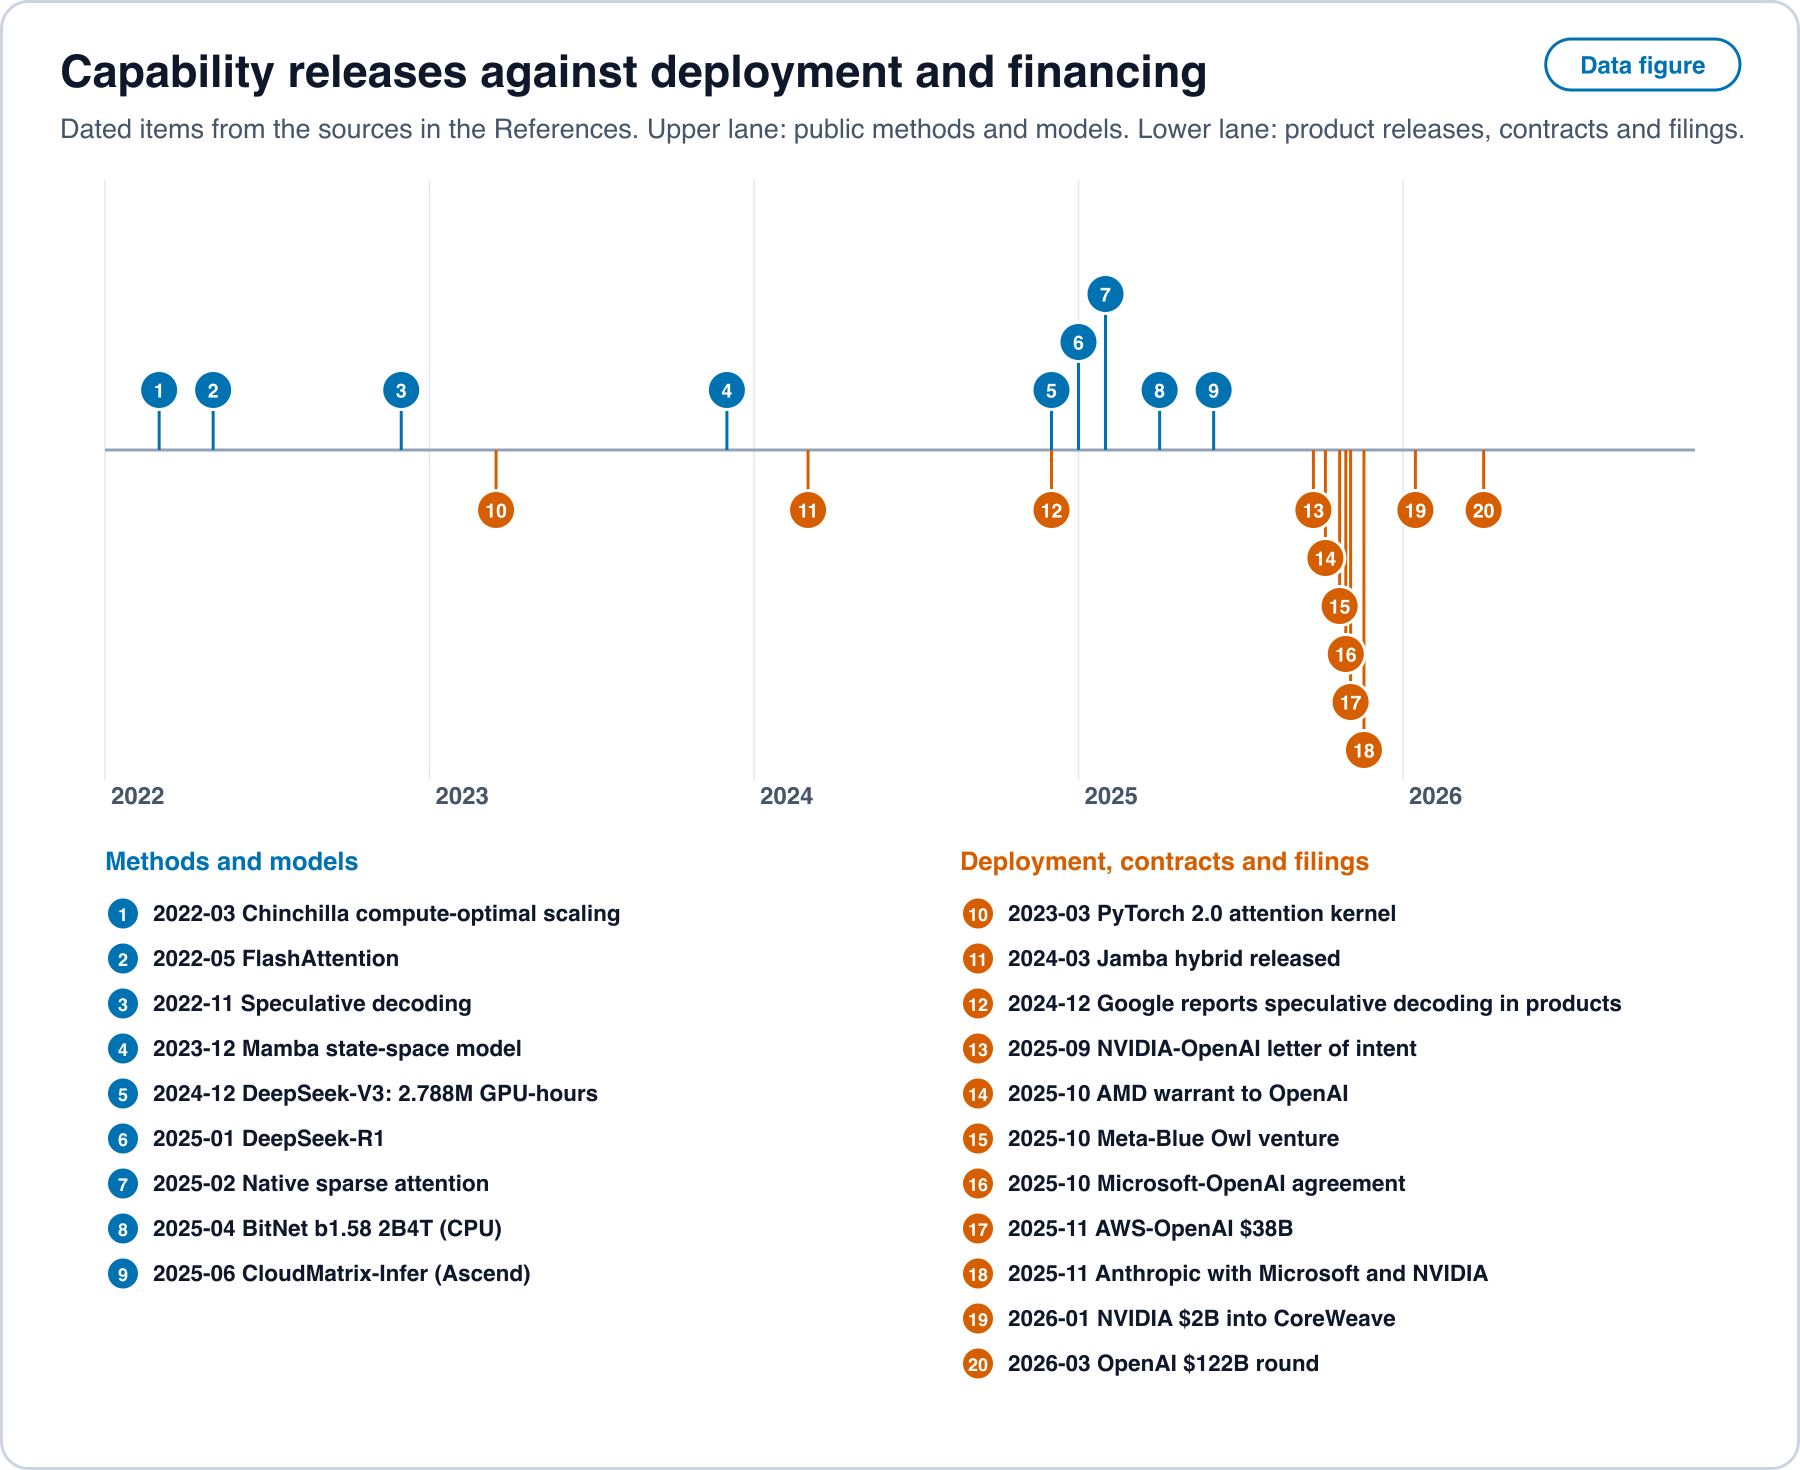
scripts/figures/latency_figures.py con latency_data/flows.csv; las fuentes se enumeran en la Tabla 4. Open full sizeCapital aportado a los clientes. En la ronda de 122.000 millones de dólares que OpenAI cerró en marzo de 2026, se reporta a NVIDIA con 30.000 millones de dólares, a Amazon con hasta 50.000 millones y a SoftBank con 30.000 millones [9]. Una carta de intención anterior había dicho que NVIDIA tenía la intención de invertir hasta 100.000 millones de dólares de forma progresiva a medida que se despliega cada gigavatio, lo cual es una declaración de intención y no una transacción cerrada [87]. Microsoft reporta alrededor del 27% de la public benefit corporation de OpenAI y 13.000 millones de dólares de compromisos totales de financiamiento contabilizados por el método de participación [7]. Para Anthropic, NVIDIA y Microsoft se comprometieron a invertir hasta 10.000 y 5.000 millones de dólares [10]. NVIDIA compró 2.000 millones de dólares en acciones de Clase A de CoreWeave después del cierre del ejercicio fiscal 2025 de esa empresa [4]. AMD emitió a OpenAI un warrant por hasta 160 millones de acciones a 0,01 dólares por acción, que se consolida por tramos vinculados a las compras de productos GPU AMD Instinct [88].
Compras comprometidas por los clientes. OpenAI contrató la compra de 250.000 millones de dólares adicionales en servicios de Azure [7, 89], un acuerdo de 38.000 millones de dólares con AWS que el anuncio describe como creciente a lo largo de siete años [8], y hasta 6.500 millones de dólares de CoreWeave, mientras que Meta tiene con CoreWeave un formulario de pedido de hasta 14.200 millones [4]. Anthropic se comprometió a comprar 30.000 millones de dólares de cómputo de Azure y a contratar hasta un gigavatio más [10]. La propia NVIDIA reporta 27.000 millones de dólares de compromisos plurianuales de servicios en la nube y 3.500 millones de dólares en garantías de terrenos, energía y edificios a socios en etapa temprana [3].
Tabla 4. Lo que está documentado, lo que se infiere y lo que las fuentes no dicen.
| Elemento | Documentado | Inferido, con el supuesto | No encontrado en las fuentes leídas |
|---|---|---|---|
| Capital de proveedores en clientes | Los importes y las fechas de arriba [9, 10, 4] | No se infiere nada | Si algún capital está condicionado a compras, salvo el warrant de AMD, cuya consolidación está vinculada a compras de GPU en el registro [88] |
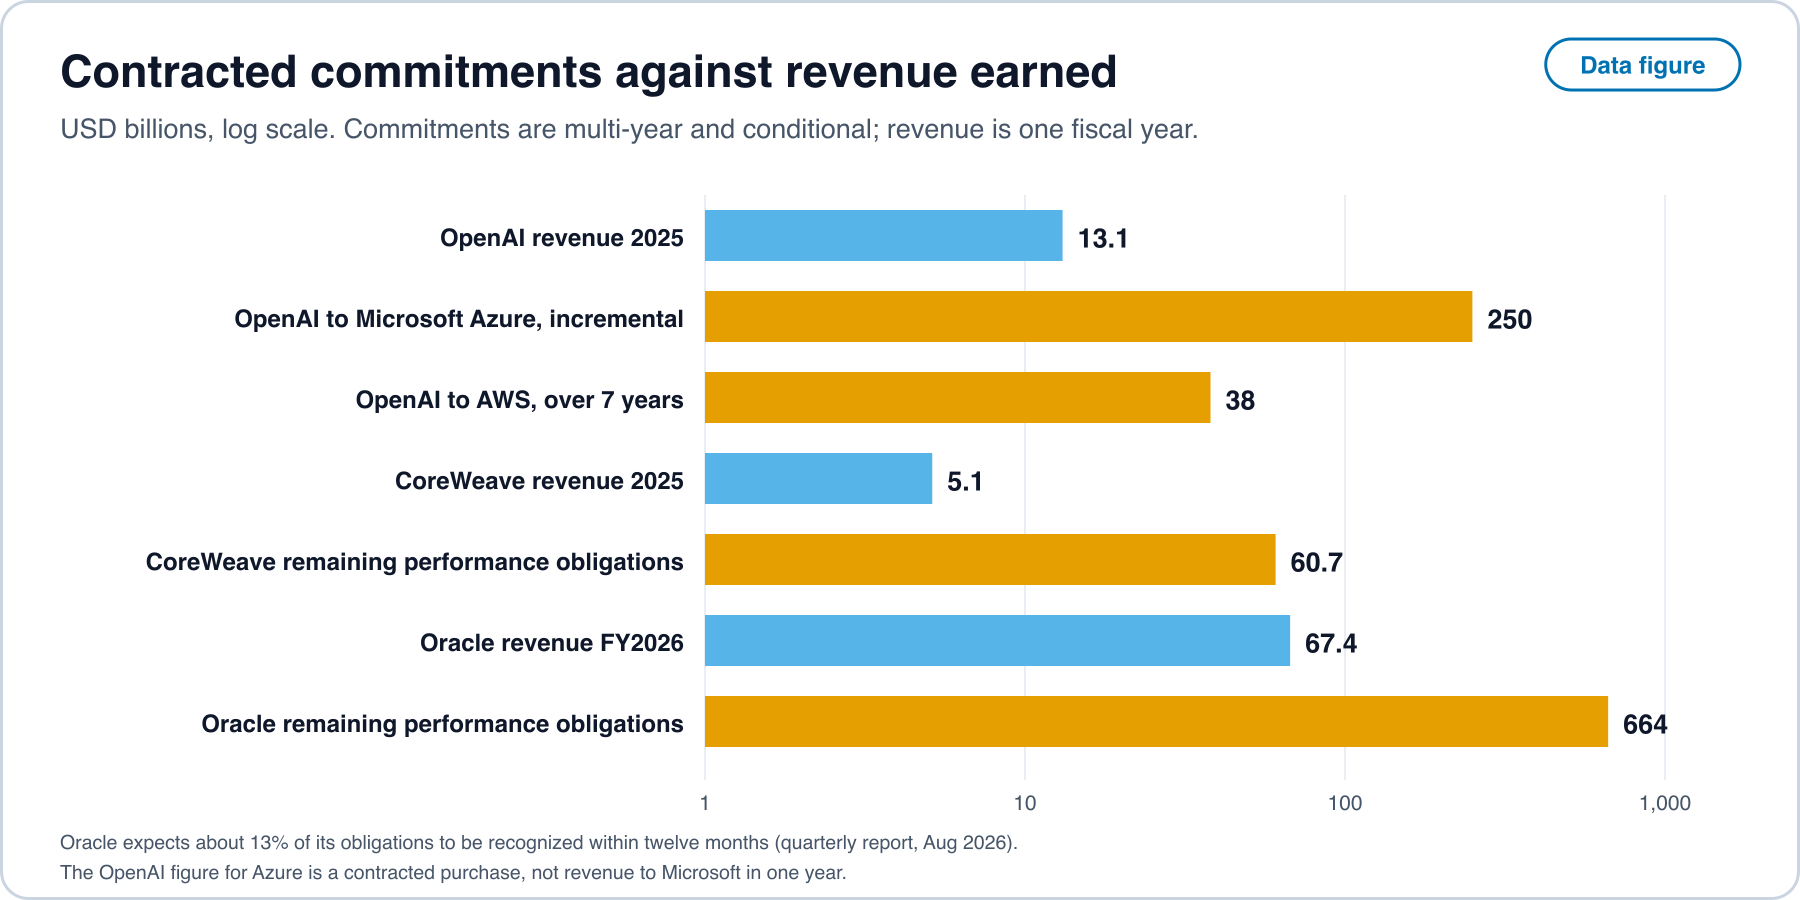
| Compras de laboratorios a nubes | Azure 250.000 y AWS 38.000 millones de dólares para OpenAI; Azure 30.000 millones para Anthropic [7, 8, 10] | la cifra de AWS promedia unos 5.400 millones de dólares al año si se reparte por igual en siete años | El plazo y la rampa del compromiso con Azure; las condiciones de la cifra de 50.000 millones de dólares de Amazon |
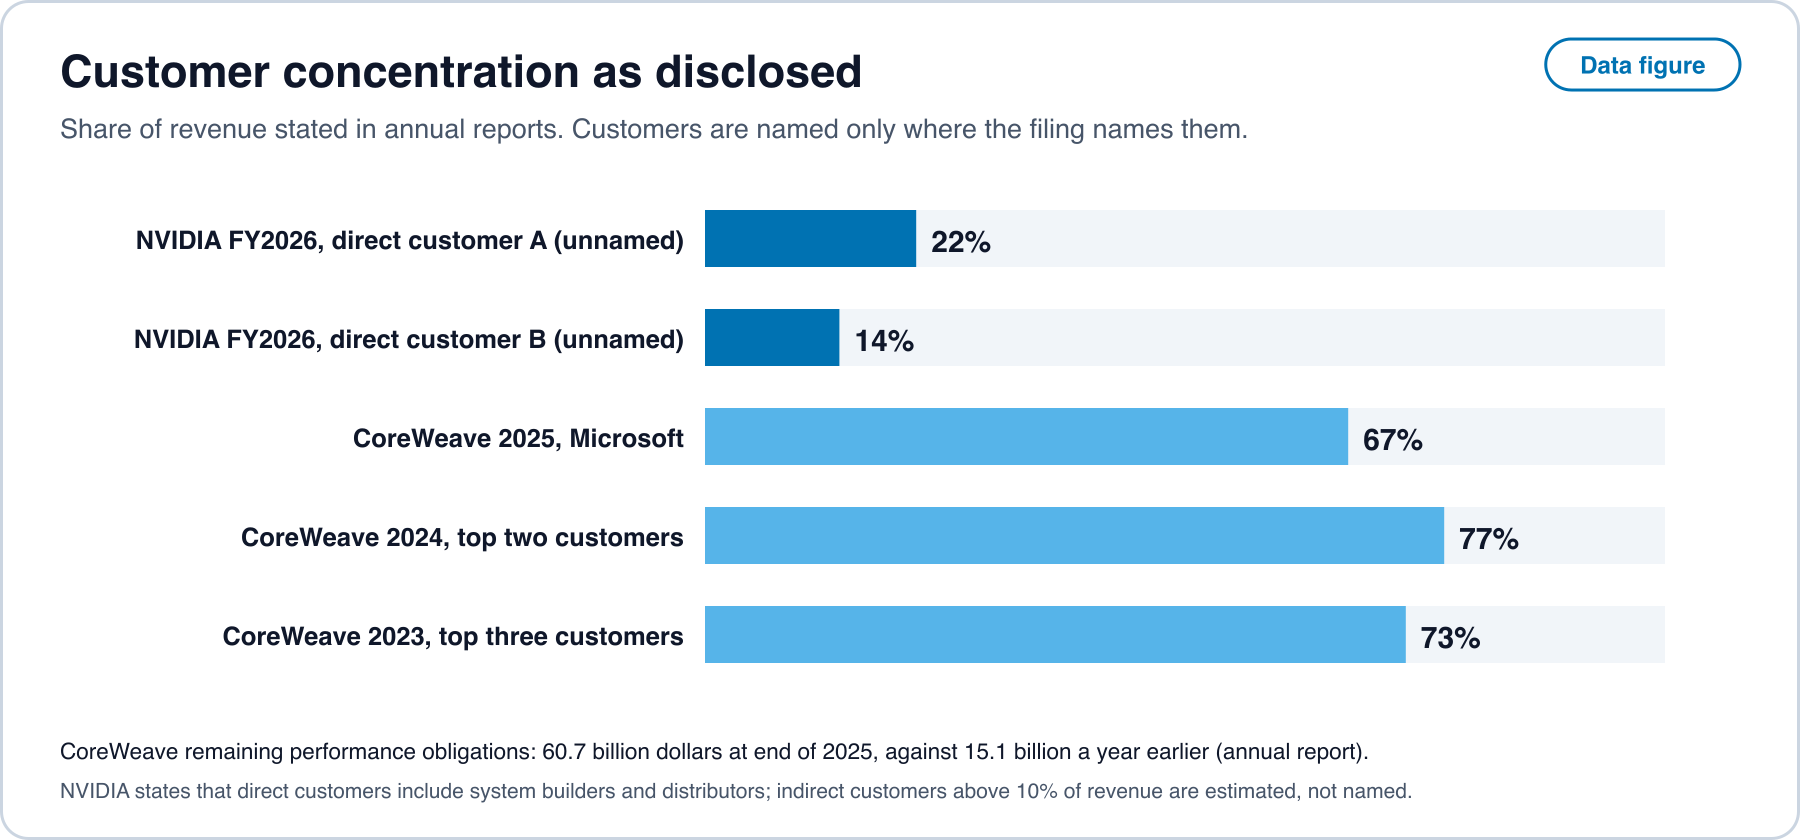
| Concentración de clientes | Clientes directos de NVIDIA con el 22% y el 14% de los ingresos, con integradores de sistemas y distribuidores entre los clientes directos [3]; CoreWeave con Microsoft en el 67% de los ingresos de 2025 [4] | Una cota inferior del índice de Herfindahl a partir de las proporciones divulgadas: al menos 0,068 para NVIDIA y 0,449 para CoreWeave | Quién está detrás de los clientes directos de NVIDIA |
| Prepagos de clientes | Los ingresos diferidos de Oracle por prepagos de clientes con un componente de financiamiento significativo subieron 11.400 millones de dólares en el trimestre, dentro de un flujo de caja operativo de 23.100 millones [5] | Alrededor de la mitad del flujo de caja operativo de ese trimestre provino de prepagos | Qué clientes pagaron por adelantado |
| Financiamiento a nivel de empresa conjunta | Los fondos de Blue Owl tienen el 80% y Meta el 20% de una empresa conjunta para el campus Hyperion; los fondos aportaron 7.000 millones de dólares en efectivo frente a unos 27.000 millones de dólares de costo de desarrollo [2, 1] | El efectivo es alrededor de una cuarta parte del costo de desarrollo | Condiciones del arrendamiento, deuda levantada por la empresa conjunta y garantías |
| Vidas de depreciación | Vidas declaradas para servidores en la Figura 12 [4, 14, 15, 16, 17] | Pasar una vida de 5 a 6 años reduce en un sexto el cargo anual lineal sobre los mismos activos | La vida de servicio que alcanzan las GPU en uso |
| Capital en efectivo frente a efectivo operativo | La serie anual de la Figura 8 [11] | La razón entre ambos | Arrendamientos financieros y arrendamientos fuera de balance |
El término cliente en esta tabla sigue el uso de cada registro. El dinero es fungible, así que un registro puede mostrar que el capital fue a un cliente y que el cliente pagó al proveedor, y no puede mostrar que lo uno financió lo otro. La Sección 10 enuncia una prueba que funciona dentro de ese límite.
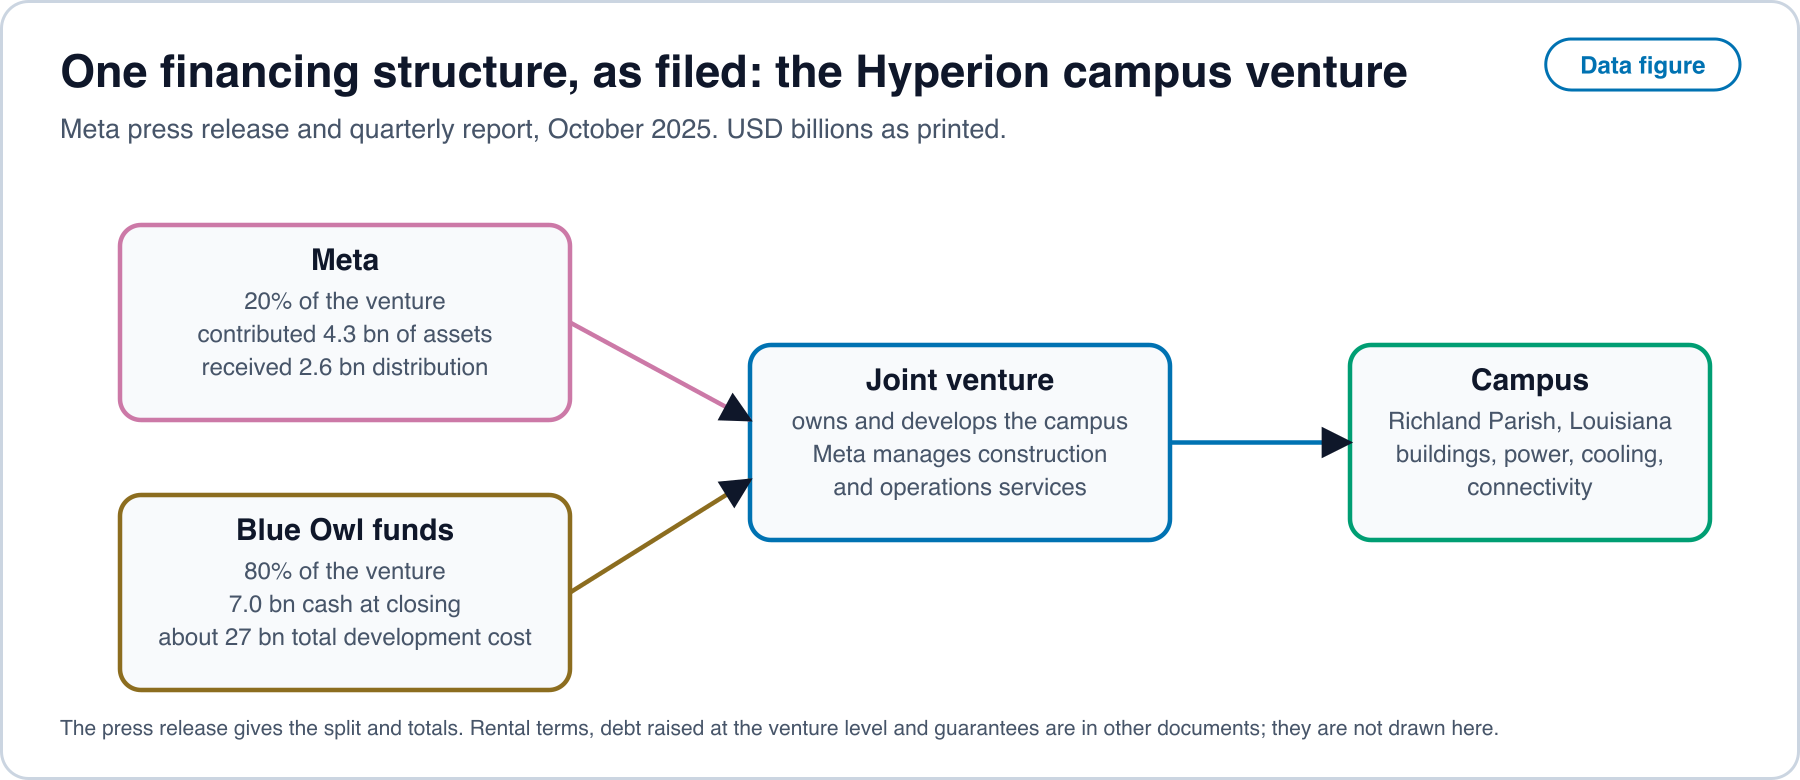
Concentración y cartera de pedidos. Las proporciones de clientes divulgadas son altas en los nodos apalancados y menores en el mayor fabricante de chips. CoreWeave reporta a sus tres principales clientes con el 73% de los ingresos de 2023, a sus dos principales con el 77% en 2024 y solo a Microsoft con el 67% en 2025 [4]. Sus obligaciones de desempeño pendientes de 60.700 millones de dólares son 11,8 veces sus ingresos de 2025 de 5.131 millones. Oracle reporta obligaciones de 664.000 millones de dólares al 31 de agosto de 2026 y espera que alrededor del 13% de ellas se reconozca en los próximos doce meses [5, 6], frente a unos ingresos del ejercicio fiscal 2026 de 67.400 millones [11]. OpenAI reportó ingresos de 13.100 millones de dólares en 2025 y declaró un ritmo de 2.000 millones de dólares al mes en marzo de 2026 [9]. Las compras contratadas son plurianuales y están condicionadas a términos que estas cifras no muestran, así que no son ingresos de un año y no se suman a las cifras anteriores.
Los laboratorios también compran en otros lugares. Anthropic anunció un plan para usar hasta un millón de TPU, por valor de decenas de miles de millones de dólares y bastante más de un gigavatio de capacidad en 2026 [90]. OpenAI anunció un plan para desplegar 10 gigavatios de aceleradores de diseño propio [91] y posee el warrant de AMD mencionado arriba. Un laboratorio que compra a varios proveedores y diseña sus propias piezas no es un cliente único de ninguno de ellos, lo que importa para la cota de la sección siguiente.
10. Una prueba de circuito cerrado y sus predicciones
La pregunta que los documentos no pueden responder por sí solos es qué parte de los ingresos de un proveedor se paga con dinero que el propio proveedor aportó. La prueba siguiente la convierte en cantidades que un registro puede acotar.
Para una ventana (un ejercicio fiscal), sea el capital aportado por el proveedor al cliente (capital, préstamos, garantías, warrants valorados en la emisión), sea el ingreso que recibe de , sea el ingreso total de , y sea el capital que levanta de todas las fuentes.
Definición 3 (razón de ida y vuelta). , el capital aportado por dólar de ingreso recibido de la misma contraparte.
Definición 4 (cota de la proporción de circuito cerrado). . Un cliente no puede haber pagado a con más capital propio de del que aportó, ni del que pagó, así que es una cota superior de la proporción de que podría haberse financiado con el propio capital de . La contraparte del lado del cliente es , la proporción del capital levantado por que provino de sus propios proveedores. Ambas son cotas calculadas a partir de cifras divulgadas. No son estimaciones de lo que ocurrió, porque el dinero es fungible.
Proposición 7 (cuándo compensa una compra financiada por el proveedor). Sea un proveedor que vende a precio con costo unitario y margen bruto . Supóngase que aporta un capital que induce una proporción de las ventas que de otro modo no ocurrirían, y que recupera un valor de su participación. El beneficio incremental es . Si todo se gasta con , de modo que , entonces si y solo si , donde .
Derivación. Se sustituye y se resuelve . (A mano, no comprobado por máquina.)
Consecuencia. Como , el financiamiento del proveedor compensa a través de las ventas inducidas por sí solas únicamente cuando . Con el margen bruto del 71,1% reportado por NVIDIA para el ejercicio fiscal 2026 [3], debe esperarse que la participación recupere al menos el 28,9% del capital. La salida del modelo para la proporción inducida de equilibrio con recuperación de 0, 25%, 50%, 75% y 100% es 1,41, 1,05, 0,70, 0,35 y 0, de modo que sin recuperación ninguna proporción de ventas inducidas basta.
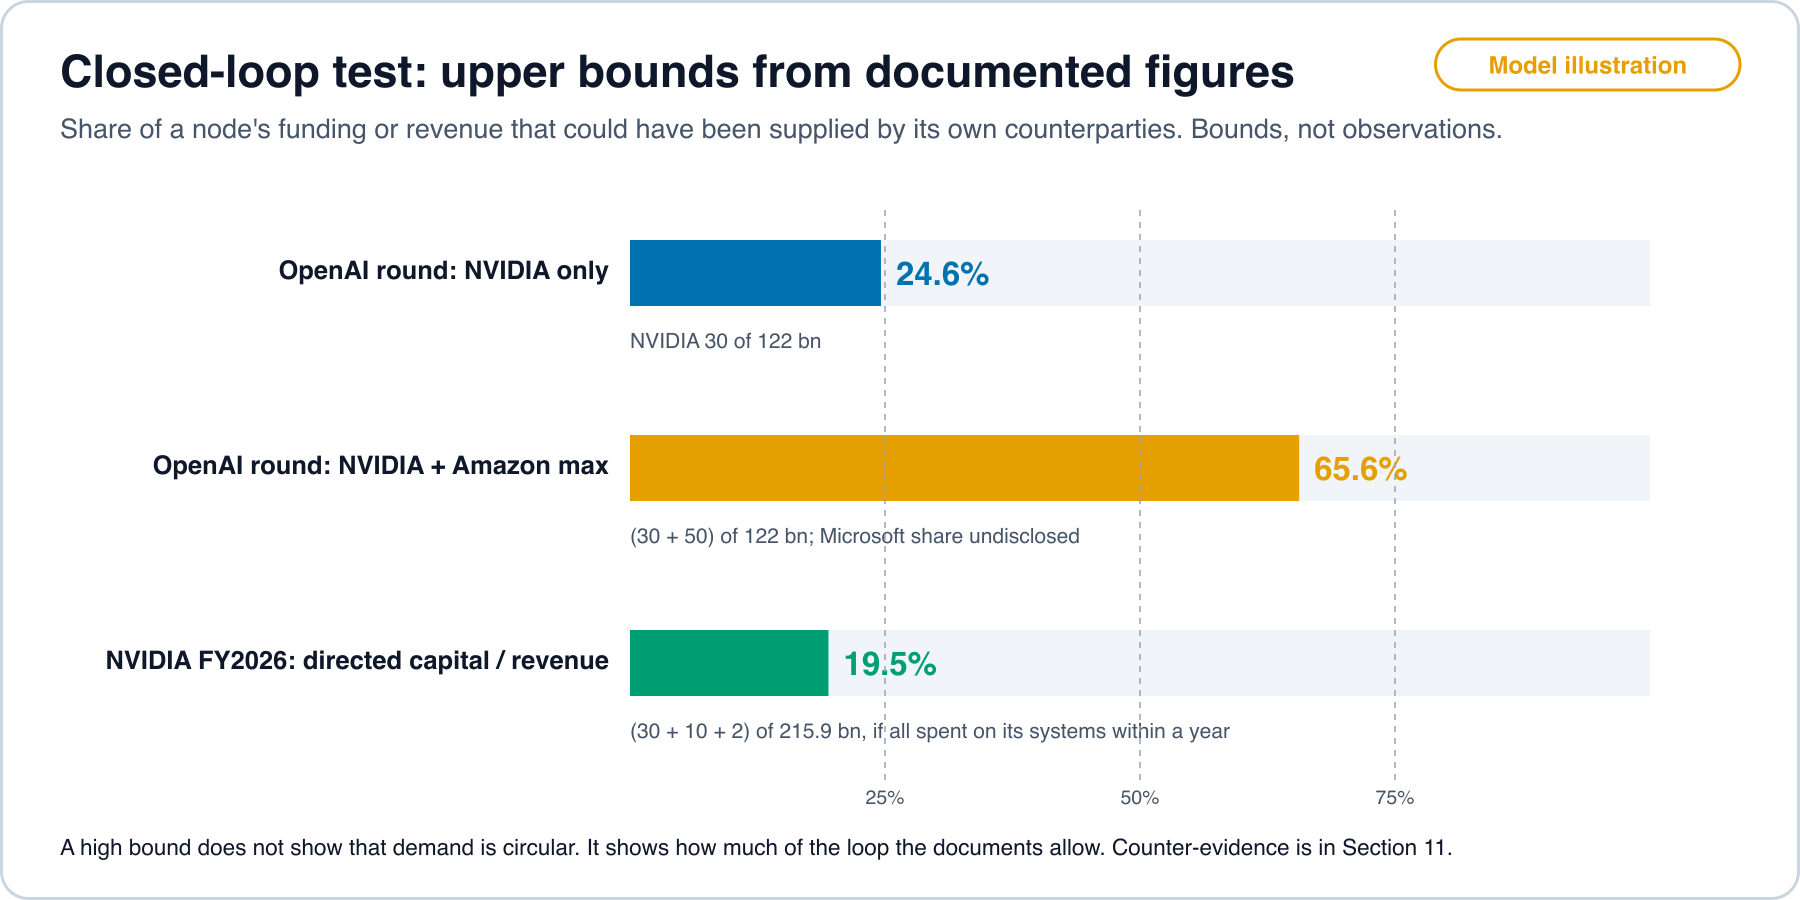
latency_data/model_outputs.json, calculado por model_airace.py a partir de [9, 10, 4, 3]. Open full sizeCotas a partir de los documentos. La proporción de NVIDIA en la ronda de OpenAI es como mucho del 24,6%, y con Amazon en su máximo declarado las dos llegan como mucho al 65,6%, sin que se divulgue la parte de Microsoft (salida del modelo). El capital que NVIDIA anunció aportar, o que se reportó que aportaba, a clientes de noviembre de 2025 a marzo de 2026 es de 42.000 millones de dólares (30.000 para OpenAI, hasta 10.000 para Anthropic y 2.000 para CoreWeave), lo que equivale al 19,5% de sus ingresos del ejercicio fiscal 2026 de 215.900 millones y al 41% de su flujo de caja operativo de 102.700 millones [3, 11]. La primera cifra es una comparación de escala, ya que los importes y el año de los ingresos difieren. Leída como cota, significa que si cada uno de esos dólares volviera como ingreso de NVIDIA en un año, como mucho alrededor de una quinta parte de los ingresos de ese año estaría financiada con el propio capital de NVIDIA.
Predicciones. Cada una nombra datos, una prueba y un resultado que contaría en contra de la afirmación. Estas predicciones se escribieron después de leer los registros anteriores, y se ponen a prueba con registros fechados después de este artículo.
Predicción 7 (la proporción del circuito sigue acotada). Para cada proveedor de chips o de nube con capital dirigido divulgado, calculado a partir de cada informe anual se mantiene por debajo de 0,25 mientras los ingresos de los clientes que no recibieron capital dirigido crecen al menos tan rápido como los de los que sí lo recibieron. Prueba: registros anuales, con los clientes nombrados donde los registros los nombran. Se refuta si supera 0,5 en un ejercicio fiscal, o si el crecimiento de los ingresos se concentra en clientes que recibieron capital dirigido. Los valores entre 0,25 y 0,5 no son concluyentes.
Predicción 8 (los ingresos de los usuarios finales crecen más que los compromisos). Para un laboratorio, la razón entre las compras contratadas y los ingresos de los últimos doce meses baja durante cuatro trimestres consecutivos mientras los ingresos suben. Prueba: declaraciones de los laboratorios y divulgaciones de la cartera de pedidos de las nubes. Se refuta si la razón sube durante cuatro trimestres consecutivos.
Predicción 9 (la tensión aparece primero donde la concentración y el apalancamiento son mayores). Cuando un laboratorio revisa a la baja un compromiso de cómputo, el tamaño de las revisiones de las previsiones en los nodos proveedores se ordena según su proporción divulgada del cliente principal. Prueba: revisiones de las previsiones después de cualquier evento de ese tipo, ordenadas por la proporción divulgada del cliente principal. Se refuta si el orden no guarda relación con la concentración.
Predicción 10 (la sustitución reduce la capacidad comprometida por dólar de ingresos). Donde los métodos abiertos y el hardware más barato reducen el tiempo de acelerador por tarea (Sección 12), los gigavatios comprometidos por dólar de ingresos de los laboratorios bajan. Prueba: capacidad anunciada e ingresos de los laboratorios por trimestre. Se refuta si los gigavatios comprometidos por dólar de ingresos suben durante cuatro trimestres consecutivos mientras el tiempo de acelerador por tarea medido también baja en pruebas de referencia abiertas.
11. La contraevidencia más fuerte
La lectura de que la expansión es sobre todo un circuito cerrado se encuentra con cuatro conjuntos de documentos que apuntan en sentido contrario, y con uno que apunta hacia la fragilidad.
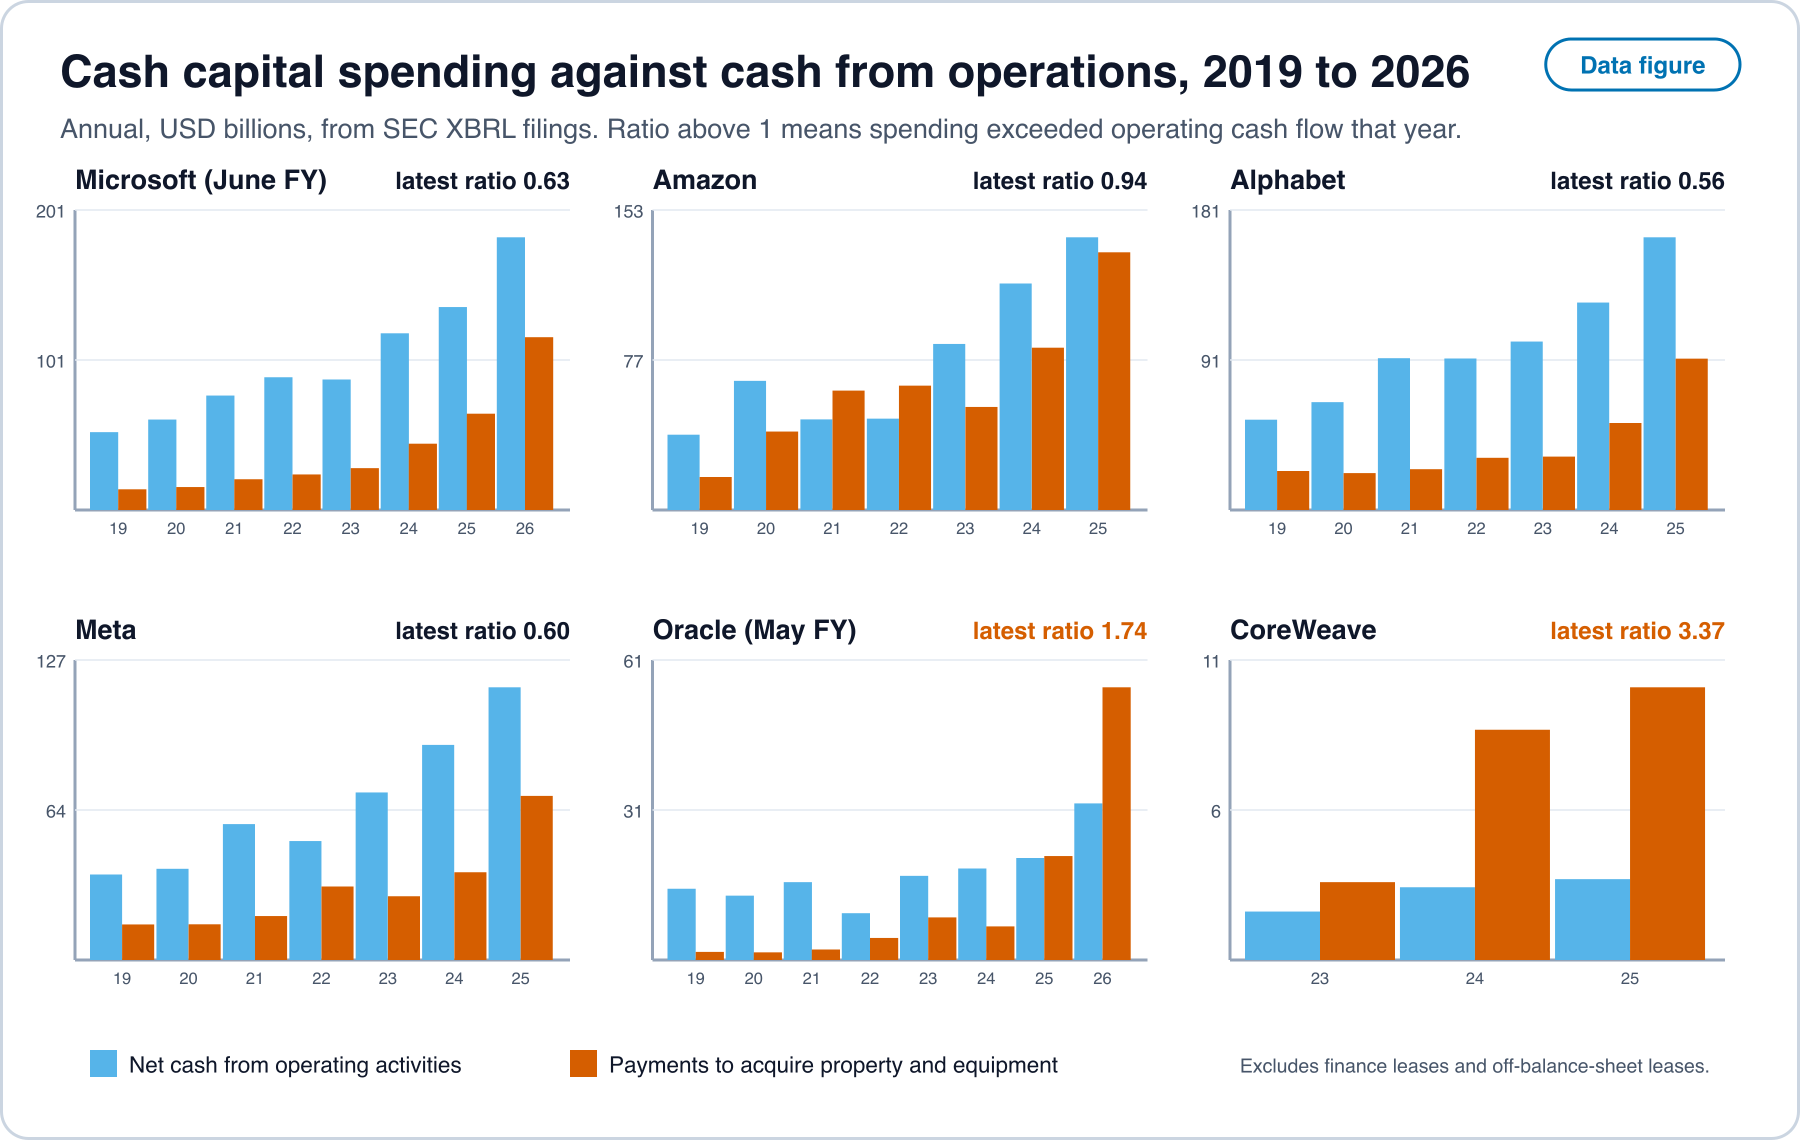
La mayor parte del gasto se financia con las operaciones de los mayores compradores. En sus últimos ejercicios fiscales, el gasto de capital en efectivo fue 0,63 del flujo de caja operativo en Microsoft, 0,94 en Amazon, 0,56 en Alphabet y 0,60 en Meta [11]. El gasto es grande, y se paga con el efectivo que las mismas empresas obtienen de otros negocios.
latency_data/capex_ocf.csv [11]. Open full sizeEl mayor proveedor de chips podría financiar su capital dirigido con su propio efectivo. Los 42.000 millones de dólares mencionados arriba son el 41% del flujo de caja operativo de un año de NVIDIA [3, 11], y sus dos mayores clientes directos son el 22% y el 14% de los ingresos, con integradores de sistemas y distribuidores entre ellos [3].
Los ingresos de los usuarios finales son reales y crecen en los estados financieros leídos. OpenAI reportó 13.100 millones de dólares de ingresos en 2025 y un ritmo de 2.000 millones de dólares al mes en marzo de 2026, que anualizado da 24.000 millones (aritmética) [9].
Los laboratorios diversifican. El plan de Anthropic de hasta un millón de TPU junto a sus compromisos con Azure y NVIDIA, y los planes de OpenAI para sus propios aceleradores y el warrant de AMD, significan que los laboratorios nombrados aquí tienen más de una fuente de chips en sus planes anunciados [90, 10, 91, 88].
Lo que la contraevidencia no elimina. El gasto de capital en efectivo fue 1,74 veces el flujo de caja operativo en Oracle en el ejercicio fiscal 2026 y 3,37 veces en CoreWeave en 2025 [11]. El trimestre de Oracle cerrado el 31 de agosto de 2026 muestra un flujo de caja operativo de 23.100 millones de dólares, de los cuales 11.400 millones provienen de prepagos de clientes, y un flujo de caja libre negativo de 5.000 millones [5, 6]. Las obligaciones de CoreWeave son 11,8 veces sus ingresos, y su base de clientes está concentrada [4]. Estos son los nodos a los que llegaría primero un déficit en el financiamiento de un laboratorio, que es lo que pone a prueba la Predicción 9.
Lectura neta, hasta donde llegan los documentos. Se documentan circuitos de decenas de miles de millones de dólares entre proveedores y clientes nombrados. Los documentos acotan por debajo de una quinta parte la proporción de los ingresos del mayor proveedor de chips que su propio capital podría haber financiado, y muestran que la mayor parte del gasto de los hiperescaladores se paga con efectivo operativo. Los nodos concentrados y apalancados, una nube con prepagos y una neonube con un único cliente dominante, son donde el supuesto del circuito importaría más. Las condiciones de los acuerdos privados no son públicas, así que los documentos dan cotas y no una medición.
12. Lo que cuesta una tarea: el modelo de costos de la infraestructura
La Sección 0 define el costo por tarea como . Esta sección completa y a partir del costo de una hora de acelerador y vincula el resultado con , y .
Hora de acelerador. Sea el capital por acelerador, incluida la parte de instalación, energía y refrigeración, con una vida lineal de años y una utilización . El capital por hora utilizada es . Sea la potencia de la instalación por acelerador en kilovatios y el precio de la electricidad por kilovatio hora. Una tarea que ocupa horas utilizadas cuesta
Proposición 8 (el precio del julio con carga de capital). Con el hardware fijo, con por kilovatio hora equivalente, de modo que los julios por tarea siguen siendo la unidad de cuenta correcta, y el precio que convierte julios en dólares está dominado por siempre que . Derivación. Se elimina entre las dos expresiones. (A mano.)
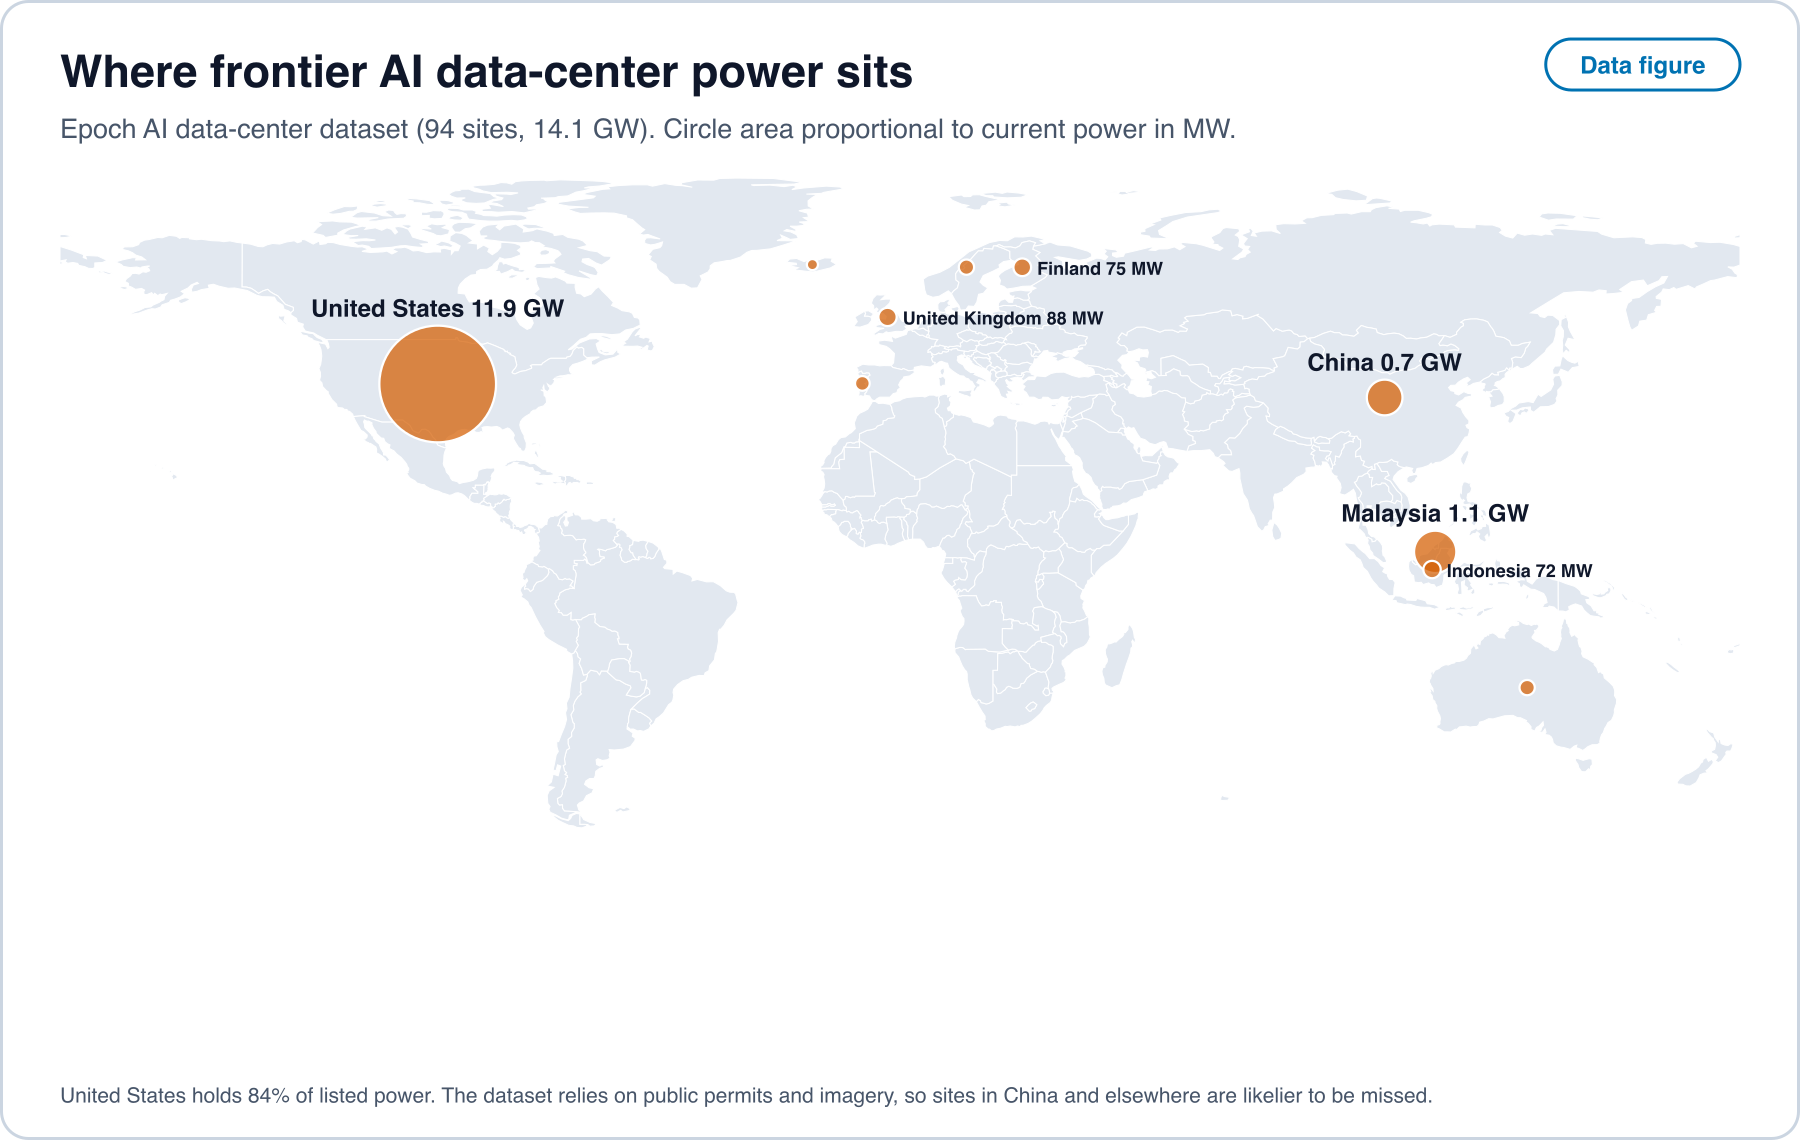
Insumos. El conjunto de datos de centros de datos de Epoch AI da, para 74 sitios con ambas cifras, un capital mediano de unos 33.300 dólares y 880 vatios de potencia de instalación por equivalente de H100, con un capital por equivalente de H100 que va de unos 19.600 a unos 200.800 dólares [12]. Son estimaciones construidas a partir de permisos públicos e imágenes, y el capital listado de un sitio incluye el cómputo, la construcción y el acondicionamiento.
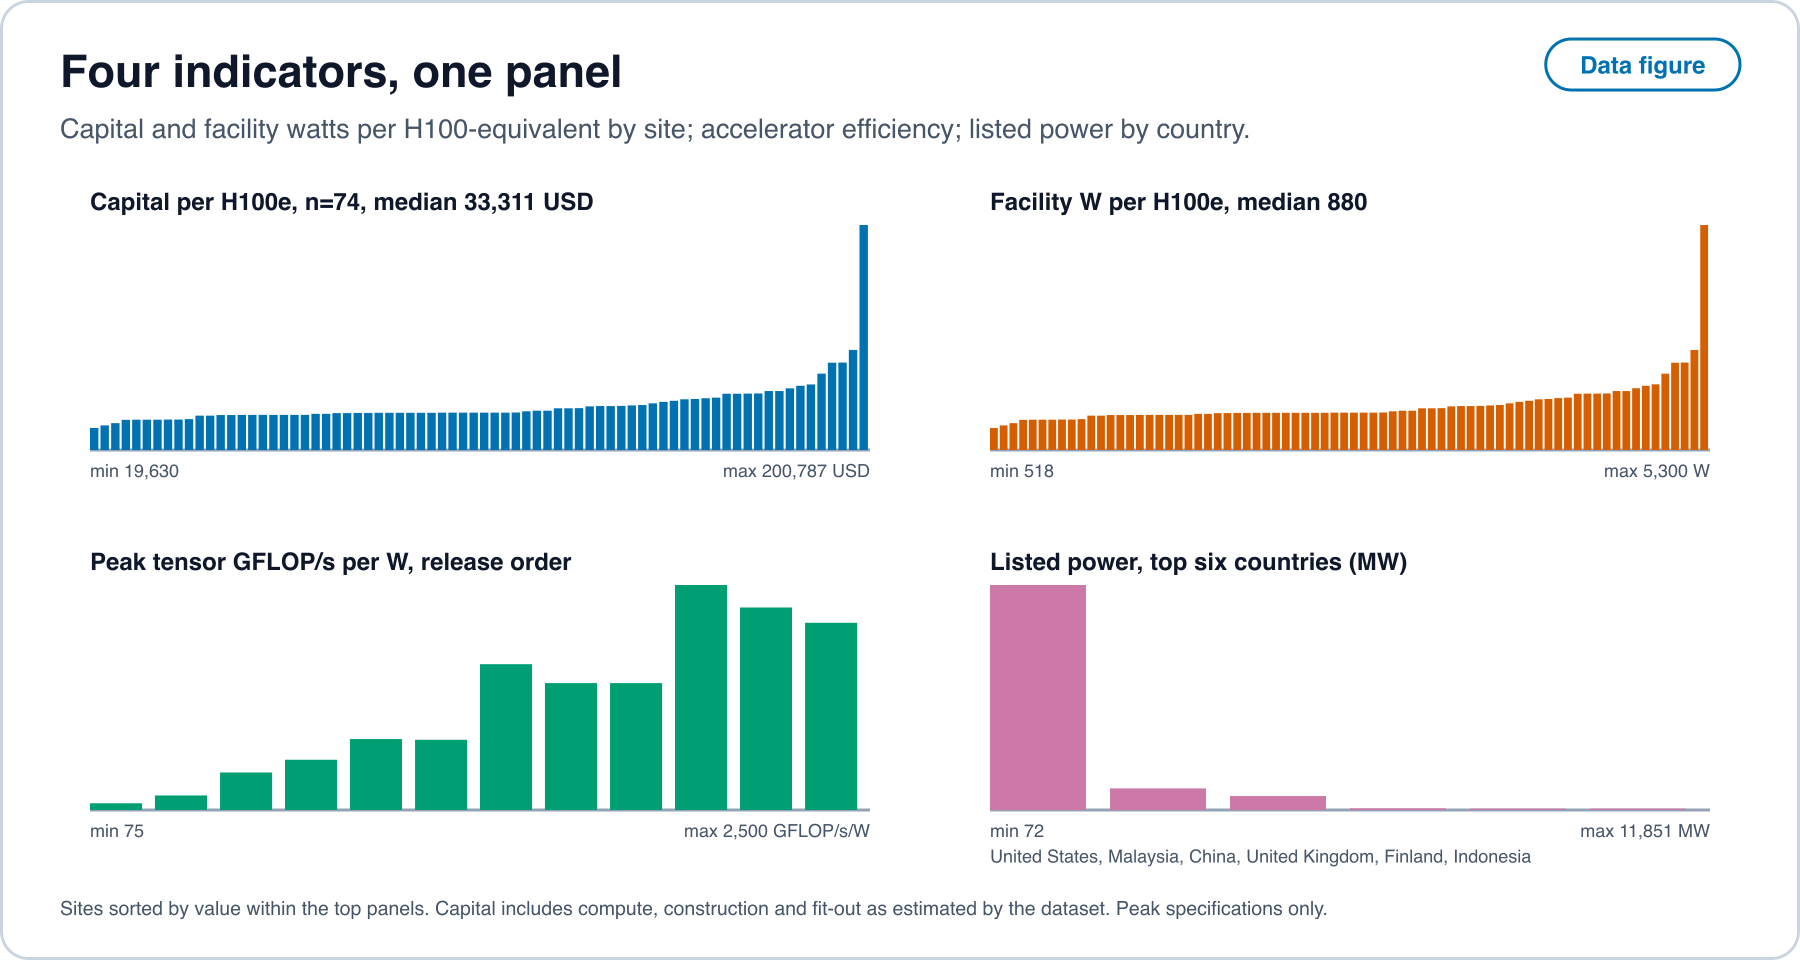
latency_data/frontier_dc_cost_per_h100e.csv, hardware_flops_per_watt.csv, frontier_dc_by_country.csv [12, 13]. Open full sizeSalida del modelo. Con vidas de 4 a 6 años, utilización del 40% al 80% y electricidad de 0,04 a 0,12 dólares por kilovatio hora, una hora de acelerador utilizada cuesta entre unos 0,83 y 2,5 dólares, y la energía es entre el 1,5% y el 11,8% de ese costo. El precio con carga de capital es de unos 0,9 a 2,7 dólares por kilovatio hora equivalente, frente a una electricidad de 0,04 a 0,12, de modo que está dominado por el capital, con aproximadamente 8 a 70 veces el término de electricidad.
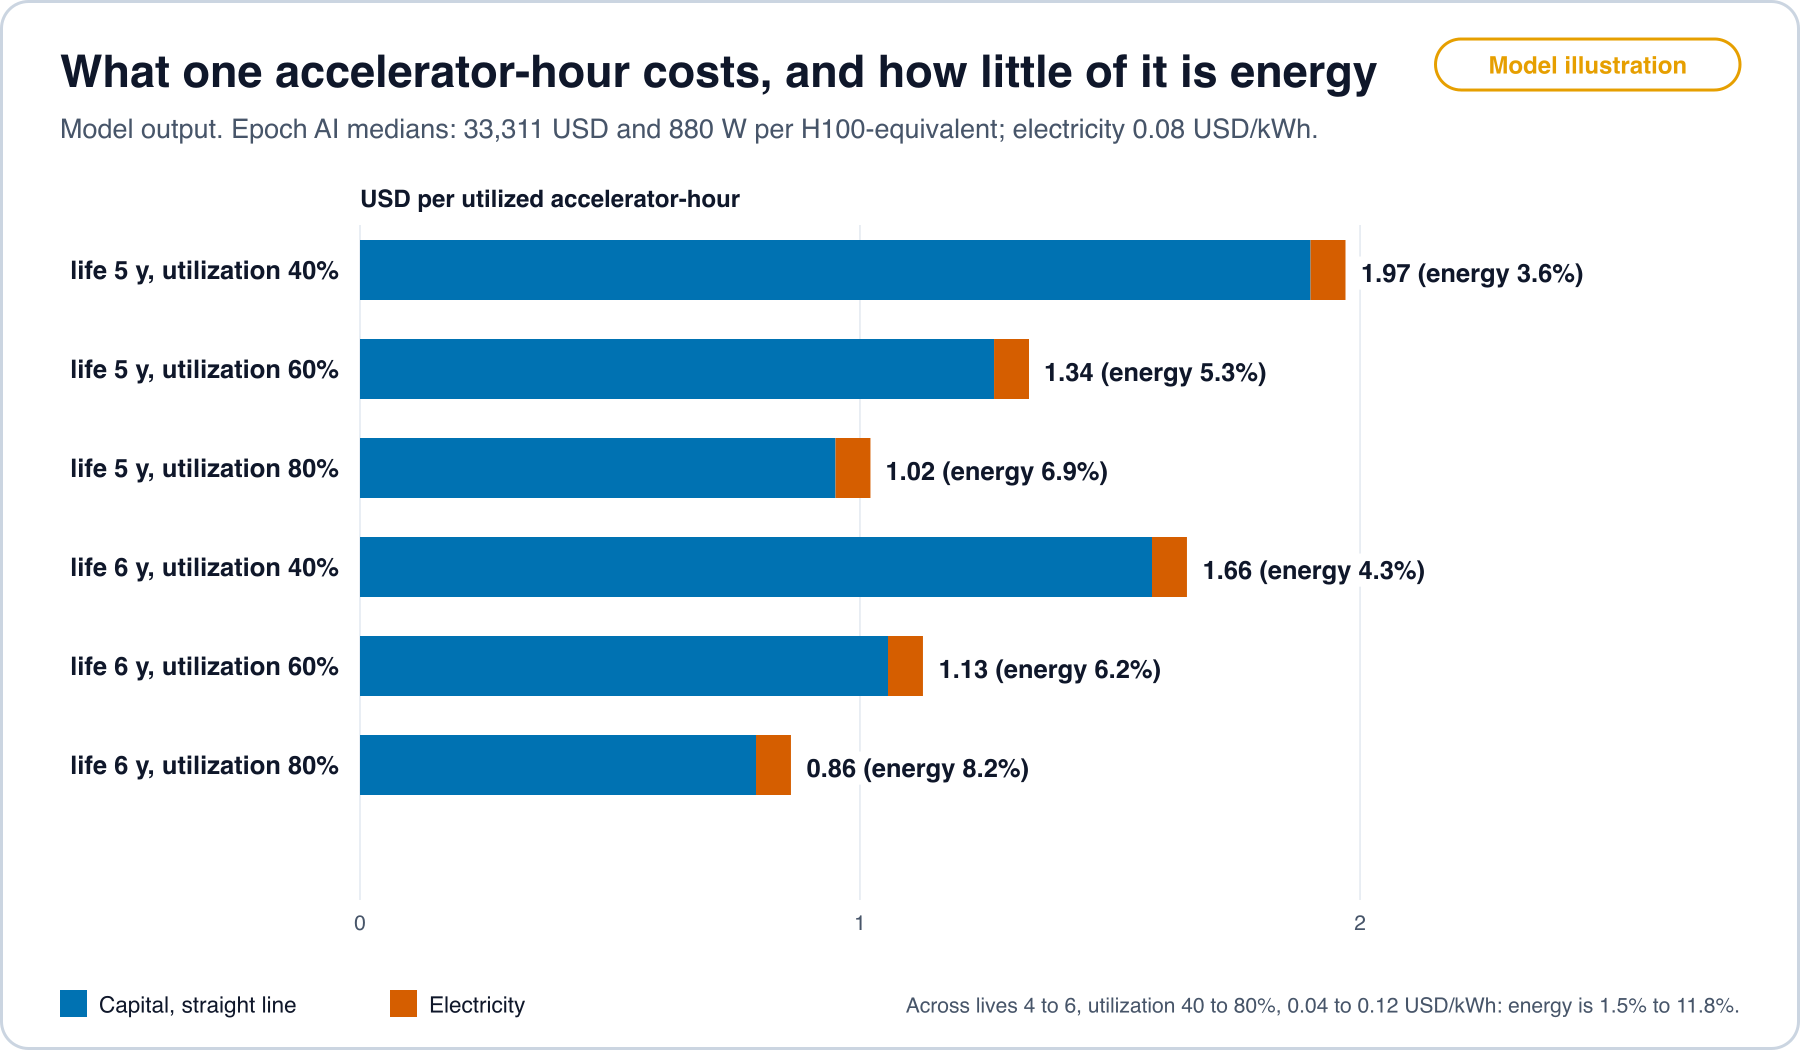
latency_data/model_outputs.json, calculado por model_airace.py a partir de [12]. Open full sizeSe siguen tres consecuencias. Una electricidad más barata puede reducir el costo de una tarea como mucho en la proporción de la energía, que en esta cuadrícula es como mucho alrededor de un octavo. La utilización importa tanto como la energía: reducir a la mitad duplica . Y la vida declarada es una elección contable que mueve en proporción a .
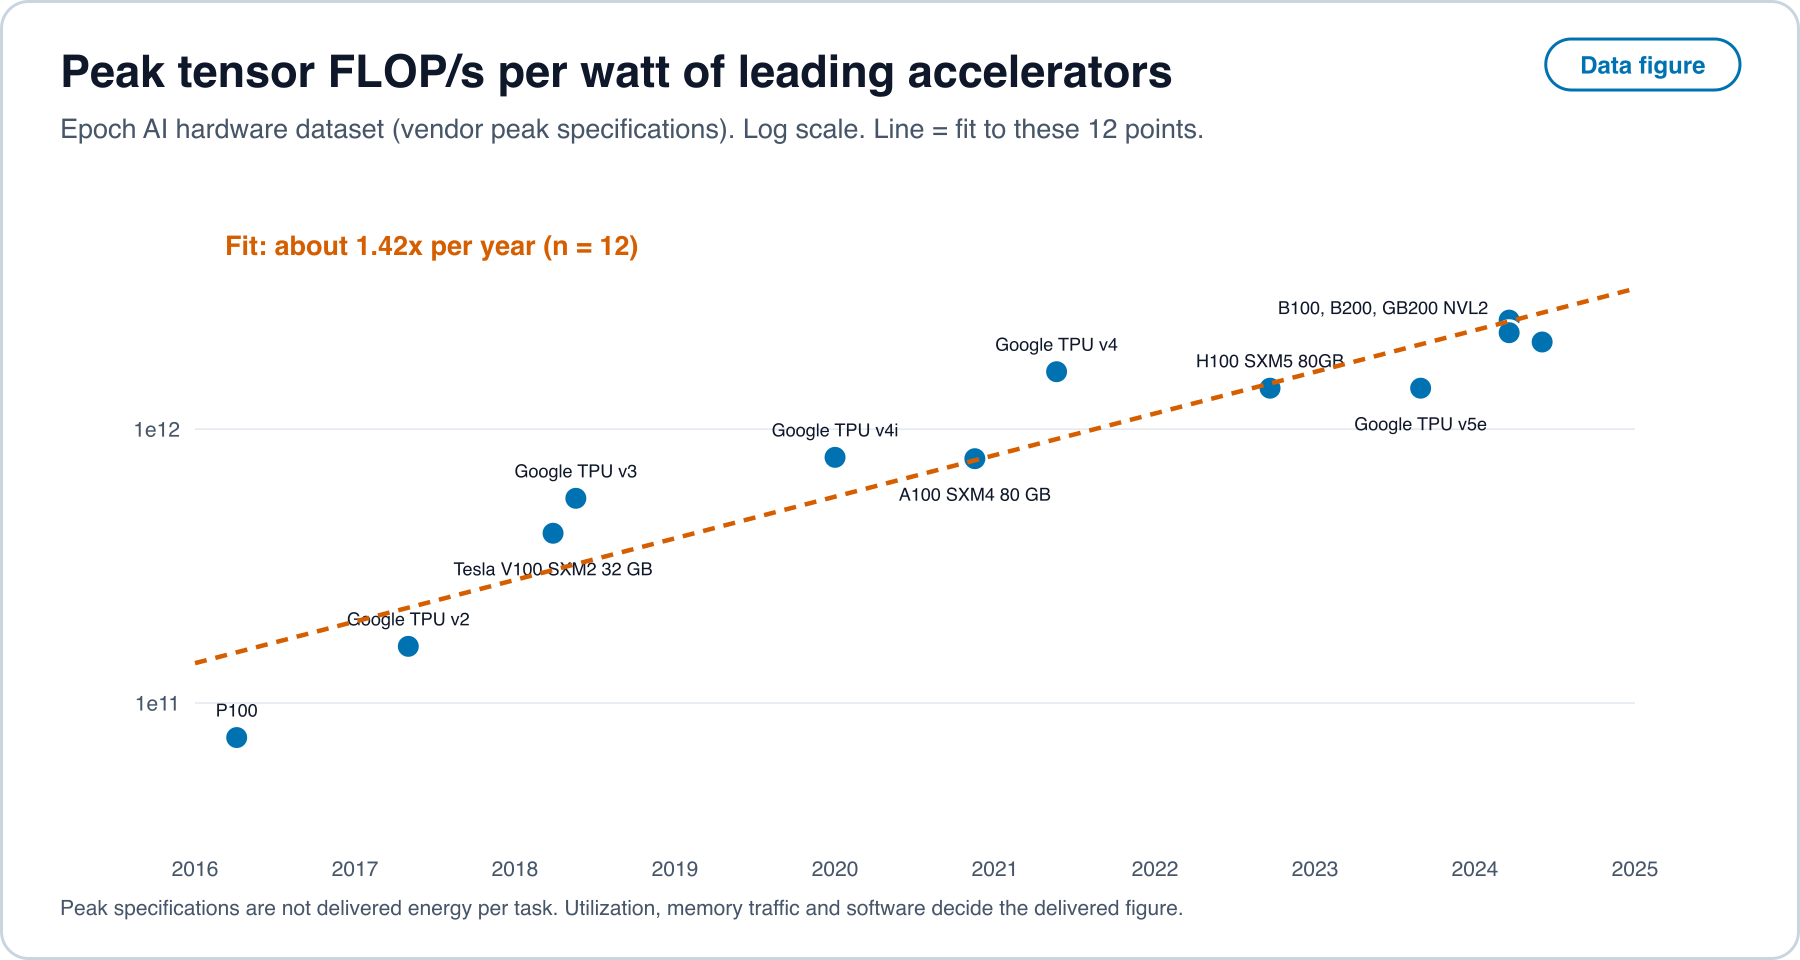
Vidas y eficiencia. Las operaciones tensoriales máximas por vatio subieron alrededor de 1,42 veces al año en doce aceleradores punteros de 2016 a 2024 según las especificaciones de los propios fabricantes, lo que supone una duplicación aproximadamente cada dos años [13]. Un sitio limitado por la potencia que sustituyera una pieza por otra tres años más reciente obtendría unas veces las operaciones máximas con la misma potencia. Las especificaciones máximas no son la energía entregada por tarea, porque la utilización, el tráfico de memoria y el software deciden la cifra entregada. Las vidas de servidores declaradas en la Figura 12 van de 5 a 6 años en varias empresas grandes, y el rango declarado es más amplio en otras. Vidas de esa duración y una duplicación de la eficiencia cada dos años son coherentes cuando las piezas más antiguas siguen generando ingresos a precios fijados por las más nuevas, lo cual es una afirmación sobre precios y no sobre física.
latency_data/hardware_flops_per_watt.csv y hardware_fit.json [13]. Open full size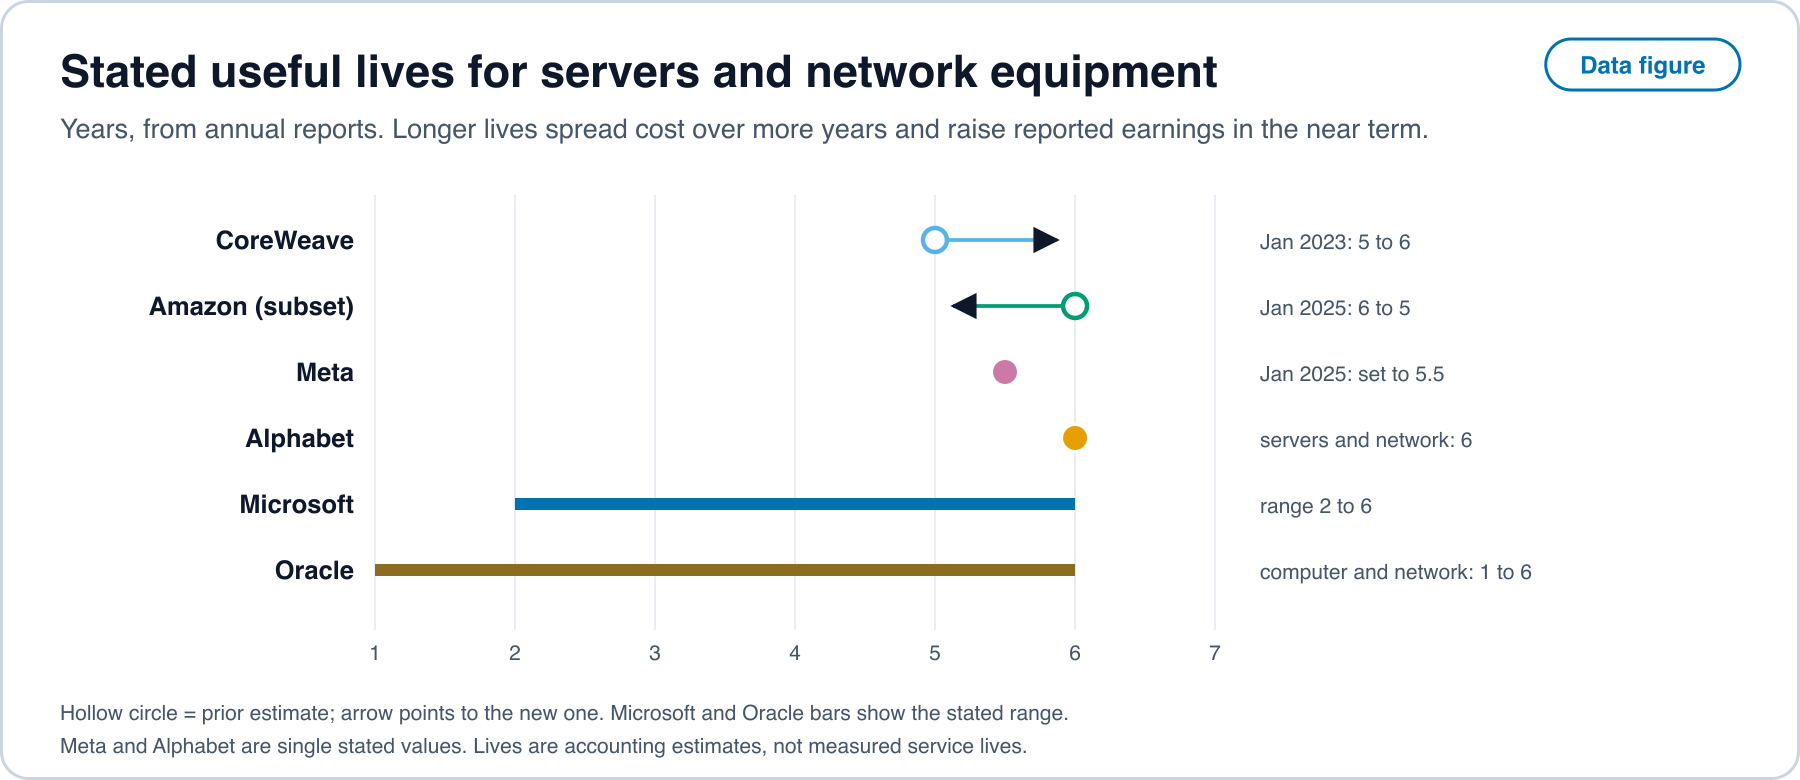
El precio no es el costo. Para un sistema del nivel de GPT-3.5, el precio de la inferencia cayó más de 280 veces entre noviembre de 2022 y octubre de 2024, mientras los costos del hardware caían un 30% al año y la eficiencia energética del hardware mejoraba un 40% al año [18]. En los 1,9 años de esa ventana esas tasas dan unas 2,0 veces para el costo del hardware y 1,9 veces para la eficiencia energética (salida del modelo). Dividir 280 entre 2,0 deja un factor de unos 141 que el costo del hardware no explica. Ese resto mezcla modelos más pequeños, eficiencia algorítmica, utilización y márgenes, y las fuentes no lo reparten. Epoch AI estima por separado que el cómputo necesario para un rendimiento fijo de un modelo de lenguaje se reduce a la mitad aproximadamente cada 8 meses [58], y que el precio para un nivel fijo en una prueba de referencia cayó de 9 a 900 veces al año con una mediana cercana a 50, con las tasas más rápidas apoyadas en menos de un año de datos [59].
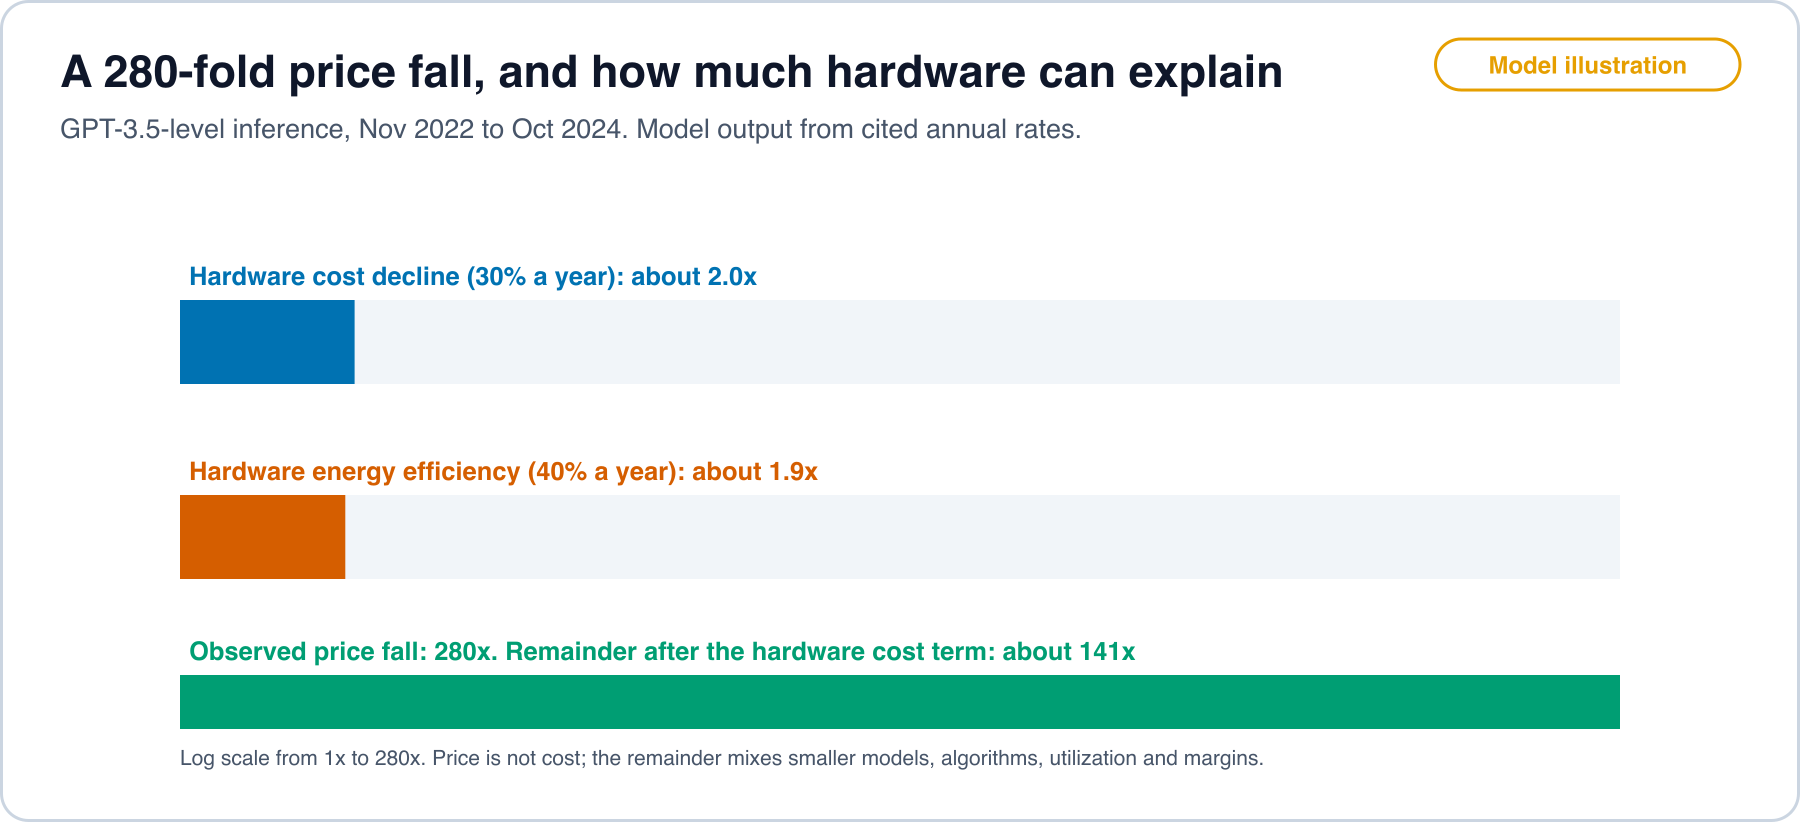
latency_data/model_outputs.json. Open full sizeVínculo con las fronteras. Sea el menor tiempo de acelerador por tarea con calidad entre los métodos documentados y el tiempo en los productos de disponibilidad general. Entonces para la frontera de capacidad, y la frontera desplegada sigue el precio ofrecido, que es al menos el costo más el margen de la Sección 6. El costo del hardware entra en y de la misma manera, porque proveedores y compradores compran en el mismo mercado, así que desplaza ambas fronteras a la vez y deja casi sin cambios. La latencia la mueve el término de software : un método que reduce el tiempo de acelerador por tarea en un factor reduce en ese factor cuando se publica, y solo cuando un producto lo adopta. Durante la espera, la razón entre el costo desplegado y el costo de capacidad es .
Vínculo con el modelo de cadencia. El capital se compromete en pasos plurianuales y se carga a lo largo de vidas de varios años, así que las fechas de decisión para el hardware están muy separadas, y el costo de adopción de la Sección 6 incluye el valor del capital instalado que un método nuevo dejaría varado o ahorraría. Un método que se ejecuta en hardware que una empresa ya posee tiene un costo de adopción que es sobre todo de ingeniería. Un método que necesita hardware nuevo arrastra consigo el ciclo de capital. Por eso los métodos de software abiertos sobre piezas existentes son los menos sujetos a compuertas, y por eso la Predicción 3 compara objetivos con y sin herramientas para portar.
Dónde el costo deja de seguir a la capacidad. Con una calidad fija , el costo por tarea baja con , con el hardware y con el precio. En la frontera de la capacidad, el costo por tarea lo fijan el entrenamiento y el servicio de los modelos más grandes y no baja de la misma manera, y por eso una tarea de calidad de frontera y una tarea de calidad fija tienen curvas de costo distintas. Los datos anteriores miden solo la primera.
Predicción 11 (las piezas más antiguas siguen generando ingresos). Si las vidas de servidores declaradas son económicamente realistas, los precios de alquiler por hora de acelerador de piezas de varios años bajan más despacio de lo que implicarían las operaciones máximas por vatio. Prueba: listados de precios abiertos y fechados por pieza y antigüedad, frente al ajuste de eficiencia de la Figura 11. Se refuta si el precio de una pieza más antigua por unidad de operaciones máximas baja al menos tan rápido como el ajuste de eficiencia.
Predicción 12 (la proporción de la energía sigue siendo pequeña). En una muestra de despliegues medidos, la proporción de la energía en el costo por tarea se mantiene por debajo del 15% con precios de la electricidad inferiores a 0,12 dólares por kilovatio hora. Prueba: medición abierta de la energía de inferencia [56] combinada con precios listados de la hora de acelerador. Se refuta si la proporción medida supera el 15% en la mayoría de los despliegues.
13. Métodos abiertos y hardware existente en paridad
Una segunda descripción del presente es que el trabajo algorítmico abierto permite que la infraestructura existente y más antigua rinda en paridad con la más nueva. El registro fechado respalda una afirmación más estrecha, expuesta aquí según la palanca que acciona cada método y el rezago hasta un uso en un producto lanzado.
Tabla 6. Métodos abiertos, sus artículos fechados y lo que muestra un uso posterior.
| Palanca | Método abierto y lo que reportan los autores | Publicado | Uso posterior | Rezago |
|---|---|---|---|---|
| Cuantización | Modelos de 175.000 millones de parámetros cuantizados en unas cuatro horas de GPU a 3 o 4 bits por peso con una pérdida de precisión despreciable [92] | oct. de 2022 | Inferencia local en 4 bits reportada como práctica en máquinas de consumo en 2023 [68] | No calculado: el uso posterior es otra implementación de 4 bits, y su fecha es evidencia de clase opinión |
| Pesos ternarios en CPU | Un modelo de 2.000 millones de parámetros con 0,4 GB de memoria sin incrustaciones y 29 ms por token en una CPU, frente a 1,4 a 4,8 GB y 41 a 124 ms de seis modelos abiertos de precisión completa de tamaño similar [26] | abr. de 2025 | Pesos del modelo publicados con el artículo | 0 meses |
| Kernels de atención | Atención exacta acelerada al contabilizar las lecturas y escrituras entre niveles de memoria [19] | may. de 2022 | Kernels de atención acelerados en la versión PyTorch 2.0 [20] | Unos 10 meses |
| Memoria de servicio | Memoria clave-valor paginada en un sistema de servicio abierto, con mayor rendimiento que los sistemas previos a la misma latencia [93] | sep. de 2023 | Código fuente publicado con el artículo | 0 meses |
| Modelos de espacio de estados e híbridos | Un modelo sin atención que reporta 5 veces el rendimiento de inferencia de los Transformers [21]; un híbrido que cabe en una GPU de 80 GB, con pesos abiertos [22] | dic. de 2023 | El híbrido, mar. de 2024; más híbridos en 2024 y 2025 [39] | Unos 3 a 4 meses |
| Decodificación especulativa | Distribución de salida sin cambios con una decodificación de 2 a 3 veces más rápida [23] | nov. de 2022 | Reportada en productos de Google para dic. de 2024 [24] | Unos 24 meses |
| Costo de entrenamiento | 2,788 millones de horas de GPU H800 para el entrenamiento completo, autodeclaradas [46]; razonamiento mediante aprendizaje por refuerzo con modelos más pequeños destilados [94] | dic. de 2024 a ene. de 2025 | Modelos destilados más pequeños publicados con el segundo informe | No aplica |
| Servicio fuera de NVIDIA | Eficiencia de prellenado de 4,45 tokens por segundo por TFLOPS en NPU Ascend, por encima de los resultados publicados para SGLang en H100 y DeepSeek en H800, sin reportar la potencia [95] | jun. de 2025 | Despliegue de los autores | No aplica |
Los rezagos se calculan desde el mes de publicación hasta la fecha del uso posterior, y se apoyan en un par por fila. Son una muestra de unos pocos, no una distribución, y el protocolo de la Sección 16 especifica cómo reunir muchos.
Modelos abiertos frente a la frontera cerrada, por cómputo de entrenamiento. Tomando el primer modelo notable en cada nivel de cómputo de entrenamiento, de cualquier tipo de acceso frente a pesos abiertos, el rezago de los pesos abiertos fue de 1 mes en FLOP, 30 meses en , 24 meses en y 15 meses en , y todavía no se registra ningún modelo de pesos abiertos en [25]. Cada nivel lo cruza primero un solo modelo, así que los rezagos se apoyan en un par por nivel. La dirección es que el rezago se acorta a medida que sube el nivel, y la salvedad es que el cómputo de entrenamiento no es capacidad.
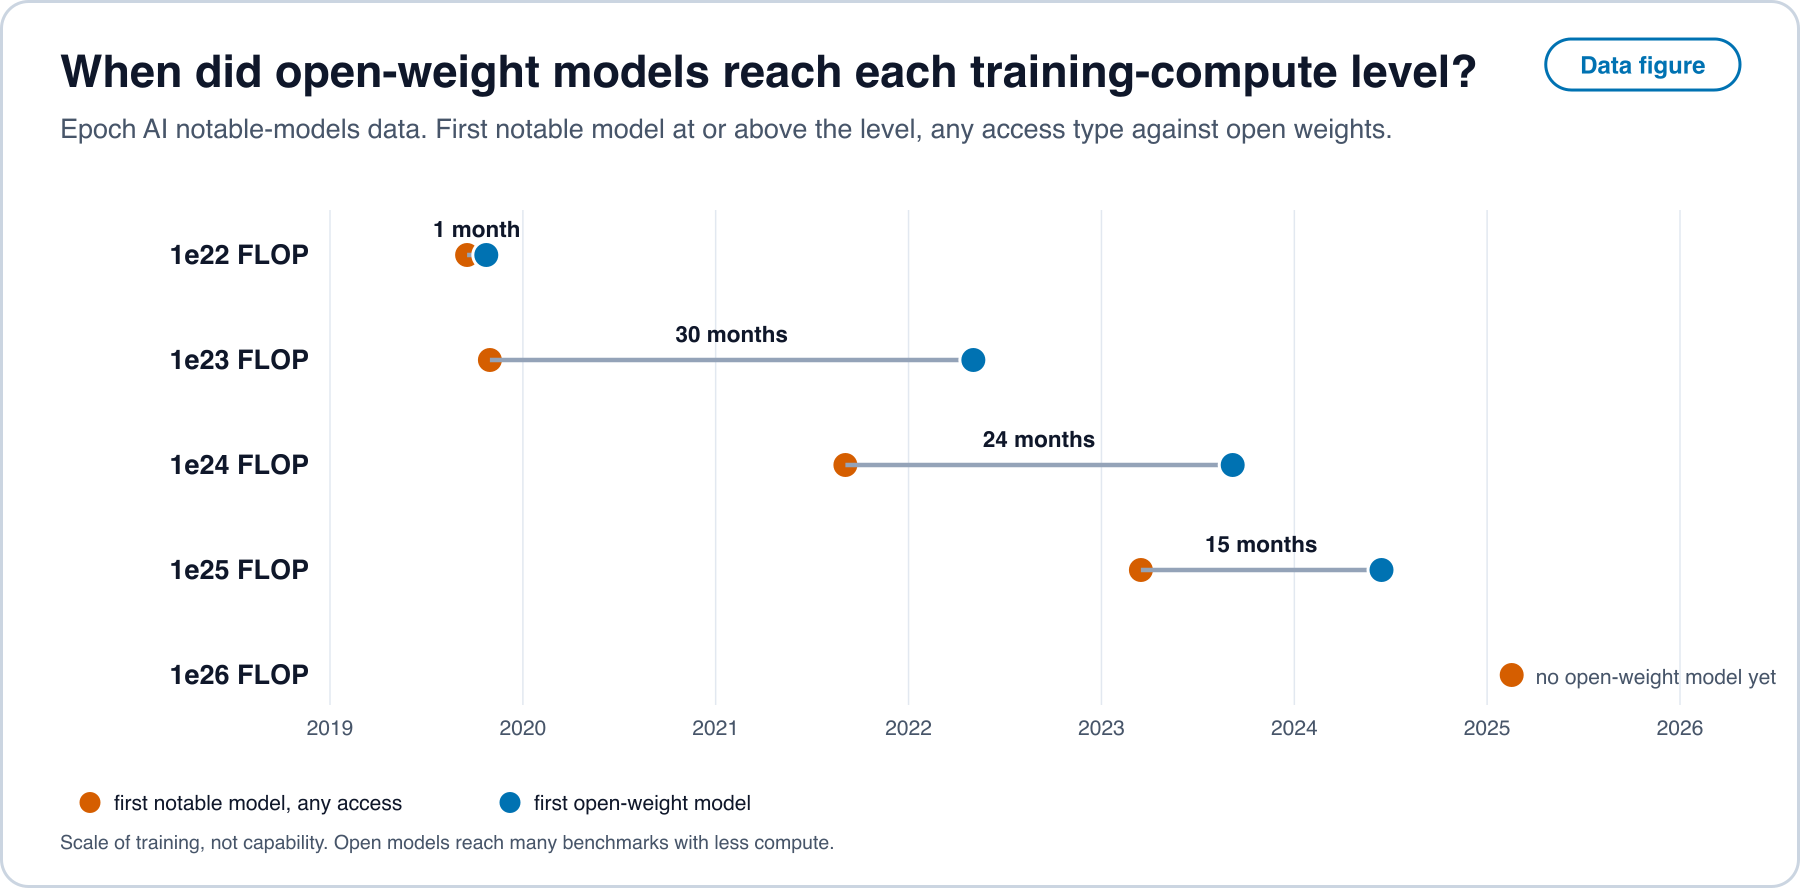
latency_data/compute_threshold_firsts.csv, del conjunto de datos de modelos notables de Epoch AI [25]. Open full sizeEn el hardware de consumo, los modelos abiertos que caben en una GPU de consumo igualan a la frontera tras una media de 6 a 12 meses, según la medida [63]. Los modelos de pesos abiertos de cualquier tamaño van alrededor de un año por detrás de la frontera cerrada en las pruebas de referencia, con un rango de 5 a 22 meses [64].
Qué significa aquí la paridad. Significa la misma puntuación en una prueba de referencia. No significa el mismo rendimiento: una tarjeta de consumo ejecuta un flujo, y un centro de datos atiende muchos, donde el procesamiento por lotes y los kernels importan. Las ganancias de la cuantización y de los kernels se aplican en ambos. El cómputo necesario para un rendimiento fijo se reduce a la mitad aproximadamente cada 8 meses [58], lo que equivale a veces al año, alrededor del doble de las 1,42 veces al año de la eficiencia del hardware de la Figura 11. Donde eso se cumple, el progreso algorítmico supera al progreso del hardware con una calidad fija, y las piezas que se compraron antes producen más tareas de una calidad dada que antes. Si esas tareas adicionales se venden a precios más bajos o se demandan en mayor número es una cuestión de demanda que ninguna de las fuentes de aquí resuelve.
14. Otras maneras de construir la máquina
Una tercera descripción es que los grupos que fabrican hardware con procesos ortogonales muestran que parte del costo de la infraestructura convencional es mayor de lo que la tarea necesita. Las fuentes leídas contienen demostraciones fechadas de diseños analógicos, fotónicos, neuromórficos, FPGA, solo con CPU y de electrónica flexible. Difieren en tarea, escala y medición, así que esta sección reporta cada uno dentro de su propio artículo y solo extrae razones que el propio artículo reporta.
Tabla 7. Diseños alternativos, lo que se midió y la salvedad.
| Enfoque | Demostración | Medido o reportado | Salvedad |
|---|---|---|---|
| Analógico en memoria | 35 millones de dispositivos de memoria de cambio de fase en 34 mosaicos en una tarea de palabras clave de voz [96] | Hasta 12,4 TOPS por vatio sostenidos en el chip, con precisión equivalente al software | Red pequeña, sin línea base equiparada en el texto leído, así que no se extrae ninguna razón |
| Fotónico | Un procesador fotónico de IA con una precisión que los autores presentan como práctica para ResNet y BERT [97] | Precisión en esas redes | Sin julios por tarea en el texto leído |
| Neuromórfico | Un modelo sin MatMul de 370 millones de parámetros en Loihi 2 [28] | Hasta 3 veces el rendimiento con 2 veces menos energía que los transformers en una GPU de borde | Preliminar, modelo pequeño |
| FPGA | FlightLLM en una tarjeta Alveo U280 ejecutando LLaMA2-7B con dispersión y cuantización compiladas [27] | 6,0 y 4,2 veces la eficiencia energética y 1,8 y 1,4 veces la eficiencia de costo de una V100S y una A100 | Comparación de los autores y configuración de la GPU |
| Pesos ternarios en CPU | BitNet b1.58 2B en una CPU [26] | 0,4 GB de memoria frente a 1,4 a 4,8 GB, y 29 ms frente a 41 a 124 ms por token | La energía de 0,028 J por token se estima con un modelo aritmético, de 6,6 a 23 veces menor que las líneas base, y no se leyó de un medidor de potencia |
| Pila de aceleradores alternativa | Servicio en NPU Ascend [95] | 4,45 tokens por segundo por TFLOPS en el prellenado, por encima de los resultados publicados para H100 y H800 | Sin reportar la potencia, así que no se extrae ninguna razón en julios |
| Proceso flexible, no de silicio | Un microprocesador Arm de 32 bits sobre un sustrato flexible [98] | Que un procesador general puede fabricarse con un proceso que no es de silicio | Ningún resultado de aprendizaje automático y ningún julio por tarea |
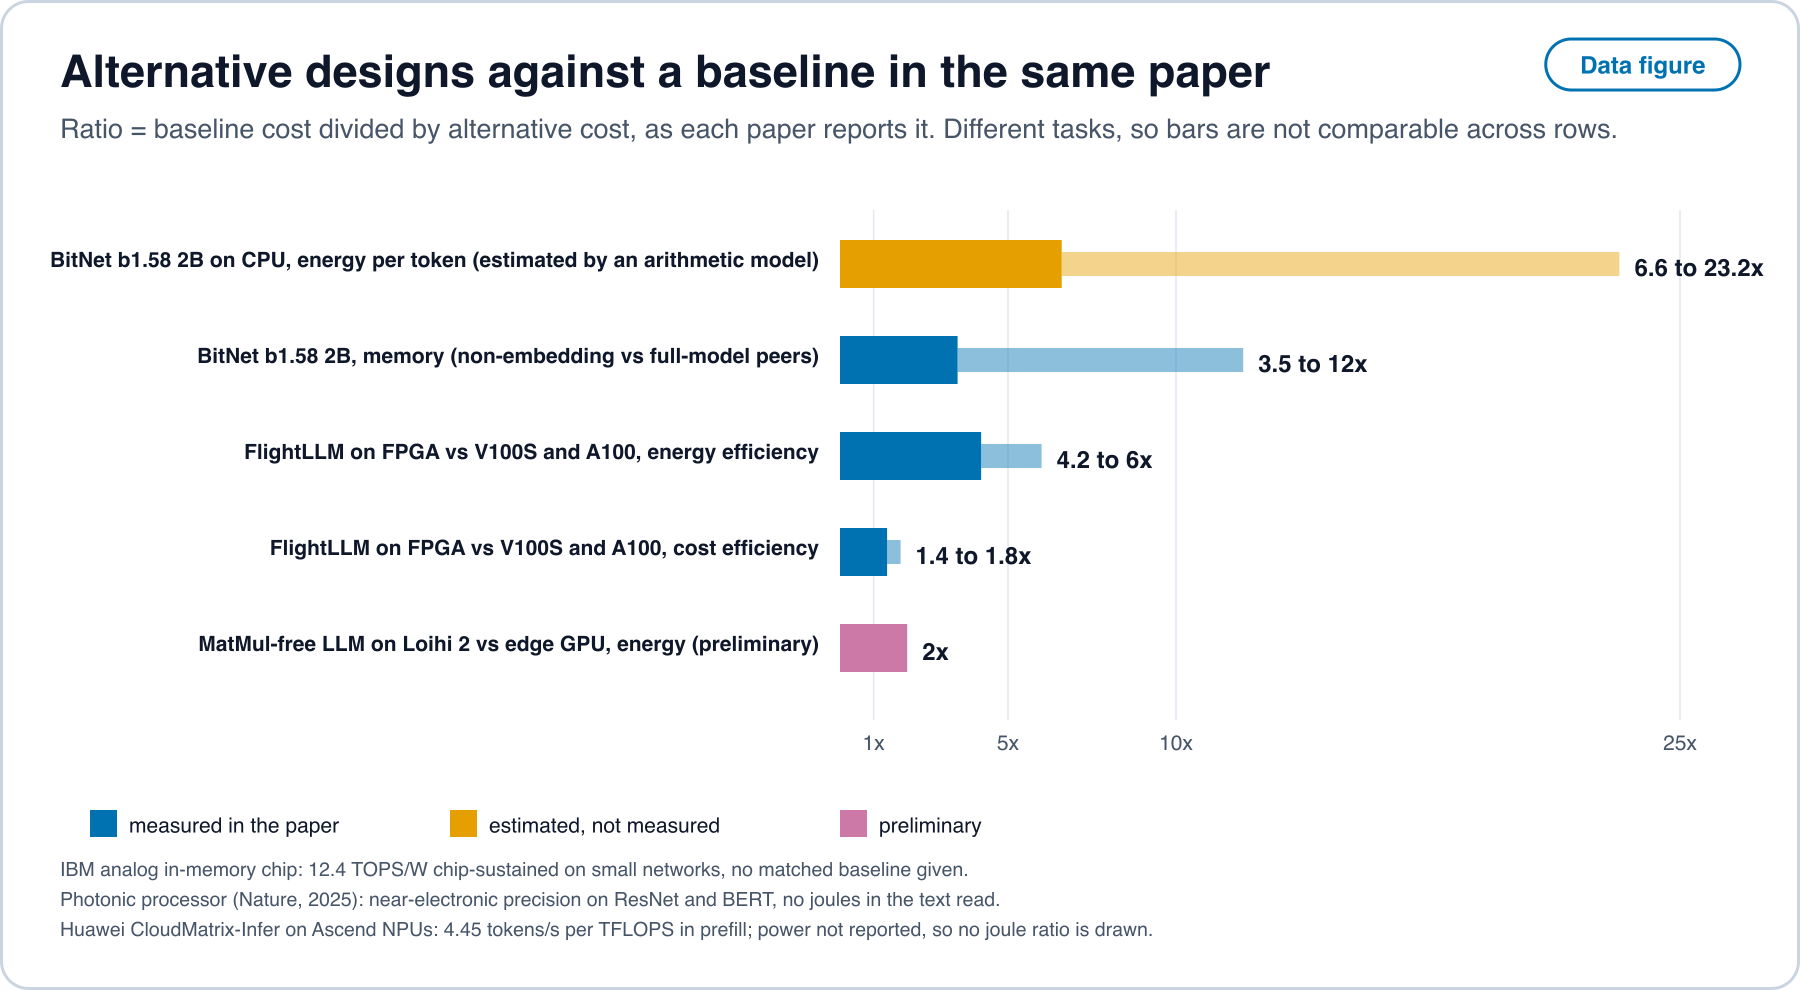
Lo que esto respalda. Para clases de tareas concretas, a saber modelos pequeños, despliegue en el borde, decodificación en CPU e inferencia dispersa o cuantizada en lógica programable, los autores reportan una energía o una memoria de 2 a 23 veces menor que una línea base convencional. Son razones dentro de un mismo artículo sobre modelos pequeños o medianos. Las fuentes leídas no contienen ninguna medición de un diseño alternativo que sirva un modelo de escala de frontera, ni ninguna sobre diseños a escala de oblea o de nodo maduro, así que este artículo no extrae ninguna conclusión para ellos.
Por qué una razón de energía no es una razón de costo. Por la Proposición 8, a precios de centro de datos la energía es entre alrededor del 1,5% y el 11,8% de una hora de acelerador. Una alternativa que reduce la energía por tarea en un factor de 10 reduce el costo por tarea como mucho en la proporción de la energía, a menos que también reduzca el capital por tarea. El resultado de memoria del modelo ternario apunta a esa segunda vía: un modelo que necesita 0,4 GB en lugar de 1,4 a 4,8 GB puede ejecutarse en un dispositivo más pequeño y más barato, y el efecto sobre el capital no se ha medido en las fuentes de aquí. Donde la electricidad no es el término dominante, la comparación útil es en dólares por tarea incluido el capital, y ninguno de los artículos sobre hardware alternativo leídos la reporta salvo FlightLLM, cuyas razones de eficiencia de costo son los números menores de la tabla.
15. Dónde se ubican la capacidad, el cómputo y la energía
La geografía de la expansión se lee aquí a partir de estadísticas nacionales, ministerios y agencias, en el idioma original cuando la fuente no está en inglés. Las unidades difieren entre países, así que las cifras se colocan una junto a otra y no se ordenan en un ranking.
Cómputo y energía. En el conjunto de datos de centros de datos de Epoch AI, los sitios de frontera listados suman 14,1 GW, de los cuales los Estados Unidos tienen el 84%, seguidos de Malasia con 1,1 GW y China con 0,7 GW [12]. El conjunto de datos se basa en permisos públicos e imágenes, así que es más probable que se omitan sitios en lugares con menos divulgación pública. Las propias estadísticas de China reportan otra cantidad: 10,85 millones de racks estándar en uso y una capacidad de cómputo inteligente de 788 EFLOPS a finales de junio de 2025 [99], y 1,59 millones de PFLOPS (FP16) a finales de 2025 [100]. Las dos cifras chinas provienen de publicaciones distintas y pueden basarse en definiciones distintas, y ninguna es comparable con una cifra de potencia listada. En cuanto a la electricidad, los centros de datos usaron unos 415 TWh en 2024, el 1,5% del total mundial, con el 45% en los Estados Unidos, el 25% en China y el 15% en Europa, y la Agencia Internacional de Energía proyecta que se duplicará hasta unos 945 TWh en 2030 como escenario modelado [101, 102].
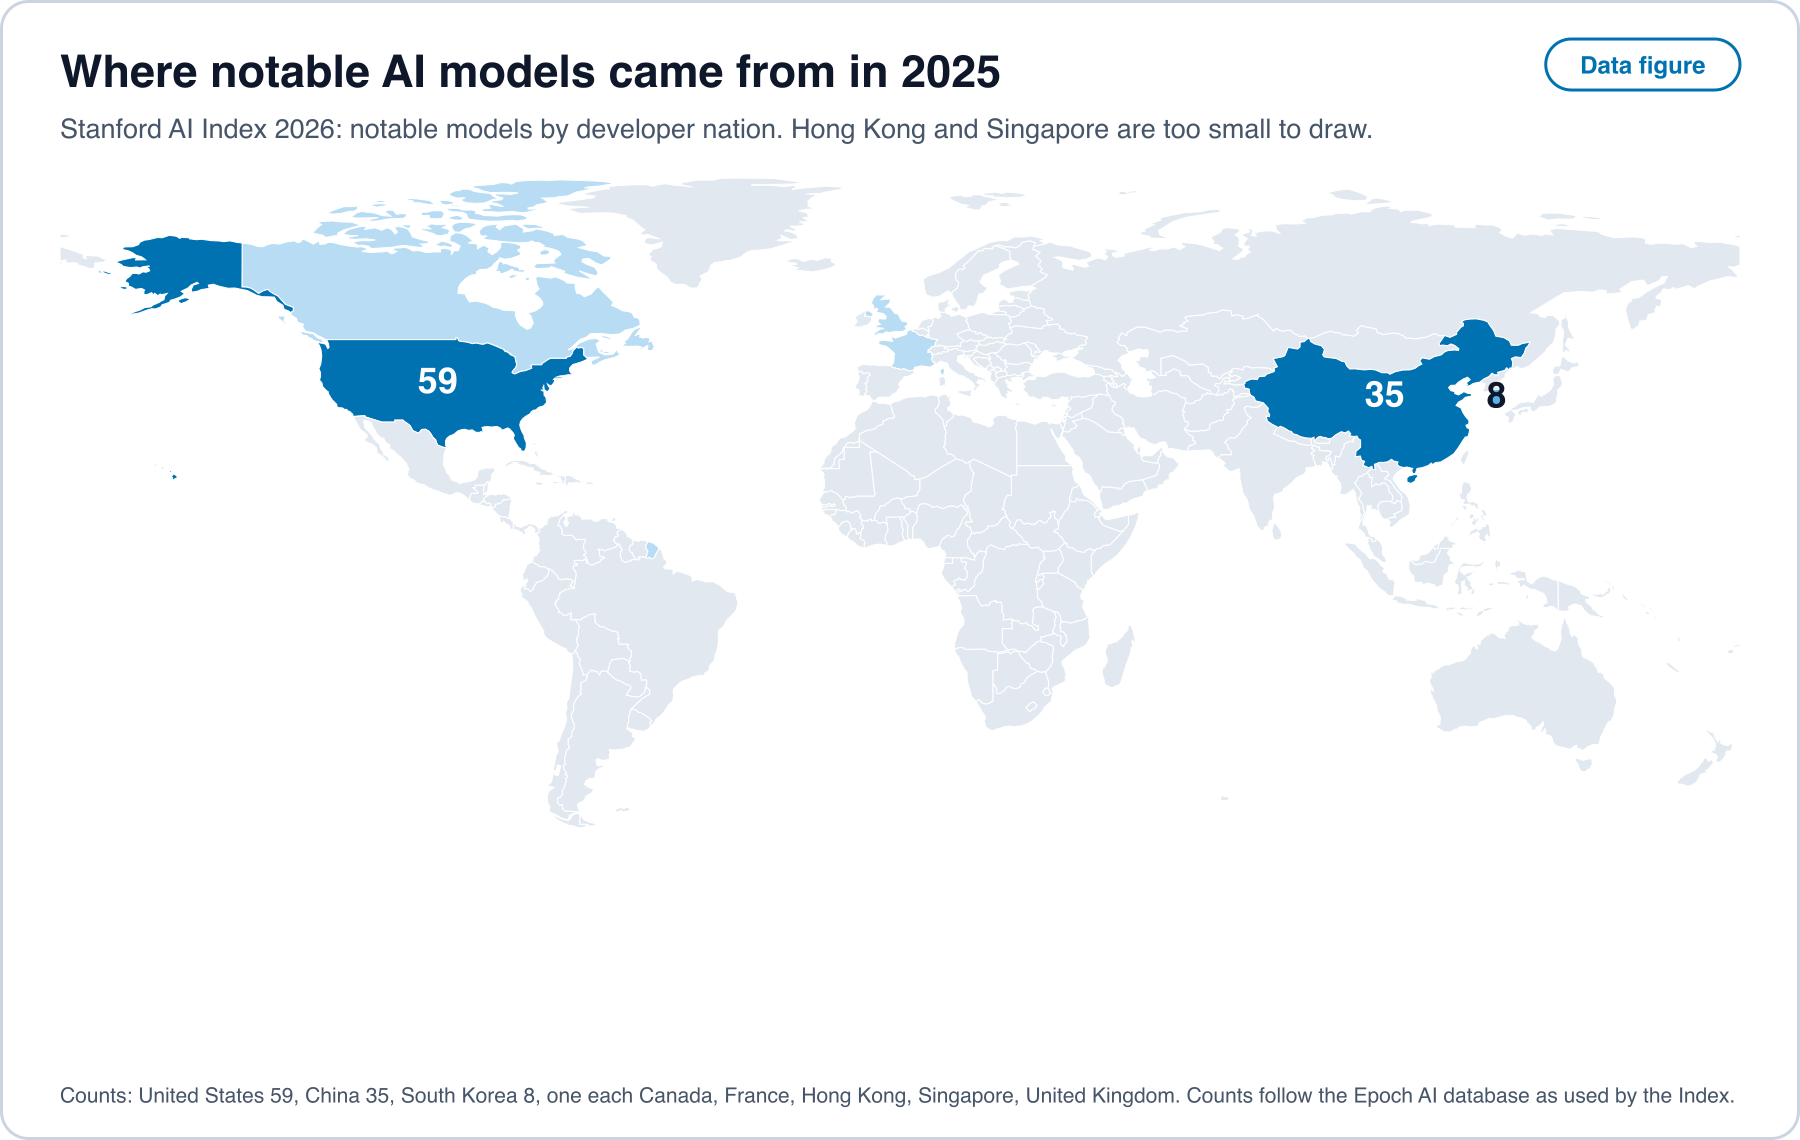
latency_data/frontier_dc_by_country.csv [12]. Open full sizeDe dónde vienen los modelos. De los modelos notables de 2025 según la afiliación nacional del desarrollador, los Estados Unidos aportan 59, China 35 y Corea del Sur 8, con modelos únicos de Canadá, Francia, Hong Kong, Singapur y el Reino Unido [29].
Chips. Para los aceleradores del conjunto de datos de hardware de Epoch, TSMC es la fundición registrada en alrededor de cuatro de cada cinco de las entradas cuya fundición está registrada, seguida de Samsung, SMIC e Intel, y la fundición no está registrada en más de un tercio de todas las entradas (latency_data/hardware_foundry_counts.json) [13]. Las fuentes leídas no dieron cifras utilizables sobre la capacidad de encapsulado ni sobre la capacidad de fabricación por país, así que este artículo no traza ningún mapa de ellas.
Programas nacionales. Los programas declaran su tamaño en unidades distintas, y la Tabla 8 da cada uno tal como se declara.
Tabla 8. Programas nacionales tal como se declaran, con el idioma de la fuente.
| Lugar | Declaración | Idioma | Clase |
|---|---|---|---|
| China | Capacidad de cómputo inteligente de 788 EFLOPS a finales de junio de 2025 y 1,59 millones de PFLOPS (FP16) a finales de 2025 [99, 100] | Chino | demostrado |
| Corea del Sur | Declaración del gobierno de asegurar 260.000 GPU de NVIDIA, en octubre de 2025 [103] | Coreano | opinión |
| Japón | Al menos 10 billones de yenes de apoyo público en los siete años hasta el ejercicio fiscal 2030, con el objetivo de más de 50 billones de yenes de inversión privada en diez años [104]; un estudio de mercado que afirma que se espera que la inversión en la nube en centros de datos japoneses sea de cientos de miles de millones de yenes o más cada año [105] | Japonés | opinión |
| Unión Europea | 200.000 millones de euros por movilizar para la IA, con un fondo de 20.000 millones de euros para gigafábricas de IA [106, 107] | Inglés e italiano | opinión |
| India | 38.231 GPU incorporadas al portal de cómputo IndiaAI, según se informó al parlamento en marzo de 2026 [108] | Inglés | demostrado |
| Brasil | R$ 23.030 millones de inversión prevista para 2024 a 2028 [109] | Portugués | opinión |
| Emiratos Árabes Unidos | Un clúster de cómputo de 1 GW dentro de un campus previsto de 5 GW en Abu Dabi [110] | Inglés | opinión |
| Arabia Saudí | Capacidad proyectada de hasta 500 MW en cinco años [111] | Inglés | opinión |
| África | Una fábrica de IA en despliegue en Sudáfrica, con planes para Nigeria, Kenia, Egipto y Marruecos; sin cifra de capacidad declarada [112] | Inglés | opinión |
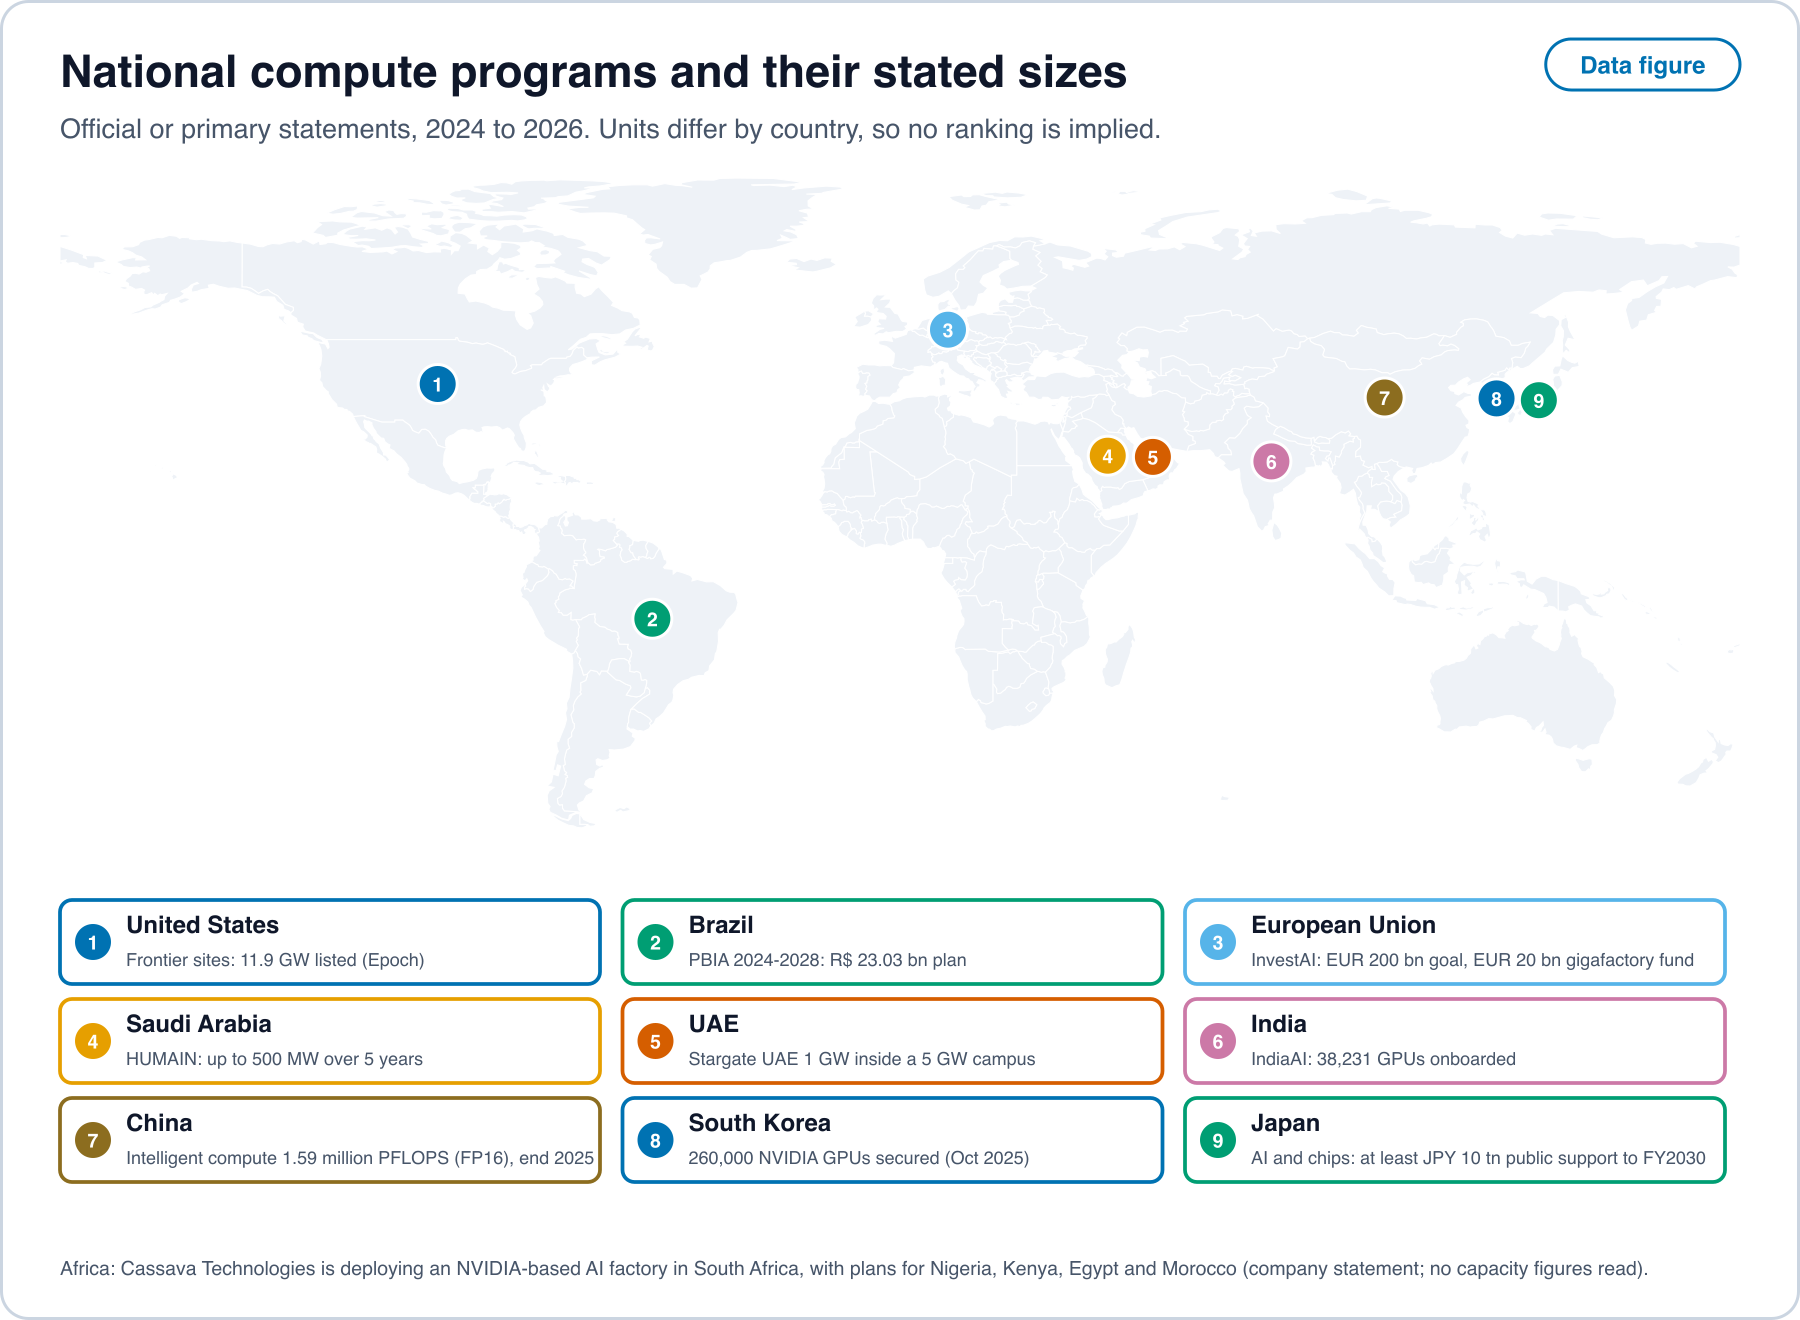
Las declaraciones de la clase Opinión son planes y metas, y la clase Demostrado reúne capacidad o estadísticas reportadas. Los dos tipos no deben sumarse.
Uso. Las encuestas oficiales sobre empresas que usan IA dan un 32,9% en Corea del Sur en 2024, un 26% en Alemania en 2025, un 21,1% en España a principios de 2025, un 20,0% en la Unión Europea en 2025, un 18% en los Estados Unidos en el invierno de 2025 a 2026, un 13,9% para el área de la OCDE en 2024, un 13% en Brasil en 2024 y un 10% en Francia en 2024, con años y definiciones que difieren [30, 31, 32, 33, 34, 35, 36, 37]. Japón y China se miden sobre personas y no sobre empresas [71, 72].
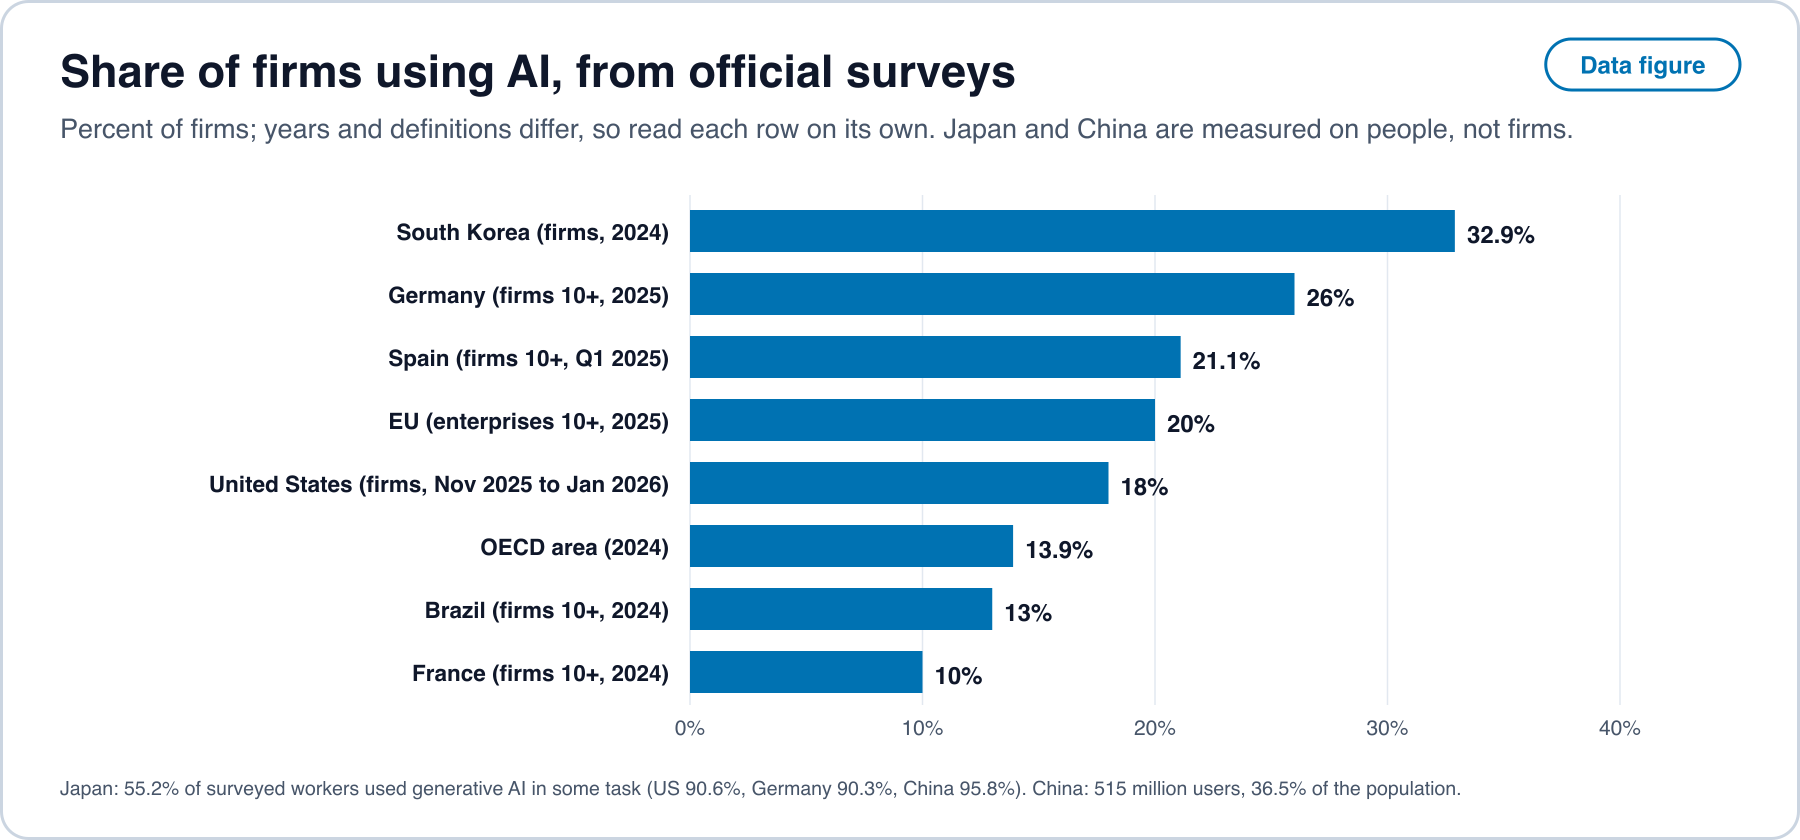
Lo que muestra la geografía. La potencia de cómputo listada se concentra en un país por un amplio margen, mientras que los modelos publicados y las declaraciones oficiales de capacidad muestran un segundo país con una gran proporción de los modelos y una gran capacidad declarada que los conjuntos de datos de potencia listada están mal situados para ver. Los programas de otros lugares declaran planes a escala de gigavatios o de cientos de miles de millones, y el uso medido de la IA por las empresas está entre el 10% y el 33% en las encuestas leídas. La brecha entre los planes y el uso medido es la brecha que estudia este artículo, ahora a escala nacional.
16. Protocolo experimental (no ejecutado)
Propósito. Medir y sus tres partes para una lista de métodos, usando solo fechas públicas.
Unidad. Un método, como un formato numérico, un kernel, un procedimiento de inferencia o un pase de compilador, con una descripción pública fechada.
Fechas por reunir para cada método. La primera publicación pública (preprint o repositorio), la primera implementación abierta, el primer lanzamiento en una biblioteca abierta de uso amplio y el primer lanzamiento de disponibilidad general en al menos un producto comercial, con el tipo de empresa (cotizada, privada, del sector público, académica). Cada fecha se registra con el enlace a su fuente y una copia de archivo.
Muestreo. Todos los métodos de una lista prerregistrada extraída de un conjunto fijo de foros y repositorios de 2022 a 2026, incluidos foros y repositorios no anglófonos, con la regla de selección escrita antes de consultar cualquier fecha de lanzamiento.
Análisis. Calcular por método. Estimar con las pruebas de fase de la Predicción 1 y comparando la demora media con . Estimar la parte de compuerta como la diferencia entre empresas cotizadas y no cotizadas (Predicción 2). Reportar medianas con intervalos bootstrap, y reportar qué proporción de los métodos nunca llega a un producto.
Energía. Donde un método reporta julios por tarea, registrar las condiciones de medición, y donde no lo hace, ejecutarlo en un arnés de energía abierto como el citado en la Tabla 1 y reportar los julios medidos.
Financiamiento y costo. Calcular la cota de la Definición 4 para cada proveedor y ejercicio fiscal a partir de los registros, el precio del julio con carga de capital a partir de los precios listados de la hora de acelerador y de la potencia medida, y la razón entre las compras contratadas y los ingresos recientes de cada laboratorio, y registrar cada uno con el registro y la página de donde proviene. El script de figuras scripts/figures/latency_figures.py y los archivos de datos de scripts/figures/latency_data/ reproducen todas las figuras de las Secciones 9 a 15 a partir de las fuentes citadas.
Resultados. Una tabla de fechas, un script de análisis y un registro de exclusiones. Los scripts y los datos se publicarán con el estudio en las mismas condiciones que este sitio.
17. Conclusión
Los métodos públicos que reducen el costo de la inteligencia computacional llegan a los productos después de una demora con una parte técnica, una parte de calendario y una parte de incentivos. La primera es tiempo de ingeniería. La segunda es la estructura de las fechas de decisión, que en un calendario trimestral añade en promedio unas seis semanas (Proposición 1). La tercera aparece cuando una regla de reporte bloquea un lanzamiento que vale la pena a largo plazo (Proposición 3). Una herramienta que reduce el costo de adoptar un método elimina la tercera cuando el costo cae por debajo de una cota declarada, y una herramienta que reduce el costo del trabajo en sí fuerza el lanzamiento cuando retener no produce nada (Proposición 4). Cuando el mercado tiene varios vendedores alcanzables con poca fricción, el más rápido fija la latencia (Proposición 5). A medida que cae el costo del cómputo, el margen que queda depende de la fricción de cambio (Proposición 6). La evidencia sobre la infraestructura añade lo siguiente. Los registros documentan circuitos de decenas de miles de millones de dólares entre proveedores y clientes nombrados, y acotan por debajo de una quinta parte la proporción de los ingresos del mayor proveedor de chips que su propio capital podría haber financiado, mientras que la mayor parte del gasto de los hiperescaladores se paga con el flujo de caja operativo. A precios de centro de datos la energía es una parte pequeña de una hora de acelerador y el capital es la parte grande, así que el costo por tarea sigue al tiempo de acelerador por tarea, a la utilización y a la vida declarada de la máquina. Los métodos abiertos y los diseños alternativos reducen el tiempo de acelerador, la memoria o la energía por tarea en las mediciones de los propios autores, para modelos pequeños y medianos, y ninguna fuente leída los mide a escala de frontera. La capacidad, el cómputo y la energía están distribuidos de forma desigual, y los planes nacionales se declaran a escalas muy por encima del uso medido. Las proposiciones son un modelo, y las predicciones nombran los registros, listados y mediciones que refutarían cada una.
Referencias
Each entry ends with its evidence class (Section 1).
- Meta, joint venture with funds managed by Blue Owl Capital to develop the Hyperion data center. 2025-10-21. https://investor.atmeta.com/investor-news/press-release-details/2025/Meta-Announces-Joint-Venture-with-Funds-Managed-by-Blue-Owl-Capital-to-Develop-Hyperion-Data-Center/default.aspx (opinion)
- Meta Platforms, Quarterly Report on Form 10-Q, period ended 30 September 2025. 2025-10-30. https://www.sec.gov/Archives/edgar/data/1326801/000162828025047240/meta-20250930.htm (demonstrated)
- NVIDIA, Annual Report on Form 10-K, fiscal year ended 25 January 2026. 2026-02-25. https://www.sec.gov/Archives/edgar/data/1045810/000104581026000021/nvda-20260125.htm (demonstrated)
- CoreWeave, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-03-02. https://www.sec.gov/Archives/edgar/data/1769628/000176962826000104/crwv-20251231.htm (demonstrated)
- Oracle, Quarterly Report on Form 10-Q, period ended 31 August 2026. 2026-09-11. https://www.sec.gov/Archives/edgar/data/1341439/000119312626389274/orcl-20260831.htm (demonstrated)
- Oracle, Q1 FY27 results (Exhibit 99.1 to Form 8-K). 2026-09-10. https://www.sec.gov/Archives/edgar/data/1341439/000119312626387905/orcl-20260910.htm (demonstrated)
- Microsoft, Quarterly Report on Form 10-Q, period ended 30 September 2025, Note 17. 2025-10-29. https://www.sec.gov/Archives/edgar/data/789019/000119312525256321/msft-20250930.htm (demonstrated)
- OpenAI and Amazon Web Services, partnership announcement. 2025-11-03. https://openai.com/index/aws-and-openai-partnership/ (opinion)
- CNBC, OpenAI closes record-breaking 122 billion dollar funding round. 2026-03-31. https://www.cnbc.com/2026/03/31/openai-funding-round-ipo.html (opinion)
- Microsoft, NVIDIA and Anthropic, strategic partnerships announcement. 2025-11-18. https://blogs.microsoft.com/blog/2025/11/18/microsoft-nvidia-and-anthropic-announce-strategic-partnerships/ (opinion)
- U.S. Securities and Exchange Commission, XBRL company concept API (annual capital expenditure and operating cash flow, seven filers). 2026-10. https://data.sec.gov/api/xbrl/companyconcept/ (demonstrated)
- Epoch AI, Frontier Data Centers dataset (CC BY). 2026-10. https://epoch.ai/data/data-centers (demonstrated)
- Epoch AI, Machine Learning Hardware dataset (CC BY). 2026-10. https://epoch.ai/data/machine-learning-hardware (demonstrated)
- Amazon, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-06. https://www.sec.gov/Archives/edgar/data/1018724/000101872426000004/amzn-20251231.htm (demonstrated)
- Meta Platforms, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-01-29. https://www.sec.gov/Archives/edgar/data/1326801/000162828026003942/meta-20251231.htm (demonstrated)
- Alphabet, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-05. https://www.sec.gov/Archives/edgar/data/1652044/000165204426000018/goog-20251231.htm (demonstrated)
- Microsoft, Annual Report on Form 10-K, fiscal year ended 30 June 2026. 2026-07-29. https://www.sec.gov/Archives/edgar/data/789019/000119312626323660/msft-20260630.htm (demonstrated)
- Stanford HAI, AI Index Report 2025. 2025-04. https://hai.stanford.edu/assets/files/hai_ai_index_report_2025.pdf (demonstrated)
- Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. 2022-05-27. https://arxiv.org/abs/2205.14135 (demonstrated)
- PyTorch, PyTorch 2.0 release announcement. 2023-03-15. https://pytorch.org/blog/pytorch-2-0-release/ (opinion)
- Gu and Dao, Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023-12-01. https://arxiv.org/abs/2312.00752 (demonstrated)
- Lieber et al., Jamba: A Hybrid Transformer-Mamba Language Model. 2024-03-28. https://arxiv.org/abs/2403.19887 (demonstrated)
- Leviathan, Kalman, Matias, Fast Inference from Transformers via Speculative Decoding. 2022-11-30 (ICML 2023). https://arxiv.org/abs/2211.17192 (established by proof in the source)
- Google Research, Looking back at speculative decoding. 2024-12-06. https://research.google/blog/looking-back-at-speculative-decoding/ (opinion)
- Epoch AI, Notable AI Models dataset (CC BY). 2026-10. https://epoch.ai/data/notable-ai-models (demonstrated)
- Ma et al., BitNet b1.58 2B4T Technical Report. 2025-04-16. https://arxiv.org/abs/2504.12285 (demonstrated)
- Zeng et al., FlightLLM: Efficient Large Language Model Inference with a Complete Mapping Flow on FPGAs. 2024-01-08. https://arxiv.org/abs/2401.03868 (demonstrated)
- Abreu et al., Neuromorphic Principles for Efficient Large Language Models on Intel Loihi 2. 2025-03. https://arxiv.org/abs/2503.18002 (demonstrated)
- Stanford HAI, AI Index Report 2026, research and development chapter. 2026-04. https://hai.stanford.edu/ai-index/2026-ai-index-report (demonstrated)
- (Korean) Electronic Times, reporting the 2025 Enterprise Informatization Statistics of the Ministry of Science and ICT and NIA. 2026-01-20. https://www.etnews.com/20260120000071 (demonstrated)
- (German) Statistisches Bundesamt, Unternehmen mit Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen (table, 2025). 2025. https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-unternehmen-kuenstliche-intelligenz.html (demonstrated)
- (Spanish) Instituto Nacional de Estadística, Encuesta sobre el uso de TIC y del comercio electrónico en las empresas, nota de prensa. 2025-10-22. https://ine.es/dyngs/Prensa/ETICCE20241T2025.pdf (demonstrated)
- Eurostat, 20% of EU enterprises use AI technologies. 2025-12-11. https://ec.europa.eu/eurostat/documents/7870049/23260410/KS-01-26-009-EN-N.pdf (demonstrated)
- Bonney et al., The Microstructure of AI Diffusion (Census CES-WP-26-25). 2026-04. https://www.census.gov/library/working-papers/2026/adrm/CES-WP-26-25.html (demonstrated)
- OECD, Emerging divides in the transition to artificial intelligence. 2025-06. https://www.oecd.org/content/dam/oecd/en/publications/reports/2025/06/emerging-divides-in-the-transition-to-artificial-intelligence_eeb5e120/7376c776-en.pdf (demonstrated)
- (Portuguese) Cetic.br/NIC.br, Pesquisa TIC Empresas 2024, resumo executivo. 2025-05. https://www.nic.br/media/docs/publicacoes/2/20250512121759/tic_empresas_2024_resumo_executivo.pdf (demonstrated)
- (French) Insee, Les technologies de l’information et de la communication dans les entreprises en 2024, Insee Première n° 2061. 2025-07. https://www.insee.fr/fr/statistiques/fichier/8604126/ip2061.pdf (demonstrated)
- Dao and Gu, Transformers are SSMs (Mamba-2, state space duality). 2024-05-31. https://arxiv.org/abs/2405.21060 (established by proof in the source)
- Lieber et al. (Jamba); NVIDIA (Nemotron-H); TII (Falcon-H1); IBM (Granite 4.0). 2024 to 2025. https://arxiv.org/abs/2504.03624 (demonstrated)
- Ma et al., The Era of 1-bit LLMs (BitNet b1.58). 2024-02-27. https://arxiv.org/abs/2402.17764 (demonstrated)
- NVIDIA, Pretraining Large Language Models with NVFP4. 2025-09. https://arxiv.org/abs/2509.25149 (demonstrated)
- Shah et al., FlashAttention-3. 2024-07. https://arxiv.org/abs/2407.08608 (demonstrated)
- Yuan et al., Native Sparse Attention. 2025-02 (ACL 2025). https://arxiv.org/abs/2502.11089 (demonstrated)
- Hoffmann et al., Training Compute-Optimal Large Language Models. 2022-03-29. https://arxiv.org/abs/2203.15556 (demonstrated)
- Sardana et al., Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling. 2024-01 (ICML 2024). https://arxiv.org/abs/2401.00448 (demonstrated)
- DeepSeek-AI, DeepSeek-V3 Technical Report. 2024-12-26. https://arxiv.org/abs/2412.19437 (demonstrated)
- Angelopoulos, Barber, Bates, Theoretical Foundations of Conformal Prediction. 2024-11-18 (v5 2026-03-06). https://arxiv.org/abs/2411.11824 (established by proof in the source)
- Zhou, Chen, Gui and Cheng, Conformal Prediction: A Data Perspective. 2024-10 (arXiv 2410.06494; ACM Computing Surveys 2025). https://arxiv.org/abs/2410.06494 (opinion)
- Angelopoulos et al., Prediction-powered inference. 2023 (Science). https://www.science.org/doi/10.1126/science.adi6000 (established by proof in the source)
- Ramdas, Grunwald, Vovk, Shafer, Game-Theoretic Statistics and Safe Anytime-Valid Inference. 2023-11 (Statistical Science 38(4)). https://doi.org/10.1214/23-sts894 (established by proof in the source)
- Chernozhukov et al., Double/debiased machine learning. 2018 (Econometrics Journal). https://doi.org/10.1111/ectj.12097 (established by proof in the source)
- Jung, Tian, Bareinboim, Estimating Identifiable Causal Effects through Double Machine Learning. 2021 (AAAI). https://doi.org/10.1609/aaai.v35i13.17438 (established by proof in the source)
- Sathia et al., Compiler Optimizations for Higher-Order Automatic Differentiation. 2025 (PPoPP workshop). https://ece.is/assets/pdf/diffprog-ppopp25-paper90.pdf (demonstrated)
- Ward et al., JAX a la Stan. 2026-10-11. https://bob-carpenter.github.io/dj-paper/template-computo-python.pdf (opinion)
- Qian et al., Impulse: probabilistic programming via compiler augmentation. 2026 (abstract). https://ece.is/assets/pdf/impulse-pldi-src-abstract.pdf (demonstrated)
- Chung et al., The ML.ENERGY Benchmark. 2025 (NeurIPS Datasets and Benchmarks). https://ml.energy/leaderboard/ (demonstrated)
- Google, Measuring the environmental impact of delivering AI at Google Scale. 2025-08. https://arxiv.org/abs/2508.15734 (demonstrated)
- Ho et al. (Epoch AI), Algorithmic progress in language models. 2024-03 (NeurIPS 2024). https://arxiv.org/abs/2403.05812 (demonstrated)
- Epoch AI, LLM inference prices have fallen rapidly but unequally across tasks. 2025. https://epoch.ai/data-insights/llm-inference-price-trends (demonstrated)
- Comin and Hobijn, An Exploration of Technology Diffusion. 2010 (AER 100(5)). https://doi.org/10.1257/aer.100.5.2031 (demonstrated)
- P. A. David, The Dynamo and the Computer. 1990 (AER 80(2)). https://ideas.repec.org/a/aea/aecrev/v80y1990i2p355-61.html (demonstrated)
- Brynjolfsson, Rock, Syverson, The Productivity J-Curve. 2021 (AEJ Macro). https://doi.org/10.1257/mac.20180386 (demonstrated)
- Somala and Emberson (Epoch AI), Frontier AI performance becomes accessible on consumer hardware within a year. 2025-08-15. https://epoch.ai/data-insights/consumer-gpu-model-gap (demonstrated)
- Epoch AI, Open vs. closed AI: how behind are open models?. 2025. https://epoch.ai/publications/open-models-report (demonstrated)
- Gupta and Kiely, Production-ready speculative decoding with TensorRT-LLM. 2024-12-19. https://www.baseten.co/blog/how-we-built-production-ready-speculative-decoding-with-tensorrt-llm/ (opinion)
- Marx and Fuegi, Reliance on Science: Worldwide Front-Page Patent Citations to Scientific Articles. 2020 (NBER 27987; JEMS 2022). https://www.nber.org/system/files/working_papers/w27987/w27987.pdf (demonstrated)
- Ahmadpoor and Jones, The dual frontier. 2017 (Science). https://doi.org/10.1126/science.aam9527 (demonstrated)
- Willison, Stanford Alpaca, and the acceleration of on-device large language model development. 2023-03-13. https://simonwillison.net/2023/Mar/13/alpaca/ (opinion)
- Li et al., Now Hiring: Firm-Level Adoption of Generative AI in China (World Bank). 2025/2026. https://thedocs.worldbank.org/en/doc/cbdef4ef57efdbb3c29aa4c07edf860b-0050062026/original/Now-hiring-Firm-Level-Li-etal.pdf (demonstrated)
- (German) Statistisches Bundesamt, Pressemitteilung Nr. 444: Jedes fünfte Unternehmen nutzt künstliche Intelligenz. 2024-11-25. https://www.destatis.de/DE/Presse/Pressemitteilungen/2024/11/PD24_444_52911.html (demonstrated)
- Japan Ministry of Internal Affairs and Communications, 令和7年版情報通信白書 (Information and Communications White Paper 2025), data tables, in Japanese. 2025. https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/html/nd112220.html (demonstrated)
- (Chinese) China Internet Network Information Center, 生成式人工智能应用发展报告(2025). 2025-10. https://pdf.dfcfw.com/pdf/H301_AP202510241768289458_1.pdf (demonstrated)
- Bick, Blandin, Deming, The Rapid Adoption of Generative AI. 2024-09 (rev. 2025-02). https://www.nber.org/papers/w32966 (demonstrated)
- Brynjolfsson, Li, Raymond, Generative AI at Work (NBER Working Paper 31161; later published in QJE 2025). 2023 working paper, revised. https://www.nber.org/papers/w31161 (demonstrated)
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. 2025-07-10. https://arxiv.org/abs/2507.09089 (demonstrated)
- Bloom, Jones, Van Reenen, Webb, Are Ideas Getting Harder to Find?. 2020 (AER 110(4)). https://doi.org/10.1257/aer.20180338 (demonstrated)
- Graham, Harvey, Rajgopal, The Economic Implications of Corporate Financial Reporting. 2005 (JAE 40); NBER 2004-10. https://www.nber.org/papers/w10550 (demonstrated)
- Asker, Farre-Mensa, Ljungqvist, Corporate Investment and Stock Market Listing: A Puzzle?. 2015 (RFS 28(2)). https://doi.org/10.1093/rfs/hhu077 (demonstrated)
- FactSet, Highest number of S&P 500 earnings calls citing AI over the past 10 years. 2025-12. https://insight.factset.com/highest-number-of-sp-500-earnings-calls-citing-ai-over-the-past-10-years-1 (demonstrated)
- Hassan, Hollander, van Lent, Tahoun, Firm-Level Political Risk. 2019 (QJE 134(4)). https://doi.org/10.1093/qje/qjz021 (demonstrated)
- Metrick and Yasuda, Venture Capital and Other Private Equity: A Survey (NBER Working Paper 16652). 2010-10. https://www.nber.org/system/files/working_papers/w16652/w16652.pdf (opinion)
- Gompers and Lerner, What Drives Venture Capital Fundraising? (Brookings Papers: Microeconomics). 1998. https://www.brookings.edu/wp-content/uploads/1998/01/1998_bpeamicro_gompers.pdf (demonstrated)
- Arrow, Economic Welfare and the Allocation of Resources for Invention (NBER chapter). 1962. https://www.nber.org/system/files/chapters/c2144/c2144.pdf (established by proof in the source)
- Shapiro, Competition and Innovation: Did Arrow Hit the Bull’s Eye? (NBER conference draft). 2010. https://conference.nber.org/confer/2010/RDIA10/Shapiro.pdf (opinion)
- Henderson and Clark, Architectural Innovation. 1990 (ASQ 35(1)). https://doi.org/10.2307/2393549 (demonstrated)
- US District Court for D.C., United States v. Google LLC, remedies memorandum. 2025-09-02. https://www.courthousenews.com/wp-content/uploads/2025/09/judge-amit-mehta-google-search-monopoly-remedy-ruling.pdf (demonstrated)
- NVIDIA and OpenAI, letter of intent announcement. 2025-09-22. https://nvidianews.nvidia.com/news/openai-and-nvidia-announce-strategic-partnership-to-deploy-10gw-of-nvidia-systems (opinion)
- Advanced Micro Devices, Form 8-K, Item 1.01 (warrant issued to OpenAI). 2025-10-06. https://www.sec.gov/Archives/edgar/data/2488/000119312525230895/d28189d8k.htm (demonstrated)
- Microsoft, The next chapter of the Microsoft-OpenAI partnership. 2025-10-28. https://blogs.microsoft.com/blog/2025/10/28/the-next-chapter-of-the-microsoft-openai-partnership/ (opinion)
- Anthropic, Expanding our use of Google Cloud TPUs and services. 2025-10-23. https://www.anthropic.com/news/expanding-our-use-of-google-cloud-tpus-and-services (opinion)
- OpenAI and Broadcom, strategic collaboration announcement. 2025-10-13. https://openai.com/index/openai-and-broadcom-announce-strategic-collaboration/ (opinion)
- Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. 2022-10-31. https://arxiv.org/abs/2210.17323 (demonstrated)
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention (vLLM). 2023-09-12. https://arxiv.org/abs/2309.06180 (demonstrated)
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025-01-22. https://arxiv.org/abs/2501.12948 (demonstrated)
- Zuo et al., Serving Large Language Models on Huawei CloudMatrix384. 2025-06. https://arxiv.org/abs/2506.12708 (demonstrated)
- Le Gallo et al., An analog-AI chip for energy-efficient speech recognition and transcription, Nature. 2023-08-23. https://www.nature.com/articles/s41586-023-06337-5 (demonstrated)
- Ahmed et al., Universal photonic artificial intelligence acceleration, Nature. 2025-04-09. https://www.nature.com/articles/s41586-025-08854-x (demonstrated)
- Biggs et al., A natively flexible 32-bit Arm microprocessor, Nature. 2021-07-21. https://www.nature.com/articles/s41586-021-03625-w (demonstrated)
- (Chinese) 国务院, 截至今年6月底我国智能算力规模达788百亿亿次/秒 (人民日报). 2025-09-02. https://www.gov.cn/yaowen/liebiao/202509/content_7038732.htm (demonstrated)
- (Chinese) 全国数据资源统计调查工作组, 全国数据资源调查报告(2025年). 2026. https://www.nda.gov.cn/sjj/swdt/xwfb/0429/ff808081-9b5e8626-019d-d86b2f54-1154.pdf (demonstrated)
- International Energy Agency, Energy and AI, executive summary. 2025-04. https://www.iea.org/reports/energy-and-ai/executive-summary (demonstrated)
- International Energy Agency, Energy and AI, energy demand from AI. 2025-04. https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai (demonstrated)
- (Korean) 뉴시스, 정부, 엔비디아 GPU 26만장 확보. 2025-10-31. https://www.newsis.com/view/NISX20251031_0003385059 (opinion)
- (Japanese) 経済産業省, AI・半導体産業基盤強化フレーム. 2024-11. https://www.meti.go.jp/policy/mono_info_service/ai_semiconductor_frame/ai_semiconductor_frame.html (opinion)
- (Japanese) 総務省 有識者会合 資料5, 国内データセンター市場におけるAI需要・地方分散・再エネ電源 (富士キメラ総研). 2024-05-30. https://www.meti.go.jp/policy/mono_info_service/joho/conference/digital_infrastructure/0007/005_fujichimera.pdf (opinion)
- European Commission, EU launches InvestAI initiative to mobilise 200 billion euro (English). 2025-02-11. https://digital-strategy.ec.europa.eu/en/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- (Italian) Commissione europea, UE lancia InvestAI per mobilitare 200 miliardi di EUR. 2025-02-11. https://digital-strategy.ec.europa.eu/it/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- Press Information Bureau (India), reply in the Lok Sabha on the IndiaAI Mission. 2026-03-25. https://www.pib.gov.in/PressReleasePage.aspx?PRID=2245063 (demonstrated)
- (Portuguese) Ministério da Ciência, Tecnologia e Inovação, Plano Brasileiro de Inteligência Artificial 2024-2028. 2025. https://www.gov.br/mcti/pt-br/acompanhe-o-mcti/transformacaodigital/plano-brasileiro-de-inteligencia-artificial (opinion)
- SoftBank Group, Global Tech Alliance Launches Stargate UAE. 2025-05-22. https://group.softbank/en/news/press/20250522 (opinion)
- NVIDIA, HUMAIN and NVIDIA Announce Strategic Partnership to Build AI Factories in Saudi Arabia. 2025-05-13. https://nvidianews.nvidia.com/news/humain-and-nvidia-announce-strategic-partnership-to-build-ai-factories-of-the-future-in-saudi-arabia (opinion)
- Cassava Technologies, Cassava scales African AI infrastructure with NVIDIA-powered AI factories. 2025. https://www.cassavatechnologies.com/cassava-scales-african-ai-infrastructure-with-nvidia-powered-ai-factories-to-accelerate-sovereign-data-capabilities/ (opinion)