可能与已部署之间的差距:计算智能的节奏模型与自动化工具的强制函数
降低计算智能成本的方法往往在公开数年之后,才被多数产品采用。本文用有日期的来源衡量这一差距,建立模型说明财报与融资日历如何决定其中一部分,检验基础设施支出中有多少构成封闭回路,建立单项任务成本模型,并说明哪些数据会推翻该模型。
David Charlot, Open Interface Engineering
本文是英文原版的译本。如有出入,以英文版为准。 英文原版.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. 可能与已部署之间的差距:计算智能的节奏模型与自动化工具的强制函数. Open Interface Engineering. Web: https://research.openie.dev/papers/latency/. PDF: https://research.openie.dev/pdfs/latency.pdf.
2026 年 10 月 18 日。来源均注明日期,并在参考文献中按证据类别分类。各命题为手工推导,未经证明助手检查,第 7 节中的数字没有一个是数据。标为模型输出的量是根据所引数字计算得出的,并非观测值。
摘要
以更低成本运行计算智能的新方法会被公开发表,然后经过一段延迟才进入多数产品。本文把这段延迟定义为一个可测量的量,将其拆分为技术、日历和激励三个部分,并建立模型,说明一个降低自动化成本的工具如何改变卖方能够有利可图地收费的对象。随后,本文把这段延迟放进当前基础设施扩建的背景中。本文列出公开申报文件中关于资金在实验室、云服务商和芯片制造商之间流动的记录,给出一个把封闭回路与外部需求区分开来的检验,建立以每项任务的美元和焦耳计的成本模型,把开放软件方法和替代硬件与现有主流栈进行比较,并描绘能力、算力和电力分布在何处。各命题为手工推导,每一项预测都指明了能够推翻它的数据。
用平常话说
- 让计算智能更便宜的开放方法,能在更旧、更便宜的机器上达到同样的结果,而从方法发表到产品上市的等待,对一些方法比对另一些方法更短。
- 一项任务的成本大部分是机器的价格,而不是电费,而用户支付的价格下降得远比硬件成本快。机器背后的资金包括申报文件所记录的少数实验室、云服务商和芯片制造商之间的回路,也包括来自其他业务以及这些回路之外客户的现金。第 10 节给出一个用数据区分两者的检验。
- 等待的一部分来自日历,因为公司按季度和年度分步决策。当一个工具让这项工作足够便宜时,等待对卖方就不再有利,剩下可以收费的是转向别处的成本,而不是计算的成本。
符号
| 术语 | 在本文中的含义 |
|---|---|
| 任务 | 一个具有既定质量阈值 的有用工作单位,例如一个正确答案或一个经过检查的估计值。 |
| 每项任务焦耳数, | 以质量不低于 完成一项任务所测得的能量,单位为焦耳。这是本文中计算智能的核算单位。 |
| 每项任务成本, | 一项任务的货币成本:,其中 是一焦耳的价格, 是不随 下降的硬件和运营成本。 |
| 能力前沿, | 到时间 为止,任何有公开文献记载的方法所能达到的最低每项任务成本。 |
| 部署前沿, | 到时间 为止,正式上市产品所提供的最低每项任务成本。 |
| 延迟, | 在成本水平 上,能力前沿达到 与部署前沿达到 之间的时间。定义见第 0 节。 |
| 报告周期, | 一家报告收益的公司的决策日期间隔,约为一个季度。 |
| 转换摩擦, | 买方转向另一家卖方所承担的每项任务成本:集成、数据迁移、再培训、合同条款、默认设置。 |
| 采用成本, | 围绕一种新方法重建一项产品或服务的一次性成本。 |
| 每项任务加速器时间, | 一项任务以质量不低于 所占用的已利用加速器小时数。见第 12 节。 |
| 计入资本的焦耳价格, | 电价加上每已利用小时的资本成本除以设施功率。见第 12 节。 |
| 封闭回路份额上界, | 供应商收入中可能由其自身提供的资本所资助的份额的上界。见第 10 节。 |
| 可容忍缺口, | 公司在一个周期内愿意接受的报告收益的最大降幅,单位与 相同。 |
0. 定义与范围
令 为时间 时,任何有公开文献记载的方法在质量 下所能达到的最低每项任务成本。它是非增的,因为文献不会被撤回。令 为时间 时正式上市产品所提供的最低每项任务成本。在卖方不撤回报价的情况下,出于同样的原因它也是非增的,并且按构造有 。对于成本水平 ,记 和 。
定义 1(延迟)。 。本文的问题是 有多大、由什么决定、以及什么能改变它。
定义 2(技术、日历和激励部分)。 对于公司 ,延迟分解为 。其中 是技术就绪延迟:工程师移植、测试和加固该方法所需的时间。 项是日历等待:从就绪到公司下一个作出发布决策的日期之间的时间。 项是激励延迟:发布具有正的长期价值,但某条报告或融资规则阻止发布的时间。人为延迟是 。这个词是在狭义上使用的:它是工程时间无法解释的部分,并不是关于任何人动机的论断。
范围。 本文涵盖改变计算智能成本的方法:模型架构、数值格式、内核、编译器、统计推断程序和能量测量。本文也涵盖运行这些方法的基础设施:实验室、云服务商和芯片制造商之间资本和算力承诺的流动,一个加速器小时的成本,改变每项任务加速器时间的开放方法和替代硬件,以及能力、算力和电力所在的位置。本文不预测任何公司、价格或份额。在存在焦耳数字的地方,每项任务的能量(以焦耳计)是度量标准。在来源只报告美元或秒的地方,使用美元或秒的数字并如实标注。
1. 证据的种类
本文中的每个来源都被归入三个类别之一,类别印在参考文献中。
- 来源中由证明确立。 来源包含一个定理或解析推导及其证明。论文中的证明是作者的证明,而不是机器检查过的证明,本文不会对它作更高的称呼。法院记录和统计发布被归为已证实,因为它们报告的是有日期的事实,而不是推导。
- 已证实。 来源报告一项具有既定方法的测量、调查、实验或有日期的发布。结果在该情境下成立,未必适用于其他情境。
- 观点。 来源是预测、没有数据的厂商陈述、从业者叙述,或总结其他工作的综述。综述归入此类,因为本文无法从中判断测量了什么。
数字按来源所述引用,并附有来源自身的情境和保留意见。在一个量是从所引数字推导而来的地方,正文称之为模型输出,并展示算式或指明计算它的脚本。关于计划、目标和拟投资的公告被归为观点,因为它们陈述的是意图而不是结果,向监管机构提交的申报文件被归为已证实。每个来源都以全文形式获取,每个所引数字都在该全文中找到了出处。德语、法语、西班牙语、葡萄牙语、意大利语、韩语、日语和中文的来源以原文阅读,其数字以英文原样转述。
2. 2024 年至 2026 年间变得可能的事
下表按每种方法作用于每项任务成本的杠杆来组织。每一行给出最早公开发布的日期、作者所报告的论断以及类别。
表 1. 改变一项任务成本的方法。
| 杠杆 | 方法与论断 | 发布 | 类别 |
|---|---|---|---|
| 架构 | 选择性状态空间模型与注意力变体通过结构化半可分矩阵互为对偶,据报告所得层比早先的扫描快 2 到 8 倍 [38]。 | 2024 年 5 月 31 日 | 来源中由证明确立 |
| 架构 | 2024 年和 2025 年间,多个团队以开放权重发布了状态空间与注意力混合模型 [39]。 | 2024 年至 2025 年 | 已证实 |
| 数值格式 | 在作者的实验中,三值权重从约 30 亿参数起即可在更低的延迟、内存和能量下达到 16 位的困惑度和终端任务得分 [40]。 | 2024 年 2 月 27 日 | 已证实 |
| 数值格式 | 硬件厂商报告,一个 120 亿参数的混合模型在 10 万亿词元上进行了稳定的 4 位预训练,结果与 8 位相当 [41]。 | 2025 年 9 月 | 已证实 |
| 内核 | 一个注意力内核在一代加速器上达到 16 位峰值吞吐量的最高 75%,而其前代为 35% [42]。 | 2024 年 7 月 | 已证实 |
| 稀疏性 | 硬件对齐、可原生训练的稀疏注意力,在 6.4 万词元上下文下报告了加速 [43]。 | 2025 年 2 月 | 已证实 |
| 解码 | 推测解码保持输出分布不变,在一个大型翻译模型上测得快 2 到 3 倍 [23]。 | 2022 年 11 月 30 日 | 来源中由证明确立 |
| 规模化 | 当计入生命周期内的推理需求时,成本最优的模型比仅考虑训练的规则所给出的更小,并在更多词元上训练 [44, 45]。 | 2024 年 1 月 | 已证实 |
| 训练成本 | 一个前沿规模模型报告完整训练用了 278.8 万加速器小时,采用潜在注意力和 8 位训练 [46]。 | 2024 年 12 月 26 日 | 已证实 |
| 保形推断 | 对任何预测器都具有有限样本、无分布假设的覆盖保证,证明汇集于一本书中 [47];一篇 2024 年 10 月首次发布、2025 年发表的综述涵盖结构化、非结构化和动态数据 [48]。 | 2024 年 11 月 18 日 | 来源中由证明确立 |
| 借助预测的推断 | 由一个小的标注集和大量机器预测得到有效区间,适用于任何预测器 [49]。 | 2023 年 | 来源中由证明确立 |
| 序贯推断 | 在任意时刻停止检验时仍保持有效的 E 过程和置信序列 [50]。 | 2023 年 11 月 | 来源中由证明确立 |
| 因果估计 | 去偏机器学习在使用灵活的冗余模型时对目标参数给出有效推断,并被推广到后门调整之外的可识别效应 [51, 52]。 | 2018 年;2021 年 | 来源中由证明确立 |
| 编译器 | 用于高阶自动微分的编译器遍报告在二阶算子上最高达 1.3 倍,属初步结果 [53];一篇 2026 年的方法论文称,编译后的 JAX 在现代硬件上的效率远超 Stan,但其摘要中没有基准数字 [54]。 | 2025 年 | 已证实 |
| 概率编程 | 一个保持概率语义的编译器在标准基准上报告几何平均比 Stan 快 6.4 倍、比 Turing 快 53 倍 [55]。 | 2025 年至 2026 年 | 已证实 |
| 能量测量 | 一个开放基准测量了 40 种架构的推理能量,报告了时间与能量的帕累托配置,部分情况下节省超过 40% [56];一家提供商报告,生产环境中一个中位文本提示耗用 0.24 瓦时 [57]。 | 2025 年 | 已证实 |
两个速率提供了背景。达到固定语言模型得分所需的算力大约每 8 个月减半,95% 区间约为 5 到 14 个月 [58]。在六个基准上,达到固定基准水平的价格每年下降 9 到 900 倍,中位数约为 50 倍,最快的速率所依据的数据不足一年 [59]。两者都是能力前沿 或价格的变化率,都不衡量与部署之间的差距。
本表有两点限制。若干行是相对于作者所选基线的加速,因此这些数字不能跨行相加或比较。而且这些行中的”可能”是指作者在既定情境中已证实,而不是在产品中可用。
3. 数据中的差距是什么样子
长期扩散。 在 1820 年至 2003 年间涵盖 15 项技术和 166 个国家的数据中,一项发明与其在一个国家被采用之间的平均滞后约为 45 年,并且滞后在此期间不断缩短 [60]。同一段历史也对”采用”意味着什么提出了警示。电动机只有在工厂围绕每台机器一台电动机重新设计之后才提高了工厂生产率,这一转变用了数十年 [61]。一个后来的模型把测得的生产率先降后升归因于对流程和技能的未被测量的互补投资 [62]。在这两种解释中,延迟主要是围绕工具重新组织的成本,在上面的符号中就是 。
从开放发布到消费级硬件。 对于能装入一块消费级显卡的模型,2025 年在四项指标上落后于总体最佳模型的平均滞后为 6 到 12 个月,最大的滞后为 12.4 个月,出现在一项偏好得分上 [63]。一项对任何规模的开放权重模型的更广泛分析发现滞后约为一年,按基准不同在 5 到 22 个月之间,而一项后来基于指数的分析把平均值定在接近 3 个月 [64]。这些数字衡量的是两个公开前沿之间的距离。它们是到产品的滞后的下界,因为显卡上的一个开放模型还不是任何人有偿支持的产品。
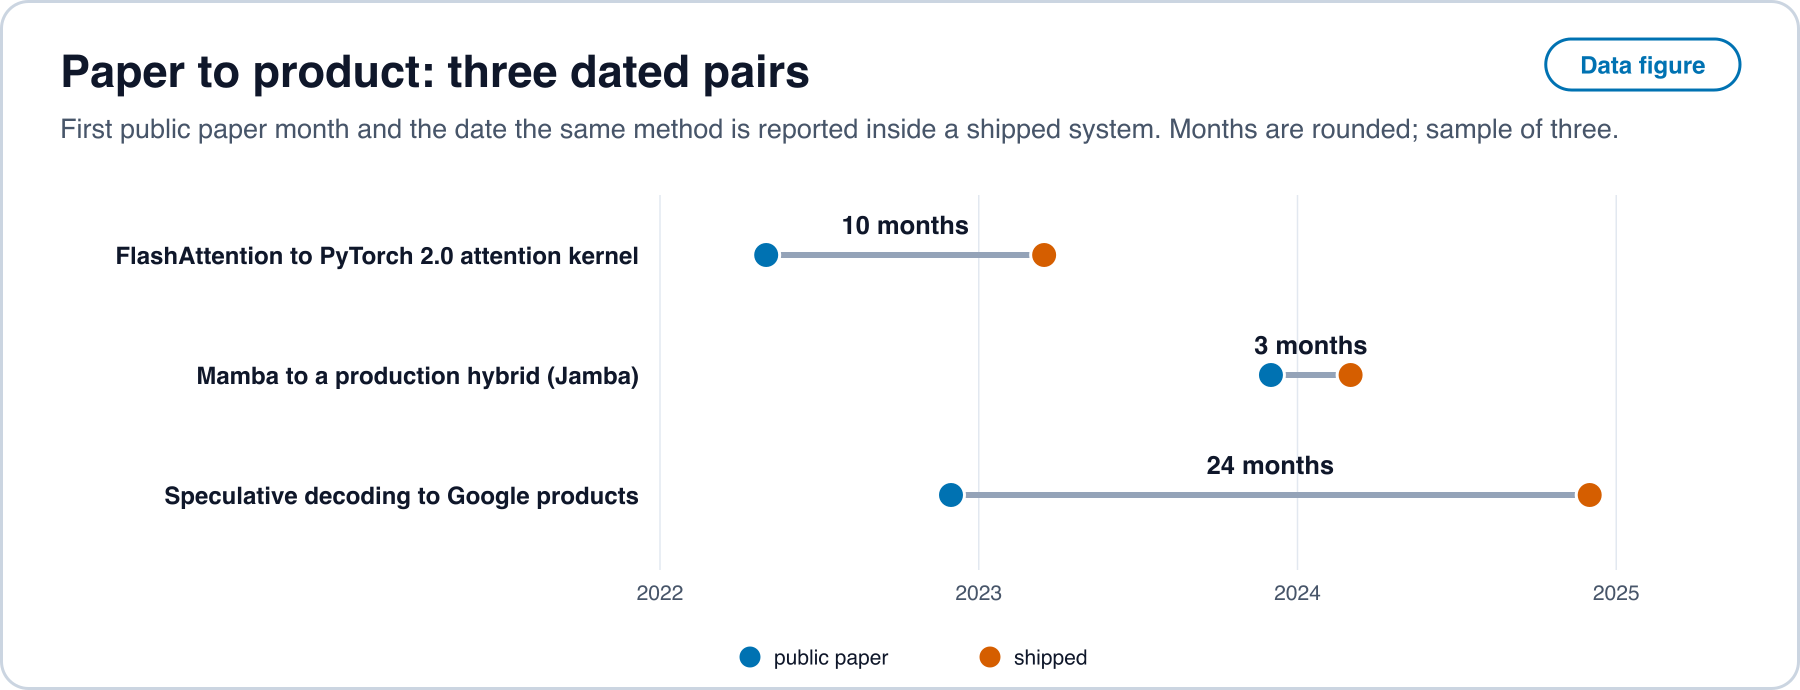
从论文到产品。 推测解码于 2022 年 11 月发布。其作者的雇主报告称,到 2024 年 12 月已在产品中应用了它 [24]。同月的一份从业者记述说,生产使用需要在批处理、质量和可靠性上做额外工作,而且主要在有限的批大小下才有帮助 [65]。另外两组配对见第 13 节。少数几组有日期的配对构不成一个分布,第 16 节的方案规定了如何收集大量配对。一项对论文到专利距离的更长期测量发现,专利对文章的引用在首页上平均比专利早 14.4 年,计入正文引用时为 16.6 年 [66],而有关联的专利和论文通常相隔两到四个引用步 [67]。这些数字针对的是整个科学,并不特指机器学习。
4 位模型的实践。 从业者记述把 4 位本地推理在消费级机器上变得可行的时间点定在 2023 年 [68]。这些记述是叙述性的,因此这是关于一个日期的观点类证据,而不是测量。
企业采用。 美国人口普查局 2026 年的补充调查发现,在 2025 年 11 月至 2026 年 1 月期间,18% 的企业在某项业务职能中使用 AI,22% 预计会在六个月内使用,57% 的使用者只在三个或更少的职能中使用 [34]。在欧盟,2025 年 10 名及以上员工的企业中有 20.0% 使用了至少一种 AI 技术,比 2024 年高 6.5 个百分点,其中大型企业为 55.0%,中型为 30.4%,小型为 17.0% [33]。OECD 报告 2024 年的采用率为 13.9%,大型企业为 39%,小型企业为 12% [35]。中国的招聘数据显示,到 2025 年底,上市公司中有 21% 在招聘生成式 AI 岗位,而非上市公司为 0.2% [69]。各来源的调查措辞和抽样框不同,人口普查局的问题在 2025 年 11 月作过修订,因此各行的比率不可相互比较。
原文语言的官方统计。 德国联邦统计局(Statistisches Bundesamt)报告,2024 年 10 名及以上员工的企业中有 20% 使用 AI,2023 年为 12%,2021 年为 11%,其中大型企业为 48%,中型为 28%,小型为 17%,并指出缺乏知识和法律不确定性是不使用的最常见原因 [70]。其 2025 年的表格给出总体 26%、250 名以上员工的企业 57%,所用的企业定义有所变化 [31]。Insee 报告,2024 年法国有 10% 的企业使用 AI,比 2023 年高四个百分点,250 名及以上员工的企业为 33%,信息和通信行业为 42%,而运输、住宿餐饮和建筑业为 5% 或更低 [37]。西班牙国家统计局(Instituto Nacional de Estadística)报告,2025 年第一季度 10 名及以上员工的企业中有 21.1% 使用 AI,比一年前高 8.7 个百分点 [32]。巴西的 Cetic.br 报告,2024 年有 13% 的企业使用 AI,与 2023 年份额相同,集中于大型企业以及信息和通信行业 [36]。据韩国媒体报道的韩国部委统计,2024 年有 32.9% 的企业使用 AI 技术或服务,2023 年为 30.3%,250 名及以上员工的企业为 66.9% [30]。日本白皮书调查了四个国家的劳动者,发现生成式 AI 的任何业务使用在日本为 55.2%,美国为 90.6%,德国为 90.3%,中国为 95.8%。在日本企业中,2024 年有 49.7% 制定了积极使用或有限使用的政策,一年前为 42.7%,日本最常见的担忧是不知道如何有效使用,占 30.1%,而美国为 9.7%,中国为 10.4% [71]。中国的 CNNIC 统计,2025 年 6 月生成式 AI 用户为 5.15 亿,比 2024 年 12 月多 2.66 亿,普及率为 36.5% [72]。这些是对使用的测量,而不是对发布的测量。在每个国家内,比率都随企业规模上升,这与固定的采用成本 对大预算的压力较小相一致,尽管这些调查无法把这一点与其他原因区分开来。
个人和任务层面的使用。 2024 年末,美国 18 至 64 岁的成年人中有近 40% 使用过生成式 AI,约 23% 的劳动者在前一周的工作中使用过它 [73]。一项对 5,179 名客户支持人员的现场研究发现,每小时解决的问题平均多 14%,新手和低技能人员多 34% [74]。一项有 16 名资深开发者和 246 项任务的随机试验发现,在该情境下允许使用 AI 的任务耗时多 19% [75]。这些结果之所以不同,是因为任务、人员和工具不同。它们表明部署不是一个单一事件,这就是为什么 是由报价而不是由使用来定义的。
是什么拖慢了研究本身。 在多数部门,研究投入不断上升,而研究生产率却在下降,维持芯片密度翻倍所需的研究人员是 1970 年代初的 18 倍以上 [76]。这影响的是 ,而不是 ,在此提及是为了让本文不把能力前沿当作免费的。
4. 日历:报告周期与融资周期
上市公司的决策日期遵循报告日历。在一项对 401 名财务高管的调查中,78% 的人愿意放弃经济价值来平滑报告收益,55% 的人如果启动一个净现值很高的项目意味着达不到当季的一致预期,就会避免启动它 [77]。可比的上市公司比私营公司投资更少,对投资机会的反应也更弱 [78]。所有这些都是针对较早的技术和时期证实的,没有一项是对 AI 发布的测量。
关注度遵循同样的日历。美国大公司财报电话会议中提及”AI”的次数在 2025 年第三季度达到 306 次,而十年平均为 86 次 [79]。财报电话会议的措辞已被用作其他主题的测量工具,并经人工阅读验证 [80],同一工具也可以用于发布主题。
融资遵循一个更长的日历。一只风险投资基金的存续期是有限的,通常为十年,公司每三到五年募集新基金 [81]。合伙协议规定了有限的存续期,通常为十年 [82]。两个日历的长度不同,约为一个季度和三到五年,两者都把可以作出承诺的时间量化为离散点。下面的命题 1 只用到这一结构。
5. 控制与在位者的反应
两个较早的结果构成了部署激励的框架。Arrow 的分析发现,垄断(指进入壁垒)下的发明激励小于竞争下的发明激励,并把不阻止进入的暂时垄断视为接近竞争 [83]。一篇后来关于竞争与创新文献的综述指出,先发制人的激励是简单静态模型中缺失的一种力量 [84]。在位者也会错过那些重新排列已知组件的变化,因为他们的惯例过滤了他们所注意到的东西 [85]。两者都不是关于当今任何公司的陈述。
对分销的控制记录在公开的法院记录中。2025 年 9 月,一家美国联邦地区法院禁止了若干搜索和助手产品的独家分销合同,允许条款一般限于一年的非独家默认付费,并下令采取数据共享和联合分发的救济措施 [86]。本文只把这份记录用作证据,说明默认设置和分销条款是有价格且受监管的,这正是第 6 节中参数 所代表的东西。
6. 模型
设定。 一个买方群体,对价格为 的一项任务每期需求为 。一家在位者用现有方法以成本 为其服务。一种公开方法以成本 向任何人开放,该成本随时间非增。买方可以以每项任务摩擦 转向使用该公开方法的卖方,因此在位者的价格上限为 。在位者可以以一次性成本 发布基于该公开方法的产品。决策只在日期 作出。
假设。
- A1. 线性需求 ,且 。
- A2. 公开成本下降: 非增且连续,,并且 。
- A3. 上限 对在位者的价格有约束力,即对其面对的成本 有 。这对第 7 节中的数字成立。
- A4. 在位者在一条报告规则的约束下以利率 最大化贴现利润: 的份额 在发布期内费用化,并且发布期的报告收益比发布前水平的降幅不得超过 。
- A5. 发布后,在位者的成本为 ,即公开方法的成本。
- A6. 发布带来的流量收益在发布日期之后视为常数(稳态近似)。
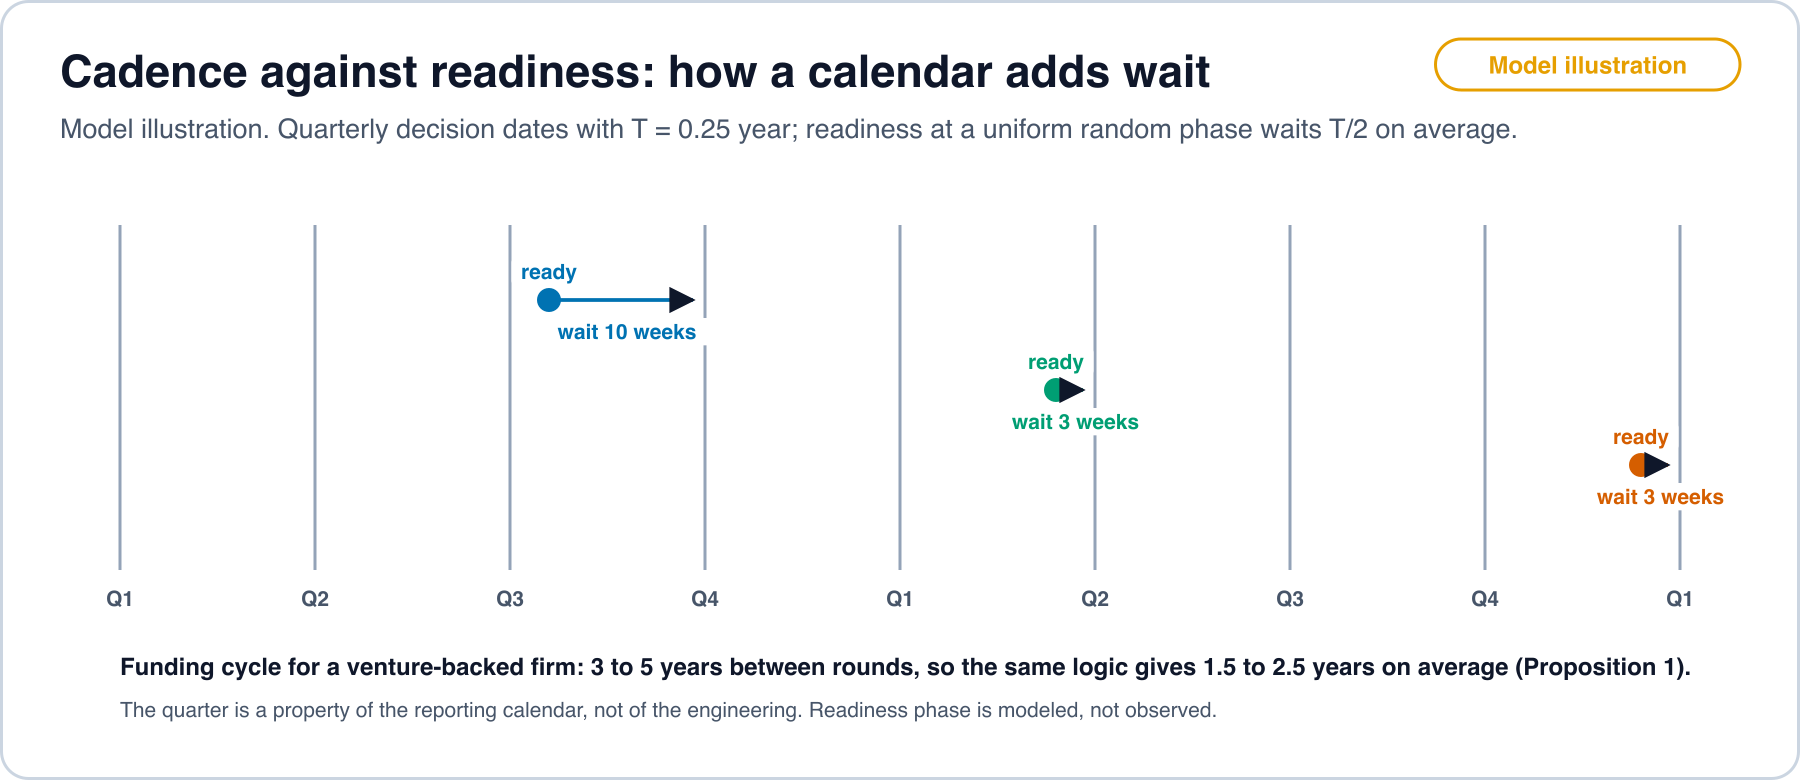
命题 1(日历量化)。 如果一种方法在时间 就绪,而公司在 当天或之后第一个值得发布的决策日期发布,则等待为 。如果 在 上均匀分布,则 且 。
推导。 记 ,其中 在 上均匀分布。对 ,下一个日期是 ,等待为 ,它在 上均匀分布。长度为 的区间上的均匀变量均值为 ,方差为 。 的情形概率为零。
推论。 一家按季度日历决策的公司平均为就绪延迟 增加约 6 周,而一家按 3 到 5 年融资周期决策的公司增加 1.5 到 2.5 年,且都没有工程上的原因。就绪在一个周期内均匀分布这一假设是薄弱之处,预测 1 检验其反面。
命题 2(发布阈值与被迫发布)。 对外部成本 ,定义流量收益 。在 上, 关于 严格递减。在没有日历或报告约束的情况下,发布恰在 时最优,即当 时,其中 是 的唯一解(若存在)。如果 ,持有不产生利润,发布优于持有。报告规则可以推迟发布,但不能使持有变得有利可图。
推导。 在 A3 下,以成本 持有的在位者按上限定价,因此其利润为 。发布后其成本为 ,利润为 。两者之差为 。求导得 在所述范围内成立,因此 严格递减。在 A6 下,发布的价值为 ,它恰在 时非负。持有产生利润 ,它在 即 时为零,低于该点时为负。在该点发布,由 A1 产生利润 。
命题 3(报告门槛、延迟与永不发布区域)。 在 A4 下,发布期报告收益的变化为 。如果它至少为 ,即如果 ,则允许发布。定义 和 。则 ,发布日期从 移到 或被迫发布点 中较早者,并且对于 ,当 时延迟为 。如果 ,其中 是成本下限,则在 NPV 和门槛条件下永远不会发布,若 ,只适用在 处的被迫发布。
推导。 发布期的报告收益获得 的营业利润,并失去采用成本中费用化的部分 。要求净额至少为 即得所述不等式。由于 严格递减(命题 2),两个所需收益中较大者对应较小的成本阈值,因此 。在 下,达到 的时间为 ,两个这样的时间之差即为所述延迟。可达到的收益至多为 ,因为由 A2 有 。
命题 4(强制函数)。 假设一个自动化工具把采用成本从 降到 。(a) NPV 阈值 上升,因此发布更早成为最优。(b) 如果 ,报告门槛不再有约束力,,且 。(c) 公司的总延迟降到 ,其中 是使用该工具时的技术就绪延迟。
推导。 (a) 且 严格递减,因此降低 会降低所需收益并提高 。(b) 当右侧非正,即 时,门槛条件 对每个 都成立。于是 。(c) 由定义 2 和命题 3 得出。
解读。 工具以两种不同的方式充当强制函数。它降低 ,因而一旦 降到 以下就消除了门槛延迟。它还为每个卖方降低 ,这迫使在 处发布,在那里持有一无所获。前者是采用公司的性质,后者是市场的性质。
命题 5(市场延迟由受约束最少的公司决定)。 如果在能够向该买方群体销售的公司中有 ,则 。
推导。 ,且 不依赖于 。相减即得结果。
推论。 当另一家公司能够不经那段延迟就触达同样的买方时,推迟一家公司的日历或门槛并不会推迟市场。于是市场中观察到的延迟就是有触达渠道的最快公司的延迟。在触达受到限制、买方无法接触其他卖方的地方,最小值是在一个更小的集合上取的。在模型中,这就是 的作用。
命题 6(还剩下什么可以收费)。 发布后,在上限有约束力的情况下,价格为 ,利润为 ,每项任务的利润率为 ,与 无关。价格与成本一对一变化,而价格与成本之比 随成本下降而上升。摩擦的边际价值为 ,它在 时为正,并随 下降而增大。
推导。 在 A3 下,在位者收取上限 。成本为 时,利润率为 ,销量为 ,得 。比率由 得出。对 关于 求导得 ,且 。
解读。 随着计算成本下降,价格中反映计算的部分缩小,剩余的利润率取决于买方离开的代价有多高。提高 的支出变得更有价值。在模型中,这是关于激励的陈述,而不是对任何公司的评判。降低 的政策,例如限制默认条款或可移植的数据格式,会以同样的幅度降低利润率,而模型并不判断这是否可取。
7. 一个数值示例,而非拟合
工作文件夹中的脚本 model_check.py 用标准库复现这些数字。参数:,,, 每年, 年,,,外部成本每 8 个月减半,因此 。8 个月的速率呼应 [58],是为示例所作的选择,而不是对成本的估计。
表 2. 有无降低采用成本的工具时的发布日期。
| 情形 | NPV 阈值 | 门槛阈值 | 发布时间 | 门槛延迟 | |
|---|---|---|---|---|---|
| 工具出现之前 | 2.0 | ,第 4 天 | 第 5.00 个月 | 4.85 个月 | |
| 工具降低采用成本 | 0.1 | 第 0.2 天 | 0 |
在第一行中,门槛要求的收益为 ,远高于 NPV 要求 ,因此激励延迟部分 为 4.85 个月。这比命题 1 中季度公司的日历项(平均 1.5 个月)更长。在第二行中,,因此门槛不再有约束力,只剩下 NPV 条件,如命题 4(b) 所述。
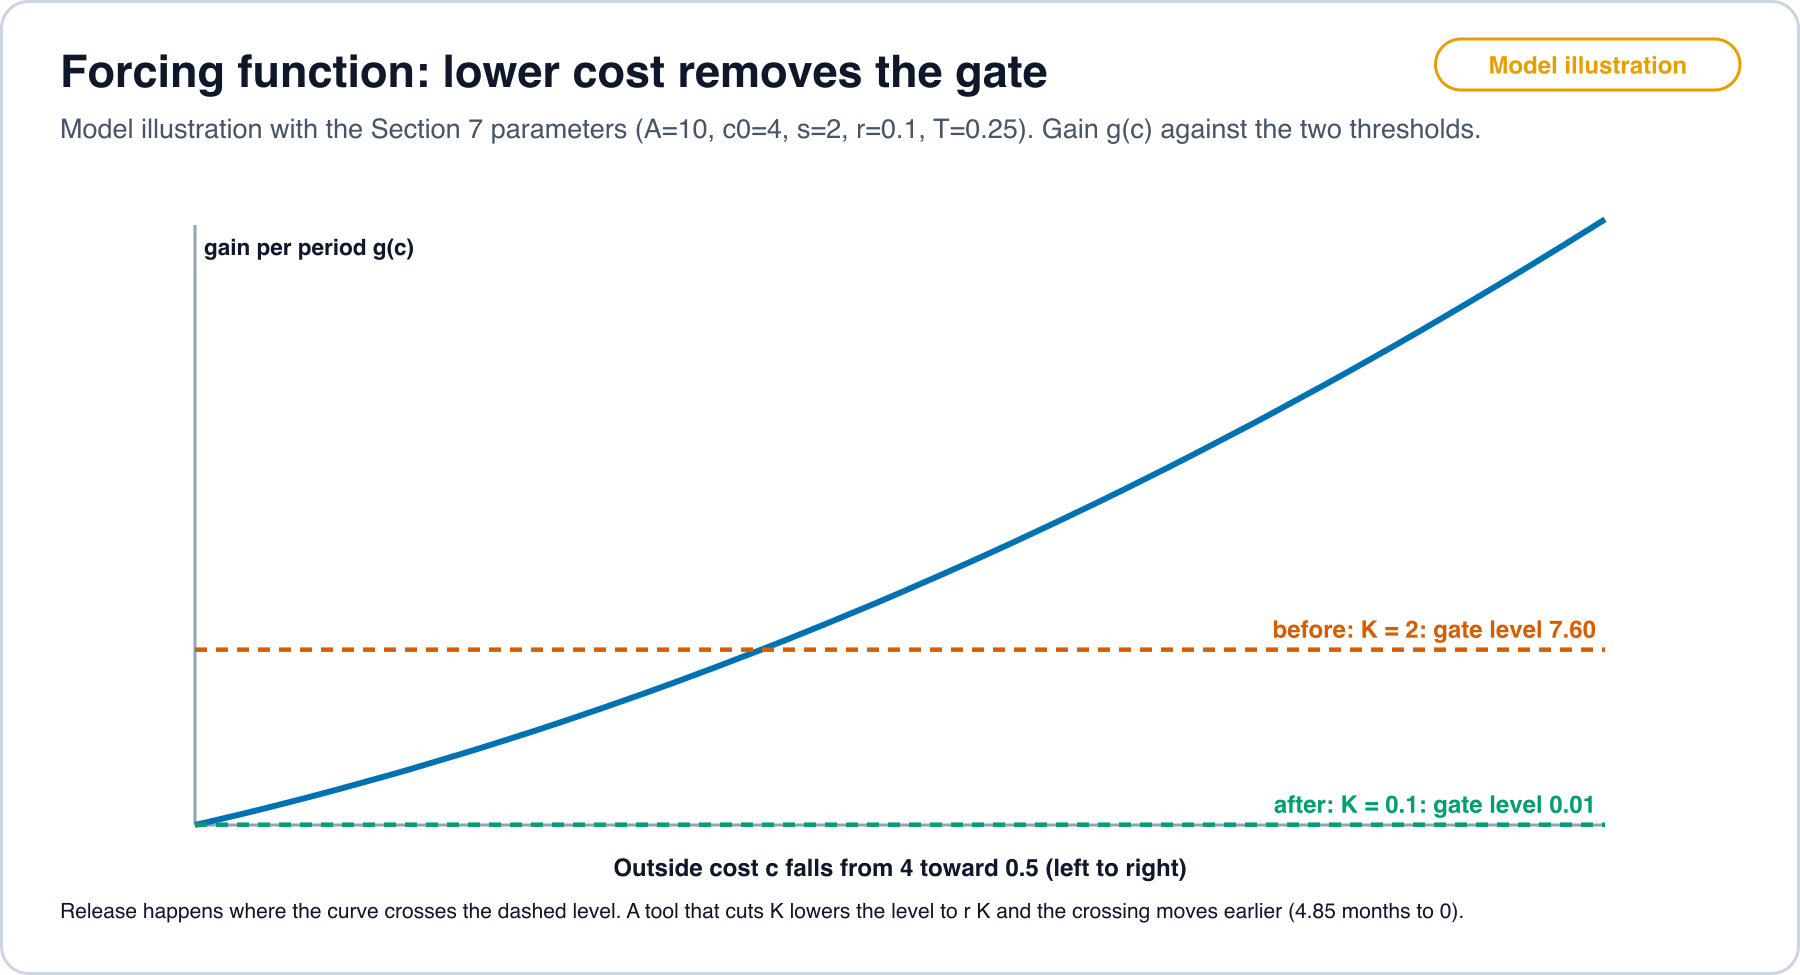
model_check.py 和表 2。 Open full size表 3. 发布后,。
| 价格 | 利润 | |||
|---|---|---|---|---|
| 4.0 | 6.00 | 1.50 | 8.00 | 2.00 |
| 3.0 | 5.00 | 1.67 | 10.00 | 3.00 |
| 2.0 | 4.00 | 2.00 | 12.00 | 4.00 |
| 1.0 | 3.00 | 3.00 | 14.00 | 5.00 |
| 0.5 | 2.50 | 5.00 | 15.00 | 5.50 |
利润随成本下降而上升,是因为线性需求让销量得以扩大。在需求饱和的情况下,利润一列会趋平,而关于利润率保持在 的论断不会改变。对命题 1 在 和均匀就绪下的模拟给出平均等待 0.1250,对照 ,方差 0.00521,对照 (200,000 次抽样,种子 7)。
8. 预测以及什么会推翻它们
每项预测都指明了数据、检验以及会构成反对模型证据的结果。各项预测都是在收集任何数据之前陈述的。
预测 1(日历聚集)。 采用季度报告的公司将先前公开的方法正式上市的日期,在季度内不是均匀分布的。检验: 对来自上市公司的至少 200 次发布的样本,计算每个日期在该公司财季内的相位,并应用 Rayleigh 和 Kuiper 均匀性检验。推翻条件: 在 200 个或更多独立样本下,相位均匀的原假设在 5% 水平上未被拒绝。
预测 2(上市公司对非上市公司)。 对于同一方法和可比难度,从开放发布到正式上市产品的中位延迟,上市公司比在报告日历之外获得融资的公司更长。检验: 按方法匹配的配对,以公司类型为处理变量,以发布时间的风险比为指标。推翻条件: 风险比(上市对非上市)的 95% 区间完全位于 0.8 以上。
预测 3(工具降低门槛)。 在一个降低移植成本的自动化工具可用于某个硬件或软件目标之后,该目标上从开放发布到正式上市的时间缩短。检验: 以该工具服务和不服务的目标做双重差分,以天为单位的发布延迟为结果变量。推翻条件: 估计变化的 95% 区间完全位于 天以上。30 天的边际是在收集数据之前作出的方案选择。
预测 4(价格跑赢成本)。 在测量了每项任务的焦耳成本和硬件成本的地方,标价与每项任务成本之比随测得成本的下降而上升。检验: 一个具有既定任务的服务面板,使用开放的能量测量和标价。推翻条件: 在成本下降 2 倍或更多的时期内,超过一半的任务中该比率持平或下降。
预测 5(支出转向摩擦)。 在每项任务成本下降的市场中,卖方收入中花在分销、默认设置和捆绑上的份额上升。检验: 申报文件和法院记录中披露的分销付款和捆绑条款与收入的对比。推翻条件: 在每项任务成本下降 2 倍或更多期间,该份额持平或下降。
预测 6(市场延迟跟随最快的公司)。 在买方能以低摩擦接触多个卖方的市场中,市场延迟接近公司延迟的最小值,而在测得摩擦较高的市场中,它更接近中位数。检验: 把市场延迟对测得的转换摩擦做回归。推翻条件: 摩擦斜率的 95% 区间完全位于零或零以下。
关于扩建的融资与成本的预测。 第 10 节和第 12 节中的预测涉及资金流和一个加速器小时的成本。它们在那两节中陈述,并用本文发表日期之后的申报文件和报价来检验。
什么会推翻模型本身。 如果发现上市公司的发布日期在季度内均匀分布(预测 1)、上市公司与非上市公司以同样的速度发布(预测 2),并且移植工具的出现不改变延迟(预测 3),那么日历或报告门槛就没有任何作用,定义 2 中的人为延迟在测量上为零。模型于是退化为工程延迟 。
9. 资金回路:申报文件记录了什么
对当前扩建的一种常见描述是循环经济:实验室向云服务商购买算力,云服务商和新兴云服务商购买芯片和内存,芯片制造商和云服务商投资于实验室。本节列出有日期的文件对这一描述说了什么。本节不给出结论。当申报文件、有日期的发布或官方统计陈述了金额和交易对手时,条目标为有记录;当在一个既定假设下由有记录的数字通过算术推出时,标为推断;当所阅读的来源没有说明时,标为未找到。
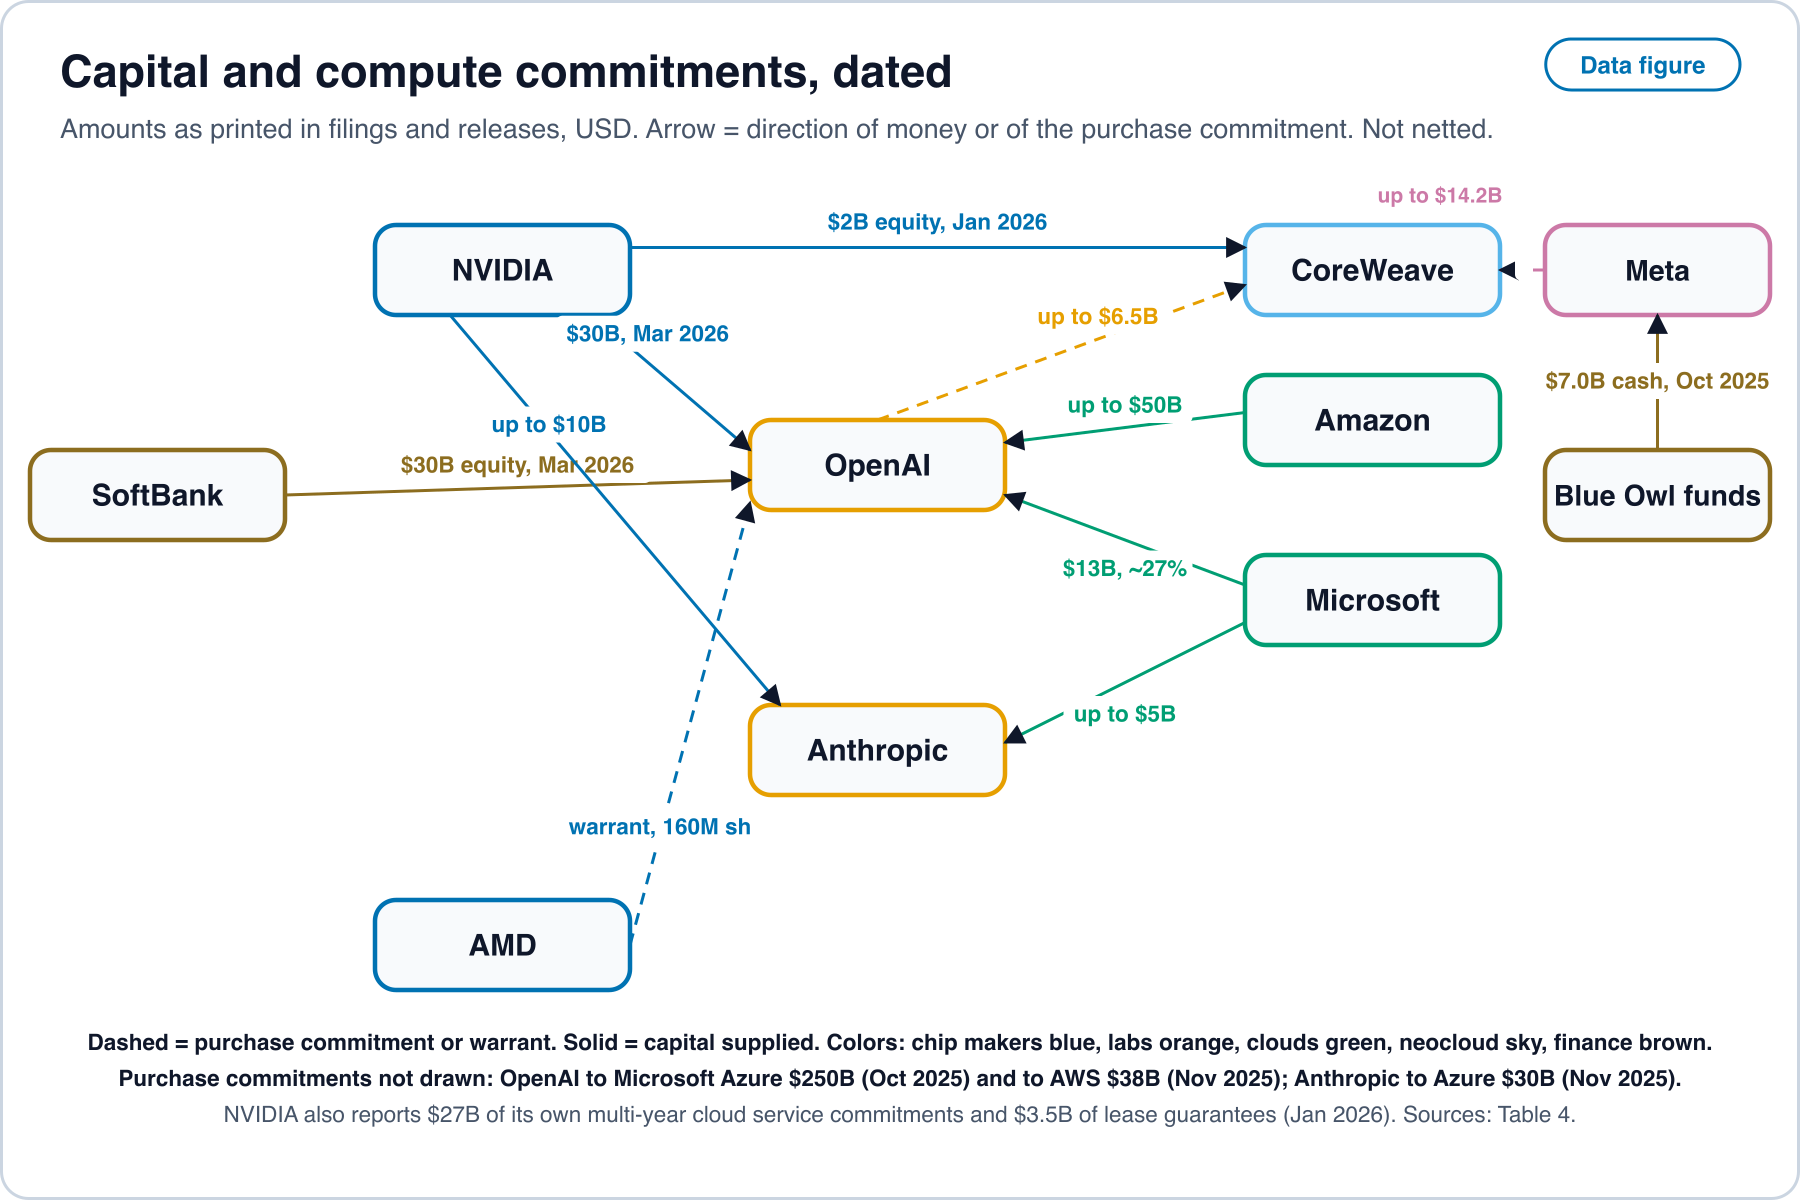
scripts/figures/latency_figures.py 及 latency_data/flows.csv;来源列于表 4。 Open full size向客户提供的资本。 在 OpenAI 于 2026 年 3 月完成的 1220 亿美元融资中,据报道 NVIDIA 出资 300 亿美元,Amazon 最多 500 亿美元,SoftBank 300 亿美元 [9]。一份较早的意向书曾说,NVIDIA 打算随着每吉瓦的部署逐步投资最多 1000 亿美元,这是意向陈述,而不是已完成的交易 [87]。Microsoft 报告持有 OpenAI 公益公司约 27% 的股份,以及按权益法核算的总计 130 亿美元的出资承诺 [7]。对于 Anthropic,NVIDIA 和 Microsoft 分别承诺投资最多 100 亿美元和 50 亿美元 [10]。NVIDIA 在 CoreWeave 2025 财年结束后购买了 20 亿美元的 CoreWeave A 类股票 [4]。AMD 向 OpenAI 发行了一份认股权证,可按每股 0.01 美元认购最多 1.6 亿股,分批归属,与 AMD Instinct GPU 产品的采购挂钩 [88]。
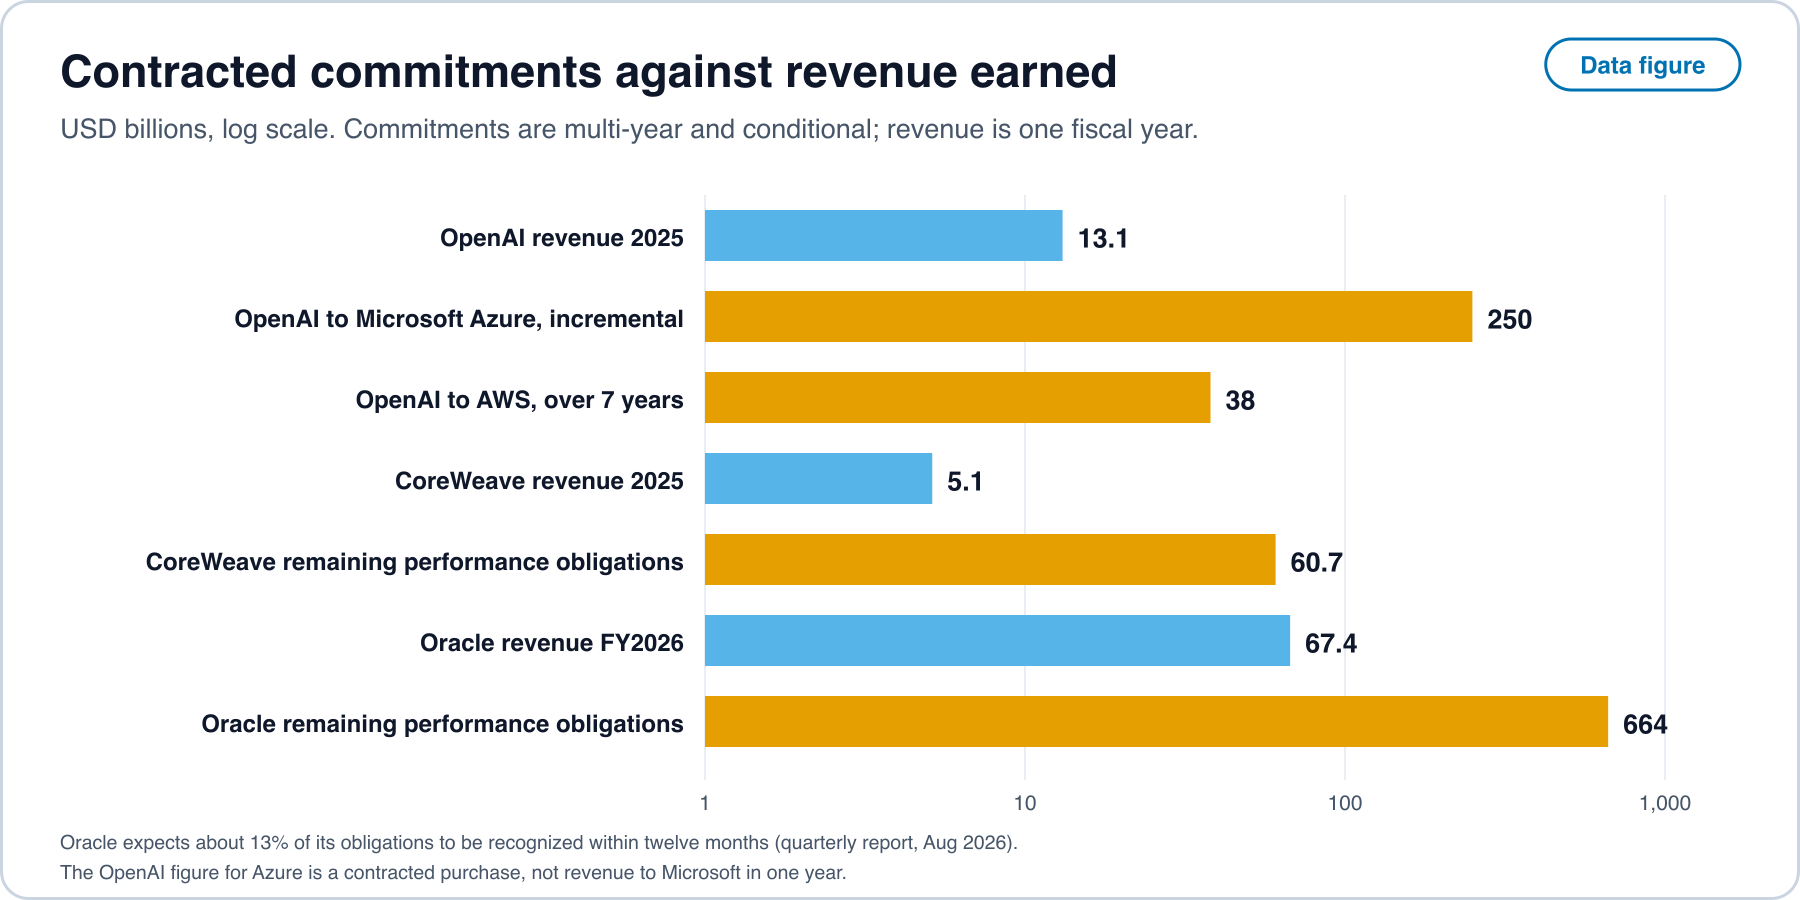
客户承诺的采购。 OpenAI 签约增购 2500 亿美元的 Azure 服务 [7, 89],与 AWS 签订了一份 380 亿美元的协议,公告称其将在七年内逐步增长 [8],并从 CoreWeave 购买最多 65 亿美元,而 Meta 与 CoreWeave 有一份最多 142 亿美元的订单 [4]。Anthropic 承诺购买 300 亿美元的 Azure 算力,并再签约最多一吉瓦 [10]。NVIDIA 自身报告了 270 亿美元的多年期云服务承诺,以及向早期合作伙伴提供的 35 亿美元土地、电力和厂房担保 [3]。
表 4. 什么有记录,什么是推断,什么是来源没有说明的。
| 条目 | 有记录 | 推断及其假设 | 在所阅读的来源中未找到 |
|---|---|---|---|
| 供应商对客户的股权投资 | 上述金额和日期 [9, 10, 4] | 未作推断 | 是否有任何股权以采购为条件,AMD 认股权证除外,其归属在申报文件中与 GPU 采购挂钩 [88] |
| 实验室向云服务商的采购 | OpenAI 的 Azure 2500 亿美元和 AWS 380 亿美元;Anthropic 的 Azure 300 亿美元 [7, 8, 10] | 若在七年内平均分摊,AWS 的数字平均约为每年 54 亿美元 | Azure 承诺的期限和爬坡;500 亿美元 Amazon 数字所附的条件 |
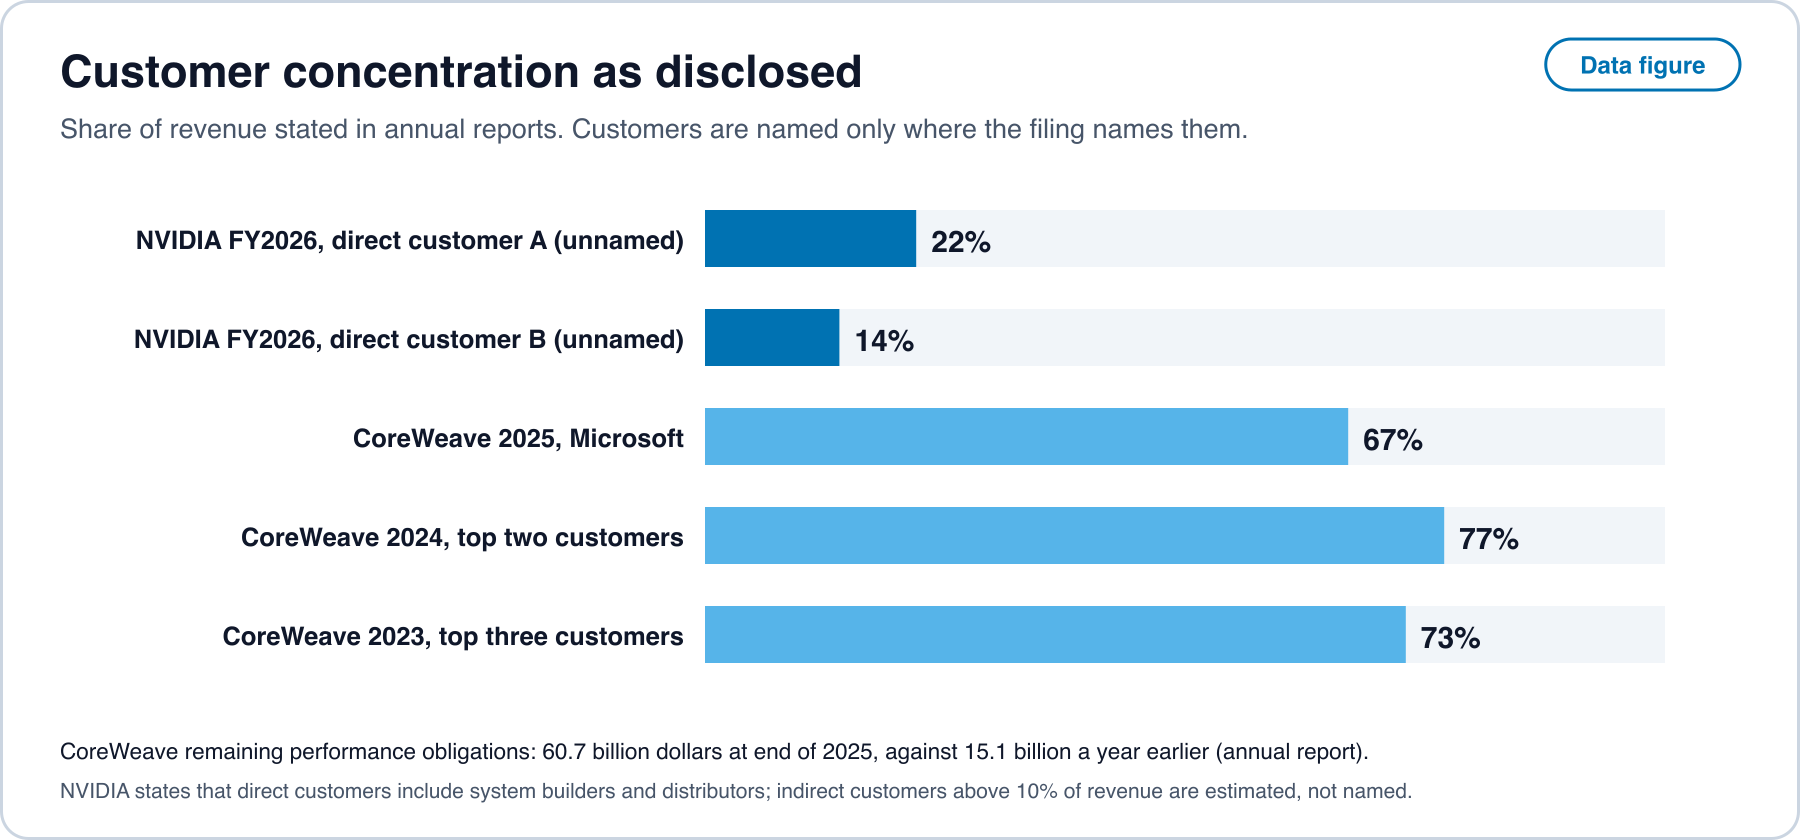
| 客户集中度 | NVIDIA 的直接客户占收入的 22% 和 14%,直接客户中包括系统集成商和分销商 [3];CoreWeave 中 Microsoft 占 2025 年收入的 67% [4] | 由披露份额得出的 Herfindahl 指数下界:NVIDIA 至少为 0.068,CoreWeave 至少为 0.449 | 谁站在 NVIDIA 的直接客户背后 |
| 客户预付款 | Oracle 来自含重大融资成分的客户预付款的递延收入在该季度增加了 114 亿美元,经营现金流为 231 亿美元 [5] | 该季度经营现金流约有一半来自预付款 | 哪些客户作了预付 |
| 合资企业层面的融资 | Blue Owl 旗下基金持有 Hyperion 园区合资企业 80% 的股份,Meta 持有 20%;这些基金出资 70 亿美元现金,而开发成本约为 270 亿美元 [2, 1] | 现金约为开发成本的四分之一 | 租赁条款、合资企业所筹债务以及担保 |
| 折旧年限 | 图 12 中所述的服务器年限 [4, 14, 15, 16, 17] | 把年限从 5 年改为 6 年,会使同一资产的直线法年折旧费降低六分之一 | GPU 在使用中实际达到的服役年限 |
| 现金资本支出与经营现金 | 图 8 中的年度序列 [11] | 两者之比 | 融资租赁和表外租赁 |
本表中的客户一词遵循每份申报文件自身的用法。资金是可替代的,因此一份申报文件可以表明资本流向了某个客户、该客户向供应商付了款,却不能表明前者资助了后者。第 10 节陈述了一个在这一限制内有效的检验。
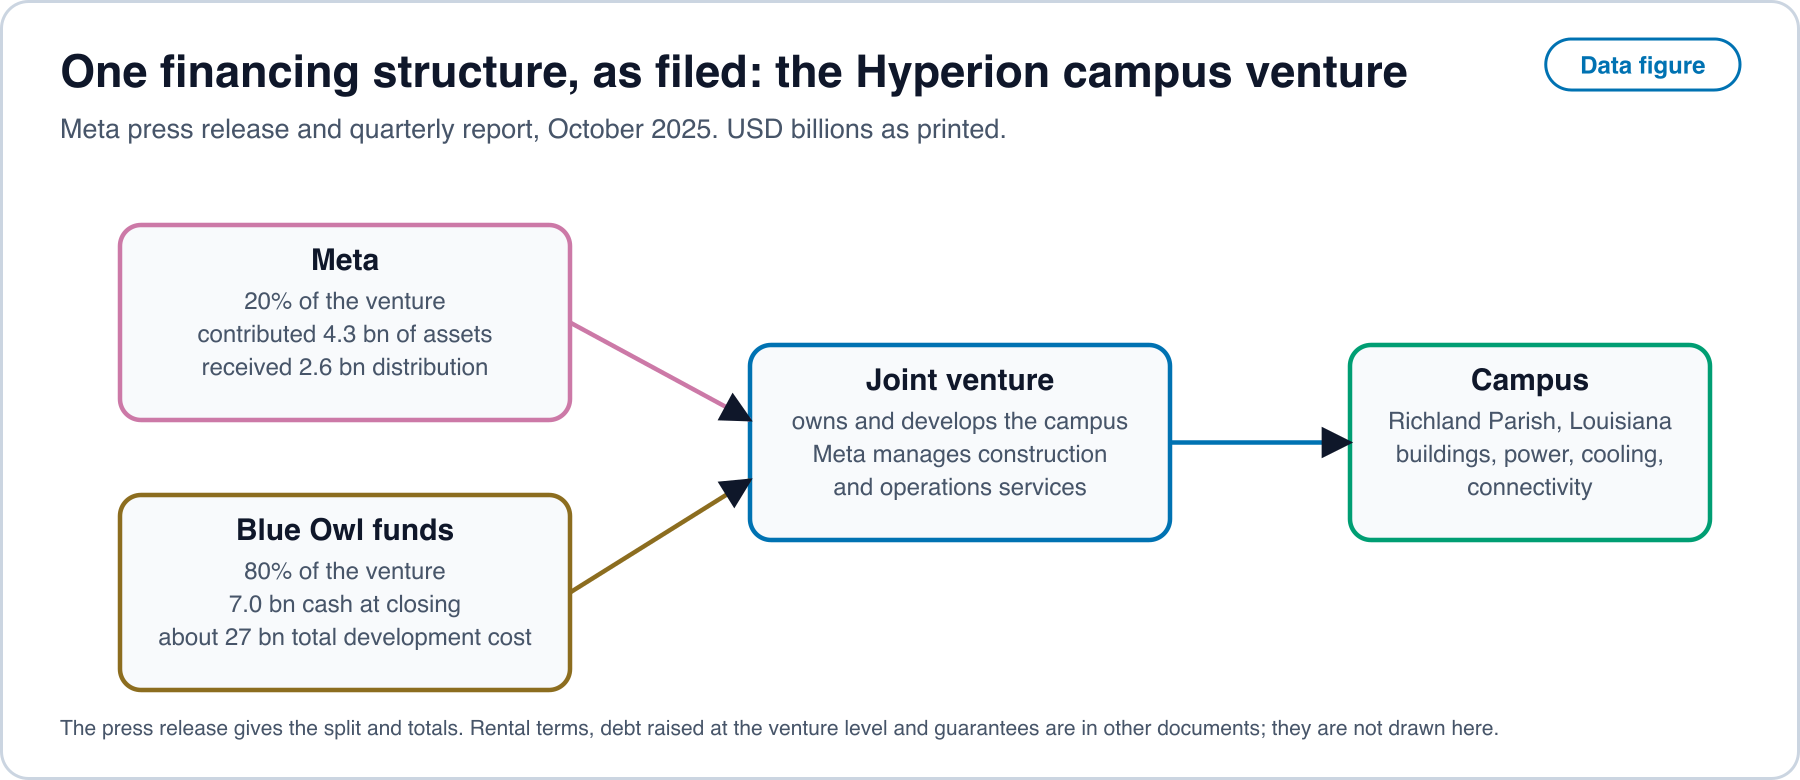
集中度与积压订单。 在高杠杆节点上,披露的客户份额很高,而在最大的芯片制造商那里较低。CoreWeave 报告其前三大客户占 2023 年收入的 73%,前两大客户占 2024 年的 77%,仅 Microsoft 一家就占 2025 年的 67% [4]。其 607 亿美元的剩余履约义务是其 2025 年收入 51.31 亿美元的 11.8 倍。Oracle 报告截至 2026 年 8 月 31 日的履约义务为 6640 亿美元,预计其中约 13% 将在未来十二个月内确认 [5, 6],而其 2026 财年收入为 674 亿美元 [11]。OpenAI 报告 2025 年收入为 131 亿美元,并在 2026 年 3 月称收入速率为每月 20 亿美元 [9]。签约采购是多年期的,并以这些数字未显示的条款为条件,因此它们不是某一年的收入,也不能与上述数字相加。
实验室也在别处采购。 Anthropic 宣布计划使用最多一百万个 TPU,价值数百亿美元,2026 年的容量远超一吉瓦 [90]。OpenAI 宣布计划部署 10 吉瓦自行设计的加速器 [91],并持有上述 AMD 认股权证。一个向多家供应商采购并自行设计部件的实验室不是其中任何一家的单一客户,这对下一节中的界很重要。
10. 一个封闭回路检验及其预测
文件本身无法回答的问题是:供应商的收入中有多少是用供应商自己提供的资金支付的。下面的检验把这个问题转化为申报文件可以给出界的量。
对于一个窗口 (一个财年),令 为供应商 向客户 提供的资本(股权、贷款、担保、按发行时估值的认股权证),令 为 从 获得的收入,令 为 的总收入,令 为 从所有来源筹集的资本。
定义 3(往返比率)。 ,即从同一交易对手每获得一美元收入所提供的资本。
定义 4(封闭回路份额上界)。 。客户用 自有资本向 支付的金额,不可能多于 所提供的,也不可能多于客户所支付的,因此 是 中可能由 自有资本资助的份额的上界。客户一侧的对应量是 ,即 筹集的资本中来自其自身供应商的份额。两者都是由披露数字计算出的界。它们不是对实际发生情况的估计,因为资金是可替代的。
命题 7(供应商融资的采购何时划算)。 令供应商 以价格 销售,单位成本为 ,毛利率为 。令它提供资本 ,诱发销量 中原本不会发生的份额 ,并令它从所持股份中收回价值 。增量利润为 。如果 全部花在 身上,即 ,则 当且仅当 ,其中 。
推导。 代入 ,解 。(手工推导,未经机器检查。)
推论。 由于 ,只有当 时,供应商融资才能仅凭诱发的销售而划算。按 NVIDIA 报告的 2026 财年毛利率 71.1% [3],所持股份必须预期至少收回 28.9% 的资本。在收回率为 0、25%、50%、75% 和 100% 时,盈亏平衡诱发份额 的模型输出为 1.41、1.05、0.70、0.35 和 0,因此在没有收回的情况下,任何诱发销售份额都不够。
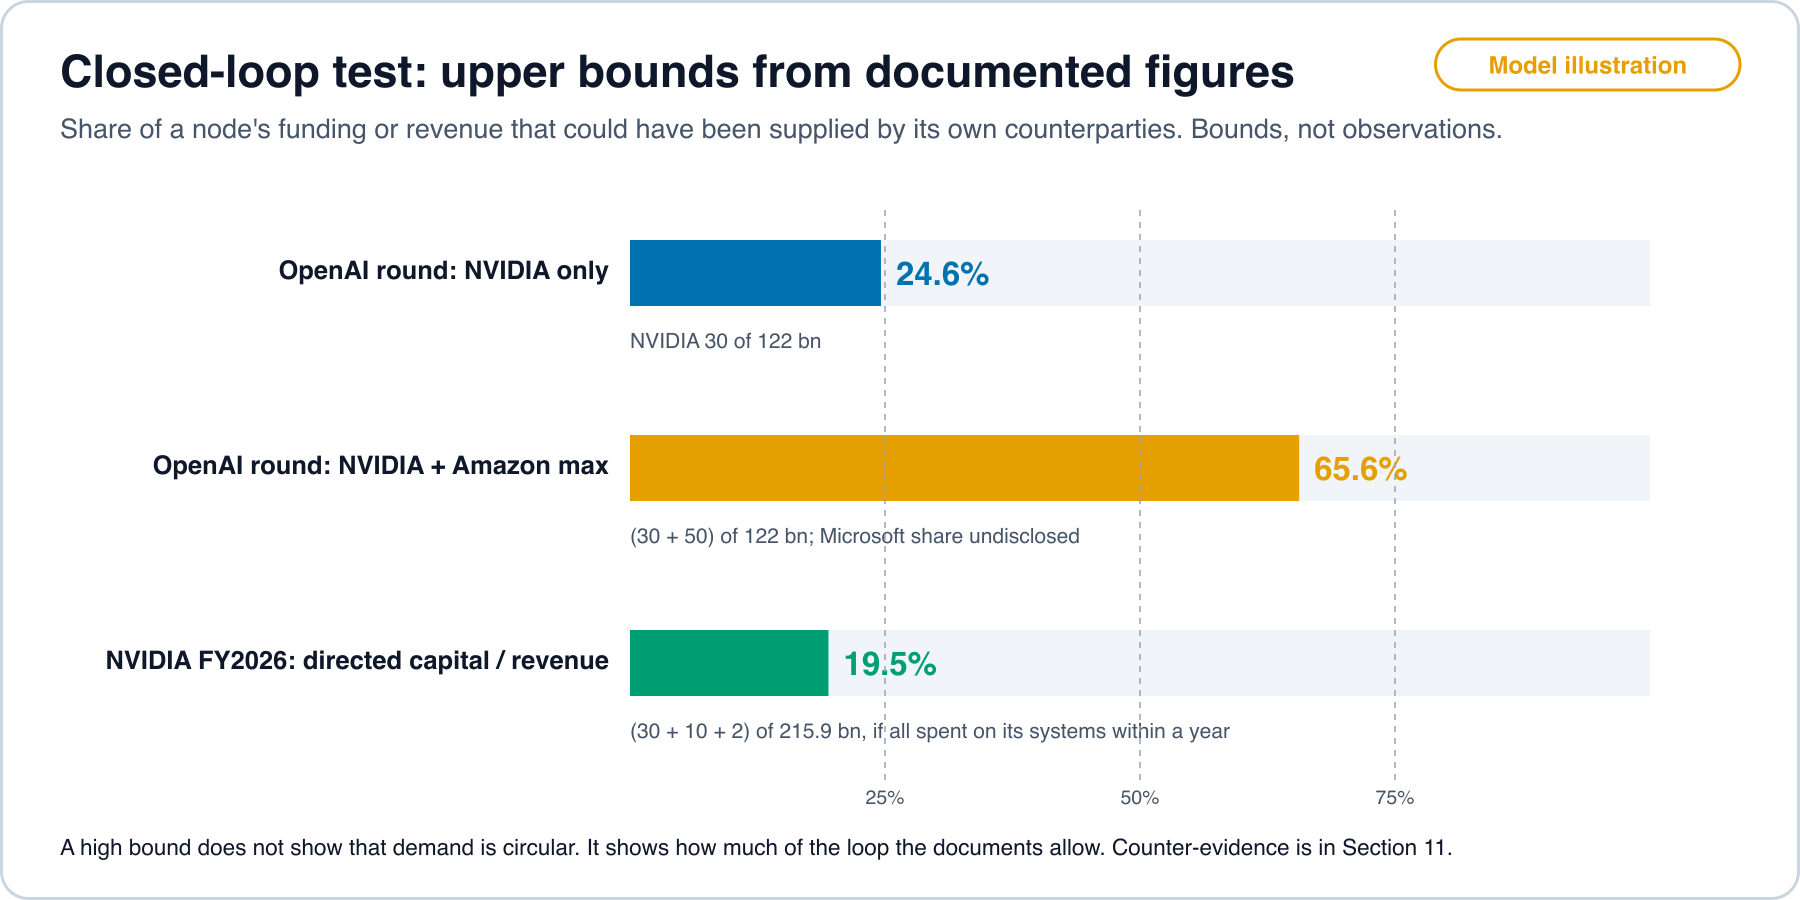
latency_data/model_outputs.json,由 model_airace.py 根据 [9, 10, 4, 3] 计算。 Open full size由文件得出的界。 NVIDIA 在 OpenAI 融资中的份额至多为 24.6%,加上按所述最大值计的 Amazon,两者至多达到 65.6%,Microsoft 的部分未披露(模型输出)。NVIDIA 在 2025 年 11 月至 2026 年 3 月间宣布或据报道向客户提供的资本为 420 亿美元(OpenAI 300 亿,Anthropic 最多 100 亿,CoreWeave 20 亿),相当于其 2026 财年收入 2159 亿美元的 19.5%,以及其经营现金流 1027 亿美元的 41% [3, 11]。第一个数字是规模上的比较,因为金额与收入所属年份不同。作为界来解读,它意味着:即使这些资金中的每一美元都在一年内回流为 NVIDIA 的收入,那一年收入中至多约五分之一是由 NVIDIA 自有资本资助的。
预测。 每项预测都指明了数据、检验以及会构成反对该论断证据的结果。这些预测是在阅读上述申报文件之后写下的,并用本文发表日期之后的申报文件来检验。
预测 7(回路份额保持有界)。 对于每个有披露的定向资本的芯片或云供应商,由每份年度报告计算的 保持在 0.25 以下,同时来自未获得定向资本的客户的收入增长至少与来自获得定向资本的客户的收入增长一样快。检验: 年度申报文件,在申报文件指明客户的地方列出客户名称。推翻条件: 某一财年中 超过 0.5,或收入增长集中于获得定向资本的客户。0.25 至 0.5 之间的值不能下结论。
预测 8(终端用户收入的增长超过承诺)。 对于一个实验室,签约采购与过去十二个月收入之比在连续四个季度中下降,同时收入上升。检验: 实验室的陈述和云服务商的积压订单披露。推翻条件: 该比率连续四个季度上升。
预测 9(压力首先出现在集中度和杠杆最高的地方)。 当一个实验室下调一项算力承诺时,供应商节点上业绩指引修订的幅度按其披露的最大客户份额排序。检验: 任何此类事件之后的业绩指引修订,按披露的最大客户份额排序。推翻条件: 排序与集中度无关。
预测 10(替代降低每美元收入所承诺的容量)。 在开放方法和更便宜的硬件降低每项任务加速器时间的地方(第 12 节),每美元实验室收入所承诺的吉瓦数下降。检验: 按季度统计的已宣布容量和实验室收入。推翻条件: 每美元收入所承诺的吉瓦数连续四个季度上升,同时在开放基准上测得的每项任务加速器时间也在下降。
11. 最有力的反面证据
认为扩建主要是一个封闭回路的解读,遇到了四组指向相反方向的文件,以及一组指向脆弱性的文件。
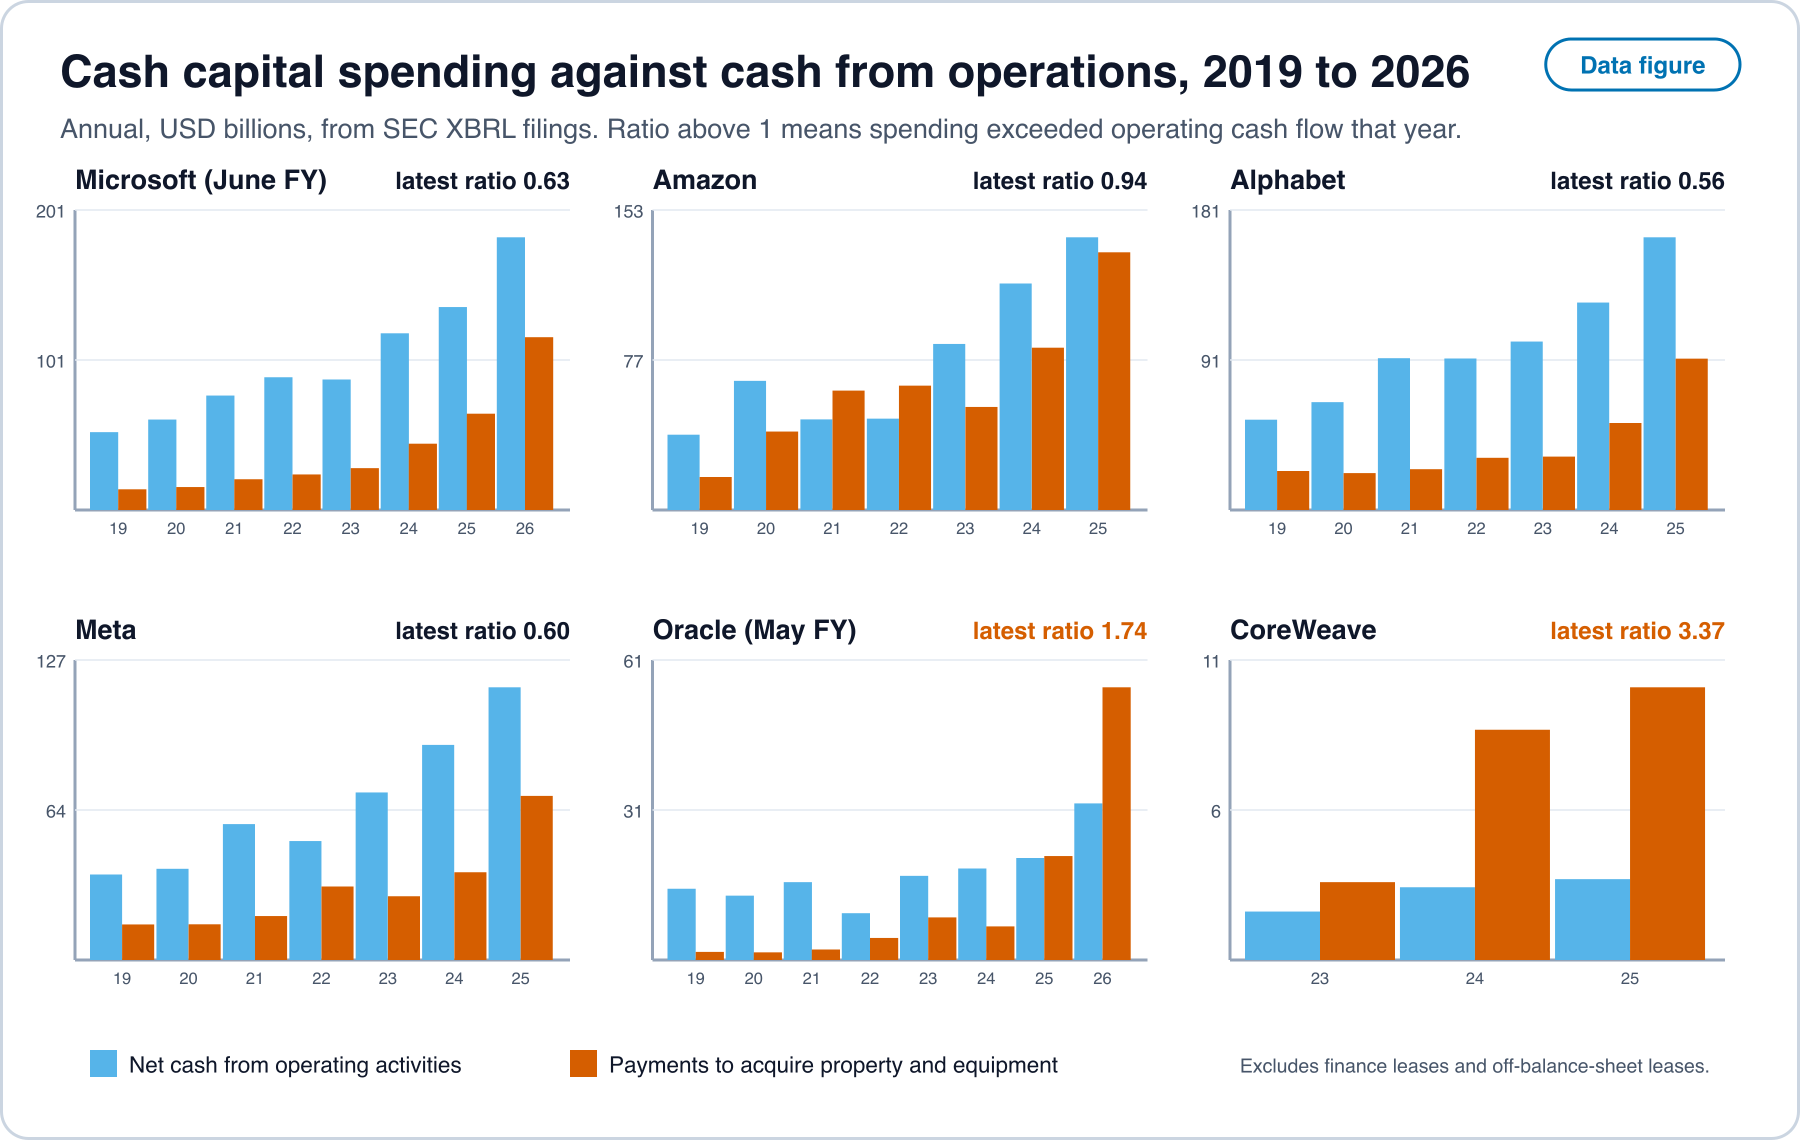
在最大的买方那里,大部分支出来自经营。 在最近的财年中,现金资本支出与经营现金流之比在 Microsoft 为 0.63,Amazon 为 0.94,Alphabet 为 0.56,Meta 为 0.60 [11]。支出规模很大,而它是用这些公司从其他业务赚取的现金支付的。
latency_data/capex_ocf.csv 中的 SEC XBRL 年度序列 [11]。 Open full size最大的芯片供应商可以用自有现金为其定向资本提供资金。 上述 420 亿美元相当于 NVIDIA 一年经营现金流的 41% [3, 11],其两个最大的直接客户分别占收入的 22% 和 14%,其中包括系统集成商和分销商 [3]。
在所阅读的报表中,来自终端用户的收入是真实的并在增长。 OpenAI 报告 2025 年收入为 131 亿美元,2026 年 3 月的收入速率为每月 20 亿美元,年化为 240 亿美元(算术)[9]。
实验室在分散化。 Anthropic 计划在其 Azure 和 NVIDIA 承诺之外使用最多一百万个 TPU,OpenAI 计划使用自有加速器并持有 AMD 认股权证,这意味着这里提到的实验室在其已宣布的计划中有不止一个芯片来源 [90, 10, 91, 88]。
反面证据没有消除的东西。 Oracle 在 2026 财年的现金资本支出是经营现金流的 1.74 倍,CoreWeave 在 2025 年是 3.37 倍 [11]。Oracle 截至 2026 年 8 月 31 日的季度显示经营现金流为 231 亿美元,其中 114 亿来自客户预付款,自由现金流为负 50 亿美元 [5, 6]。CoreWeave 的履约义务是其收入的 11.8 倍,其客户群高度集中 [4]。这些是实验室资金缺口最先到达的节点,这正是预测 9 所检验的。
就文件所及的净解读。 具名供应商与客户之间有记录的回路规模达数百亿美元。文件把最大芯片供应商收入中可能由其自有资本资助的份额限定在五分之一以下,并表明超大规模云服务商的大部分支出是用经营现金支付的。高度集中和高杠杆的节点,即一家有预付款的云服务商和一家有单一主导客户的新兴云服务商,是回路假设最为关键的地方。私人协议的条款不公开,因此文件给出的是界,而不是测量。
12. 一项任务的成本:基础设施成本模型
第 0 节把每项任务成本定义为 。本节根据一个加速器小时的成本填入 和 ,并把结果与 、 和 联系起来。
加速器小时。 令 为每台加速器的资本,包括设施、电力和冷却所分摊的份额,直线法折旧年限为 年,利用率为 。每已利用小时的资本为 。令 为每台加速器的设施功率(千瓦), 为每千瓦时的电价。一项占用 个已利用小时的任务的成本为
命题 8(计入资本的焦耳价格)。 在硬件固定时,,其中 (按每千瓦时当量计),因此每项任务焦耳数仍然是正确的核算单位,而且只要 ,把焦耳换算为美元的价格就由 主导。推导。 在两个表达式之间消去 。(手工推导。)
输入。 Epoch AI 数据中心数据集对同时具有两项数字的 74 个站点给出,每个 H100 当量的资本中位数约为 33,300 美元,设施功率为 880 瓦,每个 H100 当量的资本从约 19,600 美元到约 200,800 美元不等 [12]。这些是根据公开许可证和影像构建的估计值,一个站点所列的资本包括算力、建设和装修。
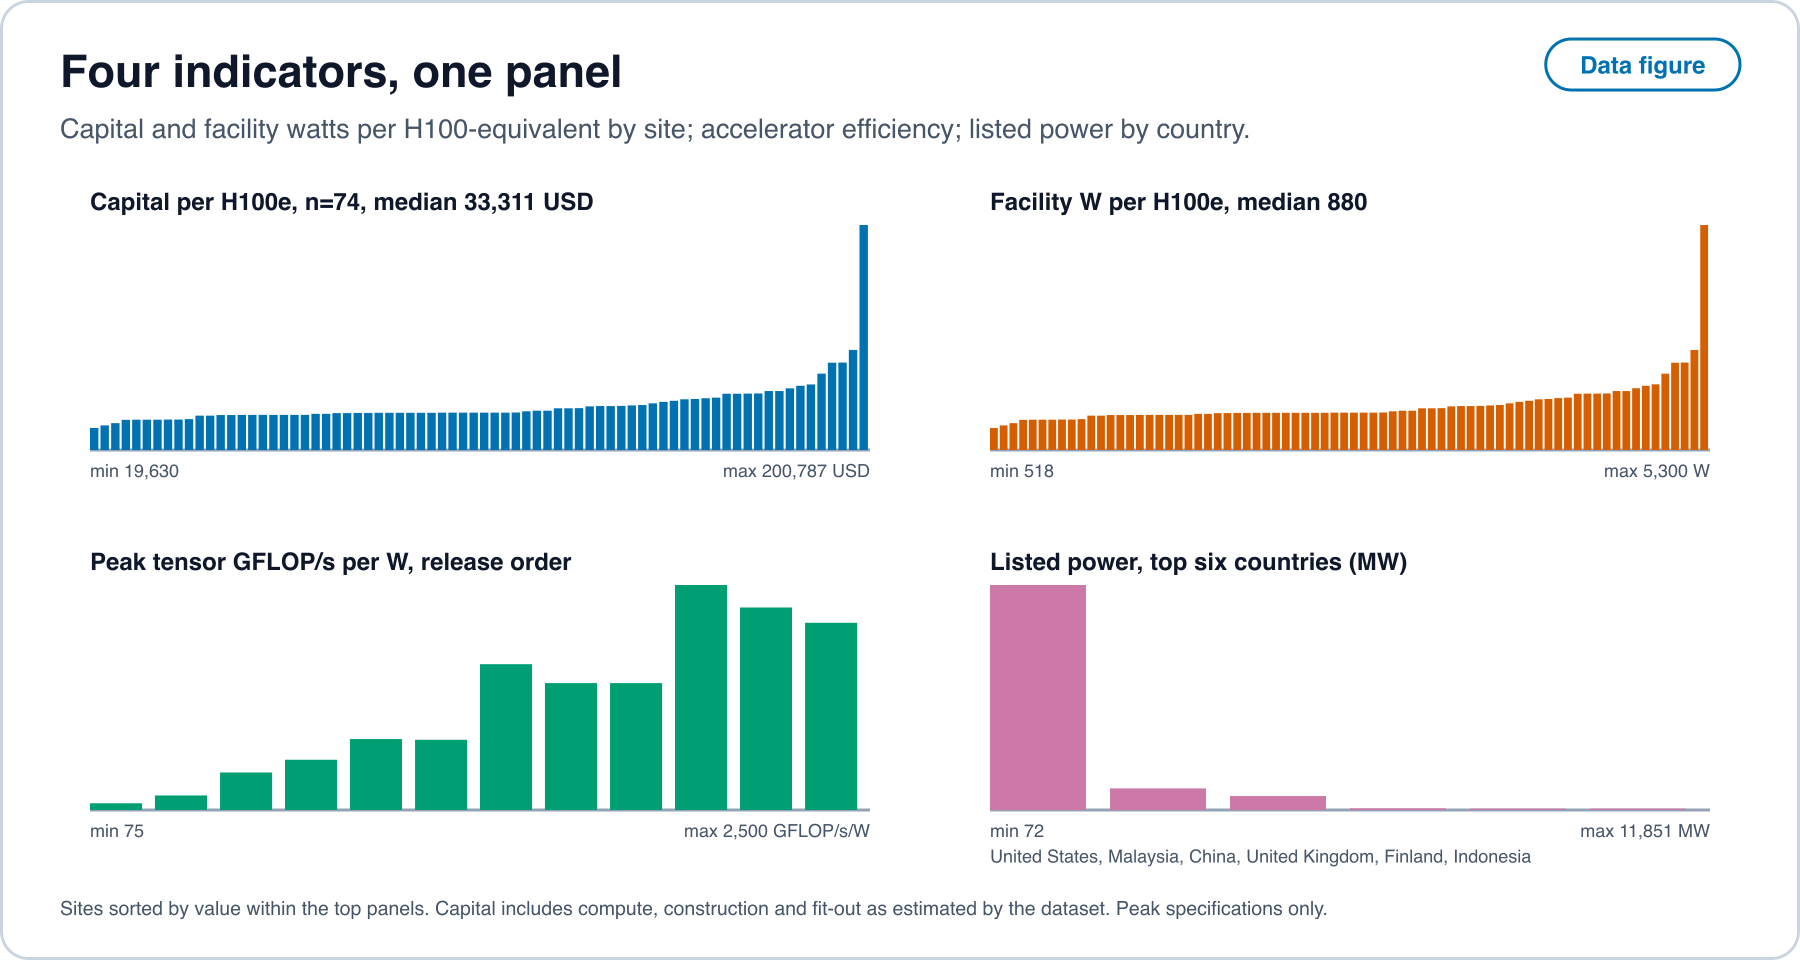
latency_data/frontier_dc_cost_per_h100e.csv、hardware_flops_per_watt.csv、frontier_dc_by_country.csv [12, 13]。 Open full size模型输出。 在 4 到 6 年的年限、40% 到 80% 的利用率以及每千瓦时 0.04 到 0.12 美元的电价下,一个已利用加速器小时的成本约在 0.83 到 2.5 美元之间,其中能量占 1.5% 到 11.8%。计入资本的价格 约为每千瓦时当量 0.9 到 2.7 美元,而电价为 0.04 到 0.12,因此 由资本主导,约为电价项的 8 到 70 倍。
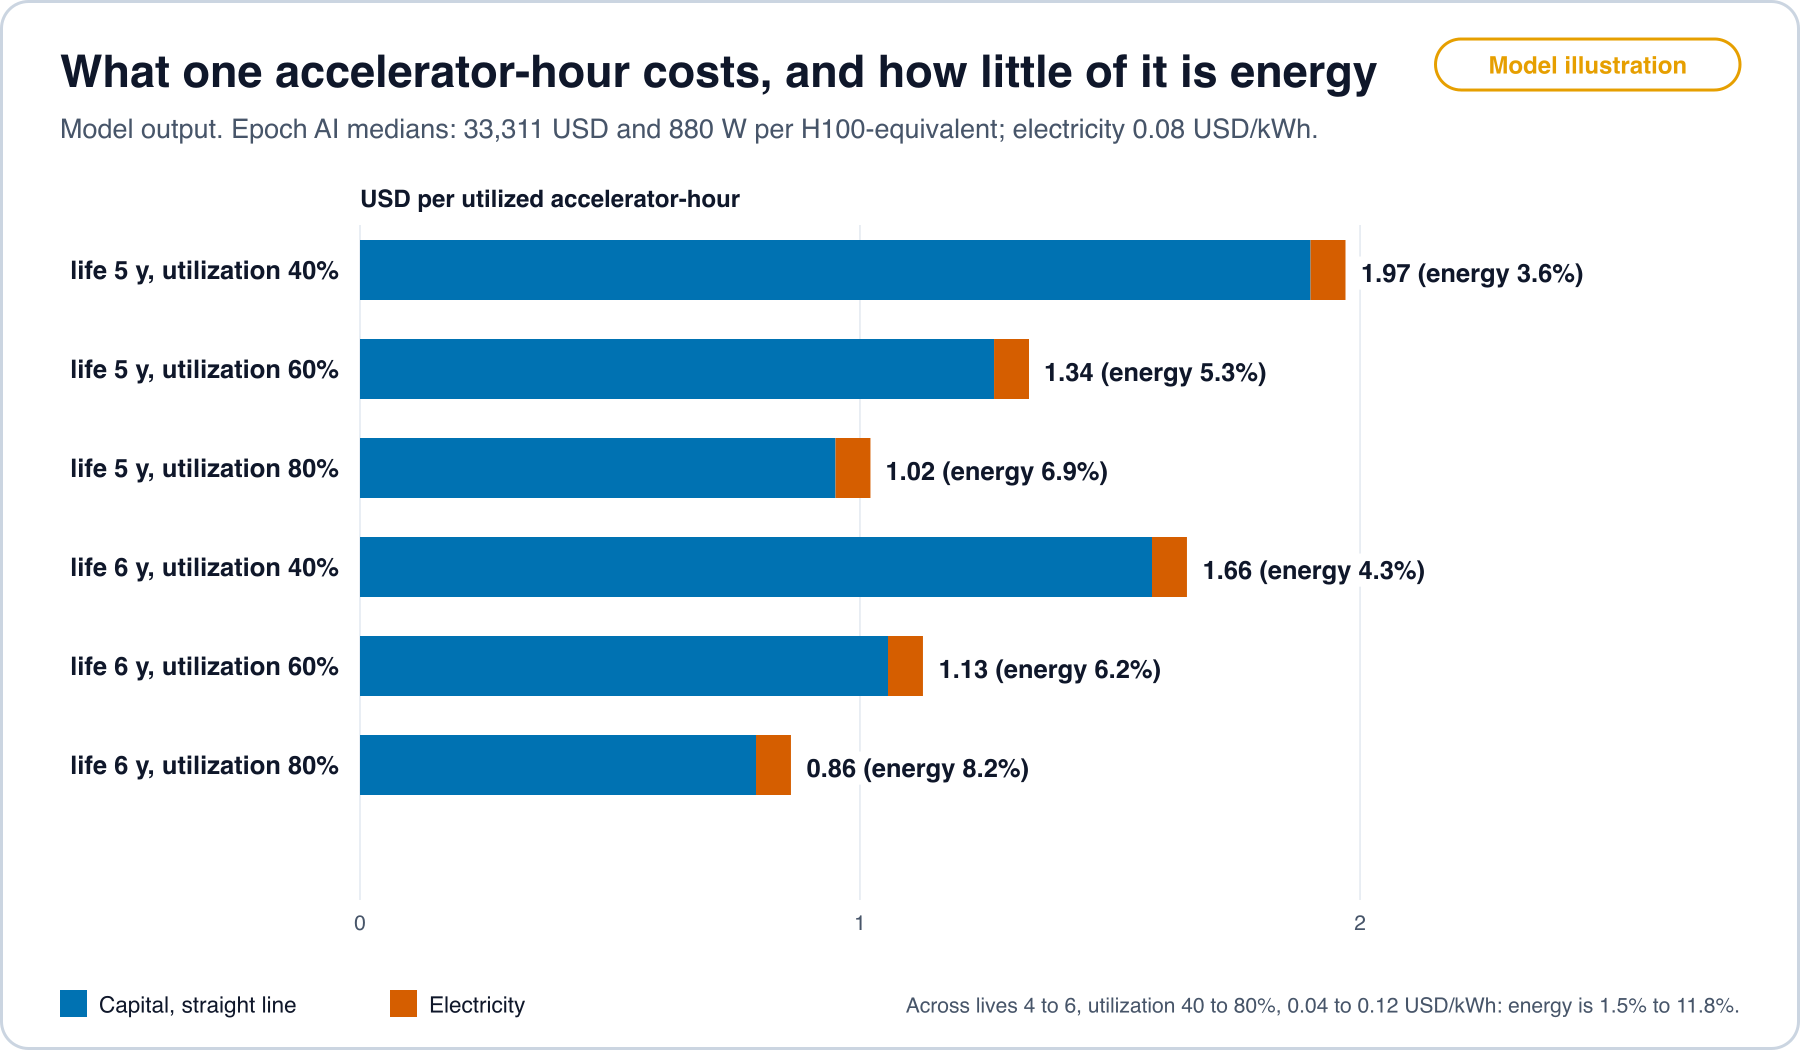
latency_data/model_outputs.json,由 model_airace.py 根据 [12] 计算。 Open full size由此得出三个推论。更便宜的电力至多能把一项任务的成本降低能量所占的份额,在这个网格中至多约为八分之一。利用率与能量同样重要: 减半会使 翻倍。而所述年限 是一个会计选择,它使 按 的比例变动。
年限与效率。 根据厂商自己的规格,2016 年至 2024 年间十二款领先加速器的每瓦峰值张量运算数每年增长约 1.42 倍,大约每两年翻一番 [13]。一个受电力限制的站点如果把一个部件换成新三年的部件,在同样电力下将获得约 倍的峰值运算。峰值规格不是每项任务实际交付的能量,因为交付的数字由利用率、内存流量和软件决定。图 12 中所述的服务器年限在几家大公司为 5 到 6 年,在其他公司所述的范围更宽。当旧部件以新部件所定的价格继续获利时,这种长度的年限与两年一次的效率翻番是相容的,这是关于价格而不是关于物理的论断。
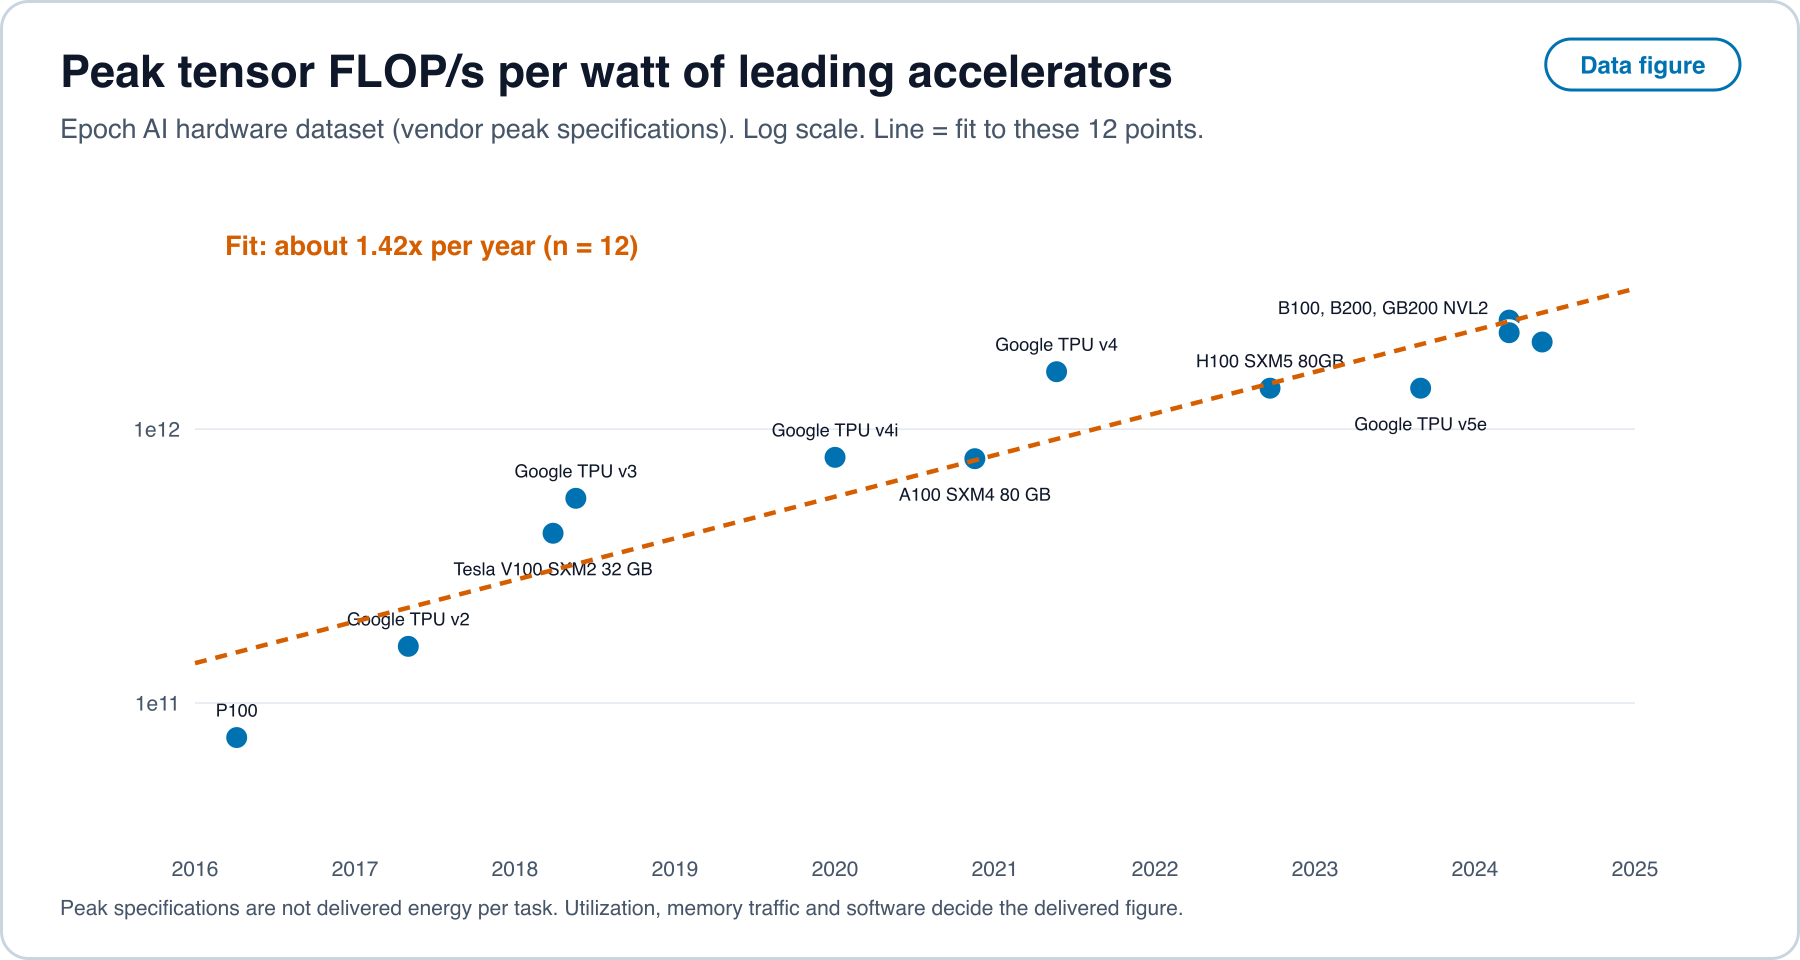
latency_data/hardware_flops_per_watt.csv 和 hardware_fit.json [13]。 Open full size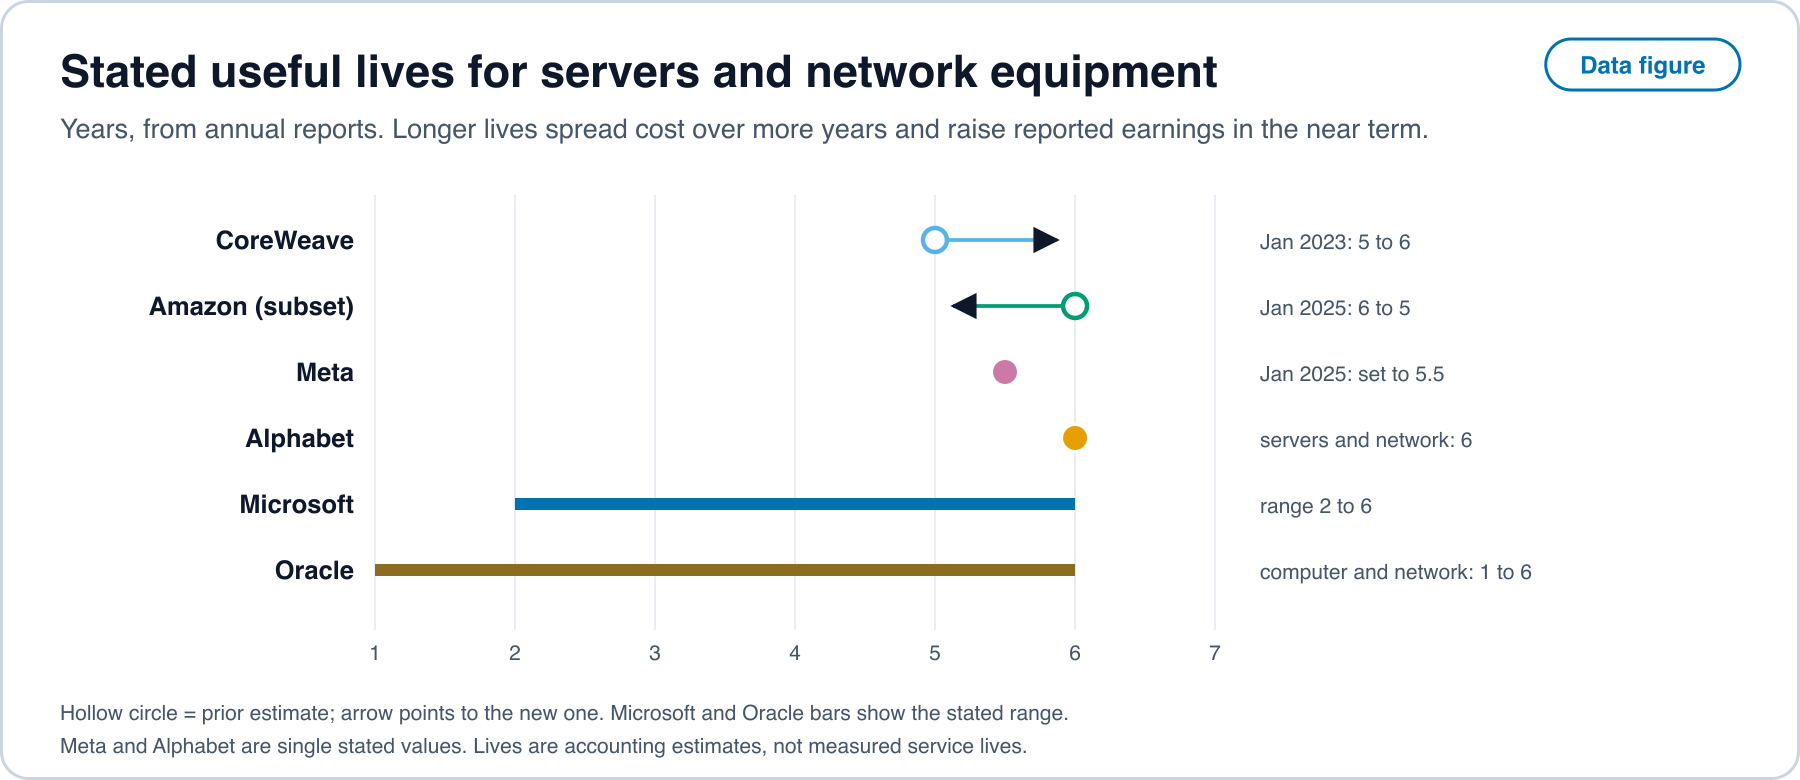
价格不等于成本。 对于 GPT-3.5 水平的系统,推理价格在 2022 年 11 月至 2024 年 10 月间下降了 280 多倍,而硬件成本每年下降 30%,硬件能效每年提高 40% [18]。在该窗口的 1.9 年中,这些速率给出硬件成本约 2.0 倍、能效约 1.9 倍(模型输出)。280 除以 2.0 剩下约 141 倍,是硬件成本无法解释的。这个余数混合了更小的模型、算法效率、利用率和利润率,而来源没有对其进行分摊。Epoch AI 另外估计,达到固定语言模型性能所需的算力大约每 8 个月减半 [58],而达到固定基准水平的价格每年下降 9 到 900 倍,中位数接近 50,最快的速率所依据的数据不足一年 [59]。
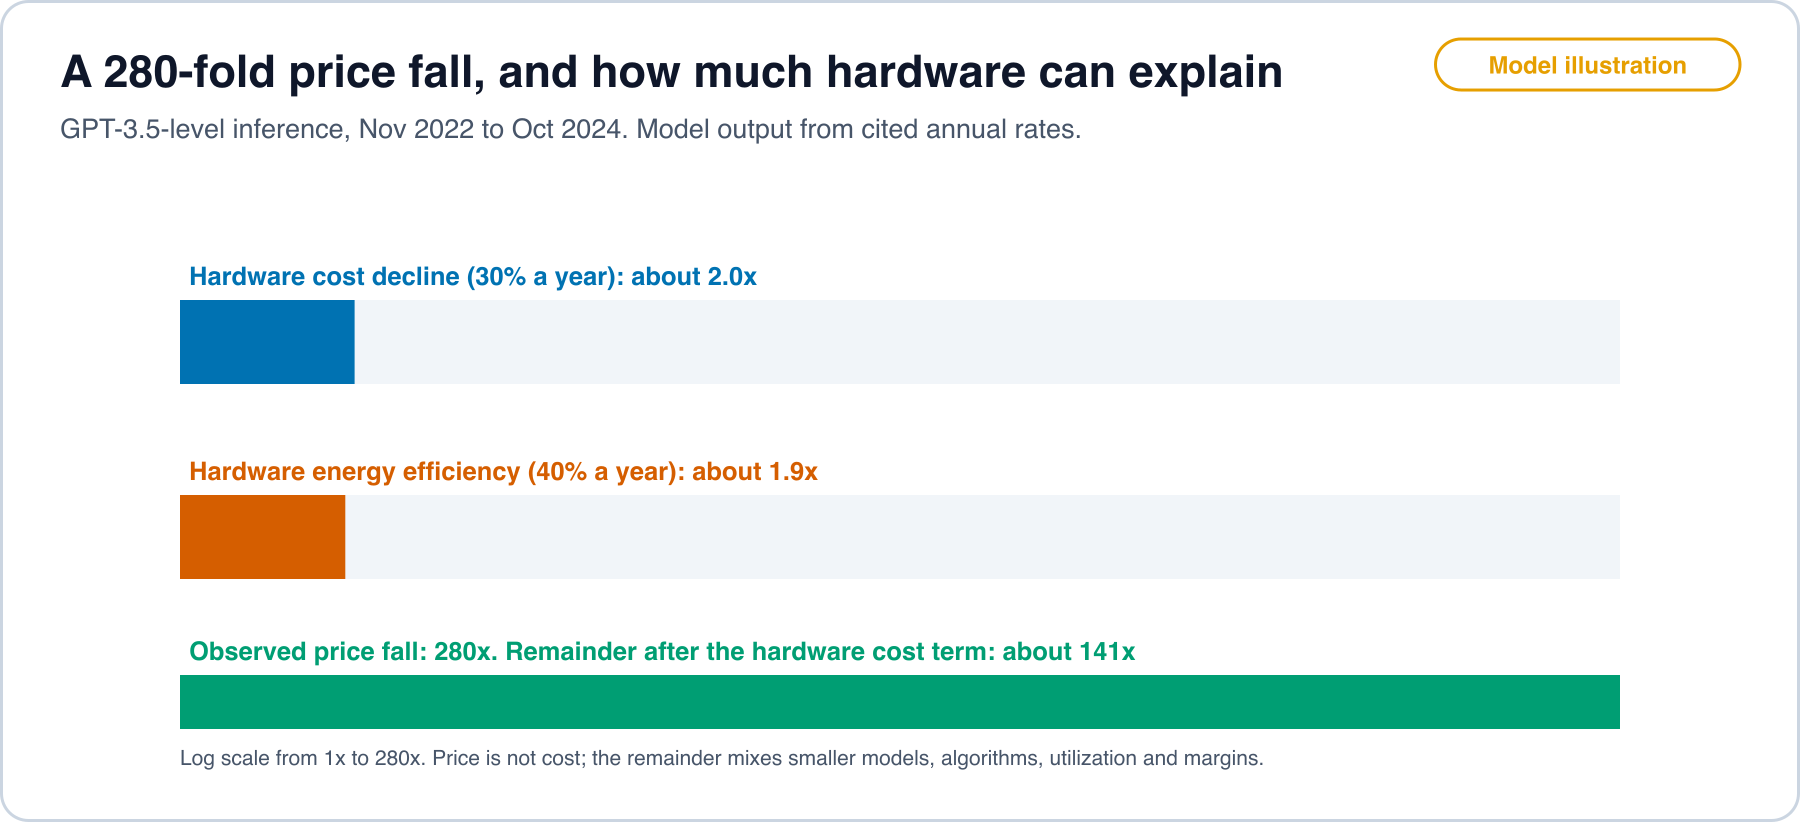
latency_data/model_outputs.json。 Open full size与前沿的联系。 令 为有文献记载的方法中质量为 时最低的每项任务加速器时间, 为正式上市产品中的该时间。则能力前沿为 ,部署前沿跟随所提供的价格,该价格至少为成本加上第 6 节的利润率。硬件成本以同样方式进入 和 ,因为供应商和买方都从同一市场采购,所以它使两个前沿一起移动,而让 几乎不变。延迟由软件项 改变:一种把每项任务加速器时间缩减 倍的方法,在发表时就使 降低该倍数,而只有当产品采用它时才使 降低。在等待期间,部署成本与能力成本之比为 。
与节奏模型的联系。 资本以多年为步长承诺,并在数年的年限内摊销,因此硬件的决策日期相隔很远,而第 6 节的采用成本 包含一种新方法会搁浅或会节省的已安装资本的价值。一种在公司已拥有的硬件上运行的方法,其采用成本主要是工程成本。一种需要新硬件的方法则连带着资本周期。这就是为什么在现有部件上的开放软件方法受门槛限制最少,也是为什么预测 3 比较有移植工具和没有移植工具的目标。
成本在何处不再跟随能力。 在固定质量 下,每项任务成本随 、硬件和价格而下降。在能力的前沿,每项任务成本由最大模型的训练和服务决定,不会以同样方式下降,这就是为什么前沿质量的任务和固定质量的任务有不同的成本曲线。上述数据只衡量前者。
预测 11(旧部件继续获利)。 如果所述服务器年限在经济上是现实的,那么已有数年历史的部件每加速器小时的租赁价格,下降得比每瓦峰值运算数所暗示的更慢。检验: 按部件和机龄分类的有日期的公开报价,对照图 11 中的效率拟合。推翻条件: 旧部件每单位峰值运算的价格下降得至少与效率拟合一样快。
预测 12(能量份额保持很小)。 在一个测得部署的样本中,在电价低于每千瓦时 0.12 美元时,能量在每项任务成本中的份额保持在 15% 以下。检验: 开放的推理能量测量 [56] 结合所列的加速器小时价格。推翻条件: 在多数部署中,测得的份额超过 15%。
13. 开放方法与达到同等水平的现有硬件
对当下的第二种描述是:开放的算法工作让现有的和更旧的基础设施达到与最新基础设施同等的表现。有日期的记录支持一个更窄的陈述,这里按每种方法作用的杠杆以及到上市使用的滞后来列出。
表 6. 开放方法、其有日期的论文以及后来的使用所显示的情况。
| 杠杆 | 开放方法及作者所报告的内容 | 发布 | 后来的使用 | 滞后 |
|---|---|---|---|---|
| 量化 | 1750 亿参数的模型在约四个 GPU 小时内被量化到每个权重 3 或 4 位,精度损失可忽略 [92] | 2022 年 10 月 | 2023 年报告 4 位本地推理在消费级机器上已切实可行 [68] | 未计算:后来的使用是另一种 4 位实现,其日期是观点类证据 |
| CPU 上的三值权重 | 一个 20 亿参数的模型,非嵌入内存为 0.4 GB,在 CPU 上每词元 29 ms,而六个规模相近的开放全精度模型为 1.4 到 4.8 GB 和 41 到 124 ms [26] | 2025 年 4 月 | 模型权重随论文发布 | 0 个月 |
| 注意力内核 | 通过计入内存层级之间的读写,使精确注意力更快 [19] | 2022 年 5 月 | PyTorch 2.0 发布中的加速注意力内核 [20] | 约 10 个月 |
| 服务内存 | 开放服务系统中的分页键值内存,在相同延迟下吞吐量高于先前的系统 [93] | 2023 年 9 月 | 源代码随论文发布 | 0 个月 |
| 状态空间与混合模型 | 一个无注意力模型,报告推理吞吐量为 Transformer 的 5 倍 [21];一个能装入一块 80 GB GPU 的混合模型,权重开放 [22] | 2023 年 12 月 | 该混合模型,2024 年 3 月;2024 年和 2025 年有更多混合模型 [39] | 约 3 到 4 个月 |
| 推测解码 | 输出分布不变,解码快 2 到 3 倍 [23] | 2022 年 11 月 | 到 2024 年 12 月据报告已用于 Google 产品 [24] | 约 24 个月 |
| 训练成本 | 完整训练用了 278.8 万 H800 GPU 小时,为自行报告 [46];通过强化学习进行推理,并蒸馏出较小的模型 [94] | 2024 年 12 月至 2025 年 1 月 | 较小的蒸馏模型随第二份报告发布 | 不适用 |
| 非 NVIDIA 服务 | 在 Ascend NPU 上的预填充效率为每 TFLOPS 每秒 4.45 个词元,高于 SGLang 在 H100 上和 DeepSeek 在 H800 上的已发表结果,未报告功率 [95] | 2025 年 6 月 | 作者的部署 | 不适用 |
滞后是从发布月份到后来使用的日期计算的,每一行只依据一组配对。它们是少数几个样本,不是一个分布,第 16 节的方案规定了如何收集大量样本。
按训练算力衡量的开放模型与封闭前沿。 以每个训练算力水平上的第一个知名模型为准,比较任意访问类型与开放权重,开放权重的滞后在 FLOP 时为 1 个月, 时为 30 个月, 时为 24 个月, 时为 15 个月,而在 上尚无开放权重模型的记录 [25]。每个水平都由一个模型率先跨越,因此滞后在每个水平上只依据一组配对。方向是滞后随水平升高而缩短,需要保留的是训练算力并不等于能力。
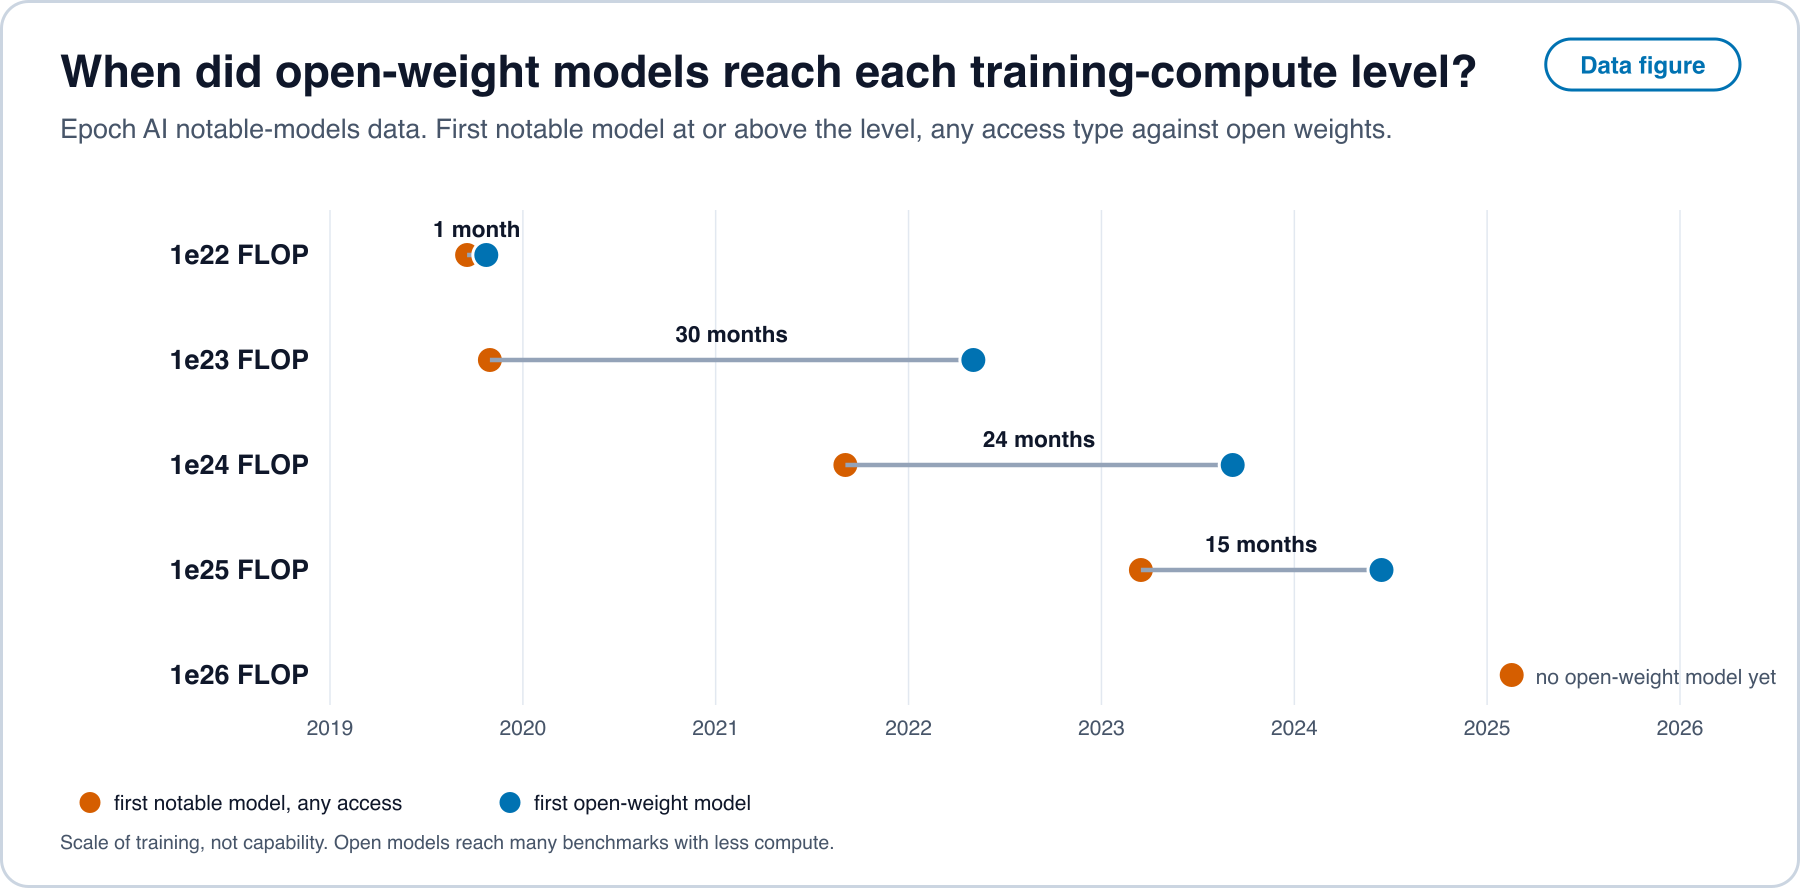
latency_data/compute_threshold_firsts.csv,来自 Epoch AI 知名模型数据集 [25]。 Open full size在消费级硬件上,能装入一块消费级 GPU 的开放模型平均在 6 到 12 个月后追平前沿,具体取决于指标 [63]。任意规模的开放权重模型在基准上落后封闭前沿约一年,范围为 5 到 22 个月 [64]。
这里的同等水平意味着什么。 它意味着相同的基准得分。它不意味着相同的吞吐量:一块消费级显卡运行一个流,而数据中心服务许多流,在那里批处理和内核很重要。量化和内核带来的收益在两者上都适用。达到固定性能所需的算力大约每 8 个月减半 [58],即每年 倍,约为图 11 中硬件效率每年 1.42 倍的两倍。在这一点成立的地方,在固定质量下算法进步跑赢硬件进步,较早购买的部件能产出比以前更多的给定质量的任务。这些额外的任务是以更低的价格出售,还是被需求得更多,是一个关于需求的问题,这里的来源没有一个能解决它。
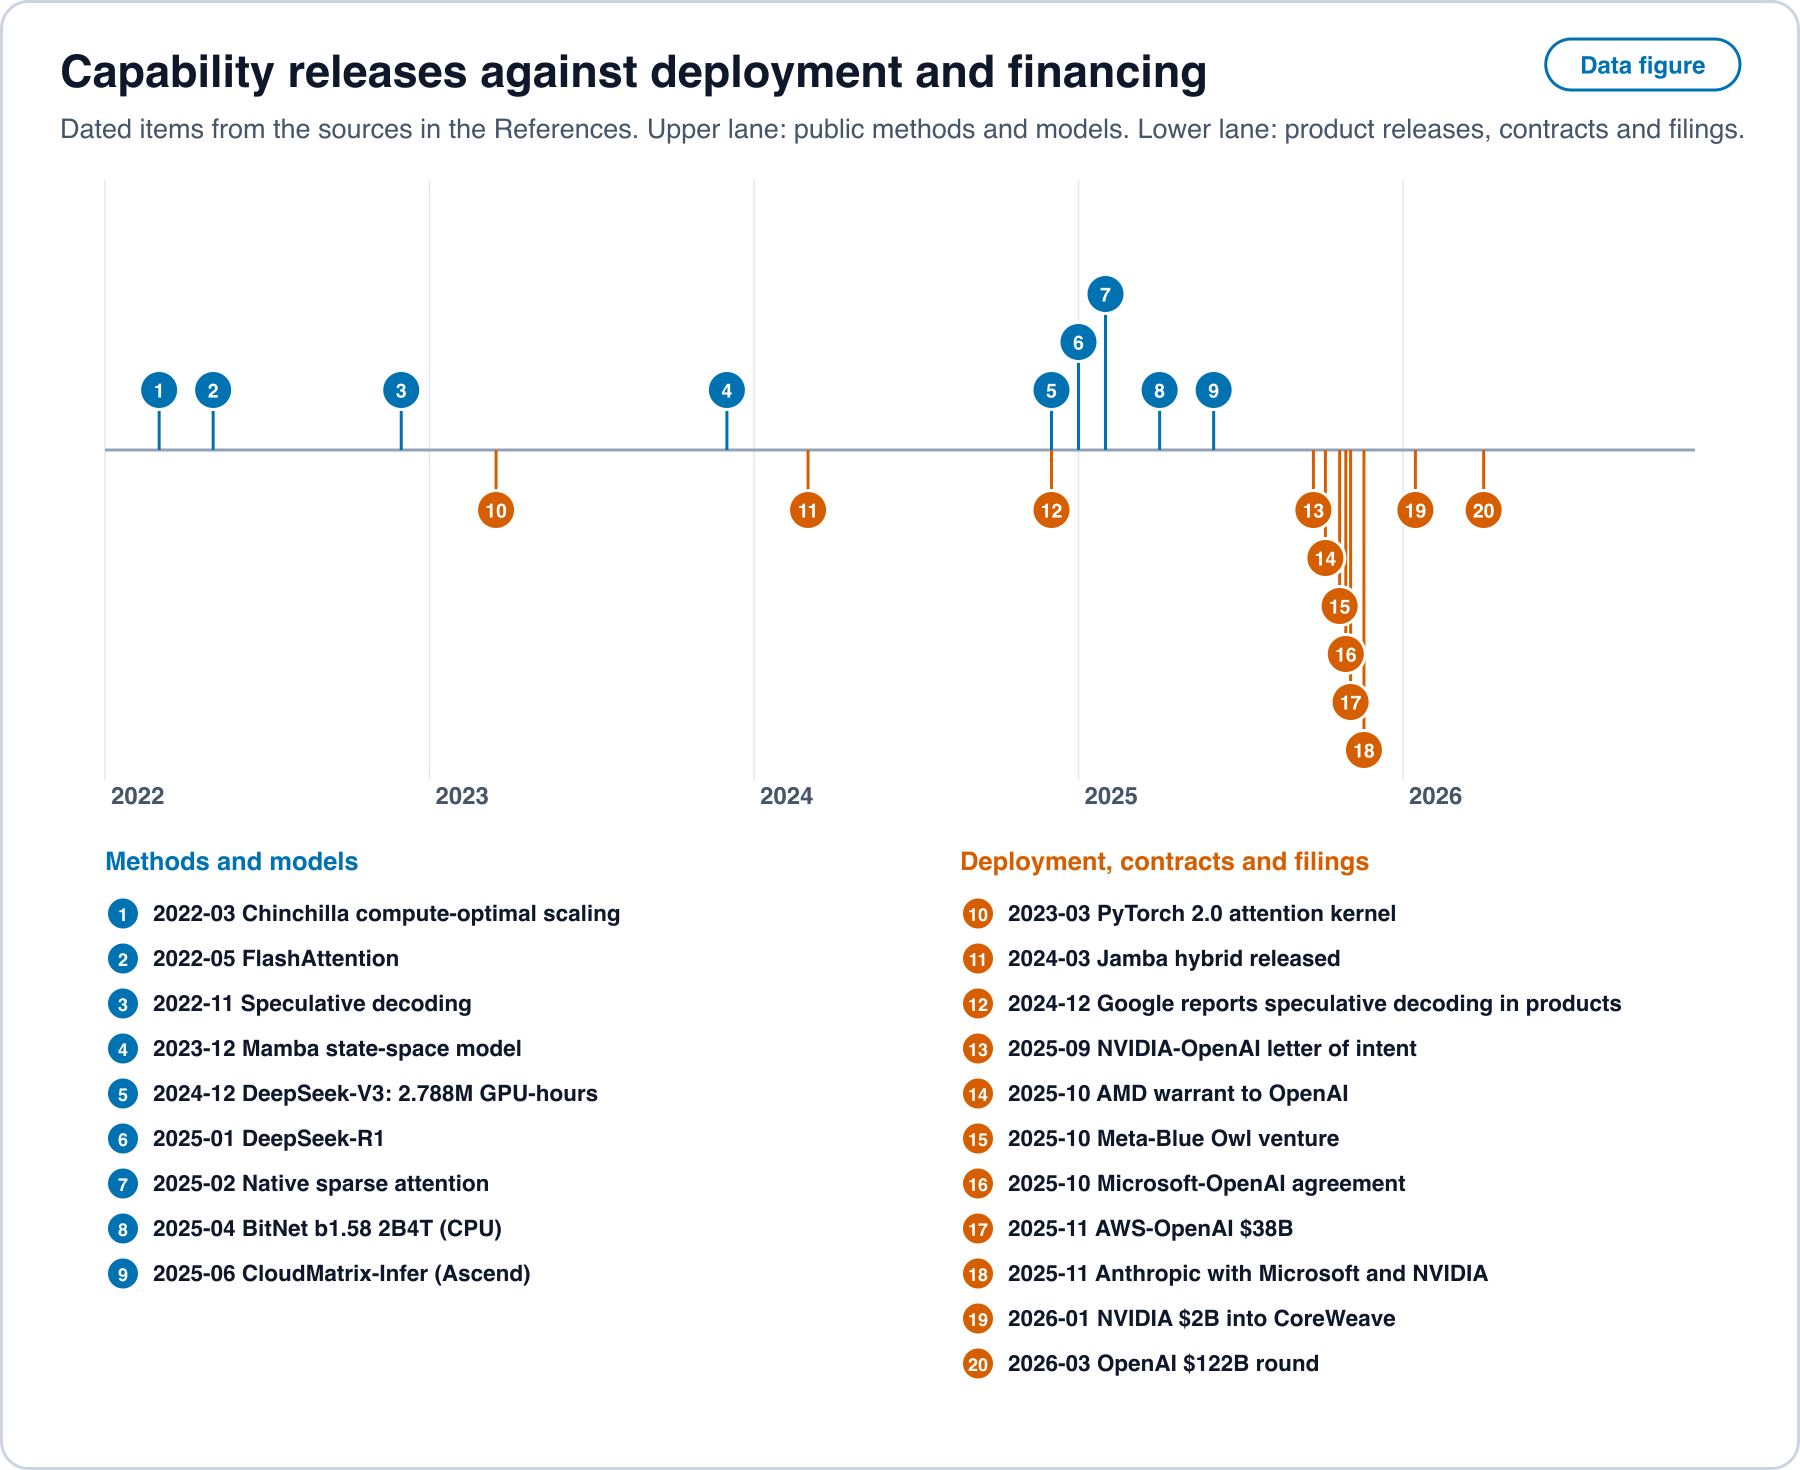
14. 构建机器的其他方式
第三种描述是:以正交工艺制造硬件的团队表明,传统基础设施的部分成本高于任务所需。所阅读的来源包含模拟、光子、神经形态、FPGA、纯 CPU 和柔性电子设计的有日期的演示。它们在任务、规模和测量上各不相同,因此本节在每篇论文自身的范围内报告,只采用论文本身报告的比率。
表 7. 替代设计、所测量的内容以及保留意见。
| 方法 | 演示 | 测量或报告的结果 | 保留意见 |
|---|---|---|---|
| 模拟存内计算 | 34 个瓦片上的 3500 万个相变存储器件,用于语音关键词任务 [96] | 芯片持续性能最高每瓦 12.4 TOPS,精度与软件相当 | 网络较小,所阅读的文本中没有匹配的基线,因此不得出比率 |
| 光子 | 一款光子 AI 处理器,其精度被作者表述为对 ResNet 和 BERT 切实可行 [97] | 在这些网络上的精度 | 所阅读的文本中没有每项任务焦耳数 |
| 神经形态 | 在 Loihi 2 上运行的 3.7 亿参数无矩阵乘法模型 [28] | 与边缘 GPU 上的 Transformer 相比,吞吐量最高为 3 倍,能量少 2 倍 | 初步结果,模型较小 |
| FPGA | 在 Alveo U280 卡上运行 LLaMA2-7B 的 FlightLLM,采用编译的稀疏性和量化 [27] | 能效分别为 V100S 和 A100 的 6.0 倍和 4.2 倍,成本效率分别为 1.8 倍和 1.4 倍 | 作者的比较和 GPU 配置 |
| CPU 上的三值权重 | 在 CPU 上运行的 BitNet b1.58 2B [26] | 内存 0.4 GB,对比 1.4 到 4.8 GB;每词元 29 ms,对比 41 到 124 ms | 每词元 0.028 J 的能量是由算术模型估计的,比基线低 6.6 到 23 倍,并非从功率计读取 |
| 替代加速器栈 | 在 Ascend NPU 上的服务 [95] | 预填充为每 TFLOPS 每秒 4.45 个词元,高于已发表的 H100 和 H800 结果 | 未报告功率,因此不得出焦耳比率 |
| 柔性非硅工艺 | 柔性基板上的一款 32 位 Arm 微处理器 [98] | 通用处理器可以用非硅工艺制造 | 没有机器学习结果,也没有每项任务焦耳数 |
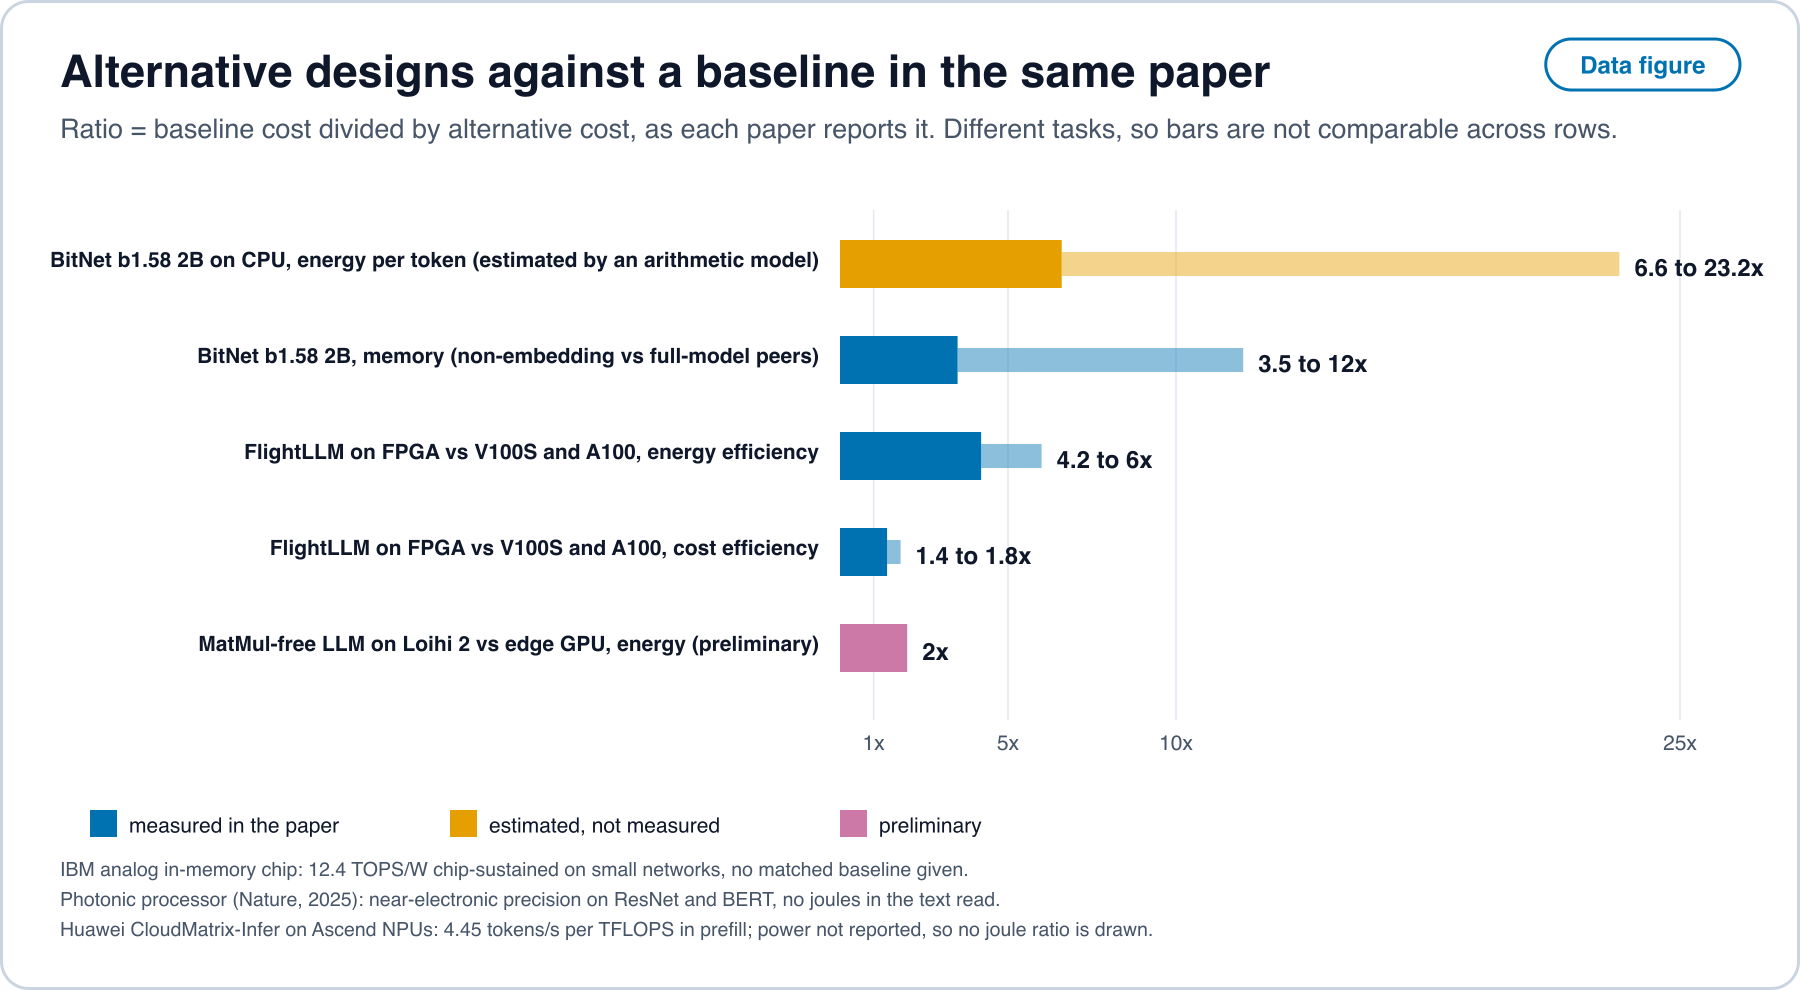
这支持什么。 对于特定的任务类别,即小模型、边缘部署、CPU 解码以及可编程逻辑上的稀疏或量化推理,作者报告的能量或内存比传统基线低 2 到 23 倍。这些是在小型或中型模型上的论文内比率。所阅读的来源中没有对替代设计服务前沿规模模型的测量,也没有对晶圆级或成熟节点设计的测量,因此本文不对它们下结论。
为什么能量比率不是成本比率。 由命题 8,在数据中心价格下,能量约占一个加速器小时的 1.5% 到 11.8%。一种把每项任务能量降低 10 倍的替代方案,除非也降低每项任务的资本,否则至多把每项任务成本降低能量所占的份额。三值模型的内存结果指向第二条路径:一个只需 0.4 GB 而不是 1.4 到 4.8 GB 的模型可以在更小、更便宜的设备上运行,而这里的来源没有测量其资本效应。在电力不是主导项的地方,有用的比较是包括资本在内的每项任务美元数,而所阅读的替代硬件论文中,除 FlightLLM 外都没有报告它,而 FlightLLM 的成本效率比率是表中较小的数字。
15. 能力、算力和电力分布在何处
这里根据国家统计、部委和机构的资料来解读扩建的地理分布,来源不是英文时以原文阅读。各国的单位不同,因此这些数字并列呈现,不作排名。
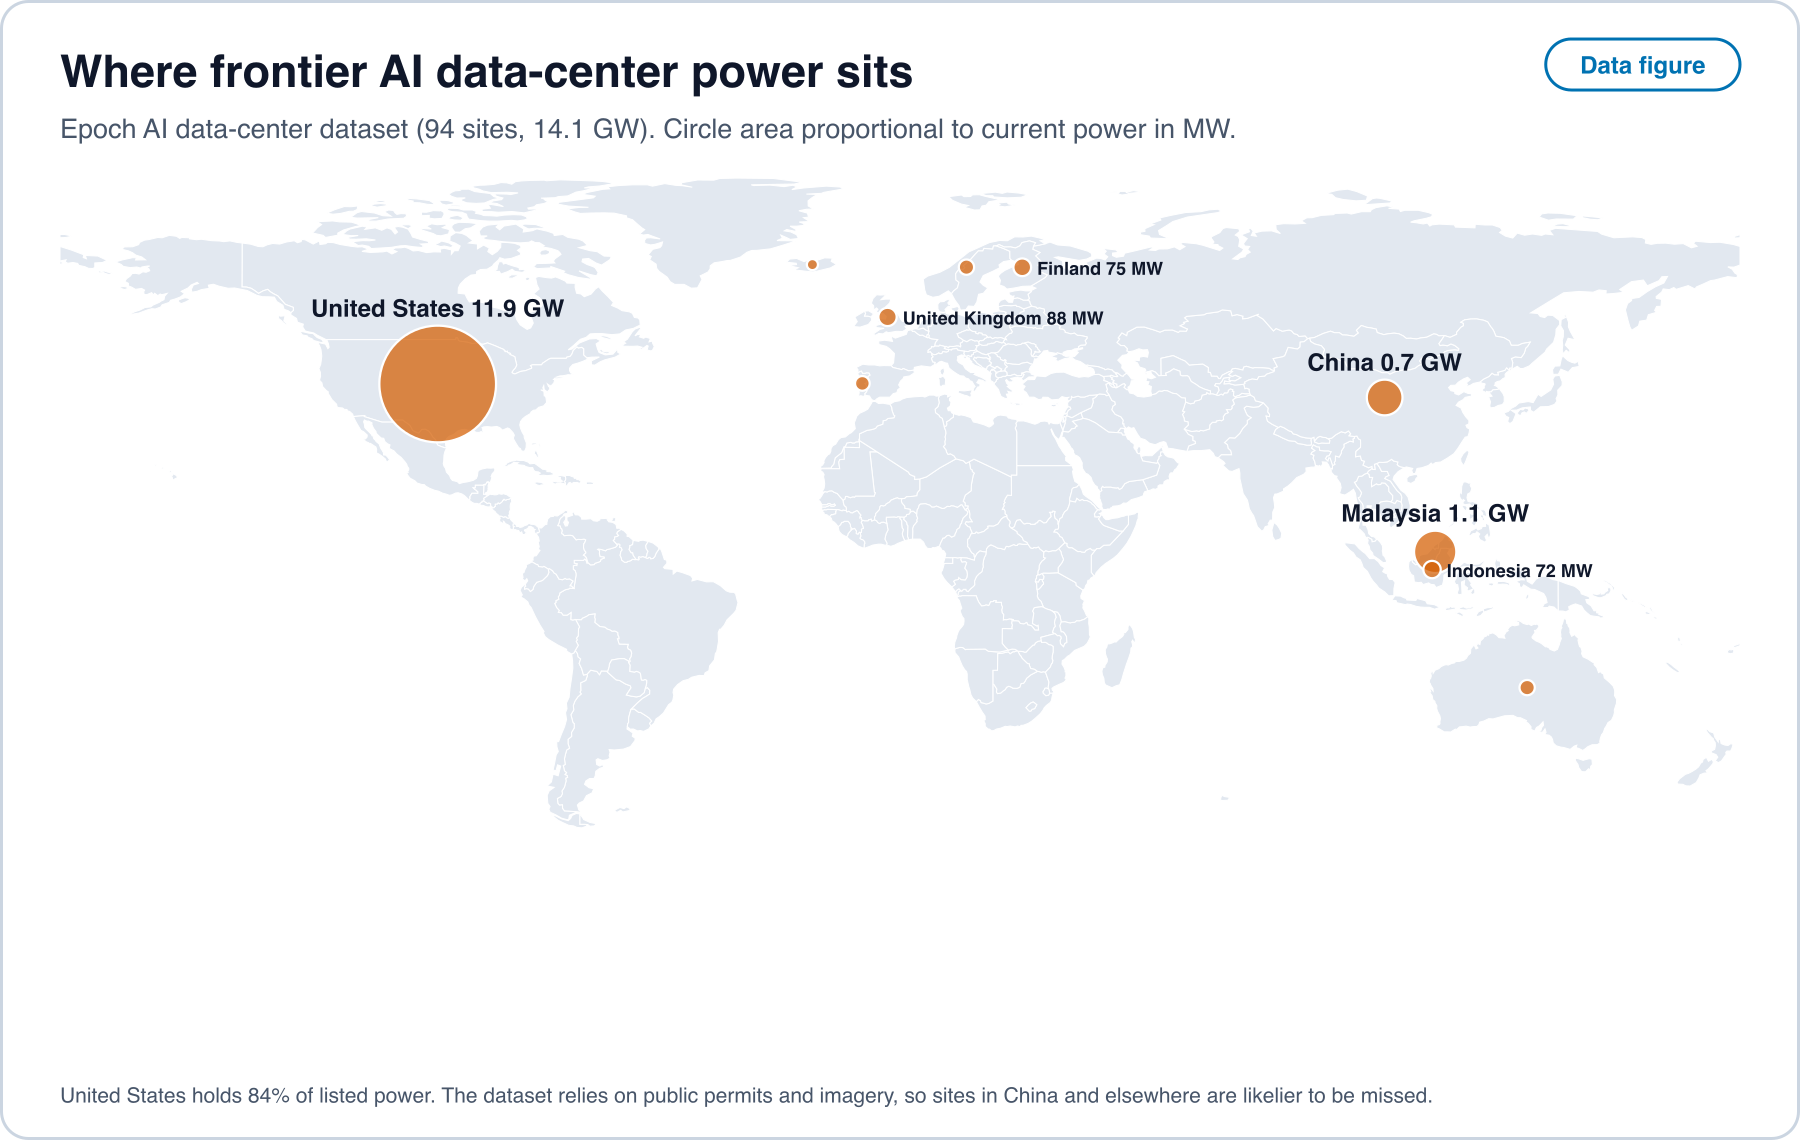
算力与电力。 在 Epoch AI 数据中心数据集中,所列前沿站点合计 14.1 GW,其中美国占 84%,其次是马来西亚 1.1 GW 和中国 0.7 GW [12]。该数据集依赖公开许可证和影像,因此在公开披露较少的地方,站点更容易被遗漏。中国自己的统计报告的是另一个量:截至 2025 年 6 月底,在用标准机架 1085 万个,智能算力规模 788 EFLOPS [99],截至 2025 年底为 159 万 PFLOPS(FP16)[100]。这两个中国数字来自不同的出版物,可能基于不同的定义,两者都不能与所列电力数字相比较。在电力方面,数据中心在 2024 年用电约 415 TWh,占全球总量的 1.5%,其中美国占 45%,中国占 25%,欧洲占 15%,国际能源署作为一种建模情景预测到 2030 年将翻一番,达到约 945 TWh [101, 102]。
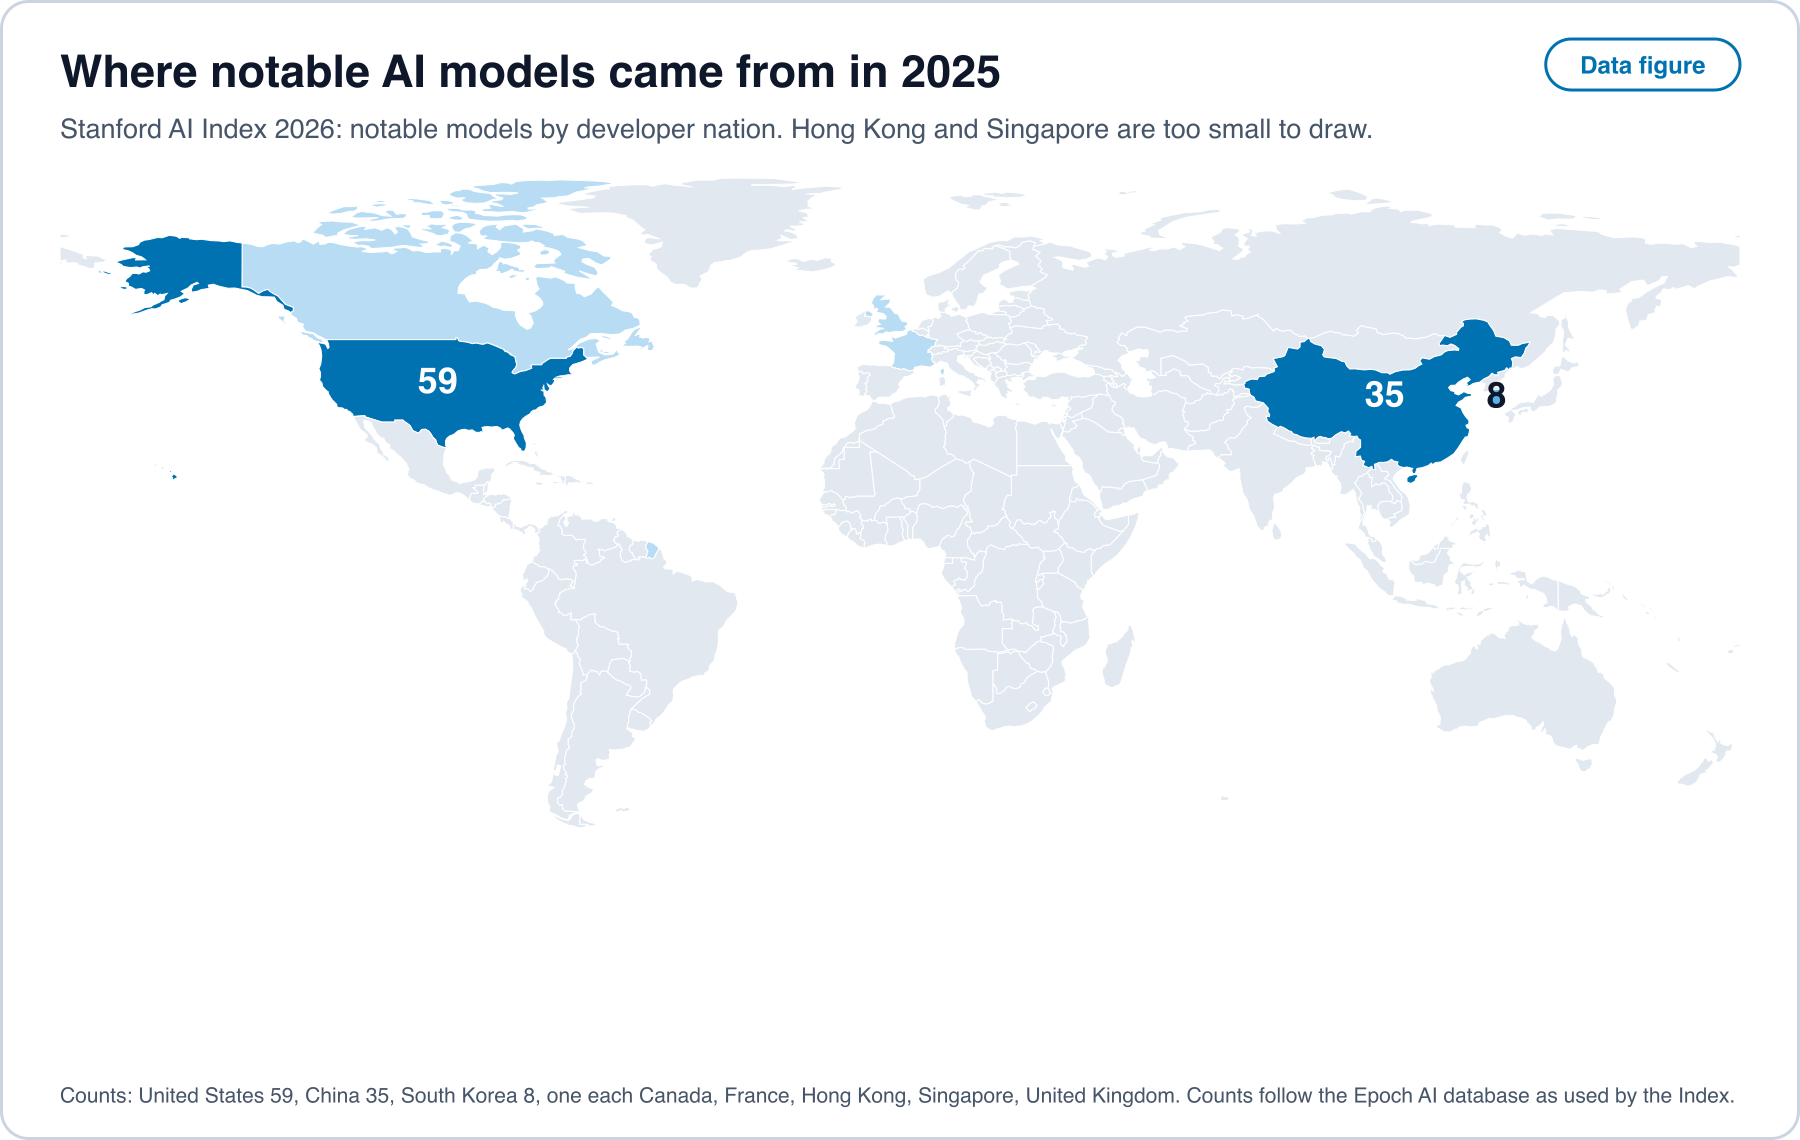
latency_data/frontier_dc_by_country.csv [12]。 Open full size模型来自哪里。 在 2025 年按开发者国籍归属统计的知名模型中,美国有 59 个,中国 35 个,韩国 8 个,加拿大、法国、香港、新加坡和英国各有一个 [29]。
芯片。 在 Epoch 硬件数据集的加速器中,在记录了代工厂的条目里,约五分之四记录的代工厂是 TSMC,其次是 Samsung、SMIC 和 Intel,而所有条目中有超过三分之一没有记录代工厂(latency_data/hardware_foundry_counts.json)[13]。所阅读的来源没有给出可用的封装产能或按国家划分的制造产能数字,因此本文不绘制它们的地图。
国家计划。 各项计划以不同的单位陈述其规模,表 8 按其所述给出每一项。
表 8. 按所述列出的国家计划,附来源语言。
| 地区 | 陈述 | 语言 | 类别 |
|---|---|---|---|
| 中国 | 2025 年 6 月底智能算力规模 788 EFLOPS,2025 年底 159 万 PFLOPS(FP16)[99, 100] | 中文 | 已证实 |
| 韩国 | 2025 年 10 月政府关于确保 260,000 块 NVIDIA GPU 的声明 [103] | 韩语 | 观点 |
| 日本 | 到 2030 财年的七年间至少 10 万亿日元的公共支持,目标是十年间超过 50 万亿日元的民间投资 [104];市场研究称,预计每年对日本数据中心的云投资将达数千亿日元或更多 [105] | 日语 | 观点 |
| 欧盟 | 将为 AI 调动 2000 亿欧元,其中包括一个 200 亿欧元的 AI 超级工厂基金 [106, 107] | 英语和意大利语 | 观点 |
| 印度 | 据 2026 年 3 月向议会的报告,IndiaAI 算力门户已接入 38,231 块 GPU [108] | 英语 | 已证实 |
| 巴西 | 2024 年至 2028 年计划投资 R$ 230.3 亿 [109] | 葡萄牙语 | 观点 |
| 阿拉伯联合酋长国 | 阿布扎比一个计划中的 5 GW 园区内的 1 GW 算力集群 [110] | 英语 | 观点 |
| 沙特阿拉伯 | 五年内预计容量最多 500 MW [111] | 英语 | 观点 |
| 非洲 | 一座正在南非部署的 AI 工厂,并计划在尼日利亚、肯尼亚、埃及和摩洛哥建设;未陈述容量数字 [112] | 英语 | 观点 |
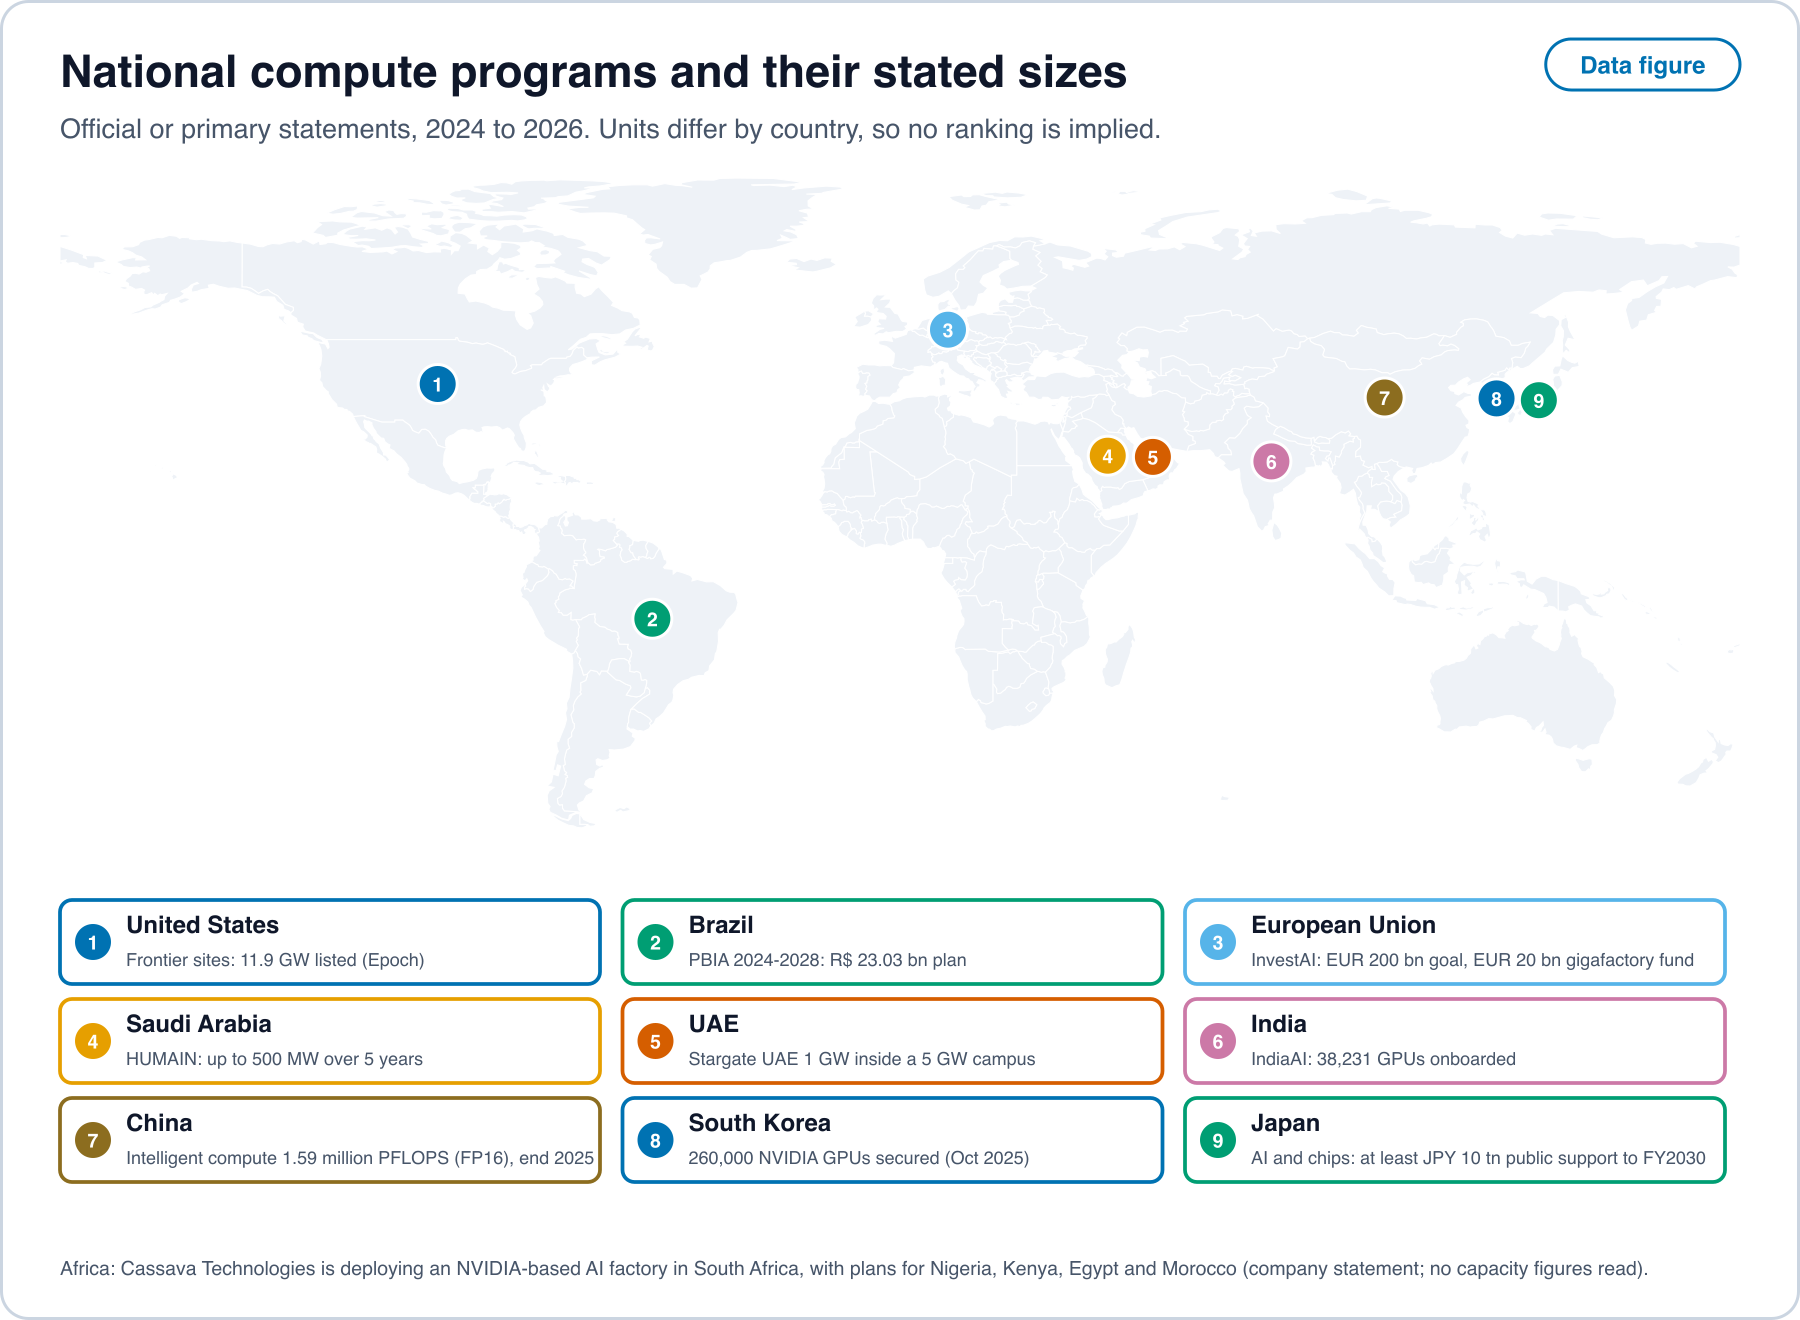
观点类中的陈述是计划和目标,已证实类包含所报告的容量或统计。两类不应相加。
使用。 关于企业使用 AI 的官方调查给出:韩国 2024 年 32.9%,德国 2025 年 26%,西班牙 2025 年初 21.1%,欧盟 2025 年 20.0%,美国 2025 年至 2026 年冬季 18%,OECD 地区 2024 年 13.9%,巴西 2024 年 13%,法国 2024 年 10%,年份和定义各不相同 [30, 31, 32, 33, 34, 35, 36, 37]。日本和中国测量的是个人而不是企业 [71, 72]。
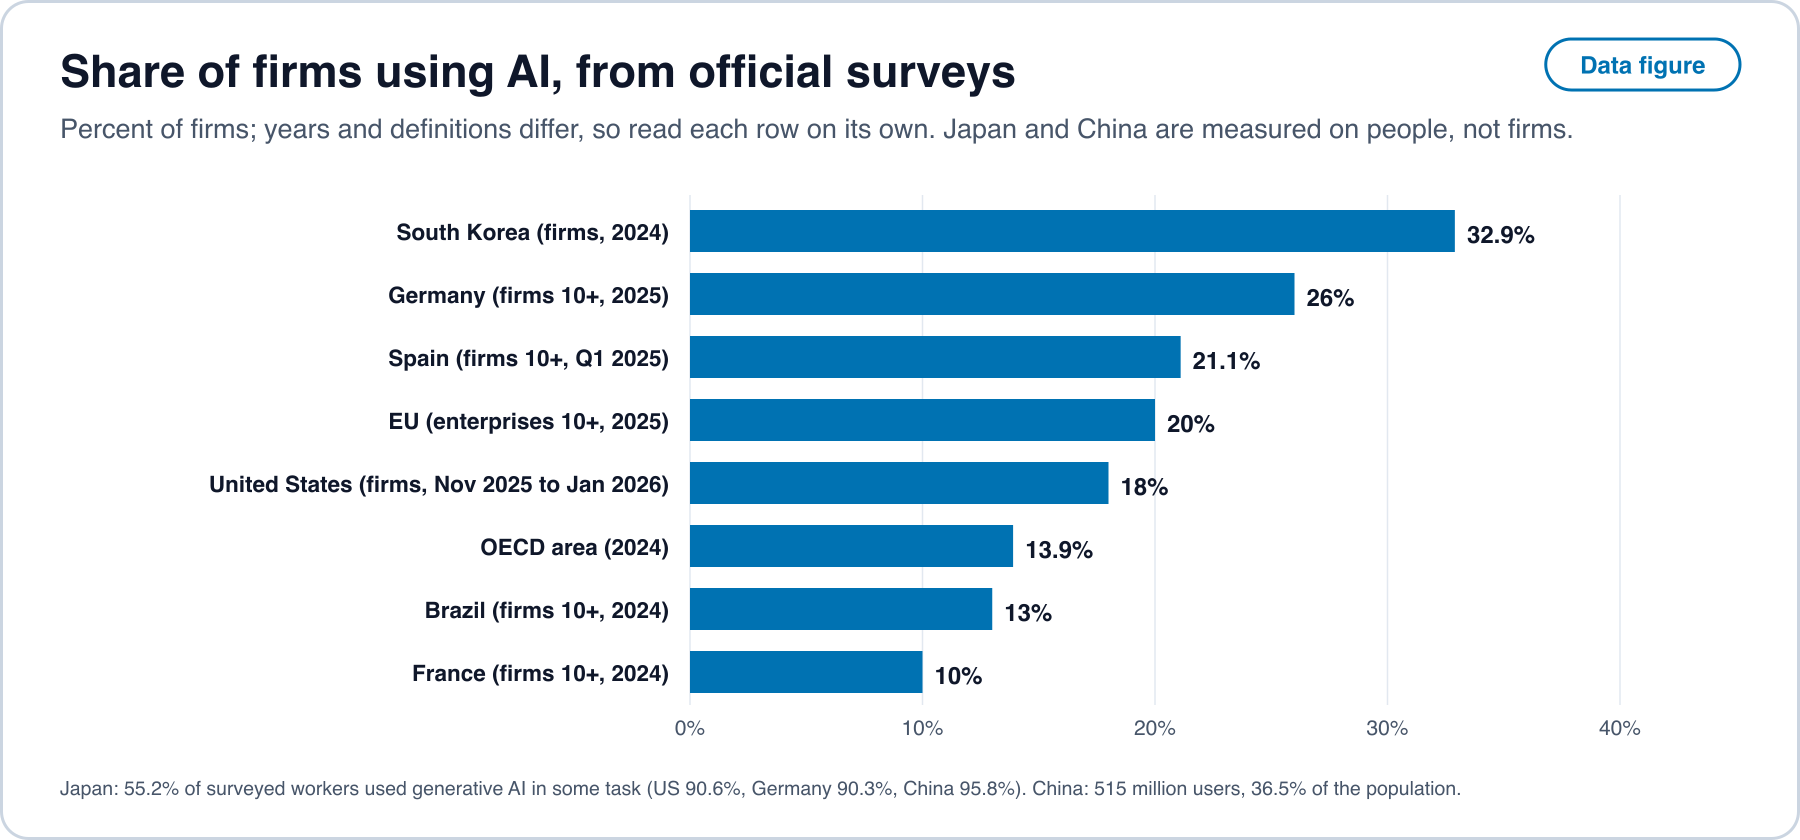
地理分布显示了什么。 所列的算力电力以很大的差距集中在一个国家,而已发表的模型和官方容量陈述显示,第二个国家拥有很大的模型份额和很大的所述容量,而所列电力数据集难以看到这些。其他地方的计划陈述了吉瓦级或千亿级的规划,而在所阅读的调查中,企业对 AI 的测得使用在 10% 到 33% 之间。计划与测得使用之间的差距,正是本文所研究的差距,如今是在国家尺度上。
16. 实验方案(未执行)
目的。 只使用公开日期,为一系列方法测量 及其三个部分。
单位。 一种方法,例如数值格式、内核、推断程序或编译器遍,带有有日期的公开描述。
每种方法需收集的日期。 最早的公开发布(预印本或代码库)、最早的开放实现、在一个被广泛使用的开放库中的最早发布,以及在至少一个商业产品中的最早正式上市发布,并注明公司类型(上市、私营、公共部门、学术)。每个日期都与其来源链接和存档副本一起记录。
抽样。 从 2022 年至 2026 年间一组固定的发表场所和代码库中抽取的预注册清单上的所有方法,包括非英文的发表场所和代码库,选择规则在查找任何发布日期之前写定。
分析。 计算每种方法的 。用预测 1 的相位检验以及把平均延迟与 比较来估计 。把门槛部分估计为上市公司与非上市公司之间的差异(预测 2)。报告中位数及自助法区间,并报告有多大份额的方法从未进入产品。
能量。 在方法报告了每项任务焦耳数的地方,记录测量条件;在没有报告的地方,在一个开放的能量测试平台(例如表 1 中所引的那个)上运行它,并报告测得的焦耳数。
融资与成本。 根据申报文件为每个供应商和财年计算定义 4 的界,根据所列的加速器小时价格和测得的功率计算计入资本的焦耳价格,并为每个实验室计算签约采购与过去收入之比,每一项都连同其来源的申报文件和页码一起记录。图表脚本 scripts/figures/latency_figures.py 和 scripts/figures/latency_data/ 下的数据文件根据所引来源复现第 9 节至第 15 节中的每一张图。
产出。 一张日期表、一个分析脚本和一份排除记录。脚本和数据将随研究以与本网站相同的条款发布。
17. 结论
降低计算智能成本的公开方法经过一段延迟才进入产品,这段延迟有技术部分、日历部分和激励部分。第一部分是工程时间。第二部分是决策日期的结构,在季度日历上平均增加约六周(命题 1)。第三部分出现在一条报告规则阻止一项长期来看值得做的发布时(命题 3)。一个降低采用某方法成本的工具,一旦成本降到既定的界以下,就消除了第三部分,而一个降低工作本身成本的工具,会在持有一无所获时迫使发布(命题 4)。当市场上有多个能以低摩擦触达的卖方时,最快的那一个决定延迟(命题 5)。随着计算成本下降,剩下的利润率取决于转换摩擦(命题 6)。基础设施方面的证据补充了以下几点。申报文件记录了具名供应商与客户之间规模达数百亿美元的回路,并把最大芯片供应商收入中可能由其自有资本资助的份额限定在五分之一以下,而超大规模云服务商的大部分支出是用经营现金流支付的。在数据中心价格下,能量只是一个加速器小时中的一小部分,资本才是大部分,因此每项任务成本跟随每项任务加速器时间、利用率和机器的所述年限。按作者自己的测量,开放方法和替代设计在小型和中型模型上降低了每项任务的加速器时间、内存或能量,而所阅读的来源中没有一个在前沿规模上测量它们。能力、算力和电力的分布不均衡,国家计划所陈述的规模远高于测得的使用。各命题是一个模型,各项预测指明了能够推翻每一项的申报文件、报价和测量。
参考文献
Each entry ends with its evidence class (Section 1).
- Meta, joint venture with funds managed by Blue Owl Capital to develop the Hyperion data center. 2025-10-21. https://investor.atmeta.com/investor-news/press-release-details/2025/Meta-Announces-Joint-Venture-with-Funds-Managed-by-Blue-Owl-Capital-to-Develop-Hyperion-Data-Center/default.aspx (opinion)
- Meta Platforms, Quarterly Report on Form 10-Q, period ended 30 September 2025. 2025-10-30. https://www.sec.gov/Archives/edgar/data/1326801/000162828025047240/meta-20250930.htm (demonstrated)
- NVIDIA, Annual Report on Form 10-K, fiscal year ended 25 January 2026. 2026-02-25. https://www.sec.gov/Archives/edgar/data/1045810/000104581026000021/nvda-20260125.htm (demonstrated)
- CoreWeave, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-03-02. https://www.sec.gov/Archives/edgar/data/1769628/000176962826000104/crwv-20251231.htm (demonstrated)
- Oracle, Quarterly Report on Form 10-Q, period ended 31 August 2026. 2026-09-11. https://www.sec.gov/Archives/edgar/data/1341439/000119312626389274/orcl-20260831.htm (demonstrated)
- Oracle, Q1 FY27 results (Exhibit 99.1 to Form 8-K). 2026-09-10. https://www.sec.gov/Archives/edgar/data/1341439/000119312626387905/orcl-20260910.htm (demonstrated)
- Microsoft, Quarterly Report on Form 10-Q, period ended 30 September 2025, Note 17. 2025-10-29. https://www.sec.gov/Archives/edgar/data/789019/000119312525256321/msft-20250930.htm (demonstrated)
- OpenAI and Amazon Web Services, partnership announcement. 2025-11-03. https://openai.com/index/aws-and-openai-partnership/ (opinion)
- CNBC, OpenAI closes record-breaking 122 billion dollar funding round. 2026-03-31. https://www.cnbc.com/2026/03/31/openai-funding-round-ipo.html (opinion)
- Microsoft, NVIDIA and Anthropic, strategic partnerships announcement. 2025-11-18. https://blogs.microsoft.com/blog/2025/11/18/microsoft-nvidia-and-anthropic-announce-strategic-partnerships/ (opinion)
- U.S. Securities and Exchange Commission, XBRL company concept API (annual capital expenditure and operating cash flow, seven filers). 2026-10. https://data.sec.gov/api/xbrl/companyconcept/ (demonstrated)
- Epoch AI, Frontier Data Centers dataset (CC BY). 2026-10. https://epoch.ai/data/data-centers (demonstrated)
- Epoch AI, Machine Learning Hardware dataset (CC BY). 2026-10. https://epoch.ai/data/machine-learning-hardware (demonstrated)
- Amazon, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-06. https://www.sec.gov/Archives/edgar/data/1018724/000101872426000004/amzn-20251231.htm (demonstrated)
- Meta Platforms, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-01-29. https://www.sec.gov/Archives/edgar/data/1326801/000162828026003942/meta-20251231.htm (demonstrated)
- Alphabet, Annual Report on Form 10-K, fiscal year ended 31 December 2025. 2026-02-05. https://www.sec.gov/Archives/edgar/data/1652044/000165204426000018/goog-20251231.htm (demonstrated)
- Microsoft, Annual Report on Form 10-K, fiscal year ended 30 June 2026. 2026-07-29. https://www.sec.gov/Archives/edgar/data/789019/000119312626323660/msft-20260630.htm (demonstrated)
- Stanford HAI, AI Index Report 2025. 2025-04. https://hai.stanford.edu/assets/files/hai_ai_index_report_2025.pdf (demonstrated)
- Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. 2022-05-27. https://arxiv.org/abs/2205.14135 (demonstrated)
- PyTorch, PyTorch 2.0 release announcement. 2023-03-15. https://pytorch.org/blog/pytorch-2-0-release/ (opinion)
- Gu and Dao, Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023-12-01. https://arxiv.org/abs/2312.00752 (demonstrated)
- Lieber et al., Jamba: A Hybrid Transformer-Mamba Language Model. 2024-03-28. https://arxiv.org/abs/2403.19887 (demonstrated)
- Leviathan, Kalman, Matias, Fast Inference from Transformers via Speculative Decoding. 2022-11-30 (ICML 2023). https://arxiv.org/abs/2211.17192 (established by proof in the source)
- Google Research, Looking back at speculative decoding. 2024-12-06. https://research.google/blog/looking-back-at-speculative-decoding/ (opinion)
- Epoch AI, Notable AI Models dataset (CC BY). 2026-10. https://epoch.ai/data/notable-ai-models (demonstrated)
- Ma et al., BitNet b1.58 2B4T Technical Report. 2025-04-16. https://arxiv.org/abs/2504.12285 (demonstrated)
- Zeng et al., FlightLLM: Efficient Large Language Model Inference with a Complete Mapping Flow on FPGAs. 2024-01-08. https://arxiv.org/abs/2401.03868 (demonstrated)
- Abreu et al., Neuromorphic Principles for Efficient Large Language Models on Intel Loihi 2. 2025-03. https://arxiv.org/abs/2503.18002 (demonstrated)
- Stanford HAI, AI Index Report 2026, research and development chapter. 2026-04. https://hai.stanford.edu/ai-index/2026-ai-index-report (demonstrated)
- (Korean) Electronic Times, reporting the 2025 Enterprise Informatization Statistics of the Ministry of Science and ICT and NIA. 2026-01-20. https://www.etnews.com/20260120000071 (demonstrated)
- (German) Statistisches Bundesamt, Unternehmen mit Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen (table, 2025). 2025. https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-unternehmen-kuenstliche-intelligenz.html (demonstrated)
- (Spanish) Instituto Nacional de Estadística, Encuesta sobre el uso de TIC y del comercio electrónico en las empresas, nota de prensa. 2025-10-22. https://ine.es/dyngs/Prensa/ETICCE20241T2025.pdf (demonstrated)
- Eurostat, 20% of EU enterprises use AI technologies. 2025-12-11. https://ec.europa.eu/eurostat/documents/7870049/23260410/KS-01-26-009-EN-N.pdf (demonstrated)
- Bonney et al., The Microstructure of AI Diffusion (Census CES-WP-26-25). 2026-04. https://www.census.gov/library/working-papers/2026/adrm/CES-WP-26-25.html (demonstrated)
- OECD, Emerging divides in the transition to artificial intelligence. 2025-06. https://www.oecd.org/content/dam/oecd/en/publications/reports/2025/06/emerging-divides-in-the-transition-to-artificial-intelligence_eeb5e120/7376c776-en.pdf (demonstrated)
- (Portuguese) Cetic.br/NIC.br, Pesquisa TIC Empresas 2024, resumo executivo. 2025-05. https://www.nic.br/media/docs/publicacoes/2/20250512121759/tic_empresas_2024_resumo_executivo.pdf (demonstrated)
- (French) Insee, Les technologies de l’information et de la communication dans les entreprises en 2024, Insee Première n° 2061. 2025-07. https://www.insee.fr/fr/statistiques/fichier/8604126/ip2061.pdf (demonstrated)
- Dao and Gu, Transformers are SSMs (Mamba-2, state space duality). 2024-05-31. https://arxiv.org/abs/2405.21060 (established by proof in the source)
- Lieber et al. (Jamba); NVIDIA (Nemotron-H); TII (Falcon-H1); IBM (Granite 4.0). 2024 to 2025. https://arxiv.org/abs/2504.03624 (demonstrated)
- Ma et al., The Era of 1-bit LLMs (BitNet b1.58). 2024-02-27. https://arxiv.org/abs/2402.17764 (demonstrated)
- NVIDIA, Pretraining Large Language Models with NVFP4. 2025-09. https://arxiv.org/abs/2509.25149 (demonstrated)
- Shah et al., FlashAttention-3. 2024-07. https://arxiv.org/abs/2407.08608 (demonstrated)
- Yuan et al., Native Sparse Attention. 2025-02 (ACL 2025). https://arxiv.org/abs/2502.11089 (demonstrated)
- Hoffmann et al., Training Compute-Optimal Large Language Models. 2022-03-29. https://arxiv.org/abs/2203.15556 (demonstrated)
- Sardana et al., Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling. 2024-01 (ICML 2024). https://arxiv.org/abs/2401.00448 (demonstrated)
- DeepSeek-AI, DeepSeek-V3 Technical Report. 2024-12-26. https://arxiv.org/abs/2412.19437 (demonstrated)
- Angelopoulos, Barber, Bates, Theoretical Foundations of Conformal Prediction. 2024-11-18 (v5 2026-03-06). https://arxiv.org/abs/2411.11824 (established by proof in the source)
- Zhou, Chen, Gui and Cheng, Conformal Prediction: A Data Perspective. 2024-10 (arXiv 2410.06494; ACM Computing Surveys 2025). https://arxiv.org/abs/2410.06494 (opinion)
- Angelopoulos et al., Prediction-powered inference. 2023 (Science). https://www.science.org/doi/10.1126/science.adi6000 (established by proof in the source)
- Ramdas, Grunwald, Vovk, Shafer, Game-Theoretic Statistics and Safe Anytime-Valid Inference. 2023-11 (Statistical Science 38(4)). https://doi.org/10.1214/23-sts894 (established by proof in the source)
- Chernozhukov et al., Double/debiased machine learning. 2018 (Econometrics Journal). https://doi.org/10.1111/ectj.12097 (established by proof in the source)
- Jung, Tian, Bareinboim, Estimating Identifiable Causal Effects through Double Machine Learning. 2021 (AAAI). https://doi.org/10.1609/aaai.v35i13.17438 (established by proof in the source)
- Sathia et al., Compiler Optimizations for Higher-Order Automatic Differentiation. 2025 (PPoPP workshop). https://ece.is/assets/pdf/diffprog-ppopp25-paper90.pdf (demonstrated)
- Ward et al., JAX a la Stan. 2026-10-11. https://bob-carpenter.github.io/dj-paper/template-computo-python.pdf (opinion)
- Qian et al., Impulse: probabilistic programming via compiler augmentation. 2026 (abstract). https://ece.is/assets/pdf/impulse-pldi-src-abstract.pdf (demonstrated)
- Chung et al., The ML.ENERGY Benchmark. 2025 (NeurIPS Datasets and Benchmarks). https://ml.energy/leaderboard/ (demonstrated)
- Google, Measuring the environmental impact of delivering AI at Google Scale. 2025-08. https://arxiv.org/abs/2508.15734 (demonstrated)
- Ho et al. (Epoch AI), Algorithmic progress in language models. 2024-03 (NeurIPS 2024). https://arxiv.org/abs/2403.05812 (demonstrated)
- Epoch AI, LLM inference prices have fallen rapidly but unequally across tasks. 2025. https://epoch.ai/data-insights/llm-inference-price-trends (demonstrated)
- Comin and Hobijn, An Exploration of Technology Diffusion. 2010 (AER 100(5)). https://doi.org/10.1257/aer.100.5.2031 (demonstrated)
- P. A. David, The Dynamo and the Computer. 1990 (AER 80(2)). https://ideas.repec.org/a/aea/aecrev/v80y1990i2p355-61.html (demonstrated)
- Brynjolfsson, Rock, Syverson, The Productivity J-Curve. 2021 (AEJ Macro). https://doi.org/10.1257/mac.20180386 (demonstrated)
- Somala and Emberson (Epoch AI), Frontier AI performance becomes accessible on consumer hardware within a year. 2025-08-15. https://epoch.ai/data-insights/consumer-gpu-model-gap (demonstrated)
- Epoch AI, Open vs. closed AI: how behind are open models?. 2025. https://epoch.ai/publications/open-models-report (demonstrated)
- Gupta and Kiely, Production-ready speculative decoding with TensorRT-LLM. 2024-12-19. https://www.baseten.co/blog/how-we-built-production-ready-speculative-decoding-with-tensorrt-llm/ (opinion)
- Marx and Fuegi, Reliance on Science: Worldwide Front-Page Patent Citations to Scientific Articles. 2020 (NBER 27987; JEMS 2022). https://www.nber.org/system/files/working_papers/w27987/w27987.pdf (demonstrated)
- Ahmadpoor and Jones, The dual frontier. 2017 (Science). https://doi.org/10.1126/science.aam9527 (demonstrated)
- Willison, Stanford Alpaca, and the acceleration of on-device large language model development. 2023-03-13. https://simonwillison.net/2023/Mar/13/alpaca/ (opinion)
- Li et al., Now Hiring: Firm-Level Adoption of Generative AI in China (World Bank). 2025/2026. https://thedocs.worldbank.org/en/doc/cbdef4ef57efdbb3c29aa4c07edf860b-0050062026/original/Now-hiring-Firm-Level-Li-etal.pdf (demonstrated)
- (German) Statistisches Bundesamt, Pressemitteilung Nr. 444: Jedes fünfte Unternehmen nutzt künstliche Intelligenz. 2024-11-25. https://www.destatis.de/DE/Presse/Pressemitteilungen/2024/11/PD24_444_52911.html (demonstrated)
- Japan Ministry of Internal Affairs and Communications, 令和7年版情報通信白書 (Information and Communications White Paper 2025), data tables, in Japanese. 2025. https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r07/html/nd112220.html (demonstrated)
- (Chinese) China Internet Network Information Center, 生成式人工智能应用发展报告(2025). 2025-10. https://pdf.dfcfw.com/pdf/H301_AP202510241768289458_1.pdf (demonstrated)
- Bick, Blandin, Deming, The Rapid Adoption of Generative AI. 2024-09 (rev. 2025-02). https://www.nber.org/papers/w32966 (demonstrated)
- Brynjolfsson, Li, Raymond, Generative AI at Work (NBER Working Paper 31161; later published in QJE 2025). 2023 working paper, revised. https://www.nber.org/papers/w31161 (demonstrated)
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. 2025-07-10. https://arxiv.org/abs/2507.09089 (demonstrated)
- Bloom, Jones, Van Reenen, Webb, Are Ideas Getting Harder to Find?. 2020 (AER 110(4)). https://doi.org/10.1257/aer.20180338 (demonstrated)
- Graham, Harvey, Rajgopal, The Economic Implications of Corporate Financial Reporting. 2005 (JAE 40); NBER 2004-10. https://www.nber.org/papers/w10550 (demonstrated)
- Asker, Farre-Mensa, Ljungqvist, Corporate Investment and Stock Market Listing: A Puzzle?. 2015 (RFS 28(2)). https://doi.org/10.1093/rfs/hhu077 (demonstrated)
- FactSet, Highest number of S&P 500 earnings calls citing AI over the past 10 years. 2025-12. https://insight.factset.com/highest-number-of-sp-500-earnings-calls-citing-ai-over-the-past-10-years-1 (demonstrated)
- Hassan, Hollander, van Lent, Tahoun, Firm-Level Political Risk. 2019 (QJE 134(4)). https://doi.org/10.1093/qje/qjz021 (demonstrated)
- Metrick and Yasuda, Venture Capital and Other Private Equity: A Survey (NBER Working Paper 16652). 2010-10. https://www.nber.org/system/files/working_papers/w16652/w16652.pdf (opinion)
- Gompers and Lerner, What Drives Venture Capital Fundraising? (Brookings Papers: Microeconomics). 1998. https://www.brookings.edu/wp-content/uploads/1998/01/1998_bpeamicro_gompers.pdf (demonstrated)
- Arrow, Economic Welfare and the Allocation of Resources for Invention (NBER chapter). 1962. https://www.nber.org/system/files/chapters/c2144/c2144.pdf (established by proof in the source)
- Shapiro, Competition and Innovation: Did Arrow Hit the Bull’s Eye? (NBER conference draft). 2010. https://conference.nber.org/confer/2010/RDIA10/Shapiro.pdf (opinion)
- Henderson and Clark, Architectural Innovation. 1990 (ASQ 35(1)). https://doi.org/10.2307/2393549 (demonstrated)
- US District Court for D.C., United States v. Google LLC, remedies memorandum. 2025-09-02. https://www.courthousenews.com/wp-content/uploads/2025/09/judge-amit-mehta-google-search-monopoly-remedy-ruling.pdf (demonstrated)
- NVIDIA and OpenAI, letter of intent announcement. 2025-09-22. https://nvidianews.nvidia.com/news/openai-and-nvidia-announce-strategic-partnership-to-deploy-10gw-of-nvidia-systems (opinion)
- Advanced Micro Devices, Form 8-K, Item 1.01 (warrant issued to OpenAI). 2025-10-06. https://www.sec.gov/Archives/edgar/data/2488/000119312525230895/d28189d8k.htm (demonstrated)
- Microsoft, The next chapter of the Microsoft-OpenAI partnership. 2025-10-28. https://blogs.microsoft.com/blog/2025/10/28/the-next-chapter-of-the-microsoft-openai-partnership/ (opinion)
- Anthropic, Expanding our use of Google Cloud TPUs and services. 2025-10-23. https://www.anthropic.com/news/expanding-our-use-of-google-cloud-tpus-and-services (opinion)
- OpenAI and Broadcom, strategic collaboration announcement. 2025-10-13. https://openai.com/index/openai-and-broadcom-announce-strategic-collaboration/ (opinion)
- Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. 2022-10-31. https://arxiv.org/abs/2210.17323 (demonstrated)
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention (vLLM). 2023-09-12. https://arxiv.org/abs/2309.06180 (demonstrated)
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025-01-22. https://arxiv.org/abs/2501.12948 (demonstrated)
- Zuo et al., Serving Large Language Models on Huawei CloudMatrix384. 2025-06. https://arxiv.org/abs/2506.12708 (demonstrated)
- Le Gallo et al., An analog-AI chip for energy-efficient speech recognition and transcription, Nature. 2023-08-23. https://www.nature.com/articles/s41586-023-06337-5 (demonstrated)
- Ahmed et al., Universal photonic artificial intelligence acceleration, Nature. 2025-04-09. https://www.nature.com/articles/s41586-025-08854-x (demonstrated)
- Biggs et al., A natively flexible 32-bit Arm microprocessor, Nature. 2021-07-21. https://www.nature.com/articles/s41586-021-03625-w (demonstrated)
- (Chinese) 国务院, 截至今年6月底我国智能算力规模达788百亿亿次/秒 (人民日报). 2025-09-02. https://www.gov.cn/yaowen/liebiao/202509/content_7038732.htm (demonstrated)
- (Chinese) 全国数据资源统计调查工作组, 全国数据资源调查报告(2025年). 2026. https://www.nda.gov.cn/sjj/swdt/xwfb/0429/ff808081-9b5e8626-019d-d86b2f54-1154.pdf (demonstrated)
- International Energy Agency, Energy and AI, executive summary. 2025-04. https://www.iea.org/reports/energy-and-ai/executive-summary (demonstrated)
- International Energy Agency, Energy and AI, energy demand from AI. 2025-04. https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai (demonstrated)
- (Korean) 뉴시스, 정부, 엔비디아 GPU 26만장 확보. 2025-10-31. https://www.newsis.com/view/NISX20251031_0003385059 (opinion)
- (Japanese) 経済産業省, AI・半導体産業基盤強化フレーム. 2024-11. https://www.meti.go.jp/policy/mono_info_service/ai_semiconductor_frame/ai_semiconductor_frame.html (opinion)
- (Japanese) 総務省 有識者会合 資料5, 国内データセンター市場におけるAI需要・地方分散・再エネ電源 (富士キメラ総研). 2024-05-30. https://www.meti.go.jp/policy/mono_info_service/joho/conference/digital_infrastructure/0007/005_fujichimera.pdf (opinion)
- European Commission, EU launches InvestAI initiative to mobilise 200 billion euro (English). 2025-02-11. https://digital-strategy.ec.europa.eu/en/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- (Italian) Commissione europea, UE lancia InvestAI per mobilitare 200 miliardi di EUR. 2025-02-11. https://digital-strategy.ec.europa.eu/it/news/eu-launches-investai-initiative-mobilise-eu200-billion-investment-artificial-intelligence (opinion)
- Press Information Bureau (India), reply in the Lok Sabha on the IndiaAI Mission. 2026-03-25. https://www.pib.gov.in/PressReleasePage.aspx?PRID=2245063 (demonstrated)
- (Portuguese) Ministério da Ciência, Tecnologia e Inovação, Plano Brasileiro de Inteligência Artificial 2024-2028. 2025. https://www.gov.br/mcti/pt-br/acompanhe-o-mcti/transformacaodigital/plano-brasileiro-de-inteligencia-artificial (opinion)
- SoftBank Group, Global Tech Alliance Launches Stargate UAE. 2025-05-22. https://group.softbank/en/news/press/20250522 (opinion)
- NVIDIA, HUMAIN and NVIDIA Announce Strategic Partnership to Build AI Factories in Saudi Arabia. 2025-05-13. https://nvidianews.nvidia.com/news/humain-and-nvidia-announce-strategic-partnership-to-build-ai-factories-of-the-future-in-saudi-arabia (opinion)
- Cassava Technologies, Cassava scales African AI infrastructure with NVIDIA-powered AI factories. 2025. https://www.cassavatechnologies.com/cassava-scales-african-ai-infrastructure-with-nvidia-powered-ai-factories-to-accelerate-sovereign-data-capabilities/ (opinion)