Die Reality Code Engine: eine verlustfreie Form für natives, verifiziertes und energiesparendes Programmieren
Ein Programmiersystem, in dem ein Programm einmal als Zustandsautomat geschrieben und jede Zielsprache daraus erzeugt wird, mit Messungen zu Rundreisen, zur Abweisung fehlerhafter Eingaben und zur Reparatur gehobenen Codes.
David Charlot, Open Interface Engineering
Dies ist eine Übersetzung der englischen Fassung. Bei Abweichungen gilt die englische Fassung. Englisches Original.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Die Reality Code Engine: eine verlustfreie Form für natives, verifiziertes und energiesparendes Programmieren. Open Interface Engineering. Web: https://research.openie.dev/papers/rce/. PDF: https://research.openie.dev/pdfs/rce.pdf.
Version 1.4, 13. Oktober 2026. Spezifikation: aktueller Entwurf (Dokument Entwurf 0.7, Sprachversion 0.8), aus openIE-dev/rce 2a0ec68. Änderungen in 1.4: Die Zahl der Engine-Tests ist die der 589 verschiedenen Tests, die cargo test --release ausführt (1.3 nannte 596, die Summe von make check, die 7 Beweistests doppelt zählt); Abschnitt 3.7 hält fest, dass Spezifikation 2.7 nun die Kostenregel pro Aufrufstelle aus C.15 angibt; für den deterministischen Vorschlagenden aus Abschnitt 5.5 werden 87 angebotene, 9 zugelassene und 78 abgelehnte Identitäten berichtet, aus dem Engine-Test; Software Heritage und Rosetta Code in Abschnitt 7 tragen die Literaturangaben [129] bis [131], mit neu abgelesenen Archivzählern; neun Abbildungen kommen hinzu (Abbildungen 5 bis 10, 12, 13 und 15), und die früheren Abbildungen 5 und 6 sind nun die Abbildungen 11 und 14. Änderungen in 1.3: Größenabhängige Methodenkosten werden der Sprachversion 0.7 zugeordnet (in 1.2 waren sie unter 0.6 beschrieben), die Regel pro Aufrufstelle für Programme aus Modulen verschiedener Versionen wird angegeben, und die Prüfungen werden bei Engine-Commit 1eb5f02 erneut ausgeführt. Daten und Code: research.openie.dev/data/. Playground (Referenzprüfer): openie-dev.github.io/rce. Engine-Demo: /demos/rce-engine/. LaTeX-PDF: /pdfs/latex/rce.pdf (Quelltext).
Korrekturen und Stand der Reproduzierbarkeit (17. Oktober 2026). Dieser Hinweis wurde nach einem Abgleich des Papiers mit den öffentlichen Repositories ergänzt. Die betroffenen Angaben sind hier aufgeführt, und der Text unten ist ansonsten unverändert. Jede Zahl unten stammt aus src/data/rce-facts.json, erzeugt von scripts/claim-counts.py in openIE-dev/rce bei e416fd0, mit Ausnahme der beiden Lean-Zahlen, die bei 4304048 erhoben wurden.
- Eine Sprache (18. Oktober 2026). Der öffentliche main von
rce(4a3dc1f) hat eine einzige Sprache und einen einzigen Text. Eine Zeile# rce-version:ist eine tolerierte, ignorierte Release-Bezeichnung, die nicht gehasht wird, und eine Release-Bezeichnung benennt genau einen Spezifikations-Commit (C.15). Ein Konstrukt, das der Prüfer nicht implementiert, wird als reserviert, nicht implementiert abgewiesen (W-RES-1, Anhang F.12), nicht versionsweise; es gibt eine einzige Liste reservierter Wörter. Daher beschreiben Abschnitt 3.7 und Abbildung 5, die Versionsschranken (Versionen 0.5 bis 0.9) beschreiben, frühere Entwürfe und gelten nicht mehr. Ein fehlgeschlagener Aufruf stellt seine&mut-Argumente wieder her (F.4.4), was die Rückschreibregel von Theorem T33 ersetzt. Die Zahlen unten wurden beie416fd0erhoben, vor dieser Änderung, und nicht erneut ermittelt. Der Beweis von T33 hat sich mit der Regel geändert: Die abgelösten Theoreme zum Rückschreiben bei jedem Ausgang haben den auditierten Baum verlassen (öffentlicher main vonrce95ead2e), und T33 beweist nun die Wiederherstellung nach F.4.4; das Audit liest 4875 Theoreme, nur mit den Standardaxiomen. - Bibliotheksnamen (rce-stdlib, 18. Oktober 2026). Weil die Liste reservierter Wörter global ist, wurden Bibliotheksnamen, die sie nun reserviert, umbenannt:
labelzulbl,nodezund,groupzugrp,childzuchd,budgetzubud,restartzurst,replicatedzurepl,ctzuctext,sessionzusess,protocolzuproto,parzuparl,offerzuoffr,choosezuchse. Die TypenJson(Modulenc) undUrl(Modulnet.url) heißen nunJsonDocundUrlParts, sodass ein Programm, dasenc.Jsonodernet.url.Urlimportiert, die neuen Namen verwenden muss. Die Textlänge.len()eines Werts vom Typtextist.len_bytes()(Bytes) oder.len_chars(). - Versionen und Zahlen bei
e416fd0. Das Spezifikationsdokument ist Entwurf 0.9 (öffentlich seitcdae5cf). Vor dem 18. Oktober akzeptierte der Referenzprüfer die Sprachversionen 0.5 bis 0.9 und wies die Teile der Version 0.9, die er nicht implementierte, versionsweise ab (Anhang F.12). Die Theoreme T1 bis T56 sind formuliert; T42 bis T56 (Anhang F) sind formuliert und unbewiesen. Es gibt 58 Lean-Module und 59 Beispielprogramme (57 auf oberster Ebene und 2 in Paketen). Die Abbildungen und Bildunterschriften dieses Papiers, die Entwurf 0.7, Sprachversion 0.8, T1 bis T34, 31 Dateien oder 51 Beispiele nennen, beschreiben das Repository bei den früheren Commits, die sie nennen, und dieses Papier beschreibt Entwurf 0.9 nicht über diesen Hinweis hinaus. - Zahl der Lean-Theoreme. Es gibt zwei verschiedene Zahlen. Der Quelltext enthält 1,116 Deklarationen mit
theoremundlemmabeie416fd0(885 bei4304048). Das Audit (scripts/lean-audit.sh) zählt jede Theoremkonstante in der Umgebung des Kernels, einschließlich der Konstanten, die der Elaborator erzeugt, und ergab bei einem erneuten Lauf über das öffentliche Repository beie416fd04,877, wobeilake builddort über 58 Dateien vonspec/lean/RCE/ohnesorryund nur mit den Standardaxiomen durchläuft (2,949 über 46 Dateien bei4304048). Die unten genannten 2,192 sind die Audit-Zahl bei Engine-Commit1eb5f02über 31 Module. Keine der beiden Zahlen sagt etwas darüber, wie viele Theoreme über den Rust-Evaluator bewiesen sind. - Heute aus öffentlichen Repositories reproduzierbar: der Lean-Build und das Axiom-Audit, die Spezifikationsprüfung (Grammatiktabellen und Beispielkorpora), der Referenzprüfer und seine Tests sowie die kanonischen JSON-Vektoren.
- Noch nicht aus öffentlichen Repositories reproduzierbar: der Ökosystemlauf über 10,000 Formen (
bench/ecosystemliegt nicht in den öffentlichen Repositories), die Kani-Ergebnisse, die 589 Engine-Tests, die Reparaturraten aus Abschnitt 6 und jede Defects4J-Zahl. Sie werden hier als eigene Läufe der Autoren berichtet und sind so zu lesen, bis die Quellen und Seeds veröffentlicht sind. - Falsifikator RCE-F0. Siehe den Hinweis in Abschnitt 2.3 unten.
Zusammenfassung
Dieses Papier beschreibt die Reality Code Engine (RCE), ein System, in dem ein Programm einmal als Zustandsmaschine, Form genannt, geschrieben wird und Code in anderen Sprachen daraus erzeugt wird. Es berichtet, was an 10,000 Formen und an öffentlichen Fehlerdatensätzen gemessen wurde, und legt dar, wie die Aussagen widerlegt werden könnten.
In einfachen Worten
- Ein Programm wird einmal geschrieben, in einer einzigen präzisen Form, und der Computer erzeugt daraus dasselbe Programm in vielen Sprachen.
- Weil die Form nur zulässt, was deklariert wurde, werden fehlerhafte Eingaben schon an der Tür abgewiesen, statt später repariert zu werden.
- Eine Korrektur, die die Prüfungen besteht, wird gespeichert und wiederverwendet, sodass dasselbe Problem nicht zweimal Zeit oder Energie kostet.
1. These
Autonome Computerautomatisierung ist ein Entwurfsraum mit vielen Punkten. Jeder Ansatz liegt irgendwo entlang fünf stetiger Achsen: der Energie, die pro korrektem Ergebnis aufgewendet wird; der Entropie, die das System zur Laufzeit auflösen muss, und damit dem Grad, in dem seine Ausgabe deterministisch ist; der Stärke der Verifikation, die ein Ergebnis annimmt; dem Maß, in dem jedes angenommene Ergebnis wiederverwendet wird und kumuliert; und dem Maß, in dem der Ansatz sich auf ein Modell stützt. Ein großes Sprachmodell (LLM), ein statistisches Textmodell, das jede Änderung aus dem Prompt schreibt, liegt nahe einer Ecke dieses Raums: Es stützt sich bei jeder Aufgabe auf das Modell, zieht jedes Mal eine frische Stichprobe aus einer Verteilung hoher Entropie und bezahlt die Generierung bei jeder Aufgabe erneut. Retrieval, Regeln, Synthese, Verifikation und Caching besetzen viele andere Punkte, und reale Systeme kombinieren sie.
Die Reality Code Engine (RCE) ist ein Punkt in diesem Raum, und dieses Papier beschreibt und misst ihn. RCE modelliert ein Programm als funktionale Datenbank-Zustandsmaschine. Lopes und Kollegen haben gemessen, dass etwa 70% des Codes auf GitHub aus Klonen früherer Dateien besteht [33], daher versucht RCE zuerst, eine vorhandene Passung abzurufen, sie anzupassen und sie zu prüfen, und ruft ein Modell nur auf, wenn nichts Billigeres die Aufgabe schließt.
Die Kernaussage. RCE ist ein vollständiges Code-Ökosystem, in dem Programme nativ aus der Absicht geschrieben werden. Die Absicht wird einmal geschrieben, als Form: ein Zustand, eine Menge von Ereignissen und ein reiner, totaler Übergang. Die Form ist eine verlustfreie Codierung dieser Absicht. Jedes Ziel (Statechart, Rust, Python, XState, SCXML, WASM) ist eine Projektion der Form, und jede Projektion spielt die Spur der Form Byte für Byte nach. Ein Zustand, den die Form nicht deklariert, kann nicht geschrieben werden, und eine Eingabe außerhalb ihres Vertrags wird am Eingang abgewiesen. Ein Programm im Ökosystem kann daher nicht von seiner Absicht abdriften, so wie ein Programm in einer gängigen Sprache von seinen Kommentaren, seinen Tests oder seinen anderen Implementierungen abdriftet, und es braucht keinen nachträglichen Diff und keine nachträgliche Fehlerverfolgung. Jede Passung, die das Tor passiert, wird gespeichert und wiederverwendet, sodass das Ökosystem mit seinem Wachstum kumulativ zulegt (§2.4). Code, der in anderen Sprachen geschrieben ist, ist ein Eingang: Er tritt durch Hebung ein (§6).
Jeder Punkt des Raums steht vor demselben Tor. Das Tor ist Korrektheit: das Vollständigkeitsprädikat einer Aufgabe, hier die Tests der Aufgabe, ein Beweis oder eine Übereinstimmungsspur. Unter den Läufen, die das Tor passieren, werden Systeme nach den Joule bis zur Fertigstellung gereiht, . Korrektheit ist eine Nebenbedingung, keine Punktzahl.
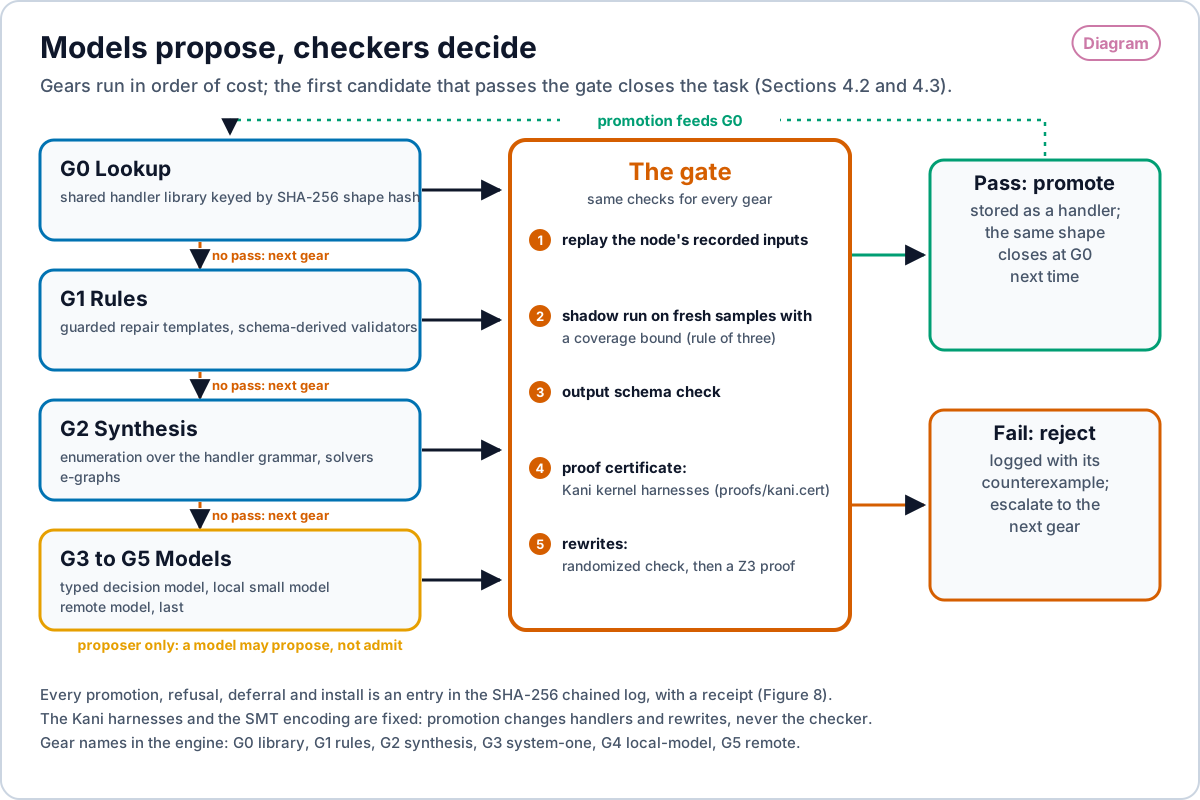
Die Mechanismen von RCE, Gänge genannt, laufen in der Reihenfolge ihrer Kosten, und der erste Gang, der das Tor passiert, schließt die Aufgabe.
Energieangaben sind nach Quelle gekennzeichnet. est_j ist eine analytische Schätzung. reported_j ist ein Zähler des Betriebssystems oder des Chips. measured_j ist einem Wandmessgerät vorbehalten und in jedem Ergebnis hier leer.
2. Der Entwurfsraum des autonomen Programmierens
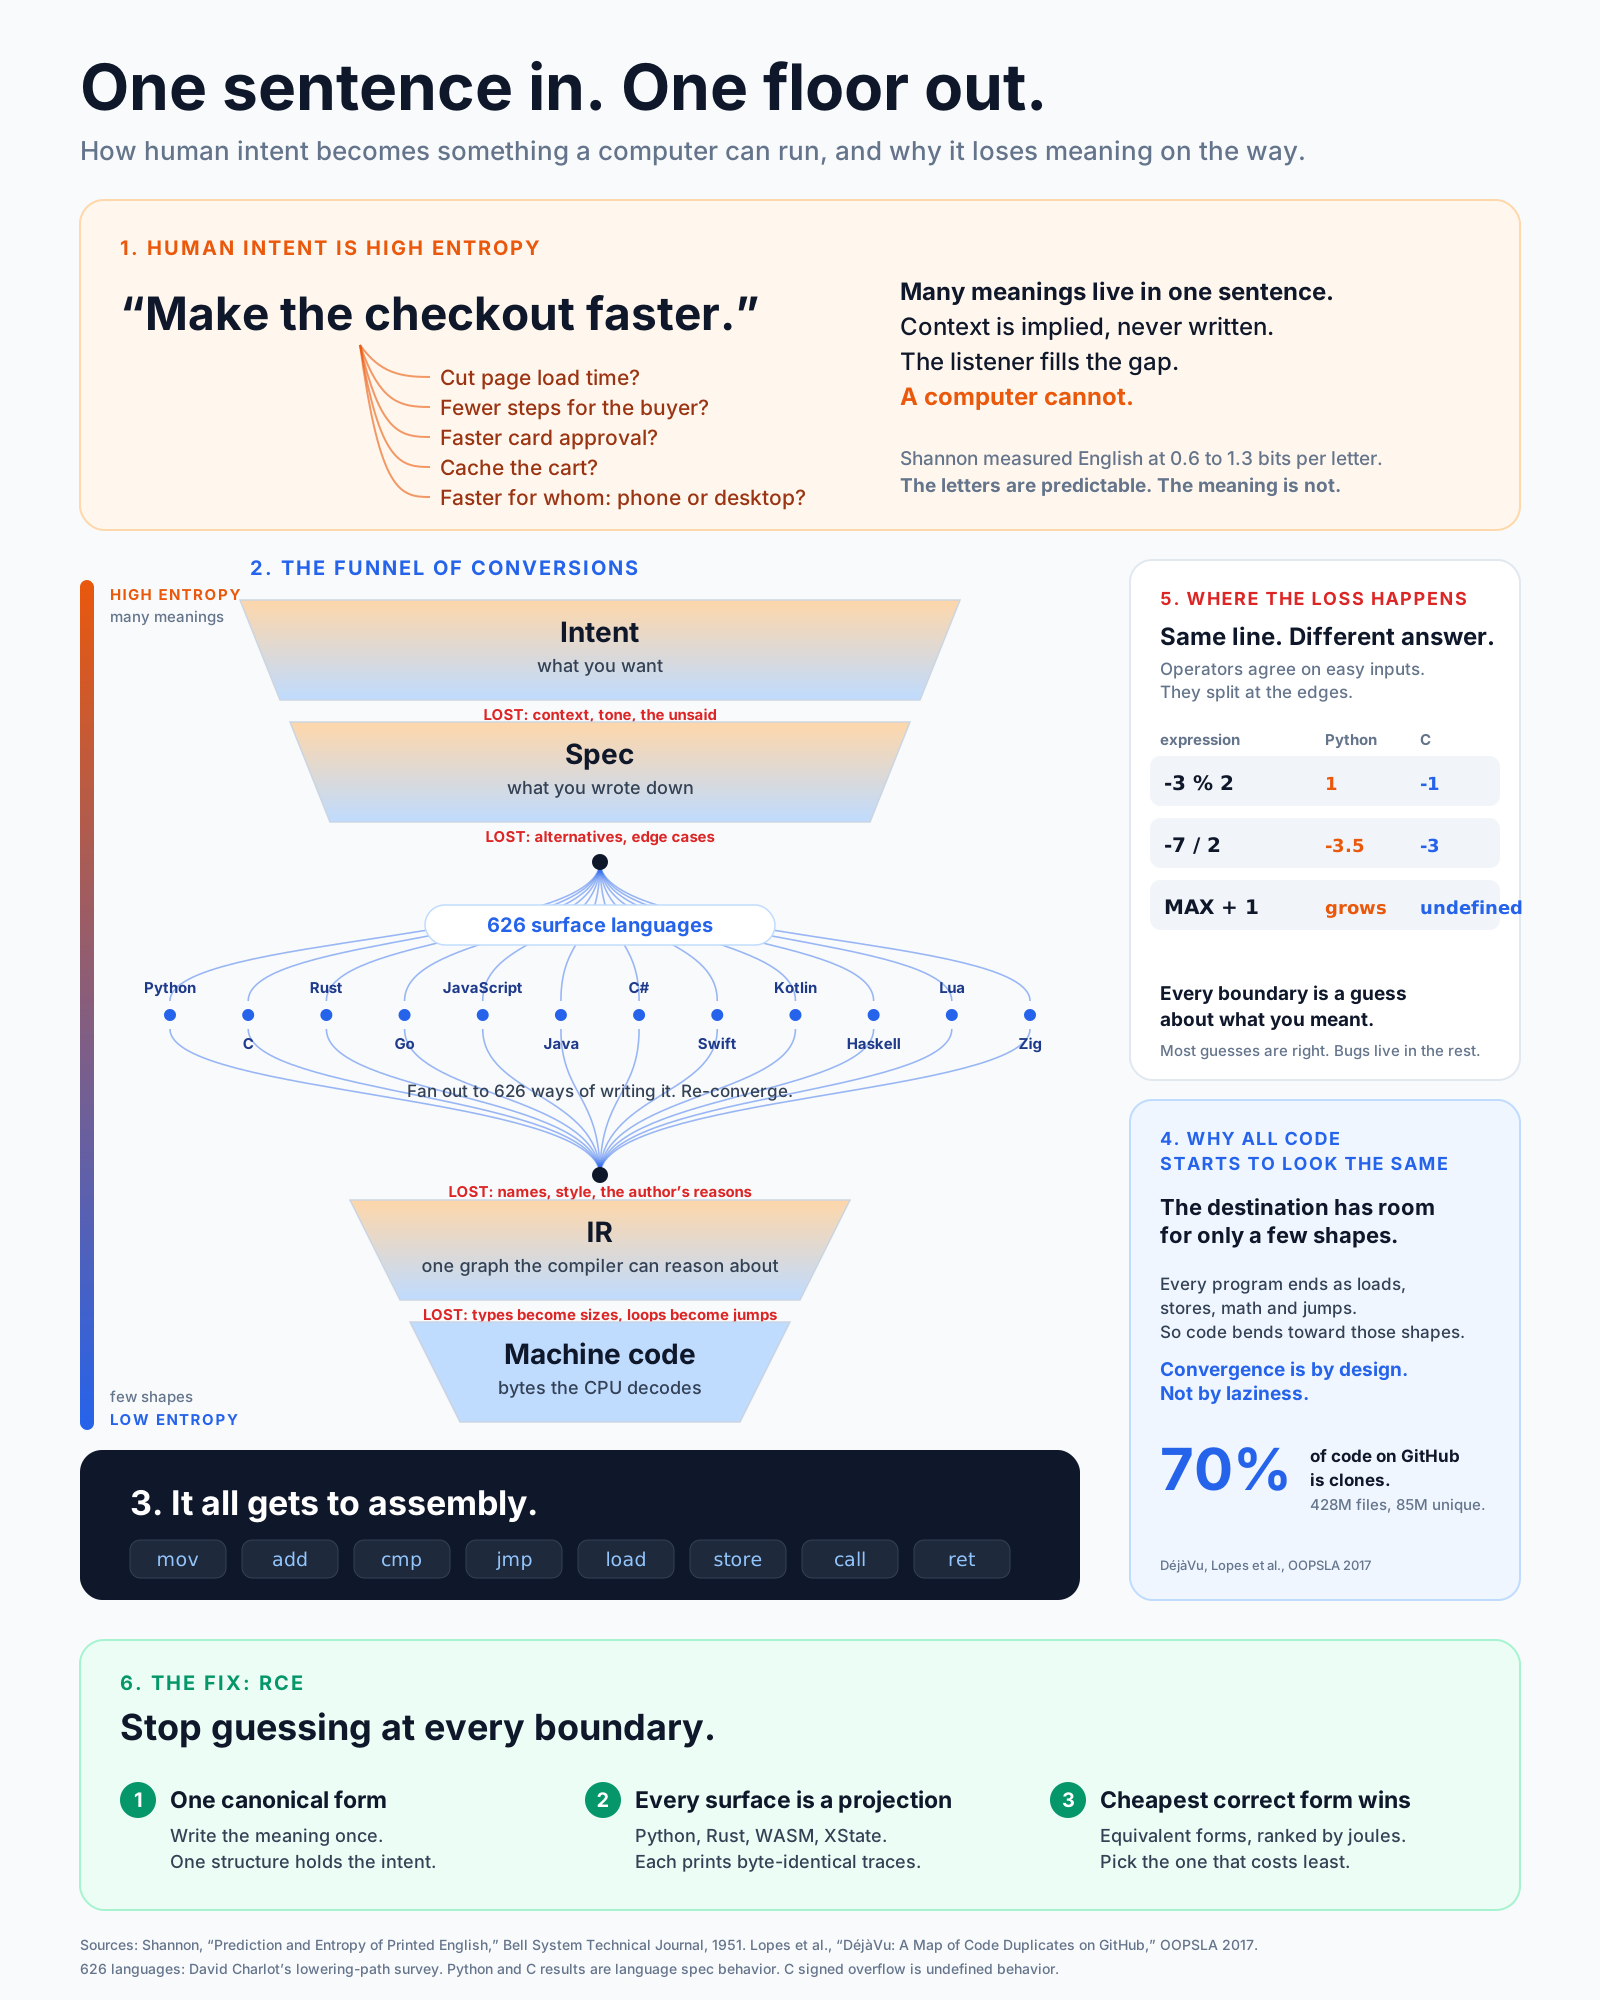
Absicht hat hohe Entropie. „Mach den Checkout schneller“ trägt viele Bedeutungen: kürzere Ladezeit, weniger Schritte, schnellere Kartenfreigabe, ein zwischengespeicherter Warenkorb oder schneller auf einer Geräteklasse. Kontext ist mitgemeint und nie aufgeschrieben. Shannon maß gedrucktes Englisch mit etwa 0.6 bis 1.3 Bit pro Buchstabe [1]. Die Buchstaben sind vorhersagbar. Die Bedeutung ist es nicht.
Jede Umwandlung verliert Information. Absicht wird zur Spezifikation, und Kontext geht verloren. Die Spezifikation wird zu einer von Hunderten Oberflächensprachen, und Alternativen und Randfälle gehen verloren. Der Quelltext wird zu einer Zwischendarstellung (IR), und Namen, Stil und die Gründe des Autors gehen verloren. Die IR wird zu Maschinencode, Typen werden zu Größen und Schleifen zu Sprüngen.
Der Boden hat niedrige Entropie. Jedes Programm endet als Laden, Speichern, Arithmetik und Sprünge. Das Ziel bietet nur Platz für wenige Formen, also biegt sich Code zu ihnen hin. Konvergenz ist konstruktionsbedingt.
An Grenzen geht die Bedeutung auseinander. Dieselbe Zeile liefert an den Rändern verschiedene Antworten. In Python ist -3 % 2 gleich 1 und -7 / 2 gleich -3.5. In C ist -3 % 2 gleich -1, -7 / 2 gleich -3, und vorzeichenbehafteter Überlauf ist undefiniert. Ein System, das Code an jeder Grenze neu generiert, rät an jeder Grenze.
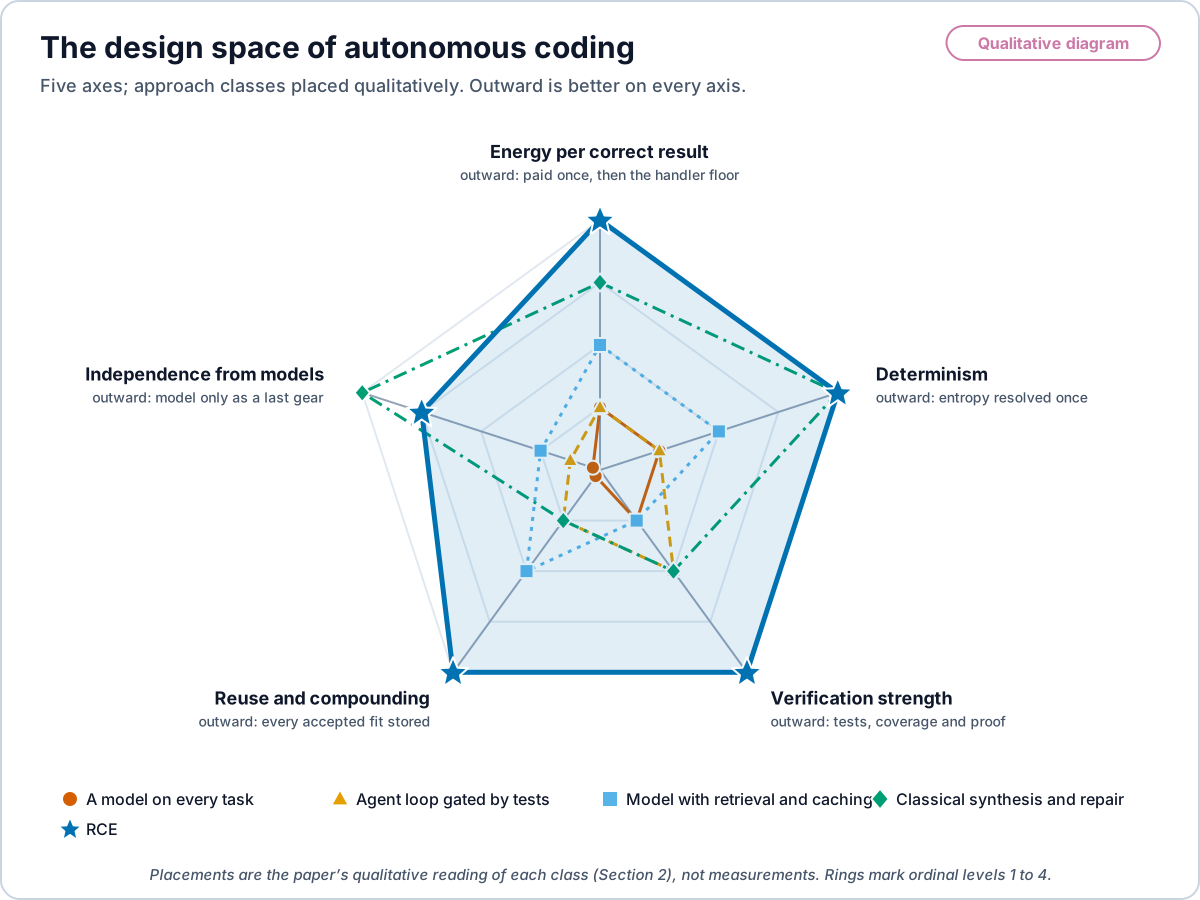
Die Achsen, als Größen ausgedrückt.
| Achse | Ein Ende | Anderes Ende | Wo RCE liegt |
|---|---|---|---|
| Energie pro korrektem Ergebnis | Bei jeder Aufgabe erneut voll bezahlt | Einmal pro neuem Fall bezahlt, danach der Boden des Handlers | Am Boden bei abgedeckten Aufgaben |
| Zur Laufzeit aufgelöste Entropie, und Determinismus | Die volle Verteilung des Prompts, jedes Mal eine frische Stichprobe | Nur der Rest, den keine gespeicherte Passung abdeckt, eine deterministische Ausgabe | Nur der Rest; jede Projektion deterministisch |
| Stärke der Verifikation | Ausgabe nach Durchsicht angenommen | Tests, Abdeckung und ein Beweiszertifikat | Das volle Tor bei jedem Ergebnis |
| Wiederverwendung und Kumulation | Jedes Ergebnis einmal verwendet | Jede angenommene Passung gespeichert und wiederverwendet | Jede Passung, die das Tor passiert, wird gespeichert |
| Abhängigkeit vom Modell | Ein Modell bei jeder Aufgabe | Kein Modell | Ein Modell nur als letzter Gang |
Ansätze unterscheiden sich auf jeder Achse dem Grad nach, und die Achsen wirken zusammen: Wiederverwendung senkt die Energie und die noch aufzulösende Entropie, und starke Verifikation ist das, was Wiederverwendung sicher macht. RCE schreibt die Bedeutung einmal, in einer kanonischen Form. Jede Oberflächensprache ist eine Projektion dieser Form, geprüft auf Übereinstimmung mit ihr. Unter äquivalenten Formen läuft die billigste korrekte.
Abbildung 2 zeichnet die fünf Achsen und ordnet die wichtigsten Klassen von Ansätzen darauf ein.
2.1 Programmieren ist Codierungstheorie
Die These dieses Abschnitts lautet, dass Programmieren als Codierungstheorie gelesen werden kann. Ein Programmierer wandelt Absicht entlang eines Gefälles zwischen zwei entropischen Regimen um. Absicht hat hohe Entropie, eine Verteilung über Bedeutungen. Code hat niedrige Entropie, ein deterministischer Übergang pro Zustand. Jeder Schritt der Softwarearbeit, von einer Anforderung bis zu einem Register, ist ein Schritt dieser Umwandlung. Die Literatur hat das seit siebzig Jahren stückweise gesagt, in vielen Sprachen. Dieser Abschnitt fügt die Stücke zu einem Argument zusammen und verortet jeden Gang von RCE darin.
Das Maß. Shannon definierte die Entropie einer Quelle und die Kapazität eines Kanals [40] und maß gedrucktes Englisch mit etwa 0.6 bis 1.3 Bit pro Buchstabe [1]. Kolmogorov, der 1965 auf Russisch in Problemy Peredachi Informatsii schrieb, gab drei Zugänge zur Informationsmenge an und stellte den algorithmischen an die erste Stelle: Die Information in einem Objekt ist die Länge des kürzesten Programms, das es erzeugt [41]. Solomonoff war als Theorie des induktiven Schließens zum selben Objekt gelangt [42], und Chaitin zeigte, dass die Programmgröße Identitäten gehorcht, die formal mit denen Shannons übereinstimmen [43]. Rissanen machte daraus eine Regel zur Modellwahl, die minimale Beschreibungslänge [44]. Zusammen sagen sie: Ein Programm ist ein Codewort, eine Beschreibung eines Verhaltens, und die kürzeste korrekte ist der Boden. Die Extraktionsregel von RCE, unter äquivalenten Passungen die mit den wenigsten Joule zu behalten (Proposition 3), ist diese Regel mit Joule statt Bit.
Code liegt im Regime niedriger Entropie, und man hat es gemessen. Hindle, Barr, Su, Gabel und Devanbu fanden, dass Code „very repetitive, and in fact even more so than natural languages“ ist, mit niedrigerer Kreuzentropie unter denselben n-Gramm-Modellen [35]. Gabel und Su fanden, dass die meisten Zeilen eines Projekts bereits anderswo existieren [34], und Lopes et al. fanden, dass die meisten Dateien auf GitHub Klone sind [33]. Tu, Su und Devanbu fanden, dass Code auch lokal ist: Was in der Nähe geschrieben wurde, sagt voraus, was als Nächstes kommt [46]. Ray und Kollegen fanden, dass fehlerhafte Zeilen weniger natürlich sind, mit höherer Entropie, und dass die Entropie sinkt, wenn der Fehler behoben ist [45]. 2025 nutzten Yang, Kolak, Hellendoorn und Martins die Entropieänderung, die ein Patch bewirkt, um Reparaturkandidaten zu reihen und korrekte Patches von überangepassten zu trennen [51]. Allamanis, Barr, Devanbu und Sutton gaben unter dem Namen Natürlichkeit einen Überblick über das Feld [47]. Das Ergebnis ist kein rein englischsprachiges. Prem Devanbu trug es 2013 als Keynote auf der India Software Engineering Conference vor [50]. Sridhara, Sinha und Mani von IBM Research India maßen am selben Ort die natürlichsprachlichen Artefakte rund um Code und fanden, dass Commit-Nachrichten am regelmäßigsten sind und Prosa auf Stack Overflow sich wie gewöhnliches Englisch verhält [49]. In China veröffentlichte das Journal of Software (软件学报) 2022 einen Überblick über die Forschung zur Natürlichkeit von Code, der das Kreuzentropiemaß und den Befund nennt, dass fehlerhafter Code höhere Entropie hat [48]. In Japan nutzten Doi, Higo, Arima, Shimonaka und Kusumoto von der Universität Osaka n-Gramm-Natürlichkeit, zuerst in einem japanischsprachigen technischen Bericht der IEICE und dann auf der ICPC 2018, um maschinell erzeugte Quelldateien von menschlich geschriebenen zu unterscheiden [73, 74]. Generierter Code liegt auf der Entropieskala noch tiefer als menschlicher Code, weil ein Generator eine feste Umwandlung ist. In Brasilien baute Arrebolas Dissertation Codevorschläge auf n-Gramm- und Themenmodellen, segmentiert nach Projekt und Maintainer, und bewertete sie über die Kreuzentropie, die Bits, die zur Codierung des nächsten Tokens nötig sind [75]. Die beiden Regime sind in einem einzigen Repository sichtbar: Die Prosa rund um den Code hat hohe Entropie, der Code niedrige.
Das Maß ist entscheidend. Febres, Jaffé und Gershenson verglichen von Venezuela und Mexiko aus englische, spanische und Programmtexte nach Vokabularvielfalt pro Nachrichtenlänge und fanden den Programmtext vielfältiger [76]. Rahman, Palani und Rigby fanden, dass ein großer Teil der n-Gramm-Vorhersagbarkeit von Code von Syntax-Tokens stammt und dass Code nach deren Entfernung immer noch repetitiv ist, weniger als zuerst berichtet, wobei die API-Nutzung der repetitivste Teil ist [77]. Beide Ergebnisse schärfen die Aussage, statt sie umzukehren. Vielfalt der Symbole ist nicht Vorhersagbarkeit, und das Regime niedriger Entropie ist eine Eigenschaft der bedingten Verteilung des nächsten Schritts, genau das, was ein deterministischer Übergang festlegt. Aus diesem Grund setzt G0 von RCE an Formen an, nicht an Oberflächen-Tokens.
Absicht liegt im Regime hoher Entropie. Zave und Jackson zeigten, dass eine Anforderung eine Aussage über die Umgebung ist, eine Spezifikation eine Aussage an der Schnittstelle, und dass die Lücke zwischen beiden nur durch Domänenwissen gefüllt wird, das oft nicht aufgeschrieben ist [64]. Brooks teilte die Schwierigkeit von Software in Essenz und Akzidenz: Die Essenz ist das begriffliche Konstrukt, und das meiste davon ist Spezifikation und Entwurf, nicht Darstellung [61]. Naur argumentierte, dass ein Programm der sichtbare Teil einer Theorie ist, die seine Programmierer besitzen, und dass diese Theorie aus dem Text nicht vollständig rückgewinnbar ist [62]. Durch Shannon gelesen sagen alle drei dasselbe. Absicht trägt mehr Unsicherheit als jedes einzelne Programm, und das Schreiben des Programms ist der Akt, der sie beseitigt. Was nach dem Schreiben des Codes im Kopf eines Programmierers bleibt, ist der Teil der Absicht, den der Code nicht codiert hat.
Die Umwandlung ist eine Verfeinerung, und Verfeinerung ist eine Einengung. Hoare gab Programmen eine Logik, in der ein Programm relativ zu einer Vor- und Nachbedingung korrekt ist [54]. Wirth lehrte schrittweise Verfeinerung: eine Aufgabe durch aufeinanderfolgende Entscheidungen in Anweisungen zerlegen, wobei jede eine Wahl festlegt, die die Spezifikation offen ließ [53]. Dijkstras bewachte Befehle machten die offenen Wahlen als Nichtdeterminismus explizit und leiteten Programme aus Spezifikationen ab, indem sie ihn beseitigten [52]. In München baute das CIP-Projekt von Bauer und Wössner Programmentwicklung als Folge korrektheitserhaltender Transformationen von der Spezifikation zum Programm [58]. In Frankreich trugen Abrials B-Methode und danach Event-B die Verfeinerung in den industriellen Maßstab, mit Beweisverpflichtungen bei jedem Schritt [55, 56]. In Finnland gaben Back und von Wright der Verfeinerung ihren verbandstheoretischen Kalkül [57]. In jedem Fall bezeichnet eine Spezifikation eine Menge zulässiger Verhaltensweisen, und jeder Verfeinerungsschritt verkleinert die Menge, bis ein deterministisches Verhalten übrig bleibt. Das ist Entropiereduktion mit einem Beweis bei jedem Schritt. Die Form von RCE ist das letzte Glied dieser Kette: ein totaler, deterministischer Übergang über Datenbankzustände, bei dem jede Wahl aufgelöst ist (§3.2).
Synthese ist Suche, die einen Hypothesenraum einengt. Gulwanis FlashFill lernt ein Zeichenkettenprogramm aus wenigen Ein- und Ausgabebeispielen, indem es die Menge aller konsistenten Programme darstellt und sie mit jedem neuen Beispiel schneidet [59]. Gulwani, Polozov und Singh fassen Programmsynthese allgemein als Suche in einem Programmraum, der durch Absicht beschränkt ist [60], und Solar-Lezamas Sketching füllt Lücken in einem Teilprogramm mit einem Löser [27]. Jedes Beispiel und jede Nebenbedingung ist eine Messung, die Hypothesen entfernt. Shannons Maß zählt, wie viele solcher Messungen nötig sind. G2 von RCE ist dieser Gang.
Was die Umwandlung erzeugt, hat eine Form. Gurevich bewies, dass jeder sequentielle Algorithmus von einer Abstract State Machine auf seiner eigenen Abstraktionsebene erfasst wird [2]. Codd machte den Zustand zu einer Relation [5], und Event Sourcing macht den Zustand zur Faltung eines nur anhängbaren Logs [14]. Nach Curry und Howard ist ein Beweis ein Programm und eine Aussage ein Typ [18, 72], also ist eine verifizierte Passung ein Beweis ihrer Spezifikation. Das sind die Gründe, warum das Regime niedriger Entropie wenige Formen hat: Das Ziel ist eine Zustandsmaschine über einer Datenbank, gleich welche Oberflächensprache.
Niedrige Entropie zerfällt ohne Tor. Lehman beobachtete über Jahrzehnte großer Systeme, dass ein genutztes Programm sich ständig ändern muss und dass seine Komplexität wächst, sofern keine Arbeit zu ihrer Verringerung geleistet wird [63]. Torres, Baltes, Treude und Wagner maßen strukturelle und textuelle Entropie über die Commit-Historien von 25 Projekten und fanden, dass beide gemeinsam steigen [78]. Entropie fließt aus der Umgebung in den Code zurück. Ein System, das Code im Regime niedriger Entropie halten will, braucht ein Tor an jeder Änderung, und das Tor von RCE ist Korrektheit (§4.3).
Compiler betreiben bereits Quellencodierung. Franz und Kistler lieferten Programme als komprimierte abstrakte Syntaxbäume aus und erzeugten beim Laden nativen Code, was Quellencodierung eines Programms über seiner eigenen Grammatik ist [67]. Fraser leitete aus einem Korpus statistische Modelle von Code ab, um ihn zu komprimieren [68]. Futamura zeigte 1971 in der japanischen Zeitschrift Systems, Computers, Controls, dass die Spezialisierung eines Interpreters auf ein Programm ein kompiliertes Programm ergibt und die Spezialisierung des Spezialisierers einen Compiler [70]. Ershov entwickelte in Nowosibirsk dieselbe Idee als gemischte Berechnung [71]. Die abstrakte Interpretation der Cousots berechnet eine korrekte Beschreibung mit weniger Information für jedes Verhalten eines Programms [69]. Die Analogie zur Kanalcodierung ist die Lesart dieses Papiers, kein zitierter Satz: Typen, Tests und Beweise fügen geprüfte Redundanz hinzu, sodass ein falsches Programm erkannt wird, bevor es läuft, so wie eine Paritätsprüfung ein verfälschtes Wort erkennt.
Beim Löschen fallen die Joule an. Landauer zeigte, dass ein logisch irreversibler Schritt, das Löschen eines Bits, mindestens dissipiert [65]. Bennett zeigte, dass Berechnung grundsätzlich logisch reversibel gemacht werden kann, sodass das Löschen, nicht die Berechnung, die Schranke trägt [66]. Die Umwandlung hochentropischer Absicht in ein niedrigentropisches Programm verwirft jede Alternative, die die Absicht zuließ. Dieses Verwerfen ist ein Löschen von Information über die Alternativen, und es hat einen thermodynamischen Boden. RCE bezahlt das Verwerfen einmal pro neuem Fall und speichert das Ergebnis, sodass ein wiederholter Fall nichts Neues löscht.
2.2 Wie RCE umwandelt und wo jeder Gang sitzt
Als Codierungstheorie gelesen trifft eine Aufgabe als Nachricht ein, deren verbleibende Unsicherheit das ist, was keine gespeicherte Passung bereits auflöst. Jeder Gang entfernt Unsicherheit zu einem anderen Preis, und die Gänge sind nach diesem Preis geordnet (§4.2).
| Gang | Was er mit der Unsicherheit macht | Herkunft im obigen Argument |
|---|---|---|
| G0 Nachschlagen | Erkennt, dass die Absicht bereits codiert wurde; löst sie durch Abruf auf, am Boden des Handlers | Repetitivität und Klone [33, 34, 35]; Lokalität [46] |
| G1 Regeln | Wendet eine bekannte bewachte Umschreibung an; löst einen wiederkehrenden Rest ohne Suche | Korrektheitserhaltende Transformation [52, 58]; Verfeinerung mit Beweisverpflichtungen [55, 56] |
| G2 Synthese | Durchsucht einen Hypothesenraum und engt ihn durch Beispiele, Nebenbedingungen und einen Löser ein | Programmsynthese als Suche [27, 59, 60] |
| G3 bis G5 Modelle | Zieht aus einer gelernten Verteilung über Code, wenn kein niedrigerer Gang die Lücke schließt; nur als Vorschlagender | Kreuzentropiemodelle von Code [35, 47] |
| Tor | Nimmt einen Kandidaten nur mit Tests, Abdeckung und einem Beweiszertifikat an | Hoare-Logik [54]; Curry-Howard [18, 72] |
| Beförderung | Speichert die angenommene Passung, sodass derselbe Rest beim nächsten Mal G0 kostet | Minimale Beschreibungslänge [44]; Landauer-Löschung einmal bezahlt [65] |
Positionen auf den Achsen von Abschnitt 2 unterscheiden sich darin, wo die Umwandlung bezahlt wird. Ein Ansatz, der bei jeder Aufgabe aus der vollen Verteilung des Prompts zieht, bezahlt jedes Mal erneut die hochentropische Seite. Ein Ansatz, der angenommene Passungen speichert und wiederverwendet, bezahlt nur den Rest, und nur einmal. Die meisten Systeme liegen zwischen diesen Enden, und RCE liegt am Ende der Wiederverwendung.
2.3 Das Ökosystem bei großem N
Die Aussage von §1 wird direkt gemessen. Der Benchmark wurde vor dem Lauf präregistriert (bench/ecosystem/PREREG.json). Ein Generator mit Seed schreibt 10,000 Formen, jede bestehend aus einer Quelle, einer Regel, deren Rumpf ein zufälliger arithmetischer Term der Tiefe bis 3 über acht Operatoren ist, und einer Senke. Die Engine ist bei Commit a079967 eingefroren, und kein Modell wird aufgerufen.
| Eigenschaft | Was pro Form geprüft wird | N | Gilt | Modellaufrufe |
|---|---|---|---|---|
| Verlustfreie Codierung | Form IR zu kanonischem JSON zu Form IR zu kanonischem JSON ist die Identität | 10,000 | 10,000 | 0 |
| Deterministische Projektion | Zwei Kompilierungen ergeben dieselben Bytes; die XState- und SCXML-Projektionen der ursprünglichen und der hin und zurück übersetzten Form sind Byte für Byte gleich | 10,000 | 10,000 | 0 |
| Getreue Projektion, Python | Das erzeugte Python-Modul gibt die Referenzspur auf 40 Ereignissen mit Seed Byte für Byte aus | 10,000 | 9,999 | 0 |
| Tor am Eingang, Eingaben | Fünf Arten fehlerhafter Nutzdaten (falscher Typ, null, fehlendes Feld, leer, verschachtelt) werden alle abgewiesen, ohne angenommenes Ergebnis | 10,000 | 10,000 | 0 |
| Tor am Eingang, Spezifikationen | Eine Spezifikation mit einem Fluss zu einem nicht deklarierten Knoten wird vor dem Kompilieren abgewiesen | 10,000 | 10,000 | 0 |
Abbildung 3 zeigt dieselben Zählungen.
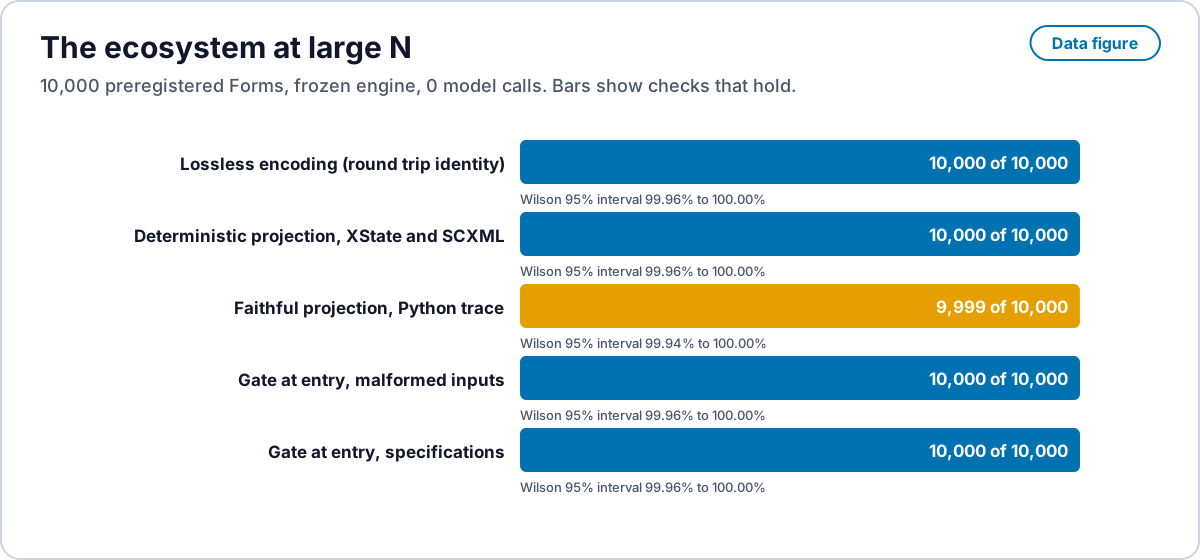
a079967, 0 Modellaufrufe, mit Wilson-95%-Intervallen, berechnet aus den Zählungen. Quelle: bench/ecosystem. Eine PNG-Kopie ist verfügbar. Open full size · PNG
RCE-F0 und der Python-Fehlschlag. Abschnitt 9 formuliert RCE-F0 so: In einem präregistrierten Lauf von mindestens 10,000 Formen gibt irgendeine Projektion eine Spur aus, die von der Referenzspur der Form abweicht, oder irgendeine fehlerhafte Eingabe wird angenommen. Dieser Lauf ist präregistriert, umfasst 10,000 Formen, und ein erzeugtes Python-Modul gab die Referenzspur nicht aus; die Beobachtung erfüllt also, so wie sie geschrieben steht, die Bedingung von RCE-F0. Das Papier berichtet den Fehlschlag und den Regressionstest unten, und es nennt keine Grundursache. Der Text von RCE-F0 ist so zu lesen, wie er formuliert ist: Die Aussage, die er widerlegt, ist, dass Projektionen getreu sind, und die Python-Projektion dieses Laufs hat diese Aussage bei einer Form nicht erfüllt. Ob der Fehlschlag vom Emitter oder vom Harness kommt, ist hier offen. Dass sich dieselbe Form unter 32 Hash-Seeds identisch abspielt, entscheidet das nicht.
Der eine Python-Fehlschlag wird als Fehlschlag gezählt; dieselbe Form und dieselben Ereignisse spielen sich im Regressionstest tests/form_ecosystem_regress.rs unter 32 Hash-Seeds identisch ab. Die Energie ist hier nur est_j; der ganze Lauf brauchte 393 s CPU-Zeit auf einem Kern. Die erzeugten Formen sind klein, daher misst diese Tabelle die Codierung, die Projektionen und das Tor. Gehobene Formen aus realen Programmen werden nach dem Protokoll von §8.7 gemessen.
2.4 Rekursive Selbstverbesserung, durch ein Tor gesichert und verifiziert
Good (1965) [111] definierte die ultraintelligente Maschine als eine, die bessere Maschinen entwerfen kann, sodass sich die Verbesserung rekursiv fortsetzt. Yudkowsky (2013) [113] fasste die Frage als eine der Erträge: ob jede Einheit Verbesserung die nächste Einheit billiger oder teurer macht. Schmidhubers Gödel-Maschine (2007) [112] gab eine formale Antwort mit einer Garantie: Ein Programm schreibt jeden Teil seiner selbst um, einschließlich seiner eigenen Suche, erst nachdem es bewiesen hat, dass die Umschreibung seinen erwarteten Nutzen erhöht. Löbs Theorem (1955) [114] ist das Hindernis, auf das ein sich selbst vertrauender Beweiser stößt, und Yudkowsky und Herreshoff (2013) [115] nannten es das Löbsche Hindernis: Ein System kann im Allgemeinen die Korrektheit eines Nachfolgers, der sein eigenes Beweissystem verwendet, nicht beweisen. Neuere Systeme lassen die Beweisforderung fallen und wählen nach gemessener Punktzahl aus: STOP (Zelikman et al., 2023) [116] verbessert das Gerüst, das Code verbessert, die Darwin Gödel Machine (Zhang et al., 2025) [117] führt ein Archiv selbstveränderter Programmieragenten, ausgewählt nach Benchmarkpunktzahl, AlphaEvolve (Novikov et al., 2025) [118] entwickelt Programme unter automatischen Bewertern weiter, und Voyager (Wang et al., 2023) [119] lässt eine Bibliothek verifizierter Fähigkeiten wachsen, die spätere Aufgaben wiederverwenden.
RCE übernimmt die Struktur der Gödel-Maschine und die Bibliothek von Voyager, mit zwei Unterschieden, die das Hindernis für die Objekte, die sie befördert, umgehen. Erstens ist das Objekt, das sich verbessert, nicht der Beweiser. RCE befördert Handler, Umschreibungen und Gänge, und jedes davon wird gegen einen festen, gesondert zertifizierten Kern geprüft: Die Kani-Harnesses und die SMT-Kodierung ändern sich durch Beförderung nie, sodass kein Schritt dem Beweissystem eines Nachfolgers vertrauen muss. Zweitens ist das Tor ein Korrektheitsbeweis an der Grenze, keine Punktzahl. Eine Punktzahl kann steigen, während eine Schnittstellenannahme bricht; ein Beweis an der Grenze kann von einer Änderung, die sie bricht, nicht passiert werden.
Proposition R1 (monotone Korrektheit). Wenn jede beförderte Änderung die Prüfung ihrer Grenze besteht und die Prüfungen der anderen Grenzen unverändert sind, dann gilt jede Eigenschaft, die diese Prüfungen vor der Beförderung festgestellt haben, auch nach ihr.
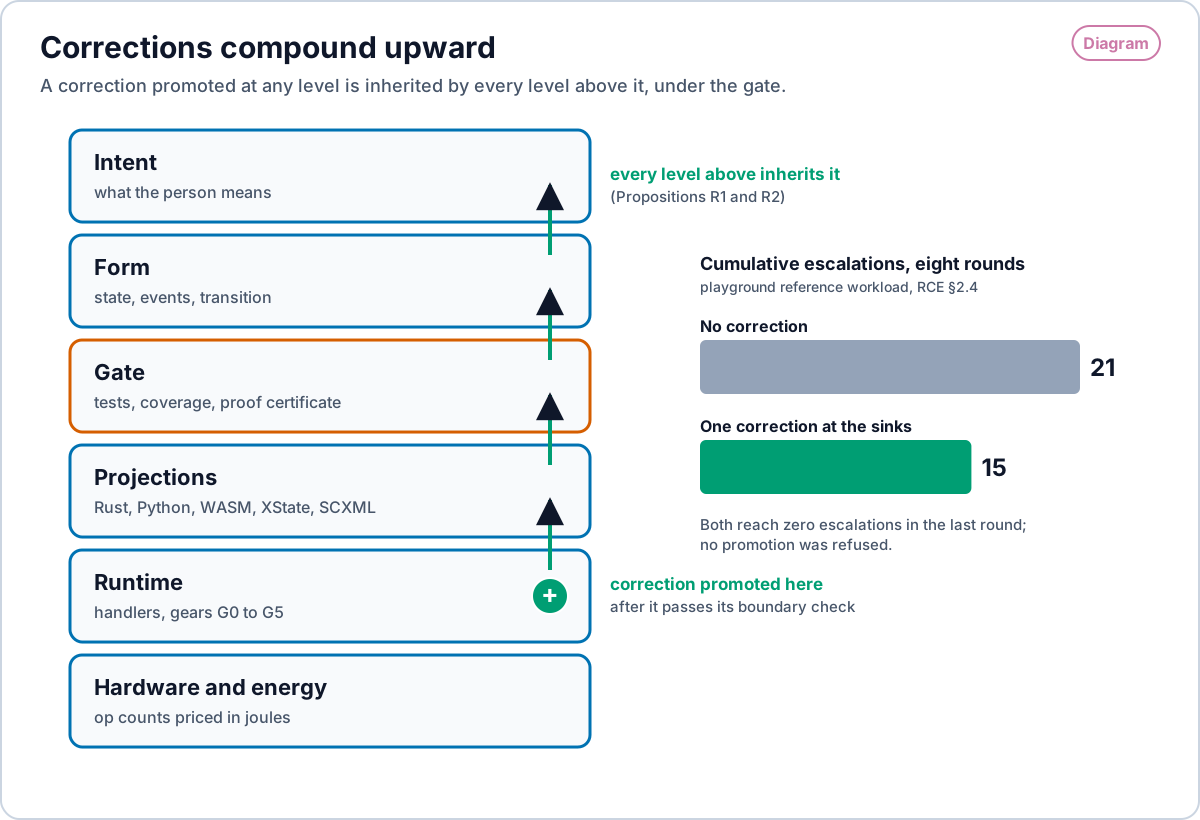
Proposition R2 (Kumulation). Eine Arbeitslast sei eine Multimenge von Aufgaben, und ein beförderter Handler schließe jede Aufgabe seiner Gestalt. Dann ist die Zahl der Eskalationen in Runde t in t nicht steigend, und eine vor Runde 1 beförderte Korrektur senkt die kumulierten Eskalationen jedes Horizonts um die Eskalationen, die sie in jeder späteren Runde schließt. In der Referenzarbeitslast der Engine-Demo fallen die kumulierten Eskalationen über acht Runden mit einer Korrektur an den Senken von 21 auf 15 und erreichen in beiden Fällen in der letzten Runde null, wobei jede Aufgabe korrekt geschlossen und keine Beförderung abgelehnt wird.
Abbildung 4 zeichnet den Mechanismus der Propositionen R1 und R2 mit den Summen der Referenzarbeitslast.
Proposition R3 (fallende Kosten). Da ein beförderter Handler anstelle eines Modellaufrufs ausgeführt wird und seine Kosten die Operationszahl des Handlers sind, bepreist mit der Substrattabelle, fällt die Energie einer Runde gegen die Energie der Handler allein, während die Eskalationen gegen null fallen.
Futamuras Projektionen (1971, neu veröffentlicht 1999) [120] und Turchins Superkompilation (1986) [121] geben den Grenzwert dieses Prozesses an. Einen Interpreter auf ein Programm zu spezialisieren ergibt ein kompiliertes Programm; den Spezialisierer zu spezialisieren ergibt einen Compiler. Die Beförderungen von RCE spezialisieren den allgemeinen Eskalationspfad auf die Gestalten, die tatsächlich vorkommen, sodass die Engine gegen das Restprogramm ihrer Arbeitslast konvergiert: den Teil der Berechnung, den ein Modell oder ein Mensch noch liefern muss. Rekursive Selbstverbesserung unter einem Tor ist diese Konvergenz, vollzogen in geprüften Schritten. Die Compounding-Ebene der RCE-Engine-Demo führt diese Arbeitslast im Browser aus.
3. Die Form
3.1 Die stärkste formale Aussage über „dieselbe Form“
Zuerst wird der Geltungsbereich des Satzes genannt. Gurevichs sequentielle Postulate decken sequentielle Algorithmen ab; parallele und interaktive Algorithmen brauchen die weiteren Postulate von Blass und Gurevich [3]. Blass, Dershowitz und Gurevich argumentieren, dass keine einzelne Äquivalenzrelation auf Algorithmen jedem Zweck genügt [79], und Moschovakis und Vardi legen die Debatte darüber dar, was ein Algorithmus ist [80, 81]. Ein Web-Handler, der Ein- und Ausgabe ausführt, liegt außerhalb des sequentiellen Satzes. Die Form behandelt Interaktion so wie die interaktive Linie: Jede Eingabe ist ein Ereignis in , und die Zustandsmaschine macht darauf einen Schritt. „Eine Form“ ist also eine Modellierungsentscheidung, die im sequentiellen Satz gründet und per Konvention erweitert ist, mit Vorbildern in der Produktion in der Elm-Architektur [83], in Ereignishistorien dauerhafter Workflows [84] und in Stromsemantiken wie Flo [82]. Die Propositionen von Abschnitt 3.4 sind für diese Entscheidung formuliert.
Gurevichs Satz über Abstract State Machines (ASM) ist die stärkste formale Aussage, dass jeder Algorithmus eine Form hat [2]. Eine abstrakte Zustandsmaschine ist eine Maschine, deren Zustände Strukturen erster Stufe sind und deren Schritt eine endliche Menge bewachter Aktualisierungen ist. Gurevich stellt drei Postulate auf. Sequentielle Zeit: Ein Algorithmus hat Zustände, Anfangszustände und eine Ein-Schritt-Abbildung . Abstrakter Zustand: Zustände sind Strukturen erster Stufe über einem festen Vokabular, abgeschlossen unter Isomorphie. Beschränkte Erkundung: Eine endliche Menge von Termen entscheidet jeden Schritt. Sein Hauptsatz (Theorem 6.13) lautet: „For every sequential algorithm A, there exists an equivalent sequential abstract state machine B.“ Blass und Gurevich erweitern ihn auf parallele Algorithmen [3]. Dershowitz und Gurevich fügen ein viertes Axiom hinzu, dass die Anfangsoperationen berechenbar sind, und leiten daraus die Church-These ab [4].
3.2 Definitionen
Definition 1 (die Form). Ein Programm ist ein Tupel
- , der Zustandsraum: Strukturen über einem festen Vokabular , aufgeteilt in Kontrollregionen und Daten . enthält die logische Uhr, die Zahl der Eingaben und die typisierten Relationen (in der Sprache auch die deklarierten Regionen). Jeder Zustand ist eine Datenbankinstanz im Sinne Codds [5].
- , das Ereignisalphabet, einschließlich des Takts der logischen Uhr.
- , der Übergang: total, deterministisch und rein, geschrieben als endliche Menge bewachter Aktualisierungen „if then “, wobei jeder Schritt eine beschränkte Menge von Orten liest. Er liefert den nächsten Zustand und die Ausgaben des Schritts. Man schreibe für seine Zustandskomponente.
- , das dauerhafte Log: eine Folge von Einträgen , wobei der SHA-256 des kanonischen JSON des Zustands nach dem Schritt ist, der SHA-256 des kanonischen JSON der ersten vier Felder, und der erste aus 64 Nullen besteht. Das Log ist eine Hashkette, sodass die Änderung eines beliebigen vergangenen Eintrags jeden späteren ändert.
- , die Ausgabeabbildung. Ein Mealy-Automat liest beide Argumente [6]; ein Moore-Automat liest nur den Zustand [7].
Definition 2 (Form und Passung). Die Form ist die Tupelgestalt mit vier Invarianten: ist deterministisch und rein; die Erkundung ist beschränkt; das Vokabular ist fest; der Zustand ist die Faltung des Logs,
Ein Log kann zu jedem Eintrag auch dessen Ergebnis, Ausgaben und Zustand tragen. Diese sind abgeleitet: Sie werden nicht gehasht und müssen der Wiedergabe gleichen (T1 und T3 aus §3.7). Zwei Arten der Ablehnung sind zu unterscheiden. Im Engine-Profil wird jedes Ereignis angewendet, und eine Eingabe, die ihren Vertrag verletzt, erzeugt eine reject-Ausgabe und eine Fehlerzeile. In der Sprache lässt ein abgelehntes Ereignis den Zustand unverändert (T8) und wird als abgelehnt aufgezeichnet.
Die Passung sind die Daten, die die Gestalt ausfüllen: das Vokabular , die Alphabete und , das Regelprogramm , das definiert, die Ausgaberegeln, die definieren, und die Anfangsdaten . In Gurevichs Begriffen ist die Passung das Vokabular, das ASM-Programm und die Anfangsstrukturen. In Codds Begriffen ist das Schema und die Instanz. In Begriffen der Produktlinien ist eine Passung eine Merkmalsauswahl [8]. In Begriffen der syntaxgesteuerten Synthese (SyGuS) ist eine Passung ein Term aus einer Grammatik, der eine Spezifikation erfüllt [9].
Definition 3 (Äquivalenz von Passungen). Zwei Passungen sind äquivalent, wenn für jede Ereignisfolge ihre Ausgabefolgen unter gleich sind.
Definition 4 (Passungssprache). Eine Grammatik, deren Terme Passungen bezeichnen. Programmiersprachen, SCXML-Dokumente, XState-Konfigurationen und .rce-Spezifikationen sind Passungssprachen. Eine Passungssprache ist vollständig, wenn jedes ASM-Programm über einen Term in ihr hat.
Definition 5 (Kontrollprojektion). Man teile in endliche Kontrollsymbole und Datenrelationen. Das Statechart von ist die Projektion von auf : Zustände sind Werte von , Übergänge tragen ein Ereignis und einen Wächter über , und Aktionen sind Aktualisierungen von . Harels Statecharts liefern die Hierarchie und die orthogonalen Regionen [10].
Definition 6 (Passungs-E-Graph). Für eine Passung und eine Menge korrekter Umschreibungen ist der Passungs-E-Graph der saturierte E-Graph der Regelterme von unter [11, 12]. Jede E-Klasse enthält Passungen, die nach Definition 3 äquivalent sind.
Definition 7 (Joule-Kosten). ist die geschätzte Energie (est_j), um den Term einmal auf einem benannten Substrat auszuführen, gewichtet mit der erwarteten Zahl von Läufen.
3.3 Warum „funktionale Datenbank-Zustandsmaschine“
Eine endliche relationale Struktur ist eine Datenbankinstanz, also ist ein Gurevich-Zustand eine Datenbank und jeder Schritt eine beschränkte Transaktion. Datenbank: ist eine relationale Struktur. Funktional: und sind rein. Zustandsmaschine: Läufe sind Faltungen von über Ereignisse. Moseley und Marks ziehen dieselbe Linie in der Architektur [13]. Event Sourcing zieht sie im Anwendungszustand: „Capture all changes to an application state as a sequence of events“ [14]. Dedalus zieht sie in der Logik, wo veränderlicher Zustand eine nach Zeit indizierte Relation ist [15].
3.4 Propositionen
Proposition 1 (die Form erfasst jeden sequentiellen Algorithmus). Zu jedem sequentiellen Algorithmus gibt es eine Form-Instanz , deren Läufe die Läufe von sind.
Beweisskizze. Theorem 6.13 liefert eine ASM mit den Zuständen, Anfangszuständen und der Ein-Schritt-Abbildung von . Setze , , und die Identität. Die Faltung nach Takten ist . Nach Gurevichs Korollar 3.3 haben und dieselben Läufe. ∎
Proposition 1b (interaktive Programme). Erweitere um ein nullstelliges Eingabesymbol, das vor jedem Schritt auf gesetzt wird; dann ist ein sequentieller Algorithmus über dem erweiterten Vokabular, und Proposition 1 gilt. Die Konstruktion ist unsere.
Proposition 1c (Berechenbarkeit). Unter dem Axiom von Dershowitz und Gurevich berechnet jede Form-Instanz eine Turing-berechenbare Funktion [4, 16, 17]. Die Form fügt keine Mächtigkeit hinzu. Sie gibt jedem Programm der Klasse eine Form.
Proposition 1d (Beweise sind Passungen). „For each proof of a given proposition, there is a program of the corresponding type“ [18]. Ein Typ ist eine Spezifikation, und ein Beweis ist eine Passung, die sie erfüllt. Das Korrektheitstor ist die Existenz dieses Beweises oder eines bestandenen Abnahmetests.
Proposition 2 (ein Generator). Eine Funktion erzeugt für jede Passung ein lauffähiges Programm und liest keine Domäne. Grundlage: Jedes Programm ist eine Form-Instanz, also gibt einen typisierten Speicher, einen Ereignistyp, kompilierte Regeln, ein Log mit einer Faltung und einen Ausgabeverteiler aus. Gerüstgeneratoren wie die Generatoren von Rails, JHipster und Yeoman sind , eingeschränkt auf kleine Passungssprachen. Produktlinienentwicklung beginnt mit „the systematic discovery and exploitation of commonality across related software systems“ [8]; die Gemeinsamkeit ist die Form.
Proposition 3 (Extraktion mit geringster Energie). Extraktion mit liefert den Term mit den wenigsten Joule, den der Extraktor in der E-Klasse von findet. Beweisskizze. Die Umschreibungen sind korrekt, also hat jeder Term der E-Klasse das beobachtbare Verhalten von und passiert dasselbe Tor. Die Extraktion minimiert die Kosten, und die Kosten sind Joule. ∎ Das ist Mixture of Limits, angewandt auf Code: Behalte die minimale Passung, die die Aufgabe erledigt, der Rest ist Verschwendung.
Proposition 4 (Determinismus der Wiedergabe). Wenn keine Wanduhr liest, Aktualisierungen ohne Namen ordnet und jede Eingabe protokolliert, ergeben zwei Wiedergaben desselben bei jedem Schritt identische Zustandshashes.
Proposition 5 (die Statechart-Projektion ist korrekt). Projiziere jeden Zustand eines Laufs auf . Das Ergebnis ist ein Lauf des ausgegebenen Statecharts unter denselben Ereignissen.
Proposition 6 (Koordinationsbudget). Als monoton markierte Regeln laufen auf Replikaten ohne Koordination; nur nichtmonotone Regeln brauchen einen Koordinationspunkt. Grundlage: der CALM-Satz, „the programs that have consistent, coordination-free distributed implementations are exactly the programs that can be expressed in monotonic logic“ [19].
Das Tag wird aus der Regel abgeleitet, nie deklariert, und die IR-Prüfung lehnt eine Form ab, deren gespeichertes Tag vom abgeleiteten abweicht (Spezifikation, Anhang D.5):
| Regel enthält | Tag | Grund |
|---|---|---|
| kein resolve, read, join oder scan | monoton | ihre Schreibvorgänge fügen nur Schlüssel hinzu und erhöhen Zähler |
| ein resolve | nicht monoton | es löscht Eskalationszeilen |
| ein read der eigenen Senke | nicht monoton | lesen, ändern, schreiben |
| ein Join über einen Schlüssel | nicht monoton | die verbundene Zeile kann jetzt fehlen und später vorhanden sein, oder überschrieben werden |
| ein Scan | nicht monoton | er beobachtet die ganze Relation, einschließlich dessen, was fehlt |
Das Tag ist korrekt, aber nicht vollständig: Ein Join gegen eine Relation, in die nur eingefügt wird, wäre monoton, aber das Profil beweist nicht, dass in eine Relation nur eingefügt wird, daher beansprucht das Tag das nicht. Eine Form ist koordinationsfrei, wenn jede Regel monoton ist. Jeder Lesezugriff, jeder Join und jeder Scan sieht den Zustand beim Eintritt des Ereignisses, sodass der Folgezustand eines Eingabeereignisses nicht von der Reihenfolge abhängt, in der die Regeln für verschiedene Senken laufen; davon hängt nur die Reihenfolge der Ausgaben ab, und sie ist durch den Inhaltshash festgelegt.
Proposition 7 (Intelligenz als Joule-Ableitung). zähle die Aufgaben durch das Tor und die aufgewendeten Joule. wird im Nachhinein aus abgelesen, das jedes Ereignis und sein est_j aufzeichnet. Extraktion unter hält das Tor fest und erhöht nicht, also senkt sie bei gleichem nicht .
3.5 Graph, E-Graph und Statechart
| Struktur | Teil der Form | Was sie entscheidet |
|---|---|---|
| Statechart | Wächter von über | Welcher Übergang feuert |
| Datenflussgraph | Lese- und Schreibabhängigkeiten von und (Kahn-Prozessnetze [20]) | Was läuft, und in welcher Reihenfolge |
| E-Graph | Die Äquivalenzklasse der Passung | Welche äquivalente Passung läuft |
Das Statechart und der Graph beschreiben eine Passung. Der E-Graph beschreibt jede dazu äquivalente Passung. Die Extraktion wählt unter ihnen nach Joule.
3.6 Ein Ökosystem, verlustfrei, und die Universalitätsthese
Verlustfrei durch Konstruktion. Shannons Quellencodierungstheorem legt den Boden eines verlustfreien Codes bei der Entropie der Quelle fest [40]. Eine Form ist ein verlustfreier Code für Absicht in einem engen, prüfbaren Sinn: Die kanonische Serialisierung der Form ist injektiv, sodass zwei Formen, die sich in irgendeinem Zustand, Ereignis oder Übergang unterscheiden, verschiedene Gestalthashes haben, und das Decodieren der Serialisierung liefert dieselbe Form zurück. Jede Projektion auf ein Ziel ist eine Funktion allein der Form. Bidirektionale Transformationen machen die Rundreise präzise. Foster, Greenwald, Moore, Pierce und Schmitt definieren eine Linse als Paar von get- und put-Funktionen mit Rundreisebedingungen, die eine Sicht und ihre Quelle in Übereinstimmung halten [122], Hofmann, Pierce und Wagner erweitern die Bedingungen auf symmetrische Linsen [123], und Czarnecki und Kollegen geben einen Überblick über dieselben Konsistenzbedingungen in Modelltechnik, Datenbanken und Programmiersprachen [124]. Die Rundreisebedingung von RCE ist die GetPut-Bedingung auf der Ebene des ganzen Programms: Hebt man eine Projektion zurück, bleibt der Gestalthash unverändert.
Korrekt durch Konstruktion. Dijkstra schlug 1968 vor, ein Programm und seinen Beweis gemeinsam zu entwickeln, sodass Korrektheit hineinkonstruiert statt durch Tests nachgewiesen wird [125]. Hall und Chapman übertrugen den Ansatz auf ein kommerzielles sicheres System mit formaler Spezifikation und Verfeinerung in jedem Schritt [126]. Minskys Regel für typisierte funktionale Programmierung, unzulässige Zustände nicht darstellbar zu machen, sagt dasselbe auf der Typebene: Ein Typ, der keinen schlechten Wert aufnehmen kann, erübrigt die Prüfung darauf [127]. Turners totale funktionale Programmierung verlangt, dass jede Funktion auf jeder Eingabe terminiert, sodass ein Programm eine mathematische Funktion ohne verborgenes Versagen bezeichnet [128]. Die Form von RCE ist total im Sinne Turners, ihre Vertragstypen machen nicht deklarierte Zustände im Sinne Minskys nicht darstellbar, und die Verfeinerungskette aus §2.1 endet in ihr im Sinne Dijkstras. Die Folge ist die in §1 genannte: Ein Fehler wird am Eingang abgewiesen, sodass hinterher nichts zu diffen oder zu verfolgen bleibt.
Die Universalitätsthese. Theoretisch formuliert lautet die These, dass es eine universelle Form gibt. Programme werden nativ in ihr geschrieben, jede bestehende Sprache ist von ihr aus als getreue Projektion erreichbar, und jedes bestehende Programm tritt durch Hebung in sie ein. Gurevichs These liefert die Grundlage: Jeder sequentielle Algorithmus wird Schritt für Schritt von einer abstrakten Zustandsmaschine auf seiner eigenen Abstraktionsebene erfasst [2], und parallele Algorithmen ebenso [3]. Eine Form ist eine solche Maschine über einem Datenbankzustand.
Proposition U1 (Erfassung). Ist ein Programm in der Sprache ein sequentieller oder paralleler Algorithmus im Sinne Gurevichs, dann gibt es eine Form, deren Übergang es auf der Abstraktionsebene des Programms Schritt für Schritt simuliert [2, 3].
Proposition U2 (getreue Projektion). Erhält die Projektion einer Form auf die Spur der Form auf jeder Eingabe im Vertrag, dann sind die Form und ihre Projektion für jeden Beobachter der Spur austauschbar, und fügt nichts hinzu, was der Form fehlt.
Proposition U3 (Hebung durch Konstruktion). Jede gebräuchliche Programmiersprache hat eine formale Grammatik, einen Parser, der einen konkreten Syntaxbaum liefert, einen abstrakten Syntaxbaum und eine Semantik, die durch ihre Spezifikation oder Referenzimplementierung festgelegt ist. Eine Hebung wird pro Sprache in drei Stufen gebaut: die Grammatik, dann der abstrakte Syntaxbaum, dann die Form, wobei jedes Konstrukt von seine Formregel aus der Semantik von erhält. Eine so gebaute Hebung erfüllt im Verhalten und im Gestalthash, sodass das Paar eine Linse im Sinne von [122] ist und ein Programm in ohne Verlust als Form gehalten wird.
Proposition U4 (Ersetzung). Gelten U2 und U3 für die Sprache , dann muss kein Programm in geschrieben werden: Es wird einmal als Form geschrieben und als ausgegeben, wo eine Plattform es verlangt.
U1 ist ein Theorem. U2 wird pro Ziel durch differentielles Testen geprüft (§5.1) und bei großem N in §2.3. U3 ist eine Konstruktion, Sprache für Sprache von der Grammatik aufwärts gebaut, und §8.7 legt fest, wie die Konstruktion während des Baus gemessen wird.
3.7 Die Sprache: Versionen 0.6 und 0.7, Kosten und Status der Theoreme
Die Sprache RCE ist durch eine schriftliche Spezifikation definiert, derzeit das Dokument Entwurf 0.7 bei Sprachversion 0.8 (/rce/spec/; Quelltext im rce-Repository). Jedes Modul wählt seine Sprachversion mit einem Kommentar in der ersten Zeile. Ein Modul ohne diesen Kommentar hat Version 0.5, die Sprache der Abschnitte 2 bis 10. Ein Modul, das # rce-version: 0.6 deklariert, erhält zusätzlich Anhang C: par, for ... par, with budget, Arbeitsgruppen, LVars, Sitzungen und Supervisoren. Ein Modul, das # rce-version: 0.7 deklariert, hat die Sprache der Version 0.6 mit einem Unterschied, den Kosten der Methoden der Standardbibliothek weiter unten (Anhang C.15). Anhang D definiert das Engine-Profil, die Handler-Spezifikationen und die Passungen, die die Engine dieses Papiers ausführt. Ein Modul der Version 0.5 sieht Anhang C nie, sodass jedes gültige Programm der Version 0.5 unverändert angenommen wird.
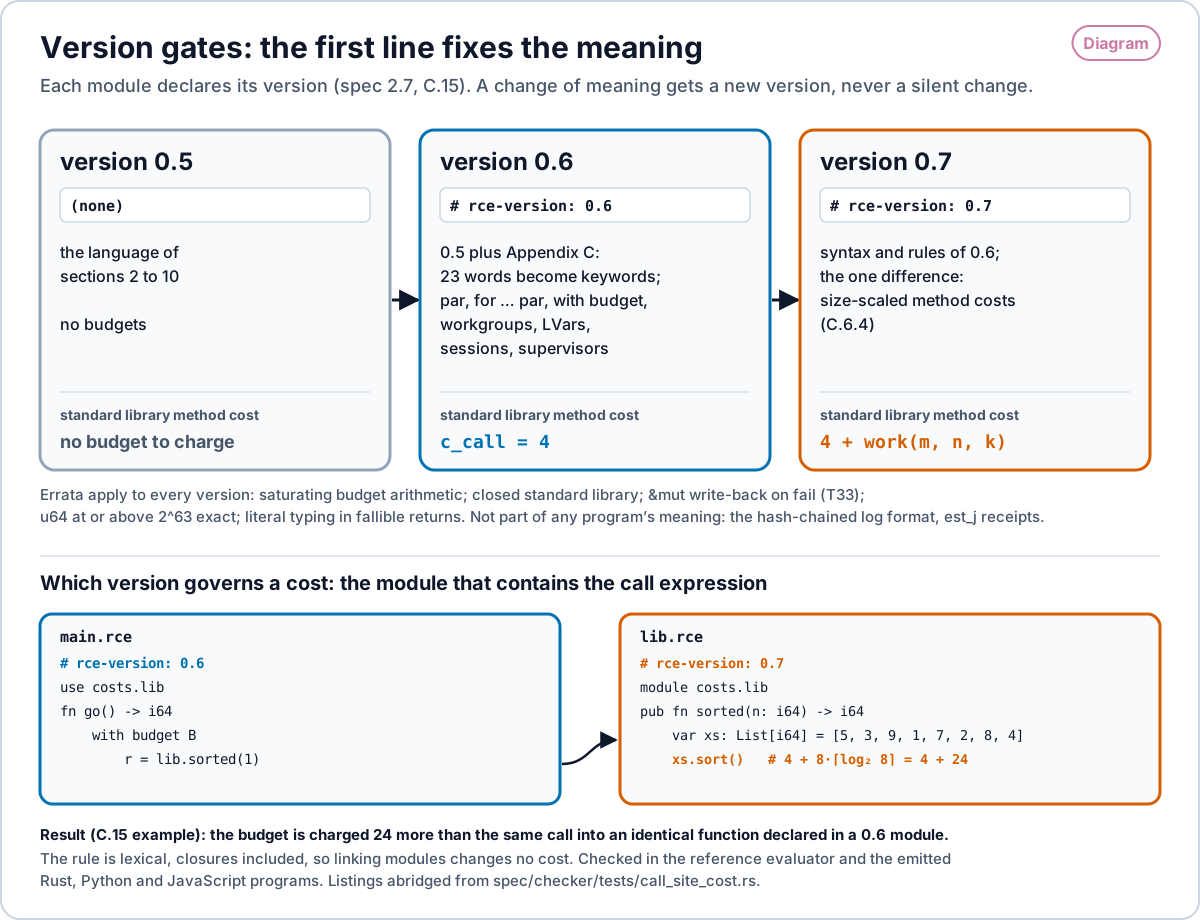
# rce-version: 0.6 fügt Anhang C hinzu (23 neue Schlüsselwörter; par, for ... par, with budget, Arbeitsgruppen, LVars, Sitzungen, Supervisoren), und eine Methode der Standardbibliothek kostet . # rce-version: 0.7 hat die Syntax und die Regeln von 0.6 und unterscheidet sich nur in den Methodenkosten, . Errata gelten für jede Version. Die Version des Moduls, das den Aufrufausdruck enthält, bestimmt dessen Kosten: Einer Funktion der Version 0.6 unter with budget, die eine importierte Funktion der Version 0.7 aufruft, die 8 Elemente sortiert, werden 24 mehr berechnet als für denselben Aufruf in eine identische Funktion der Version 0.6. Quelle: Spezifikation 2.7, C.6.4 und C.15; Listings gekürzt aus spec/checker/tests/call_site_cost.rs. Eine PNG-Kopie ist verfügbar. Open full size · PNG
Budgets zählen Arbeit. Ein with budget-Block berechnet jeder Operation feste Kosten aus der Tabelle in Anhang C.6.4 und löst den Trap budget aus, wenn die Zählung erschöpft ist. Die Zählung ist ein Stellvertreter für Arbeit, keine Messung von Zeit oder Energie; est_j ist davon getrennt.
| Operation | Kosten |
|---|---|
| Aufruf einer Benutzerfunktion oder eines Closures, | 4 |
| Methode der Standardbibliothek bei Empfängergröße und Größe des ersten Arguments | 4 in Version 0.6; in Version 0.7 |
| Senden oder Empfangen auf einem Kanal | 8 |
spawn | 32 |
ein par-Zweig oder ein for ... par-Abschnitt | 16 |
Listen- oder Map-Literal oder Comprehension mit Ergebnissen; [x; n] | |
Index, Slice, Memberzugriff; unäre Operatoren; and, or; Operatoren und Vergleiche auf Ganzzahlen, Bool und Text | 1 |
Float +, -, * | 2 |
Float /, % | 8 |
Größen sind die UTF-8-Bytelänge eines Textes, die Länge einer Liste und die Zahl der Einträge einer Map; jeder andere Wert hat Größe 0. Die Methodenarbeit ist durch die Komplexitätsklasse der Methode im Referenzauswerter festgelegt: für die linearen Methoden auf Texten, Listen und Maps (Maps sind geordnete Assoziationslisten), für sort (0, wenn ), und 0 für die übrigen Methoden. Die Aufrufe, die map, filter und fold an ihr Funktionsargument richten, werden zusätzlich als Aufrufe berechnet. Die Arithmetik sättigt bei der größten 128-Bit-Ganzzahl, und nimmt nie ab, wenn oder wächst. Der Referenzauswerter und die erzeugten Laufzeiten für Rust, Python und JavaScript berechnen dieselbe Funktion, und ein Test prüft, dass der Budget-Trap in allen vier auf dieselbe Operation fällt.
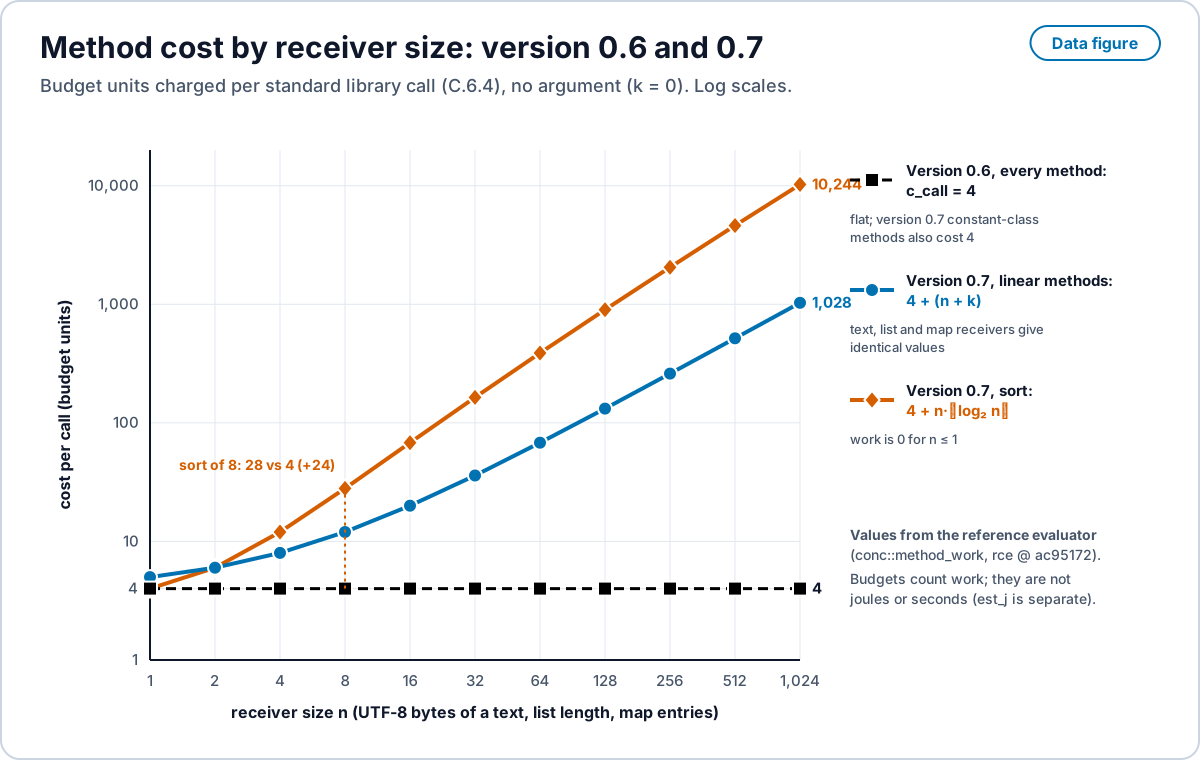
conc::method_work des Referenzauswerters (rce ac95172). Eine PNG-Kopie ist verfügbar. Open full size · PNG
Welche Version die Kosten bestimmt. Ein Programm kann Module verschiedener Versionen verbinden. Die Kosten eines Methodenaufrufs sind durch die deklarierte Version des Moduls festgelegt, das den Aufrufausdruck enthält, einschließlich eines Aufrufs in einem dort geschriebenen Closure, und nicht durch die Version der ausgeführten Funktion, ihres Aufrufers oder des ersten Moduls des Programms. Die Regel ist lexikalisch, sodass das Verlinken von Modulen keine Kosten ändert; Spezifikation 2.7 nennt dieselbe Regel und verweist auf C.15. Tests prüfen sie an der Grenze in beiden Richtungen auf dem Referenzauswerter und auf den erzeugten Programmen in Rust, Python und JavaScript: Einer Funktion der Version 0.6 unter with budget, die eine importierte Funktion der Version 0.7 aufruft, die eine Liste mit 8 Elementen sortiert, werden 24 mehr berechnet als für denselben Aufruf einer identischen Funktion der Version 0.6.
Status der Theoreme. Die Spezifikation nennt die Theoreme T1 bis T34 und hält den Status jedes einzelnen genau fest. Die Beweise sind in Lean 4 (v4.12.0, ohne Mathlib) über einem Kernkalkül geführt. Die Wörter für die Stufe eines Ergebnisses sind diese. Bewiesen bedeutet einen Lean-Beweis über die Kernsemantik der Sprache. Bewiesen auf einer Semantik bedeutet einen Lean-Beweis über einer Small-Step-Semantik eines Kerns von RCE. Modell bedeutet einen Lean-Beweis über ein abstraktes Modell, das weder mit der Semantik von RCE noch mit dem Referenzauswerter verbunden ist. Vektoren bedeutet, dass die Ergebnisse des Referenzauswerters auf erzeugten Programmen vom Lean-Kernel gegen das Modell geprüft werden; das ist eine Entsprechung auf Stichproben, kein Beweis über den Auswerter. Getestet bedeutet differentielles Testen auf angegebenen Eingaben. Mechanisch geprüft bedeutet von einem Programm entschieden, etwa von einem Generator für LALR(1)-Tabellen.
| Aussage | Stufe | |
|---|---|---|
| T1 | Determinismus: ein Ergebnis pro Zustand und Ereignis; ein Ergebnis pro Tick der Nebenläufigkeitssemantik | bewiesen |
| T2 | Totalität von , mit einer expliziten Schranke für Auswertungsschritte; strukturelle Rekursion und Komposition von Schranken entlang des Aufrufgraphen | bewiesen (der Lean-Ausdruckskern hat keine Aufrufe von Benutzerfunktionen; Rekursion und Komposition sind auf getrennten Modellen bewiesen) |
| T3 | der Laufzeitzustand ist , und die Wiedergabe reproduziert jeden Hash und jede Ausgabe | bewiesen |
| T4 | Fortschritt, einschließlich Ticks (eine Task bewegt sich, oder der Lauf endet oder meldet Deadlock) | bewiesen |
| T5 | Erhaltung, einschließlich des Ganzzahlbereichs jedes geschriebenen Feldes | bewiesen |
| T6 | Speichersicherheit, vollständige Borrow-Pfade, kein veränderliches Teilen zwischen Tasks | bewiesen für den Ownership-Kern und eine instrumentierte Semantik der Borrow-Pfade |
| T7 | Namensunabhängigkeit von Log-Hashes, IDs und select-Auswahlen | bewiesen |
| T8 | Atomarität: ein abgelehntes Ereignis lässt den Zustand unverändert | bewiesen |
| T9-F | die Ziele der Form-IR (Rust, WASM, Python, XState, SCXML) geben die Referenzspur aus | getestet |
| T9-L | die Programm-Emitter (rust, python, js) stimmen mit dem Referenzauswerter überein | bewiesen für den Rust-Emitter auf einem Kern, als verifizierte Übersetzung nach MiniRust, einer tiefen Einbettung der erzeugten Rust-Teilmenge; dass rustc MiniRust implementiert, wird vorausgesetzt und getestet; die anderen Emitter getestet |
| T10 | die Grammatik ist eindeutig | mechanisch geprüft (LALR(1), 0 Konflikte, für beide Versionen) und von einem Fuzzer stichprobenartig geprüft |
| T11 | Fairness von select | bewiesen auf dem Rotationsmodell |
| T12 | ein linearer Handle wird auf jedem Pfad genau einmal verbraucht | bewiesen auf einem Anweisungsmodell |
| T13 | f32-Operationen liefern auf Zielen, die in IEEE 754 übereinstimmen, dieselben Bits | bewiesen für die Multiplikation; für Addition, Subtraktion und Division ist die Eigenschaft der einfachen Rundung Figueroas Theorem, zitiert und nicht mechanisiert |
| T14 | geprüfte u64-Arithmetik ist im Bereich exakt | bewiesen |
| T15 | Iteratoren enden, halten das Schleifenlimit ein und sind präfixkonsistent | bewiesen |
| T16 bis T31 | Nebenläufigkeit der Version 0.6: Determinismus von par, Kommutation, Reduktionen, Verklemmungsfreiheit, Fristen, Arbeitsgruppen, Vektoruhren, Prioritäten, Scopes, Aktoren, Sitzungen, LVars, atomare Batches, Replikate | bewiesen auf einer Semantik: T16, T17, T19a, T20, T23; bewiesen auf einem Modell von Läufen: T24; bewiesen auf einem Sitzungskalkül: T28; Modell: T18, T19b, T21, T22, T25, T26, T31; Modell mit Vektoren: T27, T29, T30. Keines ist ein Beweis über den Rust-Referenzauswerter |
| T32 | Fremdwiedergabe: Für jedes Orakel gleicht die Wiedergabe des Logs dem Live-Lauf, und ein Antwortvertrag gilt für jede protokollierte Antwort | bewiesen |
| T33 | &mut-Wiederherstellung bei Fehlschlag (F.4.4): Ein fehlgeschlagener Aufruf hinterlässt den &mut-Zustand des Aufrufers wie beim Aufruf; ein zurückkehrender Aufruf schreibt zurück (die frühere Regel des Herauskopierens bei jedem Ausgang ist abgelöst) | bewiesen |
| T34 | der reihenfolgeerhaltende ANF-Durchlauf vor jedem Emitter liefert denselben Wert, denselben Speicher und dieselbe Spur von Abbuchungen und Ausgaben | bewiesen für ein Kernfragment mit vollem ANF; die Implementierung wird auf jedem Ziel differentiell getestet, einschließlich eines Durchlaufs von Budgets über den Trap-Punkt hinweg |
T9 hat zwei Zielmengen, weil die Engine des Papiers und die Sprache zwei Compiler haben. T9-F ist die Aussage über rce form --emit, die §5.1 misst. T9-L ist die Aussage über die Programm-Emitter der Sprache. Ein Ziel außerhalb dieser Mengen hat keine T9-Aussage.
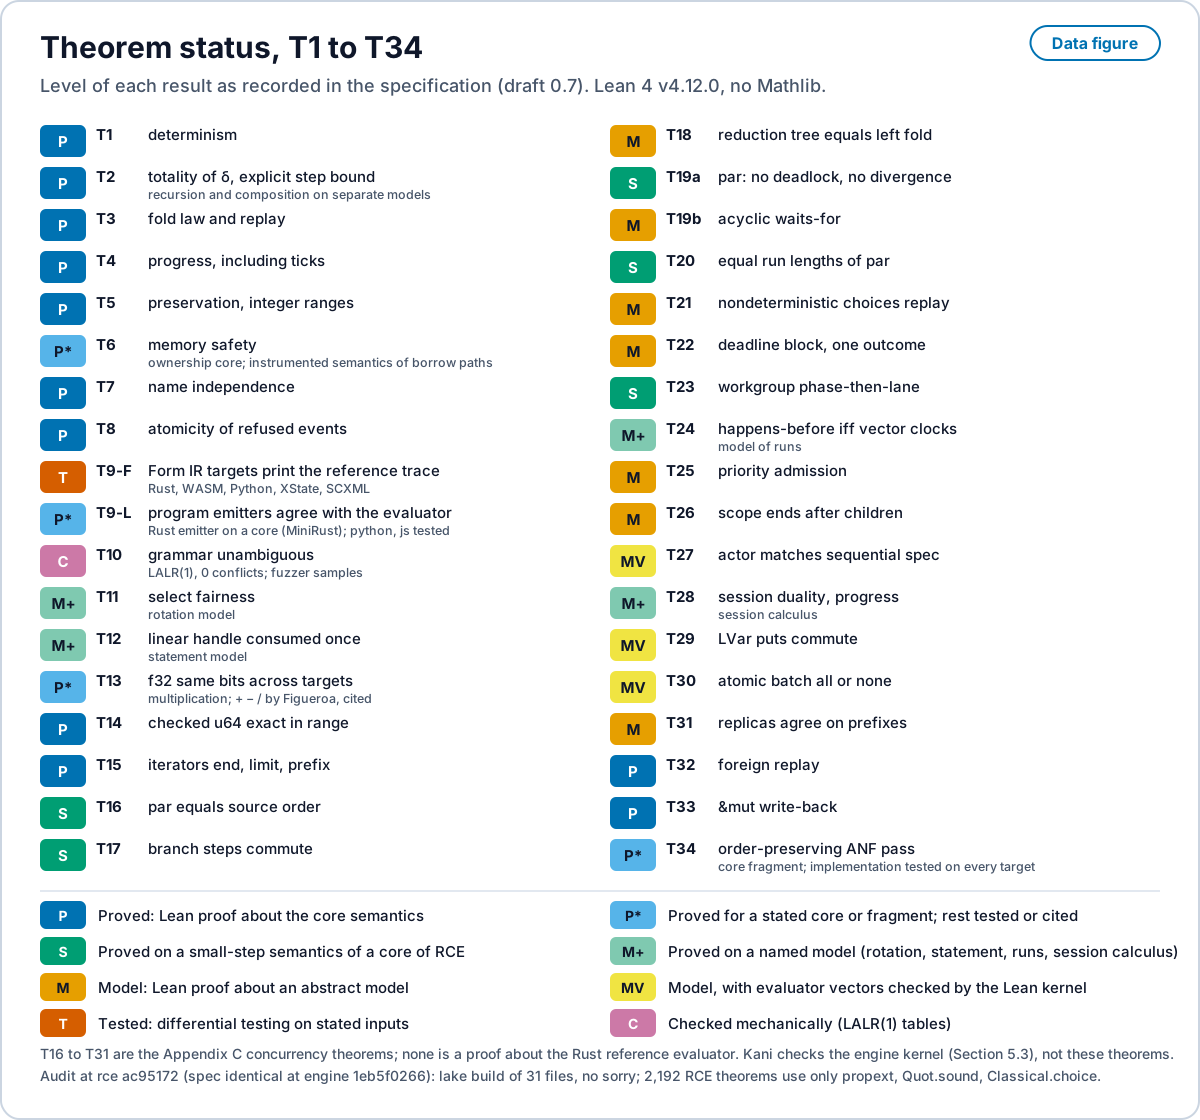
P: Lean-Beweis über die Kernsemantik. P*: bewiesen für einen angegebenen Kern oder ein Fragment, der Rest getestet oder zitiert. S: bewiesen auf einer Small-Step-Semantik eines Kerns von RCE. M+: bewiesen auf einem benannten Modell (Rotationsmodell, Anweisungsmodell, Modell von Läufen, Sitzungskalkül). M: Lean-Beweis über ein abstraktes Modell. MV: Modell, mit vom Lean-Kernel geprüften Vektoren des Referenzauswerters. T: differentielles Testen. C: mechanisch geprüft. T16 bis T31 gehören zu Version 0.6, und keines ist ein Beweis über den Rust-Referenzauswerter. Lean 4 v4.12.0, ohne Mathlib. Quelle: spec/book/10-theorems.md und Anhang C.13. Eine PNG-Kopie ist verfügbar. Open full size · PNG
Für diese Version ausgeführte Prüfungen. Bei Engine-Commit 1eb5f02 läuft lake build über die 31 Dateien von spec/lean/RCE/ ohne sorry durch (46 Dateien beim öffentlichen 4304048, 58 bei e416fd0), und das ständige Audit meldet als Axiome von 2,192 Theoremkonstanten (das Audit zählt jede Theoremkonstante des Kernels; siehe den Korrekturhinweis oben) nur propext, Quot.sound und Classical.choice. Kani verifiziert 10 von 10 Kern-Harnesses (§5.3). Die Engine-Tests (cargo test --release) bestehen 589 verschiedene Tests mit 0 Fehlschlägen (2 ignoriert); make check meldet 596, weil sein Beweisschritt 7 dieser Tests ein zweites Mal ausführt. Der Referenzprüfer, aus dem öffentlichen Repository so gebaut, wie seine Continuous Integration ihn baut, besteht 56 Tests im Standardbuild und 112 mit aktivierten Suiten der Versionen 0.6 und 0.7, mit 0 Fehlschlägen, und 57 mit dem Übereinstimmungstest für tree-sitter. Die Spezifikationsprüfung baut die LALR(1)-Tabellen der Version 0.5 und der Versionen 0.6 und 0.7, die eine Grammatik teilen, mit 0 Konflikten und parst jedes Beispiel mit drei Parsern, und der WebAssembly-Build des Prüfers besteht 401 von 401 Prüfungen gegen die Beispielkorpora.
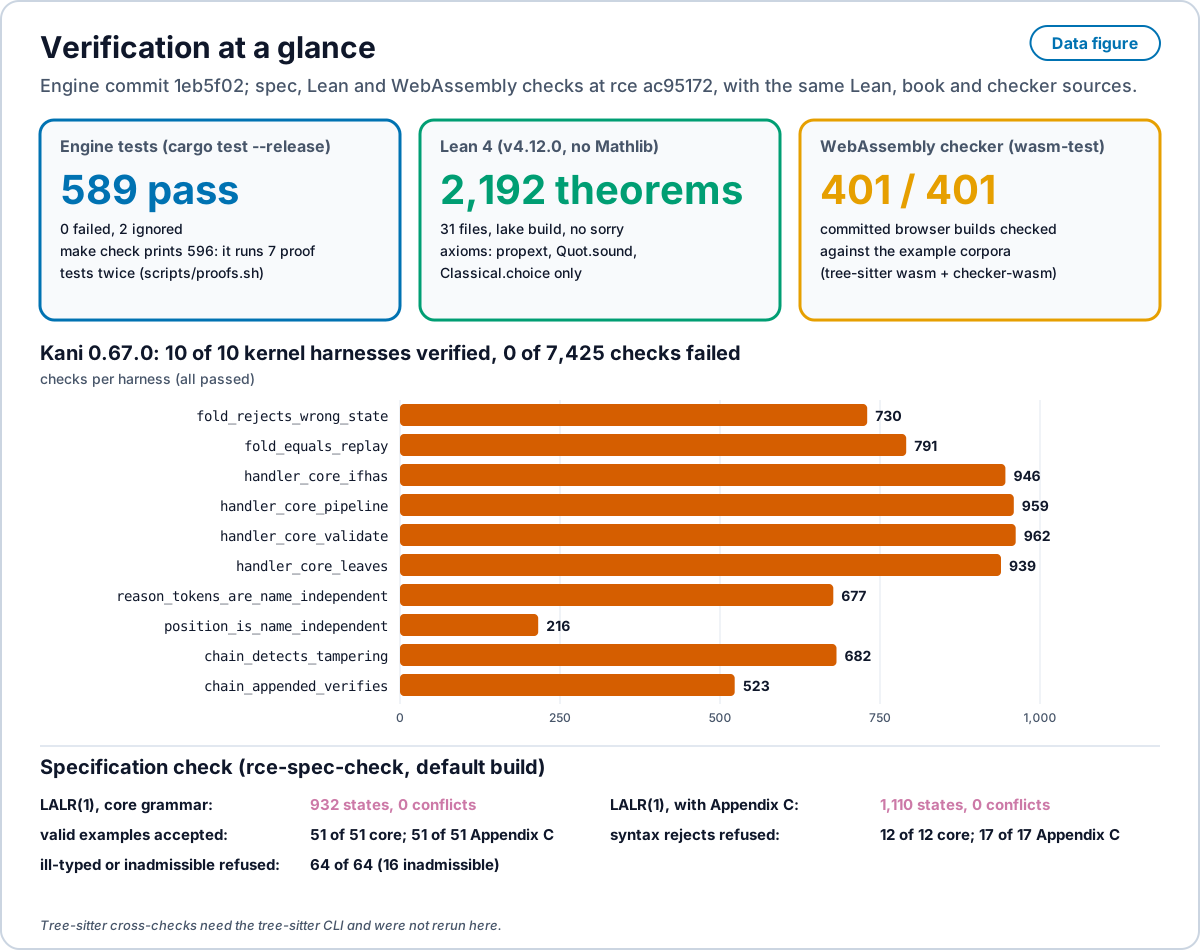
1eb5f02. Datenabbildung. Engine-Tests (cargo test --release): 589 bestanden, 0 fehlgeschlagen, 2 ignoriert; make check meldet 596, weil es 7 Beweistests zweimal ausführt. Lean 4: lake build über die 31 Dateien von spec/lean/RCE/ ohne sorry; das Audit meldet 2,192 Theoremkonstanten (Audit-Zahl, nicht Deklarationen im Quelltext), deren Axiome nur propext, Quot.sound und Classical.choice sind. Kani 0.67.0 verifiziert 10 von 10 Kern-Harnesses mit 0 von 7,425 fehlgeschlagenen Prüfungen (Balken: Prüfungen pro Harness). Der WebAssembly-Build des Prüfers besteht 401 von 401 Prüfungen gegen die Beispielkorpora. Die Spezifikationsprüfung baut LALR(1)-Tabellen mit 0 Konflikten für Version 0.5 (932 Zustände) und für die Versionen 0.6 und 0.7 (1,110 Zustände), nimmt 51 von 51 gültigen Beispielen an und lehnt 12 von 12 Syntaxfehler und 64 von 64 schlecht typisierte oder unzulässige Programme ab. Die Lean-, WebAssembly- und Spezifikationsprüfungen liefen auf dem öffentlichen Repository bei ac95172, dessen Spezifikationsquellen mit denen der Engine identisch sind. Eine PNG-Kopie ist verfügbar. Open full size · PNG
Eine Konvergenzbeobachtung. Der Katalog unter agentlanguages.dev, gelesen am 13. Oktober 2026, führt 42 Sprachen auf, die dafür entworfen sind, dass KI-Agenten Code schreiben, von seinen Herausgebern in ein syntaktisches Lager, ein Verifikationslager und ein Orchestrierungslager gruppiert. Mehrere Entwurfsentscheidungen dieses Papiers, etwa mechanisch geprüfte Verträge, hashverkettete Logs, deterministische Wiedergabe und eine kanonische Form pro Programm, erscheinen in seinen Beschreibungen anderer Projekte, die unabhängig entwickelt wurden. Das ist eine Beobachtung, dass die Entscheidungen wiederkehren. Es ist kein Nachweis dafür, dass sie richtig sind, und dieses Papier stellt keinen Vergleich mit diesen Projekten an.
4. Die Engine: Gänge, Tor und Belege
4.1 Die Engine ist eine Form
RCE führt Software als Graph kleiner deterministischer Handler aus. Ein Handler, der nicht entscheiden kann, löst eine Eskalation aus. Ein Auflöser beantwortet die Eskalation einmal, und die Antwort wird als dauerhafter Handler installiert, sodass der nächste Fall derselben Gestalt ohne Auflöser läuft. Die Engine erfüllt jede Invariante der Form, jede geprüft durch einen benannten Test in tests/form_laws.rs:
| Invariante | Was die Engine tut |
|---|---|
| Neuladen ist eine verifizierte Faltung | Das Neuladen liest das Log wörtlich, berechnet jeden Hash und jede Verkettung neu und faltet den Rest mit . Nichts wird neu gestempelt. Eine gebrochene Kette verweigert das Laden. |
| Namensfreie Taktreihenfolge | Handler laufen in topologischer Rangfolge, dann nach einem namensfreien Knotenschlüssel. Ausgaben werden zwischengespeichert und nach dem Lauf aller Handler zugestellt, wie in der ASM-Semantik. Das Umbenennen jedes Knotens ergibt bei jedem Eintrag denselben anonymen Zustandshash. |
| Kein stilles Verwerfen | Ein volles Postfach hält die Nachricht in einer geordneten Warteschlange und protokolliert Backpressure. Bei Kapazität 1 und 10 Aufgaben werden 9 Backpressure-Einträge protokolliert, und alle 10 Aufgaben werden geschlossen. |
| Nutzdaten stehen im Log | Eingaben, Takte, Ergebnisse externer Handler, Installationen und Fehler sind Logeinträge. Der Zustandshash nach jedem Eintrag stimmt mit einer Faltung aus einer leeren Engine überein, auf 1,000 zufälligen Logs. |
| Logische Uhr | Lebendigkeit zählt Takte, nicht Wandzeit. |
| Stabile Hashes | SHA-256 (Secure Hash Algorithm, 256 Bit) über kanonisches JSON, Schlüssel auf jeder Tiefe sortiert, für Einträge, Zustände, Gestalten und Regel-IDs. |
4.2 Die Gänge
Jeder Gang wird nur versucht, wenn der Gang darunter das Tor nicht passiert. Diese Reihenfolge ist eine feste Kaskade.
| Gang | Methode | Herkunft |
|---|---|---|
| G0 Nachschlagen | Eine gemeinsame Handler-Bibliothek, indiziert nach SHA-256-Gestalthash; für Codereparatur Lokalisierung auf gereihte Funktionen | Codesuche und Abruf [21] |
| G1 Regeln | Deterministische, bewachte Reparaturvorlagen und aus Schemata abgeleitete Validatoren, jeweils auf Mutationsempfindlichkeit geprüft | PAR, TBar, AVATAR, FixMiner [22, 23, 24, 25]; Codemods wie Coccinelle [26] |
| G2 Synthese | Aufzählung über der Handler-Grammatik, Löser und E-Graphen | Sketching, SyGuS, egg [27, 9, 12] |
| G3 bis G5 Modelle | Ein typisiertes Entscheidungsmodell, ein lokales kleines Modell, dann ein entferntes Modell, zuletzt | Modellkaskaden [28] |
4.3 Das Tor
Ein Kandidat wird nur befördert, wenn er das Tor passiert. Das Tor spielt die aufgezeichneten Eingaben des Knotens erneut ab, führt den Kandidaten im Schatten auf frischen Stichproben mit einer Abdeckungsschranke aus (die Dreierregel bei einem erklärten Fehlerbudget), prüft das Ausgabeschema und verlangt das Beweiszertifikat aus Abschnitt 5. Ein abgelehnter Kandidat wird mit seinem Gegenbeispiel protokolliert.
4.4 Belege
Jede Beförderung, Ablehnung, Zurückstellung und Installation ist eine Mutation in einem nur anhängbaren, mit SHA-256 verketteten Log, sodass jede Manipulation eines vergangenen Eintrags die Kette bricht [29, 30]. Die Kosten jedes Handlers werden aus den Operationszählungen des Interpreters mit der Host-Kostentabelle von FGIR, dem Backend für nativen Code von flowG, bepreist und als est_j gekennzeichnet. Jeder Aufruf des Vorarbeiters trägt seinen Beleg. Ein Beleg nennt den Gang, die Methode der Schätzung (basis), die versuchten Kandidaten und ob der Gang die Eskalation aufgelöst hat. Sein Feld est_j ist Pflicht: Es ist eine endliche, nichtnegative Zahl oder null, und null ist nur erlaubt, wenn basis unpriced angibt, wie bei einem Modellaufruf ohne Energieangabe. Ein Beleg, dem das Feld fehlt, wird nicht geparst. Nicht bepreiste Kosten werden nie als Null gelesen, daher weist eine Summe über Belege ihre bepreisten und nicht bepreisten Aufrufe getrennt aus, und eine Einsparung, die von einer nicht bepreisten Auflösung abhängt, wird als unbekannt berichtet. Die Leiterläufe fügen auf einer Teilstichprobe einen Energiezähler des Prozessorpakets hinzu, gekennzeichnet als reported_j.
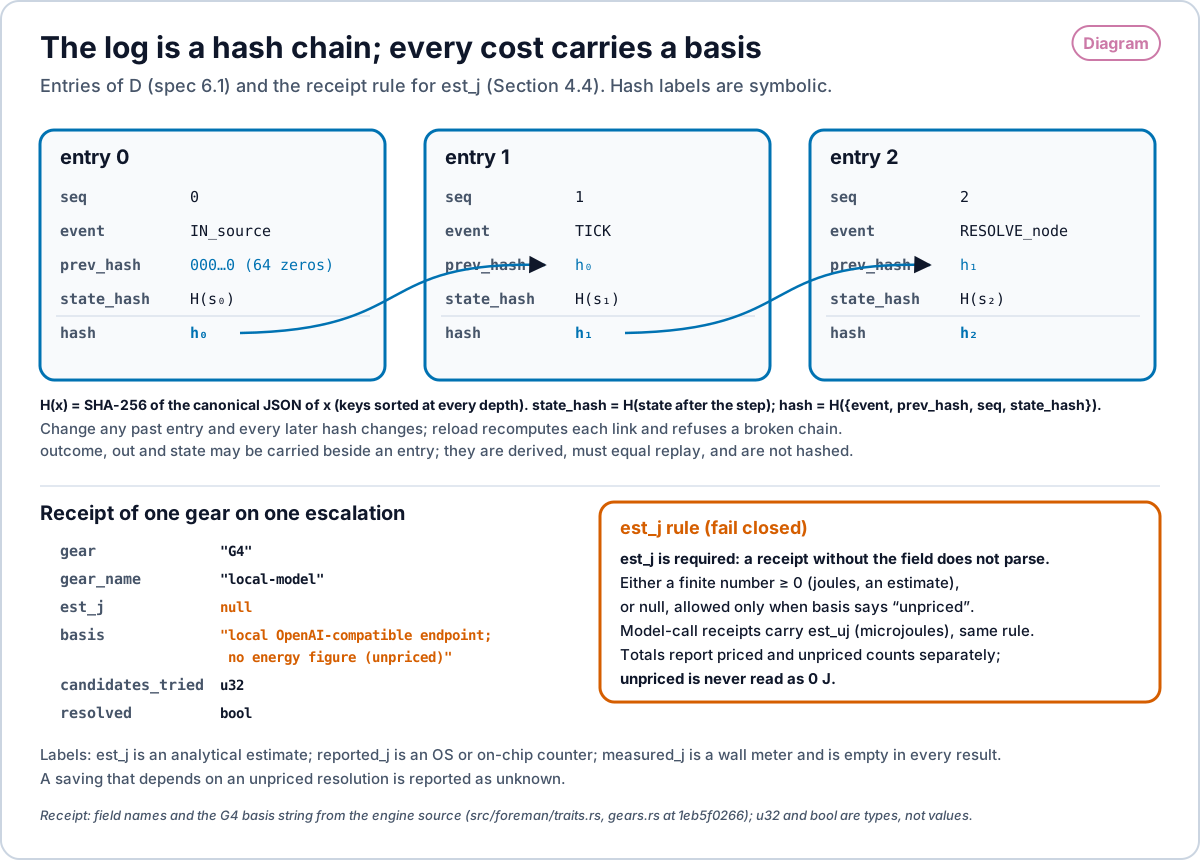
{seq, event, prev_hash, state_hash, hash}. state_hash ist der SHA-256 des kanonischen JSON des Zustands nach dem Schritt; hash ist der SHA-256 des kanonischen JSON von {event, prev_hash, seq, state_hash}; der erste prev_hash besteht aus 64 Nullen, sodass die Änderung eines beliebigen vergangenen Eintrags jeden späteren Hash ändert. Ein Gang-Beleg trägt gear, gear_name, est_j, basis, candidates_tried und resolved. est_j ist Pflicht und ist eine endliche, nichtnegative Zahl, oder null nur dann, wenn basis unpriced angibt; Belege von Modellaufrufen tragen est_uj in Mikrojoule unter derselben Regel. Nicht bepreiste Kosten werden nie als 0 J gelesen. Die Hash-Beschriftungen sind symbolisch. Quelle: Spezifikation 6.1 und Abschnitt 4.4. Eine PNG-Kopie ist verfügbar. Open full size · PNG
4.5 Der Form-Compiler
rce form nimmt eine Spezifikation und ihre Passung und gibt aus einer Form-IR fünf Ziele aus:
.rce spec + fit
  lower ─► normalize ─► egg e-graph, equality saturation (+ admitted proposals)
  ─► extract (cost = est_j) ─► Form IR (typed relations, regions, rules with SHA-256 ids)
     ├─ Rust crate (pure step, typed state, SHA-256 log and fold, tests)
     │  └─ WASM (the same crate on wasm32-wasip1)
     ├─ Python (standard library only)
     ├─ XState v5 machine
     └─ SCXML document, executed by SCION
Die IR legt an jedem numerischen Rand ein Verhalten fest: geprüfter 64-Bit-Ganzzahlüberlauf ist ein Fehler und läuft nie um; ganzzahliges / schneidet gegen null ab (); % übernimmt das Vorzeichen des Dividenden (); Division durch null ist ein Fehler; Gleitkommazahlen sind IEEE 754 binary64, und ein nicht endliches Ergebnis ist ein Fehler; null und abwesend sind verschieden; Zeit ist nur die logische Uhr. Jedes Ziel wird generiert. Keines wird von Hand geschrieben.
Ein Prozess-, HTTP- oder Closure-Handler hat keinen Term, also werden seine protokollierten Ergebnisse zu einem aufgezeichneten Orakel kompiliert, indiziert nach dem SHA-256 der kanonischen Eingabe. rce scan DIR --form hebt vorhandenes Rust, Python, TypeScript und Go in das Schema der Form, und jedes gehobene Element wird als syntaktische Hebung gekennzeichnet.
4.6 Methode: der ganze Stack bewertet, jede Schnittstellenannahme ausdrücklich
Ein Programm ist ein Stack von Ebenen: Tokens und Anweisungen; Handler; die Form, eine einzige Schrittfunktion über (Kontrollregionen; Daten: die Uhr, die Zahl der Eingaben und typisierte Relationen); das Log, eine SHA-256-Hashkette, deren Einträge jedes Ereignis, den Hash des erzeugten Zustands und den Hash des vorigen Eintrags aufzeichnen; die Umschreibungen, die die Form umformen; und das Substrat, das sie ausführt. Jede Ebene ruht auf Annahmen über die Ebene darunter. RCE behandelt keine Ebene als fest. Es bewertet den ganzen Stack, schreibt jede Schnittstellenannahme als prüfbare Aussage nieder und prüft sie bei jedem Lauf.
| Grenze | Annahme | Prüfung |
|---|---|---|
| Quelle zu Handler | eine Eingabe erfüllt ihren Quellvertrag | die Vertragsprüfung beim Eingabeereignis von δ |
| Handler zu Senke | jede Ok-Ausgabe erfüllt das Ausgabeschema | Handlerbeweis (verify::handler_proof), total und deterministisch durch den mit Kani geprüften Kernauswerter |
| Log zu Zustand | jeder Eintrag trägt den Hash des Zustands, den er erzeugt hat | Kernfaltung, die den ersten Eintrag mit nicht passendem Hash ablehnt (Kani-Harness fold_rejects_wrong_state) |
| Umschreibung zu Form | eine Umschreibung erhält die Ausgabe für jede Eingabe | randomisierte Prüfung, dann ein SMT-Beweis mit Z3 |
| Stub zu Vorarbeiter | ein Handler, der nicht entscheiden kann, eskaliert, statt zu raten | Stub-Handler geben Eskalationen aus; Auflösungen werden nur über den Beförderungspfad befördert |
| Form zu Ziel | jedes erzeugte Ziel berechnet dasselbe δ | jedes Ziel trägt dieselbe Referenzspur |
Eine fehlgeschlagene Prüfung verortet den Bruch an der Grenze, an der er auftritt. Die Korrektur wird auf dieser Ebene vorgenommen, durch die Prüfung dieser Grenze geführt und befördert. Jede Ebene über der korrigierten erbt die Korrektur ohne weitere Änderung, weil jede höhere Ebene die korrigierte Ebene nur über die Schnittstelle nutzt, deren Annahme nun geprüft wird. In diesem Sinn wandern Korrekturen nach oben und kumulieren sich. Die RCE-Engine-Demo führt dies im Browser auf dem nach WebAssembly kompilierten RCE-Kern aus: Ihre Interfaces-Ebene bricht jede Annahme und zeigt die Prüfung, die den Bruch erkennt, und ihre Compounding-Ebene zeigt, wie die Korrektur in jede spätere Runde übergeht.
5. Verifikation
5.1 Differentielles Testen über fünf Ziele
tests/form_targets.rs treibt eine arithmetische Spezifikation mit elf Operatoren mit 29 Randereignissen plus 500 geseedeten zufälligen Randwerten. Die generierten Ziele Rust, Python, WASM, XState und SCXML geben die Referenzspur Byte für Byte aus, einschließlich der arithmetischen Ränder. Das ist differentielles Testen in der Linie von McKeeman und von Csmith [86]: Übereinstimmung unabhängiger Implementierungen auf einer angegebenen Eingabemenge. Es ist keine Übersetzungsvalidierung [85] und kein verifizierter Compiler. Es deckt die elf Operatoren und die 529 Ereignisse des Tests ab und sagt nichts über Eingaben außerhalb davon. Die Ergebnisse mit Z3 und Kani unten sind die Verifikation.
Abbildung 11 zeigt die fünf Projektionen einer Form und die Rundreise der beiden Statechart-Ziele.
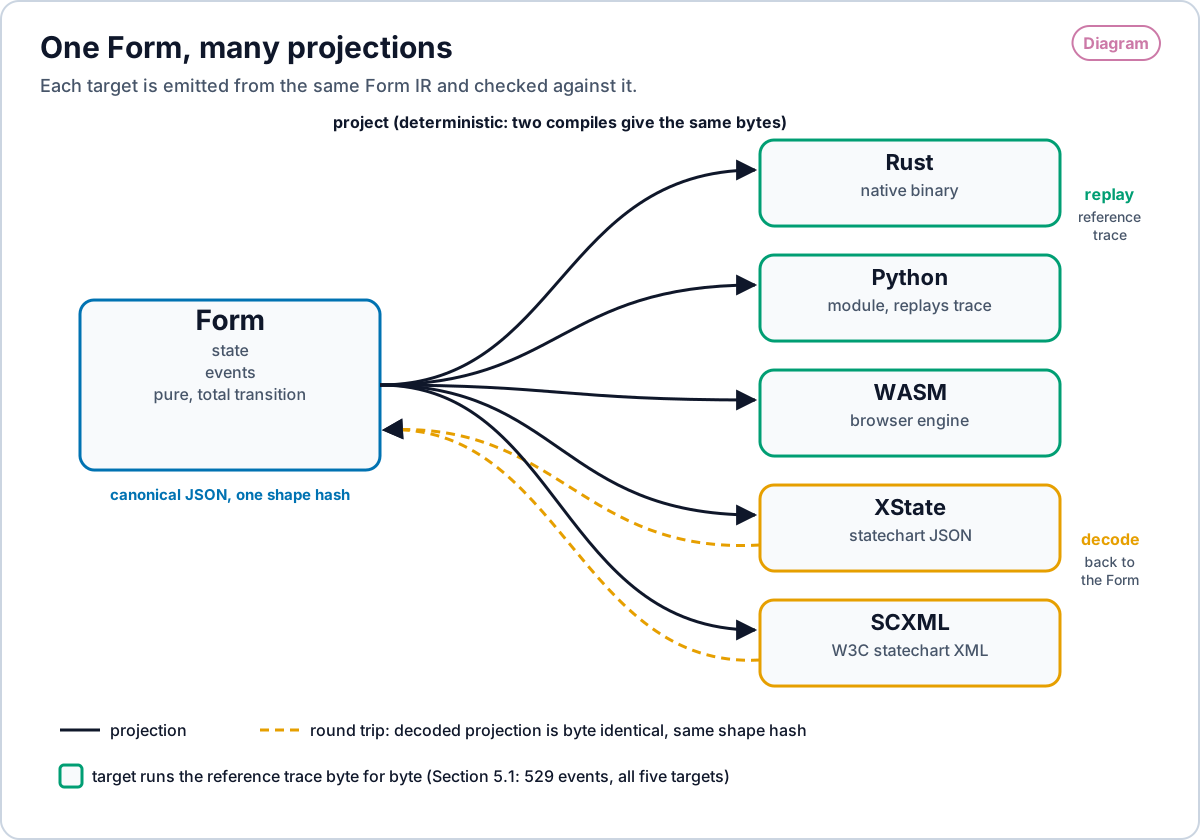
tests/form_targets.rs aus. Eine PNG-Kopie ist verfügbar. Open full size · PNG
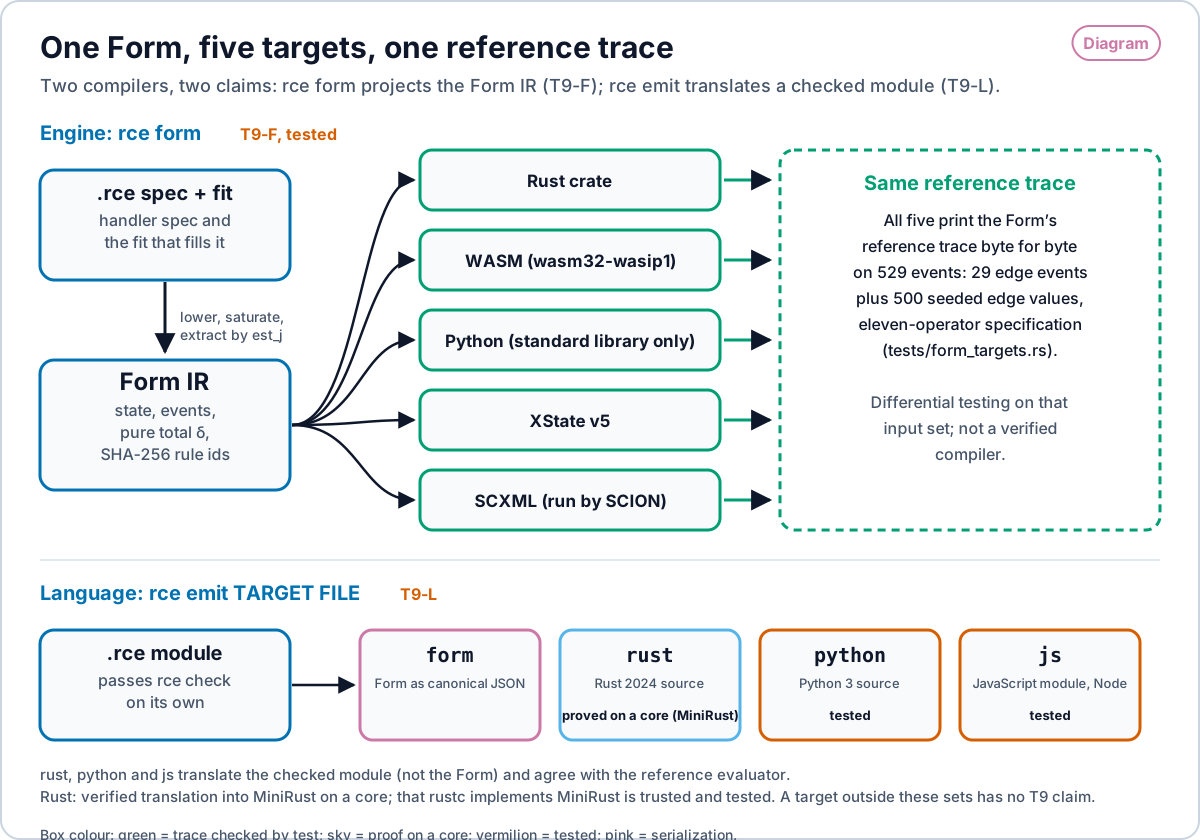
rce form senkt eine Handler-Spezifikation und ihre Passung auf die Form-IR ab und projiziert sie auf ein Rust-Crate, WASM, Python, XState v5 und SCXML; alle fünf geben die Referenzspur Byte für Byte auf 529 Ereignissen aus (29 Randereignisse plus 500 geseedete Randwerte einer Spezifikation mit elf Operatoren, tests/form_targets.rs). Das ist T9-F, durch differentielles Testen belegt, kein verifizierter Compiler. Unten: rce emit TARGET FILE übersetzt ein geprüftes Modul (nicht die Form) nach form-JSON, rust, python oder js; T9-L ist für den Rust-Emitter auf einem Kern als verifizierte Übersetzung nach MiniRust bewiesen (dass rustc MiniRust implementiert, wird vorausgesetzt und getestet) und für die anderen getestet. Eine PNG-Kopie ist verfügbar. Open full size · PNG
5.2 In Z3 bewiesene Umschreibungen
Verifizierte Umschreibregeln haben eine Herkunft. Ruler leitet Umschreibregeln durch Gleichheitssaturierung ab und prüft sie, ohne Modell in der Schleife [87]. Die 3 von 16 modellvorgeschlagenen Regeln, die in Abschnitt 5.5 zugelassen werden, sind daher eine Aussage über das Tor, das 13 ablehnte, und keine Behauptung, dass ein Modell die beste Regelquelle sei.
Jede eingebaute E-Graph-Umschreibung ist im SMT-Löser Z3 (satisfiability modulo theories) [31] gegen eine quantorenfreie Codierung der Termauswertung und Arithmetik der Form bewiesen: Werte als Datentyp, 64-Bit-Bitvektoren mit geprüftem Überlauf, vorzeichenbehaftete Division und Rest mit dem Vorzeichen des Dividenden, und binary64-Gleitkommazahlen. Eine Umschreibung, die Überlauf, Eskalationsreihenfolge oder eine Nachricht ändert, erhält keinen Beweis. Eine vorgeschlagene Äquivalenz gelangt nur mit einem Beweis in den E-Graphen.
5.3 Kani-Beweise des Kerns
Der Kern der Engine (Hashkette, Faltung, namensfreie Positionen und Handler-Auswertung) wird mit dem Model Checker Kani für Rust geprüft [32]. Die Handler-Auswertung ist der Fixpunkt eines nicht rekursiven Schritts, und Kani beweist diesen Schritt pro Konstruktor als total und deterministisch, durch strukturelle Induktion. Zehn Harnesses sind mit Kani 0.67.0 verifiziert, mit 0 von 7,425 fehlgeschlagenen Prüfungen:
| Harness | Eigenschaft |
|---|---|
chain_appended_verifies | Eine angehängte Hashkette verifiziert |
chain_detects_tampering | Ein geänderter Eintrag bricht die Kette |
fold_equals_replay | Die Faltung gleicht der Wiedergabe |
fold_rejects_wrong_state | Eine Faltung, die dem gespeicherten Zustand widerspricht, wird abgelehnt |
position_is_name_independent | Regelpositionen hängen nicht von Knotennamen ab |
reason_tokens_are_name_independent | Begründungen sind über ganze Tokens namensfrei |
handler_core_leaves | Blatt-Handler sind total und deterministisch |
handler_core_validate | Validierung ist total und deterministisch |
handler_core_pipeline | Pipelines sind total und deterministisch |
handler_core_ifhas | Wächter sind total und deterministisch |
5.4 Beförderungstor am Beweiszertifikat
Der Kani-Lauf schreibt ein Zertifikat, dessen Hash in proofs/kani.cert gespeichert wird. Die Engine, das Log, die Regel-IDs und die Handler-Auswertung laufen über den bewiesenen Kern, und die Beförderung verlangt das Zertifikat.
5.5 Das Modell als Vorschlagender hinter der Prüfung
Ein Modell darf Äquivalenzen vorschlagen. Es darf sie nicht zulassen. Mit einem lokalen Codemodell mit 1.5 Milliarden Parametern (Qwen2.5-Coder-1.5B unter llama.cpp) auf der Demonstrationsspezifikation bot der Vorschlagende 16 Äquivalenzen an. Die Prüfung ließ 3 zu, durch randomisierte Versuche und einen Z3-Beweis, und lehnte 13 ab. Ein deterministischer Vorschlagender mit 87 vertrauten Identitäten, 77 arithmetischen und 10 strukturellen, bekam 9 zugelassen, alle strukturell, und 78 abgelehnt: jede arithmetische Identität, wegen Fehlerreihenfolge, Nicht-Zahlen oder Überlauf, und eine strukturelle Umschreibung, const-absorbs-pipe, die ein eskalierendes Präfix verwerfen würde (Engine-Test tests/form_proposers.rs).
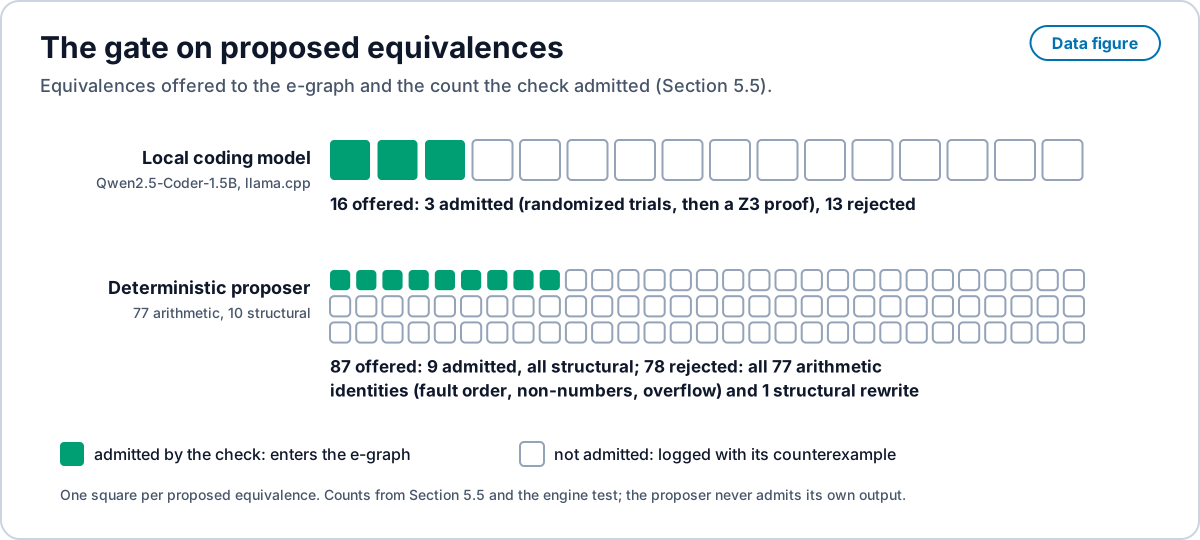
tests/form_proposers.rs. Eine PNG-Kopie ist verfügbar. Open full size · PNG
5.6 Übereinstimmung im Bestand
Die Hebung liest dieselbe Bestellmaschine aus Fixtures in Rust, Python, TypeScript und Go, führt den Originalcode auf 40 geseedeten Folgen von 30 Aufrufen aus und stimmt bei allen 1,200 Aufrufen pro Sprache überein. Ein eingefrorener Benchmark, präregistriert vor jedem Ergebnis, drückte drei vorhandene Programme für Vertriebsansprache als Formen neu aus. Die Formen stimmen mit dem Originalcode auf 4,500 von 4,500 aufgezeichneten Eingaben überein, und die Extraktion senkt est_j bei jedem (zum Beispiel J auf J).
6. Hebung: Eintritt in das Ökosystem aus anderen Sprachen
Die Hebung ist der Eingang in das Ökosystem für Code, der anderswo geschrieben wurde. Sie ist eine Konstruktion, pro Sprache aus Werkzeugen gebaut, die jede Sprache bereits hat: einer formalen Grammatik, einem Parser wie tree-sitter, der den Syntaxbaum liefert, dem abstrakten Syntaxbaum und den Symbolen, die Sprachserver-Werkzeuge auflösen (Language Server Protocol). rce scan DIR --form baut die Form aus diesem Baum für Rust, Python, TypeScript und Go (§4.5, §5.6). Ein gehobenes Programm trägt die Fehler seiner Quelle, daher schließt die Hebung Reparatur ein, unten gemessen auf öffentlichen Fehlerkorpora mit gegebenem Ort. Innerhalb des Ökosystems können diese Fehler nicht geschrieben werden.
6.0 Die Reparaturleiter auf gehobenem Code
Eine Programmieraufgabe wird hier an den Absichtsbits gemessen, die sie braucht: den Bits, die von außerhalb dessen geliefert werden müssen, was die Engine bereits hält (das Programm um die Änderung, die Bibliotheken, die Tests, der Index bekannter Korrekturen). Schreibt man für die Bits, die das Zielartefakt festlegen, und für die Bits, die der Korpus bereits festlegt, so sind die gelieferten Bits . Ein Gang, der die richtige Änderung auf Rang unter seinen Kandidaten setzt, hat Bit Suche geliefert, und das Tor liefert den Rest. Die Leiter ordnet Aufgaben nach Änderungsgröße, einem objektiven Stellvertreter für : ein Token (L0), eine Anweisung (L1), ein Hunk (L2), mehrere Hunks in einer Datei (L3), mehrere Dateien (L4), eine Funktion aus einer Spezifikation oder Tests (L5), eine Änderung auf Issue-Ebene (L6) und ein Programm aus einer Spezifikation (L7). Sprossen, Korpora, Aufteilungen und Hypothesen wurden vor den vollen Läufen präregistriert; die Dateien liegen im öffentlichen Repository.
| Sprosse | Zurückgehaltener Testkorpus | N | Gelöst | Rate | Wilson 95% KI | Median Suchbits | Modellaufrufe |
|---|---|---|---|---|---|---|---|
| L0 ein Token | Mutanten im PIT-Stil [109] von 9 realen Repositories an festgelegten Commits (Java: commons-math, commons-collections, jsoup, joda-time, gson; Python: click, attrs, pydantic, sympy) | 520,821 | 520,541 | 0.9995 | 0.9994 bis 0.9995 | 2.3 | 0 |
| L0 ein Token, nie zum Abstimmen genutzte Repositories | commons-text, commons-io, more-itertools, httpx | 23,015 | 23,015 | 1.0000 | 0.9998 bis 1.0000 | 2.0 | 0 |
| L1 eine Anweisung, Java | ManySStuBs4J 2.0, Korrekturen mit einem Hunk [107] | 24,072 | 9,288 | 0.386 | 0.380 bis 0.392 | 3.5 | 0 |
| L1 eine Anweisung, Java, ganze Datei | ManySStuBs4J 2.0 [107], Datei am Eltern-Commit mit den Methoden- und Wächterindizes des Projekts | 21,320 | 13,586 | 0.637 | 0.631 bis 0.644 | 4.8 | 0 |
| L1 eine Anweisung, Python | TSSB-3M v1.0.0, Shards 14 und 15 [108] | 157,089 | 27,266 | 0.174 | 0.172 bis 0.175 | 4.8 | 0 |
Abbildung 14 trägt die Zeilen der Tabelle mit ihren Intervallen auf.
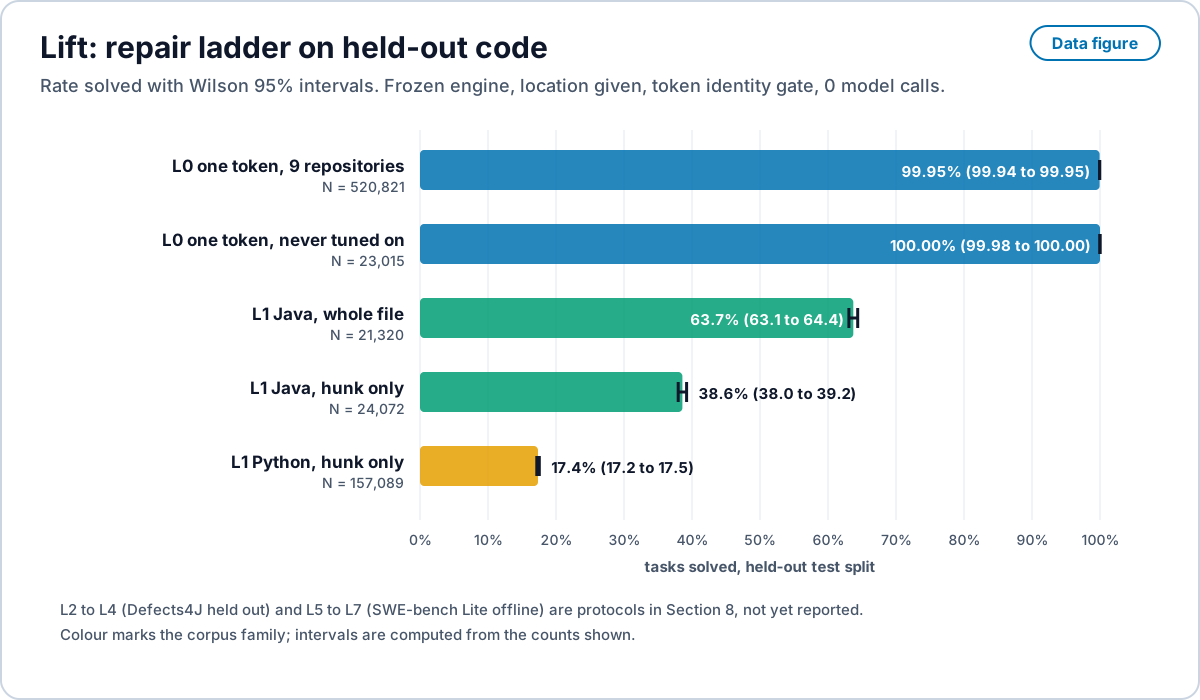
bench/ladder. Eine PNG-Kopie ist verfügbar. Open full size · PNG
L2 bis L4 werden auf dem zurückgehaltenen Defects4J-Satz von 288 Fehlern gemessen (Abschnitt 8.1). L5 bis L7 folgen den Protokollen von Abschnitt 8.2. Methode, Tor und Energie jeder Zeile folgen.
Offene Frage: Vergleichsbasis für die Ein-Token-Rate. Die L0-Zeilen messen, wie oft eine nach Priorität geordnete Ein-Token-Nachbarschaft einen Ein-Token-Mutanten wiederherstellt. Wird die Nachbarschaft aus denselben Operatortabellen gebaut, die die Mutanten erzeugt haben, spiegelt eine hohe Rate zum Teil diese Überschneidung wider und nicht die Fähigkeit, Fehler zu reparieren, die in der Praxis auftreten. Das Papier nennt dieses Kopplungsrisiko und gibt keine Zahl dafür an. Eine einfache Suche durch Umkehrung von Operatoren, auf denselben Mutanten ausgeführt, ist die Vergleichsbasis, die zeigen würde, wie viel der Rate sie erklärt. Diese Vergleichsbasis wurde nicht ausgeführt, daher wird hier keine Zahl angegeben, und die Ein-Token-Rate bleibt diesem Einwand ausgesetzt.
Die Raten lesen sich als Absichtsbits. Bei L0 liegen die fehlenden Bits fast alle auf der Zeile, und eine nach Priorität geordnete Ein-Token-Nachbarschaft liefert sie im Median mit 2.3 Bit. In der L1-Zeile mit nur dem Hunk sieht die Engine nur den 7-zeiligen Hunk. Sie schließt die Kategorien, deren Bits im Hunk liegen (Java: geänderter Operator 91%, vertauschtes boolesches Literal 84%, vertauschte Argumente 82%; Python: geändertes boolesches Literal 98.8%, vertauschte Argumente 99.4%), und lässt jene offen, deren Bits außerhalb liegen: Methodennamen (22%) und Bezeichner (37%) brauchen die Datei und ihre Typen, und neue Konjunkte (3% bis 7%) sowie Umschreibungen ganzer Anweisungen (Python, 1.2% einer Kategorie, die 34% des Korpus ausmacht) sind neue Absicht. Neue Absicht ist das, was ein Lieferant (eine Spezifikation, ein Test, ein Mensch oder ein lokales Modell) einmal bereitstellt, danach steht die Passung im Index.
Methode. Jeder Korpus wird mit einem festen Seed gemischt. Die ersten 2,000 Positionen jeder Mischung, und für L0 drei ganze Repositories (commons-lang, requests, flask), bilden die Entwicklungsaufteilung, auf der die Gänge abgestimmt werden dürfen; Entwicklungsergebnisse werden nicht berichtet. Jede übrige Aufgabe gehört zur Testaufteilung. Vor einem Testlauf wird die Engine committet und ihr Binärhash aufgezeichnet, und während des Laufs ändert sich kein Gang. Jede Zeile dieses Abschnitts ist ein Ergebnis der eingefrorenen Engine nur auf Testaufgaben, mit 0 Modellaufrufen. Die Präregistrierung (PREREG.json), die Zeilen pro Aufgabe und das Berichtsskript liegen im öffentlichen Repository.
Tor. Bei L0 und L1 ist der Ort gegeben, und das Tor ist Token-Identität: Die reparierte Zeile oder Anweisung muss Token für Token der des Entwicklers gleichen. Das ist strenger als das Bestehen der Tests, weil ein Patch eine schwache Testsuite bestehen und trotzdem falsch sein kann. Qi und Kollegen fanden, dass die meisten Patches, die GenProg als Korrekturen meldete, plausibel, aber falsch waren [92]; Überanpassung an Tests ist in suchbasierter und semantikbasierter Reparatur dokumentiert [93, 94] und wird mit generierten Tests angegangen [95]; Werkzeuge schneiden auf dem Benchmark besser ab, auf den sie abgestimmt wurden [96]; und Fehlerlokalisierung verzerrt Vergleiche [97]. Token-Identität beseitigt auf diesen Sprossen die Plausibilitätslücke, und die Angabe des Orts entfernt den Lokalisierungsterm, sodass die Rate allein die Reparaturgänge misst. L2 und darüber verwenden die Tests als Tor und berichten plausible und korrekte Zahlen getrennt (Abschnitt 8.1).
6.1 L0: Fehler in einem Token
Der L0-Korpus umfasst jeden Mutanten im PIT-Stil [109] mit einem gültigen Ersatz-Token in neun realen Repositories an festgelegten Commits, fünf in Java und vier in Python: 520,821 Testaufgaben von 547,448. Die Engine (Commit 65571d0, Gänge G0-T und G1-J) stellt 520,541 wieder her, eine Rate von 0.9995 (95% Wilson-Intervall 0.9994 bis 0.9995) bei einem Median von 2.3 Suchbits. Von den 280 ungelösten sind 108 mutierte Ziffern in Gleitkommaliteralen und 2 liegen in Python-Mengenliteralen. Ein Gang für Gleitkommaliterale (G0-F, Commit ecfe5a1) wird auf vier nie zum Abstimmen genutzten Repositories getestet (commons-text, commons-io, more-itertools, httpx): 23,015 von 23,015 Aufgaben, 1.0000 (0.9998 bis 1.0000), ein Median von 2.0 Suchbits. Mutanten stehen stellvertretend für reale Ein-Token-Fehler, die nach Just und Kollegen mit realen Fehlern gekoppelt sind [110].
6.2 L1: Fehler in einer Anweisung aus realen Historien
L1 verwendet zwei öffentliche Datensätze realer Korrekturen einzelner Anweisungen, gewonnen aus Open-Source-Historien. ManySStuBs4J 2.0 [107] liefert 24,072 Java-Testaufgaben; die Engine (Commit f2701b7) löst 9,288, eine Rate von 0.386 (0.380 bis 0.392). TSSB-3M v1.0.0 [108] liefert 157,089 Python-Testaufgaben aus den Shards 14 und 15; dieselbe Engine löst 27,266, eine Rate von 0.174 (0.172 bis 0.175). Die Engine erhält nur den 7-zeiligen Hunk, also ist diese Java-Rate ein Ergebnis nur mit Hunk. Mit der ganzen Datei am Eltern-Commit, mit Indizes der Methoden und Wächterbedingungen des Projekts und mit den Gängen für geänderte Methodennamen, hinzugefügte Argumente, Wächterbedingungen, throws und Modifikatoren (Commit 62fb7a0, sha256-Präfix der Binärdatei 3682c6515acdf722, vor dem Lauf präregistriert), löst die Engine 13,586 der 21,320 Java-Testaufgaben, deren Datei und fehlerhafte Anweisung sich auffinden ließen, eine Rate von 0.637 (0.631 bis 0.644). Nach Kategorie schließt sie geänderte Operatoren (95.9%), geänderte Operanden (92.1%), falsche Aufrufer (87.9%), vertauschte boolesche Literale (88.4%), gelöschte Argumente (85.1%) und vertauschte Argumente (83.3%); geänderte Methodennamen erreichen 61.4% und hinzugefügte Argumente 51.4%, und neue oder verengte Bedingungen (43.5% und 51.7%) bleiben die wichtigste offene Absicht. Die vollständigen Tabellen pro Schicht stehen im Repository. Für diese Datensätze gibt es unter diesem Tor (nur Hunk, Token-Identität, Ort gegeben) keine veröffentlichte Rangliste der Reparatur, daher steht keine Zahl gelernter Reparatur daneben; Defects4J, das eine hat, wird in Abschnitt 8.1 mit TBar verglichen.
6.3 Energie
Jede Zeile trägt est_j, eine Schätzung aus CPU-Sekunden mal 10 W: 0.40 J pro gelöster Aufgabe bei L0, 0.13 auf den frischen Repositories, 0.10 auf ManySStuBs4J und 0.27 auf TSSB-3M. Eine Teilstichprobe wurde mit RAPL [105] abgelesen, dem Paketzähler auf dem Prozessorchip, auf einem Linux-Laptop mit einem Intel i9-13900H (Hostname jetson-hub; kein NVIDIA Jetson). Der Harness lief auf 4 festgelegten CPUs, und reported_j ist das Paketdelta über den ganzen Lauf, einschließlich des Python-Treibers, abzüglich der Leerlaufleistung aus einer 10-s-Stichprobe unmittelbar davor, multipliziert mit der Laufdauer. Runner der kontinuierlichen Integration waren aktiv, also lag der Leerlauf bei 40 W bis 44 W, und die Unsicherheit beträgt etwa ±1 W mal die Dauer, ±10 J auf diesen Summen.
| Teilstichprobe (Testaufteilung) | Aufgaben | Gelöst | Roh J | reported_j | reported_j pro gelöster Aufgabe | Sekunden |
|---|---|---|---|---|---|---|
| L0, gson-Mutanten (geseedet, erste 3,000) | 3,000 | 3,000 | 648.3 | 167.5 | 0.056 | 11.8 |
| L1, ManySStuBs4J Positionen 2,000 bis 3,999 | 2,000 | 690 | 377.2 | 17.9 | 0.026 | 8.2 |
Die L1-Teilstichprobe baut ihren Projektindex nur aus ihren 2,000 Aufgaben, daher liegt ihre Lösungsrate (34.5%) unter der des vollen Laufs. measured_j, ein Wandmessgerät an einer benannten Versorgungsschiene, ist in jeder Zeile leer; sein Protokoll ist Abschnitt 8.3.
7. Belege für Wiederverwendung
Die Position von RCE auf der Achse der Wiederverwendung ruht auf einer technischen Tatsache: Code wird auf jeder Skala wiederverwendet. Jede der folgenden Methoden misst das anders.
| Methode | Quelle | Befund |
|---|---|---|
| Klonkartierung auf Dateiebene | DéjàVu, Lopes et al. 2017 [33] | Von 428 Millionen Dateien in 4.5 Millionen GitHub-Projekten, die keine Forks sind, sind 85 Millionen eindeutig: „70% of the code on GitHub consists of clones of previously created files.“ In JavaScript sind 6% der Dateien verschieden. |
| Redundanz auf Zeilenebene | Gabel und Su 2010 [34] | Gegenüber 420 Millionen Zeilen ist „between 50% and 100% of each project is redundant“ bei etwa einer Zeile. |
| Statistische Sprachmodelle | Hindle et al. 2012 [35] | Code ist „very repetitive, and in fact even more so than natural languages.“ |
| Beinahe-Deduplizierung von Korpora | The Stack [36] | Beinahe-Deduplizierung entfernt 54.7% von The Stack v1 (6.4 TB auf 2.9 TB) und 52.4% von v2 (67.5 TB auf 32.1 TB). |
| Bewahrung des ganzen Archivs | Software Heritage [129, 130] | 30.3 Milliarden eindeutige Dateiinhalte aus 448 Millionen Ursprüngen (Archivzähler, gelesen am 13. Oktober 2026), jeder einmal nach dem Hash seiner Bytes gespeichert. |
| Gewonnene Korrekturmuster | PAR, TBar [22, 23] | PAR fand „several common fix patterns“ in mehr als 60,000 menschlichen Patches. Die 15 Musterkategorien von TBar korrigieren 43 Defects4J-Fehler korrekt in der Standardpipeline und 74 von 101 mit perfekter Fehlerlokalisierung, ohne Lernen. Dies sind Werte, wie sie aus [23] abgelesen wurden; die Bedeutung der 101 (plausible Patches oder versuchte Fehler) wurde hier nicht erneut an jenem Papier geprüft, daher ist das Verhältnis als unbestätigt zu behandeln. |
| Sprachübergreifende Aufgaben | Rosetta Code [131] | 1,360 Aufgaben (und 421 Aufgabenentwürfe), jede ein Konzept, umgesetzt in vielen von 1,009 bekannten Sprachen. |
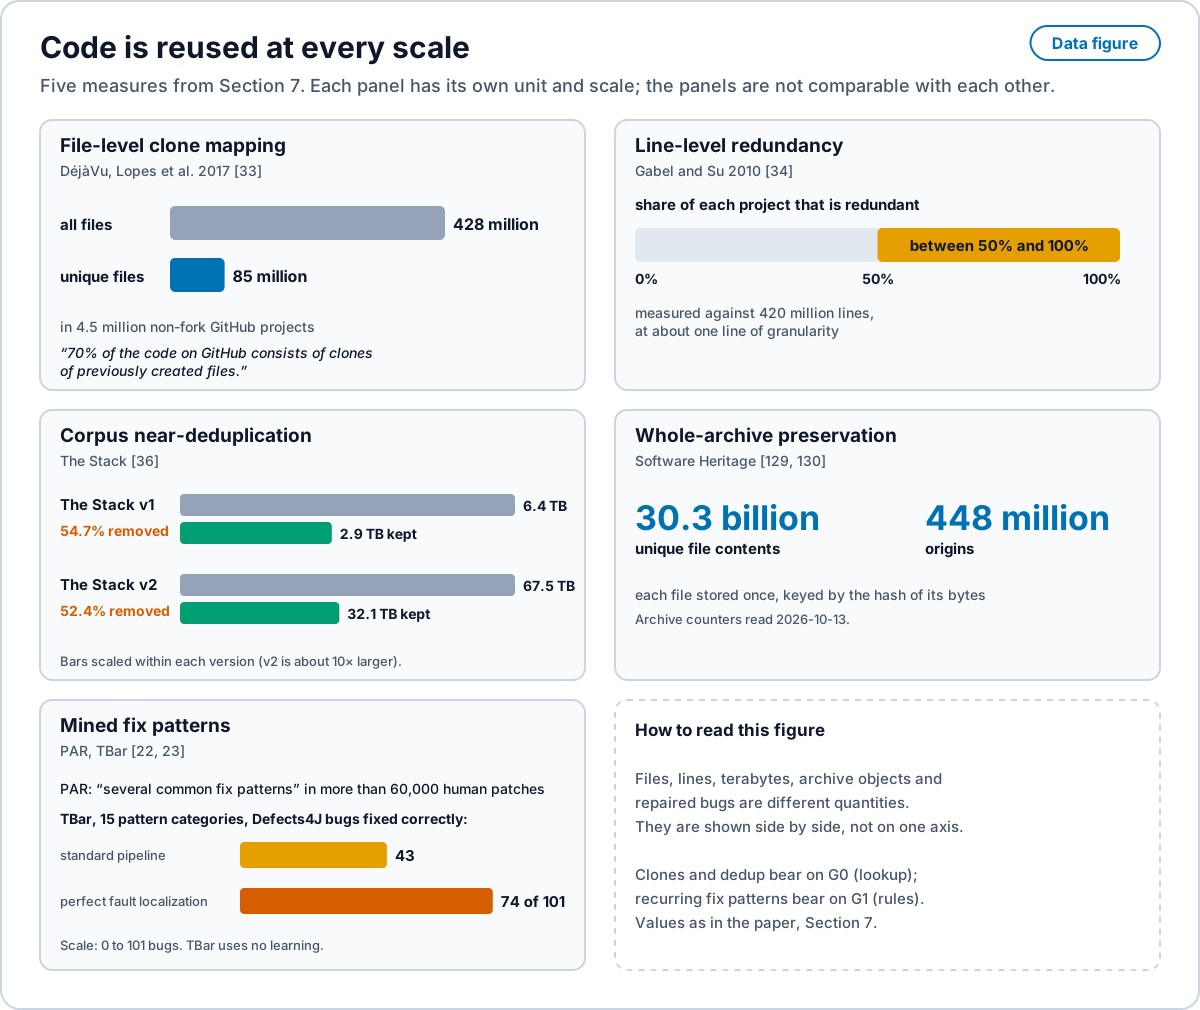
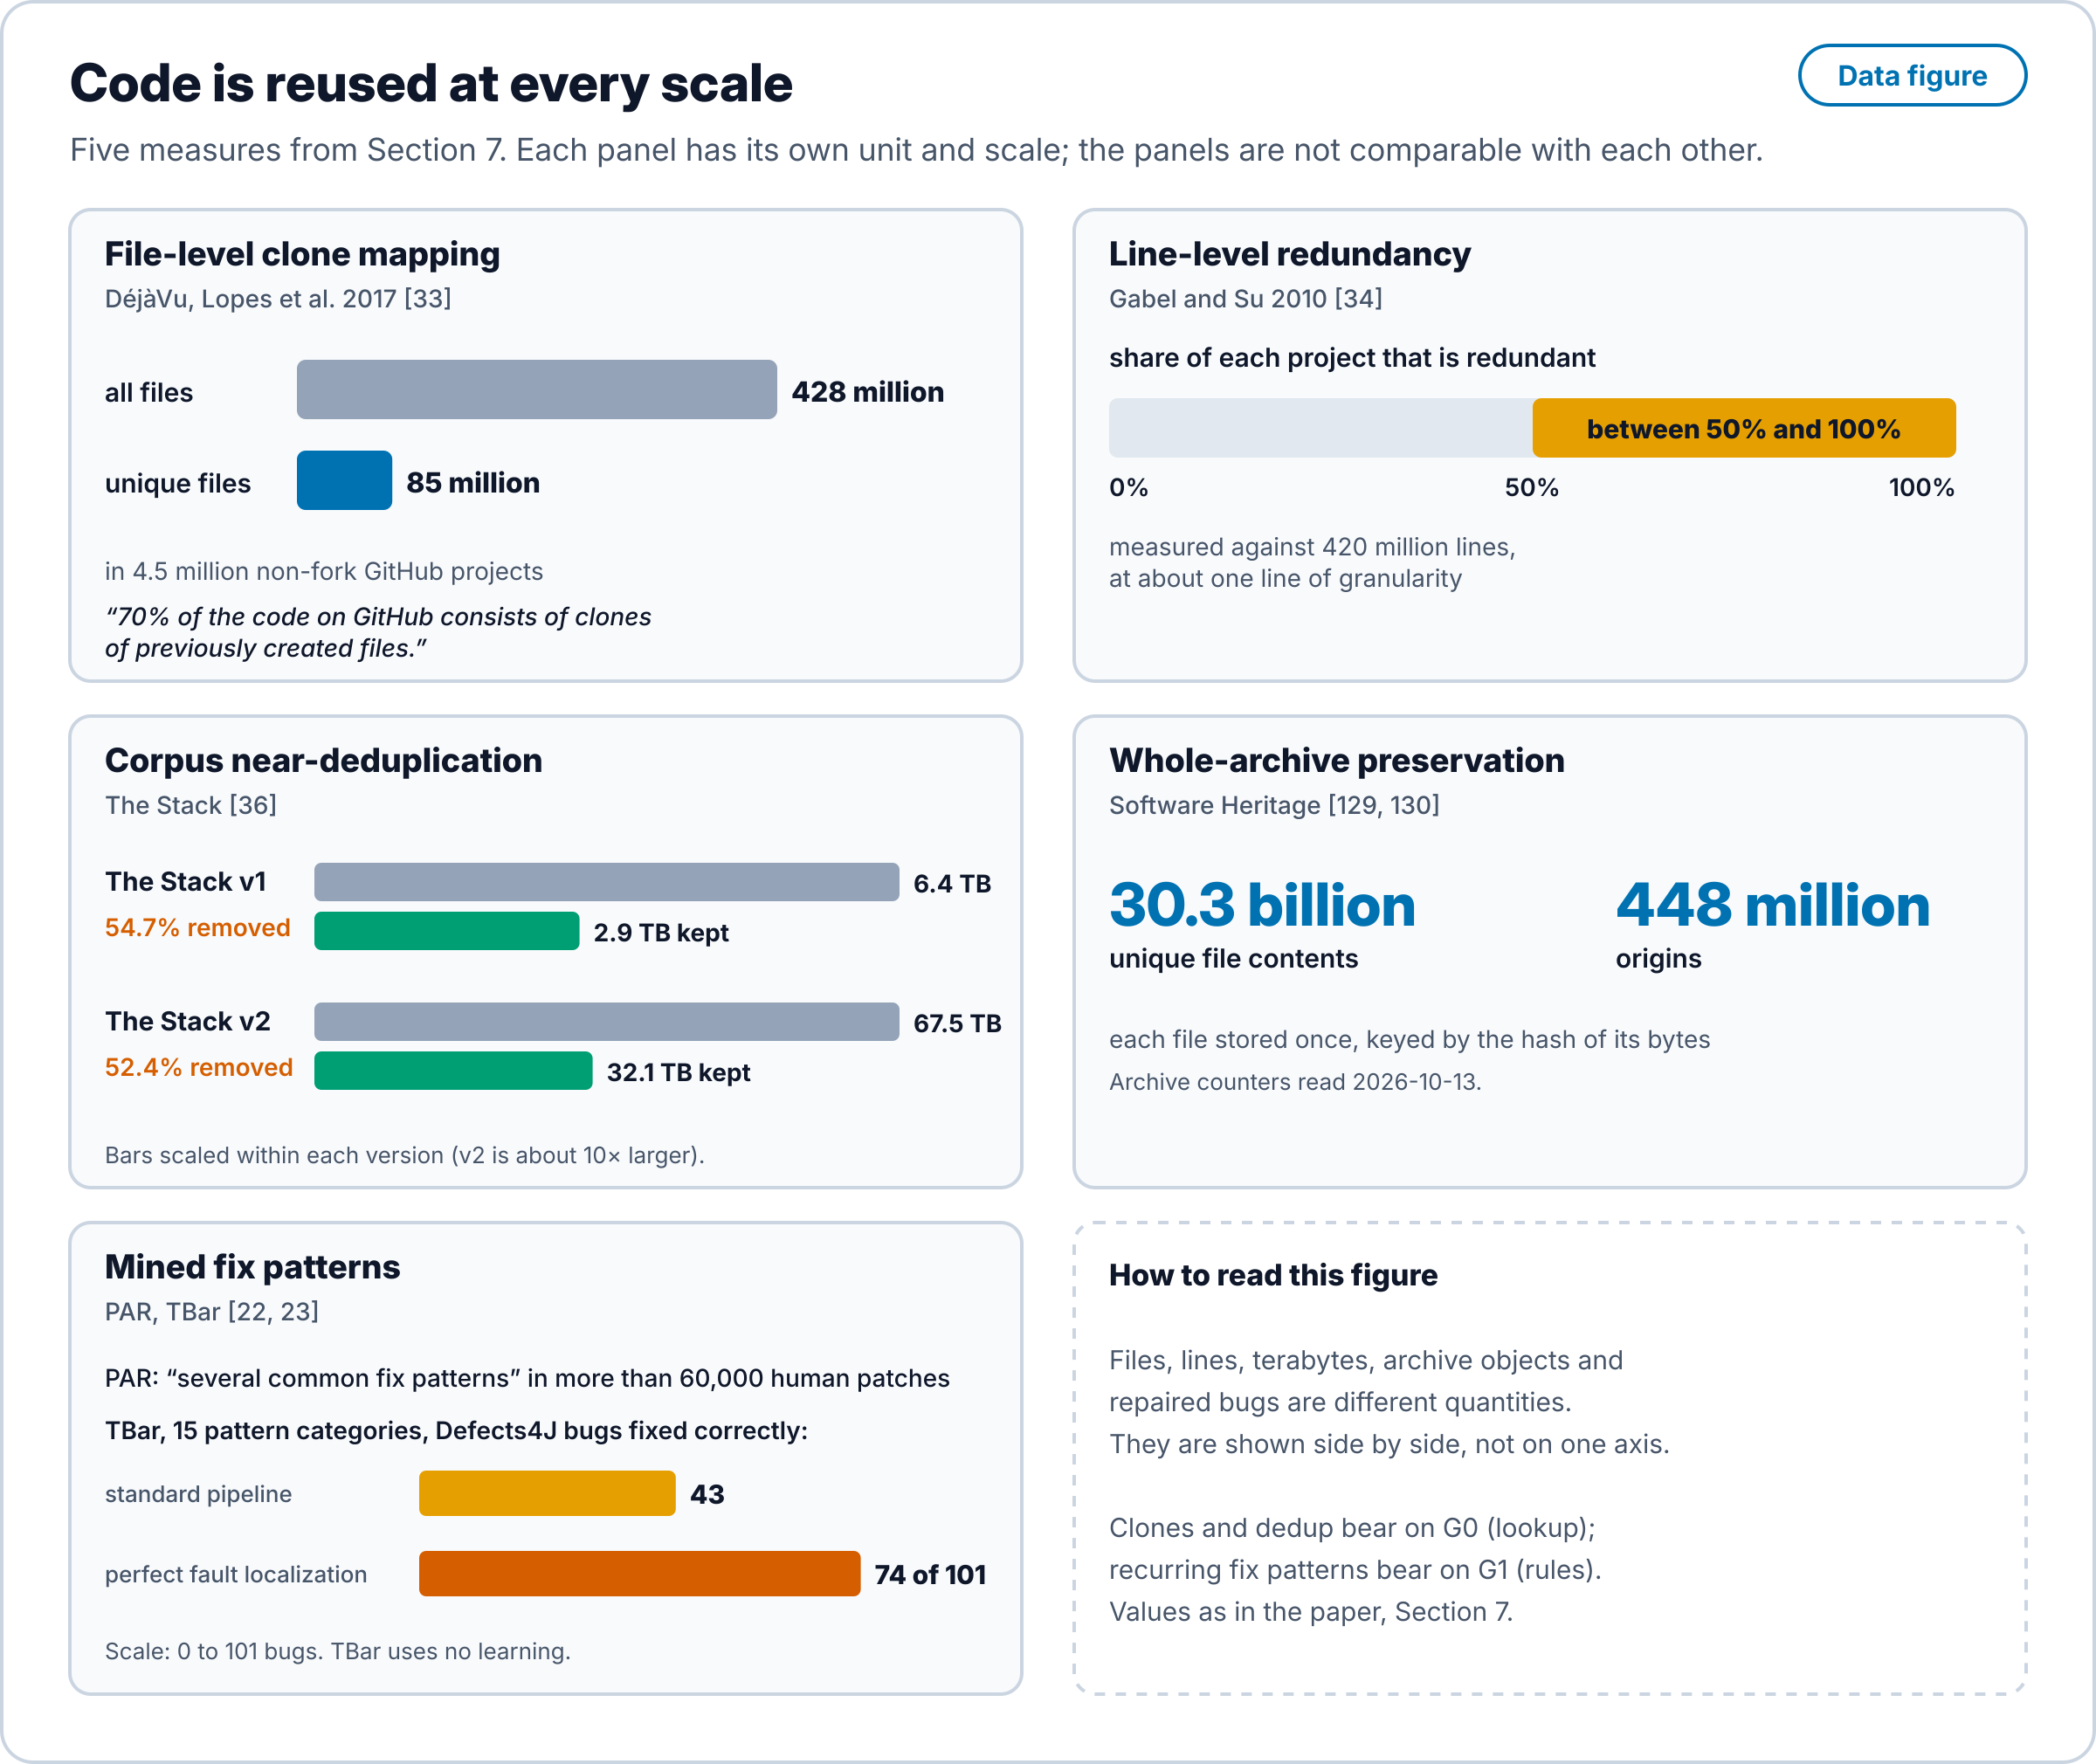
Jede Zeile ist eine Eingabe der Engine. Klone und Deduplizierung sagen, dass eine Passung meist existiert, das ist G0. Wiederkehrende Korrekturen sagen, dass Anpassung meist ein kleiner Katalog bewachter Umschreibungen ist, das ist G1. Redundanz auf Zeilenebene verkleinert den Suchraum von G2. Das Ökosystem misst das an jeder beförderten Passung (Abschnitt 2.3), und die Reparaturleiter auf gehobenem Code misst es im großen Maßstab auf zurückgehaltenen Aufteilungen (Abschnitt 6). Zwei Vorbehalte schärfen die Lesart. Duplikate blähen Abruf- und Modellwerte auf, sofern sie nicht entfernt werden [104]. Und fehlerhafte Zeilen sind weniger natürlich als korrigierte [45], also ist der Fehler selbst der Fall, den das Nachschlagen am wenigsten vorhersagen kann; die Gestalt der Korrektur, nicht die fehlerhafte Zeile, ist das, woran G0 und G1 ansetzen müssen. Die Linie des Regelabbaus, die das im großen Maßstab leistet, von GenProgs Suche nach dem Muster Erzeugen und Validieren [88] und Prophets gelerntem Korrektheitsmodell [89] bis zu Getafix bei Facebook [90] und Soralds modellfreier Reparatur von Verstößen der statischen Analyse [91], leitet Vorlagen aus disjunkter Historie ab und berichtet die Präzision auf ungesehenen Fällen [98]. Das ist der Standard, den Abschnitt 8.4 übernimmt.
8. Messprotokolle für das Kommende
Jedes Protokoll ist vor seinem Lauf festgelegt: Präregistrierung committet, Seeds und Commit des Lösers aufgezeichnet, jedes Artefakt aufbewahrt. Zuerst das Tor, dann die Joule, immer die Kennzeichnung.
8.1 Defects4J
Defects4J enthält 854 aktive reale Java-Fehler, jeder mit reproduzierenden Tests [37].
- Entwickeln auf einer Teilmenge von 100 Fehlern, offline, über
defects4j checkout; nur zurückgehaltene Ergebnisse berichten, auf einer disjunkten Menge von 288 Fehlern, die vor dem Lauf eingefroren wurde (FROZEN-heldout-v1). - G0, dann G1, dann G2, dann zuletzt ein lokales Modell ausführen. Den Gang aufzeichnen, der jeden Fehler geschlossen hat.
- Tor: Die auslösenden Tests und die volle Suite bestehen. Plausible und korrekte Zahlen getrennt berichten; korrekt heißt bei Prüfung äquivalent zum Patch des Entwicklers.
- Modellaufrufe pro korrekter Korrektur und Joule pro korrekter Korrektur berichten, gekennzeichnet.
- Bezugspunkte: die 43 korrekten Korrekturen von TBar und seine 74 von 101 bei perfekter Lokalisierung (Werte wie aus [23] abgelesen, der Nenner hier nicht erneut geprüft). Dieser Abschnitt ist ein Protokoll. In diesem Papier wird kein Defects4J-Ergebnis dieser Engine berichtet.
- Kontaminationsprüfung: jeden Fehler markieren, dessen Korrektur wörtlich im Index von G0 vorkommt, und mit und ohne markierte Fehler berichten.
8.2 SWE-bench Lite, offline
SWE-bench Lite ist eine Teilmenge von 300 Aufgaben aus realen GitHub-Issues, aufgelöst durch verborgene Tests [38].
- Den offiziellen Docker-Harness ohne Netzwerk verwenden.
- Erster Lauf: nur G0 und G1, null Modellaufrufe. Das ist der Boden des Lösens ohne Modell.
- Zweiter Lauf: ein lokales Modell als letzten Gang hinzufügen.
- Auflösungsrate, Modellaufrufe pro aufgelöster Aufgabe und Joule pro aufgelöster Aufgabe berichten, gekennzeichnet.
- Kontaminationsprüfung wie in 8.1. SWE-Bench+ fand, dass 32.67% der erfolgreichen Patches die Lösung im Issue-Text hatten [39].
8.3 Ein Wandmessgerät
- Ein Wandmessgerät oder ein Shunt-Messgerät an der Versorgung des Hosts anbringen, protokolliert mit angegebener Rate und mit einer Uhr, die mit dem Laufprotokoll synchronisiert ist.
- Ruhende Maschine: CI-Runner und andere Builds gestoppt, und vor jedem Block ein Tor für ein ruhiges Zeitfenster geprüft und aufgezeichnet.
- Eine gemessene Leerlaufbasis abziehen und die Methode angeben.
measured_jallein aus dem Messgerät füllen.reported_j(RAPL) undest_jdaneben in getrennten Spalten berichten. Nie über Kennzeichnungen hinweg summieren.- Die RAPL-Teilstichproben aus Abschnitt 6.3 unter dem Messgerät wiederholen, dann den zurückgehaltenen Defects4J-Satz.
8.4 Ein zurückgehaltener Lauf mit eingefrorenen Gängen
Das ist die Methode von Abschnitt 6, erweitert auf neue Korpora.
- G0, G1 und G2 an einem markierten Commit einfrieren, den Binärhash aufzeichnen und den Regelsatz mit seinen Erstellungszeitstempeln veröffentlichen.
- Eine disjunkte zurückgehaltene Scheibe ziehen: die Rust- und Python-Instanzen von Multi-SWE-bench [102] und BugsInPy [103], dedupliziert gegen den Index von G0 [104].
- Scheibe, Seeds und Hypothesen vor dem ersten Lauf präregistrieren.
- Aufgelöste, plausible und byteidentische Zahlen getrennt berichten, jeweils mit einem 95%-Intervall.
8.5 Vergleichswerte in derselben Tabelle
- Modellfrei:
cargo fixund clippy [106], sowie Sorald oder eine Portierung von TBar [91]. - Billiges Modell: Agentless mit einem lokalen Modell [99].
- Entferntes Modell: ein Agent mit einem Frontier-Modell, seine Energie aus Angaben des Anbieters geschätzt und als
est_jgekennzeichnet. - Cost-of-pass [101] in Joule und in Dollar für jede Zeile berichten, mit Kostenkontrolle, wie Kapoor und Kollegen sie verlangen [100].
8.6 Konvergenz der Modellaufrufe bei großem N
Beförderung ist der Mechanismus, durch den das Modell die Schleife verlässt: Ein Auflöser wird einmal für einen neuen Fall bezahlt, das Tor lässt die Passung als Handler zu, und jeder spätere Fall derselben Gestalt schließt in G0 oder G1 (Abschnitt 4.2). Konvergenz ist die Behauptung, dass die Modellaufrufe pro Runde auf einer festen Spezifikation unter Live-Verkehr auf null fallen. Sie wird wie folgt gemessen.
- Mindestens 1,000 Spezifikationen aus öffentlichen Repositories ziehen, geschichtet nach Sprache und Größe, und Engine und Auflöser vor der ersten Runde einfrieren.
- Aufgezeichneten Produktionsverkehr wiedergeben, mindestens 10,000 Ereignisse pro Spezifikation, in Runden fester Größe.
- Pro Runde aufzeichnen: neue Eskalationen, Modellaufrufe, Beförderungen, Zurückstellungen und Joule pro geschlossener Aufgabe, jeweils gekennzeichnet (
est_j,reported_j,measured_j). - Primärer Endpunkt: der Anteil der Spezifikationen, die innerhalb von 20 Runden eine Runde mit null Modellaufrufen erreichen, mit einem 95%-Wilson-Intervall. Sekundär: Modellaufrufe pro geschlossener Aufgabe nach Runde und die Runde des letzten Modellaufrufs.
- Spezifikationen, die nie konvergieren, mit ihrer Ursache berichten (eine festsitzende Eingabe, eine fehlende Abhängigkeit, neue Absicht), und die Zurückstellung festsitzender Eingaben als präregistrierten Arm ausführen.
Proposition 8 (Annäherung an den Boden). Mit wachsender Abdeckung von G0 und G1 nähern sich die Joule pro gelöster Aufgabe dem Goldboden: eine bekannte Korrektur anwenden und die Tests ausführen. Die Sprossen der Leiter und der zurückgehaltene Defects4J-Satz unter dem Wandmessgerät prüfen das.
8.7 Abdeckung der Hebung über Sprachen hinweg
Die Hebung wird gemessen, während sie gebaut wird. Für eine Sprache gilt ein Programm als gehoben, wenn die eigenen Tests des Programms besteht und seine aufgezeichneten Spuren Byte für Byte nachspielt und denselben Gestalthash hat wie . Die Stichprobe umfasst mindestens 10,000 Programme pro Sprache für mindestens zehn Sprachen, mit festem Seed aus festgelegten öffentlichen Korpora gezogen, wobei der Heber vor jedem Lauf eingefroren und sein Binärhash aufgezeichnet wird, und 0 Modellaufrufe. Jeder Lauf berichtet den gehobenen Anteil mit einem 95%-Wilson-Intervall, und jedes noch nicht gehobene Konstrukt ist ein Arbeitspunkt für den Heber dieser Sprache, gebaut und eingefroren vor dem nächsten Lauf. Das Ziel ist jedes Programm in jeder Sprache.
9. Falsifikatoren
Vor den Läufen festgelegt, die sie prüfen.
| ID | Beobachtung | Widerlegt |
|---|---|---|
| RCE-F0 | In einem präregistrierten Lauf von mindestens 10,000 Formen gibt irgendeine Projektion eine Spur aus, die von der Referenzspur der Form abweicht, oder irgendeine fehlerhafte Eingabe wird angenommen | Die Aussage, dass Projektionen getreu sind und das Tor am Eingang abweist |
| RCE-F1 | Auf der zurückgehaltenen Scheibe lösen G0 bis G2 mit eingefrorenen Regeln weniger als 10% der Aufgaben mit 0 Modellaufrufen | Die Behauptung, dass für Reparatur in diesem Maßstab die meisten Passungen bereits existieren |
| RCE-F2 | Byteidentische oder äquivalente Patches machen weniger als die Hälfte der aufgelösten zurückgehaltenen Aufgaben aus | Die Lesart des Tors als mehr als Plausibilität auf den abgedeckten Aufgaben |
| RCE-F3 | Unter dem Wandmessgerät übersteigen die Brutto-Joule pro gelöster Aufgabe des RCE-Lösers die des billigsten Modellvergleichs auf den Aufgaben, die beide lösen | Die Aussage geringerer Energie pro gelöster Aufgabe auf abgedeckten Aufgaben |
| RCE-F4 | Im Konvergenzprotokoll von Abschnitt 8.6 erreicht weniger als die Hälfte der Spezifikationen ohne festsitzende Eingabe innerhalb von 20 Runden eine Runde mit null Modellaufrufen | Das Herauskompilieren des Modells aus der Schleife |
10. Noch zu erledigende Arbeit
Jeder Punkt hat sein benanntes Protokoll.
- Hebung, gebaut und gemessen über mindestens zehn Sprachen nach dem Protokoll von Abschnitt 8.7.
- Der Spezifikationsarm: Spezifikationen im Stil von MBPP und HumanEval, als Formen geschrieben und auf jedes Ziel ausgegeben.
- Zurückgehaltene Ergebnisse auf L2 bis L4, dem Defects4J-Satz von 288 Fehlern (Abschnitt 8.1), und auf L5 bis L7 (Abschnitt 8.2).
- Vergleichswerte in einer Tabelle, Cost-of-pass in Joule und Dollar (Abschnitt 8.5).
- Eine Reihe von
measured_j: ein Wandmessgerät an einem ruhenden Host, mindestens 10 Wiederholungen, brutto und netto nebeneinander (Abschnitt 8.3). - Die Erhebung der 626 Sprachen, mit ihrer Methode veröffentlicht (Abbildung 1).
- Neue zurückgehaltene Korpora bei eingefrorenen Gängen: Multi-SWE-bench und BugsInPy (Abschnitt 8.4).
- Konvergenz der Modellaufrufe über mindestens 1,000 Spezifikationen (Abschnitt 8.6).
11. Fazit
RCE ist ein natives Code-Ökosystem. Ein Programm wird einmal aus der Absicht geschrieben, als Form: eine verlustfreie Codierung von Zustand, Ereignissen und reinen Übergängen, und jede Zielsprache ist eine getreue Projektion davon. Ungültige Zustände können nicht geschrieben werden, und fehlerhafte Eingaben werden am Eingang abgewiesen, sodass ein Programm im Ökosystem nicht von seiner Absicht abdriften kann und keinen nachträglichen Diff und keine nachträgliche Fehlerverfolgung braucht. Jede Passung, die das Tor passiert, wird gespeichert und wiederverwendet, und das Ökosystem wächst kumulativ unter einem Tor, dessen Korrektheit monoton ist. Auf 10,000 präregistrierten Formen mit eingefrorener Engine und 0 Modellaufrufen übersteht jede Form die Rundreise zu identischen Bytes, jede Projektion ist deterministisch, jede fehlerhafte Eingabe und Spezifikation wird am Eingang abgewiesen, und die Python-Projektion spielt die Referenzspur auf 9,999 nach. Code aus anderen Sprachen tritt durch Hebung ein, eine Konstruktion von der Grammatik jeder Sprache über ihren Syntaxbaum zur Form; auf gehobenem Code stellen die Reparaturgänge 99.95% von 520,821 Ein-Token-Fehlern und 63.7% von 21,320 Java-Fehlern mit einer Anweisung wieder her. Die Abschnitte 3.6 und 8.7 nennen die Universalitätspropositionen und wie ihre Konstruktion gemessen wird.
Literatur
[1] C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal 30(1), 1951. doi:10.1002/j.1538-7305.1951.tb01366.x
[2] Y. Gurevich, “Sequential Abstract State Machines Capture Sequential Algorithms,” ACM Transactions on Computational Logic 1(1), 2000. doi:10.1145/343369.343384
[3] A. Blass and Y. Gurevich, “Abstract State Machines Capture Parallel Algorithms,” ACM Transactions on Computational Logic, 2003. doi:10.1145/937555.937561
[4] N. Dershowitz and Y. Gurevich, “A Natural Axiomatization of Computability and Proof of Church’s Thesis,” Bulletin of Symbolic Logic, 2008. doi:10.2178/bsl/1231081370
[5] E. F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM, 1970. doi:10.1145/362384.362685
[6] G. H. Mealy, “A Method for Synthesizing Sequential Circuits,” Bell System Technical Journal, 1955. doi:10.1002/j.1538-7305.1955.tb03788.x
[7] E. F. Moore, “Gedanken-Experiments on Sequential Machines,” Automata Studies, 1956. doi:10.1515/9781400882618-006
[8] K. Kang et al., “Feature-Oriented Domain Analysis (FODA) Feasibility Study,” CMU/SEI-90-TR-021, 1990.
[9] R. Alur et al., “Syntax-Guided Synthesis,” FMCAD 2013. doi:10.1109/FMCAD.2013.6679385
[10] D. Harel, “Statecharts: A Visual Formalism for Complex Systems,” Science of Computer Programming, 1987. doi:10.1016/0167-6423(87)90035-9
[11] R. Tate, M. Stepp, Z. Tatlock and S. Lerner, “Equality Saturation,” POPL 2009. doi:10.1145/1480881.1480915
[12] M. Willsey et al., “egg: Fast and Extensible Equality Saturation,” POPL 2021. doi:10.1145/3434304
[13] B. Moseley and P. Marks, “Out of the Tar Pit,” 2006.
[14] M. Fowler, “Event Sourcing,” 2005. https://martinfowler.com/eaaDev/EventSourcing.html
[15] P. Alvaro et al., “Dedalus: Datalog in Time and Space,” LNCS 2011. doi:10.1007/978-3-642-24206-9_16
[16] A. M. Turing, “On Computable Numbers,” Proceedings of the London Mathematical Society, 1937. doi:10.1112/plms/s2-42.1.230
[17] A. Church, “An Unsolvable Problem of Elementary Number Theory,” American Journal of Mathematics, 1936. doi:10.2307/2371045
[18] P. Wadler, “Propositions as Types,” Communications of the ACM, 2015. doi:10.1145/2699407
[19] J. M. Hellerstein and P. Alvaro, “Keeping CALM,” Communications of the ACM, 2020. doi:10.1145/3369736
[20] G. Kahn, “The Semantics of a Simple Language for Parallel Programming,” IFIP 1974, pp. 471 to 475.
[21] H. Husain et al., “CodeSearchNet Challenge,” 2019. arXiv:1909.09436
[22] D. Kim, J. Nam, J. Song and S. Kim, “Automatic Patch Generation Learned from Human-Written Patches” (PAR), ICSE 2013. doi:10.1109/ICSE.2013.6606626
[23] K. Liu et al., “TBar: Revisiting Template-based Automated Program Repair,” ISSTA 2019. arXiv:1903.08409
[24] K. Liu et al., “AVATAR: Fixing Semantic Bugs with Fix Patterns of Static Analysis Violations,” SANER 2019. arXiv:1812.07270
[25] A. Koyuncu et al., “FixMiner: Mining Relevant Fix Patterns for Automated Program Repair,” 2018. arXiv:1810.01791
[26] Y. Padioleau et al., “Documenting and Automating Collateral Evolutions in Linux Device Drivers” (Coccinelle), EuroSys 2008. doi:10.1145/1352592.1352618
[27] A. Solar-Lezama et al., “Combinatorial Sketching for Finite Programs,” ASPLOS 2006. doi:10.1145/1168857.1168907
[28] L. Chen, M. Zaharia and J. Zou, “FrugalGPT,” 2023. arXiv:2305.05176
[29] S. Haber and W. S. Stornetta, “How to Time-Stamp a Digital Document,” Journal of Cryptology, 1991. doi:10.1007/BF00196791
[30] S. A. Crosby and D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging,” USENIX Security 2009.
[31] L. de Moura and N. Bjørner, “Z3: An Efficient SMT Solver,” TACAS 2008. doi:10.1007/978-3-540-78800-3_24
[32] Kani Rust Verifier. https://github.com/model-checking/kani
[33] C. V. Lopes et al., “DéjàVu: A Map of Code Duplicates on GitHub,” OOPSLA 2017. doi:10.1145/3133908
[34] M. Gabel and Z. Su, “A Study of the Uniqueness of Source Code,” FSE 2010. doi:10.1145/1882291.1882315
[35] A. Hindle et al., “On the Naturalness of Software,” ICSE 2012. doi:10.1109/ICSE.2012.6227135
[36] D. Kocetkov et al., “The Stack: 3 TB of Permissively Licensed Source Code,” 2022. arXiv:2211.15533; The Stack v2 dataset card, https://huggingface.co/datasets/bigcode/the-stack-v2
[37] R. Just, D. Jalali and M. D. Ernst, “Defects4J: A Database of Existing Faults to Enable Controlled Testing Studies for Java Programs,” ISSTA 2014. doi:10.1145/2610384.2628055
[38] C. E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. arXiv:2310.06770
[39] R. Aleithan et al., “SWE-Bench+: Enhanced Coding Benchmark for LLMs,” 2024. arXiv:2410.06992
[40] C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal 27, 1948. doi:10.1002/j.1538-7305.1948.tb01338.x
[41] A. N. Kolmogorov, “Three approaches to the quantitative definition of information,” Problemy Peredachi Informatsii 1(1), 1965 (in Russian); English translation, International Journal of Computer Mathematics 2, 1968. doi:10.1080/00207166808803030
[42] R. J. Solomonoff, “A formal theory of inductive inference. Part I,” Information and Control 7(1), 1964. doi:10.1016/S0019-9958(64)90223-2
[43] G. J. Chaitin, “A Theory of Program Size Formally Identical to Information Theory,” Journal of the ACM 22(3), 1975. doi:10.1145/321892.321894
[44] J. Rissanen, “Modeling by shortest data description,” Automatica 14(5), 1978. doi:10.1016/0005-1098(78)90005-5
[45] B. Ray, V. Hellendoorn, S. Godhane, Z. Tu, A. Bacchelli and P. Devanbu, “On the ‘naturalness’ of buggy code,” ICSE 2016. doi:10.1145/2884781.2884848
[46] Z. Tu, Z. Su and P. Devanbu, “On the localness of software,” FSE 2014. doi:10.1145/2635868.2635875
[47] M. Allamanis, E. T. Barr, P. Devanbu and C. Sutton, “A Survey of Machine Learning for Big Code and Naturalness,” ACM Computing Surveys 51(4), 2018. doi:10.1145/3212695
[48] 陈浙哲, 刘忠鑫, 鄢萌, 徐洲, 夏鑫, 雷晏 (Z. Chen, Z. Liu, M. Yan, Z. Xu, X. Xia and Y. Lei), “代码自然性及其应用研究进展” (Research progress of code naturalness and its application), 软件学报 (Journal of Software) 33(8), 3015 to 3034, 2022. doi:10.13328/j.cnki.jos.006355
[49] G. Sridhara, V. S. Sinha and S. Mani, “Naturalness of Natural Language Artifacts in Software,” ISEC 2015 (India Software Engineering Conference). doi:10.1145/2723742.2723758
[50] P. Devanbu, “On the naturalness of software,” keynote, ISEC 2013 (India Software Engineering Conference). doi:10.1145/2442754.2442763
[51] A. Z. H. Yang, S. Kolak, V. J. Hellendoorn, R. Martins et al., “Revisiting Unnaturalness for Automated Program Repair in the Era of Large Language Models,” ICSE 2025. doi:10.1109/ICSE55347.2025.00089
[52] E. W. Dijkstra, “Guarded commands, nondeterminacy and formal derivation of programs,” Communications of the ACM 18(8), 1975. doi:10.1145/360933.360975
[53] N. Wirth, “Program development by stepwise refinement,” Communications of the ACM 14(4), 1971. doi:10.1145/362575.362577
[54] C. A. R. Hoare, “An axiomatic basis for computer programming,” Communications of the ACM 12(10), 1969. doi:10.1145/363235.363259
[55] J.-R. Abrial, The B-Book: Assigning Programs to Meanings, Cambridge University Press, 1996. doi:10.1017/CBO9780511624162
[56] J.-R. Abrial, Modeling in Event-B: System and Software Engineering, Cambridge University Press, 2010. doi:10.1017/CBO9781139195881
[57] R.-J. Back and J. von Wright, Refinement Calculus: A Systematic Introduction, Springer, 1998. doi:10.1007/978-1-4612-1674-2
[58] F. L. Bauer and H. Wössner, Algorithmic Language and Program Development, Springer, 1982. doi:10.1007/978-3-642-61807-9
[59] S. Gulwani, “Automating string processing in spreadsheets using input-output examples,” POPL 2011. doi:10.1145/1926385.1926423
[60] S. Gulwani, O. Polozov and R. Singh, “Program Synthesis,” Foundations and Trends in Programming Languages 4(1-2), 2017. doi:10.1561/2500000010
[61] F. P. Brooks, “No Silver Bullet: Essence and Accidents of Software Engineering,” Computer 20(4), 1987. doi:10.1109/MC.1987.1663532
[62] P. Naur, “Programming as theory building,” Microprocessing and Microprogramming 15(5), 1985. doi:10.1016/0165-6074(85)90032-8
[63] M. M. Lehman, “Programs, life cycles, and laws of software evolution,” Proceedings of the IEEE 68(9), 1980. doi:10.1109/PROC.1980.11805
[64] P. Zave and M. Jackson, “Four dark corners of requirements engineering,” ACM Transactions on Software Engineering and Methodology 6(1), 1997. doi:10.1145/237432.237434
[65] R. Landauer, “Irreversibility and Heat Generation in the Computing Process,” IBM Journal of Research and Development 5(3), 1961. doi:10.1147/rd.53.0183
[66] C. H. Bennett, “Logical Reversibility of Computation,” IBM Journal of Research and Development 17(6), 1973. doi:10.1147/rd.176.0525
[67] M. Franz and T. Kistler, “Slim binaries,” Communications of the ACM 40(12), 1997. doi:10.1145/265563.265576
[68] C. W. Fraser, “Automatic inference of models for statistical code compression,” PLDI 1999. doi:10.1145/301618.301672
[69] P. Cousot and R. Cousot, “Abstract interpretation: a unified lattice model for static analysis of programs by construction or approximation of fixpoints,” POPL 1977. doi:10.1145/512950.512973
[70] Y. Futamura, “Partial evaluation of computation process: an approach to a compiler-compiler,” Systems, Computers, Controls 2(5), 1971; reprinted in Higher-Order and Symbolic Computation 12(4), 1999. doi:10.1023/A:1010095604496
[71] A. P. Ershov, “Mixed computation: potential applications and problems for study,” Theoretical Computer Science 18(1), 1982. doi:10.1016/0304-3975(82)90111-6
[72] W. A. Howard, “The formulae-as-types notion of construction,” in J. P. Seldin and J. R. Hindley (eds.), To H. B. Curry: Essays on Combinatory Logic, Lambda Calculus and Formalism, Academic Press, 1980.
[73] 土居真之, 肥後芳樹, 有馬諒, 下仲健斗, 楠本真二 (M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto), “ソースコードの「自然さ」を利用した自動生成ファイルの特定” (Identifying auto-generated files using the naturalness of source code), 電子情報通信学会技術研究報告 (IEICE Technical Report) 117(380), 19 to 24, January 2018. https://sdl.ist.osaka-u.ac.jp/pman/pman3.cgi?D=517
[74] M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto, “On the naturalness of auto-generated code: can we identify auto-generated code automatically?” ICPC 2018. doi:10.1145/3196321.3196356
[75] F. V. Arrebola, “Modelo de sugestão de código-fonte baseado em modelos de linguagem organizados em um contexto hierárquico” (A source code suggestion model based on language models organized in a hierarchical context), doctoral thesis in electrical engineering, Fundação Educacional Inaciana Padre Sabóia de Medeiros (FEI), Brazil, 2018. Advisor R. A. C. Bianchi.
[76] G. Febres, K. Jaffé and C. Gershenson, “Complexity measurement of natural and artificial languages,” Complexity 20(6), 2015. doi:10.1002/cplx.21529
[77] M. Rahman, D. Palani and P. C. Rigby, “Natural Software Revisited,” ICSE 2019. doi:10.1109/ICSE.2019.00022
[78] A. Torres, S. Baltes, C. Treude and M. Wagner, “Applying Information Theory to Software Evolution,” NLBSE 2023. doi:10.1109/NLBSE59153.2023.00017
[79] A. Blass, N. Dershowitz and Y. Gurevich, “When are two algorithms the same?,” Bulletin of Symbolic Logic 15(2), 2009. arXiv:0811.0811. https://arxiv.org/abs/0811.0811
[80] Y. N. Moschovakis, “What is an algorithm?,” in Mathematics Unlimited: 2001 and Beyond, Springer, 2001. https://www.math.ucla.edu/~ynm/papers/eng.pdf
[81] M. Y. Vardi, “What is an algorithm?,” Communications of the ACM 55(3), 2012. doi:10.1145/2093548.2093549
[82] S. Laddad, A. Cheung, J. M. Hellerstein and M. Milano, “Flo: a Semantic Foundation for Progressive Stream Processing,” POPL 2025. arXiv:2411.08274. https://arxiv.org/abs/2411.08274
[83] The Elm Architecture, Elm guide. https://guide.elm-lang.org/architecture/
[84] Temporal, “Workflows” (event history), documentation. https://docs.temporal.io/workflows
[85] A. Pnueli, M. Siegel and E. Singerman, “Translation validation,” TACAS 1998. doi:10.1007/BFb0054170
[86] X. Yang, Y. Chen, E. Eide and J. Regehr, “Finding and understanding bugs in C compilers,” PLDI 2011. doi:10.1145/1993498.1993532
[87] C. Nandi, M. Willsey, A. Zhu et al., “Rewrite Rule Inference Using Equality Saturation,” OOPSLA 2021. arXiv:2108.10436. https://arxiv.org/abs/2108.10436
[88] C. Le Goues, T. Nguyen, S. Forrest and W. Weimer, “GenProg: A Generic Method for Automatic Software Repair,” IEEE TSE 38(1), 2012. doi:10.1109/TSE.2011.104
[89] F. Long and M. Rinard, “Automatic patch generation by learning correct code,” POPL 2016. doi:10.1145/2837614.2837617
[90] J. Bader, A. Scott, M. Pradel and S. Chandra, “Getafix: Learning to Fix Bugs Automatically,” OOPSLA 2019. arXiv:1902.06111. https://arxiv.org/abs/1902.06111
[91] K. Etemadi, N. Harrand, S. Larsen et al., “Sorald: Automatic Patch Suggestions for SonarQube Static Analysis Violations,” IEEE TDSC, 2022. arXiv:2103.12033. https://arxiv.org/abs/2103.12033
[92] Z. Qi, F. Long, S. Achour and M. Rinard, “An analysis of patch plausibility and correctness for generate-and-validate patch generation systems,” ISSTA 2015. doi:10.1145/2771783.2771791
[93] E. K. Smith, E. T. Barr, C. Le Goues and Y. Brun, “Is the cure worse than the disease? Overfitting in automated program repair,” ESEC/FSE 2015. doi:10.1145/2786805.2786825
[94] X.-B. D. Le, F. Thung, D. Lo and C. Le Goues, “Overfitting in semantics-based automated program repair,” Empirical Software Engineering 23, 2018. doi:10.1007/s10664-017-9577-2
[95] Y. Xiong, X. Liu, M. Zeng, L. Zhang and G. Huang, “Identifying patch correctness in test-based program repair,” ICSE 2018. doi:10.1145/3180155.3180182
[96] T. Durieux, F. Madeiral, M. Martinez and R. Abreu, “Empirical Review of Java Program Repair Tools: A Large-Scale Experiment on 2,141 Bugs and 23,551 Repair Attempts,” ESEC/FSE 2019. arXiv:1905.11973. https://arxiv.org/abs/1905.11973
[97] K. Liu, A. Koyuncu, T. F. Bissyandé et al., “You Cannot Fix What You Cannot Find! An Investigation of Fault Localization Bias in Benchmarking Automated Program Repair Systems,” ICST 2019. arXiv:1812.07283. https://arxiv.org/abs/1812.07283
[98] M. Monperrus, “Automatic Software Repair: A Bibliography,” ACM Computing Surveys 51(1), 2018. doi:10.1145/3105906
[99] C. S. Xia, Y. Deng, S. Dunn and L. Zhang, “Agentless: Demystifying LLM-based Software Engineering Agents,” 2024. arXiv:2407.01489. https://arxiv.org/abs/2407.01489
[100] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir and A. Narayanan, “AI Agents That Matter,” 2024. arXiv:2407.01502. https://arxiv.org/abs/2407.01502
[101] M. H. Erol, B. El, M. Suzgun, M. Yuksekgonul and J. Zou, “Cost-of-Pass: An Economic Framework for Evaluating Language Models,” 2025. arXiv:2504.13359. https://arxiv.org/abs/2504.13359
[102] D. Zan, Z. Huang, W. Liu et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving,” 2025. arXiv:2504.02605. https://arxiv.org/abs/2504.02605
[103] R. Widyasari, S. Q. Sim, C. Lok et al., “BugsInPy: a database of existing bugs in Python programs to enable controlled testing and debugging studies,” ESEC/FSE 2020. doi:10.1145/3368089.3417943
[104] M. Allamanis, “The Adverse Effects of Code Duplication in Machine Learning Models of Code,” Onward! 2019. arXiv:1812.06469. https://arxiv.org/abs/1812.06469
[105] K. N. Khan, M. Hirki, T. Niemi, J. K. Nurminen and Z. Ou, “RAPL in Action: Experiences in Using RAPL for Power Measurements,” ACM TOMPECS 3(2), 2018. doi:10.1145/3177754
[106] The Rust project, rustfix and cargo fix. https://github.com/rust-lang/rustfix
[107] R.-M. Karampatsis and C. Sutton, “How Often Do Single-Statement Bugs Occur? The ManySStuBs4J Dataset,” MSR 2020. doi:10.1145/3379597.3387491
[108] C. Richter and H. Wehrheim, “TSSB-3M: Mining single statement bugs at massive scale,” MSR 2022. doi:10.1145/3524842.3528505
[109] H. Coles, T. Laurent, C. Henard, M. Papadakis and A. Ventresque, “PIT: a practical mutation testing tool for Java,” ISSTA 2016. doi:10.1145/2931037.2948707
[110] R. Just, D. Jalali, L. Inozemtseva, M. D. Ernst, R. Holmes and G. Fraser, “Are mutants a valid substitute for real faults in software testing?” FSE 2014. doi:10.1145/2635868.2635929
[111] I. J. Good, “Speculations Concerning the First Ultraintelligent Machine,” Advances in Computers 6, 1965. doi:10.1016/S0065-2458(08)60418-0
[112] J. Schmidhuber, “Gödel Machines: Fully Self-referential Optimal Universal Self-improvers,” in Artificial General Intelligence, Springer, 2007. doi:10.1007/978-3-540-68677-4_7
[113] E. Yudkowsky, “Intelligence Explosion Microeconomics,” Technical report 2013-1, Machine Intelligence Research Institute, 2013. https://intelligence.org/files/IEM.pdf
[114] M. H. Löb, “Solution of a Problem of Leon Henkin,” Journal of Symbolic Logic 20(2), 1955. doi:10.2307/2266895
[115] E. Yudkowsky and M. Herreshoff, “Tiling Agents for Self-Modifying AI, and the Löbian Obstacle,” Machine Intelligence Research Institute, 2013. https://intelligence.org/files/TilingAgentsDraft.pdf
[116] E. Zelikman, E. Lorch, L. Mackey and A. T. Kalai, “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation,” 2023. doi:10.48550/arXiv.2310.02304
[117] J. Zhang, S. Hu, C. Lu, R. Lange and J. Clune, “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents,” 2025. doi:10.48550/arXiv.2505.22954
[118] A. Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery,” 2025. doi:10.48550/arXiv.2506.13131
[119] G. Wang, Y. Xie, Y. Jiang, A. Mandlekar, C. Xiao, Y. Zhu, L. Fan and A. Anandkumar, “Voyager: An Open-Ended Embodied Agent with Large Language Models,” 2023. doi:10.48550/arXiv.2305.16291
[120] Y. Futamura, “Partial Evaluation of Computation Process: An Approach to a Compiler-Compiler,” Higher-Order and Symbolic Computation 12(4), 1999 (first published 1971). doi:10.1023/A:1010095604496
[121] V. F. Turchin, “The Concept of a Supercompiler,” ACM Transactions on Programming Languages and Systems 8(3), 1986. doi:10.1145/5956.5957
[122] J. N. Foster, M. B. Greenwald, J. T. Moore, B. C. Pierce and A. Schmitt, “Combinators for Bidirectional Tree Transformations: A Linguistic Approach to the View-Update Problem,” ACM Transactions on Programming Languages and Systems 29(3), 2007. doi:10.1145/1232420.1232424
[123] M. Hofmann, B. Pierce and D. Wagner, “Symmetric Lenses,” POPL, 2011. doi:10.1145/1926385.1926428
[124] K. Czarnecki, J. N. Foster, Z. Hu, R. Lämmel, A. Schürr and J. F. Terwilliger, “Bidirectional Transformations: A Cross-Discipline Perspective,” ICMT, LNCS 5563, 2009. doi:10.1007/978-3-642-02408-5_19
[125] E. W. Dijkstra, “A Constructive Approach to the Problem of Program Correctness,” BIT 8(3), 1968. doi:10.1007/BF01933419
[126] A. Hall and R. Chapman, “Correctness by Construction: Developing a Commercial Secure System,” IEEE Software 19(1), 2002. doi:10.1109/52.976937
[127] Y. Minsky, “OCaml for the Masses,” Communications of the ACM 54(11), 2011. doi:10.1145/2018396.2018413
[128] D. A. Turner, “Total Functional Programming,” Journal of Universal Computer Science 10(7), 2004. doi:10.3217/jucs-010-07-0751
[129] R. Di Cosmo and S. Zacchiroli, “Software Heritage: Why and How to Preserve Software Source Code,” iPRES 2017, Kyoto. https://hal.science/hal-01590958
[130] Software Heritage, archive counters, read 13 October 2026: 30,253,266,524 file contents and 448,311,919 origins. https://archive.softwareheritage.org/api/1/stat/counters/
[131] Rosetta Code, main page, read 13 October 2026: 1,360 tasks, 421 draft tasks, 1,009 known languages. https://rosettacode.org/wiki/Rosetta_Code