El Reality Code Engine: una Forma sin pérdida para una programación nativa, verificada y de bajo consumo energético
Un sistema de programación en el que un programa se escribe una vez como una máquina de estados y cada lenguaje de destino se genera a partir de ella, con mediciones de idas y vueltas, del rechazo de entradas mal formadas y de la reparación de código elevado.
David Charlot, Open Interface Engineering
Esta es una traducción de la versión en inglés. Si hay diferencias, prevalece la versión en inglés. Original en inglés.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. El Reality Code Engine: una Forma sin pérdida para una programación nativa, verificada y de bajo consumo energético. Open Interface Engineering. Web: https://research.openie.dev/papers/rce/. PDF: https://research.openie.dev/pdfs/rce.pdf.
Versión 1.4, 13 de octubre de 2026. Especificación: borrador actual (documento del borrador 0.7, versión del lenguaje 0.8), a partir de openIE-dev/rce 2a0ec68. Cambios en 1.4: el recuento de pruebas del motor son las 589 pruebas distintas que ejecuta cargo test --release (1.3 indicaba 596, el total de make check, que cuenta dos veces 7 pruebas de demostración); la Sección 3.7 indica que la especificación 2.7 da ahora la regla de coste por punto de llamada de C.15; el proponente determinista de la Sección 5.5 se informa como 87 ofrecidas, 9 admitidas y 78 rechazadas, a partir de la prueba del motor; Software Heritage y Rosetta Code en la Sección 7 llevan las referencias [129] a [131], con los contadores del archivo releídos; se añaden nueve figuras (Figuras 5 a 10, 12, 13 y 15) y las anteriores Figuras 5 y 6 son ahora las Figuras 11 y 14. Cambios en 1.3: los costes de métodos escalados por tamaño se atribuyen a la versión 0.7 del lenguaje (en 1.2 se describían bajo 0.6), se enuncia la regla por punto de llamada para programas de versiones mixtas, y las comprobaciones se vuelven a ejecutar en el commit del motor 1eb5f02. Datos y código: research.openie.dev/data/. Playground (comprobador de referencia): openie-dev.github.io/rce. Demo del motor: /demos/rce-engine/. PDF en LaTeX: /pdfs/latex/rce.pdf (fuente).
Correcciones y estado de reproducibilidad (17 de octubre de 2026). Esta nota se añadió tras una lectura del artículo frente a los repositorios públicos. Las cifras a las que afecta se enumeran aquí y, por lo demás, el texto que sigue no cambia. Cada recuento que figura a continuación procede de src/data/rce-facts.json, generado por scripts/claim-counts.py en openIE-dev/rce en e416fd0, salvo los dos recuentos de Lean, que se tomaron en 4304048.
- Un solo lenguaje (18 de octubre de 2026).
rcemain público (4a3dc1f) tiene un solo lenguaje y un solo texto. Una línea# rce-version:es una etiqueta de publicación tolerada e ignorada que no entra en el hash, y una etiqueta de publicación nombra exactamente un commit de la especificación (C.15). Una construcción que el comprobador no implementa se rechaza como reservada y no implementada (W-RES-1, Apéndice F.12), no por versión; hay una sola lista de palabras reservadas. Por ello, la Sección 3.7 y la Figura 5, que describen compuertas de versión (versiones 0.5 a 0.9), describen borradores anteriores y ya no se aplican. Una llamada fallida restaura sus argumentos&mut(F.4.4), lo que sustituye la regla de escritura de vuelta del teorema T33. Los recuentos que siguen se tomaron ene416fd0, antes de este cambio, y no se volvieron a calcular. La demostración de T33 cambió con la regla: los teoremas retirados de escritura de vuelta en todo resultado salieron del árbol auditado (rcemain público95ead2e), y T33 demuestra ahora la restauración de F.4.4; la auditoría registra 4875 teoremas con solo los axiomas estándar. - Nombres de la biblioteca (rce-stdlib, 18 de octubre de 2026). Como la lista de palabras reservadas es global, se renombraron los nombres de la biblioteca que ahora reserva:
labelalbl,nodeand,groupagrp,childachd,budgetabud,restartarst,replicatedarepl,ctactext,sessionasess,protocolaproto,paraparl,offeraoffr,chooseachse. Los tiposJson(móduloenc) yUrl(módulonet.url) pasan a serJsonDocyUrlParts, de modo que un programa que importeenc.Jsononet.url.Urldebe usar los nombres nuevos. La longitud de texto.len()de un valortextes.len_bytes()(bytes) o.len_chars(). - Versiones y recuentos en
e416fd0. El documento de especificación es el borrador 0.9 (público desdecdae5cf). Antes del 18 de octubre, el comprobador de referencia aceptaba las versiones del lenguaje 0.5 a 0.9 y rechazaba por versión las partes de la versión 0.9 que no implementaba (Apéndice F.12). Se enuncian los teoremas T1 a T56; T42 a T56 (Apéndice F) están enunciados y sin demostrar. Hay 58 módulos de Lean y 59 programas de ejemplo (57 de nivel superior y 2 en paquetes). Las figuras y leyendas de este artículo que dicen borrador 0.7, versión del lenguaje 0.8, T1 a T34, 31 archivos o 51 ejemplos describen el repositorio en los commits anteriores que nombran, y este artículo no describe el borrador 0.9 más allá de esta nota. - Recuento de teoremas de Lean. Existen dos recuentos distintos. La fuente contiene 1,116 declaraciones
theoremylemmaene416fd0(885 en4304048). La auditoría (scripts/lean-audit.sh) cuenta cada constante de teorema en el entorno del núcleo, incluidas las constantes que genera el elaborador, y dio 4,877 en una nueva ejecución sobre el repositorio público ene416fd0, dondelake buildse completa sobre 58 archivos despec/lean/RCE/sin ningúnsorryy solo con axiomas estándar (2,949 sobre 46 archivos en4304048). El 2,192 citado más abajo es el recuento de la auditoría en el commit del motor1eb5f02sobre 31 módulos. Ninguno de los dos números dice nada sobre cuántos teoremas están demostrados acerca del evaluador de Rust. - Reproducible hoy a partir de repositorios públicos: la compilación de Lean y la auditoría de axiomas, la comprobación de la especificación (tablas gramaticales y corpus de ejemplos), el comprobador de referencia y sus pruebas, y los vectores JSON canónicos.
- Aún no reproducible a partir de repositorios públicos: la ejecución del ecosistema de 10,000 Formas (
bench/ecosystemno está en los repositorios públicos), los resultados de Kani, las 589 pruebas del motor, las tasas de reparación de la Sección 6 y cualquier cifra de Defects4J. Se informan aquí como ejecuciones propias de los autores y deben leerse así hasta que se publiquen las fuentes y las semillas. - Falsador RCE-F0. Véase la nota de la Sección 2.3 más abajo.
Resumen
Este artículo describe el Reality Code Engine (RCE), un sistema en el que un programa se escribe una vez como una máquina de estados, llamada Forma, y a partir de ella se genera código en otros lenguajes. Informa de lo que se midió en 10,000 Formas y en conjuntos de datos públicos de errores, y expone cómo podría demostrarse que sus afirmaciones son falsas.
En palabras sencillas
- Un programa se escribe una vez, en una forma precisa, y el ordenador produce a partir de ella el mismo programa en muchos lenguajes.
- Como la forma solo permite lo que se declaró, una entrada defectuosa se rechaza en la puerta en lugar de corregirse más tarde.
- Una corrección que pasa las comprobaciones se guarda y se reutiliza, de modo que el mismo problema no cuesta tiempo ni energía dos veces.
1. Tesis
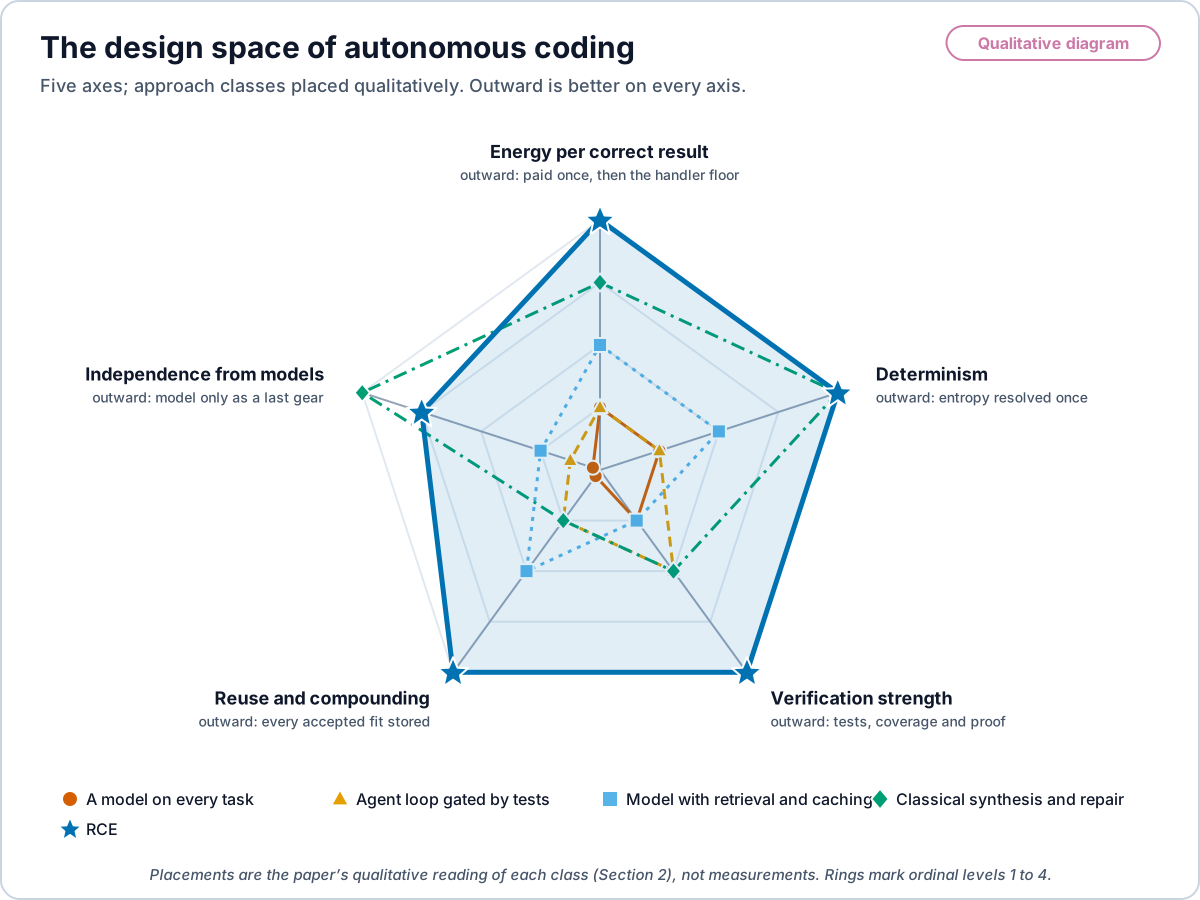
La automatización autónoma de la computación es un espacio de diseño con muchos puntos. Cada enfoque se sitúa en algún lugar a lo largo de cinco ejes continuos: la energía gastada por resultado correcto; la entropía que el sistema debe resolver en tiempo de ejecución y, con ella, cuán determinista es su salida; la solidez de la verificación que acepta un resultado; en qué medida cada resultado aceptado se reutiliza y se acumula; y cuánto depende el enfoque de un modelo. Un modelo de lenguaje grande (LLM), un modelo estadístico de texto, que escribe cada cambio a partir de la instrucción se sitúa cerca de una esquina de ese espacio: depende del modelo en cada tarea, extrae cada vez una muestra nueva de una distribución de alta entropía y vuelve a pagar la generación en cada tarea. La recuperación, las reglas, la síntesis, la verificación y la caché ocupan muchos otros puntos, y los sistemas reales los combinan.
El Reality Code Engine (RCE) es un punto del espacio, y este artículo lo describe y lo mide. RCE modela un programa como una máquina de estados funcional de base de datos. Lopes y sus colegas midieron que alrededor del 70% del código en GitHub consiste en clones de archivos anteriores [33], así que RCE intenta primero recuperar un ajuste existente, adaptarlo y comprobarlo, y llama a un modelo solo cuando nada más barato cierra la tarea.
La afirmación central. RCE es un ecosistema de código completo en el que los programas se escriben de forma nativa a partir de la intención. La intención se escribe una vez, como una Forma: un estado, un conjunto de eventos y una transición pura y total. La Forma es una codificación sin pérdida de esa intención. Cada destino (diagrama de estados, Rust, Python, XState, SCXML, WASM) es una proyección de la Forma, y cada proyección reproduce la traza de la Forma byte a byte. Un estado que la Forma no declara no puede escribirse, y una entrada fuera de su contrato se rechaza en el punto de entrada. Por tanto, un programa del ecosistema no puede desviarse de su intención como un programa en un lenguaje común se desvía de sus comentarios, de sus pruebas o de sus otras implementaciones, y no necesita comparación de diferencias ni seguimiento de errores a posteriori. Cada ajuste que pasa la compuerta se almacena y se reutiliza, así que el ecosistema crece de forma acumulativa (§2.4). El código escrito en otros lenguajes es una puerta de entrada: entra por elevación (§6).
Cada punto del espacio enfrenta la misma compuerta. La compuerta es la corrección: el predicado de completitud de una tarea, , aquí las pruebas de la tarea, una demostración o una traza de concordancia. Entre las ejecuciones que pasan la compuerta, los sistemas se clasifican por los julios hasta la finalización, . La corrección es una restricción, no una puntuación.
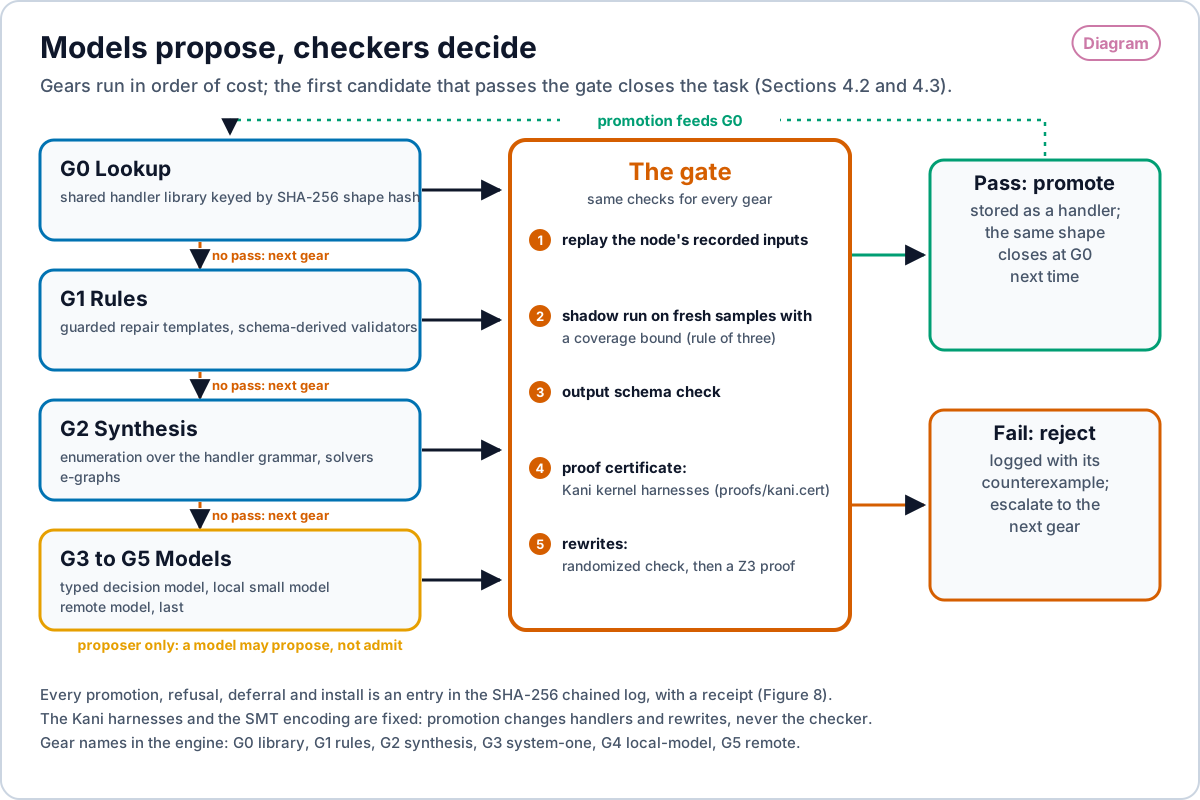
Los mecanismos de RCE, llamados engranajes, se ejecutan en orden de coste, y el primer engranaje que pasa la compuerta cierra la tarea.
Las cifras de energía se etiquetan según su fuente. est_j es una estimación analítica. reported_j es un contador del sistema operativo o del propio chip. measured_j se reserva para un medidor de pared y está vacío en todos los resultados de este artículo.
2. El espacio de diseño de la programación autónoma
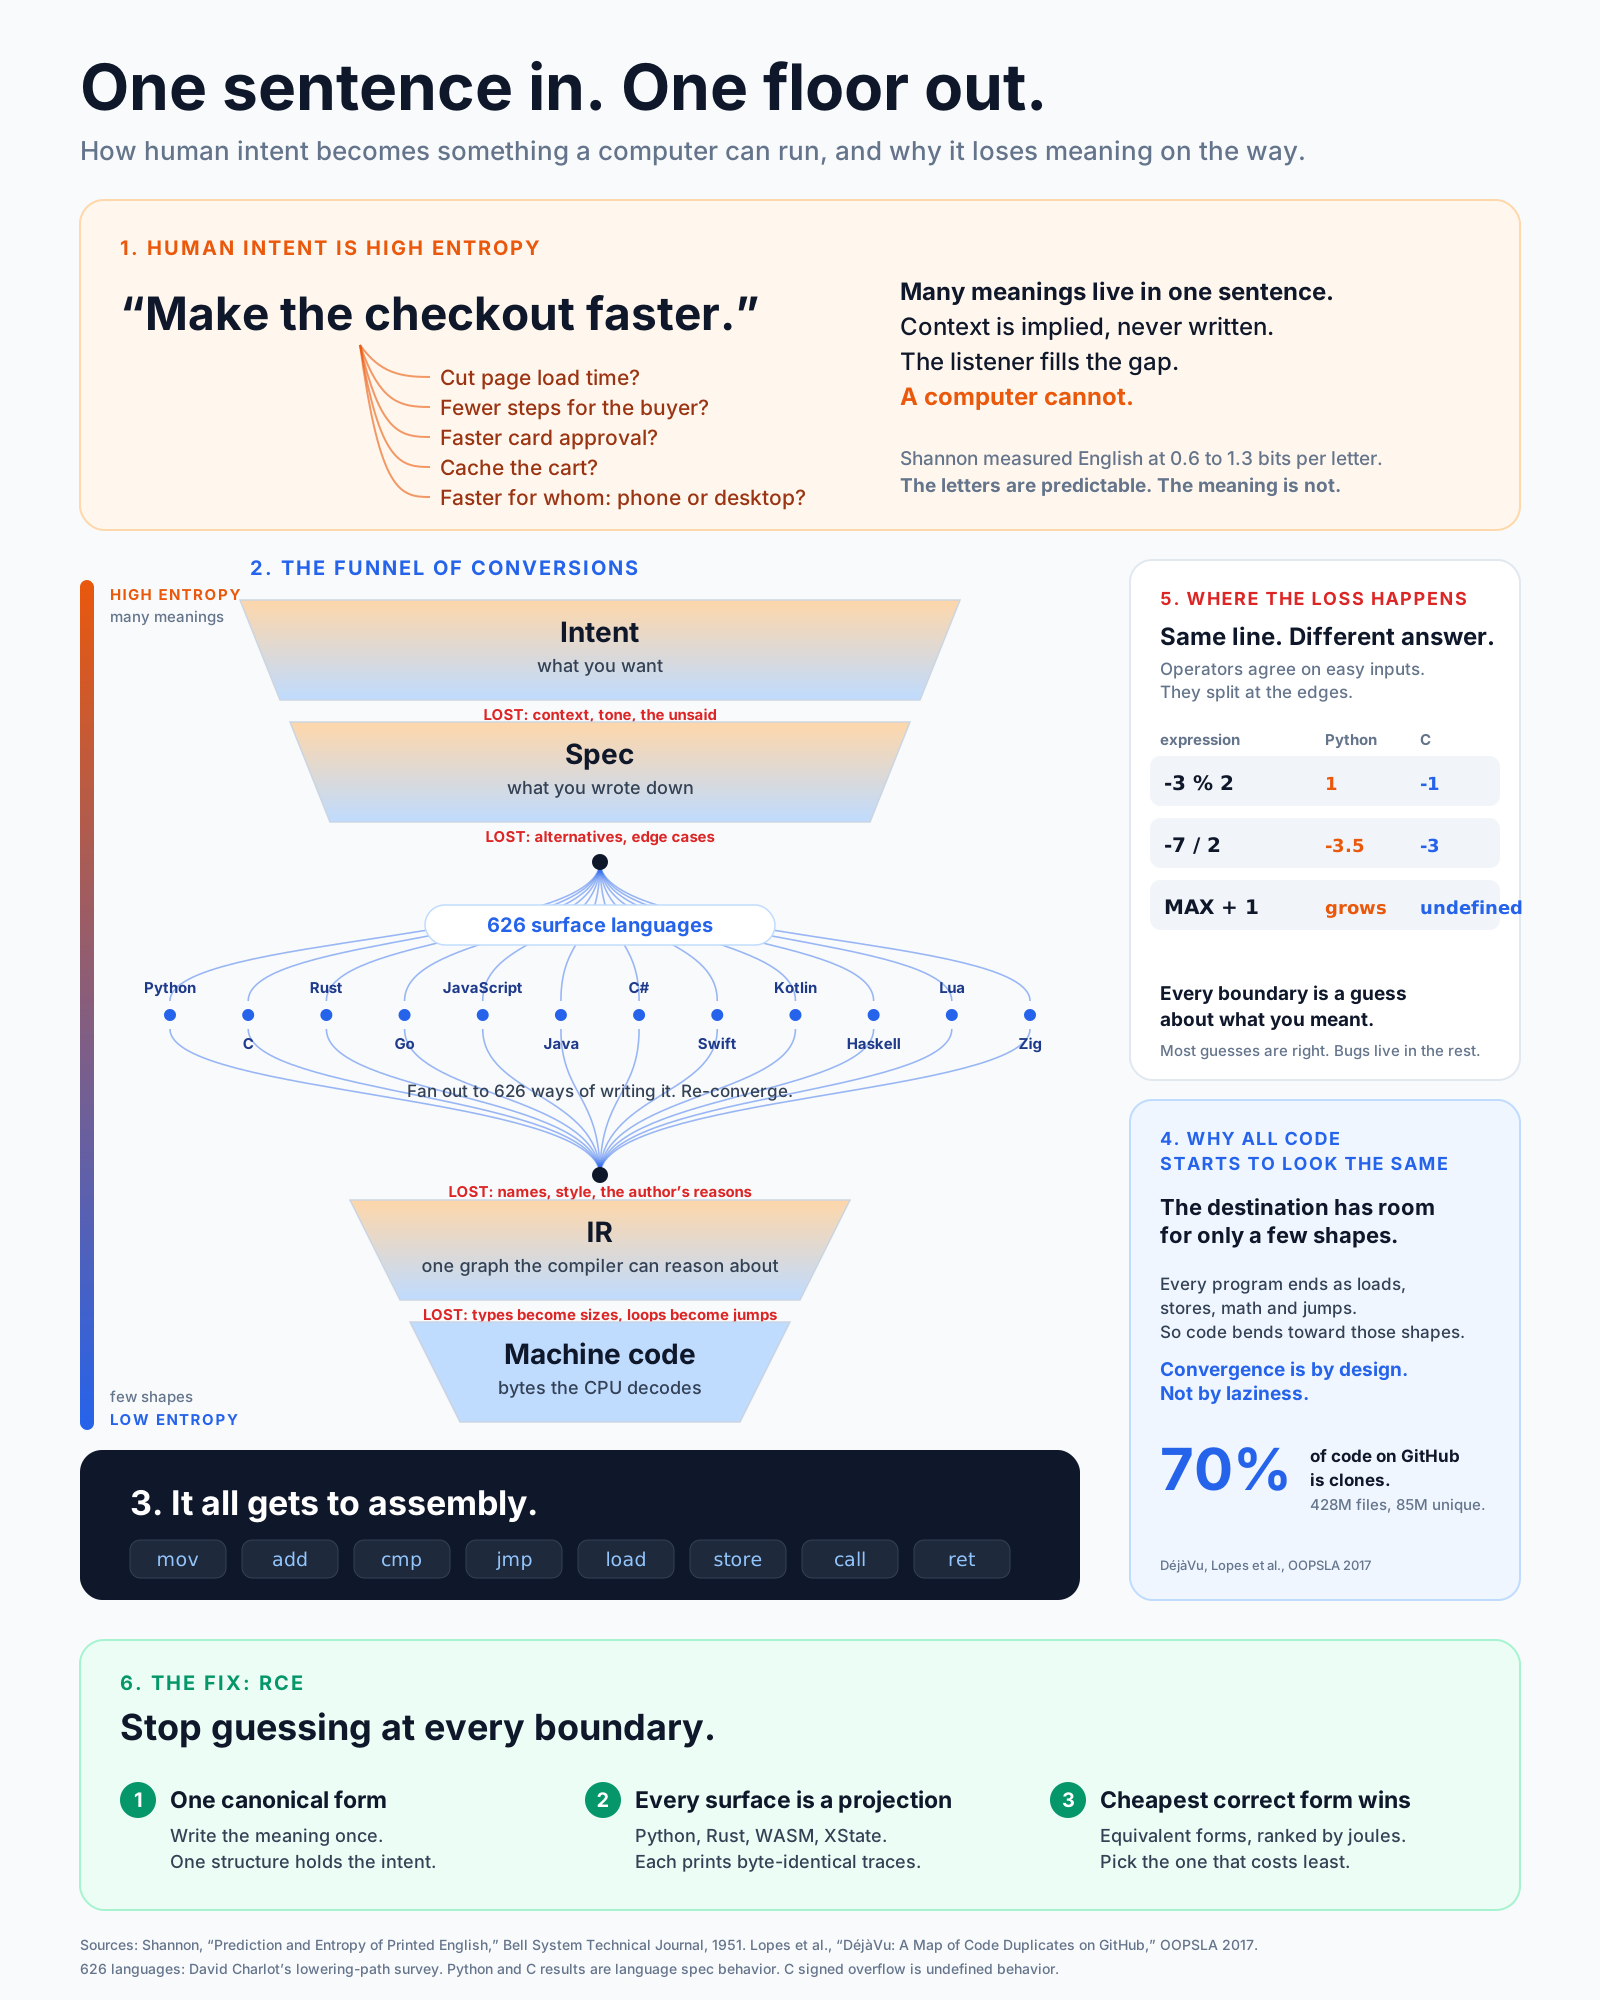
La intención es de alta entropía. “Haz que el pago sea más rápido” tiene muchos significados: carga de página más corta, menos pasos, aprobación de tarjeta más rápida, un carrito en caché o más rapidez en una sola clase de dispositivo. El contexto está implícito y nunca se escribe. Shannon midió el inglés impreso en unos 0.6 a 1.3 bits por letra [1]. Las letras son predecibles. El significado no.
Cada conversión pierde información. La intención se convierte en una especificación, y se pierde el contexto. La especificación se convierte en uno de cientos de lenguajes de superficie, y se pierden alternativas y casos límite. El código fuente se convierte en una representación intermedia (IR), y se pierden nombres, estilo y las razones del autor. La IR se convierte en código máquina, y los tipos se vuelven tamaños y los bucles se vuelven saltos.
El piso es de baja entropía. Todo programa termina como cargas, almacenamientos, aritmética y saltos. El destino solo admite unas pocas formas, así que el código se curva hacia ellas. La convergencia es por diseño.
Las fronteras son donde el significado diverge. La misma línea da respuestas distintas en los bordes. En Python, -3 % 2 es 1 y -7 / 2 es -3.5. En C, -3 % 2 es -1, -7 / 2 es -3 y el desbordamiento con signo es indefinido. Un sistema que regenera código en cada frontera adivina en cada frontera.
Los ejes, expresados como cantidades.
| Eje | Un extremo | El otro extremo | Dónde se sitúa RCE |
|---|---|---|---|
| Energía por resultado correcto | Se paga de nuevo por completo en cada tarea | Se paga una vez por caso nuevo; después, el piso del manejador | En el piso en las tareas cubiertas |
| Entropía resuelta en ejecución, y determinismo | La distribución completa de la instrucción, una muestra nueva cada vez | Solo el residuo que ningún ajuste almacenado cubre, una salida determinista | Solo el residuo; cada proyección es determinista |
| Solidez de la verificación | La salida se acepta tras inspeccionarla | Pruebas, cobertura y un certificado de prueba formal | La compuerta completa en cada resultado |
| Reutilización y acumulación | Cada resultado se usa una vez | Cada ajuste aceptado se almacena y se reutiliza | Se almacena cada ajuste que pasa la compuerta |
| Dependencia del modelo | Un modelo en cada tarea | Ningún modelo | Un modelo solo como último engranaje |
Los enfoques difieren en grado en cada eje, y los ejes interactúan: la reutilización reduce la energía y la entropía que queda por resolver, y una verificación sólida es lo que hace segura la reutilización. RCE escribe el significado una vez, en una Forma canónica. Cada lenguaje de superficie es una proyección de esa Forma, verificada para coincidir con ella. Entre formas equivalentes, se ejecuta la correcta más barata.
La Figura 2 dibuja los cinco ejes y sitúa en ellos las principales clases de enfoque.
2.1 Programar es teoría de la codificación
La tesis de esta sección es que la programación puede leerse como teoría de la codificación. Un programador convierte la intención a lo largo de un gradiente entre dos regímenes entrópicos. La intención es de alta entropía, una distribución sobre significados. El código es de baja entropía, una transición determinista por estado. Cada paso del trabajo de software, de un requisito a un registro, es un paso de esa conversión. La literatura lo ha dicho por partes durante setenta años, en muchas lenguas. Esta sección reúne las partes en un solo argumento y sitúa en él cada engranaje de RCE.
La medida. Shannon definió la entropía de una fuente y la capacidad de un canal [40], y midió el inglés impreso en unos 0.6 a 1.3 bits por letra [1]. Kolmogórov, escribiendo en ruso en Problemy Peredachi Informatsii en 1965, dio tres enfoques de la cantidad de información e hizo primario el algorítmico: la información de un objeto es la longitud del programa más corto que lo produce [41]. Solomonoff había llegado al mismo objeto como teoría de la inferencia inductiva [42], y Chaitin mostró que el tamaño de los programas obedece identidades formalmente idénticas a las de Shannon [43]. Rissanen convirtió la idea en una regla para elegir modelos, la longitud mínima de descripción [44]. Juntos dicen que un programa es una palabra de código: una descripción de un comportamiento, y la más corta correcta es el piso. La regla de extracción de RCE, conservar el ajuste de menos julios entre ajustes equivalentes (Proposición 3), es esa regla con julios en lugar de bits.
El código está en el régimen de baja entropía, y se ha medido. Hindle, Barr, Su, Gabel y Devanbu encontraron que el código es “muy repetitivo, y de hecho aún más que los lenguajes naturales”, con menor entropía cruzada bajo los mismos modelos de n-gramas [35]. Gabel y Su encontraron que la mayoría de las líneas de un proyecto ya existen en otro lugar [34], y Lopes et al. que la mayoría de los archivos de GitHub son clones [33]. Tu, Su y Devanbu encontraron que el código también es local: lo escrito cerca predice lo que viene [46]. Ray y sus colegas encontraron que las líneas con errores son menos naturales, con mayor entropía, y que la entropía baja cuando se corrige el error [45]. En 2025, Yang, Kolak, Hellendoorn y Martins usaron el cambio de entropía que induce un parche para ordenar candidatos de reparación y separar los parches correctos de los sobreajustados [51]. Allamanis, Barr, Devanbu y Sutton revisaron el campo bajo el nombre de naturalidad [47]. El resultado no es solo anglófono. Prem Devanbu lo expuso en una conferencia magistral en la India Software Engineering Conference de 2013 [50]. Sridhara, Sinha y Mani, de IBM Research India, midieron en el mismo foro los artefactos en lenguaje natural que rodean al código y encontraron que los mensajes de commit son los más regulares y que la prosa de Stack Overflow se comporta como el inglés común [49]. En China, el Journal of Software (软件学报) publicó en 2022 una revisión de la investigación sobre la naturalidad del código, que expone la medida de entropía cruzada y el hallazgo de que el código defectuoso tiene mayor entropía [48]. En Japón, Doi, Higo, Arima, Shimonaka y Kusumoto, de la Universidad de Osaka, usaron la naturalidad de n-gramas, primero en un informe técnico del IEICE en japonés y luego en ICPC 2018, para distinguir archivos fuente generados por máquina de los escritos por personas [73, 74]. El código generado está aún más abajo en la escala de entropía que el humano, porque un generador es una conversión fija. En Brasil, la tesis doctoral de Arrebola construyó sugerencia de código sobre modelos de n-gramas y de tópicos segmentados por proyecto y mantenedor, y la evaluó con entropía cruzada, los bits necesarios para codificar el siguiente token [75]. Los dos regímenes son visibles en un mismo repositorio: la prosa en torno al código es de alta entropía, y el código es de baja.
La medida importa. Febres, Jaffé y Gershenson, desde Venezuela y México, compararon inglés, español y texto de programas por diversidad de vocabulario según la longitud del mensaje y encontraron más diverso el texto de programas [76]. Rahman, Palani y Rigby encontraron que gran parte de la predictibilidad de n-gramas del código proviene de los tokens sintácticos, y que el código sigue siendo repetitivo, menos de lo informado al principio, cuando se eliminan, con el uso de API como la parte más repetitiva [77]. Ambos resultados afinan la afirmación en lugar de invertirla. La diversidad de símbolos no es predictibilidad, y el régimen de baja entropía es una propiedad de la distribución condicional del siguiente paso, que es lo que fija una transición determinista. Por esa razón el G0 de RCE indexa formas, no tokens de superficie.
La intención está en el régimen de alta entropía. Zave y Jackson mostraron que un requisito es un enunciado sobre el entorno, una especificación es un enunciado en la interfaz, y la brecha entre ambos solo la llena un conocimiento del dominio que a menudo no está escrito [64]. Brooks dividió la dificultad del software en esencia y accidente: la esencia es la construcción conceptual, y la mayor parte es especificación y diseño, no representación [61]. Naur argumentó que un programa es la parte visible de una teoría que sostienen sus programadores, y que la teoría no es plenamente recuperable a partir del texto [62]. Leídos a través de Shannon, los tres dicen lo mismo. La intención lleva más incertidumbre que cualquier programa, y escribir el programa es el acto que la elimina. Lo que queda en la cabeza de un programador después de escribir el código es la parte de la intención que el código no codificó.
La conversión es un refinamiento, y el refinamiento es un estrechamiento. Hoare dio a los programas una lógica en la que un programa es correcto respecto de una precondición y una postcondición [54]. Wirth enseñó el refinamiento paso a paso: descomponer una tarea en instrucciones mediante decisiones sucesivas, cada una de las cuales fija una elección que la especificación dejó abierta [53]. Los comandos guardados de Dijkstra hicieron explícitas las elecciones abiertas como no determinismo, y derivaron programas a partir de especificaciones eliminándolo [52]. En Múnich, el proyecto CIP de Bauer y Wössner construyó el desarrollo de programas como una secuencia de transformaciones que preservan la corrección, de la especificación al programa [58]. En Francia, el método B de Abrial y después Event-B llevaron el refinamiento a escala industrial, con obligaciones de prueba en cada paso [55, 56]. En Finlandia, Back y von Wright dieron al refinamiento su cálculo reticular [57]. En cada caso, una especificación denota un conjunto de comportamientos aceptables y cada paso de refinamiento reduce el conjunto, hasta que queda un comportamiento determinista. Eso es reducción de entropía con una demostración en cada paso. La Forma de RCE es el último eslabón de esa cadena: una transición total y determinista sobre estados de base de datos, con toda elección resuelta (§3.2).
La síntesis es una búsqueda que estrecha un espacio de hipótesis. FlashFill de Gulwani aprende un programa de cadenas a partir de unos pocos ejemplos de entrada y salida representando el conjunto de todos los programas consistentes e intersecándolo con cada nuevo ejemplo [59]. Gulwani, Polozov y Singh plantean la síntesis de programas en general como búsqueda en un espacio de programas restringido por la intención [60], y el bocetado de Solar-Lezama rellena huecos de un programa parcial con un solucionador [27]. Cada ejemplo o restricción es una medición que elimina hipótesis. La medida de Shannon cuenta cuántas mediciones de ese tipo se necesitan. El G2 de RCE es ese engranaje.
Lo que produce la conversión tiene una sola forma. Gurevich demostró que todo algoritmo secuencial queda capturado por una Máquina de Estados Abstracta en su propio nivel de abstracción [2]. Codd hizo del estado una relación [5], y el event sourcing hace del estado el plegado de un registro de solo anexado [14]. Bajo Curry y Howard, una demostración es un programa y una proposición es un tipo [18, 72], así que un ajuste verificado es una demostración de su especificación. Estas son las razones por las que el régimen de baja entropía tiene pocas formas: el destino es una máquina de estados sobre una base de datos, sea cual sea el lenguaje de superficie.
La baja entropía decae sin compuerta. Lehman observó durante décadas de grandes sistemas que un programa en uso debe seguir cambiando, y que su complejidad crece a menos que se trabaje para reducirla [63]. Torres, Baltes, Treude y Wagner midieron la entropía estructural y textual a lo largo de los historiales de commits de 25 proyectos y encontraron que ambas crecen juntas [78]. La entropía vuelve al código desde el entorno. Un sistema que mantiene el código en el régimen de baja entropía necesita una compuerta en cada cambio, y la compuerta de RCE es la corrección (§4.3).
Los compiladores ya hacen codificación de fuente. Franz y Kistler distribuyeron programas como árboles de sintaxis abstracta comprimidos y generaron código nativo al cargarlos, lo cual es codificación de fuente de un programa sobre su propia gramática [67]. Fraser infirió modelos estadísticos del código a partir de un corpus para comprimirlo [68]. Futamura mostró en 1971, en la revista japonesa Systems, Computers, Controls, que especializar un intérprete para un programa produce un programa compilado, y que especializar el especializador produce un compilador [70]. Yershov, en Novosibirsk, desarrolló la misma idea como computación mixta [71]. La interpretación abstracta de los Cousot calcula una descripción sólida y de menor información de cada comportamiento de un programa [69]. La analogía con la codificación de canal es una lectura de este artículo, no un teorema citado: tipos, pruebas y demostraciones añaden redundancia verificada para que un programa erróneo se detecte antes de ejecutarse, como una comprobación de paridad detecta una palabra corrupta.
El borrado es adonde van los julios. Landauer mostró que un paso lógicamente irreversible, el borrado de un bit, disipa al menos [65]. Bennett mostró que la computación puede, en principio, hacerse lógicamente reversible, de modo que es el borrado, y no la computación, lo que lleva la cota [66]. Convertir una intención de alta entropía en un programa de baja entropía descarta toda alternativa que la intención permitía. Ese descarte es un borrado de información sobre las alternativas, y tiene un piso termodinámico. RCE paga el descarte una vez por caso nuevo y almacena el resultado, de modo que un caso repetido no borra nada nuevo.
2.2 Cómo convierte RCE, y dónde se sitúa cada engranaje
Leída como teoría de la codificación, una tarea llega como un mensaje cuya incertidumbre restante es lo que ningún ajuste almacenado resuelve ya. Cada engranaje elimina incertidumbre a un precio distinto, y los engranajes se ordenan por ese precio (§4.2).
| Engranaje | Qué hace con la incertidumbre | Linaje en el argumento anterior |
|---|---|---|
| G0 Búsqueda | Reconoce que la intención ya estaba codificada; la resuelve por recuperación, al piso del manejador | Repetitividad y clones [33, 34, 35]; localidad [46] |
| G1 Reglas | Aplica una reescritura guardada conocida; resuelve un residuo recurrente sin búsqueda | Transformación que preserva la corrección [52, 58]; refinamiento con obligaciones de prueba [55, 56] |
| G2 Síntesis | Busca en un espacio de hipótesis y lo estrecha con ejemplos, restricciones y un solucionador | Síntesis de programas como búsqueda [27, 59, 60] |
| G3 a G5 Modelos | Muestrea de una distribución aprendida sobre código cuando ningún engranaje inferior cierra la brecha; solo como proponente | Modelos de entropía cruzada del código [35, 47] |
| Compuerta | Acepta un candidato solo con pruebas, cobertura y un certificado de demostración | Lógica de Hoare [54]; Curry-Howard [18, 72] |
| Promoción | Almacena el ajuste aceptado, de modo que el mismo residuo cueste G0 la próxima vez | Longitud mínima de descripción [44]; borrado de Landauer pagado una vez [65] |
Las posiciones en los ejes de la Sección 2 difieren en dónde se paga la conversión. Un enfoque que muestrea la distribución completa de la instrucción en cada tarea paga el lado de alta entropía cada vez. Un enfoque que almacena y reutiliza los ajustes aceptados paga solo por el residuo, y solo una vez. La mayoría de los sistemas se sitúan entre esos extremos, y RCE se sitúa en el extremo de la reutilización.
2.3 El ecosistema con N grande
La afirmación de la §1 se mide directamente. El banco de pruebas se preregistró antes de la ejecución (bench/ecosystem/PREREG.json). Un generador con semilla escribe 10,000 Formas, cada una con una fuente, una regla cuyo cuerpo es un término aritmético aleatorio de profundidad hasta 3 sobre ocho operadores, y un sumidero. El motor está congelado en el commit a079967 y no se llama a ningún modelo.
| Propiedad | Qué se comprueba por Forma | N | Se cumple | Llamadas a modelos |
|---|---|---|---|---|
| Codificación sin pérdida | Form IR a JSON canónico a Form IR a JSON canónico es la identidad | 10,000 | 10,000 | 0 |
| Proyección determinista | Dos compilaciones dan los mismos bytes; las proyecciones XState y SCXML de la Forma original y de la Forma tras la ida y vuelta son idénticas byte a byte | 10,000 | 10,000 | 0 |
| Proyección fiel, Python | El módulo Python emitido imprime la traza de referencia byte a byte sobre 40 eventos con semilla | 10,000 | 9,999 | 0 |
| Compuerta en la entrada, entradas | Cinco tipos de carga mal formada (tipo erróneo, null, campo ausente, vacío, anidado) rechazados todos, sin ningún resultado aceptado | 10,000 | 10,000 | 0 |
| Compuerta en la entrada, especificaciones | Una especificación con un flujo hacia un nodo no declarado se rechaza antes de compilar | 10,000 | 10,000 | 0 |
La Figura 3 muestra los mismos recuentos.
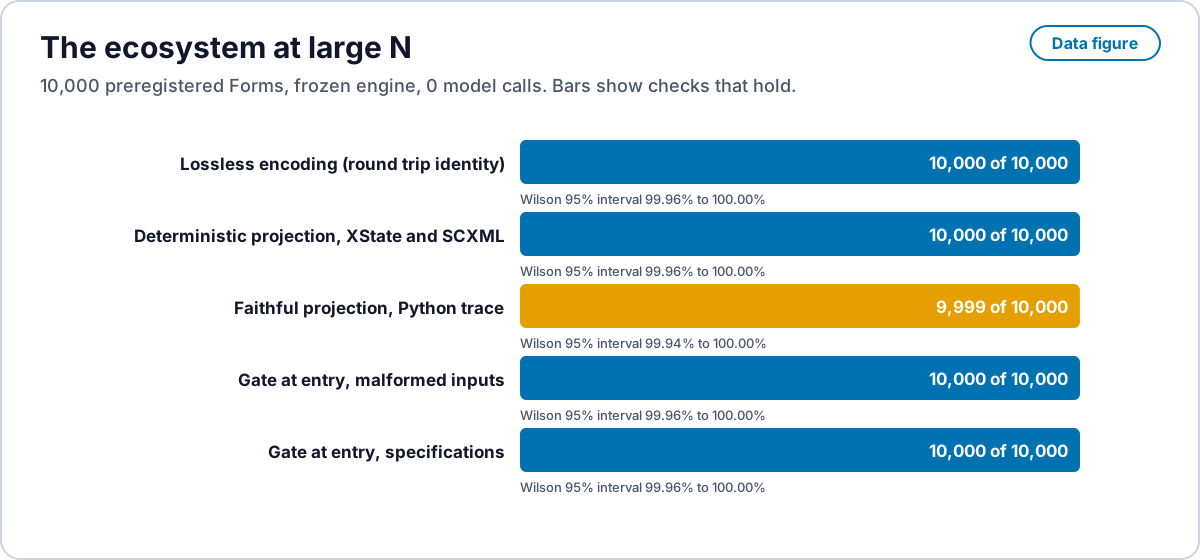
a079967, 0 llamadas a modelos, con intervalos de Wilson del 95% calculados a partir de los recuentos. Fuente: bench/ecosystem. Se ofrece una copia PNG. Open full size · PNG
RCE-F0 y el fallo de Python. La Sección 9 enuncia RCE-F0 así: en una ejecución preregistrada de al menos 10,000 Formas, alguna proyección imprime una traza que difiere de la traza de referencia de la Forma, o se acepta alguna entrada mal formada. Esta ejecución está preregistrada, tiene 10,000 Formas, y un módulo de Python emitido no imprimió la traza de referencia, así que la observación, tal como está escrita, cumple la condición de RCE-F0. El artículo informa del fallo y de la prueba de regresión que sigue, y no da una causa raíz. Léase el texto de RCE-F0 tal como está enunciado: la afirmación que refuta es que las proyecciones son fieles, y la proyección de Python de esta ejecución no cumplió esa afirmación en una Forma. Si el fallo procede del emisor o del arnés queda abierto aquí. El hecho de que la misma Forma se reproduzca de forma idéntica bajo 32 semillas de hash no lo resuelve.
El único fallo de Python se cuenta como fallo; la misma Forma y los mismos eventos se reproducen de forma idéntica bajo 32 semillas de hash en la prueba de regresión tests/form_ecosystem_regress.rs. La energía aquí es solo est_j; toda la ejecución tomó 393 s de tiempo de CPU en un núcleo. Las Formas generadas son pequeñas, así que esta tabla mide la codificación, las proyecciones y la compuerta. Las Formas elevadas a partir de programas reales se miden con el protocolo de la §8.7.
2.4 Automejora recursiva con compuerta y verificada
Good (1965) [111] definió la máquina ultrainteligente como una capaz de diseñar máquinas mejores, de modo que la mejora se volvería recursiva. Yudkowsky (2013) [113] planteó la cuestión como una de rendimientos: si cada unidad de mejora abarata o encarece la siguiente. La máquina de Gödel de Schmidhuber (2007) [112] dio una respuesta formal con garantía: un programa reescribe cualquier parte de sí mismo, incluida su propia búsqueda, solo después de demostrar que la reescritura mejora su utilidad esperada. El teorema de Löb (1955) [114] es el obstáculo que encuentra un demostrador que confía en sí mismo, al que Yudkowsky y Herreshoff (2013) [115] llamaron el obstáculo de Löb: un sistema no puede, en general, demostrar la solidez de un sucesor que usa su propio sistema de demostración. Los sistemas recientes abandonan el requisito de demostración y seleccionan por puntuación medida: STOP (Zelikman et al., 2023) [116] mejora el andamiaje que mejora el código, la Darwin Gödel Machine (Zhang et al., 2025) [117] mantiene un archivo de agentes de programación automodificados elegidos por su puntuación en un banco de pruebas, AlphaEvolve (Novikov et al., 2025) [118] hace evolucionar programas bajo evaluadores automáticos, y Voyager (Wang et al., 2023) [119] hace crecer una biblioteca de habilidades verificadas que las tareas posteriores reutilizan.
RCE toma la estructura de la máquina de Gödel y la biblioteca de Voyager, con dos diferencias que evitan el obstáculo para los objetos que promueve. Primera, el objeto que mejora no es el demostrador. RCE promueve manejadores, reescrituras y engranajes, y cada uno se comprueba frente a un núcleo fijo y certificado por separado: los arneses de Kani y la codificación SMT nunca cambian a través de la promoción, así que ningún paso necesita confiar en el sistema de demostración de un sucesor. Segunda, la compuerta es una demostración de corrección en la frontera, no una puntuación. Una puntuación puede subir mientras se rompe un supuesto de interfaz; una demostración en la frontera no puede superarla un cambio que la rompe.
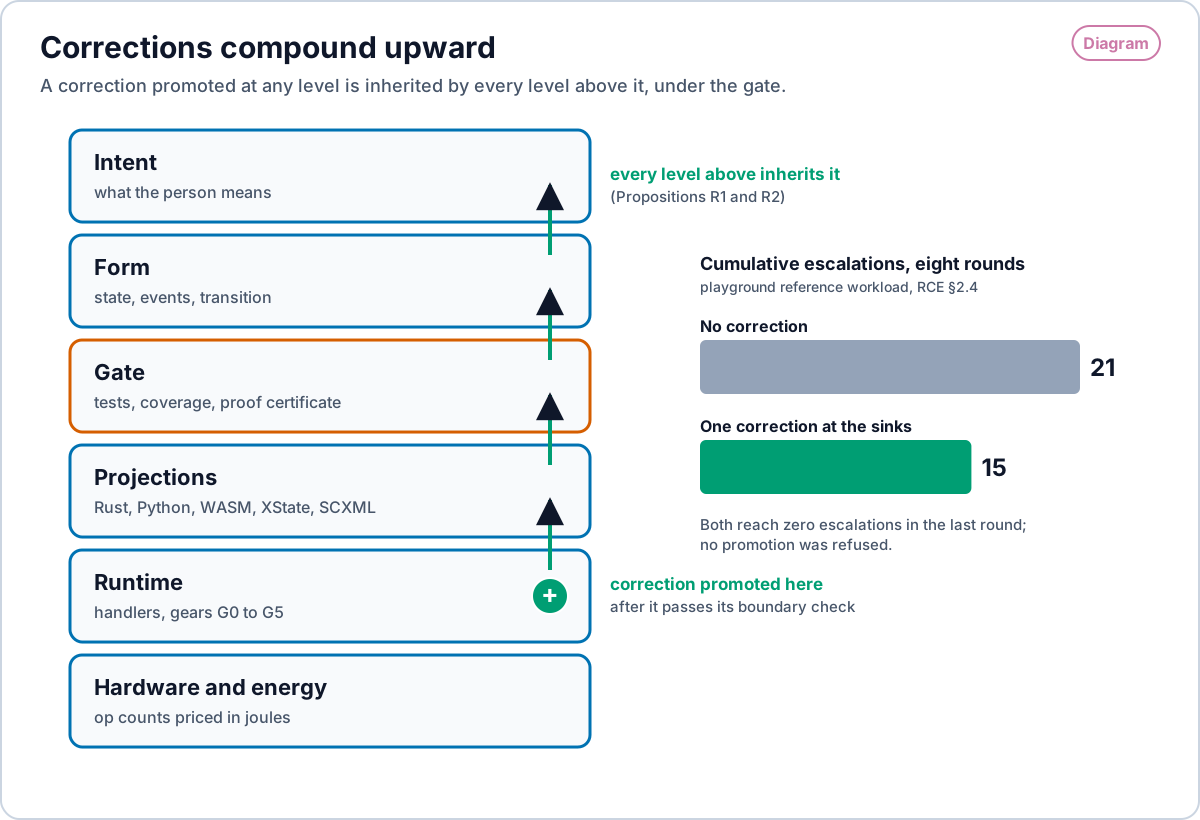
Proposición R1 (corrección monótona). Si cada cambio promovido pasa la comprobación de su frontera, y las comprobaciones de las demás fronteras no cambian, entonces toda propiedad establecida por esas comprobaciones antes de la promoción sigue valiendo después de ella.
Proposición R2 (acumulación). Sea una carga de trabajo un multiconjunto de tareas y sea un manejador promovido que cierra toda tarea de su forma. Entonces el número de escaladas en la ronda t es no creciente en t, y una corrección promovida antes de la ronda 1 reduce las escaladas acumuladas de todo horizonte en las escaladas que cierra en cada ronda posterior. En la carga de trabajo de referencia de la demo del motor, las escaladas acumuladas a lo largo de ocho rondas bajan de 21 a 15 con una corrección en los sumideros, y llegan a cero en la última ronda en ambos casos, con cada tarea cerrada correctamente y ninguna promoción rechazada.
La Figura 4 dibuja el mecanismo de las Proposiciones R1 y R2 con los totales de la carga de trabajo de referencia.
Proposición R3 (coste decreciente). Como un manejador promovido se ejecuta en lugar de una llamada a un modelo, y su coste es el número de operaciones del manejador valorado con la tabla del sustrato, la energía de una ronda desciende hacia la energía de los manejadores solos a medida que las escaladas descienden hacia cero.
Las proyecciones de Futamura (1971, republicadas en 1999) [120] y la supercompilación de Turchin (1986) [121] dan el límite de este proceso. Especializar un intérprete a un programa produce un programa compilado; especializar el especializador produce un compilador. Las promociones de RCE especializan la vía general de escalada a las formas que realmente ocurren, de modo que el motor converge hacia el programa residual de su carga de trabajo: la parte del cómputo que un modelo o una persona aún debe aportar. La automejora recursiva bajo una compuerta es esa convergencia, hecha con pasos comprobados. La capa Compounding de la demo del motor de RCE ejecuta esta carga de trabajo en el navegador.
3. La Forma
3.1 El enunciado formal más fuerte de “la misma forma”
Primero se establece el alcance del teorema. Los postulados secuenciales de Gurevich cubren los algoritmos secuenciales; los algoritmos paralelos e interactivos requieren los postulados adicionales de Blass y Gurevich [3]. Blass, Dershowitz y Gurevich sostienen que ninguna relación de equivalencia única entre algoritmos sirve para todos los fines [79], y Moschovakis y Vardi exponen el debate sobre qué es un algoritmo [80, 81]. Un manejador web que hace entrada y salida queda fuera del teorema secuencial. La Forma trata la interacción como lo hace la línea interactiva: cada entrada es un evento en , y la máquina de estados avanza con él. Así, “una Forma” es una elección de modelado fundada en el teorema secuencial y extendida por convención, con precedentes en producción en la arquitectura Elm [83], los historiales de eventos de flujos de trabajo duraderos [84] y semánticas de flujos como Flo [82]. Las proposiciones de la Sección 3.4 se enuncian para esa elección.
El teorema de la Máquina de Estados Abstracta (ASM) de Gurevich es el enunciado formal más fuerte de que todo algoritmo tiene una sola forma [2]. Una máquina de estados abstracta es una máquina cuyos estados son estructuras de primer orden y cuyo paso es un conjunto finito de actualizaciones guardadas. Gurevich enuncia tres postulados. Tiempo secuencial: un algoritmo tiene estados, estados iniciales y una aplicación de un paso . Estado abstracto: los estados son estructuras de primer orden sobre un vocabulario fijo, cerradas bajo isomorfismo. Exploración acotada: un conjunto finito de términos decide cada paso. Su Teorema Principal (Teorema 6.13) dice: “Para todo algoritmo secuencial A existe una máquina de estados abstracta secuencial B equivalente”. Blass y Gurevich lo extienden a algoritmos paralelos [3]. Dershowitz y Gurevich añaden un cuarto axioma, que las operaciones iniciales son computables, y de él derivan la tesis de Church [4].
3.2 Definiciones
Definición 1 (la Forma). Un programa es una tupla
- , el espacio de estados: estructuras sobre un vocabulario fijo , dividido en regiones de control y datos . contiene el reloj lógico, el contador de entradas y las relaciones tipadas (en el lenguaje, también las regiones declaradas). Cada estado es una instancia de base de datos en el sentido de Codd [5].
- , el alfabeto de eventos, incluido el tic del reloj lógico.
- , la transición: total, determinista y pura, escrita como un conjunto finito de actualizaciones guardadas “si entonces ”, donde cada paso lee un conjunto acotado de posiciones. Devuelve el estado siguiente y las salidas del paso. Se escribe para su componente de estado.
- , el registro duradero: una secuencia de entradas , donde es el SHA-256 del JSON canónico del estado tras el paso, es el SHA-256 del JSON canónico de los cuatro primeros campos, y el primer son 64 ceros. El registro es una cadena de hashes, así que cambiar cualquier entrada pasada cambia todos los posteriores.
- , la aplicación de salida. Una máquina de Mealy lee ambos argumentos [6]; una máquina de Moore lee solo el estado [7].
Definición 2 (Forma y ajuste). La forma es la estructura de la tupla con cuatro invariantes: es determinista y pura; la exploración es acotada; el vocabulario es fijo; el estado es el plegado del registro,
Un registro puede llevar también el resultado, las salidas y el estado de cada entrada. Son derivados: no entran en el hash, y deben ser iguales a la reproducción (T1 y T3 de la §3.7). Hay dos clases distintas de rechazo. En el perfil del motor se aplica cada evento, y una entrada que no cumple su contrato produce una salida reject y una fila de error. En el lenguaje, un evento rechazado deja el estado sin cambios (T8) y se registra como rechazado.
El ajuste son los datos que rellenan la forma: el vocabulario , los alfabetos y , el programa de reglas que define , las reglas de salida que definen y los datos iniciales . En términos de Gurevich, el ajuste es el vocabulario, el programa ASM y las estructuras iniciales. En términos de Codd, es el esquema y la instancia. En términos de líneas de producto, un ajuste es una selección de características [8]. En términos de síntesis guiada por sintaxis (SyGuS), un ajuste es un término de una gramática que cumple una especificación [9].
Definición 3 (equivalencia de ajustes). Dos ajustes son equivalentes cuando, para toda secuencia de eventos , sus secuencias de salida bajo son iguales.
Definición 4 (lenguaje de ajustes). Una gramática cuyos términos denotan ajustes. Los lenguajes de programación, los documentos SCXML, las configuraciones de XState y las especificaciones .rce son lenguajes de ajustes. Un lenguaje de ajustes es completo cuando todo programa ASM sobre tiene un término en él.
Definición 5 (proyección de control). Se divide en símbolos de control finitos y relaciones de datos. El diagrama de estados de es la proyección de sobre : los estados son valores de , las transiciones llevan un evento y una guarda sobre , y las acciones son actualizaciones de . Los statecharts de Harel aportan la jerarquía y las regiones ortogonales [10].
Definición 6 (e-grafo de ajustes). Para un ajuste y un conjunto de reescrituras sólidas, el e-grafo de ajustes es el e-grafo saturado de los términos de reglas de bajo [11, 12]. Cada e-clase contiene ajustes equivalentes según la Definición 3.
Definición 7 (coste en julios). es la energía estimada (est_j) para ejecutar el término una vez sobre un sustrato nombrado, ponderada por el número esperado de ejecuciones.
3.3 Por qué “máquina de estados funcional de base de datos”
Una estructura relacional finita es una instancia de base de datos, así que un estado de Gurevich es una base de datos y cada paso es una transacción acotada. Base de datos: es una estructura relacional. Funcional: y son puras. Máquina de estados: las ejecuciones son plegados de sobre eventos. Moseley y Marks trazan la misma línea en arquitectura [13]. El event sourcing la traza en el estado de la aplicación: “Capturar todos los cambios del estado de una aplicación como una secuencia de eventos” [14]. Dedalus la traza en lógica, donde el estado mutable es una relación indexada por el tiempo [15].
3.4 Proposiciones
Proposición 1 (la Forma captura todo algoritmo secuencial). Para todo algoritmo secuencial existe una instancia de la Forma cuyas ejecuciones son las ejecuciones de .
Esbozo de demostración. El Teorema 6.13 da una ASM con los estados, estados iniciales y aplicación de un paso de . Sean , , y la identidad. El plegado tras tics es . Por el Corolario 3.3 de Gurevich, y tienen las mismas ejecuciones. ∎
Proposición 1b (programas interactivos). Se extiende con un símbolo de entrada nulario que se fija a antes de cada paso; entonces es un algoritmo secuencial sobre el vocabulario extendido, y se aplica la Proposición 1. La construcción es nuestra.
Proposición 1c (computabilidad). Bajo el axioma de Dershowitz y Gurevich, toda instancia de la Forma computa una función Turing-computable [4, 16, 17]. La Forma no añade poder. Da a cada programa de la clase una sola forma.
Proposición 1d (las demostraciones son ajustes). “Para cada demostración de una proposición dada, hay un programa del tipo correspondiente” [18]. Un tipo es una especificación y una demostración es un ajuste que la cumple. La compuerta de corrección es la existencia de esa demostración o de una prueba de aceptación que pasa.
Proposición 2 (un generador). Una función genera un programa ejecutable para cada ajuste y no lee ningún dominio. Fundamento: todo programa es una instancia de la Forma, así que emite un almacén tipado, un tipo de evento, reglas compiladas, un registro con un plegado y un despachador de salida. Generadores de andamiaje como los de Rails, JHipster y Yeoman son restringida a lenguajes de ajustes pequeños. La ingeniería de líneas de producto parte de “el descubrimiento y la explotación sistemáticos de lo común entre sistemas de software relacionados” [8]; lo común es la Forma.
Proposición 3 (extracción de mínima energía). La extracción con devuelve el término de menos julios que el extractor encuentra en la e-clase de . Esbozo de demostración. Las reescrituras son sólidas, así que todo término de la e-clase tiene el comportamiento observable de y pasa la misma compuerta. La extracción minimiza el coste, y el coste son julios. ∎ Esto es Mixture of Limits aplicado al código: conservar el ajuste mínimo que hace la tarea; el resto es desperdicio.
Proposición 4 (determinismo de la reproducción). Si no lee ningún reloj de pared, ordena las actualizaciones sin nombres y registra cada entrada, dos reproducciones de un mismo dan hashes de estado idénticos en cada paso.
Proposición 5 (la proyección al diagrama de estados es sólida). Se proyecta cada estado de una ejecución sobre . El resultado es una ejecución del diagrama de estados emitido bajo los mismos eventos.
Proposición 6 (presupuesto de coordinación). Las reglas marcadas como monótonas se ejecutan en réplicas sin coordinación; solo las reglas no monótonas necesitan un punto de coordinación. Fundamento: el teorema CALM, “los programas que tienen implementaciones distribuidas consistentes y libres de coordinación son exactamente los programas que pueden expresarse en lógica monótona” [19].
La etiqueta se deriva de la regla, nunca se declara, y la comprobación de la IR rechaza una Forma cuya etiqueta almacenada difiere de la derivada (especificación, Apéndice D.5):
| La regla tiene | Etiqueta | Motivo |
|---|---|---|
| ningún resolve, read, join ni scan | monótona | sus escrituras solo añaden claves y hacen crecer contadores |
| un resolve | no monótona | elimina filas de escalada |
| un read de su propio sumidero | no monótona | leer, modificar, escribir |
| un join por clave | no monótona | la fila unida puede estar ausente ahora y presente después, o sobrescrita |
| un scan | no monótona | observa toda la relación, incluido lo que está ausente |
La etiqueta es sólida y no completa: un join contra una relación de solo inserción sería monótono, pero el perfil no demuestra que una relación sea de solo inserción, así que la etiqueta no lo afirma. Una Forma está libre de coordinación cuando toda regla es monótona. Cada read, join y scan ve el estado a la entrada del evento, así que el estado posterior de un evento de entrada no depende del orden en que se ejecutan las reglas de sumideros distintos; solo depende de él el orden de salida, que queda fijado por el hash de contenido.
Proposición 7 (la inteligencia como derivada en julios). Sea el número de tareas que pasan la compuerta y los julios gastados. se lee a posteriori a partir de , que registra cada evento y su est_j. La extracción bajo mantiene fija la compuerta y no eleva , así que a igual no reduce .
3.5 Grafo, e-grafo y diagrama de estados
| Estructura | Parte de la Forma | Qué decide |
|---|---|---|
| Diagrama de estados | Guardas de sobre | Qué transición se dispara |
| Grafo de flujo de datos | Dependencias de lectura y escritura de y (redes de procesos de Kahn [20]) | Qué se ejecuta y en qué orden |
| E-grafo | La clase de equivalencia del ajuste | Qué ajuste equivalente se ejecuta |
El diagrama de estados y el grafo describen un ajuste. El e-grafo describe todo ajuste equivalente a él. La extracción elige entre ellos por julios.
3.6 Un ecosistema, sin pérdida, y la tesis de universalidad
Sin pérdida por construcción. El teorema de codificación de fuente de Shannon fija el piso de un código sin pérdida en la entropía de la fuente [40]. Una Forma es un código sin pérdida para la intención en un sentido estricto que puede comprobarse: la serialización canónica de la Forma es inyectiva, así que dos Formas que difieren en cualquier estado, evento o transición tienen hashes de forma distintos, y decodificar la serialización devuelve la misma Forma. Cada proyección a un destino es función solo de la Forma. Las transformaciones bidireccionales precisan la ida y vuelta. Foster, Greenwald, Moore, Pierce y Schmitt definen una lente como un par de funciones get y put con condiciones de ida y vuelta que hacen concordar una vista y su fuente [122], Hofmann, Pierce y Wagner extienden las condiciones a las lentes simétricas [123], y Czarnecki y sus colegas examinan las mismas condiciones de consistencia en la ingeniería de modelos, las bases de datos y los lenguajes de programación [124]. La condición de ida y vuelta de RCE es la condición GetPut al nivel del programa completo: al elevar de nuevo una proyección, el hash de forma no cambia.
Correcto por construcción. Dijkstra propuso en 1968 que un programa y su demostración se desarrollen juntos, de modo que la corrección se diseñe desde el principio en lugar de comprobarse con pruebas [125]. Hall y Chapman llevaron el enfoque a un sistema seguro comercial con especificación formal y refinamiento en cada paso [126]. La regla de Minsky para la programación funcional tipada, hacer irrepresentables los estados ilegales, dice lo mismo en el nivel de los tipos: un tipo que no puede contener un valor erróneo elimina la necesidad de comprobarlo [127]. La programación funcional total de Turner exige que cada función termine en cada entrada, de modo que un programa denote una función matemática sin fallo oculto [128]. La Forma de RCE es total en el sentido de Turner, sus tipos de contrato hacen irrepresentables los estados no declarados en el sentido de Minsky, y la cadena de refinamiento de la §2.1 termina en ella en el sentido de Dijkstra. La consecuencia es la enunciada en la §1: un error se rechaza en el punto de entrada, así que no queda nada que comparar ni rastrear a posteriori.
La tesis de universalidad. Enunciada en términos teóricos, la tesis es que hay una Forma universal. Los programas se escriben en ella de forma nativa, todo lenguaje existente es alcanzable desde ella como proyección fiel, y todo programa existente entra en ella por elevación. La tesis de Gurevich da el fundamento: todo algoritmo secuencial queda capturado, paso a paso, por una Máquina de Estados Abstracta en su propio nivel de abstracción [2], y los algoritmos paralelos igualmente [3]. Una Forma es una máquina así sobre un estado de base de datos.
Proposición U1 (captura). Si un programa en el lenguaje es un algoritmo secuencial o paralelo en el sentido de Gurevich, entonces existe una Forma cuya transición lo simula paso a paso en el nivel de abstracción del programa [2, 3].
Proposición U2 (proyección fiel). Si la proyección de una Forma a preserva la traza de la Forma en toda entrada del contrato, entonces la Forma y su proyección son intercambiables para todo observador de la traza, y no añade nada que a la Forma le falte.
Proposición U3 (elevación por construcción). Todo lenguaje de programación en uso tiene una gramática formal, un analizador que produce un árbol de sintaxis concreta, un árbol de sintaxis abstracta y una semántica fijada por su especificación o su implementación de referencia. Una elevación se construye por lenguaje en tres etapas: la gramática, luego el árbol de sintaxis abstracta, luego la Forma, y cada construcción de recibe su regla de Forma según la semántica de . Una elevación así construida cumple en comportamiento y en hash de forma, así que el par es una lente en el sentido de [122], y un programa en se conserva como Forma sin pérdida.
Proposición U4 (sustitución). Si U2 y U3 se cumplen para el lenguaje , ningún programa necesita escribirse en : se escribe una vez como Forma y se emite como donde una plataforma lo exija.
U1 es un teorema. U2 se comprueba por destino mediante pruebas diferenciales (§5.1) y con N grande en la §2.3. U3 es una construcción, levantada lenguaje por lenguaje desde la gramática, y la §8.7 indica cómo se mide la construcción a medida que se levanta.
3.7 El lenguaje: versiones 0.6 y 0.7, costes y estado de los teoremas
El lenguaje RCE se define mediante una especificación escrita, actualmente el documento del borrador 0.7 en la versión 0.8 del lenguaje (/rce/spec/; fuente en el repositorio rce). Cada módulo selecciona su versión del lenguaje con un comentario en la primera línea. Un módulo sin él es de la versión 0.5, el lenguaje de las secciones 2 a 10. Un módulo que declara # rce-version: 0.6 recibe además el Apéndice C: par, for ... par, with budget, grupos de trabajo, LVars, sesiones y supervisores. Un módulo que declara # rce-version: 0.7 tiene el lenguaje de la versión 0.6 con una diferencia, el coste de los métodos de la biblioteca estándar que se da más abajo (Apéndice C.15). El Apéndice D define el perfil del motor, las especificaciones de manejadores y los ajustes que ejecuta el motor de este artículo. Un módulo de la versión 0.5 nunca ve el Apéndice C, así que todo programa válido de la versión 0.5 se acepta sin cambios.
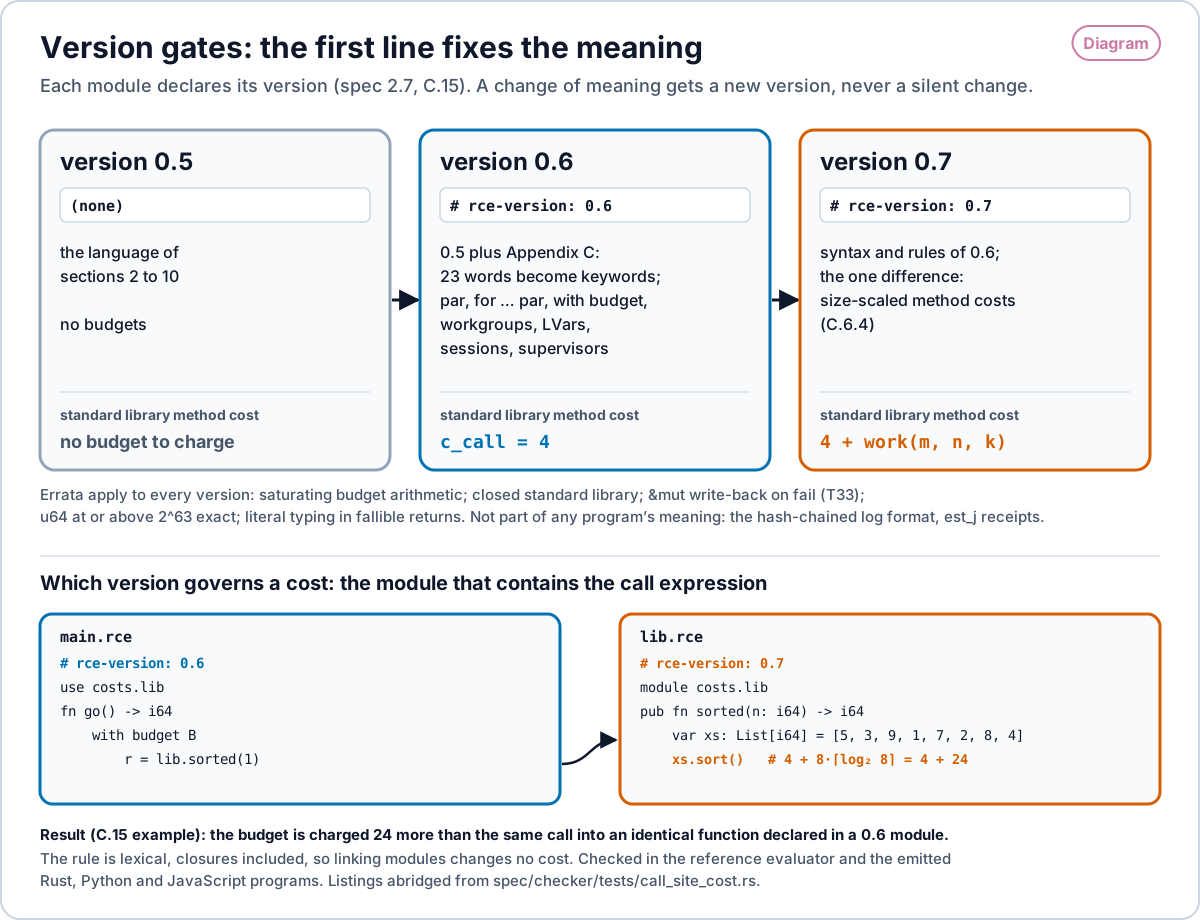
# rce-version: 0.6 añade el Apéndice C (23 palabras clave nuevas; par, for ... par, with budget, grupos de trabajo, LVars, sesiones, supervisores), y un método de la biblioteca estándar cuesta . # rce-version: 0.7 tiene la sintaxis y las reglas de 0.6 y solo difiere en el coste de los métodos, . Las erratas se aplican a todas las versiones. La versión del módulo que contiene la expresión de llamada rige su coste: a una función 0.6 bajo with budget que llama a una función 0.7 importada que ordena 8 elementos se le cobran 24 más que por la misma llamada a una función 0.6 idéntica. Fuente: especificación 2.7, C.6.4 y C.15; listados abreviados de spec/checker/tests/call_site_cost.rs. Se ofrece una copia PNG. Open full size · PNG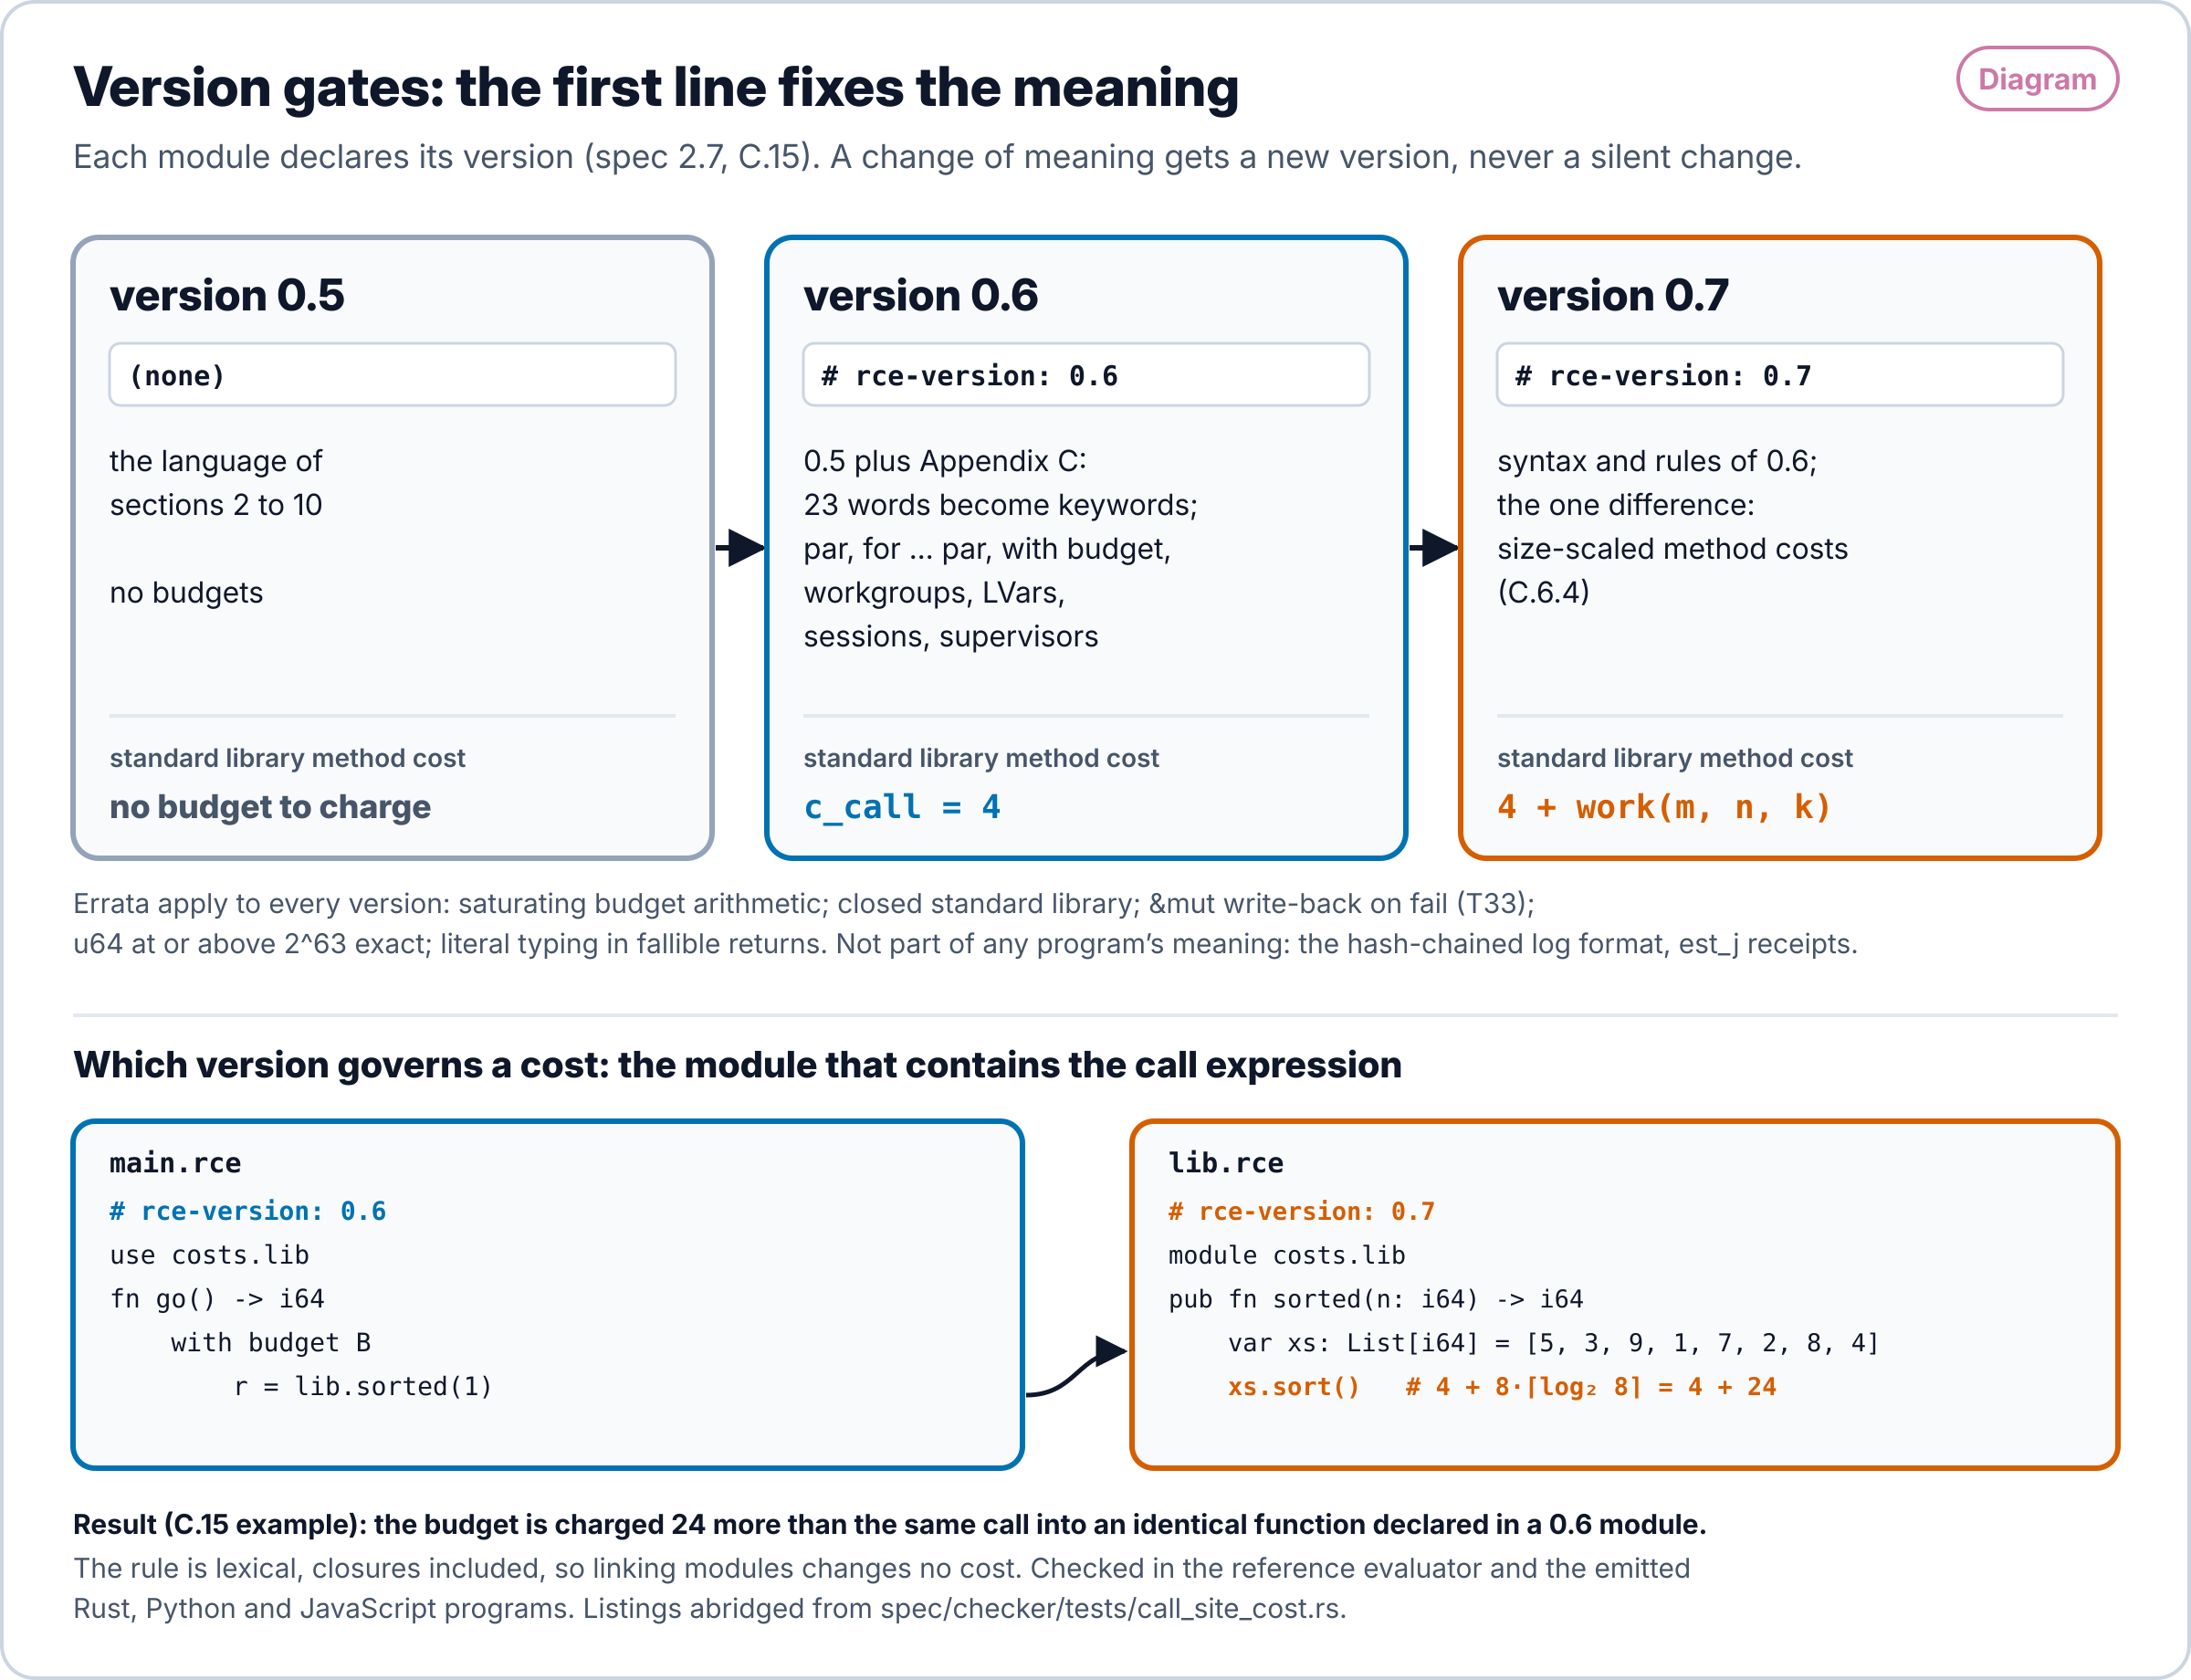
Los presupuestos cuentan trabajo. Un bloque with budget cobra a cada operación un coste fijo de la tabla del Apéndice C.6.4 y produce la trampa budget cuando se agota la cuenta. La cuenta es un indicador del trabajo, no una medición de tiempo ni de energía; est_j es aparte.
| Operación | Coste |
|---|---|
| llamada a una función de usuario o a una clausura, | 4 |
| método de la biblioteca estándar sobre un receptor de tamaño , con primer argumento de tamaño | 4 en la versión 0.6; en la versión 0.7 |
| envío o recepción por canal | 8 |
spawn | 32 |
una rama de par o un fragmento de for ... par | 16 |
literal de lista o de mapa, o comprensión, con resultados; [x; n] | |
índice, segmento, acceso a miembro; operadores unarios; and, or; operadores y comparaciones de enteros, booleanos y texto | 1 |
+, -, * de coma flotante | 2 |
/, % de coma flotante | 8 |
Los tamaños son la longitud en bytes UTF-8 de un texto, la longitud de una lista y el número de entradas de un mapa; cualquier otro valor tiene tamaño 0. El trabajo del método lo fija la clase de complejidad del método en el evaluador de referencia: para los métodos lineales sobre textos, listas y mapas (los mapas son listas de asociación ordenadas), para sort (0 cuando ), y 0 para los demás métodos. Las llamadas que map, filter y fold hacen a su argumento función se cobran además como llamadas. La aritmética se satura en el mayor entero de 128 bits, y nunca disminuye cuando o crecen. El evaluador de referencia y los entornos de ejecución emitidos en Rust, Python y JavaScript calculan la misma función, y una prueba comprueba que la trampa de presupuesto cae en la misma operación en los cuatro.
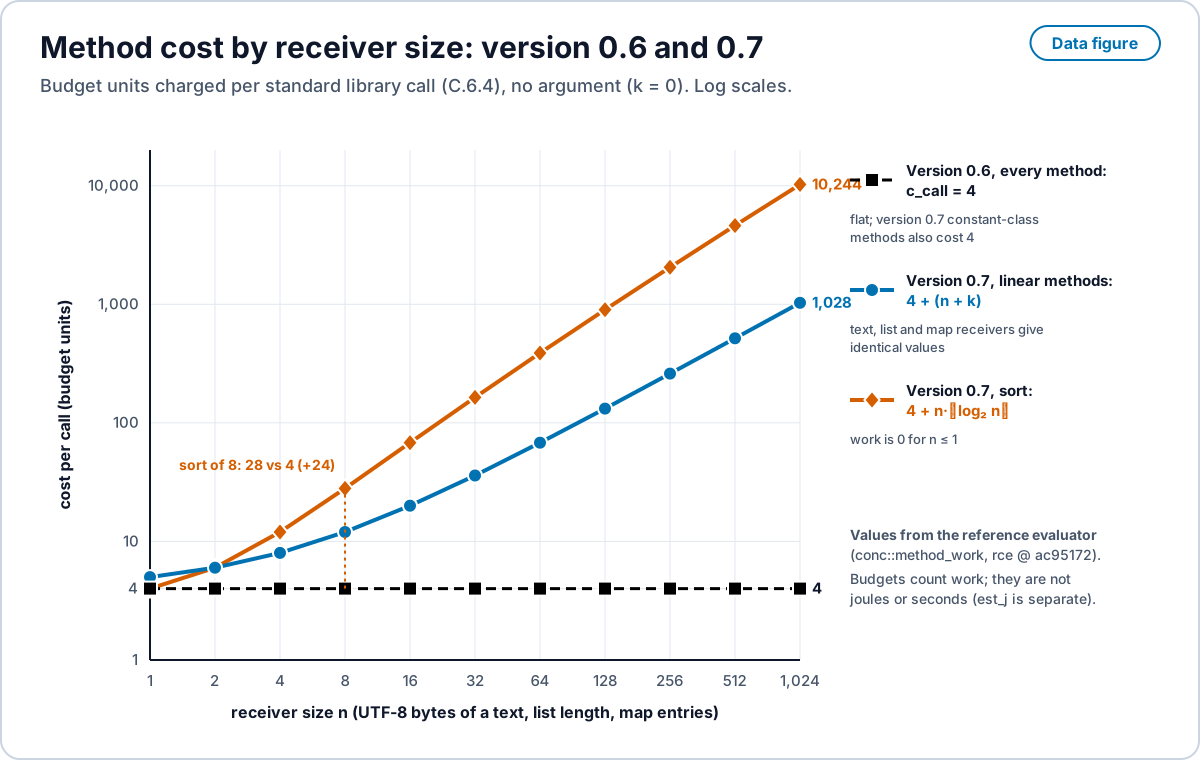
conc::method_work del evaluador de referencia (rce ac95172). Se ofrece una copia PNG. Open full size · PNG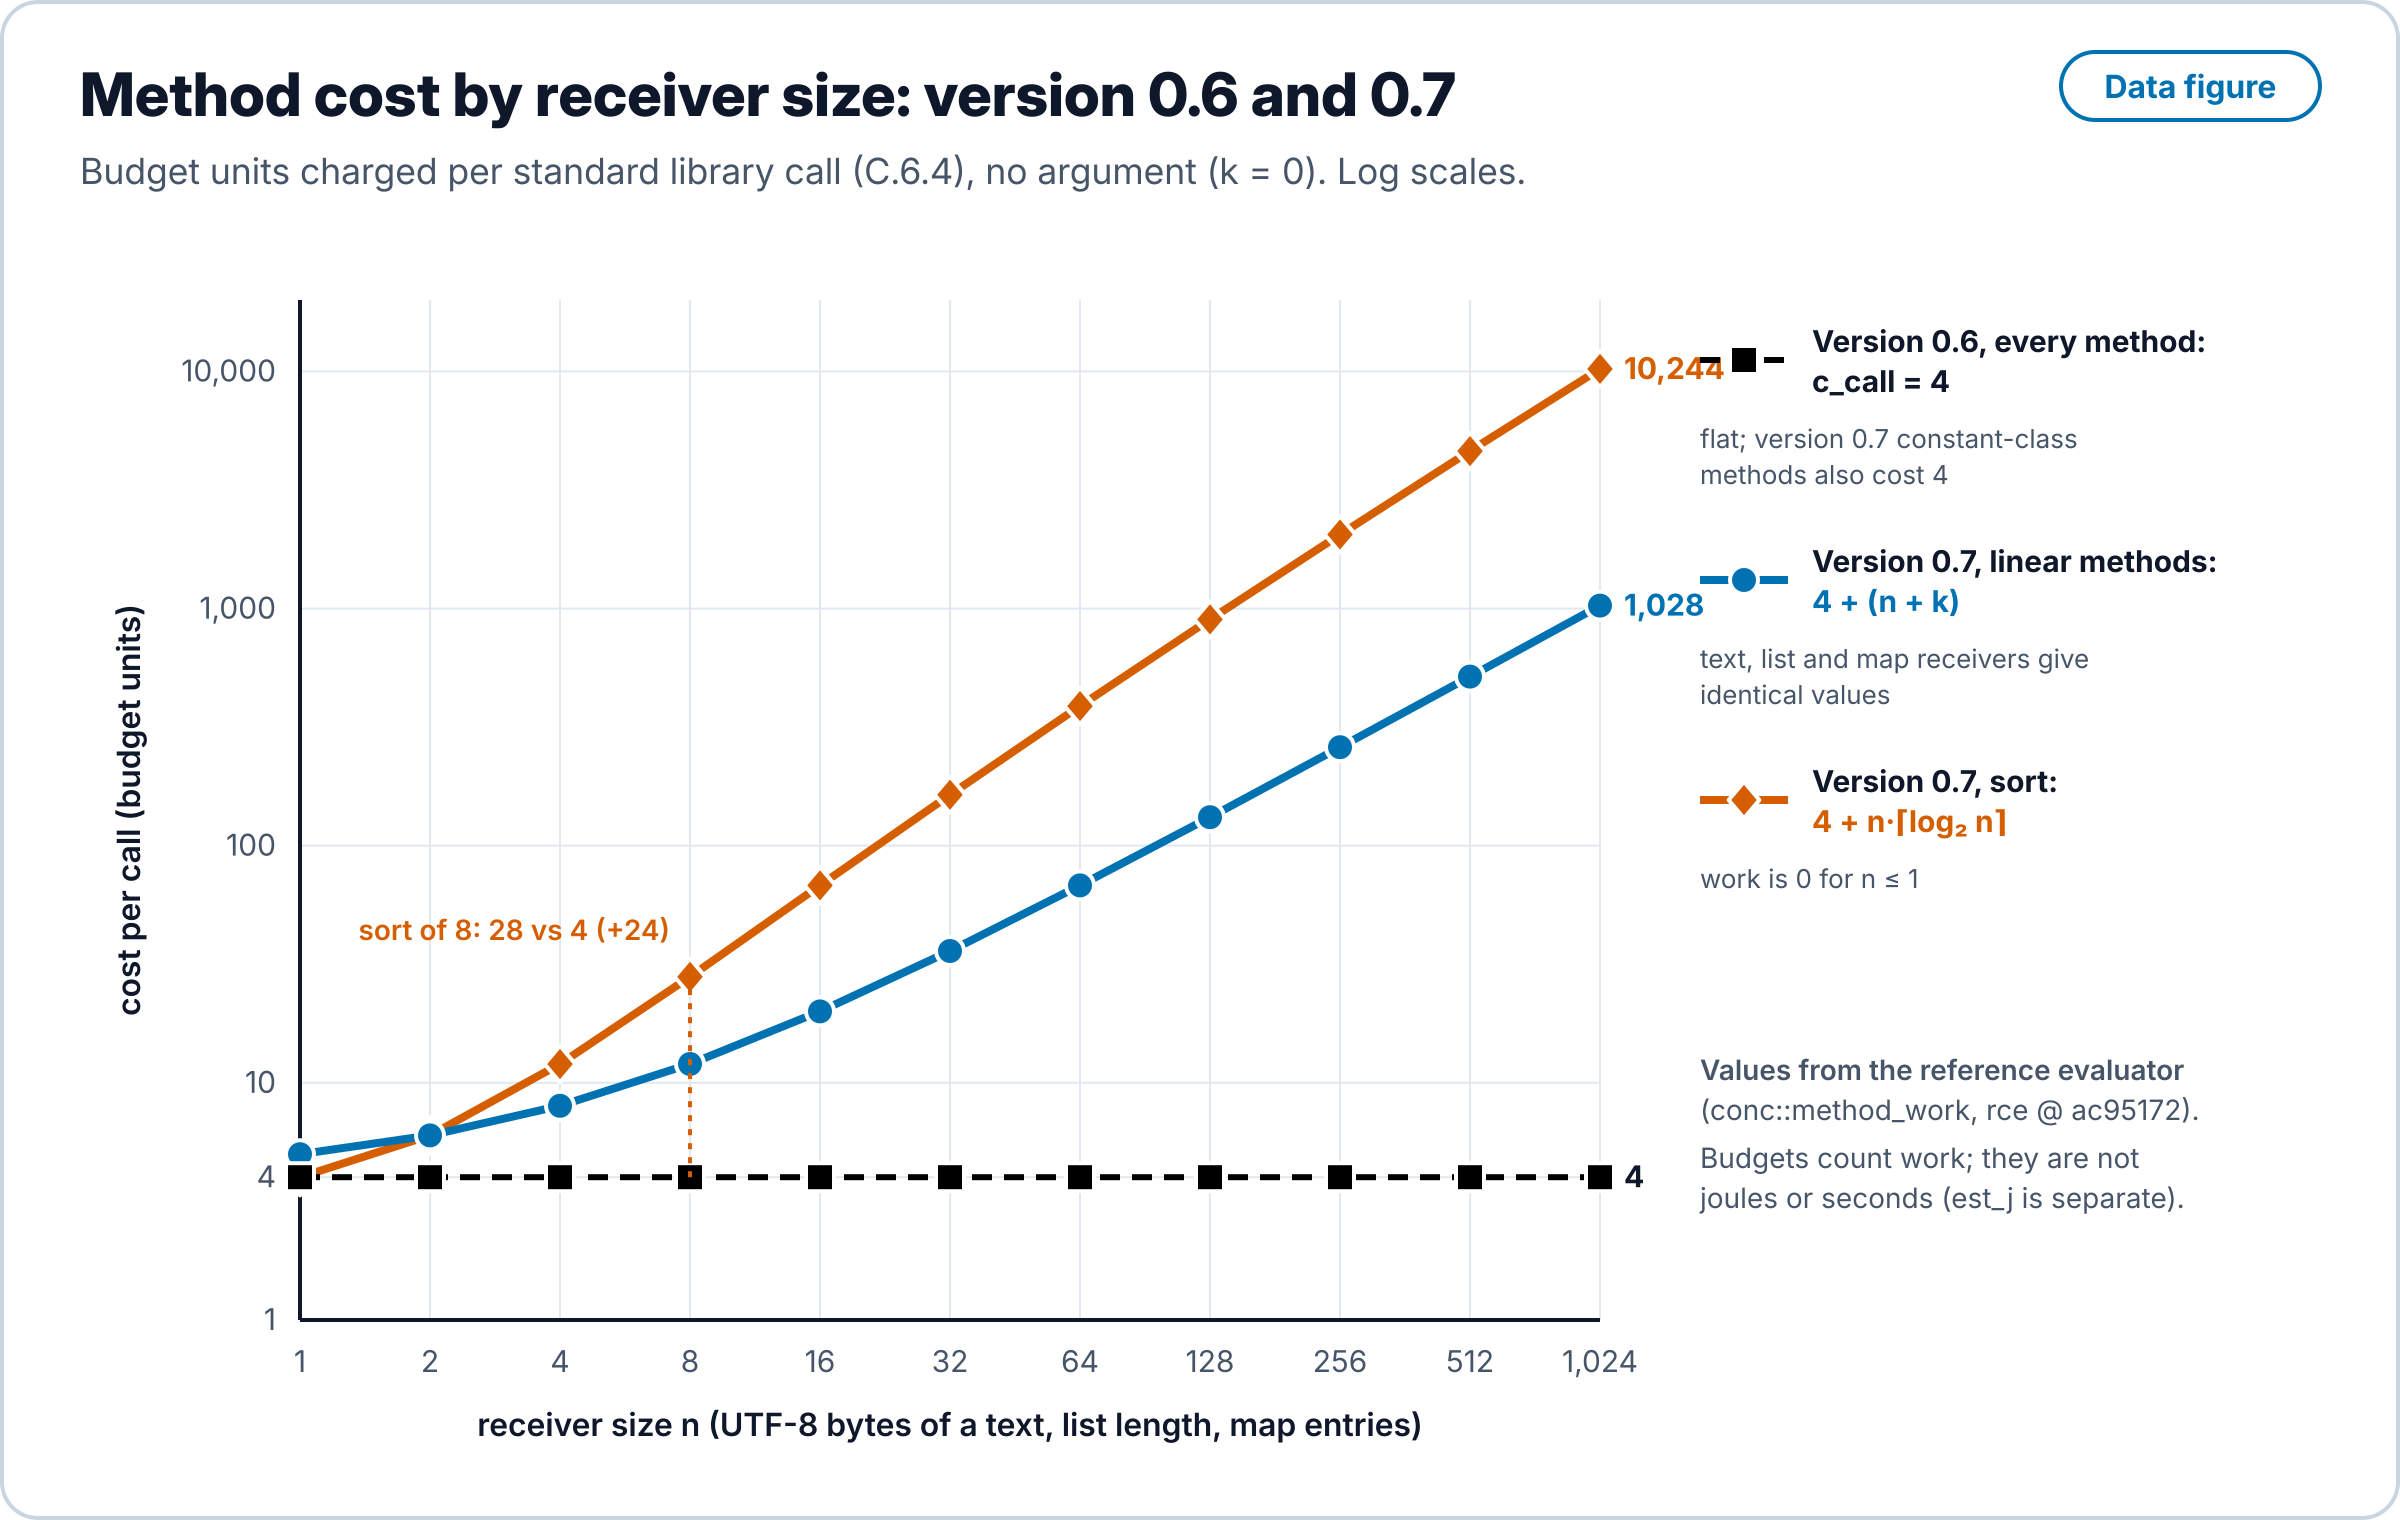
Qué versión rige un coste. Un programa puede unir módulos de versiones distintas. El coste de una llamada a método lo fija la versión declarada del módulo que contiene la expresión de llamada, incluida una llamada dentro de una clausura escrita allí, y no la versión de la función que se ejecuta, de quien la llama ni del primer módulo del programa. La regla es léxica, así que enlazar módulos no cambia ningún coste; la especificación 2.7 enuncia la misma regla y remite a C.15. Las pruebas la comprueban en la frontera en ambas direcciones sobre el evaluador de referencia y sobre los programas emitidos en Rust, Python y JavaScript: a una función 0.6 bajo with budget que llama a una función 0.7 importada que ordena una lista de 8 elementos se le cobran 24 más que por la misma llamada a una función 0.6 idéntica.
Estado de los teoremas. La especificación enuncia los teoremas T1 a T34 y registra con exactitud el estado de cada uno. Las demostraciones están en Lean 4 (v4.12.0, sin Mathlib) sobre un cálculo núcleo. Las palabras usadas para el nivel de un resultado son estas. Demostrado significa una demostración en Lean sobre la semántica núcleo del lenguaje. Demostrado sobre una semántica significa una demostración en Lean sobre una semántica de pasos pequeños de un núcleo de RCE. Modelo significa una demostración en Lean sobre un modelo abstracto que no está conectado con la semántica de RCE ni con el evaluador de referencia. Vectores significa que los resultados del evaluador de referencia sobre programas generados se comprueban frente al modelo con el núcleo de Lean, lo cual es una correspondencia sobre muestras, no una demostración sobre el evaluador. Por pruebas significa pruebas diferenciales sobre entradas declaradas. Comprobado mecánicamente significa decidido por un programa, como un constructor de tablas LALR(1).
| Enunciado | Nivel | |
|---|---|---|
| T1 | determinismo: un resultado por estado y evento; un resultado por tic de la semántica de concurrencia | demostrado |
| T2 | totalidad de , con una cota explícita de pasos de evaluación; recursión estructural y composición de cotas a lo largo del grafo de llamadas | demostrado (el núcleo de expresiones de Lean no tiene llamadas a funciones de usuario; la recursión y la composición se demuestran sobre modelos separados) |
| T3 | el estado en ejecución es y la reproducción recupera cada hash y cada salida | demostrado |
| T4 | progreso, incluidos los tics (alguna tarea avanza, o la ejecución termina o informa Deadlock) | demostrado |
| T5 | preservación, incluido el rango entero de cada campo escrito | demostrado |
| T6 | seguridad de memoria, rutas de préstamo completas, sin compartición mutable entre tareas | demostrado para el núcleo de propiedad y una semántica instrumentada de rutas de préstamo |
| T7 | independencia de nombres de los hashes del registro, los identificadores y las elecciones de select | demostrado |
| T8 | atomicidad: un evento rechazado deja el estado sin cambios | demostrado |
| T9-F | los destinos de la IR de la Forma (Rust, WASM, Python, XState, SCXML) imprimen la traza de referencia | por pruebas |
| T9-L | los emisores de programas (rust, python, js) concuerdan con el evaluador de referencia | demostrado para el emisor de Rust sobre un núcleo, como traducción verificada a MiniRust, una incrustación profunda del subconjunto de Rust emitido; que rustc implementa MiniRust se asume y se prueba; los demás emisores, por pruebas |
| T10 | la gramática no es ambigua | comprobado mecánicamente (LALR(1), 0 conflictos, para ambas versiones) y muestreado por un fuzzer |
| T11 | equidad de select | demostrado sobre el modelo de rotación |
| T12 | un descriptor lineal se consume exactamente una vez en cada camino | demostrado sobre un modelo de sentencias |
| T13 | las operaciones f32 dan los mismos bits en destinos que concuerdan en IEEE 754 | demostrado para la multiplicación; para la suma, la resta y la división, la propiedad de redondeo único es el teorema de Figueroa, citado y no mecanizado |
| T14 | la aritmética u64 comprobada es exacta dentro del rango | demostrado |
| T15 | los iteradores terminan, respetan el límite del bucle y son consistentes con los prefijos | demostrado |
| T16 a T31 | concurrencia de la versión 0.6: determinismo de par, conmutación, reducciones, ausencia de interbloqueos, plazos, grupos de trabajo, relojes vectoriales, prioridades, ámbitos, actores, sesiones, LVars, lotes atómicos, réplicas | demostrado sobre una semántica: T16, T17, T19a, T20, T23; demostrado sobre un modelo de ejecuciones: T24; demostrado sobre un cálculo de sesiones: T28; modelo: T18, T19b, T21, T22, T25, T26, T31; modelo con vectores: T27, T29, T30. Ninguno es una demostración sobre el evaluador de referencia en Rust |
| T32 | reproducción foránea: para todo oráculo, la reproducción del registro es igual a la ejecución en vivo, y un contrato de respuesta se cumple en cada respuesta registrada | demostrado |
| T33 | restauración de &mut en caso de fallo (F.4.4): una llamada fallida deja el estado &mut del llamador como estaba en la llamada; una llamada que retorna escribe de vuelta (la regla anterior de copiar hacia fuera en todo resultado queda retirada) | demostrado |
| T34 | el paso ANF que preserva el orden antes de cada emisor da el mismo valor, el mismo almacén y la misma traza de cargos y emisiones | demostrado para un fragmento núcleo con ANF completo; la implementación se prueba de forma diferencial en cada destino, incluido un barrido de presupuestos a través del punto de trampa |
T9 tiene dos conjuntos de destinos porque el motor del artículo y el lenguaje tienen dos compiladores. T9-F es la afirmación sobre rce form --emit, que mide la §5.1. T9-L es la afirmación sobre los emisores de programas del lenguaje. Un destino fuera de estos conjuntos no tiene afirmación T9.
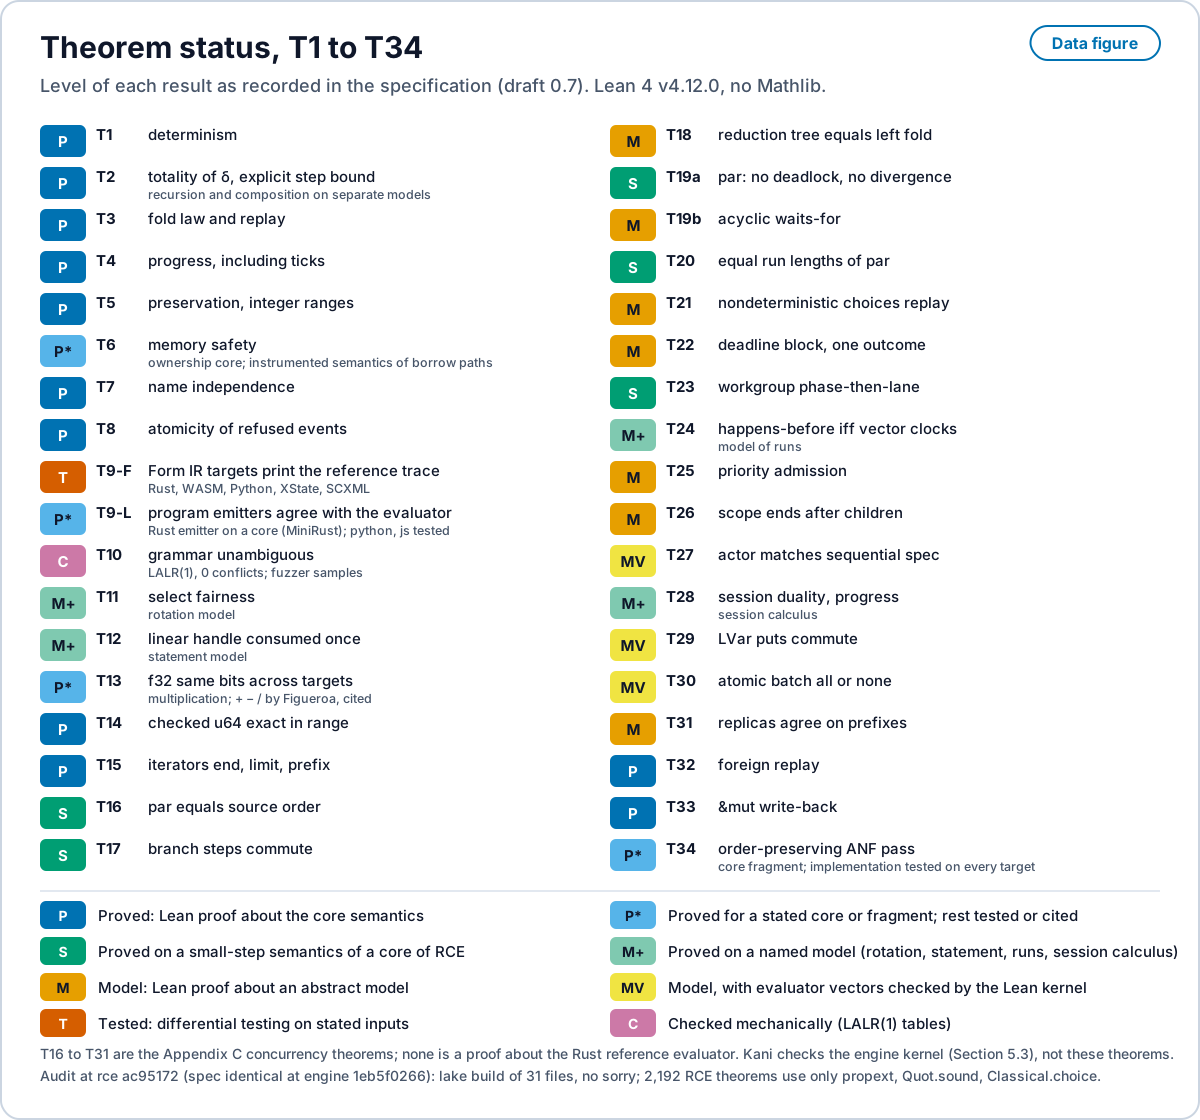
P: demostración en Lean sobre la semántica núcleo. P*: demostrado para un núcleo o fragmento declarado, el resto por pruebas o citado. S: demostrado sobre una semántica de pasos pequeños de un núcleo de RCE. M+: demostrado sobre un modelo con nombre (modelo de rotación, modelo de sentencias, modelo de ejecuciones, cálculo de sesiones). M: demostración en Lean sobre un modelo abstracto. MV: modelo, con vectores del evaluador de referencia comprobados por el núcleo de Lean. T: pruebas diferenciales. C: comprobado mecánicamente. T16 a T31 pertenecen a la versión 0.6, y ninguno es una demostración sobre el evaluador de referencia en Rust. Lean 4 v4.12.0, sin Mathlib. Fuente: spec/book/10-theorems.md y Apéndice C.13. Se ofrece una copia PNG. Open full size · PNG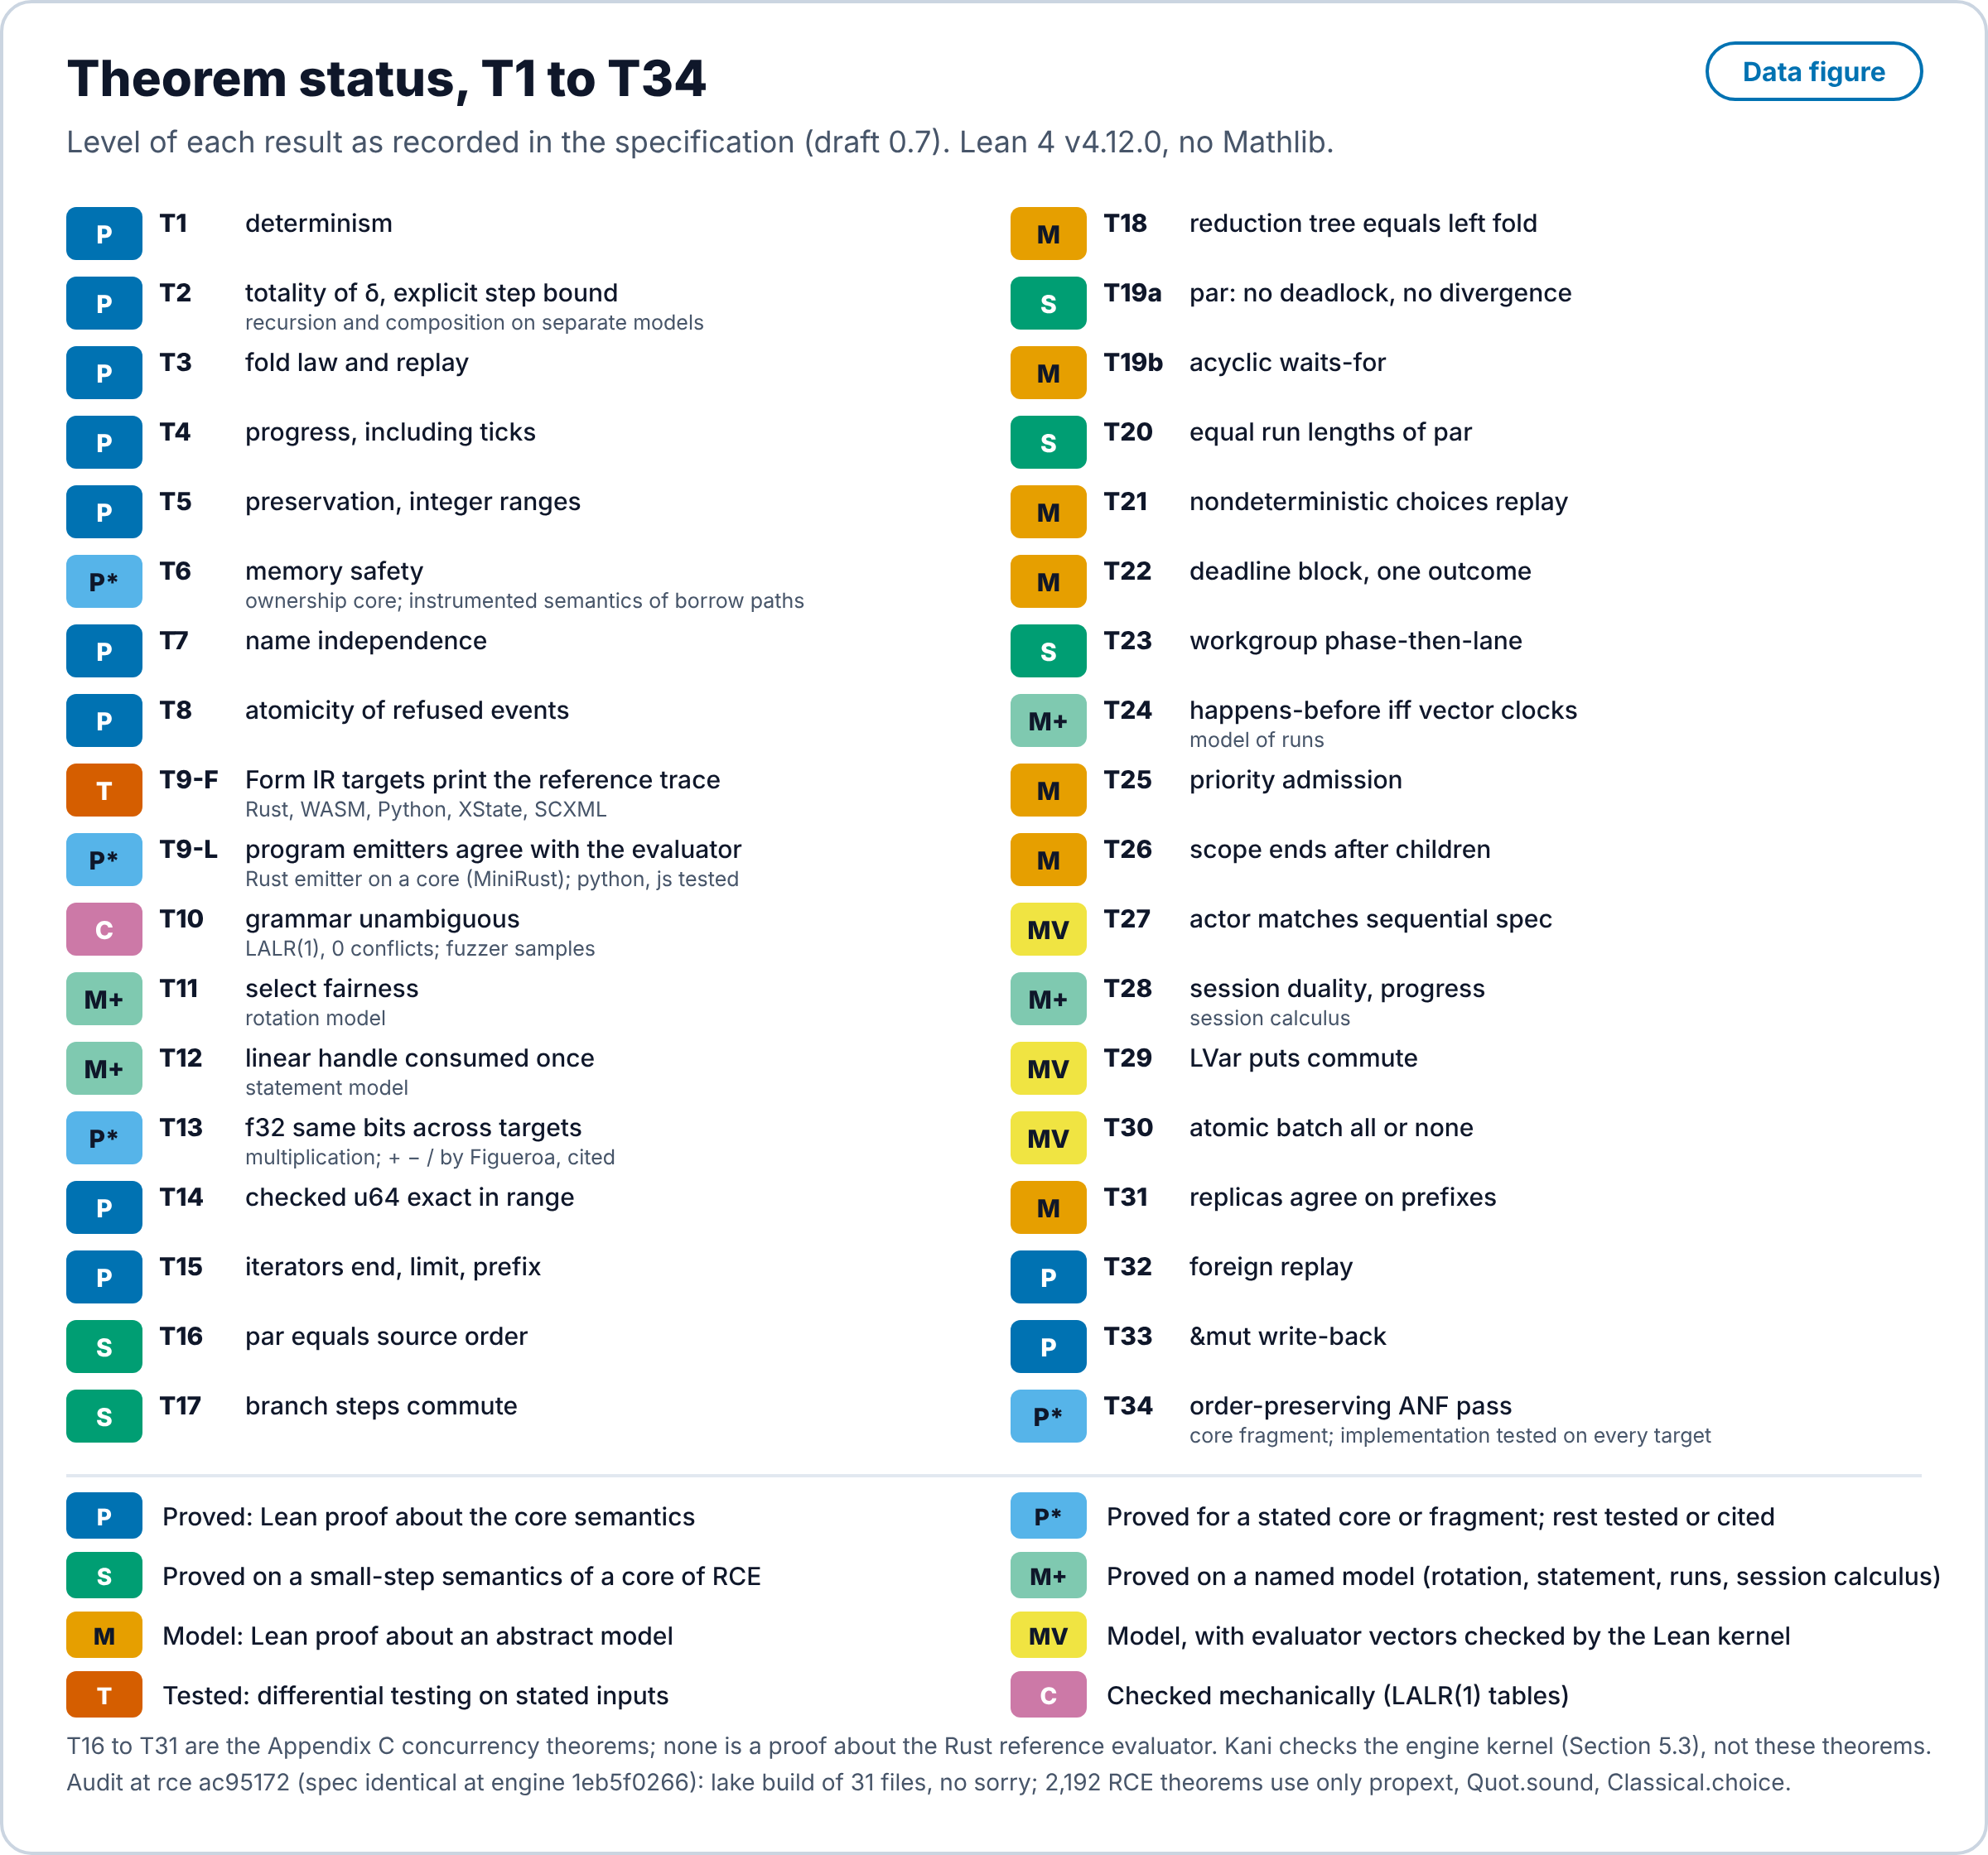
Comprobaciones ejecutadas para esta versión. En el commit del motor 1eb5f02, lake build se completa sobre los 31 archivos de spec/lean/RCE/ sin ningún sorry (46 archivos en el 4304048 público, 58 en e416fd0), y la auditoría permanente informa que los axiomas de 2,192 constantes de teorema (la auditoría cuenta cada constante de teorema del núcleo; véase la nota de correcciones anterior) son solo propext, Quot.sound y Classical.choice. Kani verifica 10 de 10 arneses del núcleo (§5.3). Las pruebas del motor (cargo test --release) pasan 589 pruebas distintas con 0 fallos (2 ignoradas); make check informa 596 porque su paso de demostraciones ejecuta 7 de esas pruebas una segunda vez. El comprobador de referencia, compilado a partir del repositorio público como lo compila su integración continua, pasa 56 pruebas en la compilación por defecto y 112 con los conjuntos de las versiones 0.6 y 0.7 activados, con 0 fallos, y 57 con la prueba de concordancia con tree-sitter. La comprobación de la especificación construye las tablas LALR(1) de la versión 0.5 y de las versiones 0.6 y 0.7, que comparten gramática, con 0 conflictos, y analiza cada ejemplo con tres analizadores, y la compilación WebAssembly del comprobador pasa 401 de 401 comprobaciones frente a los corpus de ejemplos.
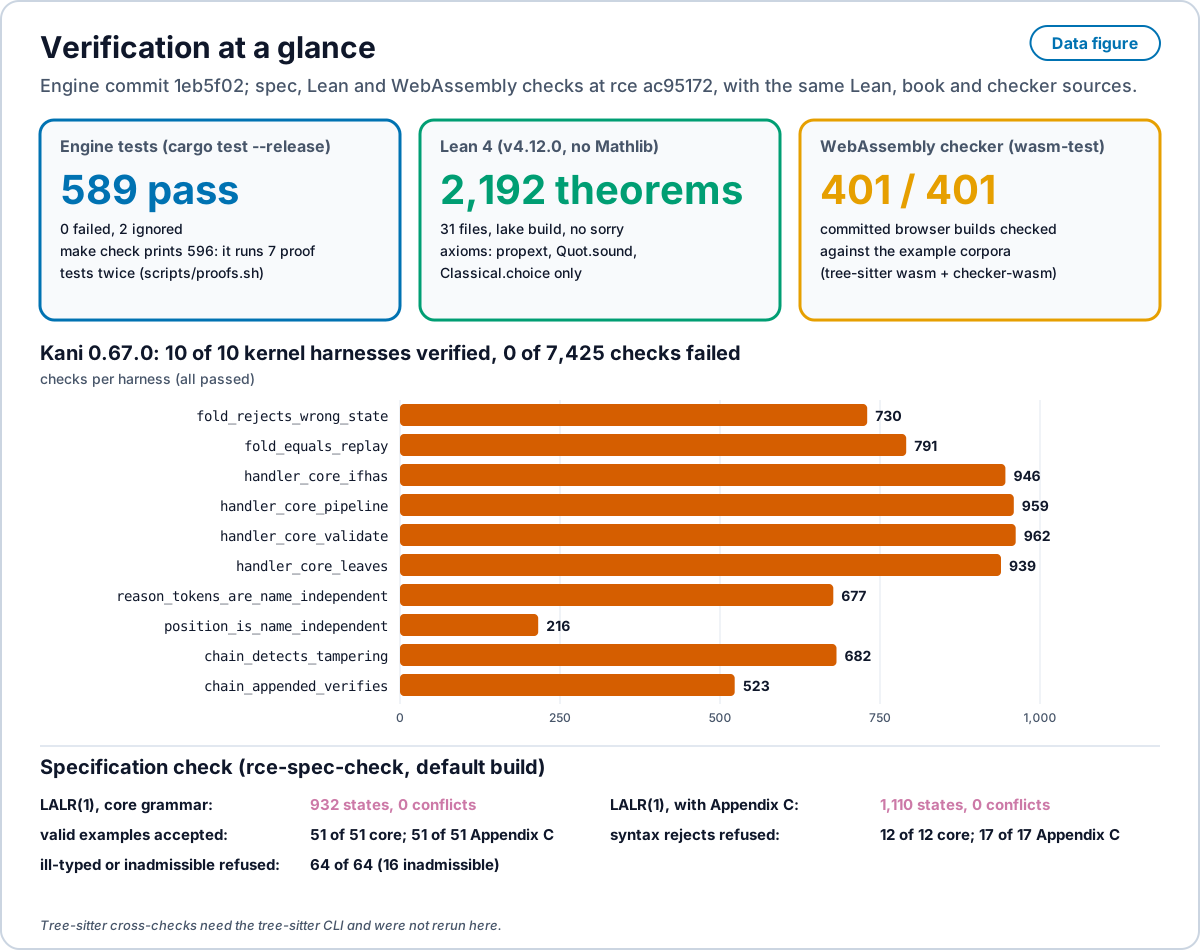
1eb5f02. Figura de datos. Pruebas del motor (cargo test --release): 589 pasan, 0 fallan, 2 ignoradas; make check informa 596 porque ejecuta 7 pruebas de demostración dos veces. Lean 4: lake build sobre los 31 archivos de spec/lean/RCE/ sin ningún sorry; la auditoría informa 2,192 constantes de teorema (recuento de la auditoría, no declaraciones de la fuente) cuyos axiomas son solo propext, Quot.sound y Classical.choice. Kani 0.67.0 verifica 10 de 10 arneses del núcleo con 0 de 7,425 comprobaciones fallidas (barras: comprobaciones por arnés). La compilación WebAssembly del comprobador pasa 401 de 401 comprobaciones frente a los corpus de ejemplos. La comprobación de la especificación construye tablas LALR(1) con 0 conflictos para la versión 0.5 (932 estados) y para las versiones 0.6 y 0.7 (1,110 estados), acepta 51 de 51 ejemplos válidos y rechaza los 12 de 12 casos de rechazo sintáctico y los 64 de 64 programas mal tipados o inadmisibles. Las comprobaciones de Lean, WebAssembly y de la especificación se ejecutaron en el repositorio público en ac95172, cuyas fuentes de la especificación son idénticas a las del motor. Se ofrece una copia PNG. Open full size · PNG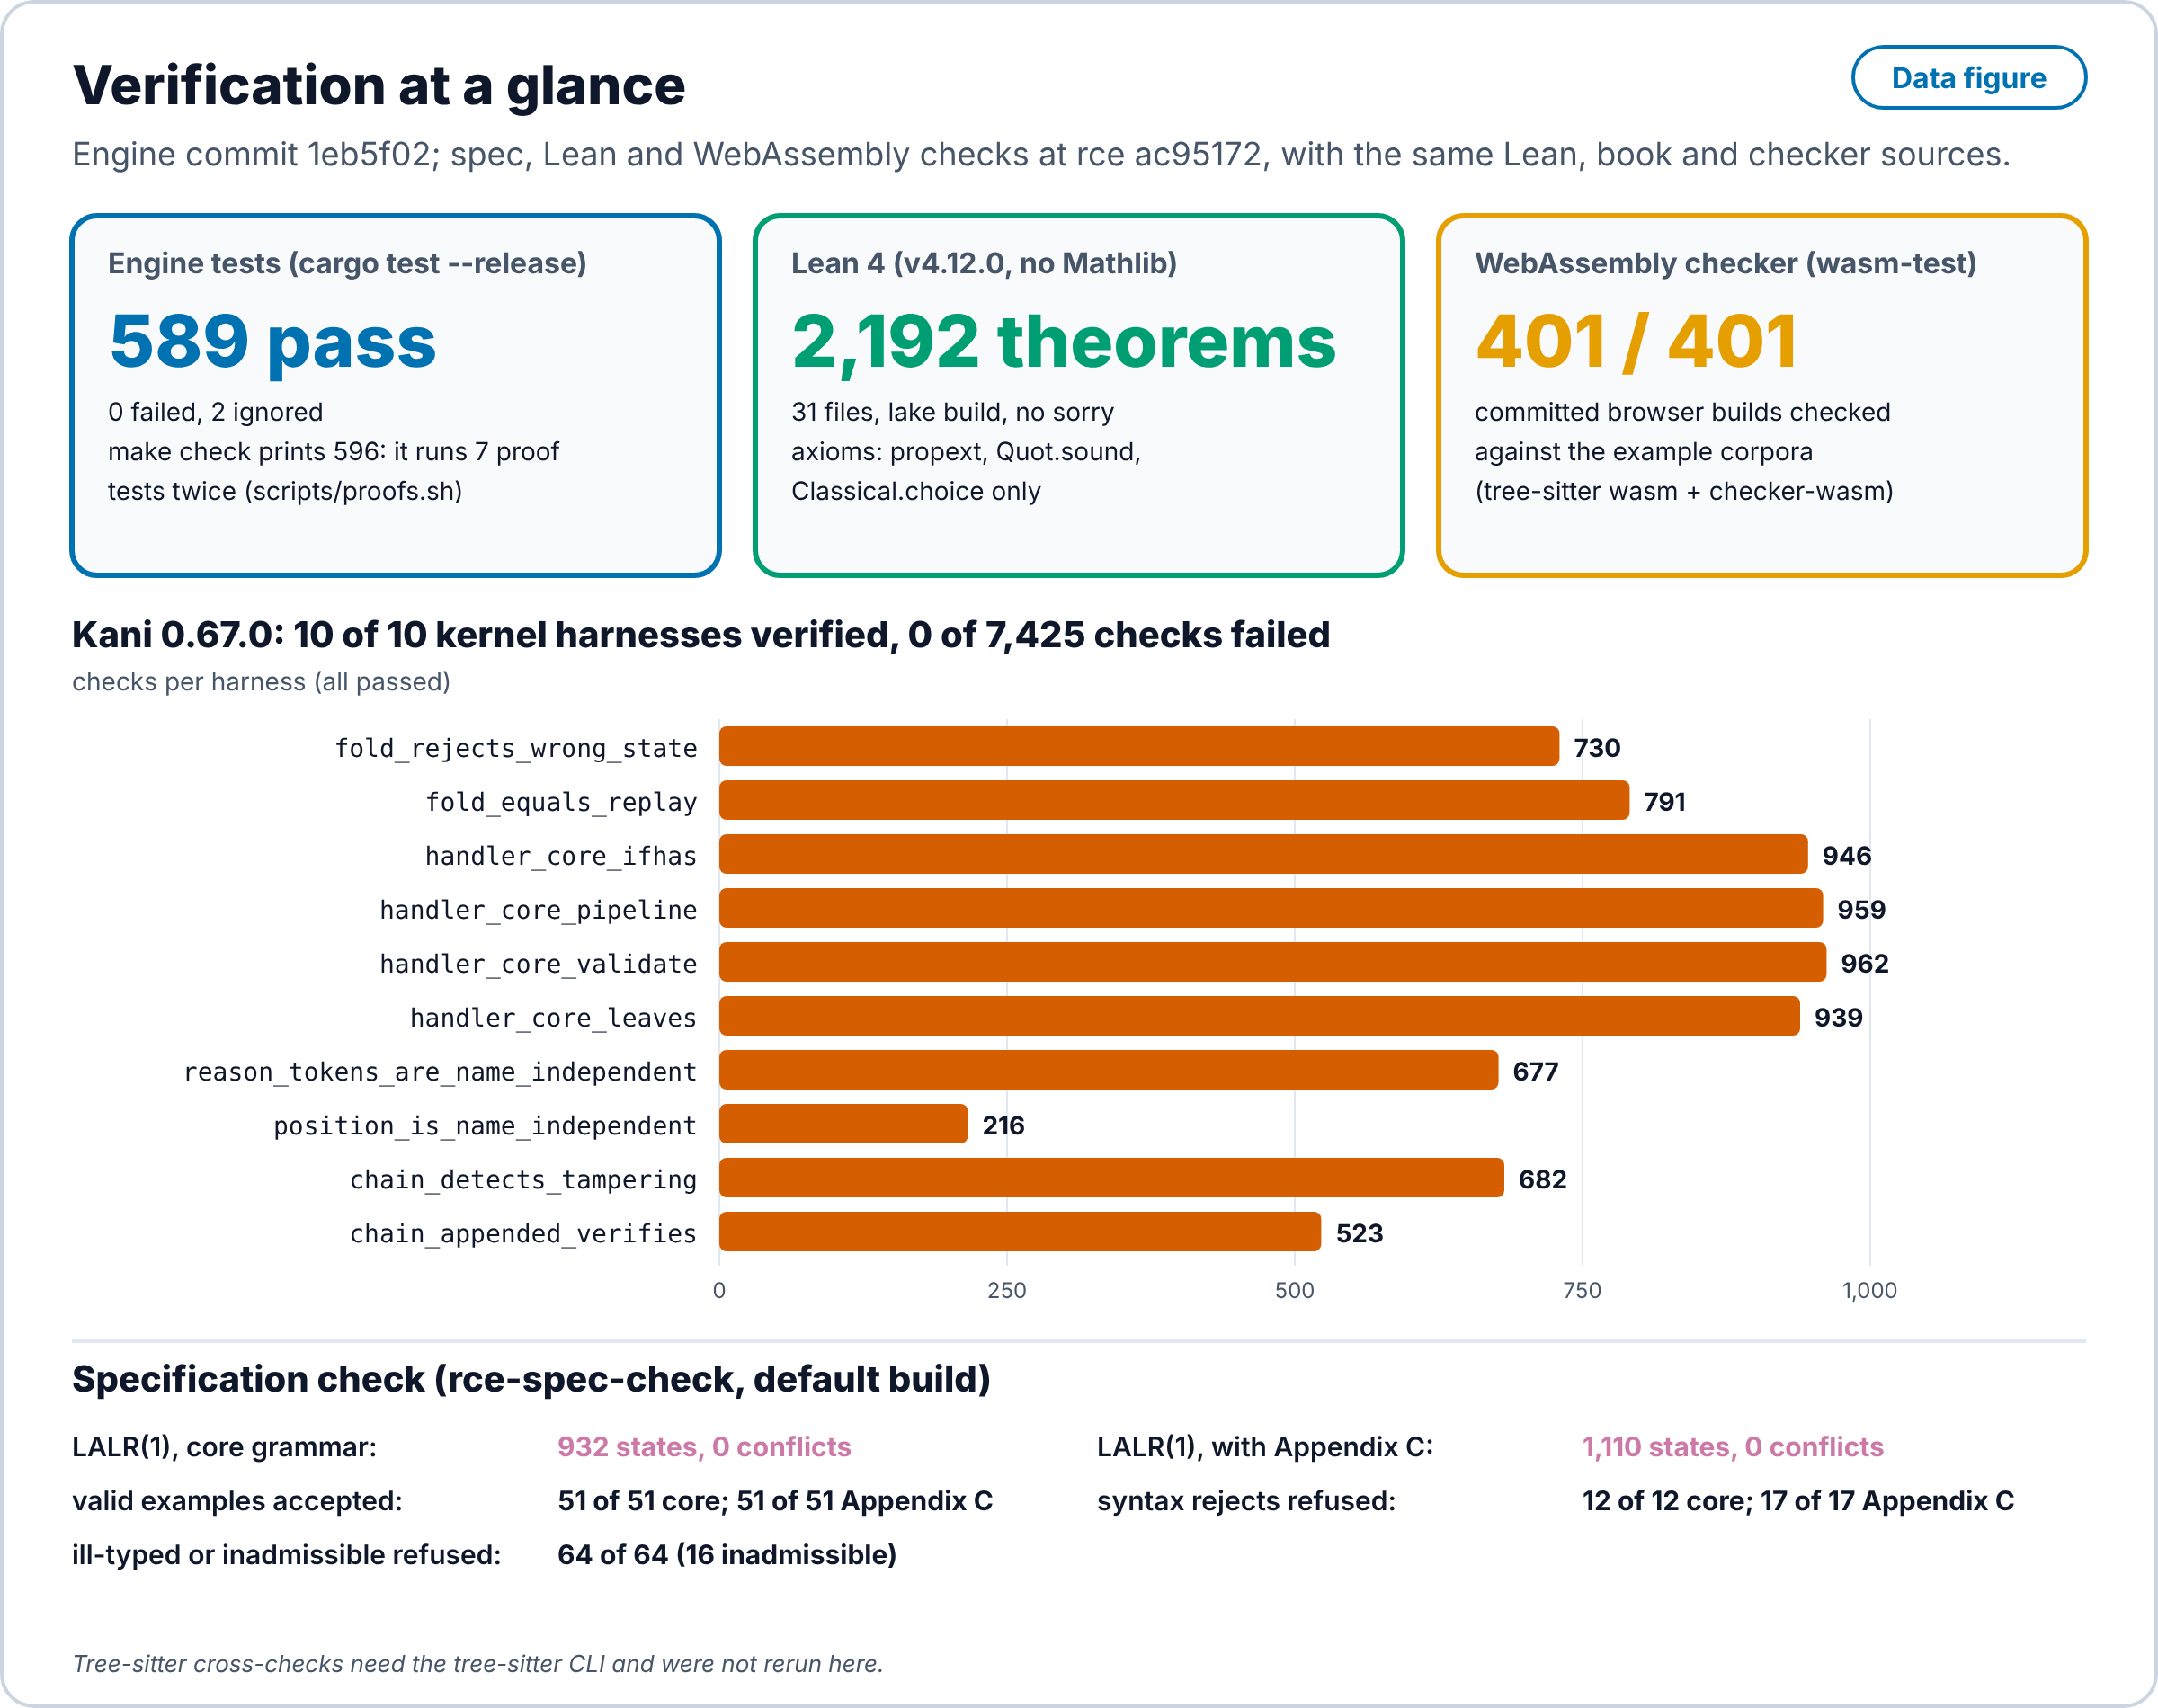
Una observación de convergencia. El catálogo de agentlanguages.dev, leído el 13 de octubre de 2026, enumera 42 lenguajes diseñados para que agentes de IA escriban código, agrupados por sus editores en un campo sintáctico, un campo de verificación y un campo de orquestación. Varias decisiones de diseño de este artículo, como los contratos comprobados mecánicamente, los registros encadenados por hash, la reproducción determinista y una forma canónica por programa, aparecen en sus descripciones de otros proyectos desarrollados de forma independiente. Esta es una observación de que las decisiones se repiten. No es evidencia de que sean correctas, y este artículo no hace ninguna comparación con esos proyectos.
4. El motor: engranajes, compuerta y recibos
4.1 El motor es una Forma
RCE ejecuta el software como un grafo de pequeños manejadores deterministas. Un manejador que no puede decidir eleva una escalada. Un resolutor responde la escalada una vez, y la respuesta se instala como manejador permanente, de modo que el siguiente caso con la misma forma se ejecuta sin resolutor. El motor cumple cada invariante de la Forma, cada uno comprobado por una prueba con nombre en tests/form_laws.rs:
| Invariante | Qué hace el motor |
|---|---|
| Recargar es un plegado verificado | La recarga lee el registro literalmente, recalcula cada hash y enlace, y pliega el resto con . Nada se vuelve a sellar. Una cadena rota se niega a cargar. |
| Orden de tics sin nombres | Los manejadores se ejecutan en orden de rango topológico y luego por una clave de nodo sin nombre. Las salidas se preparan y se entregan después de que se ejecutan todos los manejadores, como en la semántica ASM. Renombrar todos los nodos da el mismo hash de estado anónimo en cada entrada. |
| Ningún descarte silencioso | Un buzón lleno retiene el mensaje en una cola ordenada y registra Backpressure. Con capacidad 1 y 10 tareas, se registran 9 entradas Backpressure y las 10 tareas se cierran. |
| Las cargas útiles están en el registro | Entradas, tics, resultados de manejadores externos, instalaciones y fallos son entradas del registro. El hash de estado tras cada entrada coincide con un plegado desde un motor vacío, en 1,000 registros aleatorios. |
| Reloj lógico | La vivacidad cuenta tics, no tiempo de pared. |
| Hashes estables | SHA-256 (Secure Hash Algorithm, 256 bits) sobre JSON canónico, con claves ordenadas en cada nivel, para entradas, estados, formas e identificadores de reglas. |
4.2 Los engranajes
Cada engranaje se prueba solo cuando el engranaje inferior no pasa la compuerta. Ese orden es una cascada fija.
| Engranaje | Método | Linaje |
|---|---|---|
| G0 Búsqueda | Una biblioteca compartida de manejadores indexada por el hash SHA-256 de la forma; para reparación de código, localización en funciones ordenadas | Búsqueda y recuperación de código [21] |
| G1 Reglas | Plantillas de reparación deterministas y guardadas, y validadores derivados de esquemas, cada uno comprobado en sensibilidad a mutaciones | PAR, TBar, AVATAR, FixMiner [22, 23, 24, 25]; codemods como Coccinelle [26] |
| G2 Síntesis | Enumeración sobre la gramática de manejadores, solucionadores y e-grafos | Bocetado, SyGuS, egg [27, 9, 12] |
| G3 a G5 Modelos | Un modelo de decisión tipado, un modelo local pequeño y después, al final, un modelo remoto | Cascadas de modelos [28] |
4.3 La compuerta
Un candidato se promueve solo cuando pasa la compuerta. La compuerta reproduce las entradas registradas del nodo, ejecuta el candidato en sombra sobre muestras nuevas con una cota de cobertura (la regla del tres a un presupuesto de error declarado), comprueba el esquema de salida y exige el certificado de demostración de la Sección 5. Un candidato rechazado se registra con su contraejemplo.
4.4 Recibos
Cada promoción, rechazo, aplazamiento e instalación es una mutación en un registro de solo anexado encadenado con SHA-256, de modo que alterar cualquier entrada pasada rompe la cadena [29, 30]. El coste de cada manejador se valora a partir de los recuentos de operaciones del intérprete con la tabla de costes del anfitrión de FGIR, el backend de código nativo de flowG, y se etiqueta est_j. Cada llamada al capataz lleva su recibo. Un recibo nombra el engranaje, el método de la estimación (basis), los candidatos probados y si el engranaje resolvió la escalada. Su campo est_j es obligatorio: es un número finito no negativo, o null, y null solo se permite cuando basis dice unpriced, como en una llamada a modelo sin cifra de energía. Un recibo al que le falta el campo no supera el análisis sintáctico. Un coste sin valorar nunca se lee como cero, así que un total sobre recibos informa por separado sus invocaciones valoradas y sin valorar, y un ahorro que depende de una resolución sin valorar se informa como desconocido. Las ejecuciones de la escalera añaden un contador de energía del paquete sobre una submuestra, etiquetado reported_j.
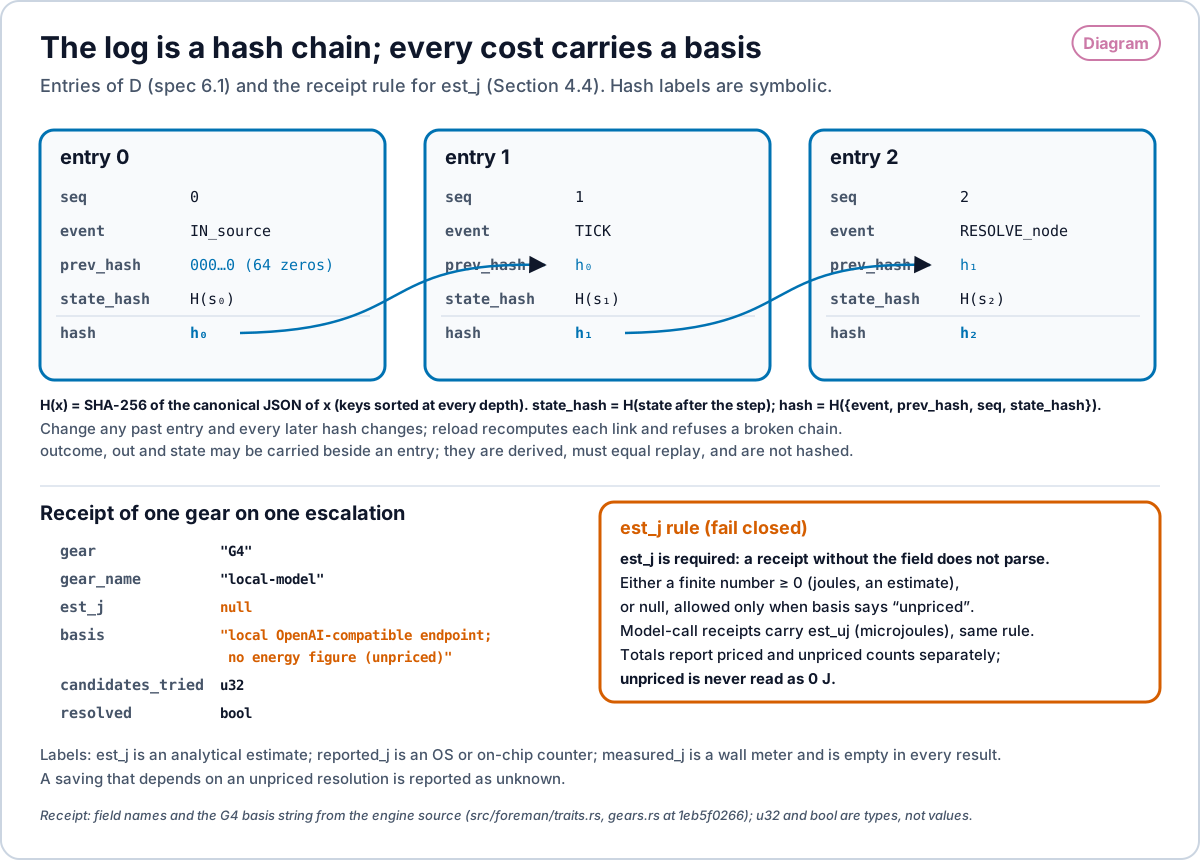
{seq, event, prev_hash, state_hash, hash}. state_hash es el SHA-256 del JSON canónico del estado tras el paso; hash es el SHA-256 del JSON canónico de {event, prev_hash, seq, state_hash}; el primer prev_hash son 64 ceros, así que cambiar cualquier entrada pasada cambia todos los hashes posteriores. Un recibo de engranaje lleva gear, gear_name, est_j, basis, candidates_tried y resolved. est_j es obligatorio y es un número finito no negativo, o null solo cuando basis dice unpriced; los recibos de llamadas a modelos llevan est_uj en microjulios bajo la misma regla. Un coste sin valorar nunca se lee como 0 J. Las etiquetas de hash son simbólicas. Fuente: especificación 6.1 y Sección 4.4. Se ofrece una copia PNG. Open full size · PNG
4.5 El compilador de la Forma
rce form toma una especificación y su ajuste y emite cinco destinos a partir de una IR de la Forma:
.rce spec + fit
  lower ─► normalize ─► egg e-graph, equality saturation (+ admitted proposals)
  ─► extract (cost = est_j) ─► Form IR (typed relations, regions, rules with SHA-256 ids)
     ├─ Rust crate (pure step, typed state, SHA-256 log and fold, tests)
     │  └─ WASM (the same crate on wasm32-wasip1)
     ├─ Python (standard library only)
     ├─ XState v5 machine
     └─ SCXML document, executed by SCION
La IR fija un comportamiento en cada borde numérico: el desbordamiento comprobado de enteros de 64 bits es un error y nunca da la vuelta; la / entera trunca hacia cero (); % toma el signo del dividendo (); la división por cero es un error; los flotantes son IEEE 754 binary64 y un resultado no finito es un error; nulo y ausente son distintos; el tiempo es solo el reloj lógico. Todo destino es generado. Ninguno es escrito a mano.
Un manejador de proceso, HTTP o clausura no tiene término, así que sus resultados registrados se compilan en un oráculo registrado indexado por el SHA-256 de la entrada canónica. rce scan DIR --form eleva Rust, Python, TypeScript y Go existentes al esquema de la Forma, y cada elemento elevado se etiqueta como elevación sintáctica.
4.6 Método: toda la pila evaluada, cada supuesto de interfaz explícito
Un programa es una pila de niveles: tokens y sentencias; manejadores; la Forma, una única función de paso sobre (regiones de control; datos: el reloj, el contador de entradas y las relaciones tipadas); el registro, una cadena de hashes SHA-256 cuyas entradas anotan cada evento, el hash del estado que produjo y el hash de la entrada anterior; las reescrituras que transforman la Forma; y el sustrato que la ejecuta. Cada nivel descansa sobre supuestos acerca del nivel inferior. RCE no trata ningún nivel como fijo. Evalúa toda la pila, escribe cada supuesto de interfaz como un enunciado comprobable y lo comprueba en cada ejecución.
| Frontera | Supuesto | Comprobación |
|---|---|---|
| fuente a manejador | una entrada satisface su contrato de fuente | la comprobación del contrato en el evento de entrada de δ |
| manejador a sumidero | toda salida Ok satisface el esquema de salida | demostración del manejador (verify::handler_proof), total y determinista por el evaluador del núcleo comprobado con Kani |
| registro a estado | cada entrada lleva el hash del estado que produjo | plegado del núcleo, que rechaza la primera entrada cuyo hash no coincide (arnés de Kani fold_rejects_wrong_state) |
| reescritura a Forma | una reescritura conserva la salida para toda entrada | comprobación aleatorizada, y después una demostración SMT con Z3 |
| stub a capataz | un manejador que no puede decidir escala en lugar de adivinar | los manejadores stub emiten escaladas; las resoluciones se promueven solo por la vía de promoción |
| Forma a destino | todo destino emitido calcula la misma δ | todo destino lleva la misma traza de referencia |
Una comprobación fallida localiza la ruptura en la frontera donde ocurre. La corrección se hace en ese nivel, pasa por la comprobación de esa frontera y se promueve. Todo nivel por encima del corregido hereda la corrección sin más cambios, porque cada nivel superior consume el nivel corregido solo a través de la interfaz cuyo supuesto ahora se comprueba. Este es el sentido en que las correcciones se propagan hacia arriba y se acumulan. La demo del motor de RCE lo ejecuta en el navegador sobre el núcleo de RCE compilado a WebAssembly: su capa Interfaces rompe cada supuesto y muestra la comprobación que lo detecta, y su capa Compounding muestra la corrección propagándose a cada ronda posterior.
5. Verificación
5.1 Pruebas diferenciales entre cinco destinos
tests/form_targets.rs ejercita una especificación aritmética de once operadores con 29 eventos de borde más 500 valores de borde aleatorios con semilla. Los destinos generados en Rust, Python, WASM, XState y SCXML imprimen la traza de referencia byte a byte, incluidos los bordes aritméticos. Esto es prueba diferencial en la línea de McKeeman y de Csmith [86]: concordancia entre implementaciones independientes sobre un conjunto de entradas declarado. No es validación de traducción [85] ni un compilador verificado. Cubre los once operadores y los 529 eventos de la prueba, y no dice nada sobre entradas fuera de ellos. Los resultados de Z3 y Kani que siguen son la verificación.
La Figura 11 muestra las cinco proyecciones de una Forma y el viaje de ida y vuelta de los dos destinos de diagrama de estados.
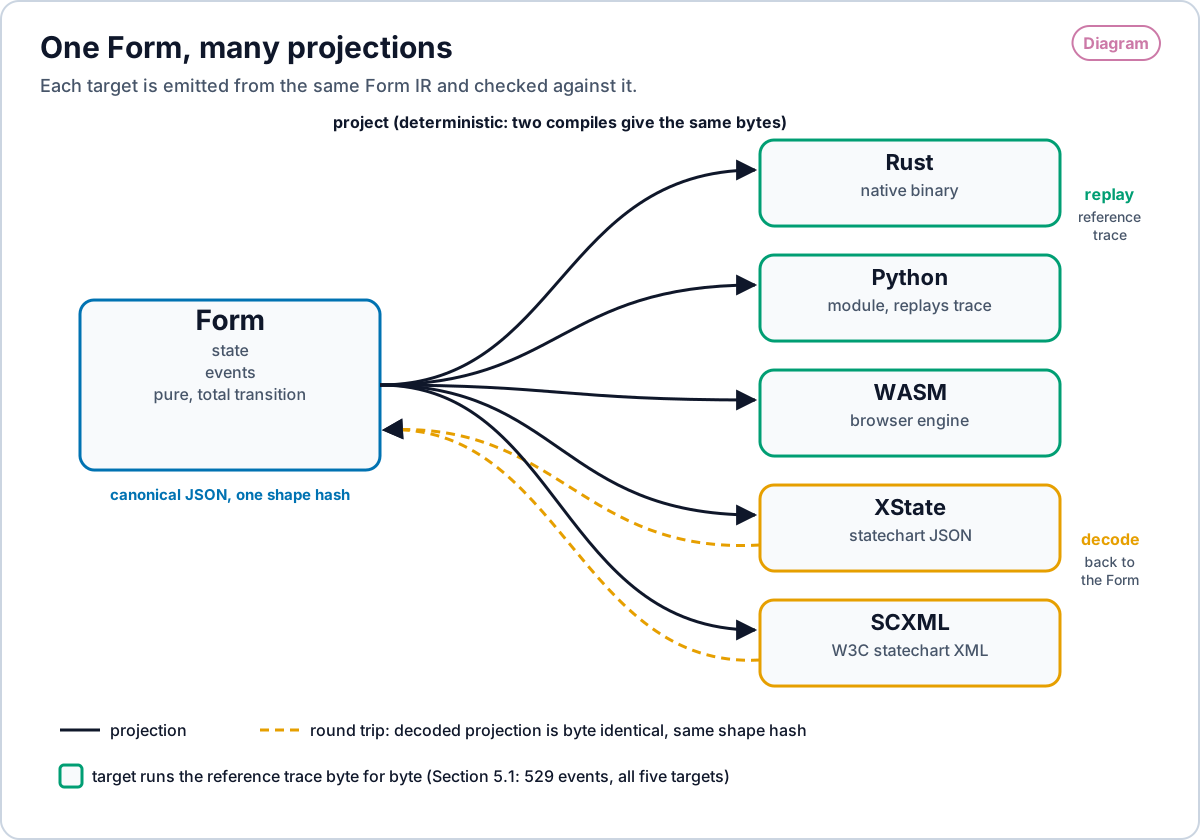
tests/form_targets.rs. Se ofrece una copia PNG. Open full size · PNG
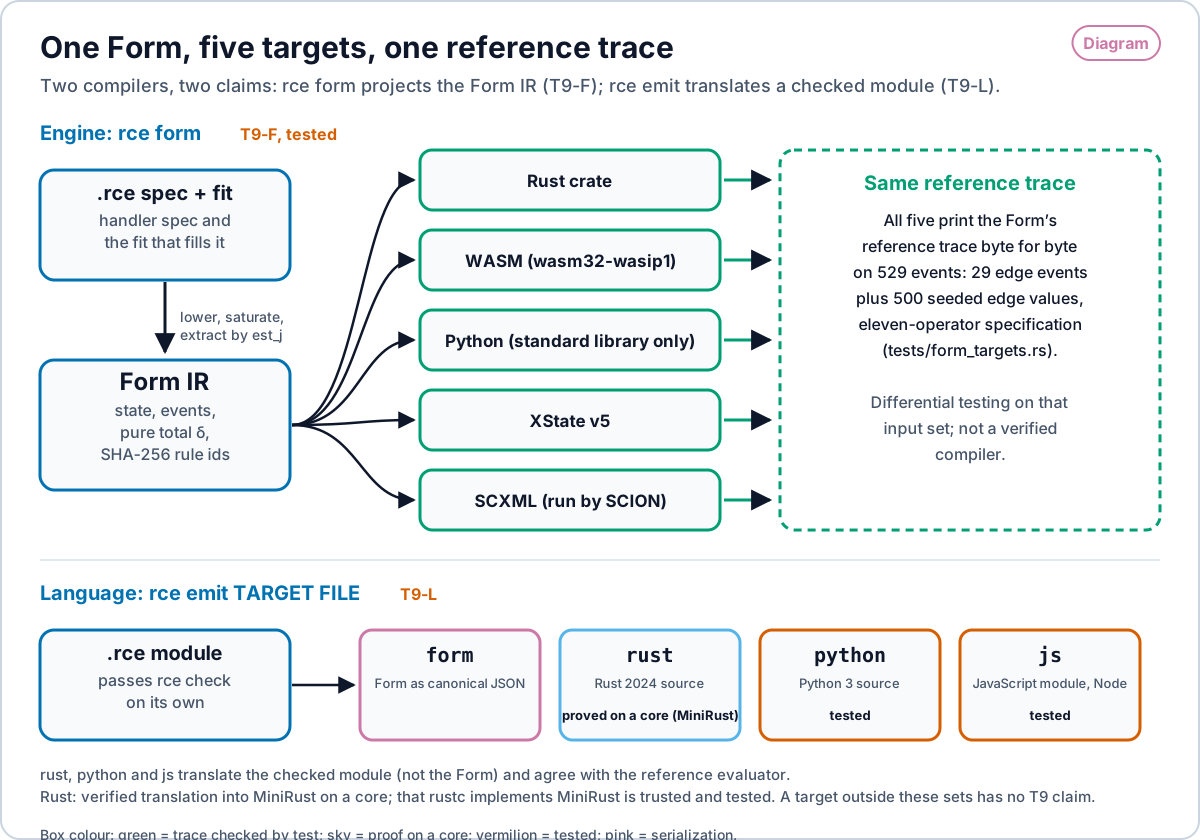
rce form rebaja una especificación de manejador y su ajuste a la IR de la Forma y la proyecta a un crate de Rust, WASM, Python, XState v5 y SCXML; los cinco imprimen la traza de referencia byte a byte en 529 eventos (29 eventos de borde más 500 valores de borde con semilla de una especificación de once operadores, tests/form_targets.rs). Esto es T9-F, establecido por pruebas diferenciales, no un compilador verificado. Abajo: rce emit TARGET FILE traduce un módulo comprobado (no la Forma) a JSON form, rust, python o js; T9-L está demostrado para el emisor de Rust sobre un núcleo como traducción verificada a MiniRust (que rustc implementa MiniRust se asume y se prueba), y probado para los demás. Se ofrece una copia PNG. Open full size · PNG
5.2 Reescrituras demostradas en Z3
Las reglas de reescritura verificadas tienen un linaje. Ruler infiere y comprueba reglas de reescritura por saturación de igualdades sin ningún modelo en el bucle [87]. Las 3 de 16 reglas propuestas por el modelo admitidas en la Sección 5.5 son, por tanto, un enunciado sobre la compuerta, que rechazó 13, y no una afirmación de que un modelo sea la mejor fuente de reglas.
Cada reescritura incorporada del e-grafo se demuestra en el solucionador SMT Z3 (satisfacibilidad módulo teorías) [31] frente a una codificación sin cuantificadores de la evaluación de términos y la aritmética de la Forma: valores como tipo de datos, vectores de bits de 64 bits con desbordamiento comprobado, división y resto con signo que toman el signo del dividendo, y flotantes binary64. Una reescritura que cambia el desbordamiento, el orden de escalada o un mensaje no obtiene demostración. Una equivalencia propuesta entra en el e-grafo solo con una demostración.
5.3 Demostraciones de Kani sobre el núcleo
El núcleo del motor (cadena de hashes, plegado, posiciones sin nombres y evaluación de manejadores) se comprueba con el verificador de modelos Kani para Rust [32]. La evaluación de manejadores es el punto fijo de un paso no recursivo, y Kani demuestra que ese paso es total y determinista por constructor, por inducción estructural. Se verifican diez arneses con Kani 0.67.0, con 0 de 7,425 comprobaciones fallidas:
| Arnés | Propiedad |
|---|---|
chain_appended_verifies | Una cadena de hashes anexada se verifica |
chain_detects_tampering | Una entrada modificada rompe la cadena |
fold_equals_replay | El plegado es igual a la reproducción |
fold_rejects_wrong_state | Se rechaza un plegado que discrepa del estado almacenado |
position_is_name_independent | Las posiciones de las reglas no dependen de los nombres de los nodos |
reason_tokens_are_name_independent | Los motivos no dependen de nombres, por tokens completos |
handler_core_leaves | Los manejadores hoja son totales y deterministas |
handler_core_validate | La validación es total y determinista |
handler_core_pipeline | Las tuberías son totales y deterministas |
handler_core_ifhas | Las guardas son totales y deterministas |
5.4 Compuerta de promoción sobre el certificado de demostración
La ejecución de Kani escribe un certificado cuyo hash se guarda en proofs/kani.cert. El motor, el registro, los identificadores de reglas y la evaluación de manejadores pasan por el núcleo demostrado, y la promoción exige el certificado.
5.5 El modelo como proponente detrás de la comprobación
Un modelo puede proponer equivalencias. No puede admitirlas. Con un modelo local de programación de 1.5 mil millones de parámetros (Qwen2.5-Coder-1.5B bajo llama.cpp) sobre la especificación de demostración, el proponente ofreció 16 equivalencias. La comprobación admitió 3, mediante ensayos aleatorizados y una demostración en Z3, y rechazó 13. Un proponente determinista de 87 identidades conocidas, 77 aritméticas y 10 estructurales, tuvo 9 admitidas, todas estructurales, y 78 rechazadas: todas las identidades aritméticas, por orden de fallos, valores no numéricos o desbordamiento, y una reescritura estructural, const-absorbs-pipe, que descartaría un prefijo que escala (prueba del motor tests/form_proposers.rs).
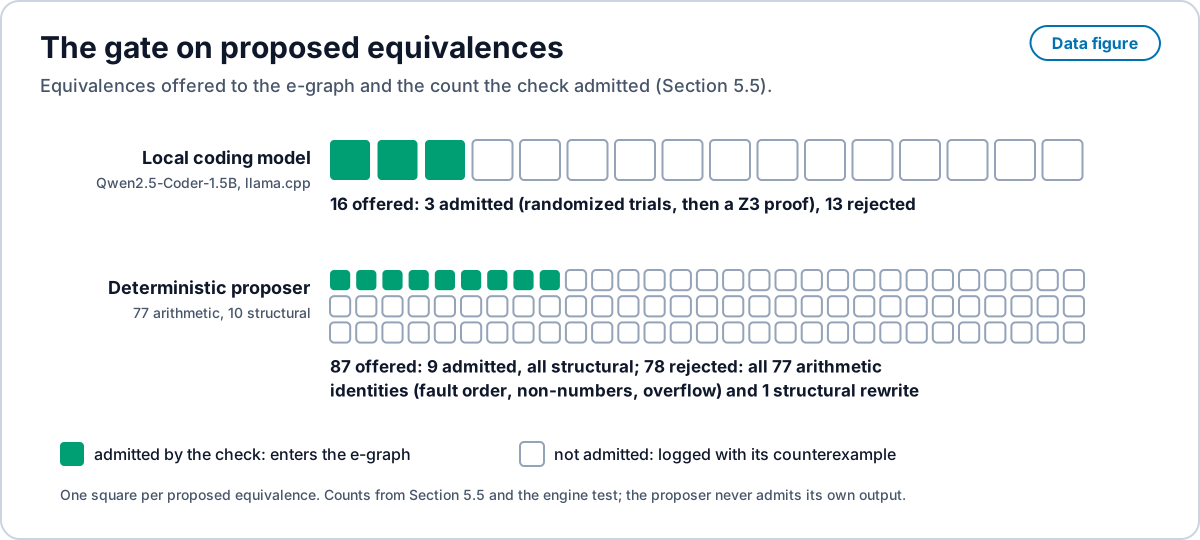
tests/form_proposers.rs. Se ofrece una copia PNG. Open full size · PNG
5.6 Concordancia con código existente
La elevación lee la misma máquina de pedidos a partir de fixtures en Rust, Python, TypeScript y Go, ejecuta el código original en 40 secuencias con semilla de 30 llamadas, y concuerda en las 1,200 llamadas por lenguaje. Un banco de pruebas congelado, preregistrado antes de cualquier resultado, reexpresó tres programas existentes de prospección comercial como Formas. Las Formas concuerdan con el código original en 4,500 de 4,500 entradas registradas, y la extracción reduce est_j en cada una (por ejemplo, de J a J).
6. Elevación: entrar en el ecosistema desde otros lenguajes
La elevación es la puerta de entrada al ecosistema para el código escrito en otra parte. Es una construcción, hecha por lenguaje con herramientas que todo lenguaje ya tiene: una gramática formal, un analizador como tree-sitter que produce el árbol de sintaxis, el árbol de sintaxis abstracta y los símbolos que resuelven las herramientas de servidor de lenguaje (Language Server Protocol). rce scan DIR --form construye la Forma a partir de ese árbol para Rust, Python, TypeScript y Go (§4.5, §5.6). Un programa elevado arrastra los fallos de su fuente, así que la elevación incluye la reparación, medida a continuación sobre corpus públicos de errores con la ubicación dada. Dentro del ecosistema estos fallos no pueden escribirse.
6.0 La escalera de reparación sobre código elevado
Aquí una tarea de programación se mide por los bits de intención que necesita: los bits que deben aportarse desde fuera de lo que el motor ya contiene (el programa en torno a la edición, las bibliotecas, las pruebas, el índice de correcciones conocidas). Escribiendo para los bits que determinan el artefacto objetivo y para los bits que el corpus ya fija, los bits aportados son . Un engranaje que sitúa la edición correcta en el puesto entre sus candidatos ha aportado bits de búsqueda, y la compuerta aporta el resto. La escalera ordena las tareas por tamaño de la edición, un indicador objetivo de : un token (L0), una sentencia (L1), un bloque (L2), varios bloques en un archivo (L3), varios archivos (L4), una función a partir de una especificación o de pruebas (L5), un cambio a nivel de incidencia (L6) y un programa a partir de una especificación (L7). Los peldaños, corpus, particiones e hipótesis se preregistraron antes de las ejecuciones completas; los archivos están en el repositorio público.
| Peldaño | Corpus de prueba reservado | N | Resueltas | Tasa | IC de Wilson al 95% | Mediana de bits de búsqueda | Llamadas a modelos |
|---|---|---|---|---|---|---|---|
| L0 un token | Mutantes al estilo PIT [109] de 9 repositorios reales en commits fijados (Java: commons-math, commons-collections, jsoup, joda-time, gson; Python: click, attrs, pydantic, sympy) | 520,821 | 520,541 | 0.9995 | 0.9994 a 0.9995 | 2.3 | 0 |
| L0 un token, repositorios nunca usados para ajuste | commons-text, commons-io, more-itertools, httpx | 23,015 | 23,015 | 1.0000 | 0.9998 a 1.0000 | 2.0 | 0 |
| L1 una sentencia, Java | Correcciones de un solo bloque de ManySStuBs4J 2.0 [107] | 24,072 | 9,288 | 0.386 | 0.380 a 0.392 | 3.5 | 0 |
| L1 una sentencia, Java, archivo completo | ManySStuBs4J 2.0 [107], archivo del commit padre con los índices de métodos y de guardas del proyecto | 21,320 | 13,586 | 0.637 | 0.631 a 0.644 | 4.8 | 0 |
| L1 una sentencia, Python | TSSB-3M v1.0.0, fragmentos 14 y 15 [108] | 157,089 | 27,266 | 0.174 | 0.172 a 0.175 | 4.8 | 0 |
La Figura 14 representa las filas de la tabla con sus intervalos.
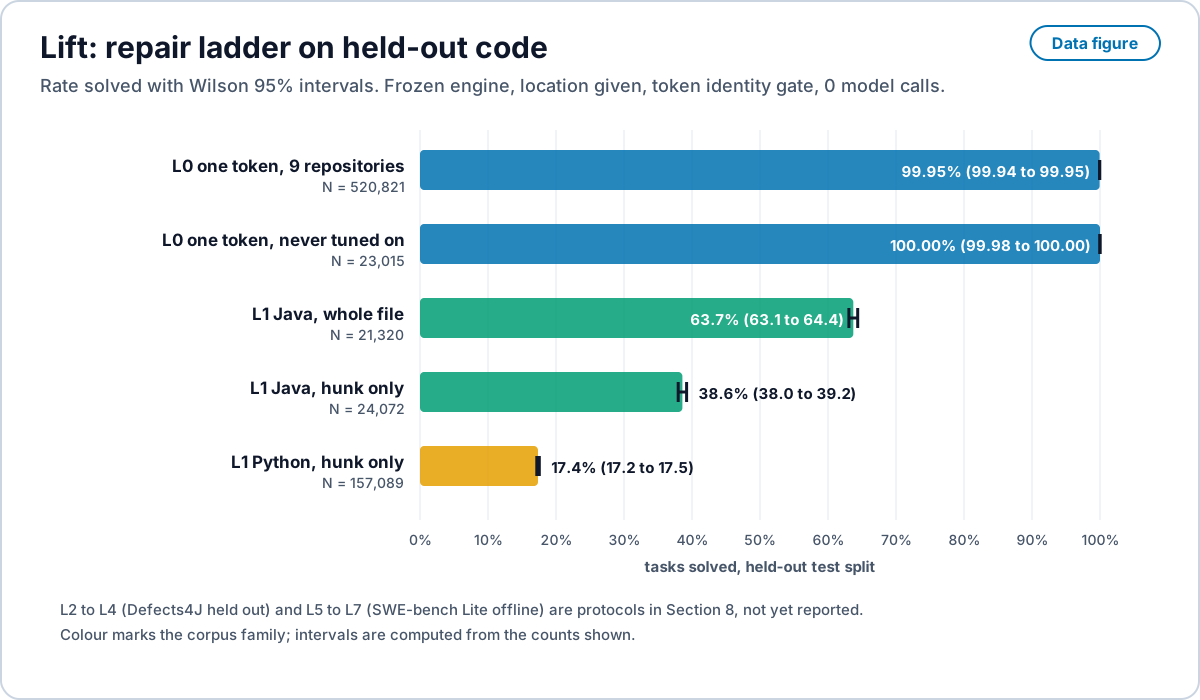
bench/ladder. Se ofrece una copia PNG. Open full size · PNG
L2 a L4 se miden en el conjunto reservado de Defects4J de 288 errores (Sección 8.1). L5 a L7 siguen los protocolos de la Sección 8.2. A continuación se dan el método, la compuerta y la energía de cada fila.
Cuestión abierta: línea base para la tasa de un token. Las filas L0 miden con qué frecuencia un vecindario de un solo token ordenado por una distribución previa restaura un mutante de un token. Si el vecindario se construye a partir de las mismas tablas de operadores que produjeron los mutantes, una tasa alta refleja en parte ese solapamiento y no la capacidad de reparar fallos que surgen en la práctica. El artículo cita este riesgo de acoplamiento y no da ninguna cifra para él. Una búsqueda simple por inversión de operadores, ejecutada sobre los mismos mutantes, es la línea base que mostraría cuánto de la tasa explica. Esa línea base no se ha ejecutado, así que aquí no se da ninguna cifra y la tasa de un token queda expuesta a esta objeción.
Las tasas se leen como bits de intención. En L0 los bits que faltan están casi todos en la línea, y un vecindario de un solo token ordenado por una distribución previa los aporta con una mediana de 2.3 bits. En la fila L1 de solo bloque el motor ve solo el bloque de 7 líneas. Cierra las categorías cuyos bits están dentro del bloque (Java: operador cambiado 91%, literal booleano intercambiado 84%, argumentos intercambiados 82%; Python: literal booleano cambiado 98.8%, argumentos intercambiados 99.4%) y deja abiertas aquellas cuyos bits están fuera: los nombres de métodos (22%) y los identificadores (37%) necesitan el archivo y sus tipos, y las conjunciones nuevas (3% a 7%) y las reescrituras de sentencias completas (Python, 1.2% de una categoría que es el 34% del corpus) son intención nueva. La intención nueva es lo que un proveedor (una especificación, una prueba, una persona o un modelo local) aporta una vez, tras lo cual el ajuste está en el índice.
Método. Cada corpus se baraja con una semilla fija. Las primeras 2,000 posiciones de cada barajado, y para L0 tres repositorios completos (commons-lang, requests, flask), forman la partición de desarrollo, sobre la que pueden ajustarse los engranajes; los resultados de desarrollo no se informan. Toda tarea restante está en la partición de prueba. Antes de una ejecución de prueba, el motor se confirma en el repositorio y se registra su hash binario, y ningún engranaje cambia durante la ejecución. Cada fila de esta sección es un resultado con el motor congelado solo sobre tareas de prueba, con 0 llamadas a modelos. El preregistro (PREREG.json), las filas por tarea y el script del informe están en el repositorio público.
Compuerta. En L0 y L1 la ubicación se da y la compuerta es la identidad de tokens: la línea o sentencia reparada debe ser igual a la del desarrollador, token por token. Esto es más estricto que pasar las pruebas, porque un parche puede pasar un conjunto de pruebas débil y aun así ser erróneo. Qi y sus colegas encontraron que la mayoría de los parches que GenProg informó como correcciones eran plausibles pero incorrectos [92]; el sobreajuste a las pruebas está documentado en la reparación basada en búsqueda y en la basada en semántica [93, 94] y se aborda con pruebas generadas [95]; las herramientas puntúan más alto en el banco de pruebas en que se ajustaron [96]; y la localización de fallos sesga las comparaciones [97]. La identidad de tokens elimina la brecha de plausibilidad en estos peldaños, y dar la ubicación elimina el término de localización, así que la tasa mide solo los engranajes de reparación. L2 y superiores usan las pruebas como compuerta e informan por separado los recuentos plausibles y correctos (Sección 8.1).
6.1 L0: fallos de un solo token
El corpus L0 es cada mutante al estilo PIT [109] con un token de reemplazo válido en nueve repositorios reales en commits fijados, cinco Java y cuatro Python: 520,821 tareas de prueba de 547,448. El motor (commit 65571d0, engranajes G0-T y G1-J) restaura 520,541, una tasa de 0.9995 (intervalo de Wilson al 95%: 0.9994 a 0.9995) con una mediana de 2.3 bits de búsqueda. De las 280 no resueltas, 108 son dígitos mutados dentro de literales de coma flotante y 2 están dentro de literales de conjunto de Python. Un engranaje de literales flotantes (G0-F, commit ecfe5a1) se prueba en cuatro repositorios nunca usados para ajuste (commons-text, commons-io, more-itertools, httpx): 23,015 de 23,015 tareas, 1.0000 (0.9998 a 1.0000), con una mediana de 2.0 bits de búsqueda. Los mutantes sustituyen a fallos reales de un solo token, y Just y sus colegas encontraron que están acoplados con fallos reales [110].
6.2 L1: errores de una sola sentencia de historiales reales
L1 usa dos conjuntos de datos públicos de correcciones reales de errores de una sola sentencia, extraídos de historiales de código abierto. ManySStuBs4J 2.0 [107] da 24,072 tareas de prueba en Java; el motor (commit f2701b7) resuelve 9,288, una tasa de 0.386 (0.380 a 0.392). TSSB-3M v1.0.0 [108] da 157,089 tareas de prueba en Python de los fragmentos 14 y 15; el mismo motor resuelve 27,266, una tasa de 0.174 (0.172 a 0.175). El motor recibe solo el bloque de 7 líneas, así que esa tasa de Java es un resultado de solo bloque. Con el archivo completo en el commit padre, con índices de los métodos y de las condiciones de guarda del proyecto y con los engranajes para nombres de método cambiados, argumentos añadidos, condiciones de guarda, throws y modificadores (commit 62fb7a0, prefijo sha256 del binario 3682c6515acdf722, preregistrado antes de la ejecución), el motor resuelve 13,586 de las 21,320 tareas de prueba en Java cuyo archivo y sentencia errónea pudieron localizarse, una tasa de 0.637 (0.631 a 0.644). Por categoría cierra operadores cambiados (95.9%), operandos cambiados (92.1%), llamadores erróneos (87.9%), literales booleanos intercambiados (88.4%), argumentos eliminados (85.1%) y argumentos intercambiados (83.3%); los nombres de método cambiados alcanzan el 61.4% y los argumentos añadidos el 51.4%, y las condiciones nuevas o estrechadas (43.5% y 51.7%) siguen siendo la principal intención abierta. Las tablas completas por estrato están en el repositorio. Estos conjuntos de datos no tienen una clasificación publicada de reparación con esta compuerta (solo bloque, identidad de tokens, ubicación dada), así que no se coloca a su lado ninguna cifra de reparación aprendida; Defects4J, que sí la tiene, se compara con TBar en la Sección 8.1.
6.3 Energía
Cada fila lleva est_j, una estimación de segundos de CPU por 10 W: 0.40 J por tarea resuelta en L0, 0.13 en los repositorios nuevos, 0.10 en ManySStuBs4J y 0.27 en TSSB-3M. Una submuestra se leyó en RAPL [105], el contador de paquete integrado en el procesador, en un portátil Linux con un Intel i9-13900H (nombre de host jetson-hub; no es una NVIDIA Jetson). El arnés se ejecutó en 4 CPU fijadas, y reported_j es el incremento del paquete durante toda la ejecución, incluido el controlador en Python, menos la potencia en reposo de una muestra de 10 s tomada justo antes, multiplicada por la duración de la ejecución. Los ejecutores de integración continua estaban activos, así que el reposo fue de 40 W a 44 W y la incertidumbre es de unos ±1 W por la duración, ±10 J en estos totales.
| Submuestra (partición de prueba) | Tareas | Resueltas | J brutos | reported_j | reported_j por tarea resuelta | Segundos |
|---|---|---|---|---|---|---|
| L0, mutantes de gson (con semilla, primeros 3,000) | 3,000 | 3,000 | 648.3 | 167.5 | 0.056 | 11.8 |
| L1, ManySStuBs4J posiciones 2,000 a 3,999 | 2,000 | 690 | 377.2 | 17.9 | 0.026 | 8.2 |
La submuestra L1 construye su índice del proyecto solo a partir de sus 2,000 tareas, así que su tasa de resolución (34.5%) es inferior a la de la ejecución completa. measured_j, un medidor de pared en un raíl nombrado, está vacío en todas las filas; su protocolo está en la Sección 8.3.
7. Evidencia de reutilización
La posición de RCE en el eje de reutilización descansa en un hecho de ingeniería: el código se reutiliza a toda escala. Cada método siguiente lo mide de forma distinta.
| Método | Fuente | Hallazgo |
|---|---|---|
| Mapeo de clones a nivel de archivo | DéjàVu, Lopes et al. 2017 [33] | De 428 millones de archivos en 4.5 millones de proyectos de GitHub que no son bifurcaciones, 85 millones son únicos: “el 70% del código en GitHub consiste en clones de archivos creados previamente”. En JavaScript, el 6% de los archivos son distintos. |
| Redundancia a nivel de línea | Gabel y Su 2010 [34] | Frente a 420 millones de líneas, “entre el 50% y el 100% de cada proyecto es redundante” a aproximadamente una línea. |
| Modelos estadísticos de lenguaje | Hindle et al. 2012 [35] | El código es “muy repetitivo, y de hecho aún más que los lenguajes naturales”. |
| Deduplicación aproximada del corpus | The Stack [36] | La deduplicación aproximada elimina el 54.7% de The Stack v1 (de 6.4 TB a 2.9 TB) y el 52.4% de v2 (de 67.5 TB a 32.1 TB). |
| Preservación del archivo completo | Software Heritage [129, 130] | 30.3 mil millones de contenidos de archivo únicos de 448 millones de orígenes (contadores del archivo, leídos el 13 de octubre de 2026), cada uno almacenado una vez por el hash de sus bytes. |
| Patrones de corrección minados | PAR, TBar [22, 23] | PAR encontró “varios patrones de corrección comunes” en más de 60,000 parches humanos. Las 15 categorías de patrones de TBar corrigen correctamente 43 errores de Defects4J en la cadena estándar, y 74 de 101 con localización perfecta de fallos, sin aprendizaje. Son cifras tal como se leen en [23]; el significado del 101 (parches plausibles o errores intentados) no se ha vuelto a comprobar aquí frente a ese artículo, así que la proporción debe tratarse como no confirmada. |
| Tareas entre lenguajes | Rosetta Code [131] | 1,360 tareas (y 421 tareas en borrador), cada una un concepto implementado en muchos de 1,009 lenguajes conocidos. |
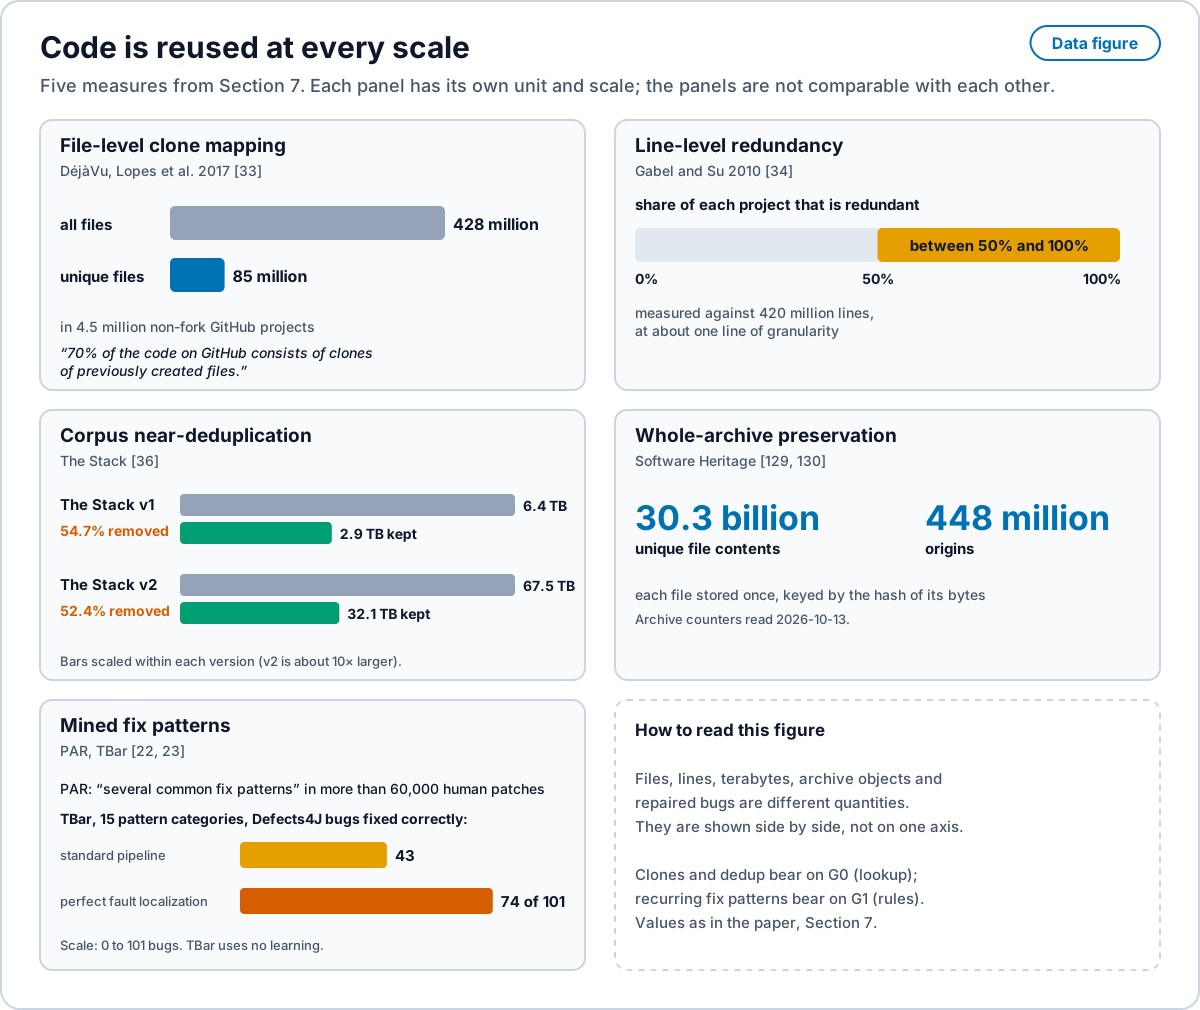
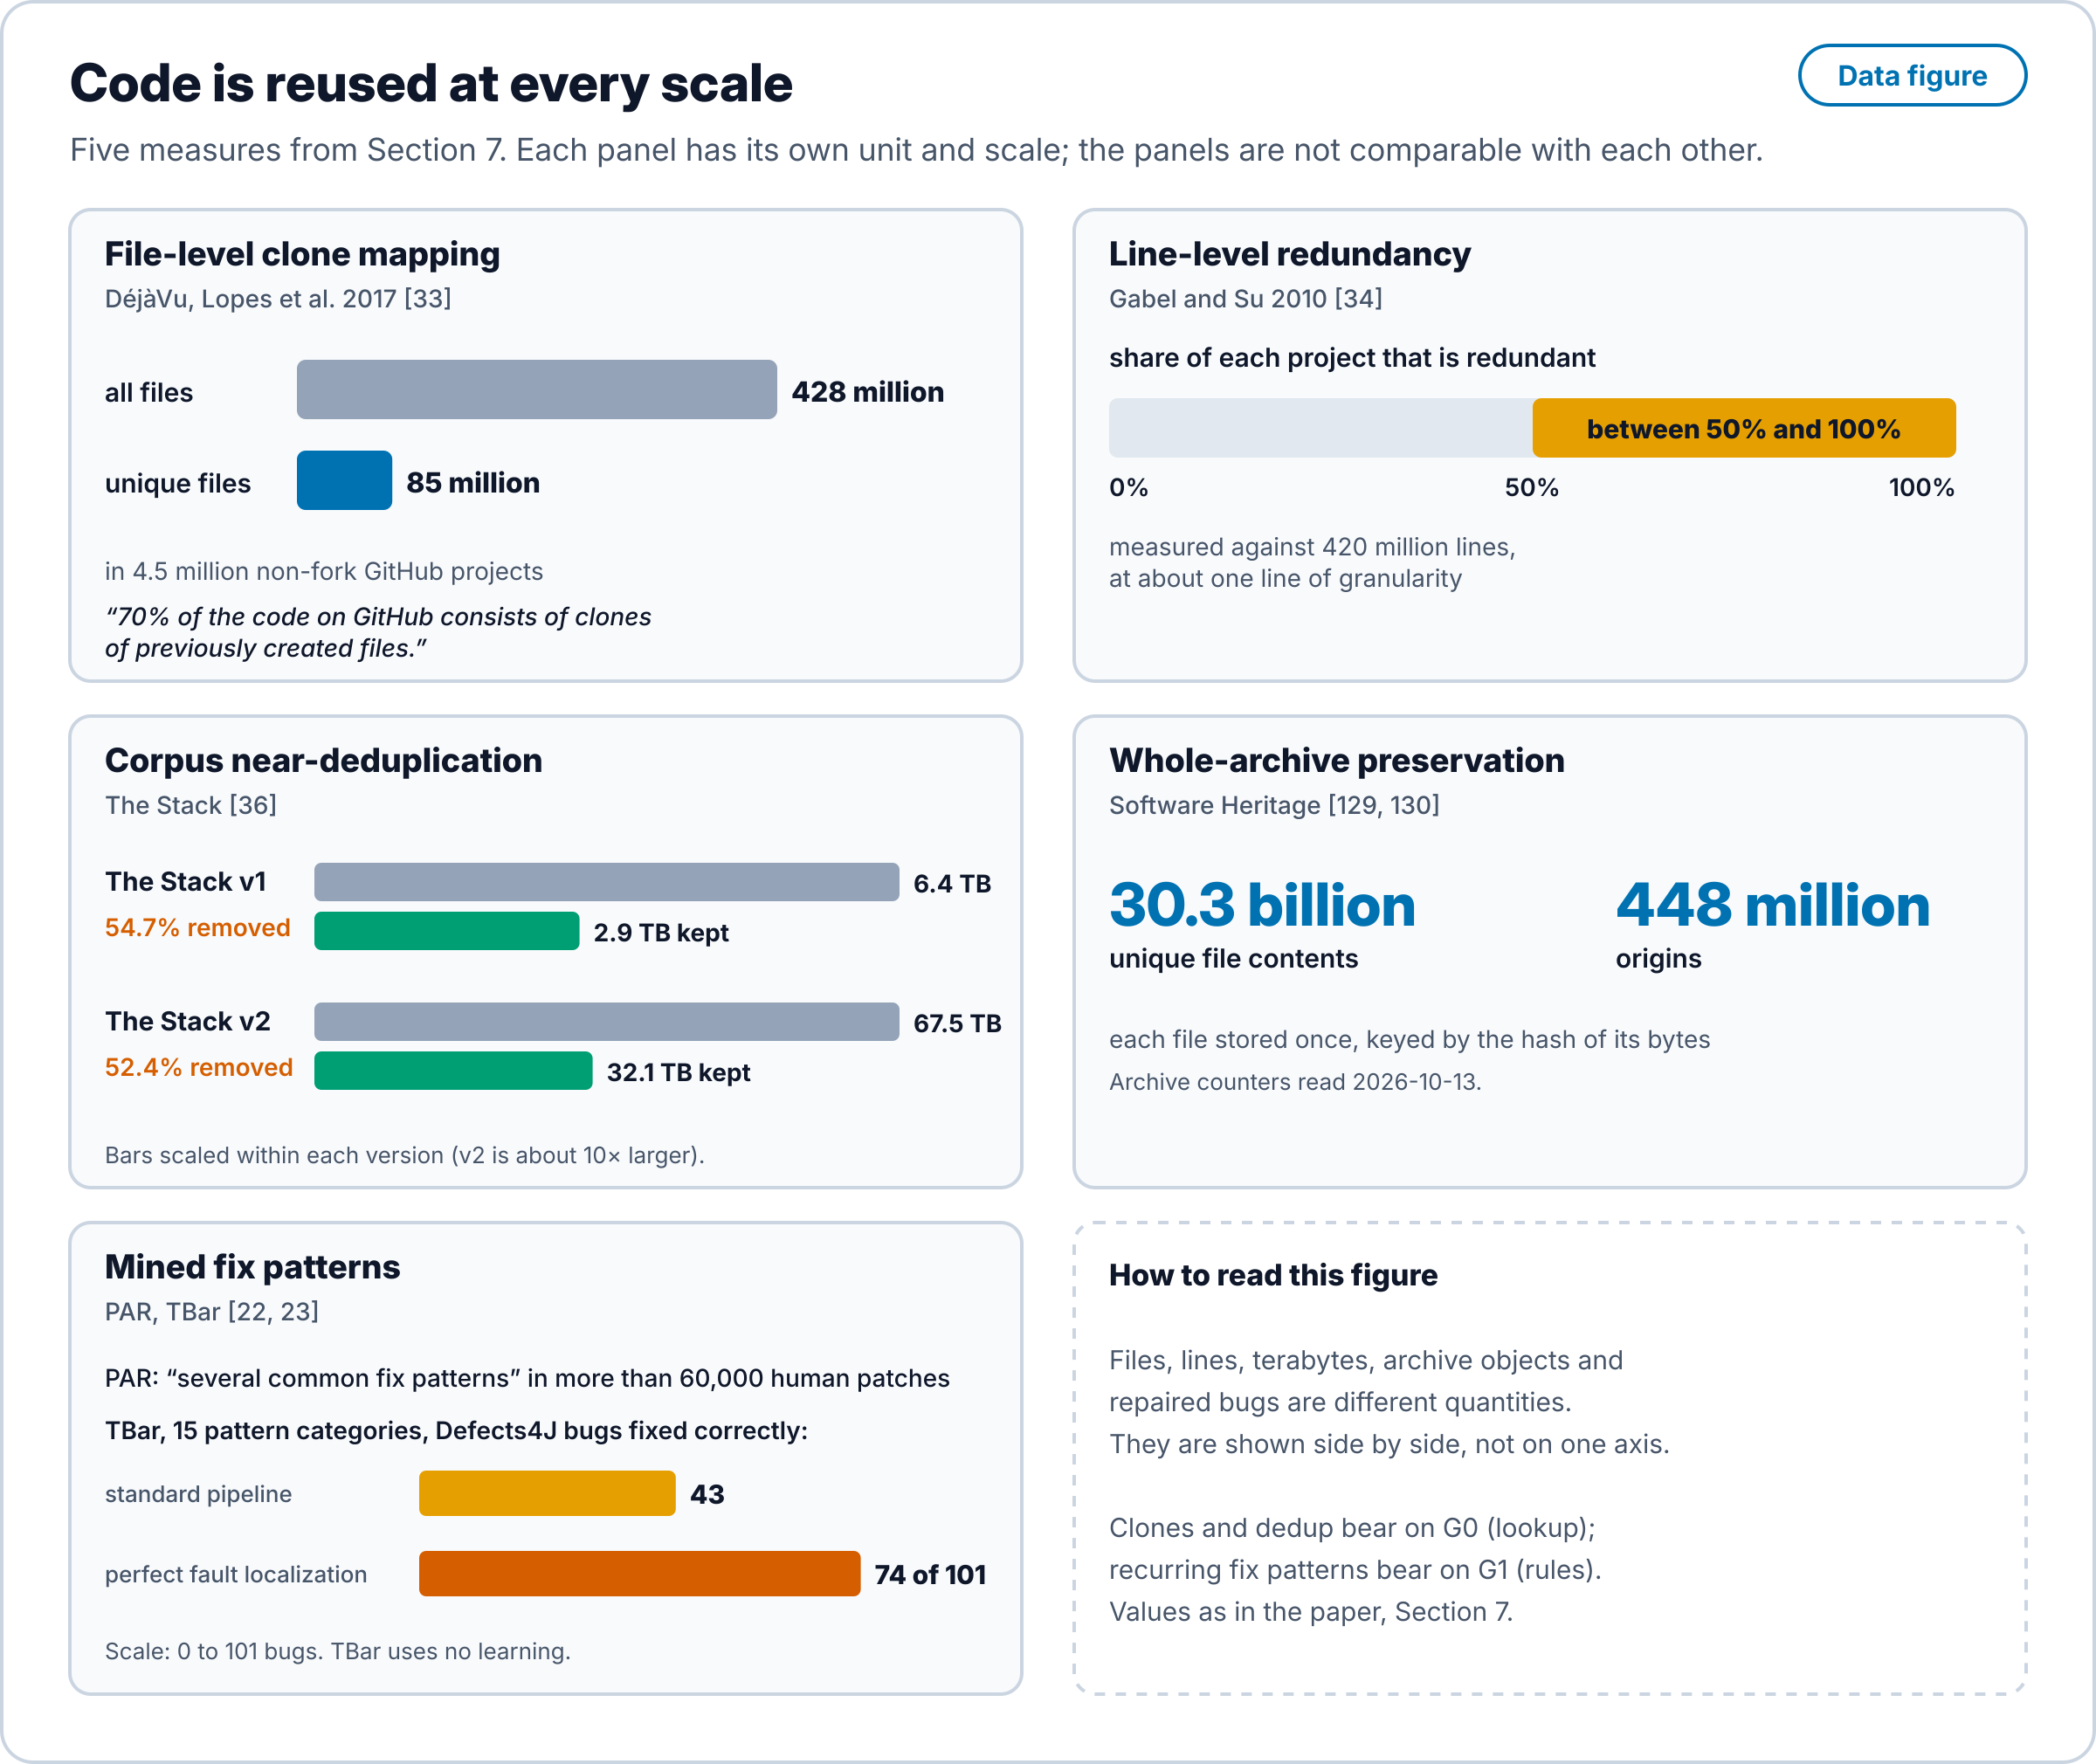
Cada fila es una entrada del motor. Los clones y la deduplicación dicen que normalmente existe un ajuste, que es G0. Las correcciones recurrentes dicen que la adaptación es en su mayoría un pequeño catálogo de reescrituras guardadas, que es G1. La redundancia a nivel de línea reduce el espacio de búsqueda de G2. El ecosistema lo mide en cada ajuste promovido (Sección 2.3), y la escalera de reparación sobre código elevado lo mide a escala sobre particiones reservadas (Sección 6). Dos advertencias afinan la lectura. Los duplicados inflan las puntuaciones de recuperación y de modelos si no se eliminan [104]. Y las líneas con errores son menos naturales que las corregidas [45], así que el error en sí es el caso que la búsqueda menos puede predecir; la forma de la corrección, no la línea con el error, es lo que G0 y G1 deben indexar. La línea de minado de reglas que hace esto a escala, desde la búsqueda de generar y validar de GenProg [88] y el modelo de corrección aprendido de Prophet [89] hasta Getafix en Facebook [90] y la reparación sin modelos de violaciones de análisis estático de Sorald [91], deriva plantillas de un historial disjunto e informa la precisión en casos no vistos [98]. Ese es el estándar que adopta la Sección 8.4.
8. Protocolos de medición para lo que sigue
Cada protocolo se fija antes de su ejecución: preregistro confirmado, semillas y commit del solucionador registrados, cada artefacto conservado. Primero la compuerta, después los julios, siempre las etiquetas.
8.1 Defects4J
Defects4J contiene 854 errores reales activos de Java, cada uno con pruebas que lo reproducen [37].
- Desarrollar sobre un subconjunto de 100 errores, sin conexión, mediante
defects4j checkout; informar solo resultados reservados, sobre un conjunto disjunto de 288 errores congelado antes de la ejecución (FROZEN-heldout-v1). - Ejecutar G0, luego G1, luego G2 y por último un modelo local. Registrar el engranaje que cerró cada error.
- Compuerta: pasan las pruebas desencadenantes y el conjunto completo. Informar por separado los recuentos plausibles y correctos; correcto significa equivalente al parche del desarrollador tras revisión.
- Informar las llamadas a modelos por corrección correcta y los julios por corrección correcta, etiquetados.
- Puntos de referencia: las 43 correcciones correctas de TBar y sus 74 de 101 con localización perfecta (cifras tal como se leen en [23], con el denominador no comprobado de nuevo aquí). Esta sección es un protocolo. En este artículo no se informa ningún resultado de este motor en Defects4J.
- Control de contaminación: marcar cada error cuya corrección aparece literalmente en el índice de G0, e informar con y sin los errores marcados.
8.2 SWE-bench Lite, sin conexión
SWE-bench Lite es un subconjunto de 300 tareas de incidencias reales de GitHub resueltas mediante pruebas ocultas [38].
- Usar el arnés oficial de Docker sin red.
- Primera ejecución: solo G0 y G1, cero llamadas a modelos. Este es el piso de resolver sin modelo.
- Segunda ejecución: añadir un modelo local como último engranaje.
- Informar la tasa de resolución, las llamadas a modelos por tarea resuelta y los julios por tarea resuelta, etiquetados.
- Control de contaminación como en 8.1. SWE-Bench+ encontró que el 32.67% de los parches exitosos tenían la solución en el texto de la incidencia [39].
8.3 Un medidor de pared
- Conectar un medidor de pared o un medidor de derivación en la alimentación del anfitrión, registrado a una frecuencia declarada y con su reloj sincronizado con el registro de la ejecución.
- Máquina en reposo: ejecutores de CI y otras compilaciones detenidos, y una compuerta de ventana de silencio comprobada antes de cada bloque y registrada.
- Restar una línea base de reposo medida, y declarar el método.
- Rellenar
measured_jsolo a partir del medidor. Informarreported_j(RAPL) yest_ja su lado en columnas separadas. Nunca sumar entre etiquetas. - Repetir las submuestras RAPL de la Sección 6.3 bajo el medidor, y después el conjunto reservado de Defects4J.
8.4 Una ejecución reservada con los engranajes congelados
Este es el método de la Sección 6, extendido a corpus nuevos.
- Congelar G0, G1 y G2 en un commit etiquetado, registrar el hash binario y publicar el conjunto de reglas con sus marcas de tiempo de autoría.
- Extraer un segmento reservado disjunto: las instancias en Rust y Python de Multi-SWE-bench [102] y BugsInPy [103], deduplicadas frente al índice de G0 [104].
- Preregistrar el segmento, las semillas y las hipótesis antes de la primera ejecución.
- Informar por separado los recuentos resueltos, plausibles e idénticos byte a byte, cada uno con un intervalo del 95%.
8.5 Líneas base en la misma tabla
- Sin modelo:
cargo fixy clippy [106], y Sorald o un port de TBar [91]. - Modelo barato: Agentless con un modelo local [99].
- Modelo remoto: un agente con un modelo de frontera, con su energía estimada a partir de las divulgaciones del proveedor y etiquetada
est_j. - Informar el coste por acierto [101] en julios y en dólares para cada fila, con el coste controlado como exigen Kapoor y sus colegas [100].
8.6 Convergencia de las llamadas a modelos con N grande
La promoción es el mecanismo por el que el modelo sale del bucle: se paga a un resolutor una vez por un caso nuevo, la compuerta admite el ajuste como manejador, y todo caso posterior con la misma forma se cierra en G0 o G1 (Sección 4.2). La convergencia es la afirmación de que las llamadas a modelos por ronda caen a cero en una especificación fija bajo tráfico real. Se mide así.
- Extraer al menos 1,000 especificaciones de repositorios públicos, estratificadas por lenguaje y tamaño, y congelar el motor y el resolutor antes de la primera ronda.
- Reproducir tráfico de producción registrado, al menos 10,000 eventos por especificación, en rondas de tamaño fijo.
- Registrar por ronda: escaladas nuevas, llamadas a modelos, promociones, aplazamientos y julios por tarea cerrada, cada uno etiquetado (
est_j,reported_j,measured_j). - Variable principal: la proporción de especificaciones que alcanzan una ronda con cero llamadas a modelos en 20 rondas, con un intervalo de Wilson al 95%. Secundarias: llamadas a modelos por tarea cerrada por ronda, y la ronda de la última llamada a modelo.
- Informar las especificaciones que nunca convergen con su causa (una entrada atascada, una dependencia ausente, intención nueva), y ejecutar el aplazamiento de entradas atascadas como un brazo preregistrado.
Proposición 8 (aproximación al piso). A medida que crece la cobertura de G0 y G1, los julios por tarea resuelta se aproximan al piso de referencia de aplicar una corrección conocida y ejecutar las pruebas. Los peldaños de la escalera y el conjunto reservado de Defects4J bajo el medidor de pared la ponen a prueba.
8.7 Cobertura de la elevación entre lenguajes
La elevación se mide a medida que se construye. Para el lenguaje , un programa cuenta como elevado cuando pasa las pruebas propias del programa y reproduce sus trazas registradas byte a byte, y tiene el mismo hash de forma que . La muestra es de al menos 10,000 programas por lenguaje para al menos diez lenguajes, extraídos con una semilla fija de corpus públicos fijados, con el elevador congelado y su hash binario registrado antes de cada ejecución, y 0 llamadas a modelos. Cada ejecución informa la proporción elevada con un intervalo de Wilson al 95%, y cada construcción aún no elevada es una tarea de trabajo para el elevador de ese lenguaje, construida y congelada antes de la siguiente ejecución. El objetivo es todo programa en todo lenguaje.
9. Falsadores
Fijados antes de las ejecuciones que ponen a prueba.
| ID | Observación | Refuta |
|---|---|---|
| RCE-F0 | En una ejecución preregistrada de al menos 10,000 Formas, alguna proyección imprime una traza que difiere de la traza de referencia de la Forma, o se acepta alguna entrada mal formada | La afirmación de que las proyecciones son fieles y de que la compuerta rechaza en el punto de entrada |
| RCE-F1 | En el segmento reservado, G0 a G2 con reglas congeladas resuelven menos del 10% de las tareas con 0 llamadas a modelos | La afirmación de que la mayoría de los ajustes ya existen para la reparación a esta escala |
| RCE-F2 | Los parches idénticos byte a byte o equivalentes son menos de la mitad de las tareas reservadas resueltas | La lectura de la compuerta como algo más que plausibilidad en las tareas cubiertas |
| RCE-F3 | Bajo el medidor de pared, los julios brutos por tarea resuelta del solucionador RCE superan a los de la línea base con modelo más barata en las tareas que ambos resuelven | La afirmación de menor energía por tarea resuelta en las tareas cubiertas |
| RCE-F4 | En el protocolo de convergencia de la Sección 8.6, menos de la mitad de las especificaciones sin entrada atascada alcanzan una ronda con cero llamadas a modelos en 20 rondas | Compilar el modelo fuera del bucle |
10. Trabajo por terminar
Cada punto tiene su protocolo nombrado.
- La elevación construida y medida en al menos diez lenguajes con el protocolo de la Sección 8.7.
- El brazo de especificaciones: especificaciones al estilo de MBPP y HumanEval escritas como Formas y emitidas a todos los destinos.
- Resultados reservados en L2 a L4, el conjunto de Defects4J de 288 errores (Sección 8.1), y en L5 a L7 (Sección 8.2).
- Líneas base en una sola tabla, coste por acierto en julios y en dólares (Sección 8.5).
- Una serie de
measured_j: un medidor de pared en un anfitrión en reposo, al menos 10 repeticiones, bruto y neto lado a lado (Sección 8.3). - El estudio de 626 lenguajes publicado con su método (Figura 1).
- Nuevos corpus reservados con los engranajes congelados: Multi-SWE-bench y BugsInPy (Sección 8.4).
- Convergencia de las llamadas a modelos en al menos 1,000 especificaciones (Sección 8.6).
11. Conclusión
RCE es un ecosistema de código nativo. Un programa se escribe una vez, a partir de la intención, como una Forma: una codificación sin pérdida del estado, los eventos y las transiciones puras, y cada lenguaje de destino es una proyección fiel de ella. Los estados inválidos no pueden escribirse y las entradas mal formadas se rechazan en el punto de entrada, así que un programa del ecosistema no puede desviarse de su intención y no necesita comparación de diferencias ni seguimiento de errores a posteriori. Cada ajuste que pasa la compuerta se almacena y se reutiliza, y el ecosistema crece de forma acumulativa bajo una compuerta cuya corrección es monótona. En 10,000 Formas preregistradas, con el motor congelado y 0 llamadas a modelos, cada Forma hace la ida y vuelta a bytes idénticos, cada proyección es determinista, cada entrada y especificación mal formada se rechaza en el punto de entrada, y la proyección Python reproduce la traza de referencia en 9,999. El código de otros lenguajes entra por elevación, una construcción que va de la gramática de cada lenguaje a su árbol de sintaxis y de ahí a la Forma; sobre código elevado, los engranajes de reparación restauran el 99.95% de 520,821 fallos de un solo token y el 63.7% de 21,320 errores Java de una sola sentencia. Las Secciones 3.6 y 8.7 enuncian las proposiciones de universalidad y cómo se mide su construcción.
Referencias
[1] C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal 30(1), 1951. doi:10.1002/j.1538-7305.1951.tb01366.x
[2] Y. Gurevich, “Sequential Abstract State Machines Capture Sequential Algorithms,” ACM Transactions on Computational Logic 1(1), 2000. doi:10.1145/343369.343384
[3] A. Blass and Y. Gurevich, “Abstract State Machines Capture Parallel Algorithms,” ACM Transactions on Computational Logic, 2003. doi:10.1145/937555.937561
[4] N. Dershowitz and Y. Gurevich, “A Natural Axiomatization of Computability and Proof of Church’s Thesis,” Bulletin of Symbolic Logic, 2008. doi:10.2178/bsl/1231081370
[5] E. F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM, 1970. doi:10.1145/362384.362685
[6] G. H. Mealy, “A Method for Synthesizing Sequential Circuits,” Bell System Technical Journal, 1955. doi:10.1002/j.1538-7305.1955.tb03788.x
[7] E. F. Moore, “Gedanken-Experiments on Sequential Machines,” Automata Studies, 1956. doi:10.1515/9781400882618-006
[8] K. Kang et al., “Feature-Oriented Domain Analysis (FODA) Feasibility Study,” CMU/SEI-90-TR-021, 1990.
[9] R. Alur et al., “Syntax-Guided Synthesis,” FMCAD 2013. doi:10.1109/FMCAD.2013.6679385
[10] D. Harel, “Statecharts: A Visual Formalism for Complex Systems,” Science of Computer Programming, 1987. doi:10.1016/0167-6423(87)90035-9
[11] R. Tate, M. Stepp, Z. Tatlock and S. Lerner, “Equality Saturation,” POPL 2009. doi:10.1145/1480881.1480915
[12] M. Willsey et al., “egg: Fast and Extensible Equality Saturation,” POPL 2021. doi:10.1145/3434304
[13] B. Moseley and P. Marks, “Out of the Tar Pit,” 2006.
[14] M. Fowler, “Event Sourcing,” 2005. https://martinfowler.com/eaaDev/EventSourcing.html
[15] P. Alvaro et al., “Dedalus: Datalog in Time and Space,” LNCS 2011. doi:10.1007/978-3-642-24206-9_16
[16] A. M. Turing, “On Computable Numbers,” Proceedings of the London Mathematical Society, 1937. doi:10.1112/plms/s2-42.1.230
[17] A. Church, “An Unsolvable Problem of Elementary Number Theory,” American Journal of Mathematics, 1936. doi:10.2307/2371045
[18] P. Wadler, “Propositions as Types,” Communications of the ACM, 2015. doi:10.1145/2699407
[19] J. M. Hellerstein and P. Alvaro, “Keeping CALM,” Communications of the ACM, 2020. doi:10.1145/3369736
[20] G. Kahn, “The Semantics of a Simple Language for Parallel Programming,” IFIP 1974, pp. 471 to 475.
[21] H. Husain et al., “CodeSearchNet Challenge,” 2019. arXiv:1909.09436
[22] D. Kim, J. Nam, J. Song and S. Kim, “Automatic Patch Generation Learned from Human-Written Patches” (PAR), ICSE 2013. doi:10.1109/ICSE.2013.6606626
[23] K. Liu et al., “TBar: Revisiting Template-based Automated Program Repair,” ISSTA 2019. arXiv:1903.08409
[24] K. Liu et al., “AVATAR: Fixing Semantic Bugs with Fix Patterns of Static Analysis Violations,” SANER 2019. arXiv:1812.07270
[25] A. Koyuncu et al., “FixMiner: Mining Relevant Fix Patterns for Automated Program Repair,” 2018. arXiv:1810.01791
[26] Y. Padioleau et al., “Documenting and Automating Collateral Evolutions in Linux Device Drivers” (Coccinelle), EuroSys 2008. doi:10.1145/1352592.1352618
[27] A. Solar-Lezama et al., “Combinatorial Sketching for Finite Programs,” ASPLOS 2006. doi:10.1145/1168857.1168907
[28] L. Chen, M. Zaharia and J. Zou, “FrugalGPT,” 2023. arXiv:2305.05176
[29] S. Haber and W. S. Stornetta, “How to Time-Stamp a Digital Document,” Journal of Cryptology, 1991. doi:10.1007/BF00196791
[30] S. A. Crosby and D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging,” USENIX Security 2009.
[31] L. de Moura and N. Bjørner, “Z3: An Efficient SMT Solver,” TACAS 2008. doi:10.1007/978-3-540-78800-3_24
[32] Kani Rust Verifier. https://github.com/model-checking/kani
[33] C. V. Lopes et al., “DéjàVu: A Map of Code Duplicates on GitHub,” OOPSLA 2017. doi:10.1145/3133908
[34] M. Gabel and Z. Su, “A Study of the Uniqueness of Source Code,” FSE 2010. doi:10.1145/1882291.1882315
[35] A. Hindle et al., “On the Naturalness of Software,” ICSE 2012. doi:10.1109/ICSE.2012.6227135
[36] D. Kocetkov et al., “The Stack: 3 TB of Permissively Licensed Source Code,” 2022. arXiv:2211.15533; The Stack v2 dataset card, https://huggingface.co/datasets/bigcode/the-stack-v2
[37] R. Just, D. Jalali and M. D. Ernst, “Defects4J: A Database of Existing Faults to Enable Controlled Testing Studies for Java Programs,” ISSTA 2014. doi:10.1145/2610384.2628055
[38] C. E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. arXiv:2310.06770
[39] R. Aleithan et al., “SWE-Bench+: Enhanced Coding Benchmark for LLMs,” 2024. arXiv:2410.06992
[40] C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal 27, 1948. doi:10.1002/j.1538-7305.1948.tb01338.x
[41] A. N. Kolmogorov, “Three approaches to the quantitative definition of information,” Problemy Peredachi Informatsii 1(1), 1965 (in Russian); English translation, International Journal of Computer Mathematics 2, 1968. doi:10.1080/00207166808803030
[42] R. J. Solomonoff, “A formal theory of inductive inference. Part I,” Information and Control 7(1), 1964. doi:10.1016/S0019-9958(64)90223-2
[43] G. J. Chaitin, “A Theory of Program Size Formally Identical to Information Theory,” Journal of the ACM 22(3), 1975. doi:10.1145/321892.321894
[44] J. Rissanen, “Modeling by shortest data description,” Automatica 14(5), 1978. doi:10.1016/0005-1098(78)90005-5
[45] B. Ray, V. Hellendoorn, S. Godhane, Z. Tu, A. Bacchelli and P. Devanbu, “On the ‘naturalness’ of buggy code,” ICSE 2016. doi:10.1145/2884781.2884848
[46] Z. Tu, Z. Su and P. Devanbu, “On the localness of software,” FSE 2014. doi:10.1145/2635868.2635875
[47] M. Allamanis, E. T. Barr, P. Devanbu and C. Sutton, “A Survey of Machine Learning for Big Code and Naturalness,” ACM Computing Surveys 51(4), 2018. doi:10.1145/3212695
[48] 陈浙哲, 刘忠鑫, 鄢萌, 徐洲, 夏鑫, 雷晏 (Z. Chen, Z. Liu, M. Yan, Z. Xu, X. Xia and Y. Lei), “代码自然性及其应用研究进展” (Research progress of code naturalness and its application), 软件学报 (Journal of Software) 33(8), 3015 to 3034, 2022. doi:10.13328/j.cnki.jos.006355
[49] G. Sridhara, V. S. Sinha and S. Mani, “Naturalness of Natural Language Artifacts in Software,” ISEC 2015 (India Software Engineering Conference). doi:10.1145/2723742.2723758
[50] P. Devanbu, “On the naturalness of software,” keynote, ISEC 2013 (India Software Engineering Conference). doi:10.1145/2442754.2442763
[51] A. Z. H. Yang, S. Kolak, V. J. Hellendoorn, R. Martins et al., “Revisiting Unnaturalness for Automated Program Repair in the Era of Large Language Models,” ICSE 2025. doi:10.1109/ICSE55347.2025.00089
[52] E. W. Dijkstra, “Guarded commands, nondeterminacy and formal derivation of programs,” Communications of the ACM 18(8), 1975. doi:10.1145/360933.360975
[53] N. Wirth, “Program development by stepwise refinement,” Communications of the ACM 14(4), 1971. doi:10.1145/362575.362577
[54] C. A. R. Hoare, “An axiomatic basis for computer programming,” Communications of the ACM 12(10), 1969. doi:10.1145/363235.363259
[55] J.-R. Abrial, The B-Book: Assigning Programs to Meanings, Cambridge University Press, 1996. doi:10.1017/CBO9780511624162
[56] J.-R. Abrial, Modeling in Event-B: System and Software Engineering, Cambridge University Press, 2010. doi:10.1017/CBO9781139195881
[57] R.-J. Back and J. von Wright, Refinement Calculus: A Systematic Introduction, Springer, 1998. doi:10.1007/978-1-4612-1674-2
[58] F. L. Bauer and H. Wössner, Algorithmic Language and Program Development, Springer, 1982. doi:10.1007/978-3-642-61807-9
[59] S. Gulwani, “Automating string processing in spreadsheets using input-output examples,” POPL 2011. doi:10.1145/1926385.1926423
[60] S. Gulwani, O. Polozov and R. Singh, “Program Synthesis,” Foundations and Trends in Programming Languages 4(1-2), 2017. doi:10.1561/2500000010
[61] F. P. Brooks, “No Silver Bullet: Essence and Accidents of Software Engineering,” Computer 20(4), 1987. doi:10.1109/MC.1987.1663532
[62] P. Naur, “Programming as theory building,” Microprocessing and Microprogramming 15(5), 1985. doi:10.1016/0165-6074(85)90032-8
[63] M. M. Lehman, “Programs, life cycles, and laws of software evolution,” Proceedings of the IEEE 68(9), 1980. doi:10.1109/PROC.1980.11805
[64] P. Zave and M. Jackson, “Four dark corners of requirements engineering,” ACM Transactions on Software Engineering and Methodology 6(1), 1997. doi:10.1145/237432.237434
[65] R. Landauer, “Irreversibility and Heat Generation in the Computing Process,” IBM Journal of Research and Development 5(3), 1961. doi:10.1147/rd.53.0183
[66] C. H. Bennett, “Logical Reversibility of Computation,” IBM Journal of Research and Development 17(6), 1973. doi:10.1147/rd.176.0525
[67] M. Franz and T. Kistler, “Slim binaries,” Communications of the ACM 40(12), 1997. doi:10.1145/265563.265576
[68] C. W. Fraser, “Automatic inference of models for statistical code compression,” PLDI 1999. doi:10.1145/301618.301672
[69] P. Cousot and R. Cousot, “Abstract interpretation: a unified lattice model for static analysis of programs by construction or approximation of fixpoints,” POPL 1977. doi:10.1145/512950.512973
[70] Y. Futamura, “Partial evaluation of computation process: an approach to a compiler-compiler,” Systems, Computers, Controls 2(5), 1971; reprinted in Higher-Order and Symbolic Computation 12(4), 1999. doi:10.1023/A:1010095604496
[71] A. P. Ershov, “Mixed computation: potential applications and problems for study,” Theoretical Computer Science 18(1), 1982. doi:10.1016/0304-3975(82)90111-6
[72] W. A. Howard, “The formulae-as-types notion of construction,” in J. P. Seldin and J. R. Hindley (eds.), To H. B. Curry: Essays on Combinatory Logic, Lambda Calculus and Formalism, Academic Press, 1980.
[73] 土居真之, 肥後芳樹, 有馬諒, 下仲健斗, 楠本真二 (M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto), “ソースコードの「自然さ」を利用した自動生成ファイルの特定” (Identifying auto-generated files using the naturalness of source code), 電子情報通信学会技術研究報告 (IEICE Technical Report) 117(380), 19 to 24, January 2018. https://sdl.ist.osaka-u.ac.jp/pman/pman3.cgi?D=517
[74] M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto, “On the naturalness of auto-generated code: can we identify auto-generated code automatically?” ICPC 2018. doi:10.1145/3196321.3196356
[75] F. V. Arrebola, “Modelo de sugestão de código-fonte baseado em modelos de linguagem organizados em um contexto hierárquico” (A source code suggestion model based on language models organized in a hierarchical context), doctoral thesis in electrical engineering, Fundação Educacional Inaciana Padre Sabóia de Medeiros (FEI), Brazil, 2018. Advisor R. A. C. Bianchi.
[76] G. Febres, K. Jaffé and C. Gershenson, “Complexity measurement of natural and artificial languages,” Complexity 20(6), 2015. doi:10.1002/cplx.21529
[77] M. Rahman, D. Palani and P. C. Rigby, “Natural Software Revisited,” ICSE 2019. doi:10.1109/ICSE.2019.00022
[78] A. Torres, S. Baltes, C. Treude and M. Wagner, “Applying Information Theory to Software Evolution,” NLBSE 2023. doi:10.1109/NLBSE59153.2023.00017
[79] A. Blass, N. Dershowitz and Y. Gurevich, “When are two algorithms the same?,” Bulletin of Symbolic Logic 15(2), 2009. arXiv:0811.0811. https://arxiv.org/abs/0811.0811
[80] Y. N. Moschovakis, “What is an algorithm?,” in Mathematics Unlimited: 2001 and Beyond, Springer, 2001. https://www.math.ucla.edu/~ynm/papers/eng.pdf
[81] M. Y. Vardi, “What is an algorithm?,” Communications of the ACM 55(3), 2012. doi:10.1145/2093548.2093549
[82] S. Laddad, A. Cheung, J. M. Hellerstein and M. Milano, “Flo: a Semantic Foundation for Progressive Stream Processing,” POPL 2025. arXiv:2411.08274. https://arxiv.org/abs/2411.08274
[83] The Elm Architecture, Elm guide. https://guide.elm-lang.org/architecture/
[84] Temporal, “Workflows” (event history), documentation. https://docs.temporal.io/workflows
[85] A. Pnueli, M. Siegel and E. Singerman, “Translation validation,” TACAS 1998. doi:10.1007/BFb0054170
[86] X. Yang, Y. Chen, E. Eide and J. Regehr, “Finding and understanding bugs in C compilers,” PLDI 2011. doi:10.1145/1993498.1993532
[87] C. Nandi, M. Willsey, A. Zhu et al., “Rewrite Rule Inference Using Equality Saturation,” OOPSLA 2021. arXiv:2108.10436. https://arxiv.org/abs/2108.10436
[88] C. Le Goues, T. Nguyen, S. Forrest and W. Weimer, “GenProg: A Generic Method for Automatic Software Repair,” IEEE TSE 38(1), 2012. doi:10.1109/TSE.2011.104
[89] F. Long and M. Rinard, “Automatic patch generation by learning correct code,” POPL 2016. doi:10.1145/2837614.2837617
[90] J. Bader, A. Scott, M. Pradel and S. Chandra, “Getafix: Learning to Fix Bugs Automatically,” OOPSLA 2019. arXiv:1902.06111. https://arxiv.org/abs/1902.06111
[91] K. Etemadi, N. Harrand, S. Larsen et al., “Sorald: Automatic Patch Suggestions for SonarQube Static Analysis Violations,” IEEE TDSC, 2022. arXiv:2103.12033. https://arxiv.org/abs/2103.12033
[92] Z. Qi, F. Long, S. Achour and M. Rinard, “An analysis of patch plausibility and correctness for generate-and-validate patch generation systems,” ISSTA 2015. doi:10.1145/2771783.2771791
[93] E. K. Smith, E. T. Barr, C. Le Goues and Y. Brun, “Is the cure worse than the disease? Overfitting in automated program repair,” ESEC/FSE 2015. doi:10.1145/2786805.2786825
[94] X.-B. D. Le, F. Thung, D. Lo and C. Le Goues, “Overfitting in semantics-based automated program repair,” Empirical Software Engineering 23, 2018. doi:10.1007/s10664-017-9577-2
[95] Y. Xiong, X. Liu, M. Zeng, L. Zhang and G. Huang, “Identifying patch correctness in test-based program repair,” ICSE 2018. doi:10.1145/3180155.3180182
[96] T. Durieux, F. Madeiral, M. Martinez and R. Abreu, “Empirical Review of Java Program Repair Tools: A Large-Scale Experiment on 2,141 Bugs and 23,551 Repair Attempts,” ESEC/FSE 2019. arXiv:1905.11973. https://arxiv.org/abs/1905.11973
[97] K. Liu, A. Koyuncu, T. F. Bissyandé et al., “You Cannot Fix What You Cannot Find! An Investigation of Fault Localization Bias in Benchmarking Automated Program Repair Systems,” ICST 2019. arXiv:1812.07283. https://arxiv.org/abs/1812.07283
[98] M. Monperrus, “Automatic Software Repair: A Bibliography,” ACM Computing Surveys 51(1), 2018. doi:10.1145/3105906
[99] C. S. Xia, Y. Deng, S. Dunn and L. Zhang, “Agentless: Demystifying LLM-based Software Engineering Agents,” 2024. arXiv:2407.01489. https://arxiv.org/abs/2407.01489
[100] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir and A. Narayanan, “AI Agents That Matter,” 2024. arXiv:2407.01502. https://arxiv.org/abs/2407.01502
[101] M. H. Erol, B. El, M. Suzgun, M. Yuksekgonul and J. Zou, “Cost-of-Pass: An Economic Framework for Evaluating Language Models,” 2025. arXiv:2504.13359. https://arxiv.org/abs/2504.13359
[102] D. Zan, Z. Huang, W. Liu et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving,” 2025. arXiv:2504.02605. https://arxiv.org/abs/2504.02605
[103] R. Widyasari, S. Q. Sim, C. Lok et al., “BugsInPy: a database of existing bugs in Python programs to enable controlled testing and debugging studies,” ESEC/FSE 2020. doi:10.1145/3368089.3417943
[104] M. Allamanis, “The Adverse Effects of Code Duplication in Machine Learning Models of Code,” Onward! 2019. arXiv:1812.06469. https://arxiv.org/abs/1812.06469
[105] K. N. Khan, M. Hirki, T. Niemi, J. K. Nurminen and Z. Ou, “RAPL in Action: Experiences in Using RAPL for Power Measurements,” ACM TOMPECS 3(2), 2018. doi:10.1145/3177754
[106] The Rust project, rustfix and cargo fix. https://github.com/rust-lang/rustfix
[107] R.-M. Karampatsis and C. Sutton, “How Often Do Single-Statement Bugs Occur? The ManySStuBs4J Dataset,” MSR 2020. doi:10.1145/3379597.3387491
[108] C. Richter and H. Wehrheim, “TSSB-3M: Mining single statement bugs at massive scale,” MSR 2022. doi:10.1145/3524842.3528505
[109] H. Coles, T. Laurent, C. Henard, M. Papadakis and A. Ventresque, “PIT: a practical mutation testing tool for Java,” ISSTA 2016. doi:10.1145/2931037.2948707
[110] R. Just, D. Jalali, L. Inozemtseva, M. D. Ernst, R. Holmes and G. Fraser, “Are mutants a valid substitute for real faults in software testing?” FSE 2014. doi:10.1145/2635868.2635929
[111] I. J. Good, “Speculations Concerning the First Ultraintelligent Machine,” Advances in Computers 6, 1965. doi:10.1016/S0065-2458(08)60418-0
[112] J. Schmidhuber, “Gödel Machines: Fully Self-referential Optimal Universal Self-improvers,” in Artificial General Intelligence, Springer, 2007. doi:10.1007/978-3-540-68677-4_7
[113] E. Yudkowsky, “Intelligence Explosion Microeconomics,” Technical report 2013-1, Machine Intelligence Research Institute, 2013. https://intelligence.org/files/IEM.pdf
[114] M. H. Löb, “Solution of a Problem of Leon Henkin,” Journal of Symbolic Logic 20(2), 1955. doi:10.2307/2266895
[115] E. Yudkowsky and M. Herreshoff, “Tiling Agents for Self-Modifying AI, and the Löbian Obstacle,” Machine Intelligence Research Institute, 2013. https://intelligence.org/files/TilingAgentsDraft.pdf
[116] E. Zelikman, E. Lorch, L. Mackey and A. T. Kalai, “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation,” 2023. doi:10.48550/arXiv.2310.02304
[117] J. Zhang, S. Hu, C. Lu, R. Lange and J. Clune, “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents,” 2025. doi:10.48550/arXiv.2505.22954
[118] A. Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery,” 2025. doi:10.48550/arXiv.2506.13131
[119] G. Wang, Y. Xie, Y. Jiang, A. Mandlekar, C. Xiao, Y. Zhu, L. Fan and A. Anandkumar, “Voyager: An Open-Ended Embodied Agent with Large Language Models,” 2023. doi:10.48550/arXiv.2305.16291
[120] Y. Futamura, “Partial Evaluation of Computation Process: An Approach to a Compiler-Compiler,” Higher-Order and Symbolic Computation 12(4), 1999 (first published 1971). doi:10.1023/A:1010095604496
[121] V. F. Turchin, “The Concept of a Supercompiler,” ACM Transactions on Programming Languages and Systems 8(3), 1986. doi:10.1145/5956.5957
[122] J. N. Foster, M. B. Greenwald, J. T. Moore, B. C. Pierce and A. Schmitt, “Combinators for Bidirectional Tree Transformations: A Linguistic Approach to the View-Update Problem,” ACM Transactions on Programming Languages and Systems 29(3), 2007. doi:10.1145/1232420.1232424
[123] M. Hofmann, B. Pierce and D. Wagner, “Symmetric Lenses,” POPL, 2011. doi:10.1145/1926385.1926428
[124] K. Czarnecki, J. N. Foster, Z. Hu, R. Lämmel, A. Schürr and J. F. Terwilliger, “Bidirectional Transformations: A Cross-Discipline Perspective,” ICMT, LNCS 5563, 2009. doi:10.1007/978-3-642-02408-5_19
[125] E. W. Dijkstra, “A Constructive Approach to the Problem of Program Correctness,” BIT 8(3), 1968. doi:10.1007/BF01933419
[126] A. Hall and R. Chapman, “Correctness by Construction: Developing a Commercial Secure System,” IEEE Software 19(1), 2002. doi:10.1109/52.976937
[127] Y. Minsky, “OCaml for the Masses,” Communications of the ACM 54(11), 2011. doi:10.1145/2018396.2018413
[128] D. A. Turner, “Total Functional Programming,” Journal of Universal Computer Science 10(7), 2004. doi:10.3217/jucs-010-07-0751
[129] R. Di Cosmo and S. Zacchiroli, “Software Heritage: Why and How to Preserve Software Source Code,” iPRES 2017, Kyoto. https://hal.science/hal-01590958
[130] Software Heritage, archive counters, read 13 October 2026: 30,253,266,524 file contents and 448,311,919 origins. https://archive.softwareheritage.org/api/1/stat/counters/
[131] Rosetta Code, main page, read 13 October 2026: 1,360 tasks, 421 draft tasks, 1,009 known languages. https://rosettacode.org/wiki/Rosetta_Code