Reality Code Engine:一个无损形式,用于原生、可验证、低能耗的编程
一种编程系统:程序只写一次,写成一个状态机,每种目标语言都由它生成;并报告往返、拒绝畸形输入和修复提升代码的测量结果。
David Charlot, Open Interface Engineering
本文是英文原版的译本。如有出入,以英文版为准。 英文原版.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Reality Code Engine:一个无损形式,用于原生、可验证、低能耗的编程. Open Interface Engineering. Web: https://research.openie.dev/papers/rce/. PDF: https://research.openie.dev/pdfs/rce.pdf.
版本 1.4,2026 年 10 月 13 日。规格:当前草案(草案 0.7 文档,语言版本 0.8),来自 openIE-dev/rce 2a0ec68。1.4 的变更:引擎测试数为 cargo test --release 运行的 589 个不同测试(1.3 印为 596,即 make check 的总数,它把 7 个证明测试计了两次);第 3.7 节说明规格 2.7 现在给出 C.15 的逐调用点成本规则;第 5.5 节的确定性提议者报告为提出 87 条、承认 9 条、拒绝 78 条,取自引擎测试;第 7 节中的 Software Heritage 与 Rosetta Code 带有参考文献 [129] 至 [131],档案计数器已重新读取;新增九幅图(图 5 至 10、12、13 与 15),先前的图 5 与图 6 现为图 11 与图 14。1.3 的变更:按规模缩放的方法成本归于语言版本 0.7(1.2 中把它们描述在 0.6 之下),陈述了混合版本程序的逐调用点规则,检查在引擎提交 1eb5f02 上重新运行。数据与代码:research.openie.dev/data/。演练场(参考检查器):openie-dev.github.io/rce。引擎演示:/demos/rce-engine/。LaTeX PDF:/pdfs/latex/rce.pdf(源文件)。
更正与可复现状态(2026 年 10 月 17 日)。 本说明是在对照公开仓库通读本文之后加入的。受其影响的数字列于此处,下文其余部分不变。下列每个计数均来自 src/data/rce-facts.json,由 openIE-dev/rce 在 e416fd0 上的 scripts/claim-counts.py 生成,但两个 Lean 计数取自 4304048。
- 单一语言(2026 年 10 月 18 日)。 公开
rcemain(4a3dc1f)只有一种语言和一种文本。# rce-version:行是被容许并被忽略的发布标签,不参与哈希,且一个发布标签恰好指明一个规格提交(C.15)。检查器未实现的构造按保留、未实现而被拒绝(W-RES-1,附录 F.12),而不是按版本拒绝;保留字列表只有一份。因此,描述版本门控(版本 0.5 至 0.9)的第 3.7 节与图 5 描述的是较早的草案,已不再适用。失败的调用会恢复其&mut参数(F.4.4),这取代了定理 T33 的回写规则。下列计数取自此变更之前的e416fd0,未重新运行。T33 的证明随该规则一同改变:已退役的“在每种结果上回写”定理已离开受审计的树(公开rcemain95ead2e),T33 现在证明 F.4.4 的恢复;审计读数为 4875 个定理,仅使用标准公理。 - 库名称(rce-stdlib,2026 年 10 月 18 日)。 由于保留列表是全局的,被它现在保留的库名称已改名:
label改为lbl,node改为nd,group改为grp,child改为chd,budget改为bud,restart改为rst,replicated改为repl,ct改为ctext,session改为sess,protocol改为proto,par改为parl,offer改为offr,choose改为chse。类型Json(模块enc)与Url(模块net.url)现为JsonDoc与UrlParts,因此导入enc.Json或net.url.Url的程序必须使用新名称。text值的文本长度.len()为.len_bytes()(字节)或.len_chars()。 e416fd0上的版本与计数。 规格文档为草案 0.9(自cdae5cf起公开)。10 月 18 日之前,参考检查器接受语言版本 0.5 至 0.9,并按版本拒绝其未实现的版本 0.9 部分(附录 F.12)。陈述了定理 T1 至 T56;T42 至 T56(附录 F)已陈述但未证明。共有 58 个 Lean 模块和 59 个示例程序(57 个位于顶层,2 个位于包中)。本文中称草案 0.7、语言版本 0.8、T1 至 T34、31 个文件或 51 个示例的图与图注,描述的是它们所指明的较早提交上的仓库;除本说明外,本文不描述草案 0.9。- Lean 定理计数。 存在两个不同的计数。源代码在
e416fd0上包含 1,116 个theorem与lemma声明(在4304048上为 885 个)。审计(scripts/lean-audit.sh)计入内核环境中的每个定理常量,包括精化器生成的常量;在e416fd0上对公开仓库重新运行得到 4,877,此时lake build在spec/lean/RCE/的 58 个文件上完成,无sorry,且仅使用标准公理(在4304048上为 46 个文件上的 2,949)。下文引用的 2,192 是引擎提交1eb5f02上 31 个模块的审计计数。这两个数字都不说明关于 Rust 求值器证明了多少定理。 - 今天可从公开仓库复现: Lean 构建与公理审计、规格检查(文法表与示例语料)、参考检查器及其测试,以及规范 JSON 向量。
- 尚不可从公开仓库复现: 10,000 个形式的生态系统运行(
bench/ecosystem不在公开仓库中)、Kani 结果、589 个引擎测试、第 6 节的修复率以及任何 Defects4J 数字。在来源与种子公布之前,它们在此作为作者自己的运行报告,应按此理解。 - 证伪者 RCE-F0。 见下文第 2.3 节中的说明。
摘要
本文描述 Reality Code Engine(RCE):一种把程序一次写成状态机(称为形式)并由其生成其他语言代码的系统。文中报告在 10,000 个形式上以及公开缺陷数据集上测得的结果,并说明这些论断可如何被证伪。
用平常话说
- 程序只写一次,写成一种精确的形式,计算机从它生成多种语言中的同一程序。
- 因为形式只允许已声明的内容,破损的输入在入口就被拒绝,而不是事后再修。
- 通过检查的修复会被保存并复用,同一问题不会再付第二次时间或能量。
1. 论题
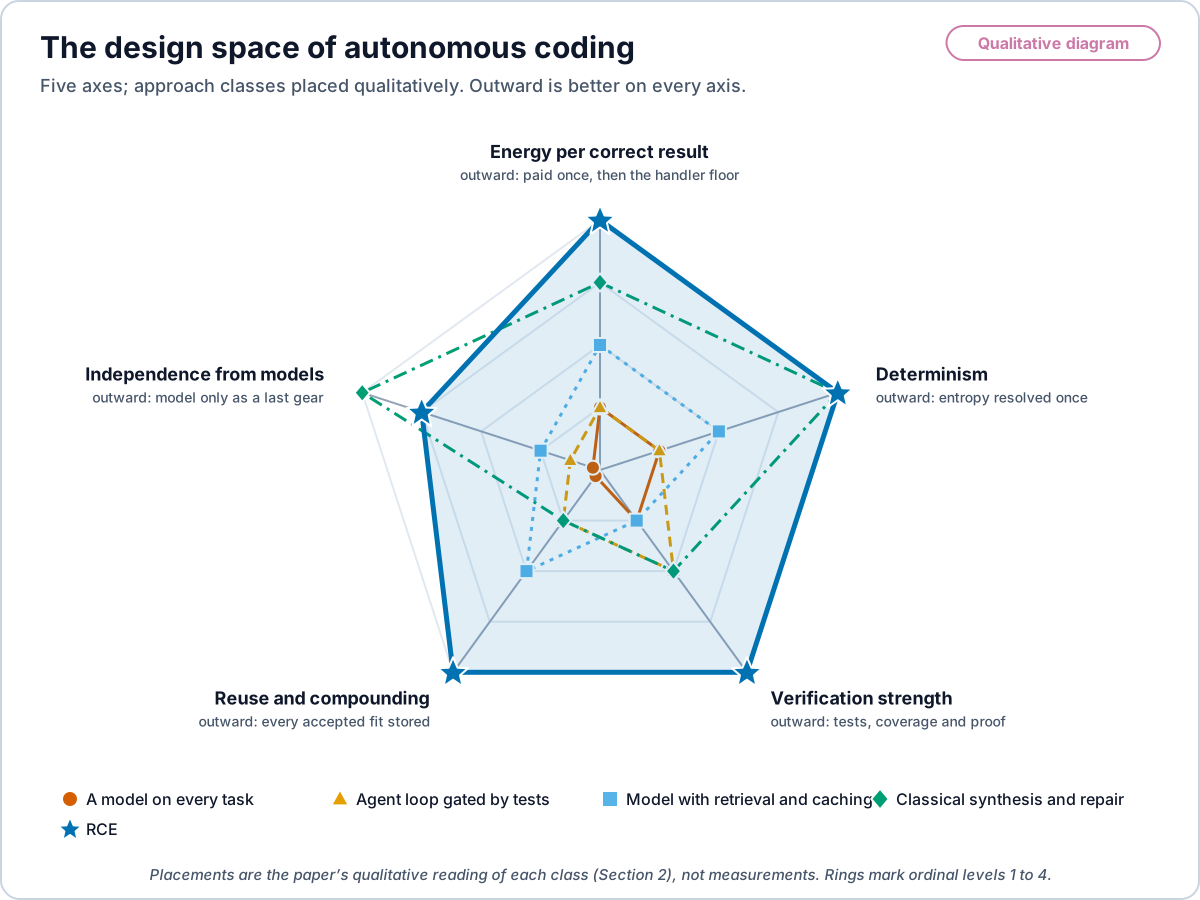
自主计算机自动化是一个含有许多点位的设计空间。每种路径都落在五条连续轴上的某处:每次正确结果所耗能量;系统在运行时必须消解的熵,以及随之而来的输出确定性;接受结果的验证强度;每个被接受结果被复用并复利的程度;以及对模型的依赖程度。一个大语言模型(LLM,一种统计文本模型)若从提示词为每次改动重新生成,则靠近该空间的一角:它每项任务都依赖模型,每次从高熵分布中取新样本,并在每项任务上再次为生成付费。检索、规则、综合、验证与缓存占据许多其他点位,真实系统往往把它们组合起来。
Reality Code Engine(RCE)是该空间中的一个点位,本文描述并测量它。RCE 把程序建模为数据库函数式状态机。Lopes 与同事测得 GitHub 上约 70% 的代码是更早文件的克隆 [33],因此 RCE 先尝试检索已有契合、加以适配并检查,仅在没有更便宜路径能关闭任务时才调用模型。
核心论断。 RCE 是一个完整的代码生态系统,其中程序由意图原生写成。意图只写一次,写成形式:一个状态、一组事件与一个纯的、全定义的转移。形式是该意图的无损编码。每个目标(状态图、Rust、Python、XState、SCXML、WASM)都是形式的投影,且每个投影都按字节重放形式的迹。形式未声明的状态无法被写出,合同之外的输入在入口被拒绝。因此,生态系统中的程序不会像常见语言中的程序那样相对注释、测试或其他实现发生漂移,也不需要事后的差分或错误追踪。每个通过门槛的契合都被存储并复用,生态系统随增长而复利(§2.4)。用其他语言写成的代码是一扇入口:它通过提升进入(§6)。
空间中每个点位都面对同一门槛。门槛是正确性:任务的完成性谓词 ,在此是任务的测试、证明或一致迹。在通过门槛的运行中,系统按完成所需焦耳 排序。正确性是约束,不是分数。
RCE 的机制称为档位,按成本顺序运行,第一个通过门槛的档位关闭任务。
能量数字按来源标注。est_j 是解析估计值。reported_j 是操作系统或片上计数器。measured_j 留给墙上电表,本文所有结果中均为空。
2. 自主编程的设计空间
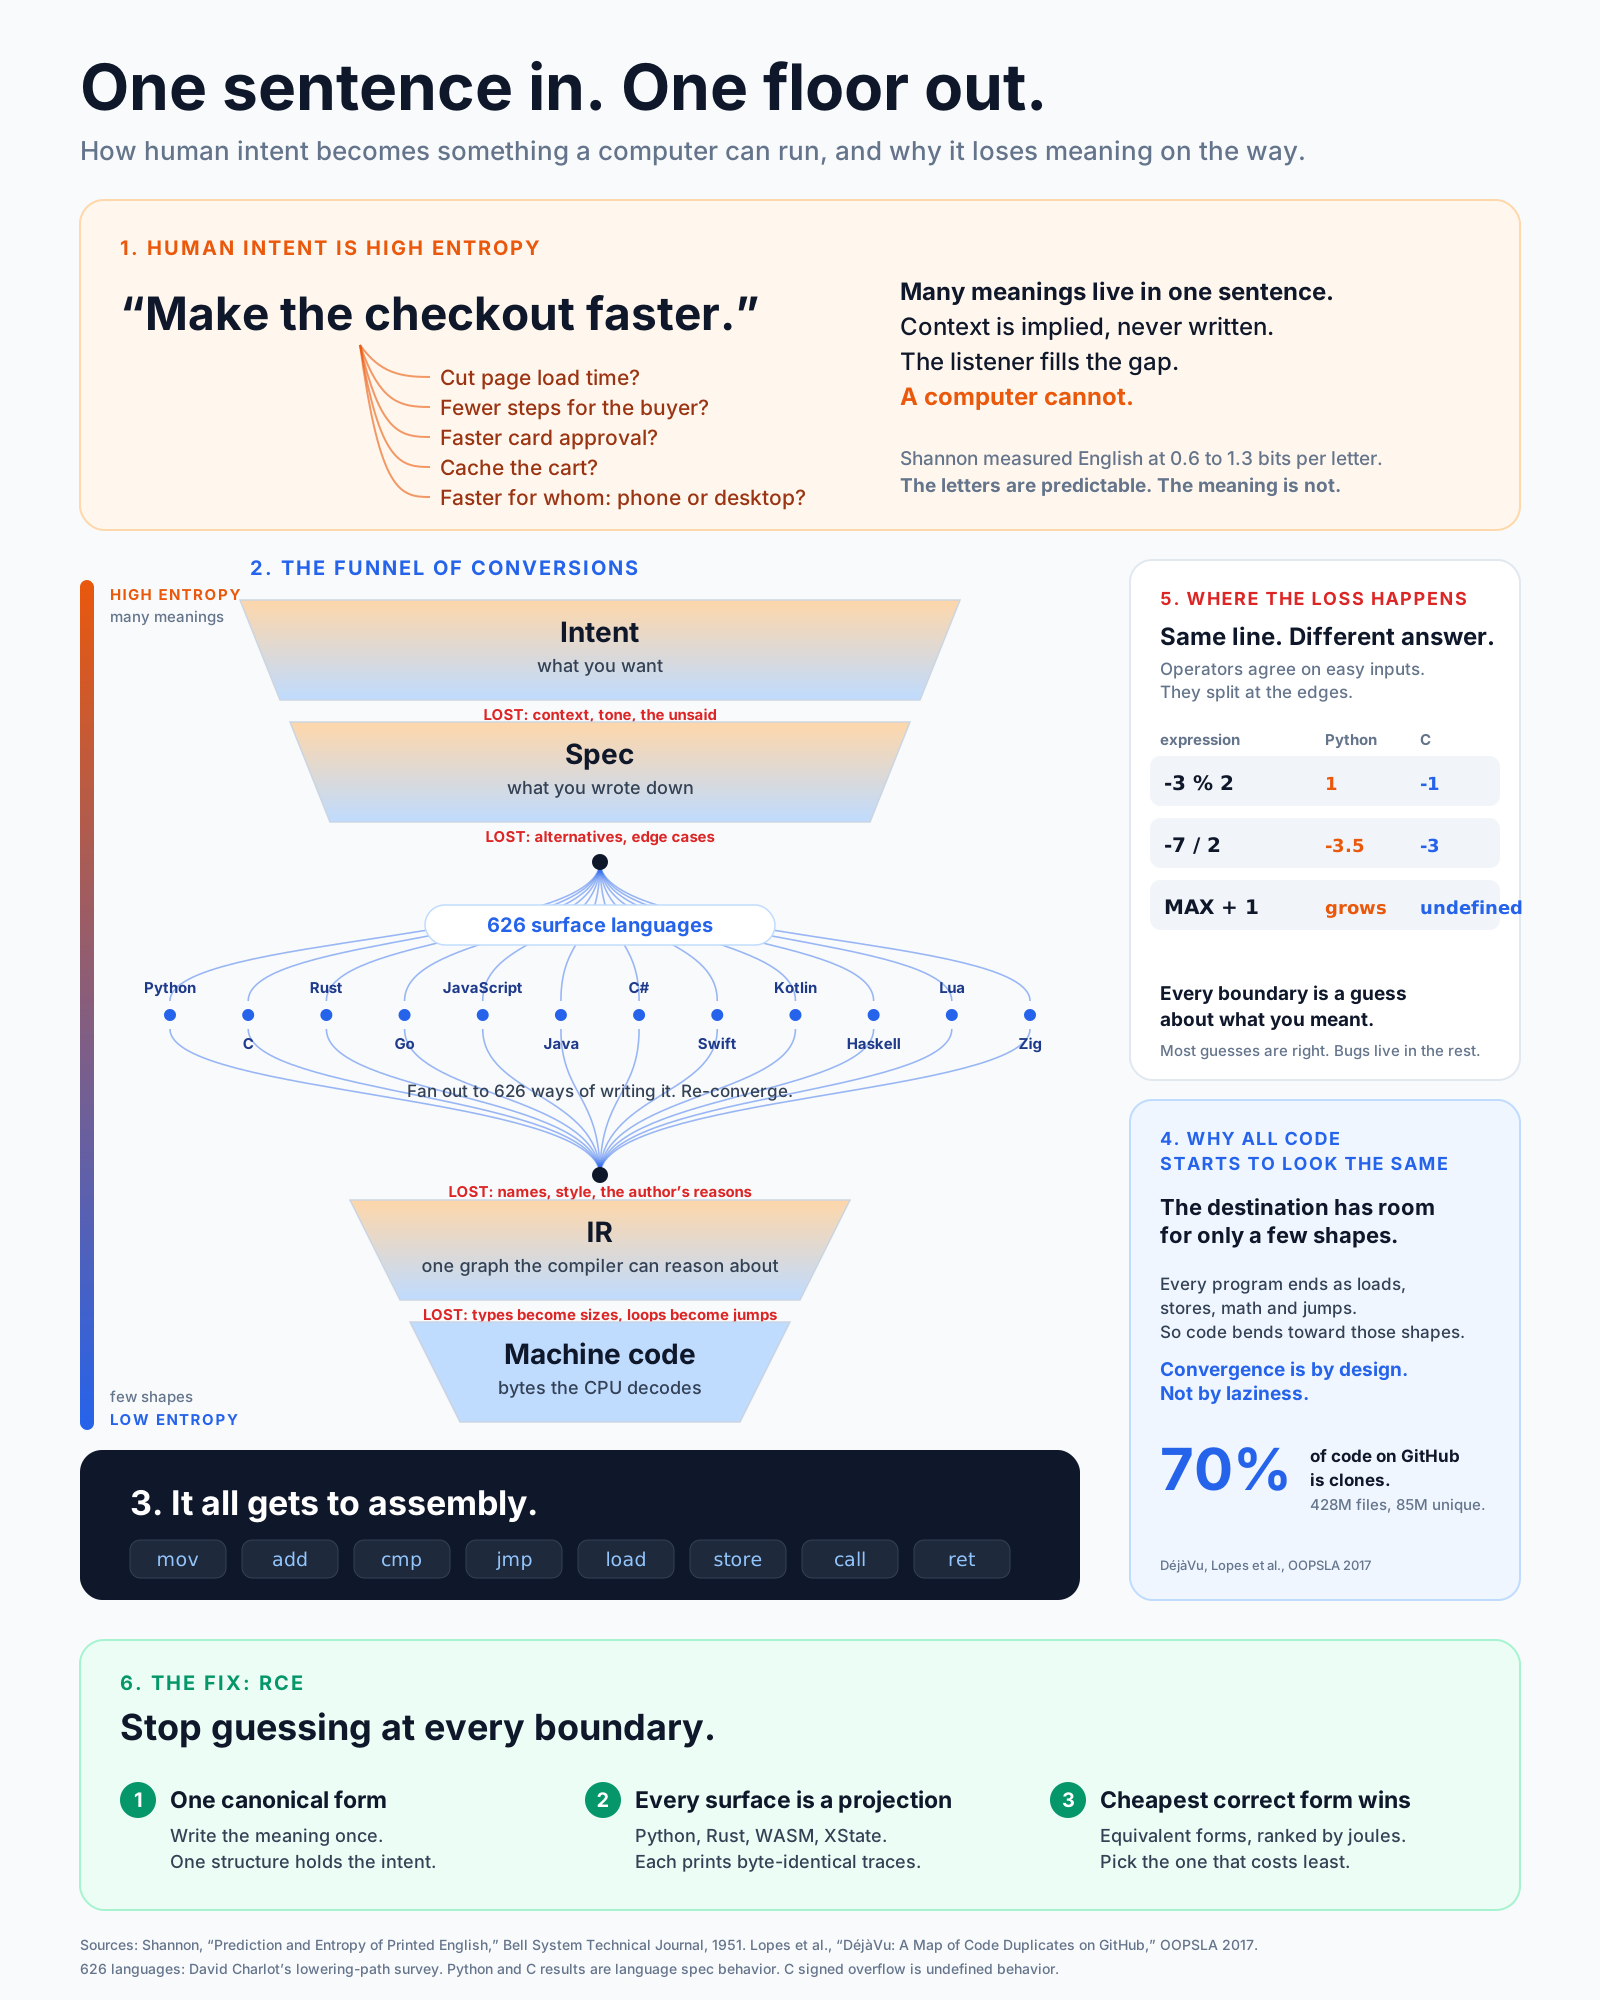
意图是高熵的。 “让结账更快”可有许多含义:更短的页面加载、更少的步骤、更快的刷卡审批、缓存的购物车,或在某一类设备上更快。上下文是隐含的,从未写明。Shannon 测得印刷英语约为每字母 0.6 到 1.3 比特 [1]。字母可预测。含义不可。
每次转换都丢失信息。 意图变成规格,上下文丢失。规格变成数百种表面语言之一,备选与边角情形丢失。源码变成中间表示(IR),名称、风格与作者理由丢失。IR 变成机器码,类型变成尺寸,循环变成跳转。
底板是低熵的。 每个程序最终都是加载、存储、算术与跳转。目的地只容得下少数形状,代码向它们弯曲。收敛是设计使然。
边界是含义分叉之处。 同一行在边缘给出不同答案。在 Python 中,-3 % 2 是 1,-7 / 2 是 -3.5。在 C 中,-3 % 2 是 -1,-7 / 2 是 -3,有符号溢出未定义。在每个边界重新生成代码的系统,在每个边界都在猜测。
各轴,以量陈述。
| 轴 | 一端 | 另一端 | RCE 所在 |
|---|---|---|---|
| 每次正确结果的能量 | 每项任务再付全价 | 每个新情形付一次,然后是处理器底板 | 在已覆盖任务上处于底板 |
| 运行时消解的熵,以及确定性 | 提示词的完整分布,每次新样本 | 仅剩无已存契合覆盖的残差,一个确定性输出 | 仅残差;每个投影确定性 |
| 验证强度 | 凭检查接受输出 | 测试、覆盖与证明证书 | 对每个结果施加完整门槛 |
| 复用与复利 | 每个结果只用一次 | 每个被接受的契合被存储并复用 | 每个通过门槛的契合都被存储 |
| 对模型的依赖 | 每项任务都用模型 | 无模型 | 模型仅作最后一档 |
路径在各轴上按程度不同,且各轴相互作用:复用降低能量与待消解的熵,强验证使复用安全。RCE 把含义一次写进一个规范形式。每种表面语言都是该形式的投影,并被检查与之匹配。在等价形式中,最便宜的正确者运行。
图 2 画出五条轴,并把主要路径类别放在其上。
2.1 编程即编码理论
本节论题是:编程可读作编码理论。程序员沿两种熵体制之间的梯度转换意图。意图是高熵的,是含义上的分布。代码是低熵的,每个状态一个确定性转移。软件工作的每一步,从需求到寄存器,都是该转换的一步。七十年来,文献以多种语言把这一点分片说出。本节把碎片收成一条论证,并把每个 RCE 档位放在其上。
度量。 Shannon 定义了信源熵与信道容量 [40],并测得印刷英语约为每字母 0.6 到 1.3 比特 [1]。Kolmogorov 于 1965 年在俄文的 Problemy Peredachi Informatsii 中给出信息量的三种进路,并把算法进路置于首位:对象中的信息是产生它的最短程序的长度 [41]。Solomonoff 已把同一对象当作归纳推理理论 [42],Chaitin 表明程序大小服从与 Shannon 形式上相同的恒等式 [43]。Rissanen 把这一思想变成选择模型的规则:最小描述长度 [44]。合在一起,它们说程序是码字:对行为的描述,最短的正确者是底板。RCE 的抽取规则(在等价契合中保留焦耳最少者,命题 3)正是以焦耳代替比特的那条规则。
代码处于低熵体制,且有人测过。 Hindle、Barr、Su、Gabel 与 Devanbu 发现代码“非常重复,事实上甚至比自然语言更甚”,在同一 n-gram 模型下交叉熵更低 [35]。Gabel 与 Su 发现项目中多数行已在别处出现 [34],Lopes 等发现 GitHub 上多数文件是克隆 [33]。Tu、Su 与 Devanbu 发现代码也是局部的:附近写过的内容预测接下来写什么 [46]。Ray 与同事发现有缺陷的行更不自然、熵更高,且缺陷被修好时熵下降 [45]。2025 年,Yang、Kolak、Hellendoorn 与 Martins 用补丁引起的熵变化来排序修复候选,并把正确补丁与过拟合补丁分开 [51]。Allamanis、Barr、Devanbu 与 Sutton 以自然性之名综述该领域 [47]。结果不只是英语文献的。Prem Devanbu 于 2013 年在印度软件工程会议的主题演讲中陈述了它 [50]。IBM Research India 的 Sridhara、Sinha 与 Mani 在同一会议测量代码周围的自然语言制品,发现提交消息最规整,而 Stack Overflow 散文行为像普通英语 [49]。在中国,《软件学报》于 2022 年发表了代码自然性研究综述,陈述交叉熵度量以及缺陷代码熵更高的发现 [48]。在日本,大阪大学的 Doi、Higo、Arima、Shimonaka 与 Kusumoto 使用 n-gram 自然性,先在日文 IEICE 技术报告、后在 ICPC 2018,区分机器生成与人手写的源文件 [73, 74]。生成代码在熵尺度上甚至低于人手代码,因为生成器是固定转换。在巴西,Arrebola 的博士论文在按项目与维护者分段的 n-gram 与主题模型上构建代码建议,并以交叉熵(编码下一词元所需比特)评估 [75]。两种体制在同一仓库可见:代码周围的散文是高熵的,代码是低熵的。
度量重要。 Febres、Jaffé 与 Gershenson 从委内瑞拉与墨西哥出发,按消息长度比较英语、西班牙语与程序文本的词汇多样性,发现程序文本更多样 [76]。Rahman、Palani 与 Rigby 发现代码 n-gram 可预测性很大一部分来自语法词元,去掉它们后代码仍重复但少于最初报告,API 使用是最重复的部分 [77]。两项结果都锐化而非推翻论断。符号多样性不是可预测性,低熵体制是下一步条件分布的性质,而确定性转移正是固定它的东西。因此 RCE 的 G0 按形状键控,而非按表面词元。
意图处于高熵体制。 Zave 与 Jackson 表明需求是关于环境的陈述,规格是关于接口的陈述,其间的缺口只由往往未写出的领域知识填补 [64]。Brooks 把软件难度分成本质与偶然:本质是概念构造,其中大多是规格与设计,而非表示 [61]。Naur 主张程序是程序员所持理论的可见部分,且该理论不能从文本完全恢复 [62]。用 Shannon 来读,三者说的是同一件事。意图携带的不确定性多于任何一个程序,写出程序正是消除它的动作。代码写成后仍留在程序员头脑中的,是意图中代码未曾编码的部分。
转换是求精,求精是收窄。 Hoare 给程序一种逻辑,其中程序相对前置与后置条件正确 [54]。Wirth 讲授逐步求精:通过相继决定把任务分解为指令,每一步固定规格留下的选择 [53]。Dijkstra 的看守命令把开放选择明示为非确定性,并通过消除它从规格导出程序 [52]。在慕尼黑,Bauer 与 Wössner 的 CIP 项目把程序开发建成从规格到程序的正确性保持变换序列 [58]。在法国,Abrial 的 B 方法及随后的 Event-B 把求精带到工业规模,每步带证明义务 [55, 56]。在芬兰,Back 与 von Wright 给出求精的格论演算 [57]。在各自情形下,规格表示可接受行为的集合,每一步求精缩小该集合,直到留下一个确定性行为。这是每步带证明的熵减。RCE 的形式是该链的最后一环:在数据库状态上的全定义、确定性转移 ,每个选择都已消解(§3.2)。
综合是收窄假设空间的搜索。 Gulwani 的 FlashFill 通过表示所有一致程序的集合并与每个新例子求交,从少量输入输出例子学习字符串程序 [59]。Gulwani、Polozov 与 Singh 把程序综合一般表述为在意图约束下对程序空间的搜索 [60],Solar-Lezama 的草图用求解器填充部分程序中的空洞 [27]。每个例子或约束是一次消除假设的测量。Shannon 的度量计算需要多少次这样的测量。RCE 的 G2 就是那一档。
转换产物只有一种形状。 Gurevich 证明每个顺序算法在其自身抽象层级上由抽象状态机捕捉 [2]。Codd 使状态成为关系 [5],事件溯源使状态成为只追加日志的折叠 [14]。在 Curry 与 Howard 之下,证明是程序,命题是类型 [18, 72],因此已验证的契合是其规格的证明。这些是低熵体制形状很少的原因:目的地是数据库上的状态机,无论表面语言为何。
没有门槛,低熵会衰变。 Lehman 在数十年大型系统观察中指出,使用中的程序必须持续变化,其复杂度会增长,除非做功去降低它 [63]。Torres、Baltes、Treude 与 Wagner 在 25 个项目的提交历史上测量结构与文本熵,发现二者一同上升 [78]。熵从环境回流进代码。要把代码保持在低熵体制,需要每次变更上的门槛,而 RCE 的门槛是正确性(§4.3)。
编译器已经在做信源编码。 Franz 与 Kistler 把程序作为压缩抽象语法树交付并在加载时生成本地代码,这是程序在其自身语法上的信源编码 [67]。Fraser 从语料推断代码的统计模型以压缩它 [68]。Futamura 于 1971 年在日文期刊 Systems, Computers, Controls 中表明,把解释器特化到程序得到编译后的程序,特化特化器得到编译器 [70]。新西伯利亚的 Ershov 把同一思想发展为混合计算 [71]。Cousot 夫妇的抽象解释计算对程序每种行为的可靠、更低信息的描述 [69]。与信道编码的类比是本文的解读,而非被引用的定理:类型、测试与证明加入经检查的冗余,使错误程序在运行前被检出,如同奇偶校验检出损坏的码字。
擦除是焦耳去向。 Landauer 表明逻辑不可逆步骤(擦除一比特)至少耗散 [65]。Bennett 表明计算原则上可做成逻辑可逆,因此界限在擦除而非计算上 [66]。把高熵意图转换成一个低熵程序,丢弃意图所允许的每个备选。那次丢弃是关于备选之信息的擦除,并有热力学底板。RCE 对每个新情形付一次丢弃并存储结果,因此重复情形不再擦除新东西。
2.2 RCE 如何转换,以及各档位所在
按编码理论来读,任务作为消息到达,其剩余不确定性是尚无已存契合消解的部分。每个档位以不同代价消除不确定性,档位按该代价排序(§4.2)。
| 档位 | 它对不确定性做什么 | 上述论证中的谱系 |
|---|---|---|
| G0 查找 | 认出意图已被编码;以处理器底板代价用检索消解 | 重复性与克隆 [33, 34, 35];局部性 [46] |
| G1 规则 | 应用已知的看守重写;以无搜索方式消解反复出现的残差 | 正确性保持变换 [52, 58];带证明义务的求精 [55, 56] |
| G2 综合 | 搜索假设空间,并用例子、约束与求解器收窄 | 作为搜索的程序综合 [27, 59, 60] |
| G3 至 G5 模型 | 当更低档位无法弥合缺口时,从学得的代码分布采样;仅作提议者 | 代码的交叉熵模型 [35, 47] |
| 门槛 | 仅在有测试、覆盖与证明证书时接受候选 | Hoare 逻辑 [54];Curry-Howard [18, 72] |
| 晋升 | 存储被接受的契合,使同一残差下次只需 G0 | 最小描述长度 [44];Landauer 擦除只付一次 [65] |
第 2 节各轴上的位置差异,在于转换在何处付费。每次任务都对提示词完整分布采样的路径,每次都再付高熵一侧。存储并复用被接受契合的路径,只为残差付费,且只付一次。多数系统介于两端之间,RCE 位于复用一端。
2.3 大 N 下的生态系统
§1 的论断被直接测量。基准在运行前预注册(bench/ecosystem/PREREG.json)。有种子的生成器写出 10,000 个形式,每个含一个源、一条体为深度至多 3、覆盖八个算子的随机算术项的规则,以及一个汇。引擎冻结于提交 a079967,且不调用模型。
| 性质 | 每个形式检查什么 | N | 成立 | 模型调用 |
|---|---|---|---|---|
| 无损编码 | 形式 IR 到规范 JSON 到形式 IR 到规范 JSON 是恒等 | 10,000 | 10,000 | 0 |
| 确定性投影 | 两次编译给出相同字节;原形式与往返形式的 XState 与 SCXML 投影按字节相同 | 10,000 | 10,000 | 0 |
| 忠实投影,Python | 发出的 Python 模块在 40 个有种子事件上按字节打印参考迹 | 10,000 | 9,999 | 0 |
| 入口门槛,输入 | 五种畸形载荷(错误类型、空值、缺字段、空、嵌套)全部被拒绝,无被接受结果 | 10,000 | 10,000 | 0 |
| 入口门槛,规格 | 流向未声明节点的规格在编译前被拒绝 | 10,000 | 10,000 | 0 |
图 3 显示相同计数。
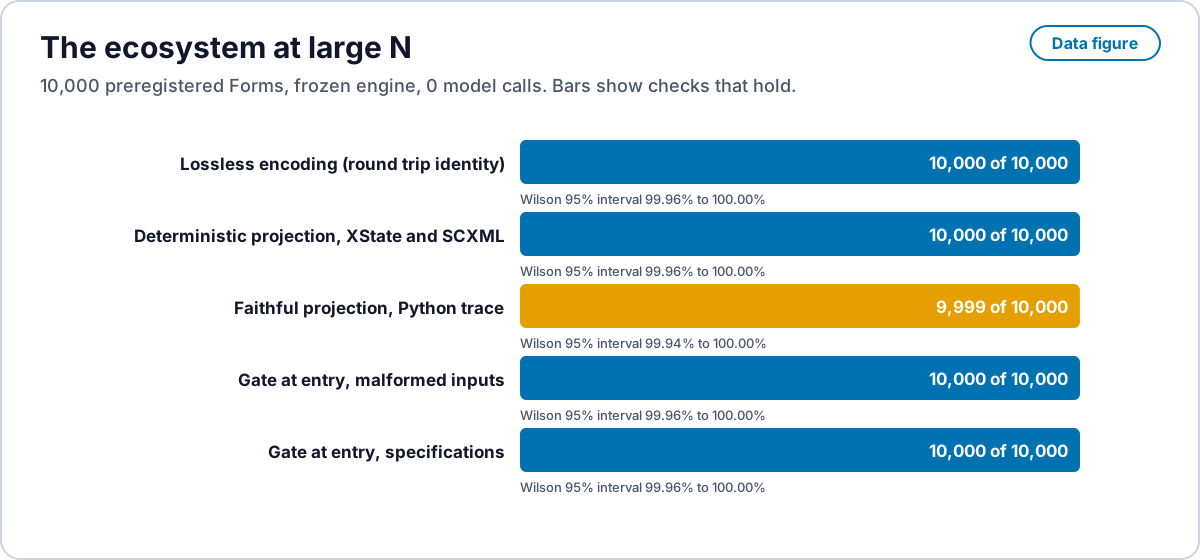
a079967,0 次模型调用,Wilson 95% 区间由计数计算。来源:bench/ecosystem。提供 PNG 副本。 Open full size · PNG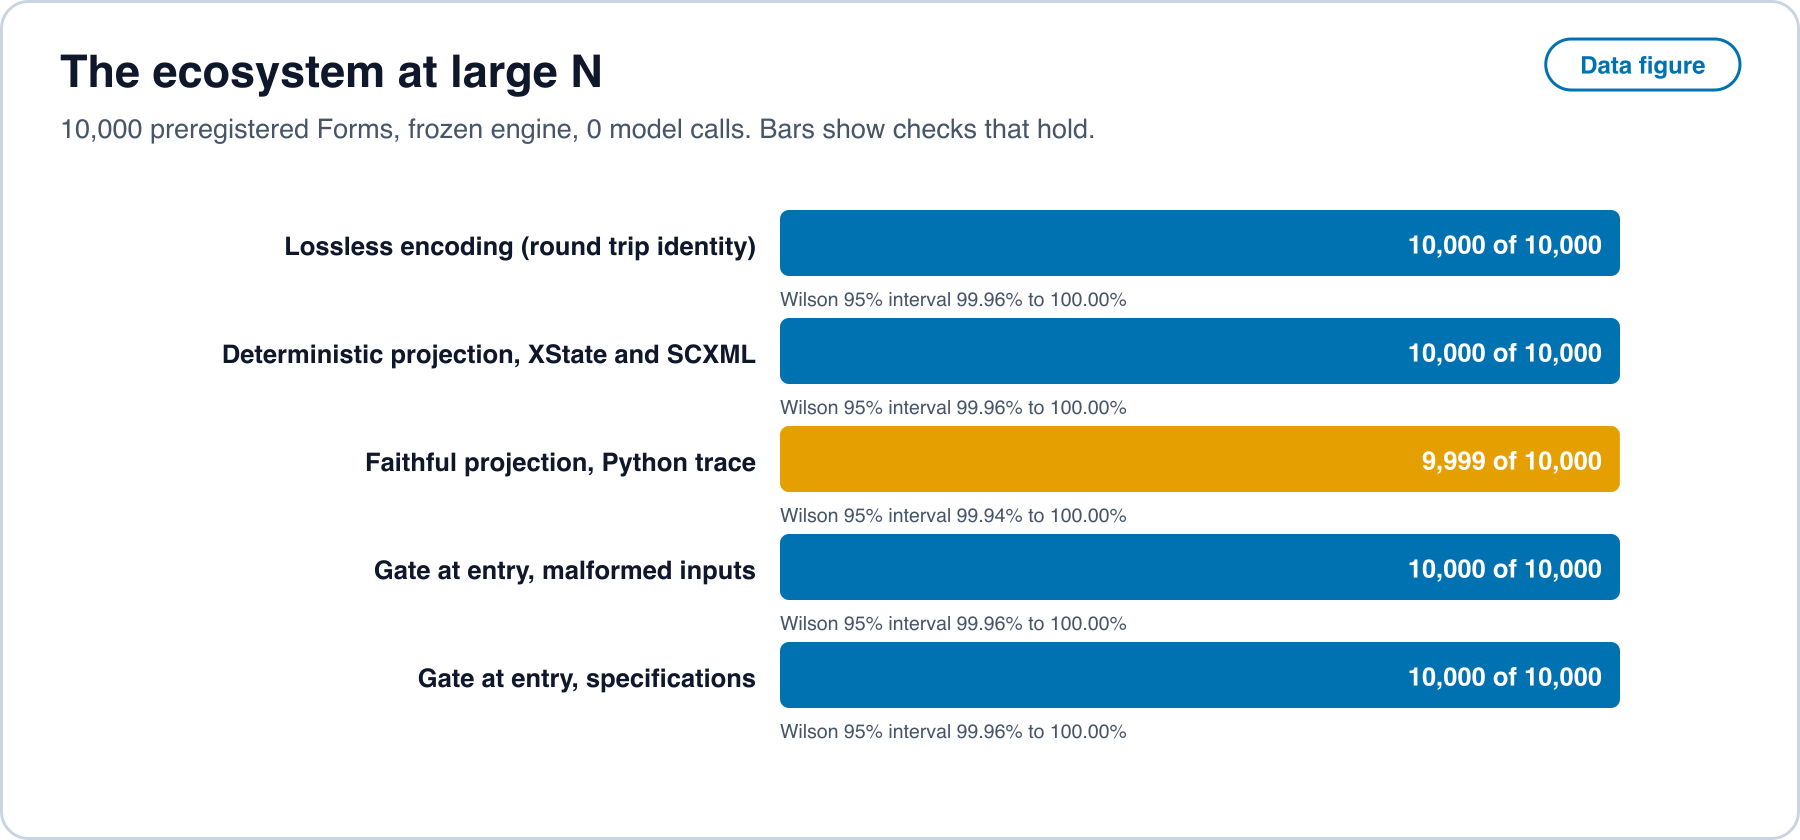
RCE-F0 与 Python 未命中。 第 9 节将 RCE-F0 表述为:在至少 10,000 个形式的预注册运行上,任何投影打印与形式参考迹不同的迹,或任何畸形输入被接受。本次运行是预注册的,有 10,000 个形式,并且有一个发出的 Python 模块没有打印参考迹,因此按所写的字面,这一观察满足 RCE-F0 的条件。本文报告了这次未命中及下文的回归测试,但没有给出根本原因。请按所陈述的文字理解 RCE-F0:它推翻的论断是投影忠实,而本次运行的 Python 投影在一个形式上未满足该论断。未命中来自发出器还是来自测试框架,在此仍未确定。同一形式在 32 个哈希种子下重放相同,这一事实并不能解决这个问题。
那一次 Python 未命中计为未命中;同一形式与事件在回归测试 tests/form_ecosystem_regress.rs 中在 32 个哈希种子下重放相同。此处能量仅为 est_j;整次运行在单核上耗时 393 s CPU。生成的形式较小,因此本表测量编码、投影与门槛。来自真实程序的提升形式按 §8.7 的协议测量。
2.4 有门槛、经验证的递归自我改进
Good (1965) [111] 把超智能机器定义为能设计更好机器的机器,从而使改进递归。Yudkowsky (2013) [113] 把问题表述为回报:每单位改进使下一单位更便宜还是更昂贵。Schmidhuber 的 Gödel 机 (2007) [112] 给出一个带保证的形式答案:程序仅在证明重写改进其期望效用之后,才重写自身任何部分(包括其自身搜索)。Löb 定理 (1955) [114] 是自我信任的证明者所遇障碍,Yudkowsky 与 Herreshoff (2013) [115] 称之为 Löbian 障碍:系统一般不能证明使用其自身证明系统的后继者的可靠性。近期系统放弃证明要求而按测量分数选择:STOP(Zelikman 等,2023)[116] 改进改进代码的脚手架,Darwin Gödel Machine(Zhang 等,2025)[117] 保留按基准分数选出的自我修改编程智能体档案,AlphaEvolve(Novikov 等,2025)[118] 在自动评估器下演化程序,Voyager(Wang 等,2023)[119] 增长经验证技能库供后续任务复用。
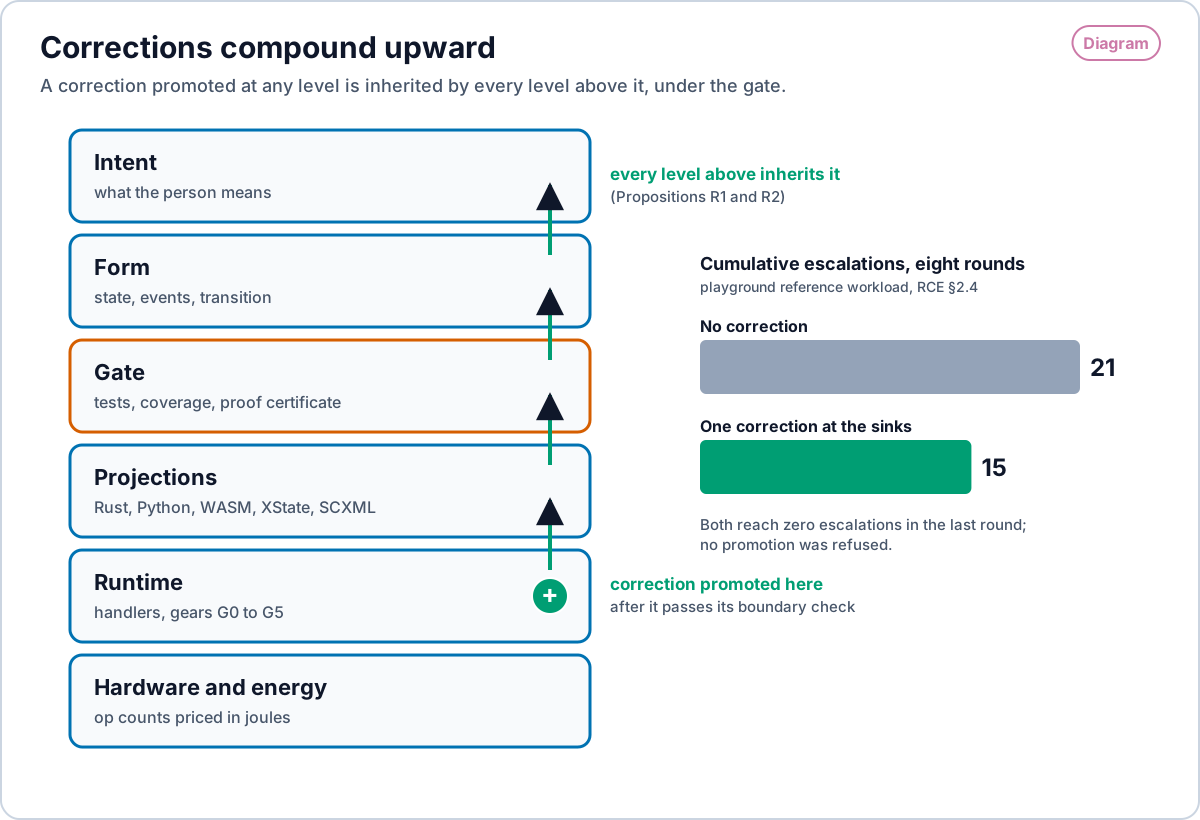
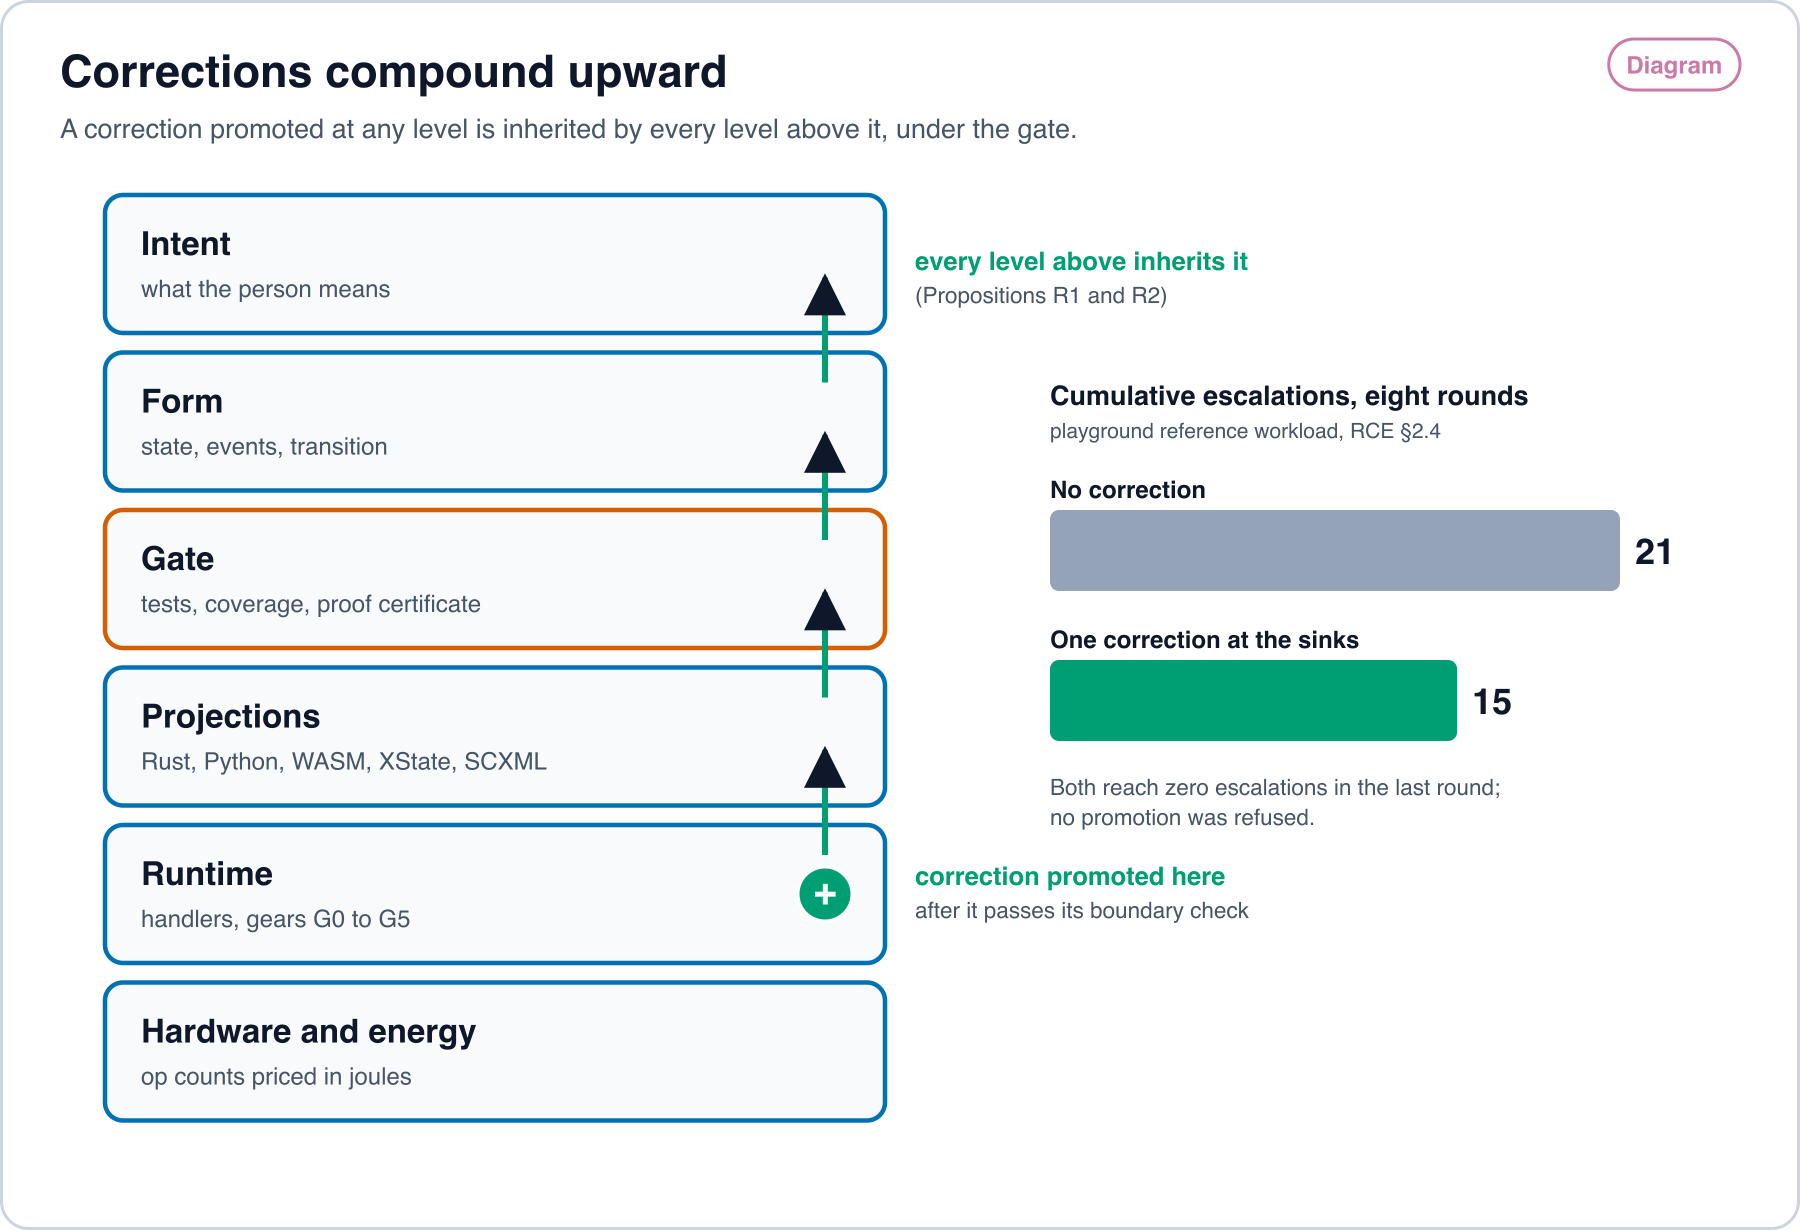
RCE 采取 Gödel 机的结构与 Voyager 的库,并有两点差异以避免对其所晋升对象的障碍。第一,改进的对象不是证明者。RCE 晋升处理器、重写与档位,每一项都对照固定的、单独认证的内核检查:Kani 线束与 SMT 编码在晋升中永不改变,因此任何一步都无需信任后继者的证明系统。第二,门槛是边界上的正确性证明,不是分数。分数可在接口假设破裂时上升;边界上的证明不能被破坏它的变更通过。
命题 R1(单调正确性)。 若每个被晋升的变更通过其边界的检查,且其他边界的检查未变,则那些检查在晋升前确立的每条性质在晋升后仍成立。
命题 R2(复利)。 设工作负载为任务的多重集,且被晋升的处理器关闭其形状的每项任务。则第 t 轮中的升级次数对 t 非增,且在第 1 轮前晋升的修正按它在每轮后续关闭的升级数降低每个视界的累计升级。在引擎演示的参考工作负载中,八轮累计升级在汇处一次修正后从 21 降到 15,两种情形下最后一轮都达到零,每项任务正确关闭且无晋升被拒绝。
图 4 画出命题 R1 与 R2 的机制及参考工作负载的合计。
命题 R3(成本下降)。 由于被晋升的处理器在模型调用之处执行,其成本是按基底表计价的处理器操作计数,因此当升级趋向零时,一轮的能量趋向仅处理器的能量。
Futamura 投影(1971,再版 1999)[120] 与 Turchin 的超编译(1986)[121] 给出该过程的极限。把解释器特化到程序得到编译后的程序;特化特化器得到编译器。RCE 的晋升把一般升级路径特化到实际出现的形状,因此引擎向其工作负载的残差程序收敛:仍须由模型或人提供的计算部分。门槛下的递归自我改进,就是以经检查步骤做出的那种收敛。RCE 引擎演示 的复利层在浏览器中运行该工作负载。
3. 形式
3.1 “同一形式”的最强形式陈述
定理的范围先陈述。Gurevich 的顺序公设覆盖顺序算法;并行与交互算法需要 Blass 与 Gurevich 的进一步公设 [3]。Blass、Dershowitz 与 Gurevich 主张,没有单一的算法等价关系适合每一目的 [79],Moschovakis 与 Vardi 阐述了何为算法的争论 [80, 81]。做输入输出的网络处理器落在顺序定理之外。形式处理交互的方式与交互进路相同:每个输入是 中的事件,状态机在其上步进。因此“一个形式”是植根于顺序定理并按约定扩展的建模选择,生产先例包括 Elm 架构 [83]、持久工作流事件历史 [84] 以及如 Flo 的流语义 [82]。第 3.4 节的命题为该选择陈述。
Gurevich 的抽象状态机(ASM)定理是每个算法有一种形状的最强形式陈述 [2]。抽象状态机是状态为一阶结构、步进为有限组看守更新的机器。Gurevich 陈述三条公设。顺序时间:算法有状态、初始状态与一步映射 。抽象状态:状态是固定词汇上的一阶结构,在同构下封闭。有界探索:有限组项决定每一步。其主定理(定理 6.13)写到:“对每个顺序算法 A,存在等价的顺序抽象状态机 B。”Blass 与 Gurevich 将其扩展到并行算法 [3]。Dershowitz 与 Gurevich 加入第四公理(初始运算可计算)并由此导出 Church 论题 [4]。
3.2 定义
定义 1(形式)。 程序是元组
- ,状态空间:固定词汇 上的结构,分为控制区域 与数据 。 持有逻辑时钟、输入计数与带类型关系(在语言中还包括已声明的区域)。每个状态是 Codd 意义上的数据库实例 [5]。
- ,事件字母表,包括逻辑时钟滴答。
- ,转移:全定义、确定性且纯,写成有限组看守更新“若 则 ”,每步读取有界组位置。它返回下一状态与该步的输出。记 为其状态分量。
- ,持久日志:条目序列 ,其中 是该步之后状态的规范 JSON 的 SHA-256, 是前四个字段的规范 JSON 的 SHA-256,第一个 是 64 个零。日志是哈希链,因此改变任何过去条目会改变其后每个 。
- ,输出映射。Mealy 机读两个参数 [6];Moore 机只读状态 [7]。
定义 2(形式与契合)。 形式 是带四条不变量的元组形状: 确定性且纯;探索有界;词汇固定;状态是日志的折叠,
日志也可携带每个条目的结果、输出与状态。它们是导出的:不被哈希,且必须等于重放(§3.7 的 T1 与 T3)。两种拒绝是不同的。在引擎配置中每个事件都被应用,违反其契约的输入产生 reject 输出与一条错误行。在语言中,被拒绝的事件使状态不变(T8),并被记录为已拒绝。
契合 是填充该形状的数据:词汇 ,字母表 与 ,定义 的规则程序 ,定义 的输出规则,以及初始数据 。用 Gurevich 的话说,契合是词汇、ASM 程序与初始结构。用 Codd 的话说, 是模式, 是实例。用产品线的话说,契合是特征选择 [8]。用语法引导综合(SyGuS)的话说,契合是满足规格的语法中的项 [9]。
定义 3(契合等价)。 两个契合等价,当且仅当对每个事件序列 ,它们在 下的输出序列相等。
定义 4(契合语言)。 其项表示契合的语法。编程语言、SCXML 文档、XState 配置与 .rce 规格是契合语言。当 上每个 ASM 程序在其中有项时,契合语言是完备的。
定义 5(控制投影)。 把 拆成有限控制符号与数据关系。 的状态图是 到 上的投影:状态是 的值,转移携带事件与对 的看守,动作是对 的更新。Harel 的状态图给出层次与正交区域 [10]。
定义 6(契合 e-图)。 对契合 与一组可靠重写 ,契合 e-图 是 的规则项在 下饱和的 e-图 [11, 12]。每个 e-类容纳按定义 3 等价的契合。
定义 7(焦耳成本)。 是在命名基底上运行项 一次的估计能量(est_j),按期望运行次数加权。
3.3 为何是“数据库函数式状态机”
有限关系结构是数据库实例,因此 Gurevich 状态是数据库,每一步是有界事务。数据库: 是关系结构。函数式: 与 是纯的。状态机:运行是 在事件上的折叠。Moseley 与 Marks 在架构上画出同一条线 [13]。事件溯源在应用状态上画出它:“把对应用状态的所有变更捕捉为事件序列”[14]。Dedalus 在逻辑上画出它,可变状态是按时间索引的关系 [15]。
3.4 命题
命题 1(形式捕捉每个顺序算法)。 对每个顺序算法 ,存在形式实例 ,其运行即 的运行。
证明概要。 定理 6.13 给出具有 的状态、初始状态与一步映射的 ASM 。设 ,,, 为恒等。 次滴答后的折叠是 。由 Gurevich 的推论 3.3, 与 有相同运行。∎
命题 1b(交互程序)。 用在每步前设为 的零元输入符号扩展 ;则 是扩展词汇上的顺序算法,命题 1 适用。该构造是我们的。
命题 1c(可计算性)。 在 Dershowitz 与 Gurevich 公理下,每个形式实例计算 Turing 可计算函数 [4, 16, 17]。形式不增加能力。它给该类中每个程序一种形状。
命题 1d(证明是契合)。 “对给定命题的每个证明,存在对应类型的程序”[18]。类型是规格,证明是满足它的契合。正确性门槛是该证明或通过接受测试的存在。
命题 2(一个生成器)。 一个函数 为每个契合生成可运行程序,且不读领域。依据: 每个程序是形式实例,因此 发出带类型的存储、事件类型、编译后的规则、带折叠的日志与输出分派器。Rails 生成器、JHipster 与 Yeoman 等脚手架是限制在小契合语言上的 。产品线工程始于“对相关软件系统共性的系统发现与利用”[8];共性就是形式。
命题 3(最小能量抽取)。 用 抽取返回抽取器在 的 e-类中找到的焦耳最少的项。证明概要。 重写是可靠的,因此 e-类中每一项都有 的可观察行为并通过同一门槛。抽取最小化成本,成本是焦耳。∎ 这是 Mixture of Limits(极限混合)应用于代码:保留完成任务的最小契合,其余是浪费。
命题 4(重放确定性)。 若 不读墙上时钟、无名称地排序更新并记录每个输入,则对同一 的两次重放在每步给出相同状态哈希。
命题 5(状态图投影可靠)。 把运行的每个状态投影到 。结果是在相同事件下发出的状态图的一次运行。
命题 6(协调预算)。 标记为单调的规则可在副本上无协调运行;仅非单调规则需要协调点。依据: CALM 定理,“具有一致、无协调分布式实现的程序恰是可用单调逻辑表达的程序”[19]。
标签由规则导出,从不声明;IR 检查拒绝存储标签与导出标签不同的形式(规格,附录 D.5):
| 规则含有 | 标签 | 原因 |
|---|---|---|
| 无 resolve、read、join 或 scan | 单调 | 其写入只增加键并增长计数器 |
| 一个 resolve | 非单调 | 它删除升级行 |
| 读取其自身的汇 | 非单调 | 读取、修改、写入 |
| 一个键控 join | 非单调 | 被连接的行可能现在缺失、之后出现,或被覆盖 |
| 一个 scan | 非单调 | 它观察整个关系,包括缺失的部分 |
标签是可靠的但不完备:对只插入关系的 join 本是单调的,但该配置不证明某关系是只插入的,因此标签不作此声称。当每条规则都单调时,形式是无协调的。每个 read、join 与 scan 看到事件进入时的状态,因此输入事件的后状态不依赖于不同汇的规则的运行顺序;只有输出顺序依赖于它,而输出顺序由内容哈希固定。
命题 7(智能作为焦耳导数)。 设 计通过门槛的任务, 为所耗焦耳。 从记录每个事件及其 est_j 的 事后读出。在 下的抽取固定门槛且不提高 ,因此在相等的 下它不降低 。
3.5 图、e-图与状态图
| 表示 | 形式的部分 | 它决定什么 |
|---|---|---|
| 状态图 | 在 上的看守 | 哪条转移触发 |
| 数据流图 | 与 的读写依赖(Kahn 过程网络 [20]) | 什么运行,以何顺序 |
| E-图 | 契合的等价类 | 哪个等价契合运行 |
状态图与图描述一个契合。e-图描述与之等价的每个契合。抽取按焦耳在其间选择。
3.6 一个生态系统、无损,以及普遍性论题
构造上无损。 Shannon 的信源编码定理把无损码的底板固定在信源熵 [40]。形式在可检查的窄义上是意图的无损码:形式的规范序列化是单射的,因此在任何状态、事件或转移上不同的两个形式有不同的形状哈希,解码序列化得到同一形式。到目标的每个投影是仅形式的函数。双向变换使往返精确。Foster、Greenwald、Moore、Pierce 与 Schmitt 把透镜定义为带往返条件的 get 与 put 函数对,使视图与其源一致 [122],Hofmann、Pierce 与 Wagner 把条件扩展到对称透镜 [123],Czarnecki 与同事在模型工程、数据库与编程语言上综述同一一致性条件 [124]。RCE 的往返条件是整程序层级的 GetPut 条件:把投影提升回来,形状哈希不变。
构造上正确。 Dijkstra 于 1968 年提出程序与其证明应一同开发,使正确性被设计进去而非事后测试 [125]。Hall 与 Chapman 把该进路带入带形式规格与每步求精的商业安全系统 [126]。Minsky 对类型化函数式编程的规则(使非法状态不可表示)在类型层级说同一件事:不能容纳坏值的类型消除检查它的需要 [127]。Turner 的全函数式编程要求每个函数在每个输入上终止,使程序表示无隐藏失败的数学函数 [128]。RCE 的形式在 Turner 意义上是全的,其合同类型在 Minsky 意义上使未声明状态不可表示,且 §2.1 的求精链在 Dijkstra 意义上终止于它。后果即 §1 所述:错误在入口被拒绝,因此事后无物可差分或追踪。
普遍性论题。 用理论术语陈述,论题是存在一个普遍形式。程序在其中原生写成,每种现有语言作为忠实投影从它可达,每个现有程序通过提升进入它。Gurevich 论题给出根基:每个顺序算法在其自身抽象层级上由抽象状态机逐步捕捉 [2],并行算法亦然 [3]。形式是数据库状态上的这样一台机器。
命题 U1(捕捉)。 若语言 中的程序是 Gurevich 意义上的顺序或并行算法,则存在形式,其转移在程序的抽象层级上逐步模拟它 [2, 3]。
命题 U2(忠实投影)。 若形式到 的投影 在合同内每个输入上保持形式的迹,则形式与其投影对迹的每个观察者可互换,且 不添加形式所缺之物。
命题 U3(构造上提升)。 使用中的每种编程语言都有形式语法、产生具体语法树的解析器、抽象语法树及其规格或参考实现固定的语义。提升 按语言分三阶段构建:语法,然后抽象语法树,然后形式,由 的语义为 的每个构造给出其形式规则。如此构建的提升在行为上满足 ,在形状哈希上满足 ,因此该对是 [122] 意义上的透镜,且 中的程序作为形式持有而无损失。
命题 U4(替换)。 若 U2 与 U3 对语言 成立,则无需用 写任何程序:它一次写成形式,并在平台要求处作为 发出。
U1 是定理。U2 按目标用差分测试检查(§5.1),并在 §2.3 的大 N 下检查。U3 是构造,按语言从语法向上构建,§8.7 说明构造如何随构建被测量。
3.7 语言:版本 0.6 与 0.7、成本与定理状态
RCE 语言由书面规格定义,当前为语言版本 0.8 的草案 0.7 文档(/rce/spec/;源文件在 rce 仓库)。每个模块用首行注释选择其语言版本。没有该注释的模块是版本 0.5,即第 2 至 10 节的语言。声明 # rce-version: 0.6 的模块还获得附录 C:par、for ... par、with budget、工作组、LVar、会话与监督者。声明 # rce-version: 0.7 的模块具有版本 0.6 的语言,只有一处不同,即下文标准库方法的成本(附录 C.15)。附录 D 定义引擎配置,即本文引擎所运行的处理器规格与契合。版本 0.5 的模块从不看到附录 C,因此每个有效的版本 0.5 程序都被原样接受。
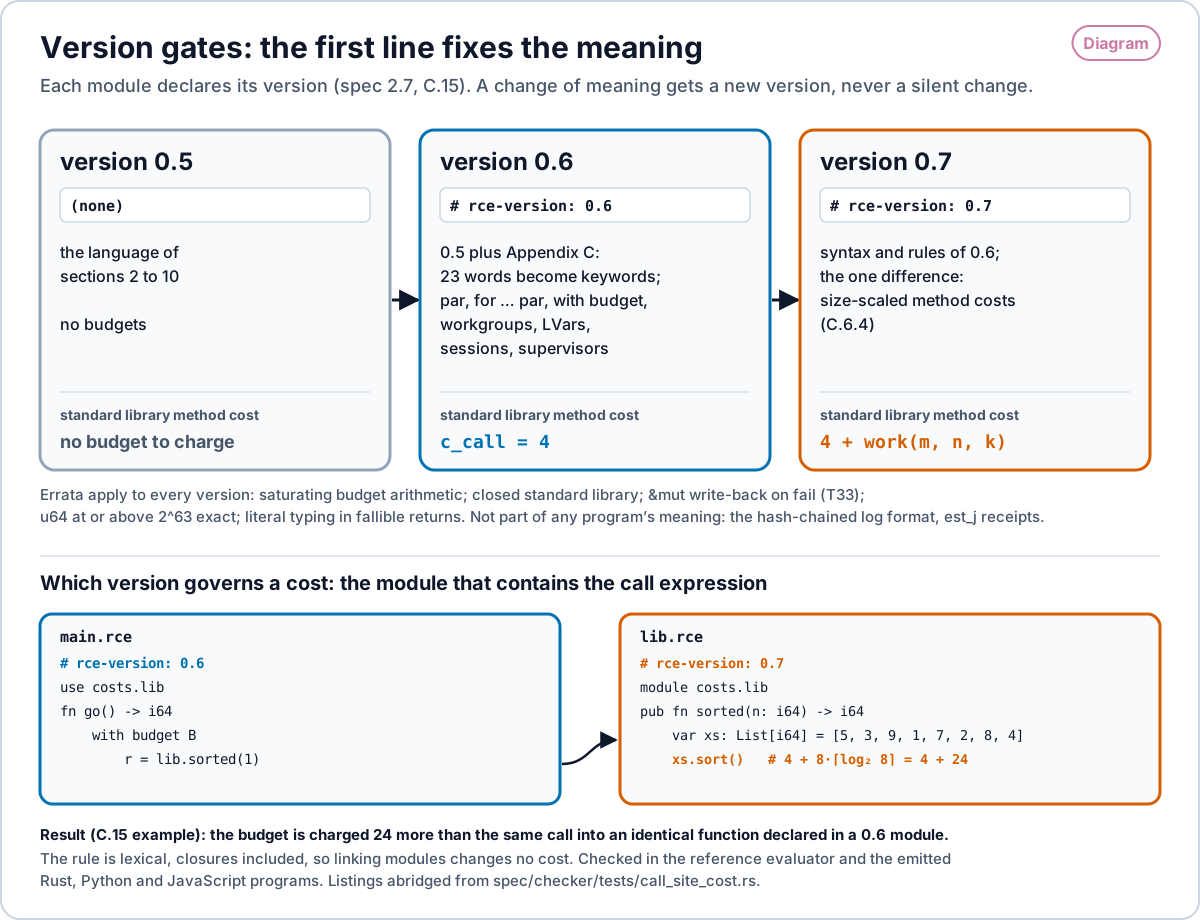
# rce-version: 0.6 加入附录 C(23 个新关键字;par、for ... par、with budget、工作组、LVar、会话、监督者),标准库方法成本为 。# rce-version: 0.7 具有 0.6 的语法与规则,仅方法成本不同,为 。勘误适用于每个版本。包含调用表达式的模块的版本决定其成本:在 with budget 下调用一个导入的、对 8 个元素排序的 0.7 函数的 0.6 函数,比对一个相同的 0.6 函数的同一调用多计 24。来源:规格 2.7、C.6.4 与 C.15;代码清单节选自 spec/checker/tests/call_site_cost.rs。提供 PNG 副本。 Open full size · PNG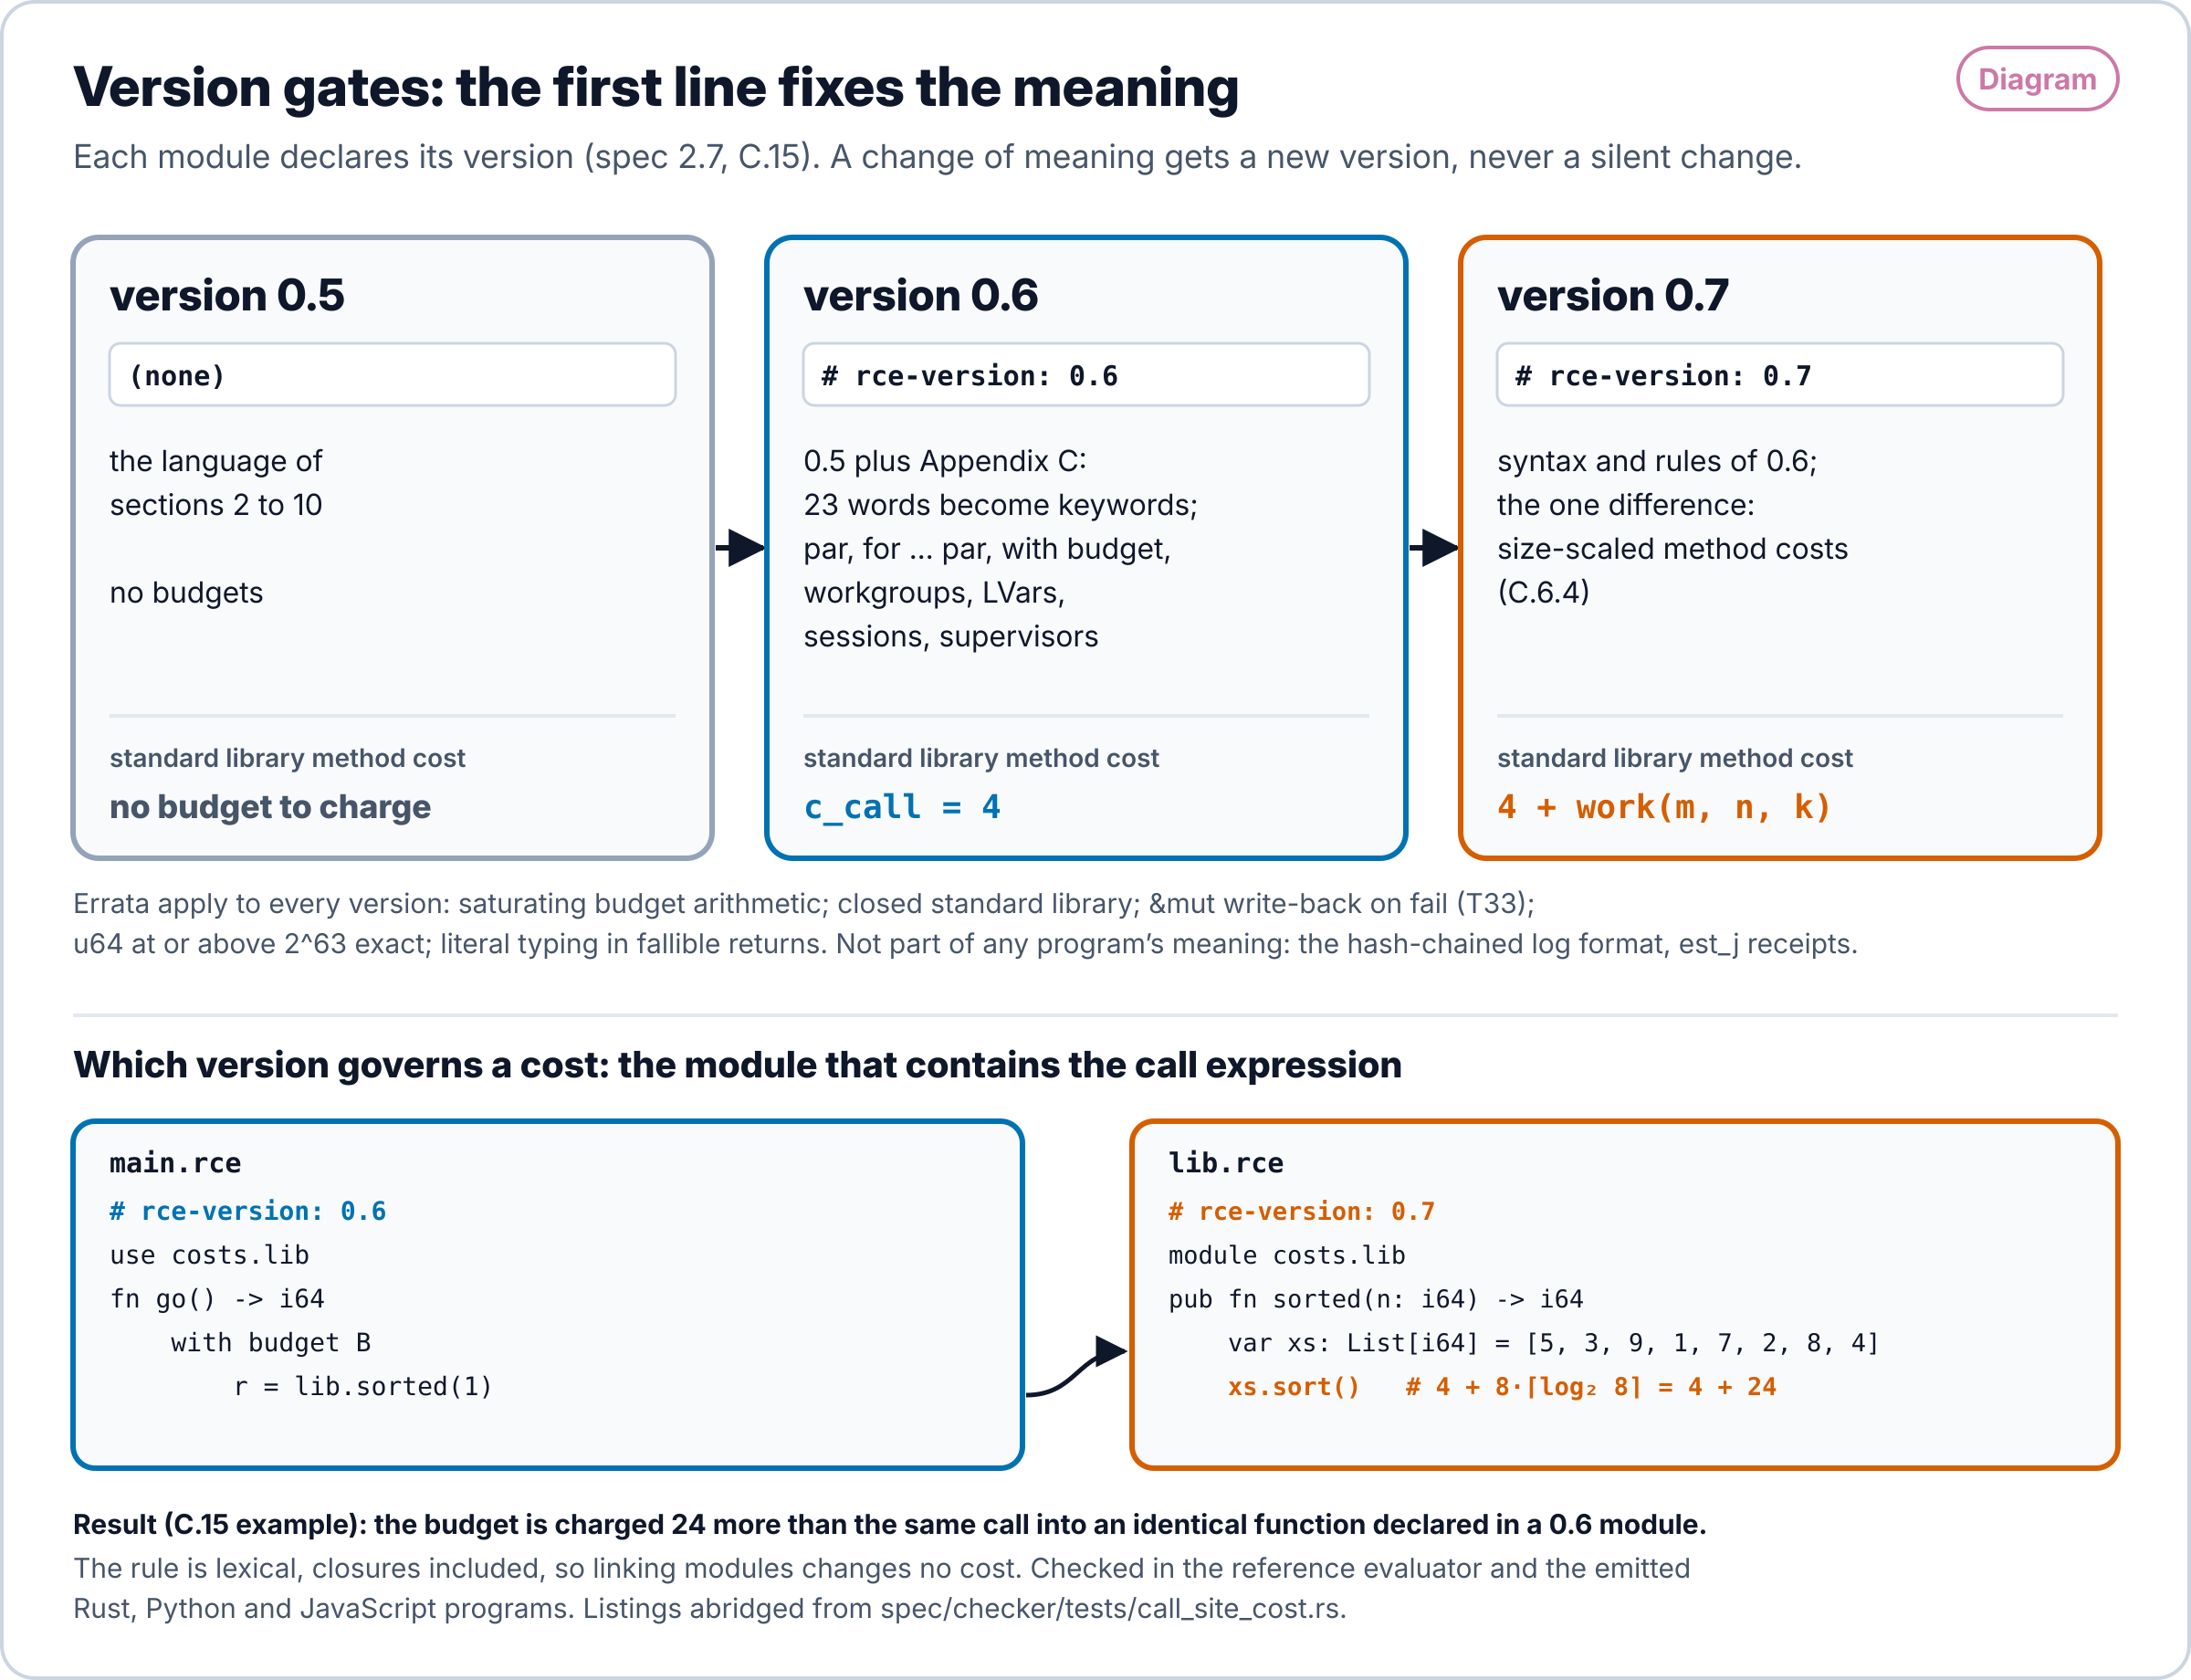
预算计数工作。 with budget 块按附录 C.6.4 的表为每个操作计固定成本,并在计数耗尽时以 budget 陷入。该计数是工作的代理,不是时间或能量的测量;est_j 是另一回事。
| 操作 | 成本 |
|---|---|
| 调用用户函数或闭包, | 4 |
| 接收者规模为 、首参数规模为 的标准库方法 | 版本 0.6 中为 4;版本 0.7 中为 |
| 通道发送或接收 | 8 |
spawn | 32 |
一个 par 分支或 for ... par 分块 | 16 |
含 个结果的列表或映射字面量,或推导式;[x; n] | |
索引、切片、成员访问;一元运算符;and、or;整数、布尔与文本运算符及比较 | 1 |
浮点 +、-、* | 2 |
浮点 /、% | 8 |
规模是文本的 UTF-8 字节长度、列表的长度与映射的条目数;其他任何值规模为 0。方法工作量 由参考求值器中该方法的复杂度类固定:文本、列表与映射上的线性方法为 (映射是有序关联列表),sort 为 (当 时为 0),其余方法为 0。map、filter 与 fold 对其函数参数的调用另外按调用计费。算术在最大的 128 位整数处饱和,且当 或 增长时 从不减少。参考求值器与发出的 Rust、Python 和 JavaScript 运行时计算同一函数,一项测试检查预算陷入在全部四者中落在同一操作上。
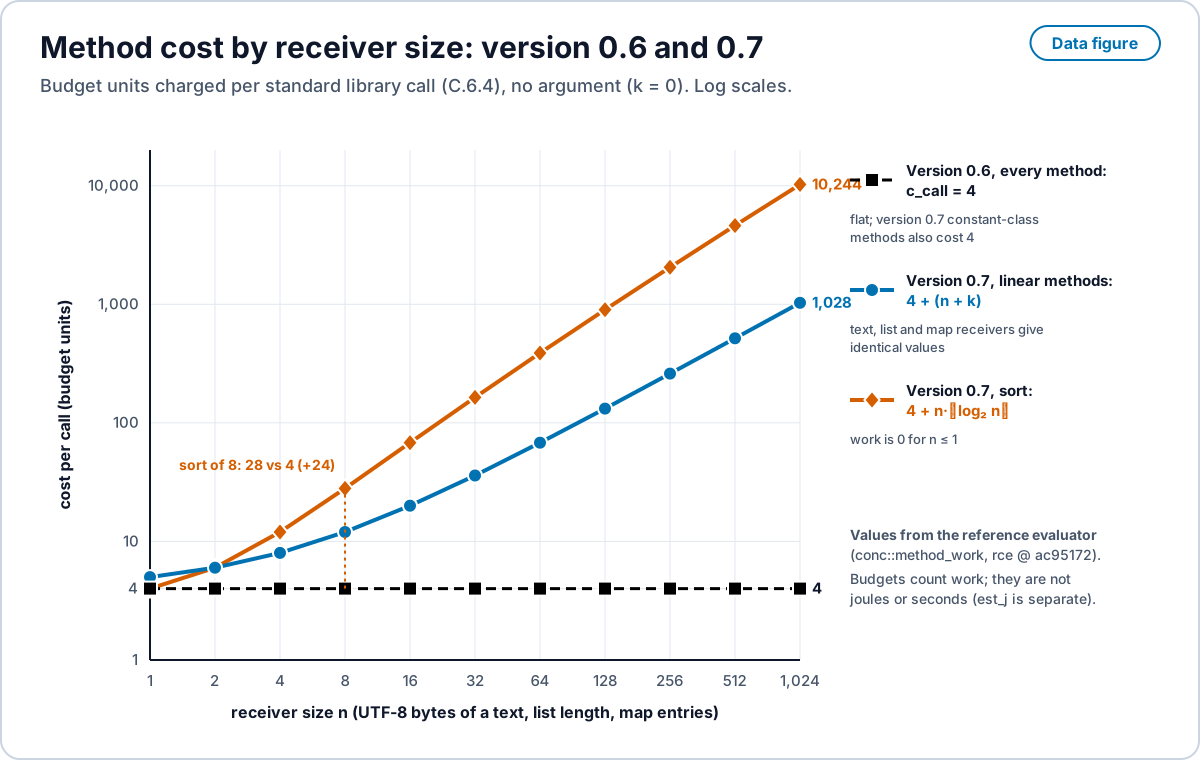
conc::method_work 计算(rce ac95172)。提供 PNG 副本。 Open full size · PNG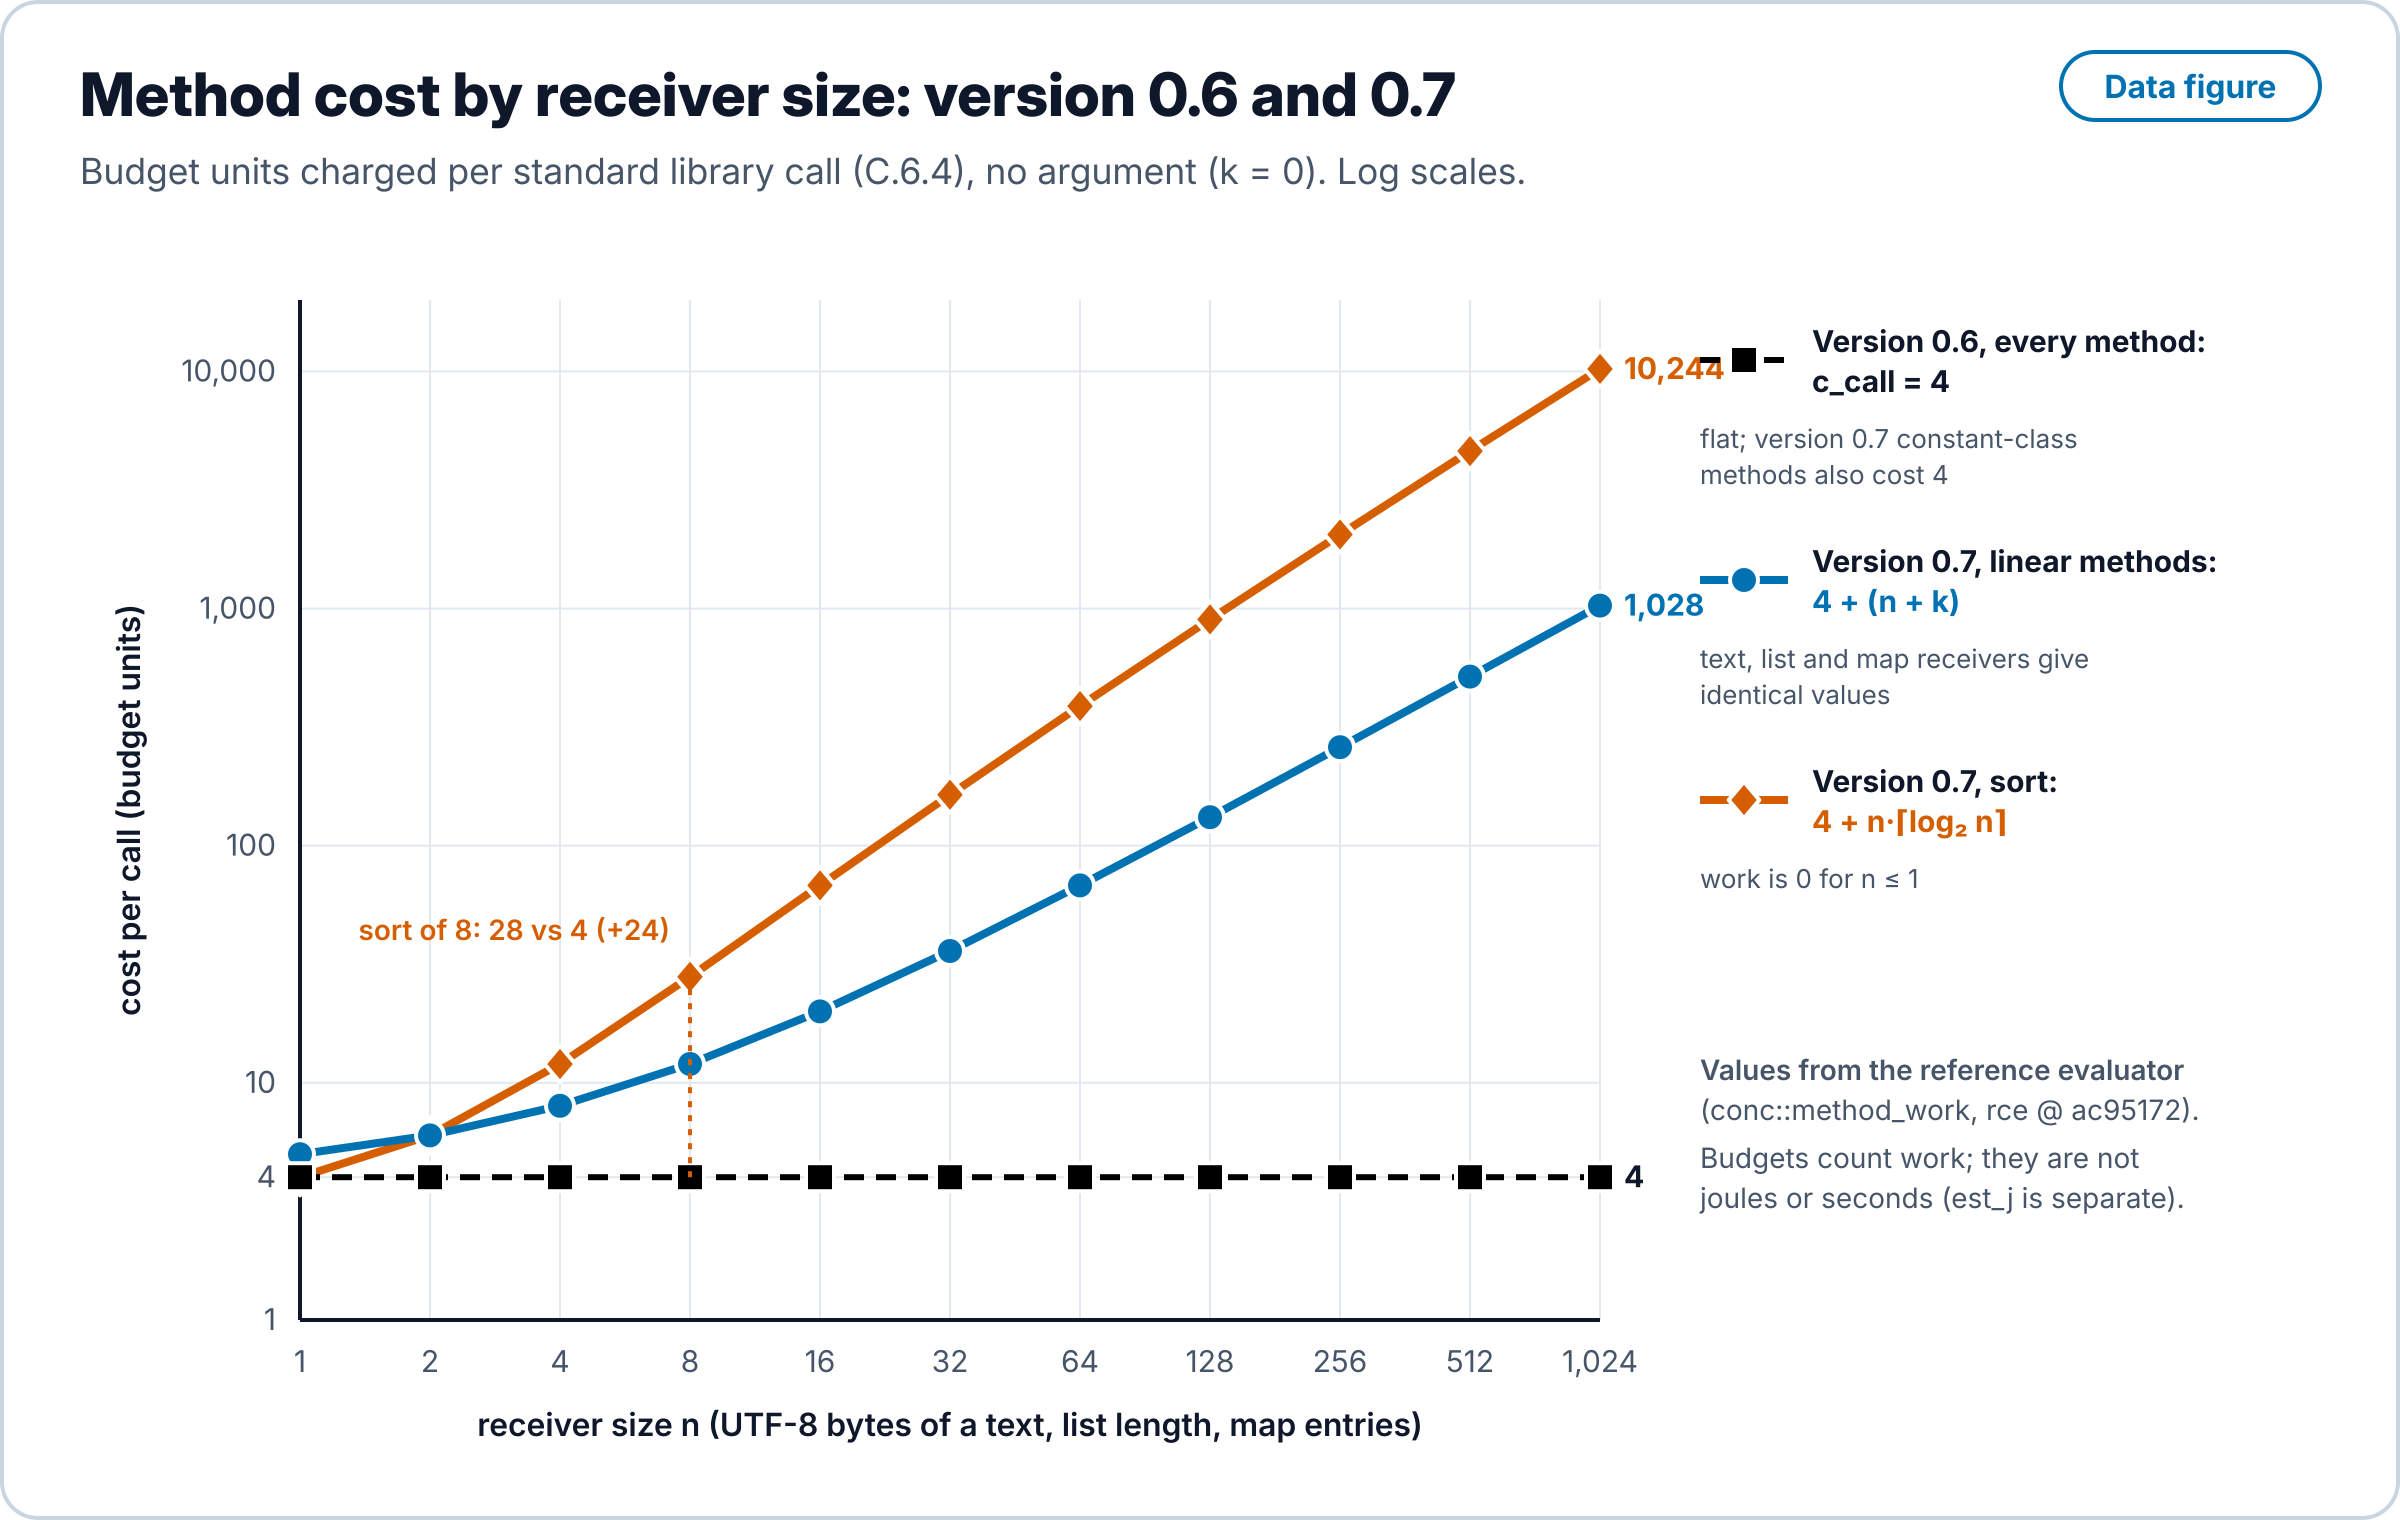
哪个版本决定成本。 一个程序可连接不同版本的模块。方法调用的成本由包含该调用表达式的模块所声明的版本固定,包括写在该模块中的闭包内的调用,而不由被运行函数、其调用者或程序首个模块的版本决定。该规则是词法的,因此链接模块不改变任何成本;规格 2.7 陈述同一规则并指向 C.15。测试在参考求值器以及发出的 Rust、Python 和 JavaScript 程序上,于边界处双向检查它:在 with budget 下调用一个导入的、对 8 元素列表排序的 0.7 函数的 0.6 函数,比对一个相同的 0.6 函数的同一调用多计 24。
定理状态。 规格陈述定理 T1 至 T34,并准确记录每个的状态。证明以 Lean 4(v4.12.0,无 Mathlib)在一个核心演算上写成。用于结果级别的词如下。已证明 指关于语言核心语义的 Lean 证明。在语义上已证明 指在 RCE 一个核心的小步语义上的 Lean 证明。模型 指关于一个抽象模型的 Lean 证明,该模型未与 RCE 语义或参考求值器相连。向量 指参考求值器在生成程序上的结果由 Lean 内核对照模型检查,这是样本上的对应,不是关于求值器的证明。已测试 指在陈述输入上的差分测试。机械检查 指由程序判定,例如 LALR(1) 表构建器。
| 陈述 | 级别 | |
|---|---|---|
| T1 | 确定性:每个状态与事件一个结果;并发语义每个滴答一个结果 | 已证明 |
| T2 | 的全定义性,带求值步数的显式界;结构递归以及沿调用图的界组合 | 已证明(Lean 表达式核心没有用户函数调用;递归与组合在单独的模型上证明) |
| T3 | 运行时状态是 ,重放复现每个哈希与输出 | 已证明 |
| T4 | 进展,包括滴答(某任务前进,或运行结束或报告 Deadlock) | 已证明 |
| T5 | 保持,包括每个被写字段的整数范围 | 已证明 |
| T6 | 内存安全、完整借用路径、任务间无可变共享 | 对所有权核心与借用路径的插桩语义已证明 |
| T7 | 日志哈希、id 与 select 选择的名称无关性 | 已证明 |
| T8 | 原子性:被拒绝的事件使状态不变 | 已证明 |
| T9-F | 形式 IR 目标(Rust、WASM、Python、XState、SCXML)打印参考迹 | 已测试 |
| T9-L | 程序发出器(rust、python、js)与参考求值器一致 | 对 Rust 发出器在一个核心上已证明,作为到 MiniRust(所发出 Rust 子集的深嵌入)的经验证翻译;rustc 实现 MiniRust 一事被信任并经测试;其他发出器已测试 |
| T10 | 语法无歧义 | 机械检查(LALR(1),0 冲突,两个版本均如此)并由模糊测试器抽样 |
| T11 | select 公平性 | 在轮转模型上已证明 |
| T12 | 线性句柄在每条路径上恰被消耗一次 | 在语句模型上已证明 |
| T13 | 在 IEEE 754 上一致的目标上,f32 运算给出相同的位 | 对乘法已证明;对加法、减法与除法,单次舍入性质是 Figueroa 定理,被引用而未机械化 |
| T14 | 带检查的 u64 算术在范围内精确 | 已证明 |
| T15 | 迭代器终止、遵守循环上限且前缀一致 | 已证明 |
| T16 至 T31 | 版本 0.6 并发:par 确定性、交换、归约、无死锁、截止时间、工作组、向量时钟、优先级、作用域、actor、会话、LVar、原子批、副本 | 在语义上已证明:T16、T17、T19a、T20、T23;在运行模型上已证明:T24;在会话演算上已证明:T28;模型:T18、T19b、T21、T22、T25、T26、T31;带向量的模型:T27、T29、T30。均不是关于 Rust 参考求值器的证明 |
| T32 | 外部重放:对每个预言机,日志的重放等于实时运行,且答案契约对每个记录的答案成立 | 已证明 |
| T33 | 失败时的 &mut 恢复(F.4.4):失败的调用使调用者的 &mut 状态保持调用时的样子;返回的调用会回写(较早的“在每种结果上复制出”规则已退役) | 已证明 |
| T34 | 每个发出器之前的保序 ANF 遍给出相同的值、存储以及计费与发出的迹 | 对带完整 ANF 的核心片段已证明;实现在每个目标上经差分测试,包括跨越陷入点的预算扫描 |
T9 有两个目标集,因为本文的引擎与语言有两个编译器。T9-F 是关于 rce form --emit 的论断,§5.1 对其进行测量。T9-L 是关于语言的程序发出器的论断。这些集合之外的目标没有 T9 论断。
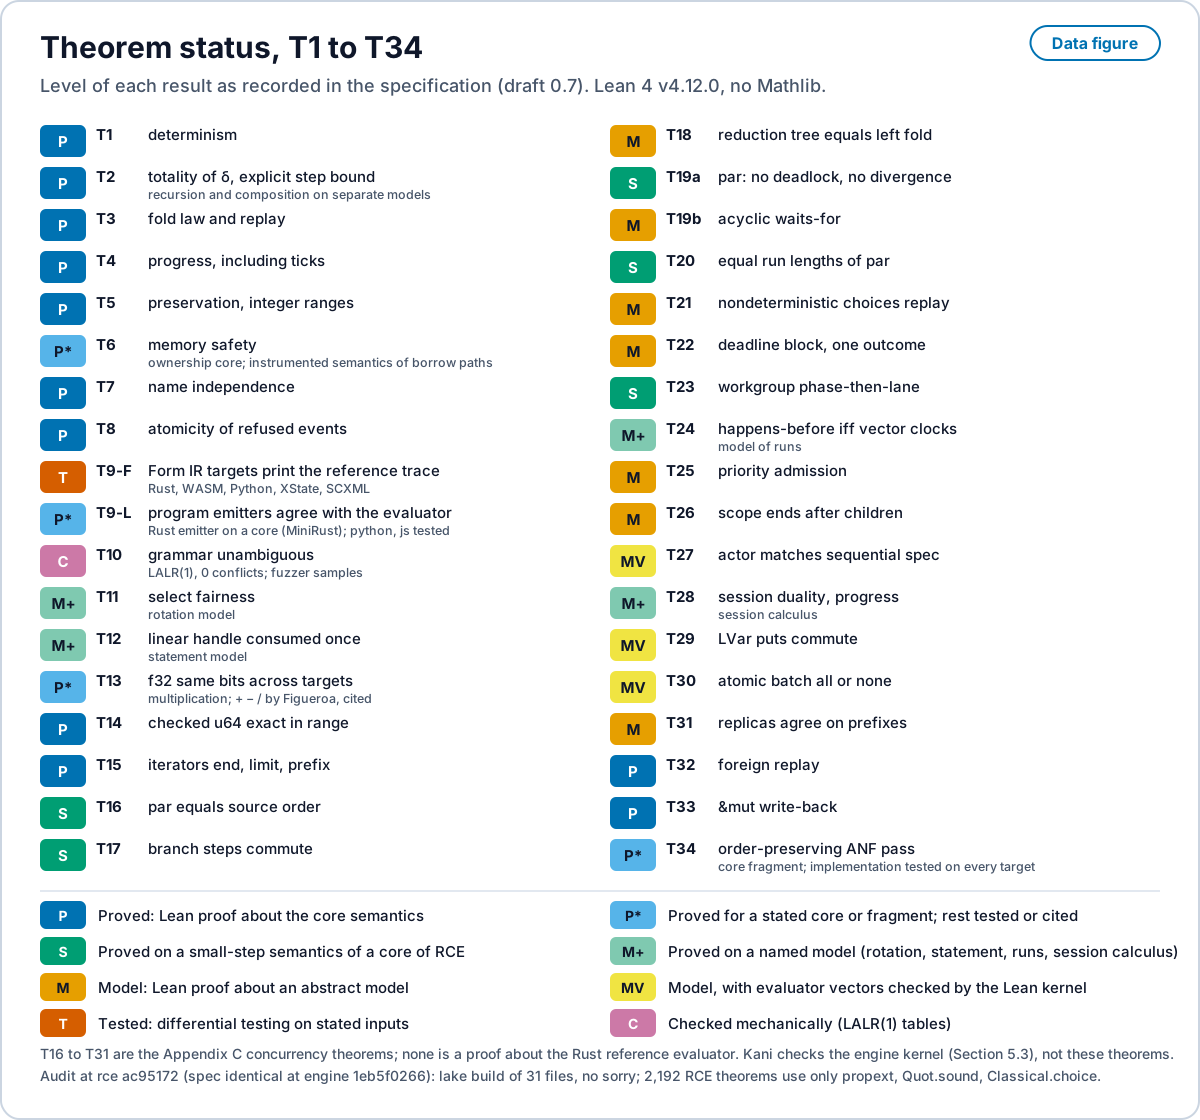
P:关于核心语义的 Lean 证明。P*:对陈述的核心或片段已证明,其余经测试或被引用。S:在 RCE 一个核心的小步语义上已证明。M+:在具名模型(轮转模型、语句模型、运行模型、会话演算)上已证明。M:关于抽象模型的 Lean 证明。MV:模型,带由 Lean 内核检查的参考求值器向量。T:差分测试。C:机械检查。T16 至 T31 属于版本 0.6,均不是关于 Rust 参考求值器的证明。Lean 4 v4.12.0,无 Mathlib。来源:spec/book/10-theorems.md 与附录 C.13。提供 PNG 副本。 Open full size · PNG
本版本运行的检查。 在引擎提交 1eb5f02 上,lake build 在 spec/lean/RCE/ 的 31 个文件上完成且无 sorry(公开 4304048 上为 46 个文件,e416fd0 上为 58 个),常设审计报告 2,192 个定理常量(审计计入每个内核定理常量;见上文的更正说明)的公理仅为 propext、Quot.sound 与 Classical.choice。Kani 验证 10 个内核线束中的 10 个(§5.3)。引擎测试(cargo test --release)通过 589 个不同测试,0 失败(2 个忽略);make check 报告 596,因为其证明步骤把其中 7 个测试再运行一次。参考检查器按其持续集成的方式从公开仓库构建,在默认构建中通过 56 个测试,启用版本 0.6 与 0.7 套件时通过 112 个,0 失败,加上 tree-sitter 一致性测试为 57 个。规格检查为版本 0.5 以及共享一套语法的版本 0.6 与 0.7 构建 LALR(1) 表,0 冲突,并用三个解析器解析每个示例;检查器的 WebAssembly 构建对示例语料通过 401 项检查中的 401 项。
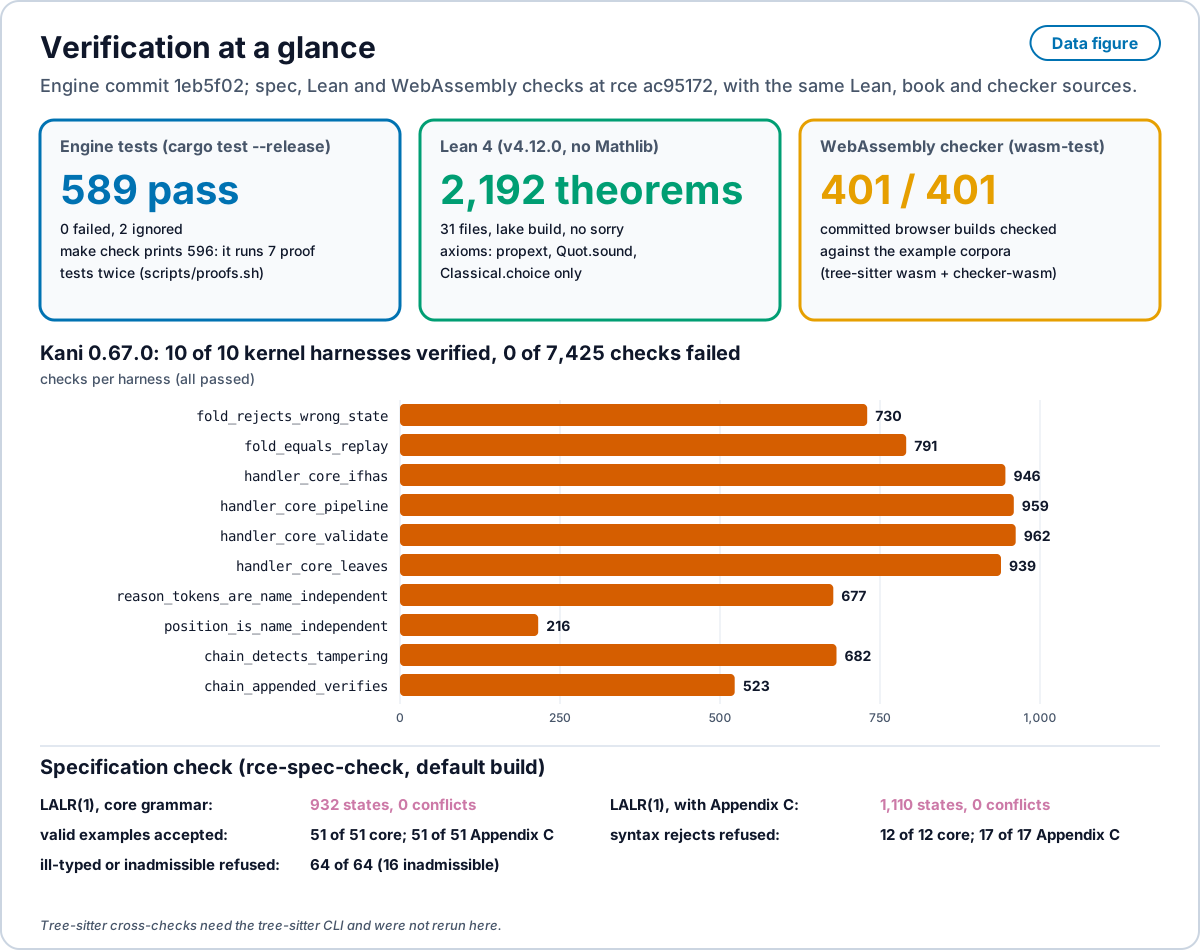
1eb5f02。数据图。引擎测试(cargo test --release):589 通过、0 失败、2 忽略;make check 报告 596,因为它把 7 个证明测试运行两次。Lean 4:lake build 在 spec/lean/RCE/ 的 31 个文件上无 sorry;审计报告 2,192 个定理常量(审计计数,而非源代码声明),其公理仅为 propext、Quot.sound 与 Classical.choice。Kani 0.67.0 验证 10 个内核线束中的 10 个,7,425 项检查中 0 项失败(条形:每个线束的检查数)。检查器的 WebAssembly 构建对示例语料通过 401 项检查中的 401 项。规格检查为版本 0.5(932 个状态)以及版本 0.6 与 0.7(1,110 个状态)构建 0 冲突的 LALR(1) 表,接受 51 个有效示例中的 51 个,并拒绝 12 个语法拒绝中的 12 个以及 64 个类型错误或不可接纳程序中的 64 个。Lean、WebAssembly 与规格检查在 ac95172 处的公开仓库上运行,其规格源文件与引擎的相同。提供 PNG 副本。 Open full size · PNG
一项趋同观察。 agentlanguages.dev 上的目录(2026 年 10 月 13 日读取)列出 42 种为 AI 智能体编写代码而设计的语言,其编辑把它们分为语法阵营、验证阵营与编排阵营。本文中若干设计选择,例如经机械检查的契约、哈希链日志、确定性重放以及每个程序一个规范形式,出现在其对其他独立开发项目的描述中。这是关于这些选择反复出现的观察。它不是它们正确的证据,本文也不与这些项目作比较。
4. 引擎:档位、门槛与收据
4.1 引擎是一个形式
RCE 把软件作为小确定性处理器的图来运行。不能决定的处理器发出升级。解析器回答一次升级,答案被安装为永久处理器,因此同一形状的下一情形无需解析器运行。引擎满足每条形式不变量,每条由 tests/form_laws.rs 中的命名测试检查:
| 不变量 | 引擎做什么 |
|---|---|
| 重载是经验证的折叠 | 重载逐字读日志,重算每个哈希与链接,并用 折叠其余。无物被重新盖戳。断裂的链拒绝加载。 |
| 无名称的滴答顺序 | 处理器按拓扑秩顺序运行,然后按无名称节点键。输出暂存并在所有处理器运行后投递,如 ASM 语义。重命名每个节点在每个入口给出相同的匿名状态哈希。 |
| 无静默丢弃 | 满邮箱把消息保存在有序队列并记录 Backpressure。容量为 1 且 10 个任务时,记录 9 条 Backpressure 且全部 10 个任务关闭。 |
| 载荷在日志中 | 输入、滴答、外部处理器结果、安装与故障是日志条目。每个条目后的状态哈希与从空引擎折叠匹配,在 1,000 个随机日志上。 |
| 逻辑时钟 | 活性计滴答,不计墙上时间。 |
| 稳定哈希 | 在规范 JSON 上的 SHA-256(安全哈希算法,256 位),每层键排序,用于条目、状态、形状与规则 id。 |
4.2 档位
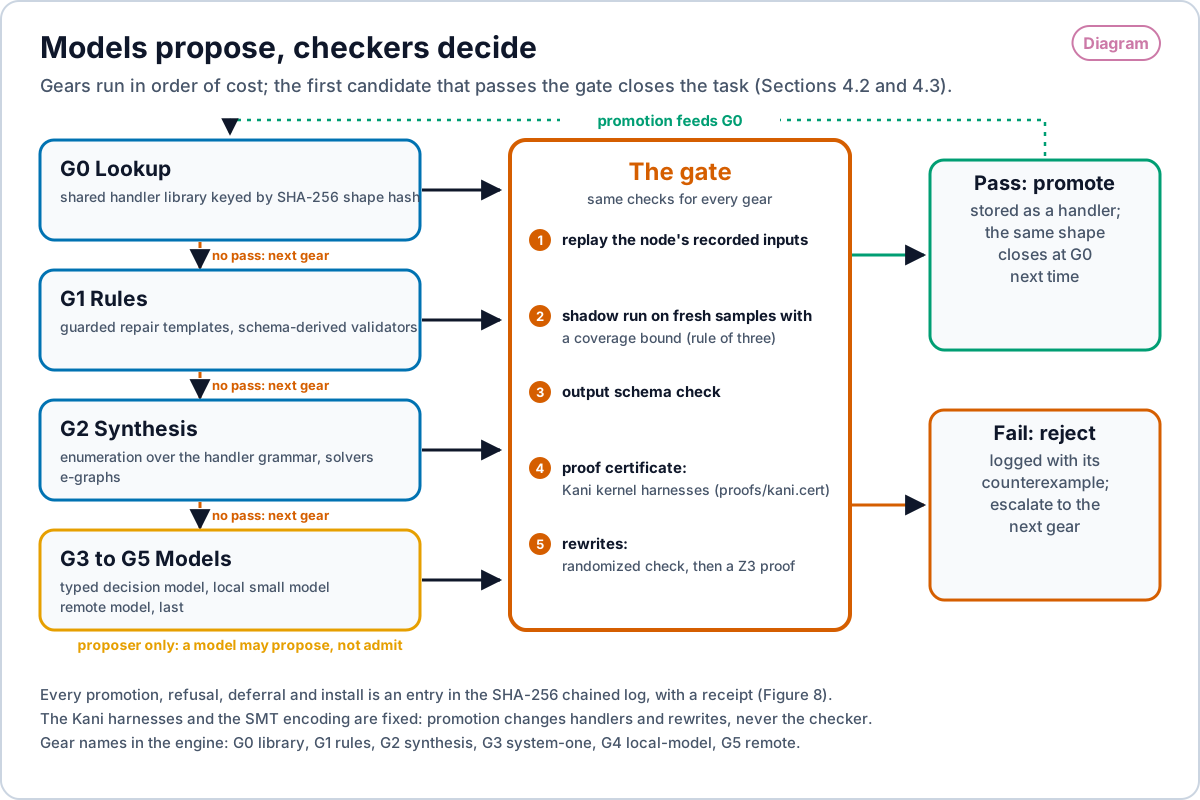
仅当下方档位未通过门槛时才尝试每个档位。该顺序是一条固定级联。
| 档位 | 方法 | 谱系 |
|---|---|---|
| G0 查找 | 按 SHA-256 形状哈希键控的共享处理器库;对代码修复,定位到排序后的函数 | 代码搜索与检索 [21] |
| G1 规则 | 确定性、带看守的修复模板与由模式导出的验证器,每个检查突变敏感性 | PAR、TBar、AVATAR、FixMiner [22, 23, 24, 25];如 Coccinelle 的代码改造 [26] |
| G2 综合 | 在处理器语法、求解器与 e-图上枚举 | 草图、SyGuS、egg [27, 9, 12] |
| G3 至 G5 模型 | 带类型的决策模型、本地小模型,然后远程模型,最后 | 模型级联 [28] |
4.3 门槛
候选仅在通过门槛时被晋升。门槛重放节点已记录的输入,在带覆盖界(在声明错误预算下的三人法则)的新鲜样本上以影子方式运行候选,检查输出模式,并要求第 5 节的证明证书。被拒绝的候选连同其反例被记录。
4.4 收据
每次晋升、拒绝、推迟与安装都是用 SHA-256 链接的只追加日志中的变更,因此篡改任何过去条目会打断链 [29, 30]。每个处理器的成本由解释器操作计数按 FGIR(flowG 的本地代码后端)的主机成本表计价,并标注 est_j。每次工头调用携带其收据。收据写明档位、估计方法(basis)、尝试过的候选以及该档位是否解决了升级。其 est_j 字段是必需的:它是有限非负数,或 null,且仅当 basis 表示 unpriced 时才允许 null,例如没有能量数字的模型调用。缺少该字段的收据无法解析。未计价成本从不被读作零,因此对收据的汇总分别报告已计价与未计价的调用,依赖未计价解决的节省被报告为未知。阶梯运行在子样本上加入包能量计数器,标注 reported_j。
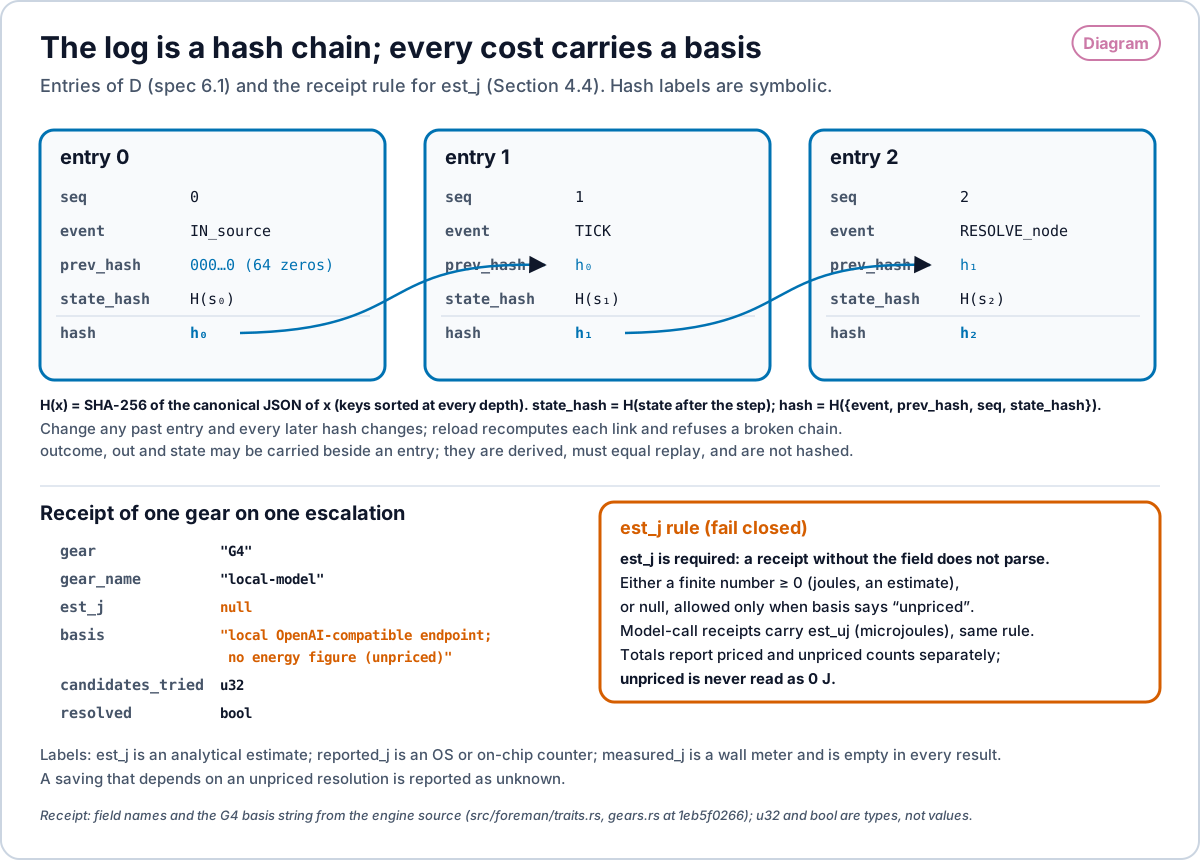
{seq, event, prev_hash, state_hash, hash}。state_hash 是该步之后状态的规范 JSON 的 SHA-256;hash 是 {event, prev_hash, seq, state_hash} 的规范 JSON 的 SHA-256;第一个 prev_hash 是 64 个零,因此改变任何过去条目会改变其后每个哈希。档位收据携带 gear、gear_name、est_j、basis、candidates_tried 与 resolved。est_j 是必需的,是有限非负数,或仅当 basis 表示未计价时为 null;模型调用收据按同一规则携带以微焦耳计的 est_uj。未计价成本从不被读作 0 J。哈希标签是符号性的。来源:规格 6.1 与第 4.4 节。提供 PNG 副本。 Open full size · PNG
4.5 形式编译器
rce form 接受规格及其契合,并从同一形式 IR 发出五个目标:
.rce spec + fit
  lower ─► normalize ─► egg e-graph, equality saturation (+ admitted proposals)
  ─► extract (cost = est_j) ─► Form IR (typed relations, regions, rules with SHA-256 ids)
     ├─ Rust crate (pure step, typed state, SHA-256 log and fold, tests)
     │  └─ WASM (the same crate on wasm32-wasip1)
     ├─ Python (standard library only)
     ├─ XState v5 machine
     └─ SCXML document, executed by SCION
IR 在每个数值边缘固定一种行为:经检查的 64 位整数溢出是错误且永不回绕;整数 / 向零截断();% 取被除数的符号();除以零是错误;浮点是 IEEE 754 binary64,非有限结果是错误;空与缺失不同;时间仅逻辑时钟。每个目标都被生成。无一被手写。
进程、HTTP 或闭包处理器没有项,因此其记录结果编译为按规范输入的 SHA-256 键控的记录预言机。rce scan DIR --form 把现有 Rust、Python、TypeScript 与 Go 提升到形式的模式中,每个被提升元素标注为语法提升。
4.6 方法:整栈被评估,每个接口假设明示
程序是多层栈:词元与语句;处理器;形式,即在 (控制区域;数据:时钟、输入计数与带类型关系)上的单步函数 ;日志,即 SHA-256 哈希链,其条目记录每个事件、它所产状态的哈希以及前一条目的哈希;变换形式的重写;以及执行它的基底。每层依赖关于其下层的假设。RCE 不把任何层当作固定。它评估整栈,把每个接口假设写成可检查陈述,并在每次运行上检查。
| 边界 | 假设 | 检查 |
|---|---|---|
| 源到处理器 | 输入满足其源合同 | δ 输入事件处的合同检查 |
| 处理器到汇 | 每个 Ok 输出满足输出模式 | 处理器证明(verify::handler_proof),由 Kani 检查的内核求值器保证全定义且确定性 |
| 日志到状态 | 每个条目携带其所产状态的哈希 | 内核折叠,拒绝第一个哈希不匹配的条目(Kani 线束 fold_rejects_wrong_state) |
| 重写到形式 | 重写对每个输入保持输出 | 随机化检查,然后用 Z3 的 SMT 证明 |
| 存根到工头 | 不能决定的处理器升级而非猜测 | 存根处理器发出升级;决议仅经晋升路径被晋升 |
| 形式到目标 | 每个发出的目标计算同一 δ | 每个目标携带同一参考迹 |
失败的检查把断裂定位在其发生的边界。修正在该层做出,通过该边界的检查,并被晋升。修正层之上的每一层无需进一步变更即继承修正,因为其上每层仅通过其假设现已检查的接口消费被修正层。这就是修正向上携带并复利的含义。RCE 引擎演示 在编译为 WebAssembly 的 RCE 核心上于浏览器中运行它:其接口层打破每个假设并显示检出它的检查,其复利层显示修正进入每一后续轮次。
5. 验证
5.1 跨五个目标的差分测试
tests/form_targets.rs 驱动十一算子算术规格,含 29 个边缘事件外加 500 个有种子的随机边缘值。生成的 Rust、Python、WASM、XState 与 SCXML 目标按字节打印参考迹,包括算术边缘。这是 McKeeman 与 Csmith 一系的差分测试 [86]:独立实现在既定输入集上一致。它不是翻译验证 [85],也不是经验证的编译器。它覆盖测试中的十一算子与 529 个事件,对它们之外的输入无所言。下方的 Z3 与 Kani 结果才是验证。
图 11 显示一个形式的五个投影以及两个状态图目标的往返。
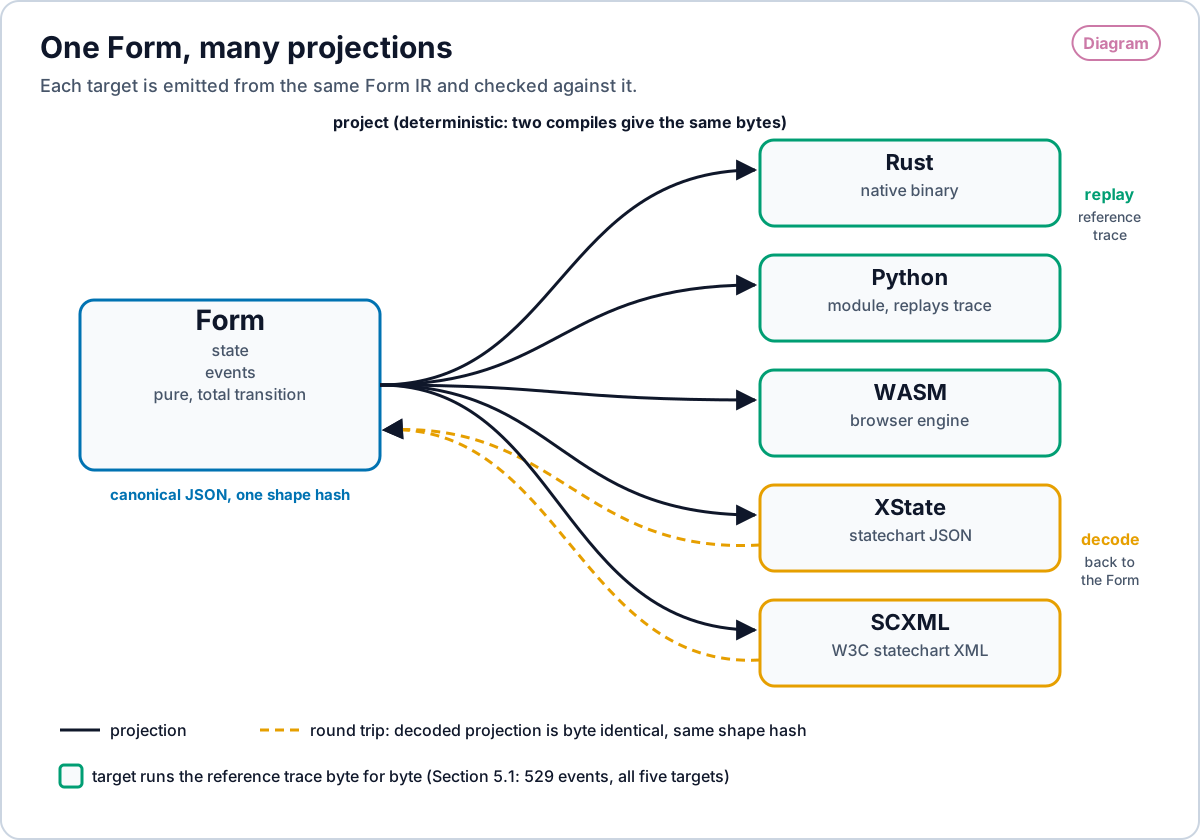
tests/form_targets.rs 的 529 个事件上按字节打印参考迹。提供 PNG 副本。 Open full size · PNG
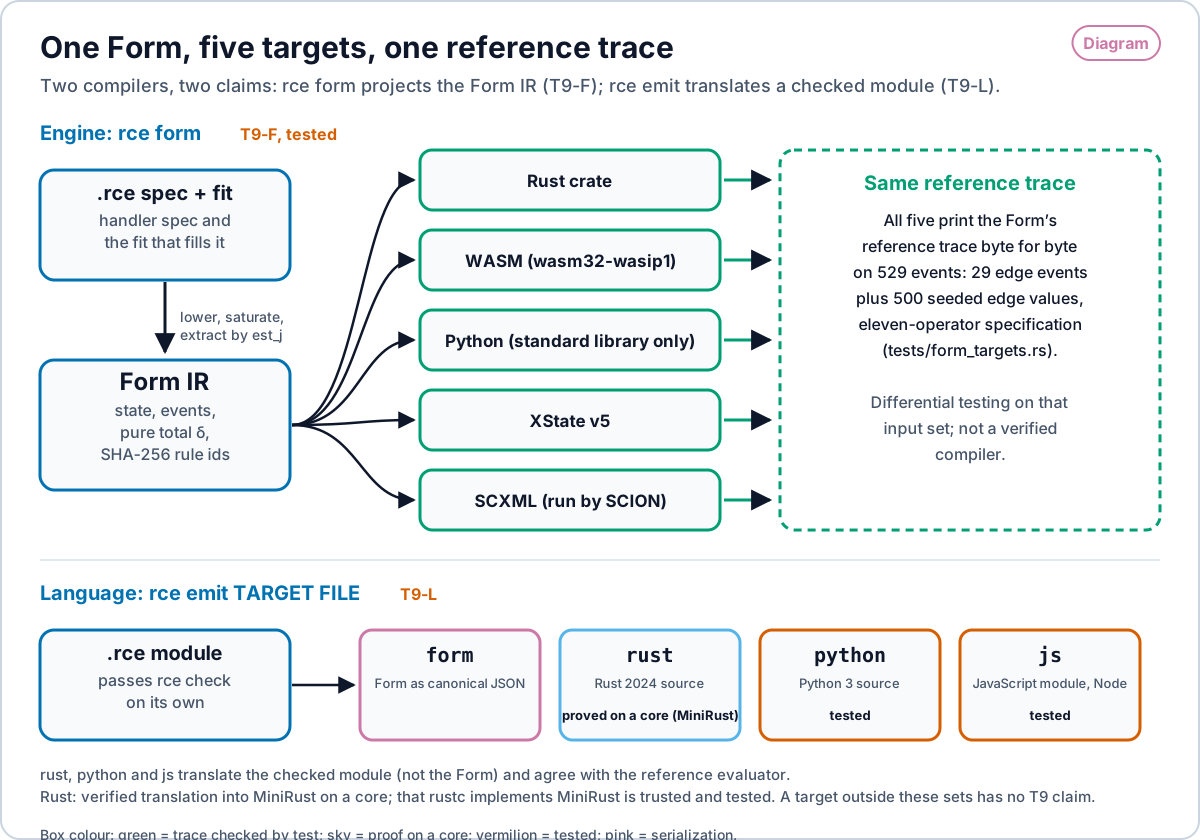
rce form 把处理器规格及其契合降低为形式 IR,并投影到 Rust crate、WASM、Python、XState v5 与 SCXML;全部五个在 529 个事件(29 个边缘事件加上一个十一算子规格的 500 个有种子的边缘值,tests/form_targets.rs)上按字节打印参考迹。这是 T9-F,由差分测试确立,而非经验证的编译器。下方:rce emit TARGET FILE 把经检查的模块(不是形式)翻译为 form JSON、rust、python 或 js;T9-L 对 Rust 发出器在一个核心上作为到 MiniRust 的经验证翻译已证明(rustc 实现 MiniRust 一事被信任并经测试),对其他发出器已测试。提供 PNG 副本。 Open full size · PNG
5.2 在 Z3 中证明的重写
经验证的重写规则有谱系。Ruler 用相等饱和推断并检查重写规则,环中无模型 [87]。因此第 5.5 节承认的 16 条模型提议规则中的 3 条是关于门槛的陈述(门槛拒绝了 13 条),而不是声称模型是最佳规则来源。
每个内置 e-图重写都在 Z3 SMT 求解器(可满足性模理论)[31] 中对照形式项求值与算术的无量词编码证明:值作为数据类型,带检查溢出的 64 位比特向量,带被除数符号的有符号除法与余数,以及 binary64 浮点。改变溢出、升级顺序或消息的重写得不到证明。提议的等价仅在有证明时进入 e-图。
5.3 内核的 Kani 证明
引擎内核(哈希链、折叠、无名称位置与处理器求值)用 Rust 的 Kani 模型检查器检查 [32]。处理器求值是非递归步进的不动点,Kani 按构造子用结构归纳证明该步进全定义且确定性。十个线束经 Kani 0.67.0 验证,7,425 项检查中 0 项失败:
| 线束 | 性质 |
|---|---|
chain_appended_verifies | 追加的哈希链验证通过 |
chain_detects_tampering | 被改条目打断链 |
fold_equals_replay | 折叠等于重放 |
fold_rejects_wrong_state | 与存储状态不一致的折叠被拒绝 |
position_is_name_independent | 规则位置不依赖节点名 |
reason_tokens_are_name_independent | 原因按整词元无名称 |
handler_core_leaves | 叶处理器全定义且确定性 |
handler_core_validate | 验证全定义且确定性 |
handler_core_pipeline | 流水线全定义且确定性 |
handler_core_ifhas | 看守全定义且确定性 |
5.4 证明证书上的晋升门槛
Kani 运行写出证书,其哈希存于 proofs/kani.cert。引擎、日志、规则 id 与处理器求值经已证明内核,晋升要求该证书。
5.5 检查之后作为提议者的模型
模型可提议等价。它不可承认它们。用本地 15 亿参数编程模型(llama.cpp 下的 Qwen2.5-Coder-1.5B)在演示规格上,提议者提出 16 条等价。检查通过随机化试验与 Z3 证明承认 3 条,拒绝 13 条。87 条熟知恒等式(77 条算术、10 条结构)的确定性提议者有 9 条被承认,全部是结构的,78 条被拒绝:每个算术恒等式,因故障顺序、非数字或溢出;以及一个结构重写 const-absorbs-pipe,它会丢弃一个升级的前缀(引擎测试 tests/form_proposers.rs)。
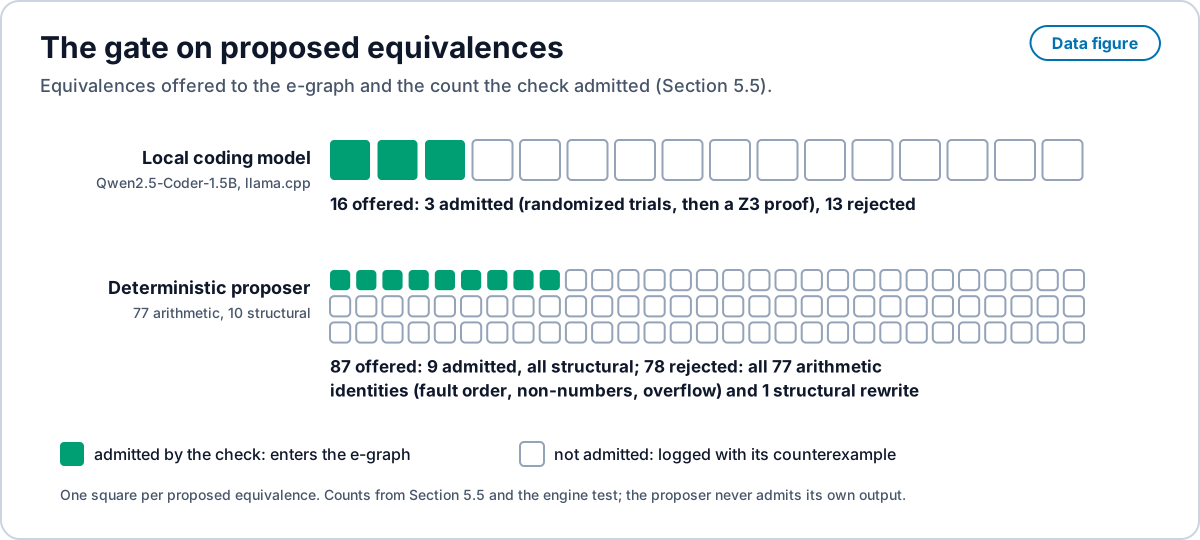
tests/form_proposers.rs。提供 PNG 副本。 Open full size · PNG
5.6 棕地一致
提升从 Rust、Python、TypeScript 与 Go 夹具读同一订单机,在 40 个有种子的、各 30 次调用的序列上运行原代码,并在每种语言的全部 1,200 次调用上一致。冻结的基准在任何结果前预注册,把三个现有销售外联程序重表述为形式。形式在 4,500 个已记录输入中的 4,500 上与原代码一致,且抽取降低每个的 est_j(例如从 J 到 J)。
6. 提升:从其他语言进入生态系统
提升是别处写成的代码进入生态系统的门。它是构造,按语言用每种语言已有的工具做成:形式语法、如 tree-sitter 产生语法树的解析器、抽象语法树以及语言服务器工具解析的符号(Language Server Protocol)。rce scan DIR --form 从该树为 Rust、Python、TypeScript 与 Go 构建形式(§4.5,§5.6)。被提升的程序携带其源的缺陷,因此提升包含修复,下文在公开缺陷语料上于给定位置测量。在生态系统内部,这些缺陷无法被写出。
6.0 被提升代码上的修复阶梯
此处编程任务按它需要的 意图比特 测量:必须从引擎已持有之外供给的比特(编辑周围的程序、库、测试、已知修复索引)。以 表示钉住目标制品的比特, 表示语料已固定的比特,则供给比特为 。在候选中把正确编辑排在第 位的档位供给了 比特的搜索,门槛供给其余。阶梯按编辑大小排序任务,作为 的客观代理:一个词元(L0)、一条语句(L1)、一块改动(L2)、单文件中多块(L3)、多个文件(L4)、由规格或测试产生的函数(L5)、议题级变更(L6)以及由规格产生的程序(L7)。各级、语料、划分与假设在完整运行前预注册;文件在公共仓库中。
| 级 | 留出测试语料 | N | 已解 | 比率 | Wilson 95% CI | 中位搜索比特 | 模型调用 |
|---|---|---|---|---|---|---|---|
| L0 一词元 | 九个真实仓库在钉住提交上的 PIT 风格突变体 [109](Java:commons-math、commons-collections、jsoup、joda-time、gson;Python:click、attrs、pydantic、sympy) | 520,821 | 520,541 | 0.9995 | 0.9994 到 0.9995 | 2.3 | 0 |
| L0 一词元,从未调参的仓库 | commons-text、commons-io、more-itertools、httpx | 23,015 | 23,015 | 1.0000 | 0.9998 到 1.0000 | 2.0 | 0 |
| L1 一语句,Java | ManySStuBs4J 2.0 单块修复 [107] | 24,072 | 9,288 | 0.386 | 0.380 到 0.392 | 3.5 | 0 |
| L1 一语句,Java,整文件 | ManySStuBs4J 2.0 [107],带项目方法与看守索引的父提交文件 | 21,320 | 13,586 | 0.637 | 0.631 到 0.644 | 4.8 | 0 |
| L1 一语句,Python | TSSB-3M v1.0.0,分片 14 与 15 [108] | 157,089 | 27,266 | 0.174 | 0.172 到 0.175 | 4.8 | 0 |
图 14 画出表中各行及其区间。
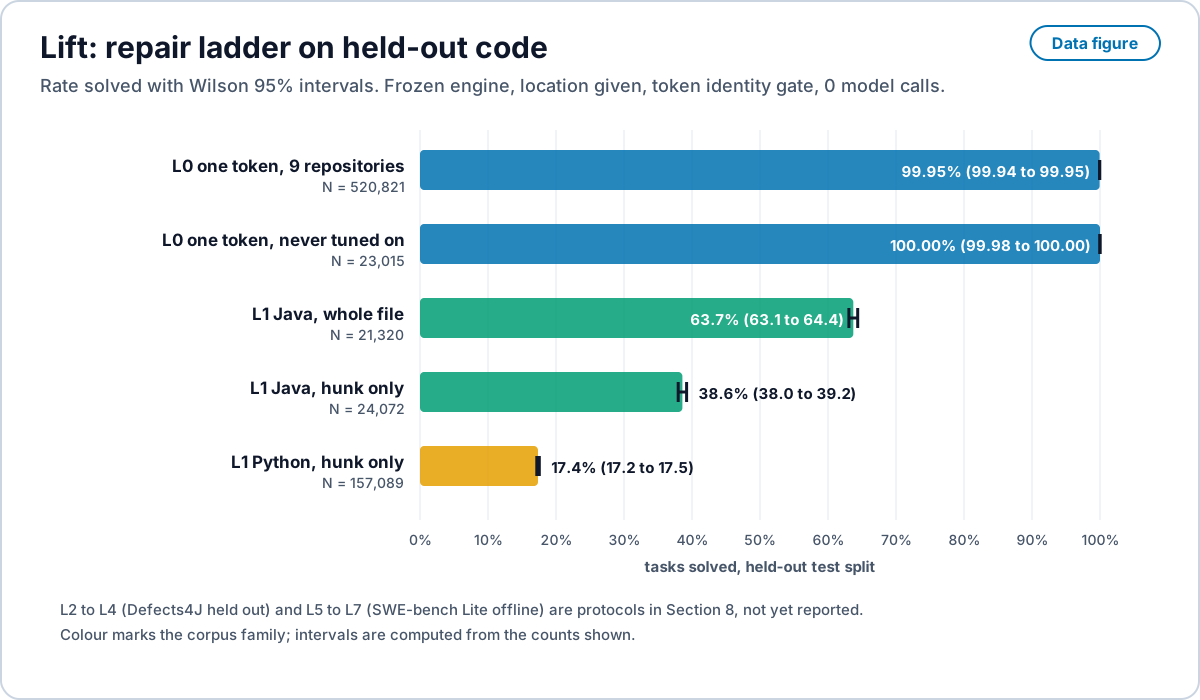
bench/ladder。提供 PNG 副本。 Open full size · PNG
L2 至 L4 在 Defects4J 留出集的 288 个缺陷上测量(第 8.1 节)。L5 至 L7 遵循 第 8.2 节 的协议。各行的方法、门槛与能量如下。
未决问题:一词元修复率的基线。 L0 各行测量按先验排序的单词元邻域恢复一词元突变体的频率。如果该邻域由产生这些突变体的同一组算子表构建,那么高比率部分反映的是这种重叠,而不是对实际出现的故障的修复能力。本文引用了这一耦合风险,但没有给出其数值。在同一批突变体上运行的朴素算子反转搜索,正是能显示该比率有多少可由此解释的基线。该基线尚未运行,因此此处不给出数字,一词元比率仍面临这一疑虑。
比率可读作意图比特。在 L0,缺失比特几乎全在该行上,按先验排序的单词元邻域以中位 2.3 比特供给它们。在仅块的 L1 行,引擎只看到 7 行块。它关闭比特在块内的类别(Java:改算子 91%,交换布尔字面量 84%,交换参数 82%;Python:改布尔字面量 98.8%,交换参数 99.4%),并留下比特在块外的开放:方法名(22%)与标识符(37%)需要文件及其类型,新合取(3% 到 7%)与整语句重写(Python,占语料 34% 的类别中的 1.2%)是新意图。新意图是供给者(规格、测试、人或本地模型)提供一次之后契合进入索引的东西。
方法。 每个语料用固定种子打乱。每次打乱的前 2,000 个位置,以及对 L0 三个整仓库(commons-lang、requests、flask),构成开发划分,档位可在其上调参;开发结果不报告。其余每项任务在测试划分中。测试运行前引擎被提交并记录其二进制哈希,运行中无档位变更。本节每行都是仅在测试任务上、0 次模型调用的冻结引擎结果。预注册(PREREG.json)、逐任务行与报告脚本在公共仓库中。
门槛。 在 L0 与 L1,位置给定,门槛是词元同一性:修复后的行或语句必须与开发者的逐词元相等。这比通过测试更严,因为补丁可通过弱测试套件却仍错误。Qi 与同事发现 GenProg 报告为修复的多数补丁是似是而非但不正确的 [92];对测试的过拟合在基于搜索与基于语义的修复中有记载 [93, 94],并用生成测试应对 [95];工具在其调参的基准上得分更高 [96];故障定位使比较偏倚 [97]。词元同一性消除这些级上的似是而非间隙,给定位置消除定位项,因此比率只测量修复档位。L2 及以上用测试作门槛,并分别报告似是而非与正确计数(第 8.1 节)。
6.1 L0:一词元故障
L0 语料是九个真实仓库在钉住提交上每个具有有效替换词元的 PIT 风格突变体 [109],五个 Java 与四个 Python:547,448 中的 520,821 个测试任务。引擎(提交 65571d0,档位 G0-T 与 G1-J)恢复 520,541,比率为 0.9995(95% Wilson 区间 0.9994 到 0.9995),中位搜索比特 2.3。280 个未解中,108 个是浮点字面量内被突变的数字,2 个在 Python 集合字面量内。浮点字面量档位(G0-F,提交 ecfe5a1)在四个从未用于调参的仓库上测试(commons-text、commons-io、more-itertools、httpx):23,015 中的 23,015 个任务,1.0000(0.9998 到 1.0000),中位搜索比特 2.0。突变体是真实一词元故障的替身,Just 与同事发现它们与真实故障耦合 [110]。
6.2 L1:来自真实历史的一语句缺陷
L1 使用两个从开源历史挖掘的真实单语句缺陷修复公开数据集。ManySStuBs4J 2.0 [107] 给出 24,072 个 Java 测试任务;引擎(提交 f2701b7)解决 9,288,比率 0.386(0.380 到 0.392)。TSSB-3M v1.0.0 [108] 从分片 14 与 15 给出 157,089 个 Python 测试任务;同一引擎解决 27,266,比率 0.174(0.172 到 0.175)。引擎只收到 7 行块,因此该 Java 比率是仅块结果。给定父提交处的整文件,带项目方法与看守条件索引以及改方法名、加参数、看守条件、throws 与修饰符的档位(提交 62fb7a0,二进制 sha256 前缀 3682c6515acdf722,运行前预注册),引擎在其文件与缺陷语句可定位的 21,320 个 Java 测试任务中解决 13,586,比率 0.637(0.631 到 0.644)。按类别关闭改算子(95.9%)、改操作数(92.1%)、错误调用者(87.9%)、交换布尔字面量(88.4%)、删除参数(85.1%)与交换参数(83.3%);改方法名达 61.4%,加参数 51.4%,新或收窄条件(43.5% 与 51.7%)仍是主要开放意图。完整分层表在仓库中。这些数据集在本门槛下(仅块、词元同一性、给定位置)无已发表修复排行榜,因此旁侧不设学习修复数字;确有排行榜的 Defects4J 在第 8.1 节与 TBar 比较。
6.3 能量
每行携带 est_j,即 CPU 秒乘 10 W 的估计:L0 每已解任务 0.40 J,新鲜仓库上 0.13,ManySStuBs4J 上 0.10,TSSB-3M 上 0.27。子样本在 RAPL [105](处理器片上包计数器)上读取,机器为带 Intel i9-13900H 的 Linux 笔记本(主机名 jetson-hub;非 NVIDIA Jetson)。线束在 4 个钉住的 CPU 上运行,reported_j 是整次运行(含 Python 驱动)的包增量,减去紧前 10 s 采样的空闲功率再乘运行时长。持续集成运行器在运行,因此空闲为 40 W 到 44 W,不确定性约为 ±1 W 乘时长,这些合计上约 ±10 J。
| 子样本(测试划分) | 任务 | 已解 | 原始 J | reported_j | 每已解任务 reported_j | 秒 |
|---|---|---|---|---|---|---|
| L0,gson 突变体(有种子,前 3,000) | 3,000 | 3,000 | 648.3 | 167.5 | 0.056 | 11.8 |
| L1,ManySStuBs4J 位置 2,000 到 3,999 | 2,000 | 690 | 377.2 | 17.9 | 0.026 | 8.2 |
L1 子样本仅从其 2,000 个任务构建项目索引,因此其求解率(34.5%)低于完整运行。measured_j(命名轨上的墙上电表)在每行中为空;其协议见第 8.3 节。
7. 复用证据
RCE 在复用轴上的位置基于工程事实:代码在每一尺度被复用。下方每种方法以不同方式测量它。
| 方法 | 来源 | 发现 |
|---|---|---|
| 文件级克隆映射 | DéjàVu,Lopes 等 2017 [33] | 在 450 万非 fork GitHub 项目的 4.28 亿文件中,8500 万是唯一的:“GitHub 上 70% 的代码由先前创建文件的克隆构成。”在 JavaScript 中,6% 的文件是不同的。 |
| 行级冗余 | Gabel 与 Su 2010 [34] | 相对 4.2 亿行,“每个项目的 50% 到 100% 在大约一行上是冗余的。” |
| 统计语言模型 | Hindle 等 2012 [35] | 代码“非常重复,事实上甚至比自然语言更甚。” |
| 语料近去重 | The Stack [36] | 近去重去掉 The Stack v1 的 54.7%(6.4 TB 到 2.9 TB)与 v2 的 52.4%(67.5 TB 到 32.1 TB)。 |
| 整档保存 | Software Heritage [129, 130] | 来自 4.48 亿起源的 303 亿个唯一文件内容(档案计数器,2026 年 10 月 13 日读取),每个按字节哈希只存一次。 |
| 挖掘的修复模式 | PAR、TBar [22, 23] | PAR 在超过 60,000 个人工补丁中发现“若干常见修复模式”。TBar 的 15 个模式类别在标准流水线中正确修复 43 个 Defects4J 缺陷,在完美故障定位下为 101 中的 74,且无学习。这些是从 [23] 读取的数字;101 的含义(似是而非的补丁还是尝试的缺陷)尚未在此对照该论文重新核查,因此请将该比率视为未经确认。 |
| 跨语言任务 | Rosetta Code [131] | 1,360 个任务(以及 421 个草稿任务),每个概念在 1,009 种已知语言中的许多种上实现。 |
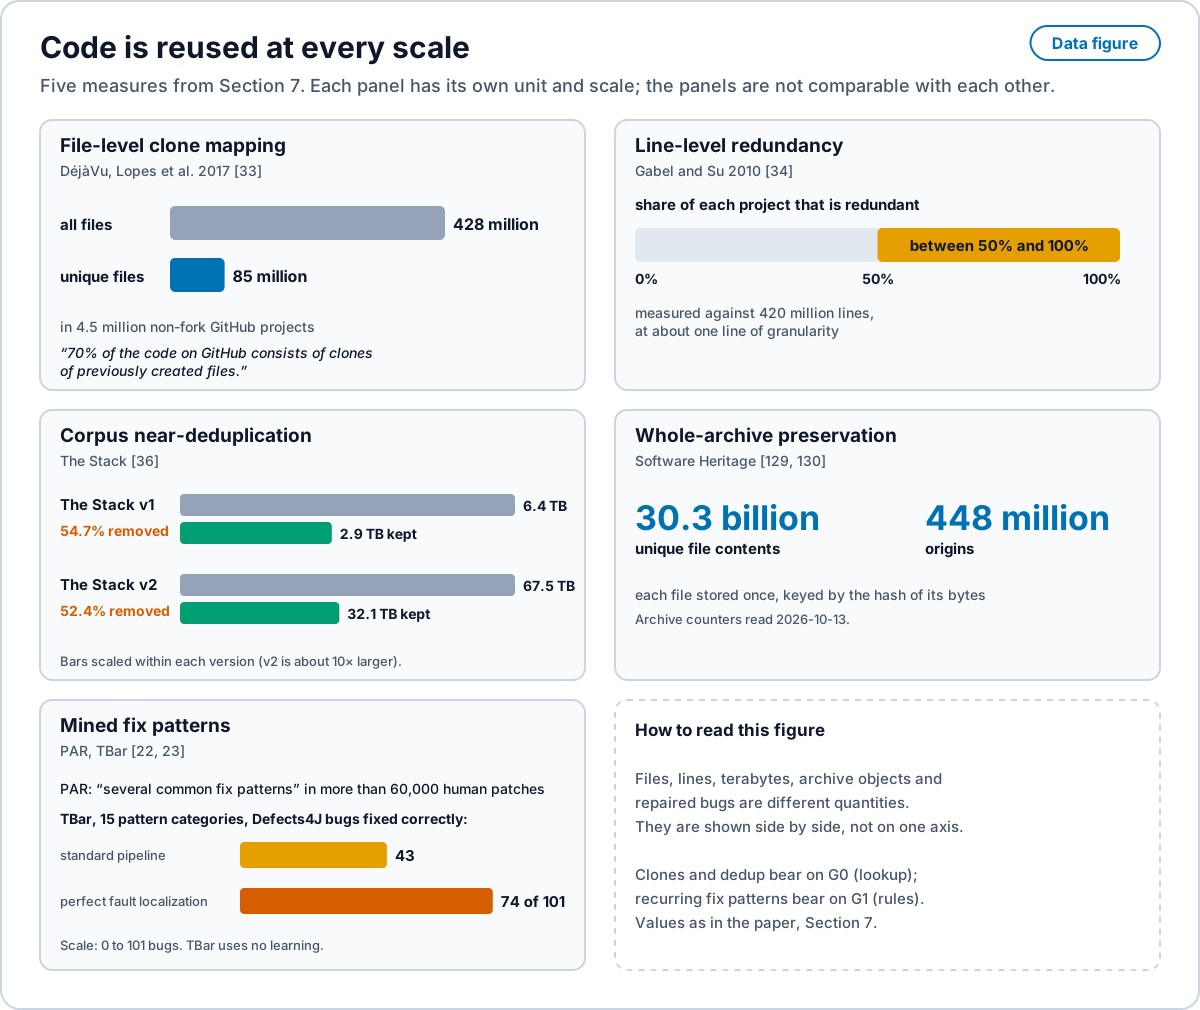
每行是引擎的输入。克隆与去重说契合通常存在,这是 G0。反复出现的修复说适配大多是带看守重写的小目录,这是 G1。行级冗余缩小 G2 的搜索空间。生态系统在每个被晋升契合上测量它(第 2.3 节),被提升代码上的修复阶梯在留出划分上大规模测量它(第 6 节)。两点谨慎锐化解读。除非去除,重复会抬高检索与模型分数 [104]。有缺陷的行比修好的更不自然 [45],因此缺陷本身是查找最难预测的情形;G0 与 G1 必须键控的是修复形状,而非有缺陷的行。大规模做此事的规则挖掘线,从 GenProg 的生成并验证搜索 [88] 与 Prophet 的学得正确性模型 [89],到 Facebook 的 Getafix [90] 与 Sorald 对静态分析违规的无模型修复 [91],从不相交历史导出模板并在未见情形上报告精度 [98]。那是第 8.4 节采用的标准。
8. 后续事项的测量协议
每个协议在其运行前固定:预注册已提交,种子与求解器提交已记录,每个制品保留。门槛在先,焦耳在后,标注始终。
8.1 Defects4J
Defects4J 持有 854 个活动的真实 Java 缺陷,每个带可复现测试 [37]。
- 在 100 个缺陷子集上离线开发,经
defects4j checkout;仅报告留出结果,在运行前冻结的不相交 288 个缺陷集上(FROZEN-heldout-v1)。 - 先运行 G0,然后 G1,然后 G2,本地模型最后。记录关闭每个缺陷的档位。
- 门槛:触发测试与完整套件通过。分别报告似是而非与正确计数;正确意味着经审阅与开发者补丁等价。
- 报告每正确修复的模型调用与每正确修复的焦耳,带标注。
- 参考点:TBar 的 43 个正确修复及其在完美定位下 101 中的 74(数字从 [23] 读取,分母未在此重新核查)。本节是一个协议。本文不报告该引擎的任何 Defects4J 结果。
- 污染检查:标记每个修复逐字出现在 G0 索引中的缺陷,并报告含与不含被标记缺陷。
8.2 SWE-bench Lite,离线
SWE-bench Lite 是由隐藏测试解决的真实 GitHub 议题的 300 任务子集 [38]。
- 使用官方 Docker 线束,无网络。
- 首次运行:仅 G0 与 G1,零次模型调用。这是无模型求解的底板。
- 第二次运行:加入本地模型作为最后一档。
- 报告解决率、每已解决任务的模型调用与每已解决任务的焦耳,带标注。
- 污染检查如 8.1。SWE-Bench+ 发现 32.67% 的成功补丁在议题文本中有解 [39]。
8.3 墙上电表
- 在主机供电上接墙上电表或分流电表,以既定速率记录,时钟与运行日志同步。
- 空闲机器:CI 运行器与其他构建已停,每个块前检查并记录安静窗口门槛。
- 减去测得的空闲基线,并陈述方法。
- 仅从电表填充
measured_j。在旁侧分列报告reported_j(RAPL)与est_j。永不跨标注求和。 - 在电表下重复第 6.3 节的 RAPL 子样本,然后是 Defects4J 留出集。
8.4 档位冻结的留出运行
这是第 6 节方法向新语料的扩展。
- 在带标签的提交冻结 G0、G1 与 G2,记录二进制哈希,并公布带撰写时间戳的规则集。
- 抽取不相交留出切片:Multi-SWE-bench [102] 与 BugsInPy [103] 的 Rust 与 Python 实例,相对 G0 索引去重 [104]。
- 在首次运行前预注册切片、种子与假设。
- 分别报告已解决、似是而非与按字节相同计数,每个带 95% 区间。
8.5 同一表中的基线
- 无模型:
cargo fix与 clippy [106],以及 Sorald 或 TBar 移植 [91]。 - 便宜模型:带本地模型的 Agentless [99]。
- 远程模型:带前沿模型的智能体,其能量由提供商披露估计并标注
est_j。 - 对每行以焦耳与美元报告通过成本 [101],成本控制按 Kapoor 与同事的要求 [100]。
8.6 大 N 下模型调用的收敛
晋升是模型离开循环的机制:解析器为新情形付一次,门槛把契合承认为处理器,同一形状的每个后续情形在 G0 或 G1 关闭(第 4.2 节)。收敛是论断:在固定规格与实况流量下,每轮模型调用降到零。测量如下。
- 从公共仓库抽取至少 1,000 个规格,按语言与规模分层,并在第一轮前冻结引擎与解析器。
- 重放已记录的生产流量,每个规格至少 10,000 个事件,按固定大小的轮次。
- 每轮记录:新升级、模型调用、晋升、推迟与每已关闭任务的焦耳,各带标注(
est_j、reported_j、measured_j)。 - 主终点:在 20 轮内达到某轮零模型调用的规格份额,带 95% Wilson 区间。次终点:按轮的每已关闭任务模型调用,以及最后一次模型调用的轮次。
- 报告永不收敛的规格及其原因(卡住的输入、缺失依赖、新意图),并把卡住输入的推迟作为预注册臂运行。
命题 8(逼近底板)。 随着 G0 与 G1 覆盖增长,每已解任务焦耳逼近应用已知修复并运行测试的黄金底板。阶梯各级与墙上电表下的 Defects4J 留出集检验它。
8.7 跨语言的提升覆盖
提升随构建被测量。对语言 ,当 通过程序自身测试并按字节重放其已记录迹,且 与 有相同形状哈希时,程序计为已提升。样本为至少十种语言、每种至少 10,000 个程序,以固定种子从钉住的公共语料抽取,提升器在每次运行前冻结并记录其二进制哈希,0 次模型调用。每次运行报告已提升份额及 Wilson 95% 区间,每个尚未提升的构造是该语言提升器的工作项,在下次运行前构建并冻结。目标是每种语言中的每个程序。
9. 证伪者
在它们所检验的运行前固定。
| ID | 观察 | 击败 |
|---|---|---|
| RCE-F0 | 在至少 10,000 个形式的预注册运行上,任何投影打印与形式参考迹不同的迹,或任何畸形输入被接受 | 投影忠实且门槛在入口拒绝的论断 |
| RCE-F1 | 在留出切片上,带冻结规则的 G0 至 G2 在 0 次模型调用下解决不足 10% 的任务 | 在此规模上修复的多数契合已存在的论断 |
| RCE-F2 | 按字节相同或等价的补丁不足已解决留出任务的一半 | 把门槛读作在已覆盖任务上多于似是而非 |
| RCE-F3 | 在墙上电表下,RCE 求解器每已解任务的总焦耳超过两者都解的任务上最便宜模型基线 | 在已覆盖任务上每已解任务更低能量的论断 |
| RCE-F4 | 在第 8.6 节的收敛协议中,无卡住输入的规格中不足一半在 20 轮内达到某轮零模型调用 | 把模型编译出循环 |
10. 待完成工作
每项有其命名协议。
- 在第 8.7 节协议下跨至少十种语言构建并测量提升。
- 规格臂:以 MBPP 与 HumanEval 风格把规格写成形式并发出到每个目标。
- L2 至 L4 的留出结果、Defects4J 的 288 个缺陷集(第 8.1 节),以及 L5 至 L7(第 8.2 节)。
- 同一表中的基线,焦耳与美元的通过成本(第 8.5 节)。
- 一个
measured_j系列:空闲主机上的墙上电表,至少 10 次重复,总与净并列(第 8.3 节)。 - 发表带方法的 626 语言调查(图 1)。
- 档位冻结的新留出语料:Multi-SWE-bench 与 BugsInPy(第 8.4 节)。
- 跨至少 1,000 个规格的模型调用收敛(第 8.6 节)。
11. 结论
RCE 是原生代码生态系统。程序由意图一次写成形式:状态、事件与纯转移的无损编码,每种目标语言是它的忠实投影。无效状态无法被写出,畸形输入在入口被拒绝,因此生态系统中的程序不会相对其意图漂移,也不需要事后差分或错误追踪。每个通过门槛的契合都被存储并复用,生态系统在正确性单调的门槛下复利。在 10,000 个预注册形式上,用冻结的引擎与 0 次模型调用,每个形式往返到相同字节,每个投影确定性,每个畸形输入与规格在入口被拒绝,Python 投影在 9,999 上重放参考迹。其他语言的代码通过提升进入,那是从每种语言的语法到其语法树再到形式的构造;在被提升代码上,修复档位恢复 520,821 个一词元故障的 99.95% 与 21,320 个单语句 Java 缺陷的 63.7%。第 3.6 节与第 8.7 节陈述普遍性命题及其构造如何被测量。
参考文献
[1] C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal 30(1), 1951. doi:10.1002/j.1538-7305.1951.tb01366.x
[2] Y. Gurevich, “Sequential Abstract State Machines Capture Sequential Algorithms,” ACM Transactions on Computational Logic 1(1), 2000. doi:10.1145/343369.343384
[3] A. Blass and Y. Gurevich, “Abstract State Machines Capture Parallel Algorithms,” ACM Transactions on Computational Logic, 2003. doi:10.1145/937555.937561
[4] N. Dershowitz and Y. Gurevich, “A Natural Axiomatization of Computability and Proof of Church’s Thesis,” Bulletin of Symbolic Logic, 2008. doi:10.2178/bsl/1231081370
[5] E. F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM, 1970. doi:10.1145/362384.362685
[6] G. H. Mealy, “A Method for Synthesizing Sequential Circuits,” Bell System Technical Journal, 1955. doi:10.1002/j.1538-7305.1955.tb03788.x
[7] E. F. Moore, “Gedanken-Experiments on Sequential Machines,” Automata Studies, 1956. doi:10.1515/9781400882618-006
[8] K. Kang et al., “Feature-Oriented Domain Analysis (FODA) Feasibility Study,” CMU/SEI-90-TR-021, 1990.
[9] R. Alur et al., “Syntax-Guided Synthesis,” FMCAD 2013. doi:10.1109/FMCAD.2013.6679385
[10] D. Harel, “Statecharts: A Visual Formalism for Complex Systems,” Science of Computer Programming, 1987. doi:10.1016/0167-6423(87)90035-9
[11] R. Tate, M. Stepp, Z. Tatlock and S. Lerner, “Equality Saturation,” POPL 2009. doi:10.1145/1480881.1480915
[12] M. Willsey et al., “egg: Fast and Extensible Equality Saturation,” POPL 2021. doi:10.1145/3434304
[13] B. Moseley and P. Marks, “Out of the Tar Pit,” 2006.
[14] M. Fowler, “Event Sourcing,” 2005. https://martinfowler.com/eaaDev/EventSourcing.html
[15] P. Alvaro et al., “Dedalus: Datalog in Time and Space,” LNCS 2011. doi:10.1007/978-3-642-24206-9_16
[16] A. M. Turing, “On Computable Numbers,” Proceedings of the London Mathematical Society, 1937. doi:10.1112/plms/s2-42.1.230
[17] A. Church, “An Unsolvable Problem of Elementary Number Theory,” American Journal of Mathematics, 1936. doi:10.2307/2371045
[18] P. Wadler, “Propositions as Types,” Communications of the ACM, 2015. doi:10.1145/2699407
[19] J. M. Hellerstein and P. Alvaro, “Keeping CALM,” Communications of the ACM, 2020. doi:10.1145/3369736
[20] G. Kahn, “The Semantics of a Simple Language for Parallel Programming,” IFIP 1974, pp. 471 to 475.
[21] H. Husain et al., “CodeSearchNet Challenge,” 2019. arXiv:1909.09436
[22] D. Kim, J. Nam, J. Song and S. Kim, “Automatic Patch Generation Learned from Human-Written Patches” (PAR), ICSE 2013. doi:10.1109/ICSE.2013.6606626
[23] K. Liu et al., “TBar: Revisiting Template-based Automated Program Repair,” ISSTA 2019. arXiv:1903.08409
[24] K. Liu et al., “AVATAR: Fixing Semantic Bugs with Fix Patterns of Static Analysis Violations,” SANER 2019. arXiv:1812.07270
[25] A. Koyuncu et al., “FixMiner: Mining Relevant Fix Patterns for Automated Program Repair,” 2018. arXiv:1810.01791
[26] Y. Padioleau et al., “Documenting and Automating Collateral Evolutions in Linux Device Drivers” (Coccinelle), EuroSys 2008. doi:10.1145/1352592.1352618
[27] A. Solar-Lezama et al., “Combinatorial Sketching for Finite Programs,” ASPLOS 2006. doi:10.1145/1168857.1168907
[28] L. Chen, M. Zaharia and J. Zou, “FrugalGPT,” 2023. arXiv:2305.05176
[29] S. Haber and W. S. Stornetta, “How to Time-Stamp a Digital Document,” Journal of Cryptology, 1991. doi:10.1007/BF00196791
[30] S. A. Crosby and D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging,” USENIX Security 2009.
[31] L. de Moura and N. Bjørner, “Z3: An Efficient SMT Solver,” TACAS 2008. doi:10.1007/978-3-540-78800-3_24
[32] Kani Rust Verifier. https://github.com/model-checking/kani
[33] C. V. Lopes et al., “DéjàVu: A Map of Code Duplicates on GitHub,” OOPSLA 2017. doi:10.1145/3133908
[34] M. Gabel and Z. Su, “A Study of the Uniqueness of Source Code,” FSE 2010. doi:10.1145/1882291.1882315
[35] A. Hindle et al., “On the Naturalness of Software,” ICSE 2012. doi:10.1109/ICSE.2012.6227135
[36] D. Kocetkov et al., “The Stack: 3 TB of Permissively Licensed Source Code,” 2022. arXiv:2211.15533; The Stack v2 dataset card, https://huggingface.co/datasets/bigcode/the-stack-v2
[37] R. Just, D. Jalali and M. D. Ernst, “Defects4J: A Database of Existing Faults to Enable Controlled Testing Studies for Java Programs,” ISSTA 2014. doi:10.1145/2610384.2628055
[38] C. E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. arXiv:2310.06770
[39] R. Aleithan et al., “SWE-Bench+: Enhanced Coding Benchmark for LLMs,” 2024. arXiv:2410.06992
[40] C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal 27, 1948. doi:10.1002/j.1538-7305.1948.tb01338.x
[41] A. N. Kolmogorov, “Three approaches to the quantitative definition of information,” Problemy Peredachi Informatsii 1(1), 1965 (in Russian); English translation, International Journal of Computer Mathematics 2, 1968. doi:10.1080/00207166808803030
[42] R. J. Solomonoff, “A formal theory of inductive inference. Part I,” Information and Control 7(1), 1964. doi:10.1016/S0019-9958(64)90223-2
[43] G. J. Chaitin, “A Theory of Program Size Formally Identical to Information Theory,” Journal of the ACM 22(3), 1975. doi:10.1145/321892.321894
[44] J. Rissanen, “Modeling by shortest data description,” Automatica 14(5), 1978. doi:10.1016/0005-1098(78)90005-5
[45] B. Ray, V. Hellendoorn, S. Godhane, Z. Tu, A. Bacchelli and P. Devanbu, “On the ‘naturalness’ of buggy code,” ICSE 2016. doi:10.1145/2884781.2884848
[46] Z. Tu, Z. Su and P. Devanbu, “On the localness of software,” FSE 2014. doi:10.1145/2635868.2635875
[47] M. Allamanis, E. T. Barr, P. Devanbu and C. Sutton, “A Survey of Machine Learning for Big Code and Naturalness,” ACM Computing Surveys 51(4), 2018. doi:10.1145/3212695
[48] 陈浙哲, 刘忠鑫, 鄢萌, 徐洲, 夏鑫, 雷晏 (Z. Chen, Z. Liu, M. Yan, Z. Xu, X. Xia and Y. Lei), “代码自然性及其应用研究进展” (Research progress of code naturalness and its application), 软件学报 (Journal of Software) 33(8), 3015 to 3034, 2022. doi:10.13328/j.cnki.jos.006355
[49] G. Sridhara, V. S. Sinha and S. Mani, “Naturalness of Natural Language Artifacts in Software,” ISEC 2015 (India Software Engineering Conference). doi:10.1145/2723742.2723758
[50] P. Devanbu, “On the naturalness of software,” keynote, ISEC 2013 (India Software Engineering Conference). doi:10.1145/2442754.2442763
[51] A. Z. H. Yang, S. Kolak, V. J. Hellendoorn, R. Martins et al., “Revisiting Unnaturalness for Automated Program Repair in the Era of Large Language Models,” ICSE 2025. doi:10.1109/ICSE55347.2025.00089
[52] E. W. Dijkstra, “Guarded commands, nondeterminacy and formal derivation of programs,” Communications of the ACM 18(8), 1975. doi:10.1145/360933.360975
[53] N. Wirth, “Program development by stepwise refinement,” Communications of the ACM 14(4), 1971. doi:10.1145/362575.362577
[54] C. A. R. Hoare, “An axiomatic basis for computer programming,” Communications of the ACM 12(10), 1969. doi:10.1145/363235.363259
[55] J.-R. Abrial, The B-Book: Assigning Programs to Meanings, Cambridge University Press, 1996. doi:10.1017/CBO9780511624162
[56] J.-R. Abrial, Modeling in Event-B: System and Software Engineering, Cambridge University Press, 2010. doi:10.1017/CBO9781139195881
[57] R.-J. Back and J. von Wright, Refinement Calculus: A Systematic Introduction, Springer, 1998. doi:10.1007/978-1-4612-1674-2
[58] F. L. Bauer and H. Wössner, Algorithmic Language and Program Development, Springer, 1982. doi:10.1007/978-3-642-61807-9
[59] S. Gulwani, “Automating string processing in spreadsheets using input-output examples,” POPL 2011. doi:10.1145/1926385.1926423
[60] S. Gulwani, O. Polozov and R. Singh, “Program Synthesis,” Foundations and Trends in Programming Languages 4(1-2), 2017. doi:10.1561/2500000010
[61] F. P. Brooks, “No Silver Bullet: Essence and Accidents of Software Engineering,” Computer 20(4), 1987. doi:10.1109/MC.1987.1663532
[62] P. Naur, “Programming as theory building,” Microprocessing and Microprogramming 15(5), 1985. doi:10.1016/0165-6074(85)90032-8
[63] M. M. Lehman, “Programs, life cycles, and laws of software evolution,” Proceedings of the IEEE 68(9), 1980. doi:10.1109/PROC.1980.11805
[64] P. Zave and M. Jackson, “Four dark corners of requirements engineering,” ACM Transactions on Software Engineering and Methodology 6(1), 1997. doi:10.1145/237432.237434
[65] R. Landauer, “Irreversibility and Heat Generation in the Computing Process,” IBM Journal of Research and Development 5(3), 1961. doi:10.1147/rd.53.0183
[66] C. H. Bennett, “Logical Reversibility of Computation,” IBM Journal of Research and Development 17(6), 1973. doi:10.1147/rd.176.0525
[67] M. Franz and T. Kistler, “Slim binaries,” Communications of the ACM 40(12), 1997. doi:10.1145/265563.265576
[68] C. W. Fraser, “Automatic inference of models for statistical code compression,” PLDI 1999. doi:10.1145/301618.301672
[69] P. Cousot and R. Cousot, “Abstract interpretation: a unified lattice model for static analysis of programs by construction or approximation of fixpoints,” POPL 1977. doi:10.1145/512950.512973
[70] Y. Futamura, “Partial evaluation of computation process: an approach to a compiler-compiler,” Systems, Computers, Controls 2(5), 1971; reprinted in Higher-Order and Symbolic Computation 12(4), 1999. doi:10.1023/A:1010095604496
[71] A. P. Ershov, “Mixed computation: potential applications and problems for study,” Theoretical Computer Science 18(1), 1982. doi:10.1016/0304-3975(82)90111-6
[72] W. A. Howard, “The formulae-as-types notion of construction,” in J. P. Seldin and J. R. Hindley (eds.), To H. B. Curry: Essays on Combinatory Logic, Lambda Calculus and Formalism, Academic Press, 1980.
[73] 土居真之, 肥後芳樹, 有馬諒, 下仲健斗, 楠本真二 (M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto), “ソースコードの「自然さ」を利用した自動生成ファイルの特定” (Identifying auto-generated files using the naturalness of source code), 電子情報通信学会技術研究報告 (IEICE Technical Report) 117(380), 19 to 24, January 2018. https://sdl.ist.osaka-u.ac.jp/pman/pman3.cgi?D=517
[74] M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto, “On the naturalness of auto-generated code: can we identify auto-generated code automatically?” ICPC 2018. doi:10.1145/3196321.3196356
[75] F. V. Arrebola, “Modelo de sugestão de código-fonte baseado em modelos de linguagem organizados em um contexto hierárquico” (A source code suggestion model based on language models organized in a hierarchical context), doctoral thesis in electrical engineering, Fundação Educacional Inaciana Padre Sabóia de Medeiros (FEI), Brazil, 2018. Advisor R. A. C. Bianchi.
[76] G. Febres, K. Jaffé and C. Gershenson, “Complexity measurement of natural and artificial languages,” Complexity 20(6), 2015. doi:10.1002/cplx.21529
[77] M. Rahman, D. Palani and P. C. Rigby, “Natural Software Revisited,” ICSE 2019. doi:10.1109/ICSE.2019.00022
[78] A. Torres, S. Baltes, C. Treude and M. Wagner, “Applying Information Theory to Software Evolution,” NLBSE 2023. doi:10.1109/NLBSE59153.2023.00017
[79] A. Blass, N. Dershowitz and Y. Gurevich, “When are two algorithms the same?,” Bulletin of Symbolic Logic 15(2), 2009. arXiv:0811.0811. https://arxiv.org/abs/0811.0811
[80] Y. N. Moschovakis, “What is an algorithm?,” in Mathematics Unlimited: 2001 and Beyond, Springer, 2001. https://www.math.ucla.edu/~ynm/papers/eng.pdf
[81] M. Y. Vardi, “What is an algorithm?,” Communications of the ACM 55(3), 2012. doi:10.1145/2093548.2093549
[82] S. Laddad, A. Cheung, J. M. Hellerstein and M. Milano, “Flo: a Semantic Foundation for Progressive Stream Processing,” POPL 2025. arXiv:2411.08274. https://arxiv.org/abs/2411.08274
[83] The Elm Architecture, Elm guide. https://guide.elm-lang.org/architecture/
[84] Temporal, “Workflows” (event history), documentation. https://docs.temporal.io/workflows
[85] A. Pnueli, M. Siegel and E. Singerman, “Translation validation,” TACAS 1998. doi:10.1007/BFb0054170
[86] X. Yang, Y. Chen, E. Eide and J. Regehr, “Finding and understanding bugs in C compilers,” PLDI 2011. doi:10.1145/1993498.1993532
[87] C. Nandi, M. Willsey, A. Zhu et al., “Rewrite Rule Inference Using Equality Saturation,” OOPSLA 2021. arXiv:2108.10436. https://arxiv.org/abs/2108.10436
[88] C. Le Goues, T. Nguyen, S. Forrest and W. Weimer, “GenProg: A Generic Method for Automatic Software Repair,” IEEE TSE 38(1), 2012. doi:10.1109/TSE.2011.104
[89] F. Long and M. Rinard, “Automatic patch generation by learning correct code,” POPL 2016. doi:10.1145/2837614.2837617
[90] J. Bader, A. Scott, M. Pradel and S. Chandra, “Getafix: Learning to Fix Bugs Automatically,” OOPSLA 2019. arXiv:1902.06111. https://arxiv.org/abs/1902.06111
[91] K. Etemadi, N. Harrand, S. Larsen et al., “Sorald: Automatic Patch Suggestions for SonarQube Static Analysis Violations,” IEEE TDSC, 2022. arXiv:2103.12033. https://arxiv.org/abs/2103.12033
[92] Z. Qi, F. Long, S. Achour and M. Rinard, “An analysis of patch plausibility and correctness for generate-and-validate patch generation systems,” ISSTA 2015. doi:10.1145/2771783.2771791
[93] E. K. Smith, E. T. Barr, C. Le Goues and Y. Brun, “Is the cure worse than the disease? Overfitting in automated program repair,” ESEC/FSE 2015. doi:10.1145/2786805.2786825
[94] X.-B. D. Le, F. Thung, D. Lo and C. Le Goues, “Overfitting in semantics-based automated program repair,” Empirical Software Engineering 23, 2018. doi:10.1007/s10664-017-9577-2
[95] Y. Xiong, X. Liu, M. Zeng, L. Zhang and G. Huang, “Identifying patch correctness in test-based program repair,” ICSE 2018. doi:10.1145/3180155.3180182
[96] T. Durieux, F. Madeiral, M. Martinez and R. Abreu, “Empirical Review of Java Program Repair Tools: A Large-Scale Experiment on 2,141 Bugs and 23,551 Repair Attempts,” ESEC/FSE 2019. arXiv:1905.11973. https://arxiv.org/abs/1905.11973
[97] K. Liu, A. Koyuncu, T. F. Bissyandé et al., “You Cannot Fix What You Cannot Find! An Investigation of Fault Localization Bias in Benchmarking Automated Program Repair Systems,” ICST 2019. arXiv:1812.07283. https://arxiv.org/abs/1812.07283
[98] M. Monperrus, “Automatic Software Repair: A Bibliography,” ACM Computing Surveys 51(1), 2018. doi:10.1145/3105906
[99] C. S. Xia, Y. Deng, S. Dunn and L. Zhang, “Agentless: Demystifying LLM-based Software Engineering Agents,” 2024. arXiv:2407.01489. https://arxiv.org/abs/2407.01489
[100] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir and A. Narayanan, “AI Agents That Matter,” 2024. arXiv:2407.01502. https://arxiv.org/abs/2407.01502
[101] M. H. Erol, B. El, M. Suzgun, M. Yuksekgonul and J. Zou, “Cost-of-Pass: An Economic Framework for Evaluating Language Models,” 2025. arXiv:2504.13359. https://arxiv.org/abs/2504.13359
[102] D. Zan, Z. Huang, W. Liu et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving,” 2025. arXiv:2504.02605. https://arxiv.org/abs/2504.02605
[103] R. Widyasari, S. Q. Sim, C. Lok et al., “BugsInPy: a database of existing bugs in Python programs to enable controlled testing and debugging studies,” ESEC/FSE 2020. doi:10.1145/3368089.3417943
[104] M. Allamanis, “The Adverse Effects of Code Duplication in Machine Learning Models of Code,” Onward! 2019. arXiv:1812.06469. https://arxiv.org/abs/1812.06469
[105] K. N. Khan, M. Hirki, T. Niemi, J. K. Nurminen and Z. Ou, “RAPL in Action: Experiences in Using RAPL for Power Measurements,” ACM TOMPECS 3(2), 2018. doi:10.1145/3177754
[106] The Rust project, rustfix and cargo fix. https://github.com/rust-lang/rustfix
[107] R.-M. Karampatsis and C. Sutton, “How Often Do Single-Statement Bugs Occur? The ManySStuBs4J Dataset,” MSR 2020. doi:10.1145/3379597.3387491
[108] C. Richter and H. Wehrheim, “TSSB-3M: Mining single statement bugs at massive scale,” MSR 2022. doi:10.1145/3524842.3528505
[109] H. Coles, T. Laurent, C. Henard, M. Papadakis and A. Ventresque, “PIT: a practical mutation testing tool for Java,” ISSTA 2016. doi:10.1145/2931037.2948707
[110] R. Just, D. Jalali, L. Inozemtseva, M. D. Ernst, R. Holmes and G. Fraser, “Are mutants a valid substitute for real faults in software testing?” FSE 2014. doi:10.1145/2635868.2635929
[111] I. J. Good, “Speculations Concerning the First Ultraintelligent Machine,” Advances in Computers 6, 1965. doi:10.1016/S0065-2458(08)60418-0
[112] J. Schmidhuber, “Gödel Machines: Fully Self-referential Optimal Universal Self-improvers,” in Artificial General Intelligence, Springer, 2007. doi:10.1007/978-3-540-68677-4_7
[113] E. Yudkowsky, “Intelligence Explosion Microeconomics,” Technical report 2013-1, Machine Intelligence Research Institute, 2013. https://intelligence.org/files/IEM.pdf
[114] M. H. Löb, “Solution of a Problem of Leon Henkin,” Journal of Symbolic Logic 20(2), 1955. doi:10.2307/2266895
[115] E. Yudkowsky and M. Herreshoff, “Tiling Agents for Self-Modifying AI, and the Löbian Obstacle,” Machine Intelligence Research Institute, 2013. https://intelligence.org/files/TilingAgentsDraft.pdf
[116] E. Zelikman, E. Lorch, L. Mackey and A. T. Kalai, “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation,” 2023. doi:10.48550/arXiv.2310.02304
[117] J. Zhang, S. Hu, C. Lu, R. Lange and J. Clune, “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents,” 2025. doi:10.48550/arXiv.2505.22954
[118] A. Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery,” 2025. doi:10.48550/arXiv.2506.13131
[119] G. Wang, Y. Xie, Y. Jiang, A. Mandlekar, C. Xiao, Y. Zhu, L. Fan and A. Anandkumar, “Voyager: An Open-Ended Embodied Agent with Large Language Models,” 2023. doi:10.48550/arXiv.2305.16291
[120] Y. Futamura, “Partial Evaluation of Computation Process: An Approach to a Compiler-Compiler,” Higher-Order and Symbolic Computation 12(4), 1999 (first published 1971). doi:10.1023/A:1010095604496
[121] V. F. Turchin, “The Concept of a Supercompiler,” ACM Transactions on Programming Languages and Systems 8(3), 1986. doi:10.1145/5956.5957
[122] J. N. Foster, M. B. Greenwald, J. T. Moore, B. C. Pierce and A. Schmitt, “Combinators for Bidirectional Tree Transformations: A Linguistic Approach to the View-Update Problem,” ACM Transactions on Programming Languages and Systems 29(3), 2007. doi:10.1145/1232420.1232424
[123] M. Hofmann, B. Pierce and D. Wagner, “Symmetric Lenses,” POPL, 2011. doi:10.1145/1926385.1926428
[124] K. Czarnecki, J. N. Foster, Z. Hu, R. Lämmel, A. Schürr and J. F. Terwilliger, “Bidirectional Transformations: A Cross-Discipline Perspective,” ICMT, LNCS 5563, 2009. doi:10.1007/978-3-642-02408-5_19
[125] E. W. Dijkstra, “A Constructive Approach to the Problem of Program Correctness,” BIT 8(3), 1968. doi:10.1007/BF01933419
[126] A. Hall and R. Chapman, “Correctness by Construction: Developing a Commercial Secure System,” IEEE Software 19(1), 2002. doi:10.1109/52.976937
[127] Y. Minsky, “OCaml for the Masses,” Communications of the ACM 54(11), 2011. doi:10.1145/2018396.2018413
[128] D. A. Turner, “Total Functional Programming,” Journal of Universal Computer Science 10(7), 2004. doi:10.3217/jucs-010-07-0751
[129] R. Di Cosmo and S. Zacchiroli, “Software Heritage: Why and How to Preserve Software Source Code,” iPRES 2017, Kyoto. https://hal.science/hal-01590958
[130] Software Heritage, archive counters, read 13 October 2026: 30,253,266,524 file contents and 448,311,919 origins. https://archive.softwareheritage.org/api/1/stat/counters/
[131] Rosetta Code, main page, read 13 October 2026: 1,360 tasks, 421 draft tasks, 1,009 known languages. https://rosettacode.org/wiki/Rosetta_Code