Le Reality Code Engine : une Forme sans perte pour une programmation native, vérifiée et sobre en énergie
Un système de programmation dans lequel un programme est écrit une fois comme une machine à états et chaque langage cible en est généré, avec des mesures des allers-retours, du refus des entrées malformées et de la réparation du code élevé.
David Charlot, Open Interface Engineering
Ceci est une traduction de la version anglaise. En cas de divergence, la version anglaise fait foi. Original anglais.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Le Reality Code Engine : une Forme sans perte pour une programmation native, vérifiée et sobre en énergie. Open Interface Engineering. Web: https://research.openie.dev/papers/rce/. PDF: https://research.openie.dev/pdfs/rce.pdf.
Version 1.4, 13 octobre 2026. Spécification : brouillon actuel (document du brouillon 0.7, version du langage 0.8), à partir de openIE-dev/rce 2a0ec68. Changements dans la 1.4 : le nombre de tests du moteur est celui des 589 tests distincts qu’exécute cargo test --release (la 1.3 indiquait 596, le total de make check, qui compte deux fois 7 tests de preuve) ; la Section 3.7 indique que la spécification 2.7 donne désormais la règle de coût par site d’appel de C.15 ; le proposant déterministe de la Section 5.5 est rapporté avec 87 identités offertes, 9 admises et 78 rejetées, d’après le test du moteur ; Software Heritage et Rosetta Code, à la Section 7, portent les références [129] à [131], avec les compteurs de l’archive relus ; neuf figures sont ajoutées (Figures 5 à 10, 12, 13 et 15) et les anciennes Figures 5 et 6 sont désormais les Figures 11 et 14. Changements dans la 1.3 : les coûts de méthode proportionnels à la taille sont attribués à la version 0.7 du langage (ils étaient décrits sous la 0.6 dans la 1.2), la règle par site d’appel pour les programmes de versions mixtes est énoncée, et les vérifications sont relancées au commit du moteur 1eb5f02. Données et code : research.openie.dev/data/. Playground (vérificateur de référence) : openie-dev.github.io/rce. Démo du moteur : /demos/rce-engine/. PDF LaTeX : /pdfs/latex/rce.pdf (source).
Corrections et état de reproductibilité (17 octobre 2026). Cette note a été ajoutée après une lecture de l’article confrontée aux dépôts publics. Les chiffres qu’elle concerne sont énumérés ici, et le texte qui suit est par ailleurs inchangé. Chaque décompte ci-dessous provient de src/data/rce-facts.json, produit par scripts/claim-counts.py dans openIE-dev/rce à e416fd0, sauf les deux décomptes Lean, qui ont été relevés à 4304048.
- Un seul langage (18 octobre 2026). La branche main publique de
rce(4a3dc1f) a un seul langage et un seul texte. Une ligne# rce-version:est une étiquette de version tolérée et ignorée, qui n’est pas hachée, et une étiquette de version nomme exactement un commit de la spécification (C.15). Une construction que le vérificateur n’implémente pas est refusée comme réservée, non implémentée (W-RES-1, Annexe F.12), et non par version ; il n’y a qu’une seule liste de mots réservés. Ainsi, la section 3.7 et la figure 5, qui décrivent des barrières de version (versions 0.5 à 0.9), décrivent des brouillons antérieurs et ne s’appliquent plus. Un appel en échec restaure ses arguments&mut(F.4.4), ce qui remplace la règle de recopie du théorème T33. Les décomptes ci-dessous ont été relevés àe416fd0, avant ce changement, et n’ont pas été refaits. La preuve de T33 a changé avec la règle : les théorèmes retirés de recopie quel que soit le résultat ont quitté l’arbre audité (branche main publique derce,95ead2e), et T33 démontre désormais la restauration de F.4.4 ; l’audit indique 4875 théorèmes avec les seuls axiomes standard. - Noms de la bibliothèque (rce-stdlib, 18 octobre 2026). Comme la liste des mots réservés est globale, les noms de la bibliothèque qu’elle réserve désormais ont été renommés :
labelenlbl,nodeennd,groupengrp,childenchd,budgetenbud,restartenrst,replicatedenrepl,ctenctext,sessionensess,protocolenproto,parenparl,offerenoffr,chooseenchse. Les typesJson(moduleenc) etUrl(modulenet.url) deviennentJsonDocetUrlParts, de sorte qu’un programme qui importeenc.Jsonounet.url.Urldoit utiliser les nouveaux noms. La longueur de texte.len()d’une valeurtextest.len_bytes()(octets) ou.len_chars(). - Versions et décomptes à
e416fd0. Le document de spécification est le brouillon 0.9 (public depuiscdae5cf). Avant le 18 octobre, le vérificateur de référence acceptait les versions du langage 0.5 à 0.9 et refusait, par version, les parties de la version 0.9 qu’il n’implémentait pas (Annexe F.12). Les théorèmes T1 à T56 sont énoncés ; T42 à T56 (Annexe F) sont énoncés et non démontrés. Il y a 58 modules Lean et 59 programmes d’exemple (57 au niveau supérieur et 2 dans des paquets). Les figures et légendes de cet article qui indiquent brouillon 0.7, version du langage 0.8, T1 à T34, 31 fichiers ou 51 exemples décrivent le dépôt aux commits antérieurs qu’elles nomment, et cet article ne décrit pas le brouillon 0.9 au-delà de cette note. - Décompte des théorèmes Lean. Il existe deux décomptes différents. La source contient 1,116 déclarations
theoremetlemmaàe416fd0(885 à4304048). L’audit (scripts/lean-audit.sh) compte chaque constante de théorème de l’environnement du noyau, y compris les constantes que génère l’élaborateur, et a donné 4,877 lors d’une nouvelle exécution sur le dépôt public àe416fd0, oùlake builds’achève sur 58 fichiers despec/lean/RCE/sans aucunsorryet avec les seuls axiomes standard (2,949 sur 46 fichiers à4304048). Le 2,192 cité plus bas est le décompte de l’audit au commit du moteur1eb5f02sur 31 modules. Aucun de ces deux nombres ne dit combien de théorèmes sont démontrés sur l’évaluateur Rust. - Reproductible aujourd’hui à partir des dépôts publics : la construction Lean et l’audit des axiomes, la vérification de la spécification (tables de grammaire et corpus d’exemples), le vérificateur de référence et ses tests, et les vecteurs JSON canoniques.
- Pas encore reproductible à partir des dépôts publics : l’exécution de l’écosystème sur 10,000 Formes (
bench/ecosystemn’est pas dans les dépôts publics), les résultats de Kani, les 589 tests du moteur, les taux de réparation de la Section 6 et tout chiffre Defects4J. Ils sont rapportés ici comme les exécutions propres des auteurs et doivent être lus ainsi jusqu’à la publication des sources et des graines. - Réfutateur RCE-F0. Voir la note de la Section 2.3 ci-dessous.
Résumé
Cet article décrit le Reality Code Engine (RCE), un système dans lequel un programme est écrit une fois comme une machine à états, appelée Forme, à partir de laquelle on génère du code dans d’autres langages. Il rend compte de ce qui a été mesuré sur 10,000 Formes et sur des jeux de données publics de bogues, et indique comment ses affirmations pourraient être réfutées.
En termes simples
- Un programme est écrit une fois, sous une forme précise, et l’ordinateur produit à partir d’elle le même programme dans de nombreux langages.
- Comme la forme n’autorise que ce qui a été déclaré, une entrée défectueuse est refusée à la porte au lieu d’être corrigée plus tard.
- Une correction qui passe les vérifications est enregistrée et réutilisée, si bien que le même problème ne coûte pas deux fois de temps ni d’énergie.
1. Thèse
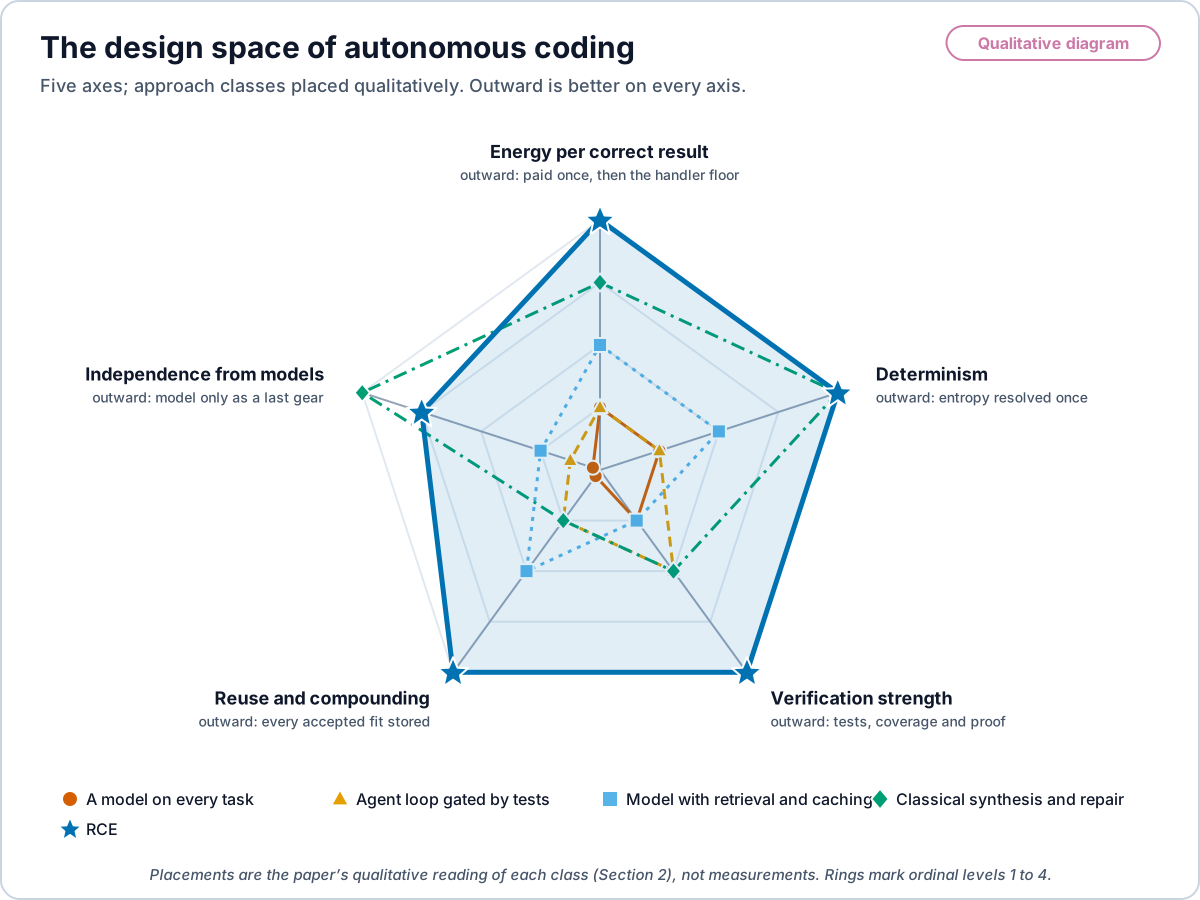
L’automatisation informatique autonome est un espace de conception qui compte de nombreux points. Chaque approche se situe quelque part le long de cinq axes continus : l’énergie dépensée par résultat correct ; l’entropie que le système doit résoudre à l’exécution et, avec elle, le degré de déterminisme de sa sortie ; la solidité de la vérification qui accepte un résultat ; la mesure dans laquelle chaque résultat accepté est réutilisé et se cumule ; et le degré de dépendance de l’approche envers un modèle. Un grand modèle de langage (LLM), modèle statistique de texte, qui écrit chaque modification à partir de l’invite se situe près d’un coin de cet espace : il dépend du modèle pour chaque tâche, tire à chaque fois un nouvel échantillon d’une distribution à forte entropie et paie de nouveau la génération à chaque tâche. La recherche documentaire, les règles, la synthèse, la vérification et le cache occupent de nombreux autres points, et les systèmes réels les combinent.
Le Reality Code Engine (RCE) est un point de cet espace, et cet article le décrit et le mesure. RCE modélise un programme comme une machine à états fonctionnelle de base de données. Lopes et ses collègues ont mesuré qu’environ 70% du code sur GitHub consiste en clones de fichiers antérieurs [33] ; RCE tente donc d’abord de retrouver un ajustement existant, de l’adapter et de le vérifier, et n’appelle un modèle que lorsque rien de moins cher ne clôt la tâche.
L’affirmation centrale. RCE est un écosystème de code complet dans lequel les programmes sont écrits nativement à partir de l’intention. L’intention est écrite une fois, comme une Forme : un état, un ensemble d’événements et une transition pure et totale. La Forme est un codage sans perte de cette intention. Chaque cible (statechart, Rust, Python, XState, SCXML, WASM) est une projection de la Forme, et chaque projection rejoue la trace de la Forme octet pour octet. Un état que la Forme ne déclare pas ne peut pas être écrit, et une entrée hors de son contrat est refusée dès l’entrée. Un programme de l’écosystème ne peut donc pas dériver de son intention comme un programme dans un langage courant dérive de ses commentaires, de ses tests ou de ses autres implémentations, et il n’a besoin d’aucune comparaison de différences ni d’aucun suivi d’erreurs après coup. Chaque ajustement qui franchit la porte est stocké et réutilisé, si bien que l’écosystème se capitalise à mesure qu’il croît (§2.4). Le code écrit dans d’autres langages est une porte d’accès : il entre par élévation (§6).
Chaque point de l’espace fait face à la même porte. La porte est la correction : le prédicat de complétude d’une tâche, , ici les tests de la tâche, une preuve ou une trace d’accord. Parmi les exécutions qui franchissent la porte, les systèmes sont classés par les joules jusqu’à l’achèvement, . La correction est une contrainte, pas un score.
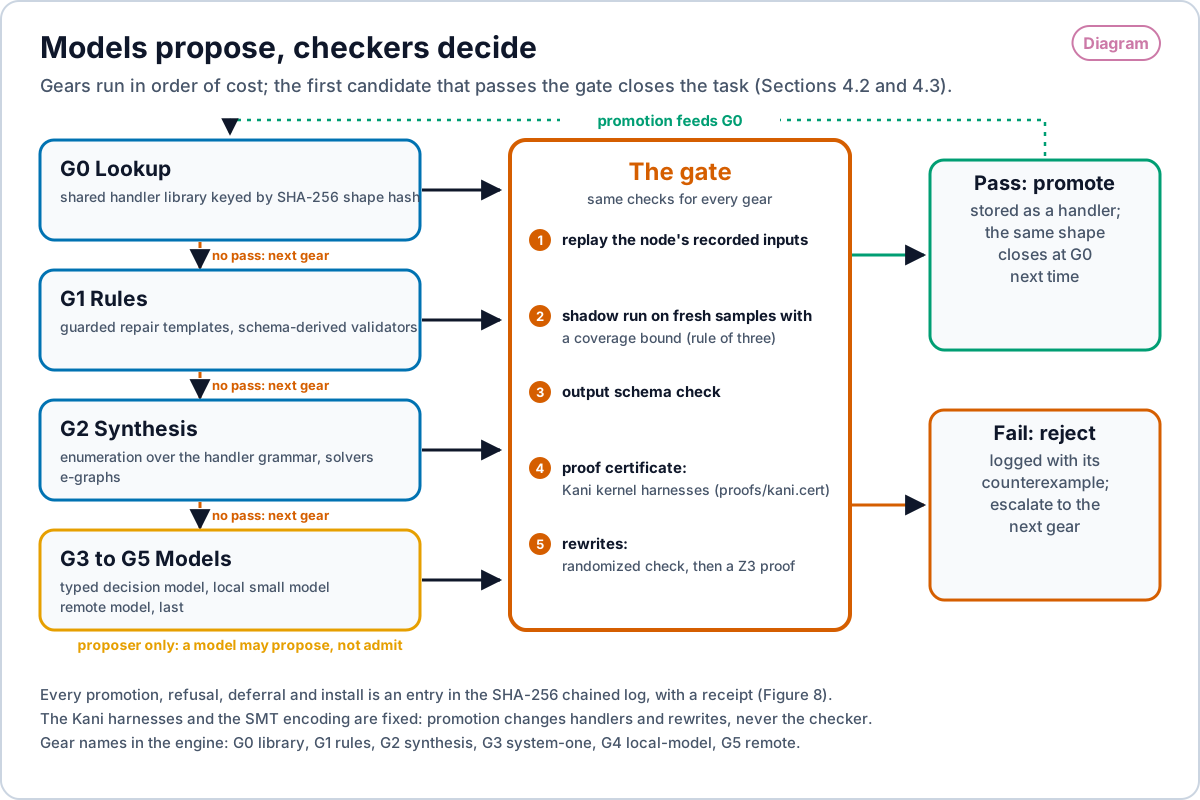
Les mécanismes de RCE, appelés engrenages, s’exécutent par ordre de coût, et le premier engrenage qui franchit la porte clôt la tâche.
Les chiffres d’énergie sont étiquetés selon leur source. est_j est une estimation analytique. reported_j est un compteur du système d’exploitation ou de la puce. measured_j est réservé à un compteur mural et il est vide dans tous les résultats présentés ici.
2. L’espace de conception de la programmation autonome
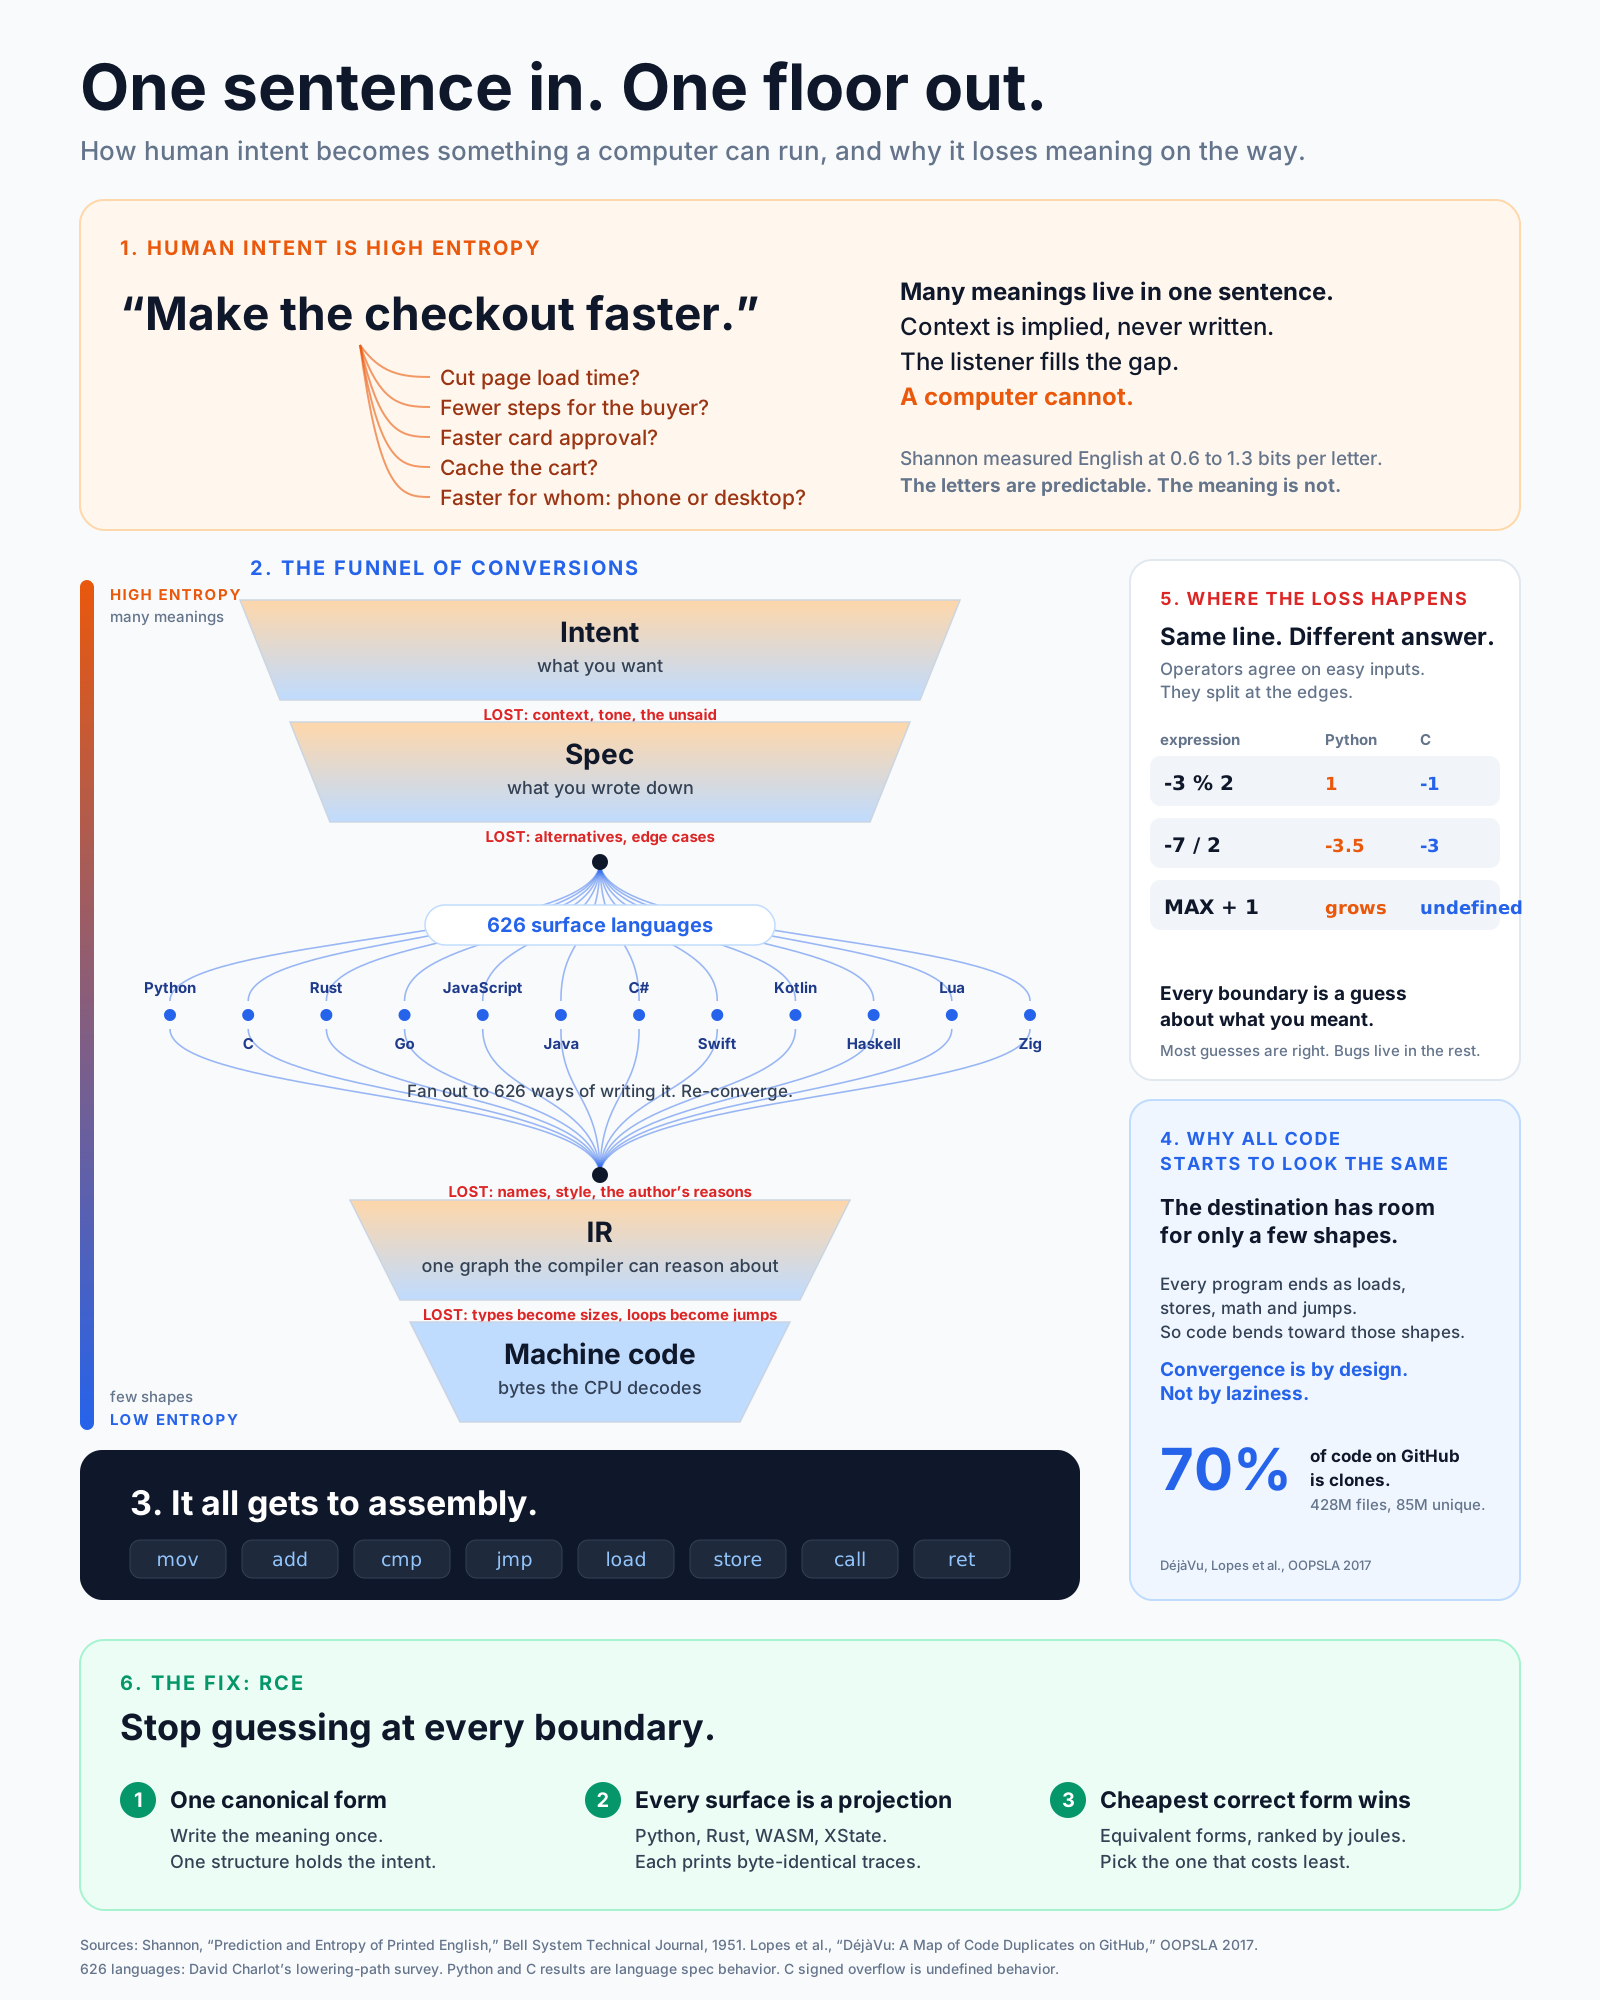
L’intention est à forte entropie. « Rends le paiement plus rapide » a de nombreux sens : chargement de page plus court, moins d’étapes, validation de carte plus rapide, panier en cache, ou rapidité sur une seule classe d’appareils. Le contexte est implicite et n’est jamais écrit. Shannon a mesuré l’anglais imprimé à environ 0.6 à 1.3 bit par lettre [1]. Les lettres sont prévisibles. Le sens ne l’est pas.
Chaque conversion perd de l’information. L’intention devient une spécification, et le contexte est perdu. La spécification devient l’un de centaines de langages de surface, et les alternatives et les cas limites sont perdus. Le source devient une représentation intermédiaire (IR), et les noms, le style et les raisons de l’auteur sont perdus. L’IR devient du code machine : les types deviennent des tailles et les boucles des sauts.
Le plancher est à faible entropie. Tout programme finit en chargements, rangements, arithmétique et sauts. La destination n’admet que quelques formes, si bien que le code s’infléchit vers elles. La convergence est voulue par construction.
Les frontières sont là où le sens diverge. La même ligne donne des réponses différentes aux bords. En Python, -3 % 2 vaut 1 et -7 / 2 vaut -3.5. En C, -3 % 2 vaut -1, -7 / 2 vaut -3, et le dépassement signé est indéfini. Un système qui régénère du code à chaque frontière devine à chaque frontière.
Les axes, énoncés comme grandeurs.
| Axe | Une extrémité | L’autre extrémité | Où se situe RCE |
|---|---|---|---|
| Énergie par résultat correct | Payée de nouveau en entier à chaque tâche | Payée une fois par cas nouveau ; ensuite, le plancher du gestionnaire | Au plancher sur les tâches couvertes |
| Entropie résolue à l’exécution, et déterminisme | La distribution complète de l’invite, un nouvel échantillon à chaque fois | Seulement le résidu qu’aucun ajustement stocké ne couvre, une sortie déterministe | Le résidu seulement ; chaque projection est déterministe |
| Solidité de la vérification | Sortie acceptée après inspection | Tests, couverture et certificat de preuve | La porte complète sur chaque résultat |
| Réutilisation et cumul | Chaque résultat utilisé une seule fois | Chaque ajustement accepté stocké et réutilisé | Chaque ajustement qui franchit la porte est stocké |
| Dépendance envers un modèle | Un modèle à chaque tâche | Aucun modèle | Un modèle seulement comme dernier engrenage |
Les approches diffèrent par degrés sur chaque axe, et les axes interagissent : la réutilisation abaisse l’énergie et l’entropie qui reste à résoudre, et une vérification solide est ce qui rend la réutilisation sûre. RCE écrit le sens une seule fois, dans une Forme canonique. Chaque langage de surface est une projection de cette Forme, vérifiée pour lui correspondre. Parmi les formes équivalentes, c’est la correcte la moins chère qui s’exécute.
La Figure 2 trace les cinq axes et y place les principales classes d’approche.
2.1 Programmer, c’est de la théorie du codage
La thèse de cette section est que la programmation peut se lire comme de la théorie du codage. Un programmeur convertit l’intention le long d’un gradient entre deux régimes entropiques. L’intention est à forte entropie, une distribution sur des sens. Le code est à faible entropie, une transition déterministe par état. Chaque étape du travail logiciel, d’une exigence à un registre, est une étape de cette conversion. La littérature l’a dit par morceaux depuis soixante-dix ans, dans de nombreuses langues. Cette section assemble les morceaux en un seul argument et y place chaque engrenage de RCE.
La mesure. Shannon a défini l’entropie d’une source et la capacité d’un canal [40], et mesuré l’anglais imprimé à environ 0.6 à 1.3 bit par lettre [1]. Kolmogorov, écrivant en russe dans Problemy Peredachi Informatsii en 1965, a donné trois approches de la quantité d’information et fait de l’approche algorithmique la première : l’information d’un objet est la longueur du plus court programme qui le produit [41]. Solomonoff avait atteint le même objet comme théorie de l’inférence inductive [42], et Chaitin a montré que la taille des programmes obéit à des identités formellement identiques à celles de Shannon [43]. Rissanen a fait de l’idée une règle de choix de modèles, la longueur de description minimale [44]. Ensemble, ils disent qu’un programme est un mot de code : une description d’un comportement, et la plus courte description correcte est le plancher. La règle d’extraction de RCE, garder l’ajustement de moindres joules parmi les ajustements équivalents (Proposition 3), est cette règle avec des joules à la place des bits.
Le code se situe dans le régime à faible entropie, et on l’a mesuré. Hindle, Barr, Su, Gabel et Devanbu ont trouvé que le code est « très répétitif, et même davantage que les langues naturelles », avec une entropie croisée plus faible sous les mêmes modèles de n-grammes [35]. Gabel et Su ont trouvé que la plupart des lignes d’un projet existent déjà ailleurs [34], et Lopes et al. que la plupart des fichiers sur GitHub sont des clones [33]. Tu, Su et Devanbu ont trouvé que le code est aussi local : ce qui a été écrit à proximité prédit la suite [46]. Ray et ses collègues ont trouvé que les lignes boguées sont moins naturelles, d’entropie plus élevée, et que l’entropie baisse quand le bogue est corrigé [45]. En 2025, Yang, Kolak, Hellendoorn et Martins ont utilisé la variation d’entropie qu’induit un correctif pour classer les candidats de réparation et séparer les correctifs corrects des correctifs surajustés [51]. Allamanis, Barr, Devanbu et Sutton ont passé en revue le domaine sous le nom de naturalité [47]. Le résultat n’est pas seulement anglophone. Prem Devanbu l’a exposé en conférence plénière à l’India Software Engineering Conference de 2013 [50]. Sridhara, Sinha et Mani, d’IBM Research India, ont mesuré au même endroit les artefacts en langue naturelle autour du code et trouvé que les messages de commit sont les plus réguliers et que la prose de Stack Overflow se comporte comme de l’anglais ordinaire [49]. En Chine, le Journal of Software (软件学报) a publié en 2022 une revue des recherches sur la naturalité du code, qui expose la mesure d’entropie croisée et le constat que le code défectueux a une entropie plus élevée [48]. Au Japon, Doi, Higo, Arima, Shimonaka et Kusumoto, de l’université d’Osaka, ont utilisé la naturalité par n-grammes, d’abord dans un rapport technique de l’IEICE en japonais puis à ICPC 2018, pour distinguer les fichiers sources générés par machine de ceux écrits par des humains [73, 74]. Le code généré se situe encore plus bas sur l’échelle d’entropie que le code humain, car un générateur est une conversion fixe. Au Brésil, la thèse de doctorat d’Arrebola a construit la suggestion de code sur des modèles de n-grammes et de thèmes segmentés par projet et par mainteneur, et l’a évaluée par l’entropie croisée, les bits nécessaires pour coder le token suivant [75]. Les deux régimes sont visibles dans un même dépôt : la prose autour du code est à forte entropie, et le code à faible entropie.
La mesure compte. Febres, Jaffé et Gershenson, depuis le Venezuela et le Mexique, ont comparé l’anglais, l’espagnol et le texte de programmes par la diversité du vocabulaire selon la longueur du message, et trouvé le texte de programmes plus divers [76]. Rahman, Palani et Rigby ont trouvé qu’une grande part de la prévisibilité par n-grammes du code vient des tokens syntaxiques, et que le code reste répétitif, moins qu’annoncé au départ, une fois ceux-ci retirés, l’usage des API étant la partie la plus répétitive [77]. Les deux résultats affinent l’affirmation au lieu de la renverser. La diversité des symboles n’est pas la prévisibilité, et le régime à faible entropie est une propriété de la distribution conditionnelle de l’étape suivante, celle que fixe une transition déterministe. C’est pourquoi le G0 de RCE indexe des formes, et non des tokens de surface.
L’intention se situe dans le régime à forte entropie. Zave et Jackson ont montré qu’une exigence est un énoncé sur l’environnement, une spécification un énoncé à l’interface, et que l’écart entre les deux n’est comblé que par une connaissance du domaine souvent non écrite [64]. Brooks a divisé la difficulté du logiciel en essence et accident : l’essence est la construction conceptuelle, et l’essentiel en est spécification et conception, non représentation [61]. Naur a soutenu qu’un programme est la partie visible d’une théorie détenue par ses programmeurs, et que cette théorie n’est pas entièrement récupérable à partir du texte [62]. Lus à travers Shannon, les trois disent la même chose. L’intention porte plus d’incertitude que n’importe quel programme, et écrire le programme est l’acte qui la supprime. Ce qui reste dans la tête d’un programmeur une fois le code écrit est la part de l’intention que le code n’a pas codée.
La conversion est un raffinement, et le raffinement est un rétrécissement. Hoare a donné aux programmes une logique où un programme est correct relativement à une précondition et une postcondition [54]. Wirth a enseigné le raffinement pas à pas : décomposer une tâche en instructions par des décisions successives, chacune fixant un choix que la spécification laissait ouvert [53]. Les commandes gardées de Dijkstra ont rendu les choix ouverts explicites sous forme de non-déterminisme, et dérivé des programmes de spécifications en le supprimant [52]. À Munich, le projet CIP de Bauer et Wössner a construit le développement de programmes comme une suite de transformations préservant la correction, de la spécification au programme [58]. En France, la méthode B d’Abrial puis Event-B ont porté le raffinement à l’échelle industrielle, avec des obligations de preuve à chaque étape [55, 56]. En Finlande, Back et von Wright ont donné au raffinement son calcul en treillis [57]. Dans chaque cas, une spécification dénote un ensemble de comportements acceptables et chaque étape de raffinement réduit l’ensemble, jusqu’à ce qu’il ne reste qu’un comportement déterministe. C’est une réduction d’entropie avec une preuve à chaque étape. La Forme de RCE est le dernier maillon de cette chaîne : une transition totale et déterministe sur des états de base de données, tout choix résolu (§3.2).
La synthèse est une recherche qui rétrécit un espace d’hypothèses. FlashFill de Gulwani apprend un programme de chaînes à partir de quelques exemples d’entrée et de sortie en représentant l’ensemble de tous les programmes cohérents et en l’intersectant avec chaque nouvel exemple [59]. Gulwani, Polozov et Singh présentent la synthèse de programmes en général comme une recherche dans un espace de programmes contraint par l’intention [60], et le sketching de Solar-Lezama remplit les trous d’un programme partiel avec un solveur [27]. Chaque exemple ou contrainte est une mesure qui élimine des hypothèses. La mesure de Shannon compte combien de mesures de ce type sont nécessaires. Le G2 de RCE est cet engrenage.
Ce que produit la conversion a une seule forme. Gurevich a démontré que tout algorithme séquentiel est capturé par une machine à états abstraite à son propre niveau d’abstraction [2]. Codd a fait de l’état une relation [5], et l’event sourcing fait de l’état le repli d’un journal en ajout seul [14]. Selon Curry et Howard, une preuve est un programme et une proposition est un type [18, 72], de sorte qu’un ajustement vérifié est une preuve de sa spécification. Voilà pourquoi le régime à faible entropie a peu de formes : la destination est une machine à états sur une base de données, quel que soit le langage de surface.
La faible entropie se dégrade sans porte. Lehman a observé sur des décennies de grands systèmes qu’un programme en usage doit continuer à changer, et que sa complexité croît à moins qu’un travail ne soit fait pour la réduire [63]. Torres, Baltes, Treude et Wagner ont mesuré l’entropie structurelle et textuelle sur les historiques de commits de 25 projets et trouvé qu’elles augmentent ensemble [78]. L’entropie revient dans le code depuis l’environnement. Un système qui maintient le code dans le régime à faible entropie a besoin d’une porte à chaque modification, et la porte de RCE est la correction (§4.3).
Les compilateurs font déjà du codage de source. Franz et Kistler ont distribué des programmes sous forme d’arbres de syntaxe abstraite compressés et généré le code natif au chargement, ce qui est un codage de source d’un programme sur sa propre grammaire [67]. Fraser a inféré des modèles statistiques du code à partir d’un corpus pour le compresser [68]. Futamura a montré en 1971, dans la revue japonaise Systems, Computers, Controls, que spécialiser un interprète pour un programme donne un programme compilé, et que spécialiser le spécialiseur donne un compilateur [70]. Erchov, à Novossibirsk, a développé la même idée sous le nom de calcul mixte [71]. L’interprétation abstraite des Cousot calcule une description sûre et de moindre information de chaque comportement d’un programme [69]. L’analogie avec le codage de canal est une lecture propre à cet article, non un théorème cité : types, tests et preuves ajoutent une redondance vérifiée pour qu’un programme erroné soit détecté avant de s’exécuter, comme un contrôle de parité détecte un mot corrompu.
L’effacement est là où vont les joules. Landauer a montré qu’une étape logiquement irréversible, l’effacement d’un bit, dissipe au moins [65]. Bennett a montré que le calcul peut en principe être rendu logiquement réversible, de sorte que c’est l’effacement, et non le calcul, qui porte la borne [66]. Convertir une intention à forte entropie en un programme à faible entropie écarte toute alternative que l’intention permettait. Cet écart est un effacement d’information sur les alternatives, et il a un plancher thermodynamique. RCE paie l’écart une fois par cas nouveau et stocke le résultat, si bien qu’un cas répété n’efface rien de nouveau.
2.2 Comment RCE convertit, et où se place chaque engrenage
Lue comme théorie du codage, une tâche arrive comme un message dont l’incertitude restante est ce qu’aucun ajustement stocké ne résout déjà. Chaque engrenage supprime de l’incertitude à un prix différent, et les engrenages sont ordonnés selon ce prix (§4.2).
| Engrenage | Ce qu’il fait de l’incertitude | Filiation dans l’argument ci-dessus |
|---|---|---|
| G0 Recherche | Reconnaît que l’intention était déjà codée ; la résout par récupération, au plancher du gestionnaire | Répétitivité et clones [33, 34, 35] ; localité [46] |
| G1 Règles | Applique une réécriture gardée connue ; résout un résidu récurrent sans recherche | Transformation préservant la correction [52, 58] ; raffinement avec obligations de preuve [55, 56] |
| G2 Synthèse | Parcourt un espace d’hypothèses et le rétrécit par des exemples, des contraintes et un solveur | Synthèse de programmes comme recherche [27, 59, 60] |
| G3 à G5 Modèles | Échantillonne une distribution apprise sur le code quand aucun engrenage inférieur ne comble l’écart ; seulement comme proposant | Modèles d’entropie croisée du code [35, 47] |
| Porte | N’accepte un candidat qu’avec des tests, une couverture et un certificat de preuve | Logique de Hoare [54] ; Curry-Howard [18, 72] |
| Promotion | Stocke l’ajustement accepté, de sorte que le même résidu coûte G0 la fois suivante | Longueur de description minimale [44] ; effacement de Landauer payé une fois [65] |
Les positions sur les axes de la Section 2 diffèrent par l’endroit où la conversion est payée. Une approche qui échantillonne la distribution complète de l’invite à chaque tâche paie à chaque fois le côté à forte entropie. Une approche qui stocke et réutilise les ajustements acceptés ne paie que pour le résidu, et une seule fois. La plupart des systèmes se situent entre ces extrémités, et RCE se situe à l’extrémité de la réutilisation.
2.3 L’écosystème à grand N
L’affirmation du §1 est mesurée directement. Le banc a été préenregistré avant l’exécution (bench/ecosystem/PREREG.json). Un générateur à graine écrit 10,000 Formes, chacune composée d’une source, d’une règle dont le corps est un terme arithmétique aléatoire de profondeur au plus 3 sur huit opérateurs, et d’un puits. Le moteur est figé au commit a079967, et aucun modèle n’est appelé.
| Propriété | Ce qui est vérifié par Forme | N | Vérifiée | Appels de modèle |
|---|---|---|---|---|
| Codage sans perte | Form IR vers JSON canonique vers Form IR vers JSON canonique est l’identité | 10,000 | 10,000 | 0 |
| Projection déterministe | Deux compilations donnent les mêmes octets ; les projections XState et SCXML de la Forme d’origine et de la Forme après aller-retour sont identiques octet pour octet | 10,000 | 10,000 | 0 |
| Projection fidèle, Python | Le module Python émis imprime la trace de référence octet pour octet sur 40 événements à graine | 10,000 | 9,999 | 0 |
| Porte à l’entrée, entrées | Cinq types de charge malformée (mauvais type, null, champ manquant, vide, imbriqué) tous refusés, sans aucun résultat accepté | 10,000 | 10,000 | 0 |
| Porte à l’entrée, spécifications | Une spécification avec un flux vers un nœud non déclaré est refusée avant la compilation | 10,000 | 10,000 | 0 |
La Figure 3 montre les mêmes décomptes.
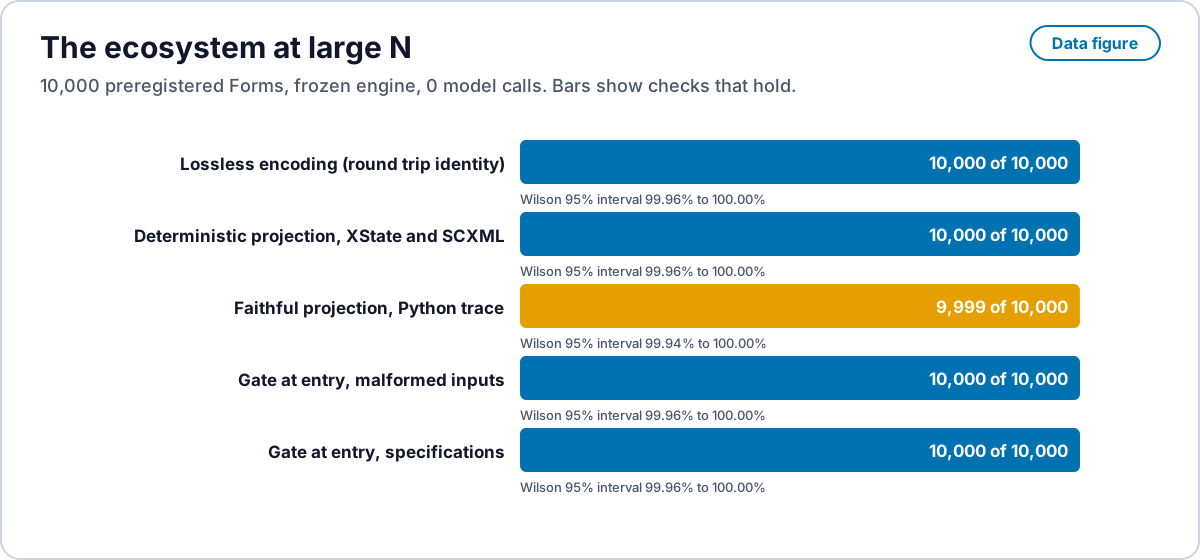
a079967, 0 appel de modèle, avec des intervalles de Wilson à 95% calculés à partir des décomptes. Source : bench/ecosystem. Une copie PNG est fournie. Open full size · PNG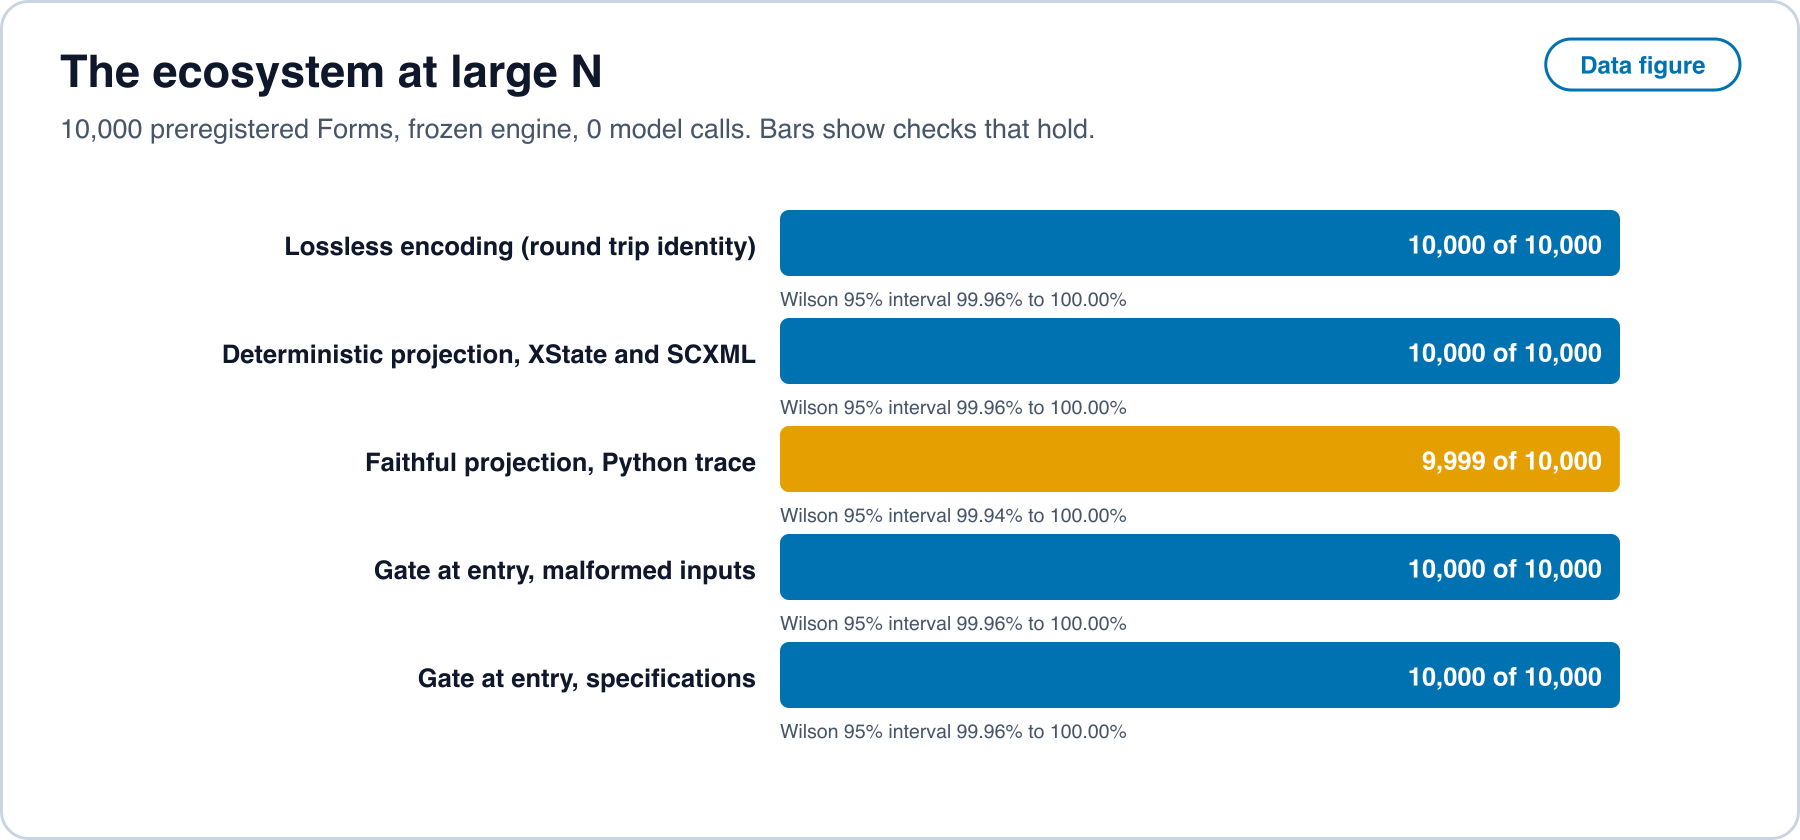
RCE-F0 et l’échec Python. La Section 9 énonce RCE-F0 ainsi : sur une exécution préenregistrée d’au moins 10,000 Formes, une projection imprime une trace qui diffère de la trace de référence de la Forme, ou une entrée malformée est acceptée. Cette exécution est préenregistrée, compte 10,000 Formes, et un module Python émis n’a pas imprimé la trace de référence, de sorte que l’observation, telle qu’elle est écrite, remplit la condition de RCE-F0. L’article rapporte l’échec et le test de régression ci-dessous, et il ne donne pas de cause racine. Il faut lire le texte de RCE-F0 tel qu’il est énoncé : l’affirmation qu’il réfute est que les projections sont fidèles, et la projection Python de cette exécution n’a pas satisfait cette affirmation sur une Forme. La question de savoir si l’échec vient de l’émetteur ou du harnais reste ouverte ici. Le fait que la même Forme se rejoue à l’identique sous 32 graines de hachage ne la tranche pas.
L’unique échec Python est compté comme un échec ; la même Forme et les mêmes événements se rejouent à l’identique sous 32 graines de hachage dans le test de régression tests/form_ecosystem_regress.rs. L’énergie est ici est_j seulement ; toute l’exécution a pris 393 s de temps CPU sur un cœur. Les Formes générées sont petites, si bien que ce tableau mesure le codage, les projections et la porte. Les Formes élevées à partir de programmes réels sont mesurées selon le protocole du §8.7.
2.4 Auto-amélioration récursive, sous porte et vérifiée
Good (1965) [111] a défini la machine ultra-intelligente comme une machine capable de concevoir de meilleures machines, de sorte que l’amélioration deviendrait récursive. Yudkowsky (2013) [113] a posé la question en termes de rendements : chaque unité d’amélioration rend-elle la suivante moins chère ou plus chère ? La machine de Gödel de Schmidhuber (2007) [112] a donné une réponse formelle assortie d’une garantie : un programme réécrit n’importe quelle partie de lui-même, y compris sa propre recherche, seulement après avoir prouvé que la réécriture améliore son utilité espérée. Le théorème de Löb (1955) [114] est l’obstacle que rencontre un prouveur qui se fait confiance, que Yudkowsky et Herreshoff (2013) [115] ont nommé l’obstacle de Löb : un système ne peut pas, en général, prouver la correction d’un successeur qui utilise son propre système de preuve. Les systèmes récents abandonnent l’exigence de preuve et sélectionnent par score mesuré : STOP (Zelikman et al., 2023) [116] améliore l’échafaudage qui améliore le code, la Darwin Gödel Machine (Zhang et al., 2025) [117] conserve une archive d’agents de programmation automodifiés choisis par leur score sur un banc d’essai, AlphaEvolve (Novikov et al., 2025) [118] fait évoluer des programmes sous des évaluateurs automatiques, et Voyager (Wang et al., 2023) [119] fait croître une bibliothèque de compétences vérifiées que les tâches ultérieures réutilisent.
RCE reprend la structure de la machine de Gödel et la bibliothèque de Voyager, avec deux différences qui contournent l’obstacle pour les objets qu’il promeut. Premièrement, l’objet qui s’améliore n’est pas le prouveur. RCE promeut des gestionnaires, des réécritures et des engrenages, et chacun est vérifié contre un noyau fixe, certifié séparément : les harnais Kani et l’encodage SMT ne changent jamais au fil des promotions, si bien qu’aucune étape n’a besoin de faire confiance au système de preuve d’un successeur. Deuxièmement, la porte est une preuve de correction à la frontière, et non un score. Un score peut monter alors qu’une hypothèse d’interface se rompt ; une preuve à la frontière ne peut pas être franchie par un changement qui la rompt.
Proposition R1 (correction monotone). Si chaque changement promu passe la vérification de sa frontière, et si les vérifications des autres frontières sont inchangées, alors toute propriété établie par ces vérifications avant la promotion tient encore après elle.
Proposition R2 (cumul). Soit une charge de travail, multiensemble de tâches, et soit un gestionnaire promu qui clôt toute tâche de sa forme. Alors le nombre d’escalades au tour t est non croissant en t, et une correction promue avant le tour 1 abaisse les escalades cumulées de tout horizon du nombre d’escalades qu’elle clôt à chaque tour ultérieur. Dans la charge de travail de référence de la démo du moteur, les escalades cumulées sur huit tours passent de 21 à 15 avec une correction aux puits, et atteignent zéro au dernier tour dans les deux cas, chaque tâche étant close correctement et aucune promotion refusée.
La Figure 4 trace le mécanisme des Propositions R1 et R2 avec les totaux de la charge de travail de référence.
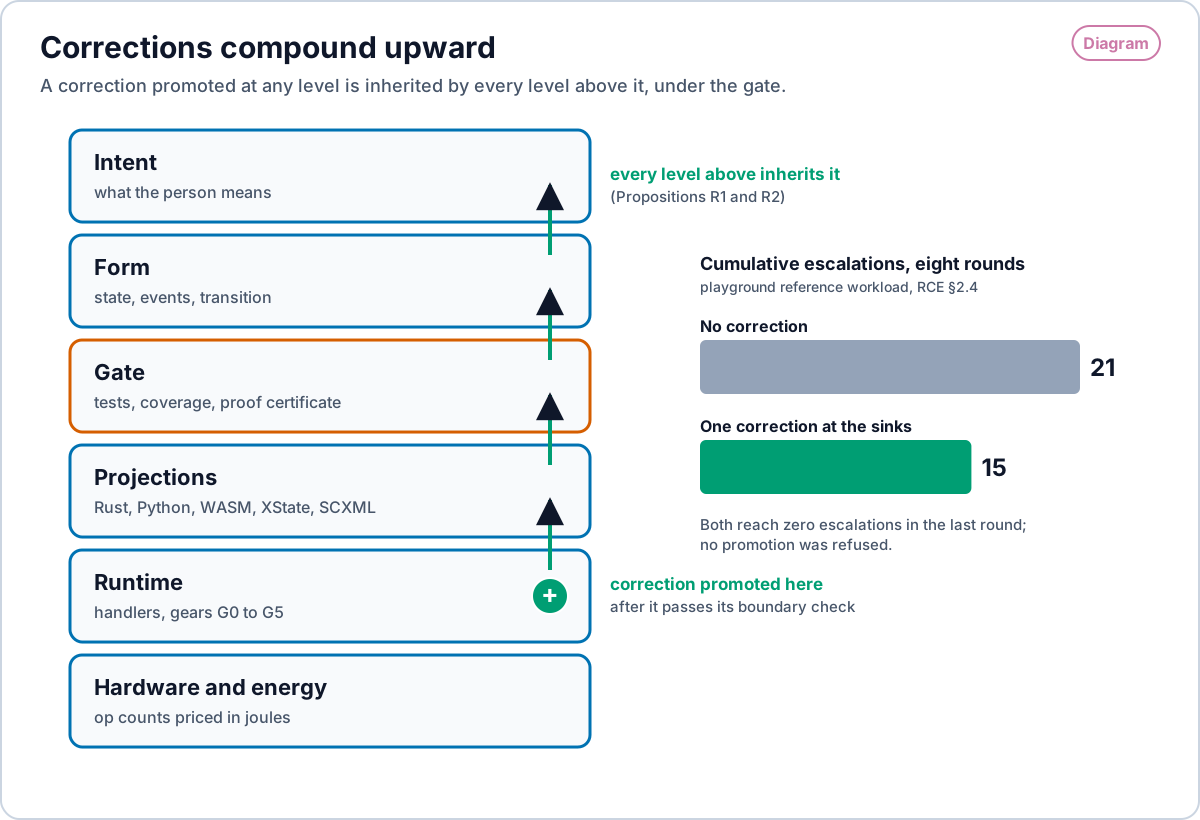
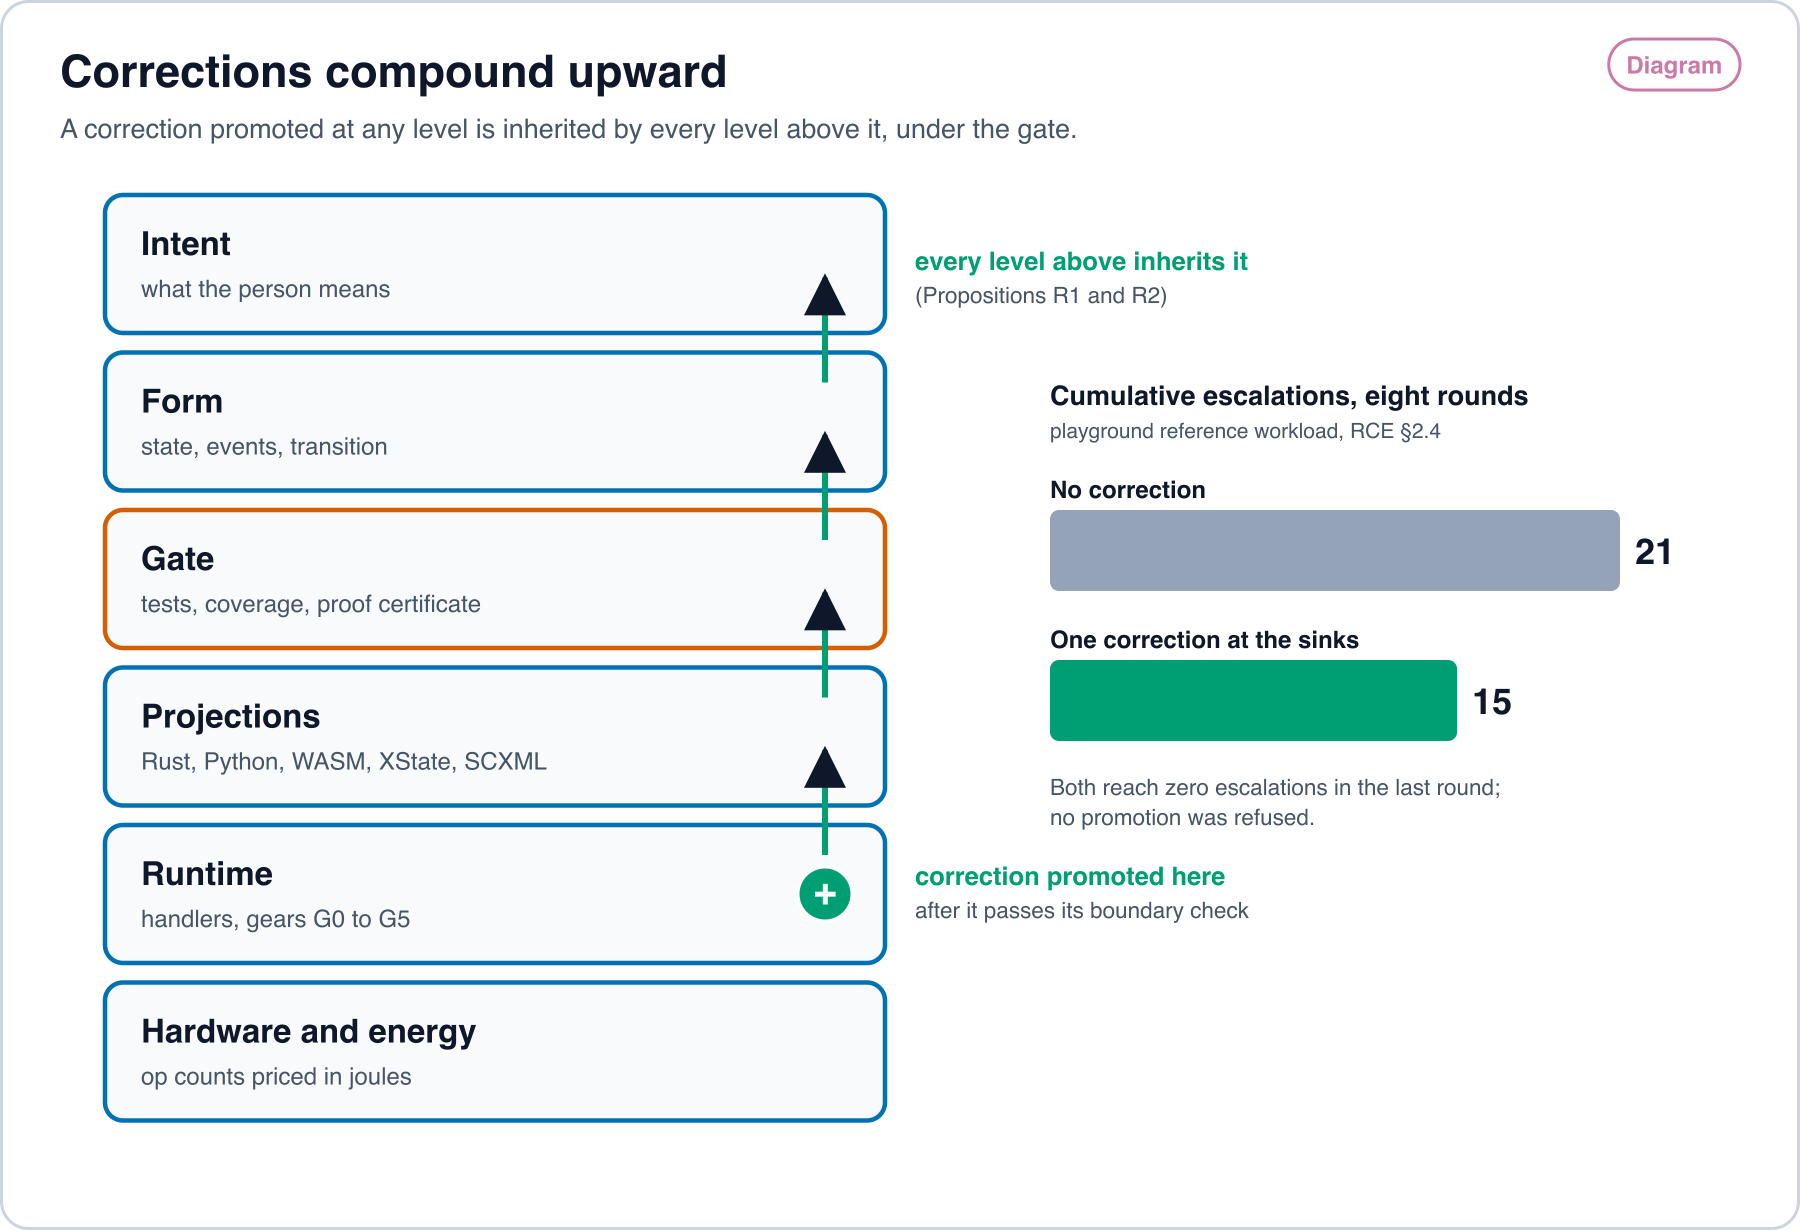
Proposition R3 (coût décroissant). Puisqu’un gestionnaire promu est exécuté à la place d’un appel de modèle, et que son coût est le nombre d’opérations du gestionnaire tarifé par la table du substrat, l’énergie d’un tour descend vers l’énergie des seuls gestionnaires à mesure que les escalades descendent vers zéro.
Les projections de Futamura (1971, republiées en 1999) [120] et la supercompilation de Turchin (1986) [121] donnent la limite de ce processus. Spécialiser un interpréteur à un programme donne un programme compilé ; spécialiser le spécialiseur donne un compilateur. Les promotions de RCE spécialisent la voie générale d’escalade aux formes qui se présentent réellement, de sorte que le moteur converge vers le programme résiduel de sa charge de travail : la part du calcul qu’un modèle ou une personne doit encore fournir. L’auto-amélioration récursive sous une porte est cette convergence, faite par étapes vérifiées. La couche Compounding de la démo du moteur de RCE exécute cette charge de travail dans le navigateur.
3. La Forme
3.1 L’énoncé formel le plus fort de « même forme »
La portée du théorème est d’abord précisée. Les postulats séquentiels de Gurevich couvrent les algorithmes séquentiels ; les algorithmes parallèles et interactifs requièrent les postulats supplémentaires de Blass et Gurevich [3]. Blass, Dershowitz et Gurevich soutiennent qu’aucune relation d’équivalence unique entre algorithmes ne convient à tous les usages [79], et Moschovakis et Vardi exposent le débat sur ce qu’est un algorithme [80, 81]. Un gestionnaire web qui fait des entrées et sorties sort du théorème séquentiel. La Forme traite l’interaction comme le fait la ligne interactive : chaque entrée est un événement de , et la machine à états avance sur lui. « Une Forme » est donc un choix de modélisation fondé sur le théorème séquentiel et étendu par convention, avec des précédents en production dans l’architecture Elm [83], les historiques d’événements des workflows durables [84] et des sémantiques de flux comme Flo [82]. Les propositions de la Section 3.4 sont énoncées pour ce choix.
Le théorème de la machine à états abstraite (ASM) de Gurevich est l’énoncé formel le plus fort selon lequel tout algorithme a une seule forme [2]. Une machine à états abstraite est une machine dont les états sont des structures du premier ordre et dont le pas est un ensemble fini de mises à jour gardées. Gurevich énonce trois postulats. Temps séquentiel : un algorithme a des états, des états initiaux et une application à un pas . État abstrait : les états sont des structures du premier ordre sur un vocabulaire fixe, closes par isomorphisme. Exploration bornée : un ensemble fini de termes décide chaque pas. Son théorème principal (théorème 6.13) dit : « Pour tout algorithme séquentiel A, il existe une machine à états abstraite séquentielle B équivalente. » Blass et Gurevich l’étendent aux algorithmes parallèles [3]. Dershowitz et Gurevich ajoutent un quatrième axiome, la calculabilité des opérations initiales, et en dérivent la thèse de Church [4].
3.2 Définitions
Définition 1 (la Forme). Un programme est un n-uplet
- , l’espace d’états : des structures sur un vocabulaire fixe , divisé en régions de contrôle et données . contient l’horloge logique, le compteur d’entrées et les relations typées (dans le langage, aussi les régions déclarées). Chaque état est une instance de base de données au sens de Codd [5].
- , l’alphabet d’événements, y compris le tic de l’horloge logique.
- , la transition : totale, déterministe et pure, écrite comme un ensemble fini de mises à jour gardées « si alors », chaque pas lisant un ensemble borné d’emplacements. Elle renvoie l’état suivant et les sorties du pas. On note sa composante d’état.
- , le journal durable : une suite d’entrées , où est le SHA-256 du JSON canonique de l’état après le pas, est le SHA-256 du JSON canonique des quatre premiers champs, et le premier vaut 64 zéros. Le journal est une chaîne d’empreintes, de sorte que modifier une entrée passée modifie chaque ultérieur.
- , l’application de sortie. Une machine de Mealy lit les deux arguments [6] ; une machine de Moore ne lit que l’état [7].
Définition 2 (Forme et ajustement). La forme est la structure du n-uplet avec quatre invariants : est déterministe et pure ; l’exploration est bornée ; le vocabulaire est fixe ; l’état est le repli du journal,
Un journal peut aussi porter le résultat, les sorties et l’état de chaque entrée. Ce sont des données dérivées : elles ne sont pas hachées, et elles doivent être égales au rejeu (T1 et T3 du §3.7). Deux sortes de rejet sont distinctes. Dans le profil du moteur, chaque événement est appliqué, et une entrée qui ne respecte pas son contrat produit une sortie reject et une ligne d’erreur. Dans le langage, un événement refusé laisse l’état inchangé (T8) et est enregistré comme refusé.
L’ajustement est la donnée qui remplit la forme : le vocabulaire , les alphabets et , le programme de règles qui définit , les règles de sortie qui définissent , et les données initiales . Dans les termes de Gurevich, l’ajustement est le vocabulaire, le programme ASM et les structures initiales. Dans ceux de Codd, est le schéma et l’instance. En termes de lignes de produits, un ajustement est une sélection de caractéristiques [8]. En termes de synthèse guidée par la syntaxe (SyGuS), un ajustement est un terme d’une grammaire qui satisfait une spécification [9].
Définition 3 (équivalence d’ajustements). Deux ajustements sont équivalents lorsque, pour toute suite d’événements , leurs suites de sorties sous sont égales.
Définition 4 (langage d’ajustements). Une grammaire dont les termes dénotent des ajustements. Les langages de programmation, les documents SCXML, les configurations XState et les spécifications .rce sont des langages d’ajustements. Un langage d’ajustements est complet lorsque tout programme ASM sur y a un terme.
Définition 5 (projection de contrôle). On sépare en symboles de contrôle finis et relations de données. Le statechart de est la projection de sur : les états sont des valeurs de , les transitions portent un événement et une garde sur , et les actions sont des mises à jour de . Les statecharts de Harel apportent la hiérarchie et les régions orthogonales [10].
Définition 6 (e-graphe d’ajustements). Pour un ajustement et un ensemble de réécritures correctes, l’e-graphe d’ajustements est l’e-graphe saturé des termes de règles de sous [11, 12]. Chaque e-classe contient des ajustements équivalents au sens de la Définition 3.
Définition 7 (coût en joules). est l’énergie estimée (est_j) pour exécuter le terme une fois sur un substrat nommé, pondérée par le nombre attendu d’exécutions.
3.3 Pourquoi « machine à états fonctionnelle de base de données »
Une structure relationnelle finie est une instance de base de données, si bien qu’un état de Gurevich est une base de données et chaque pas une transaction bornée. Base de données : est une structure relationnelle. Fonctionnelle : et sont pures. Machine à états : les exécutions sont des replis de sur des événements. Moseley et Marks tracent la même ligne en architecture [13]. L’event sourcing la trace dans l’état applicatif : « Capturer toutes les modifications de l’état d’une application comme une suite d’événements » [14]. Dedalus la trace en logique, où l’état mutable est une relation indexée par le temps [15].
3.4 Propositions
Proposition 1 (la Forme capture tout algorithme séquentiel). Pour tout algorithme séquentiel , il existe une instance de la Forme dont les exécutions sont celles de .
Esquisse de preuve. Le théorème 6.13 donne une ASM avec les états, les états initiaux et l’application à un pas de . Posons , , et l’identité. Le repli après tics est . Par le corollaire 3.3 de Gurevich, et ont les mêmes exécutions. ∎
Proposition 1b (programmes interactifs). On étend par un symbole d’entrée d’arité nulle fixé à avant chaque pas ; alors est un algorithme séquentiel sur le vocabulaire étendu, et la Proposition 1 s’applique. La construction est la nôtre.
Proposition 1c (calculabilité). Sous l’axiome de Dershowitz et Gurevich, toute instance de la Forme calcule une fonction Turing-calculable [4, 16, 17]. La Forme n’ajoute aucune puissance. Elle donne à chaque programme de la classe une seule forme.
Proposition 1d (les preuves sont des ajustements). « Pour chaque preuve d’une proposition donnée, il existe un programme du type correspondant » [18]. Un type est une spécification et une preuve est un ajustement qui la satisfait. La porte de correction est l’existence de cette preuve ou d’un test d’acceptation réussi.
Proposition 2 (un générateur). Une fonction génère un programme exécutable pour chaque ajustement et ne lit aucun domaine. Fondement : tout programme est une instance de la Forme, donc émet un stockage typé, un type d’événement, des règles compilées, un journal avec un repli et un répartiteur de sorties. Les générateurs d’échafaudage comme ceux de Rails, JHipster et Yeoman sont restreinte à de petits langages d’ajustements. L’ingénierie des lignes de produits part de « la découverte et l’exploitation systématiques des points communs entre systèmes logiciels apparentés » [8] ; le point commun est la Forme.
Proposition 3 (extraction de moindre énergie). L’extraction avec renvoie le terme de moindres joules que l’extracteur trouve dans l’e-classe de . Esquisse de preuve. Les réécritures sont correctes, donc tout terme de l’e-classe a le comportement observable de et franchit la même porte. L’extraction minimise le coût, et le coût, ce sont des joules. ∎ C’est Mixture of Limits appliqué au code : garder l’ajustement minimal qui fait la tâche ; le reste est du gaspillage.
Proposition 4 (déterminisme du rejeu). Si ne lit aucune horloge murale, ordonne les mises à jour sans noms et journalise chaque entrée, deux rejeux d’un même donnent des empreintes d’état identiques à chaque pas.
Proposition 5 (la projection en statechart est correcte). On projette chaque état d’une exécution sur . Le résultat est une exécution du statechart émis sous les mêmes événements.
Proposition 6 (budget de coordination). Les règles marquées monotones s’exécutent sur des répliques sans coordination ; seules les règles non monotones ont besoin d’un point de coordination. Fondement : le théorème CALM, « les programmes qui ont des implémentations distribuées cohérentes et sans coordination sont exactement les programmes exprimables en logique monotone » [19].
L’étiquette est dérivée de la règle, jamais déclarée, et la vérification de l’IR refuse une Forme dont l’étiquette stockée diffère de l’étiquette dérivée (spécification, Annexe D.5) :
| La règle contient | Étiquette | Raison |
|---|---|---|
| aucun resolve, read, join ni scan | monotone | ses écritures ne font qu’ajouter des clés et faire croître des compteurs |
| un resolve | non monotone | il supprime des lignes d’escalade |
| un read de son propre puits | non monotone | lire, modifier, écrire |
| un join par clé | non monotone | la ligne jointe peut être absente maintenant et présente plus tard, ou écrasée |
| un scan | non monotone | il observe toute la relation, y compris ce qui est absent |
L’étiquette est correcte mais pas complète : un join contre une relation en insertion seule serait monotone, mais le profil ne prouve pas qu’une relation est en insertion seule, donc l’étiquette ne le prétend pas. Une Forme est sans coordination lorsque chaque règle est monotone. Chaque read, join et scan voit l’état à l’entrée de l’événement, de sorte que l’état postérieur d’un événement d’entrée ne dépend pas de l’ordre dans lequel s’exécutent les règles de puits différents ; seul l’ordre des sorties en dépend, et il est fixé par l’empreinte du contenu.
Proposition 7 (l’intelligence comme dérivée en joules). Soit le nombre de tâches qui franchissent la porte et les joules dépensés. se lit a posteriori à partir de , qui enregistre chaque événement et son est_j. L’extraction sous maintient la porte fixe et n’augmente pas , donc à égal elle ne diminue pas .
3.5 Graphe, e-graphe et statechart
| Structure | Partie de la Forme | Ce qu’elle décide |
|---|---|---|
| Statechart | Gardes de sur | Quelle transition se déclenche |
| Graphe de flot de données | Dépendances de lecture et d’écriture de et (réseaux de processus de Kahn [20]) | Ce qui s’exécute, et dans quel ordre |
| E-graphe | La classe d’équivalence de l’ajustement | Quel ajustement équivalent s’exécute |
Le statechart et le graphe décrivent un ajustement. L’e-graphe décrit tout ajustement qui lui est équivalent. L’extraction choisit parmi eux par les joules.
3.6 Un écosystème, sans perte, et la thèse d’universalité
Sans perte par construction. Le théorème de codage de source de Shannon fixe le plancher d’un code sans perte à l’entropie de la source [40]. Une Forme est un code sans perte pour l’intention en un sens étroit et vérifiable : la sérialisation canonique de la Forme est injective, si bien que deux Formes qui diffèrent par un état, un événement ou une transition ont des empreintes de forme différentes, et le décodage de la sérialisation redonne la même Forme. Chaque projection vers une cible est une fonction de la seule Forme. Les transformations bidirectionnelles rendent l’aller-retour précis. Foster, Greenwald, Moore, Pierce et Schmitt définissent une lentille comme une paire de fonctions get et put dotée de conditions d’aller-retour qui accordent une vue et sa source [122], Hofmann, Pierce et Wagner étendent ces conditions aux lentilles symétriques [123], et Czarnecki et ses collègues passent en revue les mêmes conditions de cohérence en ingénierie des modèles, en bases de données et en langages de programmation [124]. La condition d’aller-retour de RCE est la condition GetPut au niveau du programme entier : si l’on élève à nouveau une projection, l’empreinte de forme ne change pas.
Correct par construction. Dijkstra a proposé en 1968 qu’un programme et sa preuve soient développés ensemble, afin que la correction soit conçue dès le départ plutôt que vérifiée par des tests [125]. Hall et Chapman ont porté l’approche dans un système sécurisé commercial, avec spécification formelle et raffinement à chaque étape [126]. La règle de Minsky pour la programmation fonctionnelle typée, rendre les états illégaux non représentables, dit la même chose au niveau des types : un type qui ne peut pas contenir une mauvaise valeur dispense de la vérifier [127]. La programmation fonctionnelle totale de Turner exige que chaque fonction termine sur chaque entrée, afin qu’un programme dénote une fonction mathématique sans échec caché [128]. La Forme de RCE est totale au sens de Turner, ses types de contrat rendent les états non déclarés non représentables au sens de Minsky, et la chaîne de raffinement du §2.1 s’achève en elle au sens de Dijkstra. La conséquence est celle qu’énonce le §1 : une erreur est refusée dès l’entrée, si bien qu’il ne reste rien à comparer ni à suivre après coup.
La thèse d’universalité. En termes théoriques, la thèse est qu’il existe une Forme universelle. Les programmes y sont écrits nativement, tout langage existant est accessible depuis elle comme projection fidèle, et tout programme existant y entre par élévation. La thèse de Gurevich en donne le fondement : tout algorithme séquentiel est capturé, pas à pas, par une machine à états abstraite à son propre niveau d’abstraction [2], et il en va de même des algorithmes parallèles [3]. Une Forme est une telle machine sur un état de base de données.
Proposition U1 (capture). Si un programme dans le langage est un algorithme séquentiel ou parallèle au sens de Gurevich, alors il existe une Forme dont la transition le simule pas à pas au niveau d’abstraction du programme [2, 3].
Proposition U2 (projection fidèle). Si la projection d’une Forme vers préserve la trace de la Forme sur toute entrée du contrat, alors la Forme et sa projection sont interchangeables pour tout observateur de la trace, et n’ajoute rien qui manque à la Forme.
Proposition U3 (élévation par construction). Tout langage de programmation en usage possède une grammaire formelle, un analyseur qui produit un arbre de syntaxe concrète, un arbre de syntaxe abstraite et une sémantique fixée par sa spécification ou son implémentation de référence. Une élévation est construite par langage en trois étapes : la grammaire, puis l’arbre de syntaxe abstraite, puis la Forme, chaque construction de recevant sa règle de Forme d’après la sémantique de . Une élévation ainsi construite satisfait en comportement et en empreinte de forme, si bien que la paire est une lentille au sens de [122], et qu’un programme en est conservé comme Forme sans perte.
Proposition U4 (remplacement). Si U2 et U3 valent pour le langage , alors aucun programme n’a besoin d’être écrit en : il est écrit une fois comme Forme et émis en là où une plateforme l’exige.
U1 est un théorème. U2 est vérifiée par cible au moyen de tests différentiels (§5.1) et à grand N au §2.3. U3 est une construction, bâtie langage par langage à partir de la grammaire, et le §8.7 indique comment la construction est mesurée à mesure qu’elle est bâtie.
3.7 Le langage : versions 0.6 et 0.7, coûts et statut des théorèmes
Le langage RCE est défini par une spécification écrite, actuellement le document du brouillon 0.7 à la version 0.8 du langage (/rce/spec/ ; source dans le dépôt rce). Chaque module choisit sa version du langage par un commentaire en première ligne. Un module qui n’en a pas est en version 0.5, le langage des sections 2 à 10. Un module qui déclare # rce-version: 0.6 reçoit en plus l’Annexe C : par, for ... par, with budget, les groupes de travail, les LVars, les sessions et les superviseurs. Un module qui déclare # rce-version: 0.7 a le langage de la version 0.6 avec une différence, le coût des méthodes de la bibliothèque standard donné ci-dessous (Annexe C.15). L’Annexe D définit le profil du moteur, les spécifications de gestionnaires et les ajustements qu’exécute le moteur de cet article. Un module en version 0.5 ne voit jamais l’Annexe C, de sorte que tout programme valide en version 0.5 est accepté sans changement.
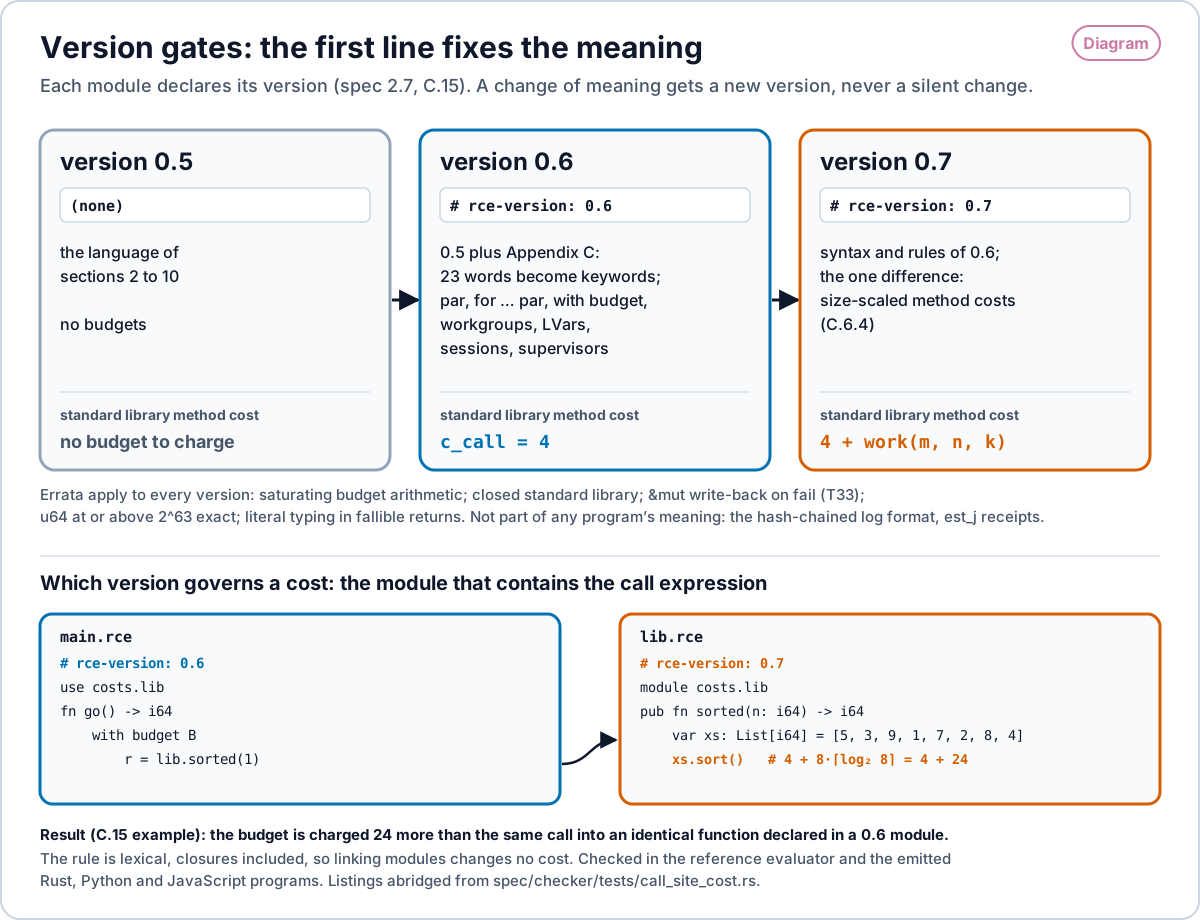
# rce-version: 0.6 ajoute l’Annexe C (23 nouveaux mots-clés ; par, for ... par, with budget, groupes de travail, LVars, sessions, superviseurs), et une méthode de la bibliothèque standard coûte . # rce-version: 0.7 a la syntaxe et les règles de la 0.6 et ne diffère que par le coût des méthodes, . Les errata s’appliquent à chaque version. La version du module qui contient l’expression d’appel régit son coût : une fonction 0.6 sous with budget qui appelle une fonction 0.7 importée triant 8 éléments est facturée 24 de plus que le même appel vers une fonction 0.6 identique. Source : spécification 2.7, C.6.4 et C.15 ; extraits abrégés de spec/checker/tests/call_site_cost.rs. Une copie PNG est fournie. Open full size · PNG
Les budgets comptent le travail. Un bloc with budget facture à chaque opération un coût fixe tiré de la table de l’Annexe C.6.4 et déclenche le piège budget quand le compte est épuisé. Le compte est un indicateur du travail, pas une mesure du temps ni de l’énergie ; est_j est distinct.
| Opération | Coût |
|---|---|
| appel d’une fonction utilisateur ou d’une fermeture, | 4 |
| méthode de la bibliothèque standard sur un receveur de taille , premier argument de taille | 4 en version 0.6 ; en version 0.7 |
| envoi ou réception sur un canal | 8 |
spawn | 32 |
une branche de par ou un bloc de for ... par | 16 |
littéral de liste ou de dictionnaire, ou compréhension, avec résultats ; [x; n] | |
indexation, tranche, accès à un membre ; opérateurs unaires ; and, or ; opérateurs et comparaisons sur les entiers, les booléens et le texte | 1 |
+, -, * flottants | 2 |
/, % flottants | 8 |
Les tailles sont la longueur en octets UTF-8 d’un texte, la longueur d’une liste et le nombre d’entrées d’un dictionnaire ; toute autre valeur a une taille 0. Le travail de méthode est fixé par la classe de complexité de la méthode dans l’évaluateur de référence : pour les méthodes linéaires sur les textes, les listes et les dictionnaires (les dictionnaires sont des listes d’association ordonnées), pour sort (0 lorsque ), et 0 pour les autres méthodes. Les appels que map, filter et fold font à leur argument fonction sont facturés en plus comme des appels. L’arithmétique sature au plus grand entier sur 128 bits, et ne décroît jamais quand ou croît. L’évaluateur de référence et les environnements d’exécution émis en Rust, Python et JavaScript calculent la même fonction, et un test vérifie que le piège de budget tombe sur la même opération dans les quatre.
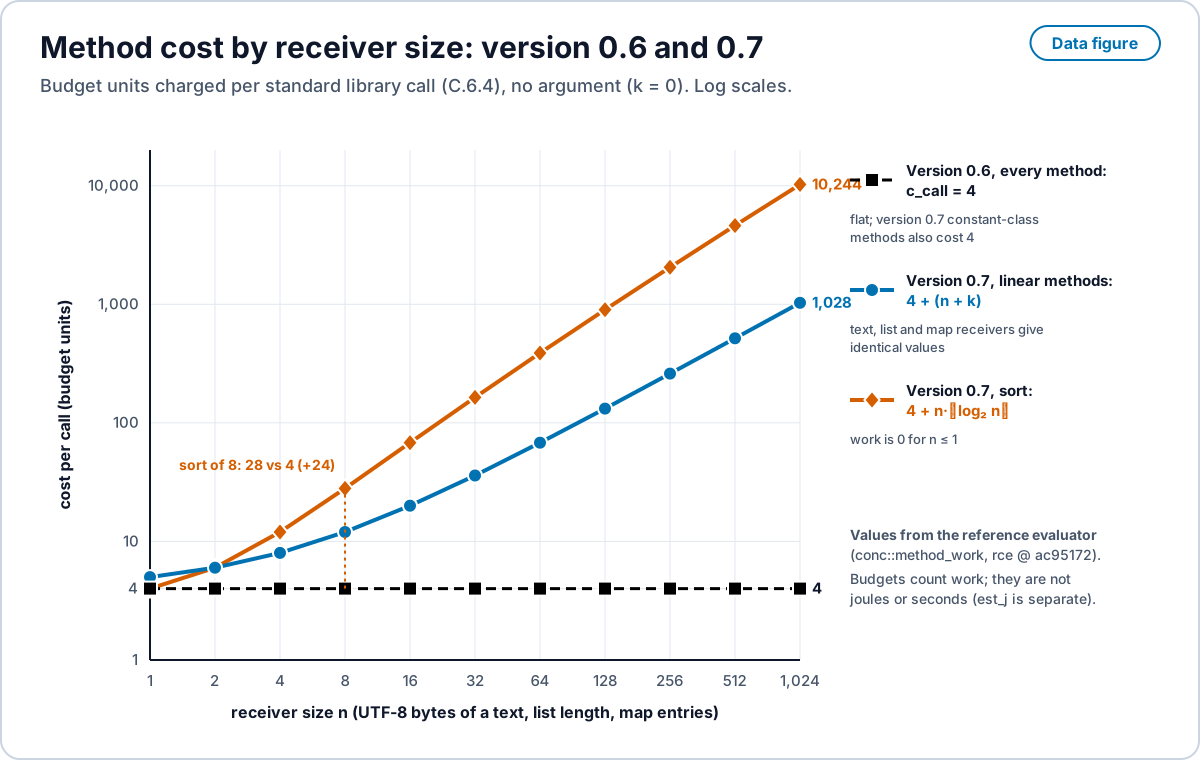
conc::method_work de l’évaluateur de référence (rce ac95172). Une copie PNG est fournie. Open full size · PNG
Quelle version régit un coût. Un programme peut réunir des modules de versions différentes. Le coût d’un appel de méthode est fixé par la version déclarée du module qui contient l’expression d’appel, y compris un appel à l’intérieur d’une fermeture écrite dans ce module, et non par la version de la fonction exécutée, de son appelant ou du premier module du programme. La règle est lexicale, donc lier des modules ne change aucun coût ; la spécification 2.7 énonce la même règle et renvoie à C.15. Des tests la vérifient à la frontière dans les deux sens, sur l’évaluateur de référence et sur les programmes émis en Rust, Python et JavaScript : une fonction 0.6 sous with budget qui appelle une fonction 0.7 importée triant une liste de 8 éléments est facturée 24 de plus que le même appel vers une fonction 0.6 identique.
Statut des théorèmes. La spécification énonce les théorèmes T1 à T34 et consigne exactement le statut de chacun. Les preuves sont en Lean 4 (v4.12.0, sans Mathlib) sur un calcul noyau. Les mots employés pour le niveau d’un résultat sont les suivants. Prouvé désigne une preuve Lean portant sur la sémantique noyau du langage. Prouvé sur une sémantique désigne une preuve Lean sur une sémantique à petits pas d’un noyau de RCE. Modèle désigne une preuve Lean sur un modèle abstrait qui n’est relié ni à la sémantique de RCE ni à l’évaluateur de référence. Vecteurs signifie que les résultats de l’évaluateur de référence sur des programmes générés sont vérifiés par rapport au modèle par le noyau de Lean, ce qui est une correspondance sur des échantillons, non une preuve sur l’évaluateur. Testé désigne des tests différentiels sur des entrées déclarées. Vérifié mécaniquement signifie décidé par un programme, comme un constructeur de tables LALR(1).
| Énoncé | Niveau | |
|---|---|---|
| T1 | déterminisme : un résultat par état et par événement ; un résultat par tic de la sémantique de concurrence | prouvé |
| T2 | totalité de , avec une borne explicite sur les pas d’évaluation ; récursion structurelle et composition des bornes le long du graphe d’appels | prouvé (le noyau d’expressions de Lean n’a pas d’appels de fonctions utilisateur ; la récursion et la composition sont prouvées sur des modèles séparés) |
| T3 | l’état d’exécution est et le rejeu reproduit chaque empreinte et chaque sortie | prouvé |
| T4 | progrès, y compris les tics (une tâche avance, ou l’exécution se termine ou signale Deadlock) | prouvé |
| T5 | préservation, y compris l’intervalle entier de chaque champ écrit | prouvé |
| T6 | sûreté mémoire, chemins d’emprunt complets, aucun partage mutable entre tâches | prouvé pour le noyau de possession et une sémantique instrumentée des chemins d’emprunt |
| T7 | indépendance vis-à-vis des noms des empreintes du journal, des identifiants et des choix de select | prouvé |
| T8 | atomicité : un événement refusé laisse l’état inchangé | prouvé |
| T9-F | les cibles de l’IR de la Forme (Rust, WASM, Python, XState, SCXML) impriment la trace de référence | testé |
| T9-L | les émetteurs de programmes (rust, python, js) concordent avec l’évaluateur de référence | prouvé pour l’émetteur Rust sur un noyau, comme traduction vérifiée vers MiniRust, un plongement profond du sous-ensemble de Rust émis ; que rustc implémente MiniRust est admis et testé ; les autres émetteurs testés |
| T10 | la grammaire est non ambiguë | vérifié mécaniquement (LALR(1), 0 conflit, pour les deux versions) et échantillonné par un fuzzer |
| T11 | équité de select | prouvé sur le modèle de rotation |
| T12 | une poignée linéaire est consommée exactement une fois sur chaque chemin | prouvé sur un modèle d’instructions |
| T13 | les opérations f32 donnent les mêmes bits sur des cibles qui s’accordent sur IEEE 754 | prouvé pour la multiplication ; pour l’addition, la soustraction et la division, la propriété d’arrondi unique est le théorème de Figueroa, cité et non mécanisé |
| T14 | l’arithmétique u64 vérifiée est exacte dans l’intervalle | prouvé |
| T15 | les itérateurs se terminent, respectent la limite de boucle et sont cohérents par préfixe | prouvé |
| T16 à T31 | concurrence de la version 0.6 : déterminisme de par, commutation, réductions, absence d’interblocage, échéances, groupes de travail, horloges vectorielles, priorités, portées, acteurs, sessions, LVars, lots atomiques, répliques | prouvé sur une sémantique : T16, T17, T19a, T20, T23 ; prouvé sur un modèle d’exécutions : T24 ; prouvé sur un calcul de sessions : T28 ; modèle : T18, T19b, T21, T22, T25, T26, T31 ; modèle avec vecteurs : T27, T29, T30. Aucun n’est une preuve sur l’évaluateur de référence en Rust |
| T32 | rejeu étranger : pour tout oracle, le rejeu du journal est égal à l’exécution en direct, et un contrat de réponse est satisfait par chaque réponse journalisée | prouvé |
| T33 | restauration de &mut en cas d’échec (F.4.4) : un appel en échec laisse l’état &mut de l’appelant tel qu’il était au moment de l’appel ; un appel qui retourne recopie en sortie (l’ancienne règle de recopie en sortie quel que soit le résultat est retirée) | prouvé |
| T34 | la passe ANF qui préserve l’ordre avant chaque émetteur donne la même valeur, le même stockage et la même trace de facturations et d’émissions | prouvé pour un fragment noyau avec ANF complète ; l’implémentation est testée de manière différentielle sur chaque cible, y compris un balayage de budgets autour du point de piège |
T9 a deux ensembles de cibles parce que le moteur de l’article et le langage ont deux compilateurs. T9-F est l’affirmation sur rce form --emit, que mesure le §5.1. T9-L est l’affirmation sur les émetteurs de programmes du langage. Une cible hors de ces ensembles n’a pas d’affirmation T9.
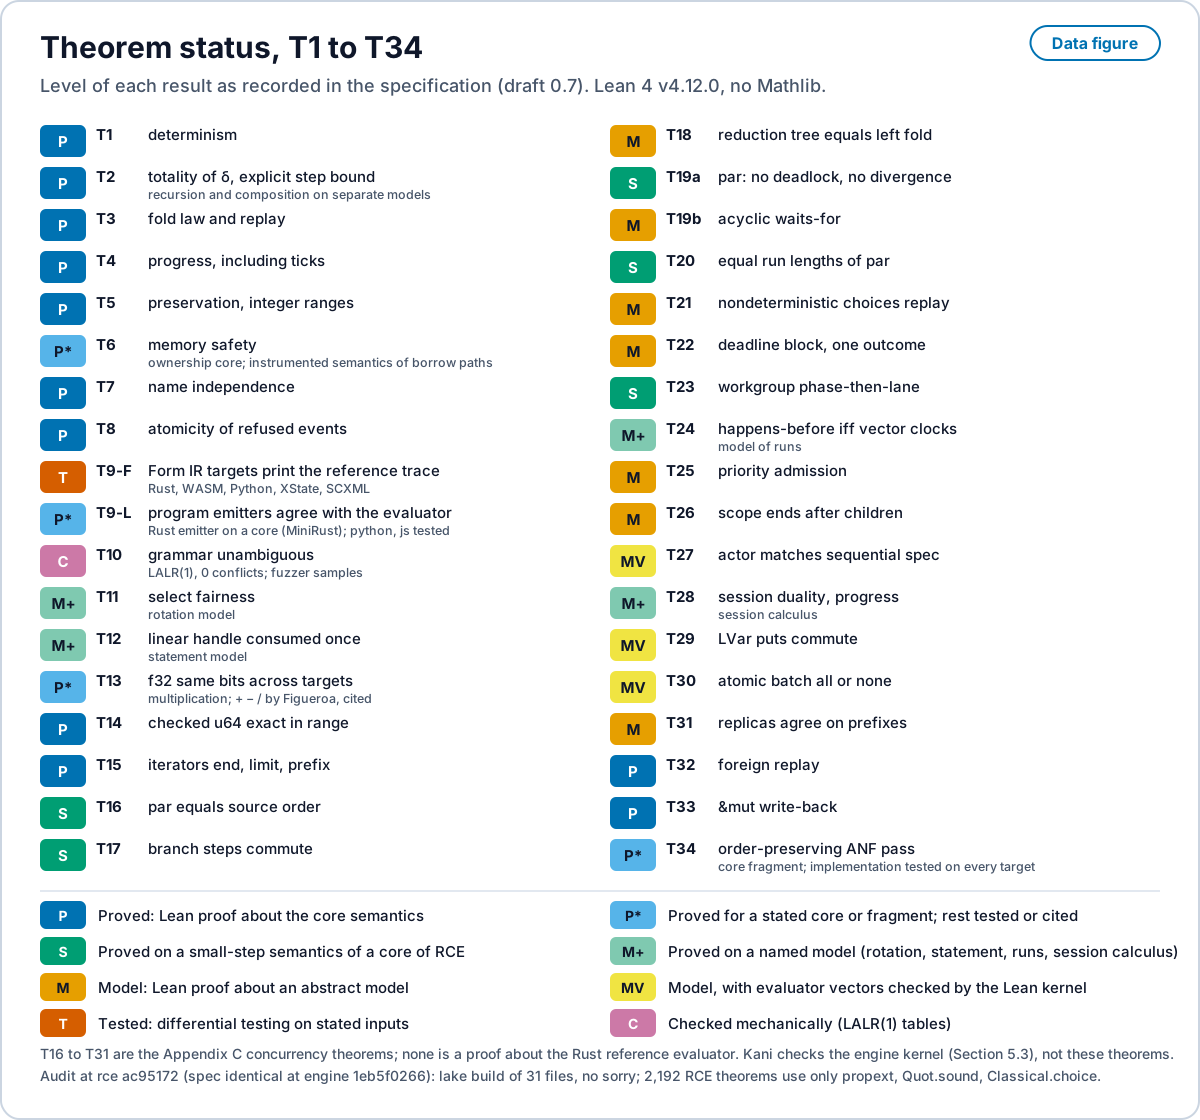
P : preuve Lean sur la sémantique noyau. P* : prouvé pour un noyau ou un fragment déclaré, le reste testé ou cité. S : prouvé sur une sémantique à petits pas d’un noyau de RCE. M+ : prouvé sur un modèle nommé (modèle de rotation, modèle d’instructions, modèle d’exécutions, calcul de sessions). M : preuve Lean sur un modèle abstrait. MV : modèle, avec vecteurs de l’évaluateur de référence vérifiés par le noyau de Lean. T : tests différentiels. C : vérifié mécaniquement. T16 à T31 relèvent de la version 0.6, et aucun n’est une preuve sur l’évaluateur de référence en Rust. Lean 4 v4.12.0, sans Mathlib. Source : spec/book/10-theorems.md et Annexe C.13. Une copie PNG est fournie. Open full size · PNG
Vérifications exécutées pour cette version. Au commit du moteur 1eb5f02, lake build s’achève sur les 31 fichiers de spec/lean/RCE/ sans aucun sorry (46 fichiers au 4304048 public, 58 à e416fd0), et l’audit permanent indique que les axiomes de 2,192 constantes de théorème (l’audit compte chaque constante de théorème du noyau ; voir la note de corrections ci-dessus) sont uniquement propext, Quot.sound et Classical.choice. Kani vérifie 10 harnais du noyau sur 10 (§5.3). Les tests du moteur (cargo test --release) réussissent 589 tests distincts avec 0 échec (2 ignorés) ; make check en indique 596 parce que son étape de preuve exécute 7 de ces tests une seconde fois. Le vérificateur de référence, construit à partir du dépôt public comme le construit son intégration continue, réussit 56 tests dans la construction par défaut et 112 avec les suites des versions 0.6 et 0.7 activées, avec 0 échec, et 57 avec le test d’accord avec tree-sitter. La vérification de la spécification construit les tables LALR(1) de la version 0.5 et des versions 0.6 et 0.7, qui partagent une grammaire, avec 0 conflit, et analyse chaque exemple avec trois analyseurs, et la construction WebAssembly du vérificateur réussit 401 vérifications sur 401 sur les corpus d’exemples.
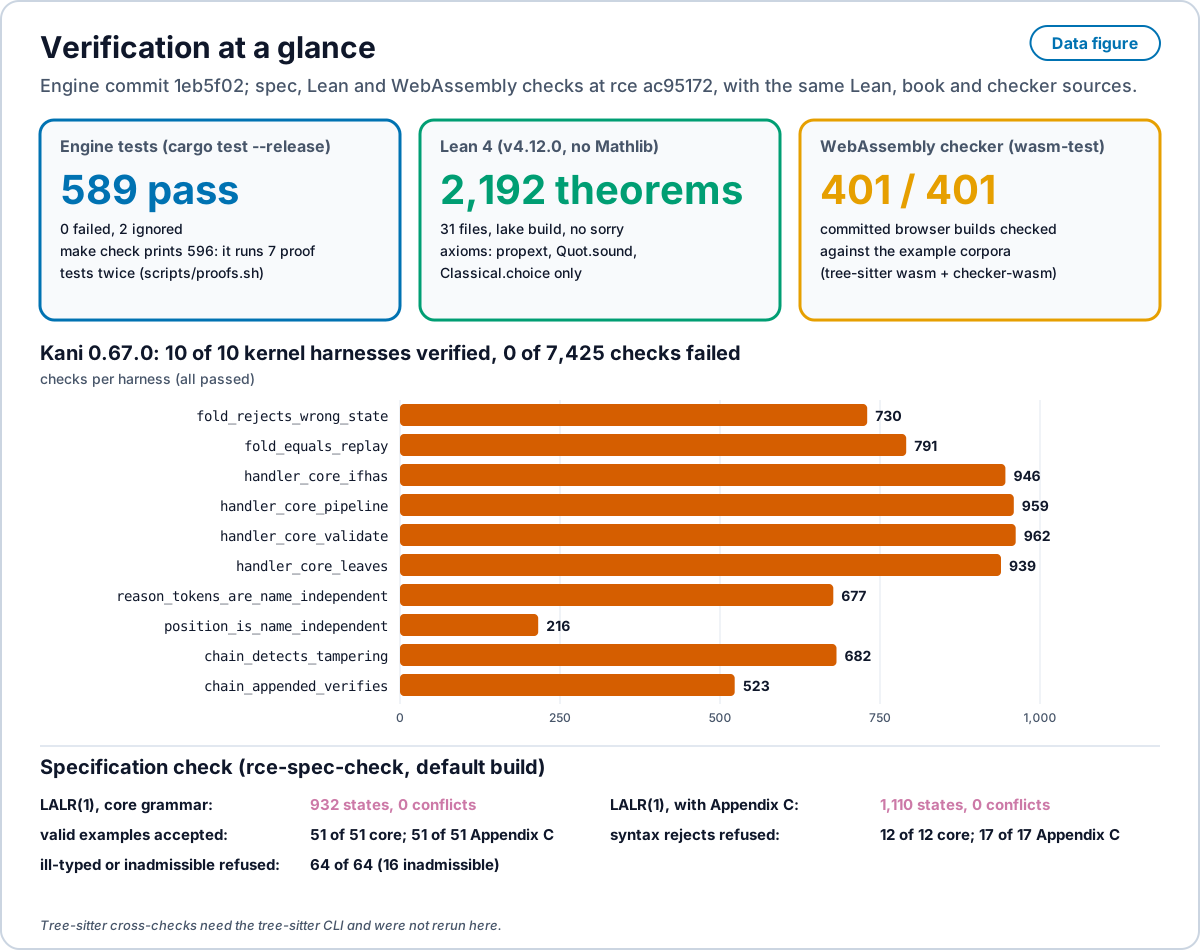
1eb5f02. Figure de données. Tests du moteur (cargo test --release) : 589 réussis, 0 échec, 2 ignorés ; make check en indique 596 parce qu’il exécute 7 tests de preuve deux fois. Lean 4 : lake build sur les 31 fichiers de spec/lean/RCE/ sans aucun sorry ; l’audit indique 2,192 constantes de théorème (décompte de l’audit, pas déclarations de la source) dont les axiomes sont uniquement propext, Quot.sound et Classical.choice. Kani 0.67.0 vérifie 10 harnais du noyau sur 10 avec 0 échec sur 7,425 vérifications (barres : vérifications par harnais). La construction WebAssembly du vérificateur réussit 401 vérifications sur 401 sur les corpus d’exemples. La vérification de la spécification construit des tables LALR(1) avec 0 conflit pour la version 0.5 (932 états) et pour les versions 0.6 et 0.7 (1,110 états), accepte 51 exemples valides sur 51 et refuse 12 rejets syntaxiques sur 12 et 64 programmes mal typés ou inadmissibles sur 64. Les vérifications Lean, WebAssembly et de la spécification ont été exécutées sur le dépôt public à ac95172, dont les sources de spécification sont identiques à celles du moteur. Une copie PNG est fournie. Open full size · PNG
Une observation de convergence. Le catalogue de agentlanguages.dev, lu le 13 octobre 2026, recense 42 langages conçus pour que des agents d’IA écrivent du code, regroupés par ses éditeurs en un camp syntaxique, un camp de la vérification et un camp de l’orchestration. Plusieurs choix de conception de cet article, comme les contrats vérifiés mécaniquement, les journaux chaînés par empreintes, le rejeu déterministe et une forme canonique par programme, apparaissent dans ses descriptions d’autres projets développés indépendamment. C’est une observation que ces choix reviennent. Ce n’est pas une preuve qu’ils sont corrects, et cet article ne fait aucune comparaison avec ces projets.
4. Le moteur : engrenages, porte et reçus
4.1 Le moteur est une Forme
RCE exécute le logiciel comme un graphe de petits gestionnaires déterministes. Un gestionnaire qui ne peut pas décider lève une escalade. Un résolveur répond une fois à l’escalade, et la réponse est installée comme gestionnaire permanent, de sorte que le cas suivant de même forme s’exécute sans résolveur. Le moteur satisfait chaque invariant de la Forme, chacun vérifié par un test nommé dans tests/form_laws.rs :
| Invariant | Ce que fait le moteur |
|---|---|
| Le rechargement est un repli vérifié | Le rechargement lit le journal tel quel, recalcule chaque empreinte et chaque lien, et replie le reste avec . Rien n’est réhorodaté. Une chaîne rompue refuse de se charger. |
| Ordre des tics sans noms | Les gestionnaires s’exécutent dans l’ordre de rang topologique, puis selon une clé de nœud sans nom. Les sorties sont mises en attente et livrées après l’exécution de tous les gestionnaires, comme dans la sémantique ASM. Renommer tous les nœuds donne la même empreinte d’état anonyme à chaque entrée. |
| Aucune perte silencieuse | Une boîte aux lettres pleine garde le message dans une file ordonnée et journalise Backpressure. Avec une capacité de 1 et 10 tâches, 9 entrées Backpressure sont journalisées et les 10 tâches se closent. |
| Les charges utiles sont dans le journal | Entrées, tics, résultats de gestionnaires externes, installations et fautes sont des entrées du journal. L’empreinte d’état après chaque entrée correspond à un repli depuis un moteur vide, sur 1,000 journaux aléatoires. |
| Horloge logique | La vivacité compte des tics, pas du temps mural. |
| Empreintes stables | SHA-256 (Secure Hash Algorithm, 256 bits) sur du JSON canonique, clés triées à chaque niveau, pour les entrées, états, formes et identifiants de règles. |
4.2 Les engrenages
Chaque engrenage n’est essayé que lorsque l’engrenage inférieur ne franchit pas la porte. Cet ordre est une cascade fixe.
| Engrenage | Méthode | Filiation |
|---|---|---|
| G0 Recherche | Une bibliothèque partagée de gestionnaires indexée par l’empreinte SHA-256 de la forme ; pour la réparation de code, localisation sur des fonctions classées | Recherche et récupération de code [21] |
| G1 Règles | Modèles de réparation déterministes et gardés et validateurs dérivés de schémas, chacun vérifié pour sa sensibilité aux mutations | PAR, TBar, AVATAR, FixMiner [22, 23, 24, 25] ; codemods comme Coccinelle [26] |
| G2 Synthèse | Énumération sur la grammaire des gestionnaires, solveurs et e-graphes | Sketching, SyGuS, egg [27, 9, 12] |
| G3 à G5 Modèles | Un modèle de décision typé, un petit modèle local, puis un modèle distant, en dernier | Cascades de modèles [28] |
4.3 La porte
Un candidat n’est promu que s’il franchit la porte. La porte rejoue les entrées enregistrées du nœud, exécute le candidat en ombre sur des échantillons frais avec une borne de couverture (la règle de trois à un budget d’erreur déclaré), vérifie le schéma de sortie et exige le certificat de preuve de la Section 5. Un candidat rejeté est journalisé avec son contre-exemple.
4.4 Reçus
Chaque promotion, refus, report et installation est une mutation dans un journal en ajout seul chaîné par SHA-256, de sorte que falsifier une entrée passée rompt la chaîne [29, 30]. Le coût de chaque gestionnaire est évalué à partir des comptes d’opérations de l’interprète avec la table de coûts de l’hôte de FGIR, le backend de code natif de flowG, et étiqueté est_j. Chaque appel au contremaître porte son reçu. Un reçu nomme l’engrenage, la méthode de l’estimation (basis), les candidats essayés et si l’engrenage a résolu l’escalade. Son champ est_j est obligatoire : c’est un nombre fini non négatif, ou null, et null n’est permis que lorsque basis indique unpriced, comme pour un appel de modèle sans chiffre d’énergie. Un reçu dont le champ manque est rejeté à l’analyse. Un coût non tarifé n’est jamais lu comme zéro, de sorte qu’un total sur des reçus rapporte séparément ses invocations tarifées et non tarifées, et qu’une économie qui dépend d’une résolution non tarifée est rapportée comme inconnue. Les exécutions de l’échelle ajoutent un compteur d’énergie du boîtier sur un sous-échantillon, étiqueté reported_j.
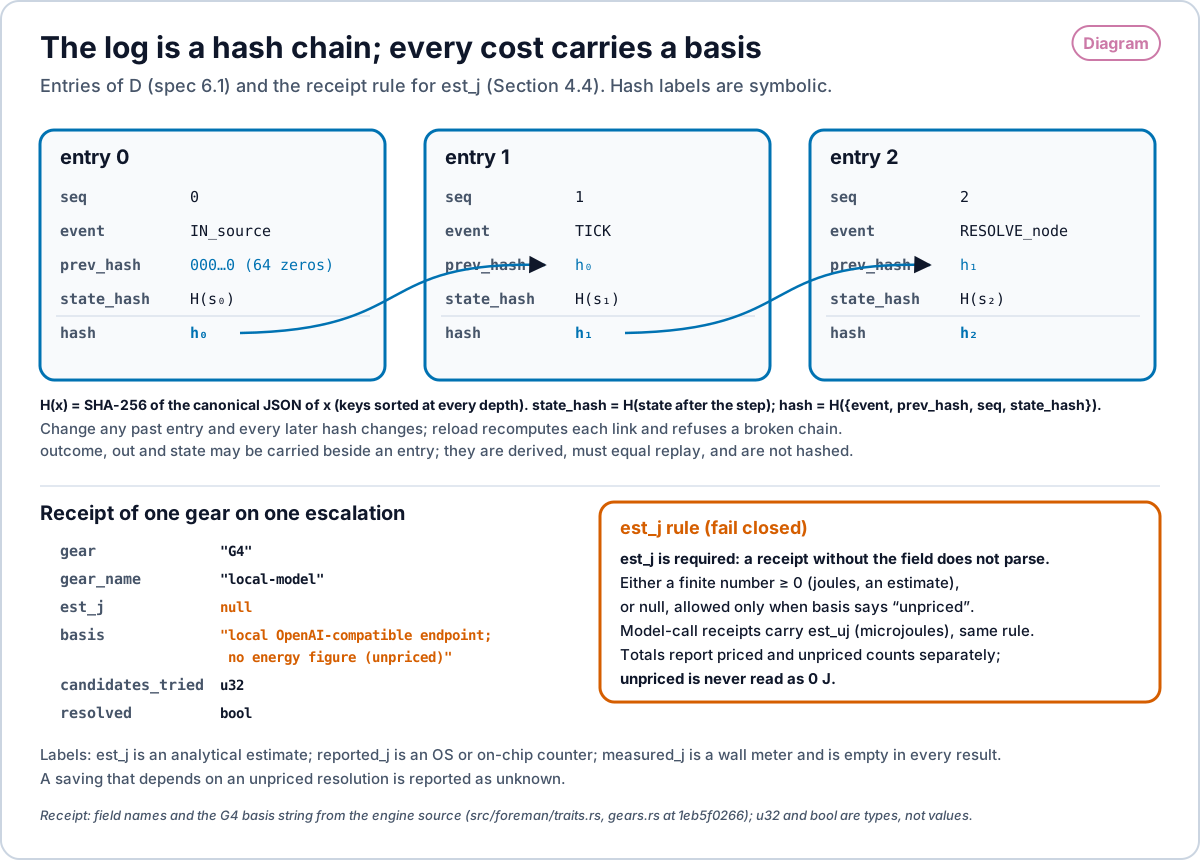
{seq, event, prev_hash, state_hash, hash}. state_hash est le SHA-256 du JSON canonique de l’état après le pas ; hash est le SHA-256 du JSON canonique de {event, prev_hash, seq, state_hash} ; le premier prev_hash vaut 64 zéros, de sorte que modifier une entrée passée modifie chaque empreinte ultérieure. Un reçu d’engrenage porte gear, gear_name, est_j, basis, candidates_tried et resolved. est_j est obligatoire et est un nombre fini non négatif, ou null seulement lorsque basis indique unpriced ; les reçus d’appels de modèle portent est_uj en microjoules selon la même règle. Un coût non tarifé n’est jamais lu comme 0 J. Les étiquettes d’empreinte sont symboliques. Source : spécification 6.1 et Section 4.4. Une copie PNG est fournie. Open full size · PNG
4.5 Le compilateur de la Forme
rce form prend une spécification et son ajustement et émet cinq cibles à partir d’une IR de la Forme :
.rce spec + fit
  lower ─► normalize ─► egg e-graph, equality saturation (+ admitted proposals)
  ─► extract (cost = est_j) ─► Form IR (typed relations, regions, rules with SHA-256 ids)
     ├─ Rust crate (pure step, typed state, SHA-256 log and fold, tests)
     │  └─ WASM (the same crate on wasm32-wasip1)
     ├─ Python (standard library only)
     ├─ XState v5 machine
     └─ SCXML document, executed by SCION
L’IR fixe un comportement à chaque bord numérique : le dépassement vérifié des entiers 64 bits est une erreur et ne boucle jamais ; la / entière tronque vers zéro () ; % prend le signe du dividende () ; la division par zéro est une erreur ; les flottants sont IEEE 754 binary64 et un résultat non fini est une erreur ; null et absent sont distincts ; le temps est uniquement l’horloge logique. Chaque cible est générée. Aucune n’est écrite à la main.
Un gestionnaire de processus, HTTP ou fermeture n’a pas de terme, si bien que ses résultats journalisés se compilent en un oracle enregistré indexé par le SHA-256 de l’entrée canonique. rce scan DIR --form élève du Rust, du Python, du TypeScript et du Go existants vers le schéma de la Forme, et chaque élément élevé est étiqueté comme élévation syntaxique.
4.6 Méthode : toute la pile évaluée, chaque hypothèse d’interface explicite
Un programme est une pile de niveaux : tokens et instructions ; gestionnaires ; la Forme, une unique fonction de pas sur (régions de contrôle ; données : l’horloge, le compteur d’entrées et les relations typées) ; le journal, une chaîne d’empreintes SHA-256 dont les entrées enregistrent chaque événement, l’empreinte de l’état qu’il a produit et l’empreinte de l’entrée précédente ; les réécritures qui transforment la Forme ; et le substrat qui l’exécute. Chaque niveau repose sur des hypothèses au sujet du niveau inférieur. RCE ne traite aucun niveau comme fixe. Il évalue toute la pile, écrit chaque hypothèse d’interface comme un énoncé vérifiable et la vérifie à chaque exécution.
| Frontière | Hypothèse | Vérification |
|---|---|---|
| source vers gestionnaire | une entrée satisfait son contrat de source | la vérification du contrat à l’événement d’entrée de δ |
| gestionnaire vers puits | toute sortie Ok satisfait le schéma de sortie | preuve du gestionnaire (verify::handler_proof), totale et déterministe par l’évaluateur du noyau vérifié par Kani |
| journal vers état | chaque entrée porte le hachage de l’état qu’elle a produit | repli du noyau, qui refuse la première entrée dont le hachage ne correspond pas (harnais Kani fold_rejects_wrong_state) |
| réécriture vers Forme | une réécriture préserve la sortie pour toute entrée | vérification aléatoire, puis une preuve SMT avec Z3 |
| stub vers contremaître | un gestionnaire qui ne peut pas décider escalade au lieu de deviner | les gestionnaires stub émettent des escalades ; les résolutions ne sont promues que par la voie de promotion |
| Forme vers cible | toute cible émise calcule la même δ | toute cible porte la même trace de référence |
Une vérification qui échoue localise la rupture à la frontière où elle se produit. La correction est faite à ce niveau, passée par la vérification de cette frontière, puis promue. Chaque niveau au-dessus du niveau corrigé hérite de la correction sans autre changement, car chaque niveau supérieur ne consomme le niveau corrigé qu’à travers l’interface dont l’hypothèse est désormais vérifiée. C’est en ce sens que les corrections remontent et se cumulent. La démo du moteur de RCE l’exécute dans le navigateur sur le cœur de RCE compilé en WebAssembly : sa couche Interfaces rompt chaque hypothèse et montre la vérification qui la détecte, et sa couche Compounding montre la correction qui se propage à chaque tour ultérieur.
5. Vérification
5.1 Tests différentiels sur cinq cibles
tests/form_targets.rs pilote une spécification arithmétique à onze opérateurs avec 29 événements de bord plus 500 valeurs de bord aléatoires avec graine. Les cibles générées en Rust, Python, WASM, XState et SCXML impriment la trace de référence octet par octet, y compris les bords arithmétiques. C’est du test différentiel dans la lignée de McKeeman et de Csmith [86] : l’accord entre implémentations indépendantes sur un ensemble d’entrées déclaré. Ce n’est ni de la validation de traduction [85] ni un compilateur vérifié. Il couvre les onze opérateurs et les 529 événements du test, et ne dit rien des entrées hors de ceux-ci. Les résultats Z3 et Kani ci-dessous sont la vérification.
La Figure 11 montre les cinq projections d’une Forme et l’aller-retour des deux cibles en diagramme d’états.
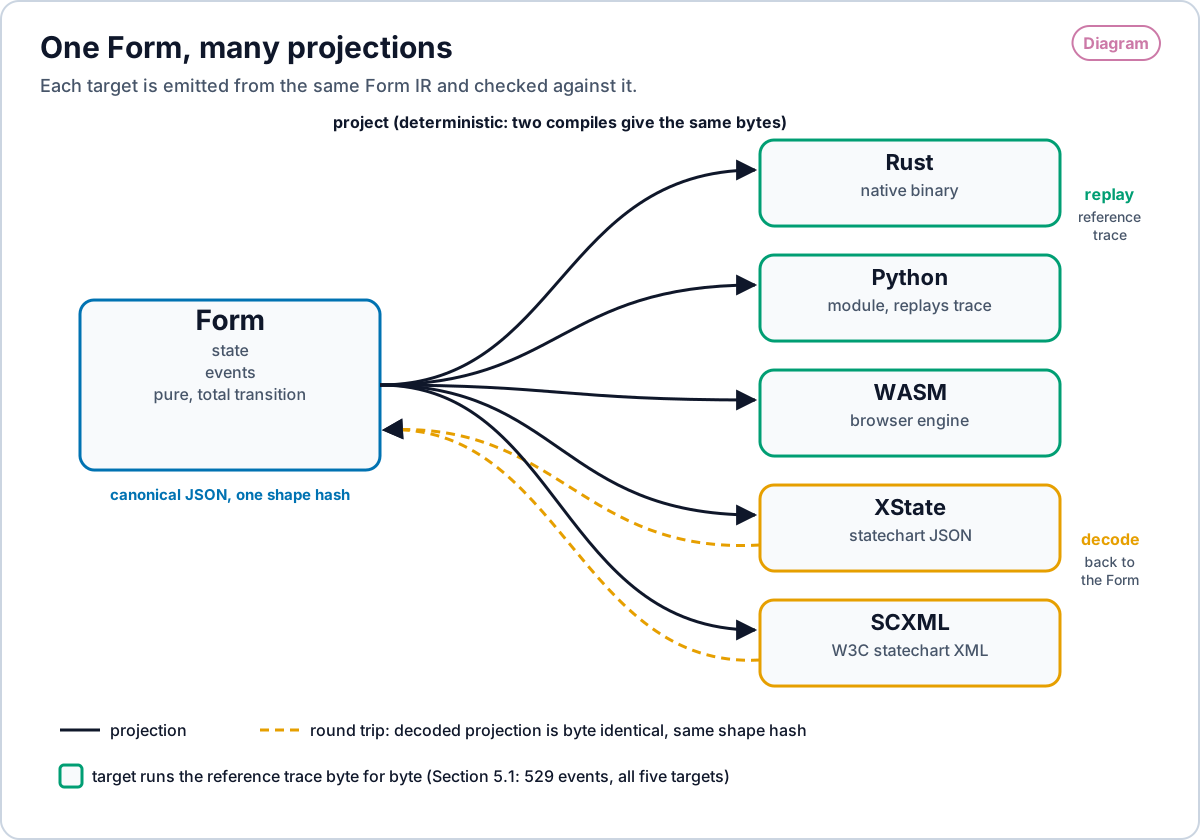
tests/form_targets.rs. Une copie PNG est fournie. Open full size · PNG
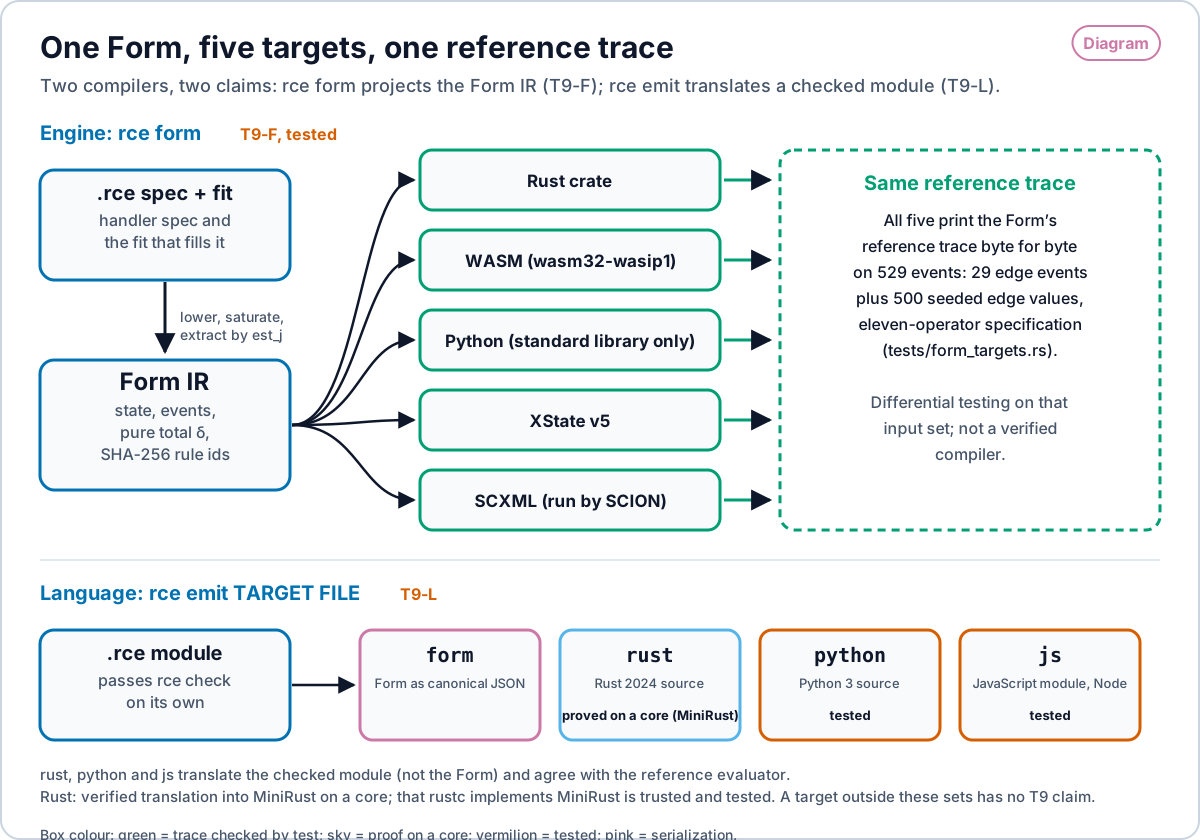
rce form abaisse une spécification de gestionnaire et son ajustement vers l’IR de la Forme et la projette vers une crate Rust, WASM, Python, XState v5 et SCXML ; les cinq impriment la trace de référence octet par octet sur 529 événements (29 événements de bord plus 500 valeurs de bord avec graine d’une spécification à onze opérateurs, tests/form_targets.rs). C’est T9-F, établi par des tests différentiels, pas un compilateur vérifié. En bas : rce emit TARGET FILE traduit un module vérifié (pas la Forme) en JSON form, rust, python ou js ; T9-L est prouvé pour l’émetteur Rust sur un noyau comme traduction vérifiée vers MiniRust (que rustc implémente MiniRust est admis et testé), et testé pour les autres. Une copie PNG est fournie. Open full size · PNG
5.2 Réécritures prouvées dans Z3
Les règles de réécriture vérifiées ont une filiation. Ruler infère et vérifie des règles de réécriture par saturation d’égalités sans modèle dans la boucle [87]. Les 3 règles sur 16 proposées par le modèle et admises en Section 5.5 sont donc un énoncé sur la porte, qui en a refusé 13, et non une affirmation qu’un modèle serait la meilleure source de règles.
Chaque réécriture intégrée de l’e-graphe est prouvée dans le solveur SMT Z3 (satisfiabilité modulo théories) [31] contre un encodage sans quantificateurs de l’évaluation des termes et de l’arithmétique de la Forme : valeurs comme type de données, vecteurs de bits de 64 bits avec dépassement vérifié, division et reste signés prenant le signe du dividende, et flottants binary64. Une réécriture qui modifie le dépassement, l’ordre d’escalade ou un message n’obtient pas de preuve. Une équivalence proposée n’entre dans l’e-graphe qu’avec une preuve.
5.3 Preuves Kani du noyau
Le noyau du moteur (chaîne d’empreintes, repli, positions sans noms et évaluation des gestionnaires) est vérifié avec le vérificateur de modèles Kani pour Rust [32]. L’évaluation des gestionnaires est le point fixe d’un pas non récursif, et Kani prouve que ce pas est total et déterministe pour chaque constructeur, par induction structurelle. Dix harnais sont vérifiés avec Kani 0.67.0, avec 0 échec sur 7,425 vérifications :
| Harnais | Propriété |
|---|---|
chain_appended_verifies | Une chaîne d’empreintes étendue se vérifie |
chain_detects_tampering | Une entrée modifiée rompt la chaîne |
fold_equals_replay | Le repli est égal au rejeu |
fold_rejects_wrong_state | Un repli en désaccord avec l’état stocké est refusé |
position_is_name_independent | Les positions des règles ne dépendent pas des noms des nœuds |
reason_tokens_are_name_independent | Les motifs sont indépendants des noms, par tokens entiers |
handler_core_leaves | Les gestionnaires feuilles sont totaux et déterministes |
handler_core_validate | La validation est totale et déterministe |
handler_core_pipeline | Les pipelines sont totaux et déterministes |
handler_core_ifhas | Les gardes sont totales et déterministes |
5.4 Porte de promotion sur le certificat de preuve
L’exécution Kani écrit un certificat dont l’empreinte est stockée dans proofs/kani.cert. Le moteur, le journal, les identifiants de règles et l’évaluation des gestionnaires passent par le noyau prouvé, et la promotion exige le certificat.
5.5 Le modèle comme proposant derrière la vérification
Un modèle peut proposer des équivalences. Il ne peut pas les admettre. Avec un modèle local de programmation de 1.5 milliard de paramètres (Qwen2.5-Coder-1.5B sous llama.cpp) sur la spécification de démonstration, le proposant a offert 16 équivalences. La vérification en a admis 3, par essais aléatoires et une preuve Z3, et en a rejeté 13. Un proposant déterministe de 87 identités familières, 77 arithmétiques et 10 structurelles, en a fait admettre 9, toutes structurelles, et rejeter 78 : chaque identité arithmétique, pour l’ordre des fautes, des non-nombres ou un dépassement, et une réécriture structurelle, const-absorbs-pipe, qui supprimerait un préfixe qui escalade (test du moteur tests/form_proposers.rs).
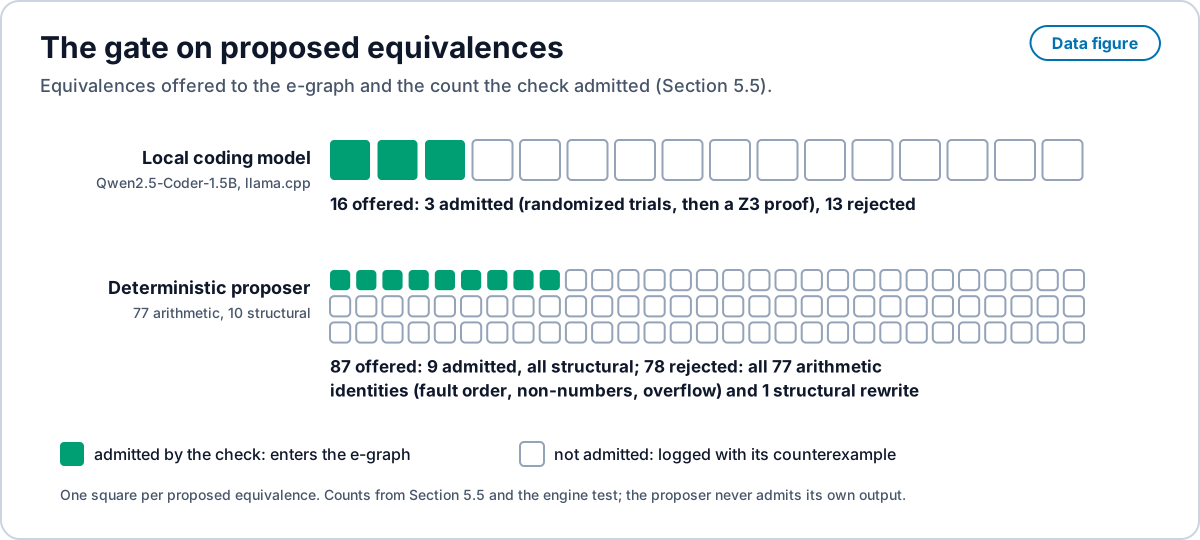
tests/form_proposers.rs. Une copie PNG est fournie. Open full size · PNG
5.6 Accord avec le code existant
L’élévation lit la même machine de commande à partir de fixtures Rust, Python, TypeScript et Go, exécute le code d’origine sur 40 séquences avec graine de 30 appels, et s’accorde sur les 1,200 appels par langage. Un banc d’essai figé, préenregistré avant tout résultat, a réexprimé trois programmes existants de prospection commerciale sous forme de Formes. Les Formes s’accordent avec le code d’origine sur 4,500 des 4,500 entrées enregistrées, et l’extraction abaisse est_j sur chacune (par exemple de J à J).
6. Élévation : entrer dans l’écosystème depuis d’autres langages
L’élévation est la porte d’entrée de l’écosystème pour le code écrit ailleurs. C’est une construction, réalisée par langage avec des outils que tout langage possède déjà : une grammaire formelle, un analyseur tel que tree-sitter qui produit l’arbre syntaxique, l’arbre de syntaxe abstraite et les symboles que résolvent les outils de serveur de langage (Language Server Protocol). rce scan DIR --form construit la Forme à partir de cet arbre pour Rust, Python, TypeScript et Go (§4.5, §5.6). Un programme élevé porte les fautes de sa source, si bien que l’élévation inclut la réparation, mesurée ci-dessous sur des corpus publics de bogues avec l’emplacement donné. Dans l’écosystème, ces fautes ne peuvent pas être écrites.
6.0 L’échelle de réparation sur le code élevé
Une tâche de programmation est mesurée ici par les bits d’intention dont elle a besoin : les bits à fournir de l’extérieur de ce que le moteur détient déjà (le programme autour de la modification, les bibliothèques, les tests, l’index des corrections connues). En notant les bits qui déterminent l’artefact cible et les bits que le corpus fixe déjà, les bits fournis sont . Un engrenage qui classe la bonne modification au rang parmi ses candidats a fourni bits de recherche, et la porte fournit le reste. L’échelle ordonne les tâches par taille de modification, indicateur objectif de : un token (L0), une instruction (L1), un bloc (L2), plusieurs blocs dans un fichier (L3), plusieurs fichiers (L4), une fonction à partir d’une spécification ou de tests (L5), une modification au niveau d’un ticket (L6) et un programme à partir d’une spécification (L7). Les échelons, corpus, partitions et hypothèses ont été préenregistrés avant les exécutions complètes ; les fichiers sont dans le dépôt public.
| Échelon | Corpus de test réservé | N | Résolues | Taux | IC de Wilson à 95% | Médiane des bits de recherche | Appels de modèle |
|---|---|---|---|---|---|---|---|
| L0 un token | Mutants de type PIT [109] de 9 dépôts réels à des commits fixés (Java : commons-math, commons-collections, jsoup, joda-time, gson ; Python : click, attrs, pydantic, sympy) | 520,821 | 520,541 | 0.9995 | 0.9994 à 0.9995 | 2.3 | 0 |
| L0 un token, dépôts jamais utilisés pour le réglage | commons-text, commons-io, more-itertools, httpx | 23,015 | 23,015 | 1.0000 | 0.9998 à 1.0000 | 2.0 | 0 |
| L1 une instruction, Java | Corrections à bloc unique de ManySStuBs4J 2.0 [107] | 24,072 | 9,288 | 0.386 | 0.380 à 0.392 | 3.5 | 0 |
| L1 une instruction, Java, fichier entier | ManySStuBs4J 2.0 [107], fichier du commit parent avec les index des méthodes et des gardes du projet | 21,320 | 13,586 | 0.637 | 0.631 à 0.644 | 4.8 | 0 |
| L1 une instruction, Python | TSSB-3M v1.0.0, fragments 14 et 15 [108] | 157,089 | 27,266 | 0.174 | 0.172 à 0.175 | 4.8 | 0 |
La Figure 14 représente les lignes du tableau avec leurs intervalles.
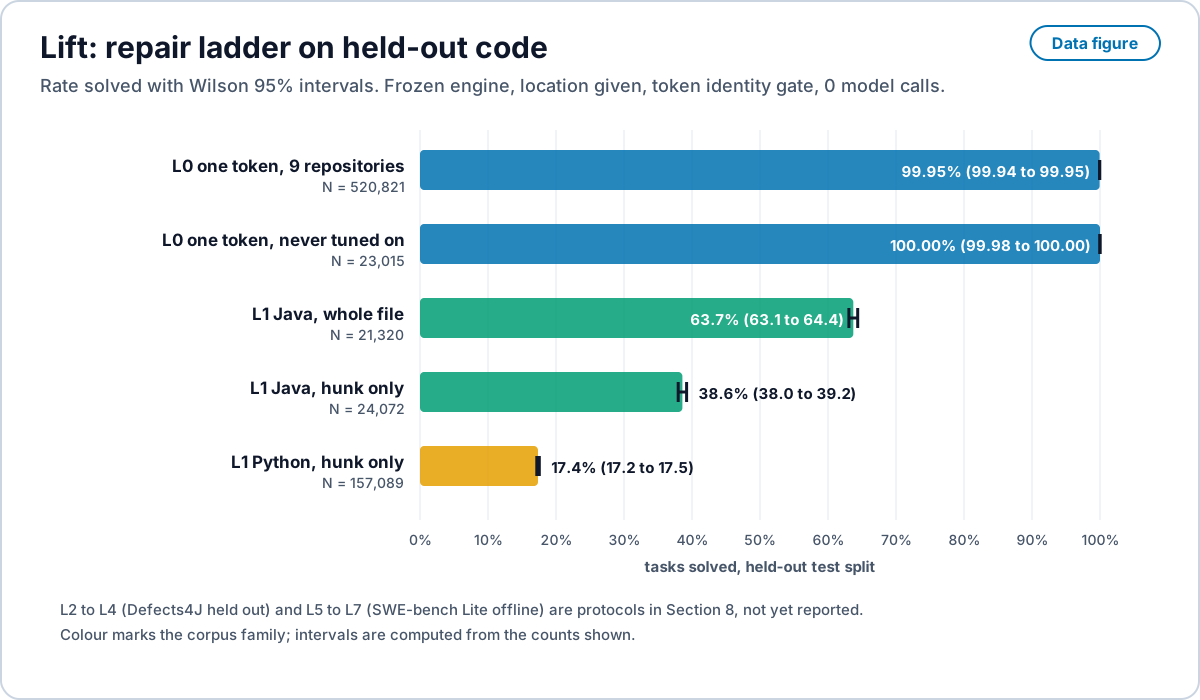
bench/ladder. Une copie PNG est fournie. Open full size · PNG
L2 à L4 sont mesurés sur l’ensemble réservé Defects4J de 288 bogues (Section 8.1). L5 à L7 suivent les protocoles de la Section 8.2. La méthode, la porte et l’énergie de chaque ligne suivent.
Question ouverte : ligne de base pour le taux à un token. Les lignes L0 mesurent la fréquence à laquelle un voisinage à un token ordonné par un a priori restaure un mutant à un token. Si le voisinage est construit à partir des mêmes tables d’opérateurs que celles qui ont produit les mutants, un taux élevé reflète en partie ce recouvrement et non la capacité à réparer des fautes qui surviennent en pratique. L’article cite ce risque de couplage et ne donne aucun chiffre pour lui. Une simple recherche par inversion d’opérateurs, exécutée sur les mêmes mutants, est la ligne de base qui montrerait quelle part du taux elle explique. Cette ligne de base n’a pas été exécutée, si bien qu’aucun chiffre n’est donné ici et que le taux à un token reste exposé à cette objection.
Les taux se lisent comme des bits d’intention. En L0, les bits manquants sont presque tous sur la ligne, et un voisinage à un token ordonné par un a priori les fournit avec une médiane de 2.3 bits. Sur la ligne L1 à bloc seul, le moteur ne voit que le bloc de 7 lignes. Il clôt les catégories dont les bits sont dans le bloc (Java : opérateur changé 91%, littéral booléen inversé 84%, arguments permutés 82% ; Python : littéral booléen changé 98.8%, arguments permutés 99.4%) et laisse ouvertes celles dont les bits sont hors du bloc : les noms de méthodes (22%) et les identifiants (37%) exigent le fichier et ses types, et les nouvelles conjonctions (3% à 7%) et les réécritures d’instructions entières (Python, 1.2% d’une catégorie qui représente 34% du corpus) sont une intention nouvelle. L’intention nouvelle est ce qu’un fournisseur (une spécification, un test, une personne ou un modèle local) apporte une fois, après quoi l’ajustement est dans l’index.
Méthode. Chaque corpus est mélangé avec une graine fixe. Les 2,000 premières positions de chaque mélange, et pour L0 trois dépôts entiers (commons-lang, requests, flask), forment la partition de développement, sur laquelle les engrenages peuvent être réglés ; les résultats de développement ne sont pas rapportés. Toute tâche restante est dans la partition de test. Avant une exécution de test, le moteur est validé dans le dépôt et son empreinte binaire enregistrée, et aucun engrenage ne change pendant l’exécution. Chaque ligne de cette section est un résultat à moteur figé sur les seules tâches de test, avec 0 appel de modèle. Le préenregistrement (PREREG.json), les lignes par tâche et le script de rapport sont dans le dépôt public.
Porte. En L0 et L1, l’emplacement est donné et la porte est l’identité des tokens : la ligne ou l’instruction réparée doit être égale à celle du développeur, token pour token. C’est plus strict que de réussir les tests, car un correctif peut réussir une suite de tests faible et rester faux. Qi et ses collègues ont trouvé que la plupart des correctifs que GenProg annonçait comme corrections étaient plausibles mais incorrects [92] ; le surajustement aux tests est documenté dans la réparation par recherche et par sémantique [93, 94] et traité par des tests générés [95] ; les outils obtiennent de meilleurs scores sur le banc sur lequel ils ont été réglés [96] ; et la localisation des fautes biaise les comparaisons [97]. L’identité des tokens supprime l’écart de plausibilité sur ces échelons, et donner l’emplacement supprime le terme de localisation, si bien que le taux ne mesure que les engrenages de réparation. L2 et au-delà utilisent les tests comme porte et rapportent séparément les comptes plausibles et corrects (Section 8.1).
6.1 L0 : fautes à un seul token
Le corpus L0 est l’ensemble des mutants de type PIT [109] ayant un token de remplacement valide dans neuf dépôts réels à des commits fixés, cinq en Java et quatre en Python : 520,821 tâches de test sur 547,448. Le moteur (commit 65571d0, engrenages G0-T et G1-J) en restaure 520,541, un taux de 0.9995 (intervalle de Wilson à 95% de 0.9994 à 0.9995) pour une médiane de 2.3 bits de recherche. Sur les 280 non résolues, 108 sont des chiffres mutés dans des littéraux à virgule flottante et 2 se trouvent dans des littéraux d’ensemble Python. Un engrenage pour les littéraux flottants (G0-F, commit ecfe5a1) est testé sur quatre dépôts jamais utilisés pour le réglage (commons-text, commons-io, more-itertools, httpx) : 23,015 tâches sur 23,015, 1.0000 (0.9998 à 1.0000), pour une médiane de 2.0 bits de recherche. Les mutants tiennent lieu de fautes réelles à un seul token, et Just et ses collègues ont trouvé qu’ils sont couplés aux fautes réelles [110].
6.2 L1 : bogues à une seule instruction issus d’historiques réels
L1 utilise deux jeux de données publics de corrections réelles de bogues à une seule instruction, extraites d’historiques open source. ManySStuBs4J 2.0 [107] donne 24,072 tâches de test en Java ; le moteur (commit f2701b7) en résout 9,288, un taux de 0.386 (0.380 à 0.392). TSSB-3M v1.0.0 [108] donne 157,089 tâches de test en Python issues des fragments 14 et 15 ; le même moteur en résout 27,266, un taux de 0.174 (0.172 à 0.175). Le moteur ne reçoit que le bloc de 7 lignes, si bien que ce taux Java est un résultat sur bloc seul. Avec le fichier entier au commit parent, des index des méthodes et des conditions de garde du projet, et les engrenages pour les noms de méthode changés, les arguments ajoutés, les conditions de garde, les throws et les modificateurs (commit 62fb7a0, préfixe sha256 du binaire 3682c6515acdf722, préenregistré avant l’exécution), le moteur résout 13,586 des 21,320 tâches de test Java dont le fichier et l’instruction fautive ont pu être localisés, un taux de 0.637 (0.631 à 0.644). Par catégorie, il clôt les opérateurs changés (95.9%), les opérandes changés (92.1%), les appelants erronés (87.9%), les littéraux booléens permutés (88.4%), les arguments supprimés (85.1%) et les arguments permutés (83.3%) ; les noms de méthode changés atteignent 61.4% et les arguments ajoutés 51.4%, et les conditions nouvelles ou resserrées (43.5% et 51.7%) restent la principale intention ouverte. Les tableaux complets par strate sont dans le dépôt. Ces jeux de données n’ont pas de classement publié de réparation sous cette porte (bloc seul, identité des tokens, emplacement donné), donc aucun chiffre de réparation apprise n’est placé à côté ; Defects4J, qui en a un, est comparé à TBar en Section 8.1.
6.3 Énergie
Chaque ligne porte est_j, une estimation en secondes CPU multipliées par 10 W : 0.40 J par tâche résolue en L0, 0.13 sur les dépôts nouveaux, 0.10 sur ManySStuBs4J et 0.27 sur TSSB-3M. Un sous-échantillon a été lu sur RAPL [105], le compteur de boîtier intégré au processeur, sur un portable Linux équipé d’un Intel i9-13900H (nom d’hôte jetson-hub ; ce n’est pas une NVIDIA Jetson). Le harnais s’est exécuté sur 4 CPU fixés, et reported_j est l’écart du boîtier sur toute l’exécution, pilote Python compris, moins la puissance au repos issue d’un échantillon de 10 s pris juste avant, multipliée par la durée de l’exécution. Des exécuteurs d’intégration continue étaient actifs, donc le repos était de 40 W à 44 W et l’incertitude d’environ ±1 W fois la durée, soit ±10 J sur ces totaux.
| Sous-échantillon (partition de test) | Tâches | Résolues | J bruts | reported_j | reported_j par tâche résolue | Secondes |
|---|---|---|---|---|---|---|
| L0, mutants gson (avec graine, 3,000 premiers) | 3,000 | 3,000 | 648.3 | 167.5 | 0.056 | 11.8 |
| L1, ManySStuBs4J positions 2,000 à 3,999 | 2,000 | 690 | 377.2 | 17.9 | 0.026 | 8.2 |
Le sous-échantillon L1 construit son index de projet à partir de ses seules 2,000 tâches, si bien que son taux de résolution (34.5%) est inférieur à celui de l’exécution complète. measured_j, un compteur mural sur un rail nommé, est vide dans chaque ligne ; son protocole est en Section 8.3.
7. Preuves de réutilisation
La position de RCE sur l’axe de la réutilisation repose sur un fait d’ingénierie : le code est réutilisé à toutes les échelles. Chaque méthode ci-dessous le mesure différemment.
| Méthode | Source | Constat |
|---|---|---|
| Cartographie des clones au niveau fichier | DéjàVu, Lopes et al. 2017 [33] | Sur 428 millions de fichiers dans 4.5 millions de projets GitHub non dérivés, 85 millions sont uniques : « 70% du code sur GitHub consiste en clones de fichiers créés auparavant. » En JavaScript, 6% des fichiers sont distincts. |
| Redondance au niveau ligne | Gabel et Su 2010 [34] | Sur 420 millions de lignes, « entre 50% et 100% de chaque projet est redondant » à environ une ligne. |
| Modèles statistiques de langage | Hindle et al. 2012 [35] | Le code est « très répétitif, et même davantage que les langues naturelles ». |
| Quasi-déduplication du corpus | The Stack [36] | La quasi-déduplication retire 54.7% de The Stack v1 (de 6.4 To à 2.9 To) et 52.4% de la v2 (de 67.5 To à 32.1 To). |
| Préservation de l’archive entière | Software Heritage [129, 130] | 30.3 milliards de contenus de fichiers uniques issus de 448 millions d’origines (compteurs de l’archive, lus le 13 octobre 2026), chacun stocké une fois par l’empreinte de ses octets. |
| Motifs de correction extraits | PAR, TBar [22, 23] | PAR a trouvé « plusieurs motifs de correction courants » dans plus de 60,000 correctifs humains. Les 15 catégories de motifs de TBar corrigent correctement 43 bogues de Defects4J dans la chaîne standard, et 74 sur 101 avec une localisation parfaite des fautes, sans apprentissage. Ce sont des chiffres tels que lus dans [23] ; le sens du 101 (correctifs plausibles ou bogues tentés) n’a pas été revérifié ici par rapport à cet article, de sorte que la proportion doit être tenue pour non confirmée. |
| Tâches multilingues | Rosetta Code [131] | 1,360 tâches (et 421 tâches à l’état de brouillon), chacune un concept implémenté dans un grand nombre de 1,009 langages connus. |
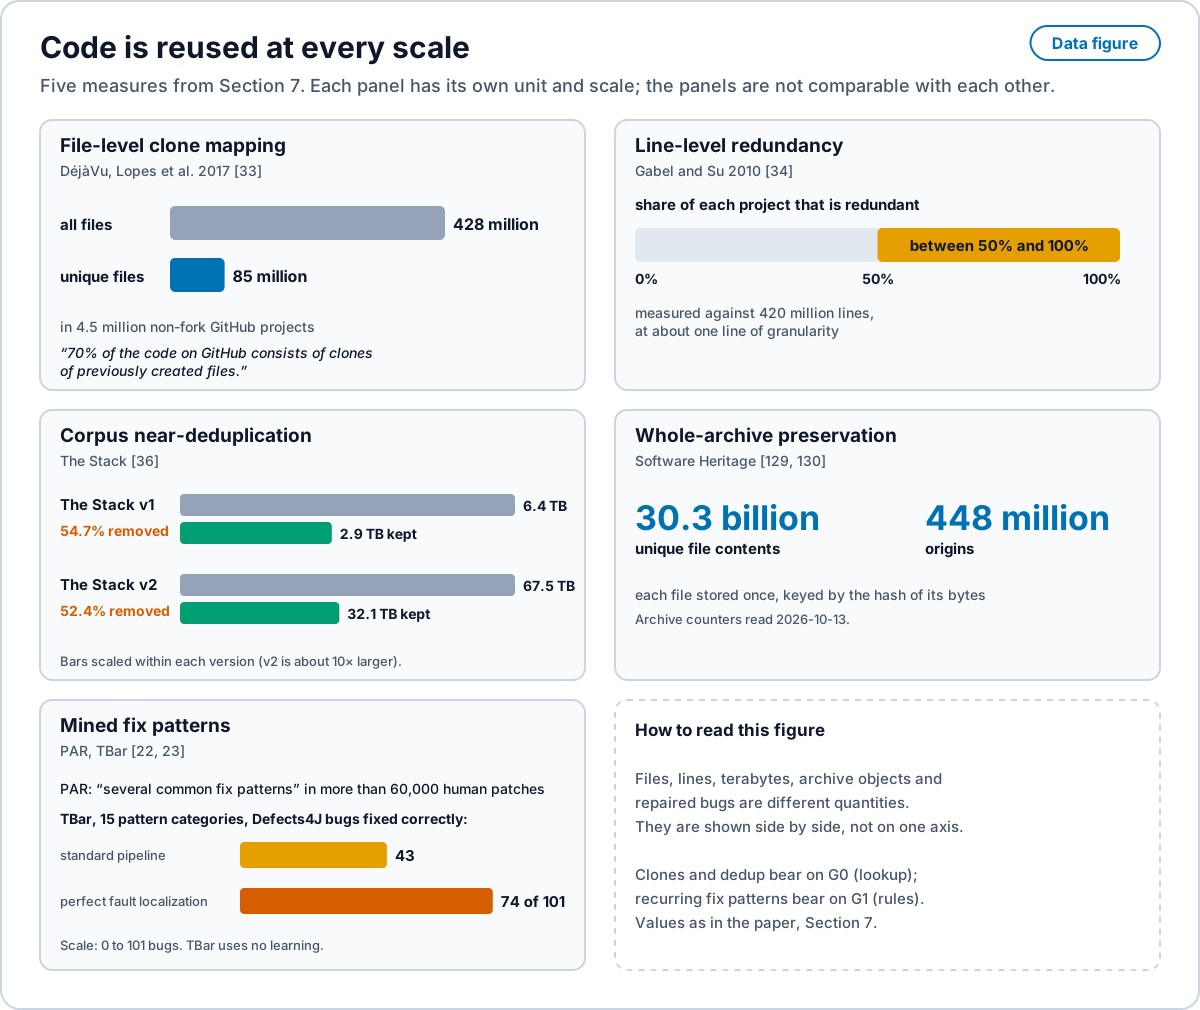
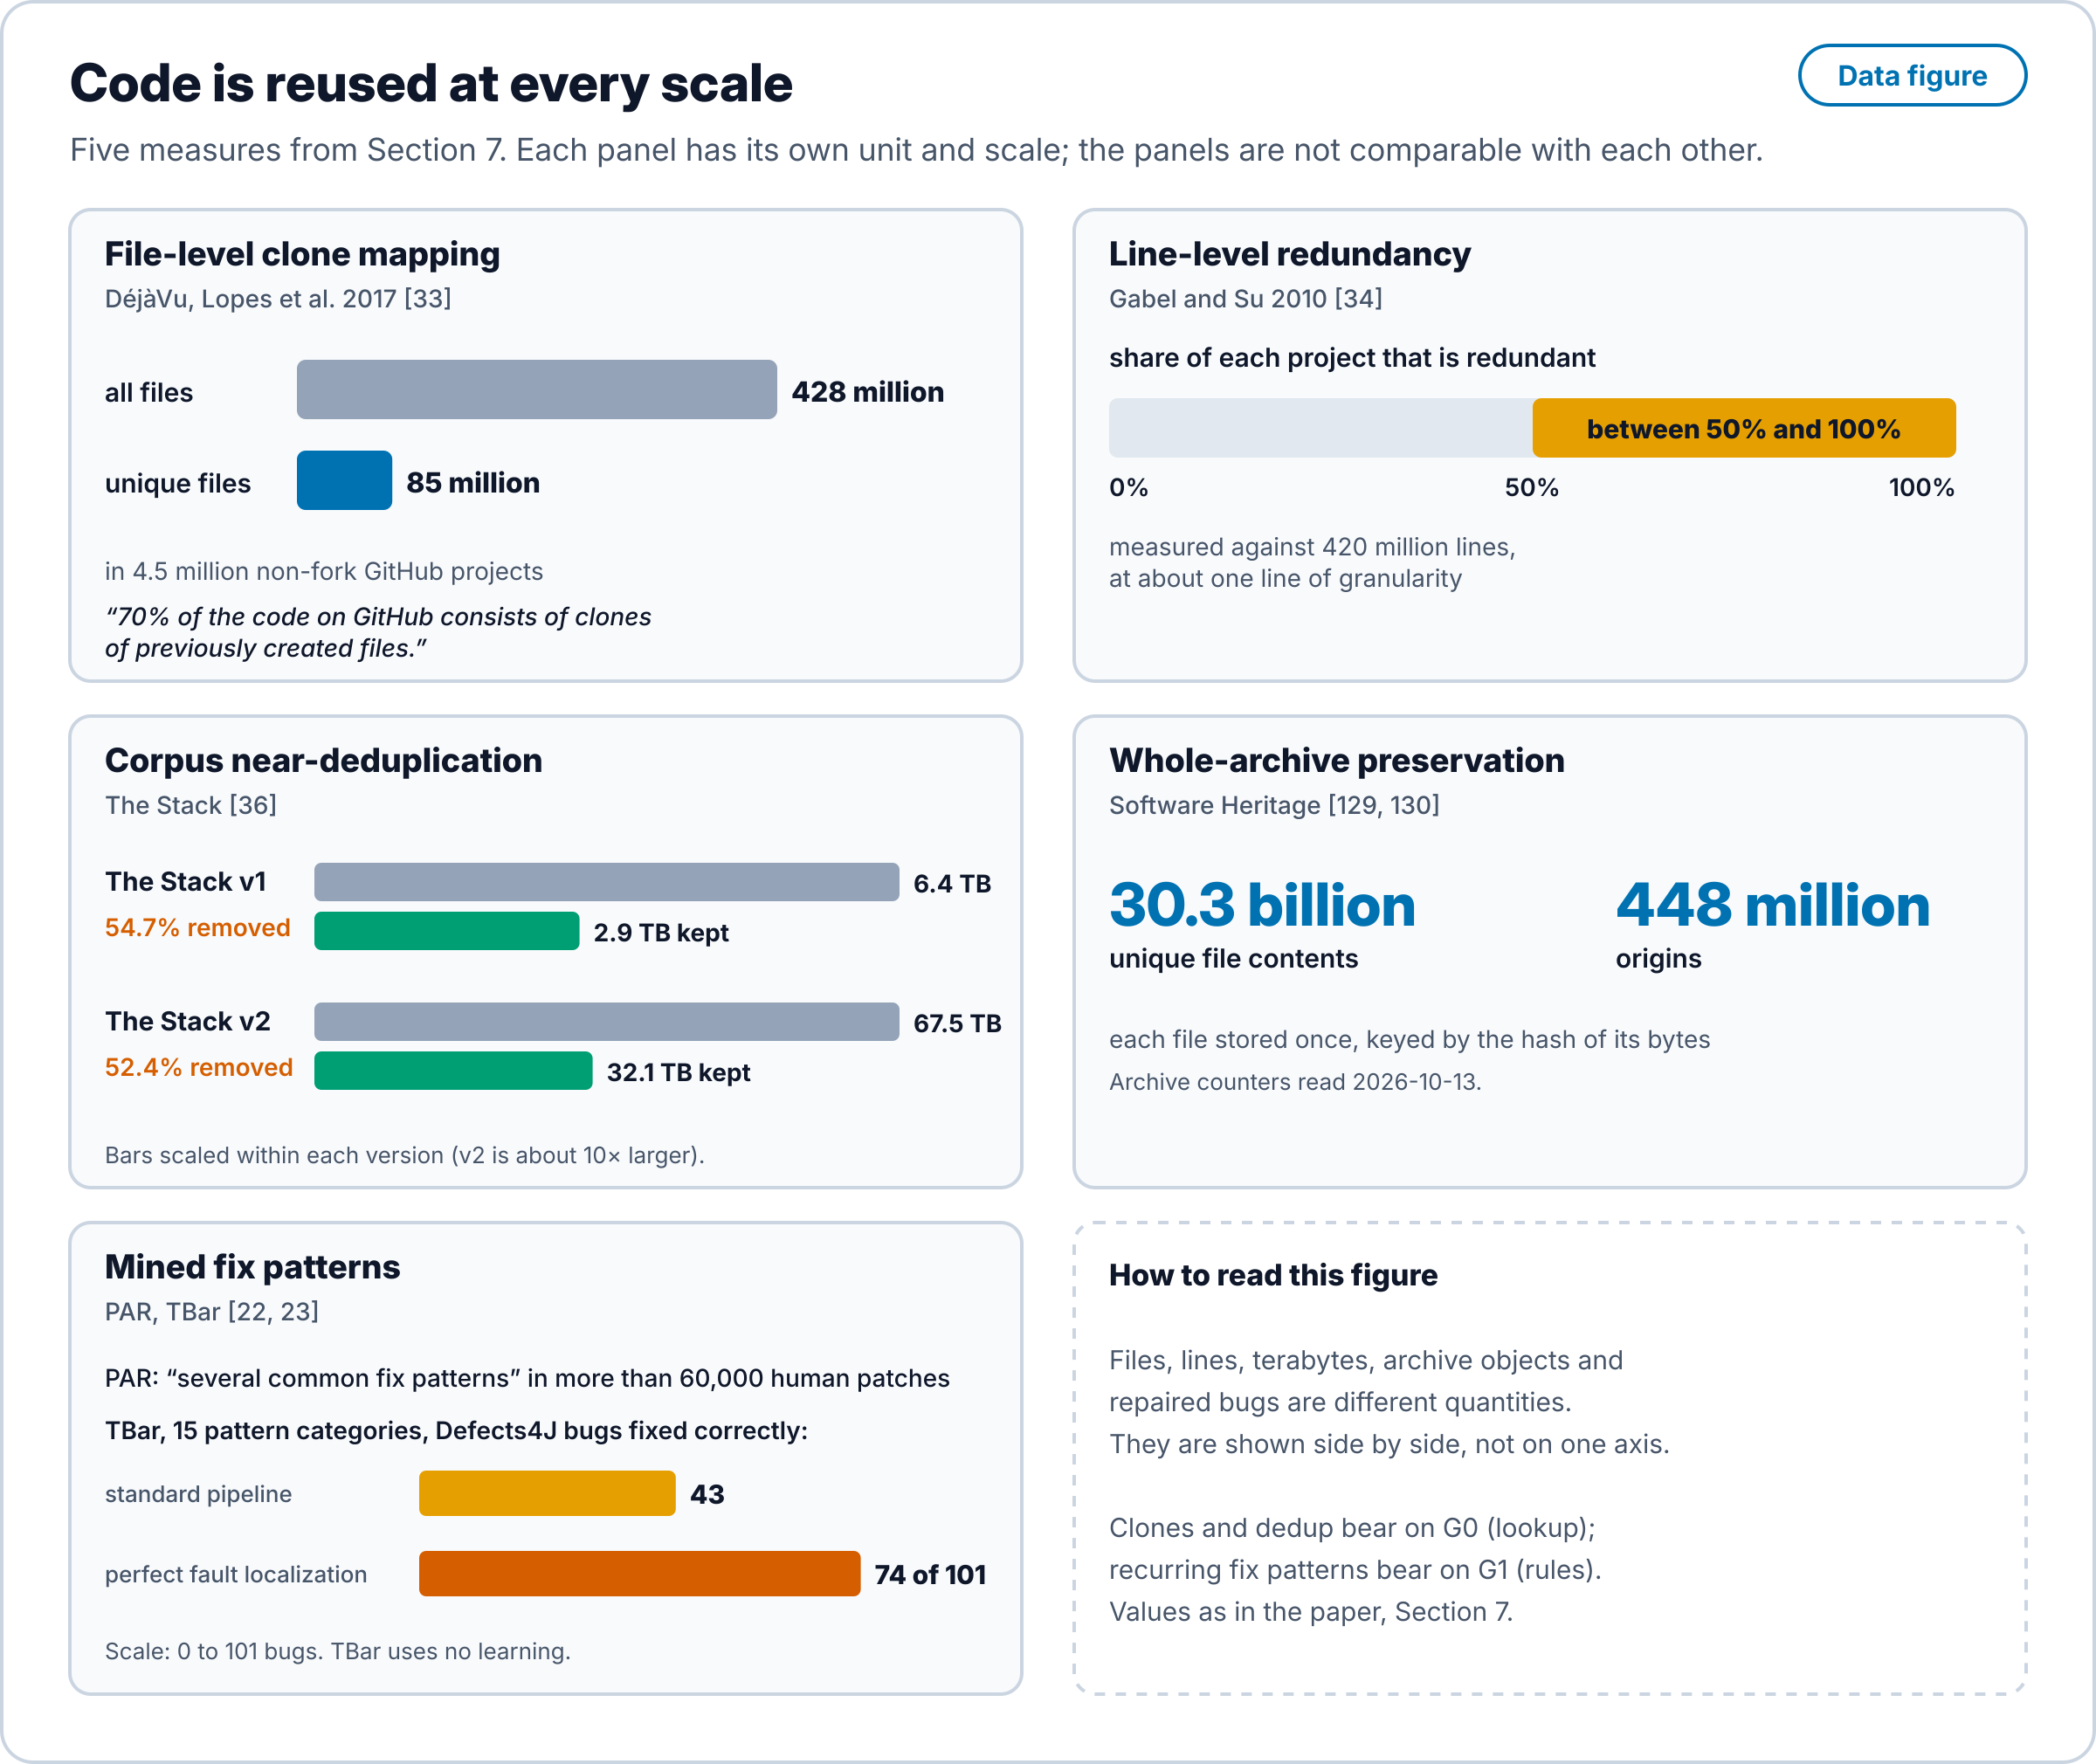
Chaque ligne est une entrée du moteur. Les clones et la déduplication disent qu’un ajustement existe généralement, c’est G0. Les corrections récurrentes disent que l’adaptation est surtout un petit catalogue de réécritures gardées, c’est G1. La redondance au niveau ligne réduit l’espace de recherche de G2. L’écosystème le mesure sur chaque ajustement promu (Section 2.3), et l’échelle de réparation sur le code élevé le mesure à grande échelle sur des partitions réservées (Section 6). Deux mises en garde affinent la lecture. Les doublons gonflent les scores de récupération et des modèles s’ils ne sont pas retirés [104]. Et les lignes boguées sont moins naturelles que les lignes corrigées [45], si bien que le bogue lui-même est le cas que la recherche peut le moins prédire ; c’est la forme de la correction, non la ligne boguée, que G0 et G1 doivent indexer. La lignée d’extraction de règles qui le fait à grande échelle, de la recherche générer-et-valider de GenProg [88] et du modèle de correction appris de Prophet [89] à Getafix chez Facebook [90] et à la réparation sans modèle des violations d’analyse statique par Sorald [91], dérive des modèles d’un historique disjoint et rapporte la précision sur des cas non vus [98]. C’est le standard qu’adopte la Section 8.4.
8. Protocoles de mesure pour la suite
Chaque protocole est fixé avant son exécution : préenregistrement validé, graines et commit du solveur enregistrés, chaque artefact conservé. La porte d’abord, les joules ensuite, les étiquettes toujours.
8.1 Defects4J
Defects4J contient 854 bogues Java réels actifs, chacun avec des tests qui le reproduisent [37].
- Développer sur un sous-ensemble de 100 bogues, hors ligne, via
defects4j checkout; ne rapporter que des résultats réservés, sur un ensemble disjoint de 288 bogues figé avant l’exécution (FROZEN-heldout-v1). - Exécuter G0, puis G1, puis G2, puis un modèle local en dernier. Enregistrer l’engrenage qui a clos chaque bogue.
- Porte : les tests déclencheurs et la suite complète réussissent. Rapporter séparément les comptes plausibles et corrects ; correct signifie équivalent au correctif du développeur après revue.
- Rapporter les appels de modèle par correction correcte et les joules par correction correcte, étiquetés.
- Points de référence : les 43 corrections correctes de TBar et ses 74 sur 101 avec localisation parfaite (chiffres tels que lus dans [23], le dénominateur n’ayant pas été revérifié ici). Cette section est un protocole. Aucun résultat Defects4J de ce moteur n’est rapporté dans cet article.
- Contrôle de contamination : signaler chaque bogue dont la correction apparaît telle quelle dans l’index de G0, et rapporter avec et sans les bogues signalés.
8.2 SWE-bench Lite, hors ligne
SWE-bench Lite est un sous-ensemble de 300 tâches issues de tickets GitHub réels résolus par des tests cachés [38].
- Utiliser le harnais Docker officiel sans réseau.
- Première exécution : G0 et G1 seulement, zéro appel de modèle. C’est le plancher de la résolution sans modèle.
- Seconde exécution : ajouter un modèle local comme dernier engrenage.
- Rapporter le taux de résolution, les appels de modèle par tâche résolue et les joules par tâche résolue, étiquetés.
- Contrôle de contamination comme en 8.1. SWE-Bench+ a trouvé que 32.67% des correctifs réussis avaient la solution dans le texte du ticket [39].
8.3 Un compteur mural
- Brancher un compteur mural ou un compteur à shunt sur l’alimentation de l’hôte, journalisé à une fréquence déclarée et avec son horloge synchronisée sur le journal d’exécution.
- Machine au repos : exécuteurs de CI et autres compilations arrêtés, et une porte de fenêtre de calme vérifiée avant chaque bloc et enregistrée.
- Soustraire une ligne de base de repos mesurée, et préciser la méthode.
- Remplir
measured_jà partir du seul compteur. Rapporterreported_j(RAPL) etest_jà côté, dans des colonnes séparées. Ne jamais additionner entre étiquettes. - Répéter sous le compteur les sous-échantillons RAPL de la Section 6.3, puis l’ensemble réservé de Defects4J.
8.4 Une exécution réservée à engrenages figés
C’est la méthode de la Section 6, étendue à de nouveaux corpus.
- Figer G0, G1 et G2 à un commit étiqueté, enregistrer l’empreinte binaire et publier le jeu de règles avec ses horodatages de rédaction.
- Tirer une tranche réservée disjointe : les instances Rust et Python de Multi-SWE-bench [102] et BugsInPy [103], dédupliquées par rapport à l’index de G0 [104].
- Préenregistrer la tranche, les graines et les hypothèses avant la première exécution.
- Rapporter séparément les comptes résolus, plausibles et identiques octet pour octet, chacun avec un intervalle à 95%.
8.5 Références de base dans le même tableau
- Sans modèle :
cargo fixet clippy [106], et Sorald ou un portage de TBar [91]. - Modèle bon marché : Agentless avec un modèle local [99].
- Modèle distant : un agent avec un modèle de pointe, son énergie estimée à partir des déclarations du fournisseur et étiquetée
est_j. - Rapporter le coût par réussite [101] en joules et en dollars pour chaque ligne, avec le coût contrôlé comme l’exigent Kapoor et ses collègues [100].
8.6 Convergence des appels de modèle à grand N
La promotion est le mécanisme par lequel le modèle quitte la boucle : un résolveur est payé une fois pour un cas nouveau, la porte admet l’ajustement comme gestionnaire, et tout cas ultérieur de même forme se clôt en G0 ou G1 (Section 4.2). La convergence est l’affirmation que les appels de modèle par tour tombent à zéro sur une spécification fixe sous un trafic réel. Elle se mesure ainsi.
- Tirer au moins 1,000 spécifications de dépôts publics, stratifiées par langage et par taille, et figer le moteur et le résolveur avant le premier tour.
- Rejouer un trafic de production enregistré, au moins 10,000 événements par spécification, en tours de taille fixe.
- Enregistrer par tour : nouvelles escalades, appels de modèle, promotions, reports et joules par tâche close, chacun étiqueté (
est_j,reported_j,measured_j). - Critère principal : la part des spécifications atteignant un tour à zéro appel de modèle en 20 tours, avec un intervalle de Wilson à 95%. Secondaires : appels de modèle par tâche close par tour, et le tour du dernier appel de modèle.
- Rapporter les spécifications qui ne convergent jamais avec leur cause (une entrée bloquée, une dépendance manquante, une intention nouvelle), et exécuter le report des entrées bloquées comme bras préenregistré.
Proposition 8 (approche du plancher). À mesure que la couverture de G0 et G1 croît, les joules par tâche résolue s’approchent du plancher de référence consistant à appliquer une correction connue et à exécuter les tests. Les échelons de l’échelle et l’ensemble réservé de Defects4J sous le compteur mural la mettent à l’épreuve.
8.7 Couverture de l’élévation à travers les langages
L’élévation est mesurée à mesure qu’elle est construite. Pour le langage , un programme compte comme élevé lorsque réussit les tests propres du programme et rejoue ses traces enregistrées octet pour octet, et que a la même empreinte de forme que . L’échantillon compte au moins 10,000 programmes par langage pour au moins dix langages, tirés avec une graine fixe de corpus publics figés, avec l’élévateur figé et son empreinte binaire enregistrée avant chaque exécution, et 0 appel de modèle. Chaque exécution rapporte la part élevée avec un intervalle de Wilson à 95%, et chaque construction pas encore élevée est un élément de travail pour l’élévateur de ce langage, construit et figé avant l’exécution suivante. La cible est tout programme dans tout langage.
9. Réfutateurs
Fixés avant les exécutions qu’ils mettent à l’épreuve.
| ID | Observation | Réfute |
|---|---|---|
| RCE-F0 | Sur une exécution préenregistrée d’au moins 10,000 Formes, une projection imprime une trace qui diffère de la trace de référence de la Forme, ou une entrée malformée est acceptée | L’affirmation que les projections sont fidèles et que la porte refuse dès l’entrée |
| RCE-F1 | Sur la tranche réservée, G0 à G2 à règles figées résolvent moins de 10% des tâches avec 0 appel de modèle | L’affirmation que la plupart des ajustements existent déjà pour la réparation à cette échelle |
| RCE-F2 | Les correctifs identiques octet pour octet ou équivalents représentent moins de la moitié des tâches réservées résolues | La lecture de la porte comme plus que de la plausibilité sur les tâches couvertes |
| RCE-F3 | Sous le compteur mural, les joules bruts par tâche résolue du solveur RCE dépassent ceux de la référence à modèle la moins chère sur les tâches que tous deux résolvent | L’affirmation d’une énergie plus faible par tâche résolue sur les tâches couvertes |
| RCE-F4 | Dans le protocole de convergence de la Section 8.6, moins de la moitié des spécifications sans entrée bloquée atteignent un tour à zéro appel de modèle en 20 tours | Compiler le modèle hors de la boucle |
10. Travail à terminer
Chaque point a son protocole nommé.
- L’élévation construite et mesurée sur au moins dix langages selon le protocole de la Section 8.7.
- Le bras des spécifications : des spécifications dans le style de MBPP et HumanEval écrites comme Formes et émises vers toutes les cibles.
- Résultats réservés sur L2 à L4, l’ensemble Defects4J de 288 bogues (Section 8.1), et sur L5 à L7 (Section 8.2).
- Références de base dans un seul tableau, coût par réussite en joules et en dollars (Section 8.5).
- Une série de
measured_j: un compteur mural sur un hôte au repos, au moins 10 répétitions, brut et net côte à côte (Section 8.3). - L’étude des 626 langages publiée avec sa méthode (Figure 1).
- De nouveaux corpus réservés à engrenages figés : Multi-SWE-bench et BugsInPy (Section 8.4).
- La convergence des appels de modèle sur au moins 1,000 spécifications (Section 8.6).
11. Conclusion
RCE est un écosystème de code natif. Un programme est écrit une fois, à partir de l’intention, comme une Forme : un codage sans perte de l’état, des événements et des transitions pures, et chaque langage cible en est une projection fidèle. Les états invalides ne peuvent pas être écrits et les entrées malformées sont refusées dès l’entrée, si bien qu’un programme de l’écosystème ne peut pas dériver de son intention et n’a besoin d’aucune comparaison de différences ni d’aucun suivi d’erreurs après coup. Chaque ajustement qui franchit la porte est stocké et réutilisé, et l’écosystème se capitalise sous une porte dont la correction est monotone. Sur 10,000 Formes préenregistrées, moteur figé et 0 appel de modèle, chaque Forme fait l’aller-retour vers des octets identiques, chaque projection est déterministe, chaque entrée et chaque spécification malformée est refusée dès l’entrée, et la projection Python rejoue la trace de référence sur 9,999. Le code d’autres langages entre par élévation, une construction qui va de la grammaire de chaque langage à son arbre syntaxique puis à la Forme ; sur le code élevé, les engrenages de réparation restaurent 99.95% de 520,821 fautes à un seul token et 63.7% de 21,320 bogues Java à une seule instruction. Les Sections 3.6 et 8.7 énoncent les propositions d’universalité et la manière dont leur construction est mesurée.
Références
[1] C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal 30(1), 1951. doi:10.1002/j.1538-7305.1951.tb01366.x
[2] Y. Gurevich, “Sequential Abstract State Machines Capture Sequential Algorithms,” ACM Transactions on Computational Logic 1(1), 2000. doi:10.1145/343369.343384
[3] A. Blass and Y. Gurevich, “Abstract State Machines Capture Parallel Algorithms,” ACM Transactions on Computational Logic, 2003. doi:10.1145/937555.937561
[4] N. Dershowitz and Y. Gurevich, “A Natural Axiomatization of Computability and Proof of Church’s Thesis,” Bulletin of Symbolic Logic, 2008. doi:10.2178/bsl/1231081370
[5] E. F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM, 1970. doi:10.1145/362384.362685
[6] G. H. Mealy, “A Method for Synthesizing Sequential Circuits,” Bell System Technical Journal, 1955. doi:10.1002/j.1538-7305.1955.tb03788.x
[7] E. F. Moore, “Gedanken-Experiments on Sequential Machines,” Automata Studies, 1956. doi:10.1515/9781400882618-006
[8] K. Kang et al., “Feature-Oriented Domain Analysis (FODA) Feasibility Study,” CMU/SEI-90-TR-021, 1990.
[9] R. Alur et al., “Syntax-Guided Synthesis,” FMCAD 2013. doi:10.1109/FMCAD.2013.6679385
[10] D. Harel, “Statecharts: A Visual Formalism for Complex Systems,” Science of Computer Programming, 1987. doi:10.1016/0167-6423(87)90035-9
[11] R. Tate, M. Stepp, Z. Tatlock and S. Lerner, “Equality Saturation,” POPL 2009. doi:10.1145/1480881.1480915
[12] M. Willsey et al., “egg: Fast and Extensible Equality Saturation,” POPL 2021. doi:10.1145/3434304
[13] B. Moseley and P. Marks, “Out of the Tar Pit,” 2006.
[14] M. Fowler, “Event Sourcing,” 2005. https://martinfowler.com/eaaDev/EventSourcing.html
[15] P. Alvaro et al., “Dedalus: Datalog in Time and Space,” LNCS 2011. doi:10.1007/978-3-642-24206-9_16
[16] A. M. Turing, “On Computable Numbers,” Proceedings of the London Mathematical Society, 1937. doi:10.1112/plms/s2-42.1.230
[17] A. Church, “An Unsolvable Problem of Elementary Number Theory,” American Journal of Mathematics, 1936. doi:10.2307/2371045
[18] P. Wadler, “Propositions as Types,” Communications of the ACM, 2015. doi:10.1145/2699407
[19] J. M. Hellerstein and P. Alvaro, “Keeping CALM,” Communications of the ACM, 2020. doi:10.1145/3369736
[20] G. Kahn, “The Semantics of a Simple Language for Parallel Programming,” IFIP 1974, pp. 471 to 475.
[21] H. Husain et al., “CodeSearchNet Challenge,” 2019. arXiv:1909.09436
[22] D. Kim, J. Nam, J. Song and S. Kim, “Automatic Patch Generation Learned from Human-Written Patches” (PAR), ICSE 2013. doi:10.1109/ICSE.2013.6606626
[23] K. Liu et al., “TBar: Revisiting Template-based Automated Program Repair,” ISSTA 2019. arXiv:1903.08409
[24] K. Liu et al., “AVATAR: Fixing Semantic Bugs with Fix Patterns of Static Analysis Violations,” SANER 2019. arXiv:1812.07270
[25] A. Koyuncu et al., “FixMiner: Mining Relevant Fix Patterns for Automated Program Repair,” 2018. arXiv:1810.01791
[26] Y. Padioleau et al., “Documenting and Automating Collateral Evolutions in Linux Device Drivers” (Coccinelle), EuroSys 2008. doi:10.1145/1352592.1352618
[27] A. Solar-Lezama et al., “Combinatorial Sketching for Finite Programs,” ASPLOS 2006. doi:10.1145/1168857.1168907
[28] L. Chen, M. Zaharia and J. Zou, “FrugalGPT,” 2023. arXiv:2305.05176
[29] S. Haber and W. S. Stornetta, “How to Time-Stamp a Digital Document,” Journal of Cryptology, 1991. doi:10.1007/BF00196791
[30] S. A. Crosby and D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging,” USENIX Security 2009.
[31] L. de Moura and N. Bjørner, “Z3: An Efficient SMT Solver,” TACAS 2008. doi:10.1007/978-3-540-78800-3_24
[32] Kani Rust Verifier. https://github.com/model-checking/kani
[33] C. V. Lopes et al., “DéjàVu: A Map of Code Duplicates on GitHub,” OOPSLA 2017. doi:10.1145/3133908
[34] M. Gabel and Z. Su, “A Study of the Uniqueness of Source Code,” FSE 2010. doi:10.1145/1882291.1882315
[35] A. Hindle et al., “On the Naturalness of Software,” ICSE 2012. doi:10.1109/ICSE.2012.6227135
[36] D. Kocetkov et al., “The Stack: 3 TB of Permissively Licensed Source Code,” 2022. arXiv:2211.15533; The Stack v2 dataset card, https://huggingface.co/datasets/bigcode/the-stack-v2
[37] R. Just, D. Jalali and M. D. Ernst, “Defects4J: A Database of Existing Faults to Enable Controlled Testing Studies for Java Programs,” ISSTA 2014. doi:10.1145/2610384.2628055
[38] C. E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. arXiv:2310.06770
[39] R. Aleithan et al., “SWE-Bench+: Enhanced Coding Benchmark for LLMs,” 2024. arXiv:2410.06992
[40] C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal 27, 1948. doi:10.1002/j.1538-7305.1948.tb01338.x
[41] A. N. Kolmogorov, “Three approaches to the quantitative definition of information,” Problemy Peredachi Informatsii 1(1), 1965 (in Russian); English translation, International Journal of Computer Mathematics 2, 1968. doi:10.1080/00207166808803030
[42] R. J. Solomonoff, “A formal theory of inductive inference. Part I,” Information and Control 7(1), 1964. doi:10.1016/S0019-9958(64)90223-2
[43] G. J. Chaitin, “A Theory of Program Size Formally Identical to Information Theory,” Journal of the ACM 22(3), 1975. doi:10.1145/321892.321894
[44] J. Rissanen, “Modeling by shortest data description,” Automatica 14(5), 1978. doi:10.1016/0005-1098(78)90005-5
[45] B. Ray, V. Hellendoorn, S. Godhane, Z. Tu, A. Bacchelli and P. Devanbu, “On the ‘naturalness’ of buggy code,” ICSE 2016. doi:10.1145/2884781.2884848
[46] Z. Tu, Z. Su and P. Devanbu, “On the localness of software,” FSE 2014. doi:10.1145/2635868.2635875
[47] M. Allamanis, E. T. Barr, P. Devanbu and C. Sutton, “A Survey of Machine Learning for Big Code and Naturalness,” ACM Computing Surveys 51(4), 2018. doi:10.1145/3212695
[48] 陈浙哲, 刘忠鑫, 鄢萌, 徐洲, 夏鑫, 雷晏 (Z. Chen, Z. Liu, M. Yan, Z. Xu, X. Xia and Y. Lei), “代码自然性及其应用研究进展” (Research progress of code naturalness and its application), 软件学报 (Journal of Software) 33(8), 3015 to 3034, 2022. doi:10.13328/j.cnki.jos.006355
[49] G. Sridhara, V. S. Sinha and S. Mani, “Naturalness of Natural Language Artifacts in Software,” ISEC 2015 (India Software Engineering Conference). doi:10.1145/2723742.2723758
[50] P. Devanbu, “On the naturalness of software,” keynote, ISEC 2013 (India Software Engineering Conference). doi:10.1145/2442754.2442763
[51] A. Z. H. Yang, S. Kolak, V. J. Hellendoorn, R. Martins et al., “Revisiting Unnaturalness for Automated Program Repair in the Era of Large Language Models,” ICSE 2025. doi:10.1109/ICSE55347.2025.00089
[52] E. W. Dijkstra, “Guarded commands, nondeterminacy and formal derivation of programs,” Communications of the ACM 18(8), 1975. doi:10.1145/360933.360975
[53] N. Wirth, “Program development by stepwise refinement,” Communications of the ACM 14(4), 1971. doi:10.1145/362575.362577
[54] C. A. R. Hoare, “An axiomatic basis for computer programming,” Communications of the ACM 12(10), 1969. doi:10.1145/363235.363259
[55] J.-R. Abrial, The B-Book: Assigning Programs to Meanings, Cambridge University Press, 1996. doi:10.1017/CBO9780511624162
[56] J.-R. Abrial, Modeling in Event-B: System and Software Engineering, Cambridge University Press, 2010. doi:10.1017/CBO9781139195881
[57] R.-J. Back and J. von Wright, Refinement Calculus: A Systematic Introduction, Springer, 1998. doi:10.1007/978-1-4612-1674-2
[58] F. L. Bauer and H. Wössner, Algorithmic Language and Program Development, Springer, 1982. doi:10.1007/978-3-642-61807-9
[59] S. Gulwani, “Automating string processing in spreadsheets using input-output examples,” POPL 2011. doi:10.1145/1926385.1926423
[60] S. Gulwani, O. Polozov and R. Singh, “Program Synthesis,” Foundations and Trends in Programming Languages 4(1-2), 2017. doi:10.1561/2500000010
[61] F. P. Brooks, “No Silver Bullet: Essence and Accidents of Software Engineering,” Computer 20(4), 1987. doi:10.1109/MC.1987.1663532
[62] P. Naur, “Programming as theory building,” Microprocessing and Microprogramming 15(5), 1985. doi:10.1016/0165-6074(85)90032-8
[63] M. M. Lehman, “Programs, life cycles, and laws of software evolution,” Proceedings of the IEEE 68(9), 1980. doi:10.1109/PROC.1980.11805
[64] P. Zave and M. Jackson, “Four dark corners of requirements engineering,” ACM Transactions on Software Engineering and Methodology 6(1), 1997. doi:10.1145/237432.237434
[65] R. Landauer, “Irreversibility and Heat Generation in the Computing Process,” IBM Journal of Research and Development 5(3), 1961. doi:10.1147/rd.53.0183
[66] C. H. Bennett, “Logical Reversibility of Computation,” IBM Journal of Research and Development 17(6), 1973. doi:10.1147/rd.176.0525
[67] M. Franz and T. Kistler, “Slim binaries,” Communications of the ACM 40(12), 1997. doi:10.1145/265563.265576
[68] C. W. Fraser, “Automatic inference of models for statistical code compression,” PLDI 1999. doi:10.1145/301618.301672
[69] P. Cousot and R. Cousot, “Abstract interpretation: a unified lattice model for static analysis of programs by construction or approximation of fixpoints,” POPL 1977. doi:10.1145/512950.512973
[70] Y. Futamura, “Partial evaluation of computation process: an approach to a compiler-compiler,” Systems, Computers, Controls 2(5), 1971; reprinted in Higher-Order and Symbolic Computation 12(4), 1999. doi:10.1023/A:1010095604496
[71] A. P. Ershov, “Mixed computation: potential applications and problems for study,” Theoretical Computer Science 18(1), 1982. doi:10.1016/0304-3975(82)90111-6
[72] W. A. Howard, “The formulae-as-types notion of construction,” in J. P. Seldin and J. R. Hindley (eds.), To H. B. Curry: Essays on Combinatory Logic, Lambda Calculus and Formalism, Academic Press, 1980.
[73] 土居真之, 肥後芳樹, 有馬諒, 下仲健斗, 楠本真二 (M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto), “ソースコードの「自然さ」を利用した自動生成ファイルの特定” (Identifying auto-generated files using the naturalness of source code), 電子情報通信学会技術研究報告 (IEICE Technical Report) 117(380), 19 to 24, January 2018. https://sdl.ist.osaka-u.ac.jp/pman/pman3.cgi?D=517
[74] M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto, “On the naturalness of auto-generated code: can we identify auto-generated code automatically?” ICPC 2018. doi:10.1145/3196321.3196356
[75] F. V. Arrebola, “Modelo de sugestão de código-fonte baseado em modelos de linguagem organizados em um contexto hierárquico” (A source code suggestion model based on language models organized in a hierarchical context), doctoral thesis in electrical engineering, Fundação Educacional Inaciana Padre Sabóia de Medeiros (FEI), Brazil, 2018. Advisor R. A. C. Bianchi.
[76] G. Febres, K. Jaffé and C. Gershenson, “Complexity measurement of natural and artificial languages,” Complexity 20(6), 2015. doi:10.1002/cplx.21529
[77] M. Rahman, D. Palani and P. C. Rigby, “Natural Software Revisited,” ICSE 2019. doi:10.1109/ICSE.2019.00022
[78] A. Torres, S. Baltes, C. Treude and M. Wagner, “Applying Information Theory to Software Evolution,” NLBSE 2023. doi:10.1109/NLBSE59153.2023.00017
[79] A. Blass, N. Dershowitz and Y. Gurevich, “When are two algorithms the same?,” Bulletin of Symbolic Logic 15(2), 2009. arXiv:0811.0811. https://arxiv.org/abs/0811.0811
[80] Y. N. Moschovakis, “What is an algorithm?,” in Mathematics Unlimited: 2001 and Beyond, Springer, 2001. https://www.math.ucla.edu/~ynm/papers/eng.pdf
[81] M. Y. Vardi, “What is an algorithm?,” Communications of the ACM 55(3), 2012. doi:10.1145/2093548.2093549
[82] S. Laddad, A. Cheung, J. M. Hellerstein and M. Milano, “Flo: a Semantic Foundation for Progressive Stream Processing,” POPL 2025. arXiv:2411.08274. https://arxiv.org/abs/2411.08274
[83] The Elm Architecture, Elm guide. https://guide.elm-lang.org/architecture/
[84] Temporal, “Workflows” (event history), documentation. https://docs.temporal.io/workflows
[85] A. Pnueli, M. Siegel and E. Singerman, “Translation validation,” TACAS 1998. doi:10.1007/BFb0054170
[86] X. Yang, Y. Chen, E. Eide and J. Regehr, “Finding and understanding bugs in C compilers,” PLDI 2011. doi:10.1145/1993498.1993532
[87] C. Nandi, M. Willsey, A. Zhu et al., “Rewrite Rule Inference Using Equality Saturation,” OOPSLA 2021. arXiv:2108.10436. https://arxiv.org/abs/2108.10436
[88] C. Le Goues, T. Nguyen, S. Forrest and W. Weimer, “GenProg: A Generic Method for Automatic Software Repair,” IEEE TSE 38(1), 2012. doi:10.1109/TSE.2011.104
[89] F. Long and M. Rinard, “Automatic patch generation by learning correct code,” POPL 2016. doi:10.1145/2837614.2837617
[90] J. Bader, A. Scott, M. Pradel and S. Chandra, “Getafix: Learning to Fix Bugs Automatically,” OOPSLA 2019. arXiv:1902.06111. https://arxiv.org/abs/1902.06111
[91] K. Etemadi, N. Harrand, S. Larsen et al., “Sorald: Automatic Patch Suggestions for SonarQube Static Analysis Violations,” IEEE TDSC, 2022. arXiv:2103.12033. https://arxiv.org/abs/2103.12033
[92] Z. Qi, F. Long, S. Achour and M. Rinard, “An analysis of patch plausibility and correctness for generate-and-validate patch generation systems,” ISSTA 2015. doi:10.1145/2771783.2771791
[93] E. K. Smith, E. T. Barr, C. Le Goues and Y. Brun, “Is the cure worse than the disease? Overfitting in automated program repair,” ESEC/FSE 2015. doi:10.1145/2786805.2786825
[94] X.-B. D. Le, F. Thung, D. Lo and C. Le Goues, “Overfitting in semantics-based automated program repair,” Empirical Software Engineering 23, 2018. doi:10.1007/s10664-017-9577-2
[95] Y. Xiong, X. Liu, M. Zeng, L. Zhang and G. Huang, “Identifying patch correctness in test-based program repair,” ICSE 2018. doi:10.1145/3180155.3180182
[96] T. Durieux, F. Madeiral, M. Martinez and R. Abreu, “Empirical Review of Java Program Repair Tools: A Large-Scale Experiment on 2,141 Bugs and 23,551 Repair Attempts,” ESEC/FSE 2019. arXiv:1905.11973. https://arxiv.org/abs/1905.11973
[97] K. Liu, A. Koyuncu, T. F. Bissyandé et al., “You Cannot Fix What You Cannot Find! An Investigation of Fault Localization Bias in Benchmarking Automated Program Repair Systems,” ICST 2019. arXiv:1812.07283. https://arxiv.org/abs/1812.07283
[98] M. Monperrus, “Automatic Software Repair: A Bibliography,” ACM Computing Surveys 51(1), 2018. doi:10.1145/3105906
[99] C. S. Xia, Y. Deng, S. Dunn and L. Zhang, “Agentless: Demystifying LLM-based Software Engineering Agents,” 2024. arXiv:2407.01489. https://arxiv.org/abs/2407.01489
[100] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir and A. Narayanan, “AI Agents That Matter,” 2024. arXiv:2407.01502. https://arxiv.org/abs/2407.01502
[101] M. H. Erol, B. El, M. Suzgun, M. Yuksekgonul and J. Zou, “Cost-of-Pass: An Economic Framework for Evaluating Language Models,” 2025. arXiv:2504.13359. https://arxiv.org/abs/2504.13359
[102] D. Zan, Z. Huang, W. Liu et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving,” 2025. arXiv:2504.02605. https://arxiv.org/abs/2504.02605
[103] R. Widyasari, S. Q. Sim, C. Lok et al., “BugsInPy: a database of existing bugs in Python programs to enable controlled testing and debugging studies,” ESEC/FSE 2020. doi:10.1145/3368089.3417943
[104] M. Allamanis, “The Adverse Effects of Code Duplication in Machine Learning Models of Code,” Onward! 2019. arXiv:1812.06469. https://arxiv.org/abs/1812.06469
[105] K. N. Khan, M. Hirki, T. Niemi, J. K. Nurminen and Z. Ou, “RAPL in Action: Experiences in Using RAPL for Power Measurements,” ACM TOMPECS 3(2), 2018. doi:10.1145/3177754
[106] The Rust project, rustfix and cargo fix. https://github.com/rust-lang/rustfix
[107] R.-M. Karampatsis and C. Sutton, “How Often Do Single-Statement Bugs Occur? The ManySStuBs4J Dataset,” MSR 2020. doi:10.1145/3379597.3387491
[108] C. Richter and H. Wehrheim, “TSSB-3M: Mining single statement bugs at massive scale,” MSR 2022. doi:10.1145/3524842.3528505
[109] H. Coles, T. Laurent, C. Henard, M. Papadakis and A. Ventresque, “PIT: a practical mutation testing tool for Java,” ISSTA 2016. doi:10.1145/2931037.2948707
[110] R. Just, D. Jalali, L. Inozemtseva, M. D. Ernst, R. Holmes and G. Fraser, “Are mutants a valid substitute for real faults in software testing?” FSE 2014. doi:10.1145/2635868.2635929
[111] I. J. Good, “Speculations Concerning the First Ultraintelligent Machine,” Advances in Computers 6, 1965. doi:10.1016/S0065-2458(08)60418-0
[112] J. Schmidhuber, “Gödel Machines: Fully Self-referential Optimal Universal Self-improvers,” in Artificial General Intelligence, Springer, 2007. doi:10.1007/978-3-540-68677-4_7
[113] E. Yudkowsky, “Intelligence Explosion Microeconomics,” Technical report 2013-1, Machine Intelligence Research Institute, 2013. https://intelligence.org/files/IEM.pdf
[114] M. H. Löb, “Solution of a Problem of Leon Henkin,” Journal of Symbolic Logic 20(2), 1955. doi:10.2307/2266895
[115] E. Yudkowsky and M. Herreshoff, “Tiling Agents for Self-Modifying AI, and the Löbian Obstacle,” Machine Intelligence Research Institute, 2013. https://intelligence.org/files/TilingAgentsDraft.pdf
[116] E. Zelikman, E. Lorch, L. Mackey and A. T. Kalai, “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation,” 2023. doi:10.48550/arXiv.2310.02304
[117] J. Zhang, S. Hu, C. Lu, R. Lange and J. Clune, “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents,” 2025. doi:10.48550/arXiv.2505.22954
[118] A. Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery,” 2025. doi:10.48550/arXiv.2506.13131
[119] G. Wang, Y. Xie, Y. Jiang, A. Mandlekar, C. Xiao, Y. Zhu, L. Fan and A. Anandkumar, “Voyager: An Open-Ended Embodied Agent with Large Language Models,” 2023. doi:10.48550/arXiv.2305.16291
[120] Y. Futamura, “Partial Evaluation of Computation Process: An Approach to a Compiler-Compiler,” Higher-Order and Symbolic Computation 12(4), 1999 (first published 1971). doi:10.1023/A:1010095604496
[121] V. F. Turchin, “The Concept of a Supercompiler,” ACM Transactions on Programming Languages and Systems 8(3), 1986. doi:10.1145/5956.5957
[122] J. N. Foster, M. B. Greenwald, J. T. Moore, B. C. Pierce and A. Schmitt, “Combinators for Bidirectional Tree Transformations: A Linguistic Approach to the View-Update Problem,” ACM Transactions on Programming Languages and Systems 29(3), 2007. doi:10.1145/1232420.1232424
[123] M. Hofmann, B. Pierce and D. Wagner, “Symmetric Lenses,” POPL, 2011. doi:10.1145/1926385.1926428
[124] K. Czarnecki, J. N. Foster, Z. Hu, R. Lämmel, A. Schürr and J. F. Terwilliger, “Bidirectional Transformations: A Cross-Discipline Perspective,” ICMT, LNCS 5563, 2009. doi:10.1007/978-3-642-02408-5_19
[125] E. W. Dijkstra, “A Constructive Approach to the Problem of Program Correctness,” BIT 8(3), 1968. doi:10.1007/BF01933419
[126] A. Hall and R. Chapman, “Correctness by Construction: Developing a Commercial Secure System,” IEEE Software 19(1), 2002. doi:10.1109/52.976937
[127] Y. Minsky, “OCaml for the Masses,” Communications of the ACM 54(11), 2011. doi:10.1145/2018396.2018413
[128] D. A. Turner, “Total Functional Programming,” Journal of Universal Computer Science 10(7), 2004. doi:10.3217/jucs-010-07-0751
[129] R. Di Cosmo and S. Zacchiroli, “Software Heritage: Why and How to Preserve Software Source Code,” iPRES 2017, Kyoto. https://hal.science/hal-01590958
[130] Software Heritage, archive counters, read 13 October 2026: 30,253,266,524 file contents and 448,311,919 origins. https://archive.softwareheritage.org/api/1/stat/counters/
[131] Rosetta Code, main page, read 13 October 2026: 1,360 tasks, 421 draft tasks, 1,009 known languages. https://rosettacode.org/wiki/Rosetta_Code