O Reality Code Engine: uma Forma sem perdas para programação nativa, verificada e de baixo consumo de energia
Um sistema de programação em que um programa é escrito uma vez como uma máquina de estados e cada linguagem de destino é gerada a partir dela, com medições de idas e voltas, da rejeição de entradas malformadas e do reparo de código elevado.
David Charlot, Open Interface Engineering
Esta é uma tradução da versão em inglês. Em caso de divergência, prevalece a versão em inglês. Original em inglês.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. O Reality Code Engine: uma Forma sem perdas para programação nativa, verificada e de baixo consumo de energia. Open Interface Engineering. Web: https://research.openie.dev/papers/rce/. PDF: https://research.openie.dev/pdfs/rce.pdf.
Versão 1.4, 13 de outubro de 2026. Especificação: rascunho atual (documento do rascunho 0.7, versão da linguagem 0.8), a partir de openIE-dev/rce 2a0ec68. Mudanças na 1.4: a contagem de testes do motor são os 589 testes distintos que cargo test --release executa (a 1.3 imprimiu 596, o total de make check, que conta 7 testes de prova duas vezes); a Seção 3.7 informa que a especificação 2.7 agora dá a regra de custo por ponto de chamada de C.15; o proponente determinístico da Seção 5.5 é relatado com 87 identidades oferecidas, 9 admitidas e 78 rejeitadas, a partir do teste do motor; Software Heritage e Rosetta Code, na Seção 7, trazem as referências [129] a [131], com os contadores do arquivo relidos; nove figuras são acrescentadas (Figuras 5 a 10, 12, 13 e 15) e as antigas Figuras 5 e 6 são agora as Figuras 11 e 14. Mudanças na 1.3: os custos de métodos escalados pelo tamanho são atribuídos à versão 0.7 da linguagem (na 1.2 eram descritos sob a 0.6), a regra por ponto de chamada para programas com versões mistas é enunciada, e as verificações são executadas de novo no commit 1eb5f02 do motor. Dados e código: research.openie.dev/data/. Playground (verificador de referência): openie-dev.github.io/rce. Demo do motor: /demos/rce-engine/. PDF em LaTeX: /pdfs/latex/rce.pdf (fonte).
Correções e estado de reprodutibilidade (17 de outubro de 2026). Esta nota foi acrescentada depois de uma leitura do artigo confrontada com os repositórios públicos. Os números que ela afeta estão listados aqui, e no mais o texto abaixo fica inalterado. Cada contagem abaixo vem de src/data/rce-facts.json, produzido por scripts/claim-counts.py em openIE-dev/rce em e416fd0, exceto as duas contagens em Lean, que foram tomadas em 4304048.
- Uma só linguagem (18 de outubro de 2026). O
rcemain público (4a3dc1f) tem uma única linguagem e um único texto. Uma linha# rce-version:é um rótulo de versão publicada tolerado e ignorado, que não entra no hash, e um rótulo de versão publicada nomeia exatamente um commit da especificação (C.15). Uma construção que o verificador não implementa é recusada como reservada e não implementada (W-RES-1, Apêndice F.12), e não por versão; há uma única lista de palavras reservadas. Por isso, a Seção 3.7 e a Figura 5, que descrevem portas de versão (versões 0.5 a 0.9), descrevem rascunhos anteriores e já não se aplicam. Uma chamada que falha restaura os seus argumentos&mut(F.4.4), o que substitui a regra de write-back do teorema T33. As contagens abaixo foram feitas eme416fd0, antes desta mudança, e não foram refeitas. A prova de T33 mudou com a regra: os teoremas retirados de write-back em todo resultado saíram da árvore auditada (rcemain público95ead2e), e T33 agora prova a restauração de F.4.4; a auditoria registra 4875 teoremas, apenas com os axiomas padrão. - Nomes da biblioteca (rce-stdlib, 18 de outubro de 2026). Como a lista de palavras reservadas é global, os nomes da biblioteca que ela agora reserva foram renomeados:
labelparalbl,nodeparand,groupparagrp,childparachd,budgetparabud,restartpararst,replicatedpararepl,ctparactext,sessionparasess,protocolparaproto,parparaparl,offerparaoffr,chooseparachse. Os tiposJson(móduloenc) eUrl(módulonet.url) passaram a serJsonDoceUrlParts, de modo que um programa que importeenc.Jsonounet.url.Urlprecisa usar os novos nomes. O comprimento de texto.len()de um valortexté.len_bytes()(bytes) ou.len_chars(). - Versões e contagens em
e416fd0. O documento da especificação é o rascunho 0.9 (público desdecdae5cf). Antes de 18 de outubro, o verificador de referência aceitava as versões da linguagem 0.5 a 0.9 e recusava, por versão, as partes da versão 0.9 que não implementava (Apêndice F.12). Os teoremas T1 a T56 são enunciados; T42 a T56 (Apêndice F) são enunciados e não provados. Há 58 módulos Lean e 59 programas de exemplo (57 no nível superior e 2 em pacotes). As figuras e legendas deste artigo que dizem rascunho 0.7, versão da linguagem 0.8, T1 a T34, 31 arquivos ou 51 exemplos descrevem o repositório nos commits anteriores que elas nomeiam, e este artigo não descreve o rascunho 0.9 além desta nota. - Contagem de teoremas em Lean. Existem duas contagens diferentes. A fonte contém 1,116 declarações
theoremelemmaeme416fd0(885 em4304048). A auditoria (scripts/lean-audit.sh) conta toda constante de teorema no ambiente do núcleo, inclusive as constantes que o elaborador gera, e deu 4,877 numa nova execução sobre o repositório público eme416fd0, ondelake buildconclui sobre 58 arquivos despec/lean/RCE/sem nenhumsorrye apenas com os axiomas padrão (2,949 sobre 46 arquivos em4304048). O 2,192 citado abaixo é a contagem da auditoria no commit1eb5f02do motor sobre 31 módulos. Nenhum dos dois números diz nada sobre quantos teoremas estão provados a respeito do avaliador em Rust. - Reprodutível hoje a partir dos repositórios públicos: a construção em Lean e a auditoria de axiomas, a verificação da especificação (tabelas da gramática e corpora de exemplos), o verificador de referência e os seus testes, e os vetores JSON canônicos.
- Ainda não reprodutível a partir dos repositórios públicos: a execução do ecossistema com 10,000 Formas (
bench/ecosystemnão está nos repositórios públicos), os resultados do Kani, os 589 testes do motor, as taxas de reparo da Seção 6 e qualquer número do Defects4J. Eles são relatados aqui como execuções dos próprios autores e devem ser lidos assim até que as fontes e as sementes sejam publicadas. - Falseador RCE-F0. Veja a nota na Seção 2.3 abaixo.
Resumo
Este artigo descreve o Reality Code Engine (RCE), um sistema no qual um programa é escrito uma única vez como uma máquina de estados, chamada Forma, e o código em outras linguagens é gerado a partir dela. O artigo relata o que foi medido em 10,000 Formas e em conjuntos de dados públicos de defeitos, e diz como as afirmações poderiam ser mostradas falsas.
Em palavras simples
- Um programa é escrito uma única vez, numa forma precisa, e o computador produz a partir dela o mesmo programa em muitas linguagens.
- Como a forma só permite o que foi declarado, uma entrada defeituosa é rejeitada logo na entrada em vez de ser corrigida depois.
- Uma correção que passa pelas verificações é guardada e reutilizada, de modo que o mesmo problema não custa tempo nem energia duas vezes.
1. Tese
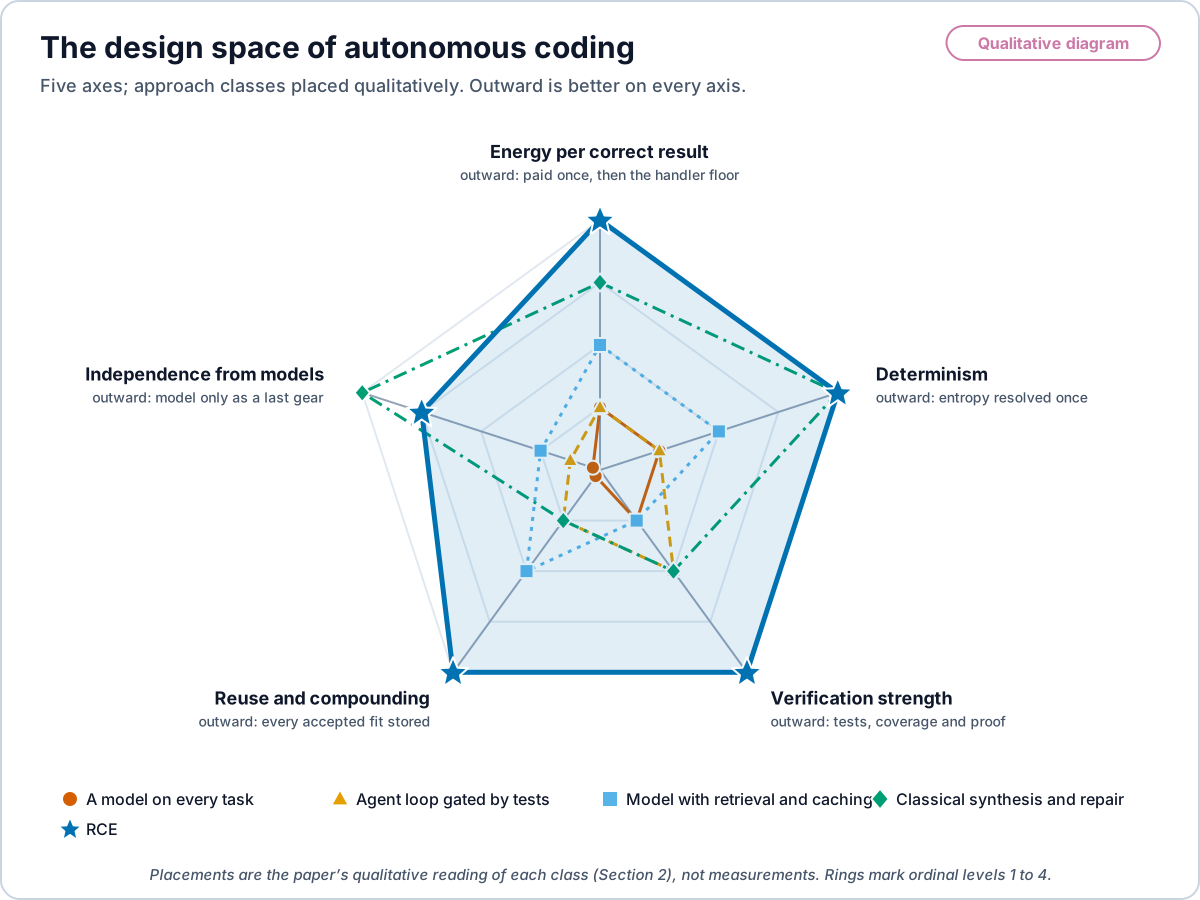
A automação computacional autônoma é um espaço de projeto com muitos pontos. Cada abordagem fica em algum lugar ao longo de cinco eixos contínuos: a energia gasta por resultado correto; a entropia que o sistema precisa resolver em tempo de execução e, com ela, o quanto sua saída é determinística; a força da verificação que aceita um resultado; o quanto cada resultado aceito é reutilizado e se acumula; e o quanto a abordagem depende de um modelo. Um grande modelo de linguagem (LLM), um modelo estatístico de texto, que escreve cada alteração a partir do prompt fica perto de um canto desse espaço: depende do modelo em cada tarefa, tira a cada vez uma amostra nova de uma distribuição de alta entropia e paga a geração de novo em cada tarefa. Recuperação, regras, síntese, verificação e cache ocupam muitos outros pontos, e os sistemas reais os combinam.
O Reality Code Engine (RCE) é um ponto do espaço, e este artigo o descreve e o mede. O RCE modela um programa como uma máquina de estados funcional de banco de dados. Lopes e colegas mediram que cerca de 70% do código no GitHub consiste em clones de arquivos anteriores [33], então o RCE tenta primeiro recuperar um ajuste existente, adaptá-lo e verificá-lo, e só chama um modelo quando nada mais barato fecha a tarefa.
A afirmação central. O RCE é um ecossistema de código completo no qual os programas são escritos nativamente a partir da intenção. A intenção é escrita uma única vez, como uma Forma: um estado, um conjunto de eventos e transições puras e totais. A Forma é uma codificação sem perdas dessa intenção. Cada alvo (statechart, Rust, Python, XState, SCXML, WASM) é uma projeção da Forma, e cada projeção reproduz o traço da Forma byte a byte. Um estado que a Forma não declara não pode ser escrito, e uma entrada fora do contrato é rejeitada no ponto de entrada. Um programa no ecossistema, portanto, não se afasta da sua intenção como um programa numa linguagem comum se afasta dos seus comentários, dos seus testes e das suas outras implementações, e não precisa de comparação de diferenças nem de rastreamento de erros depois do fato. Cada ajuste que passa pela porta é armazenado e reutilizado, de modo que o ecossistema cresce de forma cumulativa à medida que se expande (§2.4). O código escrito em outras linguagens é uma das portas de entrada e entra por elevação (§6).
Cada ponto do espaço enfrenta a mesma porta. A porta é a correção: o predicado de completude de uma tarefa, aqui os testes da tarefa, uma prova ou um traço de concordância. Entre as execuções que passam pela porta, os sistemas são classificados pelos joules até a conclusão, . A correção é uma restrição, não uma pontuação.
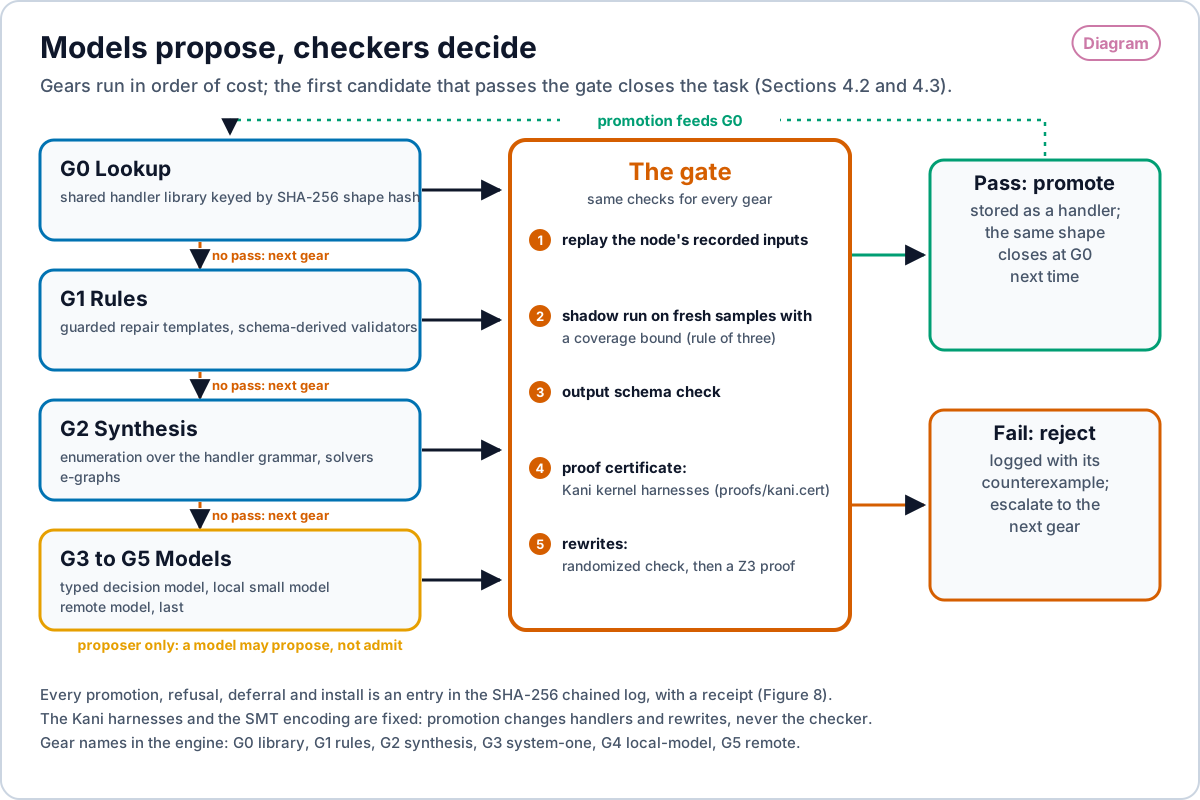
Os mecanismos do RCE, chamados engrenagens, rodam em ordem de custo, e a primeira engrenagem que passa pela porta encerra a tarefa.
Os valores de energia são rotulados pela fonte. est_j é uma estimativa analítica. reported_j é um contador do sistema operacional ou do chip. measured_j é reservado a um medidor de parede e está vazio em todos os resultados aqui.
2. O espaço de projeto da programação autônoma
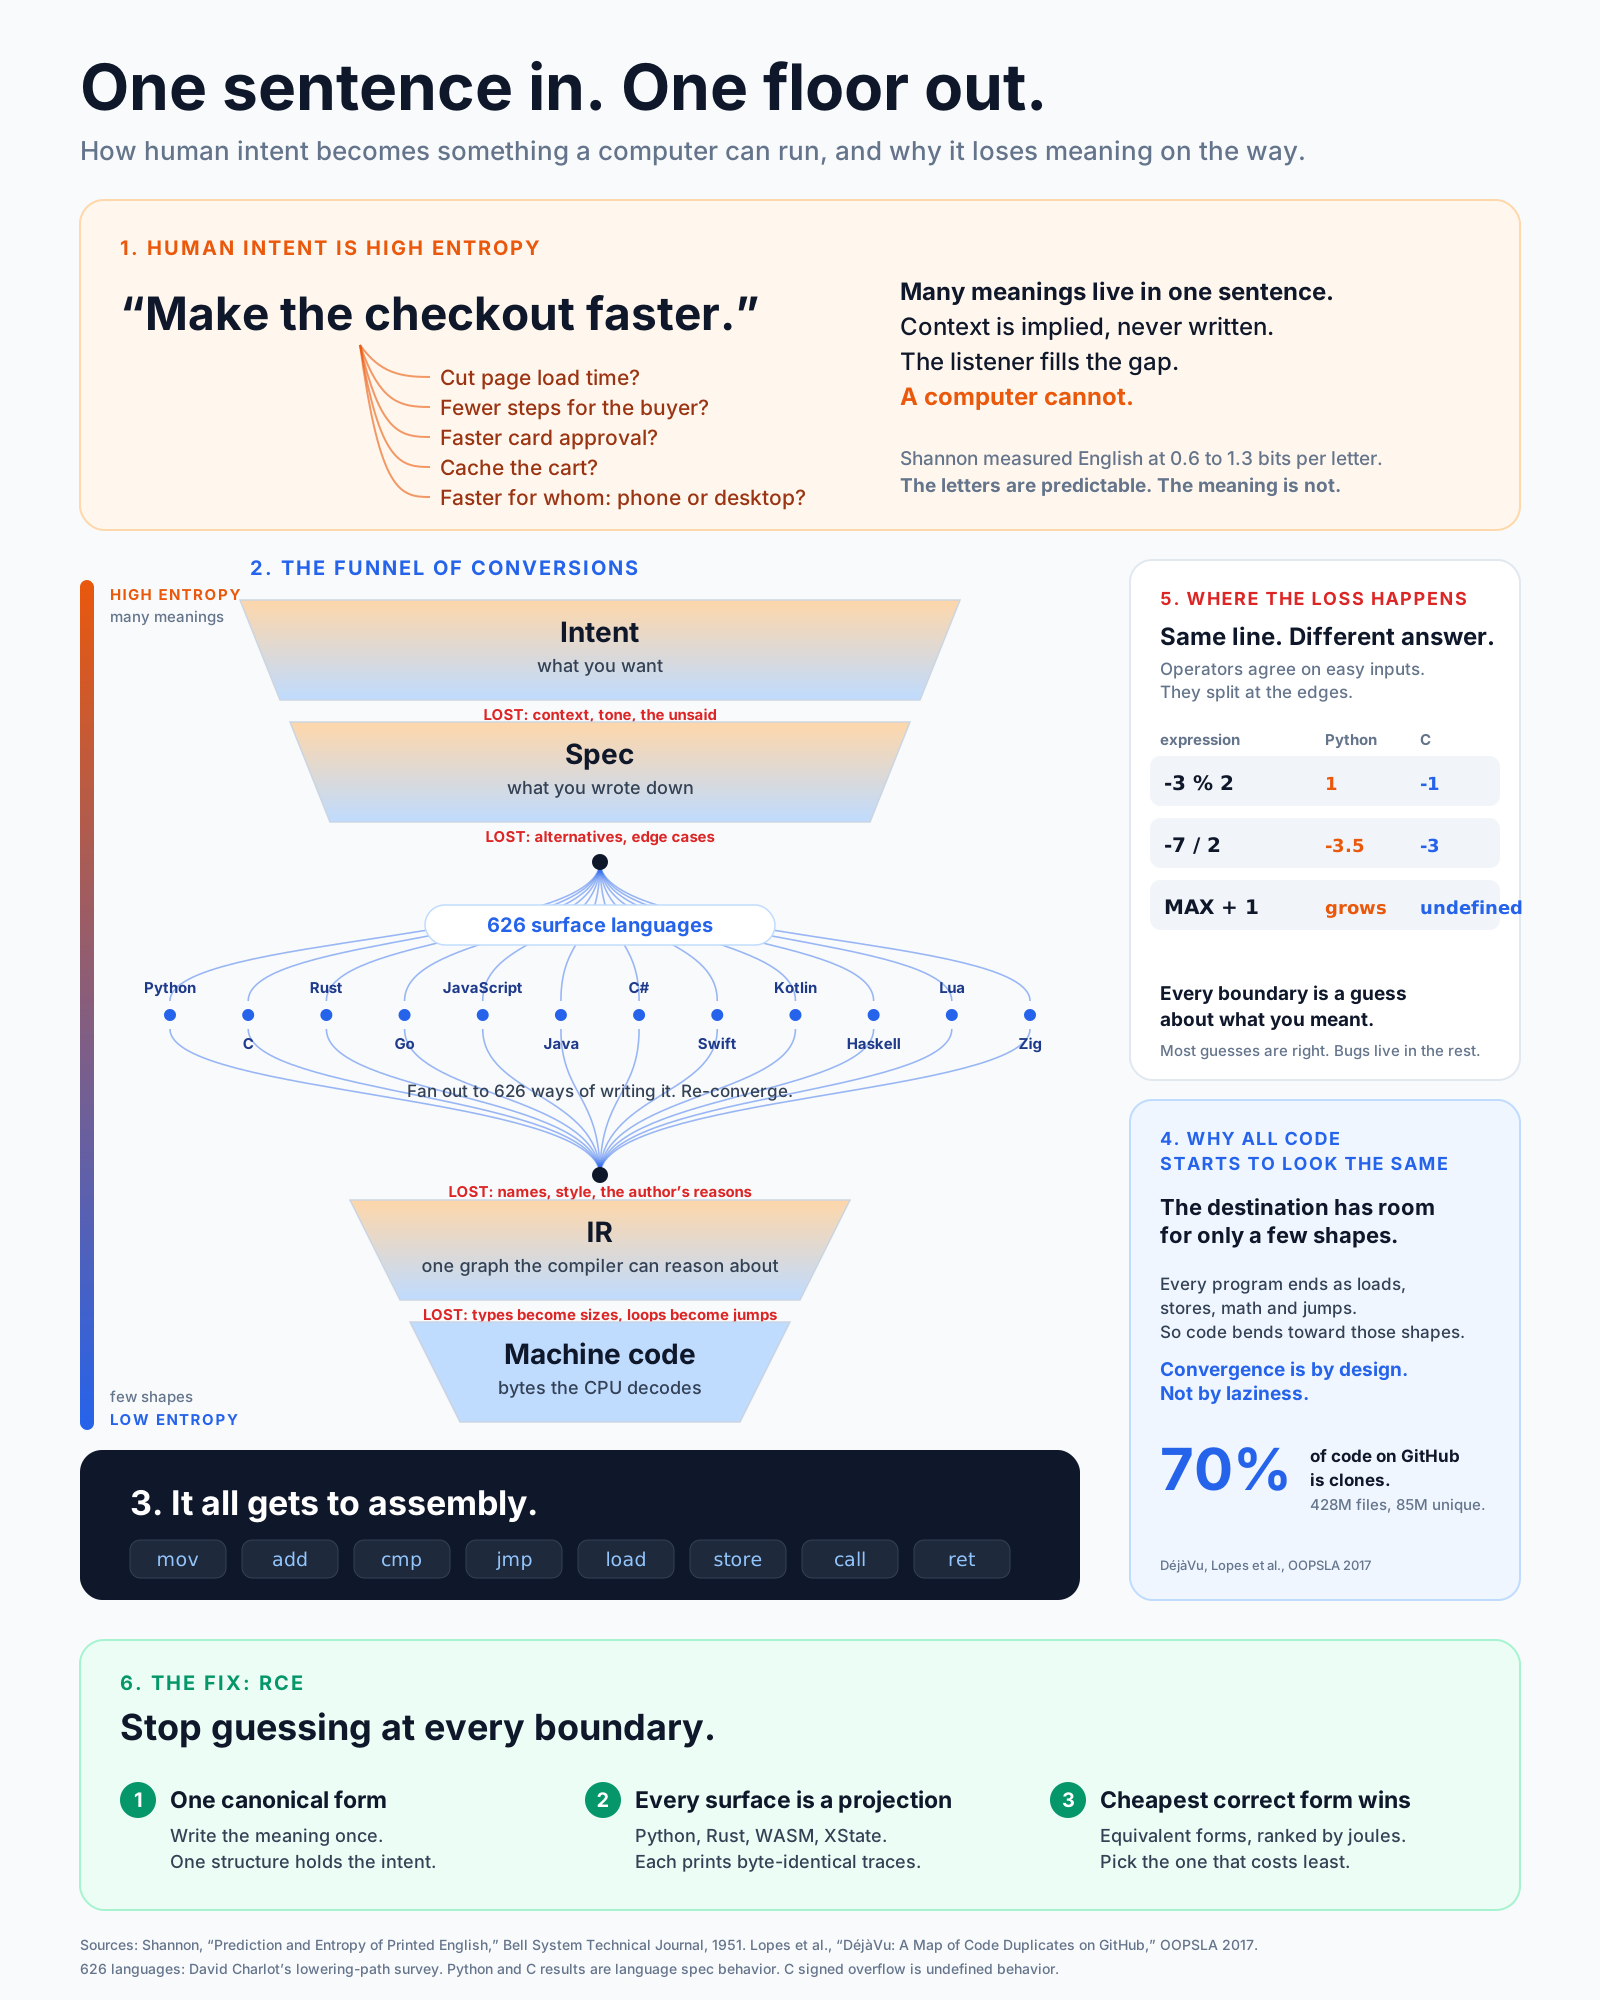
A intenção tem alta entropia. “Deixe o checkout mais rápido” carrega muitos significados: carregamento de página mais curto, menos etapas, aprovação de cartão mais rápida, um carrinho em cache, ou mais rápido numa classe de dispositivos. O contexto fica implícito e nunca é escrito. Shannon mediu o inglês impresso em cerca de 0.6 a 1.3 bits por letra [1]. As letras são previsíveis. O significado não é.
Toda conversão perde informação. A intenção vira uma especificação, e o contexto se perde. A especificação vira uma entre centenas de linguagens de superfície, e alternativas e casos de borda se perdem. O código fonte vira uma representação intermediária (IR), e nomes, estilo e as razões do autor se perdem. A IR vira código de máquina, tipos viram tamanhos e laços viram saltos.
O piso tem baixa entropia. Todo programa termina como cargas, armazenamentos, aritmética e saltos. O destino só tem espaço para poucas formas, então o código se curva em direção a elas. A convergência é por construção.
As fronteiras são onde o significado diverge. A mesma linha dá respostas diferentes nas bordas. Em Python, -3 % 2 é 1 e -7 / 2 é -3.5. Em C, -3 % 2 é -1, -7 / 2 é -3, e o estouro com sinal é indefinido. Um sistema que regenera código em cada fronteira adivinha em cada fronteira.
Os eixos, expressos como grandezas.
| Eixo | Uma ponta | A outra ponta | Onde o RCE fica |
|---|---|---|---|
| Energia por resultado correto | Paga de novo por inteiro em cada tarefa | Paga uma vez por caso novo; depois, o piso do manipulador | No piso nas tarefas cobertas |
| Entropia resolvida em tempo de execução, e determinismo | A distribuição completa do prompt, uma amostra nova a cada vez | Apenas o resíduo que nenhum ajuste armazenado cobre, uma saída determinística | Só o resíduo; toda projeção determinística |
| Força da verificação | Saída aceita após inspeção | Testes, cobertura e um certificado de prova | A porta completa em cada resultado |
| Reutilização e acumulação | Cada resultado usado uma vez | Cada ajuste aceito armazenado e reutilizado | Todo ajuste que passa pela porta é armazenado |
| Dependência de modelo | Um modelo em cada tarefa | Nenhum modelo | Um modelo só como última engrenagem |
As abordagens diferem em grau em cada eixo, e os eixos interagem: a reutilização reduz a energia e a entropia que resta resolver, e uma verificação forte é o que torna a reutilização segura. O RCE escreve o significado uma vez, numa Forma canônica. Cada linguagem de superfície é uma projeção dessa Forma, verificada para coincidir com ela. Entre formas equivalentes, roda a correta mais barata.
A Figura 2 desenha os cinco eixos e situa neles as principais classes de abordagem.
2.1 Programar é teoria da codificação
A tese desta seção é que a programação pode ser lida como teoria da codificação. Um programador converte intenção ao longo de um gradiente entre dois regimes entrópicos. A intenção tem alta entropia, uma distribuição sobre significados. O código tem baixa entropia, uma transição determinística por estado. Cada passo do trabalho de software, de um requisito a um registrador, é um passo dessa conversão. A literatura vem dizendo isso em pedaços há setenta anos, em muitas línguas. Esta seção junta os pedaços num argumento e situa nele cada engrenagem do RCE.
A medida. Shannon definiu a entropia de uma fonte e a capacidade de um canal [40], e mediu o inglês impresso em cerca de 0.6 a 1.3 bits por letra [1]. Kolmogorov, escrevendo em russo em Problemy Peredachi Informatsii em 1965, deu três abordagens para a quantidade de informação e tornou primária a algorítmica: a informação de um objeto é o comprimento do programa mais curto que o produz [41]. Solomonoff havia chegado ao mesmo objeto como teoria da inferência indutiva [42], e Chaitin mostrou que o tamanho de programas obedece a identidades formalmente idênticas às de Shannon [43]. Rissanen transformou a ideia numa regra de escolha de modelos, o comprimento mínimo de descrição [44]. Juntos, dizem que um programa é uma palavra de código: uma descrição de um comportamento, e a mais curta correta é o piso. A regra de extração do RCE, manter o ajuste de menos joules entre ajustes equivalentes (Proposição 3), é essa regra com joules no lugar de bits.
O código fica no regime de baixa entropia, e isso foi medido. Hindle, Barr, Su, Gabel e Devanbu descobriram que o código é “very repetitive, and in fact even more so than natural languages”, com menor entropia cruzada sob os mesmos modelos de n-gramas [35]. Gabel e Su descobriram que a maioria das linhas de um projeto já existe em outro lugar [34], e Lopes et al. descobriram que a maioria dos arquivos no GitHub são clones [33]. Tu, Su e Devanbu descobriram que o código também é local: o que foi escrito por perto prevê o que vem a seguir [46]. Ray e colegas descobriram que linhas com defeito são menos naturais, com entropia mais alta, e que a entropia cai quando o defeito é corrigido [45]. Em 2025, Yang, Kolak, Hellendoorn e Martins usaram a mudança de entropia que um patch induz para classificar candidatos a reparo e separar patches corretos de patches sobreajustados [51]. Allamanis, Barr, Devanbu e Sutton revisaram o campo sob o nome de naturalidade [47]. O resultado não é só de língua inglesa. Prem Devanbu o apresentou como palestra principal na India Software Engineering Conference em 2013 [50]. Sridhara, Sinha e Mani, da IBM Research India, mediram no mesmo evento os artefatos em linguagem natural ao redor do código e descobriram que as mensagens de commit são as mais regulares e que a prosa do Stack Overflow se comporta como inglês comum [49]. Na China, o Journal of Software (软件学报) publicou em 2022 uma revisão da pesquisa sobre naturalidade de código, que apresenta a medida de entropia cruzada e o achado de que código defeituoso tem entropia mais alta [48]. No Japão, Doi, Higo, Arima, Shimonaka e Kusumoto, da Universidade de Osaka, usaram a naturalidade por n-gramas, primeiro num relatório técnico do IEICE em japonês e depois no ICPC 2018, para distinguir arquivos fonte gerados por máquina dos escritos por pessoas [73, 74]. Código gerado fica ainda mais baixo na escala de entropia do que código humano, porque um gerador é uma conversão fixa. No Brasil, a tese de doutorado de Arrebola construiu sugestão de código sobre modelos de n-gramas e de tópicos segmentados por projeto e mantenedor, e a avaliou pela entropia cruzada, os bits necessários para codificar o próximo token [75]. Os dois regimes são visíveis num só repositório: a prosa ao redor do código tem alta entropia, e o código tem baixa.
A medida importa. Febres, Jaffé e Gershenson, trabalhando a partir da Venezuela e do México, compararam textos em inglês, em espanhol e de programas pela diversidade de vocabulário por comprimento de mensagem e acharam o texto de programa mais diverso [76]. Rahman, Palani e Rigby descobriram que grande parte da previsibilidade de n-gramas do código vem de tokens de sintaxe, e que o código continua repetitivo, menos do que se relatou de início, depois que eles são removidos, sendo o uso de APIs a parte mais repetitiva [77]. Os dois resultados afiam a afirmação em vez de invertê-la. Diversidade de símbolos não é previsibilidade, e o regime de baixa entropia é uma propriedade da distribuição condicional do próximo passo, que é o que uma transição determinística fixa. Por isso o G0 do RCE se orienta por formas, não por tokens de superfície.
A intenção fica no regime de alta entropia. Zave e Jackson mostraram que um requisito é uma afirmação sobre o ambiente, uma especificação é uma afirmação na interface, e a lacuna entre eles só é preenchida por conhecimento de domínio que muitas vezes não está escrito [64]. Brooks dividiu a dificuldade do software em essência e acidente: a essência é o construto conceitual, e a maior parte dela é especificação e projeto, não representação [61]. Naur argumentou que um programa é a parte visível de uma teoria mantida por seus programadores, e que a teoria não é totalmente recuperável a partir do texto [62]. Lidos através de Shannon, os três dizem a mesma coisa. A intenção carrega mais incerteza do que qualquer programa isolado, e escrever o programa é o ato que a remove. O que resta na cabeça de um programador depois que o código é escrito é a parte da intenção que o código não codificou.
A conversão é um refinamento, e refinar é estreitar. Hoare deu aos programas uma lógica na qual um programa é correto em relação a uma pré e uma pós-condição [54]. Wirth ensinou o refinamento passo a passo: decompor uma tarefa em instruções por decisões sucessivas, cada uma fixando uma escolha que a especificação deixou em aberto [53]. Os comandos guardados de Dijkstra tornaram explícitas as escolhas abertas como não determinismo e derivaram programas a partir de especificações ao removê-lo [52]. Em Munique, o projeto CIP de Bauer e Wössner construiu o desenvolvimento de programas como uma sequência de transformações que preservam a correção, da especificação ao programa [58]. Na França, o método B de Abrial e depois o Event-B levaram o refinamento à escala industrial, com obrigações de prova em cada passo [55, 56]. Na Finlândia, Back e von Wright deram ao refinamento seu cálculo baseado em teoria dos reticulados [57]. Em cada caso, uma especificação denota um conjunto de comportamentos aceitáveis e cada passo de refinamento encolhe o conjunto, até restar um único comportamento determinístico. Isso é redução de entropia com uma prova em cada passo. A Forma do RCE é o último elemento dessa cadeia: uma transição total e determinística sobre estados de banco de dados, com toda escolha resolvida (§3.2).
A síntese é uma busca que estreita um espaço de hipóteses. O FlashFill de Gulwani aprende um programa de cadeias de caracteres a partir de poucos exemplos de entrada e saída, representando o conjunto de todos os programas consistentes e intersectando-o com cada novo exemplo [59]. Gulwani, Polozov e Singh enquadram a síntese de programas em geral como busca num espaço de programas restrito pela intenção [60], e o sketching de Solar-Lezama preenche lacunas num programa parcial com um solucionador [27]. Cada exemplo ou restrição é uma medição que remove hipóteses. A medida de Shannon conta quantas medições desse tipo são necessárias. O G2 do RCE é essa engrenagem.
O que a conversão produz tem uma forma. Gurevich provou que todo algoritmo sequencial é capturado por uma Abstract State Machine no seu próprio nível de abstração [2]. Codd fez do estado uma relação [5], e o event sourcing faz do estado a dobra de um log somente de acréscimo [14]. Segundo Curry e Howard, uma prova é um programa e uma proposição é um tipo [18, 72], então um ajuste verificado é uma prova da sua especificação. Essas são as razões pelas quais o regime de baixa entropia tem poucas formas: o destino é uma máquina de estados sobre um banco de dados, seja qual for a linguagem de superfície.
A baixa entropia decai sem uma porta. Lehman observou, ao longo de décadas de grandes sistemas, que um programa em uso precisa continuar mudando e que sua complexidade cresce a menos que se trabalhe para reduzi-la [63]. Torres, Baltes, Treude e Wagner mediram a entropia estrutural e textual nos históricos de commits de 25 projetos e descobriram que as duas sobem juntas [78]. A entropia volta do ambiente para o código. Um sistema que mantém o código no regime de baixa entropia precisa de uma porta em cada alteração, e a porta do RCE é a correção (§4.3).
Compiladores já fazem codificação de fonte. Franz e Kistler distribuíram programas como árvores sintáticas abstratas comprimidas e geraram código nativo no carregamento, o que é codificação de fonte de um programa sobre a sua própria gramática [67]. Fraser inferiu modelos estatísticos de código a partir de um corpus para comprimi-lo [68]. Futamura mostrou em 1971, na revista japonesa Systems, Computers, Controls, que especializar um interpretador para um programa produz um programa compilado, e que especializar o especializador produz um compilador [70]. Ershov, em Novosibirsk, desenvolveu a mesma ideia como computação mista [71]. A interpretação abstrata dos Cousot computa uma descrição correta e com menos informação de todo comportamento de um programa [69]. A analogia com a codificação de canal é a leitura deste artigo, não um teorema citado: tipos, testes e provas acrescentam redundância verificada para que um programa errado seja detectado antes de rodar, como uma verificação de paridade detecta uma palavra corrompida.
É no apagamento que os joules vão. Landauer mostrou que um passo logicamente irreversível, o apagamento de um bit, dissipa pelo menos [65]. Bennett mostrou que a computação pode, em princípio, ser tornada logicamente reversível, de modo que o apagamento, e não a computação, carrega o limite [66]. Converter intenção de alta entropia num programa de baixa entropia descarta toda alternativa que a intenção permitia. Esse descarte é um apagamento de informação sobre as alternativas, e tem um piso termodinâmico. O RCE paga o descarte uma vez por caso novo e armazena o resultado, de modo que um caso repetido não apaga nada novo.
2.2 Como o RCE converte, e onde fica cada engrenagem
Lida como teoria da codificação, uma tarefa chega como uma mensagem cuja incerteza restante é o que nenhum ajuste armazenado já resolve. Cada engrenagem remove incerteza a um preço diferente, e as engrenagens são ordenadas por esse preço (§4.2).
| Engrenagem | O que faz com a incerteza | Linhagem no argumento acima |
|---|---|---|
| G0 Consulta | Reconhece que a intenção já foi codificada; resolve-a por recuperação, no piso do manipulador | Repetitividade e clones [33, 34, 35]; localidade [46] |
| G1 Regras | Aplica uma reescrita guardada conhecida; resolve um resíduo recorrente sem busca | Transformação que preserva a correção [52, 58]; refinamento com obrigações de prova [55, 56] |
| G2 Síntese | Busca num espaço de hipóteses e o estreita com exemplos, restrições e um solucionador | Síntese de programas como busca [27, 59, 60] |
| G3 a G5 Modelos | Amostra de uma distribuição aprendida sobre código quando nenhuma engrenagem inferior fecha a lacuna; apenas como proponente | Modelos de código por entropia cruzada [35, 47] |
| Porta | Aceita um candidato só com testes, cobertura e um certificado de prova | Lógica de Hoare [54]; Curry-Howard [18, 72] |
| Promoção | Armazena o ajuste aceito, de modo que o mesmo resíduo custe G0 da próxima vez | Comprimento mínimo de descrição [44]; apagamento de Landauer pago uma vez [65] |
As posições nos eixos da Seção 2 diferem em onde a conversão é paga. Uma abordagem que amostra a distribuição completa do prompt em cada tarefa paga o lado de alta entropia de novo a cada vez. Uma abordagem que armazena e reutiliza ajustes aceitos paga só o resíduo, e só uma vez. A maioria dos sistemas fica entre essas pontas, e o RCE fica na ponta da reutilização.
2.3 O ecossistema com N grande
A afirmação da §1 é medida diretamente. O benchmark foi pré-registrado antes da execução (bench/ecosystem/PREREG.json). Um gerador com semente escreve 10,000 Formas, cada uma com uma fonte, uma regra cujo corpo é um termo aritmético aleatório de profundidade até 3 sobre oito operadores, e um sumidouro. O motor está congelado no commit a079967 e nenhum modelo é chamado.
| Propriedade | O que é verificado em cada Forma | N | Válidas | Chamadas a modelo |
|---|---|---|---|---|
| Codificação sem perdas | Form IR para JSON canônico, para Form IR, para JSON canônico é a identidade | 10,000 | 10,000 | 0 |
| Projeção determinística | Duas compilações dão os mesmos bytes, e as projeções XState e SCXML da Forma original e da Forma após a ida e volta coincidem byte a byte | 10,000 | 10,000 | 0 |
| Projeção fiel, Python | O módulo Python gerado emite o traço de referência byte a byte em 40 eventos com semente | 10,000 | 9,999 | 0 |
| Porta no ponto de entrada, entradas | Cinco cargas malformadas (tipo errado, nulo, campo ausente, vazio, aninhado) são todas rejeitadas, e nenhuma resulta aceita | 10,000 | 10,000 | 0 |
| Porta no ponto de entrada, especificações | Uma especificação com um fluxo para um nó não declarado é rejeitada antes da compilação | 10,000 | 10,000 | 0 |
A Figura 3 mostra as mesmas contagens.
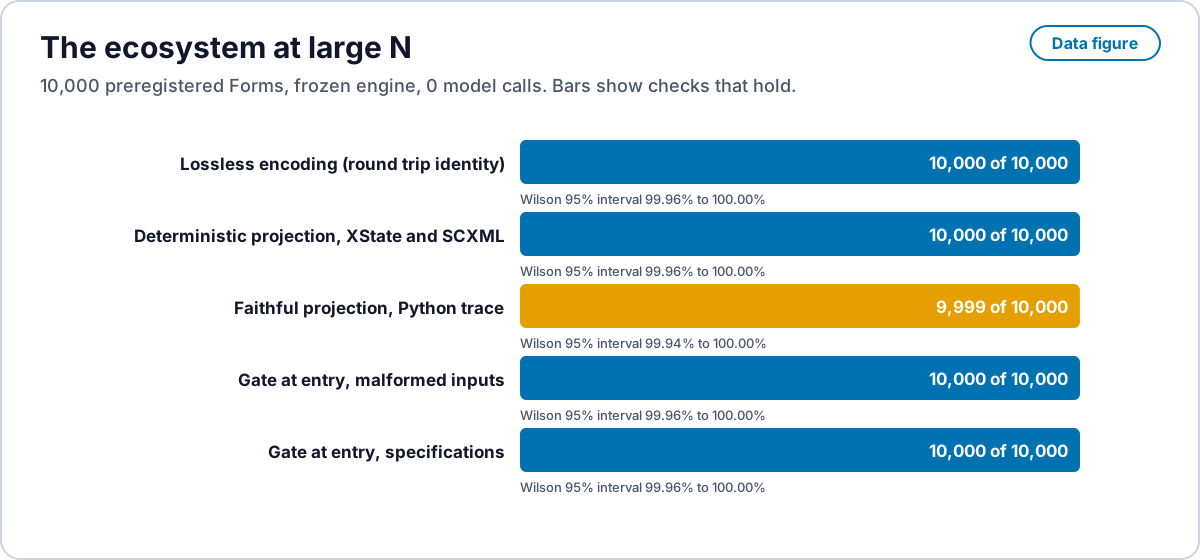
a079967, 0 chamadas a modelo, com intervalos de Wilson de 95% calculados a partir das contagens. Fonte: bench/ecosystem. Há uma cópia em PNG. Open full size · PNG
RCE-F0 e a divergência em Python. A Seção 9 enuncia o RCE-F0 assim: numa execução pré-registrada de pelo menos 10,000 Formas, alguma projeção emite um traço diferente do traço de referência da Forma, ou alguma entrada malformada é aceita. Esta execução é pré-registrada, tem 10,000 Formas, e um módulo Python gerado não emitiu o traço de referência, então a observação, tal como está escrita, satisfaz a condição do RCE-F0. O artigo relata a divergência e o teste de regressão abaixo, e não dá uma causa raiz. Leia o texto do RCE-F0 tal como está enunciado: a afirmação que ele derruba é a de que as projeções são fiéis, e a projeção Python desta execução não cumpriu essa afirmação em uma Forma. Se a divergência vem do emissor ou do harness fica em aberto aqui. O fato de a mesma Forma se reproduzir de forma idêntica sob 32 sementes de hash não resolve a questão.
A única divergência em Python é contada como divergência; a mesma Forma e os mesmos eventos se reproduzem de forma idêntica sob 32 sementes de hash no teste de regressão tests/form_ecosystem_regress.rs. A energia aqui é apenas est_j; a execução completa levou 393 s de CPU em um núcleo. As Formas geradas são pequenas, então a tabela mede a codificação, as projeções e a porta; as Formas elevadas de programas reais são medidas pelo protocolo da §8.7.
2.4 Automelhoria recursiva com porta e verificada
Good (1965) [111] definiu a máquina ultrainteligente como uma capaz de projetar máquinas melhores, de modo que a melhoria se tornaria recursiva. Yudkowsky (2013) [113] formulou a questão como uma questão de retornos: se cada unidade de melhoria torna a próxima mais barata ou mais cara. A máquina de Gödel de Schmidhuber (2007) [112] deu uma resposta formal com garantia: um programa reescreve qualquer parte de si mesmo, inclusive sua própria busca, somente depois de provar que a reescrita melhora sua utilidade esperada. O teorema de Löb (1955) [114] é o obstáculo que um provador que confia em si mesmo encontra, que Yudkowsky e Herreshoff (2013) [115] chamaram de obstáculo de Löb: um sistema não pode, em geral, provar a solidez de um sucessor que usa seu próprio sistema de prova. Sistemas recentes abandonam a exigência de prova e selecionam por pontuação medida: STOP (Zelikman et al., 2023) [116] melhora o andaime que melhora o código, a Darwin Gödel Machine (Zhang et al., 2025) [117] mantém um arquivo de agentes de programação automodificados escolhidos pela pontuação em benchmark, AlphaEvolve (Novikov et al., 2025) [118] faz evoluir programas sob avaliadores automáticos, e Voyager (Wang et al., 2023) [119] faz crescer uma biblioteca de habilidades verificadas que tarefas posteriores reutilizam.
O RCE toma a estrutura da máquina de Gödel e a biblioteca do Voyager, com duas diferenças que evitam o obstáculo para os objetos que ele promove. Primeiro, o objeto que melhora não é o provador. O RCE promove manipuladores, reescritas e engrenagens, e cada um é verificado contra um núcleo fixo e certificado à parte: os harnesses do Kani e a codificação SMT nunca mudam com a promoção, então nenhum passo precisa confiar no sistema de prova de um sucessor. Segundo, a porta é uma prova de correção na fronteira, não uma pontuação. Uma pontuação pode subir enquanto uma suposição de interface se rompe; uma prova na fronteira não pode ser atravessada por uma mudança que a rompe.
Proposição R1 (correção monótona). Se toda mudança promovida passa na verificação de sua fronteira, e as verificações das demais fronteiras não mudam, então toda propriedade estabelecida por essas verificações antes da promoção continua valendo depois dela.
Proposição R2 (acúmulo). Seja uma carga de trabalho um multiconjunto de tarefas e seja um manipulador promovido que fecha toda tarefa do seu formato. Então o número de escaladas na rodada t é não crescente em t, e uma correção promovida antes da rodada 1 reduz as escaladas acumuladas de todo horizonte pelas escaladas que ela fecha em cada rodada posterior. Na carga de trabalho de referência da demo do motor, as escaladas acumuladas ao longo de oito rodadas caem de 21 para 15 com uma correção nos sumidouros, e chegam a zero na última rodada nos dois casos, com toda tarefa fechada corretamente e nenhuma promoção recusada.
A Figura 4 desenha o mecanismo das Proposições R1 e R2 com os totais da carga de trabalho de referência.
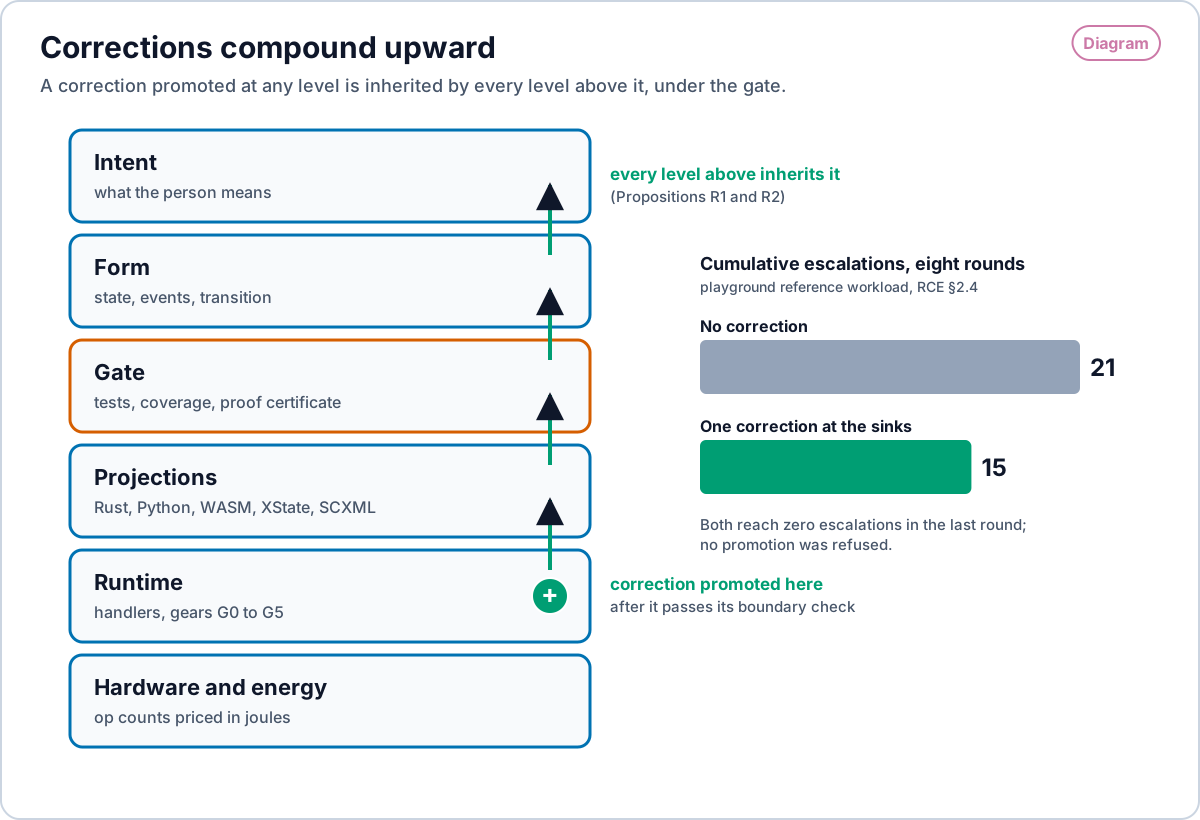
Proposição R3 (custo decrescente). Como um manipulador promovido é executado no lugar de uma chamada a modelo, e seu custo é a contagem de operações do manipulador precificada pela tabela do substrato, a energia de uma rodada cai em direção à energia dos manipuladores sozinhos à medida que as escaladas caem em direção a zero.
As projeções de Futamura (1971, republicadas em 1999) [120] e a supercompilação de Turchin (1986) [121] dão o limite desse processo. Especializar um interpretador para um programa produz um programa compilado; especializar o especializador produz um compilador. As promoções do RCE especializam o caminho geral de escalada para os formatos que de fato ocorrem, de modo que o motor converge para o programa residual de sua carga de trabalho: a parte da computação que um modelo ou uma pessoa ainda precisa fornecer. A automelhoria recursiva sob uma porta é essa convergência, feita com passos verificados. A camada Compounding da demo do motor do RCE executa essa carga de trabalho no navegador.
3. A Forma
3.1 A afirmação formal mais forte de “mesma forma”
Primeiro se declara o alcance do teorema. Os postulados sequenciais de Gurevich cobrem algoritmos sequenciais; algoritmos paralelos e interativos precisam dos postulados adicionais de Blass e Gurevich [3]. Blass, Dershowitz e Gurevich argumentam que nenhuma relação de equivalência única sobre algoritmos serve a todos os propósitos [79], e Moschovakis e Vardi expõem o debate sobre o que é um algoritmo [80, 81]. Um manipulador web que faz entrada e saída fica fora do teorema sequencial. A Forma trata a interação como a linha interativa faz: cada entrada é um evento em , e a máquina de estados dá um passo sobre ele. Assim, “uma Forma” é uma escolha de modelagem fundada no teorema sequencial e estendida por convenção, com precedentes em produção na arquitetura Elm [83], nos históricos de eventos de workflows duráveis [84] e em semânticas de fluxo como Flo [82]. As proposições da Seção 3.4 são enunciadas para essa escolha.
O teorema de Gurevich sobre Abstract State Machines (ASM) é a afirmação formal mais forte de que todo algoritmo tem uma forma [2]. Uma máquina de estados abstrata é uma máquina cujos estados são estruturas de primeira ordem e cujo passo é um conjunto finito de atualizações guardadas. Gurevich enuncia três postulados. Tempo Sequencial: um algoritmo tem estados, estados iniciais e um mapa de um passo . Estado Abstrato: os estados são estruturas de primeira ordem sobre um vocabulário fixo, fechadas sob isomorfismo. Exploração Limitada: um conjunto finito de termos decide cada passo. Seu Teorema Principal (Theorem 6.13) diz: “For every sequential algorithm A, there exists an equivalent sequential abstract state machine B.” Blass e Gurevich o estendem a algoritmos paralelos [3]. Dershowitz e Gurevich acrescentam um quarto axioma, o de que as operações iniciais são computáveis, e dele derivam a tese de Church [4].
3.2 Definições
Definição 1 (a Forma). Um programa é uma tupla
- , o espaço de estados: estruturas sobre um vocabulário fixo , divididas em regiões de controle e dados . contém o relógio lógico, a contagem de entradas e as relações tipadas (na linguagem, também as regiões declaradas). Cada estado é uma instância de banco de dados no sentido de Codd [5].
- , o alfabeto de eventos, incluindo o tique do relógio lógico.
- , a transição: total, determinística e pura, escrita como um conjunto finito de atualizações guardadas “if then ”, em que cada passo lê um conjunto limitado de posições. Ela devolve o próximo estado e as saídas do passo. Escreva para a sua componente de estado.
- , o log durável: uma sequência de entradas , em que é o SHA-256 do JSON canônico do estado após o passo, é o SHA-256 do JSON canônico dos quatro primeiros campos, e o primeiro são 64 zeros. O log é uma cadeia de hashes, de modo que mudar qualquer entrada passada muda todo posterior.
- , o mapa de saída. Uma máquina de Mealy lê os dois argumentos [6]; uma máquina de Moore lê só o estado [7].
Definição 2 (Forma e ajuste). A forma é o formato da tupla com quatro invariantes: é determinística e pura; a exploração é limitada; o vocabulário é fixo; o estado é a dobra do log,
Um log também pode carregar o resultado, as saídas e o estado de cada entrada. Esses campos são derivados: não entram no hash e devem ser iguais ao replay (T1 e T3 da §3.7). Dois tipos de rejeição são distintos. No perfil do motor todo evento é aplicado, e uma entrada que falha no seu contrato produz uma saída reject e uma linha de erro. Na linguagem, um evento recusado deixa o estado inalterado (T8) e é registrado como recusado.
O ajuste são os dados que completam o formato: o vocabulário , os alfabetos e , o programa de regras que define , as regras de saída que definem e os dados iniciais . Nos termos de Gurevich, o ajuste é o vocabulário, o programa ASM e as estruturas iniciais. Nos termos de Codd, é o esquema e é a instância. Em termos de linhas de produto, um ajuste é uma seleção de características [8]. Em termos de síntese guiada por sintaxe (SyGuS), um ajuste é um termo de uma gramática que satisfaz uma especificação [9].
Definição 3 (equivalência de ajustes). Dois ajustes são equivalentes quando, para toda sequência de eventos , suas sequências de saída sob são iguais.
Definição 4 (linguagem de ajuste). Uma gramática cujos termos denotam ajustes. Linguagens de programação, documentos SCXML, configurações XState e especificações .rce são linguagens de ajuste. Uma linguagem de ajuste é completa quando todo programa ASM sobre tem um termo nela.
Definição 5 (projeção de controle). Divida em símbolos de controle finitos e relações de dados. O statechart de é a projeção de sobre : os estados são valores de , as transições carregam um evento e uma guarda sobre , e as ações são atualizações de . Os statecharts de Harel dão a hierarquia e as regiões ortogonais [10].
Definição 6 (e-graph de ajuste). Para um ajuste e um conjunto de reescritas corretas, o e-graph de ajuste é o e-graph saturado dos termos de regra de sob [11, 12]. Cada e-classe contém ajustes equivalentes pela Definição 3.
Definição 7 (custo em joules). é a energia estimada (est_j) para executar o termo uma vez num substrato nomeado, ponderada pelo número esperado de execuções.
3.3 Por que “máquina de estados funcional de banco de dados”
Uma estrutura relacional finita é uma instância de banco de dados, então um estado de Gurevich é um banco de dados e cada passo é uma transação limitada. Banco de dados: é uma estrutura relacional. Funcional: e são puras. Máquina de estados: as execuções são dobras de sobre eventos. Moseley e Marks traçam a mesma linha na arquitetura [13]. O event sourcing a traça no estado da aplicação: “Capture all changes to an application state as a sequence of events” [14]. Dedalus a traça na lógica, em que o estado mutável é uma relação indexada pelo tempo [15].
3.4 Proposições
Proposição 1 (a Forma captura todo algoritmo sequencial). Para todo algoritmo sequencial existe uma instância da Forma cujas execuções são as execuções de .
Esboço de prova. O Theorem 6.13 dá uma ASM com os estados, os estados iniciais e o mapa de um passo de . Tome , , e a identidade. A dobra após tiques é . Pelo Corolário 3.3 de Gurevich, e têm as mesmas execuções. ∎
Proposição 1b (programas interativos). Estenda com um símbolo de entrada de aridade zero, definido como antes de cada passo; então é um algoritmo sequencial sobre o vocabulário estendido, e a Proposição 1 se aplica. A construção é nossa.
Proposição 1c (computabilidade). Sob o axioma de Dershowitz e Gurevich, toda instância da Forma computa uma função Turing-computável [4, 16, 17]. A Forma não acrescenta poder. Ela dá a todo programa da classe uma forma.
Proposição 1d (provas são ajustes). “For each proof of a given proposition, there is a program of the corresponding type” [18]. Um tipo é uma especificação, e uma prova é um ajuste que a satisfaz. A porta da correção é a existência dessa prova ou de um teste de aceitação aprovado.
Proposição 2 (um gerador). Uma função gera um programa executável para todo ajuste e não lê nenhum domínio. Base: todo programa é uma instância da Forma, então emite um armazenamento tipado, um tipo de evento, regras compiladas, um log com uma dobra e um despachante de saída. Geradores de esqueleto como os geradores do Rails, o JHipster e o Yeoman são restrito a pequenas linguagens de ajuste. A engenharia de linhas de produto parte de “the systematic discovery and exploitation of commonality across related software systems” [8]; o que é comum é a Forma.
Proposição 3 (extração de menor energia). A extração com devolve o termo de menos joules que o extrator encontra na e-classe de . Esboço de prova. As reescritas são corretas, então todo termo da e-classe tem o comportamento observável de e passa pela mesma porta. A extração minimiza o custo, e o custo é em joules. ∎ Isso é Mixture of Limits aplicado a código: manter o ajuste mínimo que faz a tarefa, e o resto é desperdício.
Proposição 4 (determinismo do replay). Se não lê relógio de parede, ordena atualizações sem nomes e registra toda entrada, dois replays do mesmo dão hashes de estado idênticos em todo passo.
Proposição 5 (a projeção em statechart é correta). Projete cada estado de uma execução sobre . O resultado é uma execução do statechart emitido sob os mesmos eventos.
Proposição 6 (orçamento de coordenação). Regras marcadas como monotônicas rodam em réplicas sem coordenação; só regras não monotônicas precisam de um ponto de coordenação. Base: o teorema CALM, “the programs that have consistent, coordination-free distributed implementations are exactly the programs that can be expressed in monotonic logic” [19].
A marca é derivada da regra, nunca declarada, e a verificação da IR recusa uma Forma cuja marca armazenada difere da derivada (especificação, Apêndice D.5):
| A regra tem | Marca | Motivo |
|---|---|---|
| nenhum resolve, read, join ou scan | monotônica | suas escritas só acrescentam chaves e fazem crescer contadores |
| um resolve | não monotônica | apaga linhas de escalada |
| um read do seu próprio sumidouro | não monotônica | ler, modificar, escrever |
| um join por chave | não monotônica | a linha juntada pode estar ausente agora e presente depois, ou ser sobrescrita |
| um scan | não monotônica | observa a relação inteira, inclusive o que está ausente |
A marca é correta e não completa: um join contra uma relação somente de inserção seria monotônico, mas o perfil não prova que uma relação é somente de inserção, então a marca não o afirma. Uma Forma é livre de coordenação quando toda regra é monotônica. Todo read, join e scan vê o estado na entrada do evento, de modo que o pós-estado de um evento de entrada não depende da ordem em que rodam as regras de sumidouros diferentes; só a ordem das saídas depende dela, e essa ordem é fixada pelo hash do conteúdo.
Proposição 7 (inteligência como derivada em joules). Seja a contagem de tarefas que passam pela porta e os joules gastos. é lida em retrospecto a partir de , que registra todo evento e seu est_j. A extração sob mantém a porta fixa e não aumenta , então, com igual, ela não diminui .
3.5 Grafo, e-graph e statechart
| Estrutura | Parte da Forma | O que decide |
|---|---|---|
| Statechart | Guardas de sobre | Qual transição dispara |
| Grafo de fluxo de dados | Dependências de leitura e escrita de e (redes de processos de Kahn [20]) | O que roda, e em que ordem |
| E-graph | A classe de equivalência do ajuste | Qual ajuste equivalente roda |
O statechart e o grafo descrevem um ajuste. O e-graph descreve todo ajuste equivalente a ele. A extração escolhe entre eles por joules.
3.6 Um ecossistema, sem perdas, e a tese da universalidade
Sem perdas por construção. O teorema de codificação de fonte de Shannon limita qualquer código sem perdas pela entropia da fonte [40]. Uma Forma é um código sem perdas da intenção num sentido estreito e verificável: a sua serialização canônica é injetiva, de modo que duas Formas que diferem em qualquer estado, evento ou transição têm hashes de formato distintos, e decodificar a serialização devolve a mesma Forma. Cada projeção para um alvo é uma função apenas da Forma. As transformações bidirecionais tornam a ida e volta precisa. Foster, Greenwald, Moore, Pierce e Schmitt definiram uma lente como um par de funções get e put com leis de ida e volta que mantêm uma visão e a sua fonte de acordo [122], Hofmann, Pierce e Wagner estenderam as leis às lentes simétricas [123], e Czarnecki e colegas revisaram as mesmas leis de consistência na engenharia de modelos, em bancos de dados e em linguagens de programação [124]. A lei de ida e volta do RCE é a lei GetPut no nível do programa inteiro: elevar de novo uma projeção deixa o hash de formato inalterado.
Correto por construção. Dijkstra propôs em 1968 que um programa e a sua prova sejam desenvolvidos juntos, para que a correção seja incorporada ao projeto e não verificada por testes [125]. Hall e Chapman levaram o método a sistemas seguros comerciais, com uma especificação formal e um refinamento em cada etapa [126]. A regra de Minsky para a programação funcional tipada, tornar irrepresentáveis os estados ilegais, diz o mesmo no nível dos tipos: um tipo que não pode conter um valor ruim torna desnecessária a verificação desse valor [127]. A programação funcional total de Turner exige que toda função termine em toda entrada, de modo que um programa denote uma função matemática sem falhas ocultas [128]. Uma Forma do RCE é total no sentido de Turner, os seus tipos de contrato tornam irrepresentáveis os estados não declarados no sentido de Minsky, e a cadeia de refinamento da §2.1 chega a ela no sentido de Dijkstra. A consequência é a da §1: um erro é rejeitado no ponto de entrada, e assim não resta nada para comparar ou rastrear depois do fato.
A tese da universalidade. Em termos teóricos, a tese é que existe uma Forma universal. Os programas são escritos nela nativamente, toda linguagem existente é alcançável a partir dela como uma projeção fiel, e todo programa existente entra nela por elevação. A tese de Gurevich dá o fundamento: todo algoritmo sequencial é capturado passo a passo, no seu próprio nível de abstração, por uma máquina de estados abstrata [2], e o mesmo vale para os algoritmos paralelos [3]. Uma Forma é uma tal máquina sobre um estado de banco de dados.
Proposição U1 (captura). Se um programa numa linguagem é um algoritmo sequencial ou paralelo no sentido de Gurevich, existe uma Forma cuja transição o simula passo a passo no nível de abstração do programa [2, 3].
Proposição U2 (projeção fiel). Se a projeção da Forma em preserva o traço da Forma em toda entrada dentro do contrato, então a Forma e a sua projeção são intercambiáveis para qualquer observador do traço, e não acrescenta nada que falte à Forma.
Proposição U3 (elevação por construção). Toda linguagem de programação em uso tem uma gramática formal, um parser que produz uma árvore sintática concreta, uma árvore sintática abstrata e uma semântica fixada por uma especificação ou por uma implementação de referência. Uma elevação é construída em três etapas por linguagem: gramática, depois árvore sintática abstrata, depois Forma, com cada construção de recebendo uma regra da Forma de acordo com a semântica de . Uma elevação construída assim satisfaz no comportamento e no hash de formato, de modo que o par é uma lente no sentido de [122], e um programa em é mantido sem perdas como uma Forma.
Proposição U4 (substituição). Se U2 e U3 valem para uma linguagem , nenhum programa precisa ser escrito em : ele é escrito uma vez como Forma e emitido como onde a plataforma o exigir.
U1 é um teorema. U2 é verificada por alvo pelo teste diferencial (§5.1) e com N grande na §2.3. U3 é uma construção, feita linguagem a linguagem a partir da gramática; a §8.7 diz como a construção é medida à medida que é construída.
3.7 A linguagem: versões 0.6 e 0.7, custos e estado dos teoremas
A linguagem RCE é definida por uma especificação escrita, atualmente o documento do rascunho 0.7 na versão 0.8 da linguagem (/rce/spec/; fonte no repositório rce). Cada módulo seleciona a sua versão da linguagem com um comentário na primeira linha. Um módulo sem esse comentário é da versão 0.5, a linguagem das seções 2 a 10. Um módulo que declara # rce-version: 0.6 recebe também o Apêndice C: par, for ... par, with budget, grupos de trabalho, LVars, sessões e supervisores. Um módulo que declara # rce-version: 0.7 tem a linguagem da versão 0.6 com uma diferença, o custo dos métodos da biblioteca padrão abaixo (Apêndice C.15). O Apêndice D define o perfil do motor, as especificações de manipuladores e os ajustes que o motor deste artigo executa. Um módulo da versão 0.5 nunca vê o Apêndice C, então todo programa válido da versão 0.5 é aceito sem mudanças.
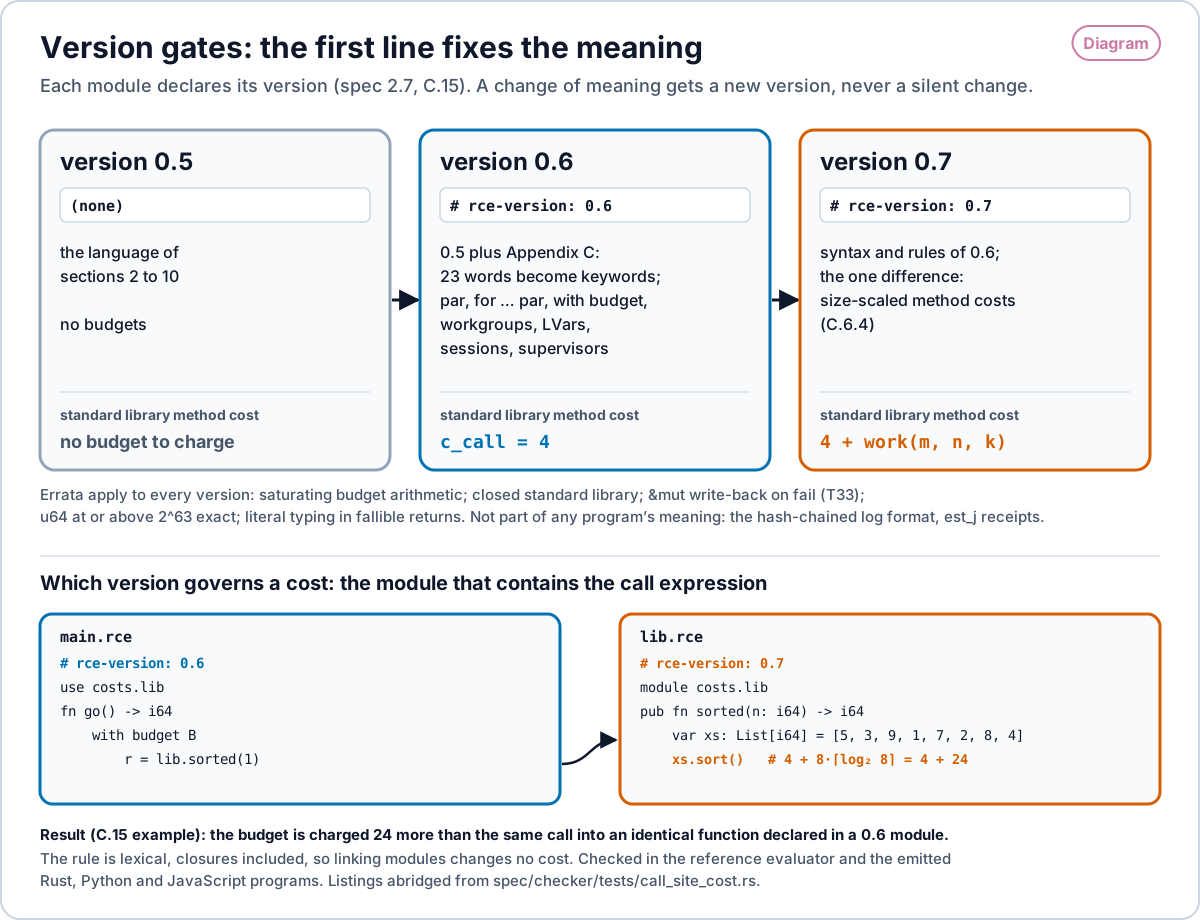
# rce-version: 0.6 acrescenta o Apêndice C (23 novas palavras-chave; par, for ... par, with budget, grupos de trabalho, LVars, sessões, supervisores), e um método da biblioteca padrão custa . # rce-version: 0.7 tem a sintaxe e as regras da 0.6 e difere apenas no custo de método, . As erratas se aplicam a todas as versões. A versão do módulo que contém a expressão de chamada governa o seu custo: uma função 0.6 sob with budget que chama uma função 0.7 importada que ordena 8 elementos é cobrada em 24 a mais do que a mesma chamada a uma função 0.6 idêntica. Fonte: especificação 2.7, C.6.4 e C.15; listagens resumidas de spec/checker/tests/call_site_cost.rs. Há uma cópia em PNG. Open full size · PNG
Os orçamentos contam trabalho. Um bloco with budget cobra de cada operação um custo fixo da tabela do Apêndice C.6.4 e interrompe a execução com a armadilha budget quando a contagem se esgota. A contagem é um indicador de trabalho, não uma medição de tempo ou de energia; est_j é separado.
| Operação | Custo |
|---|---|
| chamada de uma função do usuário ou de uma closure, | 4 |
| método da biblioteca padrão sobre um receptor de tamanho , com primeiro argumento de tamanho | 4 na versão 0.6; na versão 0.7 |
| envio ou recebimento num canal | 8 |
spawn | 32 |
um ramo de par ou um bloco de for ... par | 16 |
literal de lista ou de mapa, ou compreensão, com resultados; [x; n] | |
índice, fatia, acesso a membro; operadores unários; and, or; operadores e comparações de inteiros, booleanos e texto | 1 |
+, -, * de ponto flutuante | 2 |
/, % de ponto flutuante | 8 |
Os tamanhos são o comprimento em bytes UTF-8 de um texto, o comprimento de uma lista e o número de entradas de um mapa; qualquer outro valor tem tamanho 0. O trabalho do método é fixado pela classe de complexidade do método no avaliador de referência: para os métodos lineares sobre textos, listas e mapas (os mapas são listas de associação ordenadas), para sort (0 quando ), e 0 para os demais métodos. As chamadas que map, filter e fold fazem ao seu argumento função são cobradas adicionalmente como chamadas. A aritmética satura no maior inteiro de 128 bits, e nunca diminui quando ou cresce. O avaliador de referência e os runtimes emitidos em Rust, Python e JavaScript calculam a mesma função, e um teste verifica que a armadilha de orçamento cai na mesma operação nos quatro.
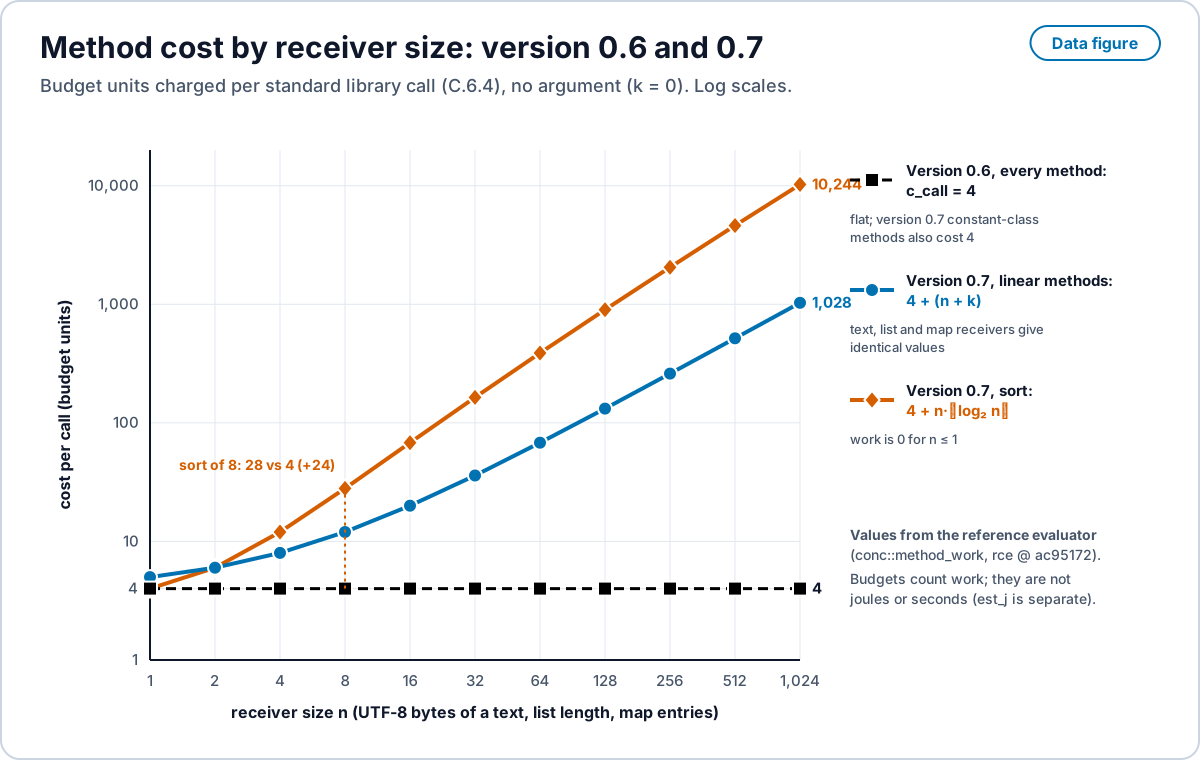
conc::method_work do avaliador de referência (rce ac95172). Há uma cópia em PNG. Open full size · PNG
Qual versão governa um custo. Um programa pode juntar módulos de versões diferentes. O custo de uma chamada de método é fixado pela versão declarada do módulo que contém a expressão de chamada, inclusive uma chamada dentro de uma closure escrita ali, e não pela versão da função executada, de quem a chama ou do primeiro módulo do programa. A regra é léxica, então ligar módulos não muda nenhum custo; a especificação 2.7 enuncia a mesma regra e remete a C.15. Testes a verificam na fronteira nas duas direções, no avaliador de referência e nos programas emitidos em Rust, Python e JavaScript: uma função 0.6 sob with budget que chama uma função 0.7 importada que ordena uma lista de 8 elementos é cobrada em 24 a mais do que a mesma chamada a uma função 0.6 idêntica.
Estado dos teoremas. A especificação enuncia os teoremas T1 a T34 e registra exatamente o estado de cada um. As provas estão em Lean 4 (v4.12.0, sem Mathlib) sobre um cálculo núcleo. As palavras usadas para o nível de um resultado são estas. Provado significa uma prova em Lean sobre a semântica núcleo da linguagem. Provado sobre uma semântica significa uma prova em Lean sobre uma semântica de pequenos passos de um núcleo do RCE. Modelo significa uma prova em Lean sobre um modelo abstrato que não está ligado à semântica do RCE nem ao avaliador de referência. Vetores significa que os resultados do avaliador de referência em programas gerados são conferidos com o modelo pelo kernel do Lean, o que é uma correspondência em amostras, não uma prova sobre o avaliador. Testado significa teste diferencial em entradas declaradas. Verificado mecanicamente significa decidido por um programa, como um construtor de tabelas LALR(1).
| Enunciado | Nível | |
|---|---|---|
| T1 | determinismo: um resultado por estado e evento; um resultado por tique da semântica de concorrência | provado |
| T2 | totalidade de , com um limite explícito de passos de avaliação; recursão estrutural e composição de limites ao longo do grafo de chamadas | provado (o núcleo de expressões em Lean não tem chamadas de funções do usuário; a recursão e a composição são provadas em modelos separados) |
| T3 | o estado de runtime é e o replay reproduz cada hash e cada saída | provado |
| T4 | progresso, incluindo tiques (alguma tarefa avança, ou a execução termina ou relata Deadlock) | provado |
| T5 | preservação, incluindo o intervalo inteiro de todo campo escrito | provado |
| T6 | segurança de memória, caminhos de empréstimo completos, nenhum compartilhamento mutável entre tarefas | provado para o núcleo de posse e para uma semântica instrumentada de caminhos de empréstimo |
| T7 | independência de nomes dos hashes do log, dos ids e das escolhas de select | provado |
| T8 | atomicidade: um evento recusado deixa o estado inalterado | provado |
| T9-F | os alvos da IR da Forma (Rust, WASM, Python, XState, SCXML) imprimem o traço de referência | testado |
| T9-L | os emissores de programas (rust, python, js) concordam com o avaliador de referência | provado para o emissor Rust sobre um núcleo, como uma tradução verificada para MiniRust, uma incorporação profunda do subconjunto de Rust emitido; que o rustc implementa MiniRust é suposto e testado; os demais emissores testados |
| T10 | a gramática não é ambígua | verificado mecanicamente (LALR(1), 0 conflitos, para as duas versões) e amostrado por um fuzzer |
| T11 | justiça do select | provado no modelo de rotação |
| T12 | um handle linear é consumido exatamente uma vez em todo caminho | provado num modelo de instruções |
| T13 | as operações f32 dão os mesmos bits em alvos que concordam com o IEEE 754 | provado para a multiplicação; para adição, subtração e divisão a propriedade de arredondamento único é o teorema de Figueroa, citado e não mecanizado |
| T14 | a aritmética u64 verificada é exata dentro do intervalo | provado |
| T15 | os iteradores terminam, respeitam o limite do laço e são consistentes com prefixos | provado |
| T16 a T31 | concorrência da versão 0.6: determinismo de par, comutação, reduções, ausência de deadlock, prazos, grupos de trabalho, relógios vetoriais, prioridades, escopos, atores, sessões, LVars, lotes atômicos, réplicas | provado sobre uma semântica: T16, T17, T19a, T20, T23; provado num modelo de execuções: T24; provado num cálculo de sessões: T28; modelo: T18, T19b, T21, T22, T25, T26, T31; modelo com vetores: T27, T29, T30. Nenhum é uma prova sobre o avaliador de referência em Rust |
| T32 | replay estrangeiro: para todo oráculo, o replay do log é igual à execução ao vivo, e um contrato de resposta vale para toda resposta registrada | provado |
| T33 | restauração de &mut em caso de falha (F.4.4): uma chamada que falha deixa o estado &mut de quem chama como estava no momento da chamada; uma chamada que retorna faz o write-back (a regra anterior de copiar para fora em todo resultado foi retirada) | provado |
| T34 | a passagem ANF que preserva a ordem antes de todo emissor dá o mesmo valor, o mesmo armazenamento e o mesmo traço de cobranças e emissões | provado para um fragmento núcleo com ANF completa; a implementação é testada diferencialmente em todo alvo, incluindo uma varredura de orçamentos através do ponto da armadilha |
T9 tem dois conjuntos de alvos porque o motor do artigo e a linguagem têm dois compiladores. T9-F é a afirmação sobre rce form --emit, que a §5.1 mede. T9-L é a afirmação sobre os emissores de programas da linguagem. Um alvo fora desses conjuntos não tem afirmação T9.
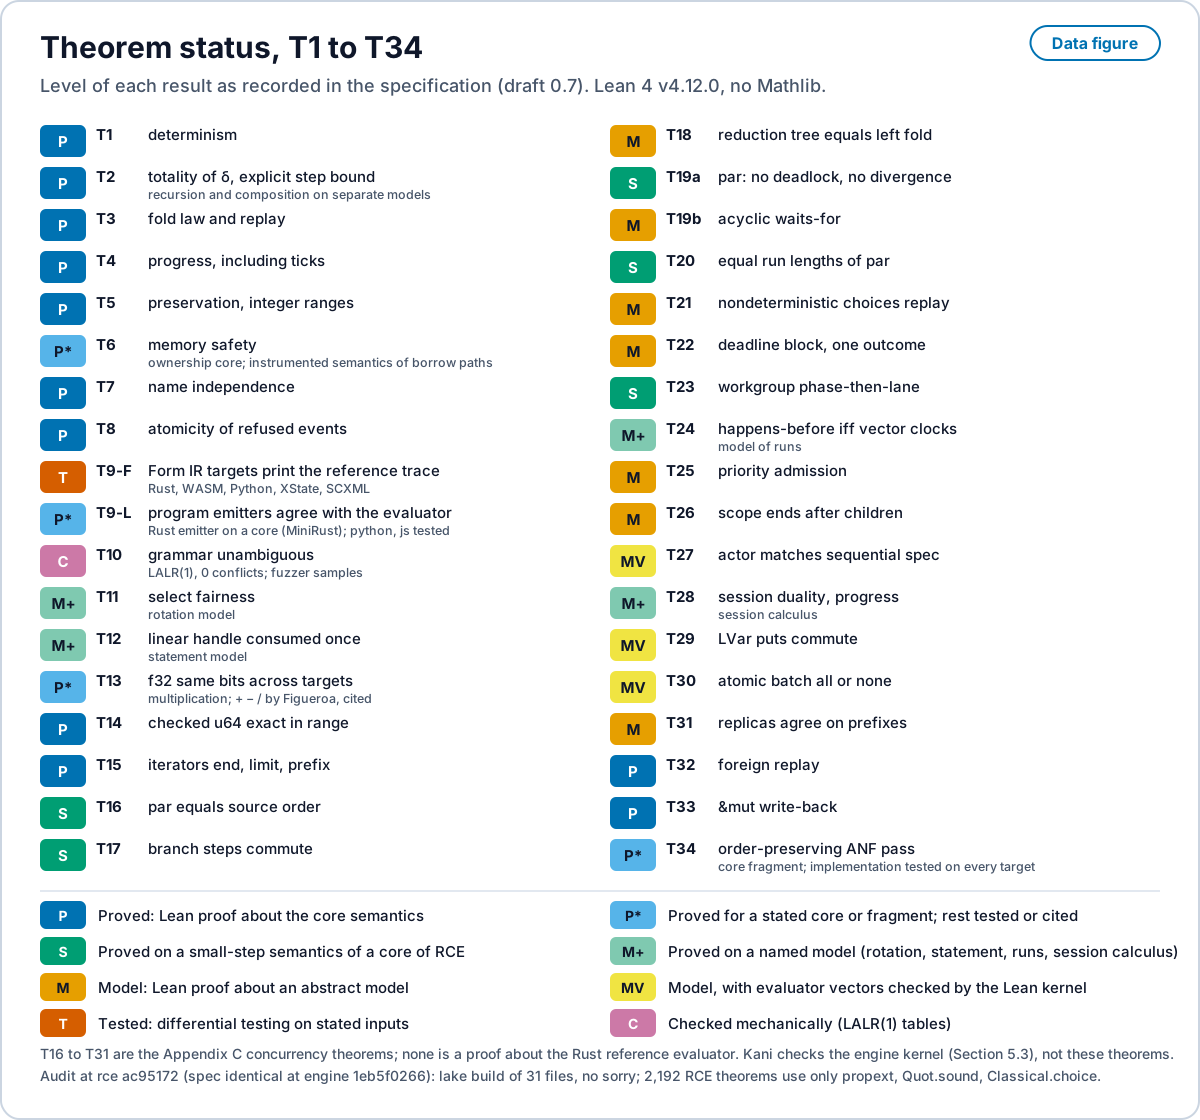
P: prova em Lean sobre a semântica núcleo. P*: provado para um núcleo ou fragmento declarado, o resto testado ou citado. S: provado sobre uma semântica de pequenos passos de um núcleo do RCE. M+: provado num modelo nomeado (modelo de rotação, modelo de instruções, modelo de execuções, cálculo de sessões). M: prova em Lean sobre um modelo abstrato. MV: modelo, com vetores do avaliador de referência conferidos pelo kernel do Lean. T: teste diferencial. C: verificado mecanicamente. T16 a T31 pertencem à versão 0.6, e nenhum é uma prova sobre o avaliador de referência em Rust. Lean 4 v4.12.0, sem Mathlib. Fonte: spec/book/10-theorems.md e Apêndice C.13. Há uma cópia em PNG. Open full size · PNG
Verificações executadas para esta versão. No commit 1eb5f02 do motor, lake build conclui sobre os 31 arquivos de spec/lean/RCE/ sem nenhum sorry (46 arquivos no 4304048 público, 58 em e416fd0), e a auditoria permanente relata que os axiomas de 2,192 constantes de teorema (a auditoria conta toda constante de teorema do núcleo; veja a nota de correções acima) são apenas propext, Quot.sound e Classical.choice. O Kani verifica 10 de 10 harnesses do núcleo (§5.3). Os testes do motor (cargo test --release) passam em 589 testes distintos com 0 falhas (2 ignorados); make check relata 596 porque a sua etapa de provas executa 7 desses testes uma segunda vez. O verificador de referência, construído a partir do repositório público tal como a sua integração contínua o constrói, passa em 56 testes na construção padrão e em 112 com as suítes das versões 0.6 e 0.7 ativadas, com 0 falhas, e em 57 com o teste de concordância do tree-sitter. A verificação da especificação constrói as tabelas LALR(1) da versão 0.5 e das versões 0.6 e 0.7, que compartilham uma gramática, com 0 conflitos, e analisa todo exemplo com três parsers, e a construção em WebAssembly do verificador passa em 401 de 401 verificações contra os corpora de exemplos.
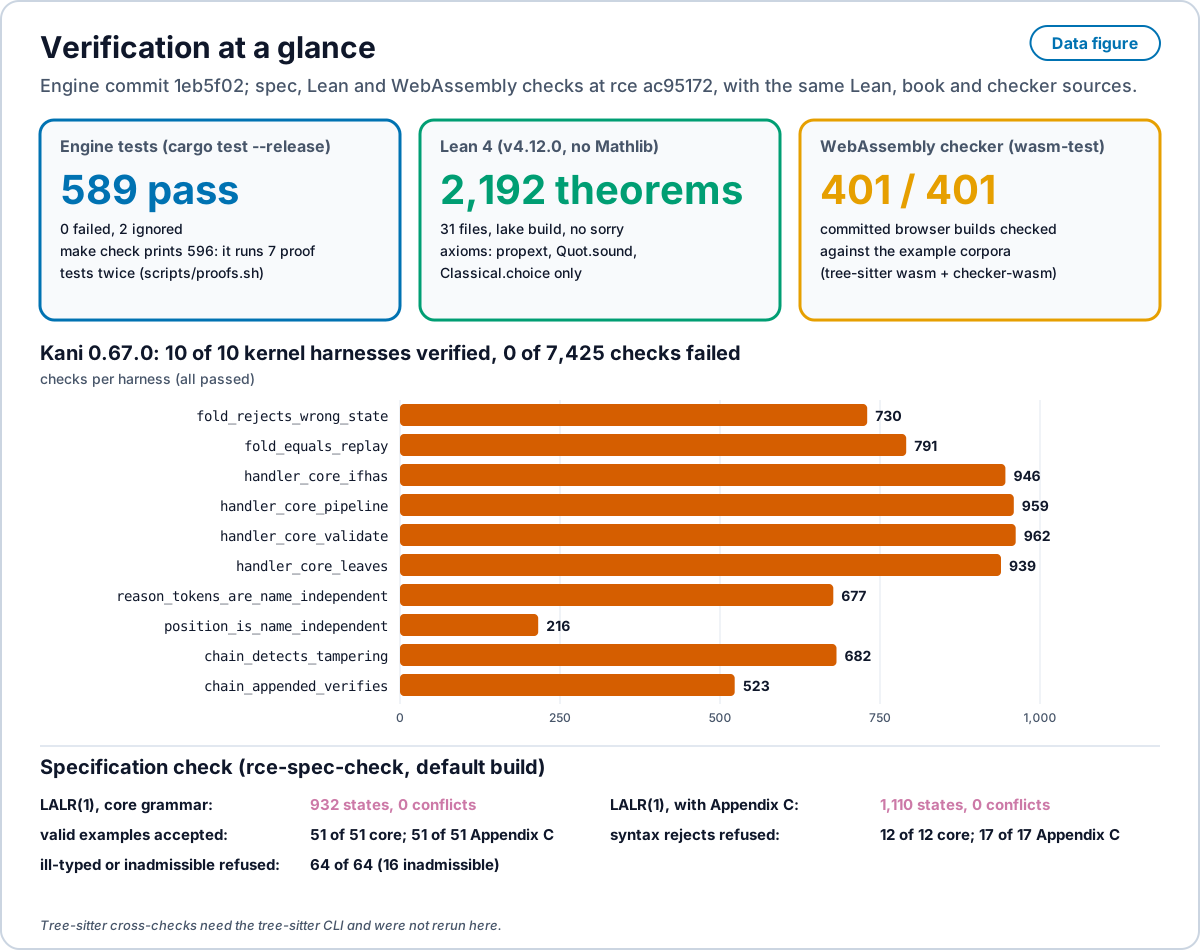
1eb5f02 do motor. Figura de dados. Testes do motor (cargo test --release): 589 passam, 0 falham, 2 ignorados; make check relata 596 porque executa 7 testes de prova duas vezes. Lean 4: lake build sobre os 31 arquivos de spec/lean/RCE/ sem nenhum sorry; a auditoria relata 2,192 constantes de teorema (contagem da auditoria, não declarações na fonte) cujos axiomas são apenas propext, Quot.sound e Classical.choice. O Kani 0.67.0 verifica 10 de 10 harnesses do núcleo com 0 de 7,425 verificações falhando (barras: verificações por harness). A construção em WebAssembly do verificador passa em 401 de 401 verificações contra os corpora de exemplos. A verificação da especificação constrói tabelas LALR(1) com 0 conflitos para a versão 0.5 (932 estados) e para as versões 0.6 e 0.7 (1,110 estados), aceita 51 de 51 exemplos válidos e recusa 12 de 12 rejeições de sintaxe e 64 de 64 programas mal tipados ou inadmissíveis. As verificações de Lean, WebAssembly e especificação foram executadas no repositório público em ac95172, cujas fontes da especificação são idênticas às do motor. Há uma cópia em PNG. Open full size · PNG
Uma observação de convergência. O catálogo em agentlanguages.dev, lido em 13 de outubro de 2026, lista 42 linguagens projetadas para que agentes de IA escrevam código, agrupadas pelos seus editores num campo sintático, num campo de verificação e num campo de orquestração. Várias escolhas de projeto deste artigo, como contratos verificados mecanicamente, logs encadeados por hash, replay determinístico e uma forma canônica por programa, aparecem nas descrições que o catálogo faz de outros projetos, desenvolvidos de forma independente. Esta é uma observação de que as escolhas se repetem. Não é evidência de que sejam corretas, e este artigo não faz nenhuma comparação com esses projetos.
4. O motor: engrenagens, porta e recibos
4.1 O motor é uma Forma
O RCE executa software como um grafo de pequenos manipuladores determinísticos. Um manipulador que não consegue decidir levanta uma escalada. Um resolvedor responde à escalada uma vez, e a resposta é instalada como manipulador permanente, de modo que o próximo caso com o mesmo formato roda sem resolvedor. O motor cumpre todas as invariantes da Forma, cada uma verificada por um teste nomeado em tests/form_laws.rs:
| Invariante | O que o motor faz |
|---|---|
| Recarregar é uma dobra verificada | O recarregamento lê o log literalmente, recalcula cada hash e cada encadeamento e dobra o restante com . Nada é recarimbado. Uma cadeia quebrada se recusa a carregar. |
| Ordem de tique sem nomes | Os manipuladores rodam em ordem de posição topológica, depois por uma chave de nó sem nomes. As saídas são preparadas e entregues depois que todos os manipuladores rodam, como na semântica ASM. Renomear todos os nós dá o mesmo hash de estado anônimo em cada entrada. |
| Nenhum descarte silencioso | Uma caixa de mensagens cheia retém a mensagem numa fila ordenada e registra Backpressure. Com capacidade 1 e 10 tarefas, 9 entradas Backpressure são registradas e as 10 tarefas são encerradas. |
| As cargas úteis estão no log | Entradas, tiques, resultados de manipuladores externos, instalações e falhas são entradas do log. O hash de estado após cada entrada coincide com uma dobra a partir de um motor vazio, em 1,000 logs aleatórios. |
| Relógio lógico | A vivacidade conta tiques, não tempo de parede. |
| Hashes estáveis | SHA-256 (Secure Hash Algorithm, 256 bits) sobre JSON canônico, com chaves ordenadas em todos os níveis, para entradas, estados, formatos e ids de regras. |
4.2 As engrenagens
Cada engrenagem só é tentada quando a engrenagem abaixo dela não passa pela porta. Essa ordem é uma cascata fixa.
| Engrenagem | Método | Linhagem |
|---|---|---|
| G0 Consulta | Uma biblioteca compartilhada de manipuladores indexada por hash SHA-256 do formato; para reparo de código, localização em funções classificadas | Busca e recuperação de código [21] |
| G1 Regras | Modelos de reparo determinísticos e guardados e validadores derivados de esquemas, cada um verificado quanto à sensibilidade a mutações | PAR, TBar, AVATAR, FixMiner [22, 23, 24, 25]; codemods como o Coccinelle [26] |
| G2 Síntese | Enumeração sobre a gramática de manipuladores, solucionadores e e-graphs | Sketching, SyGuS, egg [27, 9, 12] |
| G3 a G5 Modelos | Um modelo de decisão tipado, um modelo pequeno local e depois um modelo remoto, por último | Cascatas de modelos [28] |
4.3 A porta
Um candidato só é promovido quando passa pela porta. A porta reproduz as entradas registradas do nó, executa o candidato em modo sombra sobre amostras novas com um limite de cobertura (a regra de três com um orçamento de erro declarado), verifica o esquema de saída e exige o certificado de prova da Seção 5. Um candidato rejeitado é registrado com o seu contraexemplo.
4.4 Recibos
Toda promoção, recusa, adiamento e instalação é uma mutação num log somente de acréscimo encadeado com SHA-256, de modo que adulterar qualquer entrada passada quebra a cadeia [29, 30]. O custo de cada manipulador é precificado a partir das contagens de operações do interpretador com a tabela de custos do host do FGIR, o backend de código nativo do flowG, e rotulado est_j. Cada chamada ao capataz carrega o seu recibo. Um recibo nomeia a engrenagem, o método da estimativa (basis), os candidatos tentados e se a engrenagem resolveu a escalada. O seu campo est_j é obrigatório: é um número finito não negativo, ou null, e null só é permitido quando basis diz unpriced, como numa chamada a modelo sem valor de energia. Um recibo sem o campo é rejeitado pelo analisador. Um custo não precificado nunca é lido como zero, de modo que um total sobre recibos relata separadamente as suas invocações precificadas e não precificadas, e uma economia que depende de uma resolução não precificada é relatada como desconhecida. As execuções da escada acrescentam, numa subamostra, um contador de energia do pacote do processador, rotulado reported_j.
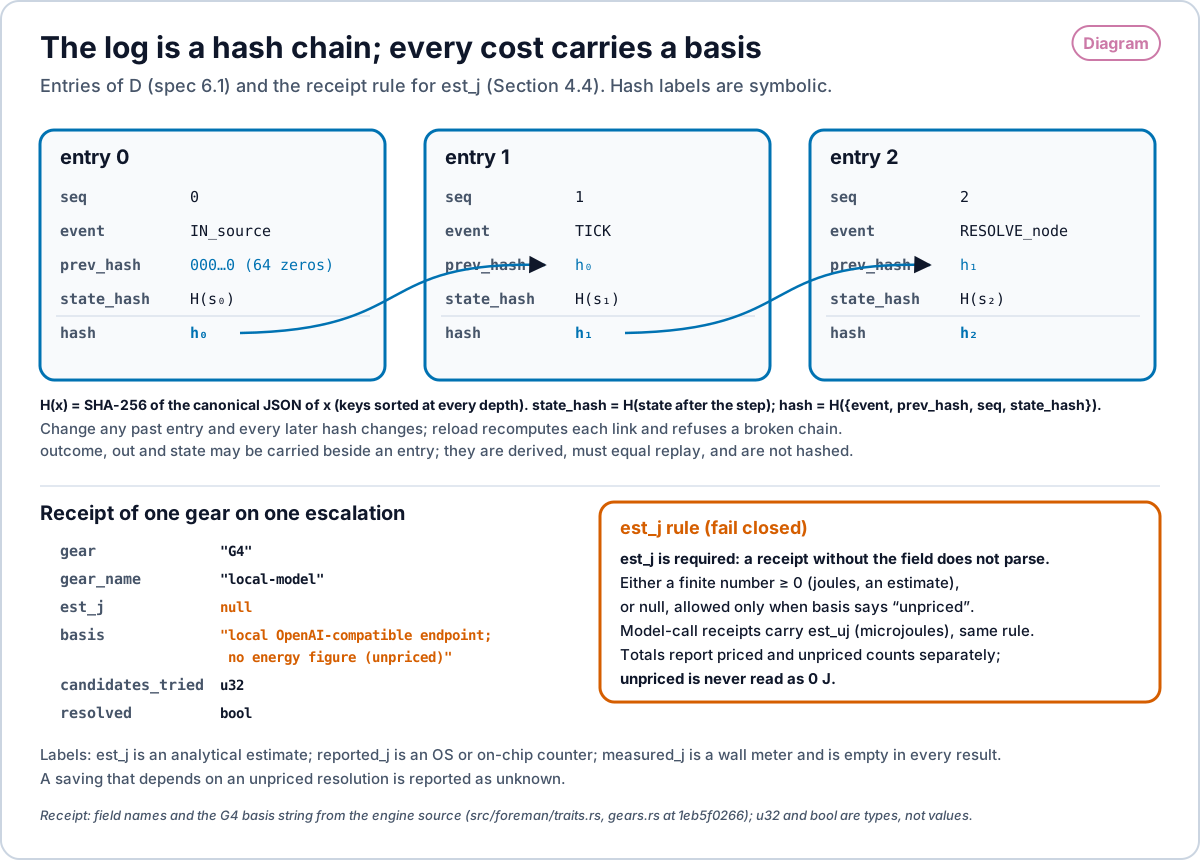
{seq, event, prev_hash, state_hash, hash}. state_hash é o SHA-256 do JSON canônico do estado após o passo; hash é o SHA-256 do JSON canônico de {event, prev_hash, seq, state_hash}; o primeiro prev_hash são 64 zeros, de modo que mudar qualquer entrada passada muda todo hash posterior. Um recibo de engrenagem carrega gear, gear_name, est_j, basis, candidates_tried e resolved. est_j é obrigatório e é um número finito não negativo, ou null somente quando basis diz unpriced; os recibos de chamadas a modelo carregam est_uj em microjoules sob a mesma regra. Um custo não precificado nunca é lido como 0 J. Os rótulos de hash são simbólicos. Fonte: especificação 6.1 e Seção 4.4. Há uma cópia em PNG. Open full size · PNG
4.5 O compilador da Forma
rce form recebe uma especificação e o seu ajuste e emite cinco alvos a partir de uma IR da Forma:
.rce spec + fit
  lower ─► normalize ─► egg e-graph, equality saturation (+ admitted proposals)
  ─► extract (cost = est_j) ─► Form IR (typed relations, regions, rules with SHA-256 ids)
     ├─ Rust crate (pure step, typed state, SHA-256 log and fold, tests)
     │  └─ WASM (the same crate on wasm32-wasip1)
     ├─ Python (standard library only)
     ├─ XState v5 machine
     └─ SCXML document, executed by SCION
A IR fixa um comportamento em cada borda numérica: o estouro verificado de inteiros de 64 bits é um erro e nunca dá a volta; a / inteira trunca em direção a zero (); % assume o sinal do dividendo (); divisão por zero é um erro; os números de ponto flutuante são IEEE 754 binary64 e um resultado não finito é um erro; nulo e ausente são distintos; o tempo é apenas o relógio lógico. Todo alvo é gerado. Nenhum é escrito à mão.
Um manipulador de processo, HTTP ou closure não tem termo, então seus resultados registrados são compilados num oráculo gravado, indexado pelo SHA-256 da entrada canônica. rce scan DIR --form eleva código Rust, Python, TypeScript e Go existente ao esquema da Forma, e cada elemento elevado é rotulado como elevação sintática.
4.6 Método: a pilha inteira avaliada, cada suposição de interface explícita
Um programa é uma pilha de níveis: tokens e instruções; manipuladores; a Forma, uma única função de passo sobre (regiões de controle; dados: o relógio, a contagem de entradas e as relações tipadas); o log, uma cadeia de hashes SHA-256 cujas entradas registram cada evento, o hash do estado que ele produziu e o hash da entrada anterior; as reescritas que transformam a Forma; e o substrato que a executa. Cada nível se apoia em suposições sobre o nível abaixo. O RCE não trata nenhum nível como fixo. Ele avalia a pilha inteira, escreve cada suposição de interface como um enunciado verificável e a verifica em toda execução.
| Fronteira | Suposição | Verificação |
|---|---|---|
| fonte para manipulador | uma entrada satisfaz seu contrato de fonte | a verificação do contrato no evento de entrada de δ |
| manipulador para sumidouro | toda saída Ok satisfaz o esquema de saída | prova do manipulador (verify::handler_proof), total e determinística pelo avaliador do núcleo verificado com Kani |
| log para estado | cada entrada carrega o hash do estado que produziu | dobra do núcleo, que recusa a primeira entrada cujo hash não confere (harness do Kani fold_rejects_wrong_state) |
| reescrita para Forma | uma reescrita preserva a saída para toda entrada | verificação aleatorizada, depois uma prova SMT com Z3 |
| stub para capataz | um manipulador que não consegue decidir escala em vez de adivinhar | manipuladores stub emitem escaladas; resoluções são promovidas só pelo caminho de promoção |
| Forma para alvo | todo alvo emitido calcula a mesma δ | todo alvo carrega o mesmo traço de referência |
Uma verificação que falha localiza a ruptura na fronteira onde ela ocorre. A correção é feita naquele nível, passa pela verificação daquela fronteira e é promovida. Todo nível acima do corrigido herda a correção sem mais mudanças, porque cada nível acima consome o nível corrigido apenas pela interface cuja suposição agora é verificada. É nesse sentido que as correções sobem e se acumulam. A demo do motor do RCE executa isso no navegador sobre o núcleo do RCE compilado para WebAssembly: sua camada Interfaces rompe cada suposição e mostra a verificação que a detecta, e sua camada Compounding mostra a correção se propagando para cada rodada posterior.
5. Verificação
5.1 Teste diferencial em cinco alvos
tests/form_targets.rs conduz uma especificação aritmética de onze operadores com 29 eventos de borda mais 500 valores de borda aleatórios com semente. Os alvos gerados Rust, Python, WASM, XState e SCXML imprimem o traço de referência byte a byte, incluindo as bordas aritméticas. Isso é teste diferencial na linha de McKeeman e do Csmith [86]: concordância entre implementações independentes num conjunto declarado de entradas. Não é validação de tradução [85] nem um compilador verificado. Cobre os onze operadores e os 529 eventos do teste, e não diz nada sobre entradas fora deles. Os resultados com Z3 e Kani abaixo são a verificação.
A Figura 11 mostra as cinco projeções de uma Forma e a ida e volta dos dois destinos de statechart.
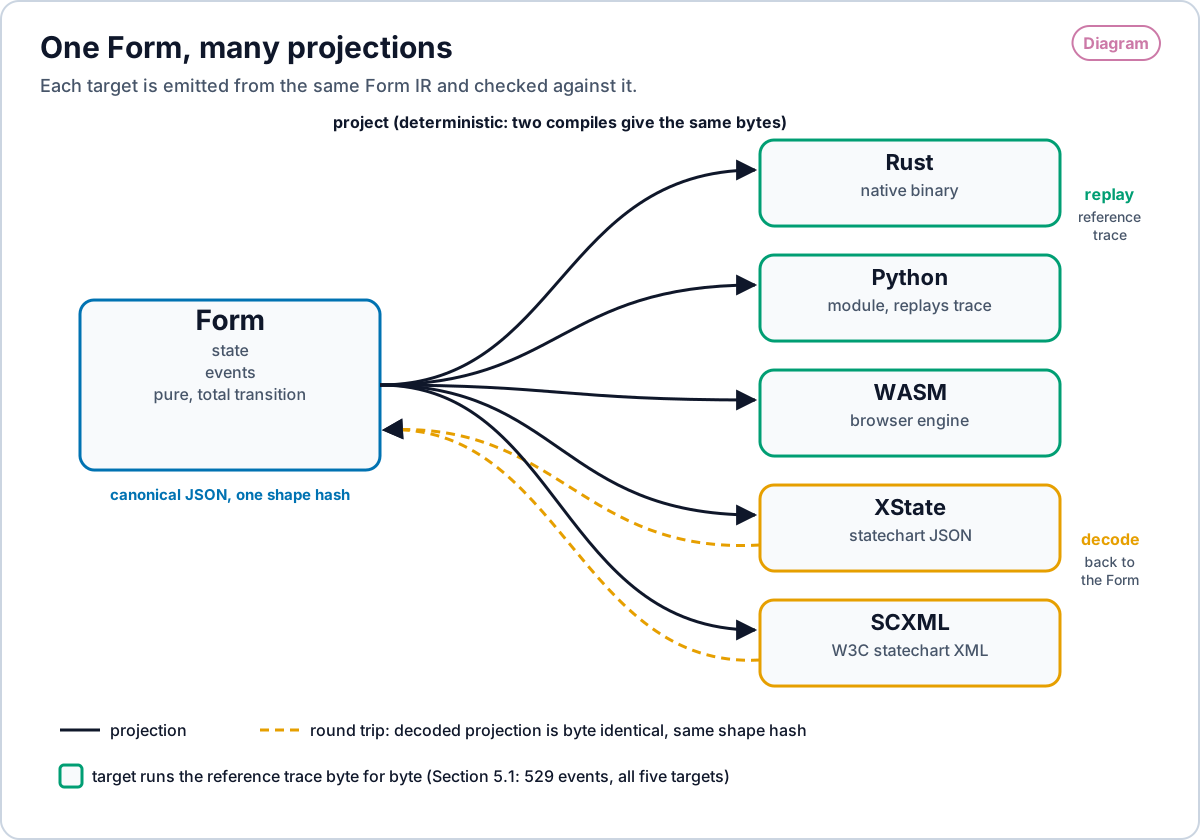
tests/form_targets.rs. Há uma cópia em PNG. Open full size · PNG
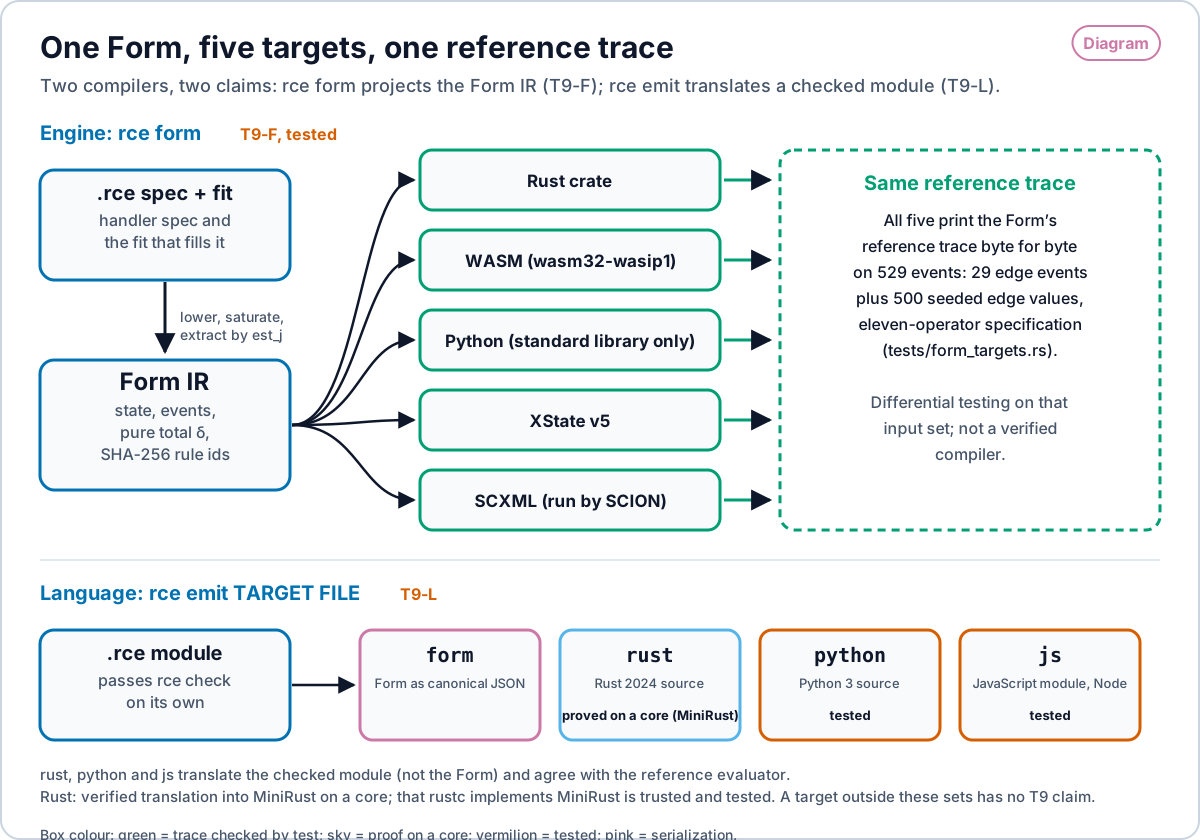
rce form rebaixa uma especificação de manipulador e o seu ajuste para a IR da Forma e a projeta num crate Rust, WASM, Python, XState v5 e SCXML; os cinco imprimem o traço de referência byte a byte em 529 eventos (29 eventos de borda mais 500 valores de borda com semente de uma especificação de onze operadores, tests/form_targets.rs). Isto é T9-F, estabelecida por teste diferencial, não um compilador verificado. Embaixo: rce emit TARGET FILE traduz um módulo verificado (não a Forma) para JSON form, rust, python ou js; T9-L é provada para o emissor Rust sobre um núcleo como uma tradução verificada para MiniRust (que o rustc implementa MiniRust é suposto e testado), e testada para os demais. Há uma cópia em PNG. Open full size · PNG
5.2 Reescritas provadas em Z3
Regras de reescrita verificadas têm uma linhagem. O Ruler infere e verifica regras de reescrita por saturação de igualdade sem modelo no laço [87]. As 3 de 16 regras propostas pelo modelo admitidas na Seção 5.5 são, portanto, uma afirmação sobre a porta, que recusou 13, e não uma alegação de que um modelo seja a melhor fonte de regras.
Toda reescrita embutida do e-graph é provada no solucionador SMT Z3 (satisfiability modulo theories) [31] contra uma codificação sem quantificadores da avaliação de termos e da aritmética da Forma: valores como tipo de dado, vetores de bits de 64 bits com estouro verificado, divisão e resto com sinal seguindo o sinal do dividendo, e números de ponto flutuante binary64. Uma reescrita que muda o estouro, a ordem de escalada ou uma mensagem não recebe prova. Uma equivalência proposta só entra no e-graph com uma prova.
5.3 Provas do núcleo com Kani
O núcleo do motor (cadeia de hashes, dobra, posições sem nomes e avaliação de manipuladores) é verificado com o verificador de modelos Kani para Rust [32]. A avaliação de manipuladores é o ponto fixo de um passo não recursivo, e o Kani prova esse passo total e determinístico por construtor, por indução estrutural. Dez harnesses são verificados com o Kani 0.67.0, com 0 de 7,425 verificações falhando:
| Harness | Propriedade |
|---|---|
chain_appended_verifies | Uma cadeia de hashes acrescida se verifica |
chain_detects_tampering | Uma entrada alterada quebra a cadeia |
fold_equals_replay | A dobra é igual ao replay |
fold_rejects_wrong_state | Uma dobra que discorda do estado armazenado é recusada |
position_is_name_independent | As posições das regras não dependem dos nomes dos nós |
reason_tokens_are_name_independent | As razões são livres de nomes por tokens inteiros |
handler_core_leaves | Os manipuladores folha são totais e determinísticos |
handler_core_validate | A validação é total e determinística |
handler_core_pipeline | Os pipelines são totais e determinísticos |
handler_core_ifhas | As guardas são totais e determinísticas |
5.4 Porta de promoção sobre o certificado de prova
A execução do Kani escreve um certificado cujo hash é armazenado em proofs/kani.cert. O motor, o log, os ids de regras e a avaliação de manipuladores passam pelo núcleo provado, e a promoção exige o certificado.
5.5 O modelo como proponente atrás da verificação
Um modelo pode propor equivalências. Não pode admiti-las. Com um modelo local de código de 1.5 bilhão de parâmetros (Qwen2.5-Coder-1.5B sob llama.cpp) na especificação de demonstração, o proponente ofereceu 16 equivalências. A verificação admitiu 3, por ensaios aleatorizados e uma prova em Z3, e rejeitou 13. Um proponente determinístico de 87 identidades conhecidas, 77 aritméticas e 10 estruturais, teve 9 admitidas, todas estruturais, e 78 rejeitadas: toda identidade aritmética, por ordem de falhas, valores não numéricos ou estouro, e uma reescrita estrutural, const-absorbs-pipe, que descartaria um prefixo que escala (teste do motor tests/form_proposers.rs).
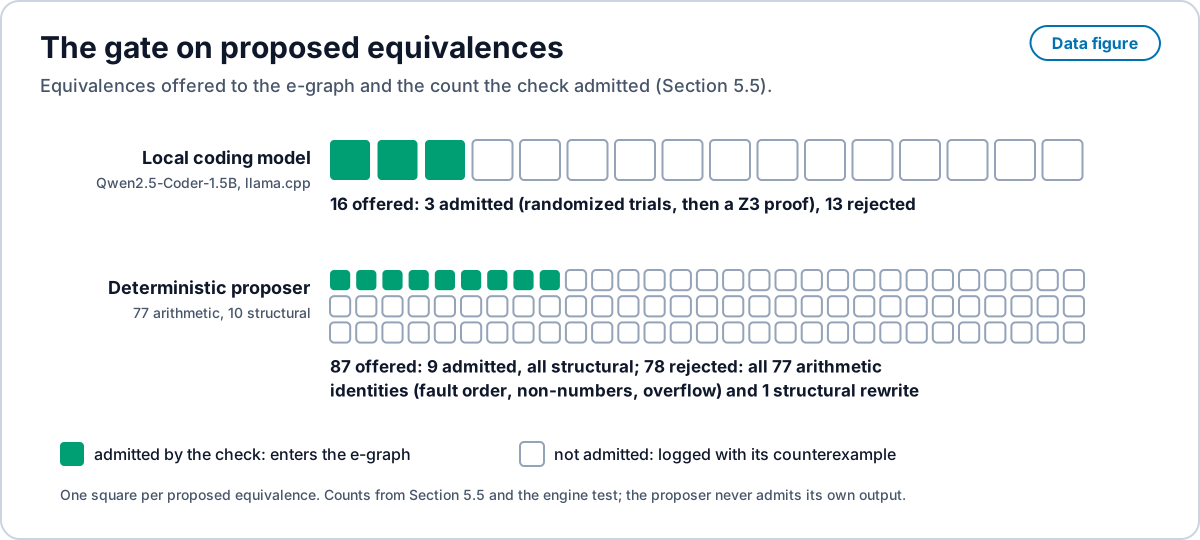
tests/form_proposers.rs. Há uma cópia em PNG. Open full size · PNG
5.6 Concordância em código existente
A elevação lê a mesma máquina de pedidos a partir de fixtures em Rust, Python, TypeScript e Go, executa o código original em 40 sequências com semente de 30 chamadas e concorda em todas as 1,200 chamadas por linguagem. Um benchmark congelado, pré-registrado antes de qualquer resultado, reexpressou três programas existentes de prospecção de vendas como Formas. As Formas concordam com o código original em 4,500 de 4,500 entradas registradas, e a extração reduz est_j em cada uma (por exemplo, de J para J).
6. Elevação: entrar no ecossistema a partir de outras linguagens
A elevação é a porta de entrada do ecossistema para o código escrito em outro lugar. Ela é uma construção, feita por linguagem com as ferramentas que toda linguagem já tem: uma gramática formal, um parser como o tree-sitter que produz a sua árvore sintática, uma árvore sintática abstrata e os símbolos que as ferramentas de servidor de linguagem resolvem (Language Server Protocol). rce scan DIR --form constrói a Forma a partir dessa árvore para Rust, Python, TypeScript e Go (§4.5, §5.6). Um programa elevado herda as falhas da sua fonte, então a elevação inclui o reparo, medido abaixo em corpora públicos de defeitos com a localização dada; dentro do ecossistema essas falhas não podem ser escritas.
6.0 A escada de reparo no código elevado
Uma tarefa de programação é medida aqui pelos bits de intenção de que precisa: os bits que precisam ser fornecidos de fora do que o motor já contém (o programa ao redor da edição, as bibliotecas, os testes, o índice de correções conhecidas). Escrevendo para os bits que fixam o artefato alvo e para os bits que o corpus já fixa, os bits fornecidos são . Uma engrenagem que coloca a edição certa na posição entre seus candidatos forneceu bits de busca, e a porta fornece o resto. A escada ordena as tarefas pelo tamanho da edição, um indicador objetivo de : um token (L0), uma instrução (L1), um hunk (L2), vários hunks num arquivo (L3), vários arquivos (L4), uma função a partir de uma especificação ou de testes (L5), uma mudança no nível de uma issue (L6) e um programa a partir de uma especificação (L7). Os degraus, corpora, partições e hipóteses foram pré-registrados antes das execuções completas; os arquivos estão no repositório público.
| Degrau | Corpus de teste reservado | N | Resolvidas | Taxa | IC de Wilson 95% | Mediana de bits de busca | Chamadas a modelo |
|---|---|---|---|---|---|---|---|
| L0 um token | Mutantes no estilo PIT [109] de 9 repositórios reais em commits fixados (Java: commons-math, commons-collections, jsoup, joda-time, gson; Python: click, attrs, pydantic, sympy) | 520,821 | 520,541 | 0.9995 | 0.9994 a 0.9995 | 2.3 | 0 |
| L0 um token, repositórios nunca usados no ajuste | commons-text, commons-io, more-itertools, httpx | 23,015 | 23,015 | 1.0000 | 0.9998 a 1.0000 | 2.0 | 0 |
| L1 uma instrução, Java | ManySStuBs4J 2.0, correções de um só hunk [107] | 24,072 | 9,288 | 0.386 | 0.380 a 0.392 | 3.5 | 0 |
| L1 uma instrução, Java, arquivo inteiro | ManySStuBs4J 2.0 [107], arquivo do commit pai com os índices de métodos e de guardas do projeto | 21,320 | 13,586 | 0.637 | 0.631 a 0.644 | 4.8 | 0 |
| L1 uma instrução, Python | TSSB-3M v1.0.0, shards 14 e 15 [108] | 157,089 | 27,266 | 0.174 | 0.172 a 0.175 | 4.8 | 0 |
A Figura 14 traça as linhas da tabela com seus intervalos.
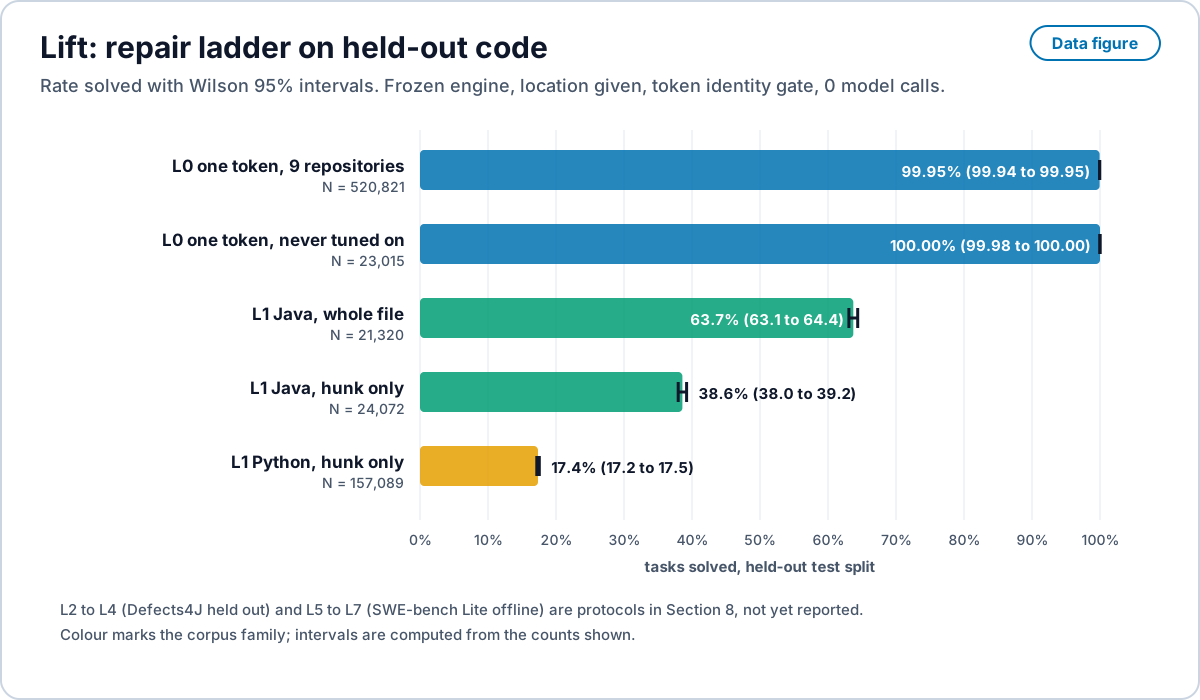
bench/ladder. Há uma cópia em PNG. Open full size · PNG
L2 a L4 são medidos no conjunto reservado do Defects4J, com 288 defeitos (Seção 8.1). L5 a L7 seguem os protocolos da Seção 8.2. O método, a porta e a energia de cada linha vêm a seguir.
Questão em aberto: linha de base para a taxa de um token. As linhas L0 medem com que frequência uma vizinhança de um token ordenada por prioridade restaura um mutante de um token. Se a vizinhança é construída a partir das mesmas tabelas de operadores que produziram os mutantes, uma taxa alta reflete em parte essa sobreposição, e não a capacidade de reparo em falhas que surgem na prática. O artigo cita esse risco de acoplamento e não dá nenhum número para ele. Uma busca simples por inversão de operadores, executada sobre os mesmos mutantes, é a linha de base que mostraria quanto da taxa ela explica. Essa linha de base não foi executada, então nenhum número é dado aqui, e a taxa de um token fica sujeita a essa objeção.
As taxas se leem como bits de intenção. Em L0 os bits que faltam estão quase todos na linha, e uma vizinhança de um token ordenada por prioridade os fornece com uma mediana de 2.3 bits. Na linha L1 só com o hunk, o motor vê apenas o hunk de 7 linhas. Ele fecha as categorias cujos bits estão dentro do hunk (Java: operador alterado 91%, literal booleano trocado 84%, argumentos trocados 82%; Python: literal booleano alterado 98.8%, argumentos trocados 99.4%) e deixa em aberto aquelas cujos bits estão fora dele: nomes de métodos (22%) e identificadores (37%) precisam do arquivo e dos seus tipos, e novas conjunções (3% a 7%) e reescritas de instruções inteiras (Python, 1.2% de uma categoria que é 34% do corpus) são intenção nova. Intenção nova é o que um fornecedor (uma especificação, um teste, uma pessoa ou um modelo local) fornece uma vez, e depois disso o ajuste está no índice.
Método. Cada corpus é embaralhado com uma semente fixa. As primeiras 2,000 posições de cada embaralhamento, e para L0 três repositórios inteiros (commons-lang, requests, flask), formam a partição de desenvolvimento, na qual as engrenagens podem ser ajustadas; resultados de desenvolvimento não são relatados. Toda tarefa restante está na partição de teste. Antes de uma execução de teste, o motor recebe commit e seu hash binário é registrado, e nenhuma engrenagem muda durante a execução. Cada linha desta seção é um resultado do motor congelado apenas em tarefas de teste, com 0 chamadas a modelo. O pré-registro (PREREG.json), as linhas por tarefa e o script do relatório estão no repositório público.
Porta. Em L0 e L1 a localização é dada e a porta é a identidade de tokens: a linha ou instrução reparada deve ser igual à do desenvolvedor, token por token. Isso é mais estrito do que passar nos testes, porque um patch pode passar numa suíte de testes fraca e ainda assim estar errado. Qi e colegas descobriram que a maioria dos patches que o GenProg relatou como correções eram plausíveis, mas incorretos [92]; o sobreajuste aos testes está documentado no reparo baseado em busca e no baseado em semântica [93, 94] e é tratado com testes gerados [95]; as ferramentas pontuam mais alto no benchmark em que foram ajustadas [96]; e a localização de falhas enviesa as comparações [97]. A identidade de tokens elimina a lacuna de plausibilidade nesses degraus, e dar a localização elimina o termo de localização, de modo que a taxa mede apenas as engrenagens de reparo. De L2 para cima, os testes são a porta e as contagens de plausíveis e corretos são relatadas separadamente (Seção 8.1).
6.1 L0: falhas de um token
O corpus L0 é todo mutante no estilo PIT [109] com um token de substituição válido em nove repositórios reais em commits fixados, cinco em Java e quatro em Python: 520,821 tarefas de teste de 547,448. O motor (commit 65571d0, engrenagens G0-T e G1-J) restaura 520,541, uma taxa de 0.9995 (intervalo de Wilson de 95% de 0.9994 a 0.9995) com uma mediana de 2.3 bits de busca. Das 280 não resolvidas, 108 são dígitos mutados dentro de literais de ponto flutuante e 2 estão dentro de literais de conjunto em Python. Uma engrenagem para literais de ponto flutuante (G0-F, commit ecfe5a1) é testada em quatro repositórios nunca usados no ajuste (commons-text, commons-io, more-itertools, httpx): 23,015 de 23,015 tarefas, 1.0000 (0.9998 a 1.0000), com mediana de 2.0 bits de busca. Os mutantes substituem falhas reais de um token, que Just e colegas mostraram estar acopladas a falhas reais [110].
6.2 L1: defeitos de uma instrução de históricos reais
L1 usa dois conjuntos de dados públicos de correções reais de uma única instrução, extraídas de históricos de código aberto. O ManySStuBs4J 2.0 [107] dá 24,072 tarefas de teste em Java; o motor (commit f2701b7) resolve 9,288, uma taxa de 0.386 (0.380 a 0.392). O TSSB-3M v1.0.0 [108] dá 157,089 tarefas de teste em Python dos shards 14 e 15; o mesmo motor resolve 27,266, uma taxa de 0.174 (0.172 a 0.175). O motor recebe apenas o hunk de 7 linhas, então essa taxa em Java é um resultado só com o hunk. Com o arquivo inteiro no commit pai, com índices dos métodos e das condições de guarda do projeto e com as engrenagens para nomes de método alterados, argumentos adicionados, condições de guarda, throws e modificadores (commit 62fb7a0, prefixo sha256 do binário 3682c6515acdf722, pré-registrado antes da execução), o motor resolve 13,586 das 21,320 tarefas de teste em Java cujo arquivo e instrução defeituosa puderam ser localizados, uma taxa de 0.637 (0.631 a 0.644). Por categoria, ele fecha operadores alterados (95.9%), operandos alterados (92.1%), chamadores errados (87.9%), literais booleanos trocados (88.4%), argumentos removidos (85.1%) e argumentos trocados (83.3%); nomes de método alterados chegam a 61.4% e argumentos adicionados a 51.4%, e condições novas ou estreitadas (43.5% e 51.7%) continuam sendo a principal intenção em aberto. As tabelas completas por estrato estão no repositório. Esses conjuntos de dados não têm ranking de reparo publicado sob esta porta (só o hunk, identidade de tokens, localização dada), então nenhum número de reparo aprendido é posto ao lado deles; o Defects4J, que tem um, é comparado com o TBar na Seção 8.1.
6.3 Energia
Cada linha traz est_j, uma estimativa de segundos de CPU vezes 10 W: 0.40 J por tarefa resolvida em L0, 0.13 nos repositórios novos, 0.10 no ManySStuBs4J e 0.27 no TSSB-3M. Uma subamostra foi lida no RAPL [105], o contador de pacote no próprio chip do processador, num laptop Linux com um Intel i9-13900H (hostname jetson-hub; não é um NVIDIA Jetson). O harness rodou em 4 CPUs fixadas, e reported_j é o delta do pacote durante toda a execução, incluindo o driver em Python, menos a potência ociosa de uma amostra de 10 s tomada logo antes, vezes a duração da execução. Runners de integração contínua estavam ativos, então a potência ociosa foi de 40 W a 44 W e a incerteza é de cerca de ±1 W vezes a duração, ±10 J nesses totais.
| Subamostra (partição de teste) | Tarefas | Resolvidas | J bruto | reported_j | reported_j por tarefa resolvida | Segundos |
|---|---|---|---|---|---|---|
| L0, mutantes do gson (com semente, primeiros 3,000) | 3,000 | 3,000 | 648.3 | 167.5 | 0.056 | 11.8 |
| L1, ManySStuBs4J posições 2,000 a 3,999 | 2,000 | 690 | 377.2 | 17.9 | 0.026 | 8.2 |
A subamostra de L1 constrói seu índice de projeto apenas a partir das suas 2,000 tarefas, então sua taxa de resolução (34.5%) fica abaixo da execução completa. measured_j, um medidor de parede num barramento nomeado, está vazio em todas as linhas; seu protocolo é a Seção 8.3.
7. Evidência de reutilização
A posição do RCE no eixo da reutilização repousa num fato de engenharia: o código é reutilizado em todas as escalas. Cada método abaixo o mede de um modo diferente.
| Método | Fonte | Achado |
|---|---|---|
| Mapeamento de clones por arquivo | DéjàVu, Lopes et al. 2017 [33] | De 428 milhões de arquivos em 4.5 milhões de projetos do GitHub que não são forks, 85 milhões são únicos: “70% of the code on GitHub consists of clones of previously created files.” Em JavaScript, 6% dos arquivos são distintos. |
| Redundância por linha | Gabel e Su 2010 [34] | Contra 420 milhões de linhas, “between 50% and 100% of each project is redundant” em cerca de uma linha. |
| Modelos estatísticos de linguagem | Hindle et al. 2012 [35] | O código é “very repetitive, and in fact even more so than natural languages.” |
| Quase deduplicação de corpus | The Stack [36] | A quase deduplicação remove 54.7% do The Stack v1 (de 6.4 TB para 2.9 TB) e 52.4% do v2 (de 67.5 TB para 32.1 TB). |
| Preservação do arquivo inteiro | Software Heritage [129, 130] | 30.3 bilhões de conteúdos de arquivo únicos de 448 milhões de origens (contadores do arquivo, lidos em 13 de outubro de 2026), cada um armazenado uma vez pelo hash dos seus bytes. |
| Padrões de correção minerados | PAR, TBar [22, 23] | O PAR encontrou “several common fix patterns” em mais de 60,000 patches humanos. As 15 categorias de padrões do TBar corrigem 43 defeitos do Defects4J corretamente no pipeline padrão, e 74 de 101 com localização de falhas perfeita, sem aprendizado. Estes são os números tal como lidos em [23]; o significado de 101 (patches plausíveis ou defeitos tentados) não foi conferido de novo com esse artigo aqui, então trate a razão como não confirmada. |
| Tarefas entre linguagens | Rosetta Code [131] | 1,360 tarefas (e 421 tarefas em rascunho), cada uma um conceito implementado em muitas de 1,009 linguagens conhecidas. |
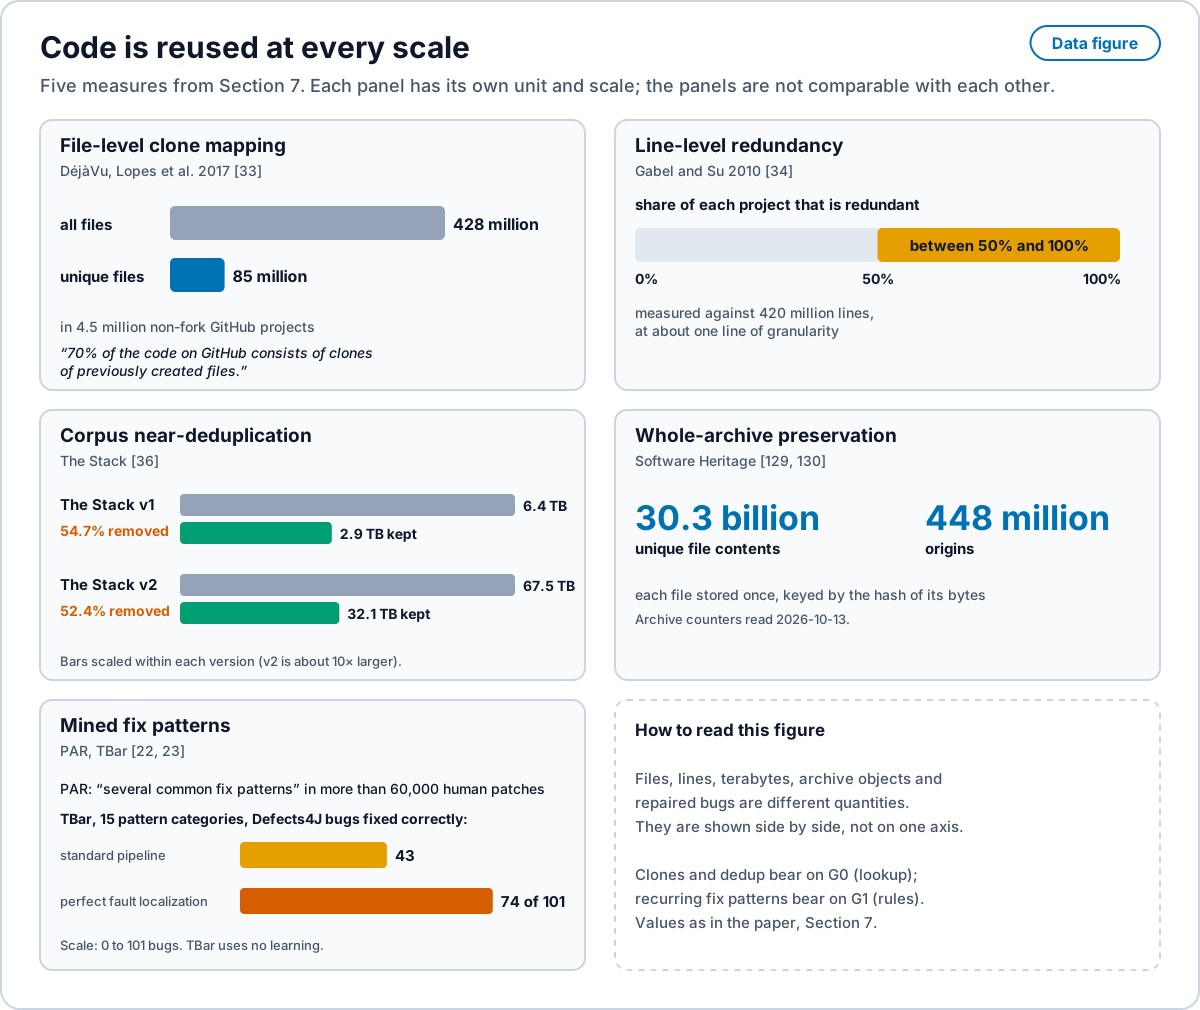
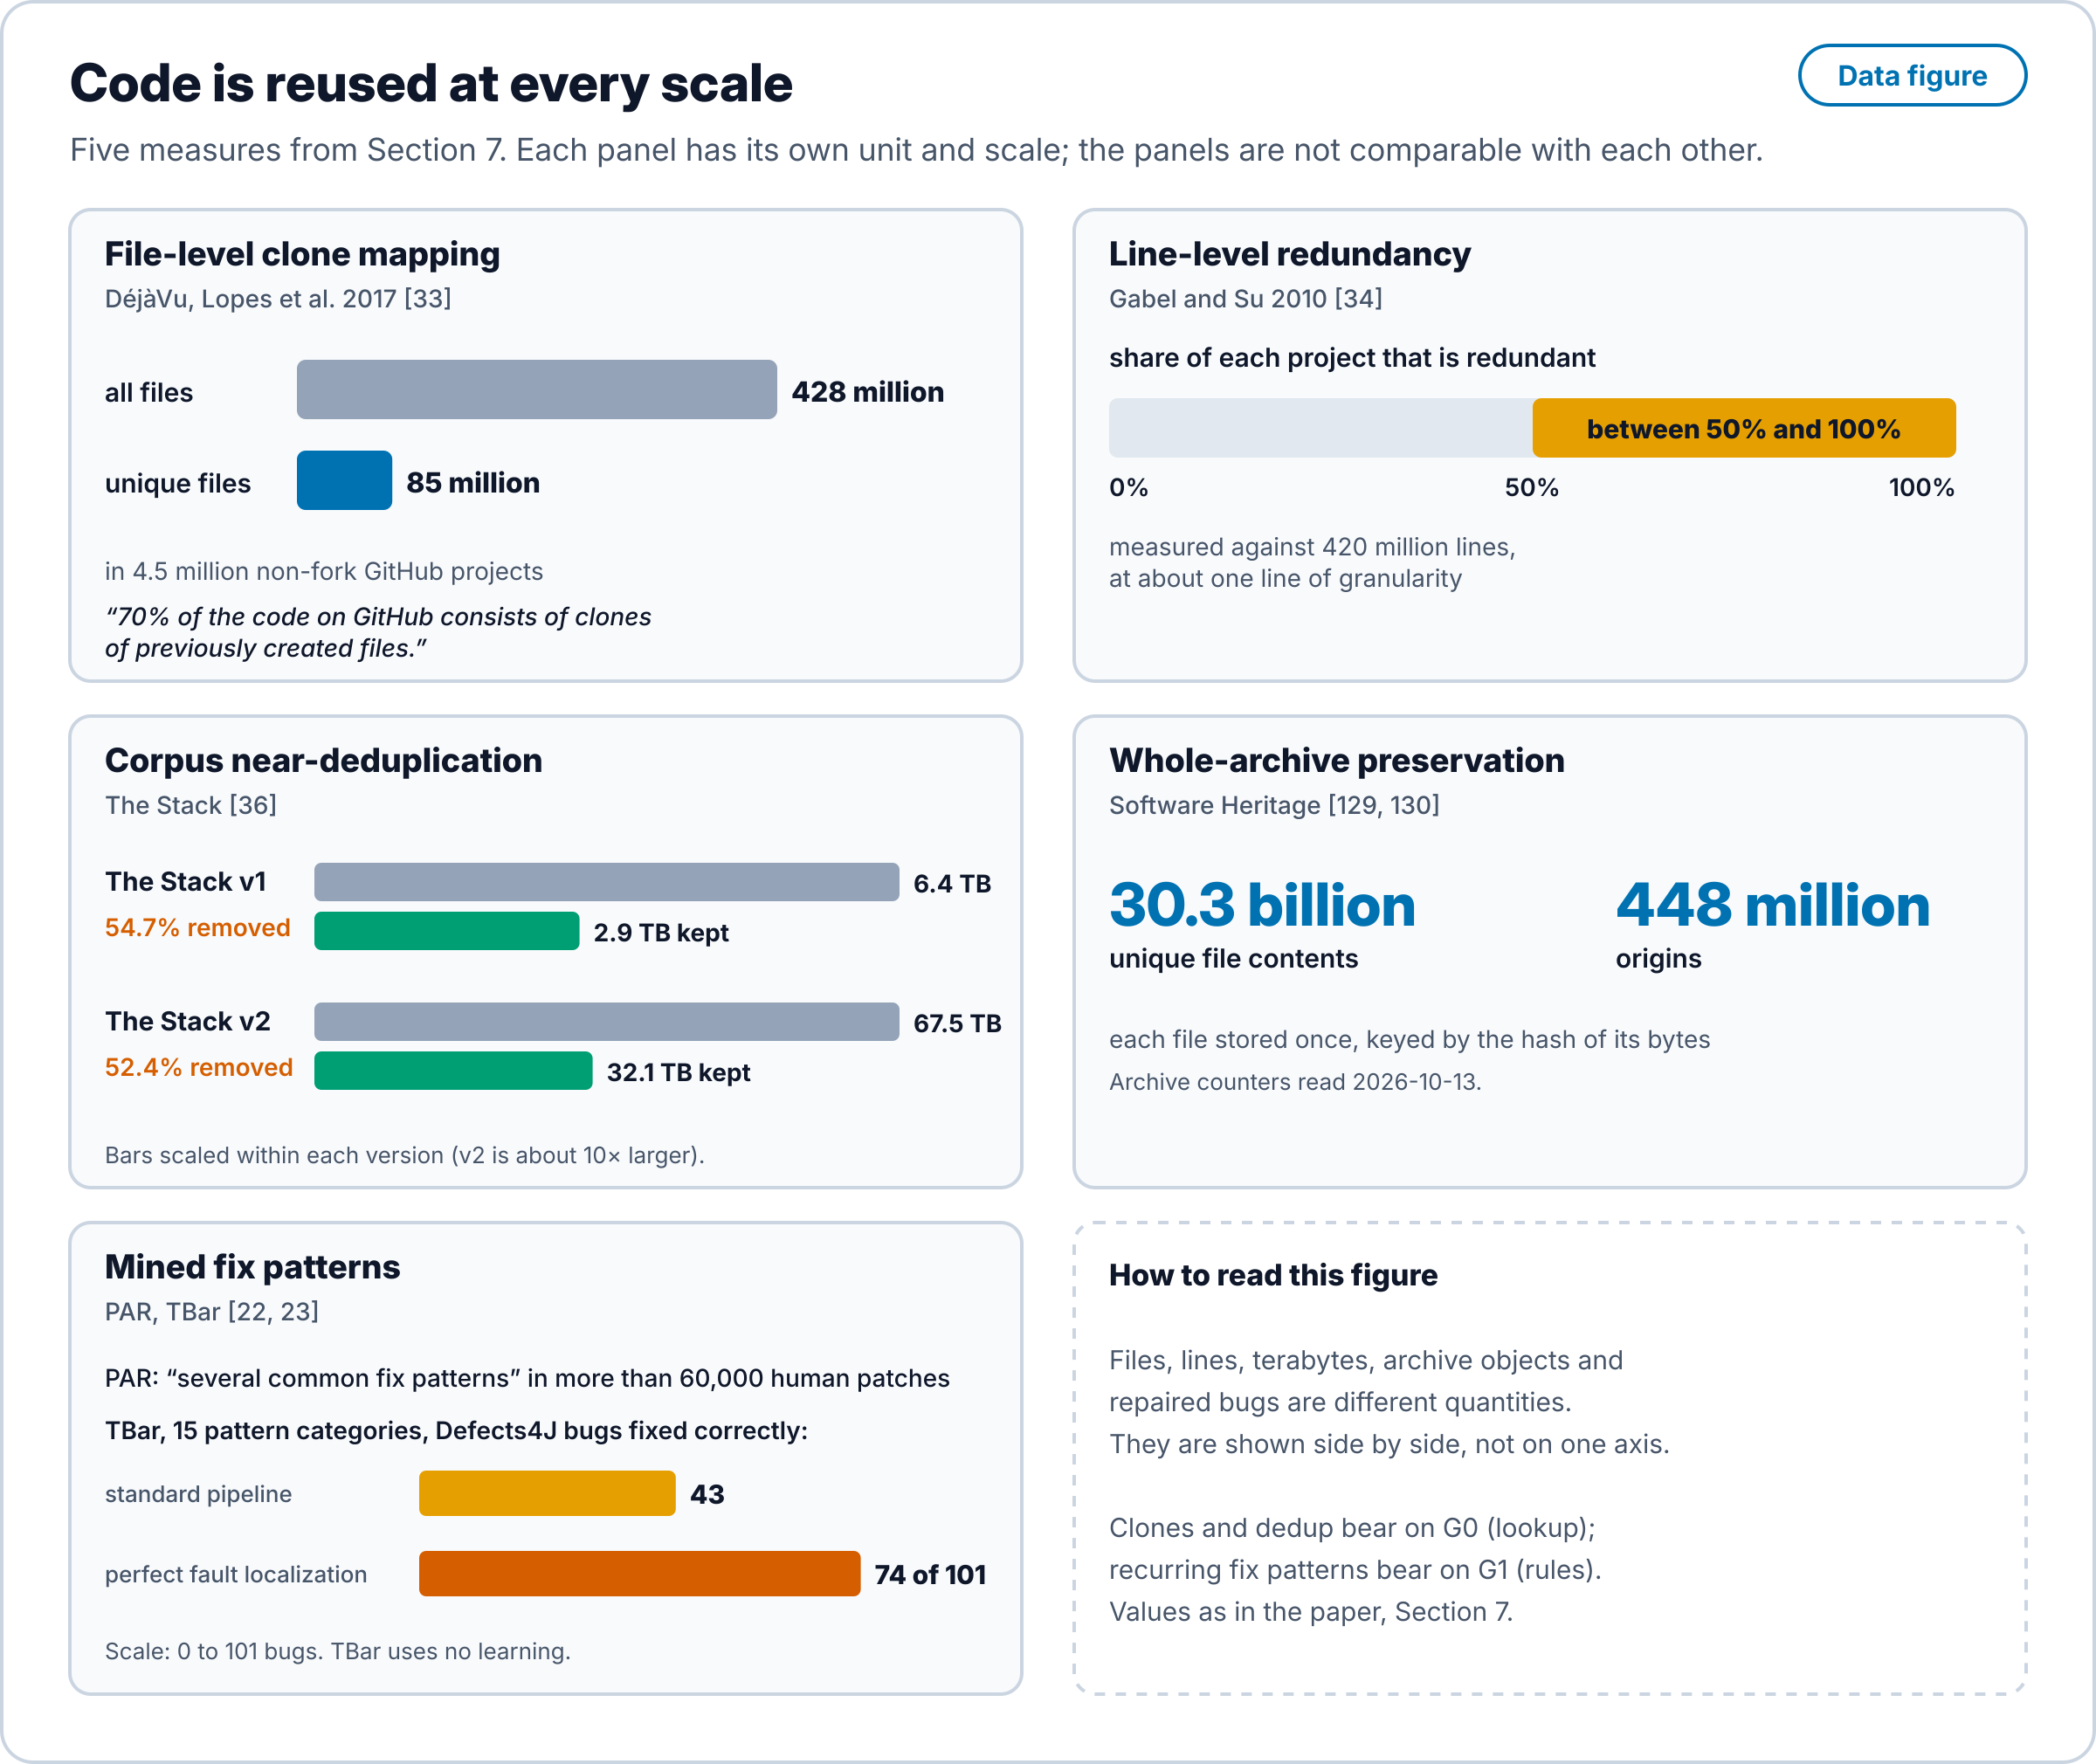
Cada linha é uma entrada do motor. Clones e deduplicação dizem que um ajuste geralmente existe, e isso é o G0. Correções recorrentes dizem que a adaptação é, na maior parte, um pequeno catálogo de reescritas guardadas, e isso é o G1. A redundância por linha encolhe o espaço de busca do G2. O ecossistema mede isso em cada ajuste promovido (Seção 2.3), e a escada de reparo no código elevado o mede em escala em partições reservadas (Seção 6). Duas ressalvas afiam a leitura. Duplicatas inflam as pontuações de recuperação e de modelos se não forem removidas [104]. E linhas com defeito são menos naturais do que as corrigidas [45], então o defeito em si é o caso que a consulta menos consegue prever; é o formato da correção, não a linha com defeito, que o G0 e o G1 precisam usar como chave. A linha de mineração de regras que faz isso em escala, da busca gerar e validar do GenProg [88] e do modelo aprendido de correção do Prophet [89] ao Getafix no Facebook [90] e ao reparo sem modelo de violações de análise estática do Sorald [91], deriva modelos de um histórico disjunto e relata a precisão em casos não vistos [98]. Esse é o padrão que a Seção 8.4 adota.
8. Protocolos de medição para o que vem a seguir
Cada protocolo é fixado antes da sua execução: pré-registro com commit, sementes e commit do solucionador registrados, todo artefato guardado. Primeiro a porta, depois os joules, rótulos sempre.
8.1 Defects4J
O Defects4J contém 854 defeitos reais ativos em Java, cada um com testes que o reproduzem [37].
- Desenvolver num subconjunto de 100 defeitos, offline, via
defects4j checkout; relatar apenas resultados reservados, num conjunto disjunto de 288 defeitos congelado antes da execução (FROZEN-heldout-v1). - Rodar G0, depois G1, depois G2, depois um modelo local por último. Registrar a engrenagem que fechou cada defeito.
- Porta: os testes que disparam o defeito e a suíte completa passam. Relatar contagens de plausíveis e corretos separadamente; correto significa equivalente ao patch do desenvolvedor na revisão.
- Relatar chamadas a modelo por correção correta e joules por correção correta, rotulados.
- Pontos de referência: as 43 correções corretas do TBar e seus 74 de 101 com localização perfeita (números tal como lidos em [23], com o denominador não conferido de novo aqui). Esta seção é um protocolo. Nenhum resultado deste motor no Defects4J é relatado neste artigo.
- Verificação de contaminação: marcar todo defeito cuja correção apareça literalmente no índice do G0, e relatar com e sem os defeitos marcados.
8.2 SWE-bench Lite, offline
O SWE-bench Lite é um subconjunto de 300 tarefas de issues reais do GitHub, resolvidas por testes ocultos [38].
- Usar o harness Docker oficial sem rede.
- Primeira execução: só G0 e G1, zero chamadas a modelo. Esse é o piso da resolução sem modelo.
- Segunda execução: acrescentar um modelo local como última engrenagem.
- Relatar a taxa de resolução, chamadas a modelo por tarefa resolvida e joules por tarefa resolvida, rotulados.
- Verificação de contaminação como em 8.1. O SWE-Bench+ descobriu que 32.67% dos patches bem-sucedidos tinham a solução no texto da issue [39].
8.3 Um medidor de parede
- Ligar um medidor de parede ou um medidor de shunt na alimentação do host, registrado a uma taxa declarada e com o relógio sincronizado ao log da execução.
- Máquina ociosa: runners de CI e outros builds parados, e uma porta de janela silenciosa verificada antes de cada bloco e registrada.
- Subtrair uma linha de base ociosa medida e declarar o método.
- Preencher
measured_japenas a partir do medidor. Relatarreported_j(RAPL) eest_jao lado, em colunas separadas. Nunca somar entre rótulos. - Repetir as subamostras RAPL da Seção 6.3 sob o medidor, depois o conjunto reservado do Defects4J.
8.4 Uma execução reservada com as engrenagens congeladas
Este é o método da Seção 6, estendido a novos corpora.
- Congelar G0, G1 e G2 num commit marcado, registrar o hash binário e publicar o conjunto de regras com os carimbos de data e hora da sua autoria.
- Tirar uma fatia reservada disjunta: as instâncias em Rust e Python do Multi-SWE-bench [102] e do BugsInPy [103], deduplicadas contra o índice do G0 [104].
- Pré-registrar a fatia, as sementes e as hipóteses antes da primeira execução.
- Relatar separadamente as contagens de resolvidos, plausíveis e idênticos byte a byte, cada uma com um intervalo de 95%.
8.5 Linhas de base na mesma tabela
- Sem modelo:
cargo fixe clippy [106], e o Sorald ou uma portabilização do TBar [91]. - Modelo barato: Agentless com um modelo local [99].
- Modelo remoto: um agente com um modelo de fronteira, sua energia estimada a partir de divulgações do provedor e rotulada
est_j. - Relatar o cost-of-pass [101] em joules e em dólares para cada linha, com o custo controlado como Kapoor e colegas exigem [100].
8.6 Convergência das chamadas a modelo com N grande
A promoção é o mecanismo pelo qual o modelo sai do laço: um resolvedor é pago uma vez por um caso novo, a porta admite o ajuste como manipulador, e todo caso posterior com o mesmo formato fecha em G0 ou G1 (Seção 4.2). A convergência é a afirmação de que as chamadas a modelo por rodada caem a zero numa especificação fixa sob tráfego real. Ela é medida da seguinte forma.
- Tirar pelo menos 1,000 especificações de repositórios públicos, estratificadas por linguagem e tamanho, e congelar o motor e o resolvedor antes da primeira rodada.
- Reproduzir tráfego de produção gravado, pelo menos 10,000 eventos por especificação, em rodadas de tamanho fixo.
- Registrar por rodada: novas escaladas, chamadas a modelo, promoções, adiamentos e joules por tarefa fechada, cada um rotulado (
est_j,reported_j,measured_j). - Desfecho primário: a fração de especificações que chegam a uma rodada com zero chamadas a modelo em até 20 rodadas, com um intervalo de Wilson de 95%. Secundários: chamadas a modelo por tarefa fechada por rodada, e a rodada da última chamada a modelo.
- Relatar as especificações que nunca convergem com a sua causa (uma entrada travada, uma dependência ausente, intenção nova), e rodar o adiamento de entradas travadas como braço pré-registrado.
Proposição 8 (aproximação do piso). À medida que cresce a cobertura de G0 e G1, os joules por tarefa resolvida se aproximam do piso de referência de aplicar uma correção conhecida e rodar os testes. Os degraus da escada e o conjunto reservado do Defects4J sob o medidor de parede o testam.
8.7 Cobertura da elevação entre linguagens
A elevação é medida à medida que é construída. Para uma linguagem , um programa conta como elevado quando passa nos próprios testes do programa, reproduz byte a byte um traço registrado, e tem o mesmo hash de formato que . A amostra tem pelo menos 10,000 programas por linguagem em pelo menos dez linguagens, extraídos de corpora públicos com versão fixada e semente fixa. O elevador é congelado e o seu hash binário é registrado antes de cada execução, com 0 chamadas a modelo. Cada execução relata a fração elevada com o seu intervalo de Wilson de 95%, e cada construção ainda não elevada é um item de trabalho para o elevador dessa linguagem, construído e congelado antes da execução seguinte. O alvo é todo programa em toda linguagem.
9. Falseadores
Fixados antes das execuções que testam.
| ID | Observação | Derruba |
|---|---|---|
| RCE-F0 | Numa execução pré-registrada de pelo menos 10,000 Formas, alguma projeção emite um traço diferente do traço de referência da Forma, ou alguma entrada malformada é aceita | A afirmação de que as projeções são fiéis e de que a porta rejeita no ponto de entrada |
| RCE-F1 | Na fatia reservada, G0 a G2 com regras congeladas resolvem menos de 10% das tarefas com 0 chamadas a modelo | A afirmação de que a maioria dos ajustes já existe para reparo nessa escala |
| RCE-F2 | Patches idênticos byte a byte ou equivalentes são menos da metade das tarefas reservadas resolvidas | A leitura da porta como mais do que plausibilidade nas tarefas cobertas |
| RCE-F3 | Sob o medidor de parede, os joules brutos por tarefa resolvida do solucionador RCE excedem os da linha de base de modelo mais barata nas tarefas que ambos resolvem | A afirmação de menor energia por tarefa resolvida nas tarefas cobertas |
| RCE-F4 | No protocolo de convergência da Seção 8.6, menos da metade das especificações sem entrada travada chega a uma rodada com zero chamadas a modelo em até 20 rodadas | Compilar o modelo para fora do laço |
10. Trabalho a concluir
Cada item tem o seu protocolo nomeado.
- Elevação construída e medida em pelo menos dez linguagens, segundo o protocolo da Seção 8.7.
- O braço de especificação: as especificações de estilo MBPP e HumanEval escritas como Formas e emitidas para todos os alvos.
- Resultados reservados em L2 a L4, o conjunto Defects4J de 288 defeitos (Seção 8.1), e em L5 a L7 (Seção 8.2).
- Linhas de base numa tabela, cost-of-pass em joules e dólares (Seção 8.5).
- Uma série de
measured_j: um medidor de parede num host ocioso, pelo menos 10 repetições, bruto e líquido lado a lado (Seção 8.3). - O levantamento das 626 linguagens publicado com o seu método (Figura 1).
- Novos corpora reservados com as engrenagens congeladas: Multi-SWE-bench e BugsInPy (Seção 8.4).
- Convergência das chamadas a modelo em pelo menos 1,000 especificações (Seção 8.6).
11. Conclusão
O RCE é um ecossistema de código nativo. Um programa é escrito uma vez a partir da intenção, como uma Forma, uma codificação sem perdas do estado, dos eventos e das transições puras, e cada linguagem alvo é uma projeção fiel dela. Um estado ilegal não pode ser escrito e uma entrada ilegal é rejeitada no ponto de entrada, então um programa no ecossistema não se afasta da sua intenção e não precisa de comparação de diferenças nem de rastreamento de erros depois do fato. Cada ajuste que passa pela porta é armazenado e reutilizado, e o ecossistema cresce de forma cumulativa sob uma porta na qual a correção é monotônica. Em 10,000 Formas pré-registradas, com o motor congelado e 0 chamadas a modelo, toda Forma faz a ida e volta para bytes idênticos, toda projeção é determinística, toda entrada e especificação malformada é rejeitada no ponto de entrada, e a projeção Python reproduz o traço de referência em 9,999. O código de outras linguagens entra por elevação, uma construção a partir da gramática de cada linguagem, passando pela sua árvore sintática, até a Forma; no código elevado, as engrenagens de reparo restauram 99.95% de 520,821 falhas de um token e 63.7% de 21,320 defeitos Java de uma instrução. As Seções 3.6 e 8.7 dão as proposições da universalidade e como a sua construção é medida.
Referências
[1] C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal 30(1), 1951. doi:10.1002/j.1538-7305.1951.tb01366.x
[2] Y. Gurevich, “Sequential Abstract State Machines Capture Sequential Algorithms,” ACM Transactions on Computational Logic 1(1), 2000. doi:10.1145/343369.343384
[3] A. Blass and Y. Gurevich, “Abstract State Machines Capture Parallel Algorithms,” ACM Transactions on Computational Logic, 2003. doi:10.1145/937555.937561
[4] N. Dershowitz and Y. Gurevich, “A Natural Axiomatization of Computability and Proof of Church’s Thesis,” Bulletin of Symbolic Logic, 2008. doi:10.2178/bsl/1231081370
[5] E. F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM, 1970. doi:10.1145/362384.362685
[6] G. H. Mealy, “A Method for Synthesizing Sequential Circuits,” Bell System Technical Journal, 1955. doi:10.1002/j.1538-7305.1955.tb03788.x
[7] E. F. Moore, “Gedanken-Experiments on Sequential Machines,” Automata Studies, 1956. doi:10.1515/9781400882618-006
[8] K. Kang et al., “Feature-Oriented Domain Analysis (FODA) Feasibility Study,” CMU/SEI-90-TR-021, 1990.
[9] R. Alur et al., “Syntax-Guided Synthesis,” FMCAD 2013. doi:10.1109/FMCAD.2013.6679385
[10] D. Harel, “Statecharts: A Visual Formalism for Complex Systems,” Science of Computer Programming, 1987. doi:10.1016/0167-6423(87)90035-9
[11] R. Tate, M. Stepp, Z. Tatlock and S. Lerner, “Equality Saturation,” POPL 2009. doi:10.1145/1480881.1480915
[12] M. Willsey et al., “egg: Fast and Extensible Equality Saturation,” POPL 2021. doi:10.1145/3434304
[13] B. Moseley and P. Marks, “Out of the Tar Pit,” 2006.
[14] M. Fowler, “Event Sourcing,” 2005. https://martinfowler.com/eaaDev/EventSourcing.html
[15] P. Alvaro et al., “Dedalus: Datalog in Time and Space,” LNCS 2011. doi:10.1007/978-3-642-24206-9_16
[16] A. M. Turing, “On Computable Numbers,” Proceedings of the London Mathematical Society, 1937. doi:10.1112/plms/s2-42.1.230
[17] A. Church, “An Unsolvable Problem of Elementary Number Theory,” American Journal of Mathematics, 1936. doi:10.2307/2371045
[18] P. Wadler, “Propositions as Types,” Communications of the ACM, 2015. doi:10.1145/2699407
[19] J. M. Hellerstein and P. Alvaro, “Keeping CALM,” Communications of the ACM, 2020. doi:10.1145/3369736
[20] G. Kahn, “The Semantics of a Simple Language for Parallel Programming,” IFIP 1974, pp. 471 to 475.
[21] H. Husain et al., “CodeSearchNet Challenge,” 2019. arXiv:1909.09436
[22] D. Kim, J. Nam, J. Song and S. Kim, “Automatic Patch Generation Learned from Human-Written Patches” (PAR), ICSE 2013. doi:10.1109/ICSE.2013.6606626
[23] K. Liu et al., “TBar: Revisiting Template-based Automated Program Repair,” ISSTA 2019. arXiv:1903.08409
[24] K. Liu et al., “AVATAR: Fixing Semantic Bugs with Fix Patterns of Static Analysis Violations,” SANER 2019. arXiv:1812.07270
[25] A. Koyuncu et al., “FixMiner: Mining Relevant Fix Patterns for Automated Program Repair,” 2018. arXiv:1810.01791
[26] Y. Padioleau et al., “Documenting and Automating Collateral Evolutions in Linux Device Drivers” (Coccinelle), EuroSys 2008. doi:10.1145/1352592.1352618
[27] A. Solar-Lezama et al., “Combinatorial Sketching for Finite Programs,” ASPLOS 2006. doi:10.1145/1168857.1168907
[28] L. Chen, M. Zaharia and J. Zou, “FrugalGPT,” 2023. arXiv:2305.05176
[29] S. Haber and W. S. Stornetta, “How to Time-Stamp a Digital Document,” Journal of Cryptology, 1991. doi:10.1007/BF00196791
[30] S. A. Crosby and D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging,” USENIX Security 2009.
[31] L. de Moura and N. Bjørner, “Z3: An Efficient SMT Solver,” TACAS 2008. doi:10.1007/978-3-540-78800-3_24
[32] Kani Rust Verifier. https://github.com/model-checking/kani
[33] C. V. Lopes et al., “DéjàVu: A Map of Code Duplicates on GitHub,” OOPSLA 2017. doi:10.1145/3133908
[34] M. Gabel and Z. Su, “A Study of the Uniqueness of Source Code,” FSE 2010. doi:10.1145/1882291.1882315
[35] A. Hindle et al., “On the Naturalness of Software,” ICSE 2012. doi:10.1109/ICSE.2012.6227135
[36] D. Kocetkov et al., “The Stack: 3 TB of Permissively Licensed Source Code,” 2022. arXiv:2211.15533; The Stack v2 dataset card, https://huggingface.co/datasets/bigcode/the-stack-v2
[37] R. Just, D. Jalali and M. D. Ernst, “Defects4J: A Database of Existing Faults to Enable Controlled Testing Studies for Java Programs,” ISSTA 2014. doi:10.1145/2610384.2628055
[38] C. E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. arXiv:2310.06770
[39] R. Aleithan et al., “SWE-Bench+: Enhanced Coding Benchmark for LLMs,” 2024. arXiv:2410.06992
[40] C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal 27, 1948. doi:10.1002/j.1538-7305.1948.tb01338.x
[41] A. N. Kolmogorov, “Three approaches to the quantitative definition of information,” Problemy Peredachi Informatsii 1(1), 1965 (in Russian); English translation, International Journal of Computer Mathematics 2, 1968. doi:10.1080/00207166808803030
[42] R. J. Solomonoff, “A formal theory of inductive inference. Part I,” Information and Control 7(1), 1964. doi:10.1016/S0019-9958(64)90223-2
[43] G. J. Chaitin, “A Theory of Program Size Formally Identical to Information Theory,” Journal of the ACM 22(3), 1975. doi:10.1145/321892.321894
[44] J. Rissanen, “Modeling by shortest data description,” Automatica 14(5), 1978. doi:10.1016/0005-1098(78)90005-5
[45] B. Ray, V. Hellendoorn, S. Godhane, Z. Tu, A. Bacchelli and P. Devanbu, “On the ‘naturalness’ of buggy code,” ICSE 2016. doi:10.1145/2884781.2884848
[46] Z. Tu, Z. Su and P. Devanbu, “On the localness of software,” FSE 2014. doi:10.1145/2635868.2635875
[47] M. Allamanis, E. T. Barr, P. Devanbu and C. Sutton, “A Survey of Machine Learning for Big Code and Naturalness,” ACM Computing Surveys 51(4), 2018. doi:10.1145/3212695
[48] 陈浙哲, 刘忠鑫, 鄢萌, 徐洲, 夏鑫, 雷晏 (Z. Chen, Z. Liu, M. Yan, Z. Xu, X. Xia and Y. Lei), “代码自然性及其应用研究进展” (Research progress of code naturalness and its application), 软件学报 (Journal of Software) 33(8), 3015 to 3034, 2022. doi:10.13328/j.cnki.jos.006355
[49] G. Sridhara, V. S. Sinha and S. Mani, “Naturalness of Natural Language Artifacts in Software,” ISEC 2015 (India Software Engineering Conference). doi:10.1145/2723742.2723758
[50] P. Devanbu, “On the naturalness of software,” keynote, ISEC 2013 (India Software Engineering Conference). doi:10.1145/2442754.2442763
[51] A. Z. H. Yang, S. Kolak, V. J. Hellendoorn, R. Martins et al., “Revisiting Unnaturalness for Automated Program Repair in the Era of Large Language Models,” ICSE 2025. doi:10.1109/ICSE55347.2025.00089
[52] E. W. Dijkstra, “Guarded commands, nondeterminacy and formal derivation of programs,” Communications of the ACM 18(8), 1975. doi:10.1145/360933.360975
[53] N. Wirth, “Program development by stepwise refinement,” Communications of the ACM 14(4), 1971. doi:10.1145/362575.362577
[54] C. A. R. Hoare, “An axiomatic basis for computer programming,” Communications of the ACM 12(10), 1969. doi:10.1145/363235.363259
[55] J.-R. Abrial, The B-Book: Assigning Programs to Meanings, Cambridge University Press, 1996. doi:10.1017/CBO9780511624162
[56] J.-R. Abrial, Modeling in Event-B: System and Software Engineering, Cambridge University Press, 2010. doi:10.1017/CBO9781139195881
[57] R.-J. Back and J. von Wright, Refinement Calculus: A Systematic Introduction, Springer, 1998. doi:10.1007/978-1-4612-1674-2
[58] F. L. Bauer and H. Wössner, Algorithmic Language and Program Development, Springer, 1982. doi:10.1007/978-3-642-61807-9
[59] S. Gulwani, “Automating string processing in spreadsheets using input-output examples,” POPL 2011. doi:10.1145/1926385.1926423
[60] S. Gulwani, O. Polozov and R. Singh, “Program Synthesis,” Foundations and Trends in Programming Languages 4(1-2), 2017. doi:10.1561/2500000010
[61] F. P. Brooks, “No Silver Bullet: Essence and Accidents of Software Engineering,” Computer 20(4), 1987. doi:10.1109/MC.1987.1663532
[62] P. Naur, “Programming as theory building,” Microprocessing and Microprogramming 15(5), 1985. doi:10.1016/0165-6074(85)90032-8
[63] M. M. Lehman, “Programs, life cycles, and laws of software evolution,” Proceedings of the IEEE 68(9), 1980. doi:10.1109/PROC.1980.11805
[64] P. Zave and M. Jackson, “Four dark corners of requirements engineering,” ACM Transactions on Software Engineering and Methodology 6(1), 1997. doi:10.1145/237432.237434
[65] R. Landauer, “Irreversibility and Heat Generation in the Computing Process,” IBM Journal of Research and Development 5(3), 1961. doi:10.1147/rd.53.0183
[66] C. H. Bennett, “Logical Reversibility of Computation,” IBM Journal of Research and Development 17(6), 1973. doi:10.1147/rd.176.0525
[67] M. Franz and T. Kistler, “Slim binaries,” Communications of the ACM 40(12), 1997. doi:10.1145/265563.265576
[68] C. W. Fraser, “Automatic inference of models for statistical code compression,” PLDI 1999. doi:10.1145/301618.301672
[69] P. Cousot and R. Cousot, “Abstract interpretation: a unified lattice model for static analysis of programs by construction or approximation of fixpoints,” POPL 1977. doi:10.1145/512950.512973
[70] Y. Futamura, “Partial evaluation of computation process: an approach to a compiler-compiler,” Systems, Computers, Controls 2(5), 1971; reprinted in Higher-Order and Symbolic Computation 12(4), 1999. doi:10.1023/A:1010095604496
[71] A. P. Ershov, “Mixed computation: potential applications and problems for study,” Theoretical Computer Science 18(1), 1982. doi:10.1016/0304-3975(82)90111-6
[72] W. A. Howard, “The formulae-as-types notion of construction,” in J. P. Seldin and J. R. Hindley (eds.), To H. B. Curry: Essays on Combinatory Logic, Lambda Calculus and Formalism, Academic Press, 1980.
[73] 土居真之, 肥後芳樹, 有馬諒, 下仲健斗, 楠本真二 (M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto), “ソースコードの「自然さ」を利用した自動生成ファイルの特定” (Identifying auto-generated files using the naturalness of source code), 電子情報通信学会技術研究報告 (IEICE Technical Report) 117(380), 19 to 24, January 2018. https://sdl.ist.osaka-u.ac.jp/pman/pman3.cgi?D=517
[74] M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto, “On the naturalness of auto-generated code: can we identify auto-generated code automatically?” ICPC 2018. doi:10.1145/3196321.3196356
[75] F. V. Arrebola, “Modelo de sugestão de código-fonte baseado em modelos de linguagem organizados em um contexto hierárquico” (A source code suggestion model based on language models organized in a hierarchical context), doctoral thesis in electrical engineering, Fundação Educacional Inaciana Padre Sabóia de Medeiros (FEI), Brazil, 2018. Advisor R. A. C. Bianchi.
[76] G. Febres, K. Jaffé and C. Gershenson, “Complexity measurement of natural and artificial languages,” Complexity 20(6), 2015. doi:10.1002/cplx.21529
[77] M. Rahman, D. Palani and P. C. Rigby, “Natural Software Revisited,” ICSE 2019. doi:10.1109/ICSE.2019.00022
[78] A. Torres, S. Baltes, C. Treude and M. Wagner, “Applying Information Theory to Software Evolution,” NLBSE 2023. doi:10.1109/NLBSE59153.2023.00017
[79] A. Blass, N. Dershowitz and Y. Gurevich, “When are two algorithms the same?,” Bulletin of Symbolic Logic 15(2), 2009. arXiv:0811.0811. https://arxiv.org/abs/0811.0811
[80] Y. N. Moschovakis, “What is an algorithm?,” in Mathematics Unlimited: 2001 and Beyond, Springer, 2001. https://www.math.ucla.edu/~ynm/papers/eng.pdf
[81] M. Y. Vardi, “What is an algorithm?,” Communications of the ACM 55(3), 2012. doi:10.1145/2093548.2093549
[82] S. Laddad, A. Cheung, J. M. Hellerstein and M. Milano, “Flo: a Semantic Foundation for Progressive Stream Processing,” POPL 2025. arXiv:2411.08274. https://arxiv.org/abs/2411.08274
[83] The Elm Architecture, Elm guide. https://guide.elm-lang.org/architecture/
[84] Temporal, “Workflows” (event history), documentation. https://docs.temporal.io/workflows
[85] A. Pnueli, M. Siegel and E. Singerman, “Translation validation,” TACAS 1998. doi:10.1007/BFb0054170
[86] X. Yang, Y. Chen, E. Eide and J. Regehr, “Finding and understanding bugs in C compilers,” PLDI 2011. doi:10.1145/1993498.1993532
[87] C. Nandi, M. Willsey, A. Zhu et al., “Rewrite Rule Inference Using Equality Saturation,” OOPSLA 2021. arXiv:2108.10436. https://arxiv.org/abs/2108.10436
[88] C. Le Goues, T. Nguyen, S. Forrest and W. Weimer, “GenProg: A Generic Method for Automatic Software Repair,” IEEE TSE 38(1), 2012. doi:10.1109/TSE.2011.104
[89] F. Long and M. Rinard, “Automatic patch generation by learning correct code,” POPL 2016. doi:10.1145/2837614.2837617
[90] J. Bader, A. Scott, M. Pradel and S. Chandra, “Getafix: Learning to Fix Bugs Automatically,” OOPSLA 2019. arXiv:1902.06111. https://arxiv.org/abs/1902.06111
[91] K. Etemadi, N. Harrand, S. Larsen et al., “Sorald: Automatic Patch Suggestions for SonarQube Static Analysis Violations,” IEEE TDSC, 2022. arXiv:2103.12033. https://arxiv.org/abs/2103.12033
[92] Z. Qi, F. Long, S. Achour and M. Rinard, “An analysis of patch plausibility and correctness for generate-and-validate patch generation systems,” ISSTA 2015. doi:10.1145/2771783.2771791
[93] E. K. Smith, E. T. Barr, C. Le Goues and Y. Brun, “Is the cure worse than the disease? Overfitting in automated program repair,” ESEC/FSE 2015. doi:10.1145/2786805.2786825
[94] X.-B. D. Le, F. Thung, D. Lo and C. Le Goues, “Overfitting in semantics-based automated program repair,” Empirical Software Engineering 23, 2018. doi:10.1007/s10664-017-9577-2
[95] Y. Xiong, X. Liu, M. Zeng, L. Zhang and G. Huang, “Identifying patch correctness in test-based program repair,” ICSE 2018. doi:10.1145/3180155.3180182
[96] T. Durieux, F. Madeiral, M. Martinez and R. Abreu, “Empirical Review of Java Program Repair Tools: A Large-Scale Experiment on 2,141 Bugs and 23,551 Repair Attempts,” ESEC/FSE 2019. arXiv:1905.11973. https://arxiv.org/abs/1905.11973
[97] K. Liu, A. Koyuncu, T. F. Bissyandé et al., “You Cannot Fix What You Cannot Find! An Investigation of Fault Localization Bias in Benchmarking Automated Program Repair Systems,” ICST 2019. arXiv:1812.07283. https://arxiv.org/abs/1812.07283
[98] M. Monperrus, “Automatic Software Repair: A Bibliography,” ACM Computing Surveys 51(1), 2018. doi:10.1145/3105906
[99] C. S. Xia, Y. Deng, S. Dunn and L. Zhang, “Agentless: Demystifying LLM-based Software Engineering Agents,” 2024. arXiv:2407.01489. https://arxiv.org/abs/2407.01489
[100] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir and A. Narayanan, “AI Agents That Matter,” 2024. arXiv:2407.01502. https://arxiv.org/abs/2407.01502
[101] M. H. Erol, B. El, M. Suzgun, M. Yuksekgonul and J. Zou, “Cost-of-Pass: An Economic Framework for Evaluating Language Models,” 2025. arXiv:2504.13359. https://arxiv.org/abs/2504.13359
[102] D. Zan, Z. Huang, W. Liu et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving,” 2025. arXiv:2504.02605. https://arxiv.org/abs/2504.02605
[103] R. Widyasari, S. Q. Sim, C. Lok et al., “BugsInPy: a database of existing bugs in Python programs to enable controlled testing and debugging studies,” ESEC/FSE 2020. doi:10.1145/3368089.3417943
[104] M. Allamanis, “The Adverse Effects of Code Duplication in Machine Learning Models of Code,” Onward! 2019. arXiv:1812.06469. https://arxiv.org/abs/1812.06469
[105] K. N. Khan, M. Hirki, T. Niemi, J. K. Nurminen and Z. Ou, “RAPL in Action: Experiences in Using RAPL for Power Measurements,” ACM TOMPECS 3(2), 2018. doi:10.1145/3177754
[106] The Rust project, rustfix and cargo fix. https://github.com/rust-lang/rustfix
[107] R.-M. Karampatsis and C. Sutton, “How Often Do Single-Statement Bugs Occur? The ManySStuBs4J Dataset,” MSR 2020. doi:10.1145/3379597.3387491
[108] C. Richter and H. Wehrheim, “TSSB-3M: Mining single statement bugs at massive scale,” MSR 2022. doi:10.1145/3524842.3528505
[109] H. Coles, T. Laurent, C. Henard, M. Papadakis and A. Ventresque, “PIT: a practical mutation testing tool for Java,” ISSTA 2016. doi:10.1145/2931037.2948707
[110] R. Just, D. Jalali, L. Inozemtseva, M. D. Ernst, R. Holmes and G. Fraser, “Are mutants a valid substitute for real faults in software testing?” FSE 2014. doi:10.1145/2635868.2635929
[111] I. J. Good, “Speculations Concerning the First Ultraintelligent Machine,” Advances in Computers 6, 1965. doi:10.1016/S0065-2458(08)60418-0
[112] J. Schmidhuber, “Gödel Machines: Fully Self-referential Optimal Universal Self-improvers,” in Artificial General Intelligence, Springer, 2007. doi:10.1007/978-3-540-68677-4_7
[113] E. Yudkowsky, “Intelligence Explosion Microeconomics,” Technical report 2013-1, Machine Intelligence Research Institute, 2013. https://intelligence.org/files/IEM.pdf
[114] M. H. Löb, “Solution of a Problem of Leon Henkin,” Journal of Symbolic Logic 20(2), 1955. doi:10.2307/2266895
[115] E. Yudkowsky and M. Herreshoff, “Tiling Agents for Self-Modifying AI, and the Löbian Obstacle,” Machine Intelligence Research Institute, 2013. https://intelligence.org/files/TilingAgentsDraft.pdf
[116] E. Zelikman, E. Lorch, L. Mackey and A. T. Kalai, “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation,” 2023. doi:10.48550/arXiv.2310.02304
[117] J. Zhang, S. Hu, C. Lu, R. Lange and J. Clune, “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents,” 2025. doi:10.48550/arXiv.2505.22954
[118] A. Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery,” 2025. doi:10.48550/arXiv.2506.13131
[119] G. Wang, Y. Xie, Y. Jiang, A. Mandlekar, C. Xiao, Y. Zhu, L. Fan and A. Anandkumar, “Voyager: An Open-Ended Embodied Agent with Large Language Models,” 2023. doi:10.48550/arXiv.2305.16291
[120] Y. Futamura, “Partial Evaluation of Computation Process: An Approach to a Compiler-Compiler,” Higher-Order and Symbolic Computation 12(4), 1999 (first published 1971). doi:10.1023/A:1010095604496
[121] V. F. Turchin, “The Concept of a Supercompiler,” ACM Transactions on Programming Languages and Systems 8(3), 1986. doi:10.1145/5956.5957
[122] J. N. Foster, M. B. Greenwald, J. T. Moore, B. C. Pierce and A. Schmitt, “Combinators for Bidirectional Tree Transformations: A Linguistic Approach to the View-Update Problem,” ACM Transactions on Programming Languages and Systems 29(3), 2007. doi:10.1145/1232420.1232424
[123] M. Hofmann, B. Pierce and D. Wagner, “Symmetric Lenses,” POPL, 2011. doi:10.1145/1926385.1926428
[124] K. Czarnecki, J. N. Foster, Z. Hu, R. Lämmel, A. Schürr and J. F. Terwilliger, “Bidirectional Transformations: A Cross-Discipline Perspective,” ICMT, LNCS 5563, 2009. doi:10.1007/978-3-642-02408-5_19
[125] E. W. Dijkstra, “A Constructive Approach to the Problem of Program Correctness,” BIT 8(3), 1968. doi:10.1007/BF01933419
[126] A. Hall and R. Chapman, “Correctness by Construction: Developing a Commercial Secure System,” IEEE Software 19(1), 2002. doi:10.1109/52.976937
[127] Y. Minsky, “OCaml for the Masses,” Communications of the ACM 54(11), 2011. doi:10.1145/2018396.2018413
[128] D. A. Turner, “Total Functional Programming,” Journal of Universal Computer Science 10(7), 2004. doi:10.3217/jucs-010-07-0751
[129] R. Di Cosmo and S. Zacchiroli, “Software Heritage: Why and How to Preserve Software Source Code,” iPRES 2017, Kyoto. https://hal.science/hal-01590958
[130] Software Heritage, archive counters, read 13 October 2026: 30,253,266,524 file contents and 448,311,919 origins. https://archive.softwareheritage.org/api/1/stat/counters/
[131] Rosetta Code, main page, read 13 October 2026: 1,360 tasks, 421 draft tasks, 1,009 known languages. https://rosettacode.org/wiki/Rosetta_Code