Reality Code Engine:ネイティブで検証済み、低エネルギーなプログラミングのためのひとつの可逆な形式
プログラムを状態機械として一度だけ書き、すべての対象言語をそこから生成するプログラミング方式。往復、不正な入力の拒否、持ち上げたコードの修復についての測定を示す。
David Charlot, Open Interface Engineering
本稿は英語版の翻訳です。相違がある場合は英語版が優先します。 英語の原文.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Reality Code Engine:ネイティブで検証済み、低エネルギーなプログラミングのためのひとつの可逆な形式. Open Interface Engineering. Web: https://research.openie.dev/papers/rce/. PDF: https://research.openie.dev/pdfs/rce.pdf.
バージョン 1.4、2026年10月13日。仕様:現行草案(草案 0.7 文書、言語バージョン 0.8)、openIE-dev/rce 2a0ec68 より。1.4 での変更:エンジンのテスト数は cargo test --release が実行する 589 個の異なるテストである(1.3 は make check の合計である 596 を記載したが、これは 7 個の証明テストを二度数えている)。第3.7節は、仕様 2.7 が C.15 の呼び出し箇所ごとのコスト規則を示すようになったことを述べる。第5.5節の決定的な提案者は、エンジンのテストに基づき、提示 87 個、受理 9 個、却下 78 個として報告する。第7節の Software Heritage と Rosetta Code には参考文献 [129] から [131] を付け、アーカイブのカウンタを読み直した。九つの図(図5から10、12、13、15)を追加し、以前の図5と図6は図11と図14になった。1.3 での変更:受け手の大きさに応じて増えるメソッドのコストを言語バージョン 0.7 に帰属させ(1.2 では 0.6 の下で記述していた)、バージョンが混在するプログラムに対する呼び出し箇所ごとの規則を述べ、検査をエンジンのコミット 1eb5f02 で再実行した。データとコード:research.openie.dev/data/。プレイグラウンド(参照チェッカー):openie-dev.github.io/rce。エンジンデモ:/demos/rce-engine/。LaTeX PDF:/pdfs/latex/rce.pdf(ソース)。
訂正と再現性の状況(2026年10月17日)。 この注記は、本論文を公開リポジトリと照合して読んだ後に追加した。影響を受ける数値をここに挙げ、以下の本文はそれ以外は変更していない。以下のすべての件数は src/data/rce-facts.json に由来し、これは openIE-dev/rce の e416fd0 において scripts/claim-counts.py が生成したものである。ただし Lean の二つの件数は 4304048 において取得した。
- 一つの言語(2026年10月18日)。 公開
rceの main(4a3dc1f)は単一の言語と単一のテキストをもつ。# rce-version:行は許容され無視されるリリースラベルであり、ハッシュされない。リリースラベルはちょうど一つの仕様コミットを名指す(C.15)。チェッカーが実装していない構成要素は、バージョンに基づいてではなく、予約済みで未実装として拒否される(W-RES-1、付録 F.12)。予約語のリストは一つである。したがって、バージョンゲート(バージョン 0.5 から 0.9)を記述する第3.7節と図5は以前の草案を記述しており、もはや当てはまらない。失敗した呼び出しはその&mut引数を復元し(F.4.4)、これが定理 T33 の書き戻し規則に取って代わる。以下の件数はe416fd0において、この変更の前に取得したものであり、再実行していない。T33 の証明は規則とともに変わった。すべての結果で書き戻すという廃止された定理は監査対象の木から外れ(公開rceの main95ead2e)、T33 は現在 F.4.4 の復元を証明する。監査は標準の公理のみで 4875 個の定理を読む。 - ライブラリ名(rce-stdlib、2026年10月18日)。 予約語のリストは大域的であるため、それが現在予約しているライブラリ名は改名された。
labelはlblに、nodeはndに、groupはgrpに、childはchdに、budgetはbudに、restartはrstに、replicatedはreplに、ctはctextに、sessionはsessに、protocolはprotoに、parはparlに、offerはoffrに、chooseはchseになった。型Json(モジュールenc)とUrl(モジュールnet.url)は現在JsonDocとUrlPartsであり、enc.Jsonまたはnet.url.Urlをインポートするプログラムは新しい名前を使わなければならない。text値のテキスト長.len()は.len_bytes()(バイト)または.len_chars()である。 e416fd0におけるバージョンと件数。 仕様文書は草案 0.9 である(cdae5cf以降公開)。10月18日より前、参照チェッカーは言語バージョン 0.5 から 0.9 を受け付け、バージョン 0.9 のうち実装していない部分をバージョンに基づいて拒否していた(付録 F.12)。定理 T1 から T56 が述べられており、T42 から T56(付録 F)は述べられているが証明されていない。Lean のモジュールは 58 個、例のプログラムは 59 個(最上位に 57 個、パッケージ内に 2 個)である。本論文の図とキャプションのうち草案 0.7、言語バージョン 0.8、T1 から T34、31 個のファイル、51 個の例と述べるものは、それらが名指す以前のコミットにおけるリポジトリを記述しており、本論文はこの注記を超えて草案 0.9 を記述しない。- Lean の定理の数。 二つの異なる件数がある。ソースには
e416fd0においてtheoremとlemmaの宣言が 1,116 個ある(4304048では 885 個)。監査(scripts/lean-audit.sh)はカーネル環境にあるすべての定理定数を、エラボレータが生成する定数も含めて数え、e416fd0において公開リポジトリに対して再実行すると 4,877 となった。そこではlake buildがspec/lean/RCE/の 58 個のファイルに対してsorryなしで、標準の公理のみで完了する(4304048では 46 個のファイルに対して 2,949)。以下に引く 2,192 は、エンジンのコミット1eb5f02における 31 個のモジュールに対する監査の件数である。どちらの数も、Rust の評価器について何個の定理が証明されているかについては何も述べない。 - 現在、公開リポジトリから再現できるもの: Lean のビルドと公理の監査、仕様の検査(文法の表と例のコーパス)、参照チェッカーとそのテスト、正準 JSON のベクトル。
- まだ公開リポジトリから再現できないもの: 10,000 個の形式に対するエコシステムの実行(
bench/ecosystemは公開リポジトリにない)、Kani の結果、589 個のエンジンのテスト、第6節の修復率、および Defects4J のあらゆる数値。これらは著者ら自身の実行としてここに報告するものであり、ソースとシードが公開されるまではそのように読むべきである。 - 反証条件 RCE-F0。 下記の第2.3節の注記を参照。
要約
本論文は Reality Code Engine(RCE)を記述する。これはプログラムを状態機械、すなわち形式として一度だけ書き、他の言語のコードをそこから生成するシステムである。10,000 個の形式と公開バグデータセットで測定した内容を報告し、主張をどのように偽と示せるかを述べる。
平易な言葉で
- プログラムは一度だけ、一つの精密な形式で書かれ、コンピュータはそこから多くの言語で同じプログラムを生成する。
- 形式は宣言されたものだけを許すので、壊れた入力は後で直されるのではなく、入口で拒否される。
- 検査を通過した修正は保存されて再利用されるので、同じ問題に時間やエネルギーを二度払わずに済む。
1. 主張
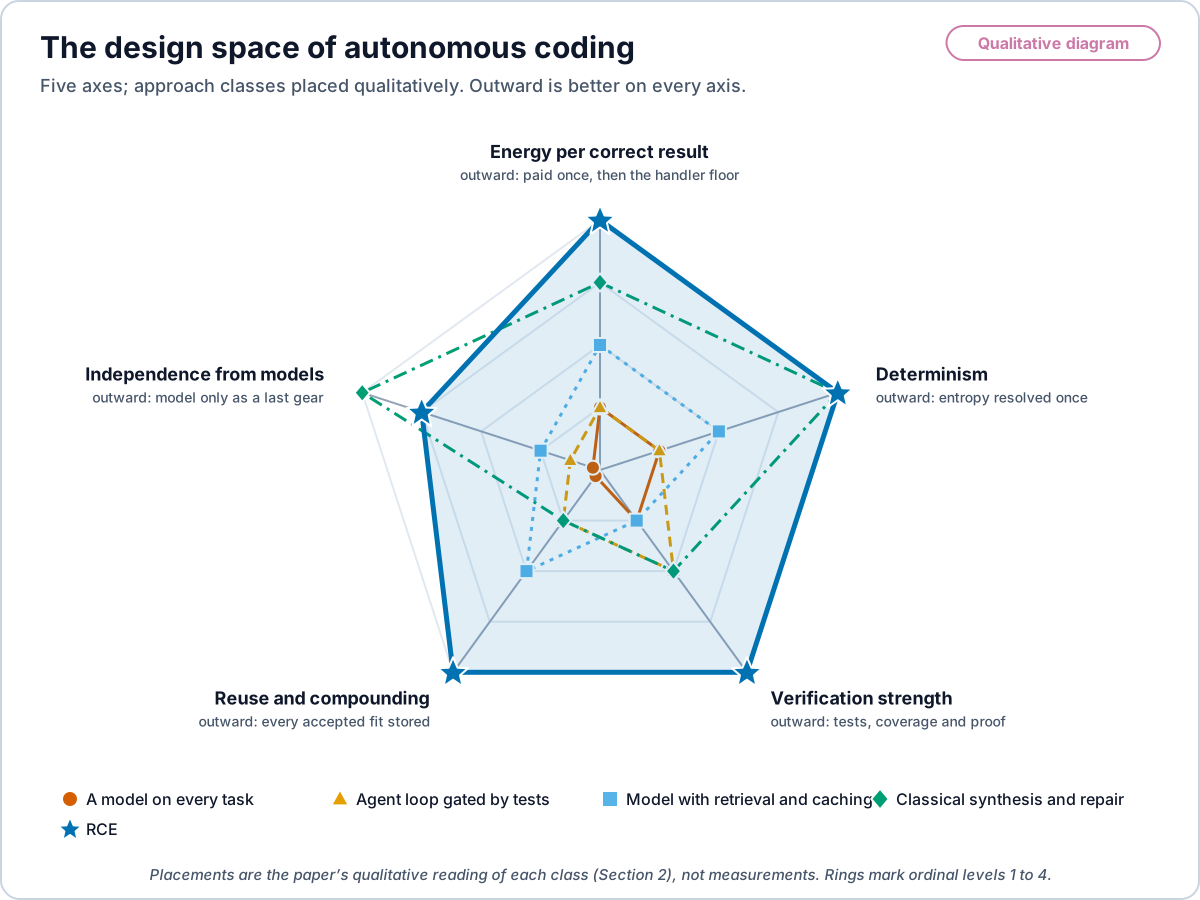
自律的なコンピュータ自動化は、多くの点を含む設計空間である。どの手法も、五つの連続的な軸のどこかに位置する。正しい結果一つあたりに費やすエネルギー、システムが実行時に解消しなければならないエントロピーとそれに伴う出力の決定性の度合い、結果を受け入れる検証の強さ、受け入れられた各結果がどこまで再利用され複利的に積み上がるか、そして手法がどれだけモデルに依存するか、の五つである。プロンプトから個々の変更を書く大規模言語モデル(LLM)、すなわち統計的なテキストモデルは、この空間の一つの隅の近くに位置する。それはどのタスクでもモデルに依存し、毎回高エントロピー分布から新しい標本を引き、どのタスクでも生成の費用を改めて支払う。検索、規則、合成、検証、キャッシュは他の多くの点を占め、実際のシステムはそれらを組み合わせる。
Reality Code Engine(RCE)はこの空間の一つの点であり、本論文はそれを記述し測定する。RCE はプログラムをデータベース関数型状態機械としてモデル化する。Lopes らは GitHub 上のコードの約 70% が以前のファイルのクローンであることを測定した [33]。したがって RCE はまず既存の適合を取り出し、適合させ、検査することを試し、より安いものでタスクを閉じられないときにだけモデルを呼び出す。
中心的な主張。 RCE は、プログラムが意図からネイティブに書かれる完全なコード・エコシステムである。意図は一度だけ、形式として書かれる。すなわち、一つの状態、一組のイベント、そして純粋で全域的な遷移である。形式はその意図の可逆(無損失)な符号化である。すべてのターゲット(ステートチャート、Rust、Python、XState、SCXML、WASM)は形式の射影であり、各射影は形式のトレースをバイト単位で再生する。形式が宣言していない状態は書くことができず、契約の外にある入力は入口で拒否される。したがって、エコシステム内のプログラムは、一般的な言語のプログラムがコメントやテストや他の実装からずれていくようには、その意図からずれることがなく、事後の差分比較もエラー追跡も必要としない。ゲートを通過したすべての適合は保存されて再利用されるので、エコシステムは成長とともに複利的に積み上がる(§2.4)。他の言語で書かれたコードは入口の一つであり、持ち上げ(lift)によって入る(§6)。
空間のどの点も同じゲートに向き合う。ゲートは正しさである。すなわちタスクの完了述語 であり、ここではタスクのテスト、証明、または一致トレースを指す。ゲートを通過した実行の中で、システムは完了までのジュール によって順位づけられる。正しさは制約であって、得点ではない。
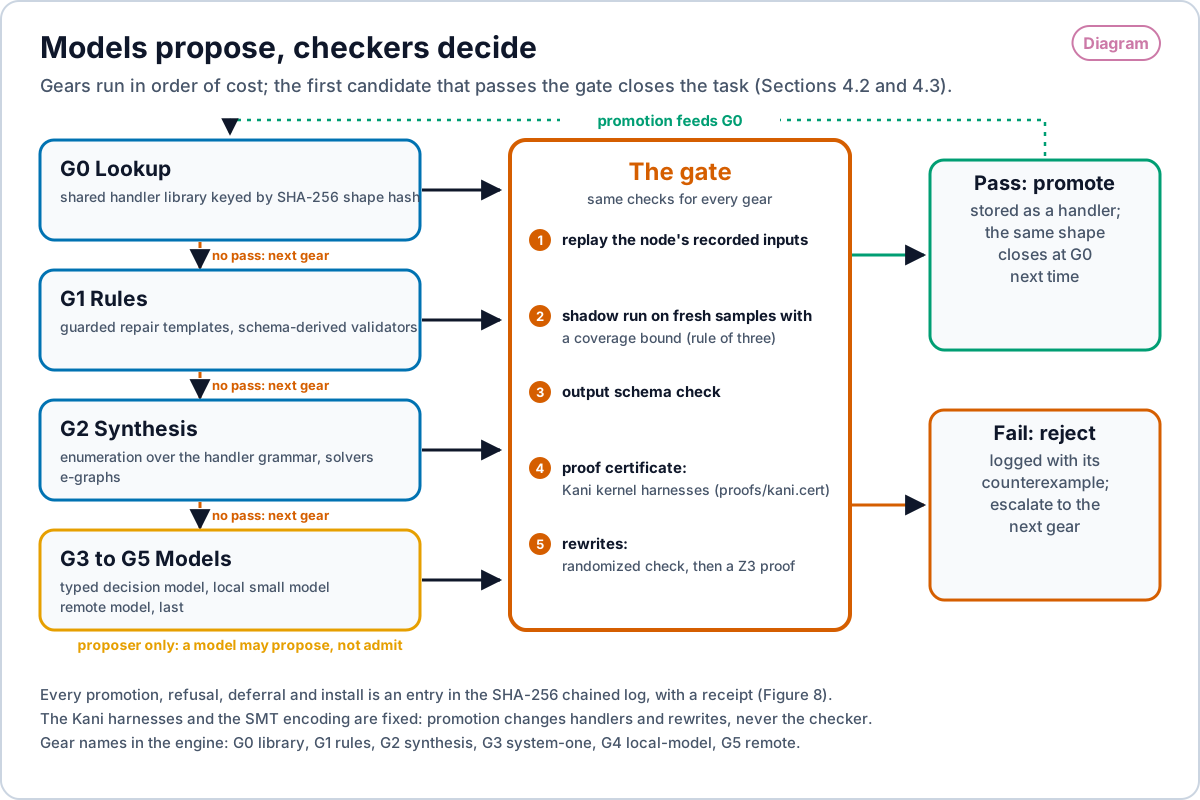
RCE の仕組み、すなわちギアは費用の順に動き、ゲートを通過した最初のギアがタスクを閉じる。
エネルギーの数値は出所によってラベル付けされる。est_j は解析的な推定値である。reported_j はオペレーティングシステムまたはチップ上のカウンタである。measured_j は壁面電力計のために予約されており、本論文のすべての結果で空欄である。
2. 自律的コーディングの設計空間
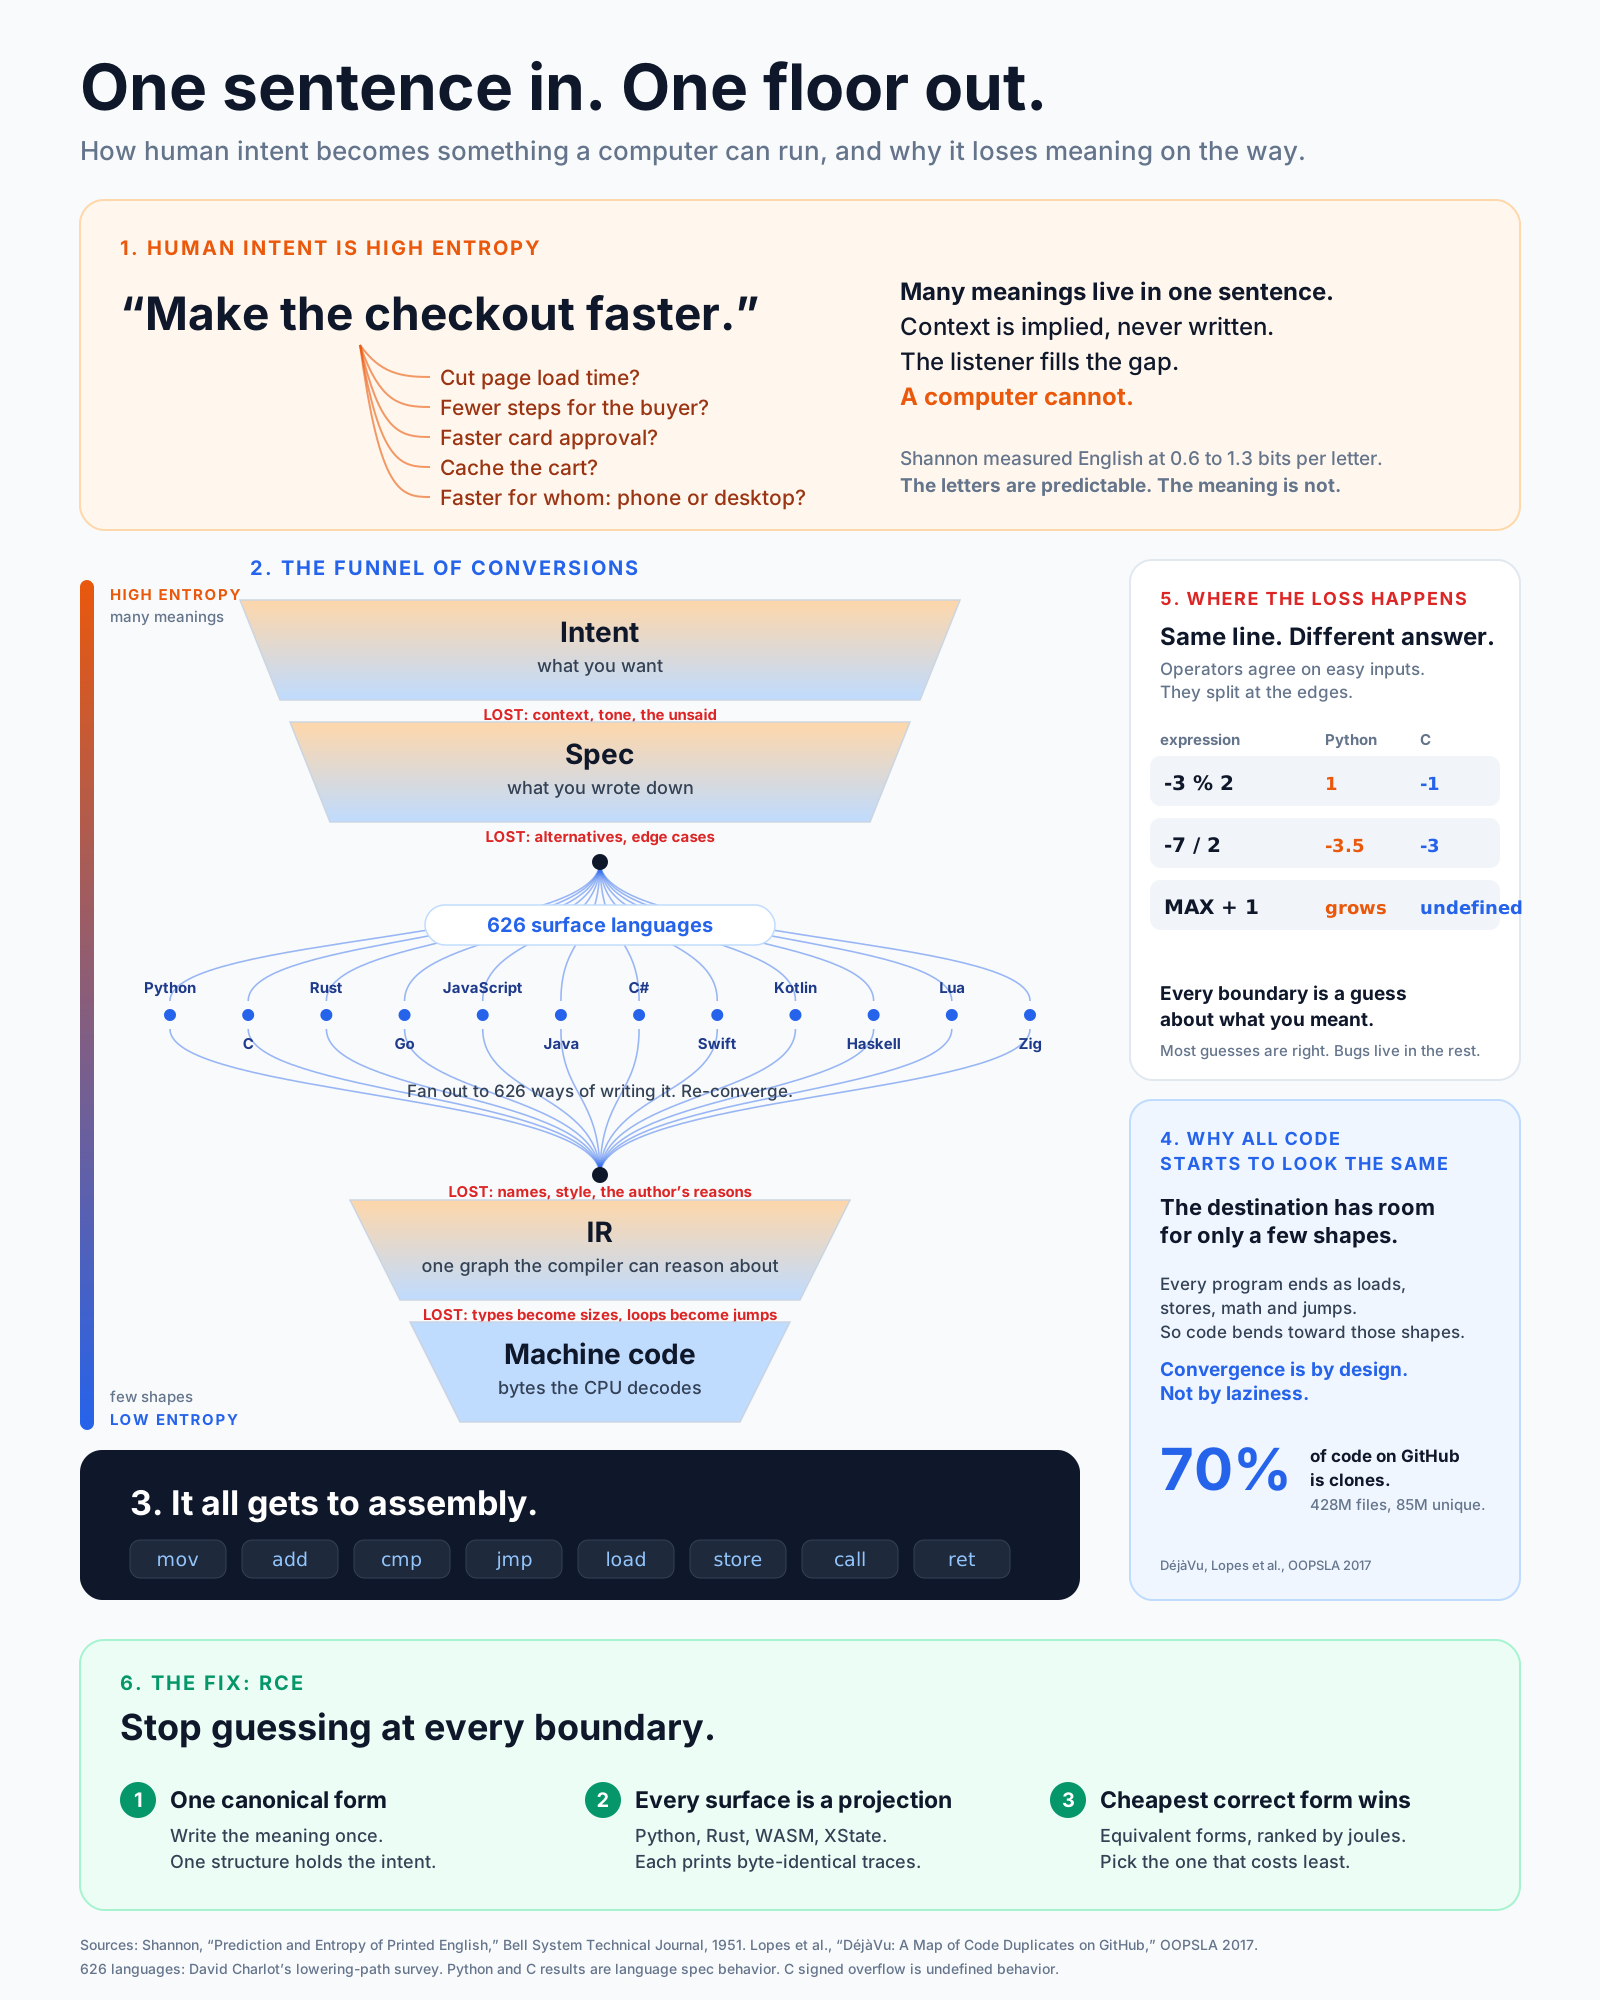
意図は高エントロピーである。 「チェックアウトを速くして」には多くの意味がある。ページ読み込みの短縮、手順の削減、カード承認の高速化、カートのキャッシュ、あるいはある機種群での高速化。文脈は含意されるだけで、書かれることはない。Shannon は印刷された英語を1文字あたり約 0.6 から 1.3 ビットと測定した [1]。文字は予測できる。意味は予測できない。
どの変換も情報を失う。 意図が仕様になると、文脈が失われる。仕様が数百ある表層言語の一つになると、代替案と境界ケースが失われる。ソースが中間表現(IR)になると、名前、スタイル、作者の理由が失われる。IR が機械語になると、型はサイズに、ループはジャンプになる。
床は低エントロピーである。 どのプログラムも最後はロード、ストア、算術、ジャンプになる。行き先には少数の形しか入る余地がないので、コードはそこへ曲がっていく。収束は設計によるものである。
意味が分かれるのは境界である。 同じ一行が端では異なる答えを返す。Python では -3 % 2 は 1、-7 / 2 は -3.5 である。C では -3 % 2 は -1、-7 / 2 は -3 であり、符号付きオーバーフローは未定義である。境界ごとにコードを生成し直すシステムは、境界ごとに推測している。
軸を量として述べる。
| 軸 | 一方の端 | もう一方の端 | RCE の位置 |
|---|---|---|---|
| 正しい結果あたりのエネルギー | タスクごとに全額を改めて支払う | 新しいケースごとに一度支払い、その後はハンドラの床 | 覆われたタスクでは床にある |
| 実行時に解消されるエントロピーと決定性 | プロンプトの分布全体、毎回新しい標本 | 保存済みの適合が覆わない残差のみ、一つの決定的な出力 | 残差のみ。すべての射影は決定的 |
| 検証の強さ | 目視で出力を受け入れる | テスト、カバレッジ、証明の証明書 | すべての結果に完全なゲート |
| 再利用と複利 | 各結果は一度だけ使われる | 受け入れられた各適合が保存され再利用される | ゲートを通過したすべての適合が保存される |
| モデル依存 | すべてのタスクにモデル | モデルなし | モデルは最後のギアとしてのみ |
手法は各軸の上で程度によって異なり、軸どうしは相互に作用する。再利用はエネルギーと解消すべき残りのエントロピーを下げ、強い検証こそが再利用を安全にする。 RCE は意味を一つの正準形式に一度だけ書く。すべての表層言語はその形式の射影であり、形式と一致するかを検査される。等価な形式の中で、最も安い正しいものが実行される。
図2は五つの軸を描き、主要な手法のクラスをその上に置く。
2.1 プログラミングは符号理論である
本節の主張は、プログラミングを符号理論として読める、というものである。プログラマは意図を、二つのエントロピー領域の間の勾配に沿って変換する。意図は高エントロピーであり、意味の上の分布である。コードは低エントロピーであり、状態ごとに一つの決定的な遷移である。要求からレジスタに至るまで、ソフトウェア作業の一歩一歩はその変換の一歩である。文献はこのことを七十年にわたり、多くの言語で、断片として述べてきた。本節はその断片を一つの議論に組み立て、RCE の各ギアをその上に位置づける。
尺度。 Shannon は情報源のエントロピーと通信路の容量を定義し [40]、印刷された英語を1文字あたり約 0.6 から 1.3 ビットと測定した [1]。Kolmogorov は1965年、ロシア語の Problemy Peredachi Informatsii において情報量への三つのアプローチを示し、アルゴリズム的なものを第一とした。対象のもつ情報とは、それを生成する最短プログラムの長さである [41]。Solomonoff は帰納推論の理論として同じ対象に到達しており [42]、Chaitin はプログラムサイズが Shannon のものと形式的に同一の恒等式に従うことを示した [43]。Rissanen はこの考えをモデル選択の規則、最小記述長にした [44]。これらを合わせると、プログラムは符号語である。つまり振る舞いの記述であり、最短の正しい記述が床である。等価な適合の中で最小ジュールのものを残すという RCE の抽出規則(命題3)は、ビットの代わりにジュールを置いたこの規則である。
コードは低エントロピー領域にあり、人々はそれを測った。 Hindle、Barr、Su、Gabel、Devanbu は、コードが「非常に反復的であり、実際、自然言語以上にそうである」ことを、同じ n-gram モデルの下でのより低い交差エントロピーとして見出した [35]。Gabel と Su はプロジェクトの行の大半がすでに他所に存在することを [34]、Lopes らは GitHub のファイルの大半がクローンであることを見出した [33]。Tu、Su、Devanbu はコードが局所的でもあること、すなわち近くに書かれたものが次に来るものを予測することを見出した [46]。Ray らはバグのある行は自然さが低くエントロピーが高いこと、そしてバグが修正されるとエントロピーが下がることを見出した [45]。2025年に Yang、Kolak、Hellendoorn、Martins は、パッチが引き起こすエントロピー変化を用いて修復候補を順位づけ、正しいパッチと過適合したパッチを区別した [51]。Allamanis、Barr、Devanbu、Sutton はこの分野を自然さ(naturalness)の名の下に概観した [47]。この結果は英語圏だけのものではない。Prem Devanbu は2013年の India Software Engineering Conference の基調講演でこれを述べた [50]。IBM Research India の Sridhara、Sinha、Mani は同じ会議で、コードを取り巻く自然言語の成果物を測定し、コミットメッセージが最も規則的で、Stack Overflow の文章は通常の英語のように振る舞うことを見出した [49]。中国では Journal of Software(软件学报)が2022年にコードの自然さ研究のレビューを掲載し、交差エントロピーの尺度と、欠陥のあるコードのエントロピーが高いという知見を述べている [48]。日本では大阪大学の土居、肥後、有馬、下仲、楠本が n-gram の自然さを用い、まず日本語の電子情報通信学会技術研究報告で、次いで ICPC 2018 で、機械生成されたソースファイルと人間が書いたものを判別した [73, 74]。生成されたコードは人間のコードよりさらにエントロピーの尺度で低い位置にある。生成器は固定された変換だからである。ブラジルでは Arrebola の博士論文が、プロジェクトと保守者で分割した n-gram モデルとトピックモデルの上にコード補完を構築し、交差エントロピー、すなわち次のトークンを符号化するのに必要なビット数で評価した [75]。二つの領域は一つのリポジトリの中に見える。コードを取り巻く文章は高エントロピーであり、コードは低エントロピーである。
尺度が重要である。 ベネズエラとメキシコを拠点とする Febres、Jaffé、Gershenson は、英語、スペイン語、プログラムテキストをメッセージ長あたりの語彙多様性で比較し、プログラムテキストの方が多様であることを見出した [76]。Rahman、Palani、Rigby は、コードの n-gram 予測可能性の多くが構文トークンに由来し、それらを除いてもコードはなお反復的であるが、当初の報告ほどではなく、API の使用が最も反復的な部分であることを見出した [77]。どちらの結果も主張を覆すのではなく、鋭くする。記号の多様性は予測可能性ではなく、低エントロピー領域とは次の一歩の条件付き分布の性質であり、それこそが決定的な遷移が固定するものである。RCE の G0 が表層トークンではなく形状をキーにするのはこのためである。
意図は高エントロピー領域にある。 Zave と Jackson は、要求は環境についての言明であり、仕様はインタフェースにおける言明であって、両者の隔たりはしばしば書かれていない領域知識によってのみ埋められることを示した [64]。Brooks はソフトウェアの困難を本質と偶有に分けた。本質は概念的な構築物であり、その大部分は表現ではなく仕様と設計である [61]。Naur は、プログラムはそのプログラマたちが保持する理論の目に見える部分であり、理論はテキストから完全には回復できないと論じた [62]。Shannon を通して読むと、三者は同じことを言っている。意図はどの一つのプログラムよりも多くの不確実性を担い、プログラムを書くことはそれを取り除く行為である。コードが書かれた後にプログラマの頭に残るものは、コードが符号化しなかった意図の部分である。
変換は詳細化であり、詳細化は絞り込みである。 Hoare はプログラムに論理を与え、そこではプログラムは事前条件と事後条件に相対的に正しい [54]。Wirth は段階的詳細化を教えた。タスクを逐次的な決定によって命令へ分解し、各決定が仕様の残した選択を一つ固定する [53]。Dijkstra のガード付きコマンドは、残された選択を非決定性として明示し、それを取り除くことで仕様からプログラムを導いた [52]。ミュンヘンでは Bauer と Wössner の CIP プロジェクトが、仕様からプログラムへの正しさを保存する変換の列としてプログラム開発を構築した [58]。フランスでは Abrial の B メソッド、次いで Event-B が、各段階に証明責務を伴う詳細化を産業規模にまで広げた [55, 56]。フィンランドでは Back と von Wright が詳細化に束論的な計算体系を与えた [57]。いずれにおいても、仕様は許容される振る舞いの集合を表し、詳細化の各段階はその集合を縮め、最後に一つの決定的な振る舞いが残る。それは各段階に証明を伴うエントロピーの削減である。RCE の形式はその連鎖の最後の要素である。すなわち、すべての選択が解消された、データベース状態上の全域的で決定的な遷移 である(§3.2)。
合成は仮説空間を絞り込む探索である。 Gulwani の FlashFill は、整合するすべてのプログラムの集合を表現し、新しい例ごとにそれと交わりをとることで、少数の入出力例から文字列プログラムを学習する [59]。Gulwani、Polozov、Singh はプログラム合成一般を、意図に制約されたプログラム空間の探索として捉え [60]、Solar-Lezama のスケッチングは部分的なプログラムの穴をソルバで埋める [27]。各例や各制約は仮説を取り除く測定である。Shannon の尺度は、そうした測定がいくつ必要かを数える。RCE の G2 がそのギアである。
変換が生み出すものは一つの形をもつ。 Gurevich は、すべての逐次アルゴリズムがそれ自身の抽象度の抽象状態機械(ASM)によって捉えられることを証明した [2]。Codd は状態を関係にし [5]、イベントソーシングは状態を追記専用ログの畳み込みにする [14]。Curry と Howard の下では証明はプログラムであり命題は型である [18, 72]。したがって検証された適合はその仕様の証明である。これらが、低エントロピー領域に形が少ない理由である。表層言語が何であれ、行き先はデータベース上の状態機械である。
低エントロピーはゲートがなければ崩れる。 Lehman は数十年にわたる大規模システムの観察から、使われているプログラムは変わり続けねばならず、複雑さを減らす作業をしない限りその複雑さは増大することを見出した [63]。Torres、Baltes、Treude、Wagner は25プロジェクトのコミット履歴にわたって構造的エントロピーとテキストのエントロピーを測定し、両者がともに上昇することを見出した [78]。エントロピーは環境からコードへ流れ戻る。コードを低エントロピー領域に保つシステムには、すべての変更にゲートが必要であり、RCE のゲートは正しさである(§4.3)。
コンパイラはすでに情報源符号化を行っている。 Franz と Kistler はプログラムを圧縮された抽象構文木として配布し、読み込み時にネイティブコードを生成した。これはプログラム自身の文法上での情報源符号化である [67]。Fraser はコーパスからコードの統計モデルを推定してそれを圧縮した [68]。二村は1971年、日本の学術誌 Systems, Computers, Controls において、インタプリタをプログラムに特化するとコンパイル済みプログラムが得られ、特化器を特化するとコンパイラが得られることを示した [70]。ノヴォシビルスクの Ershov は同じ考えを混合計算として発展させた [71]。Cousot 夫妻の抽象解釈は、プログラムのすべての振る舞いについて健全で情報量の少ない記述を計算する [69]。通信路符号化との類比は本論文の読み方であり、引用された定理ではない。型、テスト、証明は検査された冗長性を加え、パリティ検査が壊れた語を検出するように、誤ったプログラムを実行前に検出する。
ジュールが費やされるのは消去においてである。 Landauer は、論理的に不可逆な一歩、すなわち1ビットの消去が少なくとも を散逸することを示した [65]。Bennett は計算が原理的には論理的に可逆にできること、したがって限界を担うのは計算ではなく消去であることを示した [66]。高エントロピーの意図を一つの低エントロピーのプログラムに変換すると、意図が許していたすべての代替案が捨てられる。その破棄は代替案についての情報の消去であり、熱力学的な床をもつ。RCE は新しいケースごとに一度だけ破棄の費用を払い、結果を保存するので、繰り返されるケースは何も新しく消去しない。
2.2 RCE はどう変換し、各ギアはどこに位置するか
符号理論として読むと、タスクはメッセージとして到着し、その残る不確実性とは、保存済みのどの適合もまだ解消していない部分である。各ギアは異なる価格で不確実性を取り除き、ギアはその価格の順に並べられている(§4.2)。
| ギア | 不確実性に対して行うこと | 上の議論における系譜 |
|---|---|---|
| G0 ルックアップ | 意図がすでに符号化されていたことを認識し、取り出しによってハンドラの床で解消する | 反復性とクローン [33, 34, 35];局所性 [46] |
| G1 規則 | 既知のガード付き書き換えを適用し、繰り返し現れる残差を探索なしで解消する | 正しさを保存する変換 [52, 58];証明責務を伴う詳細化 [55, 56] |
| G2 合成 | 仮説空間を探索し、例、制約、ソルバによって絞り込む | 探索としてのプログラム合成 [27, 59, 60] |
| G3 から G5 モデル | 下位のギアが隔たりを埋められないとき、学習されたコードの分布から標本化する。提案者に限る | コードの交差エントロピーモデル [35, 47] |
| ゲート | テスト、カバレッジ、証明の証明書がそろった候補のみを受理する | Hoare 論理 [54];Curry-Howard [18, 72] |
| 昇格 | 受理された適合を保存し、同じ残差が次回は G0 の費用で済むようにする | 最小記述長 [44];一度だけ支払われる Landauer 消去 [65] |
第2節の軸の上の位置は、変換の費用をどこで払うかが異なる。タスクごとにプロンプトの分布全体を標本化する手法は、高エントロピー側の費用を毎回払い直す。受け入れられた適合を保存して再利用する手法は、残差の分だけを、一度だけ払う。ほとんどのシステムはその両端の間にあり、RCE は再利用の端にある。
2.3 大きな N でのエコシステム
§1 の主張は直接測定される。ベンチマークは実行前に事前登録された(bench/ecosystem/PREREG.json)。シード付きの生成器が 10,000 個の形式を書く。各形式は、ソース、本体が八つの演算子からなる深さ最大 3 のランダムな算術項であるルール、そしてシンクからなる。エンジンはコミット a079967 で凍結され、モデルは一度も呼び出されない。
| 性質 | 形式ごとに検査する内容 | N | 成立 | モデル呼び出し |
|---|---|---|---|---|
| 可逆な符号化 | Form IR から正準 JSON、Form IR、正準 JSON へと戻す変換が恒等写像である | 10,000 | 10,000 | 0 |
| 決定的な射影 | 二回のコンパイルが同じバイトを与え、元の形式と往復後の形式の XState および SCXML 射影がバイト単位で一致する | 10,000 | 10,000 | 0 |
| 忠実な射影、Python | 生成された Python モジュールが、シード付きの 40 イベントで参照トレースをバイト単位で出力する | 10,000 | 9,999 | 0 |
| 入口のゲート、入力 | 五種類の不正なペイロード(型の誤り、null、欠けたフィールド、空、入れ子)がすべて拒否され、受理された結果はない | 10,000 | 10,000 | 0 |
| 入口のゲート、仕様 | 宣言されていないノードへのフローを含む仕様が、コンパイル前に拒否される | 10,000 | 10,000 | 0 |
図3は同じ件数を示す。
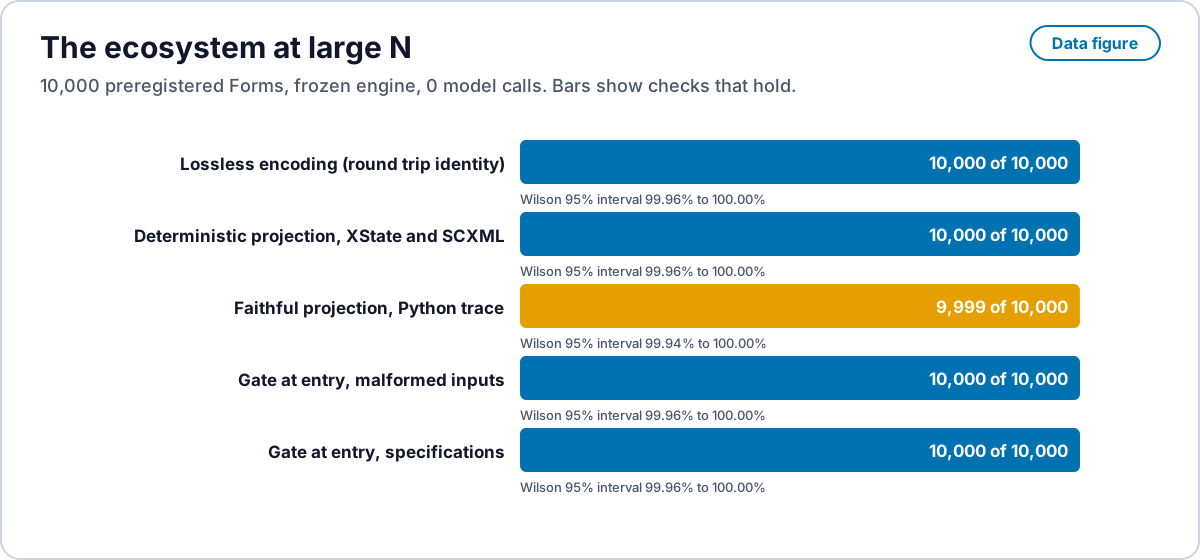
a079967 で凍結したエンジン、モデル呼び出し 0 回で行ったもので、Wilson の 95% 区間は件数から計算している。出典:bench/ecosystem。PNG 版も用意している。 Open full size · PNG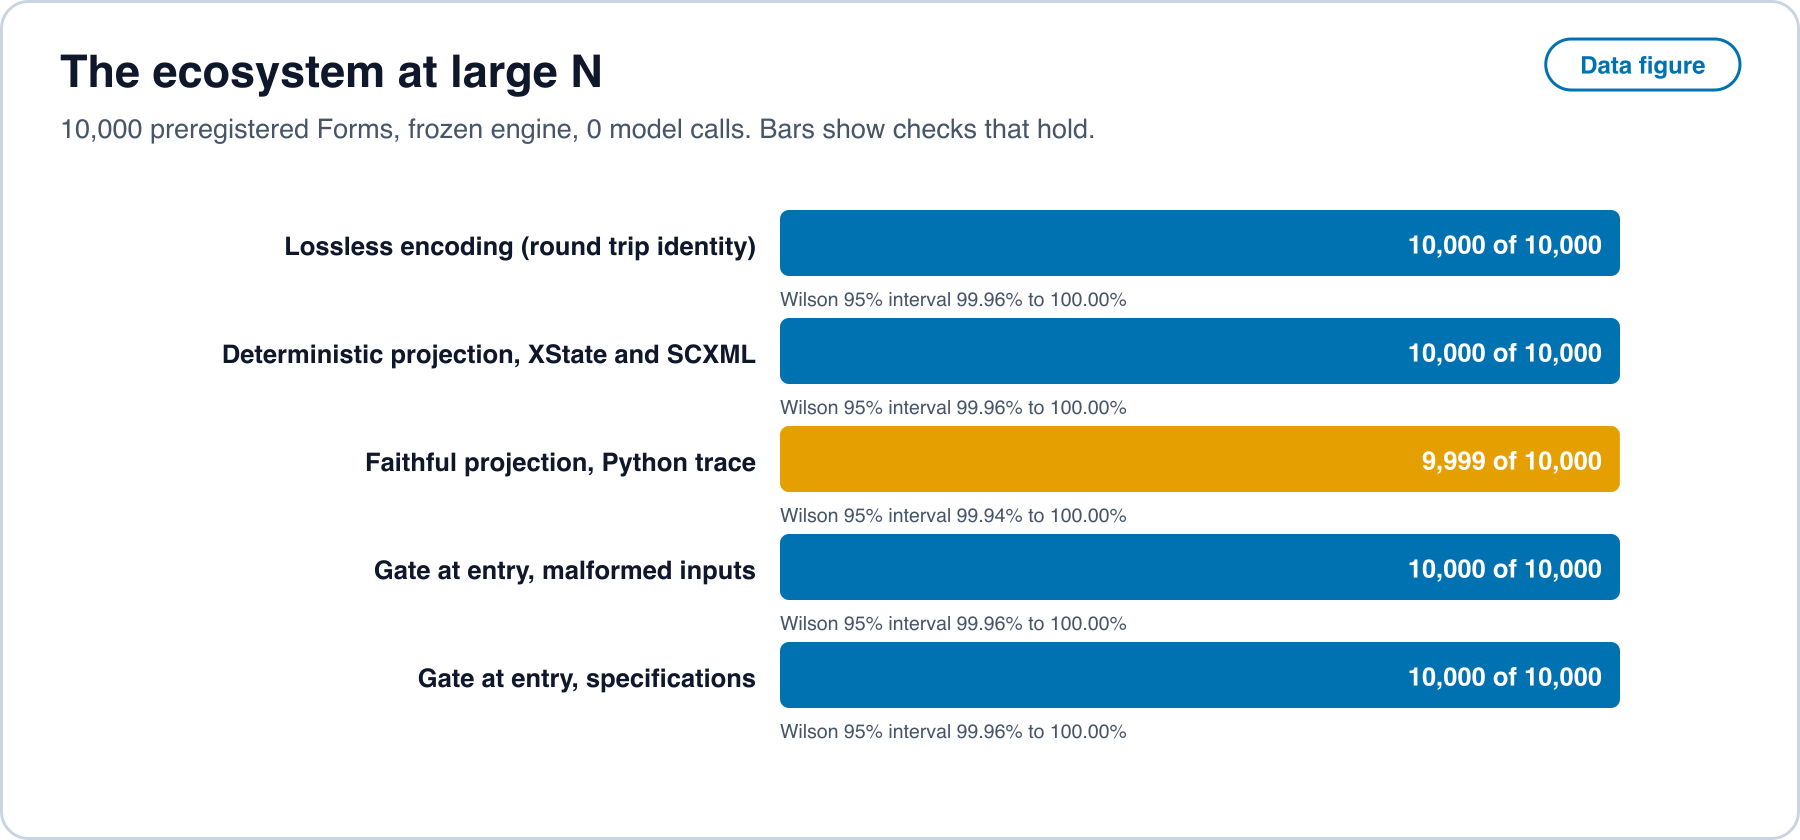
RCE-F0 と Python の不一致。 第9節は RCE-F0 を次のように述べる:少なくとも 10,000 個の形式からなる事前登録された実行で、いずれかの射影が形式の参照トレースと異なるトレースを出力する、またはいずれかの不正な入力が受理される。この実行は事前登録されており、10,000 個の形式からなり、生成された Python モジュールの一つが参照トレースを出力しなかった。したがって、この観測は書かれたとおりに読めば RCE-F0 の条件を満たす。本論文はこの不一致と下記の回帰テストを報告し、根本原因は示さない。RCE-F0 の文言は述べられたとおりに読むこと。それが覆す主張は射影が忠実であるということであり、この実行の Python の射影は一つの形式においてその主張を満たさなかった。この不一致がエミッタに由来するのかハーネスに由来するのかは、ここでは未解決である。同じ形式が 32 個のハッシュシードのもとで同一に再生されるという事実は、それを決着させない。
Python の一件の不一致は不一致として数える。同じ形式とイベントは、回帰テスト tests/form_ecosystem_regress.rs において 32 個のハッシュシードのもとで同一に再生される。ここでのエネルギーは est_j のみであり、実行全体は 1 コアで 393 s の CPU 時間を要した。生成された形式は小さいので、この表が測っているのは符号化、射影、ゲートである。実プログラムから持ち上げた形式は §8.7 のプロトコルで測定する。
2.4 ゲート付きで検証された再帰的自己改善
Good(1965)[111] は超知能機械を、より優れた機械を設計できる機械と定義し、それによって改善は再帰すると考えた。Yudkowsky(2013)[113] はこの問いを収穫の問題として定式化した。すなわち、改善の各単位が次の単位を安くするのか高くするのかである。Schmidhuber のゲーデルマシン(2007)[112] は保証つきの形式的な答えを与えた。プログラムは、書き換えが期待効用を高めることを証明した後でのみ、自分自身の探索を含むあらゆる部分を書き換える。Löb の定理(1955)[114] は自分を信頼する証明器が出会う障害であり、Yudkowsky と Herreshoff(2013)[115] はこれを Löb の障害と名づけた。すなわち、システムは一般に、自らの証明体系を使う後継者の健全性を証明できない。最近のシステムは証明の要求を捨て、測定されたスコアで選択する。STOP(Zelikman ら、2023)[116] はコードを改善する足場そのものを改善し、Darwin Gödel Machine(Zhang ら、2025)[117] はベンチマークのスコアで選ばれた自己改変コーディングエージェントのアーカイブを保持し、AlphaEvolve(Novikov ら、2025)[118] は自動評価器の下でプログラムを進化させ、Voyager(Wang ら、2023)[119] は後のタスクが再利用する検証済みスキルのライブラリを育てる。
RCE はゲーデルマシンの構造と Voyager のライブラリを取り入れるが、障害を取り除く二つの違いがある。第一に、改善される対象は証明器ではない。RCE が昇格させるのはハンドラ、書き換え、ギアであり、それぞれは固定され別途認証されたカーネルに照らして検査される。Kani のハーネスと SMT エンコーディングは昇格を通じて決して変わらないので、どのステップも後継者の証明体系を信頼する必要がない。第二に、ゲートは境界における正しさの証明であって、スコアではない。スコアはインターフェースの仮定が壊れている間にも上がりうるが、境界での証明は、それを壊す変更によって通過されることはない。
命題 R1(単調な正しさ)。 昇格されたすべての変更がその境界の検査を通過し、ほかの境界の検査が変わらないならば、昇格前にそれらの検査が確立したすべての性質は、昇格後も成り立つ。
命題 R2(複利的な積み上げ)。 ワークロードをタスクの多重集合とし、昇格されたハンドラがその形のすべてのタスクを閉じるとする。このとき第 t ラウンドのエスカレーション数は t について非増加であり、第1ラウンドより前に昇格された修正は、あらゆる期間の累積エスカレーション数を、それ以後の各ラウンドで閉じるエスカレーションの分だけ減らす。エンジンデモの参照ワークロードでは、八ラウンドにわたる累積エスカレーション数は、シンクでの一つの修正によって 21 から 15 に下がり、どちらの場合も最終ラウンドでゼロに達する。すべてのタスクは正しく閉じられ、拒否された昇格はない。
図4は命題 R1 と R2 の仕組みを、参照ワークロードの合計とともに描く。
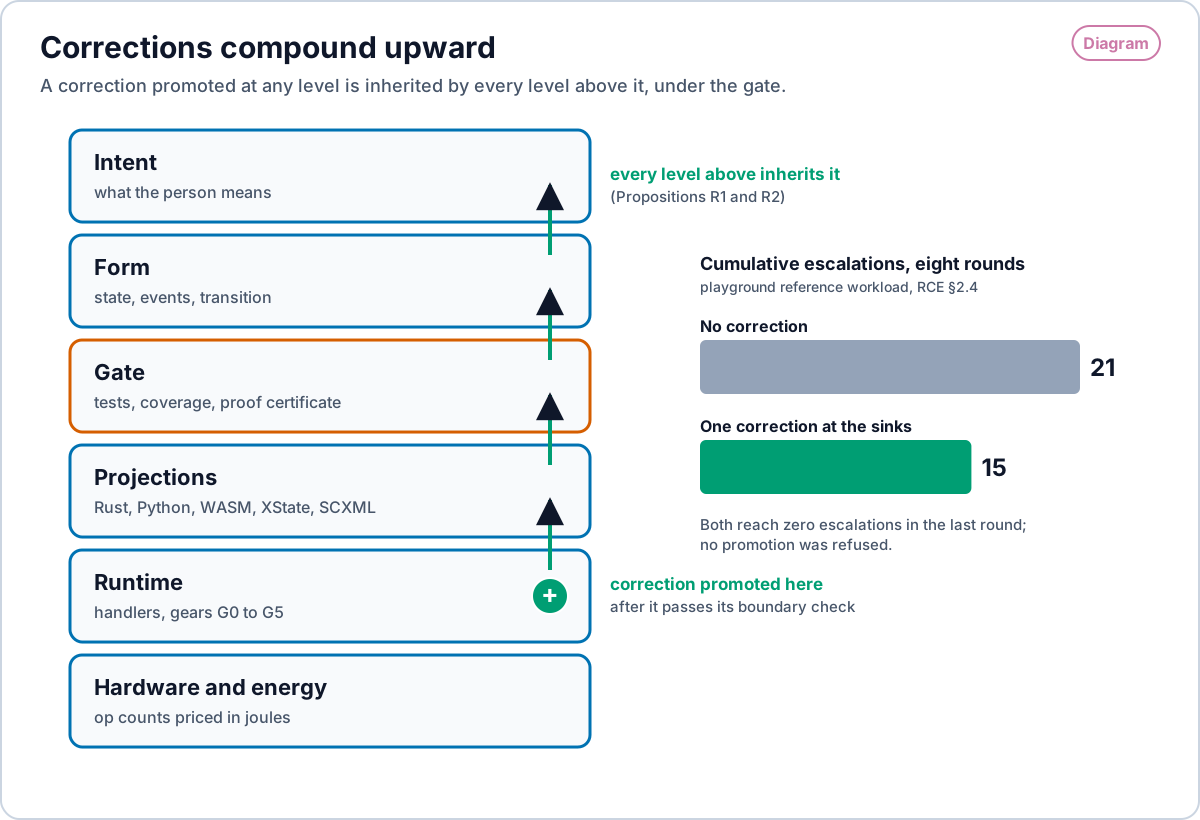
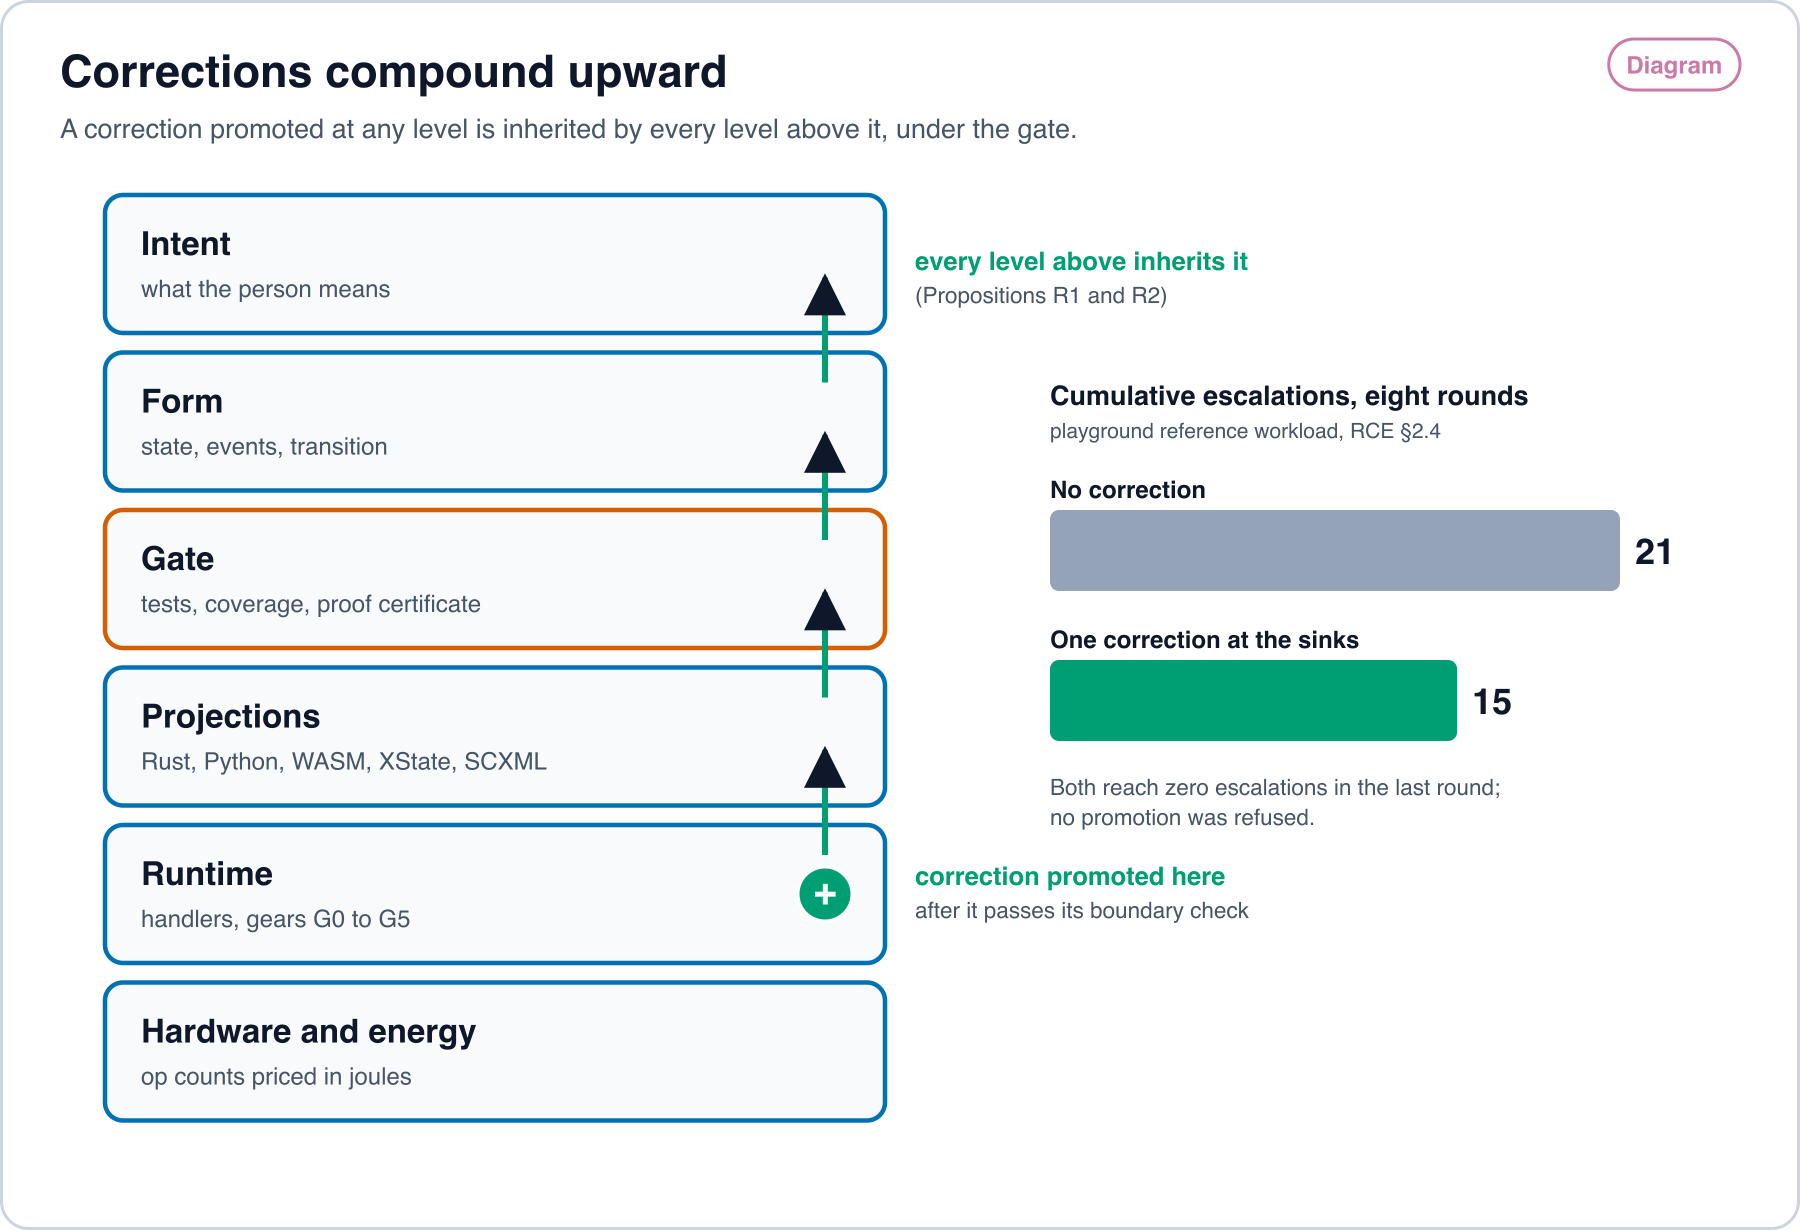
命題 R3(下がるコスト)。 昇格されたハンドラはモデル呼び出しの代わりに実行され、そのコストは基盤の価格表で値付けされたハンドラの演算数であるから、エスカレーションがゼロに近づくにつれて、ラウンドのエネルギーはハンドラだけのエネルギーへと下がっていく。
二村の射影(1971年、1999年に再掲)[120] と Turchin のスーパーコンパイル(1986)[121] は、この過程の極限を与える。インタプリタをあるプログラムに特化するとコンパイル済みプログラムが得られ、特化器自身を特化するとコンパイラが得られる。RCE の昇格は、一般的なエスカレーション経路を実際に生じる形へと特化するので、エンジンはそのワークロードの残余プログラム、すなわちモデルや人がなお供給しなければならない計算の部分へと収束する。ゲートの下での再帰的自己改善とは、この収束を検査済みのステップで行うことである。RCE エンジンデモ の Compounding レイヤーは、このワークロードをブラウザで実行する。
3. 形式
3.1 「同じ形式」の最も強い形式的言明
まず定理の範囲を述べる。Gurevich の逐次公理は逐次アルゴリズムを対象とする。並列アルゴリズムと対話的アルゴリズムには Blass と Gurevich のさらなる公理が必要である [3]。Blass、Dershowitz、Gurevich は、アルゴリズム上のただ一つの同値関係があらゆる目的に合うことはないと論じ [79]、Moschovakis と Vardi はアルゴリズムとは何かをめぐる論争を整理している [80, 81]。入出力を行う Web ハンドラは逐次定理の外にある。形式は対話を、対話的系譜と同じやり方で扱う。各入力は のイベントであり、状態機械はそれに対して一歩進む。したがって「一つの形式」は、逐次定理に根拠をもち慣習によって拡張されたモデル化上の選択であり、本番環境での先例として Elm アーキテクチャ [83]、耐久ワークフローのイベント履歴 [84]、Flo のようなストリーム意味論 [82] がある。第3.4節の命題はその選択について述べられている。
Gurevich の抽象状態機械(ASM)定理は、すべてのアルゴリズムが一つの形をもつことの最も強い形式的言明である [2]。抽象状態機械とは、状態が一階構造であり、一歩がガード付き更新の有限集合である機械である。Gurevich は三つの公理を述べる。逐次時間:アルゴリズムは状態、初期状態、一歩写像 をもつ。抽象状態:状態は一つの固定された語彙上の一階構造であり、同型の下で閉じている。有界探索:有限個の項が各一歩を決める。彼の主定理(Theorem 6.13)はこう述べる。「すべての逐次アルゴリズム A に対して、等価な逐次抽象状態機械 B が存在する。」Blass と Gurevich はこれを並列アルゴリズムへ拡張した [3]。Dershowitz と Gurevich は第四の公理、初期操作が計算可能であることを加え、そこから Church のテーゼを導いた [4]。
3.2 定義
定義1(形式)。 プログラムは組
である。
- 、状態空間:固定された語彙 上の構造であり、制御領域 とデータ に分かれる。 は論理クロック、入力数、型付き関係を保持する(言語では、宣言された領域も保持する)。各状態は Codd の意味でのデータベースインスタンスである [5]。
- 、イベントアルファベット:論理クロックの刻みを含む。
- 、遷移:全域的、決定的かつ純粋であり、ガード付き更新「if then 」の有限集合として書かれ、各一歩は有界な位置の集合を読む。次の状態とその一歩の出力を返す。その状態成分を と書く。
- 、耐久ログ:エントリ の列である。ここで はその一歩の後の状態の正準 JSON の SHA-256、 は最初の四つのフィールドの正準 JSON の SHA-256 であり、最初の は 64 個のゼロである。ログはハッシュ連鎖なので、過去のどのエントリを変えても、それ以後のすべての が変わる。
- 、出力写像。Mealy 機械は両方の引数を読み [6]、Moore 機械は状態のみを読む [7]。
定義2(形式と適合)。 形式とは、四つの不変条件をもつ組の形である。 は決定的かつ純粋である。探索は有界である。語彙は固定されている。状態はログの畳み込みである。
ログは各エントリの結果、出力、状態を持つこともできる。これらは導出されたものであり、ハッシュされず、再生と一致しなければならない(§3.7 の T1 と T3)。拒否には区別される二つの種類がある。エンジンプロファイルではすべてのイベントが適用され、契約を満たさない入力は reject 出力とエラー行を生む。言語では、拒否されたイベントは状態を変えず(T8)、拒否されたものとして記録される。
適合とは、その形を満たすデータである。語彙 、アルファベット と 、 を定める規則プログラム 、 を定める出力規則、そして初期データ である。Gurevich の用語では、適合は語彙、ASM プログラム、初期構造である。Codd の用語では はスキーマであり はインスタンスである。プロダクトラインの用語では適合は機能の選択である [8]。構文誘導合成(SyGuS)の用語では適合は仕様を満たす文法の項である [9]。
定義3(適合の等価性)。 二つの適合は、すべてのイベント列 について の下での出力列が等しいとき、等価である。
定義4(適合言語)。 項が適合を表す文法。プログラミング言語、SCXML 文書、XState の設定、.rce 仕様は適合言語である。適合言語は、 上のすべての ASM プログラムがその中に項をもつとき完全である。
定義5(制御射影)。 を有限の制御記号とデータ関係に分ける。 のステートチャートとは の への射影である。状態は の値であり、遷移はイベントと 上のガードを伴い、アクションは への更新である。Harel のステートチャートが階層と直交領域を与える [10]。
定義6(適合 e-graph)。 適合 と健全な書き換えの集合 に対し、適合 e-graph は の下での の規則項の飽和 e-graph である [11, 12]。各 e-class は定義3の意味で等価な適合を保持する。
定義7(ジュールコスト)。 は、名前を付けた基盤上で項 を一度実行するための推定エネルギー(est_j)に、期待実行回数で重みを付けたものである。
3.3 なぜ「データベース関数型状態機械」なのか
有限の関係構造はデータベースインスタンスであるから、Gurevich の状態はデータベースであり、各一歩は有界なトランザクションである。データベース: は関係構造である。関数型: と は純粋である。状態機械:実行はイベント上の の畳み込みである。Moseley と Marks はアーキテクチャにおいて同じ線を引いている [13]。イベントソーシングはアプリケーション状態において線を引く。「アプリケーション状態へのすべての変更をイベントの列として捕捉せよ」[14]。Dedalus は論理において線を引き、そこでは可変状態は時間で添字づけられた関係である [15]。
3.4 命題
命題1(形式はすべての逐次アルゴリズムを捉える)。 すべての逐次アルゴリズム に対し、その実行が の実行である形式インスタンス が存在する。
証明の概略。 Theorem 6.13 により、 の状態、初期状態、一歩写像をもつ ASM が得られる。、、 とし、 を恒等写像とする。 刻み後の畳み込みは である。Gurevich の Corollary 3.3 により、 と は同じ実行をもつ。∎
命題1b(対話的プログラム)。 を、各一歩の前に に設定される零項の入力記号で拡張する。すると は拡張された語彙上の逐次アルゴリズムとなり、命題1が適用できる。この構成は我々によるものである。
命題1c(計算可能性)。 Dershowitz と Gurevich の公理の下で、すべての形式インスタンスはチューリング計算可能な関数を計算する [4, 16, 17]。形式は能力を何も加えない。形式はそのクラスのすべてのプログラムに一つの形を与える。
命題1d(証明は適合である)。 「与えられた命題の各証明に対して、対応する型のプログラムが存在する」[18]。型は仕様であり、証明はそれを満たす適合である。正しさのゲートとは、その証明または合格する受け入れテストが存在することである。
命題2(一つの生成器)。 一つの関数 が、すべての適合に対して実行可能なプログラムを生成し、どの領域も読まない。根拠: すべてのプログラムは形式インスタンスであるから、 は型付きストア、イベント型、コンパイルされた規則、畳み込みを伴うログ、出力ディスパッチャを出力する。Rails のジェネレータ、JHipster、Yeoman のようなスキャフォールダは、小さな適合言語に制限された である。プロダクトライン工学は「関連するソフトウェアシステム間の共通性の体系的な発見と活用」から出発する [8]。その共通性が形式である。
命題3(最小エネルギーの抽出)。 による抽出は、 の e-class の中で抽出器が見つける最小ジュールの項を返す。証明の概略。 書き換えは健全であるから、e-class のすべての項は の観測可能な振る舞いをもち、同じゲートを通過する。抽出はコストを最小化し、コストはジュールである。∎ これはコードに適用された Mixture of Limits である。タスクを果たす最小の適合を残し、残りは無駄である。
命題4(再生の決定性)。 が壁時計を読まず、名前に依らずに更新を順序づけ、すべての入力をログに記録するならば、一つの の二度の再生はすべての一歩で同一の状態ハッシュを与える。
命題5(ステートチャート射影は健全である)。 実行の各状態を へ射影する。その結果は、同じイベントの下での出力されたステートチャートの実行である。
命題6(調整予算)。 単調とタグ付けされた規則は調整なしにレプリカ上で実行できる。調整点を必要とするのは非単調な規則のみである。根拠: CALM 定理、「一貫した、調整不要の分散実装をもつプログラムは、ちょうど単調論理で表現できるプログラムである」[19]。
タグは規則から導出され、宣言されることはない。IR 検査は、保存されたタグが導出されたタグと異なる形式を拒否する(仕様、付録 D.5)。
| 規則が持つもの | タグ | 理由 |
|---|---|---|
| resolve、read、join、scan のいずれもない | 単調 | その書き込みはキーを追加し、カウンタを増やすだけである |
| resolve | 非単調 | エスカレーション行を削除する |
| 自身のシンクの read | 非単調 | 読み取り、変更、書き込み |
| キー付き join | 非単調 | 結合される行は、いまは無くても後で現れることがあり、上書きされることもある |
| scan | 非単調 | 存在しないものを含めて、関係全体を観測する |
タグは健全だが完全ではない。挿入のみの関係に対する join は単調であるはずだが、プロファイルは関係が挿入のみであることを証明しないので、タグはそれを主張しない。すべての規則が単調であるとき、形式は調整不要である。すべての read、join、scan はイベントの入口での状態を見るので、入力イベントの事後状態は、異なるシンクに対する規則が実行される順序に依存しない。依存するのは出力の順序だけであり、それは内容ハッシュによって固定される。
命題7(ジュール微分としての知能)。 をゲートを通過したタスク数、 を費やしたジュールとする。 は、すべてのイベントとその est_j を記録する から事後的に読み取られる。 の下での抽出はゲートを固定したまま を増やさないので、等しい において を下げない。
3.5 グラフ、e-graph、ステートチャート
| 構造 | 形式のどの部分か | 何を決めるか |
|---|---|---|
| ステートチャート | 上の のガード | どの遷移が発火するか |
| データフローグラフ | と の読み書き依存(Kahn プロセスネットワーク [20]) | 何が、どの順序で実行されるか |
| E-graph | 適合の同値類 | どの等価な適合が実行されるか |
ステートチャートとグラフは一つの適合を記述する。e-graph はそれと等価なすべての適合を記述する。抽出はそれらの中からジュールで選ぶ。
3.6 一つのエコシステム、可逆性、そして普遍性テーゼ
構成による可逆性。 Shannon の情報源符号化定理は、可逆な符号の下限を情報源のエントロピーに定める [40]。形式は、検査可能な狭い意味で、意図の可逆な符号である。形式の正準シリアライズは単射なので、いずれかの状態、イベント、遷移が異なる二つの形式は異なる形状ハッシュをもち、シリアライズを復号すると同じ形式が戻る。ターゲットへの各射影は形式だけの関数である。双方向変換は往復を精密にする。Foster、Greenwald、Moore、Pierce、Schmitt はレンズを、ビューとそのソースを一致させる往復条件をもつ get と put の関数の対として定義し [122]、Hofmann、Pierce、Wagner はその条件を対称レンズへ拡張し [123]、Czarnecki らはモデル工学、データベース、プログラミング言語にわたる同じ整合性条件を概観している [124]。RCE の往復条件は、プログラム全体の水準での GetPut 条件である。射影を持ち上げ直しても、形状ハッシュは変わらない。
構成による正しさ。 Dijkstra は 1968 年に、プログラムとその証明を一緒に開発し、正しさをテストで確かめるのではなく設計に組み込むことを提案した [125]。Hall と Chapman はこの方法を、各段階に形式仕様と詳細化をもつ商用のセキュアシステムに持ち込んだ [126]。型付き関数型プログラミングに関する Minsky の規則、不正な状態を表現不能にせよ、は型の水準で同じことを述べている。悪い値を保持できない型は、その値の検査を不要にする [127]。Turner の全域関数型プログラミングは、すべての関数がすべての入力で停止することを求め、プログラムが隠れた失敗をもたない数学的関数を表すようにする [128]。RCE の形式は Turner の意味で全域であり、その契約型は Minsky の意味で宣言されていない状態を表現不能にし、§2.1 の詳細化の連鎖は Dijkstra の意味でそこに行き着く。その帰結は §1 で述べたとおりである。誤りは入口で拒否されるので、事後に差分を取ったり追跡したりするものは何も残らない。
普遍性テーゼ。 理論の言葉で述べれば、テーゼは一つの普遍的な形式がある、ということである。プログラムはその中でネイティブに書かれ、既存のすべての言語はそこから忠実な射影として到達でき、既存のすべてのプログラムは持ち上げによってそこに入る。Gurevich のテーゼが根拠を与える。すべての逐次アルゴリズムは、それ自身の抽象度で、抽象状態機械によって一歩ずつ捉えられ [2]、並列アルゴリズムも同様である [3]。形式は、データベース状態の上のそのような機械である。
命題 U1(捕捉)。 言語 のプログラムが Gurevich の意味での逐次または並列アルゴリズムであるならば、そのプログラムの抽象度でそれを一歩ずつ模倣する遷移をもつ形式が存在する [2, 3]。
命題 U2(忠実な射影)。 形式の への射影 が契約内のすべての入力で形式のトレースを保存するならば、トレースのあらゆる観測者にとって形式とその射影は交換可能であり、 は形式に欠けているものを何も付け加えない。
命題 U3(構成による持ち上げ)。 使われているすべてのプログラミング言語は、形式文法、具象構文木を生成するパーサ、抽象構文木、そして仕様または参照実装によって定まる意味論をもつ。持ち上げ は言語ごとに三段階で構築される。文法、次に抽象構文木、次に形式であり、 の各構成要素は の意味論に従って形式のルールを与えられる。このように構築された持ち上げは、振る舞いについて を、形状ハッシュについて を満たすので、この対は [122] の意味でのレンズであり、 のプログラムは損失なく形式として保持される。
命題 U4(置き換え)。 言語 について U2 と U3 が成り立つならば、どのプログラムも で書く必要はない。プログラムは形式として一度書かれ、プラットフォームが求める場所で として出力される。
U1 は定理である。U2 はターゲットごとに差分テストで検査され(§5.1)、§2.3 では大きな N で検査される。U3 は構成であり、言語ごとに文法から積み上げて構築される。§8.7 は、構築しながらその構成をどう測るかを述べる。
3.7 言語:バージョン 0.6 と 0.7、コスト、定理の状況
RCE 言語は書かれた仕様によって定義され、現在のものは言語バージョン 0.8 の草案 0.7 文書である(/rce/spec/。ソースは rce リポジトリ にある)。各モジュールは一行目のコメントで言語バージョンを選ぶ。それのないモジュールはバージョン 0.5 であり、第2節から第10節の言語である。# rce-version: 0.6 を宣言するモジュールは付録 C も得る。すなわち par、for ... par、with budget、ワークグループ、LVar、セッション、スーパーバイザである。# rce-version: 0.7 を宣言するモジュールはバージョン 0.6 の言語を持つが、違いが一つあり、それは後述する標準ライブラリのメソッドのコストである(付録 C.15)。付録 D は、本論文のエンジンが実行するエンジンプロファイル、ハンドラ仕様、適合を定義する。バージョン 0.5 のモジュールは付録 C を一切見ないので、有効なバージョン 0.5 のプログラムはすべて変更なしに受理される。
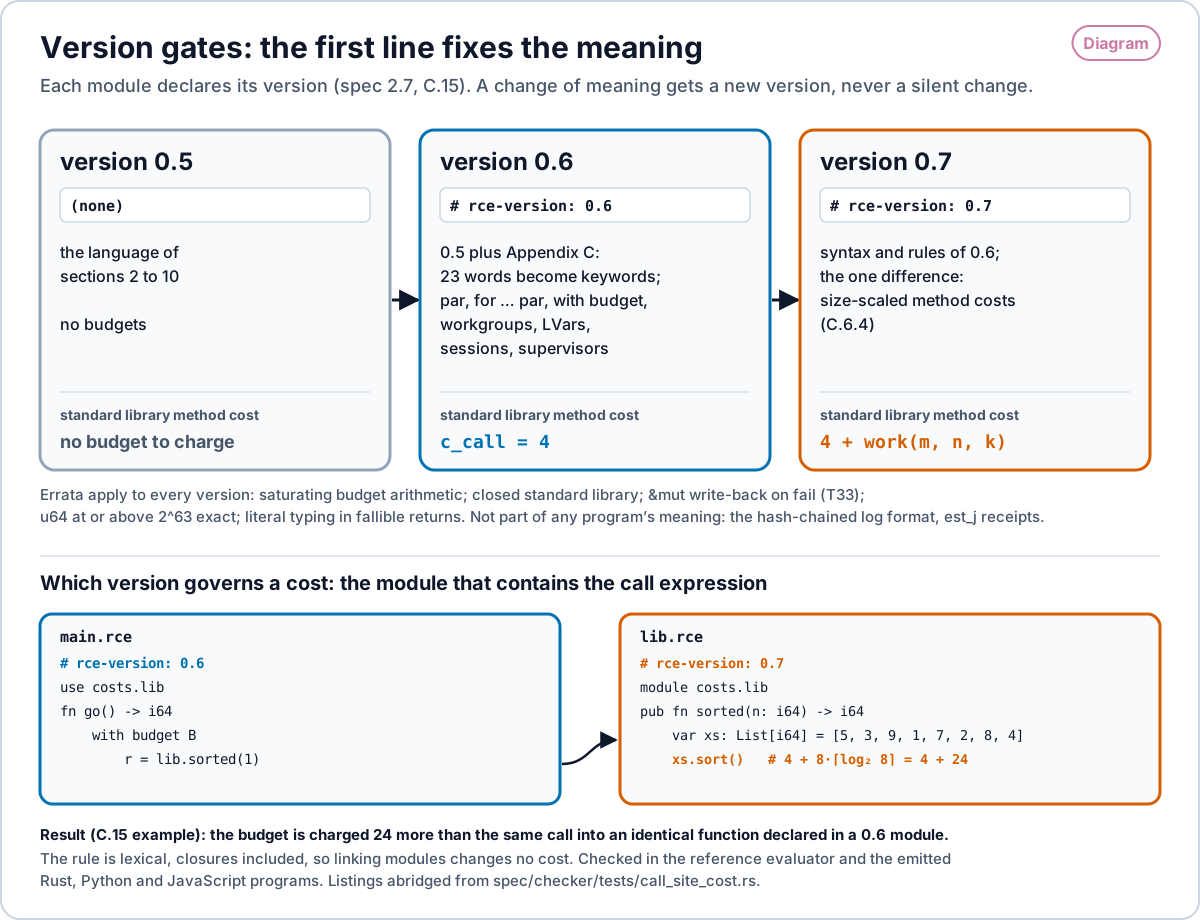
# rce-version: 0.6 は付録 C を加え(23 個の新しいキーワード。par、for ... par、with budget、ワークグループ、LVar、セッション、スーパーバイザ)、標準ライブラリのメソッドのコストは である。# rce-version: 0.7 は 0.6 の構文と規則を持ち、メソッドのコスト だけが異なる。正誤表はすべてのバージョンに適用される。呼び出し式を含むモジュールのバージョンがそのコストを決める。with budget の下にある 0.6 の関数が、8 個の要素を整列するインポートした 0.7 の関数を呼ぶと、同一の 0.6 の関数への同じ呼び出しより 24 多く課される。出典:仕様 2.7、C.6.4、C.15。リストは spec/checker/tests/call_site_cost.rs からの抜粋。PNG 版も用意している。 Open full size · PNG
予算は作業を数える。 with budget ブロックは、各演算に付録 C.6.4 の表にある固定コストを課し、カウントが尽きると budget でトラップする。このカウントは作業の代理指標であり、時間やエネルギーの測定ではない。est_j は別である。
| 演算 | コスト |
|---|---|
| ユーザー関数またはクロージャの呼び出し、 | 4 |
| 受け手の大きさ 、第一引数の大きさ に対する標準ライブラリのメソッド | バージョン 0.6 では 4、バージョン 0.7 では |
| チャネルの送信または受信 | 8 |
spawn | 32 |
par の一つの分岐、または for ... par の一つのチャンク | 16 |
個の結果をもつリストまたはマップのリテラル、または内包表記。[x; n] | |
添字、スライス、メンバーアクセス。単項演算子。and、or。整数、真偽値、テキストの演算子と比較 | 1 |
浮動小数点の +、-、* | 2 |
浮動小数点の /、% | 8 |
大きさとは、テキストでは UTF-8 のバイト長、リストでは長さ、マップではエントリ数であり、それ以外の値の大きさは 0 である。メソッドの作業量 は、参照評価器におけるメソッドの計算量クラスによって定まる。テキスト、リスト、マップに対する線形のメソッドでは (マップは順序付き連想リストである)、sort では ( のときは 0)、残りのメソッドでは 0 である。map、filter、fold がその関数引数に対して行う呼び出しは、これに加えて呼び出しとして課される。算術は最大の 128 ビット整数で飽和し、 や が増えるとき が減ることはない。参照評価器と、出力された Rust、Python、JavaScript のランタイムは同じ関数を計算し、予算のトラップが四つすべてで同じ演算で起きることをテストが検査する。
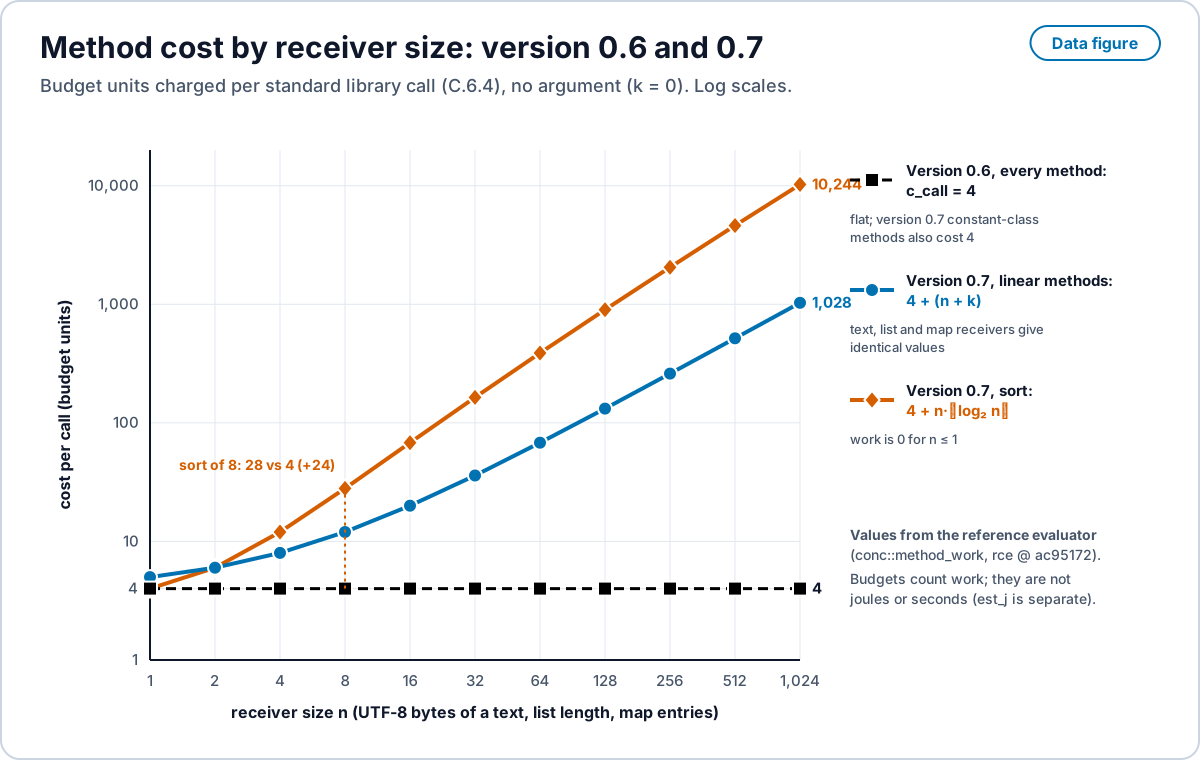
conc::method_work(rce ac95172)で計算した。PNG 版も用意している。 Open full size · PNG
どのバージョンがコストを決めるか。 プログラムは異なるバージョンのモジュールを結合してよい。メソッド呼び出しのコストは、呼び出し式を含むモジュールの宣言されたバージョンによって定まり、そこに書かれたクロージャの中の呼び出しもこれに含まれる。実行される関数のバージョン、その呼び出し元のバージョン、プログラムの最初のモジュールのバージョンによっては定まらない。この規則は字句的なので、モジュールを結合してもコストは変わらない。仕様 2.7 は同じ規則を述べ、C.15 を参照している。テストは、参照評価器と、出力された Rust、Python、JavaScript のプログラムの上で、境界の両方向についてこれを検査する。with budget の下にある 0.6 の関数が、8 要素のリストを整列するインポートした 0.7 の関数を呼ぶと、同一の 0.6 の関数への同じ呼び出しより 24 多く課される。
定理の状況。 仕様は定理 T1 から T34 を述べ、それぞれの状況を正確に記録する。証明はコア計算体系の上で Lean 4(v4.12.0、Mathlib なし)によって書かれている。結果の水準を表す語は次のとおりである。証明済み は、言語のコア意味論についての Lean の証明を意味する。意味論上で証明済み は、RCE のコアの小ステップ意味論の上での Lean の証明を意味する。モデル は、RCE の意味論にも参照評価器にも接続されていない抽象モデルについての Lean の証明を意味する。ベクトル は、生成されたプログラムに対する参照評価器の結果が Lean カーネルによってモデルと照合されることを意味し、これは標本上の対応であって、評価器についての証明ではない。テスト済み は、述べられた入力での差分テストを意味する。機械的に検査済み は、LALR(1) の表の構築器のようなプログラムによって決定されることを意味する。
| 言明 | 水準 | |
|---|---|---|
| T1 | 決定性:状態とイベントごとに結果は一つ。並行性意味論のティックごとに結果は一つ | 証明済み |
| T2 | の全域性、評価ステップ数の明示的な上限つき。構造的再帰と、呼び出しグラフに沿った上限の合成 | 証明済み(Lean の式コアにはユーザー関数の呼び出しがない。再帰と合成は別のモデルで証明されている) |
| T3 | 実行時の状態は であり、再生はすべてのハッシュと出力を再現する | 証明済み |
| T4 | 進行性、ティックを含む(いずれかのタスクが進むか、実行が終わるか、Deadlock を報告する) | 証明済み |
| T5 | 保存性、書き込まれるすべてのフィールドの整数範囲を含む | 証明済み |
| T6 | メモリ安全性、完全な借用パス、タスク間の可変な共有なし | 所有権コアと、借用パスの計装された意味論について証明済み |
| T7 | ログのハッシュ、ID、select の選択の名前非依存性 | 証明済み |
| T8 | 原子性:拒否されたイベントは状態を変えない | 証明済み |
| T9-F | 形式 IR のターゲット(Rust、WASM、Python、XState、SCXML)は参照トレースを出力する | テスト済み |
| T9-L | プログラム出力器(rust、python、js)は参照評価器と一致する | Rust 出力器についてコア上で証明済み。出力される Rust の部分集合の深い埋め込みである MiniRust への検証済み翻訳として。rustc が MiniRust を実装することは信頼され、テストされている。その他の出力器はテスト済み |
| T10 | 文法は曖昧でない | 機械的に検査済み(LALR(1)、衝突 0、両バージョンとも)、ファザーによる標本検査あり |
| T11 | select の公平性 | ローテーションモデル上で証明済み |
| T12 | 線形ハンドルはすべての経路でちょうど一度消費される | 文のモデル上で証明済み |
| T13 | f32 の演算は、IEEE 754 で一致するターゲット上で同じビットを与える | 乗算について証明済み。加算、減算、除算については、一回丸めの性質は Figueroa の定理であり、引用しているが機械化していない |
| T14 | 検査つき u64 算術は範囲内で正確である | 証明済み |
| T15 | イテレータは終了し、ループの上限を守り、接頭辞について一貫している | 証明済み |
| T16 から T31 | バージョン 0.6 の並行性:par の決定性、可換性、リダクション、デッドロックからの自由、期限、ワークグループ、ベクトルクロック、優先度、スコープ、アクター、セッション、LVar、原子的バッチ、レプリカ | 意味論上で証明済み:T16、T17、T19a、T20、T23。実行のモデル上で証明済み:T24。セッション計算上で証明済み:T28。モデル:T18、T19b、T21、T22、T25、T26、T31。ベクトルつきモデル:T27、T29、T30。いずれも Rust の参照評価器についての証明ではない |
| T32 | 外部再生:すべてのオラクルについて、ログの再生は実際の実行と等しく、回答契約はログに記録されたすべての回答について成り立つ | 証明済み |
| T33 | 失敗時の &mut の復元(F.4.4):失敗した呼び出しは呼び出し元の &mut の状態を呼び出し時のままに残す。戻る呼び出しは書き戻す(すべての結果でコピーアウトするという以前の規則は廃止された) | 証明済み |
| T34 | すべての出力器の前に置かれる順序保存の ANF パスは、同じ値、ストア、課金と出力のトレースを与える | 完全な ANF をもつコア断片について証明済み。実装は、トラップ点をまたぐ予算の掃引を含め、すべてのターゲットで差分テストされている |
T9 に二つのターゲット集合があるのは、本論文のエンジンと言語が二つのコンパイラを持つからである。T9-F は rce form --emit についての主張であり、§5.1 がそれを測定する。T9-L は言語のプログラム出力器についての主張である。これらの集合の外にあるターゲットには T9 の主張はない。
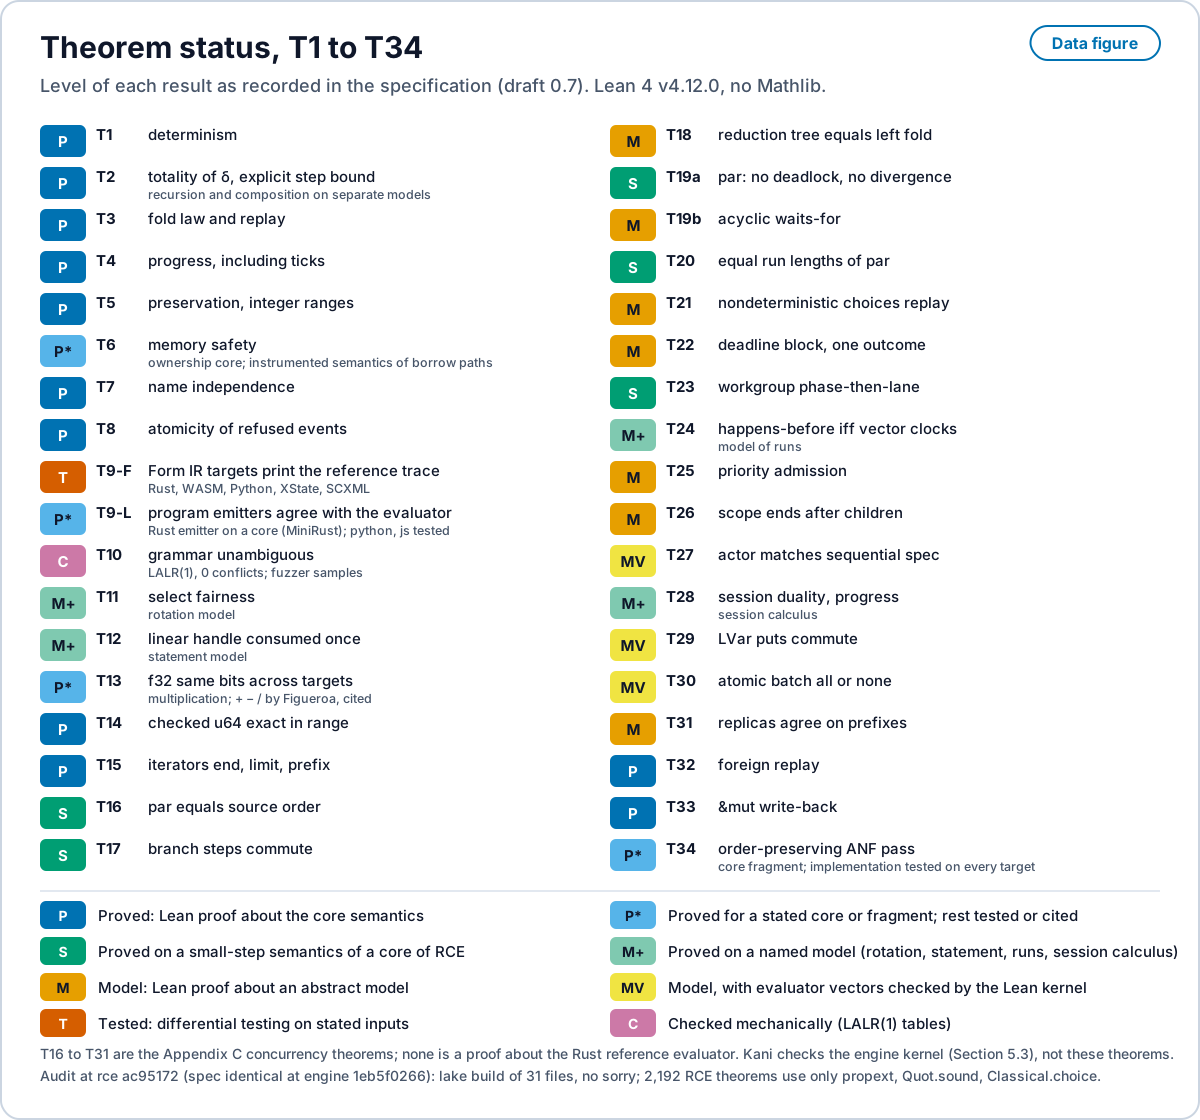
P:コア意味論についての Lean の証明。P*:述べられたコアまたは断片について証明済み、残りはテスト済みまたは引用。S:RCE のコアの小ステップ意味論上で証明済み。M+:名前の付いたモデル(ローテーションモデル、文のモデル、実行のモデル、セッション計算)上で証明済み。M:抽象モデルについての Lean の証明。MV:参照評価器のベクトルを Lean カーネルで検査したモデル。T:差分テスト。C:機械的に検査済み。T16 から T31 はバージョン 0.6 に属し、いずれも Rust の参照評価器についての証明ではない。Lean 4 v4.12.0、Mathlib なし。出典:spec/book/10-theorems.md と付録 C.13。PNG 版も用意している。 Open full size · PNG
このバージョンで実行した検査。 エンジンのコミット 1eb5f02 において、lake build は spec/lean/RCE/ の 31 個のファイルに対して sorry なしで完了し(公開リポジトリの 4304048 では 46 個のファイル、e416fd0 では 58 個)、常設の監査は 2,192 個の定理定数(監査はカーネルのすべての定理定数を数える。上記の訂正の注記を参照)の公理が propext、Quot.sound、Classical.choice のみであると報告する。Kani は 10 個中 10 個のカーネルハーネスを検証する(§5.3)。エンジンのテスト(cargo test --release)は 589 個の異なるテストに失敗 0(無視 2)で合格する。make check が 596 と報告するのは、その証明ステップがそれらのテストのうち 7 個を二度目に実行するからである。参照チェッカーは、公開リポジトリから継続的インテグレーションと同じ方法でビルドすると、既定のビルドで 56 個、バージョン 0.6 と 0.7 のスイートを有効にすると 112 個のテストに失敗 0 で合格し、tree-sitter との一致テストを含めると 57 個に合格する。仕様の検査は、バージョン 0.5 と、文法を共有するバージョン 0.6 と 0.7 の LALR(1) の表を衝突 0 で構築し、すべての例を三つのパーサで構文解析する。チェッカーの WebAssembly ビルドは、例のコーパスに対する 401 個中 401 個の検査に合格する。
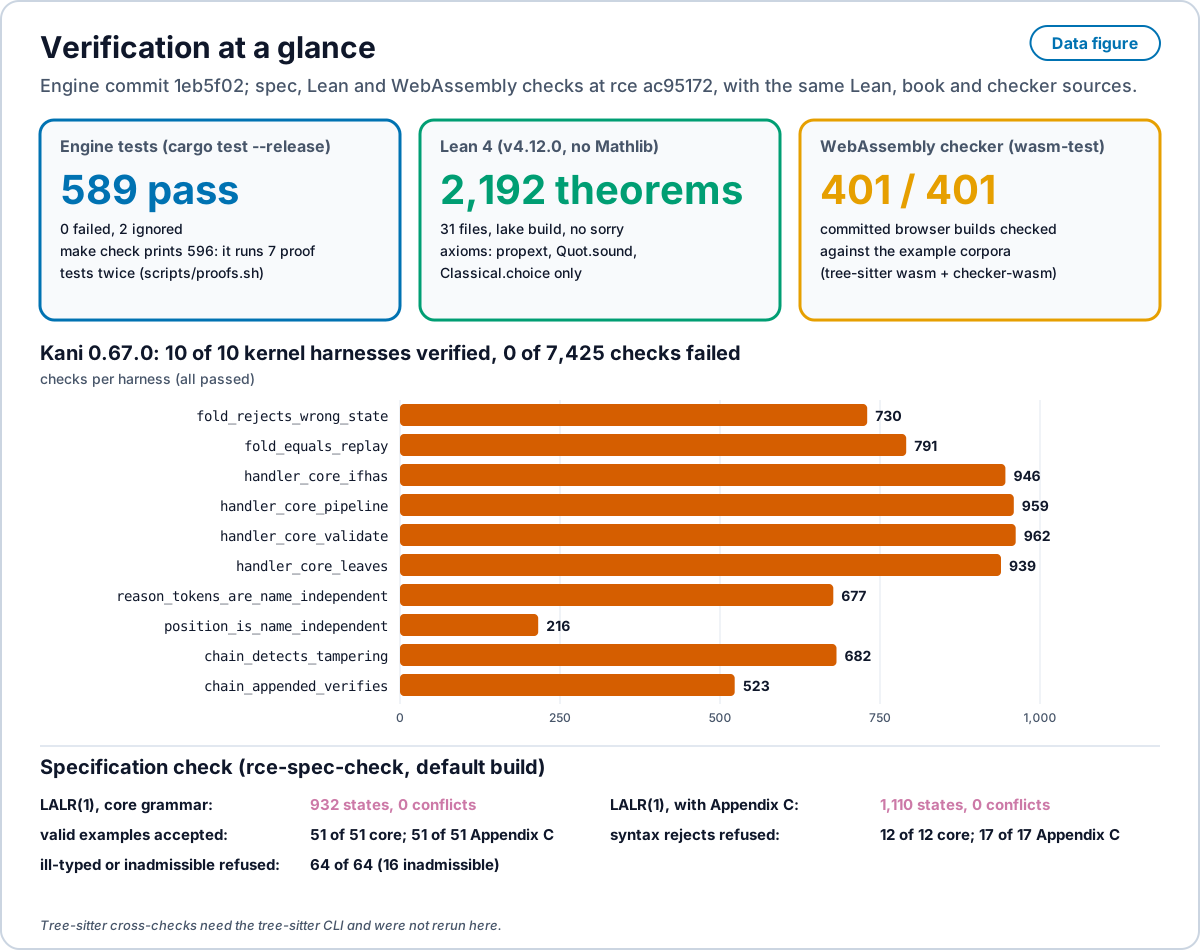
1eb5f02。データ図。エンジンのテスト(cargo test --release):合格 589、失敗 0、無視 2。make check は 7 個の証明テストを二度実行するので 596 と報告する。Lean 4:spec/lean/RCE/ の 31 個のファイルに対する lake build が sorry なしで完了。監査は、公理が propext、Quot.sound、Classical.choice のみである 2,192 個の定理定数(監査の件数であり、ソースの宣言ではない)を報告する。Kani 0.67.0 は 10 個中 10 個のカーネルハーネスを検証し、7,425 個の検査のうち失敗は 0 である(棒:ハーネスあたりの検査数)。チェッカーの WebAssembly ビルドは、例のコーパスに対する 401 個中 401 個の検査に合格する。仕様の検査は、バージョン 0.5(932 状態)とバージョン 0.6 と 0.7(1,110 状態)の LALR(1) の表を衝突 0 で構築し、有効な例 51 個中 51 個を受理し、構文上の却下 12 個中 12 個と、型の誤ったまたは許容されないプログラム 64 個中 64 個を拒否する。Lean、WebAssembly、仕様の検査は公開リポジトリの ac95172 で実行した。その仕様のソースはエンジンのものと同一である。PNG 版も用意している。 Open full size · PNG
収束についての観察。 2026年10月13日に読んだ agentlanguages.dev のカタログは、AI エージェントがコードを書くために設計された 42 の言語を挙げ、その編集者はそれらを構文の陣営、検証の陣営、オーケストレーションの陣営に分けている。機械的に検査される契約、ハッシュ連鎖したログ、決定的な再生、プログラムごとに一つの正準形式など、本論文のいくつかの設計上の選択は、独立に開発された他のプロジェクトの説明にも現れる。これは選択が繰り返し現れるという観察である。それらが正しいという証拠ではなく、本論文はそれらのプロジェクトとの比較を行わない。
4. エンジン:ギア、ゲート、レシート
4.1 エンジンは形式である
RCE はソフトウェアを小さな決定的ハンドラのグラフとして実行する。決定できないハンドラはエスカレーションを発する。リゾルバがそのエスカレーションに一度答え、その答えは恒久的なハンドラとしてインストールされるので、同じ形の次のケースはリゾルバなしで実行される。エンジンは形式のすべての不変条件を満たし、各条件は tests/form_laws.rs の名前付きテストで検査される。
| 不変条件 | エンジンが行うこと |
|---|---|
| 再読み込みは検証済みの畳み込みである | 再読み込みはログをそのまま読み、すべてのハッシュとリンクを再計算し、残りを で畳み込む。何も打刻し直さない。壊れた連鎖は読み込みを拒否する。 |
| 名前に依らない刻み順序 | ハンドラはトポロジカル順位の順に、次いで名前に依らないノードキーの順に実行される。出力はステージングされ、ASM 意味論と同様に、すべてのハンドラの実行後に配送される。すべてのノードの名前を変えても、各エントリで同じ匿名状態ハッシュが得られる。 |
| 黙った破棄をしない | 満杯のメールボックスはメッセージを順序付きキューに保持し、Backpressure を記録する。容量1でタスク10件の場合、Backpressure エントリが9件記録され、10件すべてのタスクが閉じる。 |
| ペイロードはログにある | 入力、刻み、外部ハンドラの結果、インストール、障害はログエントリである。1,000 個のランダムなログにおいて、各エントリ後の状態ハッシュは空のエンジンからの畳み込みと一致する。 |
| 論理クロック | 活性は壁時計ではなく刻みを数える。 |
| 安定したハッシュ | エントリ、状態、形状、規則 ID について、すべての深さでキーを整列した正準 JSON 上の SHA-256(Secure Hash Algorithm、256 ビット)。 |
4.2 ギア
各ギアは、その下のギアがゲートを通過しないときにのみ試される。その順序は一つの固定カスケードである。
| ギア | 方法 | 系譜 |
|---|---|---|
| G0 ルックアップ | SHA-256 形状ハッシュをキーとする共有ハンドラライブラリ。コード修復では順位づけられた関数への局所化 | コード検索と取り出し [21] |
| G1 規則 | 決定的なガード付き修復テンプレートとスキーマ由来の検証器。それぞれ変異感度を検査済み | PAR、TBar、AVATAR、FixMiner [22, 23, 24, 25];Coccinelle のようなコードモッド [26] |
| G2 合成 | ハンドラ文法上の列挙、ソルバ、e-graph | スケッチング、SyGuS、egg [27, 9, 12] |
| G3 から G5 モデル | 型付き決定モデル、ローカルの小型モデル、最後にリモートモデル | モデルカスケード [28] |
4.3 ゲート
候補はゲートを通過したときにのみ昇格される。ゲートはノードの記録された入力を再生し、カバレッジ境界(宣言された誤差予算における3の規則)の下で新しい標本に対して候補をシャドー実行し、出力スキーマを検査し、第5節の証明の証明書を要求する。却下された候補は反例とともに記録される。
4.4 レシート
すべての昇格、拒否、延期、インストールは、SHA-256 で連鎖した追記専用ログの中の変更であり、過去のどのエントリを改ざんしても連鎖が壊れる [29, 30]。各ハンドラのコストは、flowG のネイティブコードバックエンドである FGIR のホストコスト表を用いてインタプリタの演算回数から価格づけられ、est_j とラベル付けされる。各フォアマン呼び出しはそのレシートを伴う。レシートは、ギア、推定の方法(basis)、試した候補、そのギアがエスカレーションを解決したかどうかを示す。その est_j フィールドは必須である。それは有限の非負の数か null であり、null は、エネルギーの数値をもたないモデル呼び出しのように、basis が unpriced と記す場合にのみ許される。このフィールドが欠けたレシートは構文解析されない。価格のないコストがゼロとして読まれることは決してないので、レシートにわたる合計は価格のある呼び出しと価格のない呼び出しを分けて報告し、価格のない解決に依存する節約は不明として報告される。ラダーの実行では部分標本にパッケージのエネルギーカウンタを追加し、reported_j とラベル付けする。
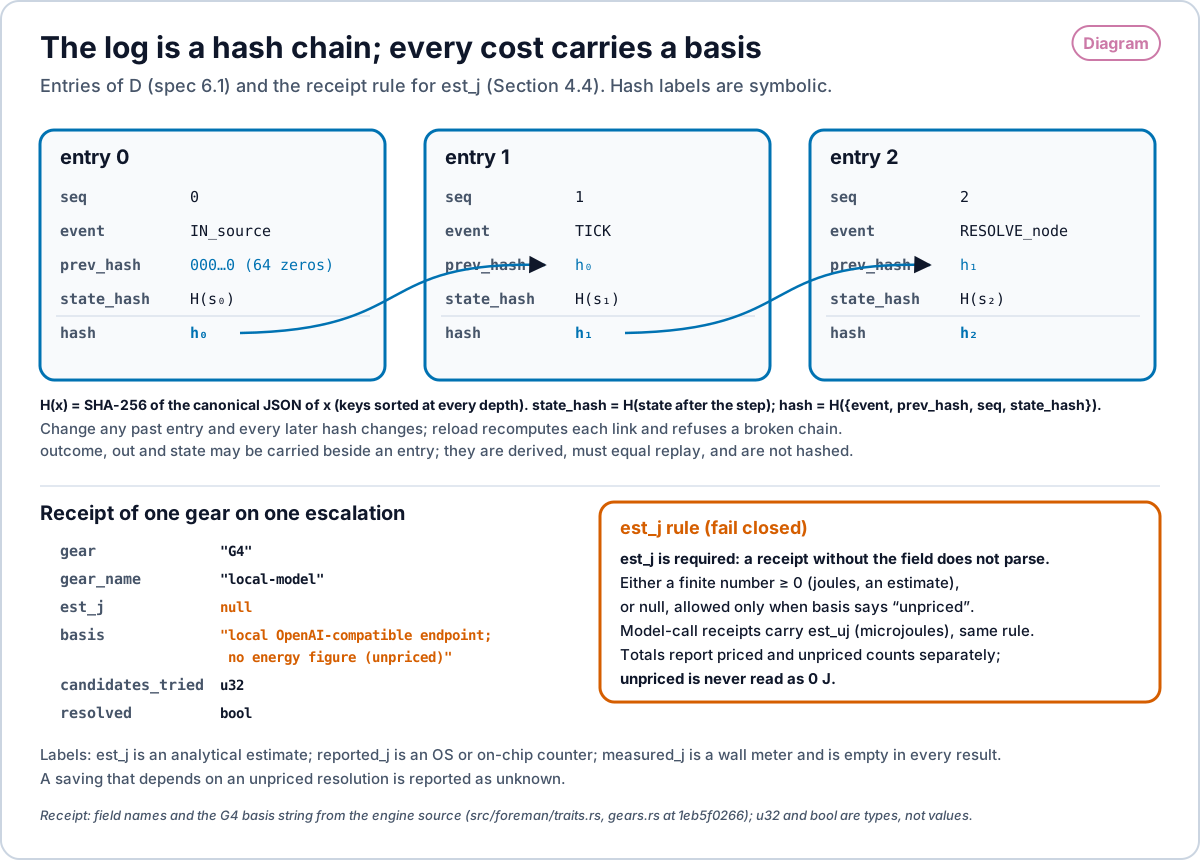
{seq, event, prev_hash, state_hash, hash} である。state_hash はその一歩の後の状態の正準 JSON の SHA-256、hash は {event, prev_hash, seq, state_hash} の正準 JSON の SHA-256 であり、最初の prev_hash は 64 個のゼロなので、過去のどのエントリを変えてもそれ以後のすべてのハッシュが変わる。ギアのレシートは gear、gear_name、est_j、basis、candidates_tried、resolved をもつ。est_j は必須であり、有限の非負の数か、basis が unpriced と記す場合にのみ null である。モデル呼び出しのレシートは同じ規則の下でマイクロジュール単位の est_uj をもつ。価格のないコストが 0 J として読まれることは決してない。ハッシュのラベルは記号的なものである。出典:仕様 6.1 と第4.4節。PNG 版も用意している。 Open full size · PNG
4.5 形式コンパイラ
rce form は仕様とその適合を受け取り、一つの Form IR から五つのターゲットを出力する。
.rce spec + fit
  lower ─► normalize ─► egg e-graph, equality saturation (+ admitted proposals)
  ─► extract (cost = est_j) ─► Form IR (typed relations, regions, rules with SHA-256 ids)
     ├─ Rust crate (pure step, typed state, SHA-256 log and fold, tests)
     │  └─ WASM (the same crate on wasm32-wasip1)
     ├─ Python (standard library only)
     ├─ XState v5 machine
     └─ SCXML document, executed by SCION
IR はすべての数値の端で一つの振る舞いを固定する。検査付き64ビット整数のオーバーフローはエラーであり、決して折り返さない。整数の / はゼロ方向に切り捨てる()。% は被除数の符号をとる()。ゼロ除算はエラーである。浮動小数点数は IEEE 754 binary64 であり、非有限の結果はエラーである。null と不在は区別される。時間は論理クロックのみである。すべてのターゲットは生成される。手で書かれたものは一つもない。
プロセス、HTTP、クロージャのハンドラは項をもたないので、記録されたその結果は、正準入力の SHA-256 をキーとする記録済みオラクルにコンパイルされる。rce scan DIR --form は既存の Rust、Python、TypeScript、Go を形式のスキーマへ持ち上げ、持ち上げられた各要素は構文的な持ち上げとしてラベル付けされる。
4.6 方法:スタック全体を評価し、すべてのインターフェース仮定を明示する
プログラムは階層のスタックである。トークンと文。ハンドラ。形式、すなわち (制御領域。データ:時計、入力数、型付き関係)の上の単一のステップ関数 。ログ、すなわちエントリが各イベント、それが生んだ状態のハッシュ、直前のエントリのハッシュを記録する SHA-256 のハッシュ連鎖。形式を変換する書き換え。そしてそれを実行する基盤。各階層は下の階層についての仮定の上に立っている。RCE はどの階層も固定とはみなさない。スタック全体を評価し、各インターフェース仮定を検査可能な命題として書き下し、実行のたびにそれを検査する。
| 境界 | 仮定 | 検査 |
|---|---|---|
| ソースからハンドラへ | 入力はそのソース契約を満たす | δ の入力イベントでの契約検査 |
| ハンドラからシンクへ | すべての Ok 出力は出力スキーマを満たす | ハンドラ証明(verify::handler_proof)、Kani で検査されたカーネル評価器により全域的かつ決定的 |
| ログから状態へ | すべてのエントリは、それが生んだ状態のハッシュを持つ | カーネルの畳み込み。ハッシュが一致しない最初のエントリを拒否する(Kani ハーネス fold_rejects_wrong_state) |
| 書き換えから形式へ | 書き換えはすべての入力に対して出力を保つ | ランダム化検査、続いて Z3 による SMT 証明 |
| スタブから監督役へ | 決定できないハンドラは推測せずにエスカレーションする | スタブハンドラはエスカレーションを発し、解決は昇格経路を通じてのみ昇格される |
| 形式からターゲットへ | 出力されるすべてのターゲットは同じ δ を計算する | すべてのターゲットは同じ参照トレースを持つ |
検査が失敗すると、破綻はそれが起きた境界に特定される。修正はその階層で行われ、その境界の検査を通され、昇格される。修正された階層より上のすべての階層は、それ以上の変更なしにその修正を受け継ぐ。上の各階層は、修正された階層を、仮定がいまや検査されているインターフェースを通じてのみ利用するからである。修正が上へ伝わり、複利的に積み上がるというのはこの意味である。RCE エンジンデモ は、WebAssembly にコンパイルした RCE コアの上でこれをブラウザで実行する。その Interfaces レイヤーは各仮定を壊し、それを検出する検査を示し、Compounding レイヤーは修正が後のすべてのラウンドへ引き継がれる様子を示す。
5. 検証
5.1 五つのターゲットにわたる差分テスト
tests/form_targets.rs は、29個の端のイベントと 500 個のシード付きランダムな端の値で、11演算子の算術仕様を駆動する。生成された Rust、Python、WASM、XState、SCXML の各ターゲットは、算術の端を含め、参照トレースをバイト単位で同一に出力する。これは McKeeman と Csmith の系譜にある差分テストである [86]。すなわち、明示された入力集合における独立した実装間の一致である。これは翻訳検証 [85] でも検証済みコンパイラでもない。テスト中の11演算子と 529 イベントを対象とし、それ以外の入力については何も述べない。検証は以下の Z3 と Kani の結果である。
図11は、一つの形式の五つの射影と、二つのステートチャート対象の往復を示す。
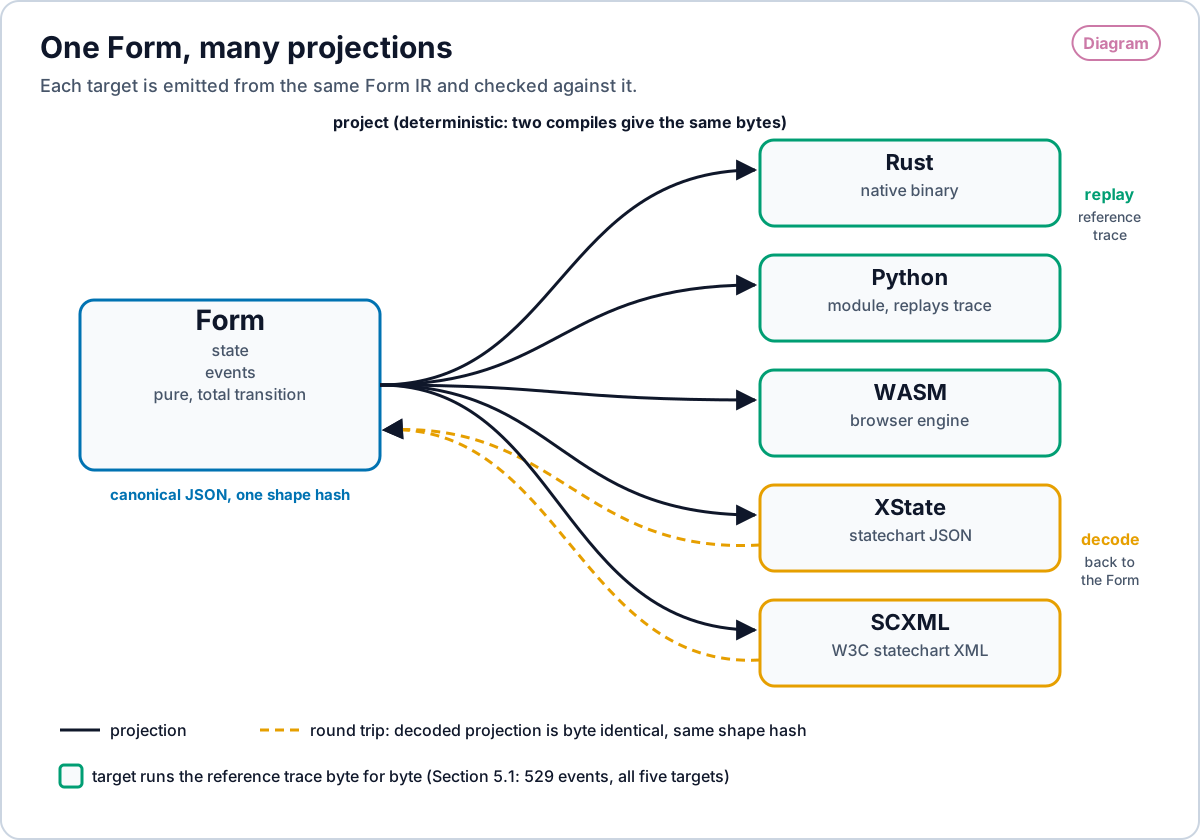
tests/form_targets.rs の 529 個のイベントで参照トレースをバイト単位で出力する。PNG 版も用意している。 Open full size · PNG
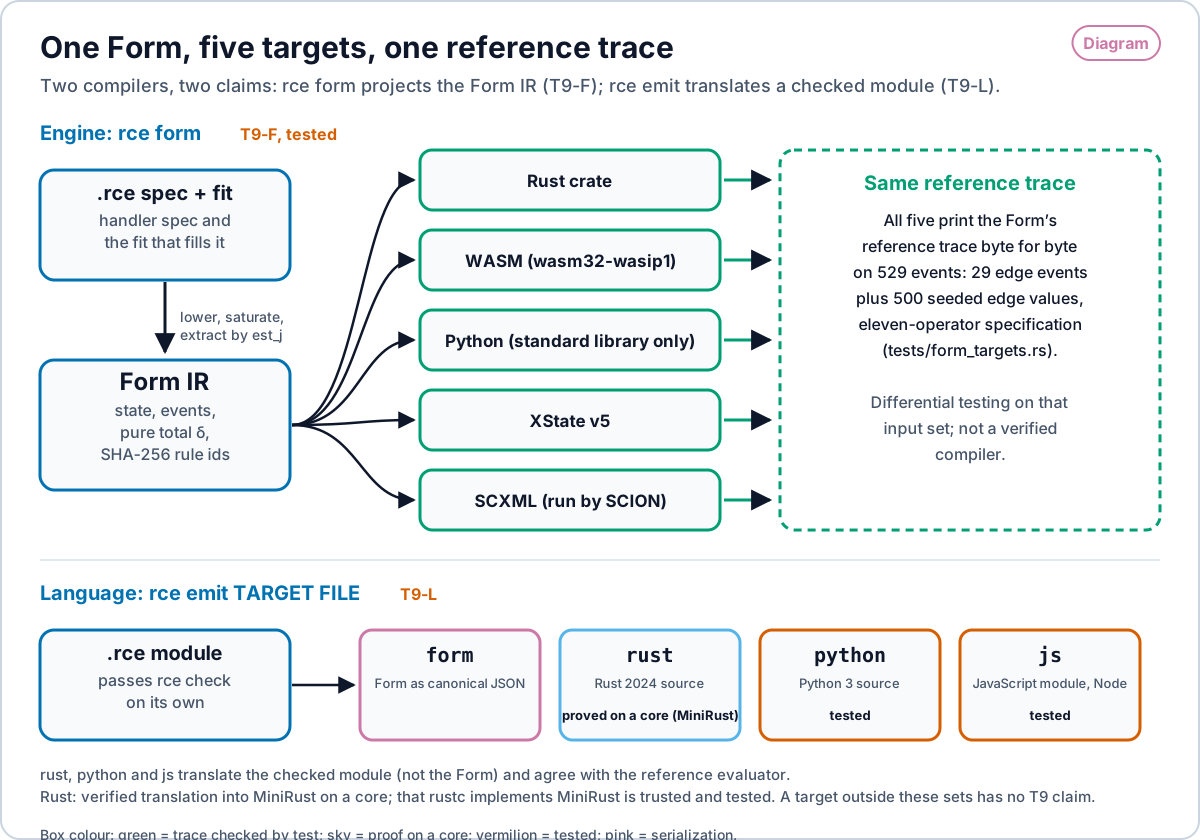
rce form はハンドラ仕様とその適合を形式 IR へ下げ、それを Rust のクレート、WASM、Python、XState v5、SCXML に射影する。五つすべてが 529 個のイベント(29 個の端のイベントと、11 演算子の仕様の 500 個のシード付きの端の値、tests/form_targets.rs)で参照トレースをバイト単位で出力する。これは差分テストによって確立される T9-F であり、検証済みコンパイラではない。下:rce emit TARGET FILE は、(形式ではなく)検査済みのモジュールを form JSON、rust、python、js に翻訳する。T9-L は、Rust 出力器についてはコア上で MiniRust への検証済み翻訳として証明され(rustc が MiniRust を実装することは信頼され、テストされている)、その他についてはテストされている。PNG 版も用意している。 Open full size · PNG
5.2 Z3 で証明された書き換え
検証済みの書き換え規則には系譜がある。Ruler はループにモデルを置かず、等式飽和によって書き換え規則を推論し検査する [87]。したがって第5.5節で受理された、モデルが提案した16規則のうち3規則は、13規則を拒否したゲートについての言明であり、モデルが最良の規則源であるという主張ではない。
組み込みのすべての e-graph 書き換えは、Z3 SMT ソルバ(satisfiability modulo theories)[31] において、形式の項評価と算術の量化子なしの符号化に対して証明される。値はデータ型として、64ビットのビットベクトルは検査付きオーバーフローとして、符号付き除算と剰余は被除数の符号として、浮動小数点数は binary64 として表される。オーバーフロー、エスカレーション順序、またはメッセージを変える書き換えには証明が与えられない。提案された等価性は証明を伴う場合にのみ e-graph に入る。
5.3 カーネルの Kani による証明
エンジンのカーネル(ハッシュ連鎖、畳み込み、名前に依らない位置、ハンドラ評価)は Rust 向けの Kani モデル検査器で検査される [32]。ハンドラ評価は非再帰的な一歩の不動点であり、Kani はその一歩がコンストラクタごとに全域的かつ決定的であることを構造帰納法で証明する。10個のハーネスが Kani 0.67.0 で検証され、7,425 個の検査のうち失敗は 0 である。
| ハーネス | 性質 |
|---|---|
chain_appended_verifies | 追記されたハッシュ連鎖が検証される |
chain_detects_tampering | 変更されたエントリが連鎖を壊す |
fold_equals_replay | 畳み込みは再生に等しい |
fold_rejects_wrong_state | 保存された状態と食い違う畳み込みは拒否される |
position_is_name_independent | 規則の位置はノード名に依存しない |
reason_tokens_are_name_independent | 理由はトークン単位で名前に依らない |
handler_core_leaves | 葉ハンドラは全域的かつ決定的である |
handler_core_validate | 検証は全域的かつ決定的である |
handler_core_pipeline | パイプラインは全域的かつ決定的である |
handler_core_ifhas | ガードは全域的かつ決定的である |
5.4 証明の証明書に基づく昇格ゲート
Kani の実行は証明書を書き出し、そのハッシュは proofs/kani.cert に保存される。エンジン、ログ、規則 ID、ハンドラ評価は証明済みカーネルを経由し、昇格には証明書が必要である。
5.5 検査の後ろに置かれた提案者としてのモデル
モデルは等価性を提案してよい。受理してはならない。デモ用仕様上で、ローカルの15億パラメータのコーディングモデル(llama.cpp 上の Qwen2.5-Coder-1.5B)を用いたところ、提案者は16個の等価性を提示した。検査はランダム試行と Z3 証明によって3個を受理し、13個を却下した。よく知られた87個の恒等式(算術 77 個、構造的 10 個)からなる決定的な提案者は、9個が受理されてすべて構造的なものであり、78個が却下された。却下されたのは、障害順序、非数値、オーバーフローのためのすべての算術の恒等式と、エスカレーションする接頭辞を落としてしまう一つの構造的な書き換え const-absorbs-pipe である(エンジンのテスト tests/form_proposers.rs)。
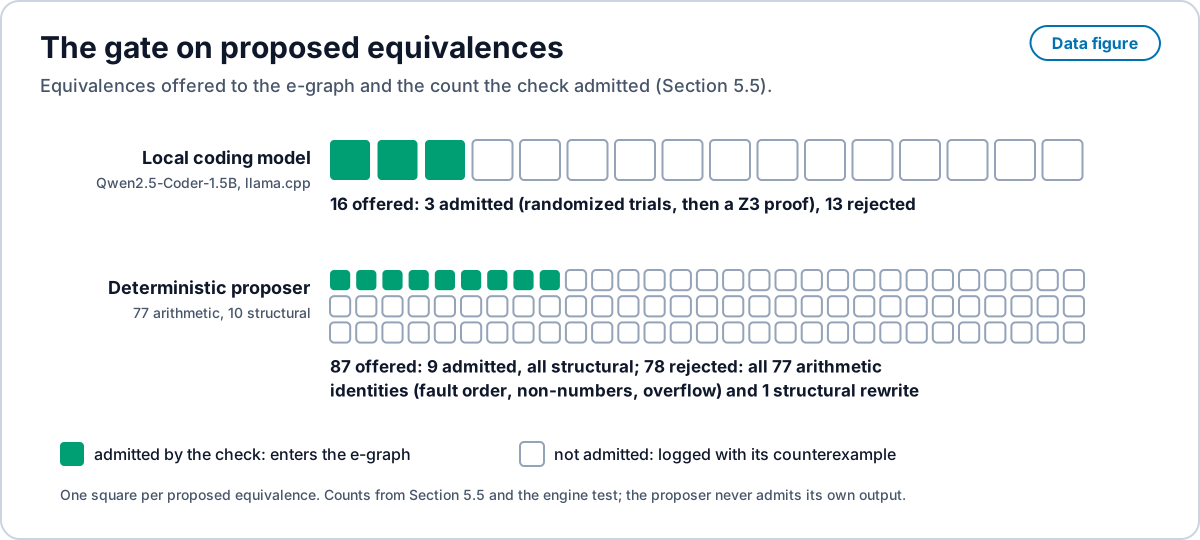
tests/form_proposers.rs による。PNG 版も用意している。 Open full size · PNG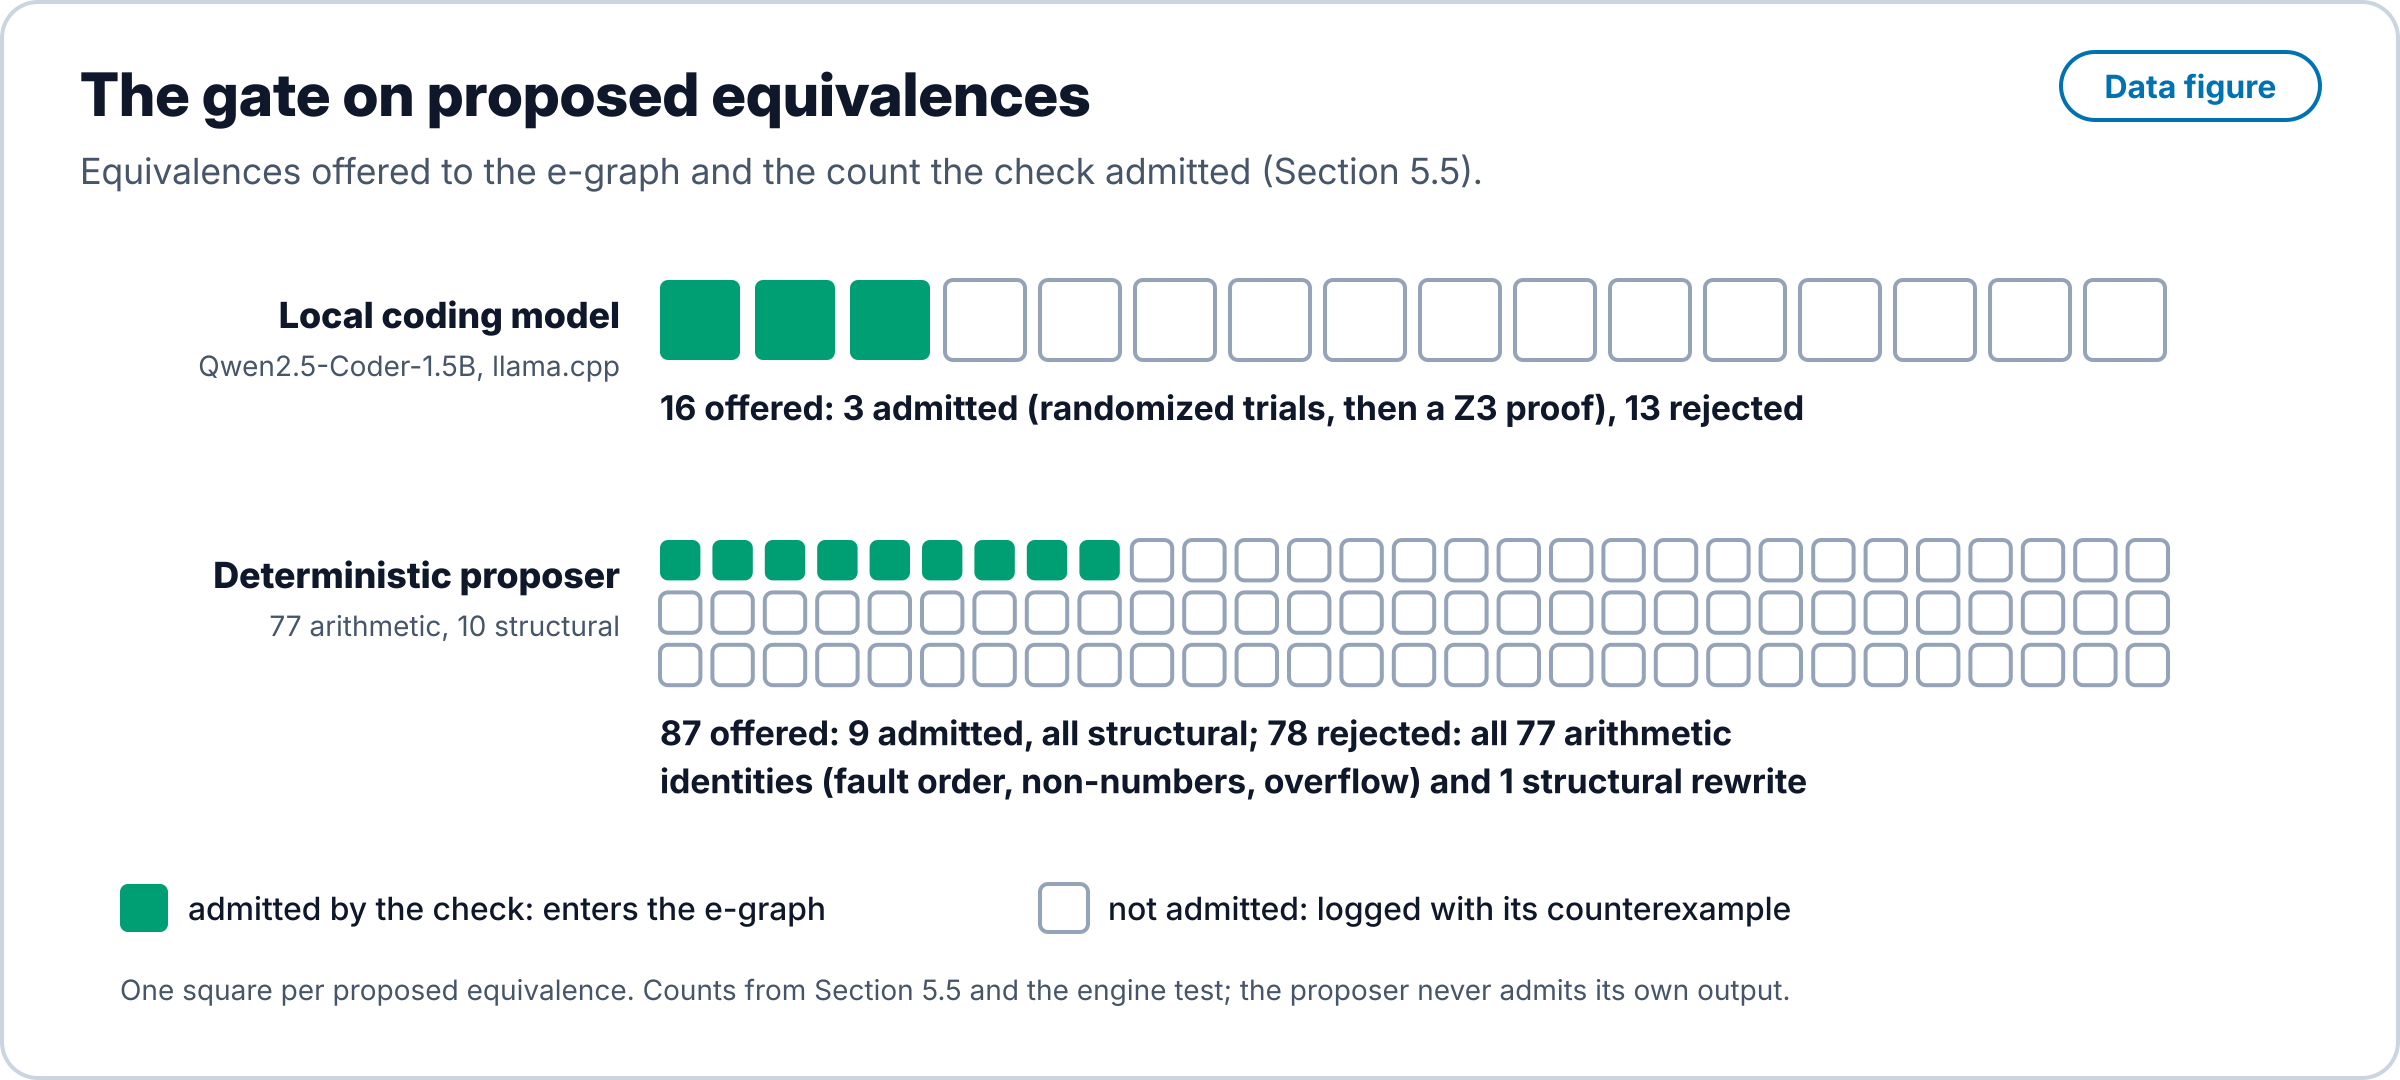
5.6 既存コードとの一致
持ち上げは、Rust、Python、TypeScript、Go のフィクスチャから同じ注文機械を読み取り、元のコードを30呼び出しからなる40個のシード付き列で実行し、各言語で 1,200 呼び出しすべてについて一致する。どの結果よりも前に事前登録された凍結ベンチマークは、既存の三つの営業アウトリーチプログラムを形式として表し直した。形式は記録された 4,500 個の入力のうち 4,500 個で元のコードと一致し、抽出はそれぞれで est_j を下げる(例えば J から J へ)。
6. 持ち上げ:他の言語からエコシステムに入る
持ち上げは、他の場所で書かれたコードがエコシステムに入るための入口である。それは構成であり、どの言語もすでにもっている道具を使って言語ごとに作られる。すなわち、形式文法、構文木を生成する tree-sitter のようなパーサ、抽象構文木、そして言語サーバーのツールが解決するシンボル(Language Server Protocol)である。rce scan DIR --form は Rust、Python、TypeScript、Go について、その木から形式を構築する(§4.5、§5.6)。持ち上げられたプログラムはそのソースの障害を引き継ぐので、持ち上げには修復が含まれ、以下では位置を与えた公開バグコーパスで測定する。エコシステムの内部では、これらの障害は書くことができない。
6.0 持ち上げたコードでの修復ラダー
ここではコーディングタスクを、それが必要とする意図ビットで測る。すなわち、エンジンがすでに保持しているもの(編集箇所を取り巻くプログラム、ライブラリ、テスト、既知の修正の索引)の外から供給されねばならないビットである。目標成果物を確定するビットを 、コーパスがすでに固定しているビットを と書くと、供給されるビットは である。候補の中で正しい編集を順位 に置くギアは ビットの探索を供給したことになり、残りはゲートが供給する。ラダーはタスクを編集の大きさ、すなわち の客観的な代理指標で並べる。1トークン(L0)、1文(L1)、1ハンク(L2)、1ファイル内の複数ハンク(L3)、複数ファイル(L4)、仕様またはテストからの関数(L5)、イシュー水準の変更(L6)、仕様からのプログラム(L7)である。段、コーパス、分割、仮説は本実行の前に事前登録されている。ファイルは公開リポジトリにある。
| 段 | 保留テストコーパス | N | 解決 | 率 | Wilson 95% CI | 探索ビットの中央値 | モデル呼び出し |
|---|---|---|---|---|---|---|---|
| L0 1トークン | 固定コミットにおける9つの実リポジトリの PIT 型ミュータント [109](Java:commons-math、commons-collections、jsoup、joda-time、gson;Python:click、attrs、pydantic、sympy) | 520,821 | 520,541 | 0.9995 | 0.9994 から 0.9995 | 2.3 | 0 |
| L0 1トークン、調整に一度も使っていないリポジトリ | commons-text、commons-io、more-itertools、httpx | 23,015 | 23,015 | 1.0000 | 0.9998 から 1.0000 | 2.0 | 0 |
| L1 1文、Java | ManySStuBs4J 2.0 の単一ハンク修正 [107] | 24,072 | 9,288 | 0.386 | 0.380 から 0.392 | 3.5 | 0 |
| L1 1文、Java、ファイル全体 | ManySStuBs4J 2.0 [107]、親コミット時点のファイルとプロジェクトのメソッド索引およびガード索引 | 21,320 | 13,586 | 0.637 | 0.631 から 0.644 | 4.8 | 0 |
| L1 1文、Python | TSSB-3M v1.0.0、シャード14と15 [108] | 157,089 | 27,266 | 0.174 | 0.172 から 0.175 | 4.8 | 0 |
図14は表の各行をその区間とともに描く。
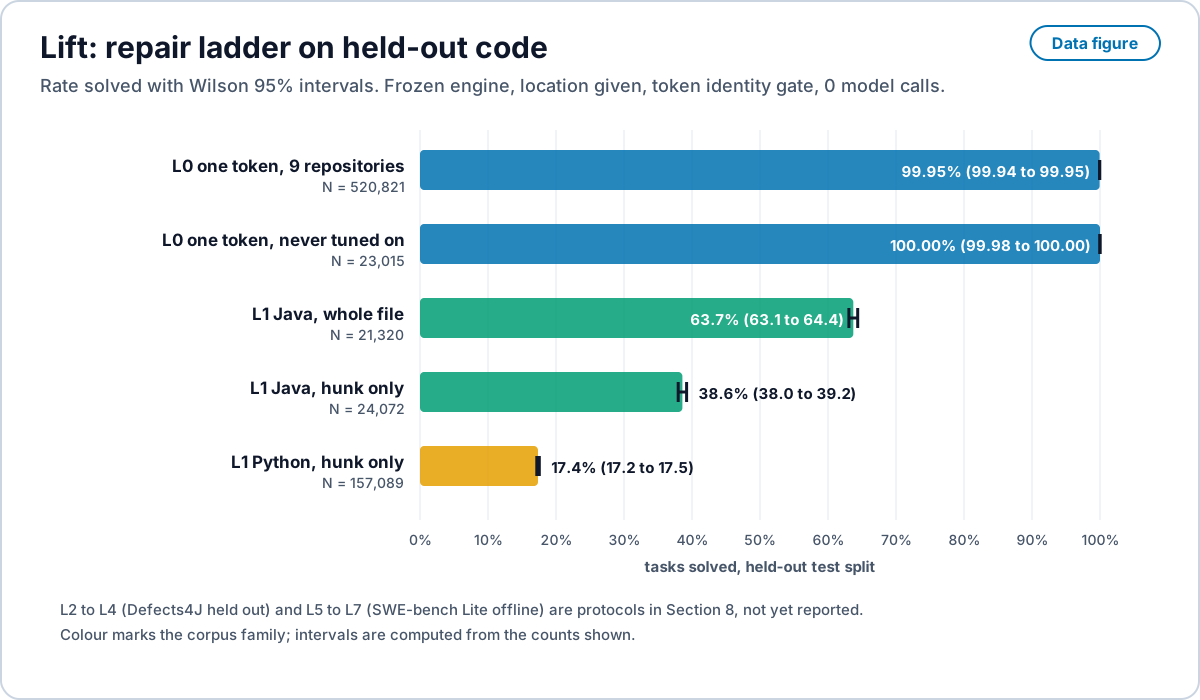
bench/ladder にある。PNG 版も用意している。 Open full size · PNG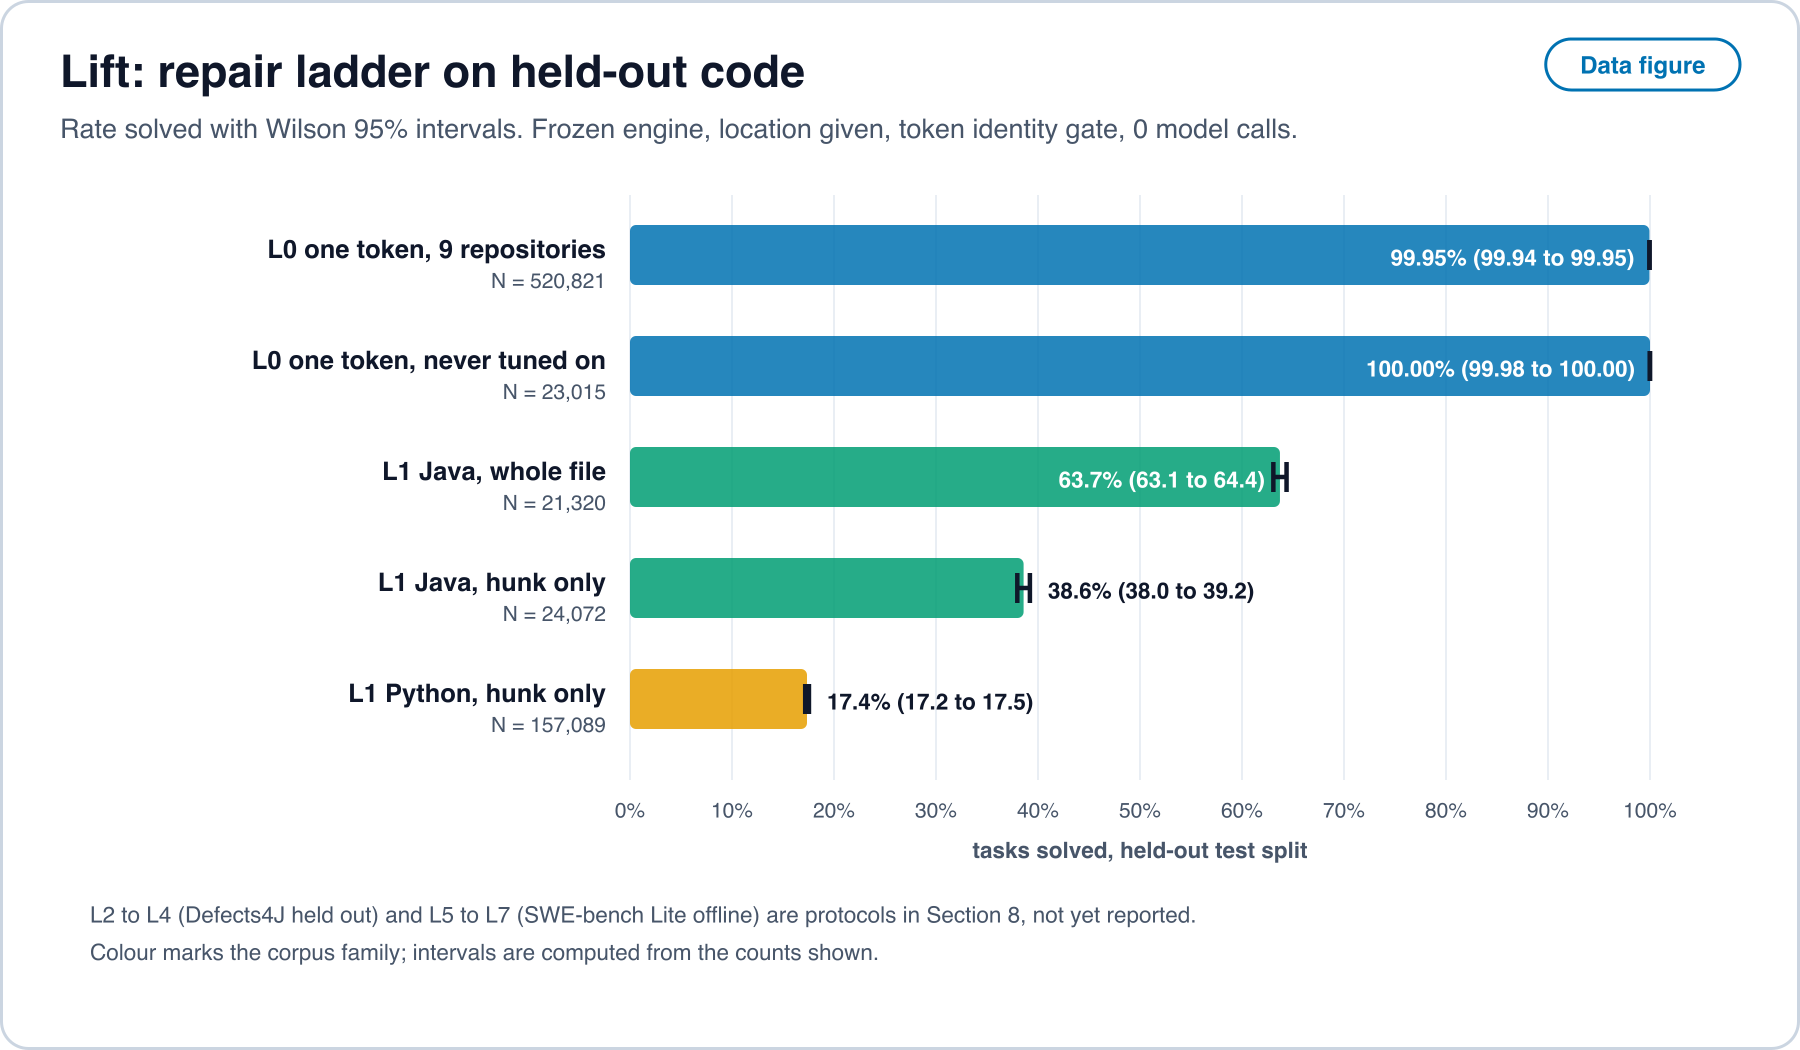
L2 から L4 は 288 件のバグからなる Defects4J の保留セットで測定する(第8.1節)。L5 から L7 は 第8.2節 のプロトコルに従う。各行の方法、ゲート、エネルギーを以下に示す。
未解決の問題:単一トークン率のベースライン。 L0 の行は、事前分布で順序づけた単一トークン近傍が単一トークンの変異体をどれほどの頻度で復元するかを測る。その近傍が変異体を生成したのと同じ演算子の表から構築されているなら、高い率の一部はその重なりを反映しているのであって、実際に生じる障害に対する修復能力を反映しているのではない。本論文はこの結合のリスクを引用しているが、それについての数値は示さない。同じ変異体に対して実行する単純な演算子反転探索が、その率のどれだけを説明するかを示すベースラインである。このベースラインは実行していないので、ここでは数値を示さず、単一トークン率はこの懸念にさらされたままである。
率は意図ビットとして読める。L0 では欠けたビットのほとんどがその行の上にあり、事前分布で順序づけた単一トークン近傍が中央値 2.3 ビットでそれを供給する。ハンクのみの L1 行では、エンジンは7行のハンクしか見ない。ビットがハンクの中にあるカテゴリは閉じ(Java:演算子の変更 91%、真偽値リテラルの入れ替え 84%、引数の入れ替え 82%;Python:真偽値リテラルの変更 98.8%、引数の入れ替え 99.4%)、ビットがその外にあるカテゴリは開いたまま残る。メソッド名(22%)と識別子(37%)にはファイルとその型が必要であり、新しい連言(3% から 7%)と文全体の書き換え(Python、コーパスの34%を占めるカテゴリのうち 1.2%)は新しい意図である。新しい意図とは、供給者(仕様、テスト、人、またはローカルモデル)が一度だけ提供するものであり、その後その適合は索引に入る。
方法。 各コーパスは固定シードでシャッフルされる。各シャッフルの最初の 2,000 位置、および L0 については三つのリポジトリ全体(commons-lang、requests、flask)が開発用分割をなし、そこではギアを調整してよい。開発用の結果は報告しない。残りのすべてのタスクはテスト用分割に入る。テスト実行の前にエンジンはコミットされ、そのバイナリハッシュが記録され、実行中にギアは一切変わらない。本節のすべての行は、テストタスクのみに対する、モデル呼び出し 0 回の凍結エンジンの結果である。事前登録(PREREG.json)、タスクごとの行、報告スクリプトは公開リポジトリにある。
ゲート。 L0 と L1 では位置が与えられ、ゲートはトークン同一性である。修復された行または文は、開発者のものとトークン単位で等しくなければならない。これはテストに合格するより厳しい。パッチは弱いテストスイートに合格しても誤っていることがあるからである。Qi らは、GenProg が修正として報告したパッチの大半がもっともらしいが誤っていることを見出した [92]。テストへの過適合は探索ベースおよび意味ベースの修復で記録されており [93, 94]、生成テストによって対処されている [95]。ツールは調整に使ったベンチマークでより高い得点を出し [96]、障害局所化は比較を偏らせる [97]。トークン同一性はこれらの段におけるもっともらしさの隔たりを取り除き、位置を与えることは局所化の項を取り除くので、率は修復ギアのみを測る。L2 以上はテストをゲートとし、もっともらしい件数と正しい件数を別々に報告する(第8.1節)。
6.1 L0:1トークンの障害
L0 コーパスは、固定コミットにおける9つの実リポジトリ(Java 5、Python 4)で、有効な置換トークンをもつすべての PIT 型ミュータント [109] である。547,448 件中 520,821 件のテストタスクである。エンジン(コミット 65571d0、ギア G0-T と G1-J)は 520,541 件を復元し、率は 0.9995(95% Wilson 区間 0.9994 から 0.9995)、探索ビットの中央値は 2.3 である。未解決の 280 件のうち、108 件は浮動小数点リテラル内の変異した数字であり、2 件は Python の集合リテラル内にある。浮動小数点リテラル用のギア(G0-F、コミット ecfe5a1)は、調整に一度も使っていない四つのリポジトリ(commons-text、commons-io、more-itertools、httpx)で試験された。23,015 件中 23,015 件、1.0000(0.9998 から 1.0000)、探索ビットの中央値 2.0 である。ミュータントは実際の1トークン障害の代用であり、Just らはそれが実際の障害と結びついていることを見出した [110]。
6.2 L1:実際の履歴からの1文バグ
L1 は、オープンソースの履歴から採掘された実際の単一文バグ修正の二つの公開データセットを用いる。ManySStuBs4J 2.0 [107] は 24,072 件の Java テストタスクを与え、エンジン(コミット f2701b7)は 9,288 件を解決し、率は 0.386(0.380 から 0.392)である。TSSB-3M v1.0.0 [108] はシャード14と15から 157,089 件の Python テストタスクを与え、同じエンジンは 27,266 件を解決し、率は 0.174(0.172 から 0.175)である。エンジンは7行のハンクのみを受け取るので、この Java の率はハンクのみの結果である。親コミット時点のファイル全体を与え、プロジェクトのメソッドとガード条件の索引、そしてメソッド名の変更、引数の追加、ガード条件、throws、修飾子のためのギアを加えると(コミット 62fb7a0、バイナリの sha256 接頭辞 3682c6515acdf722、実行前に事前登録)、エンジンはファイルとバグのある文を特定できた 21,320 件の Java テストタスクのうち 13,586 件を解決し、率は 0.637(0.631 から 0.644)である。カテゴリ別では、演算子の変更(95.9%)、オペランドの変更(92.1%)、誤った呼び出し元(87.9%)、真偽値リテラルの入れ替え(88.4%)、引数の削除(85.1%)、引数の入れ替え(83.3%)を閉じる。メソッド名の変更は 61.4%、引数の追加は 51.4% に達し、新しい条件や狭められた条件(43.5% と 51.7%)が主要な未解決の意図として残る。層ごとの完全な表はリポジトリにある。これらのデータセットには、このゲート(ハンクのみ、トークン同一性、位置は既知)の下で公表された修復のリーダーボードがないので、学習型修復の数値は並べていない。リーダーボードをもつ Defects4J は、第8.1節で TBar と比較する。
6.3 エネルギー
すべての行は est_j、すなわち CPU 秒に 10 W を掛けた推定値を伴う。解決タスクあたり L0 で 0.40 J、新しいリポジトリで 0.13、ManySStuBs4J で 0.10、TSSB-3M で 0.27 である。部分標本は、Intel i9-13900H を搭載した Linux ノートパソコン(ホスト名 jetson-hub。NVIDIA Jetson ではない)上で、プロセッサのチップ上パッケージカウンタである RAPL [105] により読み取った。ハーネスは固定した4つの CPU 上で動作し、reported_j は Python ドライバを含む実行全体にわたるパッケージの差分から、直前に取った 10 s の標本によるアイドル電力に実行時間を掛けたものを引いた値である。継続的インテグレーションのランナーが稼働していたため、アイドルは 40 W から 44 W であり、不確かさは約 ±1 W に時間を掛けたもの、これらの合計で ±10 J である。
| 部分標本(テスト用分割) | タスク | 解決 | 生の J | reported_j | 解決タスクあたりの reported_j | 秒 |
|---|---|---|---|---|---|---|
| L0、gson ミュータント(シード付き、最初の 3,000) | 3,000 | 3,000 | 648.3 | 167.5 | 0.056 | 11.8 |
| L1、ManySStuBs4J の位置 2,000 から 3,999 | 2,000 | 690 | 377.2 | 17.9 | 0.026 | 8.2 |
L1 の部分標本はその 2,000 タスクのみからプロジェクト索引を構築するので、その解決率(34.5%)は本実行の率より低い。名前を付けた電源レール上の壁面電力計である measured_j はすべての行で空欄であり、そのプロトコルは第8.3節である。
7. 再利用の証拠
再利用の軸における RCE の位置は、一つの工学的事実の上に立つ。コードはあらゆる規模で再利用されている。以下の各方法はそれを異なるやり方で測る。
| 方法 | 出典 | 知見 |
|---|---|---|
| ファイル水準のクローン写像 | DéjàVu, Lopes et al. 2017 [33] | フォークでない 450 万の GitHub プロジェクトにある 4 億 2,800 万ファイルのうち、一意なものは 8,500 万である。「GitHub 上のコードの70%は、以前に作られたファイルのクローンからなる。」JavaScript では、ファイルの6%が固有である。 |
| 行水準の冗長性 | Gabel and Su 2010 [34] | 4 億 2,000 万行に対して、約1行の粒度で「各プロジェクトの50%から100%が冗長である」。 |
| 統計的言語モデル | Hindle et al. 2012 [35] | コードは「非常に反復的であり、実際、自然言語以上にそうである」。 |
| コーパスの近似重複除去 | The Stack [36] | 近似重複除去により The Stack v1 の54.7%(6.4 TB から 2.9 TB)、v2 の52.4%(67.5 TB から 32.1 TB)が除かれる。 |
| アーカイブ全体の保存 | Software Heritage [129, 130] | 4 億 4,800 万の起源からの 303 億の一意なファイル内容(アーカイブのカウンタ、2026年10月13日に読み取り)が、それぞれバイトのハッシュによって一度だけ保存されている。 |
| 採掘された修正パターン | PAR, TBar [22, 23] | PAR は 60,000 を超える人間のパッチの中に「いくつかの共通の修正パターン」を見出した。TBar の15のパターンカテゴリは、学習なしで、標準パイプラインで Defects4J のバグ43件を正しく修正し、完全な障害局所化の下では 101 件中 74 件を修正する。これらは [23] から読み取った数値である。101 の意味(もっともらしいパッチか、試みたバグか)はここではその論文に照らして再確認しておらず、したがってこの比は未確認として扱うこと。 |
| 言語横断のタスク | Rosetta Code [131] | 1,360 のタスク(と 421 の草稿タスク)。それぞれ一つの概念が、既知の 1,009 言語の多くで実装されている。 |
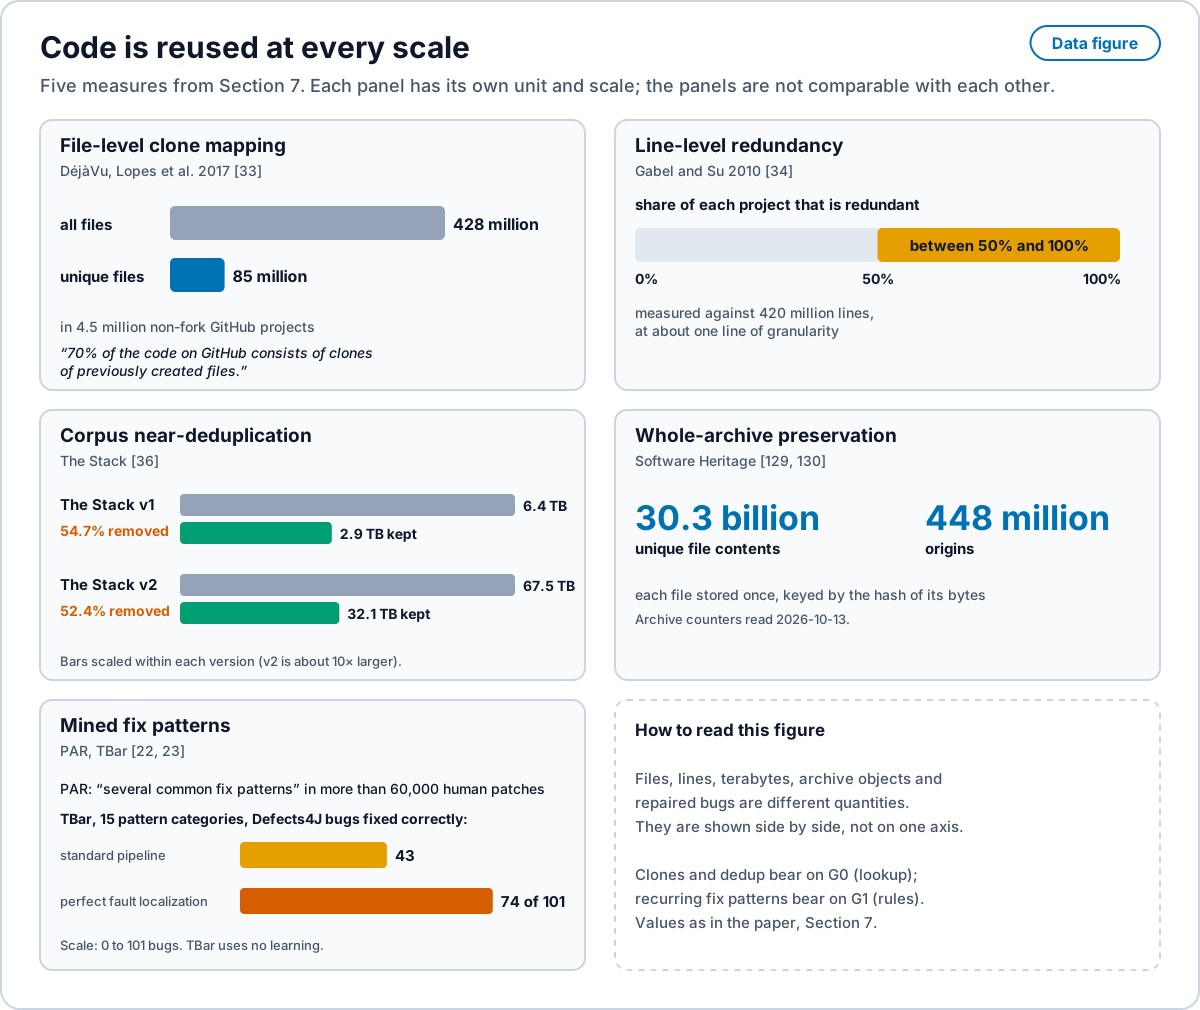
各行はエンジンへの入力である。クローンと重複除去は適合がたいてい存在することを示し、それが G0 である。繰り返し現れる修正は、適合の大半がガード付き書き換えの小さなカタログであることを示し、それが G1 である。行水準の冗長性は G2 の探索空間を縮める。エコシステムは昇格したすべての適合でこれを測り(第2.3節)、持ち上げたコードでの修復ラダーは保留分割上の大規模な測定でこれを測る(第6節)。二つの注意が読み方を鋭くする。重複は除去しない限り取り出しとモデルの得点を水増しする [104]。またバグのある行は修正後の行より自然さが低い [45] ので、バグそのものはルックアップが最も予測しにくいケースである。G0 と G1 がキーにすべきは、バグのある行ではなく修正の形状である。これを大規模に行う規則採掘の系譜は、GenProg の生成と検証による探索 [88] と Prophet の学習された正しさモデル [89] から、Facebook の Getafix [90]、静的解析違反に対する Sorald のモデル不要の修復 [91] に至るまで、互いに素な履歴からテンプレートを導き、未見のケースでの適合率を報告する [98]。それが第8.4節の採用する基準である。
8. 次に来るものの測定プロトコル
各プロトコルは実行前に固定される。事前登録をコミットし、シードとソルバのコミットを記録し、すべての成果物を保存する。ゲートが第一、ジュールが第二、ラベルは常に付ける。
8.1 Defects4J
Defects4J は 854 件の有効な実際の Java バグを保持し、それぞれに再現テストがある [37]。
defects4j checkoutを通じて、オフラインで 100 件のバグの部分集合上で開発する。保留結果のみを、実行前に凍結した互いに素な 288 件のバグの集合(FROZEN-heldout-v1)について報告する。- G0、次に G1、次に G2、最後にローカルモデルを実行する。各バグを閉じたギアを記録する。
- ゲート:トリガとなるテストと全スイートが合格すること。もっともらしい件数と正しい件数を別々に報告する。正しいとは、レビューで開発者のパッチと等価であることを意味する。
- 正しい修正あたりのモデル呼び出しと、正しい修正あたりのジュールを、ラベル付きで報告する。
- 参照点:TBar の正しい修正43件と、完全な局所化の下での 101 件中 74 件([23] から読み取った数値で、分母はここでは再確認していない)。この節はプロトコルである。本論文では、このエンジンの Defects4J の結果は報告しない。
- 汚染検査:修正が G0 の索引にそのまま現れるすべてのバグに印を付け、印付きのバグを含む場合と除く場合で報告する。
8.2 SWE-bench Lite、オフライン
SWE-bench Lite は、隠しテストで解決される実際の GitHub イシューの 300 タスクの部分集合である [38]。
- ネットワークなしで公式の Docker ハーネスを用いる。
- 第一の実行:G0 と G1 のみ、モデル呼び出しゼロ。これがモデルなしで解く床である。
- 第二の実行:最後のギアとしてローカルモデルを加える。
- 解決率、解決タスクあたりのモデル呼び出し、解決タスクあたりのジュールを、ラベル付きで報告する。
- 汚染検査は 8.1 と同様。SWE-Bench+ は、成功したパッチの32.67%でイシュー本文に解答が含まれていたことを見出した [39]。
8.3 壁面電力計
- ホストの電源に壁面電力計またはシャント計を取り付け、明示した速度で記録し、その時計を実行ログと同期させる。
- アイドル状態の機械:CI ランナーと他のビルドを停止し、各ブロックの前に静穏期間のゲートを検査して記録する。
- 測定したアイドル基準値を差し引き、その方法を明示する。
measured_jは電力計のみから埋める。reported_j(RAPL)とest_jを別々の列で横に並べて報告する。ラベルをまたいで合計してはならない。- 第6.3節の RAPL 部分標本を電力計の下で繰り返し、次いで Defects4J の保留セットを測る。
8.4 ギアを凍結した保留実行
これは第6節の方法を新しいコーパスに拡張したものである。
- G0、G1、G2 をタグ付きコミットで凍結し、バイナリハッシュを記録し、規則集合をその作成時刻とともに公開する。
- 互いに素な保留スライスを抽出する。Multi-SWE-bench [102] と BugsInPy [103] の Rust と Python のインスタンスを、G0 の索引に対して重複除去したもの [104]。
- 最初の実行の前に、スライス、シード、仮説を事前登録する。
- 解決、もっともらしい、バイト同一の件数を、それぞれ 95% 区間とともに別々に報告する。
8.5 同じ表に置くベースライン
- モデル不要:
cargo fixと clippy [106]、および Sorald または TBar の移植 [91]。 - 安価なモデル:ローカルモデルを用いた Agentless [99]。
- リモートモデル:フロンティアモデルを用いたエージェント。そのエネルギーは提供者の開示から推定し、
est_jとラベル付けする。 - すべての行について、Kapoor らが求めるようにコストを統制したうえで [100]、cost-of-pass [101] をジュールとドルで報告する。
8.6 大きな N におけるモデル呼び出しの収束
昇格は、モデルがループから去る仕組みである。リゾルバは新しいケースに一度だけ支払われ、ゲートはその適合をハンドラとして受理し、同じ形の以後のケースはすべて G0 または G1 で閉じる(第4.2節)。収束とは、固定された仕様の上で実トラフィックの下、ラウンドあたりのモデル呼び出しがゼロに落ちるという主張である。それは次のように測定する。
- 公開リポジトリから言語と規模で層別して少なくとも 1,000 の仕様を抽出し、最初のラウンドの前にエンジンとリゾルバを凍結する。
- 記録された本番トラフィックを、仕様ごとに少なくとも 10,000 イベント、固定サイズのラウンドで再生する。
- ラウンドごとに記録する:新しいエスカレーション、モデル呼び出し、昇格、延期、閉じたタスクあたりのジュール。それぞれラベル付き(
est_j、reported_j、measured_j)。 - 主要評価項目:20 ラウンド以内にモデル呼び出しゼロのラウンドに到達する仕様の割合と、その 95% Wilson 区間。副次評価項目:ラウンドごとの閉じたタスクあたりのモデル呼び出し、および最後のモデル呼び出しのラウンド。
- 収束しない仕様をその原因(行き詰まった入力、欠けた依存関係、新しい意図)とともに報告し、行き詰まった入力の延期を事前登録された群として実行する。
命題8(床への接近)。 G0 と G1 のカバレッジが増えるにつれ、解決タスクあたりのジュールは、既知の修正を適用してテストを実行するという金の床に近づく。壁面電力計の下でのラダーの段と Defects4J の保留セットがこれを検証する。
8.7 言語をまたぐ持ち上げのカバレッジ
持ち上げは構築しながら測定する。言語 について、 がそのプログラム自身のテストに合格し、記録されたトレースをバイト単位で再生し、かつ が と同じ形状ハッシュをもつとき、そのプログラムは持ち上げ済みと数える。標本は少なくとも十の言語について言語ごとに少なくとも 10,000 個のプログラムであり、固定されたシードで、版を固定した公開コーパスから抽出する。各実行の前に持ち上げ器を凍結してそのバイナリハッシュを記録し、モデル呼び出しは 0 回とする。各実行は持ち上げ済みの割合を Wilson 95% 区間とともに報告し、まだ持ち上げられていない各構成要素は、その言語の持ち上げ器に対する作業項目となり、次の実行の前に構築されて凍結される。目標は、すべての言語のすべてのプログラムである。
9. 反証条件
それぞれが検証する実行の前に固定する。
| ID | 観測 | 覆すもの |
|---|---|---|
| RCE-F0 | 少なくとも 10,000 個の形式からなる事前登録された実行で、いずれかの射影が形式の参照トレースと異なるトレースを出力する、またはいずれかの不正な入力が受理される | 射影が忠実であり、ゲートが入口で拒否するという主張 |
| RCE-F1 | 保留スライスにおいて、凍結した規則による G0 から G2 が、モデル呼び出し 0 回でタスクの10%未満しか解決しない | この規模の修復ではほとんどの適合がすでに存在するという主張 |
| RCE-F2 | バイト同一または等価なパッチが、解決された保留タスクの半数未満である | 覆われたタスクにおいてゲートをもっともらしさ以上のものとする読み方 |
| RCE-F3 | 壁面電力計の下で、両者が解くタスクにおいて、RCE ソルバの解決タスクあたりの総ジュールが最も安いモデルベースラインのそれを上回る | 覆われたタスクにおいて解決タスクあたりのエネルギーがより低いという主張 |
| RCE-F4 | 第8.6節の収束プロトコルにおいて、行き詰まった入力のない仕様のうち、20 ラウンド以内にモデル呼び出しゼロのラウンドに到達するものが半数未満である | モデルをループの外へコンパイルすること |
10. 完了すべき作業
各項目には、そのプロトコルが明示されている。
- 第8.7節のプロトコルに従い、少なくとも十の言語で持ち上げを構築して測定する。
- 仕様アーム:MBPP と HumanEval の形式の仕様を形式として書き、すべてのターゲットへ出力する。
- L2 から L4、すなわち 288 件のバグからなる Defects4J セット(第8.1節)、および L5 から L7(第8.2節)の保留結果。
- 一つの表にまとめたベースラインと、ジュールとドルでの cost-of-pass(第8.5節)。
measured_jの系列:アイドル状態のホストでの壁面電力計、少なくとも 10 回の反復、総量と正味を並べて(第8.3節)。- 626 言語の調査を、その方法とともに公開する(図1)。
- ギアを凍結した新しい保留コーパス:Multi-SWE-bench と BugsInPy(第8.4節)。
- 少なくとも 1,000 個の仕様にわたるモデル呼び出しの収束(第8.6節)。
11. 結論
RCE はネイティブなコード・エコシステムである。プログラムは意図から一度だけ、形式として書かれる。形式は状態、イベント、純粋な遷移の可逆な符号化であり、すべてのターゲット言語はその忠実な射影である。不正な状態は書くことができず、不正な入力は入口で拒否されるので、エコシステム内のプログラムはその意図からずれることがなく、事後の差分比較もエラー追跡も必要としない。ゲートを通過したすべての適合は保存されて再利用され、エコシステムは正しさが単調であるゲートのもとで複利的に積み上がる。事前登録された 10,000 個の形式について、エンジンを凍結しモデル呼び出し 0 回で、すべての形式は往復して同一のバイトに戻り、すべての射影は決定的であり、すべての不正な入力と仕様は入口で拒否され、Python 射影は 9,999 個で参照トレースを再生する。他の言語のコードは持ち上げによって入る。それは各言語の文法からその構文木を経て形式へ至る構成である。持ち上げたコードでは、修復ギアが 520,821 件の1トークン障害の 99.95% と、21,320 件の単一文 Java バグの 63.7% を復元する。第3.6節と第8.7節が普遍性の命題と、その構成をどう測るかを述べる。
参考文献
[1] C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal 30(1), 1951. doi:10.1002/j.1538-7305.1951.tb01366.x
[2] Y. Gurevich, “Sequential Abstract State Machines Capture Sequential Algorithms,” ACM Transactions on Computational Logic 1(1), 2000. doi:10.1145/343369.343384
[3] A. Blass and Y. Gurevich, “Abstract State Machines Capture Parallel Algorithms,” ACM Transactions on Computational Logic, 2003. doi:10.1145/937555.937561
[4] N. Dershowitz and Y. Gurevich, “A Natural Axiomatization of Computability and Proof of Church’s Thesis,” Bulletin of Symbolic Logic, 2008. doi:10.2178/bsl/1231081370
[5] E. F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM, 1970. doi:10.1145/362384.362685
[6] G. H. Mealy, “A Method for Synthesizing Sequential Circuits,” Bell System Technical Journal, 1955. doi:10.1002/j.1538-7305.1955.tb03788.x
[7] E. F. Moore, “Gedanken-Experiments on Sequential Machines,” Automata Studies, 1956. doi:10.1515/9781400882618-006
[8] K. Kang et al., “Feature-Oriented Domain Analysis (FODA) Feasibility Study,” CMU/SEI-90-TR-021, 1990.
[9] R. Alur et al., “Syntax-Guided Synthesis,” FMCAD 2013. doi:10.1109/FMCAD.2013.6679385
[10] D. Harel, “Statecharts: A Visual Formalism for Complex Systems,” Science of Computer Programming, 1987. doi:10.1016/0167-6423(87)90035-9
[11] R. Tate, M. Stepp, Z. Tatlock and S. Lerner, “Equality Saturation,” POPL 2009. doi:10.1145/1480881.1480915
[12] M. Willsey et al., “egg: Fast and Extensible Equality Saturation,” POPL 2021. doi:10.1145/3434304
[13] B. Moseley and P. Marks, “Out of the Tar Pit,” 2006.
[14] M. Fowler, “Event Sourcing,” 2005. https://martinfowler.com/eaaDev/EventSourcing.html
[15] P. Alvaro et al., “Dedalus: Datalog in Time and Space,” LNCS 2011. doi:10.1007/978-3-642-24206-9_16
[16] A. M. Turing, “On Computable Numbers,” Proceedings of the London Mathematical Society, 1937. doi:10.1112/plms/s2-42.1.230
[17] A. Church, “An Unsolvable Problem of Elementary Number Theory,” American Journal of Mathematics, 1936. doi:10.2307/2371045
[18] P. Wadler, “Propositions as Types,” Communications of the ACM, 2015. doi:10.1145/2699407
[19] J. M. Hellerstein and P. Alvaro, “Keeping CALM,” Communications of the ACM, 2020. doi:10.1145/3369736
[20] G. Kahn, “The Semantics of a Simple Language for Parallel Programming,” IFIP 1974, pp. 471 to 475.
[21] H. Husain et al., “CodeSearchNet Challenge,” 2019. arXiv:1909.09436
[22] D. Kim, J. Nam, J. Song and S. Kim, “Automatic Patch Generation Learned from Human-Written Patches” (PAR), ICSE 2013. doi:10.1109/ICSE.2013.6606626
[23] K. Liu et al., “TBar: Revisiting Template-based Automated Program Repair,” ISSTA 2019. arXiv:1903.08409
[24] K. Liu et al., “AVATAR: Fixing Semantic Bugs with Fix Patterns of Static Analysis Violations,” SANER 2019. arXiv:1812.07270
[25] A. Koyuncu et al., “FixMiner: Mining Relevant Fix Patterns for Automated Program Repair,” 2018. arXiv:1810.01791
[26] Y. Padioleau et al., “Documenting and Automating Collateral Evolutions in Linux Device Drivers” (Coccinelle), EuroSys 2008. doi:10.1145/1352592.1352618
[27] A. Solar-Lezama et al., “Combinatorial Sketching for Finite Programs,” ASPLOS 2006. doi:10.1145/1168857.1168907
[28] L. Chen, M. Zaharia and J. Zou, “FrugalGPT,” 2023. arXiv:2305.05176
[29] S. Haber and W. S. Stornetta, “How to Time-Stamp a Digital Document,” Journal of Cryptology, 1991. doi:10.1007/BF00196791
[30] S. A. Crosby and D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging,” USENIX Security 2009.
[31] L. de Moura and N. Bjørner, “Z3: An Efficient SMT Solver,” TACAS 2008. doi:10.1007/978-3-540-78800-3_24
[32] Kani Rust Verifier. https://github.com/model-checking/kani
[33] C. V. Lopes et al., “DéjàVu: A Map of Code Duplicates on GitHub,” OOPSLA 2017. doi:10.1145/3133908
[34] M. Gabel and Z. Su, “A Study of the Uniqueness of Source Code,” FSE 2010. doi:10.1145/1882291.1882315
[35] A. Hindle et al., “On the Naturalness of Software,” ICSE 2012. doi:10.1109/ICSE.2012.6227135
[36] D. Kocetkov et al., “The Stack: 3 TB of Permissively Licensed Source Code,” 2022. arXiv:2211.15533; The Stack v2 dataset card, https://huggingface.co/datasets/bigcode/the-stack-v2
[37] R. Just, D. Jalali and M. D. Ernst, “Defects4J: A Database of Existing Faults to Enable Controlled Testing Studies for Java Programs,” ISSTA 2014. doi:10.1145/2610384.2628055
[38] C. E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. arXiv:2310.06770
[39] R. Aleithan et al., “SWE-Bench+: Enhanced Coding Benchmark for LLMs,” 2024. arXiv:2410.06992
[40] C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal 27, 1948. doi:10.1002/j.1538-7305.1948.tb01338.x
[41] A. N. Kolmogorov, “Three approaches to the quantitative definition of information,” Problemy Peredachi Informatsii 1(1), 1965 (in Russian); English translation, International Journal of Computer Mathematics 2, 1968. doi:10.1080/00207166808803030
[42] R. J. Solomonoff, “A formal theory of inductive inference. Part I,” Information and Control 7(1), 1964. doi:10.1016/S0019-9958(64)90223-2
[43] G. J. Chaitin, “A Theory of Program Size Formally Identical to Information Theory,” Journal of the ACM 22(3), 1975. doi:10.1145/321892.321894
[44] J. Rissanen, “Modeling by shortest data description,” Automatica 14(5), 1978. doi:10.1016/0005-1098(78)90005-5
[45] B. Ray, V. Hellendoorn, S. Godhane, Z. Tu, A. Bacchelli and P. Devanbu, “On the ‘naturalness’ of buggy code,” ICSE 2016. doi:10.1145/2884781.2884848
[46] Z. Tu, Z. Su and P. Devanbu, “On the localness of software,” FSE 2014. doi:10.1145/2635868.2635875
[47] M. Allamanis, E. T. Barr, P. Devanbu and C. Sutton, “A Survey of Machine Learning for Big Code and Naturalness,” ACM Computing Surveys 51(4), 2018. doi:10.1145/3212695
[48] 陈浙哲, 刘忠鑫, 鄢萌, 徐洲, 夏鑫, 雷晏 (Z. Chen, Z. Liu, M. Yan, Z. Xu, X. Xia and Y. Lei), “代码自然性及其应用研究进展” (Research progress of code naturalness and its application), 软件学报 (Journal of Software) 33(8), 3015 to 3034, 2022. doi:10.13328/j.cnki.jos.006355
[49] G. Sridhara, V. S. Sinha and S. Mani, “Naturalness of Natural Language Artifacts in Software,” ISEC 2015 (India Software Engineering Conference). doi:10.1145/2723742.2723758
[50] P. Devanbu, “On the naturalness of software,” keynote, ISEC 2013 (India Software Engineering Conference). doi:10.1145/2442754.2442763
[51] A. Z. H. Yang, S. Kolak, V. J. Hellendoorn, R. Martins et al., “Revisiting Unnaturalness for Automated Program Repair in the Era of Large Language Models,” ICSE 2025. doi:10.1109/ICSE55347.2025.00089
[52] E. W. Dijkstra, “Guarded commands, nondeterminacy and formal derivation of programs,” Communications of the ACM 18(8), 1975. doi:10.1145/360933.360975
[53] N. Wirth, “Program development by stepwise refinement,” Communications of the ACM 14(4), 1971. doi:10.1145/362575.362577
[54] C. A. R. Hoare, “An axiomatic basis for computer programming,” Communications of the ACM 12(10), 1969. doi:10.1145/363235.363259
[55] J.-R. Abrial, The B-Book: Assigning Programs to Meanings, Cambridge University Press, 1996. doi:10.1017/CBO9780511624162
[56] J.-R. Abrial, Modeling in Event-B: System and Software Engineering, Cambridge University Press, 2010. doi:10.1017/CBO9781139195881
[57] R.-J. Back and J. von Wright, Refinement Calculus: A Systematic Introduction, Springer, 1998. doi:10.1007/978-1-4612-1674-2
[58] F. L. Bauer and H. Wössner, Algorithmic Language and Program Development, Springer, 1982. doi:10.1007/978-3-642-61807-9
[59] S. Gulwani, “Automating string processing in spreadsheets using input-output examples,” POPL 2011. doi:10.1145/1926385.1926423
[60] S. Gulwani, O. Polozov and R. Singh, “Program Synthesis,” Foundations and Trends in Programming Languages 4(1-2), 2017. doi:10.1561/2500000010
[61] F. P. Brooks, “No Silver Bullet: Essence and Accidents of Software Engineering,” Computer 20(4), 1987. doi:10.1109/MC.1987.1663532
[62] P. Naur, “Programming as theory building,” Microprocessing and Microprogramming 15(5), 1985. doi:10.1016/0165-6074(85)90032-8
[63] M. M. Lehman, “Programs, life cycles, and laws of software evolution,” Proceedings of the IEEE 68(9), 1980. doi:10.1109/PROC.1980.11805
[64] P. Zave and M. Jackson, “Four dark corners of requirements engineering,” ACM Transactions on Software Engineering and Methodology 6(1), 1997. doi:10.1145/237432.237434
[65] R. Landauer, “Irreversibility and Heat Generation in the Computing Process,” IBM Journal of Research and Development 5(3), 1961. doi:10.1147/rd.53.0183
[66] C. H. Bennett, “Logical Reversibility of Computation,” IBM Journal of Research and Development 17(6), 1973. doi:10.1147/rd.176.0525
[67] M. Franz and T. Kistler, “Slim binaries,” Communications of the ACM 40(12), 1997. doi:10.1145/265563.265576
[68] C. W. Fraser, “Automatic inference of models for statistical code compression,” PLDI 1999. doi:10.1145/301618.301672
[69] P. Cousot and R. Cousot, “Abstract interpretation: a unified lattice model for static analysis of programs by construction or approximation of fixpoints,” POPL 1977. doi:10.1145/512950.512973
[70] Y. Futamura, “Partial evaluation of computation process: an approach to a compiler-compiler,” Systems, Computers, Controls 2(5), 1971; reprinted in Higher-Order and Symbolic Computation 12(4), 1999. doi:10.1023/A:1010095604496
[71] A. P. Ershov, “Mixed computation: potential applications and problems for study,” Theoretical Computer Science 18(1), 1982. doi:10.1016/0304-3975(82)90111-6
[72] W. A. Howard, “The formulae-as-types notion of construction,” in J. P. Seldin and J. R. Hindley (eds.), To H. B. Curry: Essays on Combinatory Logic, Lambda Calculus and Formalism, Academic Press, 1980.
[73] 土居真之, 肥後芳樹, 有馬諒, 下仲健斗, 楠本真二 (M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto), “ソースコードの「自然さ」を利用した自動生成ファイルの特定” (Identifying auto-generated files using the naturalness of source code), 電子情報通信学会技術研究報告 (IEICE Technical Report) 117(380), 19 to 24, January 2018. https://sdl.ist.osaka-u.ac.jp/pman/pman3.cgi?D=517
[74] M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto, “On the naturalness of auto-generated code: can we identify auto-generated code automatically?” ICPC 2018. doi:10.1145/3196321.3196356
[75] F. V. Arrebola, “Modelo de sugestão de código-fonte baseado em modelos de linguagem organizados em um contexto hierárquico” (A source code suggestion model based on language models organized in a hierarchical context), doctoral thesis in electrical engineering, Fundação Educacional Inaciana Padre Sabóia de Medeiros (FEI), Brazil, 2018. Advisor R. A. C. Bianchi.
[76] G. Febres, K. Jaffé and C. Gershenson, “Complexity measurement of natural and artificial languages,” Complexity 20(6), 2015. doi:10.1002/cplx.21529
[77] M. Rahman, D. Palani and P. C. Rigby, “Natural Software Revisited,” ICSE 2019. doi:10.1109/ICSE.2019.00022
[78] A. Torres, S. Baltes, C. Treude and M. Wagner, “Applying Information Theory to Software Evolution,” NLBSE 2023. doi:10.1109/NLBSE59153.2023.00017
[79] A. Blass, N. Dershowitz and Y. Gurevich, “When are two algorithms the same?,” Bulletin of Symbolic Logic 15(2), 2009. arXiv:0811.0811. https://arxiv.org/abs/0811.0811
[80] Y. N. Moschovakis, “What is an algorithm?,” in Mathematics Unlimited: 2001 and Beyond, Springer, 2001. https://www.math.ucla.edu/~ynm/papers/eng.pdf
[81] M. Y. Vardi, “What is an algorithm?,” Communications of the ACM 55(3), 2012. doi:10.1145/2093548.2093549
[82] S. Laddad, A. Cheung, J. M. Hellerstein and M. Milano, “Flo: a Semantic Foundation for Progressive Stream Processing,” POPL 2025. arXiv:2411.08274. https://arxiv.org/abs/2411.08274
[83] The Elm Architecture, Elm guide. https://guide.elm-lang.org/architecture/
[84] Temporal, “Workflows” (event history), documentation. https://docs.temporal.io/workflows
[85] A. Pnueli, M. Siegel and E. Singerman, “Translation validation,” TACAS 1998. doi:10.1007/BFb0054170
[86] X. Yang, Y. Chen, E. Eide and J. Regehr, “Finding and understanding bugs in C compilers,” PLDI 2011. doi:10.1145/1993498.1993532
[87] C. Nandi, M. Willsey, A. Zhu et al., “Rewrite Rule Inference Using Equality Saturation,” OOPSLA 2021. arXiv:2108.10436. https://arxiv.org/abs/2108.10436
[88] C. Le Goues, T. Nguyen, S. Forrest and W. Weimer, “GenProg: A Generic Method for Automatic Software Repair,” IEEE TSE 38(1), 2012. doi:10.1109/TSE.2011.104
[89] F. Long and M. Rinard, “Automatic patch generation by learning correct code,” POPL 2016. doi:10.1145/2837614.2837617
[90] J. Bader, A. Scott, M. Pradel and S. Chandra, “Getafix: Learning to Fix Bugs Automatically,” OOPSLA 2019. arXiv:1902.06111. https://arxiv.org/abs/1902.06111
[91] K. Etemadi, N. Harrand, S. Larsen et al., “Sorald: Automatic Patch Suggestions for SonarQube Static Analysis Violations,” IEEE TDSC, 2022. arXiv:2103.12033. https://arxiv.org/abs/2103.12033
[92] Z. Qi, F. Long, S. Achour and M. Rinard, “An analysis of patch plausibility and correctness for generate-and-validate patch generation systems,” ISSTA 2015. doi:10.1145/2771783.2771791
[93] E. K. Smith, E. T. Barr, C. Le Goues and Y. Brun, “Is the cure worse than the disease? Overfitting in automated program repair,” ESEC/FSE 2015. doi:10.1145/2786805.2786825
[94] X.-B. D. Le, F. Thung, D. Lo and C. Le Goues, “Overfitting in semantics-based automated program repair,” Empirical Software Engineering 23, 2018. doi:10.1007/s10664-017-9577-2
[95] Y. Xiong, X. Liu, M. Zeng, L. Zhang and G. Huang, “Identifying patch correctness in test-based program repair,” ICSE 2018. doi:10.1145/3180155.3180182
[96] T. Durieux, F. Madeiral, M. Martinez and R. Abreu, “Empirical Review of Java Program Repair Tools: A Large-Scale Experiment on 2,141 Bugs and 23,551 Repair Attempts,” ESEC/FSE 2019. arXiv:1905.11973. https://arxiv.org/abs/1905.11973
[97] K. Liu, A. Koyuncu, T. F. Bissyandé et al., “You Cannot Fix What You Cannot Find! An Investigation of Fault Localization Bias in Benchmarking Automated Program Repair Systems,” ICST 2019. arXiv:1812.07283. https://arxiv.org/abs/1812.07283
[98] M. Monperrus, “Automatic Software Repair: A Bibliography,” ACM Computing Surveys 51(1), 2018. doi:10.1145/3105906
[99] C. S. Xia, Y. Deng, S. Dunn and L. Zhang, “Agentless: Demystifying LLM-based Software Engineering Agents,” 2024. arXiv:2407.01489. https://arxiv.org/abs/2407.01489
[100] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir and A. Narayanan, “AI Agents That Matter,” 2024. arXiv:2407.01502. https://arxiv.org/abs/2407.01502
[101] M. H. Erol, B. El, M. Suzgun, M. Yuksekgonul and J. Zou, “Cost-of-Pass: An Economic Framework for Evaluating Language Models,” 2025. arXiv:2504.13359. https://arxiv.org/abs/2504.13359
[102] D. Zan, Z. Huang, W. Liu et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving,” 2025. arXiv:2504.02605. https://arxiv.org/abs/2504.02605
[103] R. Widyasari, S. Q. Sim, C. Lok et al., “BugsInPy: a database of existing bugs in Python programs to enable controlled testing and debugging studies,” ESEC/FSE 2020. doi:10.1145/3368089.3417943
[104] M. Allamanis, “The Adverse Effects of Code Duplication in Machine Learning Models of Code,” Onward! 2019. arXiv:1812.06469. https://arxiv.org/abs/1812.06469
[105] K. N. Khan, M. Hirki, T. Niemi, J. K. Nurminen and Z. Ou, “RAPL in Action: Experiences in Using RAPL for Power Measurements,” ACM TOMPECS 3(2), 2018. doi:10.1145/3177754
[106] The Rust project, rustfix and cargo fix. https://github.com/rust-lang/rustfix
[107] R.-M. Karampatsis and C. Sutton, “How Often Do Single-Statement Bugs Occur? The ManySStuBs4J Dataset,” MSR 2020. doi:10.1145/3379597.3387491
[108] C. Richter and H. Wehrheim, “TSSB-3M: Mining single statement bugs at massive scale,” MSR 2022. doi:10.1145/3524842.3528505
[109] H. Coles, T. Laurent, C. Henard, M. Papadakis and A. Ventresque, “PIT: a practical mutation testing tool for Java,” ISSTA 2016. doi:10.1145/2931037.2948707
[110] R. Just, D. Jalali, L. Inozemtseva, M. D. Ernst, R. Holmes and G. Fraser, “Are mutants a valid substitute for real faults in software testing?” FSE 2014. doi:10.1145/2635868.2635929
[111] I. J. Good, “Speculations Concerning the First Ultraintelligent Machine,” Advances in Computers 6, 1965. doi:10.1016/S0065-2458(08)60418-0
[112] J. Schmidhuber, “Gödel Machines: Fully Self-referential Optimal Universal Self-improvers,” in Artificial General Intelligence, Springer, 2007. doi:10.1007/978-3-540-68677-4_7
[113] E. Yudkowsky, “Intelligence Explosion Microeconomics,” Technical report 2013-1, Machine Intelligence Research Institute, 2013. https://intelligence.org/files/IEM.pdf
[114] M. H. Löb, “Solution of a Problem of Leon Henkin,” Journal of Symbolic Logic 20(2), 1955. doi:10.2307/2266895
[115] E. Yudkowsky and M. Herreshoff, “Tiling Agents for Self-Modifying AI, and the Löbian Obstacle,” Machine Intelligence Research Institute, 2013. https://intelligence.org/files/TilingAgentsDraft.pdf
[116] E. Zelikman, E. Lorch, L. Mackey and A. T. Kalai, “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation,” 2023. doi:10.48550/arXiv.2310.02304
[117] J. Zhang, S. Hu, C. Lu, R. Lange and J. Clune, “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents,” 2025. doi:10.48550/arXiv.2505.22954
[118] A. Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery,” 2025. doi:10.48550/arXiv.2506.13131
[119] G. Wang, Y. Xie, Y. Jiang, A. Mandlekar, C. Xiao, Y. Zhu, L. Fan and A. Anandkumar, “Voyager: An Open-Ended Embodied Agent with Large Language Models,” 2023. doi:10.48550/arXiv.2305.16291
[120] Y. Futamura, “Partial Evaluation of Computation Process: An Approach to a Compiler-Compiler,” Higher-Order and Symbolic Computation 12(4), 1999 (first published 1971). doi:10.1023/A:1010095604496
[121] V. F. Turchin, “The Concept of a Supercompiler,” ACM Transactions on Programming Languages and Systems 8(3), 1986. doi:10.1145/5956.5957
[122] J. N. Foster, M. B. Greenwald, J. T. Moore, B. C. Pierce and A. Schmitt, “Combinators for Bidirectional Tree Transformations: A Linguistic Approach to the View-Update Problem,” ACM Transactions on Programming Languages and Systems 29(3), 2007. doi:10.1145/1232420.1232424
[123] M. Hofmann, B. Pierce and D. Wagner, “Symmetric Lenses,” POPL, 2011. doi:10.1145/1926385.1926428
[124] K. Czarnecki, J. N. Foster, Z. Hu, R. Lämmel, A. Schürr and J. F. Terwilliger, “Bidirectional Transformations: A Cross-Discipline Perspective,” ICMT, LNCS 5563, 2009. doi:10.1007/978-3-642-02408-5_19
[125] E. W. Dijkstra, “A Constructive Approach to the Problem of Program Correctness,” BIT 8(3), 1968. doi:10.1007/BF01933419
[126] A. Hall and R. Chapman, “Correctness by Construction: Developing a Commercial Secure System,” IEEE Software 19(1), 2002. doi:10.1109/52.976937
[127] Y. Minsky, “OCaml for the Masses,” Communications of the ACM 54(11), 2011. doi:10.1145/2018396.2018413
[128] D. A. Turner, “Total Functional Programming,” Journal of Universal Computer Science 10(7), 2004. doi:10.3217/jucs-010-07-0751
[129] R. Di Cosmo and S. Zacchiroli, “Software Heritage: Why and How to Preserve Software Source Code,” iPRES 2017, Kyoto. https://hal.science/hal-01590958
[130] Software Heritage, archive counters, read 13 October 2026: 30,253,266,524 file contents and 448,311,919 origins. https://archive.softwareheritage.org/api/1/stat/counters/
[131] Rosetta Code, main page, read 13 October 2026: 1,360 tasks, 421 draft tasks, 1,009 known languages. https://rosettacode.org/wiki/Rosetta_Code