Reality Code Engine: मूल, सत्यापित और कम ऊर्जा वाली प्रोग्रामिंग के लिए एक हानिरहित Form
एक प्रोग्रामिंग प्रणाली जिसमें प्रोग्राम एक बार state machine के रूप में लिखा जाता है और हर लक्ष्य भाषा उसी से बनाई जाती है, साथ में round trip, विकृत इनपुट की अस्वीकृति और lift किए गए कोड की मरम्मत के माप।
David Charlot, Open Interface Engineering
यह अंग्रेज़ी संस्करण का अनुवाद है। किसी भी अंतर की स्थिति में अंग्रेज़ी संस्करण मान्य होगा। मूल अंग्रेज़ी.
Research studies, not journal finals. Notation is defined in the paper. Analytical energy estimates are not board power. Interactive figures live under /living/. Shared terms: glossary.
Cite this
David Charlot, Open Interface Engineering. Reality Code Engine: मूल, सत्यापित और कम ऊर्जा वाली प्रोग्रामिंग के लिए एक हानिरहित Form. Open Interface Engineering. Web: https://research.openie.dev/papers/rce/. PDF: https://research.openie.dev/pdfs/rce.pdf.
संस्करण 1.4, 13 अक्टूबर 2026। विनिर्देश: वर्तमान मसौदा (मसौदा 0.7 दस्तावेज़, भाषा संस्करण 0.8), openIE-dev/rce 2a0ec68 से। 1.4 में परिवर्तन: इंजन परीक्षण गणना वे 589 विशिष्ट परीक्षण हैं जो cargo test --release चलाता है (1.3 ने 596 मुद्रित किया, make check का कुल योग, जिसमें 7 प्रमाणन परीक्षण दो बार गिने गए); खंड 3.7 बताता है कि विनिर्देश 2.7 अब C.15 की प्रति-कॉल साइट लागत नियम देता है; इंजन परीक्षण से सेक्शन 5.5 का नियतात्मक प्रस्तावक क्रमशः 87 प्रस्तावित, 9 स्वीकार और 78 अस्वीकृत के रूप में रिपोर्ट किया गया है; खंड 7 में Software Heritage और Rosetta Code [129] से [131] संदर्भ रखते हैं, जिसमें संग्रह काउंटर को फिर से पढ़ा जाता है; नौ आकृतियाँ जोड़ी जाती हैं (आकृति 5 से 10, 12, 13 और 15) और पहले की आकृति 5 और 6 अब आकृति 11 और 14 हैं। 1.3 में परिवर्तन: आकार-स्केल्ड विधि लागतों का श्रेय भाषा संस्करण 0.7 को दिया जाता है (इन्हें 1.2 में 0.6 के तहत वर्णित किया गया था), मिश्रित-संस्करण कार्यक्रमों के लिए प्रति-कॉल साइट नियम बताया गया है, और जांच इंजन कमिट 1eb5f02 पर फिर से चलाई जाती हैं। जर्मन अनुवाद अन्य अनुवादों की तरह संस्करण 1.1 पर रहता है। डेटा और कोड: research.openie.dev/data/। Playground (संदर्भ चेकर): openie-dev.github.io/rce। इंजन डेमो: /demos/rce-engine/। LaTeX PDF: /pdfs/latex/rce.pdf (स्रोत)।
सुधार और पुनरुत्पादन की स्थिति (17 अक्टूबर 2026)। यह टिप्पणी सार्वजनिक रिपॉजिटरी के सामने इस शोधपत्र को पढ़ने के बाद जोड़ी गई। जिन आँकड़ों पर इसका असर पड़ता है वे यहाँ सूचीबद्ध हैं, और इसके अलावा नीचे का पाठ अपरिवर्तित है। नीचे की हर गणना src/data/rce-facts.json से आती है, जिसे openIE-dev/rce में e416fd0 पर scripts/claim-counts.py ने बनाया है, सिवाय दो Lean गणनाओं के, जो 4304048 पर ली गईं।
- एक भाषा (18 अक्टूबर 2026)। सार्वजनिक
rcemain (4a3dc1f) में एक ही भाषा और एक ही पाठ है।# rce-version:पंक्ति एक सहन किया जाने वाला, अनदेखा किया जाने वाला रिलीज़ लेबल है जिसे हैश नहीं किया जाता, और एक रिलीज़ लेबल ठीक एक विनिर्देश कमिट का नाम लेता है (C.15)। जिस संरचना को चेकर लागू नहीं करता उसे संस्करण के आधार पर नहीं, बल्कि आरक्षित, लागू नहीं के रूप में अस्वीकार किया जाता है (W-RES-1, परिशिष्ट F.12); आरक्षित शब्दों की एक ही सूची है। इसलिए खंड 3.7 और आकृति 5, जो संस्करण द्वारों (संस्करण 0.5 से 0.9) का वर्णन करते हैं, पहले के मसौदों का वर्णन करते हैं और अब लागू नहीं होते। विफल कॉल अपने&mutतर्कों को पुनर्स्थापित करती है (F.4.4), जो प्रमेय T33 के राइट-बैक नियम की जगह लेता है। नीचे की गणनाएँ इस परिवर्तन से पहलेe416fd0पर ली गई थीं और दोबारा नहीं चलाई गईं। नियम के साथ T33 का प्रमाण भी बदला: हर परिणाम पर राइट-बैक वाले सेवानिवृत्त प्रमेय ऑडिट किए गए ट्री से हट गए (सार्वजनिकrcemain95ead2e), और T33 अब F.4.4 पुनर्स्थापन को सिद्ध करता है; ऑडिट केवल मानक अभिगृहीतों के साथ 4875 प्रमेय पढ़ता है। - लाइब्रेरी नाम (rce-stdlib, 18 अक्टूबर 2026)। क्योंकि आरक्षित सूची वैश्विक है, जिन लाइब्रेरी नामों को वह अब आरक्षित करती है उनके नाम बदले गए:
labelसेlbl,nodeसेnd,groupसेgrp,childसेchd,budgetसेbud,restartसेrst,replicatedसेrepl,ctसेctext,sessionसेsess,protocolसेproto,parसेparl,offerसेoffr,chooseसेchse। प्रकारJson(मॉड्यूलenc) औरUrl(मॉड्यूलnet.url) अबJsonDocऔरUrlPartsहैं, इसलिए जो प्रोग्रामenc.Jsonयाnet.url.Urlआयात करता है उसे नए नामों का उपयोग करना होगा। किसीtextमान की पाठ लंबाई.len()के बजाय.len_bytes()(बाइट) या.len_chars()है। e416fd0पर संस्करण और गणनाएँ। विनिर्देश दस्तावेज़ मसौदा 0.9 है (cdae5cfसे सार्वजनिक)। 18 अक्टूबर से पहले संदर्भ चेकर भाषा संस्करण 0.5 से 0.9 स्वीकार करता था और संस्करण 0.9 के जिन हिस्सों को वह लागू नहीं करता था उन्हें संस्करण के आधार पर अस्वीकार करता था (परिशिष्ट F.12)। प्रमेय T1 से T56 कथित हैं; T42 से T56 (परिशिष्ट F) कथित हैं और अप्रमाणित हैं। 58 Lean मॉड्यूल और 59 उदाहरण प्रोग्राम हैं (57 शीर्ष स्तर पर और 2 पैकेजों में)। इस शोधपत्र की जो आकृतियाँ और कैप्शन मसौदा 0.7, भाषा संस्करण 0.8, T1 से T34, 31 फ़ाइलें या 51 उदाहरण कहते हैं, वे रिपॉजिटरी का वर्णन उन पहले के कमिट पर करते हैं जिनका वे नाम लेते हैं, और यह शोधपत्र इस टिप्पणी से आगे मसौदा 0.9 का वर्णन नहीं करता।- Lean प्रमेय गणना। दो अलग गणनाएँ मौजूद हैं। स्रोत में
e416fd0पर 1,116theoremऔरlemmaघोषणाएँ हैं (4304048पर 885)। ऑडिट (scripts/lean-audit.sh) कर्नेल परिवेश में हर प्रमेय स्थिरांक गिनता है, जिसमें elaborator द्वारा उत्पन्न स्थिरांक भी शामिल हैं, औरe416fd0पर सार्वजनिक रिपॉजिटरी पर दोबारा चलाने पर उसने 4,877 दिया, जहाँlake buildspec/lean/RCE/की 58 फ़ाइलों पर बिना किसीsorryके और केवल मानक अभिगृहीतों के साथ पूरा होता है (4304048पर 46 फ़ाइलों पर 2,949)। नीचे उद्धृत 2,192 इंजन कमिट1eb5f02पर 31 मॉड्यूल पर ऑडिट गणना है। इनमें से कोई भी संख्या यह नहीं बताती कि Rust मूल्यांकक के बारे में कितने प्रमेय सिद्ध हैं। - आज सार्वजनिक रिपॉजिटरी से पुनरुत्पादनीय: Lean बिल्ड और अभिगृहीत ऑडिट, विनिर्देश जाँच (व्याकरण तालिकाएँ और उदाहरण कॉर्पोरा), संदर्भ चेकर और उसके परीक्षण, और मानक JSON वेक्टर।
- अभी सार्वजनिक रिपॉजिटरी से पुनरुत्पादनीय नहीं: 10,000 Forms वाला पारिस्थितिकी तंत्र रन (
bench/ecosystemसार्वजनिक रिपॉजिटरी में नहीं है), Kani परिणाम, 589 इंजन परीक्षण, खंड 6 की मरम्मत दरें और कोई भी Defects4J संख्या। इन्हें यहाँ लेखकों के अपने रन के रूप में रिपोर्ट किया गया है, और जब तक स्रोत और बीज प्रकाशित नहीं होते, इन्हें इसी रूप में पढ़ा जाना चाहिए। - खंडनकर्ता RCE-F0। नीचे खंड 2.3 की टिप्पणी देखें।
सार
यह शोधपत्र Reality Code Engine (RCE) का वर्णन करता है, एक ऐसी प्रणाली जिसमें किसी प्रोग्राम को स्टेट मशीन के रूप में लिखा जाता है, जिसे Form कहा जाता है, और इससे अन्य भाषाओं में कोड उत्पन्न किया जाता है। यह 10,000 Forms पर और सार्वजनिक बग डेटासेट पर क्या मापा गया इसका रिपोर्ट करता है, और बताता है कि दावों को झूठा कैसे दिखाया जा सकता है।
सरल शब्दों में
- एक प्रोग्राम को केवल एक सटीक रूप (form) में लिखा जाता है, और कंप्यूटर इससे कई भाषाओं में समान कार्यक्रम उत्पन्न करता है।
- क्योंकि Form केवल घोषित की गई चीज़ों की अनुमति देता है, इसलिए टूटे हुए इनपुट को बाद में ठीक करने के बजाय द्वार पर ही अस्वीकार कर दिया जाता है।
- जो सुधार जाँच पास करता है उसे सहेजा और पुन: उपयोग किया जाता है, ताकि एक ही समस्या का समय या ऊर्जा दो बार खर्च न हो।
1. प्रतिपाद्य
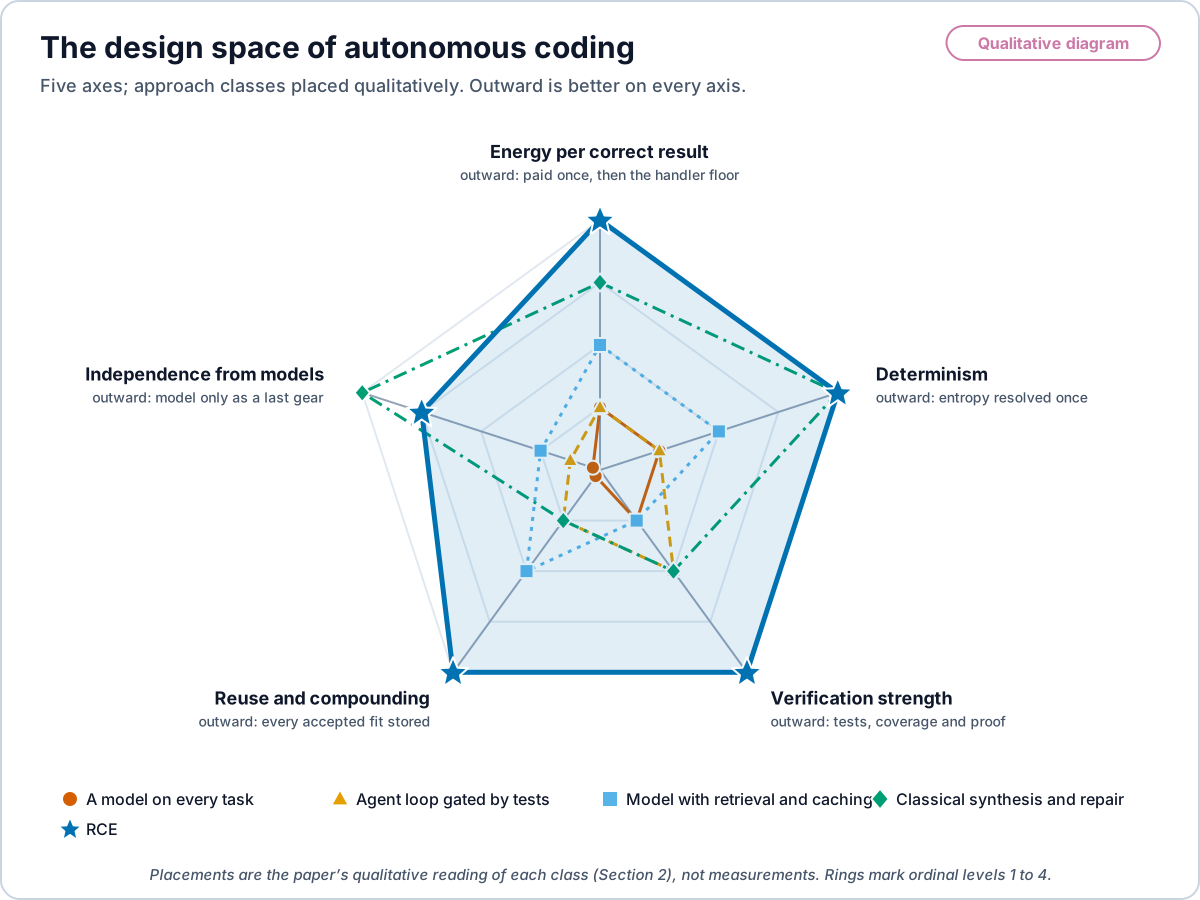
स्वायत्त कंप्यूटर स्वचालन एक डिज़ाइन स्थान है जिसमें कई बिंदु हैं। हर दृष्टिकोण पाँच सतत अक्षों पर कहीं न कहीं स्थित होता है: प्रत्येक सही परिणाम पर खर्च की गई ऊर्जा; वह एंट्रॉपी जिसे सिस्टम को रन टाइम पर सुलझाना पड़ता है, और उसके साथ यह कि उसका आउटपुट कितना नियतात्मक है; एक परिणाम को स्वीकार करने वाले सत्यापन की मज़बूती; हर स्वीकृत परिणाम कितना पुनः उपयोग किया जाता है और संचित होता है; और दृष्टिकोण किसी मॉडल पर कितना निर्भर करता है। प्रॉम्प्ट से प्रत्येक परिवर्तन लिखने वाला एक बड़ा भाषा मॉडल (LLM), यानी एक सांख्यिकीय पाठ मॉडल, उस स्थान के एक कोने के पास स्थित है: यह हर कार्य पर मॉडल पर निर्भर रहता है, हर बार उच्च एंट्रॉपी वितरण से नया नमूना लेता है, और हर कार्य पर उत्पादन की कीमत फिर से चुकाता है। पुनर्प्राप्ति, नियम, संश्लेषण, सत्यापन और कैशिंग कई अन्य बिंदुओं को घेरते हैं, और वास्तविक सिस्टम उन्हें मिलाते हैं।
Reality Code Engine (RCE) स्थान में एक बिंदु है, और यह शोधपत्र इसका वर्णन करता है तथा इसे मापता भी है। RCE किसी प्रोग्राम को डेटाबेस फंक्शनल स्टेट मशीन के रूप में मॉडल करता है। लोपेस और सहकर्मियों ने मापा कि GitHub पर लगभग 70% कोड पहले की फ़ाइलों [33] की क्लोन से बना होता है, इसलिए RCE सबसे पहले एक मौजूदा फ़िट प्राप्त करने का प्रयास करता है, उसे अनुकूलित (adapt) करके जाँचता है, और केवल तभी मॉडल को कॉल करता है जब कोई सस्ता विकल्प कार्य पूरा न करे।
मुख्य दावा। RCE एक संपूर्ण कोड पारिस्थितिकी तंत्र है जिसमें प्रोग्राम इरादे से मूल रूप से लिखे जाते हैं। इरादा, Form के रूप में लिखा जाता है: एक स्थिति (state), घटनाओं का एक सेट और एक शुद्ध, कुल संक्रमण (transition)। यह फॉर्म उस इरादे की हानि रहित एन्कोडिंग है। प्रत्येक लक्ष्य (स्टेटचार्ट, Rust, Python, XState, SCXML, WASM) फॉर्म का प्रक्षेपण (projection) होता है, और प्रत्येक प्रक्षेपण Form के ट्रेस को बाइट दर बाइट पुनः चलाता है। एक स्थिति जिसे Form घोषित नहीं करता उसे लिखा नहीं जा सकता, और इसके अनुबंध से बाहर कोई इनपुट प्रवेश पर अस्वीकार कर दिया जाता है। इसलिए पारिस्थितिकी तंत्र में प्रोग्राम अपने इरादे से भटक नहीं सकते जैसे कि किसी सामान्य भाषा का कार्यक्रम अपनी टिप्पणियों (comments), परीक्षणों या अन्य कार्यान्वयनों से भटकाव होता है, और इसे बाद के अंतरणन (diffing) या त्रुटि ट्रैकिंग की आवश्यकता नहीं होती है। प्रत्येक फ़िट जो द्वार पास करता है उसे संग्रहीत किया जाता है और पुन: उपयोग किया जाता है, इसलिए पारिस्थितिकी तंत्र बढ़ता जैसे-जैसे यह विकसित होता (§2.4)। अन्य भाषाओं में लिखा गया कोड एक दरवाज़ा मात्र है: यह लिफ़्ट द्वारा प्रवेश करता है (§6)।
स्थान में हर बिंदु एक ही द्वार का सामना करता है। यह द्वार शुद्धता (correctness) है: किसी कार्य की पूर्णता विधेय , यहाँ कार्य के परीक्षण, एक प्रमाण या सहमति ट्रेस । गेट पास करने वाले रनों में, प्रणालियों को समापन तक जूल से रैंक किया जाता है, । शुद्धता एक बाधा है, न कि स्कोर ।
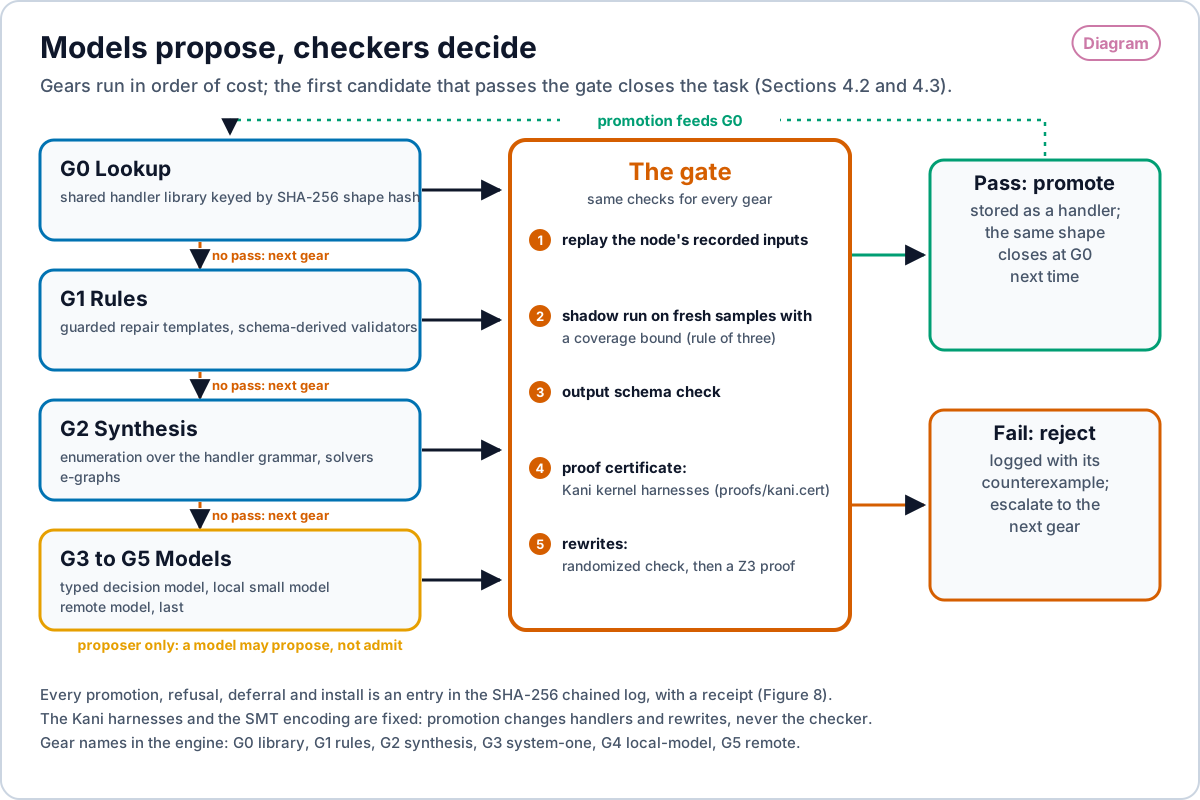
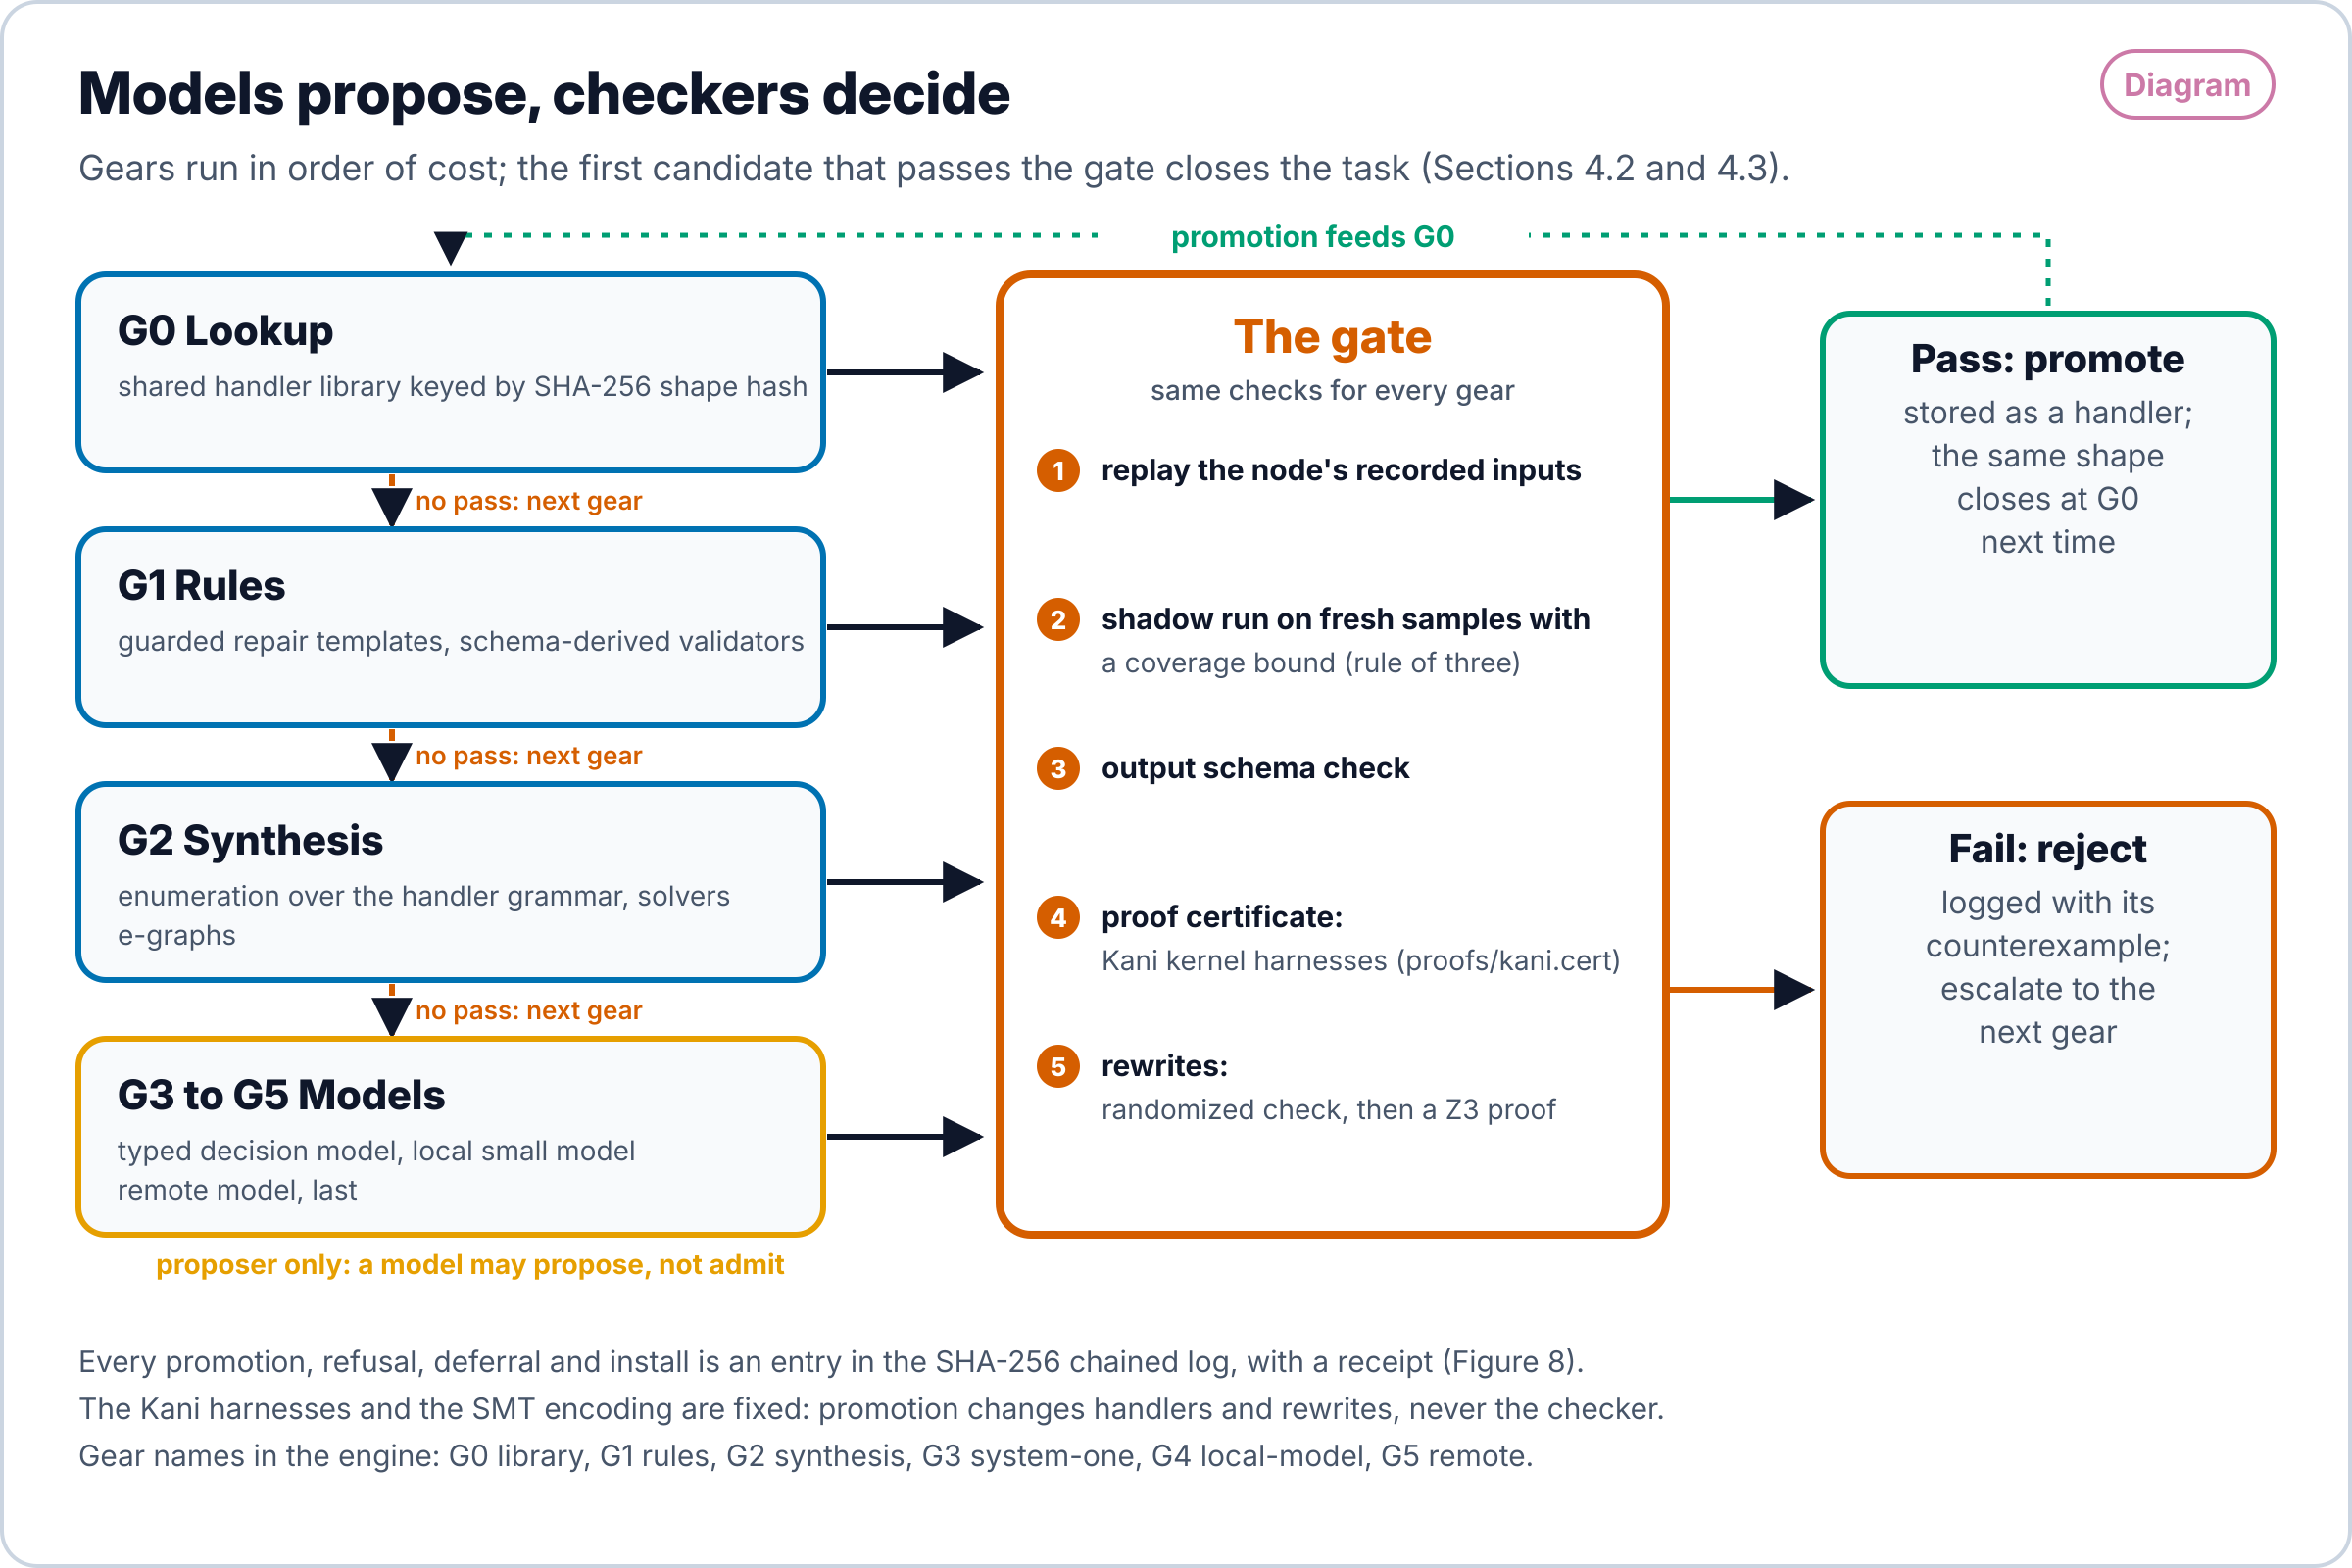
RCE के तंत्रों, जिन्हें गियर कहा जाता है, लागत के क्रम में चलते हैं, और पहला गियर जो द्वार पार करता है वह कार्य को बंद कर देता है ।
ऊर्जा आंकड़े स्रोत द्वारा लेबल किए जाते हैं। est_j एक विश्लेषणात्मक अनुमान है। reported_j एक ऑपरेटिंग-सिस्टम या ऑन-चिप काउंटर है। measured_j दीवार मीटर के लिए आरक्षित है और यहाँ हर परिणाम में खाली है ।
2. स्वायत्त कोडिंग का डिज़ाइन क्षेत्र
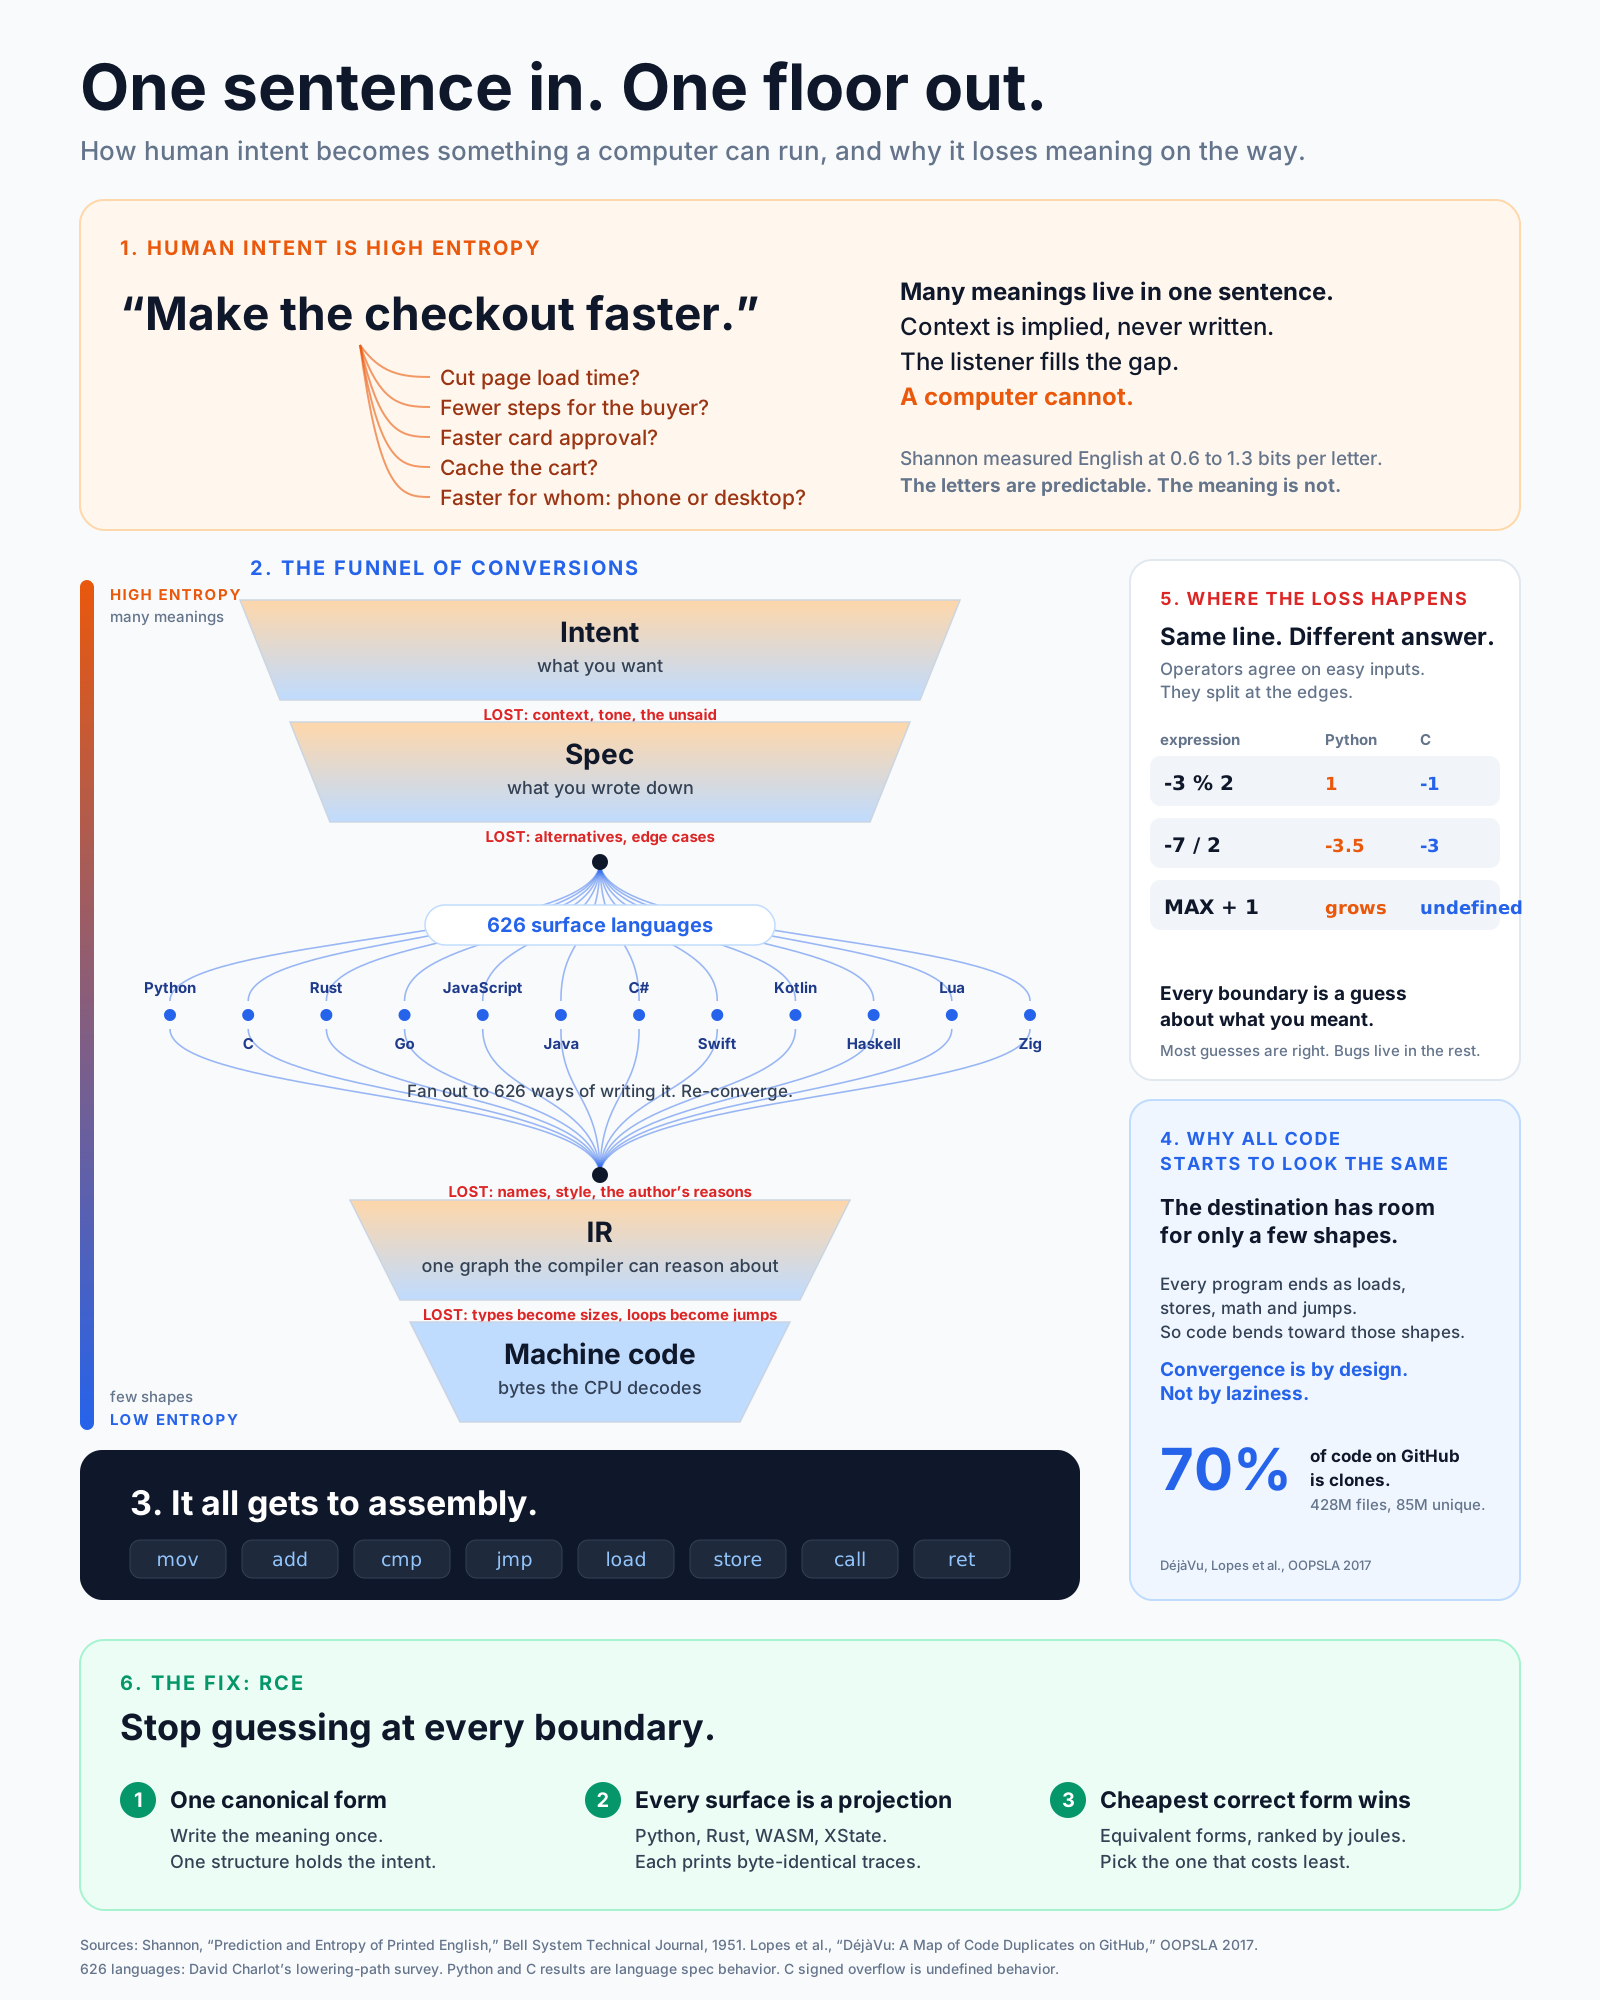
मंशा उच्च एंट्रॉपी है। “चेकआउट तेज़ करो” के कई अर्थ हो सकते हैं: पेज जल्दी लोड होना, कम चरण हों, कार्ड शीघ्र स्वीकृत हो, कार्ट कैश हो, या किसी एक प्रकार के उपकरण पर तेज़ी से काम करना। संदर्भ निहित रहता है और कभी लिखा नहीं जाता। Shannon ने मुद्रित अंग्रेजी को प्रति अक्षर लगभग 0.6 से 1.3 बिट मापा [1]। वर्ण पूर्वानुमेय हैं। अर्थ नहीं।
हर रूपांतरण सूचना खोता है। मंशा विनिर्देश बनती है, और संदर्भ खो जाता है। विनिर्देश सैकड़ों सतही भाषाओं में से एक बनता है, और विकल्प तथा किनारे के मामले खो जाते हैं। स्रोत मध्यवर्ती निरूपण (IR) बनता है, और नाम, शैली और लेखक के कारण खो जाते हैं। IR मशीन कोड बनता है, प्रकार आकार बन जाते हैं और लूप जंप बन जाते हैं।
तल निम्न एंट्रॉपी है। हर प्रोग्राम अंततः लोड, स्टोर, अंकगणित और कूद बनाता है। गंतव्य में केवल कुछ आकृतियों की जगह होती है, इसलिए कोड उनकी ओर झुकता है। अभिसरण संरचना से ही होता है।
अर्थ सीमाओं पर अलग हो जाता है। एक ही पंक्ति किनारों पर अलग उत्तर देती है। Python में -3 % 2 का मान 1 और -7 / 2 का मान -3.5 है। C में -3 % 2 का मान -1, -7 / 2 का मान -3 है, और हस्ताक्षरित ओवरफ़्लो अपरिभाषित है। जो सिस्टम हर सीमा पर कोड फिर से उत्पन्न
अक्ष, मात्राओं के रूप में बताए गए हैं।
| अक्ष | एक सिरा | दूसरा सिरा | RCE कहाँ बैठता है |
|---|---|---|---|
| सही परिणाम के लिए ऊर्जा | प्रत्येक कार्य पर पूरी तरह से भुगतान किया जाता है | प्रति नए मामले में एक बार, फिर हैंडलर फ़र्श तक का भुगतान | कवर किए गए कार्यों पर फर्श पर |
| रन समय पर हल की गई एंट्रॉपी और नियतत्ववाद | प्रॉम्प्ट का पूरा वितरण, हर बार एक ताज़ा नमूना | केवल अवशिष्ट कोई संग्रहीत फिट नहीं जो कवर करता है, एक नियतात्मक आउटपुट | केवल अवशेष; प्रत्येक प्रक्षेपण नियतात्मक होता है |
| सत्यापन शक्ति | निरीक्षण पर स्वीकार किया गया आउटपुट | परीक्षण, कवरेज और प्रमाण पत्र के साथ एक प्रमाणपत्र | हर परिणाम पर पूरा द्वार |
| पुन: उपयोग और संचयन करना | प्रत्येक परिणाम का प्रयोग एक बार | प्रत्येक स्वीकृत फिट संग्रहीत और पुनः उपयोग किया जाता है | जो भी फ़िट गेट पास करता है उसे संग्रहीत किया जाता है |
| मॉडल निर्भरता | प्रत्येक कार्य पर एक मॉडल | कोई मॉडल नहीं | केवल अंतिम गियर के रूप में एक मॉडल |
दृष्टिकोण प्रत्येक अक्ष पर डिग्री के अनुसार भिन्न होते हैं और ये अक्ष परस्पर क्रिया करते हैं: पुन: उपयोग ऊर्जा और हल करने हेतु शेष एंट्रॉपी को कम करता है, और मजबूत सत्यापन वह चीज़ है जो पुन: उपयोग को सुरक्षित बनाता है। RCE अर्थ एक बार में, एक कैनोनिकल Form में लिखता है। प्रत्येक सतह भाषा उस Form का प्रक्षेपण होती है, जिसे इससे मेल खाने के लिए जाँचा जाता है। समतुल्य Forms के बीच, सबसे सस्ता सही वाला चलता है।
आकृति 2 पाँच अक्षों को खींचती है और उन पर दृष्टिकोण की मुख्य कक्षाओं को रखती है।
2.1 प्रोग्रामिंग कोडिंग सिद्धांत है
इस खंड का शोध प्रबंध यह है कि प्रोग्रामिंग को कोडिंग सिद्धांत के रूप में पढ़ा जा सकता है। एक प्रोग्रामर दो एंट्रॉपी शासनों के बीच एक ग्रेडिएंट पर मंशा (intent) परिवर्तित करता है। इरादा उच्च एन्ट्रॉपी, अर्थों पर एक वितरण होता है। कोड निम्न एन्ट्रॉपी, प्रति अवस्था एक नियतात्मक संक्रमण होता है। सॉफ्टवेयर कार्य का हर कदम, आवश्यकता से लेकर रजिस्टर तक, उस रूपांतरण का एक चरण है। साहित्य ने सत्तर वर्षों में कई भाषाओं में टुकड़ों के रूप में ऐसा कहा है। यह खंड उन टुकड़ों को एक तर्क में इकट्ठा करता है और प्रत्येक RCE गियर पर इसे रखता है।
माप। शैनन ने एक स्रोत की एंट्रॉपी और एक चैनल की क्षमता को परिभाषित किया [40], और मुद्रित अंग्रेजी का माप प्रति अक्षर लगभग 0.6 से 1.3 बिट्स दिया [1]। कोलोमोगोरोव, जिन्होंने 1965 में Problemy Peredachi Informatsii में रूसी भाषा में लिखा था, ने सूचना की मात्रा के लिए तीन दृष्टिकोण दिए और एल्गोरिथम वाले को प्राथमिक बनाया: किसी वस्तु में जानकारी वह सबसे छोटे प्रोग्राम की लंबाई है जो उसे उत्पन्न करता है [41]। सोलोमनोफ एक अनुमानात्मक अनुमान सिद्धांत के रूप में उसी वस्तु पर पहुँचे थे [42], और चैटीन ने दिखाया कि कार्यक्रम का आकार शैनन के समान औपचारिक पहचानों का पालन करता है [43]। रिसानेन ने इस विचार को मॉडल चुनने के लिए एक नियम, न्यूनतम विवरण लंबाई बनाया [44]। वे मिलकर कहते हैं कि कोई प्रोग्राम कोड शब्द होता है: व्यवहार का वर्णन, और सबसे छोटा सही वह आधार (floor) है। RCE का निष्कर्षण नियम, समतुल्य फ़िट में से कम-जूल़ वाला फ़िट रखना (प्रस्तावना 3), बिट्स के स्थान पर जूल़ के साथ वही नियम है।
कोड कम एंट्रॉपी क्षेत्र में रहता है, और लोगों ने इसे मापा। हिंडेल, बैर, सु, गैबेल और देवानबू को पता चला कि कोड “बहुत दोहराव वाला है, और वास्तव में प्राकृतिक भाषाओं से भी अधिक,” समान n-ग्राम मॉडल पर कम क्रॉस-एंट्रॉपी के साथ [35]। गैबेल और सु ने पाया कि किसी परियोजना की अधिकांश पंक्तियाँ पहले से कहीं और मौजूद हैं [34], और लोपेस एट अल. को पता चला कि GitHub पर अधिकांश फ़ाइलें क्लोन हैं [33]। तू, सु और देवानबू ने यह भी पाया कि कोड स्थानीय होता है: पास में जो लिखा गया था वह भविष्यवाणी करता है कि आगे क्या आएगा [46]। रे और सहयोगियों ने पाया कि त्रुटिपूर्ण पंक्तियाँ कम प्राकृतिक होती हैं, जिनमें उच्च एंट्रॉपी होती है, और जब बग ठीक किया जाता है तो एंट्रॉपी गिर जाती है [45]। 2025 में यांग, कोलाक, हेलेनडोरन और मार्टिन्स ने मरम्मत उम्मीदवारों की रैंकिंग करने और सही पैच को ओवरफिटिंग वाले से अलग करने के लिए एक पैच द्वारा प्रेरित एंट्रॉपी परिवर्तन का उपयोग किया [51]। अलमानिस, बैर, देवानबू और सटन ने प्राकृतिकता नाम के तहत क्षेत्र का सर्वेक्षण किया [47]। परिणाम केवल अंग्रेजी भाषा तक सीमित नहीं है। प्रेम देवानबू ने इसे 2013 में इंडिया सॉफ्टवेयर इंजीनियरिंग कॉन्फ्रेंस में मुख्य भाषण के रूप में बताया था [50]। आईबीएम रिसर्च इंडिया में श्रीधरा, सिन्हा और मणि ने उसी स्थान पर कोड के आसपास प्राकृतिक-भाषा कलाकृतियों को मापा और पाया कि कमिट संदेश सबसे नियमित हैं और स्टैक ओवरफ़्लो गद्य सामान्य अंग्रेजी की तरह व्यवहार करता है [49]। चीन में, जर्नल ऑफ सॉफ्टवेयर (软件学报) ने 2022 में कोड प्राकृतिकता अनुसंधान की समीक्षा प्रकाशित की, जिसमें क्रॉस-एंट्रॉपी माप का उल्लेख किया गया है और यह निष्कर्ष निकाला गया है कि दोषपूर्ण कोड में उच्च एंट्रॉपी होती है [48]। जापान में, ओसाका विश्वविद्यालय के दोई, हिगो, अरिमा, शिमोनाका और कुसुमोटो ने मशीन द्वारा उत्पन्न स्रोत फ़ाइलों को मानव-लिखित फ़ाइलों से बताने के लिए n-ग्राम प्राकृतिकता का उपयोग किया, पहले एक जापानी भाषा IEICE तकनीकी रिपोर्ट में और फिर ICPC 2018 पर [73, 74]। जनरेटेड कोड एंट्रॉपी पैमाने पर मानवीय कोड की तुलना में भी कम होता है, क्योंकि जेनरेटर एक स्थिर रूपांतरण होता है। ब्राजील में, अरेबोला के डॉक्टरेट थीसिस ने परियोजना और रखरखावकर्ता द्वारा खंडित n-ग्राम और विषय मॉडल पर कोड सुझाव बनाया, और इसे क्रॉस-एंट्रॉपी से मूल्यांकन किया, अगले टोकन को एन्कोड करने के लिए आवश्यक बिट्स [75]। दोनों क्षेत्र एक रिपॉजिटरी में दिखाई देते हैं: कोड के आसपास का गद्य उच्च एंट्रॉपी वाला है, और कोड कम।
माप मायने रखता है। फरवरीस, जाफ़े और गर्शेंसन ने वेनेज़ुएला और मेक्सिको से काम करते हुए अंग्रेजी, स्पेनिश और संदेश लंबाई के अनुसार शब्दावली विविधता द्वारा प्रोग्राम पाठ की तुलना की और पाया कि कार्यक्रम का पाठ अधिक विविध था [76]। रहमान, पालानी और रिगबी को पता चला कि कोड की n-ग्राम पूर्वानुमेयता का अधिकांश भाग सिंटैक्स टोकन से आता है, और यह अभी भी दोहराव वाला है, पहले रिपोर्ट किए गए से कम, एक बार जब उन्हें हटा दिया जाता है, एपीआई उपयोग के साथ सबसे अधिक दोहराया जाने वाला हिस्सा [77]। दोनों परिणाम दावे को उलट करने के बजाय उसे तेज करते हैं। प्रतीकों की विविधता पूर्वानुमेयता नहीं है, और निम्न-एंट्रॉपी शासन अगले चरण के सशर्त वितरण का गुण है, जिसे एक नियतात्मक संक्रमण ठीक करता है। इसी कारण से RCE आकृतियों पर केंद्रित G0 कुंजी सतह टोकन पर नहीं करती है।
मंशा उच्च-एंट्रॉपी क्षेत्र में बैठती है। ज़ावे और जैक्सन ने दिखाया कि एक आवश्यकता पर्यावरण के बारे में कथन है, एक विनिर्देश इंटरफ़ेस पर एक बयान है, और उनके बीच का अंतर केवल डोमेन ज्ञान से भरा जाता है जो अक्सर लिखित नहीं होता [64]। ब्रूक्स ने सॉफ्टवेयर की कठिनाई को सार (essence) और दुर्घटना (accident) में विभाजित किया: सार वैचारिक संरचना है, और इसका अधिकांश भाग प्रतिनिधित्व नहीं बल्कि विनिर्देश और डिज़ाइन है [61]। नौर ने तर्क दिया कि एक प्रोग्राम अपने प्रोग्रामर द्वारा रखी गई सिद्धांत का दृश्य हिस्सा होता है, और वह सिद्धांत पाठ से पूरी तरह पुनर्प्राप्त नहीं हो पाता [62]। शैनन के माध्यम से पढ़ें, तीनों एक ही बात कहते हैं। मंशा किसी भी एकल कार्यक्रम की तुलना में अधिक अनिश्चितता ले जाती है, और कार्यक्रम लिखना वह कार्य है जो इसे हटा देता है। कोड लिखे जाने के बाद प्रोग्रामर के दिमाग में क्या रहता है वह इरादे का हिस्सा होता है जिसे कोड ने एन्कोड नहीं किया था।
रूपांतरण एक शोधन है, और शोधन एक संकीर्ण होना है। होयर ने कार्यक्रमों को एक तर्क दिया जिसमें कोई कार्यक्रम पूर्व-और पश्चात की शर्त के सापेक्ष सही होता है [54]। विर्थ ने चरणबद्ध शोधन सिखाया: किसी कार्य का क्रमिक निर्णयों द्वारा निर्देशों में विघटन करना, जिनमें से प्रत्येक निर्दिष्टता द्वारा खुली छोड़ी गई पसंद को निश्चित करता है [53]। डाइक्ग्रा के गार्डेड कमांड्स ने खुले विकल्पों को गैर-नियतिवाद (nondeterminacy) के रूप में स्पष्ट किया, और इसे हटाकर विनिर्देशों से कार्यक्रम प्राप्त किए गए [52]। म्यूनिख में, बाउर और वॉस्नर की CIP परियोजना ने निर्दिष्टता से प्रोग्राम तक शुद्धता बनाए रखने वाले परिवर्तनों का एक क्रम बनाया [58]। फ्रांस में, अब्रियल के B विधि और फिर इवेंट-B ने प्रत्येक चरण पर प्रमाण दायित्वों (proof obligations) के साथ शोधन को औद्योगिक पैमाने तक पहुँचाया [55, 56]। फ़िनलैंड में, बैक और वॉन राइट ने शोधन को इसका जाली सिद्धांत कैलकुलस दिया [57]। इनमें से प्रत्येक में, एक विनिर्देश स्वीकार्य व्यवहार का एक सेट दर्शाता है और प्रत्येक शोधन चरण उस सेट को सिकोड़ता जाता है, जब तक कि एक नियत व्यवहार नहीं रह जाता। अर्थात् हर कदम पर प्रमाण के साथ एंट्रॉपी न्यूनीकरण (entropy reduction)। RCE का Form श्रृंखला का अंतिम तत्व है: डेटाबेस अवस्थाओं पर कुल, नियत संक्रमण , जिसमें प्रत्येक विकल्प हल किया गया हो (§3.2)।
संश्लेषण वह खोज है जो एक परिकल्पना स्थान को संकीर्ण करती है। गुलवानी का FlashFill सभी सुसंगत कार्यक्रमों के सेट का प्रतिनिधित्व करके और इसे प्रत्येक नए उदाहरण [59] से प्रतिच्छेदित करके, कुछ इनपुट-आउटपुट उदाहरणों से एक स्ट्रिंग प्रोग्राम सीखता है। गुलवानी, पोलोज़ोव और सिंह सामान्य रूप से इरादे द्वारा बाधित कार्यक्रमों के स्थान में खोज के रूप में कार्यक्रम संश्लेषण को फ्रेम करते हैं [60], और सोलर-लेज़मा का स्केचिंग सॉल्वर के साथ आंशिक कार्यक्रम में छेद भरती है [27]। प्रत्येक उदाहरण या बाधा एक माप है जो परिकल्पनाओं को हटाता है। शैनन का मापक गणना करता है कि कितने ऐसे मापों की आवश्यकता होती है। RCE का G2 वह गियर है।
रूपांतरण जो उत्पन्न करता है उसका एक आकार होता है। गुरेविच ने सिद्ध किया कि प्रत्येक अनुक्रमिक एल्गोरिथम अपने स्वयं के अमूर्तता स्तर पर एक एब्स्ट्रैक्ट स्टेट मशीन द्वारा पकड़ा जाता है [2]। कॉड ने राज्य को एक संबंध बनाया [5], और इवेंट सोर्सिंग से राज्य का निर्माण अपेंड-ओनली लॉग का फोल्ड होता है [14]। करी और हॉवर्ड के तहत, एक प्रमाण कार्यक्रम है और एक प्रस्ताव प्रकार है [18, 72], इसलिए सत्यापित फ़िट अपने विनिर्देश का प्रमाण है। ये वे कारण हैं कि कम एंट्रॉपी शासन में कुछ ही आकार होते हैं: गंतव्य किसी डेटाबेस पर स्टेट मशीन होता है, चाहे सतह भाषा कोई भी हो।
कम एंट्रॉपी बिना एक द्वार के क्षय होती है। लीमैन ने बड़े सिस्टमों के दशकों तक अवलोकन किया कि उपयोग में आने वाला प्रोग्राम लगातार बदलना चाहिए, और इसकी जटिलता बढ़ती जाती है जब तक इसे कम करने का काम नहीं किया जाता [63]। टोरेस, बाल्टेस, ट्रूडे और वैगनर ने 25 परियोजनाओं की प्रतिबद्ध इतिहास पर संरचनात्मक और पाठ्य एंट्रॉपी को मापा और पाया कि दोनों एक साथ बढ़ते हैं [78]। वातावरण से कोड में एंट्रॉपी प्रवाहित होती है। जो सिस्टम कोड को कम-एंट्रॉपी शासन में रखता है उसे हर बदलाव पर एक द्वार चाहिए, और RCE का द्वार शुद्धता (§4.3) है।
कंपाइलर पहले से ही स्रोत कोडिंग करते हैं। फ्रांज़ और किस्लर ने प्रोग्रामों को संपीड़ित एब्स्ट्रैक्ट सिंटैक्स ट्री के रूप में भेजा और लोड पर नेटिव कोड उत्पन्न किया, जो एक कार्यक्रम का उसके अपने व्याकरण पर स्रोत कोडिंग है [67]। फ्रेज़र ने इसे संपीडित करने के लिए कॉर्पस से कोड के सांख्यिकीय मॉडल अनुमान लगाए [68]। फुटामुरा ने 1971 में जापानी पत्रिका सिस्टम्स, कंप्यूटर्स, कंट्रोल्स में दिखाया कि एक इंटरप्रेटर को किसी प्रोग्राम पर विशेषीकृत करना एक संकलित कार्यक्रम देता है, और विशेषज्ञकर्ता (specializer) के विशेषीकरण से कंपाइलर मिलता है [70]। एर्शोव ने नोवोसिबिर्स्क में मिश्रित संगणना की तरह ही विचार विकसित किया [71]। कौसोट्स का अमूर्त व्याख्या हर प्रोग्राम व्यवहार का एक ध्वनि, निम्न-सूचना विवरण कंप्यूट करती है [69]। चैनल कोडिंग के साथ सादृश्य इस शोधपत्र की समझ है, न कि उद्धृत प्रमेय: प्रकार (types), परीक्षण और प्रमाण जाँचित अतिरेक जोड़ते हैं ताकि गलत कार्यक्रम चलने से पहले पता चल जाए, जैसा कि समता जांच दूषित शब्द का पता लगाती है।
मिटाना वह जगह है जहाँ जूल जाते हैं। लैंडौअर ने दिखाया कि एक तार्किक रूप से अपरिवर्तनीय कदम, एक बिट का मिटना, कम से कम [65] ऊर्जा नष्ट करता है। बेनेट ने दिखाया कि गणना सिद्धांत में तर्कसंगत रूप से प्रतिवर्ती बनाई जा सकती है, इसलिए सीमा कंप्यूटेशन नहीं बल्कि विलोपन वहन करता है [66]। उच्च-एंट्रॉपी मंशा को एक निम्न-एंट्रॉपी प्रोग्राम में परिवर्तित करना उस हर विकल्प को त्याग देता है जो इरादे ने अनुमति दी थी। यह त्याग विकल्पों के बारे में जानकारी का मिटाना है, और इसका ऊष्मागतिक तल है। RCE प्रत्येक नए मामले पर विलोपन भुगतान करता है और परिणाम संग्रहीत करता है, इसलिए एक दोहराया गया मामला कुछ नया नहीं मिटाता है।
2.2 RCE कैसे रूपांतरित करता है, और हर गियर कहाँ बैठता है
कोडिंग सिद्धांत के रूप में पढ़ें, एक कार्य ऐसे संदेश के रूप में आता है जिसका शेष अनिश्चितता वह है जिसे कोई संग्रहीत फ़िट पहले से हल नहीं करता। प्रत्येक गियर अलग कीमत पर अनिश्चितता को हटाता है, और गियर्स उस कीमत द्वारा क्रमबद्ध हैं (§4.2)।
| गियर | अनिश्चितता पर क्या करता है | ऊपर के तर्क में वंशज |
|---|---|---|
| G0 लुकअप | पहचानता है कि मंशा पहले से एन्कोड की गई थी; हैंडलर फ़र्श पर पुनर्प्राप्ति द्वारा इसे हल करता है | पुनरावृत्ति और क्लोन [33, 34, 35]; स्थानीयता [46] |
| G1 नियम | एक ज्ञात संरक्षित रीराइट लागू करता है; बिना खोज के एक आवर्ती अवशेष को हल करता है | शुद्धता-संरक्षण परिवर्तन [52, 58]; प्रमाण दायित्वों के साथ शोधन [55, 56] |
| G2 संश्लेषण | परिकल्पना स्थान में खोज करता है और उदाहरणों, बाधाओं और एक सॉल्वर द्वारा इसे संकीर्ण करता है | खोज के रूप में प्रोग्राम संश्लेषण [27, 59, 60] |
| G3 से G5 मॉडल | जब कोई निचला गियर अंतर को नहीं भरता तो कोड पर सीखे गए वितरण से नमूना लेता है; केवल एक प्रस्तावक ही | कोड का क्रॉस-एंट्रॉपी मॉडल [35, 47] |
| द्वार (Gate) | केवल परीक्षणों, कवरेज और प्रमाण पत्र के साथ उम्मीदवार स्वीकार करता है | होयर तर्क [54]; करी-हावर्ड [18, 72] |
| पदोन्नति (Promotion) | स्वीकृत फ़िट को संग्रहीत करता है, ताकि वही अवशेष अगली बार G0 लागत दे सके | न्यूनतम विवरण लंबाई [44]; लैंडौअर मिटाना एक बार भुगतान किया गया [65] |
खंड 2 के अक्षों पर स्थितियाँ इस बात में भिन्न हैं कि रूपांतरण कहाँ का भुगतान किया जाता है। एक दृष्टिकोण जो प्रत्येक कार्य पर प्रॉम्प्ट के पूरे वितरण को नमूना करता है वह हर बार उच्च-एंट्रॉपी पक्ष का फिर से भुगतान करता है। एक दृष्टिकोण जो स्वीकृत फ़िट्स संग्रहीत और पुन: उपयोग करता है, केवल अवशेष (residual) के लिए, और केवल एक बार भुगतान करता है। अधिकांश सिस्टम उन दोनों सिरों के बीच में बैठते हैं, और RCE पुनः उपयोग करने वाले सिरे पर स्थित है।
2.3 बड़े N पर पारिस्थितिकी तंत्र
§1 का दावा सीधे मापा जाता है। बेंचमार्क रन से पहले पंजीकृत किया गया था (bench/ecosystem/PREREG.json)। एक बीजयुक्त जनरेटर 10,000 Forms लिखता है, प्रत्येक एक स्रोत (source), नियम जिसके निकाय में आठ ऑपरेटरों पर 3 तक की गहराई का यादृच्छिक अंकगणितीय पद होता है और सिंक (sink)। इंजन कमिट a079967 पर स्थिर किया गया है, और कोई मॉडल कॉल नहीं की जाती।
| गुणधर्म | Form प्रति क्या जाँचा जाता है | N | धारण करता है | मॉडल कॉल |
|---|---|---|---|---|
| हानिरहित एन्कोडिंग | Form IR से कैनोनिकल JSON तक और वापस Form IR से कैनोनिकल JSON पहचान है | 10,000 | 10,000 | 0 |
| नियतात्मक प्रक्षेपण | दो संकलनों से समान बाइट प्राप्त होते हैं; मूल के XState और SCXML का तथा राउंड ट्रिप किए गए Form का प्रक्षेपण बाइट समतुल्य है | 10,000 | 10,000 | 0 |
| वफादार प्रक्षेपण, Python | उत्सर्जित Python मॉड्यूल द्वारा 40 बीजकोष घटनाओं पर संदर्भ ट्रेस को बाइट दर बाइट प्रिंट किया जाता है | 10,000 | 9,999 | 0 |
| प्रवेश द्वार पर गेट, इनपुट | पाँच खराब पेलोड प्रकार (गलत प्रकार, नल, गुम फ़ील्ड, खाली, नेस्टेड) सभी अस्वीकार किए जाते हैं, कोई स्वीकृत परिणाम नहीं होता है | 10,000 | 10,000 | 0 |
| प्रवेश द्वार पर गेट, विनिर्देश | एक ऐसा विनिर्देश जिसमें अनिर्दिष्ट नोड तक प्रवाह हो तो संकलन से पहले ही अस्वीकृत कर दिया जाता है | 10,000 | 10,000 | 0 |
आकृति 3 समान गणनाएँ दर्शाती है।
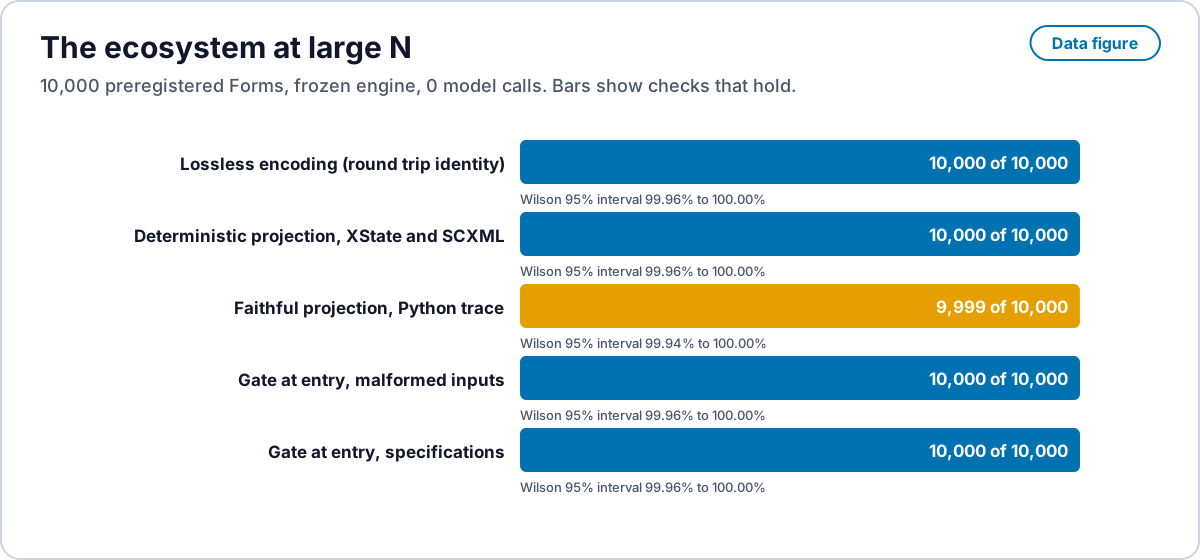
a079967 पर स्थिर इंजन के साथ ऊपर की तालिका में पाँच जाँचें, 10,000 पूर्व-पंजीकृत Forms पर, 0 मॉडल कॉल, और गणनाओं से संगणित विल्सन 95% अंतराल। स्रोत: bench/ecosystem। एक PNG प्रतिलिपि प्रदान की गई है। Open full size · PNG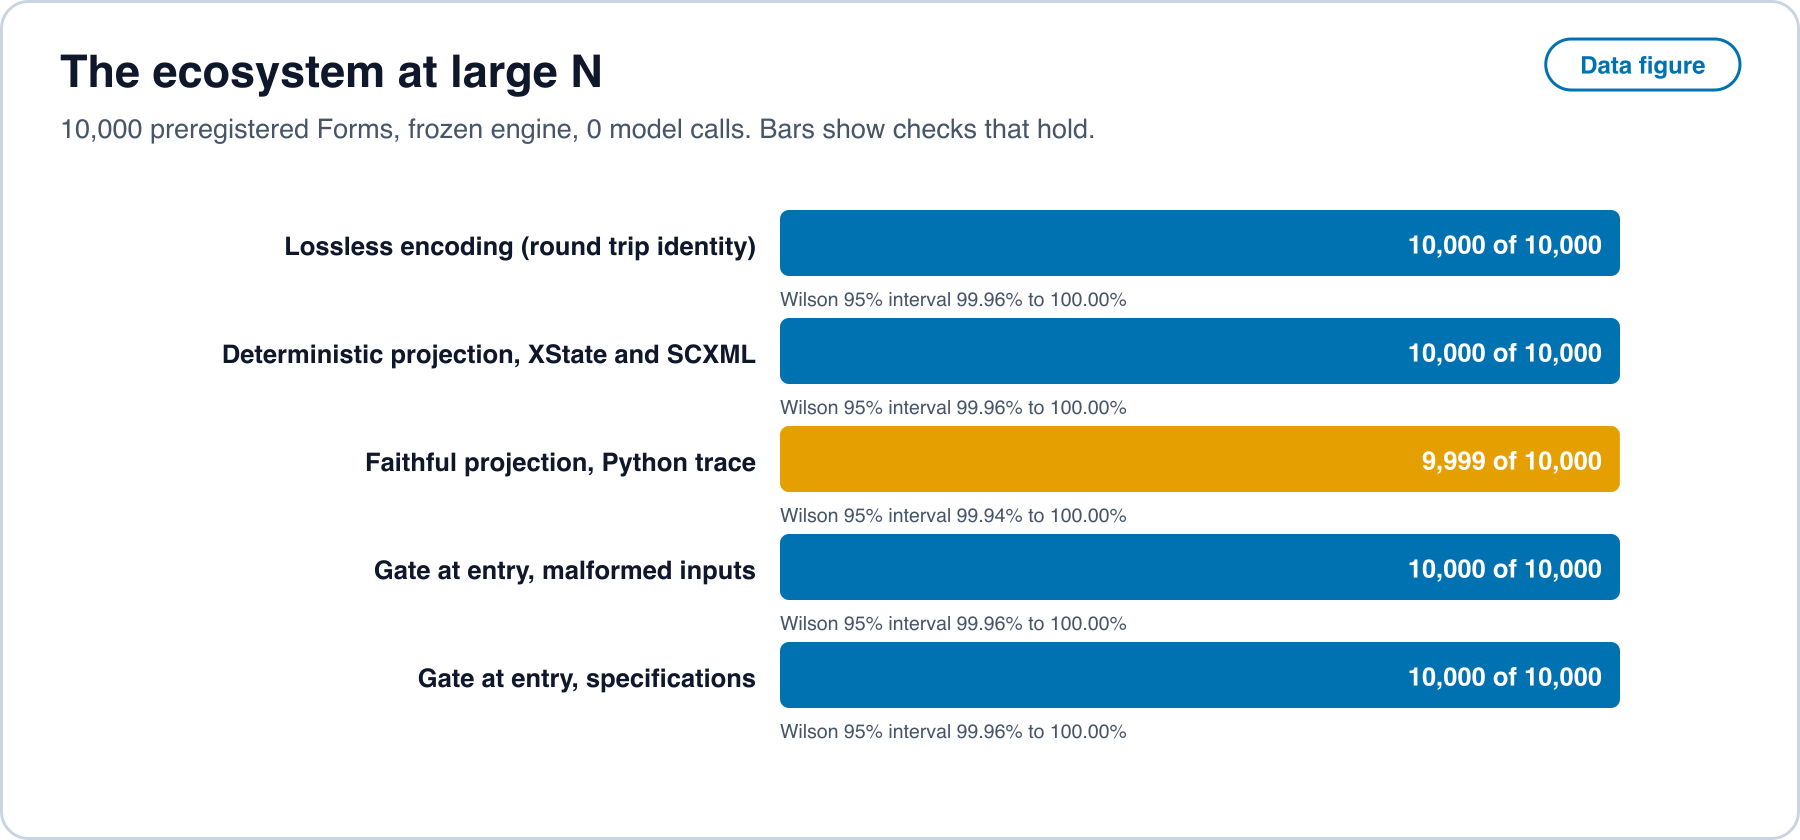
RCE-F0 और Python चूक। खंड 9 RCE-F0 को इस तरह कहता है: कम से कम 10,000 Forms के पूर्व-पंजीकृत रन पर कोई भी प्रक्षेपण ऐसा ट्रेस छापता है जो Form के संदर्भ ट्रेस से भिन्न है, या कोई भी विकृत इनपुट स्वीकार कर लिया जाता है। यह रन पूर्व-पंजीकृत है, इसमें 10,000 Forms हैं, और एक उत्सर्जित Python मॉड्यूल ने संदर्भ ट्रेस नहीं छापा, इसलिए जैसा लिखा है उस रूप में यह अवलोकन RCE-F0 की शर्त को पूरा करता है। शोधपत्र चूक और नीचे के प्रतिगमन परीक्षण की रिपोर्ट करता है, और कोई मूल कारण नहीं देता। RCE-F0 के पाठ को जैसा कहा गया है वैसा पढ़ें: जिस दावे को यह खंडित करता है वह यह है कि प्रक्षेपण विश्वसनीय हैं, और इस रन का Python प्रक्षेपण एक Form पर उस दावे पर खरा नहीं उतरा। चूक उत्सर्जक से आती है या हार्नेस से, यह यहाँ खुला प्रश्न है। यह तथ्य कि वही Form 32 hash बीजों पर समान रूप से पुनः चलता है, इसे तय नहीं करता।
एक Python चूक को एक चूक के रूप में गिना जाता है; वही Form और घटनाएँ प्रतिगमन परीक्षण tests/form_ecosystem_regress.rs में 32 hash बीजों पर समान रूप से पुनः चलाई जाती हैं। यहाँ ऊर्जा केवल est_j है; पूरे रन ने एक कोर पर 393 सेकंड का CPU समय लिया। उत्पन्न Forms छोटे होते हैं, इसलिए यह तालिका एन्कोडिंग, प्रक्षेपण और द्वार को मापती है। वास्तविक कार्यक्रमों से उठाए गए Forms §8.7 के प्रोटोकॉल के तहत मापे जाते हैं।
2.4 द्वार से नियंत्रित, सत्यापित पुनरावर्ती आत्म सुधार
गुड (1965) [111] ने अति बुद्धिमान मशीन को एक ऐसी मशीन के रूप में परिभाषित किया जो बेहतर मशीनें डिज़ाइन कर सके, ताकि सुधार पुनरावर्ती हो जाए। युडकोव्स्की (2013) [113] ने प्रश्न को प्रतिफल का प्रश्न बनाया: क्या सुधार की प्रत्येक इकाई अगली इकाई को सस्ता बनाती है या महँगा। श्मिटहूबर की गॉडेल मशीन (2007) [112] ने गारंटी के साथ पहला औपचारिक उत्तर दिया: एक प्रोग्राम अपने खोज सहित स्वयं के किसी भी भाग को तभी पुनर्लेखित करता है जब वह यह सिद्ध कर दे कि पुनरलेखन उसकी अपेक्षित उपयोगिता बढ़ाता है। लोब का प्रमेय (1955) [114] वह बाधा है जिससे स्व-विश्वास करने वाला प्रवर टकराता है, जिसे युडकोव्स्की और हेरेशॉफ (2013) [115] ने लोबियन बाधा कहा: कोई प्रणाली सामान्यतः ऐसे उत्तराधिकारी की सुदृढ़ता सिद्ध नहीं कर सकती जो अपनी स्वयं की प्रमाण प्रणाली का उपयोग करता हो। हाल की प्रणालियाँ प्रमाण आवश्यकता को छोड़ देती हैं और मापे गए अंक से चयन करती हैं: STOP (ज़ेलिकमैन एट अल., 2023) [116] उस मचान में सुधार करता है जो कोड में सुधार करता है, डार्विन गॉडेल मशीन (झांग एट अल., 2025) [117] बेंचमार्क स्कोर द्वारा चुने गए स्व-संशोधित कोडिंग एजेंटों का संग्रह रखती है, अल्फाइवॉल्व (नोविकोव एट अल., 2025) [118] स्वचालित मूल्यांकनकर्ताओं के अधीन कार्यक्रमों का विकास करता है, और वॉयजर (वांग एट अल., 2023) [119] सत्यापित कौशलों की एक पुस्तकालय बढ़ाता है जिसका बाद में कार्य पुन: उपयोग करते हैं।
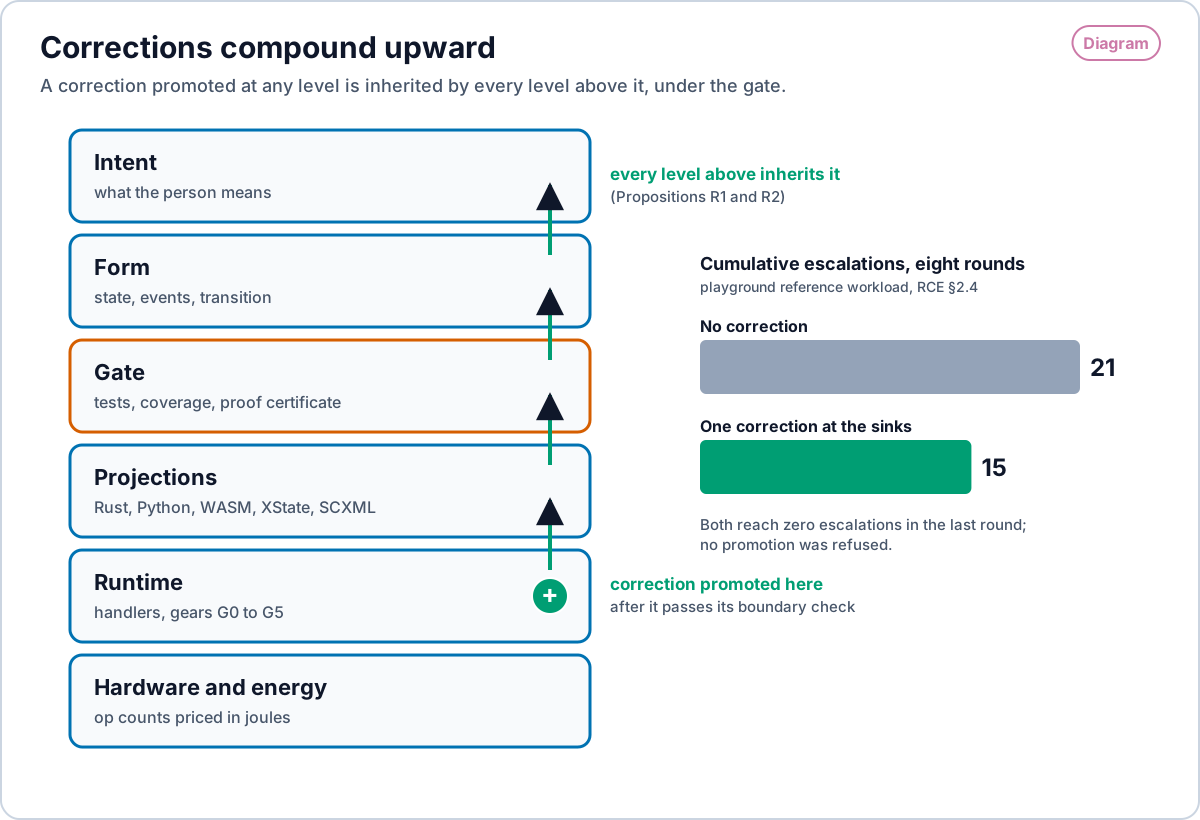
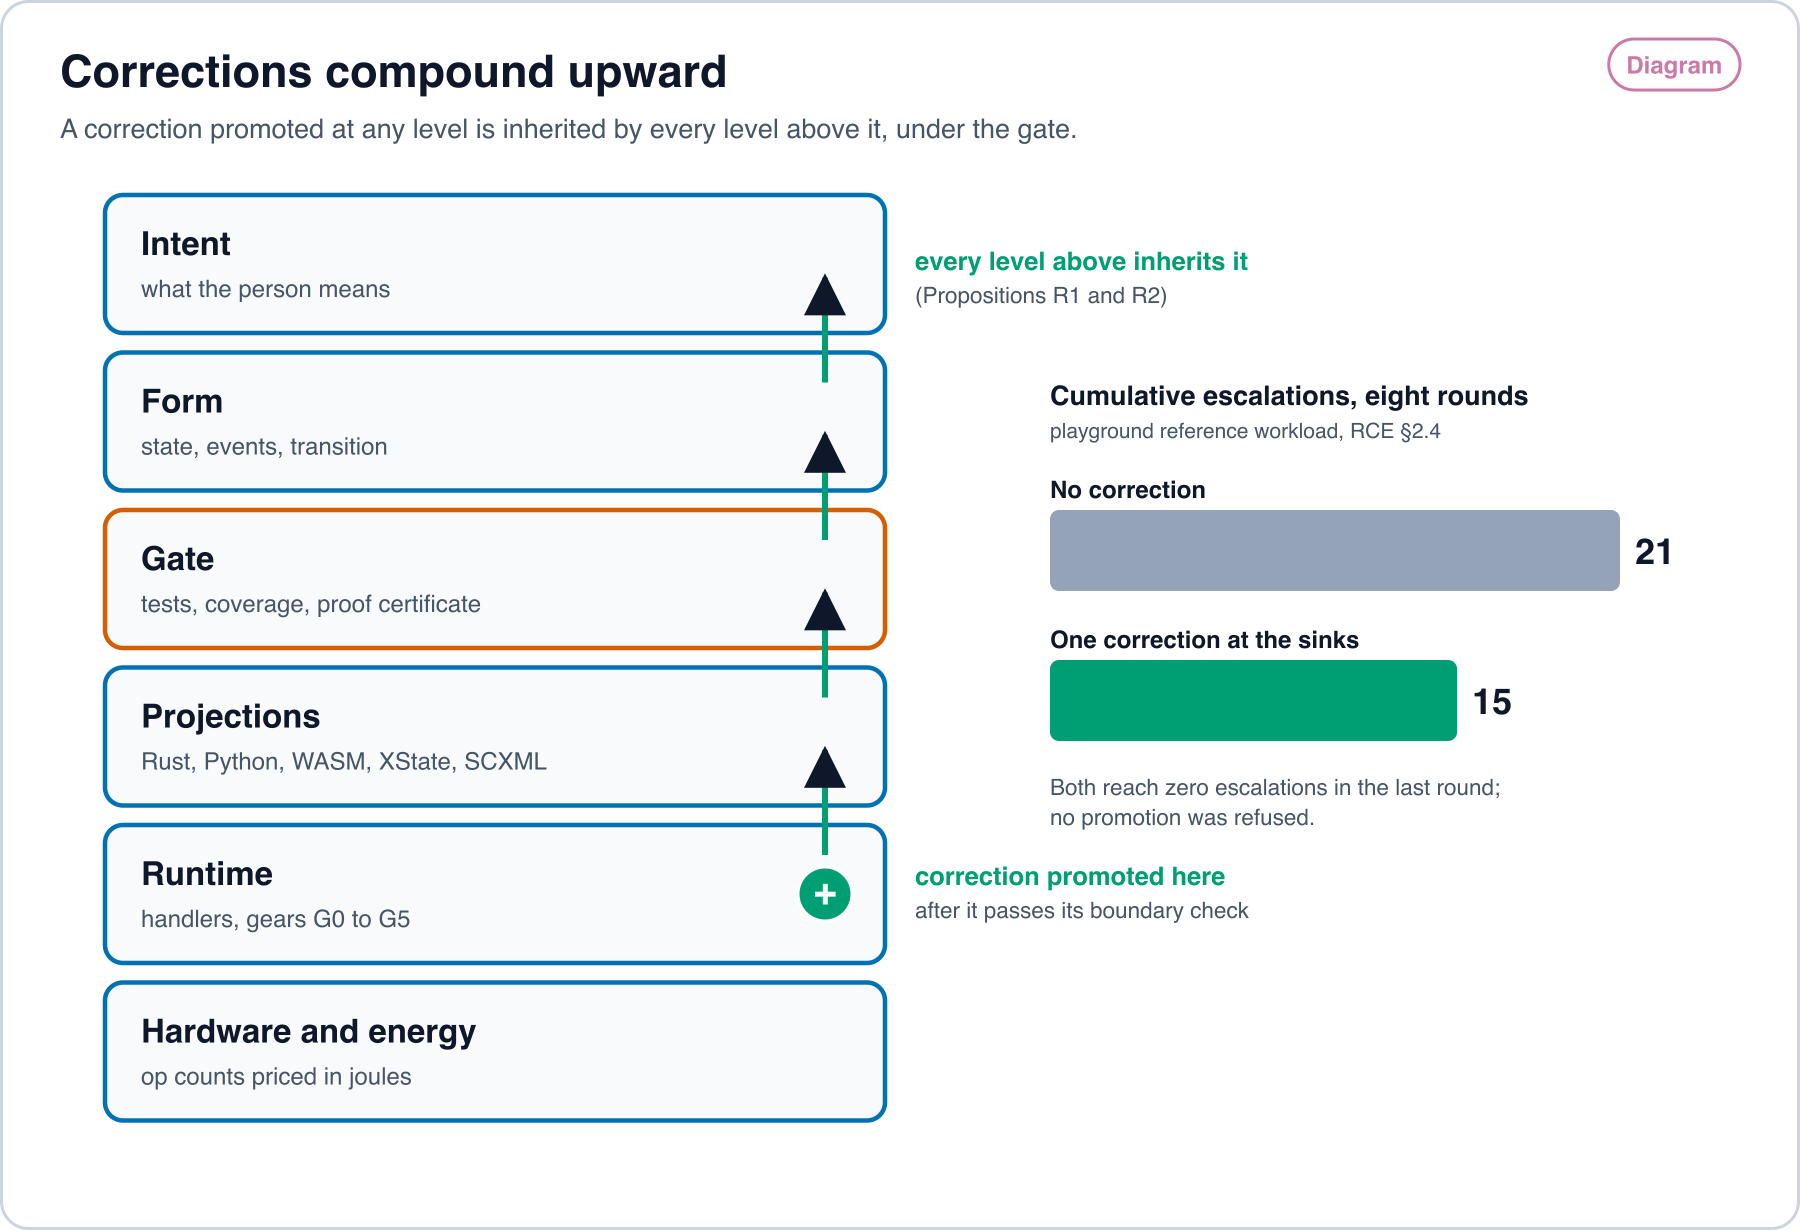
RCE गोडेल मशीन की संरचना और वॉयजर के पुस्तकालय को लेता है, जिसमें दो अंतर हैं जो उन वस्तुओं के लिए बाधा से बचते हैं जिन्हें यह बढ़ावा देता है। पहला, जिस वस्तु में सुधार होता है वह प्रवर नहीं है। RCE हैंडलर, रीराइट्स और गियर का प्रचार करता है, और प्रत्येक की जांच एक निश्चित, अलग से प्रमाणित कर्नेल के विरुद्ध की जाती है: Kani हार्नेस और SMT एन्कोडिंग प्रमोशन के दौरान कभी नहीं बदलते हैं, इसलिए किसी भी कदम को उत्तराधिकारी की प्रमाण प्रणाली पर भरोसा करने की आवश्यकता नहीं होती। दूसरा, द्वार सीमा पर शुद्धता का प्रमाण है, न कि स्कोर। एक स्कोर बढ़ सकता है जबकि इंटरफ़ेस धारणा टूट जाती है; सीमा पर दिया गया कोई प्रमाण उस परिवर्तन से पारित नहीं हो सकता जो इसे तोड़ता है।
प्रस्ताव R1 (मोनोटोनिक सही)। यदि हर प्रचारित बदलाव अपने किनारे की जांच पास करता है, और अन्य किनारों की जाँचें अपरिवर्तित रहती हैं, तो प्रमोशन के बाद भी उन जाँचों द्वारा स्थापित प्रत्येक गुण अभी भी बना रहता है।
प्रस्ताव R2 (चक्रवृद्धि)। मान लीजिए कि एक कार्यभार कार्यों का मल्टीसेट है और एक प्रचारित हैंडलर अपने आकार के प्रत्येक कार्य को बंद करता है। तो राउंड t में एस्केलेशन की संख्या t में गैर-बढ़ती होती है, और दौर 1 से पहले किया गया कोई सुधार हर क्षितिज के संचयी एस्केलेशंस को उस एस्केलेशन द्वारा कम कर देता है जिसे यह प्रत्येक बाद वाले दौर में बंद करता है। इंजन डेमो के संदर्भ कार्यभार में, आठ राउंड पर कुल मिलाकर एस्केलेशन्स 21 से घटकर एक सिंक पर एक सुधार के साथ 15 हो जाते हैं, और दोनों मामलों में अंतिम दौर में शून्य तक पहुँचते हैं, जिसमें हर कार्य सही ढंग से बंद होता है और कोई प्रचार अस्वीकार नहीं किया जाता।
आकृति 4 संदर्भ कार्यभार की कुल संख्याओं के साथ प्रस्ताव R1 और R2 की यांत्रिकी को चित्रित करती है।
प्रस्ताव R3 (गिरती लागत)। चूंकि एक प्रचारित हैंडलर मॉडल कॉल के स्थान पर निष्पादित होता है, और इसकी लागत सबस्ट्रेट तालिका द्वारा मूल्यवान हैंडलर का ऑप काउंट होती है, इसलिए जैसे-जैसे वृद्धि शून्य की ओर गिरती है वैसे ही राउंड की ऊर्जा अकेले हैंडलर की ऊर्जा की ओर घट जाती है।
फुटामुरा के प्रक्षेपण (1971, पुनर्मुद्रण 1999) [120] और टर्चिन का सुपरकंपाइलेशन (1986) [121] इस प्रक्रिया की सीमा देते हैं। एक इंटरप्रेटर को किसी प्रोग्राम में विशेषीकृत करना एक संकलित कार्यक्रम देता है; विशेषज्ञकर्ता के विशेषज्ञकरण से एक कंपाइलर मिलता है। RCE के प्रचार सामान्य वृद्धि पथ को उन आकृतियों तक विशेषीकृत करते हैं जो वास्तव में होती हैं, इसलिए इंजन अपने कार्यभार के अवशिष्ट कार्यक्रम की ओर अभिसरण करता है: गणना का वह हिस्सा जिसे मॉडल या व्यक्ति को अभी भी आपूर्ति करनी होगी। गेट के तहत पुनरावृत्ति स्व-सुधार उस अभिसरण है, जिसमें जांचे गए कदम होते हैं। RCE engine demo की कंपाउंडिंग परत इस कार्यभार को ब्राउज़र में चलाती है।
3. Form
3.1 “एक ही रूप” का सबसे सशक्त औपचारिक कथन
प्रमेय का दायरा पहले बताया जाता है। Gurevich के अनुक्रमिक अभिगृहीत अनुक्रमिक एल्गोरिदम को कवर करते हैं; समानांतर और अंतःक्रियात्मक एल्गोरिदम को Blass और Gurevich के अतिरिक्त अभिगृहीत चाहिए [3]। Blass, Dershowitz और Gurevich तर्क देते हैं कि एल्गोरिदम पर कोई एक तुल्यता संबंध हर उद्देश्य के लिए उपयुक्त नहीं है [79], और Moschovakis तथा Vardi इस बहस को प्रस्तुत करते हैं कि एल्गोरिदम क्या है [80, 81]। इनपुट और आउटपुट करने वाला वेब हैंडलर अनुक्रमिक प्रमेय से बाहर बैठता है। Form अंतःक्रिया को उसी तरह संभालता है जैसे अंतःक्रियात्मक धारा: प्रत्येक इनपुट में एक घटना होती है, और स्टेट मशीन उस पर कदम चलाती है। इसलिए “एक Form” एक मॉडलिंग विकल्प है जो अनुक्रमिक प्रमेय पर आधारित है और परिपाटी से विस्तारित होता है, जिसमें उत्पादन के पूर्व उदाहरण Elm आर्किटेक्चर [83], टिकाऊ कार्यप्रवाह इवेंट इतिहास [84] और Flo जैसे स्ट्रीम अर्थविज्ञान हैं [82]। खंड 3.4 के प्रस्ताव उस विकल्प के लिए बताए गए हैं।
गुरेविच का एब्स्ट्रैक्ट स्टेट मशीन (ASM) प्रमेय सबसे मजबूत औपचारिक कथन है कि प्रत्येक एल्गोरिथम में एक आकार होता है [2]। एक एब्स्ट्रैक्ट स्टेट मशीन एक ऐसी मशीन होती है जिसके राज्य प्रथम-क्रम संरचनाएँ होते हैं और जिसका कदम गार्ड किए गए अपडेट का एक परिमित सेट होता है। गुरेविच तीन अभिगृहीत बताता है। अनुक्रमिक समय: एक एल्गोरिथ्म के पास अवस्थाएं, प्रारंभिक अवस्थाएं और एक चरण होता है। एब्स्ट्रैक्ट स्टेट: राज्य एक निश्चित शब्दावली पर प्रथम-क्रम संरचनाएँ होते हैं, जो समरूपता (isomorphism) के तहत बंद होती हैं। बाउंडेड एक्सप्लोरेशन: प्रत्येक कदम का निर्णय करने वाला शब्दों का एक परिमित सेट होता है। उनका मुख्य प्रमेय (प्रमेय 6.13) कहता है: “प्रत्येक अनुक्रमिक एल्गोरिथम A के लिए, एक तुल्य अनुक्रमिक एब्स्ट्रैक्ट स्टेट मशीन B मौजूद होती है।” ब्लास और गुरेविच इसे समानांतर एल्गोरिदम [3] तक विस्तारित करते हैं। डेरशोविट्ज़ और गुरेविच चौथा अभिगृहीत जोड़ते हैं कि प्रारंभिक संचालन गणना योग्य होते हैं, और इससे चर्च का प्रमेय प्राप्त होता है [4]।
3.2 परिभाषाएँ
परिभाषा 1 (Form)। एक प्रोग्राम एक टपल है
- , अवस्था स्थान: एक निश्चित शब्दावली पर संरचनाएँ, जिसे नियंत्रण क्षेत्रों और डेटा में विभाजित किया गया है। तार्किक घड़ी, इनपुट गणना और टाइप किए गए संबंधों (भाषा में भी घोषित क्षेत्र) को रखता है। प्रत्येक अवस्था कॉड के अर्थ में एक डेटाबेस उदाहरण [5] होती है।
- , घटना वर्णमाला, जिसमें तार्किक घड़ी टिक शामिल है।
- , संक्रमण: कुल, नियतात्मक और शुद्ध, “यदि तो ” के रूप में लिखा गया गार्ड किए गए अपडेट का एक परिमित सेट, प्रत्येक चरण सीमित स्थानों को पढ़ता है। यह अगली अवस्था और कदम के आउटपुट लौटाता है। इसके अवस्था घटक के लिए लिखें।
- , टिकाऊ लॉग: प्रविष्टियों का एक अनुक्रम, जहाँ कदम के बाद अवस्था के कैनोनिकल JSON का SHA-256 है, पहले चार क्षेत्रों के कैनोनिकल JSON का SHA-256 है, और पहला 64 शून्य होता है। लॉग एक हैश श्रृंखला है, इसलिए किसी भी पिछले प्रविष्टि को बदलने से हर बाद वाला बदल जाता है।
- , आउटपुट मानचित्रण। मेली मशीन दोनों तर्क पढ़ती है [6]; एक मूर मशीन केवल अवस्था पढ़ती है [7]।
परिभाषा 2 (Form और fit)। form वह टपल आकार है जिसमें चार अपरिवर्तनीय गुण हैं: नियतात्मक और शुद्ध है; अन्वेषण सीमित है; शब्दावली निश्चित है; स्थिति लॉग का फोल्ड है,
एक लॉग प्रत्येक प्रविष्टि के परिणाम, आउटपुट और राज्य भी ले जा सकता है। ये व्युत्पन्न होते हैं: इन्हें हैश नहीं किया जाता है, और उन्हें रीप्ले (§3.7 के T1 और T3 से) के बराबर होना चाहिए। अस्वीकृति की दो किस्में अलग हैं। इंजन प्रोफ़ाइल में प्रत्येक घटना लागू होती है, और एक इनपुट जो अपने अनुबंध को विफल करता है वह reject आउटपुट और एक त्रुटि पंक्ति उत्पन्न करता है। भाषा में एक अस्वीकृत घटना स्थिति को अपरिवर्तित छोड़ देती है (T8) और उसे अस्वीकार के रूप में दर्ज किया जाता है।
फ़िट वह डेटा है जो आकार को भरता है: शब्दावली , वर्णमालाएँ और , नियम कार्यक्रम जो को परिभाषित करता है, आउटपुट नियम जो को परिभाषित करते हैं, और प्रारंभिक डेटा . गुरेविच के शब्दों में फ़िट वह शब्दावली, एएसएम प्रोग्राम और प्रारंभिक संरचनाएं है। कॉड के शब्दों में स्कीमा है और उदाहरण है। उत्पाद-रेखा की शर्तों पर एक फ़िट सुविधा चयन [8] होता है। सिंटैक्स-निर्देशित संश्लेषण (SyGuS) की शर्तों पर एक फ़िट व्याकरण का वह पद है जो एक विनिर्देश को पूरा करता है [9]।
परिभाषा 3 (फ़िट समतुल्यता)। दो फ़िट तब तुल्य होते हैं जब, प्रत्येक घटना अनुक्रम के लिए, के तहत उनके आउटपुट अनुक्रम बराबर हों।
परिभाषा 4 (फ़िट भाषा)। एक व्याकरण जिसके पद फ़िट दर्शाते हैं। प्रोग्रामिंग भाषाएँ, SCXML दस्तावेज़, XState कॉन्फ़िगरेशन और .rce विनिर्देश़ फ़िट भाषाएँ होती हैं। एक फ़िट भाषा पूर्ण तब होती है जब पर हर एएसएम कार्यक्रम में इसका कोई पद होता है।
परिभाषा 5 (नियंत्रण प्रक्षेपण)। को सीमित नियंत्रण प्रतीकों और डेटा संबंधों में विभाजित करें। का स्टेटचार्ट पर के प्रक्षेपण है: अवस्थाएँ के मान हैं, संक्रमण एक घटना और पर एक गार्ड ले जाते हैं, और क्रियाएं को अपडेट करना हैं। हरेल के स्टेटचार्ट्स पदानुक्रम और ऑर्थोगोनल क्षेत्रों [10] देते हैं।
परिभाषा 6 (फ़िट ई-ग्राफ)। किसी फ़िट और ध्वनि पुनलेखन () के एक सेट के लिए, फ़िट ई-ग्राफ अंडर पर की नियम पदों का संतृप्त ई-ग्राफ है [11, 12]। प्रत्येक ई-क्लास परिभाषा 3 द्वारा समतुल्य फ़िट रखता है।
परिभाषा 7 (जूल लागत)। एक नामित सब्सट्रेट पर पद को चलाने के लिए अनुमानित ऊर्जा (est_j) है, जिसे अपेक्षित रनों की संख्या से भारित किया गया है।
3.3 “डेटाबेस फ़ंक्शनल स्टेट मशीन” क्यों
एक परिमित संबंधात्मक संरचना एक डेटाबेस उदाहरण है, इसलिए गुरेविच की अवस्था एक डेटाबेस है और प्रत्येक कदम एक सीमित लेनदेन है। डेटाबेस: एक संबंधात्मक संरचना है। कार्यात्मक: और शुद्ध हैं। अवस्था मशीन: रन घटनाओं पर के फोल्ड होते हैं। मोस्ली और मार्क्स वास्तुकला में यही रेखा खींचते हैं [13]। इवेंट सोर्सिंग इसे एप्लिकेशन अवस्था में खींचती है: “एप्लिकेशन अवस्था में सभी परिवर्तनों को घटनाओं की एक अनुक्रम के रूप में कैप्चर करना” [14]। डेडालस इसे तर्क में खींचता है, जहाँ परिवर्तनशील अवस्था समय द्वारा अनुक्रमित एक संबंध है [15]।
3.4 प्रस्ताव
प्रस्तावना 1 (Form प्रत्येक अनुक्रमिक एल्गोरिथम को कैप्चर करता है)। हर अनुक्रमिक एल्गोरिथ्म के लिए एक Form उदाहरण मौजूद होता है जिसके रन के रन होते हैं।
प्रमाण का खाका। प्रमेय 6.13 हमें राज्यों, प्रारंभिक अवस्थाओं और एक-चरणीय मानचित्रण वाला ASM देता है जो से संबंधित है। सेट करें , , और पहचान होता है। टिक के बाद फोल्डिंग होती है। गुरेविच के सहखंड 3.3 द्वारा, और में समान रन होते हैं। ∎
प्रस्तावना 1b (इंटरैक्टिव प्रोग्राम)। प्रत्येक चरण से पहले एक नलरी इनपुट प्रतीक सेट को बढ़ाकर ; फिर विस्तारित शब्दावली पर एक अनुक्रमिक एल्गोरिथम है, और प्रस्तावना 1 लागू होती है। निर्माण हमारा है।
प्रस्तावना 1c (कम्प्यूटेबिलिटी)। Dershowitz और Gurevich अभिगृहीत के तहत, हर Form उदाहरण ट्यूरिंग-गणना योग्य फलन [4, 16, 17] की गणना करता है। Form कोई शक्ति नहीं जोड़ता। यह वर्ग में प्रत्येक प्रोग्राम को एक आकार देता है।
प्रस्ताव 1d (सबूत फ़िट हैं)। “किसी दिए गए प्रस्ताव के प्रत्येक प्रमाण के लिए, संबंधित प्रकार का एक प्रोग्राम होता है” [18]। एक प्रकार एक विनिर्देश है और एक प्रमाण वह फ़िट है जो इसे पूरा करता है। शुद्धता द्वार उस प्रमाण या पासिंग स्वीकृति परीक्षण की उपस्थिति है।
प्रस्ताव 2 (एक जनरेटर)। एक फलन प्रत्येक फ़िट के लिए चलाने योग्य प्रोग्राम उत्पन्न करता है और कोई डोमेन नहीं पढ़ता है। आधार: हर कार्यक्रम एक Form उदाहरण होता है, इसलिए एक टाइप किया गया स्टोर, एक इवेंट प्रकार, संकलित नियम, फोल्ड वाले लॉग और आउटपुट डिस्पैचर उत्सर्जित करता है। Rails जनरेटर, JHipster और Yeoman जैसे स्कैफोल्डर छोटे फ़िट भाषाओं तक सीमित हैं। उत्पाद-रेखा इंजीनियरिंग “संबंधित सॉफ्टवेयर सिस्टम में सामान्यता की व्यवस्थित खोज और शोषण” [8] से शुरू होती है; वह सामान्यता Form है।
प्रस्तावना 3 (न्यूनतम-ऊर्जा निष्कर्षण)। के साथ निष्कर्षण, की e-वर्ग में खोजे गए न्यूनतम जूल पद को लौटाता है। प्रमाण का खाका। पुनरलेख सुरक्षित हैं, इसलिए e-वर्ग में प्रत्येक पद का ‘s अवलोकन योग्य व्यवहार होता है और यह उसी द्वार से गुजरता है। निष्कर्षण लागत को कम करता है, और लागत जूल होती है। ∎ यह कोड पर लागू Mixture of Limits (सीमाओं के मिश्रण) है: न्यूनतम फ़िट रखें जो कार्य करती है, और बाकी बर्बादी है।
प्रस्तावना 4 (रिप्ले नियतत्ववाद)। यदि कोई दीवार घड़ी नहीं पढ़ता है, नामों के बिना अपडेट का आदेश देता है और हर इनपुट को लॉग करता है, तो एक की दो रीप्ले प्रत्येक चरण पर समान स्टेट हैश देते हैं।
प्रस्तावना 5 (स्टेटचार्ट प्रक्षेपण सुरक्षित है)। किसी रन की प्रत्येक अवस्था को पर प्रोजेक्ट करें। परिणाम उसी घटनाओं के तहत उत्सर्जित स्टेटचार्ट का एक रन होता है।
प्रस्ताव 6 (समन्वय बजट)। समन्वय के बिना प्रतिकृतियों पर टैग किए गए मोनोटोन नियम चलते हैं; केवल गैर-मोनोटोन नियमों को एक समन्वय बिंदु की आवश्यकता होती है। आधार: CALM प्रमेय, “वे प्रोग्राम जिनमें सुसंगत, समन्वय मुक्त वितरित कार्यान्वयन होते हैं वे ठीक वही कार्यक्रम हैं जिन्हें एकांकिक तर्क में व्यक्त किया जा सकता है” [19]।
टैग नियम से प्राप्त होता है, कभी घोषित नहीं किया जाता है, और IR जाँच एक Form को अस्वीकार करती है जिसका संग्रहीत टैग व्युत्पन्न वाले से भिन्न हो (विनिर्देश, परिशिष्ट D.5):
| यदि नियम में | टैग | कारण |
|---|---|---|
| कोई resolve, read, join या scan नहीं | monotone | इसके लेखन केवल कुंजियाँ जोड़ते हैं और काउंटर बढ़ाते हैं |
| एक resolve है | not monotone | यह एस्केलेशन पंक्तियाँ हटाता है |
| अपने ही सिंक का एक read है | not monotone | पढ़ो, संशोधित करो, लिखो |
| एक keyed join है | not monotone | जुड़ा हुआ पंक्ति अब अनुपस्थित और बाद में मौजूद हो सकती है, या अधिलेखित की जा सकती है |
| एक scan है | not monotone | यह पूरे संबंध को देखता है, जिसमें जो अनुपस्थित है वह भी शामिल है |
टैग ध्वनि है और पूर्ण नहीं: एक इंसर्ट-ओनली संबंध के विरुद्ध जॉइन मोनोटोन होगा, लेकिन प्रोफ़ाइल यह साबित नहीं करता कि कोई संबंध इंसर्ट-ओनली है, इसलिए टैग इसका दावा नहीं करता। जब प्रत्येक नियम मोनोटोन होता है तो Form समन्वयता मुक्त (coordination-free) होता है। हर रीड, जॉइन और स्कैन घटना की एंट्री पर स्थिति देखता है, अतः एक इनपुट इवेंट का पोस्ट-स्टेट इस बात पर निर्भर नहीं करता कि विभिन्न सिंक के लिए नियमों को किस क्रम में चलाया जाता है; केवल आउटपुट ऑर्डर निर्भर करता है, और यह कंटेंट हैश द्वारा निश्चित किया गया है।
प्रस्तावना 7 (जूल व्युत्पन्न के रूप में बुद्धि)। मान लीजिए द्वार से कार्यों की गिनती करता है और खर्च किए गए जूल को । , जो hindsight से में पढ़ा जाता है, जिसमें हर घटना और उसका est_j दर्ज होता है। के तहत निष्कर्षण (Extraction) द्वार को स्थिर रखता है और नहीं बढ़ाता है, इसलिए समान पर यह को कम नहीं करता है।
3.5 Graph, e-graph और statechart
| संरचना | Form का भाग | यह क्या तय करता है |
|---|---|---|
| Statechart | पर के गार्ड्स (Guards) | कौन सा ट्रांज़िशन फायर होता है |
| Dataflow graph | और की रीड और राइट डिपेंडेंसीज ([20] काहन प्रक्रिया नेटवर्क) | क्या चलता है, और किस क्रम में |
| E-graph | फ़िट के समतुल्य वर्ग (equivalence class of the fit) | कौन सा तुल्य़ंकारी फ़िट चलेगा |
स्टेटचार्ट और ग्राफ एक फ़िट का वर्णन करते हैं। ई-ग्राफ इसका समकक्ष हर फ़िट का वर्णन करता है। एक्सट्रैक्शन जूल द्वारा उनमें से चुनता है।
3.6 एक पारिस्थितिकी तंत्र, हानिरहित, और सार्वभौमिकता थीसिस
निर्माण से हानिरहित। Shannon का स्रोत कोडिंग प्रमेय किसी भी हानि रहित कोड को स्रोत की एंट्रॉपी पर सीमित करता है [40]। एक Form मंशा के लिए एक हानि रहित कोड है जिसे संकीर्ण अर्थ में जाँचा जा सकता है: Form का मानक क्रमण (canonical serialization) अंतःक्षेपी (injective) होता है, इसलिए किसी भी अवस्था, घटना या संक्रमण में भिन्न दो Forms के shape hash अलग होते हैं, और क्रमण को डीकोड करने पर वही Form वापस मिलता है। एक लक्ष्य तक प्रत्येक प्रक्षेपण केवल Form का फ़ंक्शन होता है। द्विदिश रूपांतरण राउंड ट्रिप को सटीक बनाते हैं। Foster, Greenwald, Moore, Pierce और Schmitt ने लेंस (lens) को get और put कार्यों के जोड़े के रूप में परिभाषित किया जिसमें राउंड ट्रिप की शर्तें होती हैं जो एक दृश्य और उसके स्रोत को सहमत बनाती हैं [122], Hofmann, Pierce और Wagner इन शर्तों का विस्तार सममित लेंसों तक करते हैं [123], और Czarnecki और सहयोगियों ने मॉडल इंजीनियरिंग, डेटाबेस और प्रोग्रामिंग भाषाओं में इन्हीं संगति शर्तों की समीक्षा की है [124]। RCE की राउंड ट्रिप शर्त पूरे कार्यक्रम के स्तर पर GetPut शर्त है: एक प्रक्षेपण को वापस लिफ़्ट करने पर shape hash अपरिवर्तित रहता है।
निर्माण द्वारा सही। डायकस्ट्रा ने 1968 में प्रस्तावित किया था कि एक प्रोग्राम और उसका प्रमाण साथ-साथ विकसित किए जाएं, ताकि शुद्धता का परीक्षण करने के बजाय उसे डिज़ाइन किया जाए [125]। हॉल और चैपमैन ने इस दृष्टिकोण को औपचारिक विनिर्देश (formal specification) और हर कदम पर शोधन (refinement) वाले एक वाणिज्यिक सुरक्षित सिस्टम में ले गए [126]। टाइपड फंक्शनल प्रोग्रामिंग के लिए मिंस्की का नियम, अवैध अवस्थाओं को अप्रतिनिधित्व योग्य बनाता है, यह उसी बात को प्रकार स्तर (type level) पर कहता है: जो प्रकार खराब मान धारण नहीं कर सकता वह इसके लिए जाँच करने की आवश्यकता को समाप्त करता है [127]। टर्नर की कुल फंक्शनल प्रोग्रामिंग के अनुसार हर फ़ंक्शन का प्रत्येक इनपुट पर समाप्त होना आवश्यक है, ताकि एक प्रोग्राम किसी छिपी हुई विफलता वाले गणितीय फलन (mathematical function) को दर्शाता हो [128]। RCE का Form टर्नर के अर्थ में कुल है, इसके कॉन्ट्रैक्ट प्रकार मिंस्की के अर्थ में अनिर्दिष्ट अवस्थाओं को अप्रतिनिधित्व योग्य बनाते हैं, और §2.1 की शोधन श्रृंखला डायकस्ट्रा के अर्थ में इसमें समाप्त होती है। परिणाम वह है जो §1 में बताया गया है: प्रवेश पर एक त्रुटि अस्वीकार कर दी जाती है, इसलिए बाद में अंतर करने या ट्रैक करने के लिए कुछ नहीं होता है।
सार्वभौमिकता थीसिस। सिद्धांत शब्दों में व्यक्त किया गया है कि एक सार्वभौम फॉर्म मौजूद है। प्रोग्राम इसमें मूल रूप से लिखे जाते हैं, हर मौजूदा भाषा इससे एक निष्ठावान प्रक्षेपण के रूप में सुलभ है, और हर मौजूदा कार्यक्रम लिफ़्ट द्वारा इसमें प्रवेश करता है। गुरेविच का थीसिस आधार देता है: प्रत्येक अनुक्रमिक एल्गोरिथम को उसके अपने स्तर की अमूर्तता पर चरण दर चरण एक एब्स्ट्रैक्ट स्टेट मशीन द्वारा कैप्चर किया जाता है [2], और समानांतर एल्गोरिदम भी [3]। फॉर्म डेटाबेस स्थिति पर ऐसी ही मशीन है।
प्रस्ताव U1 (कैपचर)। यदि भाषा में कोई प्रोग्राम गुरेविच के अर्थ में अनुक्रमिक या समानांतर एल्गोरिथम है, तो एक Form मौजूद है जिसका संक्रमण इसे कार्यक्रम के स्तर की अमूर्तता पर चरण दर चरण सिमुलेट करता है [2, 3]।
प्रस्ताव U2 (निष्ठावान प्रक्षेपण)। यदि फॉर्म का पर प्रक्षेपण अनुबंध में हर इनपुट पर फॉर्म के ट्रेस को संरक्षित रखता है, तो Form और इसका प्रक्षेपण प्रत्येक ट्रेज़ देखने वाले के लिए विनिमेय हैं, और वह कुछ भी नहीं जोड़ता जो फॉर्म में अनुपस्थित हो।
प्रस्तावना U3 (निर्माण द्वारा लिफ़्ट)। उपयोग में प्रत्येक प्रोग्रामिंग भाषा का एक औपचारिक व्याकरण होता है, जिसमें एक पार्सर होता है जो एक ठोस सिंटैक्स ट्री देता है, एक एब्स्ट्रैक्ट सिंटैक्स ट्री और उसके विनिर्देश या संदर्भ कार्यान्वयन द्वारा निश्चित अर्थविज्ञान। को तीन चरणों में प्रति भाषा बनाया जाता है: पहले व्याकरण, फिर एब्स्ट्रैक्ट सिंटैक्स ट्री, और अंत Form के साथ, जिसमें की प्रत्येक संरचना को के अर्थविज्ञान द्वारा उसका Form नियम दिया जाता है। इस प्रकार निर्मित लिफ़्ट व्यवहार पर और आकार हैश पर को संतुष्ट करता है, इसलिए जोड़ा [122] के अर्थ में एक लेंस है, और में कोई प्रोग्राम बिना किसी हानि के Form के रूप में रखा जाता है।
प्रस्तावना U4 (प्रतिस्थापन)। यदि भाषा के लिए U2 और U3 मान्य हैं, तो में कोई कार्यक्रम लिखने की आवश्यकता नहीं होती: इसे एक बार Form के रूप में लिखा जाता है और जहाँ किसी प्लेटफ़ॉर्म को इसकी आवश्यकता हो वहाँ के रूप में उत्सर्जित किया जाता है।
U1 एक प्रमेय है। U2 का परीक्षण विभेदक परीक्षण (§5.1) द्वारा प्रत्येक लक्ष्य पर और §2.3 में बड़े N के लिए किया जाता है। U3 एक निर्माण है, जिसे व्याकरण से भाषा दर भाषा बनाया गया है, और §8.7 बताता है कि जैसे ही इसका निर्माण होता है वैसे ही इस निर्माण को कैसे मापा जाता है।
3.7 भाषा: संस्करण 0.6 और 0.7, लागतें और प्रमेय स्थिति
RCE भाषा एक लिखित विनिर्देश द्वारा परिभाषित है, वर्तमान में यह ड्राफ्ट 0.7 दस्तावेज़ पर भाषा संस्करण 0.8 (/rce/spec/); रसीद rce रिपॉजिटरी में स्रोत। प्रत्येक मॉड्यूल एक पहली पंक्ति टिप्पणी के साथ अपने भाषा संस्करण का चयन करता है। इसके बिना कोई मॉड्यूल संस्करण 0.5 पर होता है, जो खंडों 2 से 10 की भाषा है। एक मॉड्यूल जो # rce-version: 0.6 घोषित करता है उसे परिशिष्ट C भी मिलता है: par, for ... par, with budget, कार्यसमूह (workgroups), LVars, सत्र और पर्यवेक्षक (supervisors)। एक मॉड्यूल जो # rce-version: 0.7 घोषित करता है उसमें संस्करण 0.6 की भाषा होती है जिसमें नीचे मानक पुस्तकालय विधियों की लागत का एक अंतर होता है (परिशिष्ट C.15)। परिशिष्ट D इंजन प्रोफ़ाइल, हैंडलर विनिर्देश और फ़िट को परिभाषित करता है जिस पर यह शोधपत्र का इंजन चलता है। कोई भी संस्करण 0.5 मॉड्यूल कभी भी परिशिष्ट C नहीं देखता है, इसलिए हर वैध संस्करण 0.5 प्रोग्राम बिना बदले स्वीकार किया जाता है।
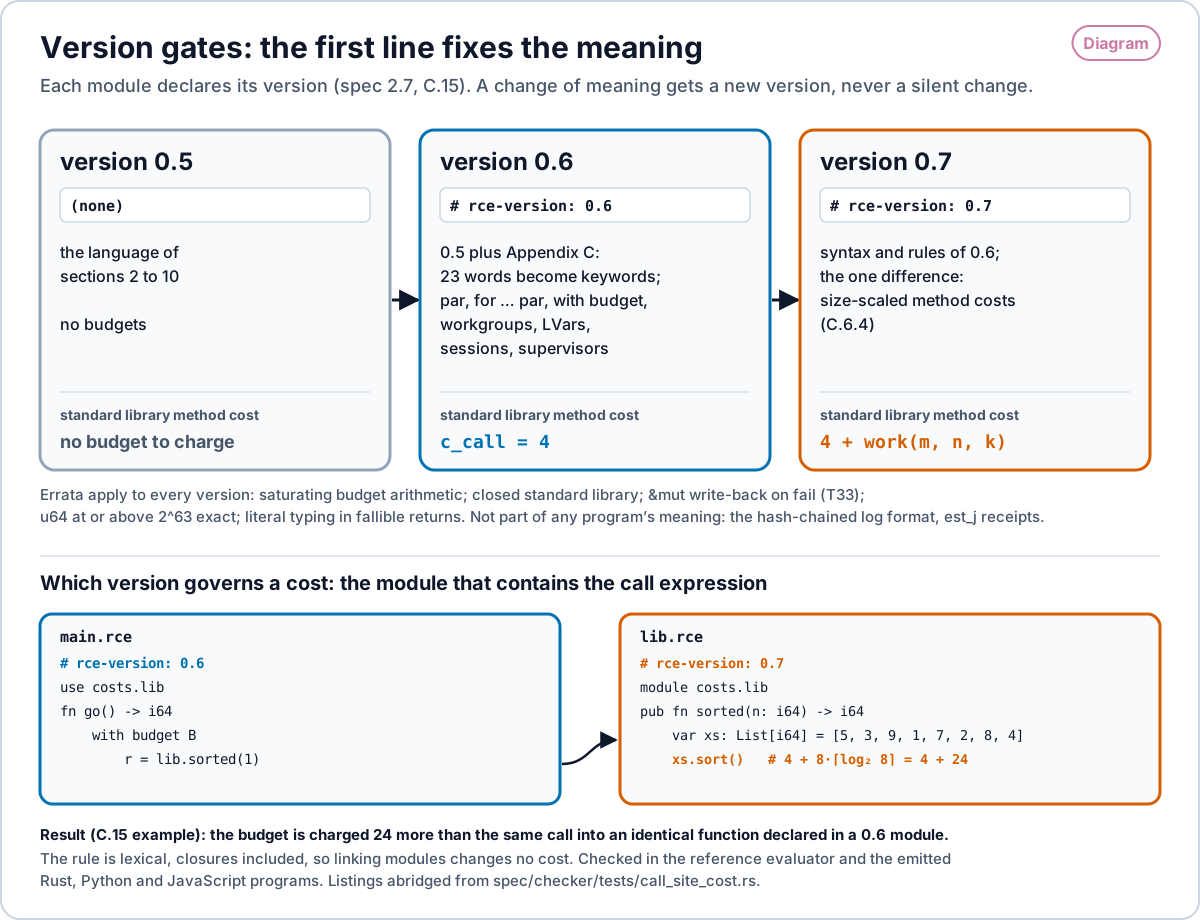
# rce-version: 0.6 परिशिष्ट C (23 नए कीवर्ड; par, for ... par, with budget, कार्यसमूह, LVars, सत्र, पर्यवेक्षक), और एक मानक पुस्तकालय विधि लागत जोड़ता है। # rce-version: 0.7 में 0.6 का सिंटैक्स और नियम हैं और केवल विधि लागत में भिन्न होता है, । त्रुटि सुधार हर संस्करण पर लागू होते हैं। कॉल अभिव्यक्ति वाले मॉड्यूल का संस्करण उसकी लागत को नियंत्रित करता है: with budget के तहत एक 0.6 फ़ंक्शन जो 8 तत्वों को सॉर्ट करने वाली आयातित 0.7 फ़ंक्शन को कॉल करता है, उसे समान ही 0.6 फ़ंक्शन में किए गए उसी कॉल की तुलना में 24 अधिक शुल्क लिया जाता है। स्रोत: विनिर्देश 2.7, सी.6.4 और सी.15; सूची spec/checker/tests/call_site_cost.rs से संक्षिप्त। एक PNG प्रतिलिपि प्रदान की गई है। Open full size · PNG
बजट कार्य गिनता है। एक with budget ब्लॉक प्रत्येक ऑपरेशन पर परिशिष्ट C.6.4 की तालिका से निश्चित लागत लगाता है और जब गणना समाप्त हो जाती है तो budget के साथ ट्रैप करता है। यह गिनती काम का प्रॉक्सी है, समय या ऊर्जा का माप नहीं; est_j अलग है।
| ऑपरेशन | लागत |
|---|---|
| एक उपयोगकर्ता फ़ंक्शन या क्लोजर की कॉल, | 4 |
| रिसीवर आकार पर मानक पुस्तकालय विधि, पहले तर्क के आकार का | संस्करण 0.6 में 4; संस्करण 0.7 में |
| चैनल भेजना या प्राप्त करना | 8 |
spawn | 32 |
एक par शाखा या for ... par खंड | 16 |
सूची या मानचित्र शाब्दिक, या समझन (comprehension), परिणामों के साथ; [x; n] | |
इंडेक्स, स्लाइस, सदस्य एक्सेस; यूनरी ऑपरेटर्स; and, or; पूर्णांक, बूल और पाठ ऑपरेटरों और तुलनाएँ | 1 |
float +, -, * | 2 |
float /, % | 8 |
साइज़ किसी पाठ की UTF-8 बाइट लंबाई, एक सूची की लंबाई और एक मैप के प्रविष्टियों की संख्या है; कोई अन्य मान साइज़ 0 रखता है। विधि कार्य संदर्भ मूल्यांकनकर्ता में विधि की जटिलता वर्ग द्वारा निश्चित होता है: टेक्स्ट, सूचियाँ और मैप पर रैखिक विधियों के लिए , sort के लिए (जब तो 0), और शेष विधियों के लिए 0। जो कॉलें map, filter और fold अपने फ़ंक्शन तर्क को करती हैं, उन्हें अतिरिक्त कॉलों में चार्ज किया जाता है। अंकगणित सबसे बड़े 128-बिट पूर्णांक पर संतृप्त होता है, और कभी कम नहीं होता जब या बढ़ता है। संदर्भ मूल्यांकनकर्ता और उत्सर्जित Rust, Python और JavaScript रनटाइम समान फ़ंक्शन की गणना करते हैं, और एक परीक्षण जाँचता है कि बजट जाल सभी चार में उसी ऑपरेशन पर पड़ता है।
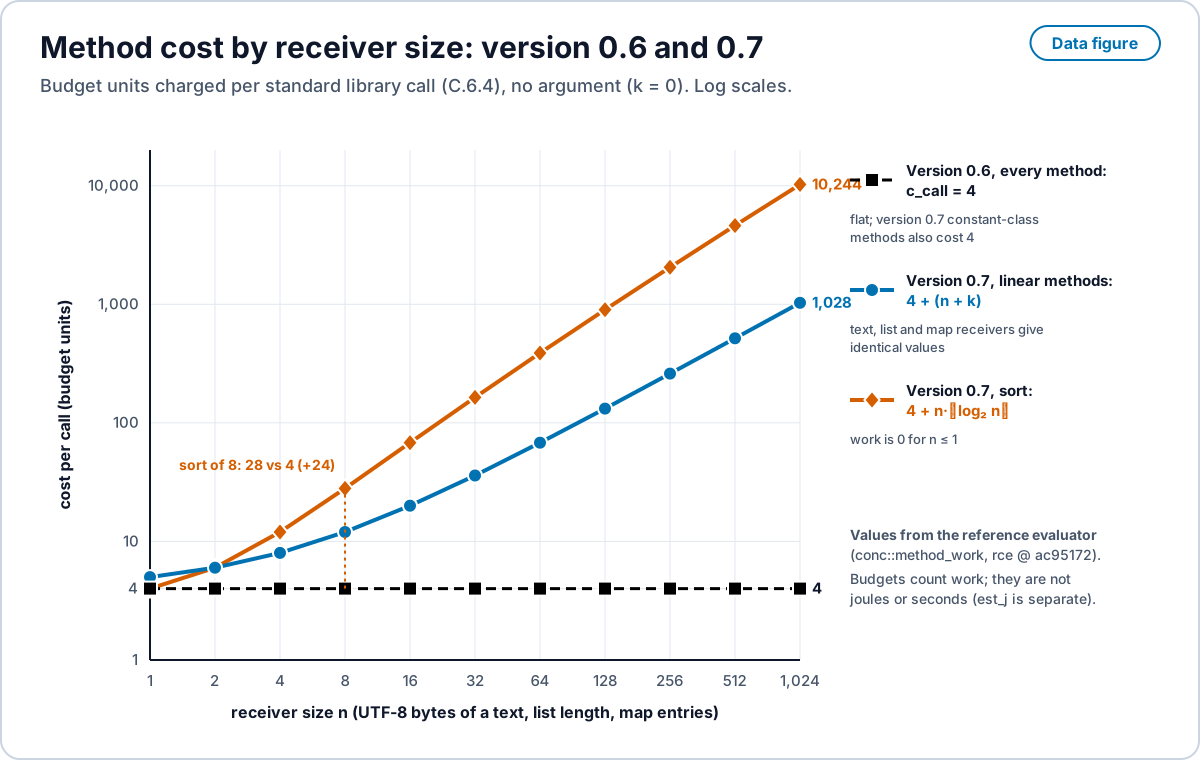
conc::method_work (rce ac95172) द्वारा गणना किए गए मान। एक PNG प्रतिलिपि प्रदान की गई है। Open full size · PNG
कौन सा संस्करण लागत को नियंत्रित करता है। एक प्रोग्राम विभिन्न संस्करणों के मॉड्यूल से जुड़ सकता है। किसी विधि कॉल की लागत उस मॉड्यूल के घोषित संस्करण द्वारा निश्चित होती है जिसमें कॉल अभिव्यक्ति शामिल है, इसमें वहाँ लिखे गए क्लोजर के अंदर का कॉल भी शामिल होता है, और यह इस बात पर निर्भर नहीं करती कि कौन सा फ़ंक्शन चल रहा है, उसके कॉलर या प्रोग्राम के पहले मॉड्यूल का। नियम शाब्दिक (lexical) है, इसलिए मॉड्यूलों को लिंक करने से कोई लागत परिवर्तन नहीं होती; विनिर्देश 2.7 समान नियम बताता है और C.15 की ओर इशारा करता है। परीक्षण संदर्भ मूल्यांकनकर्ता पर दोनों दिशाओं में और उत्सर्जित Rust, Python और JavaScript प्रोग्रामों पर इसकी जाँच करते हैं: with budget के तहत एक 0.6 फ़ंक्शन जो एक आयातित 0.7 फ़ंक्शन को कॉल करता है जिसमें 8-तत्व वाली सूची सॉर्ट की जाती है, उसे समान call से $24 अधिक चार्ज किया जाता है जो कि एक ही 0.6 फ़ंक्शन पर होता।
प्रमेय स्थिति। विनिर्देश प्रमेय T1 से T34 बताता है और प्रत्येक की स्थिति को सटीक रूप से रिकॉर्ड करता है। प्रमाण एक कोर कैलकुलस पर Lean 4 (v4.12.0, कोई Mathlib नहीं) में हैं। किसी परिणाम के स्तर के लिए उपयोग किए गए शब्द ये हैं। सिद्ध का अर्थ भाषा के मूल सिमेंटिक्स के बारे में एक लीन प्रमाण है। सिमेंटिक्स पर सिद्ध का अर्थ RCE के कोर की स्मॉल-स्टेप सिमेंटिक्स पर एक लीन प्रमाण है। मॉडल का अर्थ एक अमूर्त मॉडल के बारे में एक लीन प्रमाण है जो RCE सिमेंटिक्स या संदर्भ मूल्यांकनकर्ता से जुड़ा नहीं है। वेक्टर का मतलब यह है कि उत्पन्न कार्यक्रमों पर संदर्भ मूल्यांकनकर्ता के परिणाम को लीन कर्नेल द्वारा मॉडल के विरुद्ध जांचा जाता है, जो नमूनों पर एक पत्राचार है, न कि मूल्यांकनकर्ता के बारे में कोई प्रमाण। परीक्षित का अर्थ बताए गए इनपुट पर विभेदक परीक्षण है। यांत्रिक रूप से जाँच किया गया का मतलब किसी प्रोग्राम द्वारा तय करना है, जैसे LALR(1) तालिका निर्माता।
| कथन | स्तर | |
|---|---|---|
| T1 | नियतता: स्थिति और घटना के लिए एक परिणाम; समवर्ती अर्थशास्त्र की प्रत्येक टिक के लिए एक परिणाम | सिद्ध |
| T2 | का संपूर्ण, मूल्यांकन चरणों पर स्पष्ट सीमा के साथ; कॉल ग्राफ के साथ संरचनात्मक पुनरावृत्ति और बाउंड संयोजन | सिद्ध (लीन अभिव्यक्ति कोर में कोई उपयोगकर्ता फ़ंक्शन कॉल नहीं है; पुनरावृत्ति और संयोजन को अलग मॉडल पर सिद्ध किया गया) |
| T3 | रनटाइम स्थिति है और रीप्ले प्रत्येक हैश और आउटपुट का पुनर्निर्माण करता है | सिद्ध |
| T4 | प्रगति, टिक सहित (कुछ कार्य चलते हैं, या दौड़ समाप्त होती है या Deadlock की रिपोर्ट करती है) | सिद्ध |
| T5 | संरक्षण, हर लिखे गए फ़ील्ड के पूर्णांक रेंज सहित | सिद्ध |
| T6 | मेमोरी सुरक्षा, पूर्ण उधार पथ, कार्यों के बीच कोई परिवर्तनीय साझाकरण नहीं | स्वामित्व कोर और उधार पथों के एक उपकरण-युक्त अर्थशास्त्र के लिए सिद्ध किया गया है |
| T7 | लॉग हैश, आईडी और चयन विकल्पों की नाम स्वतंत्रता | सिद्ध |
| T8 | परमाणुता: एक अस्वीकृत घटना स्थिति को अपरिवर्तित छोड़ देती है | सिद्ध |
| T9-F | Form IR लक्ष्य (Rust, WASM, Python, XState, SCXML) संदर्भ ट्रेस प्रिंट करते हैं | परीक्षित |
| T9-L | प्रोग्राम उत्सर्जक (rust, python, js) संदर्भ मूल्यांकनकर्ता के साथ सहमत होते हैं | एक कोर पर Rust उत्सर्जक के लिए सिद्ध किया गया है, जो MiniRust में सत्यापित अनुवाद है, जिसमें उत्सर्जित Rust उपसमूह का गहरा एम्बेडिंग शामिल है; यह भरोसा और परीक्षण किया जाता है कि rustc MiniRust को लागू करता है; अन्य उत्सर्जकों का परीक्षण किया गया |
| T10 | व्याकरण गैर-अस्पष्ट है | यांत्रिक रूप से जांचा गया (LALR(1), 0 संघर्ष, दोनों संस्करणों के लिए) और एक फ़ज़ज़र द्वारा नमूना लिया गया |
| T11 | चयन निष्पक्षता | रोटेशन मॉडल पर सिद्ध किया गया |
| T12 | प्रत्येक पथ पर रैखिक हैंडल का ठीक एक बार उपभोग होता है | कथन मॉडल पर सिद्ध किया गया |
| T13 | f32 ऑपरेशन उन लक्ष्यों पर समान बिट्स देते हैं जो IEEE 754 पर सहमत होते हैं | गुणा के लिए सिद्ध; जोड़, घटाव और विभाजन के लिए एकल-राउंडिंग गुण फिगुएरो का प्रमेय है, उद्धृत और मशीनीकृत नहीं किया गया |
| T14 | जांचा u64 अंकगणित सीमा में सटीक है | सिद्ध किया गया |
| T15 | इटरेटर समाप्त होते हैं, लूप सीमा का सम्मान करते हैं और उपसर्ग-संगत हैं | सिद्ध किया गया |
| T16 से T31 | संस्करण 0.6 समवर्तीता: par नियतत्ववाद, विनिमय (commutation), कमीकरण (reductions), डेडलॉक स्वतंत्रता, समय सीमाएँ, कार्यसमूह (workgroups), वेक्टर घड़ी (vector clocks), प्राथमिकताएँ, दायरे (scopes), अभिनेता (actors), सत्र (sessions), LVars, परमाणु बैच (atomic batches), प्रतिकृतियाँ (replicas) | एक सिमेंटिक्स पर सिद्ध: T16, T17, T19a, T20, T23; रन के मॉडल पर सिद्ध: T24; एक सत्र कैलकुलस पर सिद्ध: T28; मॉडल: T18, T19b, T21, T22, T25, T26, T31; वैक्टरों के साथ मॉडल: T27, T29, T30। इनमें से कोई भी Rust संदर्भ मूल्यांकनकर्ता पर प्रमाण नहीं है |
| T32 | विदेशी पुनरावृत्ति (foreign replay): प्रत्येक ऑरेकल के लिए, लॉग की पुनरावृत्ति लाइव रन के बराबर होती है, और हर दर्ज किए गए उत्तर का एक जवाब अनुबंध कायम रहता है | सिद्ध किया गया |
| T33 | विफलता पर &mut पुनर्स्थापन (F.4.4): विफल कॉल कॉलर की &mut स्थिति को वैसा ही छोड़ती है जैसी वह कॉल के समय थी; लौटने वाली कॉल राइट-बैक करती है (हर परिणाम पर कॉपी-आउट का पहले का नियम सेवानिवृत्त है) | सिद्ध किया गया |
| T34 | प्रत्येक उत्सर्जक (emitter) से पहले क्रम-संरक्षण ANF पास समान मान देता है, और शुल्कों का भंडारण तथा पता लगाता है और उत्सर्जित करता है | पूर्ण ANF के साथ एक कोर खंड के लिए सिद्ध; कार्यान्वयन को हर लक्ष्य पर अंतरण रूप से परीक्षित किया जाता है, जिसमें ट्रैप बिंदु में बजट की स्वीप शामिल है |
T9 के दो लक्ष्य सेट हैं क्योंकि शोधपत्र का इंजन और भाषा दोनों में दो कंपाइलर हैं। T9-F, rce form --emit पर दावा है, जिसे §5.1 मापता है। T9-L भाषा के प्रोग्राम उत्सर्जकों (program emitters) के बारे में दावा है। इन सेटों से बाहर किसी लक्ष्य का कोई T9 दावा नहीं होता है।
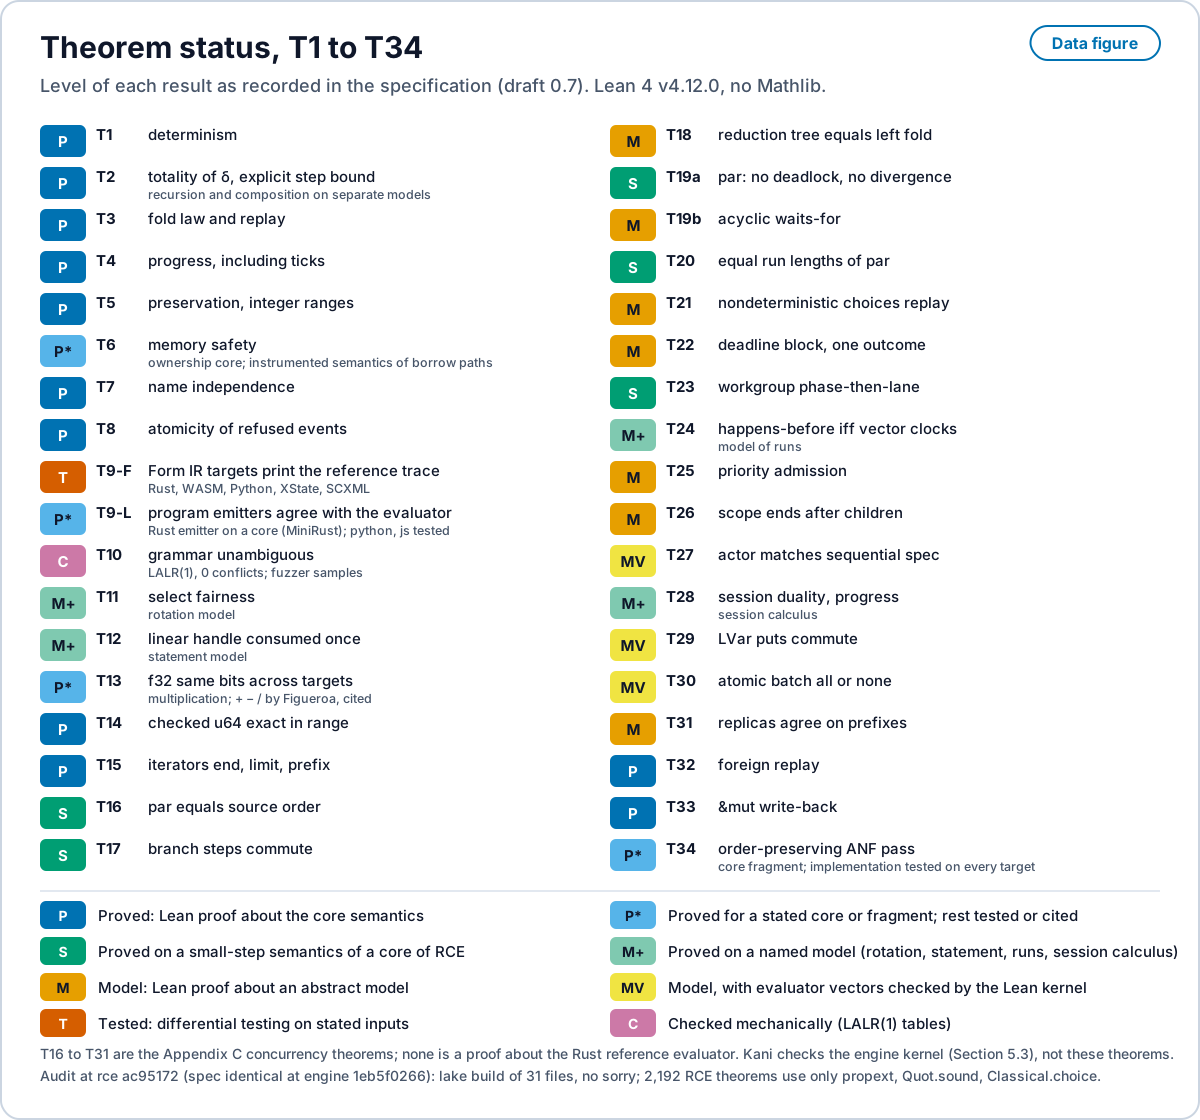
P: मूल सिमेंटिक्स पर लीन प्रमाण। P*: एक बताए गए कोर या खंड के लिए सिद्ध किया गया, बाकी परीक्षणित या उद्धृत। S: RCE के कोर की छोटे-कदम अर्थनीति पर सिद्ध। M+: एक नामित मॉडल (रोटेशन मॉडल, स्टेटमेंट मॉडल, रन का मॉडल, सेशन कैलकुलस) पर सिद्ध। M: अमूर्त मॉडल पर लीन प्रमाण। MV: मॉडल, जिसमें लीन कर्नेल द्वारा जांचे गए संदर्भ मूल्यांकनकर्ता वैक्टर हैं। T: विभेदक परीक्षण। C: यांत्रिक रूप से जाँचा गया है। T16 से T31 संस्करण 0.6 के संबंधित हैं, और कोई भी रस्ट संदर्भ मूल्यांकक पर प्रमाण नहीं है। लीन 4 v4.12.0, बिना Mathlib। स्रोत: spec/book/10-theorems.md और परिशिष्ट C.13। एक PNG प्रति प्रदान किया गया। Open full size · PNG
इस संस्करण के लिए चलाई गई जाँचें। इंजन कमिट 1eb5f02 पर, lake build spec/lean/RCE/ की 31 फ़ाइलों पर बिना किसी sorry के पूरा होता है (सार्वजनिक 4304048 पर 46 फ़ाइलें, e416fd0 पर 58), और स्थायी ऑडिट 2,192 प्रमेय स्थिरांकों (ऑडिट हर कर्नेल प्रमेय स्थिरांक गिनता है; ऊपर सुधार टिप्पणी देखें) के अभिगृहीतों को केवल propext, Quot.sound और Classical.choice बताता है। Kani 10 में से 10 कर्नेल हार्नेस सत्यापित करता है (§5.3)। इंजन परीक्षण (cargo test --release) 589 विशिष्ट परीक्षण 0 विफलताओं के साथ पास करते हैं (2 अनदेखे); make check 596 रिपोर्ट करता है क्योंकि इसका प्रमाण चरण उनमें से 7 परीक्षण दूसरी बार चलाता है। संदर्भ चेकर, सार्वजनिक रिपॉजिटरी से उसी तरह बनाया गया जैसे उसका निरंतर एकीकरण उसे बनाता है, डिफ़ॉल्ट बिल्ड में 56 परीक्षण और संस्करण 0.6 और 0.7 के सूट सक्षम होने पर 112 परीक्षण 0 विफलताओं के साथ पास करता है, और tree-sitter सहमति परीक्षण के साथ 57। विनिर्देश जाँच संस्करण 0.5 की और संस्करण 0.6 और 0.7 की, जो एक व्याकरण साझा करते हैं, LALR(1) तालिकाएँ 0 संघर्षों के साथ बनाती है और हर उदाहरण को तीन पार्सरों से पार्स करती है, और चेकर का WebAssembly बिल्ड उदाहरण कॉर्पोरा के विरुद्ध 401 में से 401 जाँचें पास करता है।
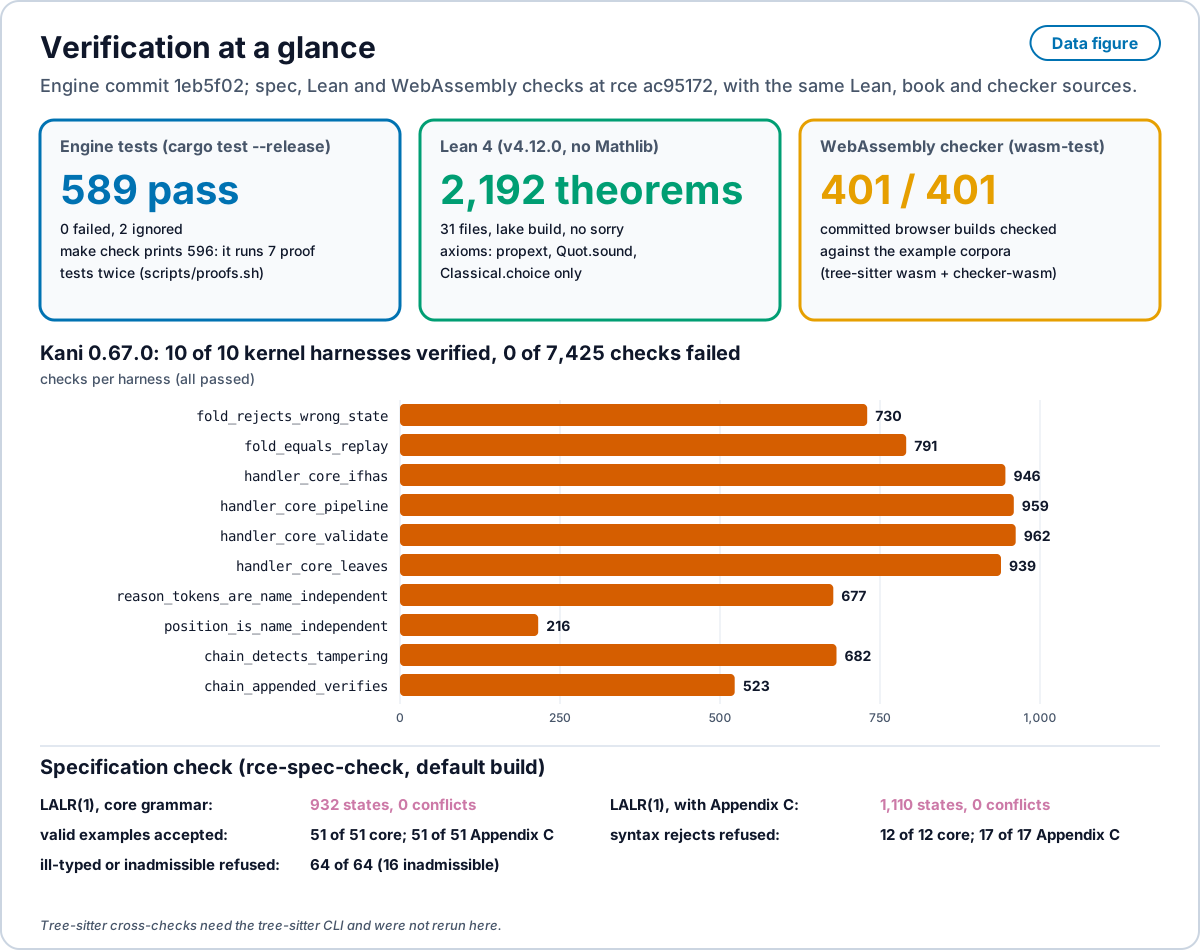
1eb5f02। डेटा आकृति। इंजन परीक्षण (cargo test --release): 589 पास, 0 विफल, 2 अनदेखे; make check 596 रिपोर्ट करता है क्योंकि यह 7 प्रमाण परीक्षण दो बार चलाता है। Lean 4: spec/lean/RCE/ की 31 फ़ाइलों पर बिना किसी sorry के lake build; ऑडिट 2,192 प्रमेय स्थिरांक रिपोर्ट करता है (ऑडिट गणना, स्रोत घोषणाएँ नहीं) जिनके अभिगृहीत केवल propext, Quot.sound और Classical.choice हैं। Kani 0.67.0 10 में से 10 कर्नेल हार्नेस सत्यापित करता है, 7,425 में से 0 जाँचें विफल (बार: प्रति हार्नेस जाँचें)। चेकर का WebAssembly बिल्ड उदाहरण कॉर्पोरा के विरुद्ध 401 में से 401 जाँचें पास करता है। विनिर्देश जाँच संस्करण 0.5 (932 अवस्थाएँ) और संस्करण 0.6 और 0.7 (1,110 अवस्थाएँ) के लिए 0 संघर्षों वाली LALR(1) तालिकाएँ बनाती है, 51 में से 51 वैध उदाहरण स्वीकार करती है और 12 में से 12 सिंटैक्स अस्वीकृतियाँ और 64 में से 64 गलत टाइप वाले या अस्वीकार्य प्रोग्राम अस्वीकार करती है। Lean, WebAssembly और विनिर्देश जाँचें सार्वजनिक रिपॉजिटरी पर ac95172 पर चलाई गईं, जिसके विनिर्देश स्रोत इंजन के स्रोतों के समान हैं। एक PNG प्रतिलिपि प्रदान की गई है। Open full size · PNG
एक अभिसरण अवलोकन। agentlanguages.dev पर 13 अक्टूबर 2026 को पढ़ा गया कैटलॉग AI एजेंटों के लिए कोड लिखने हेतु डिज़ाइन की गई 42 भाषाओं को सूचीबद्ध करता है, जिसे इसके संपादकों द्वारा एक सिंटैक्टिक कैंप, सत्यापन कैंप और ऑर्केस्ट्रेशन कैंप में समूहीकृत किया गया है। इस शोधपत्र में कई डिजाइन विकल्प, जैसे यांत्रिक रूप से जाँचे गए अनुबंध (mechanically checked contracts), हैश-श्रृंखला लॉग्स (hash-chained logs), नियतात्मक रीप्ले (deterministic replay) और प्रति प्रोग्राम एक मानक स्वरूपण (one canonical form per program), स्वतंत्र रूप से विकसित अन्य परियोजनाओं के विवरण में दिखाई देते हैं। यह अवलोकन है कि ये विकल्प बार-बार आते हैं। यह प्रमाण नहीं है कि वे सही हैं, और इस शोधपत्र का उन परियोजनाओं के साथ कोई तुलना नहीं करता है।
4. इंजन: गियर, द्वार और रसीदें
4.1 इंजन एक Form है
RCE सॉफ्टवेयर को छोटे नियतात्मक हैंडलर के ग्राफ के रूप में चलाता है। एक हैंडलर जो निर्णय नहीं ले सकता वह एक एस्केलेशन उठाता है। एक रिज़ॉल्वर इस एस्केलेशन का उत्तर एक बार देता है, और जवाब को स्थायी हैंडलर के रूप में स्थापित किया जाता है, इसलिए उसी आकार का अगला मामला बिना किसी रिज़ॉल्वर के चलता है। इंजन हर Form अपरिवर्तनीय (invariant) को पूरा करता है, जिसकी जाँच tests/form_laws.rs में नाम दिए गए परीक्षण द्वारा की जाती है:
| अपरिवर्तनीयता | इंजन क्या करता है |
|---|---|
| रीलोड एक सत्यापित फोल्ड है | रीड लॉग को शब्दशः पढ़ता है, हर हैश और लिंक की पुनर्गणना करता है, और बाकी के साथ मोड़ देता है। कुछ भी पुनः मुहरबंद नहीं होता है। टूटी हुई श्रृंखला लोड करने से इनकार करती है। |
| नाम-मुक्त टिक क्रम | हैंडलर टोपोलॉजिकल रैंक ऑर्डर में चलते हैं, फिर एक नाम-मुक्त नोड कुंजी द्वारा। आउटपुट स्टेज किए जाते हैं और सभी हैंडलर चलने के बाद वितरित होते हैं, जैसा कि ASM अर्थशास्त्र में होता है। हर नोड का पुनर्नाम करना प्रत्येक प्रवेश पर समान गुमनाम स्थिति हैश देता है। |
| कोई साइलेंट ड्रॉप नहीं | एक पूर्ण मेलबॉक्स संदेश को एक क्रमबद्ध कतार में रखता है और Backpressure लॉग करता है। क्षमता 1 और 10 कार्यों के साथ, 9 Backpressure प्रविष्टियाँ दर्ज की जाती हैं और सभी 10 कार्य बंद हो जाते हैं। |
| पेलोड लॉग में होते हैं | इनपुट, टिक, बाहरी हैंडलर परिणाम, इंस्टॉलेशन और दोष लॉग प्रविष्टि होती है। हर प्रवेश के बाद स्थिति का हैश एक खाली इंजन से फोल्ड से मेल खाता है, 1,000 यादृच्छिक लॉग पर। |
| तार्किक घड़ी | जीवंतता समय टिकटों की गणना करती है, न कि दीवार समय की। |
| स्थिर हैश | प्रविष्टियों, राज्यों, आकृतियों और नियम आईडी के लिए कैनोनिकल JSON पर SHA-256 (सिक्योर हैश एल्गोरिथम, 256-बिट), हर गहराई पर कुंजी क्रमबद्ध हैं। |
4.2 गियर
हर गियर तभी आज़माया जाता है जब उसके नीचे का गियर द्वार पार नहीं करता। वह क्रम एक निश्चित कैस्केड है।
| गियर | विधि | वंश परंपरा |
|---|---|---|
| G0 Lookup | SHA-256 आकार के हैश द्वारा कुंजीकृत एक साझा हैंडलर लाइब्रेरी; कोड मरम्मत के लिए, रैंक किए गए फ़ंक्शनों तक स्थानीयकरण | कोड खोज और पुनर्प्राप्ति [21] |
| G1 नियम | नियतात्मक, गार्ड वाले मरम्मत टेम्पलेट और स्कीमा से व्युत्पन्न वैलिडेटर, प्रत्येक को उत्परिवर्तन संवेदनशीलता के लिए जाँचा गया | PAR, TBar, AVATAR, FixMiner [22, 23, 24, 25]; Coccinelle जैसे कोडमॉड्स [26] |
| G2 संश्लेषण | हैंडलर व्याकरण पर एन्यूमरेशन, सॉल्वर और ई-ग्राफ्स | स्केचिंग, SyGuS, egg [27, 9, 12] |
| G3 से G5 मॉडल | एक टाइप किया गया निर्णय मॉडल, एक स्थानीय छोटा मॉडल, फिर एक दूरस्थ मॉडल, अंत में | मॉडल कैस्केड [28] |
4.3 द्वार
एक उम्मीदवार तभी पदोन्नत होता है जब वह द्वार पार करता है। यह द्वार नोड के दर्ज इनपुट को पुनः चलाता है, एक कवरेज सीमा (घोषित त्रुटि बजट पर तीन का नियम) के साथ नए नमूनों पर उम्मीदवार को छाया में चलाता है, आउटपुट स्कीमा की जाँच करता है और खंड 5 का प्रमाण प्रमाणपत्र मांगता है। अस्वीकृत उम्मीदवार अपने प्रति उदाहरण के साथ लॉग होता है।
4.4 रसीदें
हर पदोन्नति, इनकार, स्थगन और स्थापित करना SHA-256 से जुड़े एक अपेंड-ओनली लॉग में एक उत्परिवर्तन है, इसलिए किसी भी पिछली प्रविष्टि के साथ छेड़छाड़ श्रृंखला तोड़ देती है [29, 30]। प्रत्येक हैंडलर की लागत FGIR की होस्ट लागत तालिका के साथ इंटरप्रेटर ऑपरेशन गणनाओं से निर्धारित होती है, जो flowG का नेटिव-कोड बैकएंड है, और जिस पर est_j लेबल होता है। प्रत्येक फोरमैन कॉल अपनी रसीद लेकर चलता है। एक रसीद गियर, अनुमान की विधि (basis), आज़माए गए उम्मीदवारों और क्या गियर ने वृद्धि को हल किया इसका नाम बताती है। इसके est_j फ़ील्ड की आवश्यकता होती है: यह एक परिमित गैर-ऋणात्मक संख्या या null होता है, और null केवल तभी अनुमत है जब basis unpriced कहता हो, जैसा कि ऊर्जा आंकड़ा रहित मॉडल कॉल के लिए होता है। क्षेत्र गायब होने वाली रसीद पार्स नहीं करती है। अपरिभाषित लागत को कभी भी शून्य पढ़ा नहीं जाता है, इसलिए कुल मिलाकर रसीदों में अपनी मूल्यवान और अपरिभाषी आह्वान अलग से रिपोर्ट करता है, और एक बचत जो किसी अप्रतिबंधित समाधान पर निर्भर करती है उसे अज्ञात के रूप में रिपोर्ट किया जाता है। सीढ़ी चलाने वाले उपनमूने पर पैकेज ऊर्जा काउंटर जोड़ते हैं, जिस पर reported_j लेबल होता है।
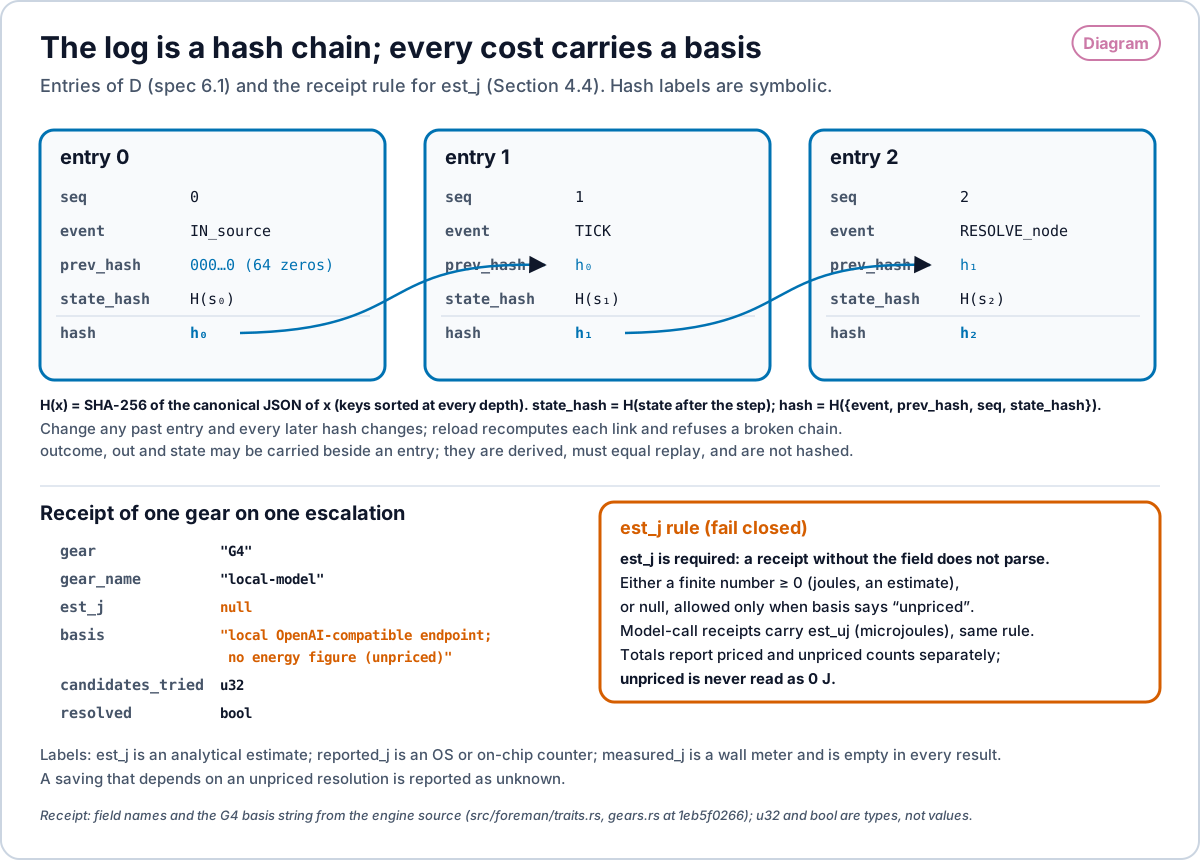
{seq, event, prev_hash, state_hash, hash} हैं। state_hash चरण के बाद स्थिति के मानक JSON का SHA-256 है; hash {event, prev_hash, seq, state_hash} के मानक JSON का SHA-256 है; पहला prev_hash 64 शून्य होता है, इसलिए किसी भी पिछले प्रविष्टि को बदलने से हर बाद वाले hash में बदलाव आता है। एक गियर रसीद में gear, gear_name, est_j, basis, candidates_tried और resolved ले जाती है। est_j आवश्यक है और यह एक परिमित गैर-ऋणात्मक संख्या है, या केवल तभी null होता है जब basis अनप्राइस्ड कहता हो; मॉडल कॉल रसीदें समान नियम के तहत माइक्रोजूल में est_uj ले जाती हैं। एक अप्राइस्ड लागत को कभी भी 0 J नहीं पढ़ा जाता है। hash लेबल प्रतीकात्मक होते हैं। स्रोत: विनिर्देश 6.1 और खंड 4.4। PNG कॉपी प्रदान की गई है। Open full size · PNG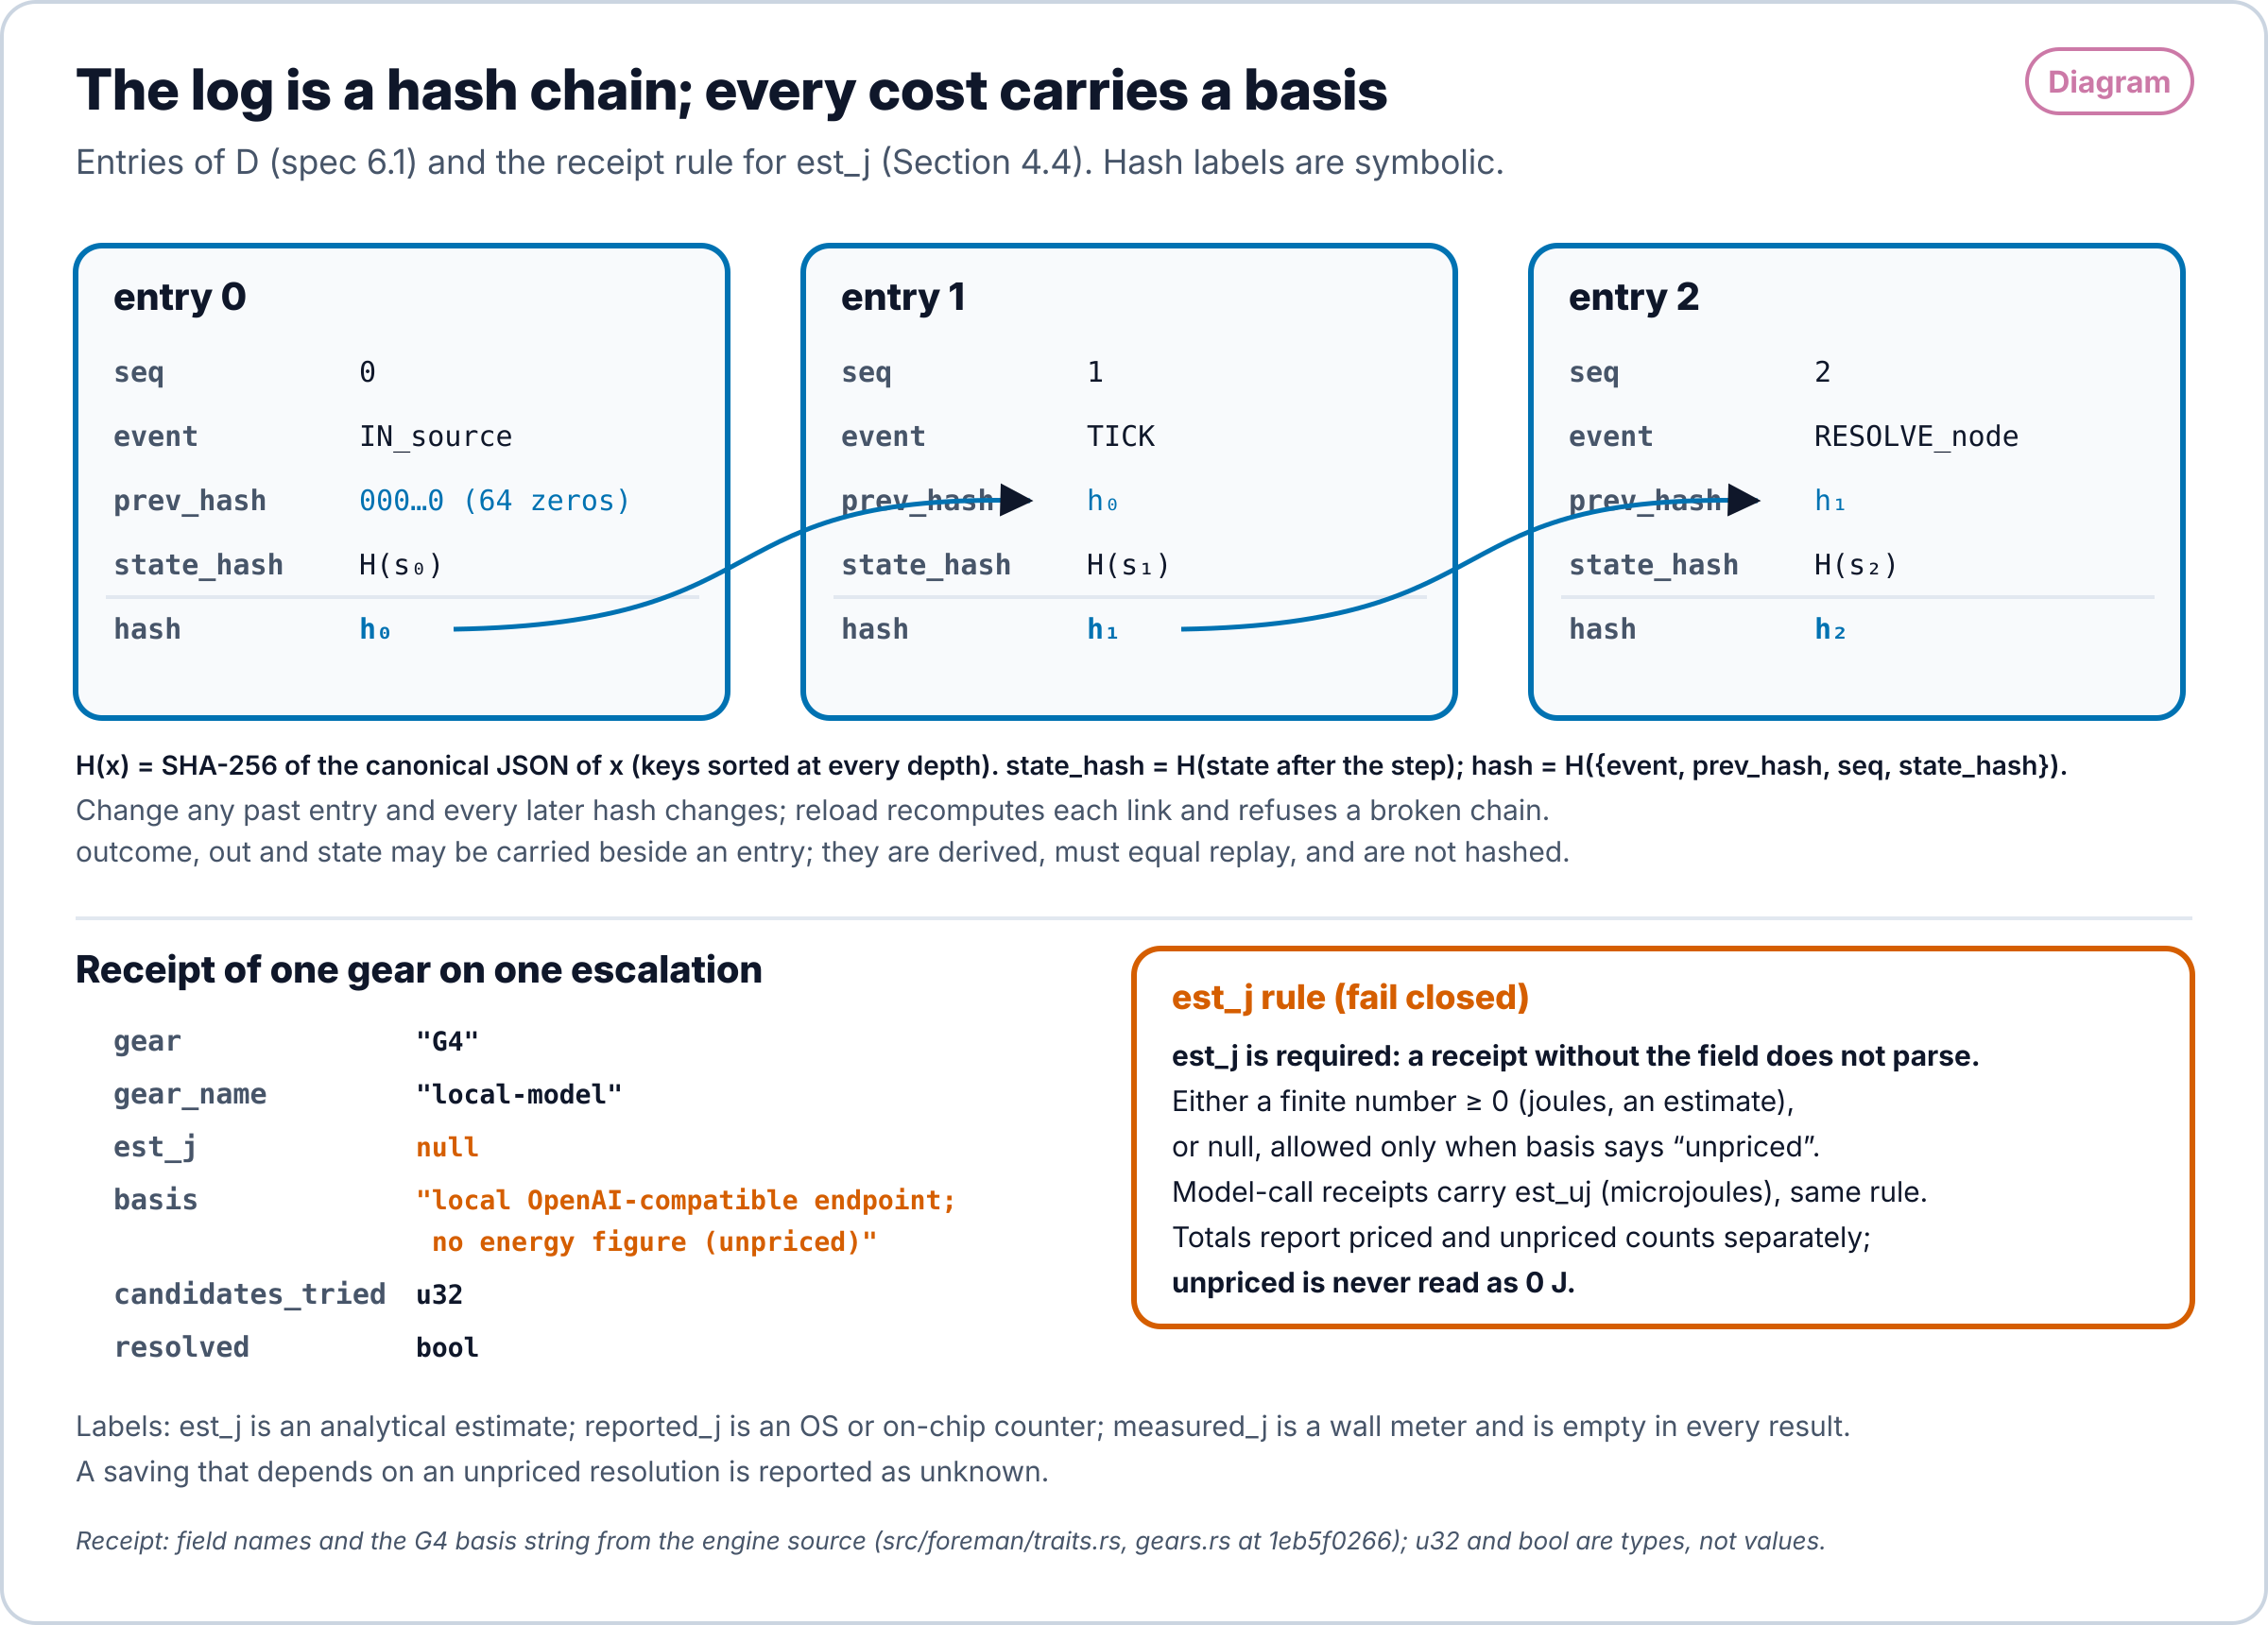
4.5 Form कंपाइलर
rce form एक विनिर्देश और उसके फ़िट को लेता है और एक Form IR से पाँच लक्ष्य उत्सर्जित करता है:
.rce spec + fit
  lower ─► normalize ─► egg e-graph, equality saturation (+ admitted proposals)
  ─► extract (cost = est_j) ─► Form IR (typed relations, regions, rules with SHA-256 ids)
     ├─ Rust crate (pure step, typed state, SHA-256 log and fold, tests)
     │  └─ WASM (the same crate on wasm32-wasip1)
     ├─ Python (standard library only)
     ├─ XState v5 machine
     └─ SCXML document, executed by SCION
IR हर संख्यात्मक किनारे पर एक व्यवहार को ठीक करता है: जाँच किया गया 64-बिट पूर्णांक ओवरफ़्लो एक त्रुटि है और कभी रैप नहीं होता; पूर्णांक / शून्य की ओर ट्रंकेट करता है (); % भाज्य का चिह्न लेता है (); शून्य से विभाजन एक त्रुटि है; फ्लोट IEEE 754 binary64 हैं और एक गैर-परिमित परिणाम एक त्रुटि है; नल और अनुपस्थित अलग हैं; समय केवल तार्किक घड़ी है। हर लक्ष्य उत्पन्न होता है। कोई भी लिखा नहीं जाता है।
एक प्रक्रिया, HTTP या क्लोजर हैंडलर का कोई टर्म नहीं है, इसलिए इसके लॉग किए गए परिणाम एक रिकॉर्डेड ऑरेकल में संकलित होते हैं जो कैनोनिकल इनपुट के SHA-256 द्वारा कुंजीकृत होता है। rce scan DIR --form मौजूदा Rust, Python, TypeScript और Go को Form की स्कीमा में लिफ़्ट करता है, और प्रत्येक लिफ्ट किया गया तत्व एक सिंटैक्टिक लिफ़ट के रूप में लेबल किया जाता है।
4.6 विधि: पूरा stack मूल्यांकित, हर interface धारणा स्पष्ट
एक प्रोग्राम स्तरों का एक स्टैक है: टोकन और कथन; हैंडलर; Form, जो पर नामक एकल चरण फ़ंक्शन (नियंत्रण क्षेत्र; डेटा: घड़ी, इनपुट गणना और टाइप किए गए संबंध); लॉग, एक SHA-256 हैश श्रृंखला जिसकी प्रविष्टियाँ प्रत्येक घटना को रिकॉर्ड करती हैं, जो उसके द्वारा उत्पादित स्थिति का हैश और पिछली प्रविष्टि का हैश होती हैं; वे पुनर्लेखन जो Form को रूपांतरित करते हैं; और वह सबस्ट्रेट जो इसे निष्पादित करता है। प्रत्येक स्तर नीचे के स्तरों के बारे में धारणाओं पर टिका होता है। RCE किसी भी स्तर को स्थिर नहीं मानता। यह पूरे स्टैक का मूल्यांकन करता है, हर इंटरफ़ेस धारणा को एक जाँचने योग्य कथन के रूप में लिखता है, और हर रन पर इसकी जाँच करता है।
| सीमा | धारणा | जाँच |
|---|---|---|
| source से handler | इनपुट अपने स्रोत अनुबंध (source contract) को पूरा करता है | δ की इनपुट घटना पर अनुबंध जाँच |
| handler से sink | प्रत्येक Ok आउटपुट आउटपुट स्कीमा को पूरा करता है | हैंडलर प्रमाण (verify::handler_proof), Kani द्वारा जाँचे गए कर्नेल मूल्यांकनकर्ता द्वारा पूर्ण और नियतात्मक |
| log से state | हर प्रविष्टि उस स्थिति का हैश रखती है जो उसने उत्पन्न किया | कर्नेल फोल्ड, जो पहली ऐसी प्रविष्टि को अस्वीकार करता है जिसका हैश मेल नहीं खाता (Kani harness fold_rejects_wrong_state) |
| पुनर्लेखन से Form | पुनर्लेखन प्रत्येक इनपुट के लिए आउटपुट बनाए रखता है | यादृच्छिक जाँच, फिर Z3 के साथ SMT प्रमाण |
| stub से foreman | जो हैंडलर निर्णय नहीं ले सकता वह अनुमान लगाने के बजाय एस्केलेट करता है | स्टब हैंडलर एस्केलेशन उत्सर्जित करते हैं; समाधान केवल पदोन्नति मार्ग (promotion path) से उन्नत होते हैं |
| Form से target | प्रत्येक उत्सर्जित लक्ष्य वही δ गणना करता है | हर लक्ष्य वही संदर्भ ट्रेस रखता है |
एक विफल जाँच टूटन को उसी सीमा पर स्थित करती है जहाँ वह होती है। सुधार उसी स्तर पर किया जाता है, उस सीमा की जाँच से पास कराया जाता है, और उन्नत (promote) होता है। सुधारे गए स्तर के ऊपर का प्रत्येक स्तर बिना किसी अन्य परिवर्तन के सुधार विरासत में पाता है, क्योंकि हर ऊपरी स्तर केवल उस इंटरफ़ेस का उपयोग करता है जिसकी धारणा अब जाँची जाती है। इसी अर्थ में सुधार ऊपर की ओर ले जाए जाते हैं और चक्रवृद्धि होते हैं। RCE इंजन डेमो इसे ब्राउज़र में WebAssembly में संकलित RCE कोर पर चलाता है: इसकी Interfaces परत हर धारणा को तोड़ती है और वह जाँच दिखाती है जो उसे पकड़ती है, और इसकी Compounding परत सुधार को हर बाद के दौर में आगे जाते हुए दिखाती है।
5. सत्यापन
5.1 पाँच targets पर differential परीक्षण
tests/form_targets.rs ग्यारह ऑपरेटरों वाले एक अंकगणितीय विनिर्देश को 29 किनारे की घटनाओं और 500 बीजंकित यादृच्छिक किनारे के मानों से चलाता है। उत्पन्न Rust, Python, WASM, XState और SCXML लक्ष्य संदर्भ ट्रेस को बाइट दर बाइट छापते हैं, जिसमें अंकगणितीय किनारे शामिल हैं। यह McKeeman और Csmith [86] की परंपरा में विभेदक परीक्षण है: एक बताए गए इनपुट समुच्चय पर स्वतंत्र कार्यान्वयनों के बीच सहमति। यह अनुवाद सत्यापन [85] नहीं है और न ही सत्यापित कंपाइलर है। यह टेस्ट में ग्यारह ऑपरेटरों और 529 घटनाओं को कवर करता है, और इसके बाहर के इनपुट्स के बारे में कुछ नहीं कहता। नीचे दिए गए Z3 और Kani परिणाम सत्यापन हैं।
आकृति 11 एक Form के पाँच प्रक्षेपण और दोनों statechart लक्ष्यों का राउंड ट्रिप दिखाता है।
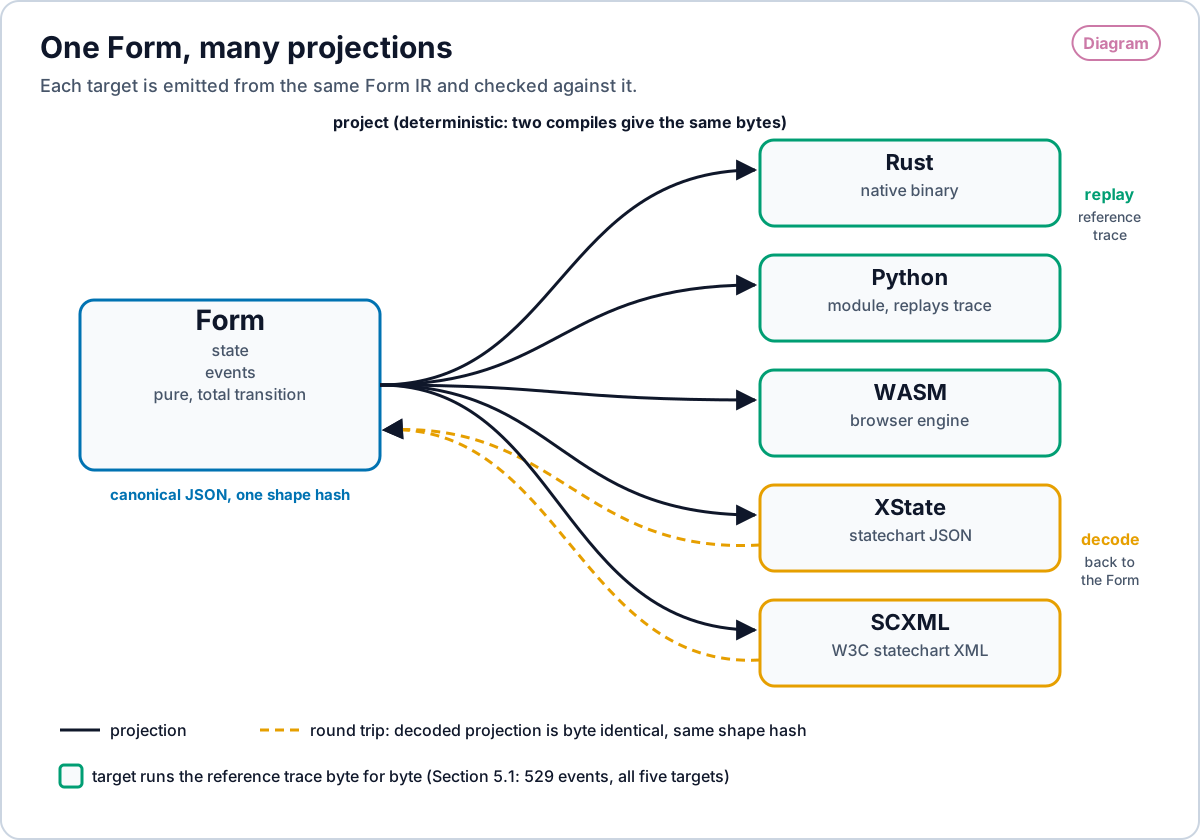
tests/form_targets.rs की 529 घटनाओं पर संदर्भ ट्रेस को बाइट दर बाइट प्रिंट करते हैं। एक PNG प्रतिलिपि प्रदान किया गया है। Open full size · PNG
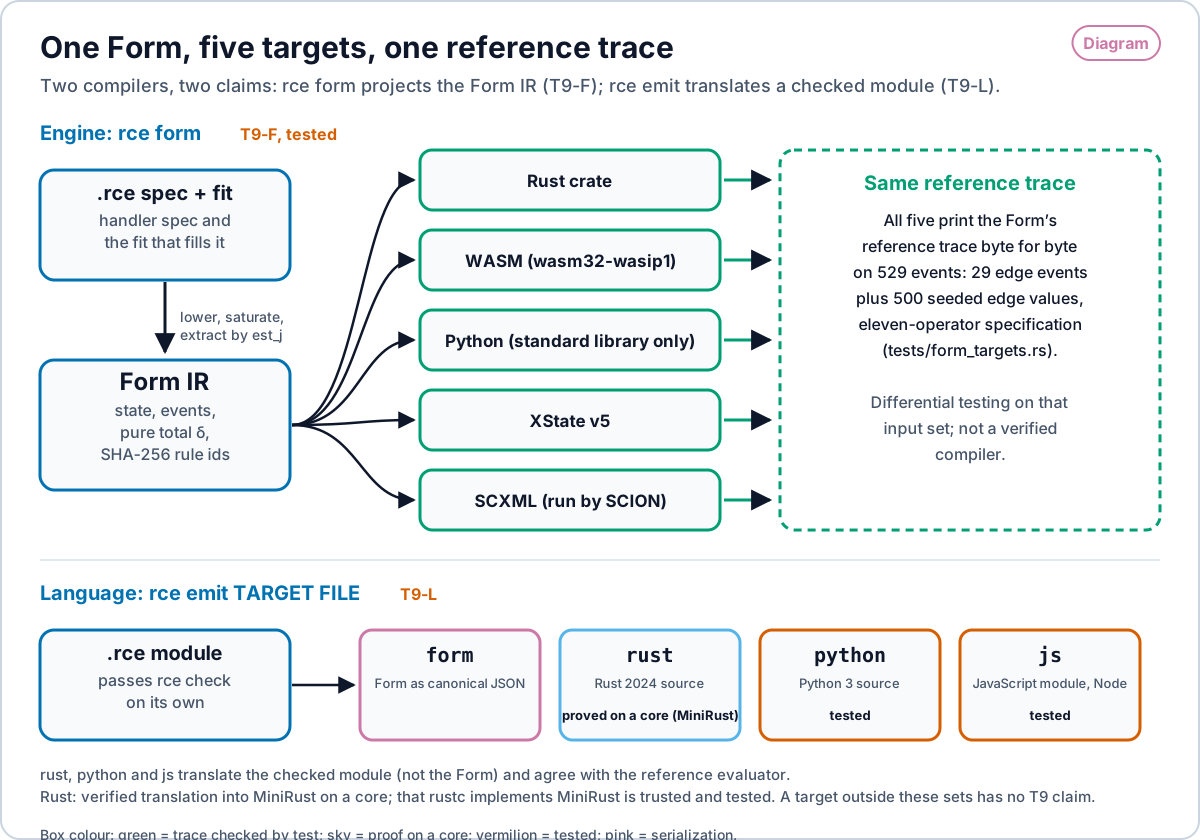
rce form एक हैंडलर विनिर्देश और इसका Form IR के साथ फ़िट को कम करता है और इसे एक Rust क्रेट, WASM, Python, XState v5 और SCXML में प्रक्षेपित करता है; सभी पाँच 529 घटनाओं पर बाइट दर बाइट संदर्भ ट्रेस प्रिंट करते हैं (एक ग्यारह-ऑपरेटर विनिर्देश के 29 एज इवेंट प्लस 500 सीडेड एज मानों का tests/form_targets.rs)। यह T9-F है, जो विभेदक परीक्षण द्वारा स्थापित किया गया है, न कि एक सत्यापित कंपाइलर। नीचे: rce emit TARGET FILE एक जाँचे गए मॉड्यूल (Form नहीं) को form JSON, rust, python या js में अनुवाद करता है; T9-L कोर पर MiniRust में एक सत्यापित अनुवाद के रूप में Rust उत्सर्जक के लिए सिद्ध किया गया है (कि rustc द्वारा Minirust लागू करना विश्वसनीय और परीक्षण किया जाता है), और अन्य के लिए परीक्षण किया गया। PNG कॉपी प्रदान की गई है। Open full size · PNG
5.2 Z3 में सिद्ध पुनर्लेखन
सत्यापित पुनर्लेखन नियमों की एक परंपरा है। Ruler बिना किसी मॉडल के समानता संतृप्ति से पुनर्लेखन नियम निकालता और जाँचता है [87]। इसलिए खंड 5.5 में स्वीकृत, मॉडल द्वारा प्रस्तावित 16 में से 3 नियम द्वार के बारे में एक कथन हैं, जिसने 13 को अस्वीकार किया, यह दावा नहीं कि कोई मॉडल सर्वश्रेष्ठ नियम स्रोत है।
हर अंतर्निर्मित e-graph पुनर्लेखन Z3 SMT सॉल्वर (सैटीस्फाइबिलिटी मॉड्युलो थ्योरीज़) [31] में Form के पद मूल्यांकन और अंकगणित के क्वांटिफायर मुक्त एन्कोडिंग के विरुद्ध सिद्ध किया जाता है: मान एक डेटाटाइप के रूप में, जाँच किए गए ओवरफ़्लो वाले 64-बिट बिट-वेक्टर, भाज्य के चिह्न वाला हस्ताक्षरित विभाजन और शेषफल, और binary64 फ्लोट। कोई पुनर्लेखन जो ओवरफ़्लो, एस्केलेशन क्रम या किसी संदेश को बदलता है, उसे प्रमाण नहीं मिलता। एक प्रस्तावित तुल्यता केवल प्रमाण के साथ e-graph में प्रवेश करती है।
5.3 kernel के Kani प्रमाण
इंजन का कर्नेल (हैश शृंखला, फोल्ड, नाम-मुक्त स्थितियाँ और हैंडलर मूल्यांकन) Rust के लिए Kani मॉडल चेकर से जाँचा जाता है [32]। हैंडलर मूल्यांकन एक गैर-पुनरावर्ती कदम का निश्चित बिंदु होता है, और Kani संरचनात्मक आगमन द्वारा सिद्ध करता है कि वह कदम प्रत्येक कंस्ट्रक्टर पर कुल (total) और नियतात्मक है। दस हार्नेस को Kani 0.67.0 के साथ सत्यापित किया गया है, जिसमें 7,425 जाँचों में से 0 विफल हैं:
| Harness | गुणधर्म |
|---|---|
chain_appended_verifies | एक जोड़ा गई हैश शृंखला सत्यापित करती है |
chain_detects_tampering | बदली हुई प्रविष्टि श्रृंखला को तोड़ती है |
fold_equals_replay | फोल्ड रीप्ले के बराबर होता है |
fold_rejects_wrong_state | एक ऐसा फोल्ड जो संग्रहीत अवस्था से असहमत हो, उसे अस्वीकार किया जाता है |
position_is_name_independent | नियम स्थितियाँ नोड नामों पर निर्भर नहीं करतीं |
reason_tokens_are_name_independent | कारण पूरे टोकन द्वारा नाम-मुक्त होते हैं |
handler_core_leaves | पत्ती हैंडलर कुल और नियतात्मक होते हैं |
handler_core_validate | सत्यापन कुल और नियतात्मक होता है |
handler_core_pipeline | पाइपलाइनें कुल और नियतात्मक होती हैं |
handler_core_ifhas | गार्ड्स कुल और नियतात्मक होते हैं |
5.4 प्रमाण प्रमाणपत्र पर पदोन्नति द्वार
Kani रन एक प्रमाण पत्र लिखता है जिसका हैश proofs/kani.cert में संग्रहीत होता है। इंजन, लॉग, नियम आईडी और हैंडलर मूल्यांकन सिद्ध कर्नेल से होकर गुजरते हैं, और पदोन्नति के लिए प्रमाणपत्र आवश्यक है।
5.5 जाँच के पीछे प्रस्तावक के रूप में मॉडल
एक मॉडल तुल्यताएँ प्रस्तावित कर सकता है। वह उन्हें स्वीकार नहीं कर सकता। प्रदर्शन विनिर्देश पर एक स्थानीय 1.5 अरब पैरामीटर वाले कोडिंग मॉडल (llama.cpp के अंतर्गत Qwen2.5-Coder-1.5B) के साथ, प्रस्तावक ने 16 तुल्यताएँ दीं। जाँच ने यादृच्छिक परीक्षणों और एक Z3 प्रमाण से 3 स्वीकार किए, और 13 अस्वीकार किए। 87 परिचित सर्वसमिकाओं वाले एक नियतात्मक प्रस्तावक की, जिसमें 77 अंकगणितीय और 10 संरचनात्मक थीं, में से 9 स्वीकृत हुए, सभी संरचनात्मक थे, और 78 अस्वीकृत: प्रत्येक अंकगणितीय सर्वसमिका, दोष क्रम (fault order), गैर-संख्याओं या ओवरफ़्लो के कारण, और एक संरचनात्मक पुनर्लेखन, const-absorbs-pipe, जो एक बढ़ते उपसर्ग को गिरा देगा (इंजन परीक्षण tests/form_proposers.rs)।
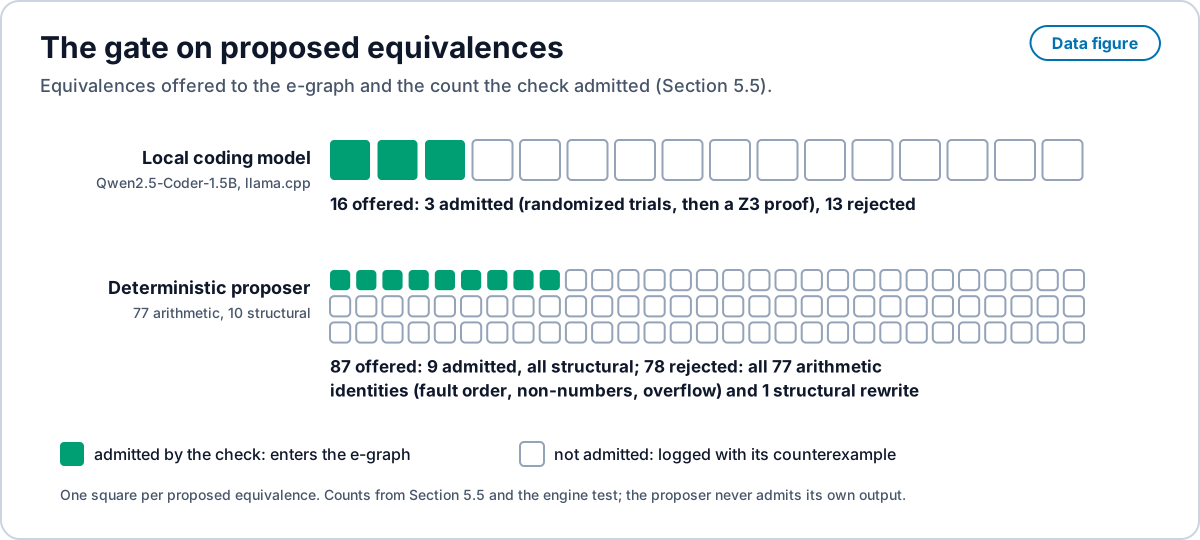
tests/form_proposers.rs से नियतात्मक गणनाएँ। PNG प्रतिलिपि प्रदान की गई है। Open full size · PNG
5.6 Brownfield सहमति
लिफ़्ट रस्ट, पायथन, टाइपस्क्रिप्ट और गो फिक्स्चर से उसी क्रम के मशीन को पढ़ता है, मूल कोड पर 30 कॉल के 40 सीडेड अनुक्रमों पर चलाता है, और प्रति भाषा सभी 1,200 कॉलों पर सहमत होता है। एक स्थिर बेंचमार्क, किसी भी परिणाम से पहले पूर्व-पंजीकृत होकर, तीन मौजूदा बिक्री आउटरीच कार्यक्रमों को Forms के रूप में फिर से व्यक्त करता है। फॉर्म्स रिकॉर्ड किए गए 4,500 इनपुट में से 4,500 पर मूल कोड से सहमत होते हैं, और निष्कर्षण प्रत्येक पर est_j घटाता है (उदाहरण के लिए J से J)।
6. लिफ़्ट: अन्य भाषाओं से पारिस्थितिकी तंत्र में प्रवेश
लिफ़्ट कहीं और लिखे गए कोड के लिए पारिस्थितिकी तंत्र का प्रवेश द्वार है। यह एक निर्माण है, जो हर भाषा के लिए उन्हीं उपकरणों से बनाया जाता है जो हर भाषा के पास पहले से हैं: एक औपचारिक व्याकरण, tree-sitter जैसा पार्सर जो उसका सिंटैक्स ट्री बनाता है, एब्स्ट्रैक्ट सिंटैक्स ट्री और वे प्रतीक जिन्हें लैंग्वेज सर्वर टूलींग हल करता है (Language Server Protocol)। rce scan DIR --form रस्ट, पायथन, टाइपस्क्रिप्ट और गो के लिए उस पेड़ से Form बनाता है (§4.5, §5.6)। एक लिफ़्ट किया गया प्रोग्राम अपने स्रोत की दोष विरासत में लाता है, इसलिए लिफ़्ट में मरम्मत शामिल है, जिसे नीचे दिए गए स्थान वाले सार्वजनिक बग कॉर्पोरा पर मापा गया है; पारिस्थितिकी तंत्र के भीतर ये दोष लिखे नहीं जा सकते हैं।
6.0 लिफ़्ट किए गए कोड पर मरम्मत की सीढ़ी
एक कोडिंग कार्य यहाँ आवश्यक इरादा बिट्स द्वारा मापा जाता है: वे बिट जो इंजन के पास पहले से मौजूद चीज़ों (संपादित करने वाले प्रोग्राम, पुस्तकालयें, परीक्षण, ज्ञात सुधार का सूचकांक) से बाहर आपूर्ति किए जाने चाहिए। लक्ष्य कलाकृति को निश्चित करने वाले बिट्स के लिए और कॉर्पस द्वारा पहले ही ठीक की गई बिट्स के लिए , प्रदान किए गए बिट्स हैं । एक गियर जो अपने उम्मीदवारों में रैंक पर सही संपादन को रैंक करता है, ने खोज का बिट आपूर्ति किया है, और द्वार बाकी की आपूर्ति करता है। सीढ़ी कार्यों को संपादित आकार द्वारा क्रमबद्ध करती है, जो के लिए उद्देश्य प्रॉक्सी है: एक टोकन (L0), एक कथन (L1), एक हंक (L2), एक फ़ाइल में कई हंक्स (L3), कई फाइलें (L4), विनिर्देश या परीक्षण से एक कार्य (L5), एक मुद्दे-स्तर का परिवर्तन (L6) और एक विनिर्देश से प्रोग्राम (L7)। पायदान, कॉर्पोरा, विभाजन और परिकल्पनाएँ पूर्ण रनों से पहले पंजीकृत की गईं; फ़ाइलें सार्वजनिक भंडार में हैं।
| पायदान | अलग रखा गया परीक्षण कॉर्पस | N | हल किया गया | दर | विल्सन 95% सीआई | माध्य खोज बिट्स | मॉडल कॉल |
|---|---|---|---|---|---|---|---|
| L0 एक टोकन | पिन किए गए कमिट पर 9 वास्तविक रिपॉजिटरी के PIT-शैली उत्परिवर्तित [109] (जावा: commons-math, commons-collections, jsoup, joda-time, gson; पायथन: click, attrs, pydantic, sympy) | 520,821 | 520,541 | 0.9995 | 0.9994 से 0.9995 | 2.3 | 0 |
| L0 एक टोकन, रिपॉजिटरी कभी ट्यून नहीं की गईं | commons-text, commons-io, more-itertools, httpx | 23,015 | 23,015 | 1.0000 | 0.9998 से 1.0000 | 2.0 | 0 |
| L1 एक कथन, जावा | ManySStuBs4J 2.0 एकल-हंक फिक्स [107] | 24,072 | 9,288 | 0.386 | 0.380 से 0.392 | 3.5 | 0 |
| L1 एक कथन, जावा, पूर्ण फ़ाइल | ManySStuBs4J 2.0 [107], परियोजना विधि और गार्ड इंडेक्स के साथ पैरेंट-कमिट फ़ाइल | 21,320 | 13,586 | 0.637 | 0.631 से 0.644 | 4.8 | 0 |
| L1 एक कथन, पायथन | TSSB-3M v1.0.0, शार्ड 14 और 15 [108] | 157,089 | 27,266 | 0.174 | 0.172 से 0.175 | 4.8 | 0 |
आकृति 14 तालिका की पंक्तियों को उनके अंतराल के साथ प्लॉट करती है।
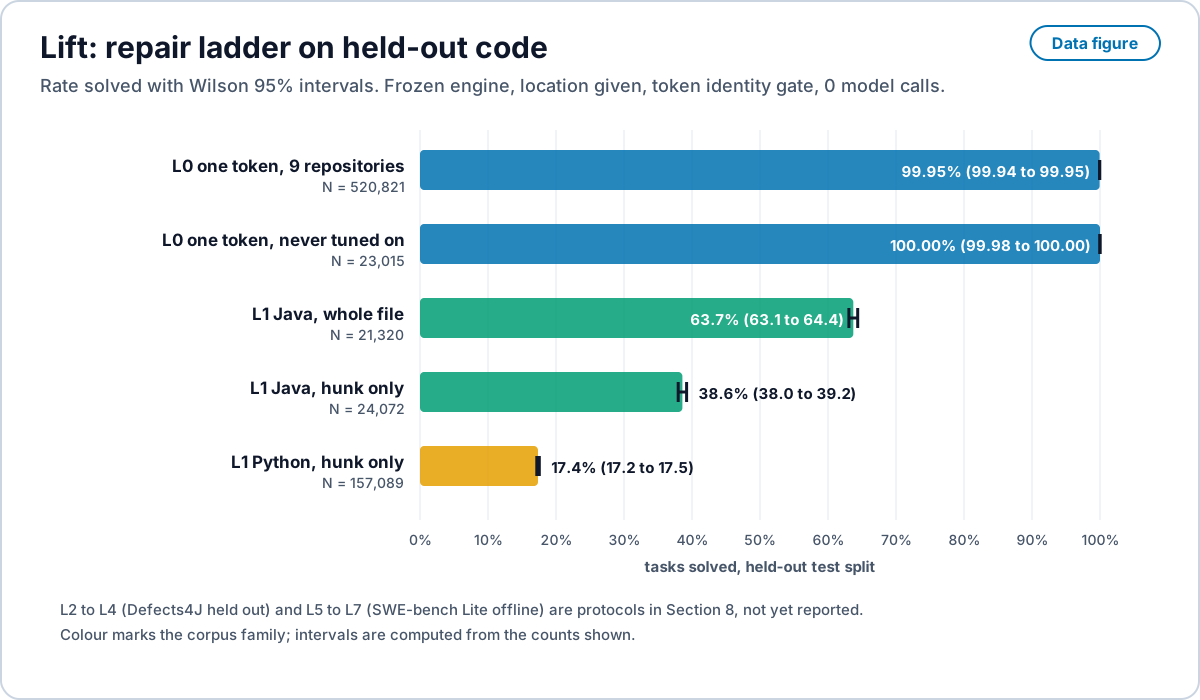
bench/ladder में प्रति कार्य पंक्तियाँ। एक पीएनजी कॉपी प्रदान की गई है। Open full size · PNG
एल2 से एल4 को 288 बगों के Defects4J अलग रखे गए सेट पर मापा गया (खंड 8.1)। एल5 से एल7 खंड 8.2 की प्रोटोकॉल का पालन करते हैं। विधि, द्वार और प्रत्येक पंक्ति की ऊर्जा निम्नलिखित है।
खुला मुद्दा: एक-टोकन दर के लिए आधार रेखा। L0 पंक्तियाँ मापती हैं कि एक पूर्व-क्रमित एकल-टोकन पड़ोस कितनी बार एक-टोकन उत्परिवर्ती को पुनर्स्थापित करता है। यदि पड़ोस उन्हीं ऑपरेटर तालिकाओं से बनाया गया है जिनसे उत्परिवर्ती बने, तो ऊँची दर आंशिक रूप से उस अतिव्यापन को दर्शाती है, न कि व्यवहार में उत्पन्न होने वाले दोषों पर मरम्मत की क्षमता को। शोधपत्र इस युग्मन जोखिम का उल्लेख करता है और इसके लिए कोई संख्या नहीं देता। उन्हीं उत्परिवर्तियों पर चलाई गई एक सादी ऑपरेटर-व्युत्क्रम खोज वह आधार रेखा है जो दिखाएगी कि दर का कितना हिस्सा वह समझाती है। वह आधार रेखा नहीं चलाई गई है, इसलिए यहाँ कोई आँकड़ा नहीं दिया गया है और एक-टोकन दर इस आपत्ति के प्रति खुली है।
दरें मंशा बिट्स के रूप में पढ़ी जाती हैं। L0 पर लापता बिट लगभग पूरी तरह से लाइन पर होते हैं, और एक पूर्व-क्रमित एकल-टोकन पड़ोस उन्हें 2.3 बिटों की माध्यिका में प्रदान करता है। केवल हंक वाली L1 पंक्ति पर इंजन को केवल 7-लाइन का हंक दिखाई देता है। यह उन श्रेणियों को बंद कर देता है जिनके बिट्स हंक के अंदर हैं (जावा: बदला हुआ ऑपरेटर 91%, स्वैप्ड बूलियन लिटरल 84%, स्वैप्ड आर्गुमेंट्स 82%; पायथन: बदला हुआ बूलियन लिटरल 98.8%, स्वैप्ड आर्गुमेंट्स 99.4%) और उन को खुला छोड़ देता है जिनके बिट्स इसके बाहर हैं: मेथड नाम (22%) और आइडेंटिफायर्स (37%) के लिए फ़ाइल और उसके प्रकारों की आवश्यकता होती है, और नए कंजंक्ट्स (3% से 7%) तथा पूरे-स्टेटमेंट रीराइट्स (पायथन में एक ऐसी श्रेणी का 1.2%, जो कॉर्पस का 34% है) नई मंशा हैं। नई मंशा वह है जिसे कोई आपूर्तिकर्ता (एक विनिर्देश, एक परीक्षण, एक व्यक्ति या एक स्थानीय मॉडल) एक बार प्रदान करता है, जिसके बाद फ़िट इंडेक्स में होता है।
विधि। प्रत्येक कॉर्पस को एक निश्चित बीज के साथ शफल किया जाता है। हर शफल की पहली 2,000 स्थितियाँ और L0 के लिए तीन पूरे रिपॉजिटरी (commons-lang, requests, flask), विकास विभाजन का निर्माण करते हैं जिस पर गियर ट्यून किए जा सकते हैं; विकास परिणाम रिपोर्ट नहीं किए जाते हैं। प्रत्येक शेष कार्य परीक्षण विभाजन में है। एक परीक्षण रन से पहले इंजन को कमिट किया जाता है और इसका बाइनरी हैश रिकॉर्ड किया जाता है, और दौड़ के दौरान कोई भी गियर परिवर्तन नहीं होता है। इस खंड की हर पंक्ति केवल टेस्ट कार्यों पर स्थिर-इंजन परिणाम होती है, जिसमें 0 मॉडल कॉल होते हैं। प्रीरजिस्ट्रेशन (PREREG.json), प्रति कार्य पंक्तियाँ और रिपोर्ट स्क्रिप्ट सार्वजनिक रिपॉजिटरी में है।
द्वार। एल0 और एल1 पर स्थान दिया गया है और द्वार टोकन पहचान होता है: मरम्मत की गई पंक्ति या कथन को डेवलपर के, टोकन से टोकन बराबर होना चाहिए। यह परीक्षण पास करने से अधिक सख्त है, क्योंकि एक पैच कमजोर टेस्ट सूट पास कर सकता है और फिर भी गलत हो सकता है। क्यूआई और सहयोगियों ने पाया कि अधिकांश पैच जो जेनप्रोग द्वारा फिक्स बताए गए थे वे प्रशंसनीय लेकिन गलत थे [92]; परीक्षणों पर ओवरफिटिंग खोज-आधारित और अर्थविज्ञान-आधारित मरम्मत में प्रलेखित है [93, 94] और उत्पन्न किए गए परीक्षणों से संबोधित किया गया है [95]; उपकरण उन बेंचमार्क पर अधिक स्कोर करते हैं जिन पर उन्हें ट्यून किया जाता था [96]; और दोष का स्थानीयकरण तुलनाओं को पक्षपाती बनाता है [97]। टोकन पहचान इन पायदानों पर प्रशंसनीयता के अंतर को हटा देती है, और स्थान देने से स्थानीयकरण पद हट जाता है, इसलिए दर केवल मरम्मत गियर मापती है। एल2 और उससे ऊपर परीक्षणों का उपयोग द्वार के रूप में करते हैं और क्रमशः प्रशंसनीय और सही गणना रिपोर्ट करते हैं (खंड 8.1)।
6.1 L0: एक token के दोष
L0 कॉर्पस पिन किए गए कमिट्स पर नौ वास्तविक रिपॉज़िटरी में हर PIT-शैली का उत्परिवर्तित (mutant) [109] है, जिसमें एक वैध प्रतिस्थापन टोकन शामिल है: पाँच जावा और चार पायथन के लिए; 547,448 में से 520,821 परीक्षण कार्य। इंजन (कमिट 65571d0, गियर G0-T और G1-J) द्वारा 520,541 को पुनर्स्थापित किया जाता है, दर 0.9995 (95% विल्सन अंतराल 0.9994 से 0.9995), खोज बिट की माध्यिका 2.3 पर। 280 अनसुलझे में से, 108 फ्लोटिंग-पॉइंट लिटरल के अंदर उत्परिवर्तित अंक हैं और 2 पायथन सेट लिटरल के अंदर हैं। एक फ़्लोट-लिटरल गियर (G0-F, कमिट ecfe5a1) को चार रिपॉज़िटरी पर परखा जाता है जिनका ट्यूनिंग में कभी उपयोग नहीं किया गया था (commons-text, commons-io, more-itertools, httpx): 23,015 में से 23,015 कार्य, 1.0000 (0.9998 से 1.0000), खोज बिट की माध्यिका 2.0। उत्परिवर्तित वास्तविक एक-टोकन दोषों का प्रतिनिधित्व करते हैं जिन्हें जस्ट और सहयोगियों ने वास्तविक दोषों के साथ जुड़ा पाया था [110]।
6.2 L1: वास्तविक इतिहासों से एक कथन के बग
L1 खुले स्रोत इतिहासों से निकाले गए वास्तविक एकल कथन बग सुधारों के दो सार्वजनिक डेटासेट का उपयोग करता है। ManySStuBs4J 2.0 [107] द्वारा दिए गए 24,072 जावा परीक्षण कार्य हैं; इंजन (कमिट f2701b7) 9,288 को हल करता है, दर 0.386 (0.380 से 0.392)। TSSB-3M v1.0.0 [108] शार्ड 14 और 15 से 157,089 पायथन परीक्षण कार्य देता है; वही इंजन 27,266 को हल करता है, दर 0.174 (0.172 से 0.175)। इंजन केवल 7-पंक्ति का हंक प्राप्त करता है, इसलिए जावा दर एक हंक-केवल परिणाम है। पैरेंट कमिट पर पूरी फ़ाइल के साथ, परियोजना के तरीकों और गार्ड स्थितियों के सूचकांकों और बदले गए विधि नामों, जोड़े गए तर्क, गार्ड स्थितियों, थ्रो और संशोधकों के गियरों (कमिट 62fb7a0, बाइनरी sha256 उपसर्ग 3682c6515acdf722, रन से पहले पूर्व-पंजीकृत), इंजन उन 21,320 जावा परीक्षण कार्यों में से 13,586 को हल करता है जिनकी फ़ाइल और बग कथन का पता लगाया जा सका था, दर 0.637 (0.631 से 0.644)। श्रेणी के अनुसार यह बदले गए ऑपरेटरों (95.9%), बदले गए ऑपरेटैंड्स (92.1%), गलत कॉलर (87.9%), स्वैप किए गए बूलियन लिटरल (88.4%), हटाए गए तर्क (85.1%) और स्वैप किए गए तर्कों (83.3%) को बंद करता है; बदले गए विधि नाम 61.4% तक पहुँचते हैं और जोड़े गए तर्क 51.4%, तथा नई या संकुचित स्थितियाँ (43.5% और 51.7%) मुख्य खुली मंशा बनी रहती हैं। पूर्ण प्रति-स्ट्रैटम तालिकाएँ भंडार में हैं। इन डेटासेट का इस द्वार के तहत कोई प्रकाशित मरम्मत लीडरबोर्ड नहीं है (केवल हंक, टोकन पहचान, स्थान दिया गया), इसलिए उनके साथ कोई सीखा हुआ-मरम्मत संख्या सेट नहीं की गई; Defects4J, जिसका एक है, को खंड 8.1 में TBar से तुलना किया जाता है।
6.3 ऊर्जा
हर पंक्ति में est_j है, जो CPU सेकंड गुणा 10 W का अनुमान है: L0 पर प्रति हल किए गए कार्य 0.40 J, ताज़ा रिपॉजिटरी पर 0.13, ManySStuBs4J पर 0.10 और TSSB-3M पर 0.27। एक उपनमूना RAPL [105] पर पढ़ा गया, जो प्रोसेसर का ऑन-चिप पैकेज काउंटर है, Intel i9-13900H वाले एक Linux लैपटॉप पर (होस्टनाम jetson-hub; यह NVIDIA Jetson नहीं है)। हार्नेस 4 पिन किए गए CPU पर चला, और reported_j पूरे रन पर पैकेज डेल्टा है, Python ड्राइवर सहित, जिसमें से ठीक पहले लिए गए 10 s के नमूने की निष्क्रिय शक्ति गुणा रन की अवधि घटाई गई है। निरंतर एकीकरण रनर चालू थे, इसलिए निष्क्रिय शक्ति 40 W से 44 W थी और अनिश्चितता लगभग ±1 W गुणा अवधि है, इन कुल योगों पर ±10 J।
| उपनमूना (परीक्षण विभाजन) | कार्य | हल किए गए | कच्चा जे | reported_j | प्रति हल किया गया कार्य reported_j | सेकंड |
|---|---|---|---|---|---|---|
| L0, gson म्यूटेंट (बीजक, पहले 3,000) | 3,000 | 3,000 | 648.3 | 167.5 | 0.056 | 11.8 |
| L1, ManySStuBs4J स्थान 2,000 से 3,999 | 2,000 | 690 | 377.2 | 17.9 | 0.026 | 8.2 |
L1 उप-नमूना अपने प्रोजेक्ट इंडेक्स का निर्माण केवल अपने 2,000 कार्यों से करता है, इसलिए इसकी समाधान दर (34.5%) पूर्ण रन की तुलना में कम है। measured_j, एक नामित रेल पर दीवार मीटर है, जो हर पंक्ति में खाली है; इसका प्रोटोकॉल खंड 8.3 है।
7. पुनः उपयोग के प्रमाण
आरसीई का पुनरुपयोग अक्ष पर स्थान एक इंजीनियरिंग तथ्य पर टिका है: कोड हर पैमाने पर पुन: उपयोग किया जाता है। नीचे प्रत्येक विधि इसे अलग तरह से मापती है।
| विधि | स्रोत | निष्कर्ष |
|---|---|---|
| फ़ाइल-स्तर क्लोन मैपिंग | DéjàVu, Lopes et al. 2017 [33] | 4.5 मिलियन गैर-फोर्क GitHub परियोजनाओं में 428 मिलियन फ़ाइलों में से, 85 मिलियन अद्वितीय हैं: “GitHub पर कोड का 70% पहले बनाए गए फ़ाइलों के क्लोन से बना है।” JavaScript में, 6% फाइलें अलग हैं। |
| लाइन-स्तर अतिरेक (redundancy) | Gabel और Su 2010 [34] | 420 मिलियन लाइनों की तुलना में, “प्रत्येक परियोजना का 50% और 100% के बीच हिस्सा एक पंक्ति पर अनावश्यक है।” |
| सांख्यिकीय भाषा मॉडल | Hindle et al. 2012 [35] | कोड “बहुत दोहराव वाला है, और वास्तव में प्राकृतिक भाषाओं की तुलना में भी अधिक ऐसा है।” |
| कॉर्पस निकट-डीडुप्लीकेशन | The Stack [36] | निकट-डीडुप्लीकेशन ने द स्टैक v1 (6.4 टीबी से 2.9 टीबी) का 54.7% और v2 (67.5 टीबी से 32.1 टीबी) का 52.4% हटाया। |
| संपूर्ण संग्रह संरक्षण | Software Heritage [129, 130] | 448 मिलियन मूल स्रोतों से 30.3 बिलियन अद्वितीय फ़ाइल सामग्री (आर्काइव काउंटर, पढ़ा गया 13 अक्टूबर 2026), प्रत्येक को अपने बाइट्स के हैश द्वारा एक बार संग्रहीत किया जाता है। |
| माइन किए गए फ़िक्स पैटर्न | PAR, TBar [22, 23] | PAR ने 60,000 से अधिक मानव पैच में “कई सामान्य फ़िक्स पैटर्न” पाए। TBar की 15 पैटर्न श्रेणियाँ मानक पाइपलाइन में 43 Defects4J बग सही ढंग से ठीक करती हैं, और पूर्ण दोष स्थानीयकरण के साथ 101 में से 74, बिना किसी सीखने के। ये आँकड़े [23] से पढ़े गए रूप में हैं; 101 का अर्थ (संभावित पैच या आज़माए गए बग) यहाँ उस शोधपत्र से दोबारा नहीं जाँचा गया है, इसलिए इस अनुपात को अपुष्ट मानें। |
| क्रॉस-लैंग्वेज कार्य | Rosetta Code [131] | 1,360 कार्य (और 421 मसौदा कार्य), जिनमें प्रत्येक अवधारणा को ज्ञात भाषाओं के 1,009 में से कई पर लागू किया गया है। |
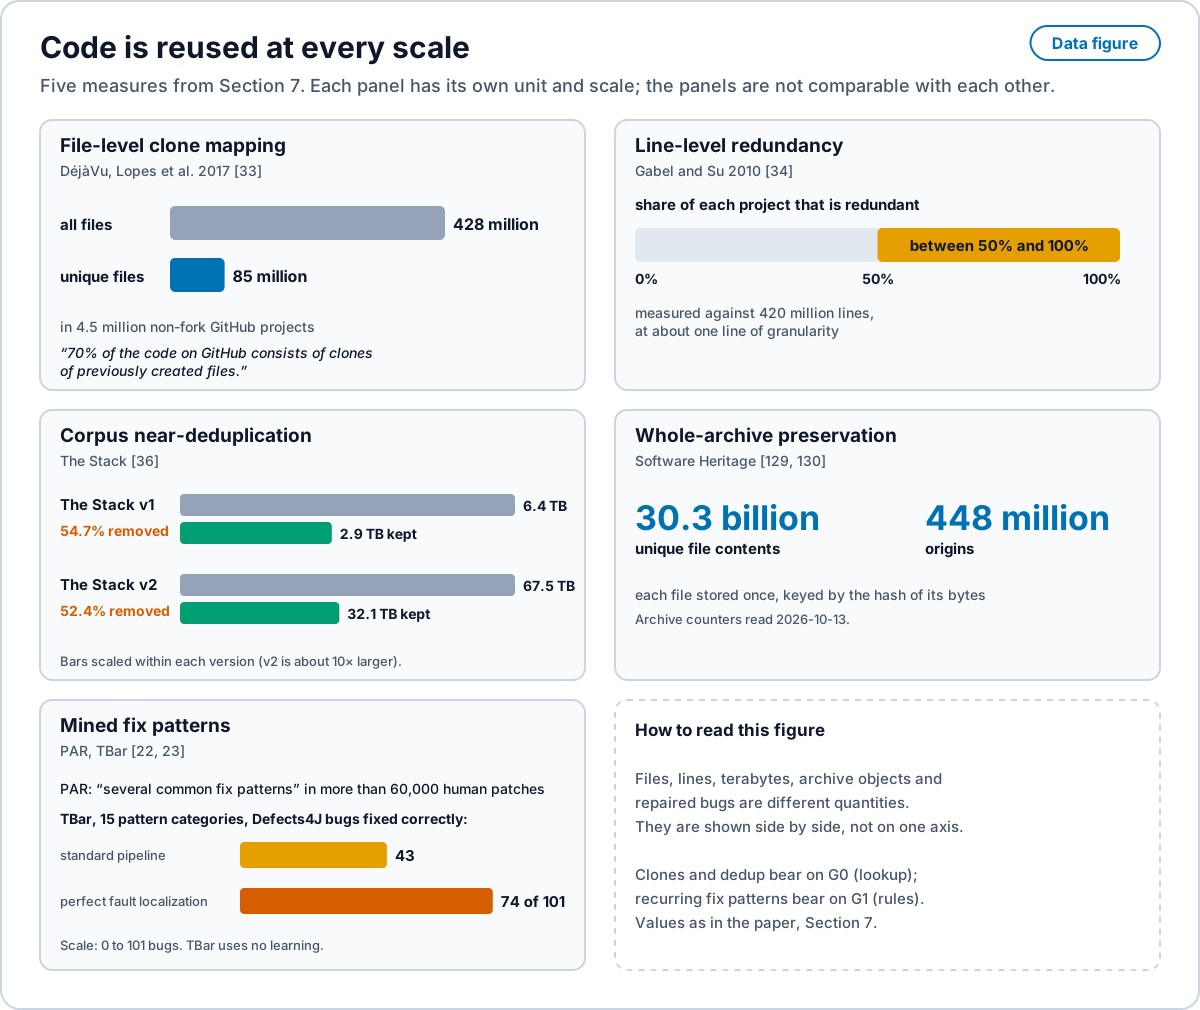
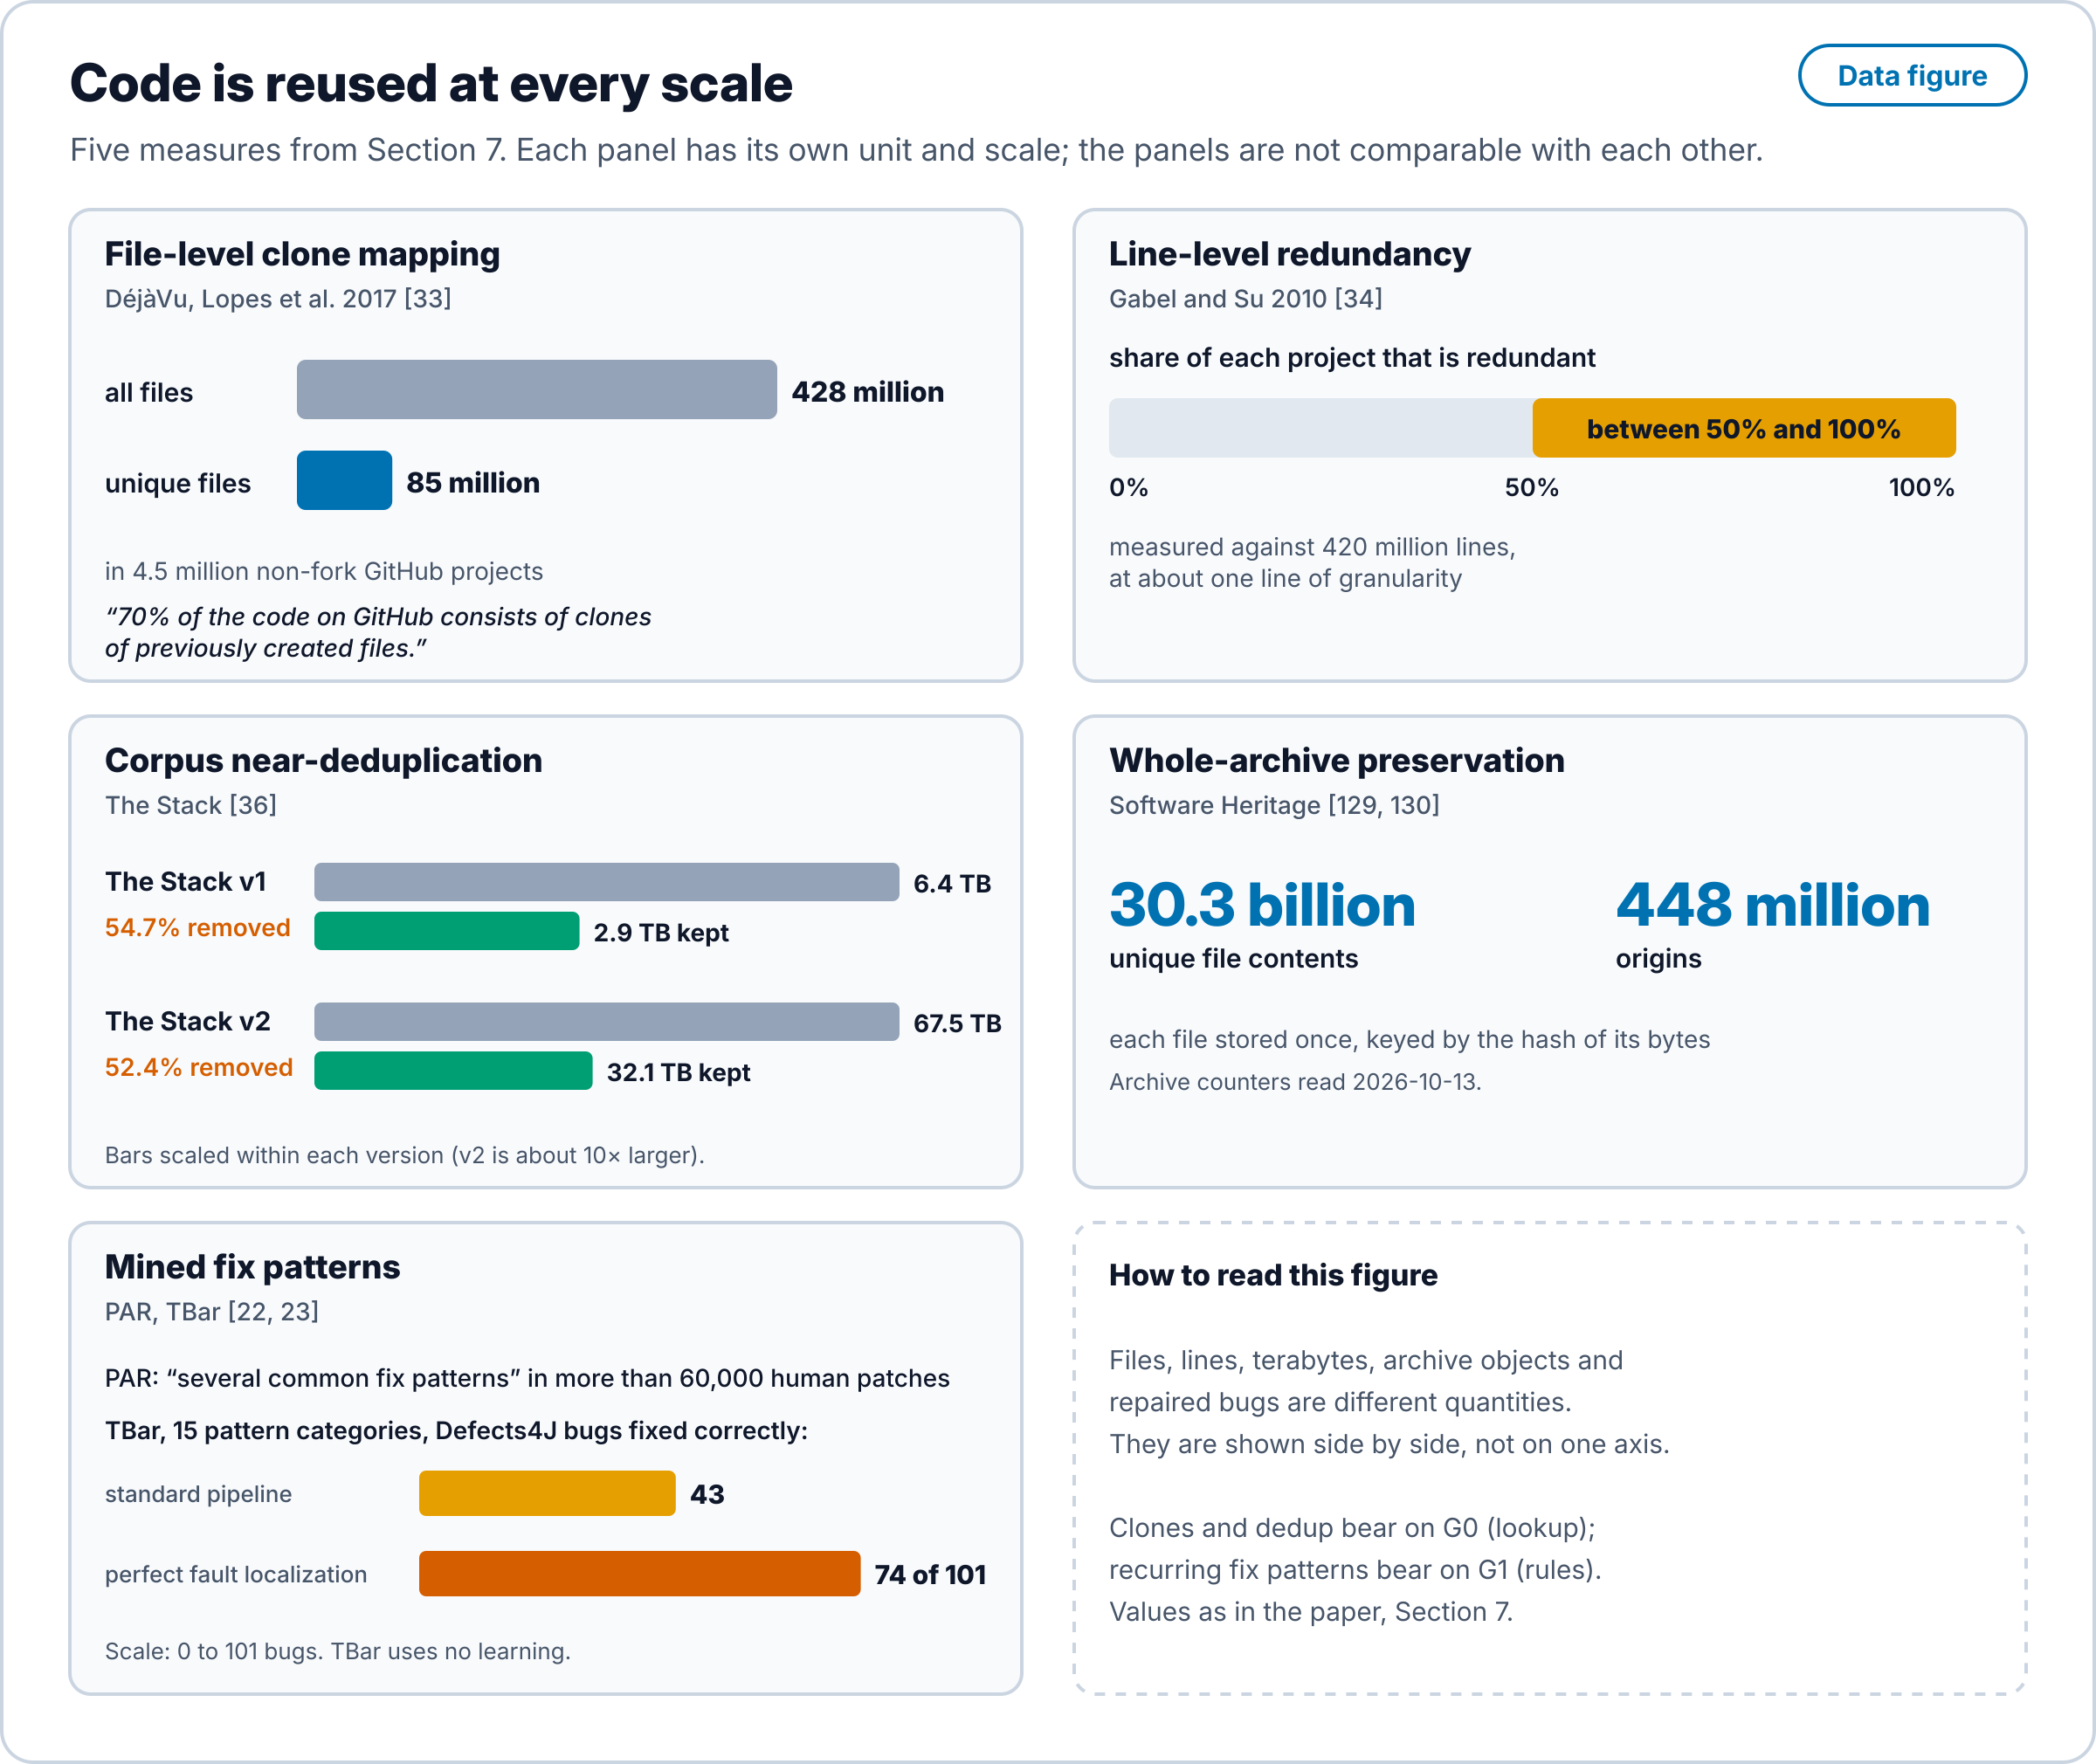
प्रत्येक पंक्ति इंजन के लिए एक इनपुट है। क्लोन और डीडअप कहते हैं कि आमतौर पर एक फ़िट मौजूद होता है, जो G0 है। पुनरावर्ती सुधार कहते हैं कि अनुकूलन अधिकतर संरक्षित पुनर्लेखनों का एक छोटा कैटलॉग है, जो G1 है। लाइन-स्तर की अतिरेकता से G2 के खोज स्थान में कमी आती है। पारिस्थितिकी तंत्र इसे हर प्रचारित फ़िट पर मापता है (खंड 2.3), और लिफ़्ट किए गए कोड पर मरम्मत सीढ़ी अलग रखे गए विभाजन पर बड़े पैमाने पर इसका माप करती है (खंड 6)। दो सावधानियाँ पढ़ने को तेज करती हैं। डुप्लिकेट पुनर्प्राप्ति और मॉडल स्कोर को फुलाते हैं जब तक कि उन्हें हटाया न जाए [104]। और बग वाली लाइनें ठीक की गई लाइनों जितनी प्राकृतिक नहीं होतीं [45], इसलिए स्वयं बग ही वह मामला है जिसका लुकअप सबसे कम भविष्यवाणी कर पाता है; G0 और G1 को सुधार के आकार पर कुंजी बनानी चाहिए, बग वाली पंक्ति पर नहीं। नियम-माइनिंग रेखा जो यह बड़े पैमाने पर करती है, GenProg के जनरेट-और-वैलिडेट खोज [88] और Prophet के सीखे गए शुद्धता मॉडल [89] से लेकर Facebook में Getafix [90] और Sorald द्वारा स्थिर विश्लेषण उल्लंघनों की मॉडल-मुक्त मरम्मत [91] तक, विविक्त इतिहास से टेम्पलेट प्राप्त करती है और अनदेखे मामलों पर सटीकता रिपोर्ट करती है [98]। यही मानक खंड 8.4 अपनाता है।
8. आगे के लिए माप प्रोटोकॉल
प्रत्येक प्रोटोकॉल अपने रन से पहले तय होता है: पूर्व पंजीकरण कमिट किया गया, बीज और सॉल्वर कमिट दर्ज किए गए, हर कलाकृति संरक्षित। द्वार पहले, जूल दूसरे, लेबल हमेशा।
8.1 Defects4J
Defects4J में 854 सक्रिय वास्तविक Java बग हैं, प्रत्येक पुनरुत्पादक परीक्षणों के साथ [37]।
- एक 100-बग उपसमुच्चय पर ऑफ़लाइन रूप से
defects4j checkoutके माध्यम से विकसित करें; केवल अलग रखे गए परिणामों की रिपोर्ट करें, जो रन से पहले स्थिर किए गए (FROZEN-heldout-v1) 288 बगों के एक असंयुक्त समुच्चय पर हैं। - G0 चलाएँ, फिर G1, फिर G2, और अंत में एक स्थानीय मॉडल। प्रत्येक बग को बंद करने वाले गियर का रिकॉर्ड रखें।
- द्वार: ट्रिगरिंग परीक्षण और पूरी सूट पास हों। प्रशंसनीय (plausible) और सही गणनाओं की अलग से रिपोर्ट करें; ‘सही’ का अर्थ समीक्षा पर डेवलपर पैच के समतुल्य है।
- प्रति सही सुधार मॉडल कॉल और प्रति सही सुधार जूल, लेबल सहित, रिपोर्ट करें।
- संदर्भ बिंदु: TBar के 43 सही सुधार और पूर्ण स्थानीयकरण के तहत उसके 101 में से 74 (आँकड़े [23] से पढ़े गए रूप में, जिनका हर यहाँ दोबारा नहीं जाँचा गया)। यह खंड एक प्रोटोकॉल है। इस इंजन का कोई Defects4J परिणाम इस शोधपत्र में रिपोर्ट नहीं किया गया है।
- संदूषण जाँच: हर उस बग को चिह्नित करें जिसका सुधार G0 के सूचकांक में शब्दशः दिखाई देता है, और चिह्नित बगों के साथ और बिना रिपोर्ट करें।
8.2 SWE-bench Lite, offline
SWE-bench Lite वास्तविक GitHub मुद्दों का एक 300 कार्य उपसमुच्चय है जिसे छिपे हुए परीक्षणों द्वारा हल किया जाता है [38]।
- बिना नेटवर्क के आधिकारिक Docker हार्नेस का उपयोग करें।
- पहला रन: केवल G0 और G1, शून्य मॉडल कॉल। यह मॉडल के बिना समाधान करने की निचली सीमा है।
- दूसरा रन: अंतिम गियर के रूप में एक स्थानीय मॉडल जोड़ें।
- रिज़ॉल्व दर, प्रति हल कार्य मॉडल कॉल और प्रति हल कार्य जूल रिपोर्ट करें, लेबल सहित।
- संदूषण जाँच 8.1 की तरह। SWE-Bench+ ने पाया कि सफल पैच का 32.67% समाधान issue पाठ में था [39]।
8.3 दीवार मीटर
- होस्ट की आपूर्ति पर एक दीवार मीटर या शंट मीटर संलग्न करें, बताई गई दर पर लॉग किया जाए और इसकी घड़ी को रन लॉग के साथ सिंक्रनाइज़ किया जाए।
- आइडल मशीन: CI धावक (runners) और अन्य बिल्ड रोके गए, और प्रत्येक ब्लॉक से पहले एक शांत विंडो द्वार की जाँच करके दर्ज किया गया।
- एक मापा गया निष्क्रिय आधार रेखा घटाएँ, और विधि बताएं।
measured_jकेवल मीटर से भरें।reported_j(RAPL) औरest_jको अलग स्तंभों में इसके बगल में रिपोर्ट करें। कभी भी लेबल के पार योग न करें।- खंड 6.3 की RAPL उप-नमूनाओं को मीटर के तहत दोहराएँ, फिर Defects4J का अलग रखा गया समुच्चय।
8.4 गियर स्थिर करके एक अलग रखा गया रन
यह खंड 6 की विधि है, जिसे नए कॉर्पोरा तक विस्तारित किया गया है।
- G0, G1 और G2 को एक टैग किए गए कमिट पर स्थिर करें, बाइनरी हैश रिकॉर्ड करें, और नियम सेट को उसके लेखक समय-चिह्न के साथ प्रकाशित करें।
- एक असंयुक्त अलग रखा गया स्लाइस निकालें: Multi-SWE-bench [102] और BugsInPy [103] के Rust और Python इंस्टेंस, G0 के इंडेक्स के विरुद्ध डी-डुप्लिकेट किए गए [104]।
- पहले रन से पहले स्लाइस, बीजों और परिकल्पनाओं का पूर्व पंजीकरण करें।
- हल की गई (resolved), प्रशंसनीय (plausible) और बाइट-समान गणनाओं को अलग से रिपोर्ट करें, प्रत्येक 95% अंतराल के साथ।
8.5 एक ही तालिका में baselines
- मॉडल रहित:
cargo fixऔर clippy [106], तथा Sorald या एक TBar पोर्ट [91]। - सस्ता मॉडल: स्थानीय मॉडल के साथ एजेंटलेस [99]।
- दूरस्थ मॉडल: फ्रोंटियर मॉडल वाला एक एजेंट, जिसकी ऊर्जा प्रदाता खुलासों से अनुमानित है और
est_jलेबल वाली है। - प्रत्येक पंक्ति के लिए जूल और डॉलर में cost-of-pass [101] रिपोर्ट करें, जिसमें खर्च को कपूर और सहयोगियों द्वारा आवश्यक अनुसार नियंत्रित किया गया हो [100]।
8.6 बड़े N पर मॉडल कॉल का अभिसरण
पदोन्नति वह तंत्र है जिसके द्वारा मॉडल लूप से बाहर निकलता है: एक नए मामले के लिए resolver को एक बार भुगतान किया जाता है, द्वार फ़िट को हैंडलर के रूप में स्वीकार करता है, और उसी आकार का हर बाद का मामला G0 या G1 में बंद होता है (खंड 4.2)। अभिसरण यह दावा है कि लाइव ट्रैफ़िक पर एक निश्चित विनिर्देश के तहत प्रति राउंड मॉडल कॉल शून्य तक गिर जाती हैं। इसे इस प्रकार मापा जाता है।
- सार्वजनिक रिपॉजिटरी से कम से कम 1,000 विनिर्देश निकालें, भाषा और आकार द्वारा स्तरित करें, और पहले दौर से पहले इंजन तथा सॉल्वर को स्थिर कर दें।
- रिकॉर्ड किए गए उत्पादन ट्रैफ़िक का पुन:प्ले करें, प्रति विनिर्देश पर कम से कम 10,000 घटनाएँ, निश्चित आकार के दौरों में।
- प्रत्येक दौर के लिए दर्ज करें: नई एस्केलेशन, मॉडल कॉल, पदोन्नति (promotions), स्थगन और बंद कार्य प्रति जूल, जिनमें से प्रत्येक लेबल किया गया हो (
est_j,reported_j,measured_j)। - प्राथमिक एंडपॉइंट: 20 दौरों के भीतर शून्य मॉडल कॉल्स वाले दौर तक पहुँचने वाले विनिर्देश का हिस्सा, जिसमें 95% विल्सन अंतराल शामिल है। द्वितीयक: प्रति कार्य-बंद कॉल द्वारा राउंड में मॉडल कॉल और अंतिम मॉडल कॉल का दौर।
- उन विनिर्देशों की रिपोर्ट करें जो अपने कारण (एक अटका हुआ इनपुट, एक गुम निर्भरता, नई मंशा) के साथ कभी अभिसरण नहीं करते हैं, और प्ररीक्षित भुजा के रूप में अटके हुए-इनपुट स्थगन चलाएँ।
प्रस्ताव 8 (फ़्लोर दृष्टिकोण)। जैसे ही G0 और G1 कवरेज बढ़ता है, हल किए गए कार्य प्रति जूल एक ज्ञात सुधार लागू करने और परीक्षण चलाने की स्वर्ण फ़्लोर तक पहुँचता है। सीढ़ी के पायदानों और दीवार मीटर टेस्ट में Defects4J अलग रखा गया सेट इसे मापता है।
8.7 भाषाओं में लिफ़्ट की coverage
लिफ़्ट को बनते समय मापा जाता है। भाषा के लिए, कोई प्रोग्राम तब लिफ़्ट किया हुआ गिना जाता है जब कार्यक्रम के अपने परीक्षण पास करता है और इसके दर्ज किए गए ट्रेस को बाइट दर बाइट दोहराता है, और का आकार हैश के समान होता है। नमूना कम से कम दस भाषाओं में प्रति भाषा 10,000 प्रोग्राम हैं, जिन्हें पिन किए गए सार्वजनिक कॉर्पोरा से एक निश्चित बीज (seed) के साथ लिया जाता है, जिसमें प्रत्येक रन से पहले लिफ़टर को स्थिर किया जाता है और उसका बाइनरी हैश दर्ज होता है, तथा 0 मॉडल कॉल होते हैं। हर रन में विल्सन 95% अंतराल के साथ उठाया गया हिस्सा रिपोर्ट किया जाता है, और अभी तक न उठाए गए प्रत्येक कंस्ट्रक्ट उस भाषा के लिफ्टर के लिए एक कार्य मद (work item) होता है, जिसे अगले रन से पहले बनाया और स्थिर किया जाता है। लक्ष्य हर भाषा का हर प्रोग्राम है।
9. खंडन कसौटियाँ
वे रन जिनसे वे परखते हैं पहले ठीक।
| ID | अवलोकन | पराजित करता है |
|---|---|---|
| RCE-F0 | कम से कम 10,000 Forms के एक पूर्व पंजीकृत रन पर, कोई भी प्रक्षेपण Form के संदर्भ ट्रेस से भिन्न ट्रेस प्रिंट करता है, या कोई गलत स्वरूपित इनपुट स्वीकार किया जाता है | यह दावा कि प्रक्षेपण विश्वसनीय हैं और द्वार प्रवेश पर अस्वीकार करता है |
| RCE-F1 | अलग रखे गए स्लाइस पर, स्थिर नियमों वाले G0 से G2 0 मॉडल कॉल के साथ 10% से कम कार्यों को हल करते हैं | इस पैमाने की मरम्मत के लिए अधिकांश फ़िट पहले से मौजूद होने का दावा |
| RCE-F2 | बाइट-समान या समकक्ष पैच हल किए गए अलग रखे गए कार्यों के आधे से कम होते हैं | ढके हुए कार्यों पर द्वार को संभाव्यता से अधिक पढ़ना |
| RCE-F3 | दीवार मीटर के तहत, दोनों द्वारा हल किए गए कार्यों का प्रति हल कार्य सकल जूल सबसे सस्ते मॉडल बेसलाइन की तुलना में अधिक होता है | ढके हुए कार्यों पर प्रति हल कार्य कम ऊर्जा का दावा |
| RCE-F4 | खंड 8.6 के अभिसरण प्रोटोकॉल में, अटके इनपुट रहित विनिर्देशों का आधे से कम 20 राउंड के भीतर शून्य मॉडल कॉल वाले दौर तक पहुँचता है | लूप से बाहर मॉडल संकलित करना |
10. पूरा करने का काम
प्रत्येक मद का प्रोटोकॉल नामित है।
- खंड 8.7 के प्रोटोकॉल के तहत कम से कम दस भाषाओं में लिफ़्ट बनाया और मापा गया।
- विनिर्देश भुजा: MBPP और HumanEval शैली में लिखे गए, Forms के रूप में रचित और प्रत्येक लक्ष्य पर उत्सर्जित किए गए विनिर्देश।
- L2 से L4 पर, यानी 288 बगों वाले Defects4J सेट (खंड 8.1) पर, और L5 से L7 (खंड 8.2) पर अलग रखे गए परिणाम।
- एक तालिका में बेसलाइन, जूल और डॉलर में पास करने की लागत (cost-of-pass) (खंड 8.5)।
measured_jश्रृंखला: निष्क्रिय होस्ट पर दीवार मीटर, कम से कम 10 दोहराव, सकल और शुद्ध साथ-साथ (खंड 8.3)।- अपनी विधि के साथ प्रकाशित 626 भाषाओं का सर्वेक्षण (आकृति 1)।
- गियर को स्थिर करके नए अलग रखे कॉर्पोरा: Multi-SWE-bench और BugsInPy (खंड 8.4)।
- कम से कम 1,000 विनिर्देशों पर मॉडल कॉल का अभिसरण (खंड 8.6)।
11. निष्कर्ष
RCE एक मूल (native) कोड पारिस्थितिकी तंत्र है। किसी प्रोग्राम को मंशा से केवल एक बार Form के रूप में लिखा जाता है: जो अवस्था, घटनाओं और शुद्ध संक्रमणों का हानिरहित कूटन है, और हर लक्ष्य भाषा इसका एक विश्वसनीय प्रक्षेपण होती है। अवैध अवस्थाओं को नहीं लिखा जा सकता और गलत स्वरूपित इनपुट प्रवेश द्वार पर अस्वीकार होते हैं, इसलिए पारिस्थितिकी तंत्र में कोई प्रोग्राम अपनी मंशा से भटक नहीं सकता और उसे बाद के diffing या त्रुटि ट्रैकिंग की आवश्यकता नहीं होती। जो भी फ़िट गेट पार करता है वह संग्रहीत होता है और पुन: उपयोग किया जाता है, और यह पारिस्थितिकी तंत्र एक ऐसे गेट के तहत चक्रवृद्धि रूप से संचित होता है जिसकी शुद्धता एकदिष्ट (monotone) होती है। 10,000 पूर्व-पंजीकृत Forms पर, स्थिर इंजन और 0 मॉडल कॉल के साथ, हर Form समान बाइट्स में राउंड ट्रिप करता है, हर प्रक्षेपण नियतात्मक होता है, हर गलत स्वरूपित इनपुट और विनिर्देश प्रवेश द्वार पर अस्वीकार होते हैं, और Python प्रक्षेपण 9,999 पर संदर्भ ट्रेस को पुनः चलाता है। अन्य भाषाओं का कोड लिफ़्ट द्वारा प्रवेश करता है, जो प्रत्येक भाषा के व्याकरण से उसके सिंटैक्स ट्री तक Form में एक निर्माण होता है; उठाए गए (lifted) कोड पर मरम्मत गियर 520,821 एक-टोकन दोषों में से 99.95% और 21,320 एकल-कथन Java बगों में से 63.7% को पुनर्स्थापित करते हैं। खंड 3.6 और 8.7 सार्वभौमिकता के प्रस्ताव बताते हैं और यह भी कि उनके निर्माण को कैसे मापा जाता है।
संदर्भ
[1] C. E. Shannon, “Prediction and Entropy of Printed English,” Bell System Technical Journal 30(1), 1951. doi:10.1002/j.1538-7305.1951.tb01366.x
[2] Y. Gurevich, “Sequential Abstract State Machines Capture Sequential Algorithms,” ACM Transactions on Computational Logic 1(1), 2000. doi:10.1145/343369.343384
[3] A. Blass and Y. Gurevich, “Abstract State Machines Capture Parallel Algorithms,” ACM Transactions on Computational Logic, 2003. doi:10.1145/937555.937561
[4] N. Dershowitz and Y. Gurevich, “A Natural Axiomatization of Computability and Proof of Church’s Thesis,” Bulletin of Symbolic Logic, 2008. doi:10.2178/bsl/1231081370
[5] E. F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM, 1970. doi:10.1145/362384.362685
[6] G. H. Mealy, “A Method for Synthesizing Sequential Circuits,” Bell System Technical Journal, 1955. doi:10.1002/j.1538-7305.1955.tb03788.x
[7] E. F. Moore, “Gedanken-Experiments on Sequential Machines,” Automata Studies, 1956. doi:10.1515/9781400882618-006
[8] K. Kang et al., “Feature-Oriented Domain Analysis (FODA) Feasibility Study,” CMU/SEI-90-TR-021, 1990.
[9] R. Alur et al., “Syntax-Guided Synthesis,” FMCAD 2013. doi:10.1109/FMCAD.2013.6679385
[10] D. Harel, “Statecharts: A Visual Formalism for Complex Systems,” Science of Computer Programming, 1987. doi:10.1016/0167-6423(87)90035-9
[11] R. Tate, M. Stepp, Z. Tatlock and S. Lerner, “Equality Saturation,” POPL 2009. doi:10.1145/1480881.1480915
[12] M. Willsey et al., “egg: Fast and Extensible Equality Saturation,” POPL 2021. doi:10.1145/3434304
[13] B. Moseley and P. Marks, “Out of the Tar Pit,” 2006.
[14] M. Fowler, “Event Sourcing,” 2005. https://martinfowler.com/eaaDev/EventSourcing.html
[15] P. Alvaro et al., “Dedalus: Datalog in Time and Space,” LNCS 2011. doi:10.1007/978-3-642-24206-9_16
[16] A. M. Turing, “On Computable Numbers,” Proceedings of the London Mathematical Society, 1937. doi:10.1112/plms/s2-42.1.230
[17] A. Church, “An Unsolvable Problem of Elementary Number Theory,” American Journal of Mathematics, 1936. doi:10.2307/2371045
[18] P. Wadler, “Propositions as Types,” Communications of the ACM, 2015. doi:10.1145/2699407
[19] J. M. Hellerstein and P. Alvaro, “Keeping CALM,” Communications of the ACM, 2020. doi:10.1145/3369736
[20] G. Kahn, “The Semantics of a Simple Language for Parallel Programming,” IFIP 1974, pp. 471 to 475.
[21] H. Husain et al., “CodeSearchNet Challenge,” 2019. arXiv:1909.09436
[22] D. Kim, J. Nam, J. Song and S. Kim, “Automatic Patch Generation Learned from Human-Written Patches” (PAR), ICSE 2013. doi:10.1109/ICSE.2013.6606626
[23] K. Liu et al., “TBar: Revisiting Template-based Automated Program Repair,” ISSTA 2019. arXiv:1903.08409
[24] K. Liu et al., “AVATAR: Fixing Semantic Bugs with Fix Patterns of Static Analysis Violations,” SANER 2019. arXiv:1812.07270
[25] A. Koyuncu et al., “FixMiner: Mining Relevant Fix Patterns for Automated Program Repair,” 2018. arXiv:1810.01791
[26] Y. Padioleau et al., “Documenting and Automating Collateral Evolutions in Linux Device Drivers” (Coccinelle), EuroSys 2008. doi:10.1145/1352592.1352618
[27] A. Solar-Lezama et al., “Combinatorial Sketching for Finite Programs,” ASPLOS 2006. doi:10.1145/1168857.1168907
[28] L. Chen, M. Zaharia and J. Zou, “FrugalGPT,” 2023. arXiv:2305.05176
[29] S. Haber and W. S. Stornetta, “How to Time-Stamp a Digital Document,” Journal of Cryptology, 1991. doi:10.1007/BF00196791
[30] S. A. Crosby and D. S. Wallach, “Efficient Data Structures for Tamper-Evident Logging,” USENIX Security 2009.
[31] L. de Moura and N. Bjørner, “Z3: An Efficient SMT Solver,” TACAS 2008. doi:10.1007/978-3-540-78800-3_24
[32] Kani Rust Verifier. https://github.com/model-checking/kani
[33] C. V. Lopes et al., “DéjàVu: A Map of Code Duplicates on GitHub,” OOPSLA 2017. doi:10.1145/3133908
[34] M. Gabel and Z. Su, “A Study of the Uniqueness of Source Code,” FSE 2010. doi:10.1145/1882291.1882315
[35] A. Hindle et al., “On the Naturalness of Software,” ICSE 2012. doi:10.1109/ICSE.2012.6227135
[36] D. Kocetkov et al., “The Stack: 3 TB of Permissively Licensed Source Code,” 2022. arXiv:2211.15533; The Stack v2 dataset card, https://huggingface.co/datasets/bigcode/the-stack-v2
[37] R. Just, D. Jalali and M. D. Ernst, “Defects4J: A Database of Existing Faults to Enable Controlled Testing Studies for Java Programs,” ISSTA 2014. doi:10.1145/2610384.2628055
[38] C. E. Jimenez et al., “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?” 2023. arXiv:2310.06770
[39] R. Aleithan et al., “SWE-Bench+: Enhanced Coding Benchmark for LLMs,” 2024. arXiv:2410.06992
[40] C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal 27, 1948. doi:10.1002/j.1538-7305.1948.tb01338.x
[41] A. N. Kolmogorov, “Three approaches to the quantitative definition of information,” Problemy Peredachi Informatsii 1(1), 1965 (in Russian); English translation, International Journal of Computer Mathematics 2, 1968. doi:10.1080/00207166808803030
[42] R. J. Solomonoff, “A formal theory of inductive inference. Part I,” Information and Control 7(1), 1964. doi:10.1016/S0019-9958(64)90223-2
[43] G. J. Chaitin, “A Theory of Program Size Formally Identical to Information Theory,” Journal of the ACM 22(3), 1975. doi:10.1145/321892.321894
[44] J. Rissanen, “Modeling by shortest data description,” Automatica 14(5), 1978. doi:10.1016/0005-1098(78)90005-5
[45] B. Ray, V. Hellendoorn, S. Godhane, Z. Tu, A. Bacchelli and P. Devanbu, “On the ‘naturalness’ of buggy code,” ICSE 2016. doi:10.1145/2884781.2884848
[46] Z. Tu, Z. Su and P. Devanbu, “On the localness of software,” FSE 2014. doi:10.1145/2635868.2635875
[47] M. Allamanis, E. T. Barr, P. Devanbu and C. Sutton, “A Survey of Machine Learning for Big Code and Naturalness,” ACM Computing Surveys 51(4), 2018. doi:10.1145/3212695
[48] 陈浙哲, 刘忠鑫, 鄢萌, 徐洲, 夏鑫, 雷晏 (Z. Chen, Z. Liu, M. Yan, Z. Xu, X. Xia and Y. Lei), “代码自然性及其应用研究进展” (Research progress of code naturalness and its application), 软件学报 (Journal of Software) 33(8), 3015 to 3034, 2022. doi:10.13328/j.cnki.jos.006355
[49] G. Sridhara, V. S. Sinha and S. Mani, “Naturalness of Natural Language Artifacts in Software,” ISEC 2015 (India Software Engineering Conference). doi:10.1145/2723742.2723758
[50] P. Devanbu, “On the naturalness of software,” keynote, ISEC 2013 (India Software Engineering Conference). doi:10.1145/2442754.2442763
[51] A. Z. H. Yang, S. Kolak, V. J. Hellendoorn, R. Martins et al., “Revisiting Unnaturalness for Automated Program Repair in the Era of Large Language Models,” ICSE 2025. doi:10.1109/ICSE55347.2025.00089
[52] E. W. Dijkstra, “Guarded commands, nondeterminacy and formal derivation of programs,” Communications of the ACM 18(8), 1975. doi:10.1145/360933.360975
[53] N. Wirth, “Program development by stepwise refinement,” Communications of the ACM 14(4), 1971. doi:10.1145/362575.362577
[54] C. A. R. Hoare, “An axiomatic basis for computer programming,” Communications of the ACM 12(10), 1969. doi:10.1145/363235.363259
[55] J.-R. Abrial, The B-Book: Assigning Programs to Meanings, Cambridge University Press, 1996. doi:10.1017/CBO9780511624162
[56] J.-R. Abrial, Modeling in Event-B: System and Software Engineering, Cambridge University Press, 2010. doi:10.1017/CBO9781139195881
[57] R.-J. Back and J. von Wright, Refinement Calculus: A Systematic Introduction, Springer, 1998. doi:10.1007/978-1-4612-1674-2
[58] F. L. Bauer and H. Wössner, Algorithmic Language and Program Development, Springer, 1982. doi:10.1007/978-3-642-61807-9
[59] S. Gulwani, “Automating string processing in spreadsheets using input-output examples,” POPL 2011. doi:10.1145/1926385.1926423
[60] S. Gulwani, O. Polozov and R. Singh, “Program Synthesis,” Foundations and Trends in Programming Languages 4(1-2), 2017. doi:10.1561/2500000010
[61] F. P. Brooks, “No Silver Bullet: Essence and Accidents of Software Engineering,” Computer 20(4), 1987. doi:10.1109/MC.1987.1663532
[62] P. Naur, “Programming as theory building,” Microprocessing and Microprogramming 15(5), 1985. doi:10.1016/0165-6074(85)90032-8
[63] M. M. Lehman, “Programs, life cycles, and laws of software evolution,” Proceedings of the IEEE 68(9), 1980. doi:10.1109/PROC.1980.11805
[64] P. Zave and M. Jackson, “Four dark corners of requirements engineering,” ACM Transactions on Software Engineering and Methodology 6(1), 1997. doi:10.1145/237432.237434
[65] R. Landauer, “Irreversibility and Heat Generation in the Computing Process,” IBM Journal of Research and Development 5(3), 1961. doi:10.1147/rd.53.0183
[66] C. H. Bennett, “Logical Reversibility of Computation,” IBM Journal of Research and Development 17(6), 1973. doi:10.1147/rd.176.0525
[67] M. Franz and T. Kistler, “Slim binaries,” Communications of the ACM 40(12), 1997. doi:10.1145/265563.265576
[68] C. W. Fraser, “Automatic inference of models for statistical code compression,” PLDI 1999. doi:10.1145/301618.301672
[69] P. Cousot and R. Cousot, “Abstract interpretation: a unified lattice model for static analysis of programs by construction or approximation of fixpoints,” POPL 1977. doi:10.1145/512950.512973
[70] Y. Futamura, “Partial evaluation of computation process: an approach to a compiler-compiler,” Systems, Computers, Controls 2(5), 1971; reprinted in Higher-Order and Symbolic Computation 12(4), 1999. doi:10.1023/A:1010095604496
[71] A. P. Ershov, “Mixed computation: potential applications and problems for study,” Theoretical Computer Science 18(1), 1982. doi:10.1016/0304-3975(82)90111-6
[72] W. A. Howard, “The formulae-as-types notion of construction,” in J. P. Seldin and J. R. Hindley (eds.), To H. B. Curry: Essays on Combinatory Logic, Lambda Calculus and Formalism, Academic Press, 1980.
[73] 土居真之, 肥後芳樹, 有馬諒, 下仲健斗, 楠本真二 (M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto), “ソースコードの「自然さ」を利用した自動生成ファイルの特定” (Identifying auto-generated files using the naturalness of source code), 電子情報通信学会技術研究報告 (IEICE Technical Report) 117(380), 19 to 24, January 2018. https://sdl.ist.osaka-u.ac.jp/pman/pman3.cgi?D=517
[74] M. Doi, Y. Higo, R. Arima, K. Shimonaka and S. Kusumoto, “On the naturalness of auto-generated code: can we identify auto-generated code automatically?” ICPC 2018. doi:10.1145/3196321.3196356
[75] F. V. Arrebola, “Modelo de sugestão de código-fonte baseado em modelos de linguagem organizados em um contexto hierárquico” (A source code suggestion model based on language models organized in a hierarchical context), doctoral thesis in electrical engineering, Fundação Educacional Inaciana Padre Sabóia de Medeiros (FEI), Brazil, 2018. Advisor R. A. C. Bianchi.
[76] G. Febres, K. Jaffé and C. Gershenson, “Complexity measurement of natural and artificial languages,” Complexity 20(6), 2015. doi:10.1002/cplx.21529
[77] M. Rahman, D. Palani and P. C. Rigby, “Natural Software Revisited,” ICSE 2019. doi:10.1109/ICSE.2019.00022
[78] A. Torres, S. Baltes, C. Treude and M. Wagner, “Applying Information Theory to Software Evolution,” NLBSE 2023. doi:10.1109/NLBSE59153.2023.00017
[79] A. Blass, N. Dershowitz and Y. Gurevich, “When are two algorithms the same?,” Bulletin of Symbolic Logic 15(2), 2009. arXiv:0811.0811. https://arxiv.org/abs/0811.0811
[80] Y. N. Moschovakis, “What is an algorithm?,” in Mathematics Unlimited: 2001 and Beyond, Springer, 2001. https://www.math.ucla.edu/~ynm/papers/eng.pdf
[81] M. Y. Vardi, “What is an algorithm?,” Communications of the ACM 55(3), 2012. doi:10.1145/2093548.2093549
[82] S. Laddad, A. Cheung, J. M. Hellerstein and M. Milano, “Flo: a Semantic Foundation for Progressive Stream Processing,” POPL 2025. arXiv:2411.08274. https://arxiv.org/abs/2411.08274
[83] The Elm Architecture, Elm guide. https://guide.elm-lang.org/architecture/
[84] Temporal, “Workflows” (event history), documentation. https://docs.temporal.io/workflows
[85] A. Pnueli, M. Siegel and E. Singerman, “Translation validation,” TACAS 1998. doi:10.1007/BFb0054170
[86] X. Yang, Y. Chen, E. Eide and J. Regehr, “Finding and understanding bugs in C compilers,” PLDI 2011. doi:10.1145/1993498.1993532
[87] C. Nandi, M. Willsey, A. Zhu et al., “Rewrite Rule Inference Using Equality Saturation,” OOPSLA 2021. arXiv:2108.10436. https://arxiv.org/abs/2108.10436
[88] C. Le Goues, T. Nguyen, S. Forrest and W. Weimer, “GenProg: A Generic Method for Automatic Software Repair,” IEEE TSE 38(1), 2012. doi:10.1109/TSE.2011.104
[89] F. Long and M. Rinard, “Automatic patch generation by learning correct code,” POPL 2016. doi:10.1145/2837614.2837617
[90] J. Bader, A. Scott, M. Pradel and S. Chandra, “Getafix: Learning to Fix Bugs Automatically,” OOPSLA 2019. arXiv:1902.06111. https://arxiv.org/abs/1902.06111
[91] K. Etemadi, N. Harrand, S. Larsen et al., “Sorald: Automatic Patch Suggestions for SonarQube Static Analysis Violations,” IEEE TDSC, 2022. arXiv:2103.12033. https://arxiv.org/abs/2103.12033
[92] Z. Qi, F. Long, S. Achour and M. Rinard, “An analysis of patch plausibility and correctness for generate-and-validate patch generation systems,” ISSTA 2015. doi:10.1145/2771783.2771791
[93] E. K. Smith, E. T. Barr, C. Le Goues and Y. Brun, “Is the cure worse than the disease? Overfitting in automated program repair,” ESEC/FSE 2015. doi:10.1145/2786805.2786825
[94] X.-B. D. Le, F. Thung, D. Lo and C. Le Goues, “Overfitting in semantics-based automated program repair,” Empirical Software Engineering 23, 2018. doi:10.1007/s10664-017-9577-2
[95] Y. Xiong, X. Liu, M. Zeng, L. Zhang and G. Huang, “Identifying patch correctness in test-based program repair,” ICSE 2018. doi:10.1145/3180155.3180182
[96] T. Durieux, F. Madeiral, M. Martinez and R. Abreu, “Empirical Review of Java Program Repair Tools: A Large-Scale Experiment on 2,141 Bugs and 23,551 Repair Attempts,” ESEC/FSE 2019. arXiv:1905.11973. https://arxiv.org/abs/1905.11973
[97] K. Liu, A. Koyuncu, T. F. Bissyandé et al., “You Cannot Fix What You Cannot Find! An Investigation of Fault Localization Bias in Benchmarking Automated Program Repair Systems,” ICST 2019. arXiv:1812.07283. https://arxiv.org/abs/1812.07283
[98] M. Monperrus, “Automatic Software Repair: A Bibliography,” ACM Computing Surveys 51(1), 2018. doi:10.1145/3105906
[99] C. S. Xia, Y. Deng, S. Dunn and L. Zhang, “Agentless: Demystifying LLM-based Software Engineering Agents,” 2024. arXiv:2407.01489. https://arxiv.org/abs/2407.01489
[100] S. Kapoor, B. Stroebl, Z. S. Siegel, N. Nadgir and A. Narayanan, “AI Agents That Matter,” 2024. arXiv:2407.01502. https://arxiv.org/abs/2407.01502
[101] M. H. Erol, B. El, M. Suzgun, M. Yuksekgonul and J. Zou, “Cost-of-Pass: An Economic Framework for Evaluating Language Models,” 2025. arXiv:2504.13359. https://arxiv.org/abs/2504.13359
[102] D. Zan, Z. Huang, W. Liu et al., “Multi-SWE-bench: A Multilingual Benchmark for Issue Resolving,” 2025. arXiv:2504.02605. https://arxiv.org/abs/2504.02605
[103] R. Widyasari, S. Q. Sim, C. Lok et al., “BugsInPy: a database of existing bugs in Python programs to enable controlled testing and debugging studies,” ESEC/FSE 2020. doi:10.1145/3368089.3417943
[104] M. Allamanis, “The Adverse Effects of Code Duplication in Machine Learning Models of Code,” Onward! 2019. arXiv:1812.06469. https://arxiv.org/abs/1812.06469
[105] K. N. Khan, M. Hirki, T. Niemi, J. K. Nurminen and Z. Ou, “RAPL in Action: Experiences in Using RAPL for Power Measurements,” ACM TOMPECS 3(2), 2018. doi:10.1145/3177754
[106] The Rust project, rustfix and cargo fix. https://github.com/rust-lang/rustfix
[107] R.-M. Karampatsis and C. Sutton, “How Often Do Single-Statement Bugs Occur? The ManySStuBs4J Dataset,” MSR 2020. doi:10.1145/3379597.3387491
[108] C. Richter and H. Wehrheim, “TSSB-3M: Mining single statement bugs at massive scale,” MSR 2022. doi:10.1145/3524842.3528505
[109] H. Coles, T. Laurent, C. Henard, M. Papadakis and A. Ventresque, “PIT: a practical mutation testing tool for Java,” ISSTA 2016. doi:10.1145/2931037.2948707
[110] R. Just, D. Jalali, L. Inozemtseva, M. D. Ernst, R. Holmes and G. Fraser, “Are mutants a valid substitute for real faults in software testing?” FSE 2014. doi:10.1145/2635868.2635929
[111] I. J. Good, “Speculations Concerning the First Ultraintelligent Machine,” Advances in Computers 6, 1965. doi:10.1016/S0065-2458(08)60418-0
[112] J. Schmidhuber, “Gödel Machines: Fully Self-referential Optimal Universal Self-improvers,” in Artificial General Intelligence, Springer, 2007. doi:10.1007/978-3-540-68677-4_7
[113] E. Yudkowsky, “Intelligence Explosion Microeconomics,” Technical report 2013-1, Machine Intelligence Research Institute, 2013. https://intelligence.org/files/IEM.pdf
[114] M. H. Löb, “Solution of a Problem of Leon Henkin,” Journal of Symbolic Logic 20(2), 1955. doi:10.2307/2266895
[115] E. Yudkowsky and M. Herreshoff, “Tiling Agents for Self-Modifying AI, and the Löbian Obstacle,” Machine Intelligence Research Institute, 2013. https://intelligence.org/files/TilingAgentsDraft.pdf
[116] E. Zelikman, E. Lorch, L. Mackey and A. T. Kalai, “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation,” 2023. doi:10.48550/arXiv.2310.02304
[117] J. Zhang, S. Hu, C. Lu, R. Lange and J. Clune, “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents,” 2025. doi:10.48550/arXiv.2505.22954
[118] A. Novikov et al., “AlphaEvolve: A coding agent for scientific and algorithmic discovery,” 2025. doi:10.48550/arXiv.2506.13131
[119] G. Wang, Y. Xie, Y. Jiang, A. Mandlekar, C. Xiao, Y. Zhu, L. Fan and A. Anandkumar, “Voyager: An Open-Ended Embodied Agent with Large Language Models,” 2023. doi:10.48550/arXiv.2305.16291
[120] Y. Futamura, “Partial Evaluation of Computation Process: An Approach to a Compiler-Compiler,” Higher-Order and Symbolic Computation 12(4), 1999 (first published 1971). doi:10.1023/A:1010095604496
[121] V. F. Turchin, “The Concept of a Supercompiler,” ACM Transactions on Programming Languages and Systems 8(3), 1986. doi:10.1145/5956.5957
[122] J. N. Foster, M. B. Greenwald, J. T. Moore, B. C. Pierce and A. Schmitt, “Combinators for Bidirectional Tree Transformations: A Linguistic Approach to the View-Update Problem,” ACM Transactions on Programming Languages and Systems 29(3), 2007. doi:10.1145/1232420.1232424
[123] M. Hofmann, B. Pierce and D. Wagner, “Symmetric Lenses,” POPL, 2011. doi:10.1145/1926385.1926428
[124] K. Czarnecki, J. N. Foster, Z. Hu, R. Lämmel, A. Schürr and J. F. Terwilliger, “Bidirectional Transformations: A Cross-Discipline Perspective,” ICMT, LNCS 5563, 2009. doi:10.1007/978-3-642-02408-5_19
[125] E. W. Dijkstra, “A Constructive Approach to the Problem of Program Correctness,” BIT 8(3), 1968. doi:10.1007/BF01933419
[126] A. Hall and R. Chapman, “Correctness by Construction: Developing a Commercial Secure System,” IEEE Software 19(1), 2002. doi:10.1109/52.976937
[127] Y. Minsky, “OCaml for the Masses,” Communications of the ACM 54(11), 2011. doi:10.1145/2018396.2018413
[128] D. A. Turner, “Total Functional Programming,” Journal of Universal Computer Science 10(7), 2004. doi:10.3217/jucs-010-07-0751
[129] R. Di Cosmo and S. Zacchiroli, “Software Heritage: Why and How to Preserve Software Source Code,” iPRES 2017, Kyoto. https://hal.science/hal-01590958
[130] Software Heritage, archive counters, read 13 October 2026: 30,253,266,524 file contents and 448,311,919 origins. https://archive.softwareheritage.org/api/1/stat/counters/
[131] Rosetta Code, main page, read 13 October 2026: 1,360 tasks, 421 draft tasks, 1,009 known languages. https://rosettacode.org/wiki/Rosetta_Code